2021年最火的编程语言将会是哪个?

thbcm阅读(284)

2020年已经过去四分之三了,很快就要到2021年了。作为一名程序员,需要关注一下现在流行的编程语言,以及未来会火的语言。回顾编程语言历史,CJava 是最古老的两个,并且在业界仍然存在,但是你会发现它们的热度一直在下降。

作为开发人员,我爱上了 JavaScript,并且已经使用 JavaScript 已有一段时间了。但是,如果我们睁开眼睛看看开发人员世界,情况可能会稍有改变。让我们从 JavaScriptPythonGo 中选择一门在 2021 年使用的语言。在讨论每种语言的优点之前,让我向您展示一些在线调查及其结果。

StackOverflow 调查

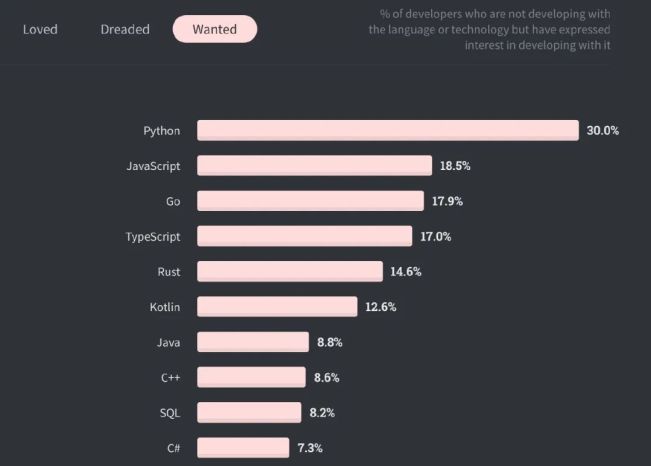
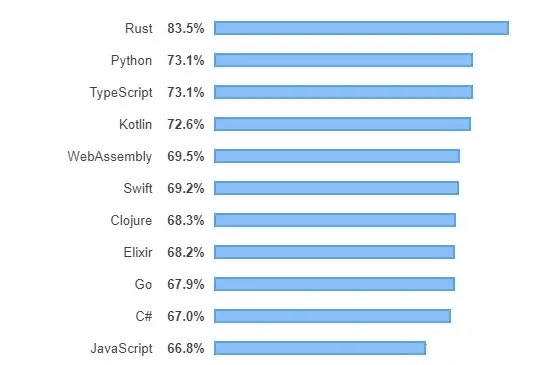
StackOverflow 的年度开发人员调查是对全球开人员的最大、最全面的调查。超过 90,000 个开发人员参加了此调查。我们可以看到Python 领先,而 JavaScriptGo分别位于第二和第三位。

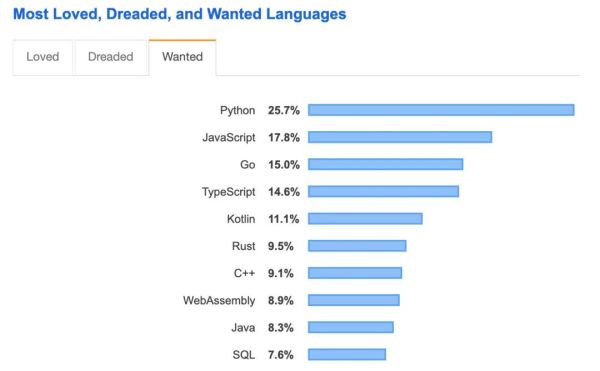
下图在 2019 年进行的调查。作为一种快速增长的语言,Go 的受欢迎程度正在疯狂增加。

GitHub-GitHut 排名

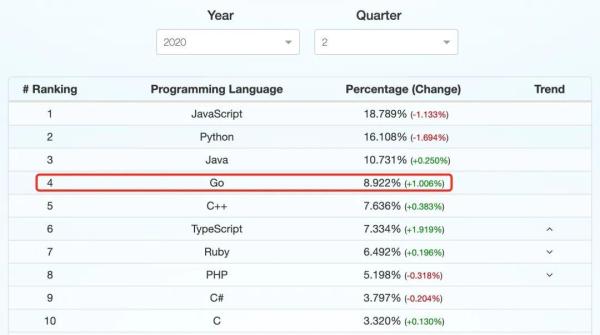
但是通过观察每种编程语言的排名,我们可以看到 Go 的流行度正在显着增加,而 JavaScriptPython 的流行度却在下降。

为什么选择 Python?

Python 是一种高级的动态类型编程语言,在 IT 行业中已经流行了很多年。根据许多调查,Python 被认为是过去十年中最受欢迎的语言。

(推荐教程:python教程

Python 的优点

  • 使用 Python,您可以用更少的代码在更短的时间内解决复杂的问题。
  • Python 通过简单而强大的语法使许多复杂的事情变得非常容易。
  • 这是一种高级语言,因此您不必像使用 C++ 那样担心诸如内存管理之类的复杂任务。
  • 它是跨平台的,这意味着您可以在 Windows,Mac 和 Linux 上构建和运行 Python 应用程序。
  • 它有一个庞大的社区。每当您遇到困难时,都会有人帮助您。
  • 它具有大量的库,框架和工具。这意味着无论您想做什么,很可能其他人以前都做过,因为 Python 已经问世 20 多年了。

简而言之,Python 是一种多用途语言,具有简单,干净且对初学者友好的语法。所有这些都意味着 Python 很棒。从技术上讲,您使用 Python 所做的一切,也可以使用其他编程语言。但是 Python 的简单性和优雅性使其比其他编程语言有了更大的发展。这就是为什么它是雇主寻找的第一语言。无论您是程序员还是绝对的初学者,学习 Python 都会在 2021 年为您带来很多就业机会。实际上,一个 Python 开发人员的平均年薪高达 116,000 美元。(国内是这样吗?感觉悬)

为什么选择 JavaScript(Node.js)?

我个人很喜欢 Node.js,因为 Node.js 是我开始进行后端开发的语言。到目前为止,我已经谈论编程语言。但是在本节中,我想进一步谈谈 Node.js,它是最流行的 JavaScript 运行时环境之一。众所周知,Node.jsIT 行业中很受后端开发的欢迎。主要原因之一是 Node.js基于 JavaScript。如果您是 JavaScript 开发人员,则可以轻松地成为全栈开发人员,这是了解 JavaScript 的另一项优势。

(推荐教程:JavaScript教程

JavaScript 和 Node.js 的优点

  • 这是非阻塞的。因此,这意味着 Node.js 确实非常快。(非阻塞文件读写是服务器需要做的事情之一。但这是 Node.js 要做的事情。)
  • 前端和后端使用一种语言编写。
  • Uber,LinkedIn,Netflix 和 Facebook 等主要公司都在使用它。
  • 它是跨平台的。这意味着您可以在 Windows,Mac 和 Linux 上构建和运行 Node.js 应用程序。
  • 它有一个庞大的社区。(Gitter[2] 是我目前所在的社区之一。此外,您可以找到 Slack 频道和 StackOverflow 讨论。)
  • 它不是一个臃肿的框架。这意味着它是一种 Web 服务器技术,可以与 Node.js 所使用的不同框架一起使用,例如 Express,它是流行的 Node.js 框架之一。

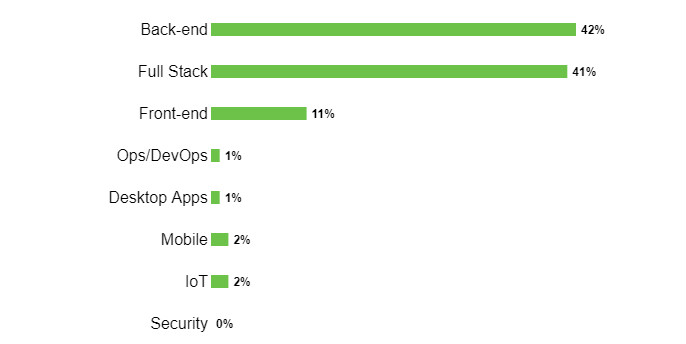
再一次,我们可以看到 Node.js 还将成为在后端开发中使用的绝佳 JavaScript 环境。通过观察下图,我们可以看到在 2019–2020 年期间,JavaScript 用于后端和前端开发的比例相似。如果我们看一下 Node.js 在美国的开发人员的平均年薪,我们发现它的年薪在 48,000 美元到 130,000 美元之间。

为什么选择 Go?

Go 是一种开放源代码编程语言,可轻松构建简单,可靠和高效的软件。它最初是在 2009 年发布的,但自那时以来,其流行度一直低于 PythonJavaScript。然而 Go两次被评为年度编程语言。此外,Go 已成为 67.9% 的开发人员最喜欢的编程语言。显然,有一些原因使开发人员开始喜欢 Go

Go 的优点

  • 高效。由于 Go 是一种类似于 C 的语言,因此您无需了解太多新的语法。
  • Go 也是一门跨平台语言。
  • 这是一门简单的语言。为什么?答案是它只有 25 个关键字和较少数量的数据结构(没有类,只有函数和类型)。
  • 这是一门可靠的语言。这是一门快速的语言。默认情况下,它支持并发,具有漂亮的模型并默认情况下处理可用于生产环境的服务器。
  • Go 不会经常更新。如果更新,则也不会特别重大更改,并且 Go 与旧版本 100% 兼容。
  • Go 现在是一门成熟的语言。(Go 具有内置的包管理器测试框架和并发模型。)

基于以上优点,我们可以看到 Go 也是一门很棒的语言。您可能想知道为什么要花这么多时间才能弄清这一点,为什么还没有开始使用 Go。在我这边,我也这么认为。如我们所见,大多数程序员都将 C 语言作为他们的第一门编程语言来学习。如果您以这种方式开始学习和使用 Go,那么对您来说将毫不费力。

如果我们看一下 Go 开发者在美国的平均薪水,则为每年 45,000 美元 至 130,000 美元。

(推荐课程:Go教程

结论

如上所见,Go 在过去几年中做得很好。此外,根据调查,与 JavaScriptPython 相比,我们可以看到 Go 吸引了大量用户。当然,在接下来的几个月中,人气和资源将会增加。即使我开始使用 JavaScript,我还是选择 Go 作为 2021 年将要使用的最火编程语言。

文章来源:Go语言中文网

以上就是W3Cschool编程狮关于2021年最火的编程语言将会是哪个?的相关介绍了,希望对大家有所帮助。

完美解决JavaScript的深浅拷贝

thbcm阅读(307)

前言

“拷贝”一直都是面试的热门考题。看似简单,实则难住不少面试者,回答的马马虎虎,模棱两可。抽出时间好好分析总结一下”拷贝”,让这个难题彻底消失。

正文

从一则故事讲起,昨天因为医院开不出药,我拿上药取小区药店去买药,进门之后我问老板有没有这个药,老板转身进去一个小屋子拿了一盒药,果不其然确实有,药的名字和毫克一摸一样,但是盒子的样子和厂商不一样,我问老板:“这两个药是一种药吗,盒子不一样啊,药的成分是一样的吗?”老板说当然一样啊,这个就和你去买猪肉一样,同样是猪身上的肉,只不过是你去这个超市和去其他超市买场地一样而已。最后为了安全起见,我还是没有买那个药。

“拷贝”分为浅拷贝和深拷贝。它是针对对象来说的,如果不是对象一切免谈。这里的对象可以理解为我拿的那盒药,浅拷贝可以理解为老板拿出来的那盒药,虽然药的名字和毫克一样,然后里面的我们不知道是否真的一样,可能一样可能不一样。深拷贝可以理解为我买到了一摸一样的药,一层一层的药名,毫克,厂商,成分都一样。

总结:

  • 浅拷贝就是针对对象的属性依次进行复制,只复制一层,不会递归到个属性复制,会产生引用问题即内存地址是指的同一地址。简单来说就是拷贝之后和原对象有关
  • 深拷贝就是针对对象的各属性递归复制到新的对象上,内存地址不会指向同一地址。简单来说就是拷贝之后和元对象无关

下面看一个浅拷贝的例子:

let school={'name':"W3Cschool"};
let my = {age:{count:18},name:"W3Cschool编程狮"};
let all = {...school,...my};
my.age.count=100;
console.log(all);
console.log(my);

结果:

{ age: { count: 100 }, name: 'W3Cschool编程狮' }

结论是:浅拷贝修改拷贝之后的对象上的属性会把原对象身上的属性同时修改掉。

下面再看一个深拷贝的例子:

const _ = require("loadsh")
let my = {age:{count:18},name:"W3Cschool编程狮"};
let all = _.cloneDeep(my);
all.age.count =100;
console.log(my);
console.log(all);

结果:

{ age: { count: 18 }, name: 'W3Cschool编程狮' }
{ age: { count: 100 }, name: 'W3Cschool编程狮' }

结论是:深拷贝修改拷贝之后的对象上的属性不会把原对象身上的属性同时修改掉。

拷贝的方法

1.数组方法:slice和concat

  • slice
let arr = [1,2,3,4];
let arr2 = arr.slice(0)
arr2[2]=5;


console.log(arr);  //[ 1, 2, 3, 4 ]
console.log(arr2); //[ 1, 2, 5, 4 ]

当数组里是不是对象的时候从结果上看是深拷贝,在看下面例子

let arr = [{1:1,2:2}];
let arr2 = arr.slice(0)
arr2[2]=5;


console.log(arr);  //[ { '1': 1 }, { '2': 5 } ]
console.log(arr2); //[ { '1': 1 }, { '2': 5 } ]

当数组里是对象的时候就变成了浅拷贝

  • concat
let arr = [1,2,3,4];
let arr2 = [].concat(arr);
arr2[2]=5;
console.log(arr); //[ 1, 2, 3, 4 ]  
console.log(arr2); //[ 1, 2, 5, 4 ]

当数组里不是对象的时候从结果上看是深拷贝,在看下面例子

let arr = [{1:1},{2:2}];
let arr2 = arr.cancat(0)
arr2[1][2]=5;


console.log(arr);  //[ { '1': 1 }, { '2': 5 } ]  变成了引用
console.log(arr2); //[ { '1': 1 }, { '2': 5 } ]

当数组里是对象的时候就变成了浅拷贝

总结:只有当数组是一维数组而且不包含对象的时候才是深拷贝

(推荐教程:JavaScript教程

2.Object.assgin()

let a= {a:1,b:2};
let b= Object.assign({},a);
a.a=3;
console.log(a)  //{a: 3, b: 2}
console.log(b)  //{a: 1, b: 2}  
let a= {a:1,b:{c:2}};
let b= Object.assign({},a);
a.b.c=3;
console.log(a)  //{a: 1, b: {c:3}}
console.log(b)  //{a: 1, b: {c:3}}   变成了引用

总结:Object.assgin如果涉及到嵌套多个对象的话就变成了引用 解决方法:使用JSON.stringify()先转化成字符串,再通过JSON.parse()转化成对象

  • 3.JSON.parse(JSON.stringify())
let a= {a:1,b:{c:2}};
let b= JSON.parse(JSON.stringify(a))
a.b.c=3;
console.log(a)  //{a: 1, b: {c:3}}
console.log(b)  //{a: 1, b: {c:2}}   
let school={'name':"W3Cschool编程狮",fn:function(){}};
let my = {age:{count:18},name:"W3Cschool编程狮"};
let all=JSON.parse(JSON.stringify({...school,...my}))
console.log(all);  //{'name':"W3Cschool编程狮",age:{count:18}}; //把fn给丢了

总结: JSON.parse(JSON.stringify()) 这个方法有一定的局限性,会丢失 fn 。

  • 4.手写深拷贝
let deepClone=(obj)=>{
    if(obj==undefined) return obj;  //undefined == null
    if(obj instanceof RegExp) return new RegExp(obj);
    if(obj instanceof Date) return new Date(obj);
    if(typeof obj!=="object") return obj;
    let newObj = new obj.constructor;
    for(let key in obj){
        if(obj.hasOwnProperty(key)){
            newObj[key] = deepClone(obj[key])
        }
    }
    return newObj;
}
let obj1 = {name:{age:"10"}}
let n = deepClone(obj1)
obj1.name.age = "231"
console.log(n);  //{name:{age:"10"}}  
let obj = { name:"W3Cschool编程狮" }
obj.aaa=obj
let n = deepClone(obj1)
console.log(n);  //死循环了  

解决这个问题可以使用WeakMap

let deepClone=(obj,hash=new WeakMap())=>{
    if(obj==undefined) return obj;  //undefined == null
    if(obj instanceof RegExp) return new RegExp(obj);
    if(obj instanceof Date) return new Date(obj);
    if(typeof obj!=="object") return obj;
    if(hash.has(obj)) return hash.get(obj);
    let newObj = new obj.constructor;
    hash.set(obj,newObj);


    for(let key in obj){
        if(obj.hasOwnProperty(key)){
            newObj[key] = deepClone(obj[key],hash)
        }
    }
    return newObj;
}

  • 5.lodash的cloneDeep

<br> 源码地址:https://github.com/lodash/lodash/blob/86a852fe763935bb64c12589df5391fd7d3bb14d/.internal/baseClone.js
<br> ```
  • 6.vue-router源码中的克隆方法
function clone (value) {
  if (Array.isArray(value)) {
    return value.map(clone)
  } else if (value && typeof value === 'object') {
    const res = {}
    for (const key in value) {
      res[key] = clone(value[key])
    }
    return res
  } else {
    return value
  }
}
let arr = [{1:1},{2:2},function(){}];
let arr2 = clone(arr)
arr2[1][2]=5;
console.log(arr)  //[ { '1': 1 }, { '2': 2 }, [Function (anonymous)] ]    深拷贝
console.log(arr2); //[ { '1': 1 }, { '2': 5 }, [Function (anonymous)] ]
function extend (a, b) {
  for (const key in b) {
    a[key] = b[key]
  }
  return a
}
let b={a:1,b:{c:2}};
let a= extend({},b);
a.b.c=5;
console.log(a);  //{ a: 1, b: { c: 5 } }
console.log(b);  //{ a: 1, b: { c: 5 } }   浅拷贝

(推荐微课:JavaScript微课

文章来源:公众号–小丑的小屋 作者:小丑

以上就是W3Cschool编程狮关于 完美解决JavaScript的深浅拷贝 的相关介绍了,希望对大家有所帮助。

Vue新特性:在CSS 中可以使用 JS 变量

thbcm阅读(264)

前言

小编之前在看《Vue 3:2020年中状态更新》的时候,记得文中尤雨溪希望在7月中旬发布RC版(候选版本),然后8月初发布3.0正式版。

不过现在已经八月初了怎么还是没发布呢?这个月初到底几号才算是”初”呢?于是我赶紧去github上看看现在到底有没有什么风吹草动,看着看着突然发现一个非常好玩的特性,这个特性我以前就经常这么想:要是我在data里面定义的变量也能在 CSS 里面用那该多好啊!(大家有没有也这么想过)

幻想

以前做项目的时候经常会这么想:

<template>
  <h1>{{ color }}</h1>
</template>


<script>
export default {
  data () {
    return {
        color: 'red'
    }
  }
}
</script>


<style>
h1 {
  color: this.color;
}
</style>

当然,想想也知道不可能,JSCSS隶属不同上下文,CSS哪来的this呢?

那么怎么才能在CSS中使用JS变量呢?那就只能用JS操作DOM然后把变量塞进style里了,比如用ref获取到DOM元素,然后dom.style.color = this.color

或者在模板里:

<template>
  <h1 :style="{ color }">Vue</h1>
</template>


<script>
export default {
  data () {
    return {
        color: 'red'
    }
  }
}
</script>

不过这种方式还是有缺陷的,比如本来就不推荐把样式写在style属性里,还有就是变量复用会很麻烦,比如一组DOM元素都想用这个变量,那就不得不给这一组起个类名,然后再在mounted里面document.getElementsByClassName(),获取到DOM集合之后还要循环遍历每个元素,为其加上dom.style.color = this.color,浪费了很多的性能。

其实CSS本身有很多缺陷,并不图灵完备,所以才导致了各种预处理器的出现:SassLessStylus等……

它们为CSS提供了很多特性:循环、条件语句、变量、函数等……

其中有个特性非常有用,那就是变量!于是CSS也引入了变量的这个概念,自从有了CSS变量,很多事情真的方便了许多,通过JS操作CSS变量,然后再在需要的地方使用CSS变量,这种方法比之前的高效得多。

什么是CSS变量

JS里(不止JS,所有语言都差不多),变量有如下几个特性:

  • 声明
  • 使用
  • 作用域

声明

为了方便理解,咱们通过用JS的方式来类比:

var color = ‘red’;

在CSS中等同于:

–color: red;

当然这点跟JS不太一样,但是如果你学PHP这类语言或者Sass的话应该就很好理解了,在PHPSass中,声明变量的时候没有一个关键字,而是在变量名的第一位加上一个美元符号$,这就代表声明变量了。

PHP:

$color = 'red';

Sass:

$color: color;

但是$符号被Sass占用了,@符号被less占了,所以CSS只能想出别的符号了,CSS的符号就是两个减号--

使用

光声明一个变量是没有什么太大意义的,只有使用了它,这个变量才算有价值:

JS:

console.log(color)

可以看到var只是个声明变量的关键字,color才是变量名。

PHP:

echo $color;

Scss:

h1 {
    color: $color;
}

但是在PHPSass中,声明变量的时候带着,用的时候也得带着。

这就令许多开发者感到困惑,所以CSS在使用变量的时候用到了一个函数叫var()

CSS:

h1 {
    color: var(--color);
}

虽然和PHPSass一样,调用时要带着前缀(因为那就是变量名的一部分),但是不一样的是需要用一个var()来把变量包裹起来。

作用域

这个很好理解,不仅JS里有作用域,CSS里也有作用域,比如:

JS:

var color = 'red';


function h1 () {
    console.log(color);
}


function div () {
    var color = 'blue';
    console.log(color);
}


h1(); // red
div(); // blue

类似于CSS里的:

body {
    --color: red;
}


h1 {
    color: var(--color); /** 这里获取到的是全局声明的变量,值为red **/
}


div {
    --color: blue;
    color: var(--color); /** 这里获取到的是局部声明的变量,值为blue **/
}

也就是说,变量的作用域就是它所在的选择器的有效范围。

中文CSS变量

有一次我看到了两个脑洞大开的库,才发现CSS变量还可以这么玩:

  • chinese-gradient
  • chinese-layout

从他俩的名字就可以看出,都是用chinese开头的,那么大概率就是用中文做的CSS变量,点进去一看果不其然。

也就是说CSS变量的包容性很强,不像以往编程的时候都必须是英文命名,中文这次居然也可以完美运行,不信咱们来试一下:

<!DOCTYPE html>
<html lang="en">
<head>
  <meta charset="UTF-8">
  <meta name="viewport" content="width=device-width, initial-scale=1.0">
  <title>Document</title>
  <!-- 在这里用link标签引入中文布局 -->
  <link rel="stylesheet" href="https://cdn.jsdelivr.net/npm/chinese-layout">


  <!-- 在这里用link标签引入中文渐变色 -->
  <link rel="stylesheet" href="https://cdn.jsdelivr.net/npm/chinese-gradient">
  <style>
    /* 清除默认样式 */
    * { padding: 0; margin: 0 }
    ul { list-style: none }


    /* 全屏显示 */
    html, body, ul { height: 100% }


    /* 在父元素上写入九宫格 */
    ul {
      display: grid;
      grid: var(--九宫格);
      gap: 5px
    }


    /* 给子元素上色 */
    li {
      background: var(--极光绿)
    }
  </style>
</head>
<body>
  <ul>
    <li></li>
    <li></li>
    <li></li>
    <li></li>
    <li></li>
    <li></li>
    <li></li>
    <li></li>
    <li></li>
  </ul>
</body>
</html>

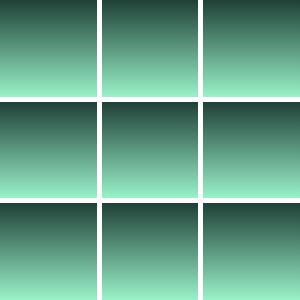
运行结果:

也就是说,CSS变量可以这样定义:

body {
    --蓝绿色: aquamarine;
}

然后调用的时候:

h1 {
    color: var(--蓝绿色);
}

在vue中的变量

那么怎样才能在 vue3<style> 中使用**<script>**里声明的变量呢?

首先我们先创建个支持vue3vite项目:

npm init vite-app vars

然后进入到该文件夹安装依赖:

cd vars

npm i

然后创建一个组件,组件型式长这样:

<template>
  <h1>{{ color }}</h1>
</template>


<script>
export default {
  data () {
    return {
      color: 'red'
    }
  }
}
</script>


<style vars="{ color }">
h1 {
  color: var(--color);
}
</style>

还记得文章一开始写的幻想中的组件是什么样吗:

<style>
h1 {
  color: this.color;
}
</style>

但是就算vue再牛它也不可能给CSS安个this啊,除非再做一个什么预处理器,不过这次利用CSS变量已经可以很接近咱们幻想中的组件啦:

<style vars="{ color }">
h1 {
  color: var(--color);
}
</style>

首先要在<style>标签中写个vars=”{}”,再在大括号里写上你在data中声明过的值。

再来试一下这个变量是不是响应式的,动态改变<script>标签中的this.color值会不会引起视图的变化呢?来试一下:

<template>
  <h1>Vue</h1>
</template>


<script>
export default {
  data () {
    return {
      opacity: 0
    }
  },
  mounted () {
    setInterval(_ => {
      this.opacity >= 1 && (this.opacity = 0)
      this.opacity += 0.2
    }, 300)
  }
}
</script>


<style vars="{ opacity }">
h1 {
  color: rgb(65, 184, 131);
  opacity: var(--opacity);
}
</style>

运行结果:

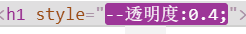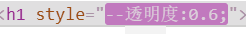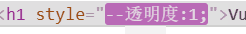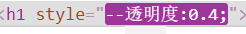
可以看到每 300 毫秒我们就改变一下this.opacity的值,它会映射到CSS变量上去,this.opacity变了,--opacity的值就会随之变化,视图也会随着数据的更新而相应的更新,这个特性简直太棒了!

多个变量之间使用逗号进行分隔:

<template>
  <h1>Vue</h1>
</template>


<script>
export default {
  data () {
    return {
      border: '1px solid black',
      color: 'red'
    }
  }
}
</script>


<style vars="{ border, color }" scoped>
h1 {
  color: var(--color);
  border: var(--border);
}
</style>

脑洞大开

既然chinese-gradientchinese-layout这两个CSS库验证了CSS中文变量的可行性,而且我记得对象的属性也是可以写中文的,那么咱们就来试一下在vue中能不能用这种黑魔法来写中文:

<template>
  <h1>Vue</h1>
</template>


<script>
export default {
  data () {
    return {
      '透明度': 0
    }
  },
  mounted () {
    setInterval(_ => {
      this['透明度'] >= 1 && (this['透明度'] = 0)
      this['透明度'] += 0.2
    }, 300)
  }
}
</script>


<style vars="{ 透明度 }">
h1 {
  color: rgb(65, 184, 131);
  opacity: var(--透明度);
}
</style>

运行结果:

居!然!管!用!了!

以后大家不会命名的话也别用汉语拼音了,直接写中文吧哈哈!后续维护的时候一看变量名就能一目了然(不过还是推荐用英文)。

原理

猜也能猜到,大概率是用到了类似于dom.style.setProperty(‘–opacity’, this.opacity)之类的方法,按下 f12 打开控制台一看,果不其然,它控制的是组件元素的style属性:

不过我们刚才在<style>标签中只用到了varscoped其实也很常用,那么如果他们两个碰到一起去会编译成什么样呢?

<style vars="{ 透明度 }" scoped>
h1 {
  color: var(--透明度);
}
</style>

运行结果:

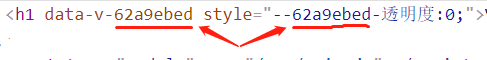
可以看到Vue把CSS变量也编译了一个和data-v-后面的那串随机字符一样的:

那么问题来了,假如我要是在全局样式里定义了一个–color属性,我在带有scoped属性的组件里想用这个全局的CSS变量,可是一旦在scoped中使用CSS变量就会被编译成:–62a9ebed-color,可是全局定义的不是–62a9ebed-color而是–color,这样就会出现找不到全局属性的局面,这个问题要怎么解决呢?其实也很简单,只需要在的后面加上一个global:就可以了:

<style vars="{ color }" scoped>
h1 {
  color: var(--global:color);
}
</style>

这样编译出来的CSS就会变成:var(–color)啦!

结语

怎么样是不是很好玩?Vue这次更新诚意满满,不过大家都把关注点放在了Composition-API上了,没有注意到这些不起眼的边边角角,但就是这些边边角角却可以极大的提高我们的开发体验。

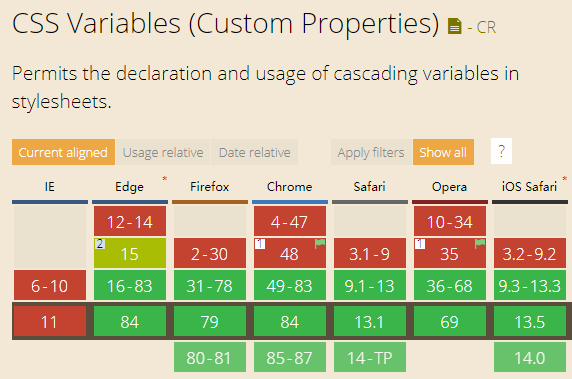
对了,CSS变量也是有兼容性的:

从 caniuse (www.caniuse.com/#search=CSS Variables)网站上可以看到,它是不兼容IE的,使用的时候记得确认一下自己项目需要兼容的范围。

原文链接:segmentfault.com/a/1190000023479851

作者:手撕红黑树

以上就是W3Cschool编程狮关于Vue新特性:在CSS 中可以使用 JS 变量的相关介绍了,希望对大家有所帮助。

【重磅更新】飞冰(ICE)现已支持无线开发

thbcm阅读(261)

前言

从我们正式发布飞冰(ICE)项目截止到目前,在过去的这段时间里,仅仅淘宝内部已经有约 2000+ 项目使用它进行开发;除了内部之外同时也持续得到了业内广大的关注,并被社区众多个人与公司在其中后台项目中采用,飞冰致力于提供简单而友好的前端研发体系。

然而在实际中除了中后台业务场景外,也被部分用户经常问到能否使用飞冰开发无线应用,何时能支持无线开发等问题,这意味着之前的产品定位和架构设计已不能满足业务场景的需要。

经过持续的高速迭代,ice.js 终于迎来了重大的升级(完全向下兼容),正式支持无线 Web App 和小程序的开发,目前支持的小程序平台包括阿里小程序和微信小程序。这意味着如果你想开发多端投放的小程序、Web App、中后台管理系统,那么你只需使用 ice.js 就够了,这在一定程度上能极大的提升开发效率。更重要的是,无需学习各个平台的小程序语法,只要你会使用 React 即可开发。

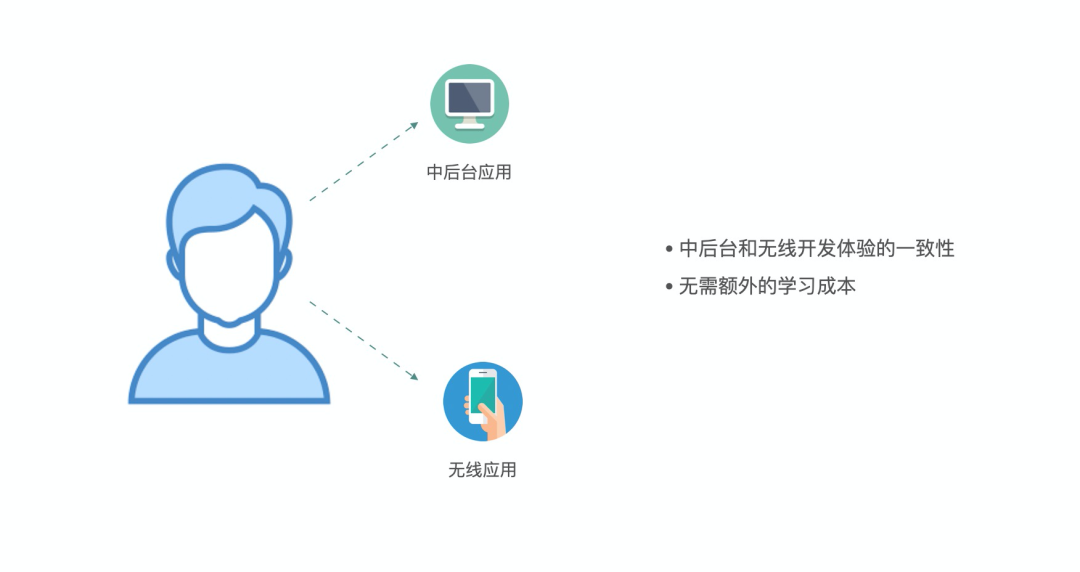
多端一致的开发体验

毫无疑问,小程序原生语法的开发体验是为人所诟病的,从微信开始到后来的众多追随者如支付宝、百度、头条等,都选择了与微信类似的架构设计,但也存在着一定的差异性,导致开发人员需要适配的小程序平台越来越多,而每个端开发一套代码又不现实,进一步导致研发成本上升,代码维护困难。

社区基于小程序的上层开发框架也层出不穷,这类框架主要的区别和重心在于 DSL多端适配。核心解决的是能复用现有 Web 的生态,以及能提供不同平台一致性的开发体验。如能使用类 React 或者类 Vue 去开发小程序,能复用 NPM 上数以万计的工具包等。

这是很重要但也很基础的能力,但在飞冰体系中却有所不同,除了支持阿里、支付宝等不同端开发的一致性之外,我们致力于为 ICE 开发者提供更简单更平滑的开发小程序的解决方案, 这意味着如果你使用 ice.js 开发过中后台应用,那么几乎可以无任何成本的上手小程序开发。同时将中后台领域沉淀出的标准化的 React 应用开发模式和最佳实践,完全应用到了小程序开发上,包括但不限于状态管理、数据请求、生命周期、样式、Hooks 等能力,

提供从中后台到小程序开发的体验一致性是至关重要的,这其中包括:

  • 开发心智:提供完整的 React 支持,无需额外的学习成本;
  • 开发体验:提供基于 VS Code 的辅助插件,默认支持 TypeScript;
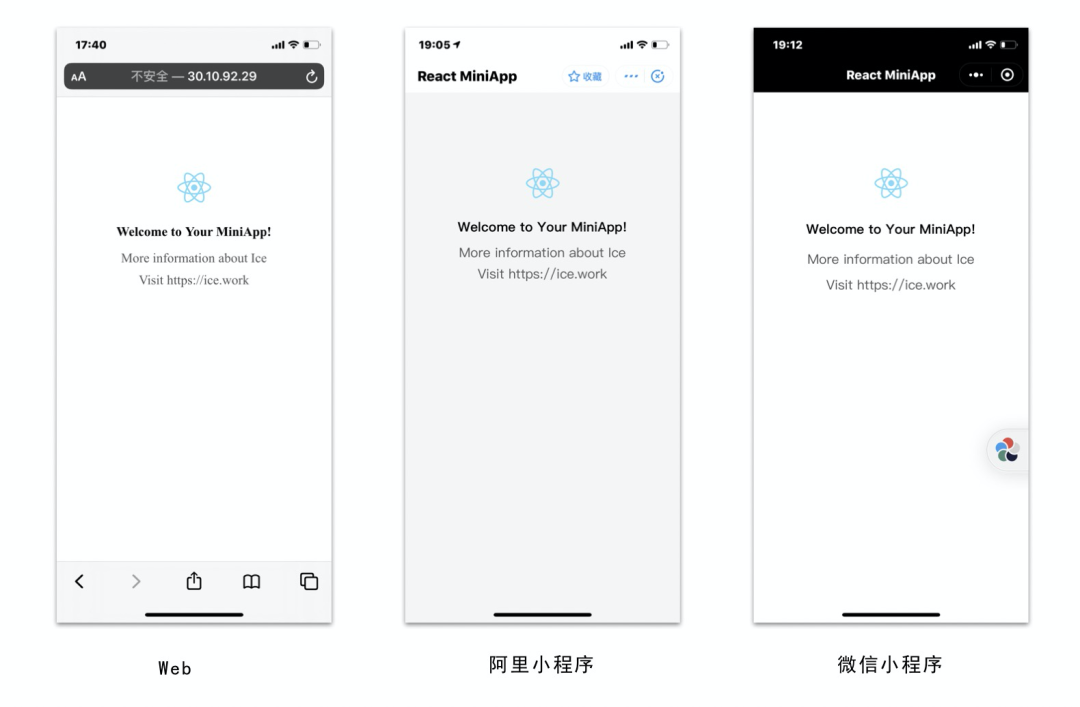
  • 多端适配:一次编码多端投放,已支持阿里小程序,支付宝小程序,Web;
  • 社区生态:与现有社区生态完全兼容。

不受限制地使用 React 所有特性

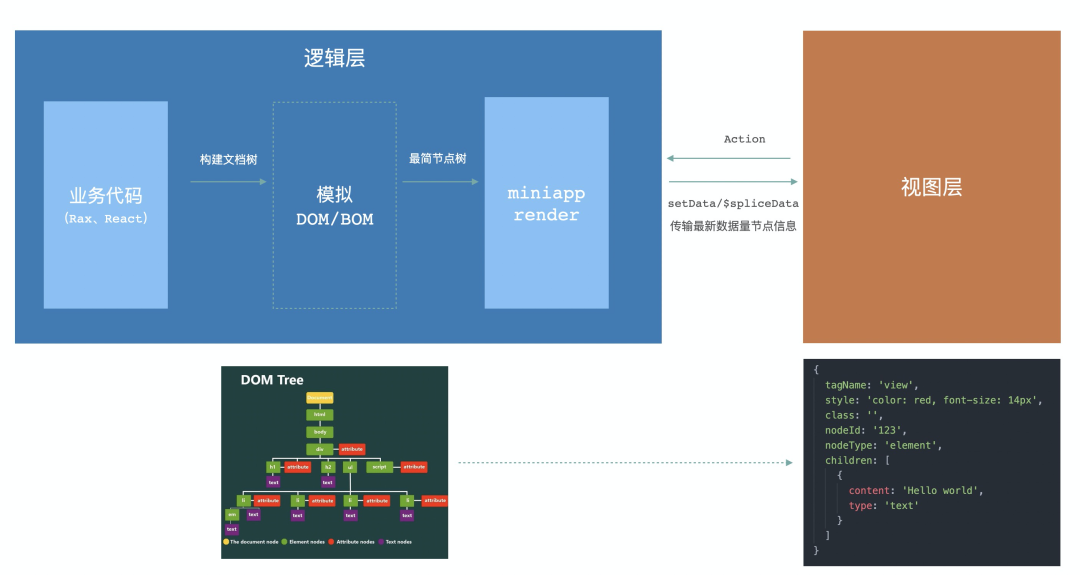
ice.js 的小程序机制基于 Rax 小程序的运行时方案,采用模拟 DOM/BOM API 的方式适配,因此可做到 DSL 无关。目前这套方案已经在阿里内部落地 100+ 小程序项目,经过了大量线上项目的验证,值得信赖。让你可以不受限制地使用 React 所有特性。

  • 几乎没有任何语法约束
  • 支持使用 Hooks
  • 支持操作 DOM (不推荐)
  • 丰富的 React 社区生态

逻辑层做的事情其实比较复杂。首先要做的是,去处理节点间的关系,去模拟appendChild/ removeChild/updateNode 等各个行为来操作 VDOM 树。其次是去模拟事件,在逻辑层每一个节点类会继承自 EventTarget 基类,这个和 W3C 是一样的,然后通过 nodeId 作为标识去收集需要监听的事件,当视图层通过 action 触发了某个节点的事件之后,再通过原生小程序事件中的 event.currentTarget.dataset.nodeId获取到目标节点的 id,最终触发目标回调。

完备的应用开发实践

ice.js 小程序在设计上继承了Web应用开发的最佳实践,如果你使用过ice.js 开发过应用,那么使用它开发小程序几乎是零成本的,遵循同一套开发规范和最佳实践。

应用入口 ** 通过默认生成的代码运行应用而无需任何配置,只需要调用 runApp 即可启动小程序。

import { runApp } from 'ice';


runApp();

生命周期

生命周期指的是应用自身的一些函数,这些函数在特殊的时间点或一些特殊的框架事件时被自动触发。框架提供了完整的应用生命周期能力。

import { runApp } from 'ice';


const appConfig = {
  app: {
    // 应用启动的时候触发
    onLaunch() {},


    // 应用唤起时触发
    // 应用从后台切到前台的时候触发
    onShow() {},


    // 应用从前台切到后台的时候触发
    onHide() {},


    // 监听全局错误
    onError(error) {}
  }
};


runApp(appConfig);

全局配置

用于对应用进行全局的静态配置,如设置路由、窗口表现等。

  • routes 用于指定应用的页面,每一项代表对应页面的路径及文件信息。
{
  "routes": [
    {
      "path": "/",
      "source": "pages/Home/index"
    }
  ]
}

  • window 用于配置应用的窗口表现,同时也支持针对每个页面设置窗口表现。目前已经支持的参数的有:
{
  "window": {
    "titleBarColor": "",
    "pullRefresh": true,
    "title": "Home"
  }
}

样式方案

默认推荐使用 CSS Modules 方案,这能很好的解决样式开发中的全局污染和命名混乱的两个痛点问题。但同时也支持 SassLess 等编写样式。

数据请求

大多数情况下都需要通过 HTTP 协议与后端服务器通讯,开发小程序时我们提供了 universal-request 用于网络请求,该模块已支持多端发送请求。

Hooks 方案

开发小程序时除了使用基础的 Hooks 之外,我们还提供了一套完备的自定义 Hooks 的工具库 ahooks,覆盖绝大部分的 Hooks 场景,助力您的应用开发。

更多其他细节如状态管理,工程配置,事件等能力详见官网文档。

三分钟上手

初始化项目

基于 npm init ice 命令选择初始化模板进行下载:

$ npm init ice <projectName>


# 或者使用 yarn
$ yarn create ice <projectName>

选择模板

可选择小程序 TypeScript 或者 JavaScript 模板:

? Please select a template (Use arrow keys)
 Lightweight JavaScript template with Mini Program
  Lightweight TypeScript template with Mini Program

启动项目

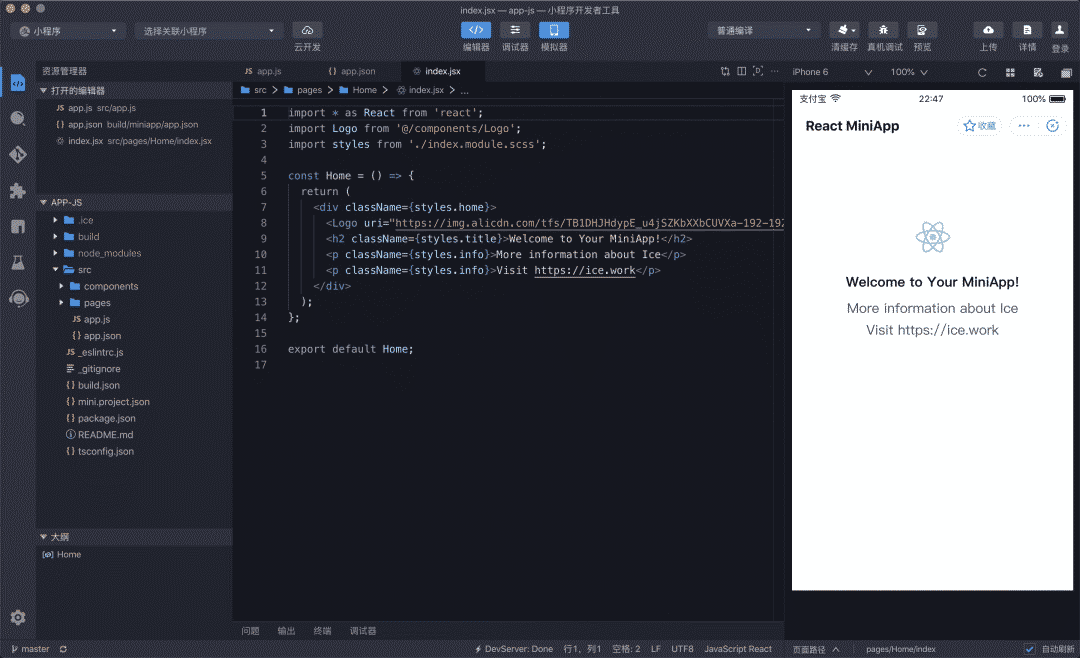
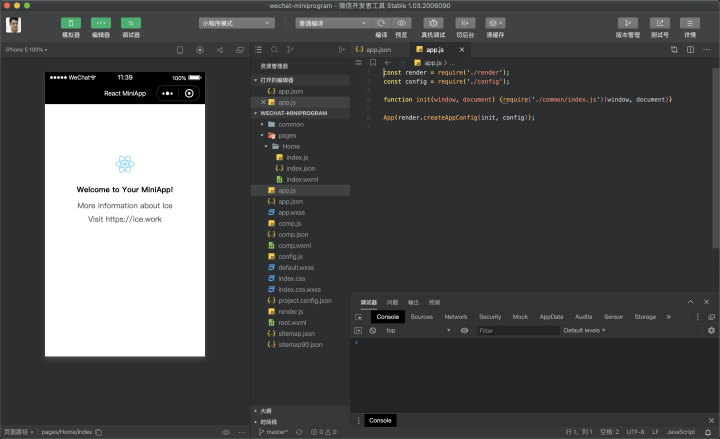
使用小程序开发者工具打开项目,执行以下命令即可看到如下界面:

$ cd <projectName>
$ npm install
$ npm start

  • 支付宝小程序效果图:

  • 微信小程序效果图:

最后

随着业务场景的不断复杂和需要,飞冰(ICE)从专注中后台领域升级为面向多终端的研发框架,但初心未变我们始终致力于提供简单而友好的前端研发体系,提升开发效率和幸福感。

文章来源:公众号–前端人

以上就是W3Cschool编程狮关于 【重磅更新】飞冰(ICE)现已支持无线开发 的相关介绍了,希望对大家有所帮助。

当你使用print时,Python是怎么运行的

thbcm阅读(259)

学编程这么久了,大家不知道有没有想过一个问题,当我们执行Python时,它是怎么实现的呢?

众所周知,Python 是一门解释型的语言

——所谓“解释型”,当然是区别于以 C语言 为代表的编译型语言。编译型语言需要将整个程序文件全部转换为可以直接由机器执行的二进制文件;而解释型语言则是由相应的解释器一行一行“解释”并执行代码描述的行为。

正是因此,对于新接触的人来说,Python这样的解释性语言很多时候需要执行到相应的语句,才会发现一些显然的错误。

话说回来,Python的解释器是怎么样来“解释”Python代码的呢?

实际上,类似于Java的执行机制,Python也拥有自己的虚拟机。而这个虚拟机实际上执行的也是一种“字节码”。

Python程序的执行中依然存在一个“编译”的过程:将Python代码编译为字节码。

并且,Python也提供了一个名为dis模块,用于查看、分析Python的字节码。

1. dis模块

举例来说,dis模块中有一个同名函数dis,可以用于将当前命名空间中的对象反汇编为字节码。

import dis


def add(add_1, add_2):
    sum_value = add_1 + add_2


dis.dis(add)

执行结果为:

  4           0 LOAD_FAST                0 (add_1)
              2 LOAD_FAST                1 (add_2)
              4 BINARY_ADD
              6 STORE_FAST               2 (sum_value)
              8 LOAD_CONST               0 (None)
             10 RETURN_VALUE

其中,开头的数字“4”表示字节码的内容对应于脚本中第 4 行的内容。

随后的一列数字则表示对应指令所在的地址。纵向观察可以发现一个规律:下一条指令的地址总比上一条指令的地址大 2 。这是巧合吗?

显然不是的。官方文档《dis — Python 字节码反汇编器》中记录的更改显示,从Python 3.6版本开始,”每条指令使用2个字节“。所以每条指令的地址会在上一条指令地址的基础上加2。

再往后,是一列表示指令含义的单词组合,实际上就是人类可读的对应指令名称。顾名思义,LOAD_FAST就是加载某个内容/对象到某处,”FAST“很可能意味着这是一个便捷快速的命令实现。

最右边,则是对应于当前命令的操作数,即操作对象。数字同样是一个类似于地址的表示,括号中的字符串则表示相应对象在Python代码中的具体名称。

这样我们就可以大概地阅读生成的字节码了:

首先Python将函数add的第一个参数add_1加载到某处,紧跟着将第二个参数add_2加载到第一个参数之后。然后调用了一个名为BINARY_ADD的指令,即对之前加载的两个参数做加法。再然后则是将加法所得的和sum_value存储在了另一个位置。最后,加载了一个常量None并返回。

其实读完上面这个执行过程,我们很容易想到一种常用的数据结构——栈。

像下面这样:

当然这并不是本文的重点——真要探讨Python的实现机制,还得另外写几篇长文才能说得一二。

使用dis.dis函数除了可以查看当前脚本中各个对象对应的字节码,还可以直接传入一段代码对应的字符串进行反汇编:

# test_dis.py
import dis


s = """
def add(add_1, add_2):
    sum_value = add_1 + add_2


print("Hello World!")


import sys
"""


dis.dis(s)

汇编结果:

  2           0 LOAD_CONST               0 (<code object add at 0x0000019FF66DFDB0, file "<dis>", line 2>)
              2 LOAD_CONST               1 ('add')
              4 MAKE_FUNCTION            0
              6 STORE_NAME               0 (add)


  5           8 LOAD_NAME                1 (print)
             10 LOAD_CONST               2 ('Hello World!')
             12 CALL_FUNCTION            1
             14 POP_TOP


  7          16 LOAD_CONST               3 (0)
             18 LOAD_CONST               4 (None)
             20 IMPORT_NAME              2 (sys)
             22 STORE_NAME               2 (sys)
             24 LOAD_CONST               4 (None)
             26 RETURN_VALUE

2. compile函数

除了在程序中直接给出要反汇编的程序形成的字符串,我们还可以通过使用内置函数compile来形成相应脚本的编译对象,再使用dis.dis查看其字节码内容。

# test_compile.py
import dis


with open("test_dis.py", "r", encoding="utf-8") as f:
    s = f.read()


compile_obj = compile(s, "test_dis.py","exec")


dis.dis(compile_obj)

字节码输出结果:

  1           0 LOAD_CONST               0 (0)
              2 LOAD_CONST               1 (None)
              4 IMPORT_NAME              0 (dis)
              6 STORE_NAME               0 (dis)


 11           8 LOAD_CONST               2 ('\ndef add(add_1, add_2):\n    sum_value = add_1 + add_2\n\nprint("Hello World!")\n\nimport sys\n')
             10 STORE_NAME               1 (s)


 13          12 LOAD_NAME                0 (dis)
             14 LOAD_METHOD              0 (dis)
             16 LOAD_NAME                1 (s)
             18 CALL_METHOD              1
             20 POP_TOP
             22 LOAD_CONST               1 (None)
             24 RETURN_VALUE

总结

dis模块为我们提供了一个观察Python内部机制的手段,恰当地使用dis模块,并结合其他方法,可以快速有效弄懂一些Python令人迷惑的地方。

(推荐微课:python3基础微课

希望大家善于利用这样一些有用的工具。

文章来源:公众号–Python技术 作者:轩辕御龙

以上就是W3Cschool编程狮关于 当你使用print时,Python是怎么运行的 的相关介绍了,希望对大家有所帮助。

网页链接用了target=”_blank”,结果出乎意料

thbcm阅读(289)

本文给大家分享一个关于 Web 的知识点。假如你做过一段时间Web开发,那你可能已经知道了。但是对于新手还是可以了解一下的。

我们知道,网页里的a标签默认在当前窗口跳转链接地址,如果需要在新窗口打开,需要给 a 标签添加一个target="_blank"属性。

<a href="https://www.w3cschool.cn/" target="_blank">W3Cschool编程狮</a>

顺便提下一个有意思的现象,很早之前我就发现,国外网站倾向于在当前页跳转,而国内网站喜欢打开新窗口。不信你们可以去验证下。我不知道这是交互设计上的文化差异,还是技术上的开发习惯。

当然,这两种方式各有优缺点。当前页跳转显得操作比较有连贯性,不会贸然打断用户的注意力,也会减少浏览器的窗口(tab 页)数量。但是对于需要反复回到初始页面的场景来说,就很麻烦了。比如搜索结果页面,通常需要查看对比几个目标地址,保留在多个窗口还是比较方便。

今天要说的不只是用户体验上的差别,而是涉及安全性能

安全隐患

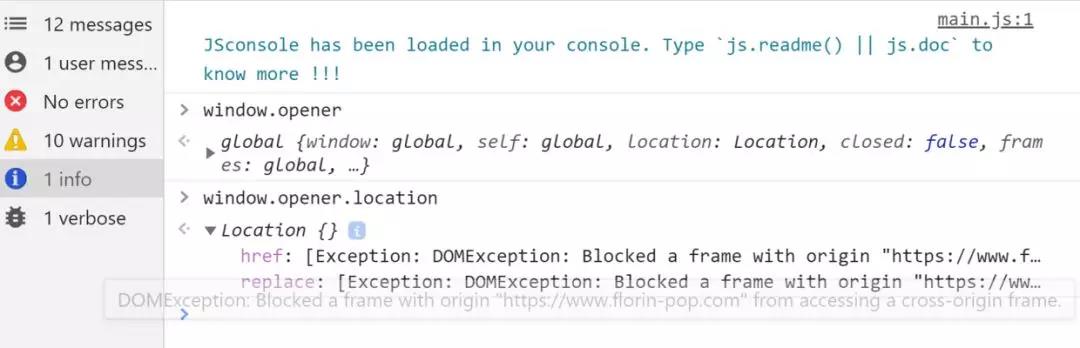
如果只是加上target="_blank",打开新窗口后,新页面能通过window.opener获取到来源页面的window对象,即使跨域也一样。虽然跨域的页面对于这个对象的属性访问有所限制,但还是有漏网之鱼。

这是某网页打开新窗口的页面控制台输出结果。可以看到window.opener的一些属性,某些属性的访问被拦截,是因为跨域安全策略的限制。

即便如此,还是给一些操作留下可乘之机。比如修改window.opener.location的值,指向另外一个地址。你想想看,刚刚还是在某个网站浏览,随后打开了新窗口,结果这个新窗口神不知鬼不觉地把原来的网页地址改了。这个可以用来做什么?钓鱼啊!等你回到那个钓鱼页面,已经伪装成登录页,你可能就稀里糊涂把账号密码输进去了。

还有一种玩法,如果你处于登录状态,有些操作可能只是发送一个GET请求就完事了。通过修改地址,就执行了非你本意的操作,其实就是 CSRF 攻击。

性能问题

除了安全隐患外,还有可能造成性能问题。通过target="_blank"打开的新窗口,跟原来的页面窗口共用一个进程。如果这个新页面执行了一大堆性能不好的 JavaScript 代码,占用了大量系统资源,那你原来的页面也会受到池鱼之殃。

解决方案

尽量不使用target="_blank",如果一定要用,需要加上rel="noopener"或者rel="noreferrer"。这样新窗口的window.openner就是null了,而且会让新窗口运行在独立的进程里,不会拖累原来页面的进程。不过,有些浏览器对性能做了优化,即使不加这个属性,新窗口也会在独立进程打开。不过为了安全考虑,还是加上吧。

我找了个博客网站试了一下,点击里面的外链打开新页面,window.openner都null。查看页面元素发现,a标签都加上了 rel=”noreferrer”。博客是用 Hexo 生成的,看来这种设置已经成了基本常识了。

另外,对于通过window.open的方式打开的新页面,可以这样做:

var yourWindow = window.open();
yourWindow.opener = null;
yourWindow.location = "http://someurl.here";
yourWindow.target = "_blank";

希望这个小技巧对你有用。

以上就是W3Cschool编程狮关于 网页链接用了target=”_blank”,结果出乎意料 的相关介绍了,希望对大家有所帮助。

TypeScript 4.0 发布了,有什么新的关注点?

thbcm阅读(371)

整体看来,此版本在兼容性方面没有特别大的变化。因为 TypeScript 团队表示新版本继续使用与过去版本相似的版本控制模型,可将 4.0 视作 3.9 的延续升级版本。

而且他们也一直在追求不牺牲主要灵活性的情况下,提供一个最大限度减少 breaking changes 的升级路径。

如果你还不熟悉 TypeScript,这里简单介绍一下:它是一种在 JavaScript 之上通过添加静态类型语法来构建的语言。它的基本理念是,记下值的类型以及它们的使用位置后,可以使用 TypeScript 对代码进行类型检查,并在运行代码之前(甚至在保存文件之前)告诉你代码错误的相关信息。然后,你可以使用 TypeScript 编译器从代码中剥离类型,并为你提供可在任何地方运行的简洁易读的 JavaScript 代码。除了类型检查之外,TypeScript还使用静态类型来支持强大的编辑器工具,例如自动完成、代码导航、重构等。实际上,如果你在 Visual Studio CodeVisual Studio 这样的编辑器中使用过 JavaScript,那么你已经用上了类型和 TypeScript 带来的体验。

TypeScript 是当今许多人使用的 JavaScript 技术栈的核心部分。在 npm 上,TypeScript 在 7 月首次实现了超过 5000 万的月下载量!尽管我们知道它总有增长和改进的余地,但很明显,大多数使用 TypeScript 编码的开发人员确实很喜欢它。StackOverflow 的最新开发人员调查将 TypeScript 列为第二受欢迎的语言。在最新的 JS 现状调查中,使用 TypeScript 的开发人员中有大约 89% 表示会再次使用它。

4.0 版本的主要更新内容如下:

  • 可变参数元组类型
  • 标记的元组元素
  • 构造函数的类属性推断
  • 短路分配运算符
  • catch 子句中的unknown
  • 定制 JSX 工厂
  • --noEmitOnError参数build模式下的速度提升
  • --incremental with --noEmit
  • 编辑器改进
    • 转换为可选链接
    • 支持/** @deprecated */
    • 启动时的部分编辑模式
    • 更智能的自动导入
  • Breaking Changes

构造函数的类属性推断

noImplicitAny 被启用时,TypeScript 4.0 现在可以使用控制流分(control flow analysis)析来确定类中的属性类型。

class Square {
    // Previously: implicit any!
    // Now: inferred to `number`!
    area;
    sideLength;


    constructor(sideLength: number) {
        this.sideLength = sideLength;
        this.area = sideLength ** 2;
    }
}

如果并非将构造函数的所有路径都分配给实例成员,则该属性可能被视为undefined

class Square {
    sideLength;


    constructor(sideLength: number) {
        if (Math.random()) {
            this.sideLength = sideLength;
        }
    }


    get area() {
        return this.sideLength ** 2;
        //     ~~~~~~~~~~~~~~~
        // error! Object is possibly 'undefined'.
    }
}

在更清楚的情况下(例如具有某种initialize方法),如果位于strictPropertyInitialization中,可能会需要显式类型注释以及定值赋值断言(!)

class Square {
    // definite assignment assertion
    //        v
    sideLength!: number;
    //         ^^^^^^^^
    // type annotation


    constructor(sideLength: number) {
        this.initialize(sideLength)
    }


    initialize(sideLength: number) {
        this.sideLength = sideLength;
    }


    get area() {
        return this.sideLength ** 2;
    }
}

短路分配运算符

JavaScript 和其他很多语言都支持复合赋值运算符。复合赋值运算符将一个运算符应用到两个参数上,然后将结果赋值到左边。如下:

/ Addition
// a = a + b
a += b;


// Subtraction
// a = a - b
a -= b;


// Multiplication
// a = a * b
a *= b;


// Division
// a = a / b
a /= b;


// Exponentiation
// a = a ** b
a **= b;


// Left Bit Shift
// a = a << b
a <<= b;

JavaScript 中的许多运算符都有一个对应的赋值运算符,但有三个例外:逻辑和(&&)、逻辑或(||),以及空值合并(??)。

TypeScript 4.0 为上述三个运算符增加了对应的赋值运算符支持:

let values: string[];


// Before
(values ?? (values = [])).push("hello");


// After
(values ??= []).push("hello");
a ||= b;


// actually equivalent to


a || (a = b);

以上就是W3Cschool编程狮关于 TypeScript 4.0 发布,有什么新的关注点?的相关介绍了,希望对大家有所帮助。

你只知道with,那with该with who呢?

thbcm阅读(308)

在长时间的编程开发中,你肯定见过或者使用过下面这段代码:

with open("test.txt", "r", encoding="utf-8") as f:
    s = f.readlines()

有些人会知道这么写的原因,但是更多的人不知道原因。只是觉得别人都这么写,那我也跟着写。

同时,很多知道原因的人也只是知其然而不知其所以然:with 语句可以替我们自动关闭打开的文件对象。但是这是通过什么机制办到的呢?

1. with和异常处理

我们知道,如果不使用with语句的话,正常地读写一个文件应该经过这些过程:打开文件、操作文件、关闭文件。表达为 Python 代码如下:

f = open("test.txt", "r", encoding="utf-8")
s = f.readlines()
f.close()

在正常情况下,这样写看起来也没啥问题。

接下来我们就人为制造一点“意外”:把打开文件对象时指定的模式由“r”改为“w”。

f = open("test.txt", "w", encoding="utf-8")
s = f.readlines()
f.close()

此时,当程序执行到第2行读取文件内容时,就会抛出错误:

Traceback (most recent call last):
  File "test_with.py", line 2, in <module>
    s = f.readlines()
io.UnsupportedOperation: not readable

然后……一个可怕的情况就发生了。

Python 产生未处理的异常从而退出了,导致第2行之后的代码尚未执行,因此f.close()也就再也没有机会执行。一个孤魂野鬼般打开的文件对象就这样一个人漂泊在内存的汪洋大海中,没有人知道他是谁、他从哪儿来、他要去哪儿。

就这样,每当抛出一次异常,就会产生这么一个流浪对象。久而久之,内存的汪洋大海也就顺理成章被改造成了流浪者的乐土,其他人想来压根儿没门儿。

追根究底,我们发现导致这个问题的关键在于“打开-操作-关闭”文件这个流水操作中,存在抛出异常的可能。

所以我们想到了使用 Python 为我们提供的大杀器,来对付这些异常:try-catch

用异常处理改造一下前面的代码:

try:
    f = open("test.txt", "a", encoding="utf-8")
    s = f.readlines()
except:
    print("出现异常")
finally:
    f.close()

这样一来,通过附加的finally语句,无论文件操作是否抛出异常,都能够保证打开的文件被关闭。从而避免了不断占用资源导致资源泄露的问题。

实际上,with 语句正是为我们提供了一种try-catch-finally的封装。

编程时,看似只是随随便便的一个 with ,其实已经暗地里确保了类似于上面代码的异常处理机制。

2. 上下文管理器

with 要生效,需要作用于一个上下文管理器——

打住,到底什么是上下文管理器呢?

长话短说,就是实现了__enter____exit__方法的对象。

在进入一个运行时上下文前,会先加载这两个方法以备使用。进入这个运行时上下文时,调用__enter__方法;退出该上下文前,则会调用__exit__方法。

这里的“运行时上下文”,可以简单地理解为一个提供了某些特殊配置的代码作用域。

当我们使用with open("test.txt", "r", encoding="utf-8") as f这句代码时,Python首先对open("test.txt", "r", encoding="utf-8")求值,得到一个上下文管理器。

这里有一点特殊的是,Python中文件对象本身就是一个上下文管理器,因此我们可以使用open函数作为求值的表达式。

随后调用__enter__方法,返回的对象绑定到我们指定的标识符f上。文件对象的__enter__返回文件对象自身,因此这句代码就是将打开的“test.txt”文件对象绑定到了标识符f上。

紧跟着执行 with 语句块中的内容。

最后调用__exit__,退出 with 语句块。

根据上面的内容,我们也可以自行构造一个上下文管理器(注意,两个特征方法的参数要与协议一致):

class testContextManager:
    def __enter__(self):
        print("进入运行时上下文,调用__enter__方法")


    def __exit__(self, exc_type, exc_value, traceback):
        print("退出运行时上下文,调用__exit__方法")


with testContextManager() as o:
    pass

输出结果:

进入运行时上下文,调用__enter__方法
退出运行时上下文,调用__exit__方法

with 语句之所以能够替代繁琐的异常处理语句,正是由于上下文管理器遵循协议实现了__enter____exit__方法,而with语句又确保了发生异常时能够执行完__exit__方法,再退出相关运行时上下文。

在这个方法中,我们就可以完成一些必要的清理工作。

总结

本文我们讲解了 with 语句的内部逻辑,尝试实现了一个自定义的上下文管理器。相信大家对于 with 的作用方式有了更深刻的领会。

with 语句不仅仅可以用于读写文件,还可以用于锁的自动获取和释放、全局状态的保存和恢复等。更多的实用方式留待大家探索。

文章来源:公众号–Python技术 作者:派森酱

以上就是W3Cschool编程狮关于 你只知道with,那with该with who呢?的相关介绍了,希望对大家有所帮助。

推荐5个很好用的Vue.js库

thbcm阅读(358)

从事编程这么久了,或多或少都会用的一些库。今天给大家推荐5个好用的 Vue.js

1.Click Off to Close

有的时候,我们需要在用户点击元素之外的时候触发一个事件。最常见的用例是当你想通过点击关闭一个下拉框或对话框时。这是一个必不可少的包,几乎在我构建的每个应用中都会用到。

首选:vue-clickaway

我通常会将它安装在 main.js 中,以便在我的应用程序中使用。如果你只在一个或两个页面上使用它,你可能会想单独导入它。

如果你真的单独导入,请记住,指令需要在指令下暴露。

 directives: { onClickaway }

而不是组件:

 components: { onClickaway }

使其全局可用(在 main.js 中):

import { directive as onClickaway } from 'vue-clickaway'
Vue.directive('on-clickaway', onClickaway)

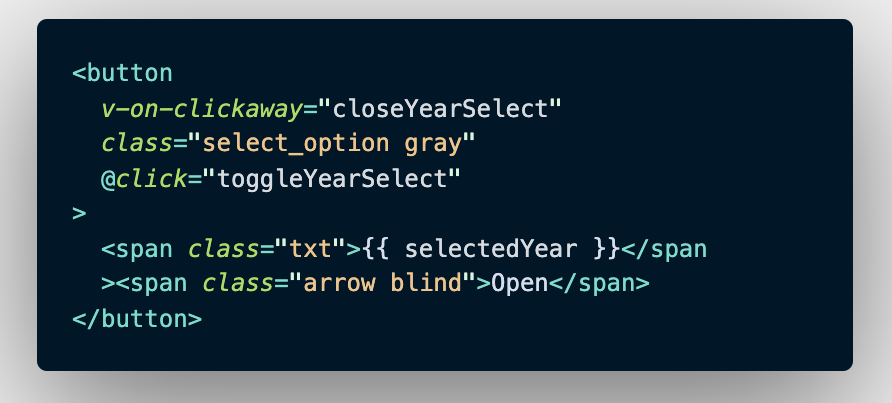
在模板中:

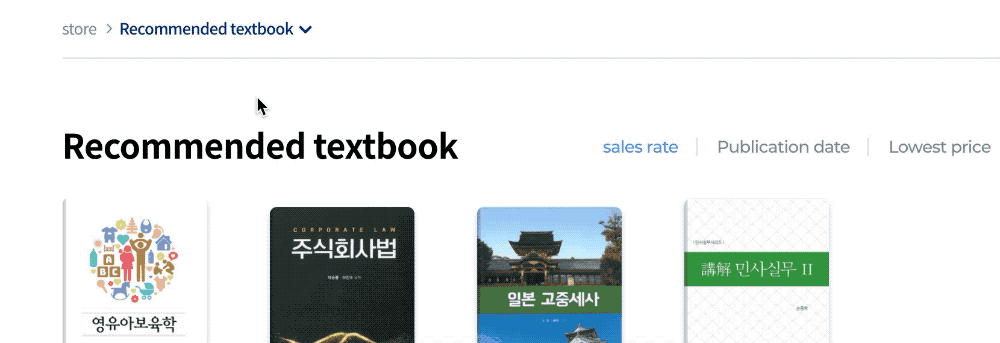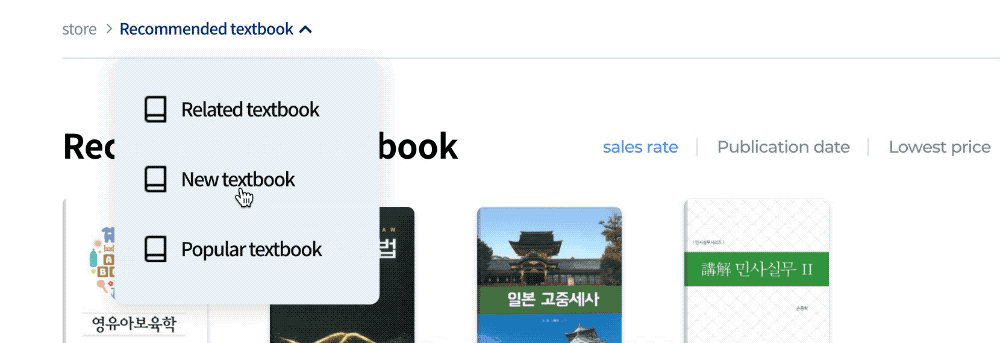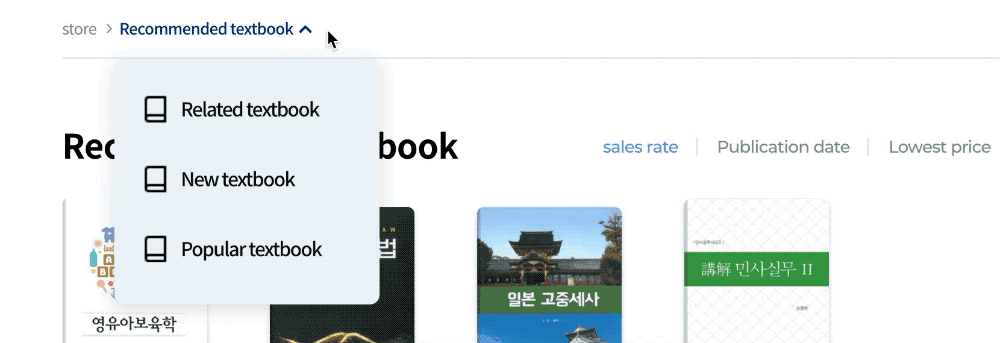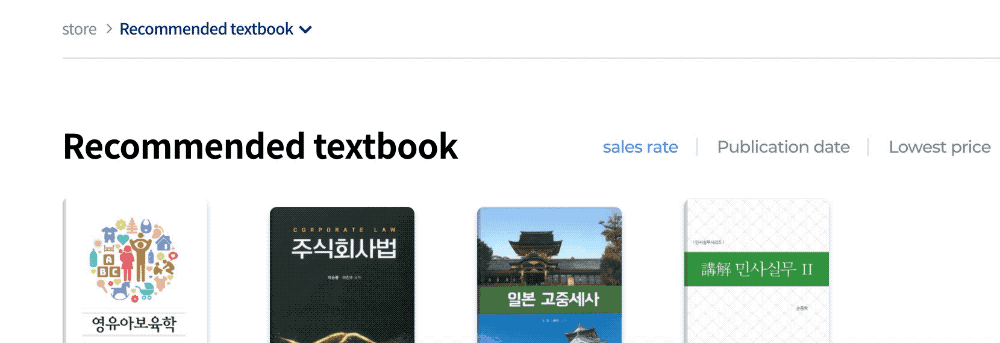
想象一下,我有一个完整的选择框,其中包含 li 元素列表(此处未显示)。上面的按钮用于触发我的自定义选择框项目列表,当我在该元素外点击时,会触发一个关闭选项列表的方法。这比强迫用户始终单击元素右上角处的“X”按钮要好得多。我们只需将以下内容添加到按钮即可获得此功能: v-on-clickaway = “closeMethodName”

注意:你应该总是在 close 方法中使用 vue-clickaway ,而不是 toggle 方法。我的意思是这个方法连接到 v-on-clickaway 应该是这样的:

closeMethod() {
  this.showSomething = false
}

而不是这样:

toggleMethod() {
  this.showSomething = !this.showSomething
}

如果你使用了 toggle 方法,那么每当你在该元素外点击时,无论你点击什么,它都会打开,然后一遍遍地关闭该元素。这很可能不是你想要的结果,所以请记住使用 close 方法来防止这种情况发生。

2.Toasts (Notification Bar)

首选:vue-toastification

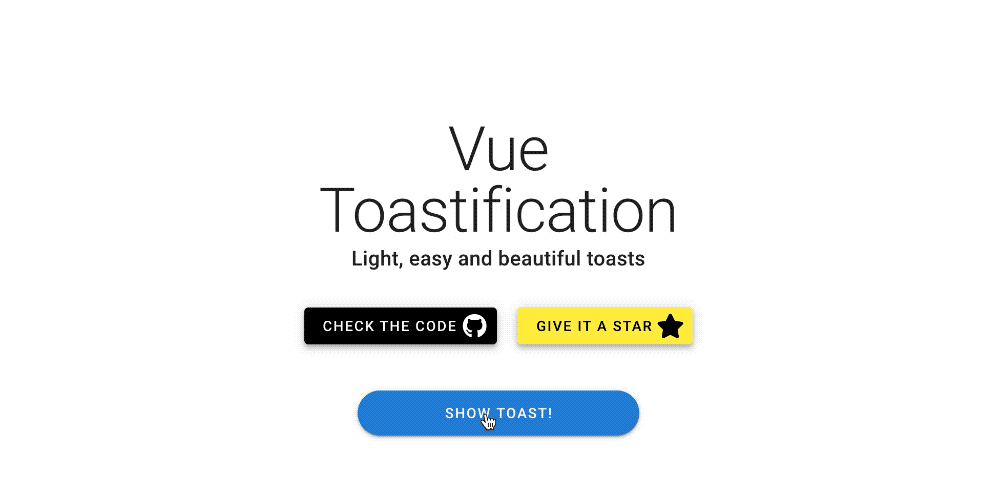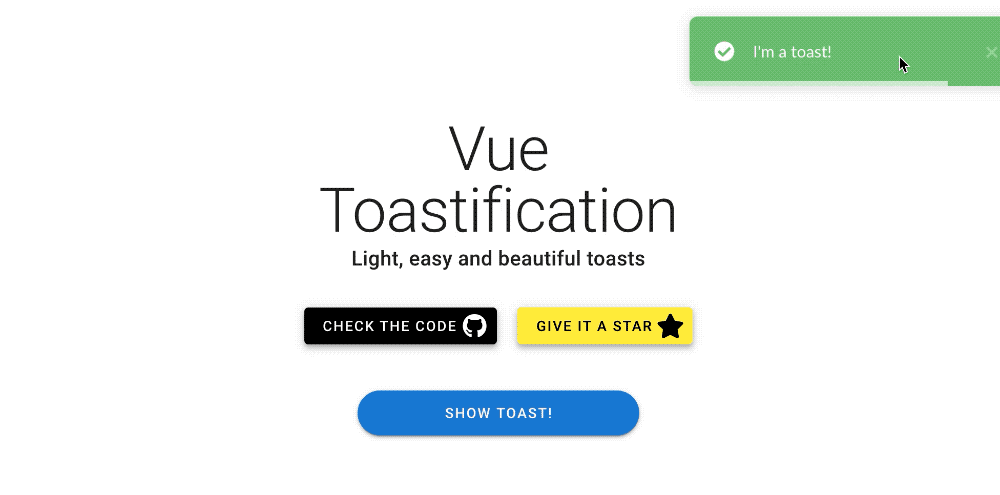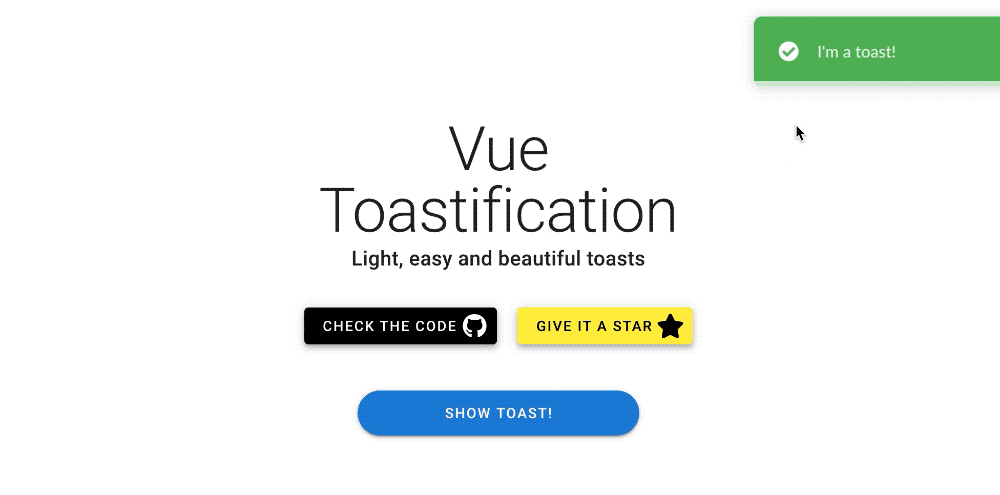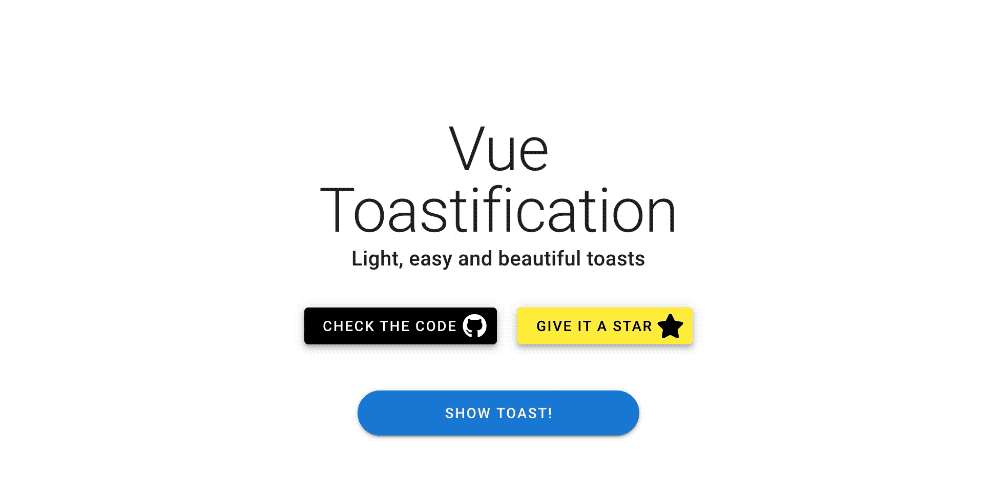
你有很多toast和类似通知的选择,但我是Maronatovue-toastification的忠实粉丝。它提供了大量的选项来覆盖你的大部分边界情况,而且样式和动画导致了出色的用户体验,远远超过其他软件包。

Vue-toastification提供了几种在其文档中使用它的方法。你可以在组件级别,全局级别甚至在Vuex内执行此操作,如果你希望根据状态或与服务器相关的操作显示toasts

全局使用(在 main.js 中):

import Toast from 'vue-toastification'
// Toast styles
import 'vue-toastification/dist/index.css'
Vue.use(Toast, {
  transition: 'Vue-Toastification__bounce',
  maxToasts: 3,
  newestOnTop: true,
  position: 'top-right',
  timeout: 2000,
  closeOnClick: true,
  pauseOnFocusLoss: true,
  pauseOnHover: false,
  draggable: true,
  draggablePercent: 0.7,
  showCloseButtonOnHover: false,
  hideProgressBar: true,
  closeButton: 'button',
  icon: true,
  rtl: false
})

你可以在每个组件中单独控制样式,但在上面的案例中,我通过将它导入 main.js,然后在那里设置我想使用的选项,使它在我的应用程序中到处可用,这使我不必每次都编写相同的选项属性。Vue-toastification有一个很好的在线演示,在这里你可以看到每个选项属性的结果,只需要复制粘贴你想要的选项,就像我上面做的那样。

/ 选项1:在组件(模板)中使用Toast /

<button @click="showToast">Show toast</button> 

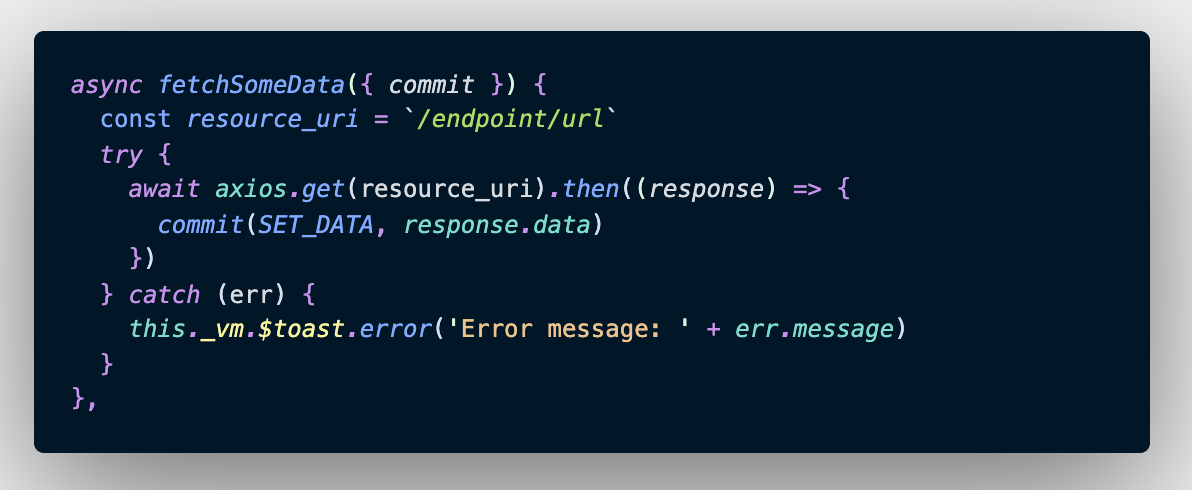
/ 选项2:在Vuex action中发现错误(或成功)时调用Toast /

你只需将 .error 改为 .success.info.warning 即可更改所需的 Toast 类型,也可以将其完全删除以作为默认的 Toast 通知。

Toasts 可以让你根据实时状态的变化或者发生了不可预见的错误来显示消息,这大大改善了用户的体验。Toasts 提供了比模态或丑陋的提示框更好的视觉指示,例如,用户必须提供一个额外的点击来关闭。用户会很感激你给他们一个视觉上的提示,让他们知道出了什么问题,防止他们盯着屏幕茫然地等待一些永远不会发生的事情。确认他们执行的操作是否成功完成也很有用。

3.Tables

首选:vue-good-table

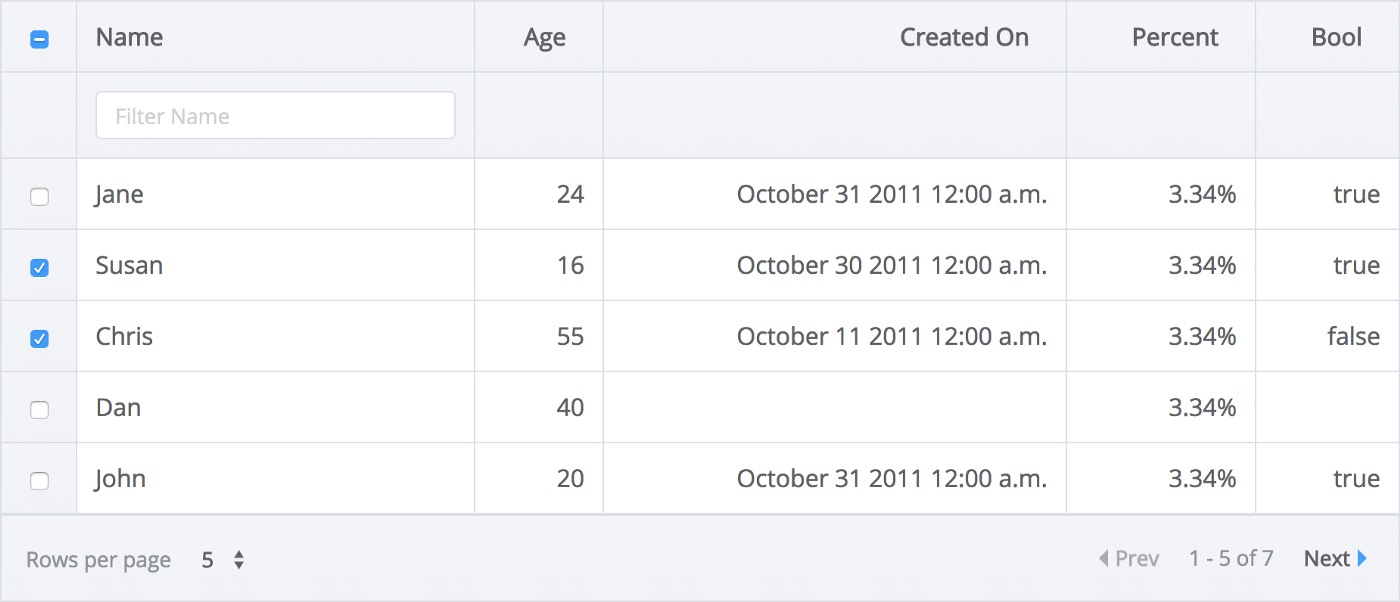
表格是许多Web应用程序的重要组成部分,选择错误的表格会让你陷入无尽的痛苦之中。尝试了很长的包选项列表后,我相信vue-good-table将解决你大部分的表需求。它不仅仅是为了好玩才叫“good-table”。它真的很好,提供了更多的选择和功能,超出了你的能力范围。

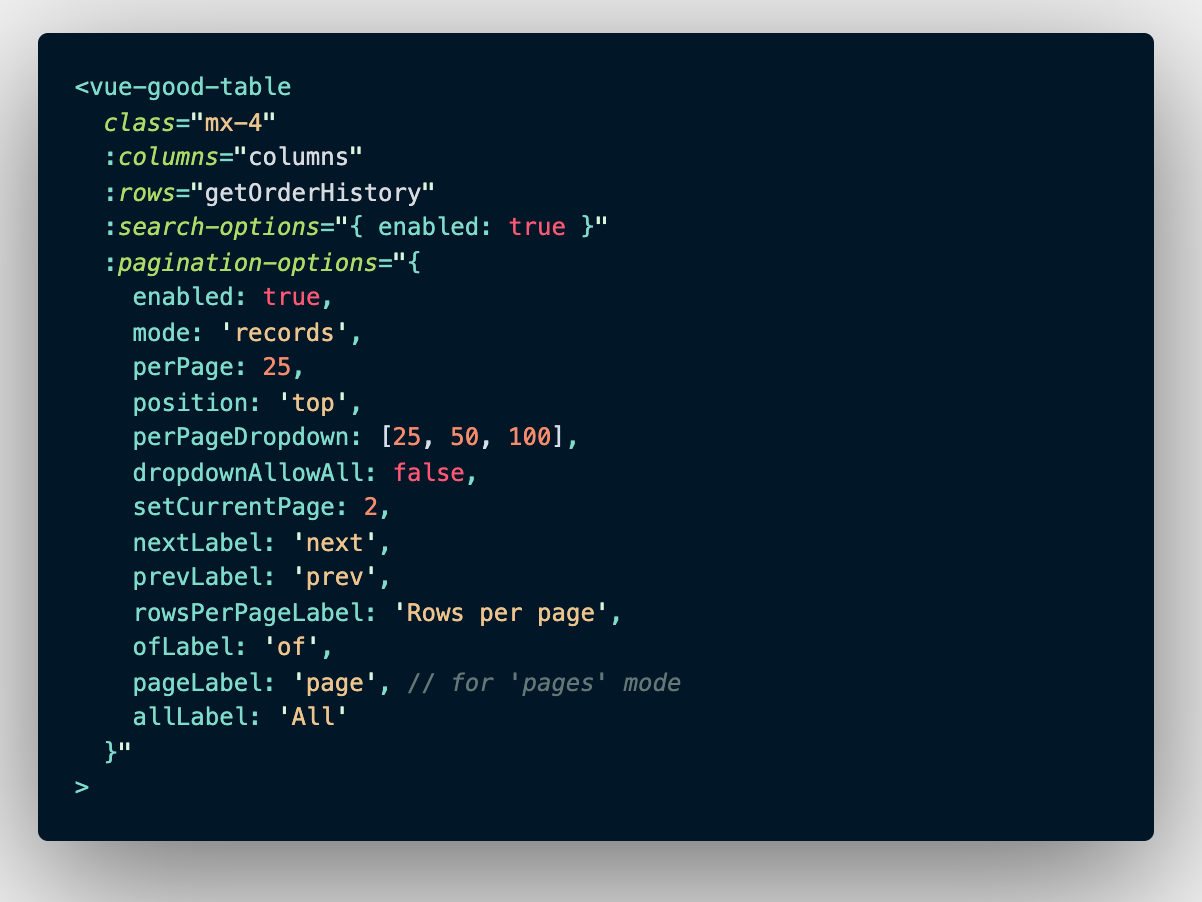
在以下情况下,我将 :rows 数据绑定到名为 getOrderHistory 的Vuex getter。

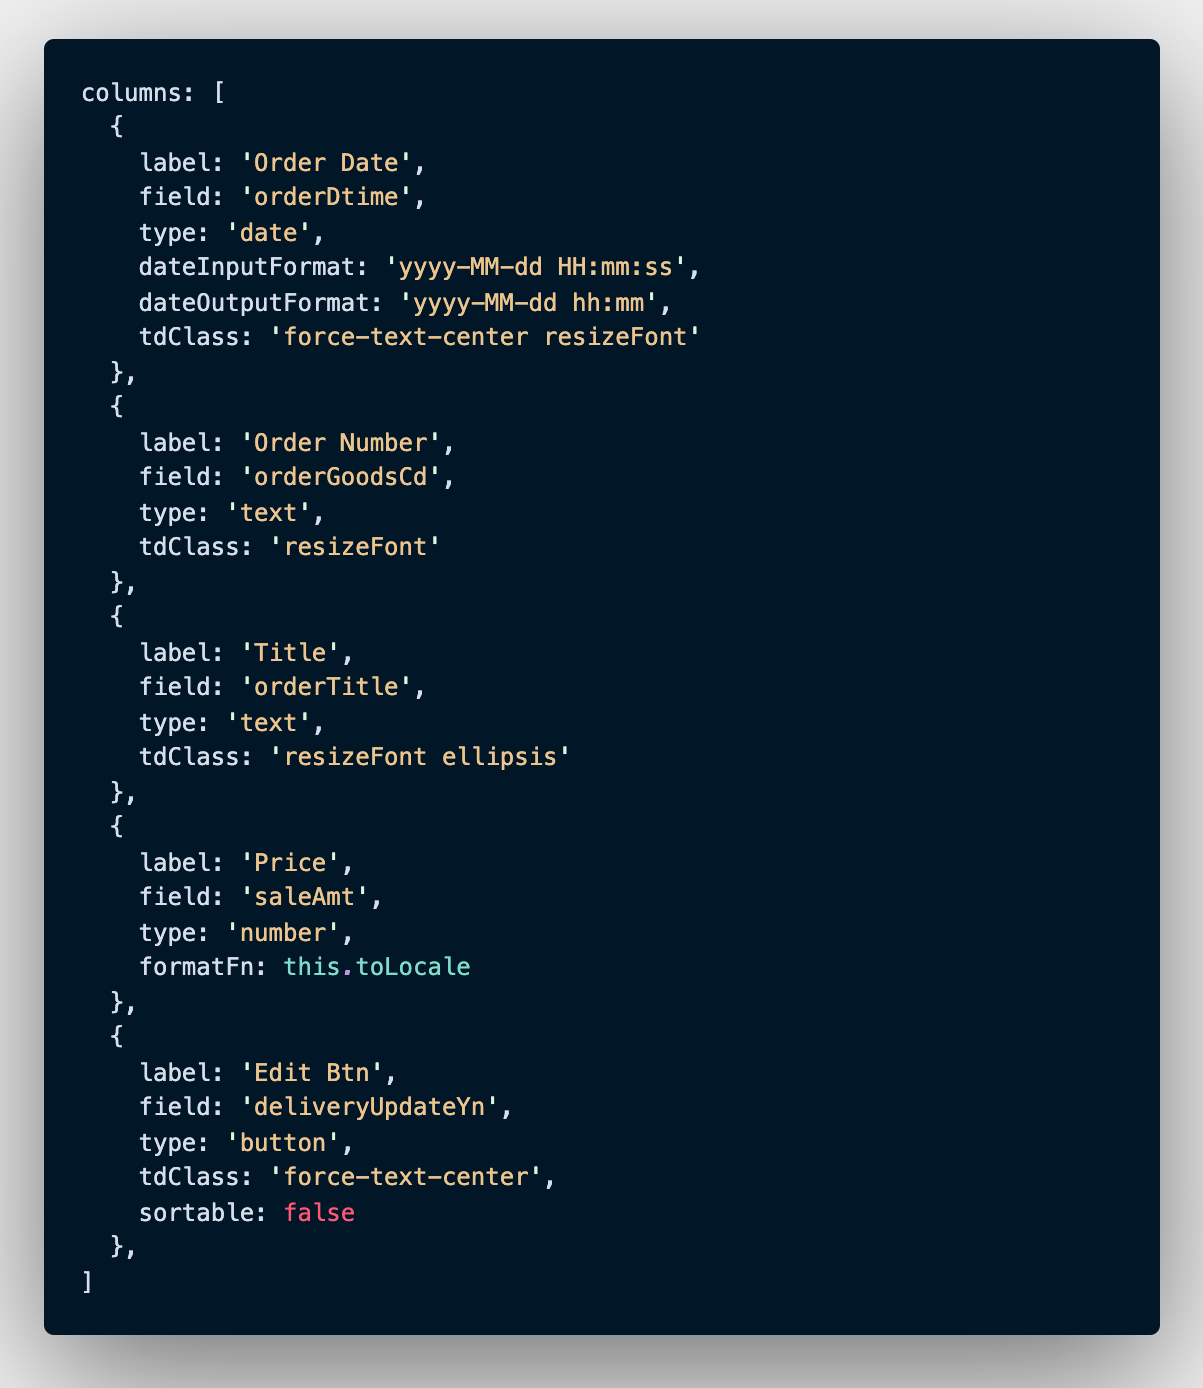
在本地 data() 中定义我的列:

label 是显示的列标题,而 field 是我在Vuex getter中绑定的数据。

在上图中,我还使用了vue-good-table的一些自定义选项,比如设置我的日期的输入和输出格式(这让我可以把服务器提供的一个很长的时间戳改成对我的用户来说更易读的东西)。我还使用 formatFn来格式化我的价格,调用了一个我命名为 toLocale 的单独方法,然后我通过绑定 tdClass 到我在 local <style> 中设置的类来定制每个单元格的外观。Vue-good-table确实内置了无穷的可定制性,他们已经覆盖了非常广泛的边缘案例。

Vue-good-table还可以与自定义模板配合使用,因此你可以轻松地将按钮,选择框或您喜欢的其他任何东西注入到表格的单元格中。为此,你只需使用 v-if 定义应将其注入的位置。

要添加另一个自定义列,只需在你的 v-if 标签后面添加一个 v-else-if(在上面的例子中是一个跨度),然后在那里添加第二个自定义模板的逻辑。无论你需要什么,vue-good-table都能满足你的需求。

4.Date Picker

首选:vue2-datepicker

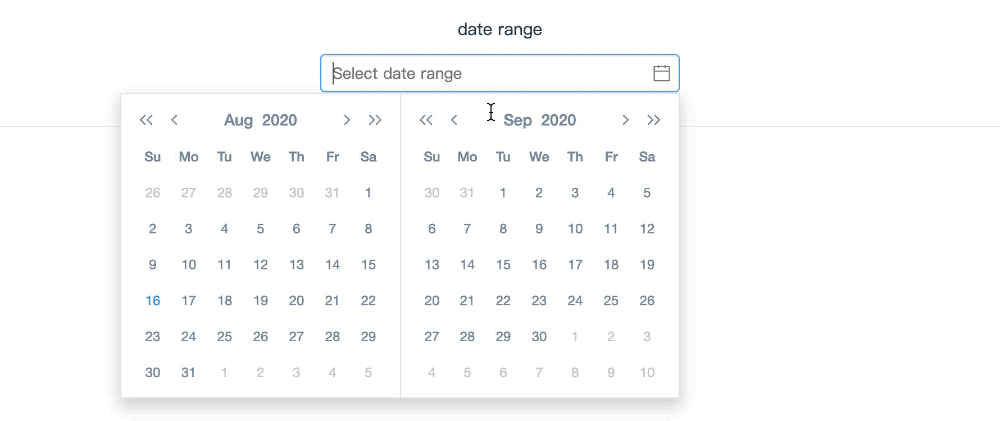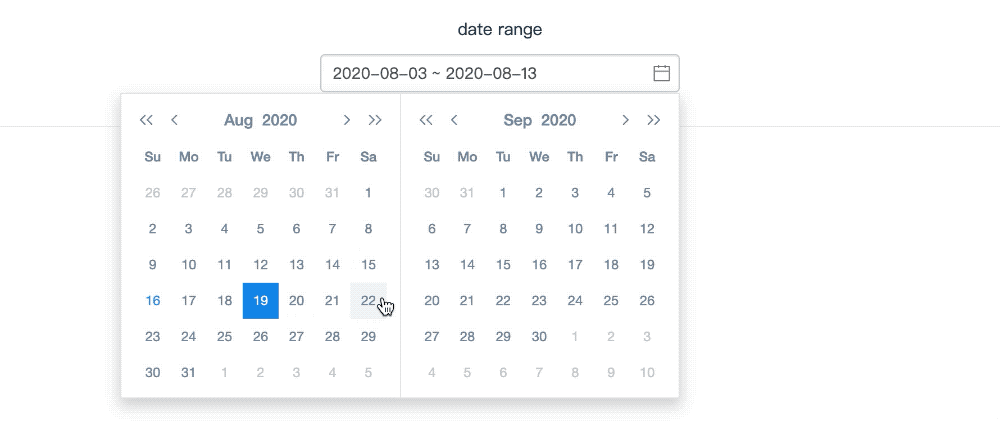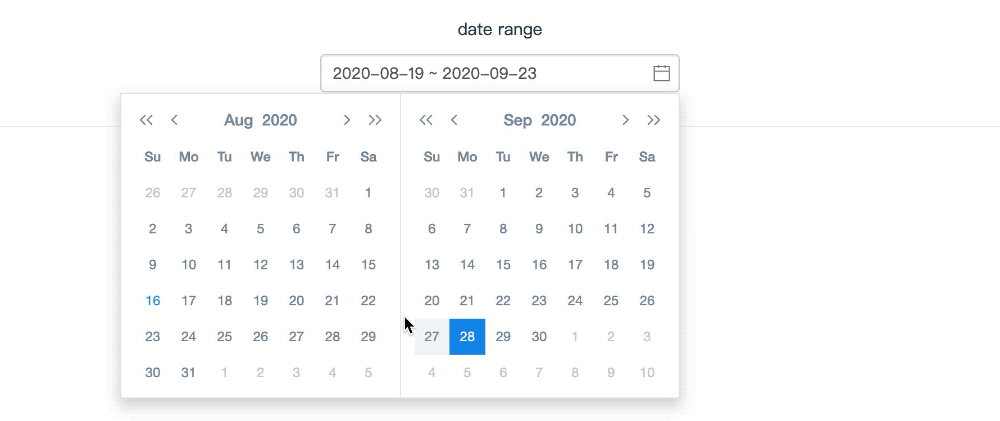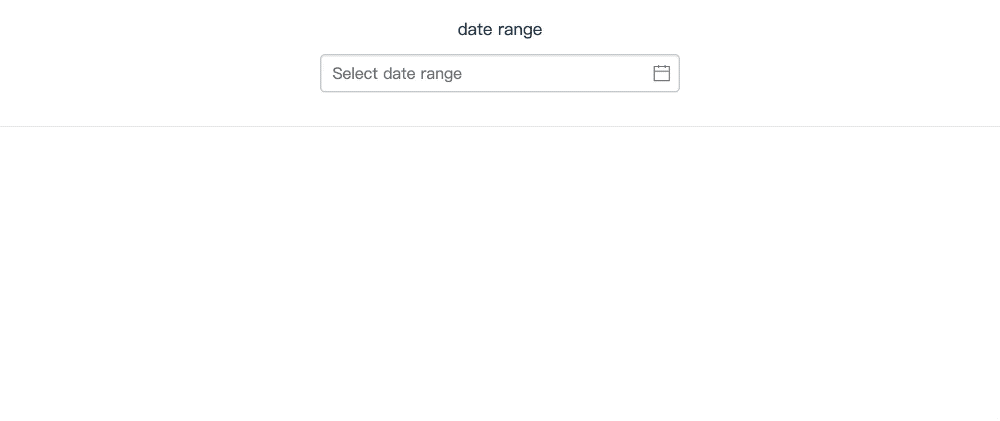
啊,日期选择器,这是许多应用程序的重要组成部分。在这个列表中,日期选择器的选择比其他任何东西都多,但Mengxiong打造的vue2-datepicker是我不断回归的一个选择。它的风格简单,提供了广泛的选择日期和日期范围的选项,并被包装在一个光滑和用户友好的UI中。它甚至支持i18n语言和日期格式的本地化。

注意:尽管包名为vue2-datepicker,但将这个包(或这里列出的其他包)添加到Vue 3.0应用程序中应该没有问题。

在组件或视图中导入,使其可以使用。

import DatePicker from 'vue2-datepicker';
// styles
import 'vue2-datepicker/index.css';

在模板中:

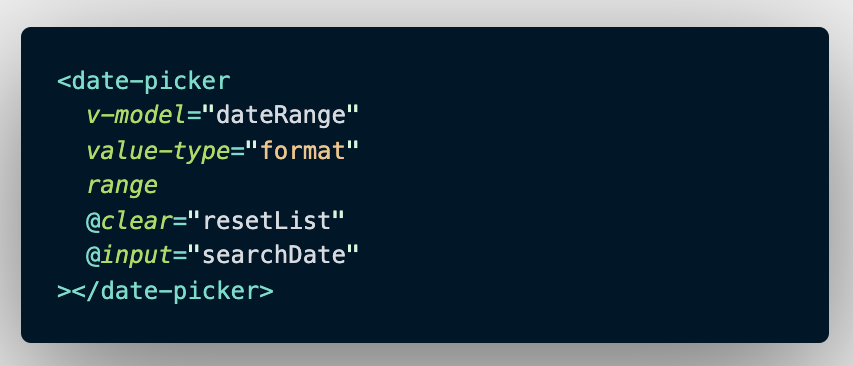
在这里,我使用的是 range 选项,允许用户选择日期范围,并将用户输入的日期 v-model 以一个名为 dateRange 的数据值绑定。然后,vue-good-table(如下)使用 dateRange 对我的表的结果进行排序。我还使用事件选项 @clear@input 来触发重置表(resetList)或发送服务器请求表数据(searchDate)的方法。Vue2-datepicker提供了更多的选项和事件,以方便你的使用,但这些是我发现自己最经常使用的。

5.User Ratings

首选:vue-star-rating

虽然你可能不会在每个项目中都使用这个功能,但对于任何需要用户评级元素的网站(比如Amazon或Rotten Tomatoes),vue-star-rating是我的首选。自己创建看似是一件微不足道的事情,但当你进入细节后,星级评定很快就会变得比你预期的要复杂。如果需要特殊功能,它可以让你使用自定义SVG形状,并且可以轻松自定义大小,间距和颜色。

通过这些选项,可以很容易地将用户选择的评级 v-model 绑定到任何你想使用的地方,你可以通过一个prop将评级设置为可更改或只读。

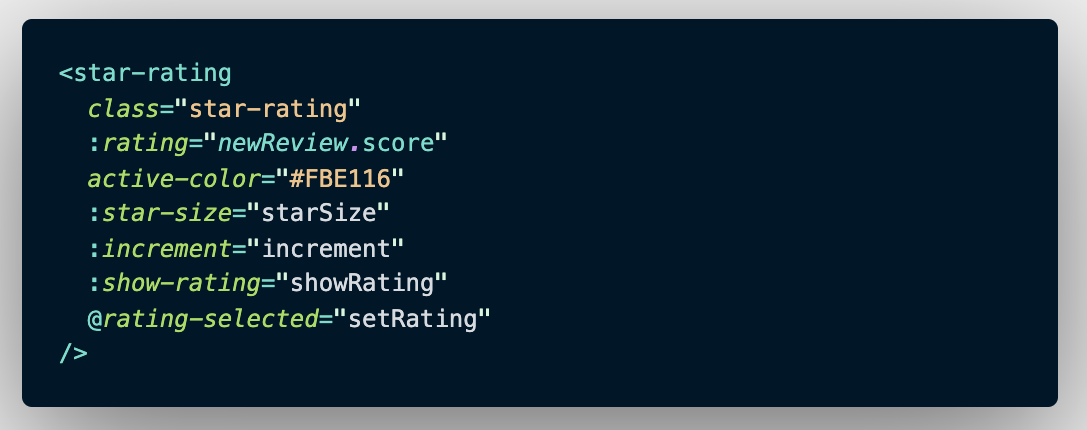
如果你发现需要更多选择,请查看创建者的扩展软件包vue-rate-it。

在模板中(带有选项):

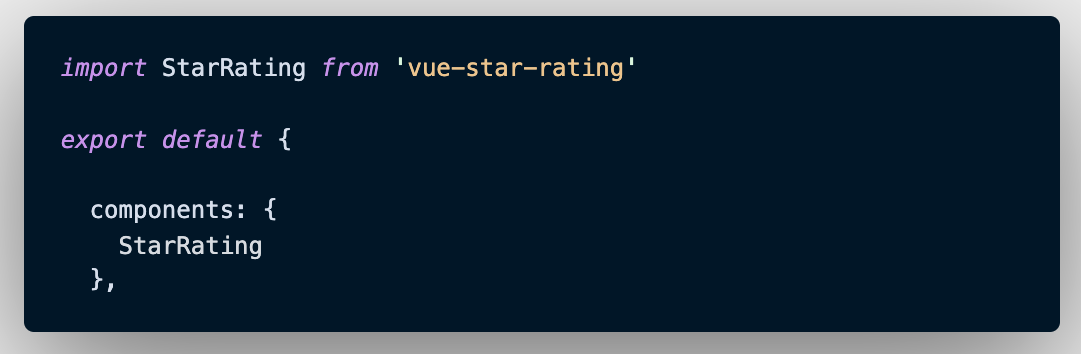
将其导入到组件或视图中:

文章来源:www.toutiao.com/a6865327554656469508/ 作者:杭州程序员小张

以上就是W3Cschool编程狮关于 推荐5个很好用的Vue.js库 的相关介绍了,希望对大家有所帮助。

Java面试题:重写了equals,还要重写hashCode?

thbcm阅读(378)

重写了 equals ,还要重写 hashCode ?这不仅仅是一道面试题,而且是关系到我们的代码是否健壮和正确的问题。本篇文章,带大家从底层来分析一下hashcode方法重写的意义以及如何实现。

回顾equals方法

我们先回顾一下 Object的equals方法 实现,并简单汇总一下使用equals方法的规律。

public boolean equals(Object obj) {
    return (this == obj);
}

通过上面Object的源代码,可以得出一个结论:如果一个类未重写equals方法,那么本质上通过“==”和equals方法比较的效果是一样的,都是比较两个对象的的内存地址。

前面两篇文章讲到StringInteger在比较时的区别,关键点也是它们对equals方法的实现。

面试时总结一下就是:默认情况下,从Object类继承的equals方法与“==”完全等价,比较的都是对象的内存地址。但我们可以重写equals方法,使其按照需要进行比较,如String类重写了equals方法,比较的是字符的序列,而不再是内存地址。

与hashCode方法的关系

那么equals方法与hashCode方法又有什么关系呢?我们来看Object上equals方法的一段注释。

Note that it is generally necessary to override the hashCode method whenever this method is overridden, so as to maintain the general contract for the hashCode method, which states that equal objects must have equal hash codes.

大致意思是:当重写equals方法后有必要将hashCode方法也重写,这样做才能保证不违背hashCode方法中“相同对象必须有相同哈希值”的约定。

此处只是提醒了我们重写hashCode方法的必要性,那其中提到的hashCode方法设计约定又是什么呢?相关的内容定义在hashCode方法的注解部分。

hashCode方法约定

关于hashCode方法的约定原文比较多,大家直接看源码即可看到,这里汇总一下,共三条:

(1)如果对象在使用equals方法中进行比较的参数没有修改,那么多次调用一个对象的hashCode()方法返回的哈希值应该是相同的。

(2)如果两个对象通过equals方法比较是相等的,那么要求这两个对象的hashCode方法返回的值也应该是相等的。

(3)如果两个对象通过equals方法比较是不同的,那么也不要求这两个对象的hashCode方法返回的值是不相同的。但是我们应该知道对于不同对象产生不同的哈希值对于哈希表(HashMap等)能够提高性能。

其实,看到这里我们了解了hashCode的实现规约,但还是不清楚为什么实现equals方法需要重写hashCode方法。但我们可以得出一条规律:hashCode方法实际上必须要完成的一件事情就是,为equals方法认定为相同的对象返回相同的哈希值。

其实在上面规约中提到了哈希表,这也正是hashCode方法运用的场景之一,也是我们为什么要重写的核心。

hashCode应用场景

如果了解HashMap的数据结构,就会知道它用到“键对象”的哈希码,当我们调用put方法或者get方法对Map容器进行操作时,都是根据键对象的哈希码来计算存储位置的。如果我们对哈希码的获取没有相关保证,就可能会得不到预期的结果。
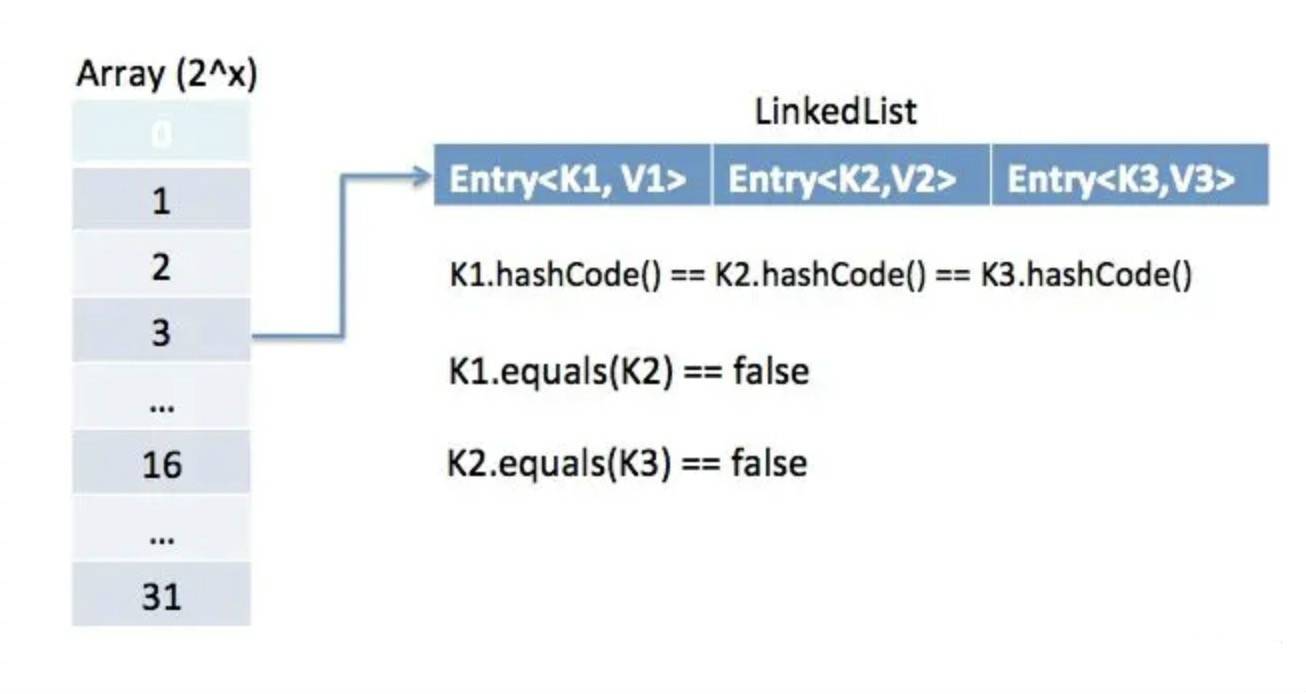
而对象的哈希码的获取正是通过hashCode方法获取的。如果自定义的类中没有实现该方法,则会采用Object中的hashCode()方法。

Object中该方法是一个本地方法,会返回一个int类型的哈希值。可以通过将对象的内部地址转换为整数来实现的,但是Java中没有强制要求通过该方式实现。

具体实现网络上有不同的说法,有说通过内置地址转换得来,也有说“OpenJDK8默认hashCode的计算方法是通过和当前线程有关的一个随机数+三个确定值,运用Marsaglia's xorshift scheme随机数算法得到的一个随机数”获得。

无论默认实现是怎样的,大多数情况下都无法满足equals方法相同,同时hashCode结果也相同的条件。比如下面的示例重写与否差距很大。

public void test1() {
    String s = "ok";
    StringBuilder sb = new StringBuilder(s);
    System.out.println(s.hashCode() + "  " + sb.hashCode());


    String t = new String("ok");
    StringBuilder tb = new StringBuilder(s);
    System.out.println(t.hashCode() + "  " + tb.hashCode());
}

上面这段代码打印的结果为:

3548  1833638914
3548  1620303253

String实现了hashCode方法,而StringBuilder并没有实现,这就导致即使值是一样的,hashCode也不同。

上个示例中问题还不太明显,下面我们以HashMap为例,看看如果没有实现hashCode方法会导致什么严重的后果。

@Test
public void test2() {
    String hello = "hello";


    Map<String, String> map1 = new HashMap<>();
    String s1 = new String("key");
    String s2 = new String("key");
    map1.put(s1, hello);
    System.out.println("s1.equals(s2):" + s1.equals(s2));
    System.out.println("map1.get(s1):" + map1.get(s1));
    System.out.println("map1.get(s2):" + map1.get(s2));


    Map<Key, String> map2 = new HashMap<>();
    Key k1 = new Key("A");
    Key k2 = new Key("A");
    map2.put(k1, hello);
    System.out.println("k1.equals(k2):" + s1.equals(s2));
    System.out.println("map2.get(k1):" + map2.get(k1));
    System.out.println("map2.get(k2):" + map2.get(k2));
}


class Key {


    private String k;


    public Key(String key) {
        this.k = key;
    }


    @Override
    public boolean equals(Object obj) {
        if (obj instanceof Key) {
            Key key = (Key) obj;
            return k.equals(key.k);
        }
        return false;
    }
}

实例中定义了内部类Key,其中实现了equals方法,但未实现hashCode方法。存放于Map中的value值都是字符串“hello”。

代码分两段,第一段演示当Mapkey通过实现了hashCodeString时是什么效果;第二段演示了当Mapkey通过未实现hashCode方法的Key对象时是什么效果。

执行上述代码,打印结果如下:

s1.equals(s2):true
map1.get(s1):hello
map1.get(s2):hello
k1.equals(k2):true
map2.get(k1):hello
map2.get(k2):null

分析结果可以看出,对于String作为key的 s1 和 s2 来说,通过equals比较相等是自然的,获得的值也是相同的。但 k1 和 k2 通过equals比较是相等,但为什么在Map中获得的结果却不一样?本质上就是因为没有重写hashCode方法导致Map在存储和获取过程中调用hashCode方法获得的值不一致。

此时在Key类中添加hashCode方法:

@Override
public int hashCode(){
    return k.hashCode();
}

再次执行,便可正常获得对应的值。

s1.equals(s2):true
map1.get(s1):hello
map1.get(s2):hello
k1.equals(k2):true
map2.get(k1):hello
map2.get(k2):hello

通过上面的典型实例演示了不重写hashCode方法的潜在后果。简单看一下HashMap中的put方法。

public V put(K key, V value) {
    return putVal(hash(key), key, value, false, true);
}


static final int hash(Object key) {
    int h;
    return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}


final V putVal(int hash, K key, V value, boolean onlyIfAbsent,
               boolean evict) {
    Node<K,V>[] tab; Node<K,V> p; int n, i;
    if ((tab = table) == null || (n = tab.length) == 0)
        n = (tab = resize()).length;
    // 通过哈希值来查找底层数组位于该位置的元素p,如果p不为null,则使用新的键值对来覆盖旧的键值对
    if ((p = tab[i = (n - 1) & hash]) == null)
        tab[i] = newNode(hash, key, value, null);
    else {
        Node<K,V> e; K k;
        // (二者哈希值相等)且(二者地址值相等或调用equals认定相等)。
        if (p.hash == hash &&
            ((k = p.key) == key || (key != null && key.equals(k))))
            e = p;
        else if (p instanceof TreeNode)
            e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value);
        else {
            for (int binCount = 0; ; ++binCount) {
                if ((e = p.next) == null) {
                    p.next = newNode(hash, key, value, null);
                    if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st
                        treeifyBin(tab, hash);
                    break;
                }
                if (e.hash == hash &&
                    ((k = e.key) == key || (key != null && key.equals(k))))
                    break;
                p = e;
            }
        }
        // 如果底层数组中存在传入的Key,那么使用新传入的覆盖掉查到的
        if (e != null) { // existing mapping for key
            V oldValue = e.value;
            if (!onlyIfAbsent || oldValue == null)
                e.value = value;
            afterNodeAccess(e);
            return oldValue;
        }
    }
    ++modCount;
    if (++size > threshold)
        resize();
    afterNodeInsertion(evict);
    return null;
}

在上述方法中,put方法在拿到key的第一步就对key对象调用了hashCode方法。暂且不看后面的代码,如果没有重写hashCode方法,就无法确保keyhash值一致,后续操作就是两个key的操作了。

重写hashCode方法

了解了重写hashCode方法的重要性,也了解了对应的规约,那么下面我们就聊聊如何优雅的重写hashCode方法。

首先,如果使用IDEA的话,那么直接使用快捷键即可。
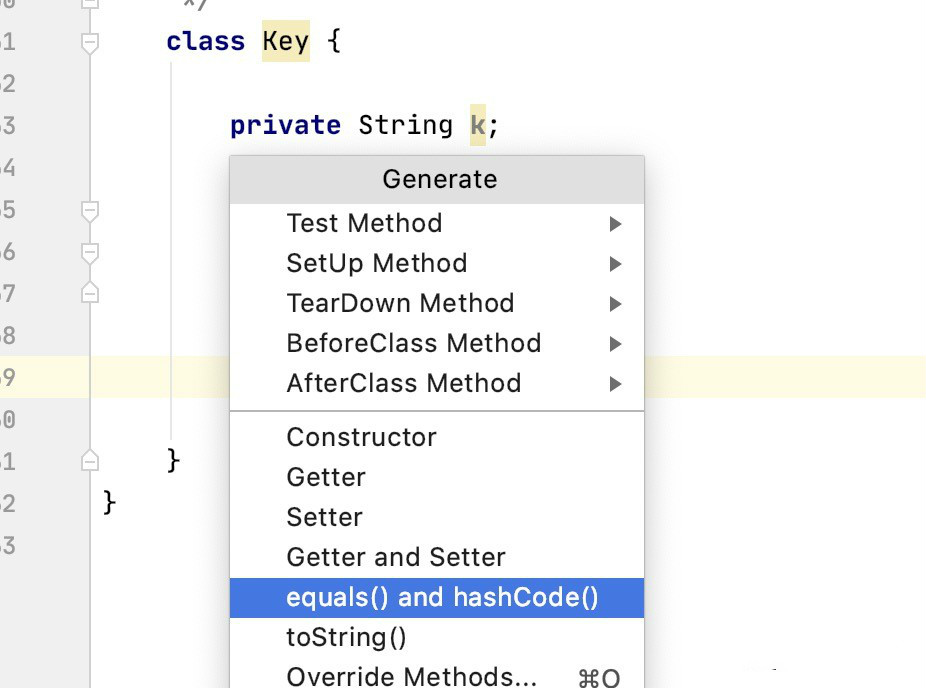
生成的效果如下:

@Override
public boolean equals(Object o) {
    if (this == o) {
        return true;
    }
    if (o == null || getClass() != o.getClass()) {
        return false;
    }
    Key key = (Key) o;
    return Objects.equals(k, key.k);
}


@Override
public int hashCode() {
    return Objects.hash(k);
}

根据需要可对生成的方法内部实现进行修改。在上面的实例中用到了java.util.Objects类,它的hash方法的优点是如果参数为null,就只返回 0 ,否则返回对象参数调用的hashCode的结果。Objects.hash方法源码如下:

public static int hash(Object... values) {
    return Arrays.hashCode(values);
}

其中Arrays.hashCode方法源码如下:

public static int hashCode(Object a[]) {
    if (a == null)
        return 0;


    int result = 1;


    for (Object element : a)
        result = 31 * result + (element == null ? 0 : element.hashCode());


    return result;
}

当然此处只有一个参数,也可以直接使用ObjectshashCode方法:

public static int hashCode(Object o) {
    return o != null ? o.hashCode() : 0;
}

如果是多个属性都参与hash值的情况建议可使用第一个方法。只不过需要注意,在类结构(成员变量)变动时,同步增减方法里面的参数值。

小结

当我们准备面试时,一直在背诵“实现equals方法的同时也要实现hashCode方法”,牢记这些结论并没有错。但我们也不能因为匆忙准备面试题,而忘记了这些面试题之所以频繁出现的原因是什么。当深入探索之后,会发现在那些枯燥的结论背后还有这么多不容忽视的知识点,还有这么多有意思的设计与陷阱。

文章来源:www.toutiao.com/a6865829963505861132/

以上就是W3Cschool编程狮关于Java面试题:重写了equals,还要重写hashCode?的相关介绍了,希望对大家有所帮助。

联系我们