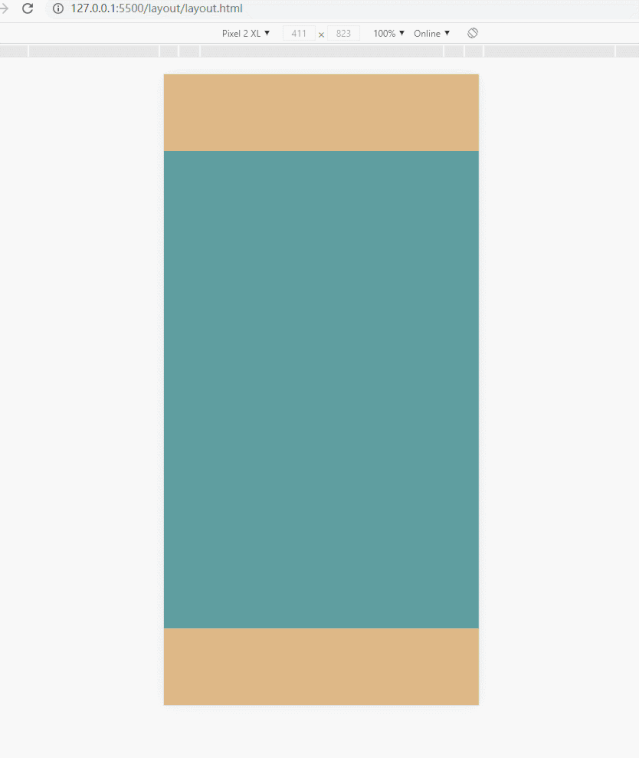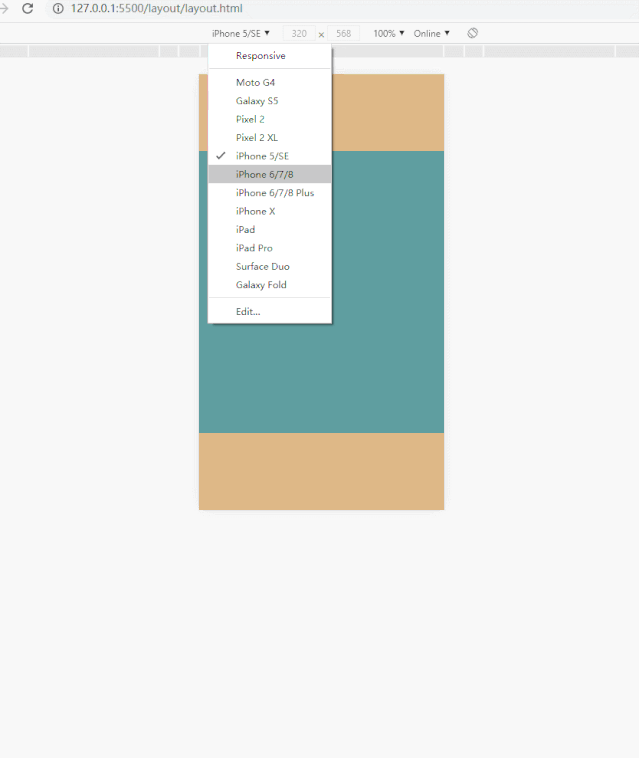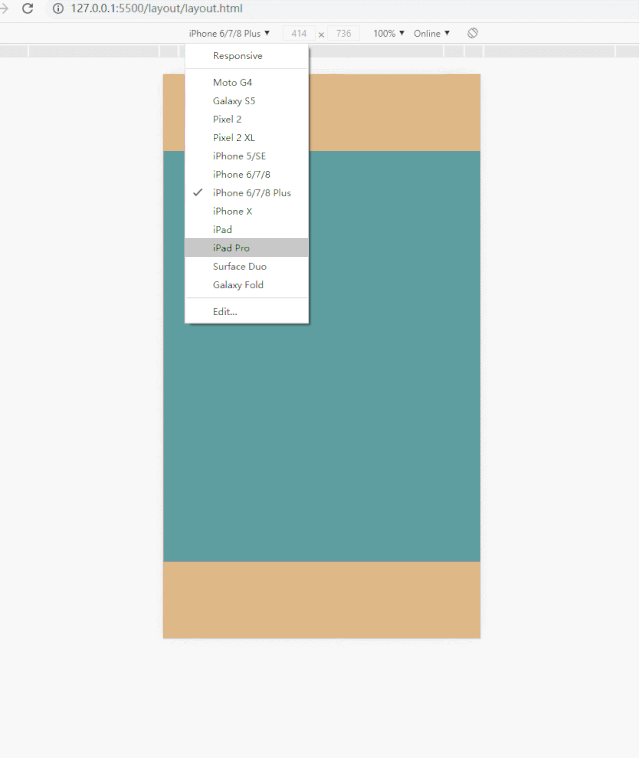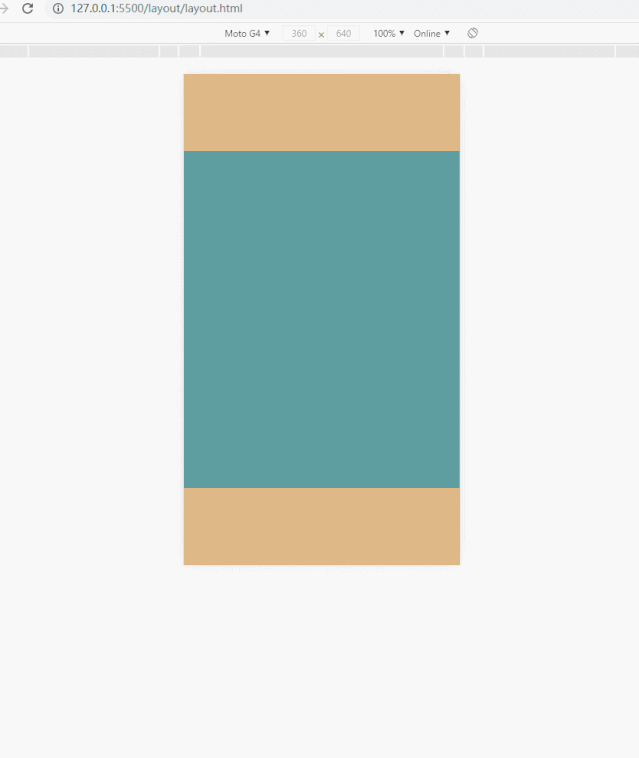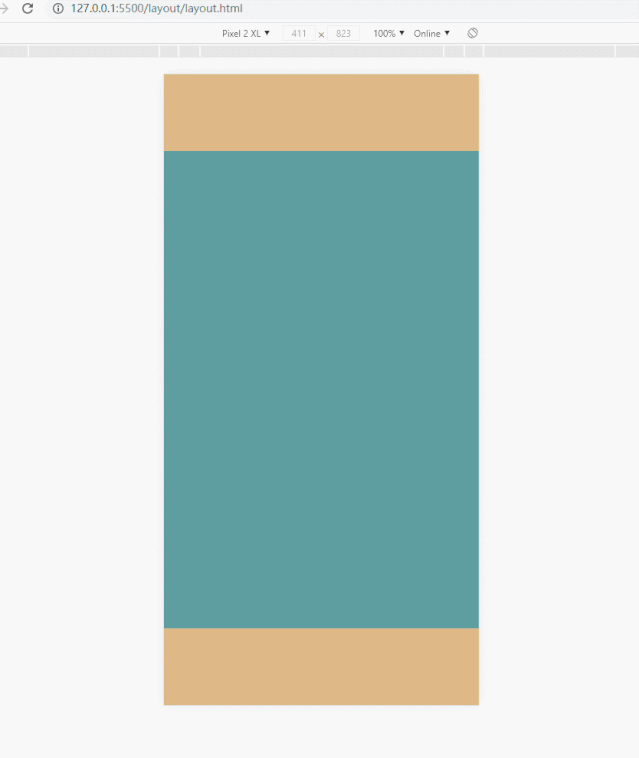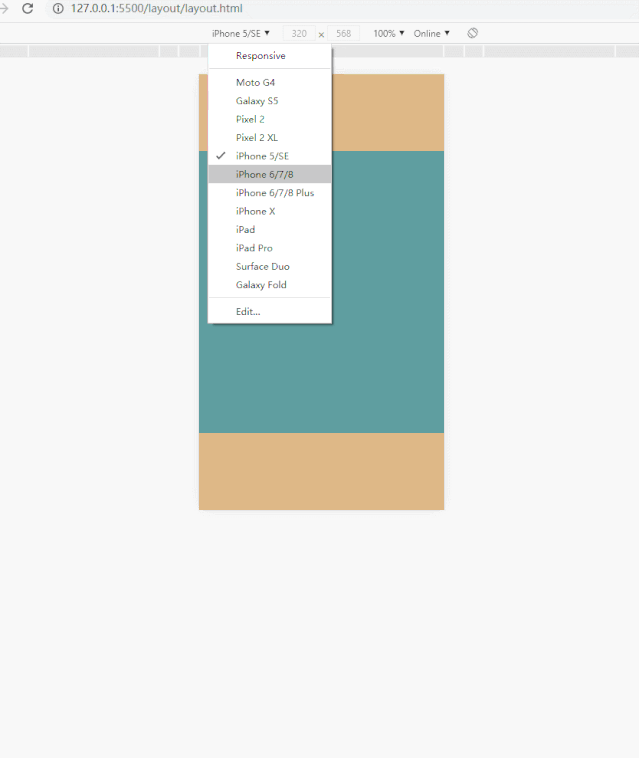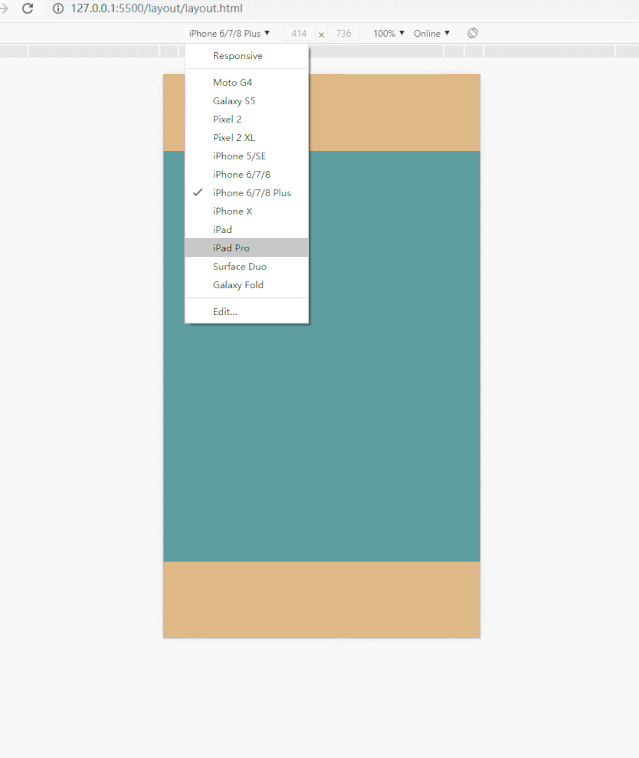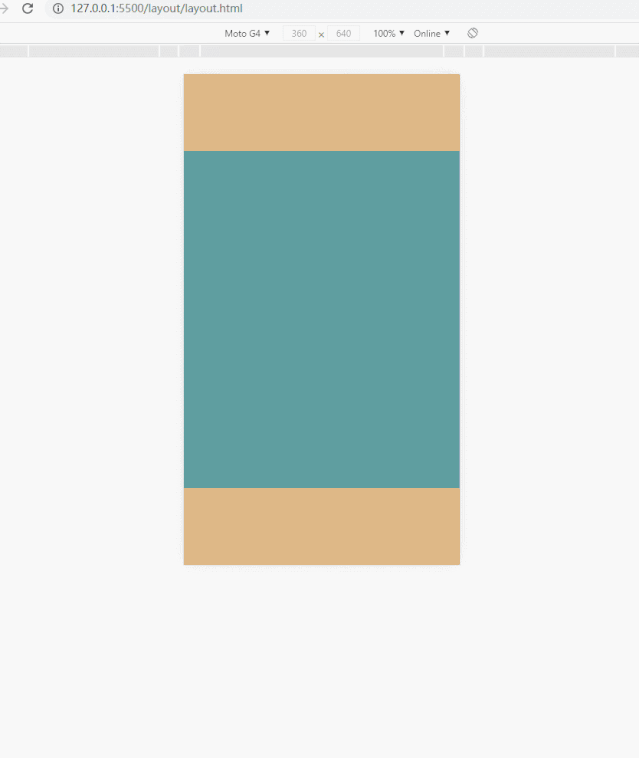CSS背景知识,一篇文章带你由浅到深全面理解

thbcm阅读(303)

文章转载自公众号:前端人

本文从简单到深入讲解了 CSS 背景相关的知识,请一定要耐心看完,切勿浮躁!

CSS background是最常用的 CSS 属性之一。但是,在所有开发人员中使用多种背景仍然不是很了解。我将重点关注使用多种背景的潜力,并充分利用 CSS 的全部功能。

在本文中,我将background-image详细解释该属性,并提供一个可视化的解释器,说明如何堆叠多个背景及其实际好处。当然,将有一些视觉示例,您可以大饱口福!

如果您不了解CSS background属性,我更喜欢看Mozilla开发人员网络(MDN)的这份参考资料,它解释了CSS的background工作原理。

介绍

CSS background属性是以下属性的简写。

背景剪辑,背景颜色,背景图像,背景来源,背景位置,背景重复,背景大小和背景附件。

在这篇文章中,我将重点放在background-imagebackground-positionbackground-size。你准备好了吗?让我们潜入吧!

考虑以下示例。

.element {
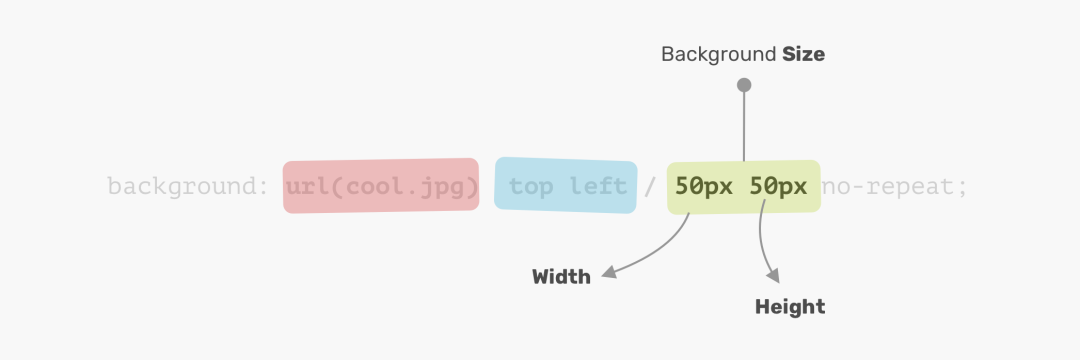
 background: url(cool.jpg) top left/50px 50px no-repeat;
}

背景图像被定位在左上角的元件的拐角,具有尺寸的50px * 50px。了解并记住位置和大小的顺序很重要。
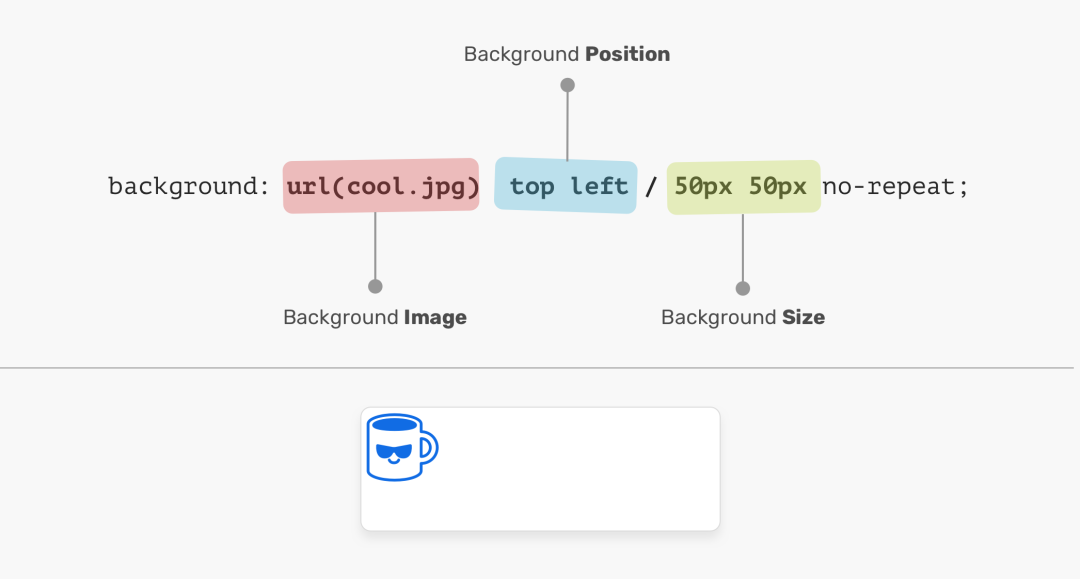
在上图中,background-position后面跟着background-size。反之亦然!换句话说,以下CSS 无效:

.element {
 /* Warning: Invalid CSS */
 background: url(cool.jpg) 50px 50px/top left no-repeat;
}

背景位置

相对于background-origin属性设置的定位层定位元素。我喜欢的灵活性background-position。它具有多种定位元素的方式:

  • 关键字值(top,right,bottom,left,center
  • 百分比值。例如:50%
  • 长度值。例如:20px 2.5rem
  • 边缘偏移值。例如:top 20px left 10px

坐标系从左上角开始,默认值为0% 0%

值得一提的是,该值top left与相同left top。浏览器足够聪明,可以确定其中一个用于x轴,哪个用于y轴。
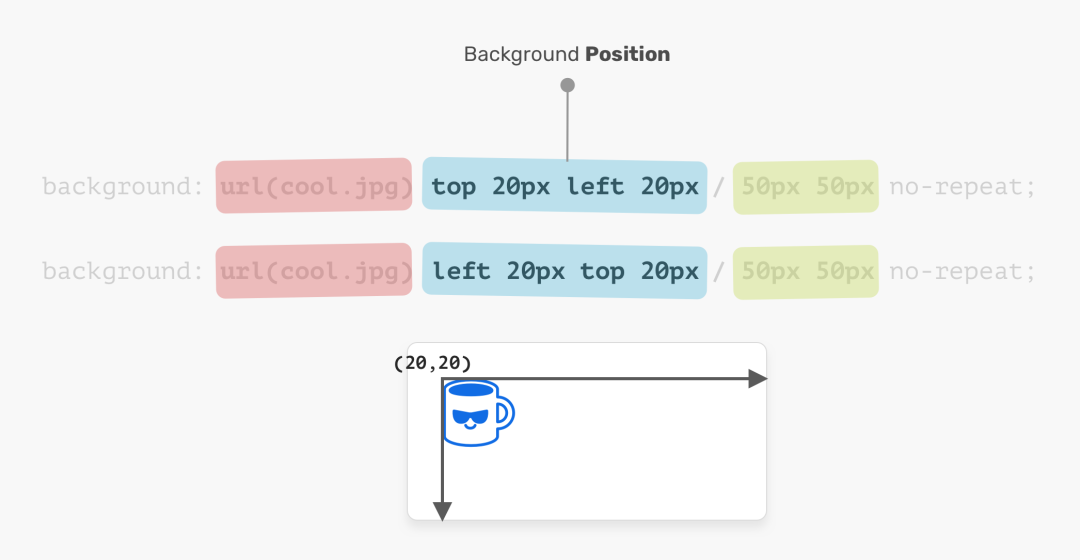
.element {
 background: url(cool.jpg) top left/50px 50px no-repeat;
 /* is the same as */
 background: url(cool.jpg) left top/50px 50px no-repeat;
}

背景尺寸

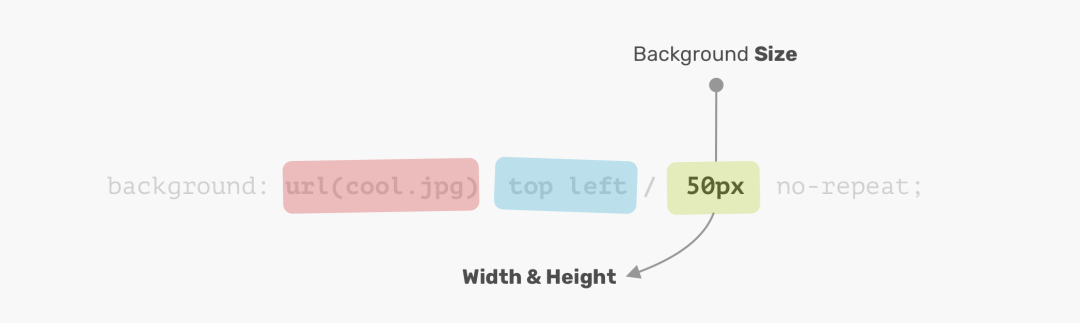
该属性的名称不言而喻。大小由widthheight组成。对于该background-size属性,第一个是width,第二个是height

不必使用两个值。您可以使用一个值,它将用于宽度和高度。

免责声明:值得一提的是CSS规范指出:“如果仅给出一个值,则第二个将被认为是自动的”。但是,该功能尚未在浏览器中实现,并且将来会更改。感谢Ilya Streltsyn的来信。
现在,我已经了解了CSS如何background工作的基础知识,让我们探索如何使用多个背景。

多种背景

背景属性可以有一个或更多的层,用逗号分隔。如果多个背景的大小相同,则其中一个将覆盖另一个背景。

.element {
 background: url(cool.jpg) top left/50px 50px no-repeat,
 url(cool.jpg) center/50px 50px no-repeat;
}
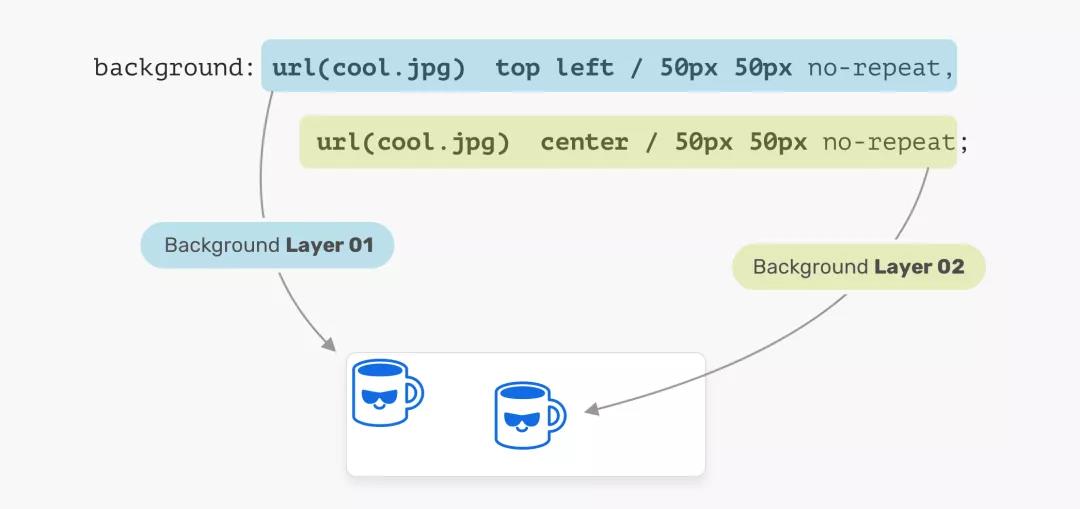
在上图中,我们有两个背景层。他们每个人的位置都不同。这是多种背景的基本用法。让我们探索一个更高级的示例。

堆叠顺序

当放置多个背景时,其中一个背景占据其父级的全部宽度和高度时,将进行堆叠顺序。决定何时将背景堆叠在彼此之上可能会有些混乱。考虑以下示例。

.hero {
  min-height: 350px;
  background: url('table.jpg') center/cover no-repeat,
    url('konafa.svg') center/50px no-repeat; 
}
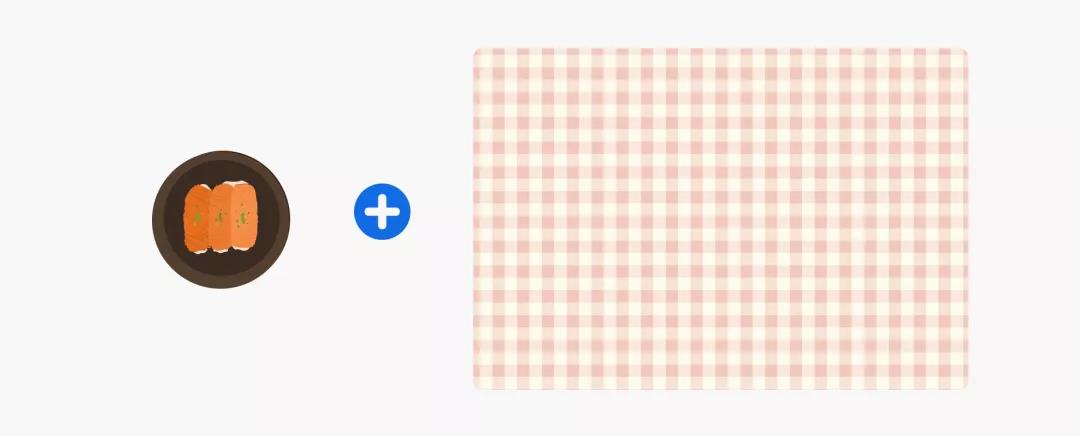
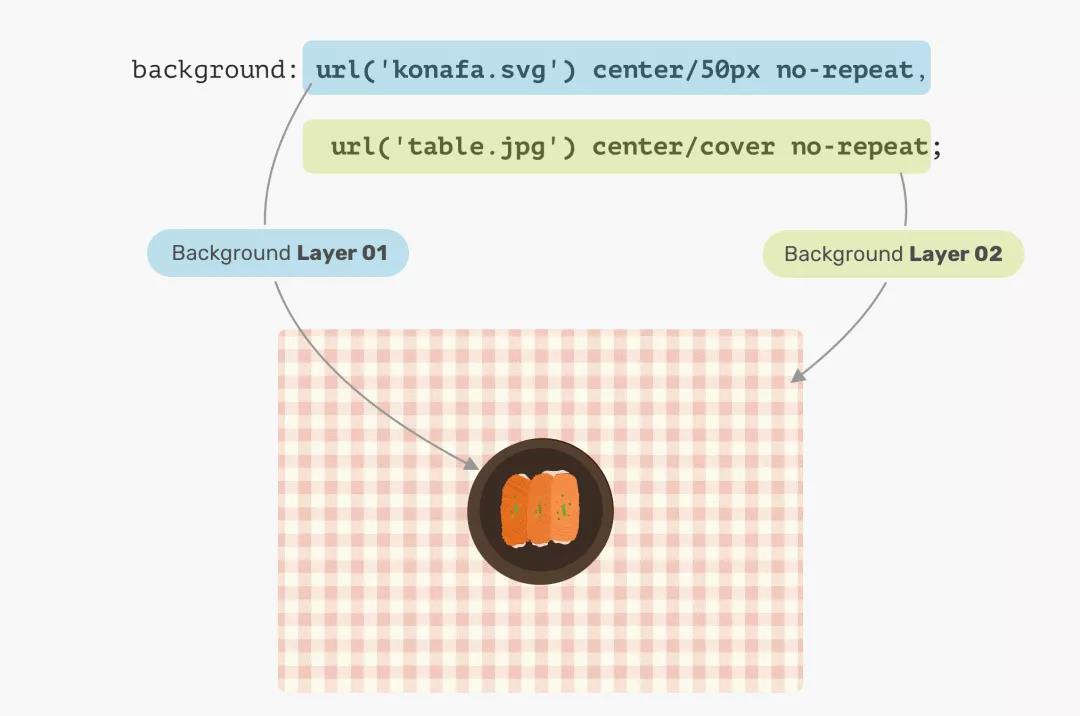
我们有一个盘子和一张桌子。您希望上面的CSS产生什么结果?哪个先到?盘子还是桌子?

答案是桌子。在CSS中,第一个背景可以堆叠在第二个背景上,第二个背景可以堆叠在第三个背景上,依此类推。通过替换背景顺序,结果将达到预期。

.hero {
  background: url('konafa.svg') center/50px no-repeat,
  url('table.jpg') center/cover no-repeat;
}
纯色

假设您要绘制两个具有CSS背景的矩形,您将如何做?幸运的是,使用CSS渐变非常容易。当linear-gradient具有相同颜色的停止时,结果将为纯色。而已!

.hero {
 background: linear-gradient(#3c88Ec, #3c88Ec)
}
通过探索CSS渐变的一个非常非常有用的用例,我们可以进一步采用这种方式。请继续关注用例部分!

用例和范例

叠加

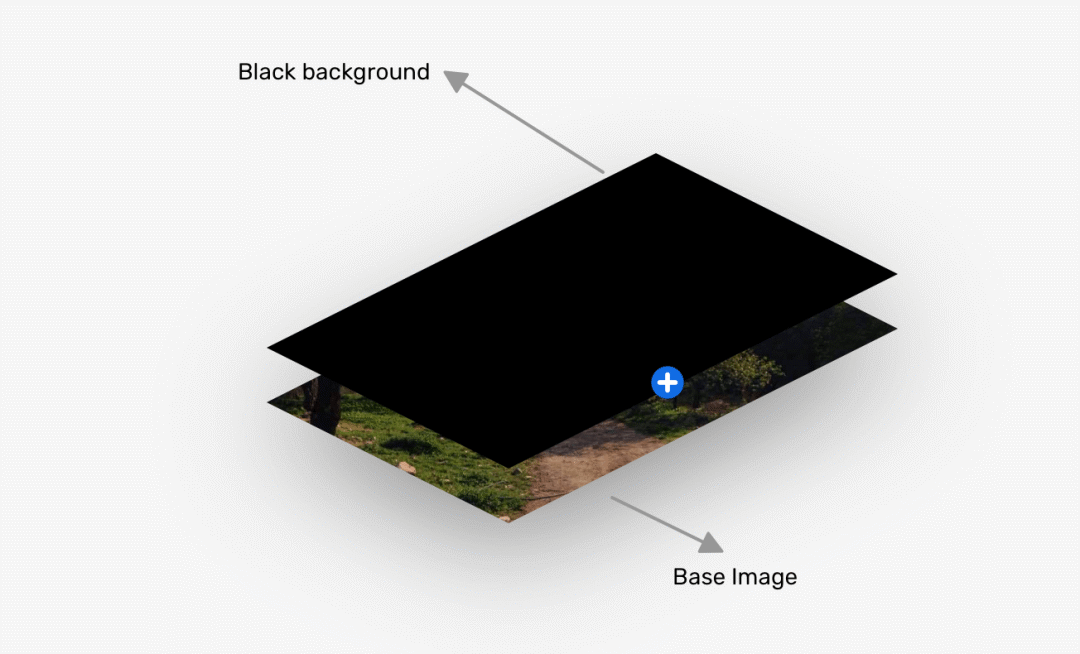
通常,您可能需要在英雄部分的顶部放置一个覆盖层,以便使文本易于阅读。通过堆叠两个背景可以轻松完成此操作。

.hero {
 background: linear-gradient(rgba(0, 0, 0, 0.15), rgba(0, 0, 0, 0.15)),
    url("landscape.jpg") center/cover;
}
更好的是,我们可以使用与上面相同的方法将淡色应用于元素。考虑以下:

.hero {
 background: linear-gradient(135deg, rgba(177, 234, 77, 0.25), rgba(69, 149, 34, 0.25),
    url("landscape.jpg") center/cover;
}
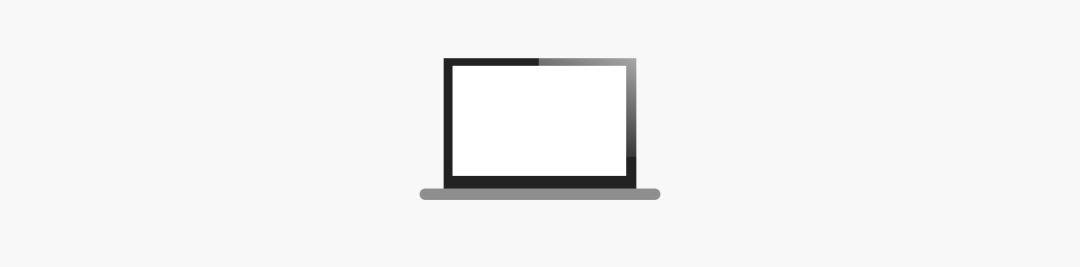
使用CSS绘图 使用CSS渐变绘制的可能性是无限的。您可以使用linear-gradientradial-gradient更多。对于此基本示例,我将解释如何绘制笔记本电脑。
让我们拆卸笔记本电脑,看看我们需要使用什么梯度。
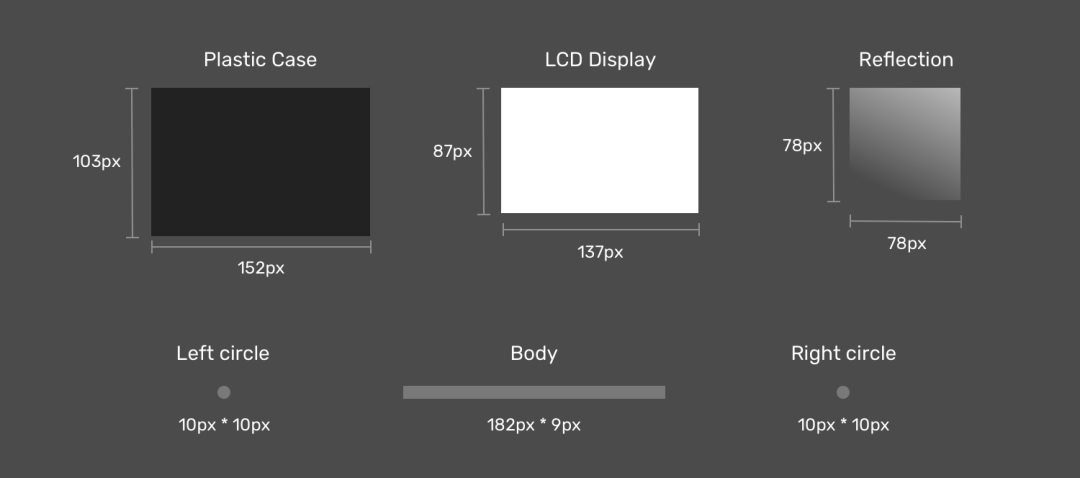
请注意,当分解便携式计算机项目时,现在更容易考虑如何将其实现为多个CSS背景。如果你注意到了,我创建了两个圈充当圆角的身体,因为有做与圆边的梯度没有直接的方法。

接下来是图纸。首先是将每个渐变定义为CSS变量及其大小。我喜欢使用CSS变量,因为它可以减少代码的复杂性,并使代码更简洁,更易于阅读。完成后,我将转到放置它们的步骤。

:root {
  --case: linear-gradient(#222, #222);
  --case-size: 152px 103px;


  --display: linear-gradient(#fff, #fff);
  --display-size: 137px 87px;


  --reflection: linear-gradient(205deg, #fff, rgba(255, 255, 255, 0));
  --reflection-size: 78px 78px;


  --body: linear-gradient(#888, #888);
  --body-size: 182px 9px;


  --circle: radial-gradient(9px 9px at 5px 5.5px, #888 50%, transparent 50%);
  --circle-size: 10px 10px;
}

现在我们定义了渐变及其大小,下一步是放置它们。考虑下图,以获得更好的视觉解释。
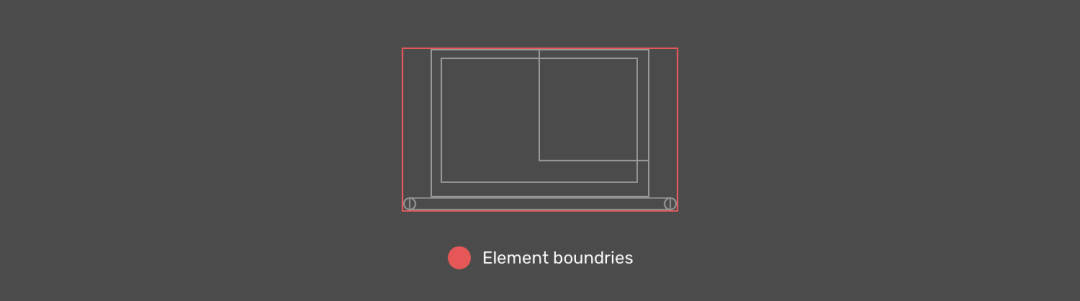
显示反射

如前所述,应该首先定义需要在顶部的元素。在我们的情况下,显示反射应该是第一个渐变。
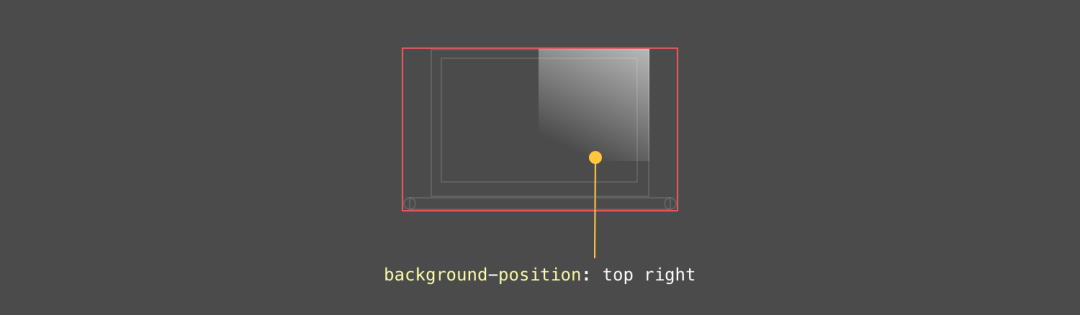
液晶显示器

显示屏位于 x轴的中心,并且位于6pxy轴的位置。
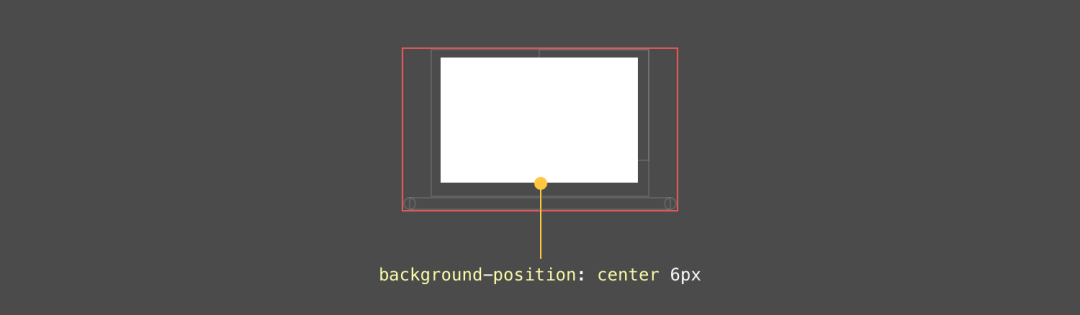
塑料盒

外壳位于显示屏下方,并且位于x轴的中心,并且位于0pxy轴。

身体

那是图形中最有趣的组件。首先,主体是一个矩形,每个侧面(左侧和右侧)有两个圆圈。
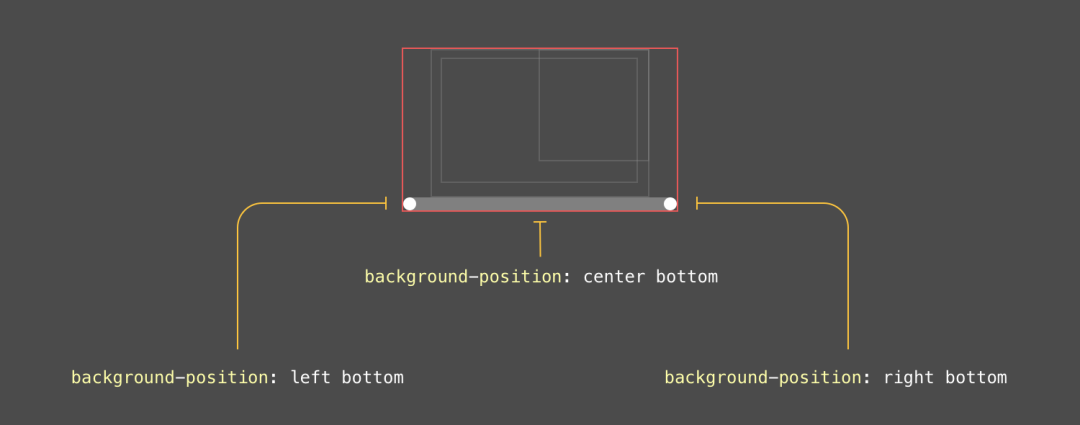
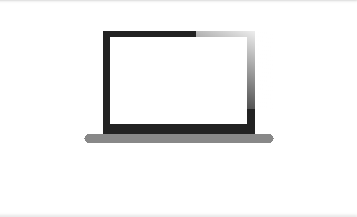
最后结果

:root {
  --case: linear-gradient(#222, #222);
  --case-size: 152px 103px;
  --case-pos: center 0;


  --display: linear-gradient(#fff, #fff);
  --display-size: 137px 87px;
  --display-pos: center 6px;


  --reflection: linear-gradient(205deg, #fff, rgba(255, 255, 255, 0));
  --reflection-size: 78px 78px;
  --reflection-pos: top right;


  --body: linear-gradient(#888, #888);
  --body-size: 182px 9px;
  --body-pos: center bottom;


  --circle: radial-gradient(9px 9px at 5px 5.5px, #888 50%, transparent 50%);
  --circle-size: 10px 10px;
  --circle-left-pos: left bottom;
  --circle-right-pos: right bottom;
}


.cool {
  width: 190px;
  height: 112px;


  background-image: var(--reflection), var(--display), var(--case), var(--circle), var(--circle), var(--body);


  background-size: var(--reflection-size), var(--display-size), var(--case-size), var(--circle-size), var(--circle-size), var(--body-size);


  background-position: var(--reflection-pos), var(--display-pos), var(--case-pos), var(--circle-left-pos), var(--circle-right-pos), var(--body-pos);


  background-repeat: no-repeat;


  /*outline: solid 1px;*/
}
混合多个背景

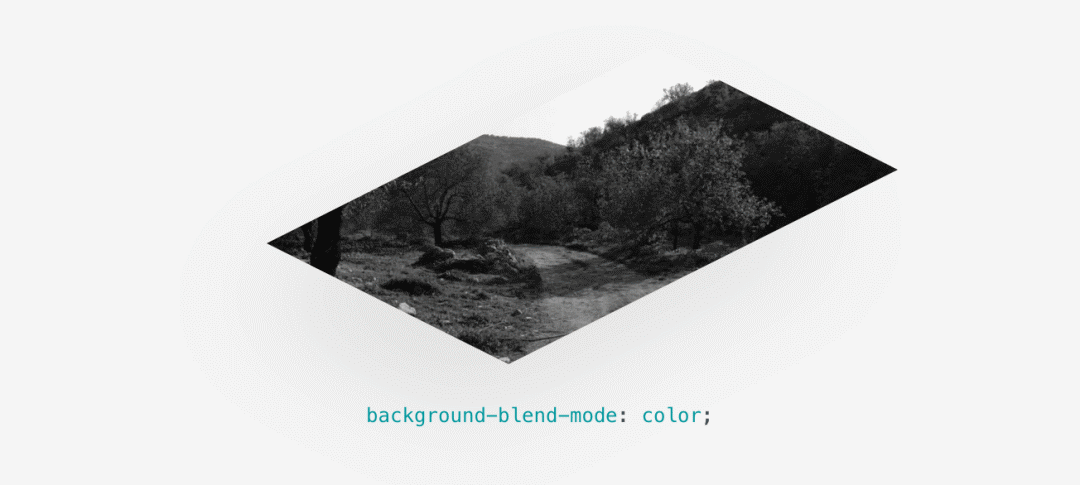
可以混合使用多个背景时会令人兴奋。我可以解释的最简单的用例是使图像去饱和。考虑一下您background-imageCSS中有一个,并且想要将其转换为黑色和白色的需求。

.hero {
  background: linear-gradient(#000, #000),
  url("landscape.jpg") center/cover;
  background-blend-mode: color;
}
翻译原文:ishadeed.com/article/css-multiple-backgrounds

以上就是W3Cschool编程狮关于CSS背景知识,一篇文章带你由浅到深全面理解的相关介绍了,希望对大家有所帮助。

从”算法”角度回答—输入URL后页面呈现发生了什么?

thbcm阅读(296)

文章转载自公众号:前端三元同学

老生常谈的问题,可以另辟蹊径来回答!本文不讲解 URL 输入后发生的网络部分,只从算法角度讲解拿到页面后的解析部分,主要分为以下几个步骤:

  • 构建 DOM
  • 样式计算
  • 生成布局树(Layout Tree)

构建 DOM 树

由于浏览器无法直接理解 HTML字符串 ,因此将这一系列的字节流转换为一种有意义并且方便操作的数据结构,这种数据结构就是DOM树DOM树本质上是一个以document为根节点的多叉树。

那通过什么样的方式来进行解析呢?

HTML文法的本质

首先,我们应该清楚把握一点: HTML 的文法并不是上下文无关文法

这里,有必要讨论一下什么是上下文无关文法

在计算机科学的编译原理学科中,有非常明确的定义:

若一个形式文法G = (N, Σ, P, S) 的产生式规则都取如下的形式:V-&w,则叫上下文无关语法。其中 V∈N ,w∈(N∪Σ)* 。

其中把 G = (N, Σ, P, S) 中各个参量的意义解释一下:

  1. N 是非终结符(顾名思义,就是说最后一个符号不是它, 下面同理)集合。
  2. Σ 是终结符集合。
  3. P 是开始符,它必须属于 N ,也就是非终结符。
  4. S 就是不同的产生式的集合。如 S -> aSb 等等。

通俗一点讲,上下文无关的文法就是说这个文法中所有产生式的左边都是一个非终结符。

看到这里,如果还有一点懵圈,我举个例子你就明白了。

比如:

A -> B

这个文法中,每个产生式左边都会有一个非终结符,这就是上下文无关的文法。在这种情况下,xBy一定是可以规约出xAy的。

我们下面看看看一个反例:

aA -> B
Aa -> B

这种情况就是不是上下文无关的文法,当遇到B的时候,我们不知道到底能不能规约出A,取决于左边或者右边是否有a存在,也就是说和上下文有关。

关于它为什么是非上下文无关文法,首先需要让大家注意的是,规范的 HTML 语法,是符合上下文无关文法的,能够体现它非上下文无关的是不标准的语法。在此我仅举一个反例即可证明。

比如解析器扫描到form标签的时候,上下文无关文法的处理方式是直接创建对应 form 的 DOM 对象,而真实的 HTML5 场景中却不是这样,解析器会查看 form 的上下文,如果这个 form 标签的父标签也是 form, 那么直接跳过当前的 form 标签,否则才创建 DOM 对象。

常规的编程语言都是上下文无关的,而HTML却相反,也正是它非上下文无关的特性,决定了HTML Parser并不能使用常规编程语言的解析器来完成,需要另辟蹊径。

解析算法

HTML5 规范详细地介绍了解析算法。这个算法分为两个阶段:

  1. 标记化。
  2. 建树。

对应的两个过程就是词法分析语法分析

标记化算法

这个算法输入为 HTML文本 ,输出为HTML标记,也成为标记生成器。其中运用有限自动状态机来完成。即在当当前状态下,接收一个或多个字符,就会更新到下一个状态。

<html>
  <body>
    Hello sanyuan
  </body>
</html>

通过一个简单的例子来演示一下标记化的过程。

遇到<, 状态为标记打开

接收[a-z]的字符,会进入标记名称状态

这个状态一直保持,直到遇到>,表示标记名称记录完成,这时候变为数据状态

接下来遇到body标签做同样的处理。

这个时候htmlbody的标记都记录好了。

现在来到<body>中的>,进入数据状态,之后保持这样状态接收后面的字符hello sanyuan

接着接收 </body> 中的<,回到标记打开, 接收下一个/后,这时候会创建一个end tag的token。

随后进入标记名称状态, 遇到>回到数据状态

接着以同样的样式处理 </body>。

建树算法

之前提到过,DOM 树是一个以document为根节点的多叉树。因此解析器首先会创建一个document对象。标记生成器会把每个标记的信息发送给建树器建树器接收到相应的标记时,会创建对应的 DOM 对象。创建这个DOM对象后会做两件事情:

  1. DOM对象加入 DOM 树中。
  2. 将对应标记压入存放开放(与闭合标签意思对应)元素的栈中。

还是拿下面这个例子说:

<html>
  <body>
    Hello sanyuan
  </body>
</html>

首先,状态为初始化状态

接收到标记生成器传来的html标签,这时候状态变为before html状态。同时创建一个HTMLHtmlElement的 DOM 元素, 将其加到document根对象上,并进行压栈操作。

接着状态自动变为before head, 此时从标记生成器那边传来body,表示并没有head, 这时候建树器会自动创建一个HTMLHeadElement并将其加入到DOM树中。

现在进入到in head状态, 然后直接跳到after head

现在标记生成器传来了body标记,创建HTMLBodyElement, 插入到DOM树中,同时压入开放标记栈。

接着状态变为in body,然后来接收后面一系列的字符: Hello sanyuan。接收到第一个字符的时候,会创建一个Text节点并把字符插入其中,然后把Text节点插入到 DOM 树中body元素的下面。随着不断接收后面的字符,这些字符会附在Text节点上。

现在,标记生成器传过来一个body的结束标记,进入到after body状态。

标记生成器最后传过来一个html的结束标记, 进入到after after body的状态,表示解析过程到此结束。

容错机制

讲到HTML5规范,就不得不说它强大的宽容策略, 容错能力非常强,虽然大家褒贬不一,不过我想作为一名资深的前端工程师,有必要知道HTML Parser在容错方面做了哪些事情。

接下来是 WebKit 中一些经典的容错示例,发现有其他的也欢迎来补充。

1.使用</br>而不是<br>

if (t->isCloseTag(brTag) && m_document->inCompatMode()) {
  reportError(MalformedBRError);
  t->beginTag = true;
}

全部换为<br>的形式。

2.表格离散

<table>
  <table>
    <tr><td>inner table</td></tr>
  </table>
  <tr><td>outer table</td></tr>
</table>

WebKit会自动转换为:

<table>
    <tr><td>outer table</td></tr>
</table>
<table>
    <tr><td>inner table</td></tr>
</table>

3.表单元素嵌套

这时候直接忽略里面的form

样式计算

关于CSS样式,它的来源一般是三种:

  1. link标签引用
  2. style标签中的样式
  3. 元素的内嵌style属性

格式化样式表

首先,浏览器是无法直接识别 CSS 样式文本的,因此渲染引擎接收到 CSS 文本之后第一件事情就是将其转化为一个结构化的对象,即styleSheets。

这个格式化的过程过于复杂,而且对于不同的浏览器会有不同的优化策略,这里就不展开了。

在浏览器控制台能够通过document.styleSheets来查看这个最终的结构。当然,这个结构包含了以上三种CSS来源,为后面的样式操作提供了基础。

标准化样式属性

有一些 CSS 样式的数值并不容易被渲染引擎所理解,因此需要在计算样式之前将它们标准化,如em->px,red->#ff0000,bold->700等等。

计算每个节点的具体样式

样式已经被格式化标准化,接下来就可以计算每个节点的具体样式信息了。

其实计算的方式也并不复杂,主要就是两个规则: 继承层叠

每个子节点都会默认继承父节点的样式属性,如果父节点中没有找到,就会采用浏览器默认样式,也叫UserAgent样式。这就是继承规则,非常容易理解。

然后是层叠规则,CSS 最大的特点在于它的层叠性,也就是最终的样式取决于各个属性共同作用的效果,甚至有很多诡异的层叠现象,看过《CSS世界》的同学应该对此深有体会,具体的层叠规则属于深入 CSS 语言的范畴,这里就不过多介绍了。

不过值得注意的是,在计算完样式之后,所有的样式值会被挂在到window.computedStyle当中,也就是可以通过JS来获取计算后的样式,非常方便。

生成布局树

现在已经生成了DOM树DOM样式,接下来要做的就是通过浏览器的布局系统确定元素的位置,也就是要生成一棵布局树(Layout Tree)。

布局树生成的大致工作如下:

  1. 遍历生成的 DOM 树节点,并把他们添加到布局树中
  2. 计算布局树节点的坐标位置。

值得注意的是,这棵布局树值包含可见元素,对于 head标签和设置了display: none的元素,将不会被放入其中。

有人说首先会生成Render Tree,也就是渲染树,其实这还是 16 年之前的事情,现在 Chrome 团队已经做了大量的重构,已经没有生成Render Tree的过程了。而布局树的信息已经非常完善,完全拥有Render Tree的功能。

之所以不讲布局的细节,是因为它过于复杂,一一介绍会显得文章过于臃肿,不过大部分情况下我们只需要知道它所做的工作是什么即可,如果想深入其中的原理,知道它是如何来做的,我强烈推荐你去读一读人人FED团队的文章从Chrome源码看浏览器如何layout布局。

总结

梳理一下这一节的主要脉络:

以上就是W3Cschool编程狮关于从”算法”角度回答—输入URL后页面呈现发生了什么?的相关介绍了,希望对大家有所帮助。
后端接收long类型参数时精度丢失,如何处理这个天坑

thbcm阅读(289)

文章转载自公众号:Java极客技术 作者:鸭血粉丝

最近几天一直在改造工程,采用雪花算法生成主键ID,突然踩到一个天坑,前端 JavaScript 在取 Long 型参数时,参数值有点不太对!

一、问题描述

最近在改造内部管理系统的时候, 发现了一个巨坑,就是前端 JavaScript 在获取后端 Long 型参数时,出现精度丢失!

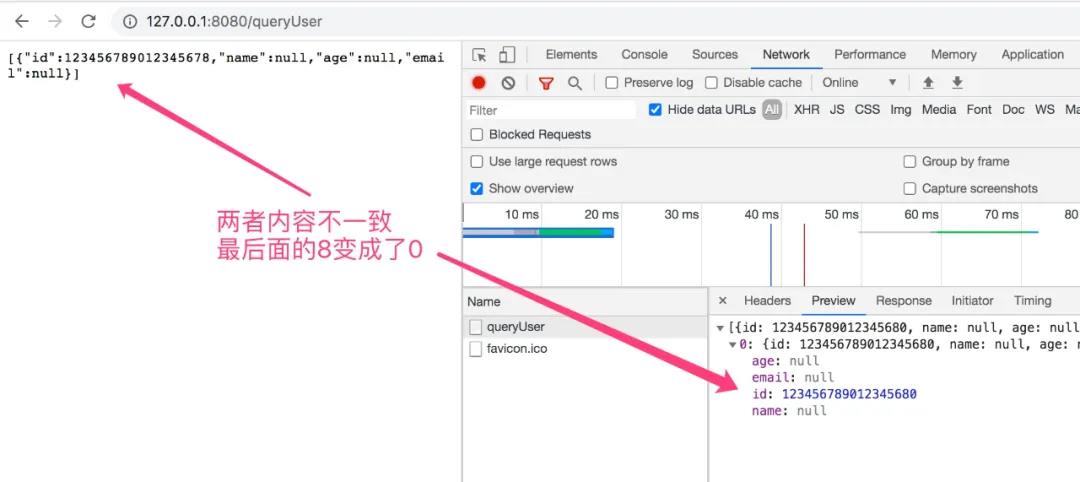
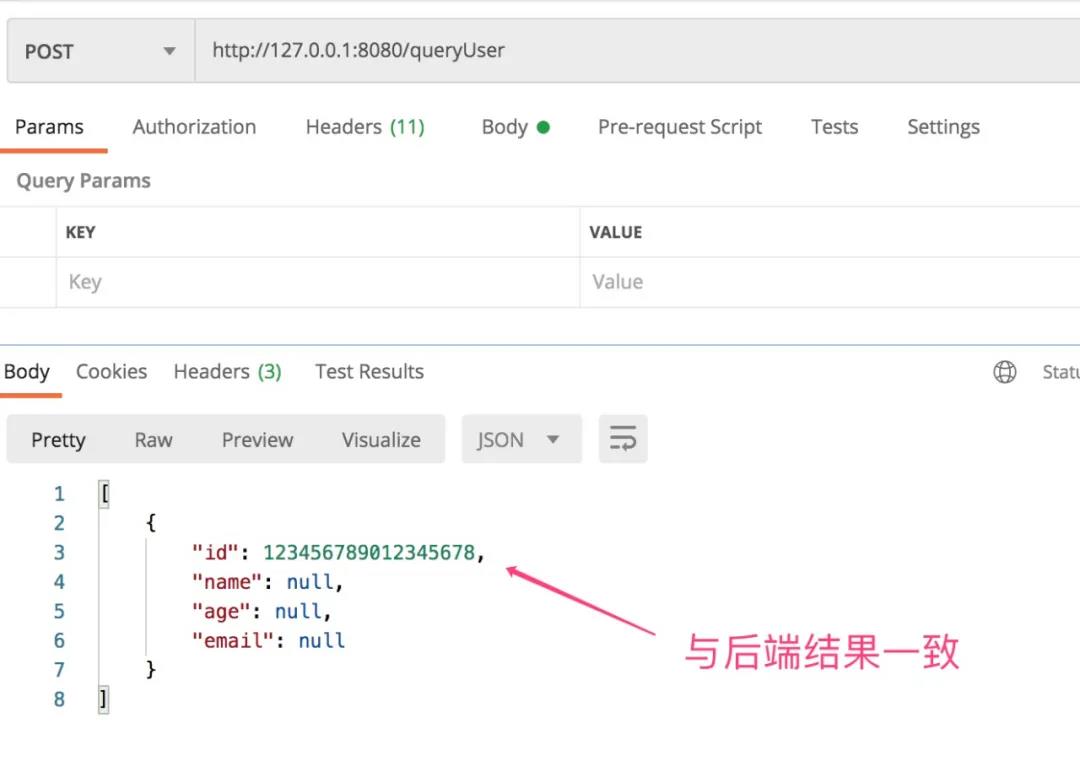
起初,用 postman 模拟接口请求,都很正常,但是用浏览器请求的时候,就出现问题了!

  • 问题复现
@RequestMapping("/queryUser")
public List<User> queryUser(){
    List<User> resultList = new ArrayList<>();
    User user = new User();
    //赋予一个long型用户ID
    user.setId(123456789012345678L);
    resultList.add(user);
    return resultList;
}

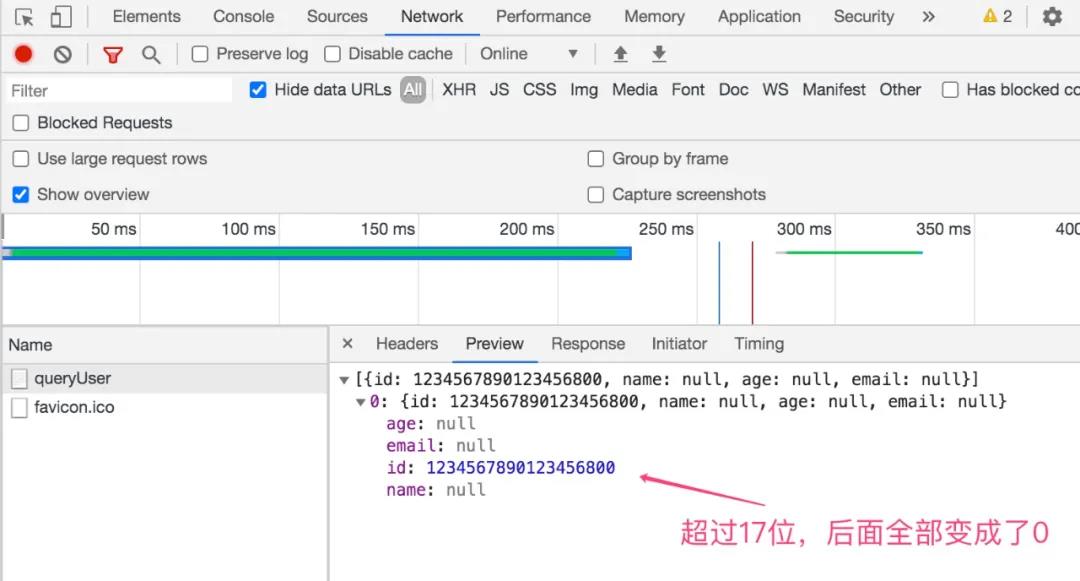
打开浏览器,请求接口,结果如下!

用 postman 模拟接口请求,结果如下!

刚开始的时候,还真没发现这个坑,结果当进行测试的时候,才发现前端传给后端的 ID ,与数据库中存的 ID 不一致,才发现 JavaScript 还有这个天坑!

由于 JavaScriptNumber 类型的自身原因,并不能完全表示 Long 型的数字,在 Long 长度大于17位时会出现精度丢失的问题。

当我们把上面的用户 ID 改成 19 位的时候,我们再来看看浏览器请求返回的结果。

//设置用户ID,位数为19位
user.setId(1234567890123456789l);

浏览器请求结果!

当返回的结果超过17位的时候,后面的全部变成0!

二、解决办法

遇到这种情况,应该怎么办呢?

  • 第一种办法:在后台把 long型改为String类型,但是代价有点大,只要涉及到的地方都需要改
  • 第二种办法:使用工具进行转化把 long 型改为String类型,这种方法可以实现全局转化(推荐)
  • 第三种办法:前端进行处理(目前没有很好的办法,不推荐)

因为项目涉及到的代码非常多,所以不可能把 long 型改为 String 类型,而且使用 Long 类型的方法非常多,改起来风险非常大,所以不推荐使用!

最理想的方法,就是使用aop代理拦截所有的方法,对返回参数进行统一处理,使用工具进行转化,过程如下!

2.1、Jackson 工具序列化对象

我们可以使用Jackson工具包来实现对象序列化。

  • 首先在 maven 中添加必须的依赖
<!--jackson依赖-->
<dependency>
    <groupId>com.fasterxml.jackson.core</groupId>
    <artifactId>jackson-core</artifactId>
    <version>2.9.8</version>
</dependency>
<dependency>
    <groupId>com.fasterxml.jackson.core</groupId>
    <artifactId>jackson-annotations</artifactId>
    <version>2.9.8</version>
</dependency>
<dependency>
    <groupId>com.fasterxml.jackson.core</groupId>
    <artifactId>jackson-databind</artifactId>
    <version>2.9.8</version>
</dependency>

  • 编写一个转化工具类JsonUtil
public class JsonUtil {


    private static final Logger log = LoggerFactory.getLogger(JsonUtil.class);


    private static ObjectMapper objectMapper = new ObjectMapper();
    private static final String DATE_FORMAT = "yyyy-MM-dd HH:mm:ss";


    static {
        // 对象的所有字段全部列入
        objectMapper.setSerializationInclusion(JsonInclude.Include.ALWAYS);
        // 取消默认转换timestamps形式
        objectMapper.configure(SerializationFeature.WRITE_DATES_AS_TIMESTAMPS, false);
        // 忽略空bean转json的错误
        objectMapper.configure(SerializationFeature.FAIL_ON_EMPTY_BEANS, false);
        //设置为东八区
        objectMapper.setTimeZone(TimeZone.getTimeZone("GMT+8"));
        // 统一日期格式
        objectMapper.setDateFormat(new SimpleDateFormat(DATE_FORMAT));
        // 反序列化时,忽略在json字符串中存在, 但在java对象中不存在对应属性的情况, 防止错误
        objectMapper.configure(DeserializationFeature.FAIL_ON_UNKNOWN_PROPERTIES, false);
        // 序列换成json时,将所有的long变成string
        objectMapper.registerModule(new SimpleModule().addSerializer(Long.class, ToStringSerializer.instance).addSerializer(Long.TYPE, ToStringSerializer.instance));
    }


    /**
     * 对象序列化成json字符串
     * @param obj
     * @param <T>
     * @return
     */
    public static <T> String objToStr(T obj) {
        if (null == obj) {
            return null;
        }


        try {
            return obj instanceof String ? (String) obj : objectMapper.writeValueAsString(obj);
        } catch (Exception e) {
            log.warn("objToStr error: ", e);
            return null;
        }
    }


    /**
     * json字符串反序列化成对象
     * @param str
     * @param clazz
     * @param <T>
     * @return
     */
    public static <T> T strToObj(String str, Class<T> clazz) {
        if (StringUtils.isBlank(str) || null == clazz) {
            return null;
        }


        try {
            return clazz.equals(String.class) ? (T) str : objectMapper.readValue(str, clazz);
        } catch (Exception e) {
            log.warn("strToObj error: ", e);
            return null;
        }
    }


    /**
     * json字符串反序列化成对象(数组)
     * @param str
     * @param typeReference
     * @param <T>
     * @return
     */
    public static <T> T strToObj(String str, TypeReference<T> typeReference) {
        if (StringUtils.isBlank(str) || null == typeReference) {
            return null;
        }


        try {
            return (T) (typeReference.getType().equals(String.class) ? str : objectMapper.readValue(str, typeReference));
        } catch (Exception e) {
            log.warn("strToObj error", e);
            return null;
        }
    }
}

  • 紧接着,编写一个实体类Person,用于测试
@Data
public class Person implements Serializable {


    private static final long serialVersionUID = 1L;


    private Integer id;


    //Long型参数
    private Long uid;
    private String name;
    private String address;
    private String mobile;


    private Date createTime;
}

  • 最后,我们编写一个测试类测试一下效果
public static void main(String[] args) {
    Person person = new Person();
    person.setId(1);
    person.setUid(1111L);
    person.setName("hello");
    person.setAddress("");
    System.out.println(JsonUtil.objToStr(person));
}

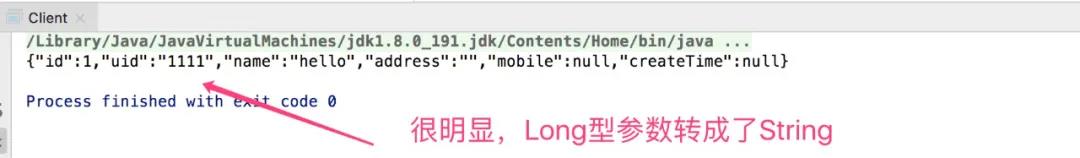
输出结果如下:

其中最关键一行代码,是注册了这个转换类,从而实现将所有的 long 变成 string

// 序列换成json时,将所有的long变成string
SimpleModule simpleModule = new SimpleModule();
simpleModule.addSerializer(Long.class, ToStringSerializer.instance);
simpleModule.addSerializer(Long.TYPE, ToStringSerializer.instance);
objectMapper.registerModule(simpleModule);

如果想对某个日期进行格式化,可以全局设置。

//全局统一日期格式
objectMapper.setDateFormat(new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"));

也可以,单独对某个属性进行设置,例如对createTime属性格式化为yyyy-MM-dd,只需要加上如下注解即可。

@JsonFormat(pattern="yyyy-MM-dd", timezone="GMT+8")
private Date createTime;

工具转化类写好之后,就非常简单了,只需要对 aop 拦截的方法返回的参数,进行序列化就可以自动实现将所有的 long变成 string

2.2、SpringMVC 配置

如果是 SpringMVC 项目,操作也很简单。

  • 自定义一个实现类,继承自ObjectMapper
package com.example.util;


/**
 * 继承ObjectMapper
 */
public class CustomObjectMapper extends ObjectMapper {


    public CustomObjectMapper() {
        super();
        SimpleModule simpleModule = new SimpleModule();
        simpleModule.addSerializer(Long.class, ToStringSerializer.instance);
        simpleModule.addSerializer(Long.TYPE, ToStringSerializer.instance);
        registerModule(simpleModule);
    }
}

  • 在 SpringMVC 的配置文件中加上如下配置
<mvc:annotation-driven >
    <mvc:message-converters>
        <bean class="org.springframework.http.converter.StringHttpMessageConverter">
            <constructor-arg index="0" value="utf-8" />
            <property name="supportedMediaTypes">
                <list>
                    <value>application/json;charset=UTF-8</value>
                    <value>text/plain;charset=UTF-8</value>
                </list>
            </property>
        </bean>          
        <bean class="org.springframework.http.converter.json.MappingJackson2HttpMessageConverter">
            <property name="objectMapper">
                <bean class="com.example.util.CustomObjectMapper">
                    <property name="dateFormat">
                        <-对日期进行统一转化->
                        <bean class="java.text.SimpleDateFormat">
                            <constructor-arg type="java.lang.String" value="yyyy-MM-dd HH:mm:ss" />
                        </bean>
                    </property>
                </bean>
            </property>
        </bean>
    </mvc:message-converters>
</mvc:annotation-driven>

2.3、SpringBoot 配置

如果是 SpringBoot 项目,操作也类似。

  • 编写一个WebConfig配置类,并实现自WebMvcConfigurer,重写configureMessageConverters方法
/**
 * WebMvc配置
 */
@Configuration
@Slf4j
@EnableWebMvc
public class WebConfig implements WebMvcConfigurer {


    /**
     *添加消息转化类
     * @param list
     */
    @Override
    public void configureMessageConverters(List<HttpMessageConverter<?>> list) {
        MappingJackson2HttpMessageConverter jsonConverter = new MappingJackson2HttpMessageConverter();
        ObjectMapper objectMapper = jsonConverter.getObjectMapper();
        //序列换成json时,将所有的long变成string
        SimpleModule simpleModule = new SimpleModule();
        simpleModule.addSerializer(Long.class, ToStringSerializer.instance);
        simpleModule.addSerializer(Long.TYPE, ToStringSerializer.instance);
        objectMapper.registerModule(simpleModule);
        list.add(jsonConverter);
    }
}

三、总结

在实际的项目开发中,很多服务都是纯微服务开发,没有用到SpringMVC,在这种情况下,使用JsonUtil工具类实现对象序列化,可能是一个非常好的选择。

如果有理解不对的地方,欢迎网友批评指出!

以上就是W3Cschool编程狮关于后端接收long类型参数时精度丢失,如何处理这个天坑的相关介绍了,希望对大家有所帮助。
CSS布局–CC中不可忽视的部分

thbcm阅读(269)

文章转载自公众号:小丑的小屋

前言

CSS 布局是一个前端必备的技能, HTML 如果说是结构之美, CSS 就是视觉之美可以给用户不一样的体验的效果和视觉冲击。如果一个大方美观的布局,用户第一眼看到会很舒服,不仅提高了用户的视觉效果也提高了用户的体验效果。随着现在设备种类的增多,各种大小不一,奇形怪状的设备使得前端开发的压力不断增大,越来越多的UI框架层出不群,我们就会忽略了最基本的 CSS, 下面总结了一些经常用到的 CSS 布局,一起学习和进步。

单列布局

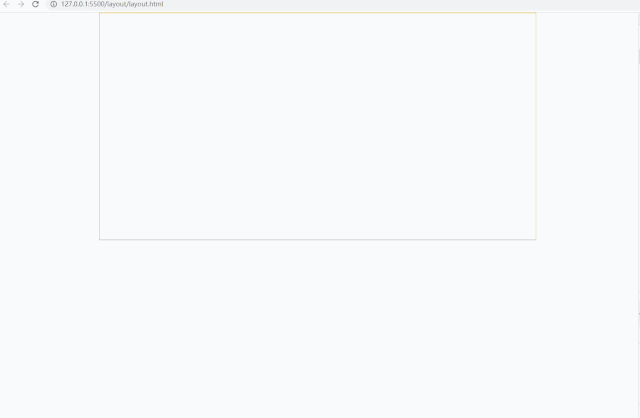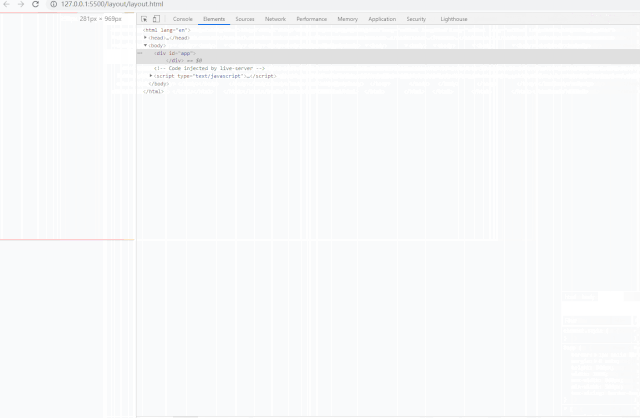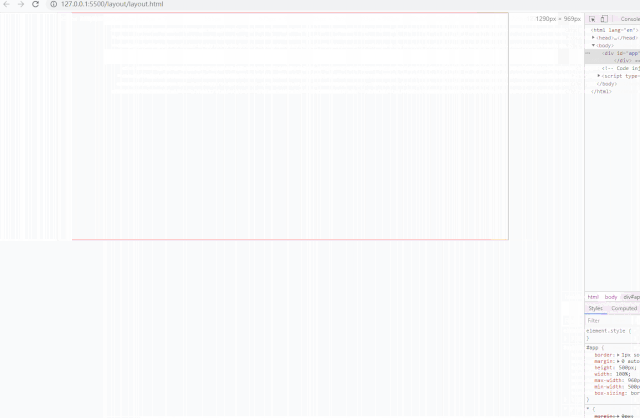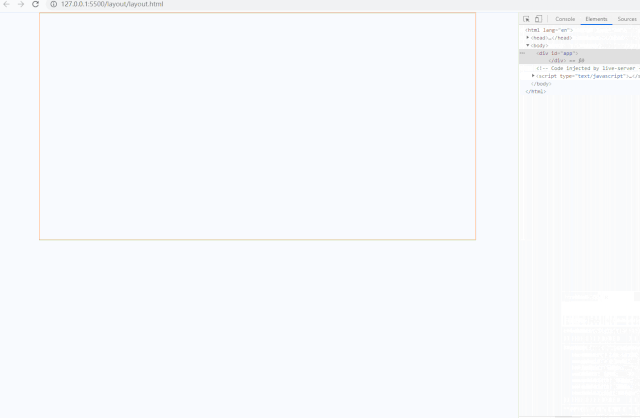
单列布局是最常见也是最常用的布局方式,一般设置一个最大或者最小的宽度和居中就可以实现了。

<div id="app"></div>
#app{
    border:1px solid red;
    margin:0 auto;
    height: 500px;
    width: 100%;
    max-width: 960px;
    min-width: 500px;
    box-sizing: border-box;
}

两列布局

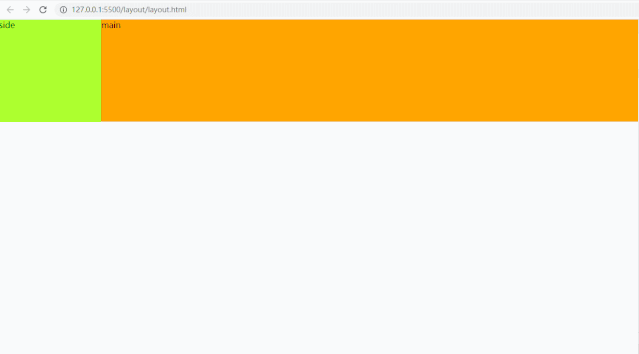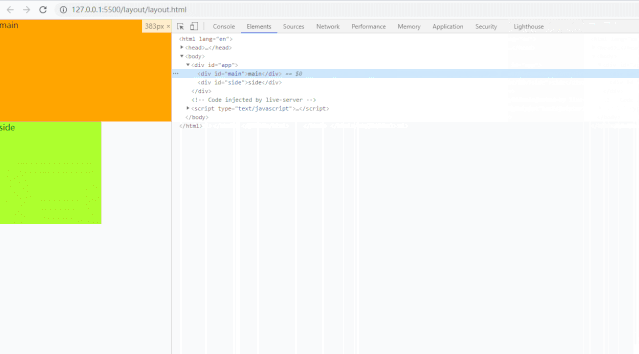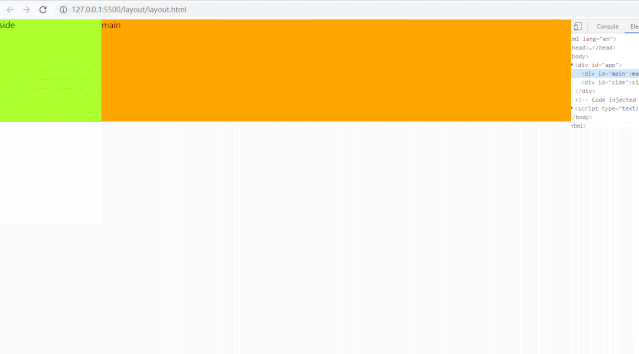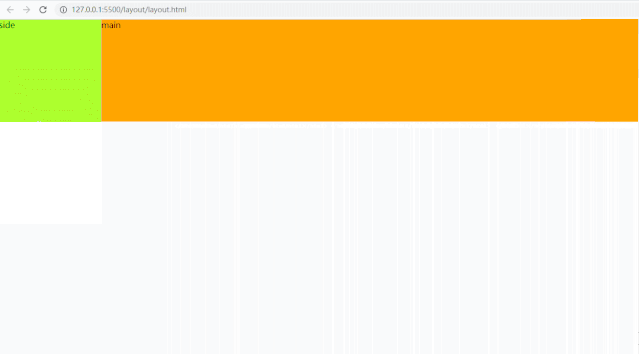
两列布局将页面分割成左右宽度不一样的两部分,一般情况下都是左边宽度固定,右边宽度撑满剩余宽度,常用于api网站后台管理系统。这种布局当屏幕缩小的时候,或者宽度不够的时候,右边撑满的部分就变成了单列布局,左边的部分改为垂直方向的显示或者隐藏。

<div id="app">
    <div id="main">main</div>
    <div id="side">side</div>
</div>
#main{
    background:orange;
    flex:1;
}
#side{
    width:200px;
    background:greenyellow;
}
#main,#side{
    height: 200px;
}
#app{
    display: flex;
    flex-direction:row-reverse;
    flex-wrap: wrap;
}
@media only screen and (max-width:1000px){
    #app{
        flex-direction: row;
    }
    #main{
        flex:100%;
    }
}

三列布局

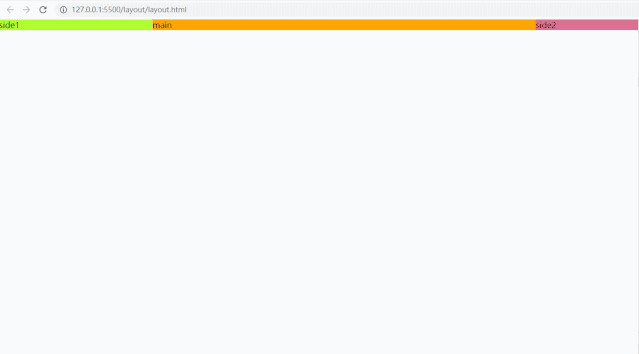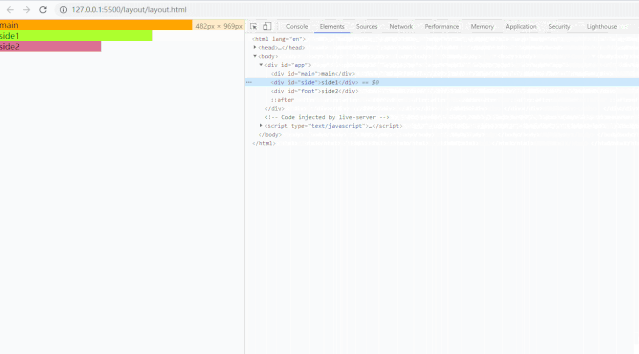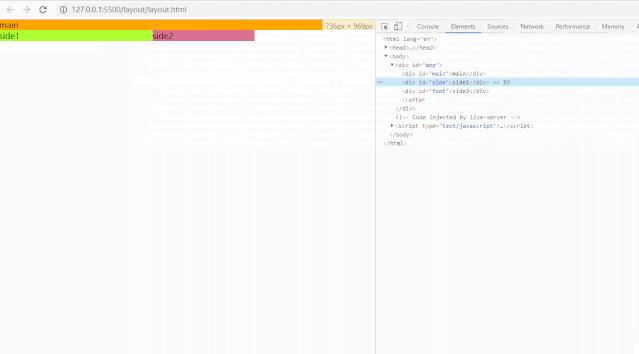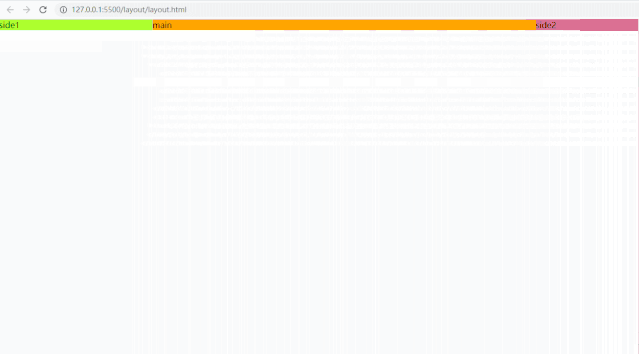
三列布局是将页面分为左中右水平方向的三个部分比如github。也有可能是水平方向上的两列布局中右边撑满的部分嵌套一个两列布局组成。

  • 圣杯布局
<div id="app">
    <div id="main">main</div>
    <div id="side">side1</div>
    <div id="foot">side2</div>
</div>
*{
    margin:0px;
    padding:0px;
}
#app{
    padding:0px 200px 0px 300px;
}
#app::after{
    content: "";
    display: block;
    clear: both;
}
#main,#side,#foot{
    float: left;
}
#main{
    background:orange;
    width:100%;
}
#side{
    background:greenyellow;
    width: 300px;
    position: relative;
    margin-left:-100%;
    left: -300px;
}
#foot{
    background:palevioletred;
    width: 200px;
    position: relative;
    margin-left:-200px;
    right:-200px;


}
@media only screen and (max-width:1000px){
    #app{
        padding:0px;
    }
   #side{
      margin-left:0px;
      left:0px;
   }
   #foot{
    margin-left:0px;
    right:0px;
 }
}

  • 双飞翼布局
<div id="app">
    <main>
        <div id="container">main</div>
    </main>
    <header>header</header>
    <footer>footer</footer>
</div>
*{
    margin:0px;
    padding:0px;
}
#app::after{
    content: "";
    display: block;
    clear: both;
}
main,header,footer{
    float: left;
}
main{
    background:orange;
    width: 100%;
}
header{
    background:greenyellow;
    width: 300px;
    margin-left: -100%;
}
footer{
    background:palevioletred;
    width: 200px;
    margin-left: -200px;
}
#container{
    margin: 0px 200px 0px 300px;
}
@media only screen and (max-width:1000px){
   header{
      margin-left:0px;
   }
   footer{
    margin-left:0px;
 }
}

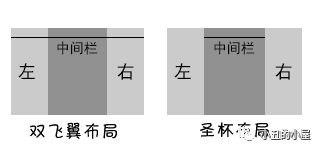
  • 圣杯和双飞翼的区别见下图

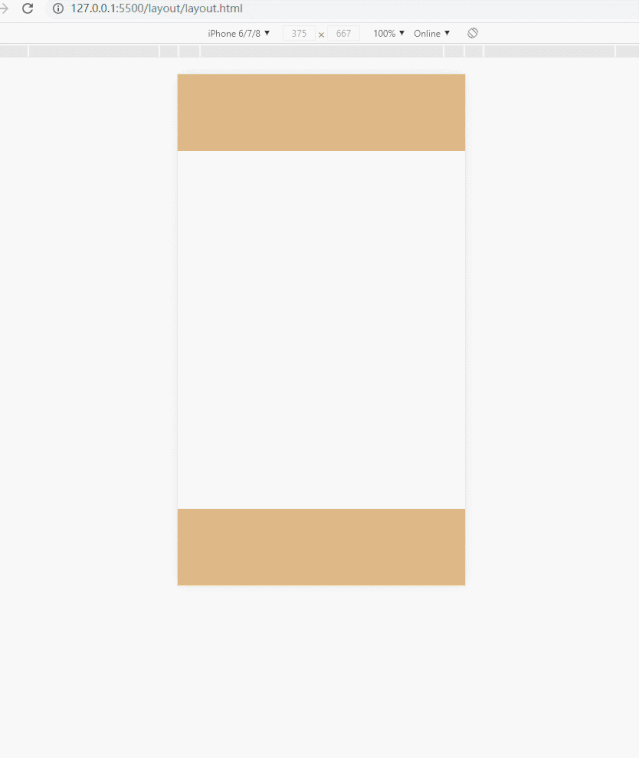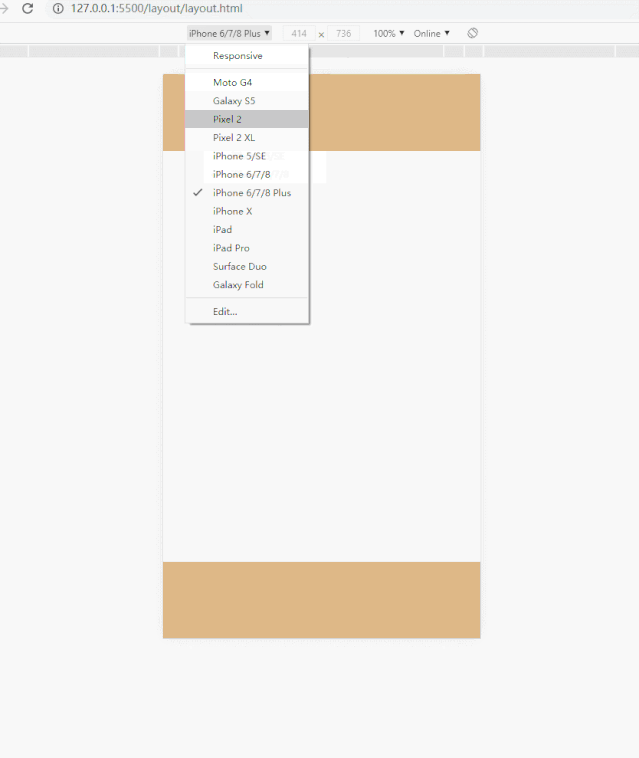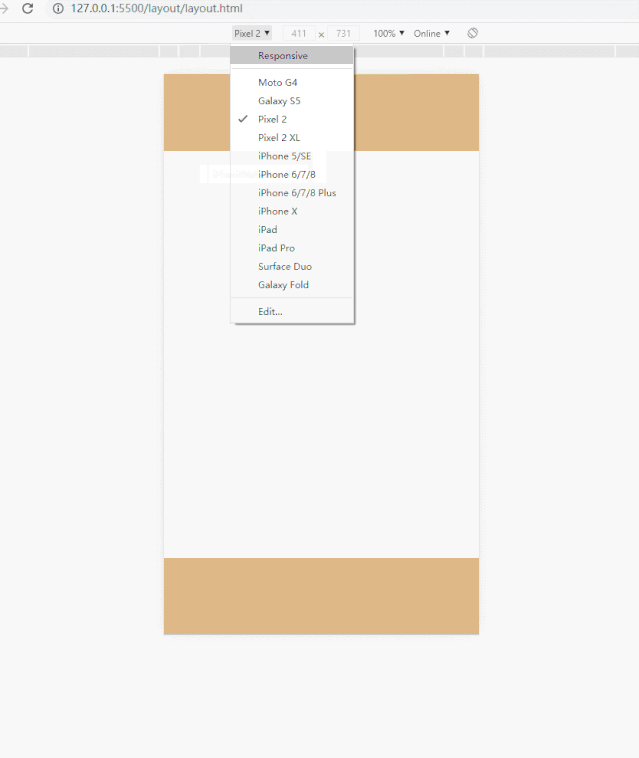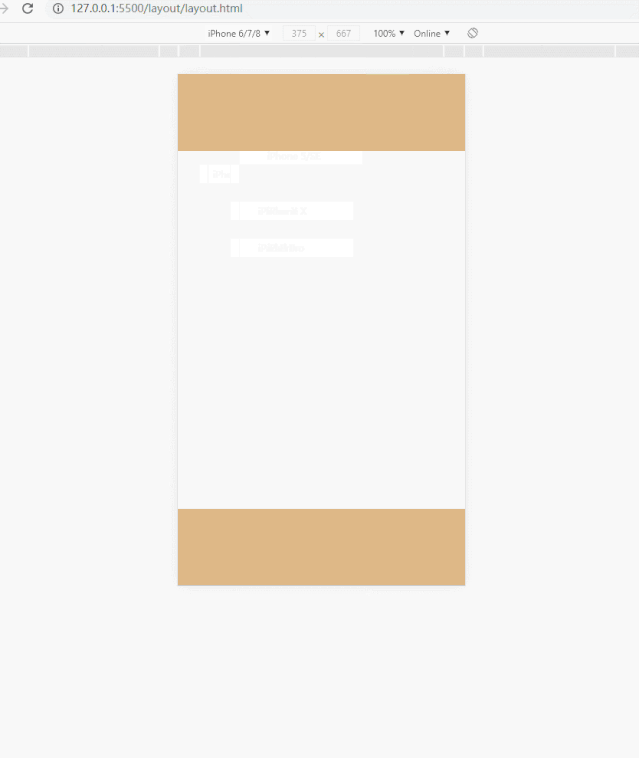
还有一种布局是垂直方向上的分为上中下三个部分,上和下两部分固定高度,中间部分高度不定,当页面高度小于浏览器高度时,下部分应该固定在浏览器的底部,但是当页面的高度超出浏览器高度的时候,下部分应该随中间部分被撑开,显示在页面的最底部即sticky footer

  • 传统布局的方法

headermain放到一个容器中,让容器的高度撑满整个屏幕,下面预留出一定的高度,给footer设置外边距使它插入到容器底部实现功能。

<div id="app">
    <header></header>
    <main>
        <div id="container"></div>
    </main>
</div>
<footer></footer>
*{
    margin:0px;
    padding:0px;
}
#app{
    box-sizing: border-box;
    min-height: 100vh;
    padding-bottom: 100px;
}


header,footer{
    height: 100px;
    background: burlywood;
}
main{
    background: cadetblue;
}
footer{
    margin-top:-100px ;
}

  • flex布局

父级app使用flex布局高度撑满容器,让子容器垂直排列,headerfooter设置固定高度,让main撑满剩余的容器

<div id="app">
    <header></header>
    <main>
        <div id="container"></div>
    </main>
    <footer></footer>
</div>
*{
    margin:0px;
    padding:0px;
}
#app{
    display: flex;
    flex-direction: column;
    height: 100%;
}


header,footer{
    background: burlywood;
    height: 100px;
}
main{
    background: cadetblue;
    flex: 1;
}

这里有的面试会问到flex:1的原理是什么?**flex**是flex-grow, flex-shrinkflex-basis的缩写

flex-grow:1; //放大比例
flex-shrink:1;  //  缩小比例
flex-basis;0%;  // 分配剩余空间

  • grid布局

grid布局就一句话,设置第一行和最后一行高为固定值,中间部分由浏览器自己决定长度

<div id="app">
    <header></header>
    <main>
        <div id="container"></div>
    </main>
    <footer></footer>
</div>
*{
    margin:0px;
    padding:0px;
}
#app{
    display: grid;
    height: 100%;
    grid-template-rows:100px auto 100px;
}


header,footer{
    background: burlywood;
}
main{
    background: cadetblue;
}

总结

经典永远都是经典,框架再多选择再多,基础永远是我们需要掌握的,所谓万变不离其中,有了这些基础知识我们只需要灵活的运用即可

  • 1.首先将我们需要布局的大框架写出来,即页面容器的主层次,一般主容器放到次容器的上面。
  • 2.将布局容器进行水平排列。
  • 3.设置容器的宽度。
  • 4.消除布局的副作用,比如浮动造成的高度塌陷。
  • 5.为了适配不同机型,通过媒体查询进行优化。

以上就是W3Cschool编程狮关于CSS布局–CC中不可忽视的部分的相关介绍了,希望对大家有所帮助。
Java是值传递还是引用传递?有图为证

thbcm阅读(268)

文章转载自公众号:Java中文社群 作者:磊哥

开篇先来曝答案,在 Java 语言中,本质只有值传递,而无引用传递,解释和证明详见正文。

说到值传递和引用传递我们不得不提到两个概念:值类型和引用类型。

1.值类型

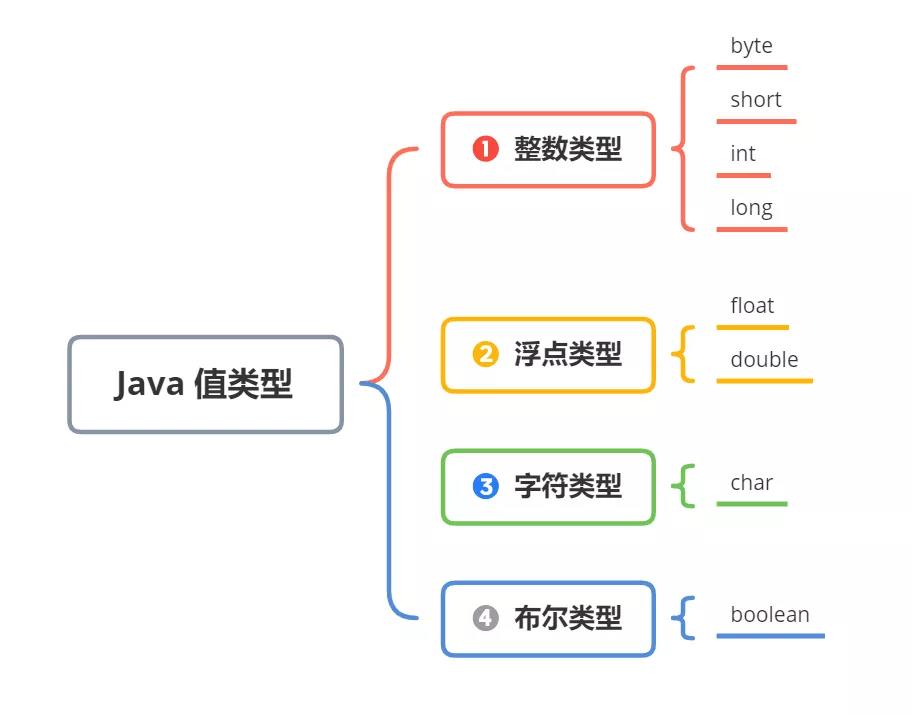
通俗意义上来说,所谓的值类型指的就是 Java 中的 8 大基础数据类型:

  • 整数型:byte、int、short、long
  • 浮点型:float、double
  • 字符类型:char
  • 布尔类型:boolean

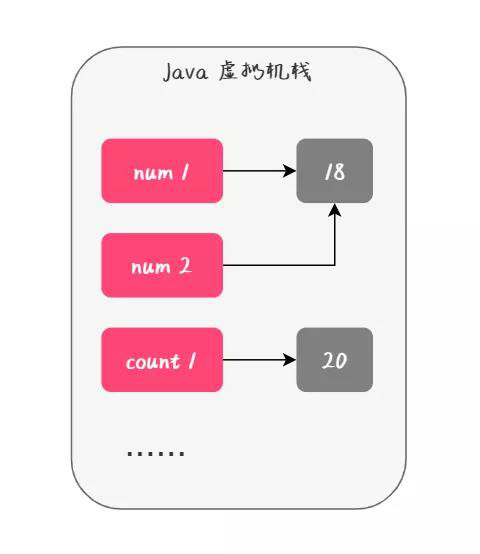
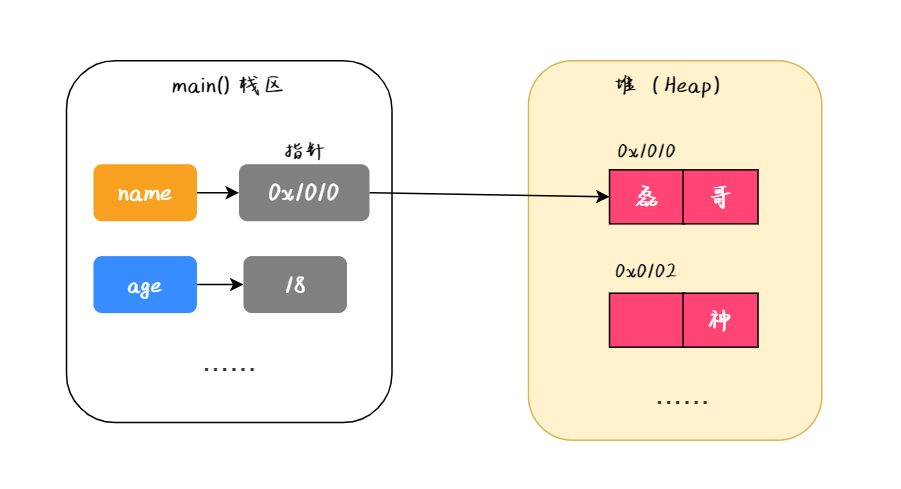
从 JVM 层面来讲:所谓的值类型指的是在赋值时,直接在栈中(Java 虚拟机栈)生成值的类型,如下图所示:

2.引用类型

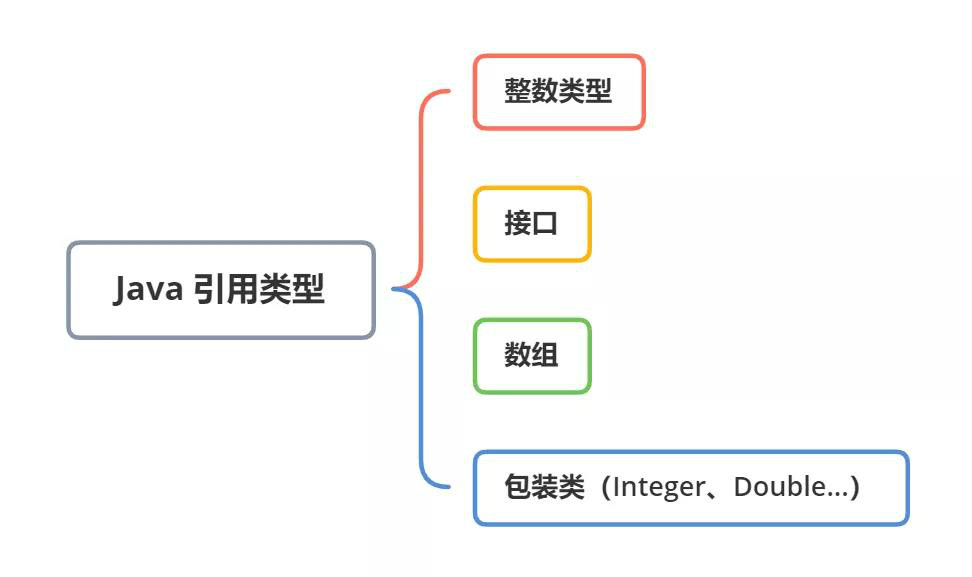
引用类型是指除值类型之外的数据类型,比如:

  • 接口
  • 数组
  • 字符串
  • 包装类(Integer、Double…)

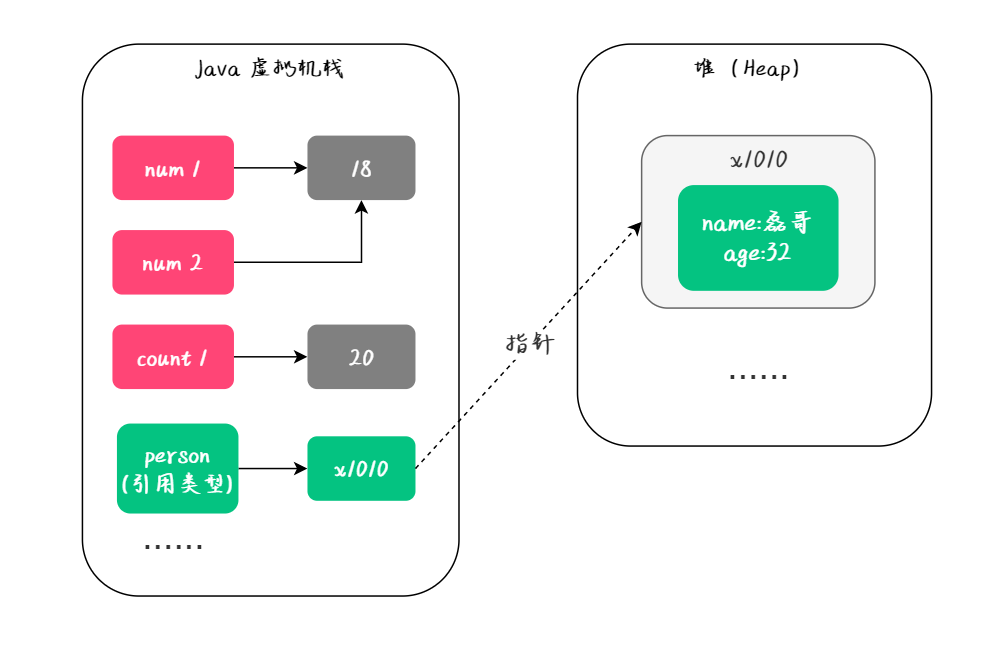
从 JVM 的层面来讲,所谓的引用类型是指,在初始化时将引用生成栈上,而值生成在堆上的这些数据类型,如下图所示:

3.值传递

值传递(Pass By Value)指的是方法传参时,传递的是原内容的副本,因此对副本进行如何修改都不会影响原内容。

实现代码如下:

public class PassTest {
    public static void main(String[] args) {
        int age = 18;
        System.out.println("调用方法前:" + age);
        intTest(age);
        System.out.println("调用方法后:" + age);
    }


    private static void intTest(int age) {
        age = 30;
        System.out.println("方法中修改为:" + age);
    }
}

程序的执行结果为:

调用方法前:18

方法中修改为:30

调用方法后:18

从上述结果可以看出,在方法中修改参数并未影响原内容,我们把这种传参方式称之为值传递。

4.引用传递

引用传递(Pass By Reference)指的是方法传参时,传递的是参数本身,因此对参数进行任意修改都会影响原内容。

模拟“引用传递”的实现代码如下:

public class PassTest {
    public static void main(String[] args) {
        char[] name = {'编程', '师'};
        System.out.println("调用方法前:" + new String(name));
        paramTest(name);
        System.out.println("调用方法后:" + new String(name));
    }
    private static void paramTest(char[] n) {
        n[1] = '狮';
        System.out.println("方法中修改为:" + new String(n));
    }
}

程序的执行结果为:

调用方法前:编程师

方法中修改为:编程狮

调用方法后:编程狮

从上述的结果可以看出在 paramTest 方法中修改了参数之后,在 main 方法中再打印参数时,发现参数的值也跟着发生了改变,那么似乎我们可以得出结论,Java 中貌似也有“引用传递”,然而实事并如此,我们接着看。

5.真假“引用传递”

我们给上面的代码添加一行,如下所示:

public class PassByValue {
    public static void main(String[] args) {
        char[] name = {'磊', '哥'};
        System.out.println("调用方法前:" + new String(name));
        paramTest(name);
        System.out.println("调用方法后:" + new String(name));
    }
    private static void paramTest(char[] n) {
        n = new char[2]; // 添加此行代码
        n[1] = '神';
        System.out.println("方法中修改为:" + new String(n));
    }
}

程序的执行结果为:

调用方法前:磊哥

方法中修改为:神

调用方法后:磊哥

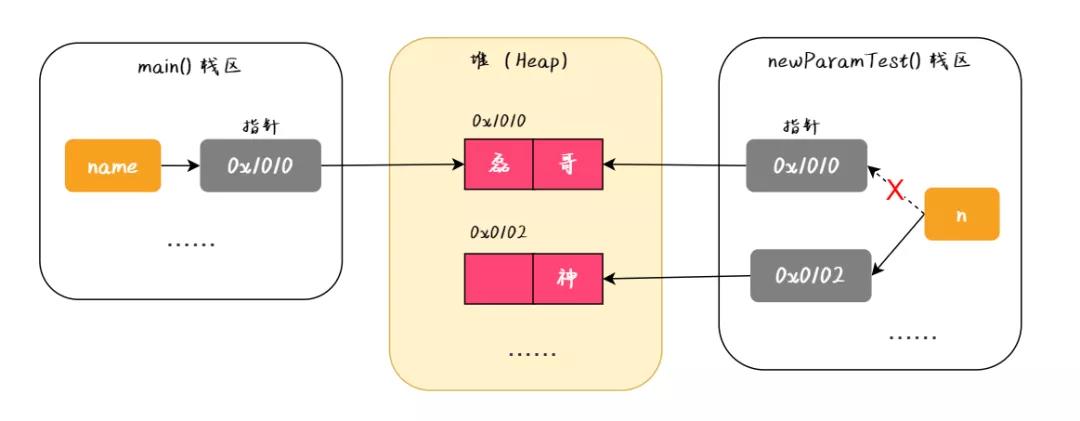
从上述结果可以看出,当我们在 paramTest 方法中添加 new char[]之后,“引用传递”就突然变值传递了?为什么?

这是因为,在 Java 语言中本质上只有值传递,也就说 Java 的传参只会传递它的副本,并不会传递参数本身。

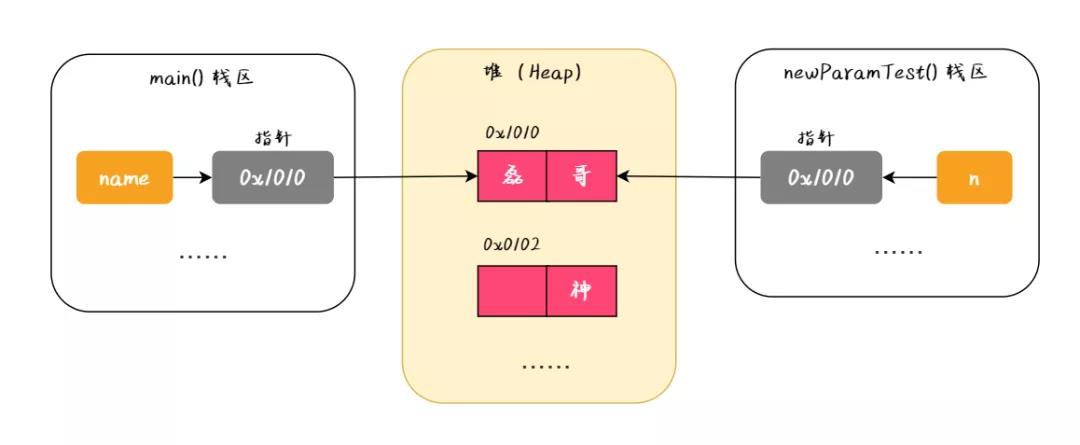
前面那个带引号的“引用传递”其实只是传递了它的引用副本,如下图所示:

PS:《Java虚拟机规范》中对 Java 堆的描述是:“所有的对象实例以及数组都应当在堆上分配”。

所以我们在调用 new char[] 之后,可以看出 n 对象有了新地址,而原内容并未被修改,如果按照引用传递的思路来看的话,不管执行任何方式的修改都会改变原内容,因此我们可以更加确认 Java 语言中只有值传递,如下图所示:

总结

通过本文的内容,我们可以得出:在 Java 语言中只有值传递,方法传参时只会传递副本信息而非原内容。我们还知道了基础数据类型会直接生成到栈上,而对象或数组则会在栈和堆上都生成信息,并将栈上生成的引用,直接指向堆中生成的数据,如下图所示:

以上就是W3Cschool编程狮关于Java是值传递还是引用传递?有图为证的相关介绍了,希望对大家有所帮助。
一个CSS属性让你页面渲染速度提升数倍

thbcm阅读(298)

文章转载自公众号:code秘密花园

浏览器在接收到服务端返回的 HTML 之后,需要把这段数据渲染成用户看到的页面,在开始渲染第一个元素之前可能还需要经过很多步骤。这个过程会适用于整个页面,包括当前不可见的内容。

所以在首屏渲染时,是有很大一部分时间花费在用户不可见的内容上,实际上这部分数据我们没必要在首屏就把它们渲染出来。

Chrome 85 新推出的 content-visibility: auto 就是为了解决上面的问题,它可以告诉浏览器暂时跳过该元素的布局和渲染工作,直到这个元素滚动到当前视口,从而可以加快整个页面的初始渲染,并且缩短用户和页面可交互需要花费的时间。

CSS Containment

content-visibility 依赖于 CSS Containement,目前只能在 Chromium 85 中支持 content-visibility 属性,但是大多数浏览器都支持 CSS Containement

CSS Containment 是一种规范,它的主要目的就是在页面渲染的过程中通过忽略文档中的某些子树来提高页面的渲染性能。

上面我们提到,在首屏渲染时,是有很大一部分时间花费在用户不可见的内容上,实际上这部分数据我们没必要在首屏就把它们渲染出来。作为开发者,肯定很清楚当前修改的元素是否独立或者影响其他元素。因此如果开发者能把这个信息通过 CSS 告诉浏览器,那么浏览器就不需要再去考虑其他元素了。CSS Containment 模块中提供的 contain 属性就为我们提供了这种能力。

css contain 一共有四个属性:

  • size: 在计算该元素盒子大小的时候会忽略其子元素
  • layout: 元素的内部布局不受外部影响,同时该元素以及其内容也不会影响到上级
  • style: 声明同时会影响这个元素和其子孙元素的属性,都在这个元素的包含范围内
  • paint: 声明这个元素的子孙节点不会在它边缘外显示。如果一个元素在视窗外或因其他原因导致不可见,则同样保证它的子孙节点不会被显示。

content-visibility

css contain 是一个很棒的属性,但是我们不太容易判断要选取它的哪个值。现在,我们可以直接应用 content-visibility 来达到这样的效果,但是配置却简单的多。

content-visibility 属性也有多个值,但是 auto 这个值是一个可以立刻提高性能的属性:

.my-class {
  content-visibility: auto;
}

如果一个元素具有 auto 这个属性,如果当前元素没有出现在屏幕上,浏览器就不会渲染它和它的子元素;当元素接近用户的可视区域时,浏览器就会解除限制,并开始进行渲染;这可以保证元素会及时被用户看到。

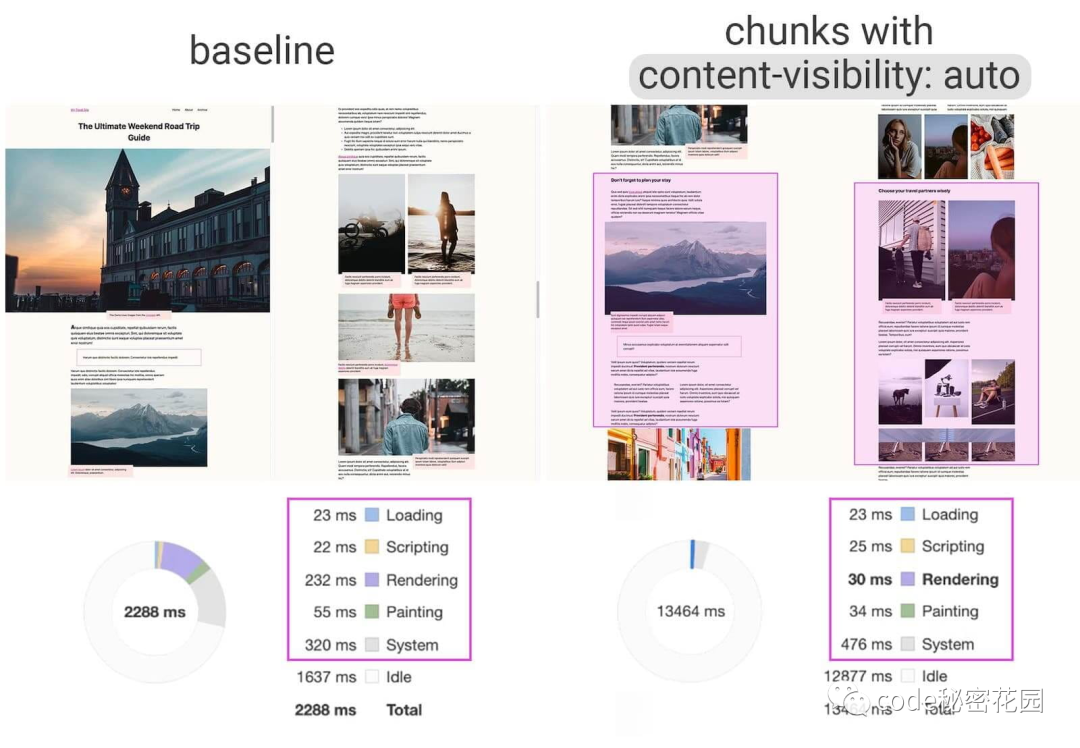
看看上面的例子,在将 content-visibility: auto 设置到一些小的模块之后,渲染时间直接从232ms提升到了30ms,性能提升了7倍。

contain-intrinsic-size

如果我们给可视区域外的元素增加了 content-visibility: auto 属性,那么当滚动条滚动到这个元素之后,如果这个元素很大有一定高度,那么滚动条的长度就会发生变化,页面可能就会发生抖动的现象。

解决这个问题,可以先使用 contains-intrinsic-size 提前给元素设置自然高度的大小,比如 1000px ,这样元素提前占用了一些高度,就不会发生抖动现象。

以上就是W3Cschool编程狮关于一个CSS属性让你页面渲染速度提升数倍的相关介绍了,希望对大家有所帮助。
JVM字符串常量池及String的intern方法详解?

thbcm阅读(344)

文章转载自公众号:程序新视界

本篇文章基于字符串常量池的存储及在使用 intern方法 时所引起的内存变化进行一步深层次的讲解。

重点内容:当字符串调用 intern方法 方法后,再进行字符串的比较,会发生什么变化?

本文内容均以HotSpot虚拟机为基础讲解。

面试题

先通过一个面试题形象的了解一下我们本篇文章要讲的内容的呈现形式:

String s1 = new String("he") + new String("llo");
String s2 = new String("h") + new String("ello");


String s3 = s1.intern();
String s4 = s2.intern();
System.out.println(s1 == s3);
System.out.println(s1 == s4);

执行上面的代码,会发现打印的结果都是 true 。那么,为什么本来不相等的字符串,调用了intern方法之后便相等了呢?下面我们就来逐步分析这其中的底层实现。

intern方法的作用

intern()方法的功能定义:

(1)如果当前字符串内容存在于字符串常量池(即equals()方法为true,也就是内容一样),那直接返回此字符串在常量池的引用;

(2)如果当前字符串不在字符串常量池中,那么在常量池创建一个引用并指向堆中已存在的字符串,然后返回常量池中的引用。

简单说intern方法就是判断并将字符串是否存在于字符串常量池,如果不存在则创建,存在则返回。

字符串常量池

HotSpot中实现字符串常量池功能的是一个StringTable类,它是一个Hash表,默认值大小长度是1009。在每个HotSpot虚拟机的实例中只有一份,被所有的类共享。字符串常量由一个个字符组成,放在了StringTable上。

JDK6及之前版本,字符串常量池是放在Perm Gen区(方法区)中。StringTable的长度是固定的,长度是1009,当String字符串过多时会造成hash冲突,导致链表过长,性能大幅度下降。此时字符串常量池里面放的全部是字符串常量(字面值)。

由于永久代的空间有限且固定,JDK6的存储模式很容易造成OutOfMemoryError

JDK7时正在着手去永久代的工作,因此字符串常量池被放在了堆中。此时,即使堆的大小也是固定的,但对于应用调优工作,只需要调整堆大小就行了。

JDK7中字符串常量池不仅仅可以存放字符串常量,还可以存放字符串的引用。也就是说,堆中的字符串的引用可以作为常量池的值而存在。

字符串池化流程分析

在了解了上面的基础理论,我们下面以图文相结合的形式来逐步演示字符串池化的流程和分类。以下实例以JDK8版本为基础来进行分析讲解。

当我们通过双引号声明一个字符串:

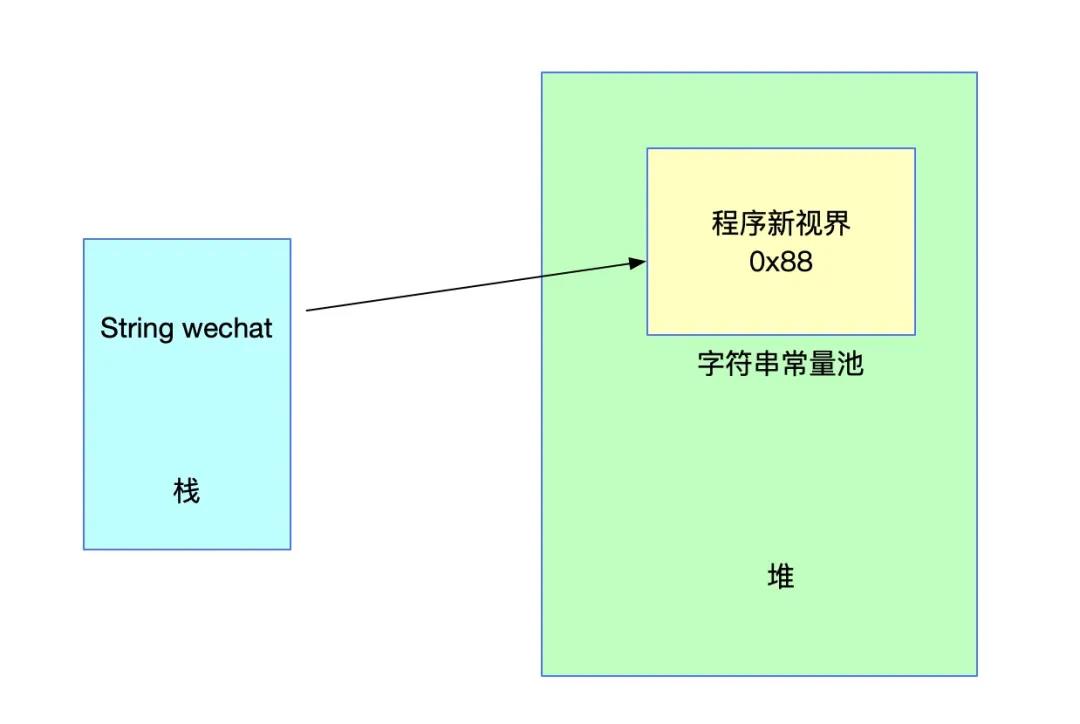
String wechat = "程序新视界";

此时,双引号内的字符串会被直接存储在字符串常量池中。

关于上面的存储结构,我们已经在之前文章中提到,不再过多解释。下面如果我们再声明同样的字符串看看会有什么样的变化。

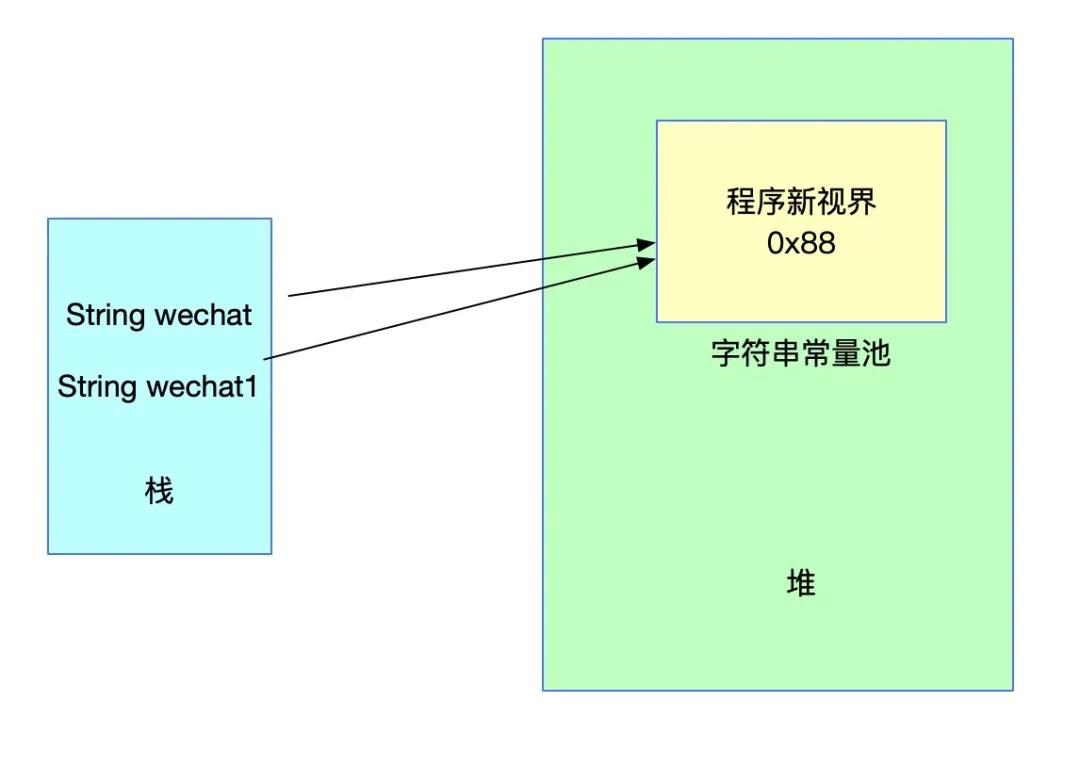
String wechat = "程序新视界";
String wechat1 = "程序新视界";

上述代码中声明wechat1时,会发现常量池中已经存在了对应的字符串,则不会再重新创建,只是把对应的引用返回给wechat1。对应结构图如下:

此时,如果直接用双等号比较wechatwechat1肯定是相等的,因为它们的引用和字面值都是相同的。

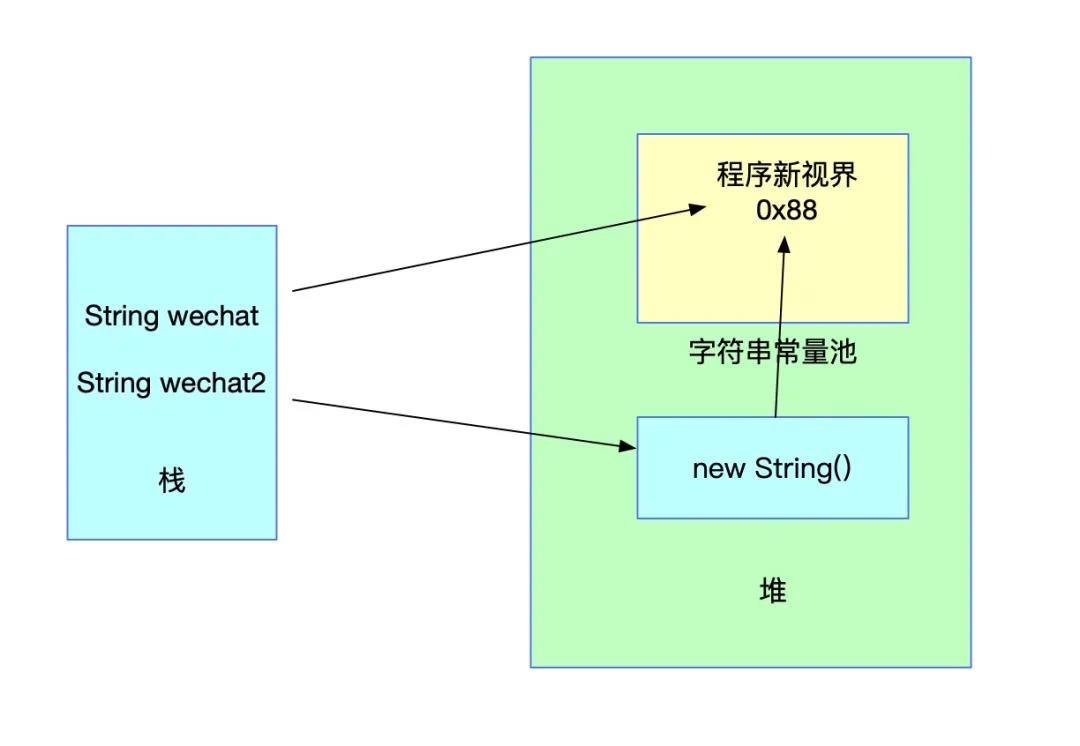
上面是直接双引号赋值的情况,那么如果通过 new 的形式创建字符串对应的流程又是如何呢?前面文章已经讲到这分两种情况:常量池存在对应的值和不存在对应的值。

String wechat2 = new String("程序新视界");

如果存在对应的值,此时会先在堆中创建一个针对wechat2变量的对象引用,然后将这个对象引用指向字符串常量池中已经存在的常量。

此时直接使用双等号比较wechatwechat2变量肯定是不相等的,而通过equals方法进行对比字面值则是相等的。

另外一种情况就是通过 new 创建时,字符串常量池中并不存在对应的常量。这种情况会现在字符串常量池中创建一个字符串常量,然后再在堆中创建一个字符串,持有常量池中对应字符串的引用。并把堆中对象的地址返回给wechat2。最终效果图依旧如上图。

在此时,如果不是直接new字符串赋值,而是通过+号操作,情况就有所不同。

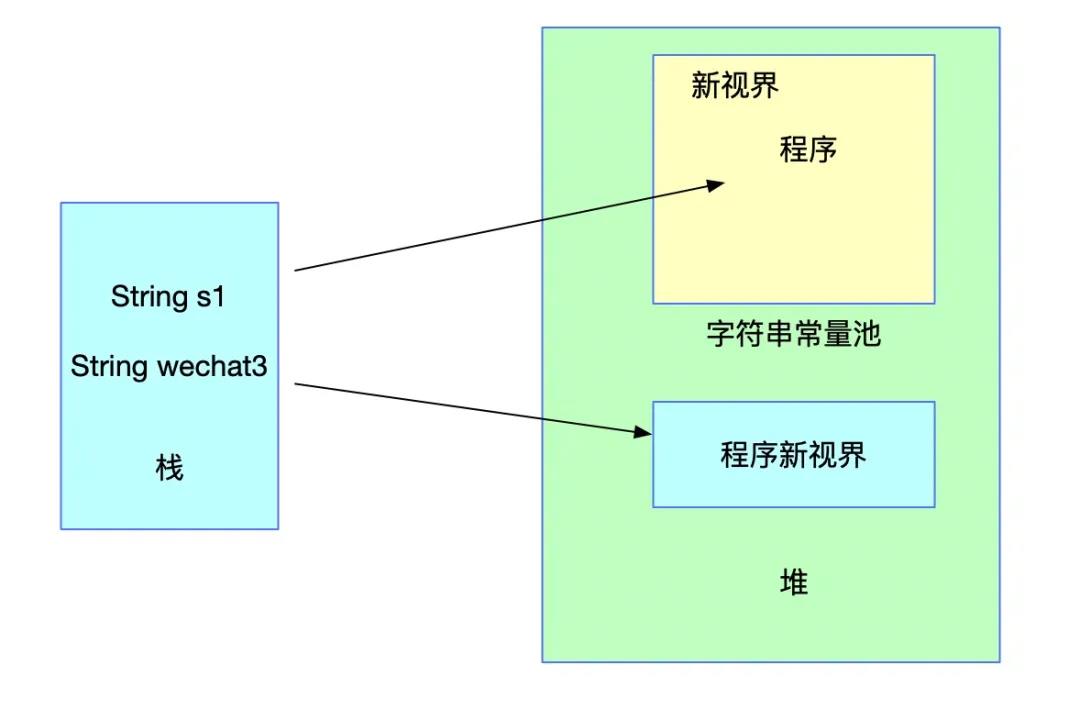
String s1 = "程序";
String wechat3 = new String(s1 + "新视界");

上述代码 s1 会存入常量池,而wechat3的值则由于JVM编译时采用了StringBuilder进行加号的拼接,只会在堆中创建一个String对象,并不会在常量池中存储对应的字符串。

此时的情况已经涉及到我们面试题中创建字符串的情况了。那么,下面我们就通过intern方法进行池化操作,看看字符串常量池的具体变化。

还以上面的代码为例,此时wechatwechat1wechat2三个变量和wechat3直接用双等号比较肯定是不相等的。下面对wechat3进行intern池化处理。

String s1 = "程序";
String wechat3 = new String(s1 + "新视界");
wechat3 = wechat3.intern();

此时会发现wechatwechat1两个变量与wechat3的值相等了。由于wechatwechat1其实是一个,这里只以wechatwechat3的比较为例来分析一下这个流程。

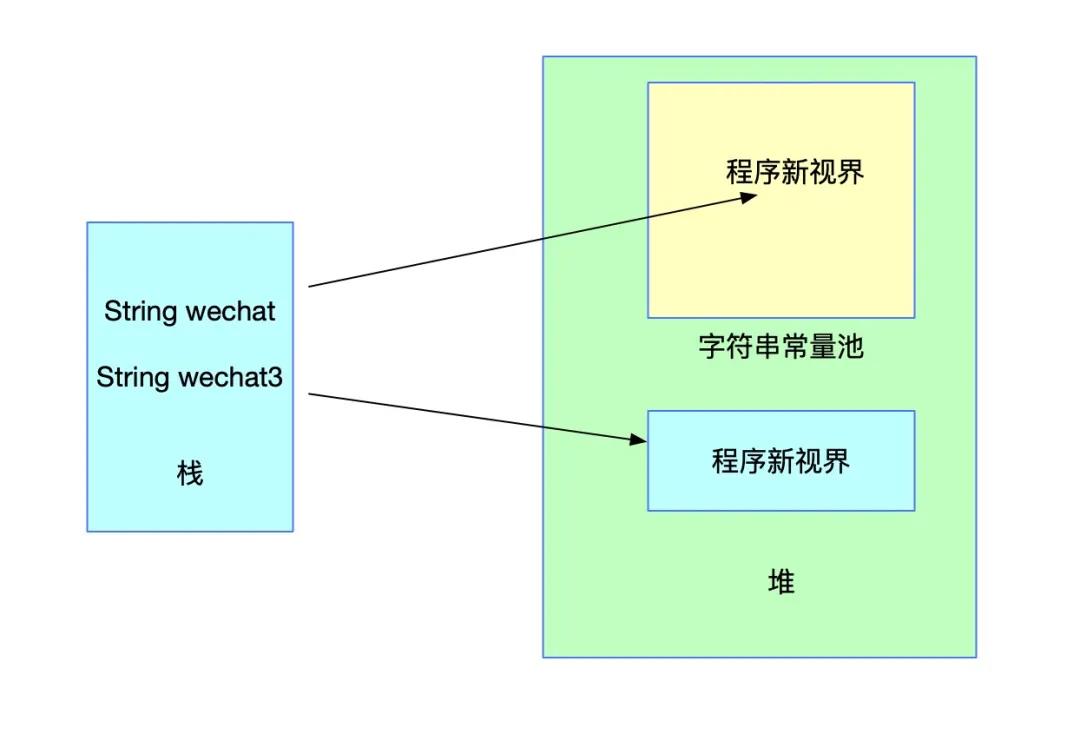
在没有调用intern方法之前内存的状态是下图(忽略掉s1部分)这样的:

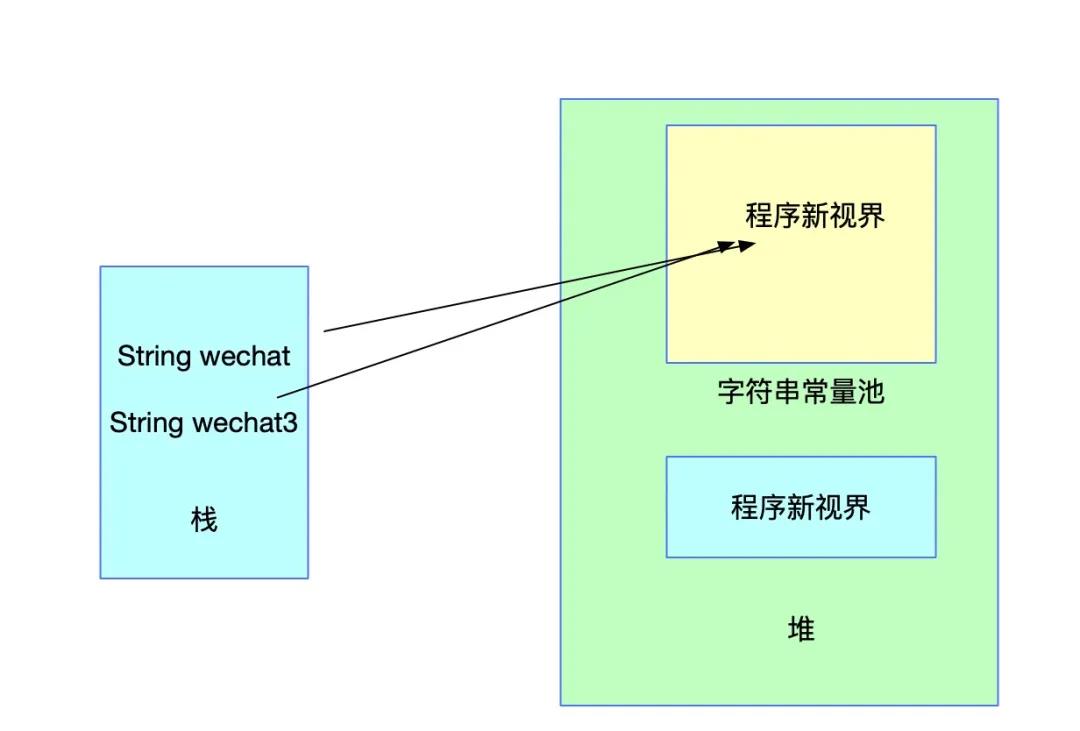
看上图它们的值不相等也就不奇怪了。下面对wechat3进行池化处理,并把池化的结果赋值给wechat3,就是上面的代码。内存结构会发生如下变化:

此时,再判断对应的两个值,因为引用和字面值全部相同,因此便相等了。具体intern的判断规则我们上面已经知道,如果常量池中存在对应的值,则直接返回引用。

那还有另外一种情况,就是常量池中不存在对应的值会是如何处理的呢?先看如下代码:

String s2 = "关注";
String wechat4 = new String(s2 + "公众号");
wechat4 = wechat4.intern();

在调用intern之前的操作我们前面已经说过,会在堆中创建一个String对象,而常量池中并不会存储一份,与wechat3的图一样。

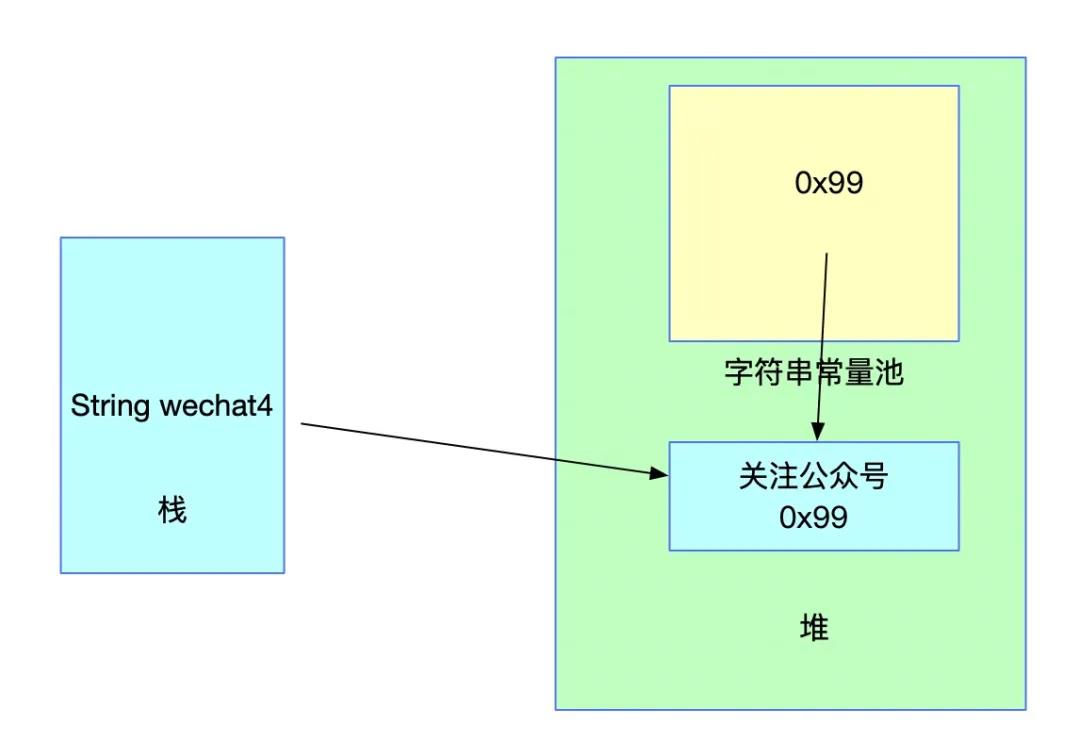
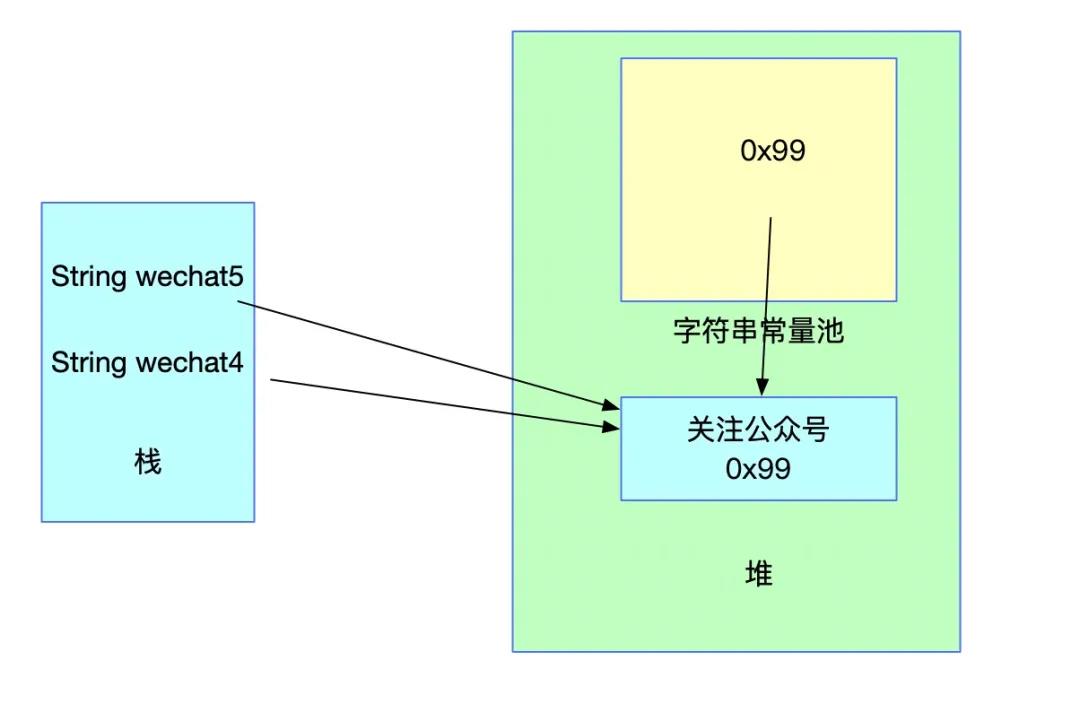
此时常量池中并未存在对应的字符串,此时调用intern方法之后,内存结构如下:

intern方法之后,常量池中存了堆中对应字符串的引用。对照上面说的,JDK7及之后字符串常量池中可以存储引用了。

需要注意的是,当字符串常量池中并不存在对应字符串时,调用intern方法返回的地址为堆中的地址,对应图中的0x99。而wechat4本来地址指向的就是堆中的地址,因此不会发生变化。

此时如果再定义一个双引号赋值的wechat5,如下代码:

String s2 = "关注";
String wechat4 = new String(s2 + "公众号");
wechat4 = wechat4.intern();


String wechat5 = "关注公众号";
System.out.println(wechat4 == wechat5);

变量wechat5初始化时发现字符串常量池中已经存在了一个引用,那么wechat5会直接指向这个引用,也就是wechat5wechat4一样,都指向内存中的String对象。

小结

上面这个演示实例时需要注意的重点是intern方法返回的引用地址。如果字符串常量池中已经存在对应的字符串时,此时返回的是字符串常量的地址【常量池中存储的是字符串】,如果字符串常量池中不存在对应的字符串,此时会把堆中的引用放在常量池对应的位置【常量池中存储的是堆中字符串的引用】,此时intern返回的是堆中字符串对应的引用。

搞清楚了上面的返回逻辑再看最初的代码:

String s1 = new String("he") + new String("llo");
String s2 = new String("h") + new String("ello");


String s3 = s1.intern();
String s4 = s2.intern();
System.out.println(s1 == s3);
System.out.println(s1 == s4);

其中 s1 为堆中字符串“hello”的地址;s2 为堆中另外一个“hello”字符串的地址。当s1.intern(),常量池中存储了 s1 的地址,此时s1.intern()返回的也是 s1 的地址,因此s1=s3,都是同一个地址嘛。

然后执行s2.intern(),此时常量池中已经有 hello 字符串,类型为引用且指向 s1 的地址,执行之后返回的便是 s1 的地址,赋值给 s4 ,因此 s1 和 s4 也指向同一个地址,因此相等。

通过上面的更深层次的分析,想必大家对字符串常量、字符串常量池以及intern方法有了更加深刻的理解。相关的面试题如果按照这个思路分析,基本上都可以进行准确解答了。

以上就是W3Cschool编程狮关于JVM字符串常量池及String的intern方法详解?的相关介绍了,希望对大家有所帮助。
react hooks线上 bug后复盘

thbcm阅读(297)

文章转载自公众号:前端之露

最近团队内有同学,由于写 react hooks 引发了一些 bug,甚至有 1 例是线上问题。团队内也因此发起了一些争执,到底要不要写 hooks?到底要不要加 lint?到底要不要加 autofix?争论下来结论如下:

  1. 写还是要写的;
  2. 写 hooks 前一定要先学习 hooks;
  3. 团队再出一篇必读文档,必须要求每位同学,先读再写。

因此便有了此文。

本文主要讲两大点:

  1. 写 hooks 前的硬性要求;
  2. 写 hooks 常见的几个注意点。

硬性要求

1. 必须完整阅读一次 React Hooks 官方文档

英文文档:https://reactjs.org/docs/hooks-intro.html

中文文档:https://zh-hans.reactjs.org/docs/hooks-intro.html

其中重点必看 hooks: useStateuseReduceruseEffectuseCallbackuseMemo 另外推荐阅读:

  1. Dan的《useEffect完全指南》
  2. 衍良同学的《React Hooks完全上手指南》

2. 工程必须引入 lint 插件,并开启相应规则

lint 插件:https://www.npmjs.com/package/eslint-plugin-react-hooks 必开规则:

{
  "plugins": ["react-hooks"],
  "rules": {
    "react-hooks/rules-of-hooks": "error",
    "react-hooks/exhaustive-deps": "warn"
  }
}

其中, react-hooks/exhaustive-deps 至少 warn,也可以是 error。建议全新的工程直接配 “error”,历史工程配 “warn”。

切记,本条是硬性条件。

如果你的工程,当前没开启 hooks lint rule,请不要编写任何 hooks 代码。如果你 CR 代码时,发现对方前端工程,没有开启相应规则,并且提交了 hooks 代码,请不要合并。该要求适应于任何一个 React 前端工程。

这两条规则会避免我们踩坑。虽然对于 hooks 新手,这个过程可能会比较“痛苦”。不过,如果你觉得这两个规则对你编写代码造成了困扰,那说明你还未完全掌握 hooks。

如果对于某些场景,确实不需要「exhaustive-deps」,可在代码处加: // eslint-disable-next-line react-hooks/exhaustive-deps

切记只能禁本处代码,不能偷懒把整个文件都禁了。

3. 如若有发现 hooks 相关 lint 导致的 warning,不要全局 autofix

除了 hooks 外,正常的 lint 基本不会改变代码逻辑,只是调整编写规范。但是 hookslint 规则不同,exhaustive-deps 的变化会导致代码逻辑发生变化,这极容易引发线上问题,所以对于 hookswaning,请不要做全局 autofix 操作。除非保证每处逻辑都做到了充分回归。

另外公司内部有个小姐姐补充道:eslint-plugin-react-hooks 从2.4.0版本开始,已经取消了 exhaustive-deps 的autofix。所以,请尽量升级工程的lint插件至最新版,减少出错风险

然后建议开启 vscode 的「autofix on save」。未来无论是什么问题,能把 error 与 warning 尽量遏制在最开始的开发阶段,保证自测跟测试时就是符合规则的代码。

常见注意点

依赖问题

依赖与闭包问题是一定要开启exhaustive-deps 的核心原因。最常见的错误即:mount 时绑定事件,后续状态更新出错。

错误代码示例:(此处用 addEventListener 做 onclick 绑定,只是为了方便说明情况)

function ErrorDemo() {
  const [count, setCount] = useState(0);
  const dom = useRef(null);
  useEffect(() => {
    dom.current.addEventListener('click', () => setCount(count + 1));
  }, []);
  return <div ref={dom}>{count}</div>;
}

这段代码的初始想法是:每当用户点击 domcount 就加1。理想中的效果是一直点,一直加。但实际效果是 {count} 到「1」以后就加不上了。

我们来梳理一下, useEffect(fn, []) 代表只会在 mount 时触发。也即是首次 render 时,fn 执行一次,绑定了点击事件,点击触发 setCount(count + 1) 。乍一想,count 还是那个 count,肯定会一直加上去呀,当然现实在啪啪打脸。

状态变更触发页面渲染的本质是什么?本质就是 ui = fn(props, state, context) 。props、内部状态、上下文的变更,都会导致渲染函数(此处就是ErrorDemo)的重新执行,然后返回新的 view。

那现在问题来了, ErrorDemo 这个函数执行了多次,第一次函数内部的 count 跟后面几次的 count 会有关系吗?这么一想,感觉又应该没有关系了。那为什么第二次又知道 count 是1,而不是 0 了呢?第一次的setCount 跟后面的是同一个函数吗?这背后涉及到 hooks 的一些底层原理,也关系到了为什么 hooks 的声明需要声明在函数顶部,不允许在条件语句中声明。在这里就不多讲了。

结论是:每次 count 都是重新声明的变量,指向一个全新的数据;每次的setCount 虽然是重新声明的,但指向的是同一个引用。

回到正题,我们知道了每次 render,内部的 count 其实都是全新的一个变量。那我们绑定的点击事件方法,也即:setCount(count + 1) ,这里的 count,其实指的一直是首次 render 时的那个 count,所以一直是 0 ,因此 setCount,一直是设置 count 为1。

那这个问题怎么解?

首先,应该遵守前面的硬性要求,必须要加 lint 规则,并开启 autofix on save。然后就会发现,其实这个 effect 是依赖 count 的。autofix 会帮你自动补上依赖,代码变成这样:

useEffect(() => {
  dom.current.addEventListener('click', () => setCount(count + 1));
}, [count]);

那这样肯定就不对了,相当于每次 count 变化,都会重新绑定一次事件。所以对于事件的绑定,或者类似的场景,有几种思路,我按我的常规处理优先级排列:

思路1:消除依赖

在这个场景里,很简单,我们主要利用 setCount 的另一个用法 functional updates。这样写就好了: () => setCount(prevCount => ++prevCount) ,不用关心什么新的旧的、什么闭包,省心省事。

思路2:重新绑定事件

那如果我们这个事件就是要消费这个 count 怎么办?比如这样:

dom.current.addEventListener('click', () => {
  console.log(count);
  setCount(prevCount => ++prevCount);
});

我们不必执着于一定只在 mount 时执行一次。也可以每次重新 render 前移除事件,render 后绑定事件即可。这里利用 useEffect 的特性,具体可以自己看文档:

useEffect(() => {
  const $dom = dom.current;
  const event = () => {
    console.log(count);
    setCount(prev => ++prev);
  };
  $dom.addEventListener('click', event);
  return () => $dom.removeEventListener('click', event);
}, [count]);

思路3

如果嫌这样开销大,或者编写麻烦,也可以用 useRef 其实用 useRef 也挺麻烦的,我个人不太喜欢这样操作,但也能解决问题,代码如下:

const [count, setCount] = useState(0);
const countRef = useRef(count);
useEffect(() => {
  dom.current.addEventListener('click', () => {
    console.log(countRef.current);
    setCount(prevCount => {
      const newCount = ++prevCount;
      countRef.current = newCount;
      return newCount;
    });
  });
}, []);

useCallback 与 useMemo

这两个 api,其实概念上还是很好理解的,一个是「缓存函数」, 一个是缓存「函数的返回值」。但我们经常会懒得用,甚至有的时候会用错。

从上面依赖问题我们其实可以知道,hooks对「有没有变化」这个点其实很敏感。如果一个 effect 内部使用了某数据或者方法。若我们依赖项不加上它,那很容易由于闭包问题,导致数据或方法,都不是我们理想中的那个它。如果我们加上它,很可能又会由于他们的变动,导致 effect 疯狂的执行。真实开发的话,大家应该会经常遇到这种问题。

所以,在此建议:

  1. 在组件内部,那些会成为其他 useEffect 依赖项的方法,建议用 useCallback 包裹,或者直接编写在引用它的useEffect中。
  2. 己所不欲勿施于人,如果你的 function 会作为 props传递给子组件,请一定要使用 useCallback 包裹,对于子组件来说,如果每次render都会导致你传递的函数发生变化,可能会对它造成非常大的困扰。同时也不利于 react 做渲染优化。

不过还有一种场景,大家很容易忽视,而且还很容易将 useCallbackuseMemo 混淆,典型场景就是:节流防抖。

举个例子:

function BadDemo() {
  const [count, setCount] = useState(1);
  const handleClick = debounce(() => {
    setCount(c => ++c);
  }, 1000);
  return <div onClick={handleClick}>{count}</div>;
}

我们希望防止用户连续点击触发多次变更,加了防抖,停止点击1秒后才触发 count + 1 ,这个组件在理想逻辑下是OK的。但现实是骨感的,我们的页面组件非常多,这个 BadDemo 可能由于父级什么操作就重新 render 了。现在假使我们页面每500毫秒会重新 render 一次,那么就是这样:

function BadDemo() {
  const [count, setCount] = useState(1);
  const [, setRerender] = useState(false);
  const handleClick = debounce(() => {
    setCount(c => ++c);
  }, 1000);
  useEffect(() => {
    // 每500ms,组件重新render
    window.setInterval(() => {
      setRerender(r => !r);
    }, 500);
  }, []);
  return <div onClick={handleClick}>{count}</div>;
}

每次 render 导致 handleClick 其实是不同的函数,那么这个防抖自然而然就失效了。这样的情况对于一些防重点要求特别高的场景,是有着较大的线上风险的。

那怎么办呢?自然是想加上 useCallback :

const handleClick = useCallback(debounce(() => {
  setCount(c => ++c);
}, 1000), []);

现在我们发现效果满足我们期望了,但这背后还藏着一个惊天大坑。

假如说,这个防抖的函数有一些依赖呢?比如 setCount(c => ++c); 变成了 setCount(count + 1) 。那这个函数就依赖了 count 。代码就变成了这样:

const handleClick = useCallback(
  debounce(() => {
    setCount(count + 1);
  }, 1000),
  []
);

大家会发现,你的 lint 规则,竟然不会要求你把 count 作为依赖项,填充到 deps 数组中去。这进而导致了最初的那个问题,只有第一次点击会 count++。这是为什么呢?

因为传入 useCallback 的是一段执行语句,而不是一个函数声明。只是说它执行以后返回的新函数,我们将其作为了 useCallback 函数的入参,而这个新函数具体是个啥,其实 lint 规则也不知道。

更合理的姿势应该是使用 useMemo :

const handleClick = useMemo(
  () => debounce(() => {
    setCount(count + 1);
  }, 1000),
  [count]
);

这样保证每当 count 发生变化时,会返回一个新的加了防抖功能的新函数。

总而言之,对于使用高阶函数的场景,建议一律使用 useMemo

有些网友提供了宝贵的反馈,我继续补充:刚使用useMemo,依旧存在一些问题。

问题1useMemo「将来」并不「稳定」

react 的官方文档中提到:你可以把 useMemo 作为性能优化的手段,但不要把它当成语义上的保证。将来,React 可能会选择“遗忘”以前的一些 memoized 值,并在下次渲染时重新计算它们,比如为离屏组件释放内存。先编写在没有 > useMemo 的情况下也可以执行的代码 —— 之后再在你的代码中添加 > useMemo,以达到优化性能的目的。也就是说,在将来的某种特殊情况下,这个防抖函数依旧会失效。当然,这种情况是发生在「将来」,且相对比较极端,出现概率较小,即使出现,也不会“短时间内连续”出现。所以对于不是 「前端防不住抖就要完蛋」的场景,风险相对较小。

问题2useMemo 并不能一劳永逸解决所有高阶函数场景

在示例的场景中,防抖的逻辑是:「连续点击后1秒,真正执行逻辑,在这过程中的重复点击失效」。而如果业务逻辑改成了「点击后立即发生状态变更,再之后的1秒内重复点击无效」,那么我们的代码可能就变成了。

const handleClick = useMemo( 
  () => throttle(() => { setCount(count + 1); }, 1000), [count] );

然后发现又失效了。原因是点击以后,count 立即发生了变化,然后 handleClick 又重复生成了新函数,这个节流就失效了。

所以这种场景,思路又变回了前面提到的,「消除依赖」 或 「使用ref」

当然啦,也可以选择自己手动实现一个 debouncethrottle 。我建议可以直接使用社区的库,比如 react-use,或者参考他们的实现自己写两个实现。

以上就是W3Cschool编程狮关于react hooks线上 bug后复盘的相关介绍了,希望对大家有所帮助。
纯CSS实现吸附效果

thbcm阅读(314)

文章转载自公众号:IQ前端

前言

「吸附效果」就是网页滚到到某个位置,元素固定在该位置,后续不随网页滚动而滚动。吸附效果很常见,譬如吸顶效果吸底效果,经常用在跟随导航移动广告悬浮提示等场景中。

原理

jQuery 时代就有很多吸附效果插件了,现在常用的三大前端框架也有自身第三方的吸附效果组件。它们都有着共通的实现原理:监听scroll事件,判断scrollTop目标元素的位置范围,符合条件则将目标元素position声明为fixed,令目标元素相对于浏览器窗口进行定位,让用户看上去就像钉在浏览器指定位置上。

javascript 实现吸附效果的代码在网上一搜一大堆,更何况笔者喜欢耍 CSS ,在此就不贴相关的JS代码了。本文为各位同学推荐一个很少见很少用的 CSS 属性:position:sticky。简单的「两行CSS核心代码」就能完成「十多行JS核心代码」的功能,何乐而不为呢。

实现

简单回顾position常用的值,怎样用就不说了,各位同学应该都熟透了。

取值 功能 版本
「inherit」 继承 2
「static」 标准流 2
「relative」 相对定位 2
「absolute」 绝对定位 2
「fixed」 固定定位 2
「sticky」 粘性定位 3

当值为sticky时将元素变成粘性定位「粘性定位」相对定位固定定位的合体,元素在特定阈值跨越前为相对定位,跨越后为固定定位。

主要是为了推广知识点,直接上代码,样式就不细磨了,将就看吧。

<div class="ads-position">
    <ul>
        <li>Top 1</li>
        <li>Top 2</li>
        <li>Normal</li>
        <li>Bottom 1</li>
        <li>Bottom 2</li>
    </ul>
</div>
.ads-position {
    overflow: auto;
    position: relative;
    width: 400px;
    height: 280px;
    outline: 1px solid #3c9;
    ul {
        padding: 200px 0;
    }
    li {
        position: sticky;
        height: 40px;
        line-height: 40px;
        text-align: center;
        color: #fff;
        &:nth-child(1) {
            top: 0;
            z-index: 9;
            background-color: #f66;
        }
        &:nth-child(2) {
            top: 40px;
            z-index: 9;
            background-color: #66f;
        }
        &:nth-child(3) {
            background-color: #f90;
        }
        &:nth-child(4) {
            bottom: 0;
            z-index: 9;
            background-color: #09f;
        }
        &:nth-child(5) {
            bottom: 40px;
            z-index: 9;
            background-color: #3c9;
        }
    }
}

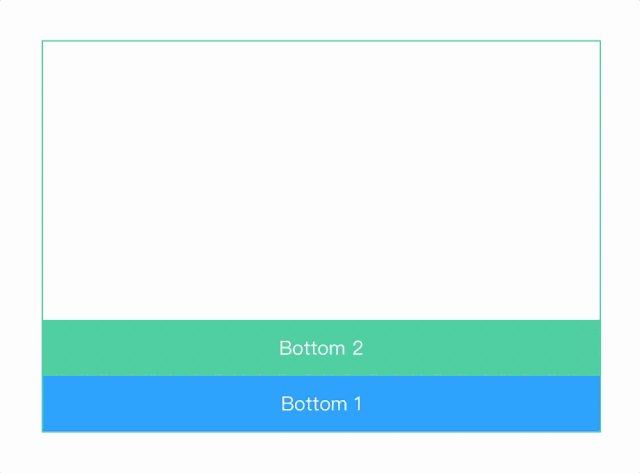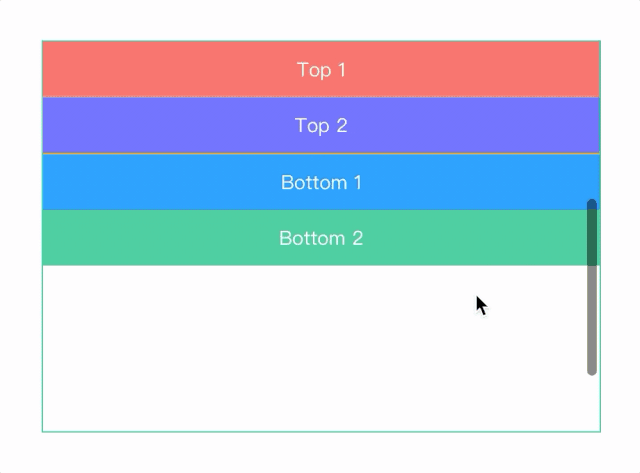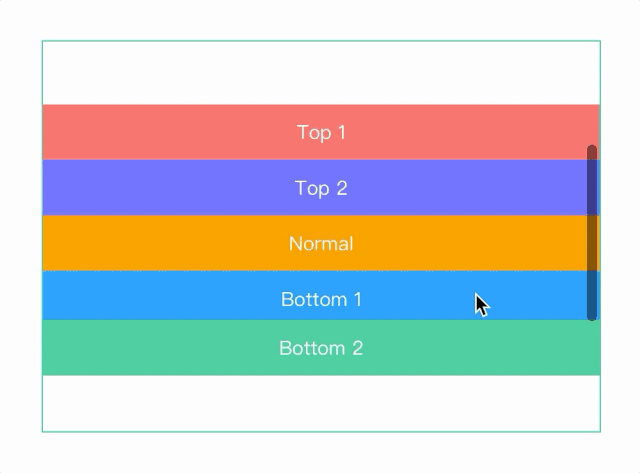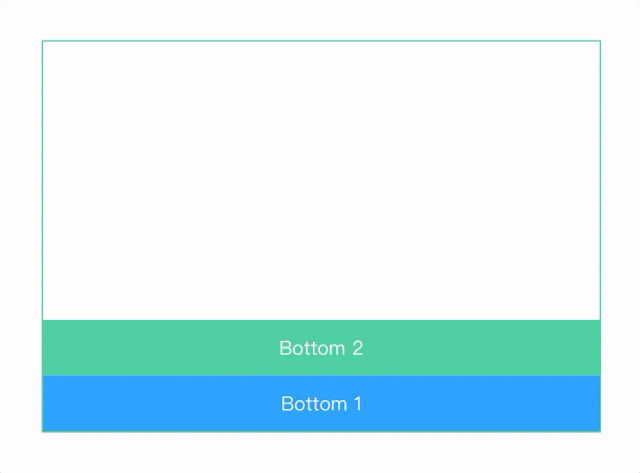
最终效果如下。两行CSS核心代码分别是position:stickytop/bottom:npx。上述Demo里5个节点都声明了position:sticky,但由于top/bottom赋值有所不同就产生了不同的吸附效果。

细心的同学可能发现这些元素在某些滚动时刻处于相对定位,在特定滚动时刻就处于固定定位

  • 第1个<li>top0px,滚动到容器顶部就固定
  • 第2个<li>top40px,滚动到距离容器顶部40px就固定
  • 第3个<li>:没有声明top/bottom,就一直保持相对定位
  • 第4个<li>bottom40px,滚动到距离容器底部40px就固定
  • 第5个<li>bottom0px,滚动到容器底部就固定

当然,换成leftright也一样能实现横向的吸附效果

注意

粘性定位的参照物并不一定是position:fixed

目标元素的任意祖先元素都未声明position:relative|absolute|fixed|sticky,才与position:fixed表现一致。

当离目标元素最近的祖先元素声明了position:relative|absolute|fixed|sticky目标元素就相对该祖先元素进行粘性定位

确认参照物跟position:absolute一致。

兼容

兼容性勉强还行,近2年发版的浏览器都能支持,SafariFirefox的兼容性还是挺赞的。有吸附效果需求的同学建议一试,要兼容IExplorer就算了。

以上就是W3Cschool编程狮关于纯CSS实现吸附效果的相关介绍了,希望对大家有所帮助。
在 JavaScript 中使用 Promises 时最常见的 3 个错误

thbcm阅读(280)

文章转载自公众号:印记中文

原文链接:dev.to/mpodlasin/3-most-common-mistakes-when-using-promises-in-javascript-oab

译者:Shopee 金融前端团队 张铁山

本文对开发者编写 Promise 时常出现的几种错误进行了总结,剖析的一针见血,来看看是不是你平时所写?

时至今日,即使有 async / await 的引入,JavaScriptPromises 的编写规则对于所有的 JS 开发者来说仍然是必不可少的知识。

JavaScript 在处理异步问题上和其它编程语言不同。因此,即使具有丰富经验的开发人员有时也会陷入误区。我亲身看到过优秀的 PythonJava 程序员在为 Node.js 或浏览器编码时犯了非常愚蠢的错误。

为了避免这些错误,JavaScript 中的 Promises 有许多编写细节需要考虑。其中有一些纯粹是语言风格问题,但也有许多是实际引入、难以跟踪的错误。因此,我决定编写一个清单,列出开发人员在使用 Promises 编程时遇到的三个最常见的错误。

将所有内容包装在 Promise 构造函数中

第一个错误也是最为明显的错误之一,但是我发现开发者犯这个错误的频率出奇的高。

当第一次学习 Promises 时,你会了解到 Promise 的构造函数,这个构造函数可以用来创建一个新的 Promises 对象。

也许因为人们通常是通过将一些浏览器 API(例如 setTimeout)包装在 Promise 构造函数中这种方式来开始学习的,所以在他们心中根深蒂固地认为创建 Promise 对象的唯一方法是使用构造函数。

因此,通常会这样写:

const createdPromise = new Promise(resolve => {
  somePreviousPromise.then(result => {
    // 对 result 进行一些操作
    resolve(result);
  });
});

可以看到,为了对 somePreviousPromise 的结果 result 进行一些操作,有些人使用了 then,但是后来决定将其再次包装在一个 Promise 的构造函数中,为的是将该操作的结果存储在 createdPromise 的变量中,大概是为了稍后对该 Promise 进行更多操作。

这显然是没有必要的。then 方法的全部要点在于它本身会返回一个 Promise,它表示的是执行 somePreviousPromise 后再执行then 中的的回调函数,then 的参数是 somePreviousPromise成功执行返回的结果。

所以,上一段代码大致等价于:

const createPromise = somePreviousPromise.then(result => {
  // 对 result 进行一些操作
  return result
})

如此编写,会简洁很多。

但是,为什么我说它只是大致等价呢?区别在哪里?

经验不足且不细心观察的话可能很难发现,实际上两者在错误处理上存在巨大的差异,这种差异比第一段代码的冗余问题更为重要。

假设 somePreviousPromise 出于某些原因失败了且抛出错误。例如,这个 Promise 里发送了一个 HTTP 请求,而 API 响应 500 错误。

事实证明,在上一段代码中,我们将一个 Promise 包装到另一个 Promise 中,我们根本无法捕获该错误。为了解决此问题,我们必须进行以下更改:

const createdPromise = new Promise((resolve, reject) => {
  somePreviousPromise.then(result => {
    // 对 result 进行一些操作
    resolve(result);
  }, reject);
});

我们简单的在回调函数中添加了一个 reject 参数,然后通过将其作为第二个参数传递给 then 的方式来使用它。请务必记住,then 方法接受第二个可选参数来进行错误处理,这一点非常重要。

现在如果 somePreviousPromise 出于某些原因失败了,reject函数将会被调用,并且我们将能够一如往常地处理 createdPromise上的错误。

这样是否解决了所有问题?抱歉,并没有。

我们处理了 somePreviousPromise 自身可能发生的错误,但是我们仍然无法控制作为 then 方法第一个参数的回调函数中发生的情况。在注释区域 // 对 result 进行一些操作 执行的代码可能会有一些错误,如果这块地方的代码抛出任何错误,那 then 方法的第二个参数reject 依旧捕获不到这些错误。

这是因为作为 then 方法的第二个参数的错误处理函数只对 Promise 链上当前 then 之前发生的错误作出响应。

因此,最合适的(也是最终的)解决方案应该如下:

const createdPromise = new Promise((resolve, reject) => {
  somePreviousPromise.then(result => {
    // 对 result 进行一些操作
    resolve(result);
  }).catch(reject);
});

注意,这次我们使用了 catch 方法 —— 因为它将在第一个 then之后被调用,它将捕获到 Promise 链上抛出的所有错误。无论是 somePreviousPromise 还是 then 中的回调失败了,Promise 都将按预期处理这些情况。

从上述示例可以发现,在 Promise 的构造函数中包装代码时,有很多细节问题需要处理。这就是为什么最好使用 then 方法创建新的 Promises 的原因,如第二段代码所示。它不仅看起来优雅,并且还可以帮助我们避免那些极端情况。

串行调用 then 与并行调用 then 的比较

由于许多程序员都有着面向对象的编程背景,因此对他们来说,调用一个方法会更改一个对象,而非创建一个新的对象,这很稀松平常。

这或许也是我看到有人对于「在 Promise 上调用 then 方法时」到底发生了什么会感到困惑的原因。

比较下面两段代码:

const somePromise = createSomePromise();


somePromise
  .then(doFirstThingWithResult)
  .then(doSecondThingWithResult);
const somePromise = createSomePromise();


somePromise
  .then(doFirstThingWithResult);


somePromise
  .then(doSecondThingWithResult);

它们所做之事是否相同?看起来似乎相同,毕竟,两段代码都在 somePromise 上调用了两次 then,对吗?

不,这又是一个非常普遍的误区。实际上,这两段代码做的事情完全不同。如果不完全理解两段代码中正在做的事情,可能会导致出现非常棘手的错误。

正如我们在之前的章节中所说,then 方法会创建一个完全新的、独立的 Promise。这意味着在第一段代码中,第二个 then 方法不是在 somePromise 上调用,而是在一个新的 Promise 对象上调用,这段代码表示等待 somePromise 的状态变为成功后立刻调用 doFirstThingWithResult。然后给新返回的 Promise 实例添加一个回调操作 doSecondThingWithResult

实际上,这两个回调将会一个接着一个地执行 —— 可以确保只有在第一个回调执行完成且没有任何问题之后,才会调用第二个回调。此外,第一个回调将会接收 somePromise 返回的值作为参数,但是第二个回调函数将接收 doFirstThingWithResult 函数返回的值作为参数。

另一方面,在第二段代码中,我们在 somePromise 上调用两次then 方法,基本上忽略了从该方法返回的两个新的 Promises 对象。因为 then 在完全相同的 Promise 实例上被调用了两次,因此我们无法确定首先执行哪个回调,这里的执行顺序是不确定的。

从某种意义上说,这两个回调应该是独立的,并且不依赖于任何先前调用的回调,我有时将其视为 “并行” 的执行。但是,当然,实际上,JS 引擎同一时刻只能执行一个功能 —— 你根本无法知道它们将以什么顺序调用。

两段代码的第二个不同之处是,在第二段代码中 doFirstThingWithResultdoSecondThingWithResult 都会接收到同样的参数 —— somePromise 成功执行返回的结果,两个回调函数的返回值在这个示例中被完全忽略掉了。

创建后立即执行 Promise

这个误区出现的原因也是因为大部分程序员有着丰富的面向对象编程经验。

在面向对象编程的思想中,确保对象的构造函数自身不执行任何操作通常被认为是一种很好的实践。举个例子,一个代表数据库的对象在使用new 关键字调用其构造函数时不应该启动与数据库的链接。

相反,应该提供一个特定的方法,如调用一个名为 init 的方法 —— 它将显式地创建连接。这样,一个对象不会因为已被创建而执行任何期望之外的操作。它会按照程序员的明确要求来执行。

但这「不是 Promises 的工作方式」

考虑如下示例:

const somePromise = new Promise(resolve => {
  // 创建 HTTP 请求
  resolve(result);
});

你可能会认为发出 HTTP 请求的函数未在此处调用,因为它包装在 Promise 构造函数中。实际上,许多程序员希望 somePromise 上执行 then 方法之后它才被调用。

但事实并非如此。创建该 Promise 后,回调将立即执行。这意味着当您在创建 somePromise 变量后进入下一行时,你的 HTTP 请求可能已被执行,或者说已存在执行队列里。

我们说 Promise 是 “eager” 的,因为它尽可能快地执行与其关联的动作。相反,许多人期望 Promises 是 “lazy” 的,即仅在必要时调用(例如,当 then 方法在 Promise 上首次被调用)。这是一个误区,Promise 永远是 eager 的,而非 lazy 的。

但是,如果您想要延迟执行 Promise,应该怎么做?如果您希望延迟发出该 HTTP 请求怎么办?Promises 中是否内置了某种奇特的机制,可以让您执行类似的操作?

答案有时会超出开发者们的期望。函数是一种 lazy 机制。仅当程序员使用 () 语法显式调用它们时,才执行它们。仅仅定义一个函数实际上并不能做任何事情。因此,要使 Promise 成为 “lazy”, 最佳方法是将其简单地包装在函数中!

具体代码如下:

const createSomePromise = () => new Promise(resolve => {
  // 创建 HTTP 请求
  resolve(result);
});

现在,我们将 Promise 构造函数的调用操作包装在一个函数中。事实上它还没有真正被调用。我们还将变量名从 somePromise 更改为 createSomePromise,因为它不再是一个 Promise 对象 —— 而是一个创建并返回 Promise 对象的函数。

Promise 构造函数(以及带有 HTTP 请求的回调函数)仅在执行该函数时被调用。因此,现在我们有了一个 lazy 的 Promise,只有在我们真正想要它执行时才去执行它。

此外,请注意,它还附带提供了另一种功能。我们可以轻松地创建另一个可以执行相同操作的 Promise 对象。

如果出于某些奇怪的原因,我们希望进行两次相同的 HTTP 请求并同时执行这些请求,则只需要两次调用 createSomePromise 函数。又或者,如果请求由于任何原因失败了,我们可以使用相同的函数重新请求。

这表明将 Promises 包装在函数(或方法)中非常方便,因此对于 JavaScript 开发人员来说,使用这种模式开发应该要变得很自然而然。

而讽刺的是,如果你阅读过我写的文章 Promises vs Observables ,你就会知道编写 Rx.js 的程序员经常会犯一个与此相反的错误。他们对 Observable 进行编码,就好像它们是 “eager”(与 Promises 一致),而实际上它们是 ”lazy“ 的。因此,将 Observables 封装在函数或方法中通常没有任何意义,实际上甚至是有害的。

结语

本文展示了我经常看到开发者使用 Promise 时所犯的三种类型的错误,因为他们对 JavaScript 中的 Promises 的理解仅停留在表面。

以上就是W3Cschool编程狮关于在 JavaScript 中使用 Promises 时最常见的 3 个错误的相关介绍了,希望对大家有所帮助。
联系我们