如何使用代码体现一个浪漫七夕

thbcm阅读(325)

明天就是农历七月初七了,也就是我们传统的七夕节日要来了。七夕作为一个重大传统节日,它不仅仅是情侣专属,也合适单身人员表白,或许你也可以一起过节了呢。

你们准备好怎么和自己心仪的女童鞋表白了吗?已经有女朋友你们准备好礼物了吗?

作为程序猿兼码农的你们不表示一下吗?

心动

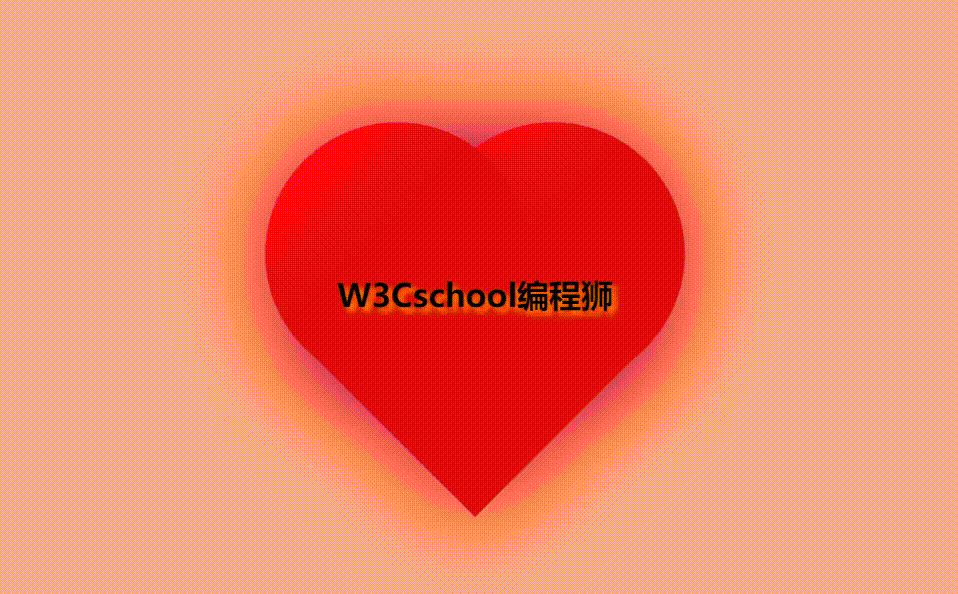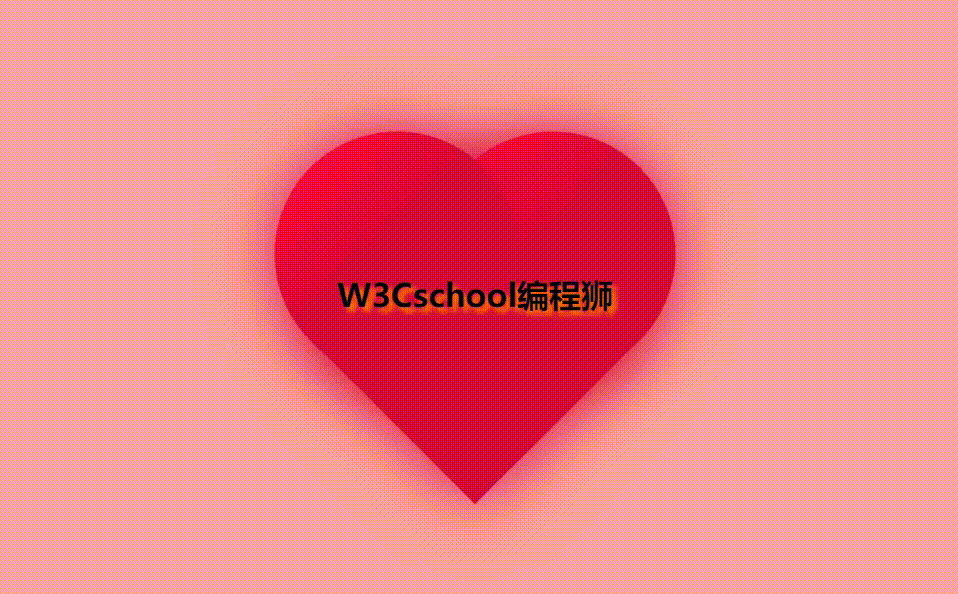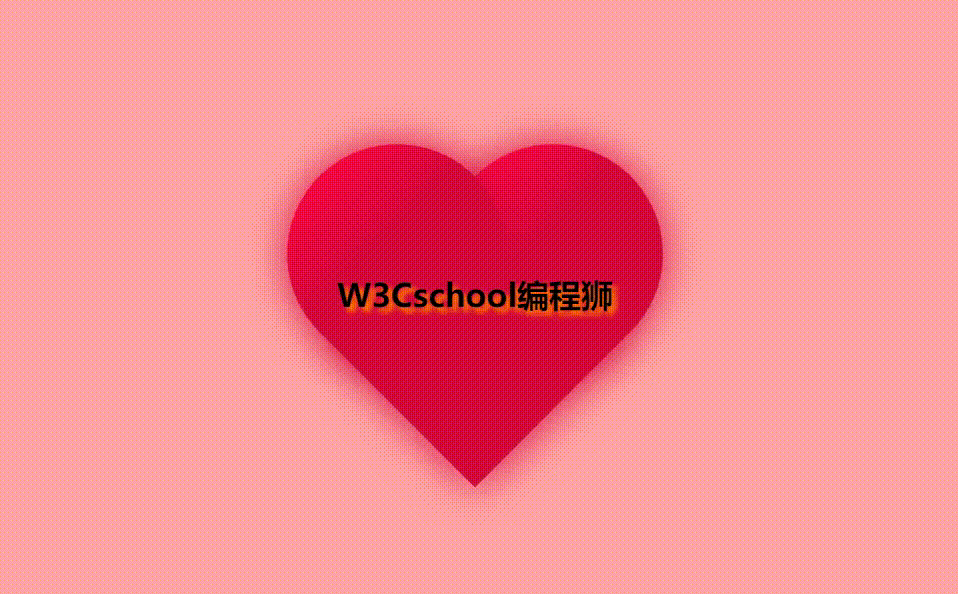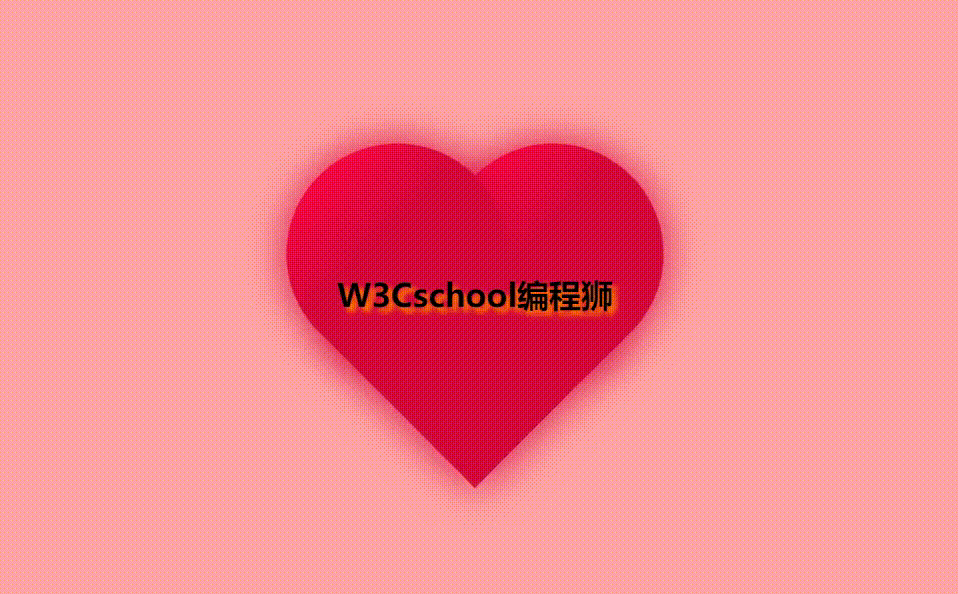
送一个爱心表示我对你心动,使用CSS3transform实现:

css 部分

html,body {
height:100%;
}
body {
margin:0;
padding:0;
background:#ffa5a5;
  display: flex;
  justify-content: center;
  align-items: center;
}
.chest {
width:500px;
height:500px;
  position:relative;
  display: flex;
  justify-content: center;
  align-items: center;
}
.heart {
    position:absolute;
    z-index:2;
    background:linear-gradient(-90deg,#F50A45 0%,#d5093c 40%);
    animation:beat 0.7s ease 0s infinite normal;
}
.heart.center {
    background:linear-gradient(-45deg,#B80734 0%,#d5093c 40%);
}
.heart.top {
    z-index:3;
}
.sided {
    top:100px;
    width:220px;
    height:220px;
    border-radius:110px;
}
.center {
    width:210px;
    height:210px;
    bottom:100px;
    left:145px;
    transform:rotateZ(225deg);
}
.left {
    left:62px;
}
.right {
    right:62px;
}
.title{
   z-index: 999;
   text-shadow: 5px 5px 5px #ff7f00;
}
@keyframes beat {
    0% {
    transform:scale(1) rotate(225deg);
    box-shadow:0 0 40px #d5093c;
}
50% {
    transform:scale(1.2) rotate(225deg);
    box-shadow:0 0 70px #d5093c;
}
100% {
    transform:scale(1) rotate(225deg);
    box-shadow:0 0 40px #d5093c;
}
}

html 部分

<html lang="en">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>W3Cschool编程狮</title>
    <link href="./flower.css" type="text/css" rel="stylesheet">
</head>
<body>
    <div class="chest">
        <div class="heart left sided top"></div>
        <div class="heart center"></div>
        <div class="heart right sided"></div>
        <h1 class="title">W3Cschool编程狮</h1>
    </div>
</body>
</html>

玫瑰花

送一朵玫瑰表示我对你的爱,使用canvans画布实现:

<!DOCTYPE HTML>
<html>


<head>
    <title>Rose</title>
    <meta http-equiv="Content-Type" content="text/html; charset=UTF-8">
    <style>
        html,
        body {
            height: 100%;
        }
    </style>
</head>


<body style="background:#000;margin:0;padding:0;display: flex;justify-content: center;align-items: center;">
    <canvas id="c" style="display:block"></canvas>
    <script>
        var b = document.body;
        var c = document.getElementsByTagName('canvas')[0];
        var a = c.getContext('2d');
        document.body.clientWidth;
    </script>
    <script>


        with (m = Math) C = cos, S = sin, P = pow, R = random;
        c.width = c.height = f = 600; h = -250;
        function p(a, b, c) {
            if (c > 60)
                return [S(a * 7) * (13 + 5 / (.2 + P(b * 4, 4))) - S(b) * 50, b * f + 50, 625 + C(a * 7) * (13 + 5 / (.2 + P(b * 4, 4))) + b * 400, a * 1 - b / 2, a];
            A = a * 2 - 1; B = b * 2 - 1;
            if (A * A + B * B < 1) {
                if (c > 37) { n = (j = c & 1) ? 6 : 4; o = .5 / (a + .01) + C(b * 125) * 3 - a * 300; w = b * h; return [o * C(n) + w * S(n) + j * 610 - 390, o * S(n) - w * C(n) + 550 - j * 350, 1180 + C(B + A) * 99 - j * 300, .4 - a * .1 + P(1 - B * B, -h * 6) * .15 - a * b * .4 + C(a + b) / 5 + P(C((o * (a + 1) + (B > 0 ? w : -w)) / 25), 30) * .1 * (1 - B * B), o / 1e3 + .7 - o * w * 3e-6] } if (c > 32) { c = c * 1.16 - .15; o = a * 45 - 20; w = b * b * h; z = o * S(c) + w * C(c) + 620; return [o * C(c) - w * S(c), 28 + C(B * .5) * 99 - b * b * b * 60 - z / 2 - h, z, (b * b * .3 + P((1 - (A * A)), 7) * .15 + .3) * b, b * .7] } o = A * (2 - b) * (80 - c * 2);
                w = 99 - C(A) * 120 - C(b) * (-h - c * 4.9) + C(P(1 - b, 7)) * 50 + c * 2;
                z = o * S(c) + w * C(c) + 700;
                return [o * C(c) - w * S(c), B * 99 - C(P(b, 7)) * 50 - c / 3 - z / 1.35 + 450, z, (1 - b / 1.2) * .9 + a * .1, P((1 - b), 20) / 4 + .05]
            }
        }
        setInterval('for(i=0;i<1e4;i++)if(s=p(R(),R(),i%46/.74)){z=s[2];x=~~(s[0]*f/z-h);y=~~(s[1]*f/z-h);if(!m[q=y*f+x]|m[q]>z)m[q]=z,a.fillStyle="rgb("+~(s[3]*h)+","+~(s[4]*h)+","+~(s[3]*s[3]*-80)+")",a.fillRect(x,y,1,1)}', 0)


    </script>
</body>

结束

在这里衷心祝大家七夕节日快乐,有女盆友的爱情美满比以前更甜蜜,没女盆友的早日脱单。

文章来源:公众号–小丑的小屋 作者:小丑

以上就是W3Cschool编程狮关于如何使用代码体现一个浪漫七夕的相关介绍了,希望对大家有所帮助。

阿里为什么推荐使用LongAdder,而不是volatile?

thbcm阅读(351)

阿里《Java开发手册》最新嵩山版在不久前发布,其中有一段内容引起了编者的注意,内容如下:

【参考】volatile 解决多线程内存不可见问题。对于一写多读,是可以解决变量同步问题,但是如果多写,同样无法解决线程安全问题。

说明:如果是 count++ 操作,使用如下类实现:AtomicInteger count = new AtomicInteger(); count.addAndGet(1); 如果是 JDK8,推荐使用 LongAdder 对象,比 AtomicLong 性能更好(减少乐观 锁的重试次数)。

以上内容共有两个重点:

  1. 类似于 count++ 这种非一写多读的场景不能使用 volatile
  2. 如果是 JDK8 推荐使用 LongAdder 而非 AtomicLong 来替代 volatile,因为 LongAdder 的性能更好。

但口说无凭,即使是孤尽大佬说的,咱们也得证实一下,因为马老爷子说过:实践是检验真理的唯一标准

这样做也有它的好处,第一,加深了我们对知识的认知;第二,文档上只写了LongAdderAtomicLong 的性能高,但是高多少呢?文中并没有说,那只能我们自己动手去测试喽。

(推荐教程:Java教程

话不多,接下来我们直接进入本文正式内容…

volatile 线程安全测试

首先我们来测试 volatile 在多写环境下的线程安全情况,测试代码如下:

public class VolatileExample {
    public static volatile int count = 0; // 计数器
    public static final int size = 100000; // 循环测试次数


    public static void main(String[] args) {
        // ++ 方式 10w 次
        Thread thread = new Thread(() -> {
            for (int i = 1; i <= size; i++) {
                count++;
            }
        });
        thread.start();
        // -- 10w 次
        for (int i = 1; i <= size; i++) {
            count--;
        }
        // 等所有线程执行完成
        while (thread.isAlive()) {}
        System.out.println(count); // 打印结果
    }
}

我们把 volatile 修饰的 count 变量 ++ 10w 次,在启动另一个线程 — 10w 次,正常来说结果应该是 0,但是我们执行的结果却为:

1063

结论:由以上结果可以看出 volatile 在多写环境下是非线程安全的,测试结果和《Java开发手册》相吻合。

LongAdder VS AtomicLong

接下来,我们使用 Oracle 官方的 JMH 来测试一下两者的性能,测试代码如下:

import org.openjdk.jmh.annotations.*;
import org.openjdk.jmh.infra.Blackhole;
import org.openjdk.jmh.runner.Runner;
import org.openjdk.jmh.runner.RunnerException;
import org.openjdk.jmh.runner.options.Options;
import org.openjdk.jmh.runner.options.OptionsBuilder;


import java.util.concurrent.TimeUnit;
import java.util.concurrent.atomic.AtomicInteger;
import java.util.concurrent.atomic.LongAdder;


@BenchmarkMode(Mode.AverageTime) // 测试完成时间
@OutputTimeUnit(TimeUnit.NANOSECONDS)
@Warmup(iterations = 1, time = 1, timeUnit = TimeUnit.SECONDS) // 预热 1 轮,每次 1s
@Measurement(iterations = 5, time = 5, timeUnit = TimeUnit.SECONDS) // 测试 5 轮,每次 3s
@Fork(1) // fork 1 个线程
@State(Scope.Benchmark)
@Threads(1000) // 开启 1000 个并发线程
public class AlibabaAtomicTest {


    public static void main(String[] args) throws RunnerException {
        // 启动基准测试
        Options opt = new OptionsBuilder()
                .include(AlibabaAtomicTest.class.getSimpleName()) // 要导入的测试类
                .build();
        new Runner(opt).run(); // 执行测试
    }


    @Benchmark
    public int atomicTest(Blackhole blackhole) throws InterruptedException {
        AtomicInteger atomicInteger = new AtomicInteger();
        for (int i = 0; i < 1024; i++) {
            atomicInteger.addAndGet(1);
        }
        // 为了避免 JIT 忽略未被使用的结果
        return atomicInteger.intValue();
    }


    @Benchmark
    public int longAdderTest(Blackhole blackhole) throws InterruptedException {
        LongAdder longAdder = new LongAdder();
        for (int i = 0; i < 1024; i++) {
            longAdder.add(1);
        }
        return longAdder.intValue();
    }
}

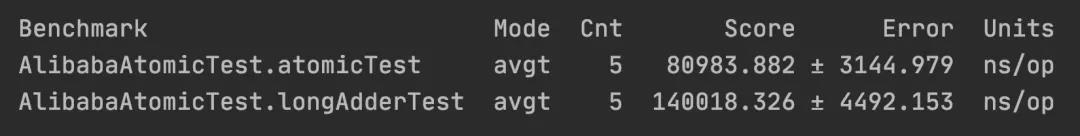
程序执行的结果为:

从上述的数据可以看出,在开启了 1000 个线程之后,程序的 LongAdder 的性能比 AtomicInteger 快了约 1.53 倍,你没看出是开了 1000 个线程,为什么要开这么多呢?这其实是为了模拟高并发高竞争的环境下二者的性能查询。

如果在低竞争下,比如我们开启 100 个线程,测试的结果如下:

结论:从上面结果可以看出,在低竞争的并发环境下 AtomicInteger的性能是要比 LongAdder 的性能好,而高竞争环境下 LongAdder的性能比 AtomicInteger,当有 1000 个线程运行时,LongAdder 的性能比 AtomicInteger 快了约 1.53 倍,所以各位要根据自己业务情况选择合适的类型来使用。

性能分析

为什么会出现上面的情况?这是因为 AtomicInteger 在高并发环境下会有多个线程去竞争一个原子变量,而始终只有一个线程能竞争成功,而其他线程会一直通过 CAS 自旋尝试获取此原子变量,因此会有一定的性能消耗;而 LongAdder 会将这个原子变量分离成一个 Cell 数组,每个线程通过 Hash 获取到自己数组,这样就减少了乐观锁的重试次数,从而在高竞争下获得优势;而在低竞争下表现的又不是很好,可能是因为自己本身机制的执行时间大于了锁竞争的自旋时间,因此在低竞争下表现性能不如 AtomicInteger

(推荐微课:Java微课

总结

本文我们测试了 volatile 在多写情况下是非线程安全的,而在低竞争的并发环境下 AtomicInteger 的性能是要比 LongAdder 的性能好,而高竞争环境下 LongAdder 的性能比 AtomicInteger,因此我们在使用时要结合自身的业务情况来选择相应的类型。

文章来源:公众号– Java中文社群 作者:磊哥

以上就是W3Cschool编程狮关于阿里为什么推荐使用LongAdder,而不是volatile?的相关介绍了,希望对大家有所帮助。

6种对象复制工具类,该如何选择呢?

thbcm阅读(359)

在日常工作中,我们难免会碰到对象属性复制的时候,下面就一个常见的三层 MVC 架构举例。
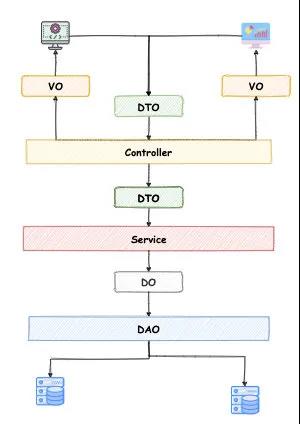
当我们在上面的架构下编程时,我们通常需要经历对象转化,比如业务请求流程经历三层机构后需要把 DTO 转为DO然后在数据库中保存。

当需要从数据查询数据页面展示时,查询数据经过三层架构将会从 DO 转为 DTO,最后再转为 VO,然后在页面中展示。

当业务简单的时候,我们手写代码,通过 getter/setter复制对象属性,十分简单。但是一旦业务变的复杂,对象属性变得很多,那么手写代码就会成为程序员的噩梦。

不但手写十分繁琐,非常耗时间,并且还可能容易出错。

小编之前就经历过一个项目,一个对象中大概有四五十个字段属性,那时候小编还刚入门,什么都不太懂,写了半天 getter/setter复制对象属性。

话外音:一个对象属性这么多,显然是不太合理的,我们设计过程应该将其拆分。

直到后来,小编了解到了对象属性复制工具类,使用之后,发现是真香,再也不用手写代码。再后来,碰到越来越多工具类,虽然核心功能都是一样的,但是还是存在很多差异。新手看到可能会一脸懵逼,不知道如何选择。

所以小编今天这篇介绍一下市面上常用的工具类:

  • Apache BeanUtils
  • Spring BeanUtils
  • Cglib BeanCopier
  • Dozer
  • orika
  • MapStruct

工具类特性

在介绍这些工具类之前,我们来看下一个好用的属性复制工具类,需要有哪些特性:

  • 基本属性复制,这个是基本功能
  • 不同类型的属性赋值,比如基本类型与其包装类型等
  • 不同字段名属性赋值,当然字段名应该尽量保持一致,但是实际业务中,由于不同开发人员,或者笔误拼错单词,这些原因都可能导致会字段名不一致的情况
  • 浅拷贝/深拷贝,浅拷贝会引用同一对象,如果稍微不慎,同时改动对象,就会踩到意想不到的坑

下面我们开始介绍工具类。

(推荐教程:Java教程

Apache BeanUtils

首先介绍是第一位应该是 Java 领域属性复制的最有名的工具类「Apache BeanUtils」,这个工具类想必很多人或多或少用过或则见过。

没用过也没关系,我们来展示这个类的用法,用法非常简单。

首先我们引入依赖,这里使用最新版本:

<dependency>
    <groupId>commons-beanutils</groupId>
    <artifactId>commons-beanutils</artifactId>
    <version>1.9.4</version>
</dependency>

假设我们项目中有如下类:
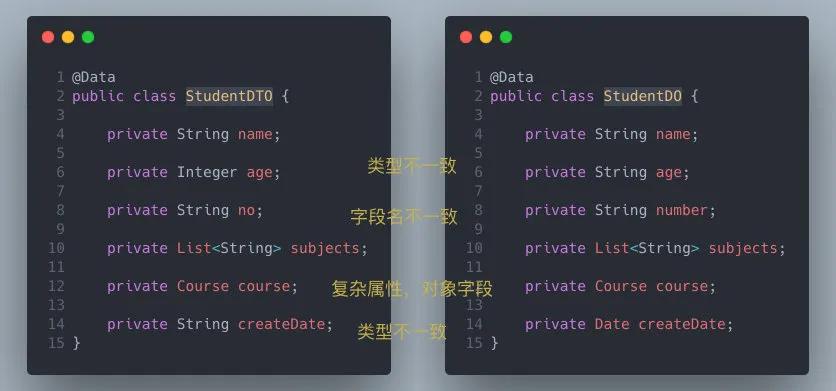
此时我们需要完成 DTO 对象转化到 DO 对象,我们只需要简单调用BeanUtils#copyProperties 方法就可以完成对象属性的复制。

StudentDTO studentDTO = new StudentDTO();
studentDTO.setName("小编");
studentDTO.setAge(18);
studentDTO.setNo("6666");


List<String> subjects = new ArrayList<>();
subjects.add("math");
subjects.add("english");
studentDTO.setSubjects(subjects);
studentDTO.setCourse(new Course("CS-1"));
studentDTO.setCreateDate("2020-08-08");


StudentDO studentDO = new StudentDO();


BeanUtils.copyProperties(studentDO, studentDTO);

不过,上面的代码如果你这么写,我们会碰到第一个问题,BeanUtils默认不支持 String转为 Date 类型。
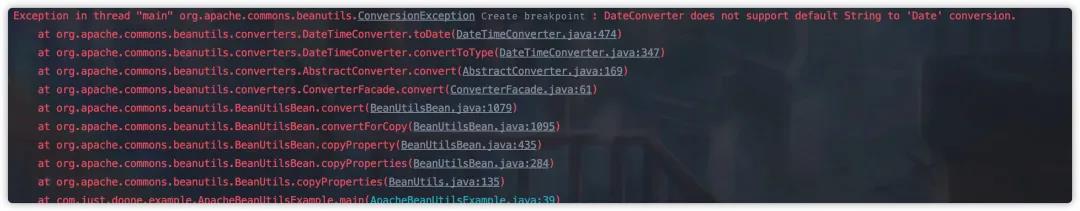
为了解决这个问题,我们需要自己构造一个 Converter 转换类,然后使用 ConvertUtils注册,使用方法如下:

ConvertUtils.register(new Converter() {
    @SneakyThrows
    @Override
    public <Date> Date convert(Class<Date> type, Object value) {
        if (value == null) {
            return null;
        }
        if (value instanceof String) {
            String str = (String) value;
            return (Date) DateUtils.parseDate(str, "yyyy-MM-dd");
        }
        return null;


    }
}, Date.class);

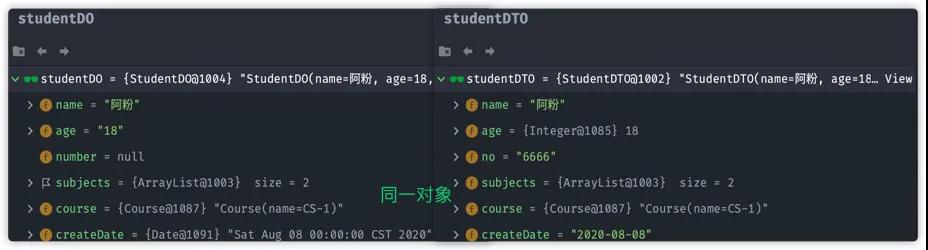
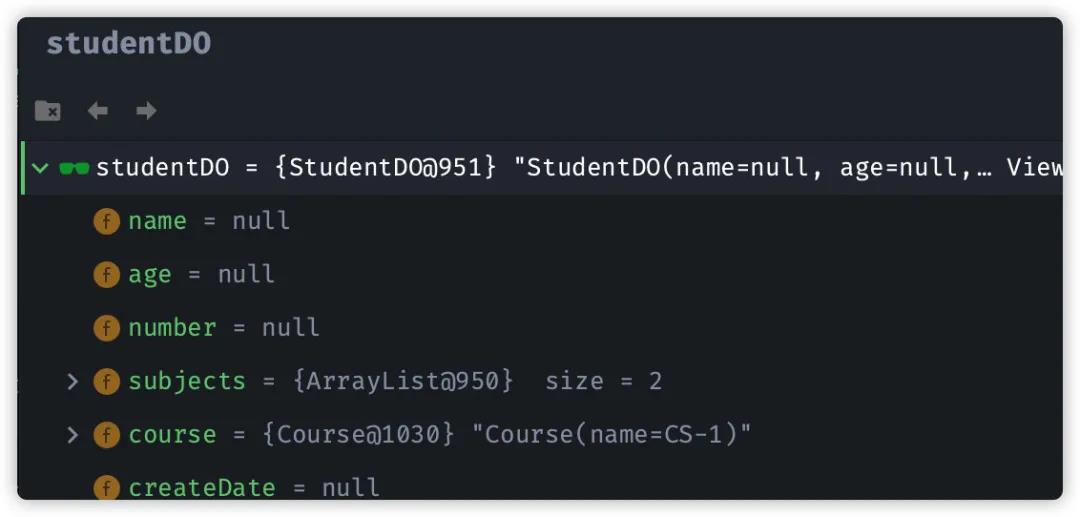
此时,我们观察 studentDOstudentDTO对象属性值:

从上面的图我们可以得出BeanUtils一些结论:

  • 普通字段名不一致的属性无法被复制
  • 嵌套对象字段,将会与源对象使用同一对象,即使用浅拷贝
  • 类型不一致的字段,将会进行默认类型转化。

虽然 BeanUtils 使用起来很方便,不过其底层源码为了追求完美,加了过多的包装,使用了很多反射,做了很多校验,所以导致性能较差,所以并阿里巴巴开发手册上强制规定避免使用 Apache BeanUtils

Spring BeanUtils

Spring 属性复制工具类类名与 Apache 一样,基本用法也差不多。我先来看下 Spring BeanUtils 基本用法。

同样,我们先引入依赖,从名字我们可以看出,BeanUtils 位于 Spring-Beans 模块,这里我们依然使用最新模块。

<dependency>
    <groupId>org.springframework</groupId>
    <artifactId>spring-beans</artifactId>
    <version>5.2.8.RELEASE</version>
</dependency>

这里我们使用 DTO 与 DO 复用上面的例子,转换代码如下:

// 省略上面赋值代码,与上面一致
StudentDO studentDO = new StudentDO();


BeanUtils.copyProperties(studentDTO, studentDO);

从用法可以看到,Spring BeanUtils 与 Apache 有一个最大的不同,两者源对象与目标对象参数位置不一样,小编之前没注意,用了 Spring 工具类,但是却是按照 Apache 的用法使用。

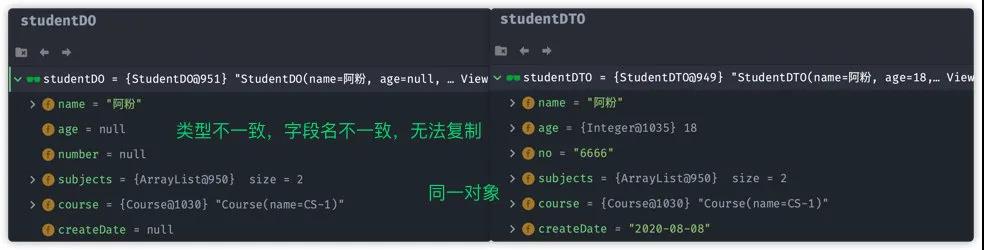
此时对比studentDOstudentDTO对象:

从上面的对比图我们可以得到一些结论:

  • 字段名不一致,属性无法复制
  • 类型不一致,属性无法复制。但是注意,如果类型为基本类型以及基本类型的包装类,这种可以转化
  • 嵌套对象字段,将会与源对象使用同一对象,即使用浅拷贝

除了这个方法之外,Spring BeanUtils 还提供了一个重载方法:

public static void copyProperties(Object source, Object target, String... ignoreProperties) 

使用这个方法,我们可以忽略某些不想被复制过去的属性:

BeanUtils.copyProperties(studentDTO, studentDO,"name");

这样,name 属性就不会被复制到 DO 对象中。
虽然 Spring BeanUtils 与 Apache BeanUtils 功能差不多,但是在性能上 Spring BeanUtils 还是完爆 Apache BeanUtils。主要原因还是在于 Spring 并没有与 Apache 一样使用反射做了过多校验,另外 Spring BeanUtils 内部使用了缓存,加快转换的速度。

所以两者选择,还是推荐使用 Spring BeanUtils。

Cglib BeanCopier

上面两个是小编日常工作经常使用,而下面的这些都是小编最近才开始接触的,比如 Cglib BeanCopier。这个使用方法,可能比上面两个类稍微复杂一点,下面我们来看下具体用法:

首先我们引入 Cglib 依赖:

<dependency>
    <groupId>cglib</groupId>
    <artifactId>cglib</artifactId>
    <version>3.3.0</version>
</dependency>

画外音:如果你工程内还有 Spring-Core 的话,如果查找BeanCopier 这个类,可以发现两个不同的包的同名类。

一个属于 Cglib,另一个属于 Spring-Core。

其实 Spring-Core 内BeanCopier 实际就是引入了 Cglib 中的类,这么做的目的是为包了保证 Spring 使用长度 Cglib 相关类的稳定性,防止外部 Cglib 依赖不一致,导致 Spring 运行异常。

转换代码如下:

// 省略赋值语句
StudentDO studentDO = new StudentDO();
BeanCopier beanCopier = BeanCopier.create(StudentDTO.class, StudentDO.class, false);
beanCopier.copy(studentDTO, studentDO, null);

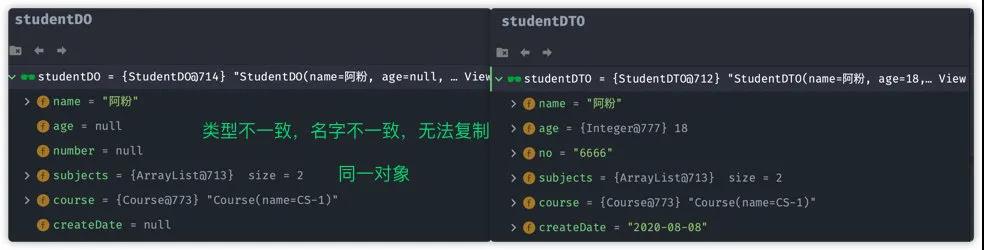
使用方法相比 BeanUtils, BeanCopier 稍微多了一步。 对比studentDOstudentDTO对象:

从上面可以得到与 Spring Beanutils 基本一致的结论:

  • 字段名不一致,属性无法复制
  • 类型不一致,属性无法复制。不过有点不一样,如果类型为基本类型/基本类型的包装类型,这两者无法被拷贝。
  • 嵌套对象字段,将会与源对象使用同一对象,即使用浅拷贝

上面我们使用 Beanutils,遇到这种字段名,类型不一致的这种情况,我们没有什么好办法,只能手写硬编码。

不过在 BeanCopier 下,我们可以引入转换器,进行类型转换。

// 注意最后一个属性设置为 true
BeanCopier beanCopier = BeanCopier.create(StudentDTO.class, StudentDO.class, true);
// 自定义转换器
beanCopier.copy(studentDTO, studentDO, new Converter() {
    @Override
    public Object convert(Object source, Class target, Object context) {
        if (source instanceof Integer) {
            Integer num = (Integer) source;
            return num.toString();
        }
        return null;
    }
});

不过吐槽一下这个转换器,一旦我们自己打开使用转换器,所有属性复制都需要我们自己来了。比如上面的例子中,我们只处理当源对象字段类型为 Integer,这种情况,其他都没处理。我们得到 DO 对象将会只有 name 属性才能被复制。
Cglib BeanCopier 的原理与上面两个 Beanutils 原理不太一样,其主要使用 字节码技术动态生成一个代理类,代理类实现get 和 set方法。生成代理类过程存在一定开销,但是一旦生成,我们可以缓存起来重复使用,所有 Cglib 性能相比以上两种 Beanutils 性能比较好。

Dozer

Dozer ,中文直译为挖土机 ,这是一个「重量级」属性复制工具类,相比于上面介绍三个工具类,Dozer 具有很多强大的功能。

画外音:重量级/轻量级其实只是一个相对的说法,由于 Dozer 相对 BeanUtils 这类工具类来说,拥有许多高级功能,所以相对来说这是一个重量级工具类。

小编刚碰到这个工具类,就被深深折服,真的太强大了,上面我们期望的功能,Dozer 都给你实现了。

下面我们来看下使用方法,首先我们引入 Dozer 依赖:

<dependency>
  <groupId>net.sf.dozer</groupId>
  <artifactId>dozer</artifactId>
  <version>5.4.0</version>
</dependency>

使用方法如下:

// 省略属性的代码
DozerBeanMapper mapper = new DozerBeanMapper();
StudentDO studentDO =
        mapper.map(studentDTO, StudentDO.class);
System.out.println(studentDO);

Dozer 需要我们新建一个DozerBeanMapper,这个类作用等同与 BeanUtils,负责对象之间的映射,属性复制。

画外音:下面的代码我们可以看到,生成 DozerBeanMapper实例需要加载配置文件,随意生成代价比较高。在我们应用程序中,应该使用单例模式,重复使用DozerBeanMapper

如果属性都是一些简单基本类型,那我们只要使用上面代码,可以快速完成属性复制。

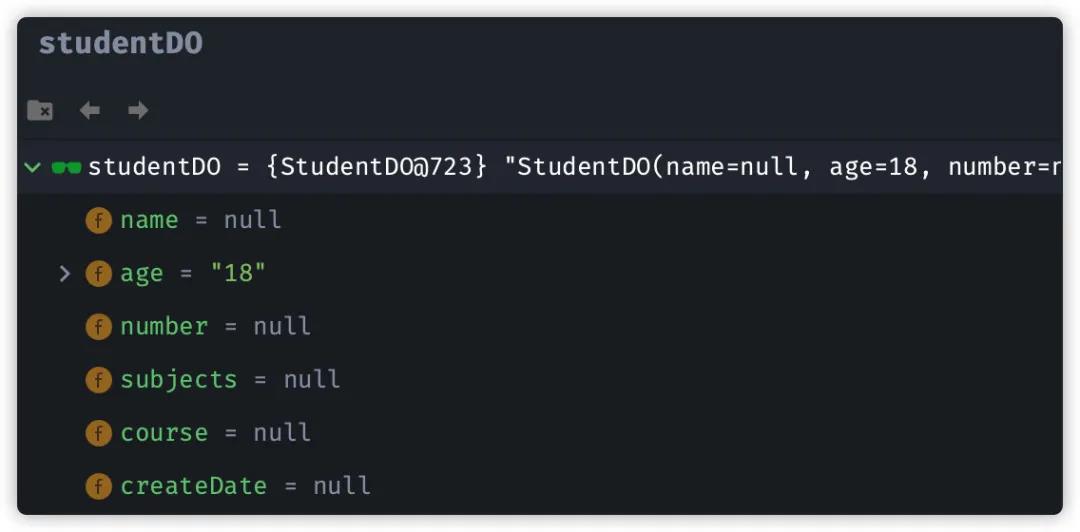
不过很不幸,我们的代码中有字符串与 Date 类型转化,如果我们直接使用上面的代码,程序运行将会抛出异常。
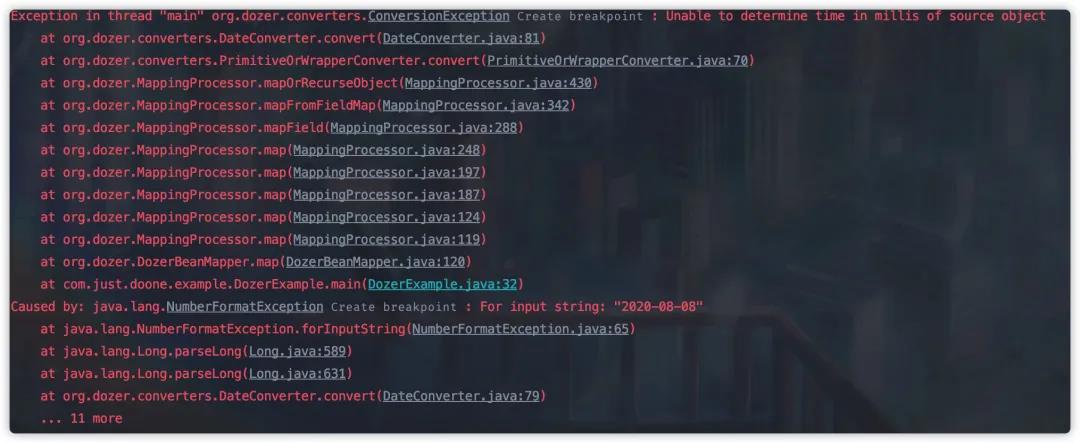
所以这里我们要用到 Dozer 强大的配置功能,我们总共可以使用下面三种方式:

  • XML
  • API
  • 注解

其中,API 的方式比较繁琐,目前大部分使用 XML 进行,另外注解功能的是在 Dozer 5.3.2 之后增加的新功能,不过功能相较于 XML 来说较弱。

XML 使用方式

下面我们使用 XML 配置方式,配置 DTO 与 DO 关系,首先我们新建一个dozer/dozer-mapping.xml 文件:

<?xml version="1.0" encoding="UTF-8"?>
<mappings xmlns="http://dozer.sourceforge.net" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
          xsi:schemaLocation="http://dozer.sourceforge.net
          http://dozer.sourceforge.net/schema/beanmapping.xsd">
    <!-- 类级别的日期转换,默认使用这个格式转换    -->
    <mapping date-format="yyyy-MM-dd HH:mm:ss">
        <class-a>com.just.doone.example.domain.StudentDTO</class-a>
        <class-b>com.just.doone.example.domain.StudentDO</class-b>
        <!-- 在下面指定字段名不一致的映射关系       -->
        <field>
            <a>no</a>
            <b>number</b>
        </field>


        <field>
            <!-- 字段级别的日期转换,将会覆盖字段上的转换            -->
            <a date-format="yy-MM-dd">createDate</a>
            <b>createDate</b>
        </field>
    </mapping>
</mappings>

然后修改我们的 Java 代码,增加读取 Dozer 的配置文件:

DozerBeanMapper mapper = new DozerBeanMapper();
List<String> mappingFiles = new ArrayList<>();
// 读取配置文件
mappingFiles.add("dozer/dozer-mapping.xml");
mapper.setMappingFiles(mappingFiles);
StudentDO studentDO = mapper.map(studentDTO, StudentDO.class);
System.out.println(studentDO);

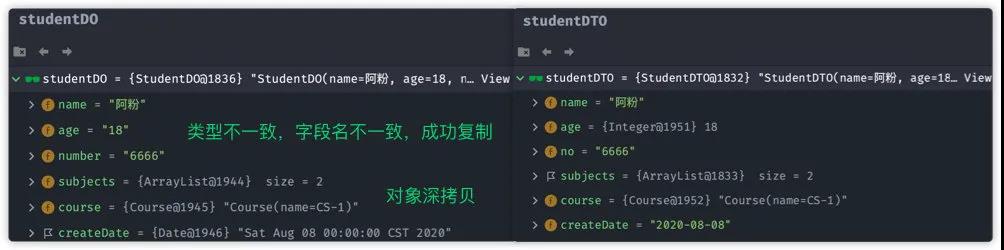
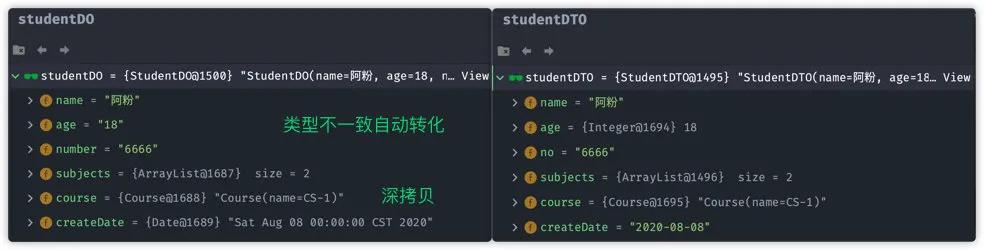
运行之后,对比studentDOstudentDTO对象:

从上面的图我们可以发现:

  • 类型不一致的字段,属性被复制
  • DO 与 DTO 对象字段不是同一个对象,也就是深拷贝
  • 通过配置字段名的映射关系,不一样字段的属性也被复制

除了上述这些相对简单的属性以外,Dozer 还支持很多额外的功能,比如枚举属性复制,Map 等集合属性复制等。
有些小伙伴刚看到 Dozer 的用法,可能觉得这个工具类比较繁琐,不像 BeanUtils 工具类一样一行代码就可以解。

其实 Dozer 可以很好跟 Spring 框架整合,我们可以在 Spring 配置文件提前配置,后续我们只要引用 Dozer 的相应的 Bean ,使用方式也是一行代码。

Dozer 与 Spring 整合,我们可以使用其 DozerBeanMapperFactoryBean,配置如下:

    <bean class="org.dozer.spring.DozerBeanMapperFactoryBean">
        <property name="mappingFiles" 
                  value="classpath*:/*mapping.xml"/>
      <!--自定义转换器-->
        <property name="customConverters">
            <list>
                <bean class=
                      "org.dozer.converters.CustomConverter"/>      
            </list>
        </property>
    </bean>

DozerBeanMapperFactoryBean支持设置属性比较多,可以自定义设置类型转换,还可以设置其他属性。

另外还有一种简单的方法,我们可以在 XML 中配置DozerBeanMapper

    <bean id="org.dozer.Mapper" class="org.dozer.DozerBeanMapper">
        <property name="mappingFiles">
            <list>
                <value>dozer/dozer-Mapperpping.xml</value>
            </list>
        </property>
    </bean>

Spring 配置完成之后,我们在代码中可以直接注入:

@Autowired
Mapper mapper;


public void objMapping(StudentDTO studentDTO) {
// 直接使用
StudentDO studentDO =
mapper.map(studentDTO, StudentDO.class);
}

注解方式

Dozer 注解方式相比 XML 配置来说功能很弱,只能完成字段名不一致的映射。

上面的代码中,我们可以在 DTO 的 no 字段上使用 @Mapping 注解,这样我们在使用 Dozer 完成转换时,该字段属性将会被复制。

@Data
public class StudentDTO {


    private String name;


    private Integer age;
    @Mapping("number")
    private String no;


    private List<String> subjects;


    private Course course;
    private String createDate;
}

虽然目前注解功能有点薄弱,不过后看版本官方可能增加新的注解功能,另外 XML 与注解可以一起使用。

最后 Dozer 底层本质上还是使用了反射完成属性的复制,所以执行速度并不是那么理想。

orika

orika也是一个跟 Dozer 类似的重量级属性复制工具类,也提供诸如 Dozer 类似的功能。但是 orika 无需使用繁琐 XML 配置,它自身提供一套非常简洁的 API 用法,非常容易上手。

首先我们引入其最新的依赖:

<dependency>
    <groupId>ma.glasnost.orika</groupId>
    <artifactId>orika-core</artifactId>
    <version>1.5.4</version>
</dependency>

基本使用方法如下:

// 省略其他设值代码


// 这里先不要设值时间
// studentDTO.setCreateDate("2020-08-08");


MapperFactory mapperFactory = new DefaultMapperFactory.Builder().build();
MapperFacade mapper = mapperFactory.getMapperFacade();
StudentDO studentDO = mapper.map(studentDTO, StudentDO.class);

这里我们引入两个类 MapperFactoryMapperFacade,其中 MapperFactory 可以用于字段映射,配置转换器等,而 MapperFacade 的作用就与 Beanutils 一样,用于负责对象的之间的映射。

上面的代码中,我们故意注释了 DTO 对象中的 createDate 时间属性的设值,这是因为默认情况下如果没有单独设置时间类型的转换器,上面的代码将会抛错。

另外,上面的代码中,对于字段名不一致的属性,是不会复制的,所以我们需要单独设置。

下面我们就设置一个时间转换器,并且指定一下字段名:

MapperFactory mapperFactory = new DefaultMapperFactory.Builder().build();
ConverterFactory converterFactory = mapperFactory.getConverterFactory();
converterFactory.registerConverter(new DateToStringConverter("yyyy-MM-dd"));
mapperFactory.classMap(StudentDTO.class, StudentDO.class)
        .field("no", "number")
      // 一定要调用下 byDefault
        .byDefault()
        .register();
MapperFacade mapper = mapperFactory.getMapperFacade();
StudentDO studentDO = mapper.map(studentDTO, StudentDO.class);

上面的代码中,首先我们需要在 ConverterFactory 注册一个时间类型的转换器,其次我们还需要再 MapperFactory 指定不同字段名的之间的映射关系。

这里我们要注意,在我们使用 classMap 之后,如果想要相同字段名属性默认被复制,那么一定调用 byDefault方法。

简单对比一下 DTO 与 DO 对象:
上图可以发现 orika 的一些特性:

  • 默认支持类型不一致(基本类型/包装类型)转换
  • 支持深拷贝
  • 指定不同字段名映射关系,属性可以被成功复制。

另外 orika 还支持集合映射:

MapperFactory mapperFactory = new DefaultMapperFactory.Builder().build();
List<Person> persons = new ArrayList<>();
List<PersonDto> personDtos = mapperFactory.getMapperFacade().mapAsList(persons, PersonDto.class);

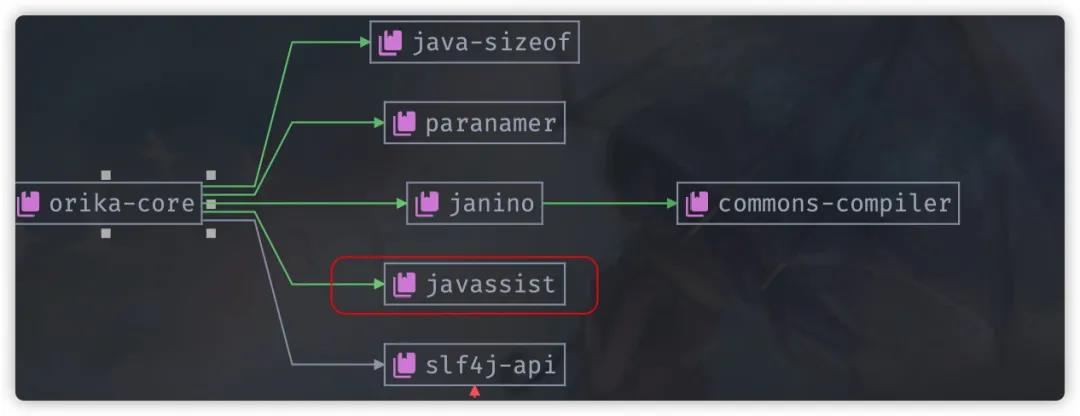
最后聊下 orika 实现原理,orika 与 dozer 底层原理不太一样,底层其使用了 javassist 生成字段属性的映射的字节码,然后直接动态加载执行字节码文件,相比于 Dozer 的这种使用反射原来的工具类,速度上会快很多。
MapStruct

不知不觉,一口气已经写了 5 个属性复制工具类,小伙伴都看到这里,那就不要放弃了,坚持看完,下面将介绍一个与上面这些都不太一样的工具类「MapStruct」。

上面介绍的这些工具类,不管使用反射,还是使用字节码技术,这些都需要在代码运行期间动态执行,所以相对于手写硬编码这种方式,上面这些工具类执行速度都会慢很多。

那有没有一个工具类的运行速度与硬编码这种方式差不多那?

这就要介绍 MapStruct 这个工具类,这个工具类之所以运行速度与硬编码差不多,这是因为他在编译期间就生成了 Java Bean 属性复制的代码,运行期间就无需使用反射或者字节码技术,所以确保了高性能。

另外,由于编译期间就生成了代码,所以如果有任何问题,编译期间就可以提前暴露,这对于开发人员来讲就可以提前解决问题,而不用等到代码应用上线了,运行之后才发现错误。

下面我们来看下,怎么使用这个工具类,首先我们先引入这个依赖:

<dependency>
    <groupId>org.mapstruct</groupId>
    <artifactId>mapstruct</artifactId>
    <version>1.3.1.Final</version>
</dependency>

其次,由于 MapStruct 需要在编译器期间生成代码,所以我们需要 maven-compiler-plugin插件中配置:

<plugin>
    <groupId>org.apache.maven.plugins</groupId>
    <artifactId>maven-compiler-plugin</artifactId>
    <version>3.8.1</version>
    <configuration>
        <source>1.8</source> <!-- depending on your project -->
        <target>1.8</target> <!-- depending on your project -->
        <annotationProcessorPaths>
            <path>
                <groupId>org.mapstruct</groupId>
                <artifactId>mapstruct-processor</artifactId>
                <version>1.3.1.Final</version>
            </path>
            <!-- other annotation processors -->
        </annotationProcessorPaths>
    </configuration>
</plugin>

接下来我们需要定义映射接口,代码如下:

@Mapper
public interface StudentMapper {


    StudentMapper INSTANCE = Mappers.getMapper(StudentMapper.class);

  
    @Mapping(source = "no", target = "number")
    @Mapping(source = "createDate", target = "createDate", dateFormat = "yyyy-MM-dd")
    StudentDO dtoToDo(StudentDTO studentDTO);
}

我们需要使用 MapStruct 注解 @Mapper 定义一个转换接口,这样定义之后,StudentMapper 的功能就与 BeanUtils 等工具类一样了。

其次,由于我们 DTO 与 DO 对象中存在字段名不一致的情况,所以我们还在在转换方法上使用 @Mapping 注解指定字段映射。另外我们 createDate 字段类型不一致,这里我们还需要指定时间格式化类型。

上面定义完成之后,我们就可以直接使用 StudentMapper 一行代码搞定对象转换。

// 忽略其他代码
StudentDO studentDO = StudentMapper.INSTANCE.dtoToDo(studentDTO);

如果我们对象使用 Lombok 的话,使用 @Mapping指定不同字段名,编译期间可能会抛出如下的错误:

这个原因主要是因为 Lombok 也需要编译期间自动生成代码,这就可能导致两者冲突,当 MapStruct 生成代码时,还不存在 Lombok 生成的代码。

解决办法可以在 maven-compiler-plugin插件配置中加入 Lombok,如下:

<plugin>
    <groupId>org.apache.maven.plugins</groupId>
    <artifactId>maven-compiler-plugin</artifactId>
    <version>3.8.1</version>
    <configuration>
        <source>1.8</source> <!-- depending on your project -->
        <target>1.8</target> <!-- depending on your project -->
        <annotationProcessorPaths>
            <path>
                <groupId>org.mapstruct</groupId>
                <artifactId>mapstruct-processor</artifactId>
                <version>1.3.1.Final</version>
            </path>
            <path>
                <groupId>org.projectlombok</groupId>
                <artifactId>lombok</artifactId>
                <version>1.18.12</version>
            </path>
            <!-- other annotation processors -->
        </annotationProcessorPaths>
    </configuration>
</plugin>

输出 DO 与 DTO 如下:
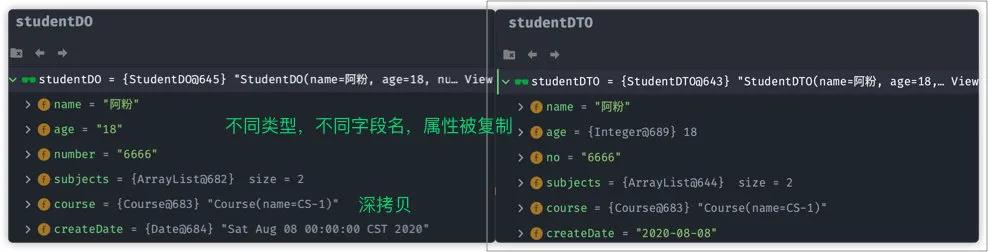
从上图中我们可以得到一些结论:

  • 部分类型不一致,可以自动转换,比如
    • 基本类型与包装类型
    • 基本类型的包装类型与 String
  • 深拷贝

上面介绍的例子介绍一些简单字段映射,如果小伙伴在工作总共还碰到其他的场景,可以先查看一下这个工程,查看一下有没有结局解决办法:github.com/mapstruct/mapstruct-examples

上面我们已经知道 MapStruct 在编译期间就生成了代码,下面我们来看下自动生成代码:

public class StudentMapperImpl implements StudentMapper {
    public StudentMapperImpl() {
    }


    public StudentDO dtoToDo(StudentDTO studentDTO) {
        if (studentDTO == null) {
            return null;
        } else {
            StudentDO studentDO = new StudentDO();
            studentDO.setNumber(studentDTO.getNo());


            try {
                if (studentDTO.getCreateDate() != null) {
                    studentDO.setCreateDate((new SimpleDateFormat("yyyy-MM-dd")).parse(studentDTO.getCreateDate()));
                }
            } catch (ParseException var4) {
                throw new RuntimeException(var4);
            }


            studentDO.setName(studentDTO.getName());
            if (studentDTO.getAge() != null) {
                studentDO.setAge(String.valueOf(studentDTO.getAge()));
            }


            List<String> list = studentDTO.getSubjects();
            if (list != null) {
                studentDO.setSubjects(new ArrayList(list));
            }


            studentDO.setCourse(studentDTO.getCourse());
            return studentDO;
        }
    }
}

从生成的代码来看,里面并没有什么黑魔法,MapStruct 自动生成了一个实现类 StudentMapperImpl,里面实现了 dtoToDo,方法里面调用getter/setter设值。

从这个可以看出,MapStruct 作用就相当于帮我们手写getter/setter设值,所以它的性能会很好。

(推荐微课:Java微课

总结

看文这篇文章,我们一共学习了 7 个属性复制工具类,这么多工具类我们该如何选择那?小编讲讲自己的一些见解:

第一,首先我们直接抛弃 Apache Beanutils ,这个不用说了,阿里巴巴规范都这样定了,我们就不要使用好了。

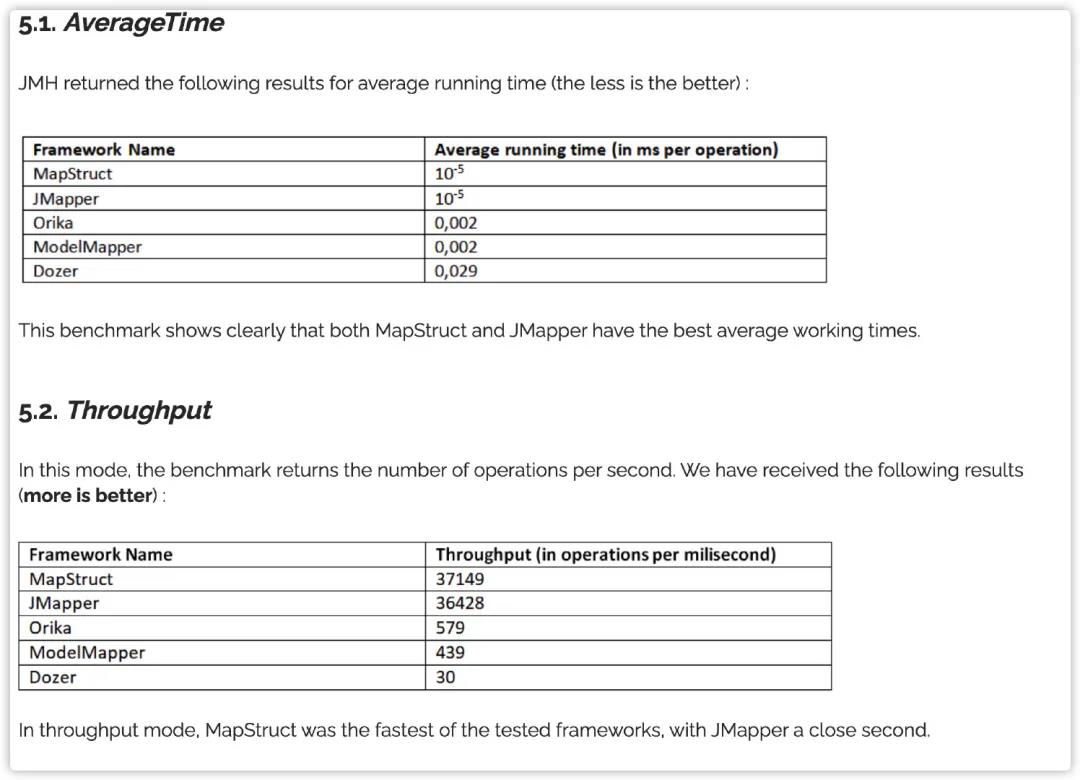
第二,当然是看工具类的性能,这些工具类的性能,网上文章介绍的比较多,小编就复制过来,大家可以比较一下。
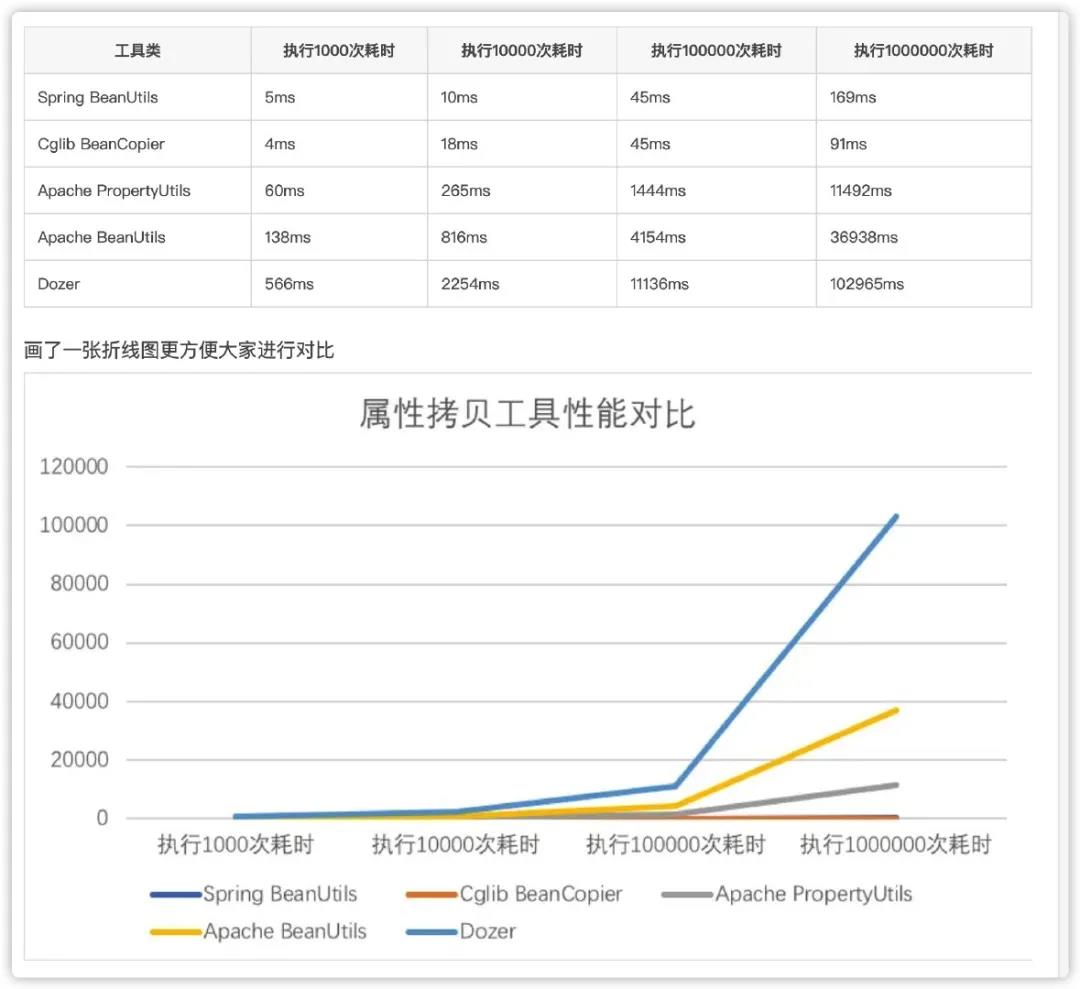
可以看到 MapStruct 的性能可以说还是相当优秀。那么如果你的业务对于性能,响应等要求比较高,或者你的业务存在大数据量导入/导出的场景,而这个代码存在对象转化,那就切勿使用 Apache Beanutils, Dozer 这两个工具类。

第三,其实很大一部分应用是没有很高的性能的要求,只要工具类能提供足够的便利,就可以接受。如果你的业务中没有很复杂的的需求,那么直接使用 Spring Beanutils 就好了,毕竟 Spring 的包大部分应用都在使用,我们都无需导入其他包了。

那么如果业务存在不同类型,不同的字段名,那么可以考虑使用 orika 等这种重量级工具类。

文章来源:公众号–Java极客技术 作者:鸭血粉丝

以上就是W3Cschool编程狮关于 6种对象复制工具类,该如何选择呢?的相关介绍了,希望对大家有所帮助。

12题精选的CSS面试题(含解析)

thbcm阅读(324)

本文收集整理了12道关于CSS的面试题,大家一起来看看吧。

1.在 css 选择器当中,优先级排序正确的是()

A、id选择器>标签选择器>类选择器

B、标签选择器>类选择器>id选择器

C、类选择器>标签选择器>id选择器

D、id选择器>类选择器>标签选择器

4个等级的定义如下:

第一等:代表内联样式,如: style=””,权值为1000

第二等:代表ID选择器,如:#content,权值为100

第三等:代表类,伪类和属性选择器,如.content,权值为10

第四等:代表类型选择器和伪元素选择器,如div p,权值为1

2.下列定义的 css 中,哪个权重是最低的?( )

A、#game .name

B、#game .name span

C、#game div

D、#game div.name

权重越大,优先级越高

CSS选择器优先级是指基础选择器的优先级:

ID` > `CLASS` > `ELEMENT` > `*

3、关于HTML语义化,以下哪个说法是正确的?( )

A、语义化的HTML有利于机器的阅读,如PDA手持设备、搜索引擎爬虫;但不利于人的阅读

B、Table 属于过时的标签,遇到数据列表时,需尽量使用 div 来模拟表格

C、语义化是HTML5带来的新概念,此前版本的HTML无法做到语义化

D、headerarticleaddress都属于语义化明确的标签

解析:

选D

1、什么是HTML语义化?

根据内容的结构化(内容语义化),选择合适的标签(代码语义化)便于开发者阅读和写出更优雅的代码的同时让浏览器的爬虫和机器很好地解析。

2、为什么要语义化?

为了在没有CSS的情况下,页面也能呈现出很好地内容结构、代码结构

用户体验:例如titlealt用于解释名词或解释图片信息、label标签的活用;

有利于SEO :和搜索引擎建立良好沟通,有助于爬虫抓取更多的有效信息:

爬虫依赖于标签来确定上下文和各个关键字的权重;方便其他设备解析(如屏幕阅读器、盲人阅读器、移动设备)以意义的方式来渲染网页;

便于团队开发和维护,语义化更具可读性,是下一步吧网页的重要动向,遵循W3C标准的团队都遵循这个标准,可以减少差异化

4、CSS 样式,下面哪一个元素能够达到最大宽度,且前后各有一个换行?( )

A、Block Element

B、Square Element

C、Side Element

D、Box Element

解析:

选A

块级元素block element

行内元素 inline element

行内块元素inline-block element

5、放在HTML里的哪一部分JavaScripts会在页面加载的时候被执行?( )

A、文件头部位置

B、文件尾

C、<head>标签部分

D、<body>标签部分

解析:

选D

head部分中的JavaScripts会在被调用的时候才执行。

body部分中的JavaScripts会在页面加载的时候被执行。

6、下列说法正确的有:( )

A、visibility:hidden;所占据的空间位置仍然存在,仅为视觉上的完全透明;

B、display:none;不为被隐藏的对象保留其物理空间;

C、visibility:hidden;与display:none;两者没有本质上的区别;

D、visibility:hidden;产生reflowrepaint(回流与重绘);

AB

visiblity:看不见,摸的着.

display:看不见,摸不着.

displaydom级别的,可以渲染和重绘。

visiblity不是dom级别的,不能重绘,只能渲染

7、新窗口打开网页,用到以下哪个值( )

A、_self

B、_blank

C、_top

D、_parent

解析:

B

html中通过<a>标签打开一个链接,通过 <a> 标签的 target

属性规定在何处打开链接文档。

如果在标签<a>中写入target属性,则浏览器会根据target的属性值去打开与其命名或名称相符的 框架<frame>或者窗口.

target中还存在四个保留的属性值如下,

_black:在新窗口中打开被链接文档

_self:默认。在相同的框架中打开被链接文档

_ parent:在父框架中打开被链接文档

_top:在整个窗口中打开被链接文档

framename:在指定框架中打开被链接文档

8、下列说法错误的是( )

A、设置display:none后的元素只会导致浏览器的重排而不会重绘

B、设置visibility:hidde后的元素只会导致浏览器重绘而不会重排

C、设置元素opacity:0之后,也可以触发点击事件

D、visibility:hidden的元素无法触发其点击事件

解析:

A

设置display:none后的元素会导致浏览器的重排重绘

9、超链接访问过后hover样式就不出现了,被点击访问过的超链接样式不再具有hoveractive了,解决方法是改变CSS属性的排列顺序?( )

A、a:link {} a:visited {} a:hover {} a:active {}

B、a:visited {} a:link {} a:hover {} a:active {}

C、a:active {} a:link {} a:hover {} a:visited {}

D、a:link {} a:active {} a:hover {} a:visited {}

解析:

A

a:link`; `a:visited`; `a:hover`; `a:active;

a:hover必须放在a:linka:visited之后;

a:active必须放在a:hover之后。

10、关于position定位,下列说法错误的是( )

A、fixed元素,可定位于相对于浏览器窗口的指定坐标,它始终是以 body 为依据

B、relative元素以它原来的位置为基准偏移,在其移动后,原来的位置不再占据空间

C、absolute 的元素,如果它的 父容器设置了 position 属性,并且 position 的属性值为 absolute 或者 relative,那么就会依据父容器进行偏移

D、fixed 属性的元素在标准流中不占位置

解析:

B

absolute:生成绝对定位的元素,相对于static定位以外的第一个父元素进行定位,元素的位置通过lefttopright、以及bottom属性进行规定fixed

生成绝对定位的元素,相对于浏览器窗口进行定位,元素的位置通过lefttopright以及bottom属性进行规定relative

生成相对定位的元素,相对于其正常位置进行定位,因此,left:20会向元素的LEFT位置添加20像素static

默认值,没有定位,元素出现正常的流中(忽略topbottomleftright或者z-index声明)inherit

规定应该从父元素继承position属性的值

11、css中哪些属性可以继承( )

A、font-size

B、color

C、font-family

D、border

解析:

ABC

margin padding border display 不可以继承

12、cssclear的作用是什么?( )

A、清除该元素所有样式

B、清除该元素父元素的所有样式

C、指明该元素周围不可出现浮动元素

D、指明该元素的父元素周围不可出现浮动元素

解析:

C

clear` : `none` | `left` | `right` | `both

(推荐教程:CSS教程

对于CSS的清除浮动(clear), 这个规则只能影响使用清除的元素本身,不能影响其他元素

文章来源:公众号–前端人 作者:鬼哥

以上就是W3Cschool编程狮关于12题精选的CSS面试题(含解析)的相关介绍了,希望对大家有所帮助。

做JS逆向时,Python怎么调用JS代码

thbcm阅读(316)

有次在做JS逆向时,我不知道怎么用Python去实现,估计是我水平不够,那该怎么办呢?本文给大家介绍一个第三方库——pyexecjs,它能很好的解决我碰到的问题,可以用python运行JavaScript代码。

配置环境

node.js

下载地址:https://nodejs.org/en/download/

选好版本直接下就好了,它会自动加入系统环境的,检查Node.js版本,出现版本号就说明配置好了。

Pyexecjs

pip install pyexecjs

基本使用

先检查一下使用的引擎是否为node.js

import execjs


print(execjs.get().name)
运行结果:
Node.js (V8)

运行js代码

pyexecjs运行js代码有两种方法

一、eval()

eval()可以直接执行js代码

import execjs


print(execjs.eval("a = new Array(1, 2, 3)"))
运行结果:
[1, 2, 3]

二、compile()

代码量多的话就推荐用这个方法,先将js代码写入一个文件中,需要的时候读取执行即可。

创建js_text.js文件,写入如下代码:

function a(str) {
    return str;
}

python代码:

import execjs


with open('js_text.js', 'r', encoding='utf-8') as f:
    jstext = f.read()


ctx = execjs.compile(jstext)
a = '123456'
result = ctx.call('a', a)
print(result)
运行结果:
123456

先调用compile编译js代码,再调用call方法进行执行,call的第一个参数的js代码中的函数名,第二个参数是该函数需要的参数(如果有多个参数,直接逗号写下一个参数即可)。

常见的问题

js代码返回的字符串如果有特殊字符的话可能会出错。

解决方法就是先将字符串进行 base64 编码后再返回。

function a(str) {
    return new Buffer(str).toString("base64");
}

有了这个方法你就可以不用重写代码了,直接扣js代码运行即可,扣代码有时会有些变量未声明,在js代码中查找补全即可,帮助你节省脑力。

文章来源:www.toutiao.com/a6864498293032878604/

以上就是W3Cschool编程狮关于做JS逆向时,Python怎么调用JS代码的相关介绍了,希望对大家有所帮助。

完整的Explain宝典,SQL优化再也不用担心了

thbcm阅读(331)

在日常编程中,我们需要经常与数据库打交道,所以本文给大家带来一些关于Explain的总结,让大家更好的处理SQL

select 语句之前增加 explain 关键字,MySQL 会在查询上设置一个标记,执行查询时,会返回执行计划的信息,而不是执行这条SQL(如果 from 中包含子查询,仍会执行该子查询,将结果放入临时表中)

CREATE TABLE `film` (
  `id` int(11) NOT NULL AUTO_INCREMENT,
  `name` varchar(10) DEFAULT NULL,
  PRIMARY KEY (`id`),
  KEY `idx_name` (`name`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8;


CREATE TABLE `actor` (
  `id` int(11) NOT NULL,
  `name` varchar(45) DEFAULT NULL,
  `update_time` datetime DEFAULT NULL,
  PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8;


CREATE TABLE `film_actor` (
  `id` int(11) NOT NULL,
  `film_id` int(11) NOT NULL,
  `actor_id` int(11) NOT NULL,
  `remark` varchar(255) DEFAULT NULL,
  PRIMARY KEY (`id`),
  KEY `idx_film_actor_id` (`film_id`,`actor_id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8

两个变种

explain extended

会在 explain 的基础上额外提供一些查询优化的信息。紧随其后通过 show warnings 命令可以 得到优化后的查询语句,从而看出优化器优化了什么。额外还有 filtered 列,是一个半分比的值,rows * filtered/100 可以估算出将要和 explain 中前一个表进行连接的行数(前一个表指 explain 中的 id 值比当前表 id 值小的表)

mysql> explain extended select * from film where id = 

mysql> show warnings;

explain partitions

相比 explain 多了个 partitions 字段,如果查询是基于分区表的话,会显示查询将访问的分区。

(推荐课程:SQL教程)

id列

id列的编号是 select 的序列号,有几个 select 就有几个id,并且id的顺序是按 select 出现的顺序增长的。 MySQLselect 查询分为简单查询(SIMPLE)和复杂查询(PRIMARY)。 复杂查询分为三类:简单子查询、派生表(from语句中的子查询)、union 查询。 id列越大执行优先级越高,id相同则从上往下执行,idNULL最后执行**

select_type列

select_type 表示对应行是简单还是复杂的查询,如果是复杂的查询,又是上述三种复杂查询中的哪一种。

1)simple 简单查询:查询不包含子查询和union

mysql> explain select * from film where id = 2;

2)primary:复杂查询中最外层的 select

3)subquery:包含在 select 中的子查询(不在 from 子句中)

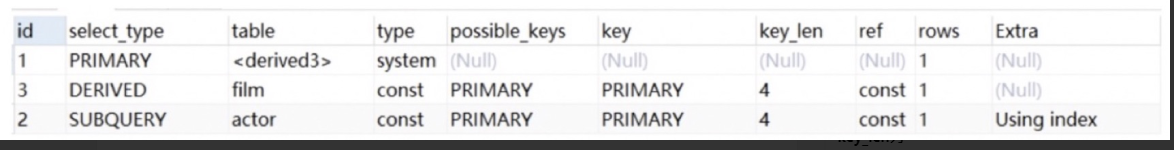
4)derived:包含在 from子句中的子查询。MySQL会将结果存放在一个临时表中,也称为派生表(derived的英文含义) 用这个例子来了解 primarysubqueryderived 类型

mysql> explain select (select 1 from actor where id = 1) from (select * from film where id = 1) der;

5)union:在 union 中的第二个和随后的 select

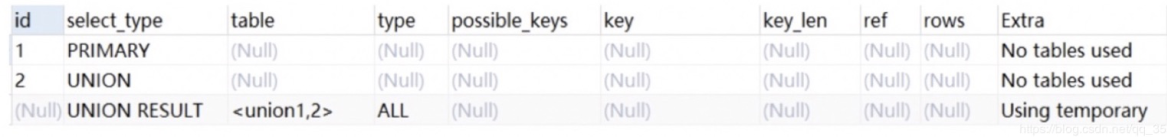
6)union result:从 union 临时表检索结果的 select 用这个例子来了解 unionunion result 类型:

mysql> explain select 1 union all select 1;

table列

这一列表示 explain 的一行正在访问哪个表。 当 from 子句中有子查询时,table列是 格式,表示当前查询依赖 id=N 的查询,于是先执行 id=N 的查询。 当有 union 时,UNION RESULTtable 列的值为<union1,2>,1 和 2 表示参与 unionselect 行 id 。

type列

这一列表示关联类型或访问类型,即MySQL决定如何查找表中的行,查找数据行记录的大概范围。 依次从最优到最差分别为:system > const > eq_ref > ref > range > index > ALL 一般来说,得保证查询达到range级别,最好达到ref

NULL

mysql能够在优化阶段分解查询语句,在执行阶段用不着再访问表或索引。例如:在索引列中选取最小值,可以单独查找索引来完成,不需要在执行时访问表

mysql> explain select min(id) from film;

const, system

mysql能对查询的某部分进行优化并将其转化成一个常量(可以看show warnings 的结果)。用于 primary keyunique key 的所有列与常数比较时,所以表最多有一个匹配行,读取 1 次,速度比较快。systemconst的特例,表里只有一条元组匹配时为system

mysql> explain extended select * from (select * from film where id = 1) tmp;

eq_ref

primary keyunique key 索引的所有部分被连接使用 ,最多只会返回一条符合条件的记录。这可能是在 const 之外最好的联接类型了,简单的 select 查询不会出现这种 type

mysql> explain select * from film_actor left join film on film_actor.film_id = film.id;

ref

相比 eq_ref,不使用唯一索引,而是使用普通索引或者唯一性索引的部分前缀,索引要和某个值相比较,可能会找到多个符合条件的行。

1.简单 select 查询,name是普通索引(非唯一索引)

mysql> explain select * from film where name = "film1";

2.关联表查询,idx_film_actor_idfilm_idactor_id的联合索引,这里使用到了film_actor的左边前缀film_id部分。

mysql> explain select film_id from film left join film_actor on film.id = film_actor.film_id;

range

范围扫描通常出现在 in(), between ,> ,<, >=等操作中。使用一个索引来检索给定范围的行。

mysql> explain select * from actor where id > 1;

index

扫描全表索引,这通常比ALL快一些。( index 是从索引中读取的,而 all 是从硬盘中读取)

mysql> explain select * from film;

ALL

即全表扫描,意味着mysql需要从头到尾去查找所需要的行。通常情况下这需要增加索引来进行优化了

mysql> explain select * from actor;

(推荐课程:MySQL教程)

possible_keys列

这一列显示查询可能使用哪些索引来查找。 explain 时可能出现 possible_keys 有列,而 key 显示 NULL 的情况,这种情况是因为表中数据不多,mysql认为索引对此查询帮助不大,选择了全表查询。 如果该列是NULL,则没有相关的索引。在这种情况下,可以通过检查 where 子句看是否可以创造一个适当的索引来提高查询性能,然后用 explain 查看效果。

key列

这一列显示mysql实际采用哪个索引来优化对该表的访问。 如果没有使用索引,则该列是 NULL。如果想强制mysql使用或忽视possible_keys列中的索引,在查询中使用 force indexignore index

key_len列

这一列显示了mysql在索引里使用的字节数,通过这个值可以算出具体使用了索引中的哪些列。 举例来说,film_actor的联合索引 idx_film_actor_idfilm_idactor_id两个int列组成,并且每个int是 4字节。通过结果中的key_len=4可推断出查询使用了第一个列:film_id列来执行索引查找。

mysql> explain select * from film_actor where film_id = 2;

“key_len计算规则如下: 字符串 char(n):n字节长度 varchar(n):2字节存储字符串长度,如果是utf-8,则长度 3n + 2 数值类型 tinyint:1字节 smallint:2字节 int:4字节 bigint:8字节   时间类型  date:3字节 timestamp:4字节 datetime:8字节”

如果字段允许为 NULL,需要 1字节记录是否为 NULL 索引最大长度是 768字节,当字符串过长时,mysql会做一个类似左前缀索引的处理,将前半部分的字符提取出来做索引。

ref列

这一列显示了在key列记录的索引中,表查找值所用到的列或常量,常见的有:const(常量),字段名(例:film.id)

rows列

这一列是mysql估计要读取并检测的行数,注意这个不是结果集里的行数。

Extra列

这一列展示的是额外信息。常见的重要值如下:

Using index

查询的列被索引覆盖,并且where筛选条件是索引的前导列,是性能高的表现。一般是使用了覆盖索引(索引包含了所有查询的字段)。对于innodb来说,如果是辅助索引性能会有不少提高

mysql> explain select film_id from film_actor where film_id = 1;

Using where

查询的列未被索引覆盖,where筛选条件非索引的前导列

mysql> explain select * from actor where name = 'a';

Using where Using index

查询的列被索引覆盖,并且where筛选条件是索引列之一但是不是索引的前导列,意味着无法直接通过索引查找来查询到符合条件的数据

mysql> explain select film_id from film_actor where actor_id = 1;

NULL

查询的列未被索引覆盖,并且where筛选条件是索引的前导列,意味着用到了索引,但是部分字段未被索引覆盖,必须通过“回表”来实现,不是纯粹地用到了索引,也不是完全没用到索引

mysql>explain select * from film_actor where film_id = 1;

Using index condition

Using where类似,查询的列不完全被索引覆盖,where条件中是一个前导列的范围;

mysql> explain select * from film_actor where film_id > 1;

Using temporary

mysql需要创建一张临时表来处理查询。出现这种情况一般是要进行优化的,首先是想到用索引来优化。

1.actor.name没有索引,此时创建了张临时表来distinct

mysql> explain select distinct name from actor;

2.film.name建立了idx_name索引,此时查询时extrausing index,没有用临时表

mysql> explain select distinct name from film;

(推荐微课:MySQL微课)

Using filesort

mysql会对结果使用一个外部索引排序,而不是按索引次序从表里读取行。此时mysql会根据联接类型浏览所有符合条件的记录,并保存排序关键字和行指针,然后排序关键字并按顺序检索行信息。这种情况下一般也是要考虑使用索引来优化的。

1.actor.name未创建索引,会浏览actor整个表,保存排序关键字name和对应的id,然后排序name并检索行记录

mysql> explain select * from actor order by name;

2.film.name建立了idx_name索引,此时查询时extrausing index

mysql> explain select * from film order by name;

文章来源:juejin.im/post/6863832433062739981

以上就是W3Cschool编程狮关于完整的Explain宝典,SQL优化再也不用担心了的相关介绍了,希望对大家有所帮助。

你应该知道的 Nacos 接入和避坑指南

thbcm阅读(334)

本文给大家分享一个强大的组件Nacos,它是微服务环境下必须要用到的组件。用了Nacos后,再也不用担心服务注册和发现以及配置管理混乱的问题了。

背景

Nacos 致力于帮助开发人员发现、配置和管理微服务,Nacos 提供了一组简单易用的特性集,快速实现动态服务发现、服务配置、服务元数据及流量管理。

目前主流的互联网服务都是基于微服务架构的,那服务与服务之间的交互是必不可少的,而且各个服务的上下线都是相互独立的,而且服务的配置信息也是会动态调整的,这就需要我们的服务更加灵活。Nacos 的出现就是帮助我们实现这些繁琐的功能。

详细的 Nacos 介绍和部署可以参考官方网站 Nacos.io。这里只介绍一下在 SpringBoot 项目中如何快速接入以及接入和使用过程中可能会遇到的坑。

接入

加入依赖

  1. 第一步在 pom 配置文件中加入下面的依赖,用于实现服务注册发现和配置中心功能。
<!-- nacos 配置中心 -->
<dependency>
  <groupId>com.alibaba.cloud</groupId>
  <artifactId>spring-cloud-starter-alibaba-nacos-config</artifactId></dependency>
  <!-- nacos 注册发现 -->
<dependency>
  <groupId>com.alibaba.cloud</groupId>
  <artifactId>spring-cloud-starter-alibaba-nacos-discovery</artifactId></dependency>

增加配置

  1. 第二步在 SpringBoot 项目的启动类上增加如下注解 @EnableDiscoveryClient 用于启动服务注册发现功能。
  1. 增加配置文件,对应的配置信息需要修改成适合自己的,为了方便管理,应用的分组名称,命名空间以及相关的配置都需要合理的设置。多个业务使用同一个 nacos 集群的时候,需要根据各个的业务设定各自的命名空间。所有的配置文件都需要在对应的命名空间下设置,避免多个业务混用,另外业务需要根据用到的组件或者配置,设定独立的配置文件,例如数据库的配置,Redis 的配置等都需要单独设定,这样是为了同一个应用其他的其他服务也可以使用,而且再有地址变更的时候可以只修改一个文件就好,不会忘记。
# 应用服务名称
spring.application.name=application-name
# 应用分组名称
spring.cloud.nacos.config.group=GROUP-NAME
# 配置文件的后缀名
spring.cloud.nacos.config.file-extension=properties
# nacos 对应的命名空间,在后台创建好命名空间后会自动生成
spring.cloud.nacos.config.namespace=xxxxxxxxxxxxxxxxxxxxxxxxx
# 对应的配置文件
# MySQL 相关配置
spring.cloud.nacos.config.ext-config[0].data-id=mysql.properties
spring.cloud.nacos.config.ext-config[0].group=GROUP-NAME
# Redis 相关配置
spring.cloud.nacos.config.ext-config[1].data-id=redis.properties
spring.cloud.nacos.config.ext-config[1].group=GROUP-NAME
# 其他配置等
spring.cloud.nacos.config.ext-config[2].data-id=other.properties
spring.cloud.nacos.config.ext-config[2].group=GROUP-NAME
# 配置中心地址,多个逗号分隔
spring.cloud.nacos.config.server-addr=xxx.xx.xx.xx:xxxx
# 服务注册发现地址,多个逗号分隔
spring.cloud.nacos.discovery.server-addr=xxx.xx.xx.xx:xxxx
# 集群名称
spring.cloud.nacos.discovery.cluster-name=CLUSTER-NAME

  1. 代码中可以使用注解 @Value() 来直接读取 Nacos 配置中的属性参数,也可以使用 @ConfigurationProperties(prefix = "spring.datasource") 读取批量参数。
  1. spring.cloud.nacos.config.ext-config[0].refresh=true 该参数表示是否开启自动更新,根据是否需要自动更新觉得是否配置,如果需要自动更新,加上这个配置后还需要在需要自动更新配置的 Bean 上面增加@RefreshScop 注解。然后对应的 Bean 内部的属性就可以实现自动更新了。增加了spring.cloud.nacos.config.ext-config[0].refresh=true 配置后在修改了 Nacos 中的配置过后日志会出现下面信息,会重新加载配置,并且输出变更的 key 信息。

服务调用

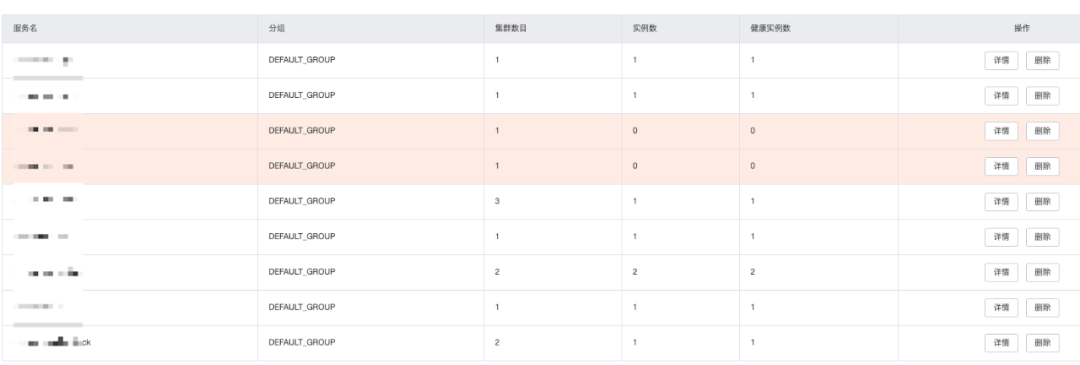
当所有的服务都接入 Nacos 过后,我们在 Nacos 的后台就可以看到每个服务的情况,如下图,可以看到服务状态。

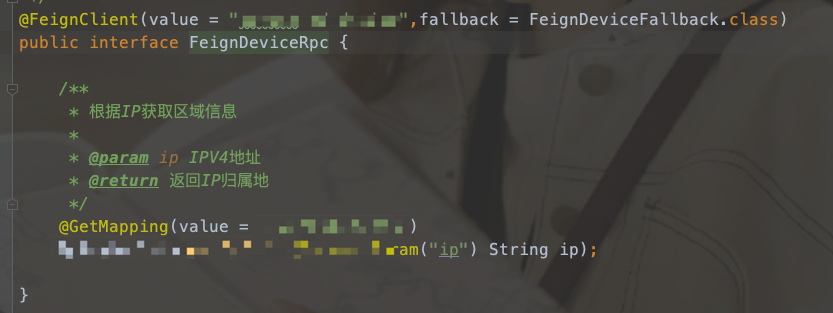
然后我们在服务 A 里面如果要调用服务 B 的时候,就可以直接在 FeginClient 中配置服务 B 的名称,不需要填写 URL 了。这样我们就不用考虑服务 B 是否地址和端口会不会变。服务 B 的实例增加还是减少,端口是否变了,对服务 A 来说都不关心,只要有个服务名称就可以了。

避坑

命名空间

Nacos 有一个默认的名为 public 的命名空间,这个命名空间是无法删除的,所有未指定命名空间的配置都会放在该命名空间下;同样的 Nacos 有一个默认的名为 DEFAULT_GROUP 的分组,在没有指定分组名称的时候默认的配置都是在该分组下。

对于我们应用程序来说,由于很多情况下一个 Nacos 集群是多个团队共同使用的,所以为了方便管理,我们需要根据自己的业务设置自己的命名空间,用于存放本业务的配置文件。本命名空间下的配置文件,根据各个的模块决定是否需要重新分组。

要知道在没有清晰的命名空间划分的时候,要想修改一个配置的内容,是很难受的一件事情。线上的配置调整,一个不小心就是事故。如果还是自动更新配置的话,那连后悔的机会都没有。

精细配置

配置文件应该专一,一个配置文件就设置一个内容,比如 MySQL 的数据源单独一个配置,Redis 的数据源单独一个配置,如果多个 Redis 服务,根据功能建议分开配置,因为并不是所有的服务都需要每个 Redis 的链接配置。各自的服务根据需要单独引用对应的配置文件即可。

将所有的配置独立成一个配置文件方便后续修改配置,只要修改一个配置文件就好,不用担心其他还有未修改的地方。

合理的规划配置文件的内容,往往很多时候可以事半功倍,极大的节约时间和减少出错的概率。

自动刷新

前面介绍了如何设置配置自动刷新,不过服务是否需要自动更新配置,这个根据自身的业务去决定。

我这里一般不建议设置自动更新,因为现在都是微服务部署,有时候我们上线一个新功能的时候都是灰度发布,如果配置自动更新,再调整配置过后,全部实例都会生效,这样会有风险。不设置自动更新的话,我们可以单独重启个别实例,观察线上情况,等稳定了再发布所有服务,这样会安全很多。

当然对于没有那么多服务,不需要灰度,影响不大的场景下,配置自动更新会方便很多,再修改配置后不需要重启服务。

(推荐教程:Spring Boot 那些事)

总结

Nacos 作为服务的注册发现和配置的统一管理确实十分出色,除了能快速接入 SpringBoot 项目之外,其他的框架都能快速的接入,更多使用可以参考官网。

文章来源:公众号–Java极客技术

以上就是W3Cschool编程狮关于你应该知道的 Nacos 接入和避坑指南的相关介绍了,希望对大家有所帮助。

无需代码,使用API操作数据库

thbcm阅读(296)

前言

对于编程人员来说,数据库是必须要接触的,但操作起来却一点都不简单,要用到好几种管理工具,好几种连接方式。假如有一个工具能适用各种数据库,让我们节省大量工作,那该多好。历尽千辛万苦,我总算找到了这么个工具,不仅支持多种数据库,更厉害的是,不用为适配写一行代码,来了解下吧。

神器出场

今天的主角是 sandman2

可以基于已存在的数据库,自动生成一个 RESTful API 服务器,而不需要写任何代码,用作者的话说,简单地就像给食物加点盐

更厉害的是,从简单地 SQLite 数据库,到大型的商业数据 PostgreSQL, 都能完美支持,且不用写一行代码

目前支持的数据库:

  • MySQL
  • PostgreSQL
  • Oracle
  • Microsoft SQL Server
  • SQLite
  • Sybase
  • Drizzle
  • Firebird

这让我想起了曾经因为找不到合适的数据库框架手忙脚乱的日子,如果早点知道 sandman2 就好了

之所以叫 sandman2,是因为它的前辈是 sandman,sandman 已经有了很强的数据库支持能力,不过在 SQLAlchemy 0.9 版本中,增加了 automap功能,可以进一步使 sandman 得到简化,于是重写了 sandman,就有了 sandman2,并且 sandman2 的功能远超 sandman

使用 pip 安装 pip install sandman2

安装成功后,就可以得到一个 sandman2ctl 命令行工具,用它来启动一个 RESTful API 服务器

不用写一行代码,直接启动:

sandman2ctl sqlite+pysqlite:///data.db

注意:如果用的 python 版本是 3.8 及以上,且在 Windows 上,执行时可能会遇到,AttributeError: module 'time' has no attribute 'clock' 的错误 这是因为 3.8 以后 time 模块的 clock 属性换成了perf_counter() 方法,所以需要修改下 lib\site-packages\sqlalchemy\util\compat.py 的 331 行,将 time_func = time.clock 换成 time_func = time.perf_counter() 保存即可

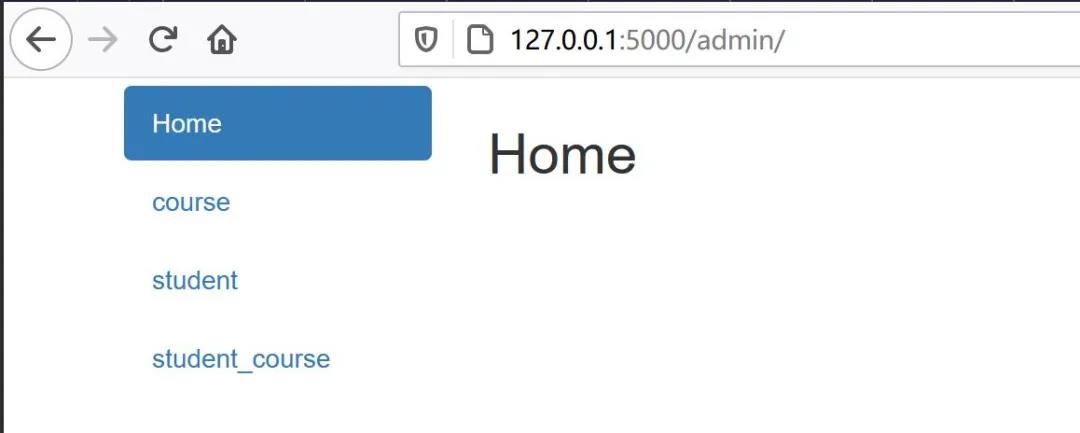
启动之后,默认端口是 5000,访问地址是 http://localhost:5000/admin就能看到服务器控制台了

数据库连接

前面已经看到连接 SQLite 数据的方法

sandman2 是基于 SQLAlchemy 的,所以使用连接 Url 来连接数据库

格式为

dialect+driver://username:password@host:port/database

  • dialect 为数据库类型,如 mysql、SQLite 等
  • driver 为数据库驱动模块名,例如 pymysql、psycopg2、mysqldb 等,如果忽略,表示使用默认驱动

以 mysql 数据库为例:

sandman2ctl 'mysql+pymysql://bob:bobpasswd@localhost:3306/testdb'

如果环境中没有安装 pymysql 模块,必须先安装,才能正常启动

其他数据库的连接方式可参考 SQLAlchemy 的 引擎配置 章节, 在这里查看 docs.sqlalchemy.org/en/13/core/engines.html

控制台

需要快速预览数据,对数据进行简单调整的话,控制台很有用

左侧菜单除了 Home 外,其他的都是库表名称

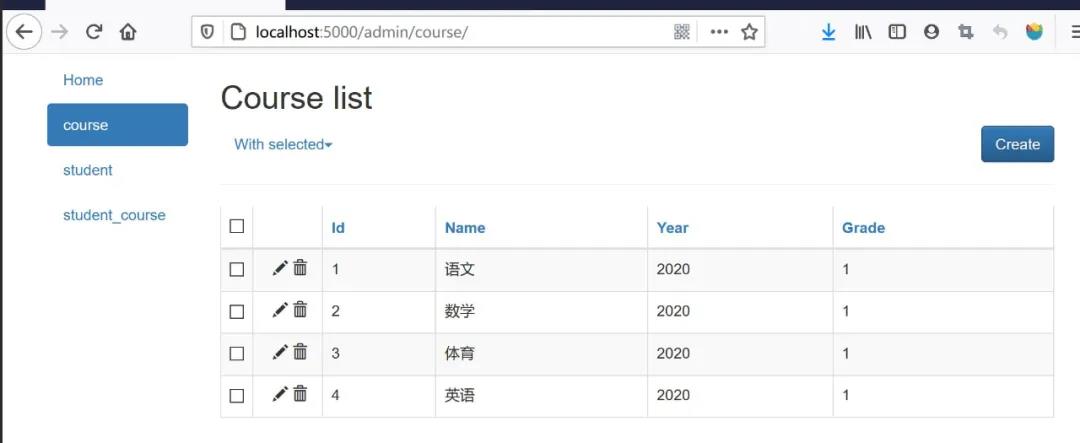
点击相应库表名称,会在右侧显示表内数据,并且可以做增删改操作

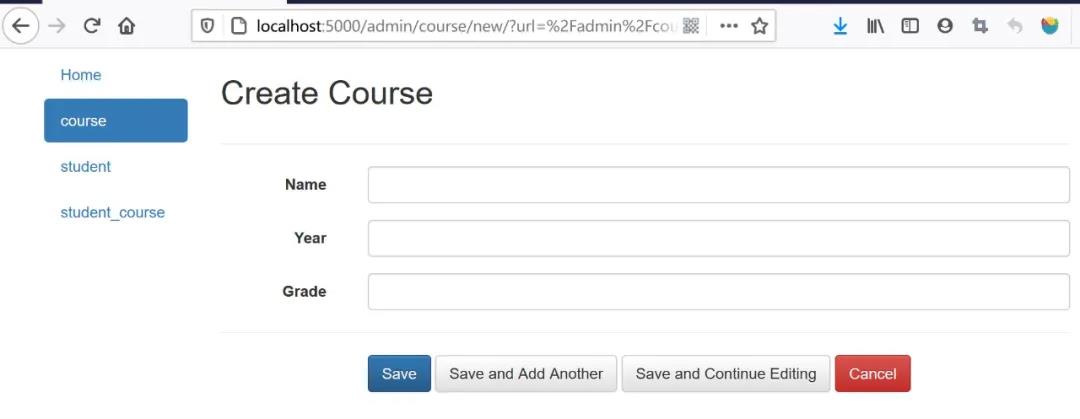
点击新增,打开新增页面:

用过 Django 的同学会感觉很熟悉,不过字段并没有类型支持,只能以字符串输入,自行确保数据类型正确,否则保存时会收到错误信息

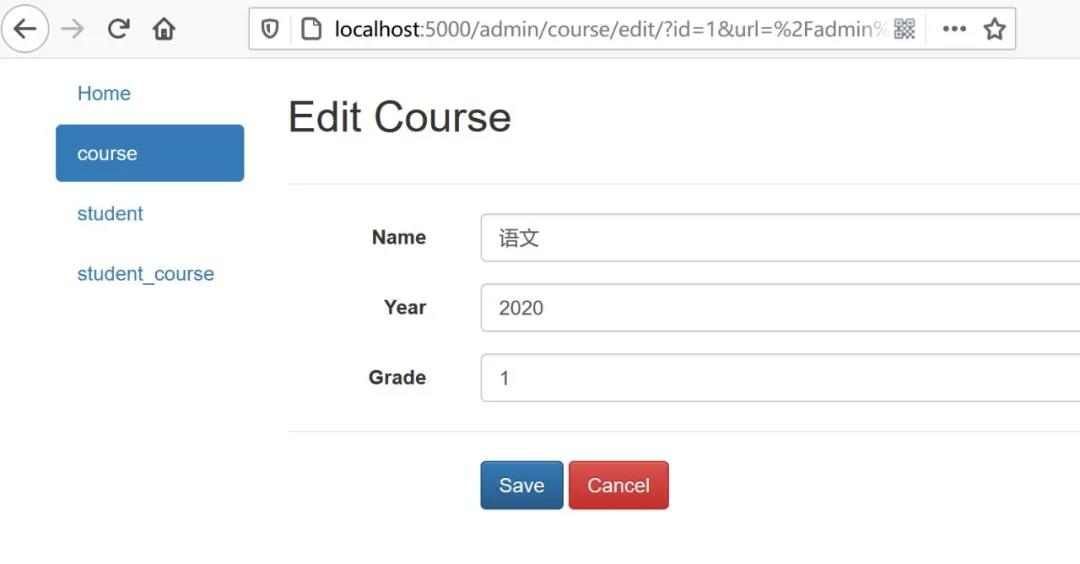
点击记录前面的笔状图标,会进入编辑页面

点击记录前的删除图标,来删除记录

另外多选数据后,可以通过 With selected 菜单下的 Delete 按钮来批量删除

控制台方便易用,适合一些简单的、数据量少的操作

注意:由于控制台不能登录即可访问,建议将服务器创建在本地或内网环境中

API

以 RESTful 的角度来看,库表相当于资源(resource),一组资源相当于集合(collection)

以下测验,均采用 curl 工具进行,具体用法可参考 阮一峰的 《curl 的用法指南》(www.ruanyifeng.com/blog/2019/09/curl-reference.html)

查询

通过 Http GET 方法,以 JSON 格式将数据返回,例如返回 学生表 student的所有记录:

$ curl http://localhost:5000/student/


{"resources":[{"age":18,"class":"1","id":1,"name":"\u5f20\u4e09","profile":"\u64c5\u957f\u5b66\u4e60"},...

注意:资源要以 / 结尾

通过参数 page 来分页,例如返回 学生表 student 的第一页数据

$ curl http://localhost:5000/student/?page=1
{"resources":[{"age":18,"class":"1"...

通过参数 limit 显示返回行数

如果要获取具体记录,可以用主键值作为节段,例如获取 id 为 3 的学生记录

$ curl http://localhost:5000/student/3
{"age":18,"class":"2","id":3,"name":"\u738b\u4e94","profile":"\u7231\u7f16\u7a0b"}

以字段名做参数,相当于查询条件,例如,查询 name 为 Tom 的学生记录:

$ curl http://localhost:5000/student/?name=Tom{"resources":
[{"age":19,"class":"1","id":7,"name":"Tom","profile":"Handsome"}]}

查询条件可以被组合,例如,查询班级为 1 年龄为 18 的学生:

$ curl http://localhost:5000/student/?class=1&age=19{"resources":
[{"age":19,"class":"1","id":2,"name":"\u674e\u56db","profile":"\u559c\u6b22\u7bee\u7403"},{"age":19,"class":"1","id":7,"name":"Tom","profile":"Handsome"}]}

修改

POST 方法用于新增,新增内容,由请求的数据部分提供,例如增加一个学生信息:

$ curl -X POST -d '{"name": "Lily", "age": 17, "class":1, "profile":"Likely"}' -H "Content-Type:
application/json" http://127.0.0.1:5000/student/{"age":17,"class":"1","id":8,"name":"Lily","profile":"Likely"}

注意:库表主键是自增长的,可以忽略主键字段,否则必须提供

PATCH 方法用于更新,更新内容,由请求的数据部分提供,例如将 id 为 1 的学生班级更改为 3

注意: 更新时主键信息通过 url 的主键值节段提供,而不在数据部分中

$ curl -X PATCH -d '{"class":3}' -H "Content-Type:
application/json" http://127.0.0.1:5000/student/1{"age":18,"class":"3","id":1,"name":"\u5f20\u4e09","profile":"\u64c5\u957f\u5b66\u4e60"}

DELETE 方法由于删除,例如删除 id 为 8 的学生记录:

$ curl -X DELETE -H "Content-Type: application/json" http://127.0.0.1:5000/student/8

其他接口

获取表的字段定义信息,通过 meta 节段获取,例如获取 学生表 student的字段定义:

$ curl http://127.0.0.1:5000/student/meta
{"age":"INTEGER(11)","class":"VARCHAR(255)","id":"INTEGER(11) (required)","name":"VARCHAR(255)","profile":"VARCHAR(500)"}

导出数据,通过查询字段 export 获取,数据格式为 csv,例如导出学生数据,存放到 student.csv 文件中:

$ curl -o student.csv http://127.0.0.1:5000/student/?export
% Total    % Received % Xferd  Average Speed
Time    Time     Time  Current                                 Dload  Upload   Total   Spent    Left  Speed100   202  100   202    0     0   2525      0 --:--:-- --:--:-- --:--:--  2525

还有更多的接口有待你的探索

部署服务

sandman2 的服务器是基于 Flask 的,具体可以去官网参考,在此就不赘述了。

总结

sandman2 之所以简单易用,是因组合了很多应用和技术,SQLAlchemyORM 层,FlaskRESTful 服务器,Bootstrap 做前台框架等

给我们提供便利的同时,展示了技术组合的强大,使得我们对一些细小知识点的学习不会再感到枯燥无味

文章来源:公众号–Python技术 作者:派森酱

以上就是W3Cschool编程狮关于无需代码,使用API操作数据库的相关介绍了,希望对大家有所帮助。

某公司的初级前端岗位面试小结,我差点怀疑自己是不是高级程序员了

thbcm阅读(306)

本文给大家分享一份来自上海某互联网公司的初级前端岗位面试小结,希望对你有所帮助。

面试过程

1.)自我介绍以及平时是怎么学习前端的?

答:正常回答即可。

2.)问:请举例说明一下Vue 和 React 二者的差异?

答:组件:React组件即函数,在函数内部是JS部分,return 的是HTML部分;Vue我使用的是单文件组件,其由HTML模板、JSCSS构成。

PropsReact子组件通过作为函数参数传递进来的 props对象 拿到父组件传递的外部属性 ,Vue 的子组件通过构造选项 prop 拿到父组件传递的外部属性。

stateReact 通过 useState 声明和初始化数据并拿到 statesetState,通过setState更新状态到视图,Vue 通过 data选项声明数据,修改数据直接更新到视图上。

3.)问:讲讲为什么 Vue 修改数据可以直接更新到视图上?

答:Vue 会对在data 选项里声明的属性通过 defineProperty 方法将属性修改为 gettersetter

Vue 通过 gettersetter 类型监听数据的读取与写入,每当数据变动时Vue就会重新渲染组件。

4.)问:现在如果有一个data数据 { a:123 } ,现在这个 a 被异步的更改为 456 ,现在要求当 a 变更为 456 执行一段代码请问怎么实现?

答:可以通过Watch 选项监听数据 a 的变动,然后执行对应的代码。问:这确实可行,如果不用 Watch 呢?

答:。。。

5.)问:你想一想 Vue 的异步API

答:哦,可以用 nextTick() 方法去获取数据,然后判断 a 是否等于 456 再去执行对应代码。

6.)问:Vuex用过吗?聊一聊你的理解。

答:VuexVue项目的全局状态管理工具,它有几个核心概念分别是:

  • store:存储状态的容器;
  • state:状态;
  • mutation:同步改变状态的方法;
  • getter:store的计算属性;
  • action:异步改变状态的方法;
  • 模块:将 store 进行模块化管理。

7.)问:你对 ES6 有了解吗?聊聊 let 和 var 的区别。

答:

  • let 声明的变量在块级作用域内,而var声明的变量在函数作用域内。
  • let 不可以重复声明,而var可以重复声明。
  • let 不存在变量提升现象,而var存在变量提升。

8.)问:有如下代码,请写出控制台结果。

{
   var a = 1;
   let b = 2;
}
console.log(a)
console.log(b)

答:分别输出:1、报错

9.)问:那吧console提上去呢?

console.log(a)
console.log(b)
{
   var a = 1;
   let b = 2;
}

答:undefined、报错

10.)问:ES6 还有其他了解的吗?Promise了解吗?

答:了解的。

11.)问:阐述一下你对Promise的了解

答:这里本人将Promise是什么、三种状态、回调函数里的resolvereject的作用、以及三个实例方法.then .catch .finally 和两个静态方法.all .race进行了阐述

12.)问:try catch 和 Promise 的 .catch 有什么区别?

答:try catch 也是用来捕获错误的,Promise拥有错误冒泡功能,虽然.then返回的是一个新的对象,但是在.then后面.catch仍然可以捕获到最开始的那个Promise对象的错误。(我不确定这样回答是否正确,面试官也没说什么)

13.)问:宏任务,微任务了解吗?

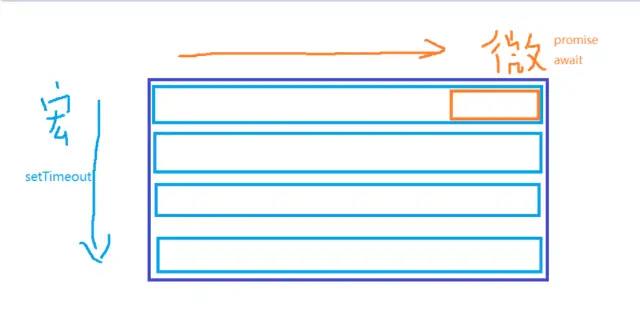
答:了解的(然后我画了张图,蓝色块表示宏任务队列,橙色表示微任务队列,执行顺序是先执行当前所在横行的同步任务,再执行所在横行的微任务,再执行下一横行的宏任务)

宏任务与微任务

14.)问:Promise 返回的是宏任务还是微任务呢?

答:Promise 返回的是微任务

1.)问:Promise 为什么返回微任务。

答:Promise 表示异步操作的返回结果 -> 当浏览器拿到结果肯定想第一时间处理 -> 加入微任务队列比宏任务处理速度快 -> 所以加入微任务队列。

15.)问:当前有一个 父div 和 子div,在 子div 上有一个 button 绑定一个点击事件,当button 被点击请问发生了什么?

答:button被点击 -> 子组件事件触发 -> 父组件事件触发 这是事件的冒泡机制

16.)问:事件除了冒泡还有其他机制吗?

答:还有捕获机制,addEventListener默认是冒泡机制,可以通过将第三个参数改为true 更改为捕获。

17.)问:你在Vue 项目和 React项目分别踩过的坑有哪些?(这个问题最好提前准备,我是现场想了一会再说的)

  • Vue 项目在 TS 开发中由于Vue2.0的模板内JS代码没有类型声明 -> 导致拿到的数据是 any 类型 -> 结论:Vue2.0目前对TS支持不好。
  • React 是函数式编程,当你的state是某个对象并且要更改其某个属性时,setState需要将就对象先用…展开,在更改对应属性值。

18.)问:接着开始问项目相关的问题,你的UI组件项目popover组件的具体怎么实现的?简单的讲一下。

答:(这个回答根据具体项目而异,具体回答内容这里就不赘述了)

19.)问:你项目中遇到的最棘手的问题是什么?

答:(这个问题最好提前准备,答案根据具体项目而异,也不赘述)

经验总结:

1.如果面试问题比较复杂,你可以先说:让我稍微想一想,不用急着回答。

2.有些问题最后提前准备一下,比如说:项目中最难的问题以及解决方案,遇到哪些坑等等。

3.基础知识还是十分重要的,面试官很多问题会基于你提到的概念再进行拓展,你最好对你说的每一个技术名词都有一定了解。

文章来源:公众号–前端人 作者:鬼哥

以上就是W3Cschool编程狮关于初级前端岗位面试小结的相关介绍了,希望对大家有所帮助。

分享14条能缩减SCSS 50%样式代码的实战经验

thbcm阅读(296)

前言

SassCSS3语言的扩展,它能帮你更省事地写出更好的样式表,使你摆脱重复劳动,使工作更有创造性。因为你能更快地拥抱变化,你也将敢于在设计上创新。你写出的样式表能够自如地应对修改颜色或修改HTML标签,并编译出标准的CSS代码用于各种生产环境。Sass语法比较简单,难点在于如何将Sass运用到实际项目中,解决CSS存在的痛点,从而提高我们效率。经过实际项目的摸索,总结了以下14条实践经验进行分享,希望能帮助大家扩宽思维,更好地将Sass运用到实际项目中。在项目中,我们使用支持传统的类CSS语法—— Scss,所以以下项目经验总结分享以Scss为例。

1、变量 $ 使用

我们可以通过变量来复用属性值,比如颜色、边框大小、图片路径等,这样可以做到更改一处,从而进行全局更改,从而实现“换肤”的功能。

实例1:我们的组件库,利用变量配置,进行统一更改组件的颜色、字体大小等(换肤):

$color-primary: #3ecacb;
$color-success: #4fc48d;
$color-warning: #f3d93f;
$color-danger: #f6588e;
$color-info: #27c6fa;

实例2:图片的配置及全局引入

Scss中图片的使用,可能存在以下2个问题:

(1)如果样式文件和使用该样式文件的vue文件不在同一目录会出现图片找不到

(2)如果将图片路径配置变量写在vue文件的style中,但是该写法导致图片和样式分离

我们可以采用将图片路径写成配置文件,然后进行全局引入,这样可以统一更改图片路径(并且该方法只会在使用相应图片时进行加载,不会导致额外性能问题):

$common-path: './primary/assets/img/';
$icon-see: $common-path+'icon-see.png';
$icon-play: $common-path+'icon-play.png';
$icon-comment: $common-path+'icon-comment.png';
$icon-checkbox: $common-path+'icon-checkbox.png';

2、@import 导入Scss文件

(1)Css中的@import规则,它允许在一个css文件中导入其他css文件。然而,后果是只有执行到@import时,浏览器才会去下载其他css文件,这导致页面加载起来特别慢。

(2)Scss中的@import规则,不同的是,scss@import规则在生成css文件时就把相关文件导入进来。这意味着所有相关的样式被归纳到了同一个css文件中,而无需发起额外的下载请求。

实例1:组件库中统一将组件的样式文件importindex.sccs,然后如果项目中有使用组件库的地方只需要在项目的入口处,引入index.scss文件,如下所示在index.scss文件中引入各组件的样式文件:

@import "./base.scss";
@import "./webupload.scss";
@import "./message-hint.scss";

3、局部文件命名的使用

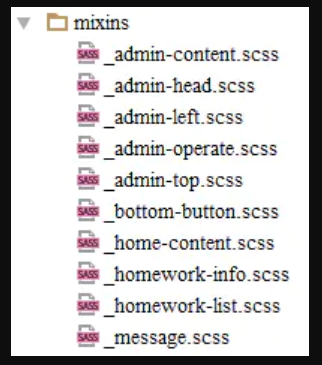
scss局部文件的文件名以下划线开头。这样,scss就不会在编译时单独编译这个文件输出css,而只把这个文件用作导入。在使用scss时,混合器mixins是最适合的使用场景,因为混合器不需要单独编译输出css文件。

实例1:将混合器的名称写成局部文件命名的方式,如下图所示

4、Scss的嵌套功能和父选择器标识符

我们可以使用嵌套功能和父选择器标识符 & 来缩减重复的代码,特别如果你CSS类采用BEM命名规范,样式类命名存在冗长的问题。使用此功能,能解决BEM命名冗长的问题,且样式可读性更高。

实例1:嵌套功能和父选择器标识符 & 解决BEM冗长问题:

.tea-assignhw {
 &__top {
  margin: 0;
}
 &__content {
   padding-left: 45px;
 }
&__gradeselect {
   width: 158px;
 }
}

实例2:嵌套中使用子选择器、兄弟选择器和伪类选择器

(1)子选择器

&__hint {
  margin: 20px;
  font-size: 14px;
  > p:first-child {
     font-weight: bold;
 }
}

(2)兄弟选择器

&__input {
 width: 220px;
 & + span { 
   margin-left: 10px;
 }
}

(3)伪类选择器

&__browse {
  background: url($btn-search) no-repeat;
&:hover {
  background: url($btn-search) -80px 0 no-repeat;
}
&:visited {
  background: url($btn-search) -160px 0 no-repeat;
 }
}

5、@mixin 混合器和 @extend 指令的使用

变量使你能够复用属性值,但如果想要复用一大段规则呢?传统的做法是,如果在样式表

中发现重复,就会把公共的规则抽离出来放到新的CSS类中。

Scss中可以使用混合器@mixin@extend继承指令来解决以上提到的复用一大段规则的场景。但两者的使用场景又有啥区别呢?

(1)@mixin主要的优势就是它能够接受参数。如果想传递参数,你会很自然地选择@mixin而不是@extend,因为@extend不能够接受参数

(2)因为混合器规则都混入到其他类中,所以在输出的样式表中不能完全避免重复。选择器继承的意思就是让一个选择器能够复用另一个选择器的所有样式,但又不重复输出这些样式属性;即使用@extend产生 DRY CSS风格的代码(Don’t repeat yourself)

综上所述,如果你需要传参数,只能使用@mixin混合器,否则用@extend继承来实现更优。

实例1:@mixin混合器的使用

@mixin paneactive($image, $level, $vertical) {
  background: url($image) no-repeat $level $vertical;
  height: 100px;
  width: 30px;
  position: relative;
  top: 50%;
}
&--left-active {
  @include paneactive($btn-flip, 0, 0);
}
&--right-active {
  @include paneactive($btn-flip, 0, -105px);
}

实例2:@extend继承的使用

.common-mod {
  height: 250px;
  width: 50%;
  background-color: #fff;
  text-align: center;
}
&-mod {
  @extend .common-mod;
  float: right;
}
&-mod2 {
  @extend .common-mod;
}

(推荐教程:CSS教程

6、@mixin 混合器默认参数值的使用

@include混合器时不必传入所有的参数,我们可以给参数指定一个默认值,如果所需要传的参数是 默认值,则@include时可以省略该参数;如果所需要传的参数不是默认值,则@include时则传入新的参数。

实例1:@mixin混合器默认参数值的使用

@mixin pane($dir: left) {
  width: 35px;
  display: block;
  float: $dir;
  background-color: #f1f1f1;
}
&__paneleft {
  @include pane;
}
&__paneright {
  @include pane(right);
}

7、#{} 插值的使用

通过 #{} 插值语句可以在选择器或属性名中使用变量。当有两个页面的样式类似时,我们会将类似的样式抽取成页面混合器,但两个不同的页面样式的命名名称根据BEM命名规范不能一样,这时我们可使用插值进行动态命名。

实例1:页面级混合器中的类名利用#{}插值进行动态设置

@mixin home-content($class) {
 .#{$class} {
   position: relative;
   background-color: #fff;
   overflow-x: hidden;
   overflow-y: hidden;
 &--left {
    margin-left: 160px;
 }
 &--noleft {
    margin-left: 0;
 }
 }
}

8、运算的使用

SassScript 支持数字的加减乘除、取整等运算 (+, -, *, /, %)

实例1:input组件根据输入框的高度设置左右内边距,如下所示:

.ps-input {
   display: block;
   &__inner {
    -webkit-appearance: none;
     padding-left: #{$--input-height + 10
   };
     padding-right: #{$--input-height + 10
   };
  }
}

9、相关scss自带函数的应用

scss自带一些函数,例如hslmix函数等。

实例1:button组件的点击后颜色是将几种颜色根据一定的比例混合在一起,生成另一种颜色。如下所示:

&:focus {
  color: mix($--color-white, $--color-primary, $--button-hover-tint-percent);
  border-color: transparent;
  background-color: transparent;}
&:active {
  color: mix($--color-black, $--color-primary, $--button-active-shade-percent);
  border-color: transparent;  background-color: transparent;
}

10、相关scss自带函数的应用

@for指令可以在限制的范围内重复输出样式,每次按变量的值对输出结果进行变动。

实例1:例如项目中需要设置hwicon类底下第2到8个div子节点需设置样式,如下所示:

@for $i from 2 through 8 {
.com-hwicon {
 > div:nth-child(#{$i}) {
   position: relative;
   float: right;
  }
 }
}

11、each遍历、map数据类型、@mixin/@include混合器、#{}插值 结合使用

可通过结合each遍历、map数据类型、@mixin/@include混合器、#{}插值,从而生成不同的选择器类,并且每个选择器类中的背景图片不同,如下所示:

$img-list: (
 (accessimg, $papers-access),
 (folderimg, $papers-folder),
 (bmpimg, $papers-bmp),
 (xlsimg, $papers-excel),
 (xlsximg, $papers-excel),
 (gifimg, $papers-gif),
 (jpgimg, $papers-jpg),
 (unknownimg, $papers-unknown)
);


@each $label, $value in $img-list {
 .com-hwicon__#{$label} {
    @include commonImg($value);
 }
}

12、样式代码检查校验 —— stylelint 插件

CSS不能算是严格意义的编程语言,但是在前端体系中却不能小觑。CSS 是以描述为主的样式表,如果描述得混乱、没有规则,对于其他开发者一定是一个定时炸弹,特别是有强迫症的人群。CSS 看似简单,想要写出漂亮的 CSS 还是相当困难。所以校验 CSS 规则的行动迫在眉睫。stylelint是一个强大的现代 CSS 检测器,可以让开发者在样式表中遵循一致的约定和避免错误。

(1)需要安装gulp、stylelint、gulp-postscss 、 postcss-reporter、stylelint-config-standard,安装命令为:

npm install gulp stylelint gulp-postscss  postcss-reporter 
stylelint-config-standard--save-dev

(2)安装完成后会在项目根目录下创建gulpfile.js文件,文件gulpfile.js配置为:

var reporter = require('postcss-reporter');
var stylelint = require('stylelint');
var stylelintConfig = {
  'extends': 'stylelint-config-standard',
  'rules': {
  'at-rule-no-unknown': [
     true, {
     'ignoreAtRules': [
     'extend',
     'include',
     'mixin',
     'for'
     ]
    }
   ]
  }
};
gulp.task('scss-lint', function() {
   var processors = [
   stylelint(stylelintConfig),
   reporter({
     clearMessages: true,
     throwError: true
   })
   ];
 return gulp.src(
   ['src/style/*.scss']// 需要工具检查的scss文件 
  ).pipe(postcss(processors));});
 gulp.task('default', ['scss-lint']);

(3) stylelint-config-standard 检验规则

stylelint-config-standardstylelint官方推荐的标准校验规则,具体校验规则有哪些内容,可参照官网。

(4)运行命令进行样式检查

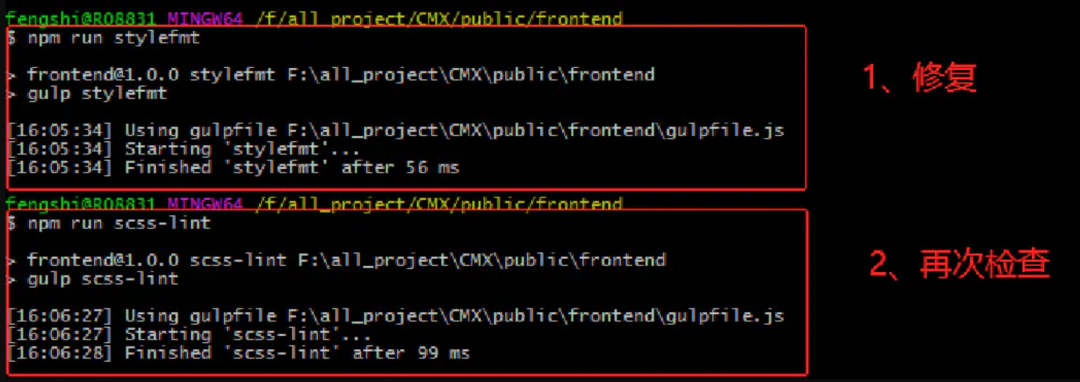
13、样式自动修复插件 —— stylefmt 插件

stylefmt 是一个基于 stylelint 的代码修正工具,它可以基于stylelint的代码规范约定配置,对可修正的地方作格式化输出。

(1)gulp.js配置文件如下:

var stylefmt = require('gulp-stylefmt'); // css格式自动调整工具
gulp.task('stylefmt', function() {
  return gulp.src(
  ['src/style/student/index.scss' // 需要工具检查的scss文件
  ]).pipe(stylefmt(stylelintConfig))
    .pipe(gulp.dest('src/style/dest/student'));});
 gulp.task('fix', ['stylefmt']);

(2)运行命令进行样式修复,如下图所示

14、将scss语法编译成css语法——gulp-sass 插件

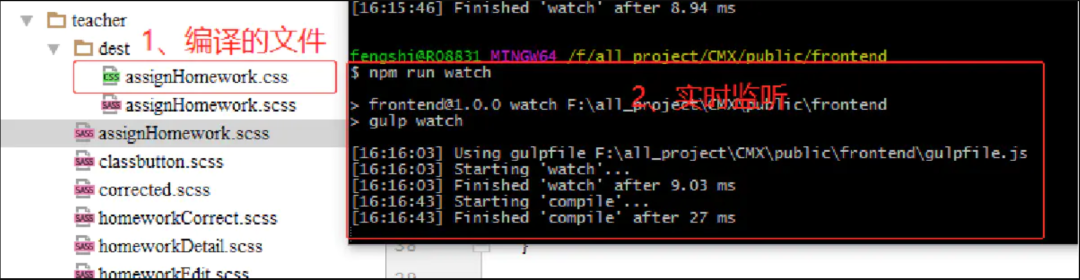
初写scss代码时,由于对语法不熟悉等,写出来的scss代码所得到的页面效果,并不是我们想要的。这时,我们可以使用gulp-sass插件来监听scss代码,实时生成css代码,从而可以通过查看css代码,来判断所写的scss代码是否正确。

(1)gulp.js配置文件如下:

var gulpsass = require('gulp-sass');
gulp.task('gulpsass', function() { 
  return gulp.src('src/style/components/hwIcon.scss')    
  .pipe(gulpsass().on('error', gulpsass.logError))   
  .pipe(gulp.dest('src/style/dest'));});
  gulp.task('watch', function() {  
  gulp.watch('src/style/components/hwIcon.scss', ['gulpsass']);
});复制代码复制代码

(2)运行命令从而监听scss文件,动态编译scss代码生成css代码文件,如下图所示

(推荐微课:CSS微课

文章来源:github.com/fengshi123/blog/issues/8

以上就是W3Cschool编程狮关于14条能缩减SCSS 50%样式代码的实战经验的相关介绍了,希望对大家有所帮助。

联系我们