Redis规范,这可能是最中肯的了

thbcm阅读(1008)

本文转载自公众号:小姐姐味道

redis 功能强大,数据类型丰富,再快的系统,也经不住疯狂的滥用。通过禁用部分高风险功能,并挂上开发的枷锁,业务更能够以简洁、通用的思想去考虑问题,而不是绑定在某种实现上。

Redis 根据不同的用途,会有不同的持久化策略和逐出策略,所以,在使用和申请 Redis 集群前,请明确是用来做缓存还是存储。redis 的集群有主从和 cluster 两种模式,各有优缺点。以下规范不区分集群模式,我们分别从使用场景和操作限制两方面说明。

使用规范

冷热数据区分

虽然 redis支持持久化,但将所有数据存储在 redis 中,成本非常昂贵。建议将热数据 (如 QPS超过 5k) 的数据加载到 redis 中。低频数据可存储在 MysqlElasticSearch中

业务数据分离

不要将不相关的数据业务都放到一个 Redis中。一方面避免业务相互影响,另一方面避免单实例膨胀,并能在故障时降低影响面,快速恢复。

消息大小限制

由于 Redis 是单线程服务,消息过大会阻塞并拖慢其他操作。保持消息内容在 1KB 以下是个好的习惯。严禁超过 50KB 的单条记录。消息过大还会引起网络带宽的高占用,持久化到磁盘时的 IO 问题。

连接数限制

连接的频繁创建和销毁,会浪费大量的系统资源,极限情况会造成宿主机当机。请确保使用了正确的 Redis 客户端连接池配置。

缓存 Key 设置失效时间

作为缓存使用的 Key,必须要设置失效时间。失效时间并不是越长越好,请根据业务性质进行设置。注意,失效时间的单位有的是秒,有的是毫秒,这个很多同学不注意容易搞错。

缓存不能有中间态

缓存应该仅作缓存用,去掉后业务逻辑不应发生改变,万不可切入到业务里。第一,缓存的高可用会影响业务;第二,产生深耦合会发生无法预料的效果;第三,会对维护行产生肤效果。

扩展方式首选客户端 hash

小应用就算了

如单 redis 集群并不能为你的数据服务,不要着急扩大你的 redis 集群(包括 M/S 和 Cluster),集群越大,在状态同步和持久化方面的性能越差。 优先使用客户端 hash 进行集群拆分。如:根据用户 id 分 10 个集群,用户尾号为 0 的落在第一个集群。

操作限制

严禁使用 Keys

Keys 命令效率极低,属于 O(N)操作,会阻塞其他正常命令,在 cluster 上,会是灾难性的操作。严禁使用,DBA 应该 rename 此命令,从根源禁用。

严禁使用 Flush

flush 命令会清空所有数据,属于高危操作。严禁使用,DBA 应该 rename 此命令,从根源禁用,仅 DBA 可操作。

严禁作为消息队列使用

如没有非常特殊的需求,严禁将 Redis 当作消息队列使用。Redis 当作消息队列使用,会有容量、网络、效率、功能方面的多种问题。如需要消息队列,可使用高吞吐的 Kafka 或者高可靠的 RocketMQ

严禁不设置范围的批量操作

redis 那么快,慢查询除了网络延迟,就属于这些批量操作函数。大多数线上问题都是由于这些函数引起。

1、[zset] 严禁对 zset 的不设范围操作

ZRANGEZRANGEBYSCORE等多个操作 ZSET 的函数,严禁使用 ZRANGE myzset 0 -1 等这种不设置范围的操作。请指定范围,如 ZRANGE myzset 0 100。如不确定长度,可使用 ZCARD 判断长度

2、[hash] 严禁对大数据量 Key 使用 HGETALL

HGETALL会取出相关 HASH 的所有数据,如果数据条数过大,同样会引起阻塞,请确保业务可控。如不确定长度,可使用 HLEN 先判断长度

3、[key] Redis Cluster 集群的 mget 操作

Redis ClusterMGET 操作,会到各分片取数据聚合,相比传统的 M/S架构,性能会下降很多,请提前压测和评估

4、[其他] 严禁使用 sunion, sinter, sdiff等一些聚合操作

禁用 select 函数

select函数用来切换 database,对于使用方来说,这是很容易发生问题的地方,cluster 模式也不支持多个 database,且没有任何收益,禁用。

禁用事务

redis 本身已经很快了,如无大的必要,建议捕获异常进行回滚,不要使用事务函数,很少有人这么干。

禁用 lua 脚本扩展

lua 脚本虽然能做很多看起来很 cool 的事情,但它就像是 SQL 的存储过程,会引入性能和一些难以维护的问题,禁用。

禁止长时间 monitor

monitor函数可以快速看到当前 redis 正在执行的数据流,但是当心,高峰期长时间阻塞在 monitor 命令上,会严重影响 redis 的性能。此命令不禁止使用,但使用一定要特别特别注意。

Key 规范

RedisKey 一定要规范,这样在遇到问题时,能够进行方便的定位。Redis 属于无 schemeKV 数据库,所以,我们靠约定来建立其 scheme 语义。其好处:

  1. 能够根据某类 key 进行数据清理
  2. 能够根据某类 key 进行数据更新
  3. 能够方面了解到某类 key 的归属方和应用场景
  4. 为统一化、平台化做准备,减少技术变更

一般,一个 key 需要带以下维度:业务、key 用途、变量等,各个维度使用 : 进行分隔,以下是几个 key 的实例:

user:sex 用户 10002232 的性别

msg:achi 201712 的用户发言数量排行榜

End

适当的约束是架构成熟的必要条件,通过约定能达到规范是集体开发的最高境界。Redis用的多,也要用的稳,给点约束、立点规矩,生活将变的美好。通过二次封装redis客户端,直接阻断,效果更佳。

以上就是W3Cschool编程狮关于Redis规范,这可能是最中肯的了的相关介绍了,希望对大家有所帮助。

现实中的路由规则,可能比你想象中复杂的多

thbcm阅读(350)

文章转载自公众号:小姐姐味道

几乎每一个分布式系统,都会给用户提供自定义路由的功能。因为,仅通过rangemodhash等方法,很大概率已经满足不了用户的需求。下面以一个实际场景为例,说一下数据路由的思路。

文中聊的是数据路由,不是nginx之类的。

场景

某个大型toB的应用,使用 MySQL 存储,单表数据量已达数亿,在结构变更、数据查询方面,已表现出明显的瓶颈,需要进行分库分表。

实施步骤

找到切分键

第一步就是找到切分的纬度。比如业务是按照时间纬度进行查询的,那么就把创建时间作为切分键。

此业务的切分键,是商户 id (类似于你在美团开店了,美团给你分配的唯一 id )。由于历史原因,这个 id 是用的数据库主键 id ,而且是自增的。业务具有以下特点:

  1. 业务操作是由某个商户发起的,每张表都有商户 id 字段
  2. 商户的数据不均衡,有的商户有几千万,有的可能只有十几条
  3. 存在部分 vip 商家,其数据量非常庞大
  4. 存储大量统计需求,所以无法分表,只能分库
  5. 存在遍历数据的可能,比如部分定时

切分需求一阶段

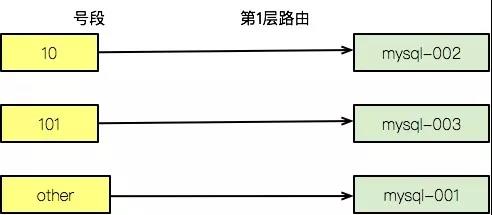
分库迫在眉睫。通过分析,部分 vip 商户,数据量巨大,把它单独转移到一个数据库中也不为过。

通过维护一个映射文件,来控制 vip 商户到数据存储流向。这时候,就需要自定义路由。

伪代码如下:

function viptable(id){
    10 => "mysql-002"
    101 => "mysql-003"
}
function router4vip(id){
    aimDb = viptable(id)
    if(aimDb) return aimDb


    return "mysql-001"
}

商户为 10,数据将落向mysql-002;商户为 101,将落向mysql-003;数据默认使用mysql-001存储。

另外,由于 id 是自动生成的自增字段,与路由存在一个先有鸡还是先有蛋的问题,所以将 id 字段修改为人工设值,延伸出另外一个配号系统,在此不多提。

切分需求二阶段

解决了 vip 商户的问题,接下来就需要解决mysql-001的问题。随着业务的发展,落在默认库上的数据越来越多,很快又遇到了瓶颈。

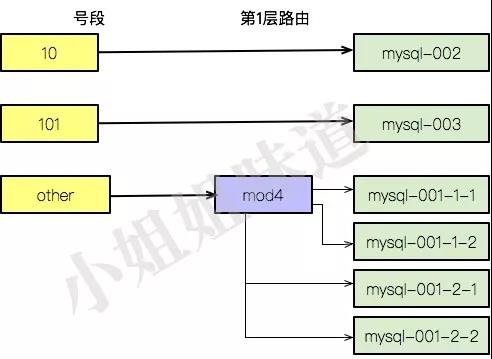
想到的方法是,对其一分为二。mysql-001的数据打散到两个库中。这个打散的规则,我们直接采用mod。

为什么不是一拆为三呢?主要是基于以下考虑,假设拆分后的 db 为:

mysql-001-1
mysql-001-2

这种情况下mysql-001就变成了逻辑集群。当mysql-001-1mysql-001-2也达到了瓶颈,那我们就可以对其继续进行拆分,依然是一拆为二,这时候,mod 4就可以了,不会涉及复杂的数据迁移。

拆分后的db为:

mysql-001-1-1
mysql-001-1-2
mysql-001-2-1
mysql-001-2-2

到现在为止,我们采用了 vip 分库,mod 4分库,伪代码如下:

...


function routertable(pivot){
    0 => "mysql-001-1-1"
    1 => "mysql-001-1-2"
    2 => "mysql-001-2-1"
    3 => "mysql-001-2-2"
}


function router4mod(id){
    aimDb = router4vip(id)
    if(aimDb) return aimDb


    pivot = mod4(id)
    return routertable(pivot)
}

到现在,我们已经分了六个库了。通过裂变的模式,有着较好的扩展性。

这样就可以高枕无忧了么?

切分需求三阶段

可惜的是,我们每次扩容,都是指数级别的。下一次,就是 mod 8 ;而下下次,就是mod 16 。每次扩容,都会动一半的数据,wtf。

最后,决定在商户 id 的范围上做文章。

首先,做一个定长的商户 id ,比现有系统中的任何一个都长,主要考虑新的规则不会影响旧的路由规则。

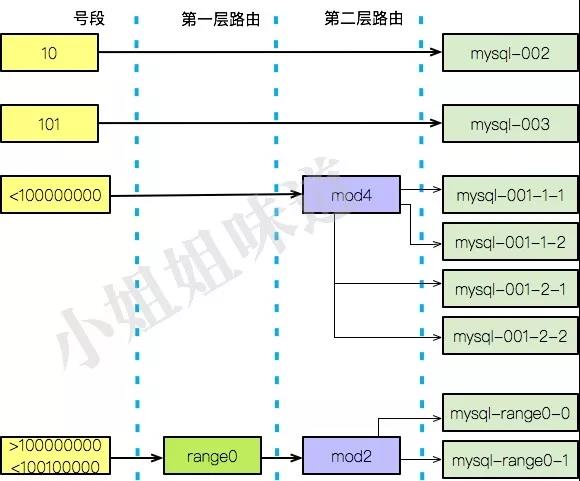
然后,首先根据商户 id 的范围划分第一层虚拟集群,然后再根据 mod 划分第二层虚拟集群。我们的路由,现在是双层路由。

比如,我们把商户号定9位(java中int是10位),并做如下路由表:

100 000000 - 100 100000=> 虚拟集群1
100 100000 - 100 200000=> 虚拟集群2
...

前三位,用来分第一层虚拟集群,支持899个;后6位,代表范围,最大10万。每个范围下面,都会有自己的路由规则,有的可能 mod 2,有的可能 mod 3 ,有的可能再次 range

好,我们加入新的集群:

mysql-range0-0 代表号段在范围1中的偶数id
mysql-range0-1

伪代码如下:

...
function router4range(id){
    if(id < 100000000){
        return router4mod(id)
    }else if
    (id in [100000000-100100000]){
        return 
            "mysql-range0-"+mod2(id)
    }
}

到此为止,我们一共有8个库,其中两个是给 vip 用的,四个是遗留的路由算法,还有两个是给新的分库规则使用。

通过三次改进,我们的路由满足:

一、 当我们发现,当商户 id 增长到100 056400,就达到瓶颈了,那么就可以新增一个新的范围,只需要改动一下路由表逻辑就ok了

二、 当某个范围内某个商户成长为 vip ,那我们就可以单独将其提取出来,增加新的 vip 库

三、 某个范围内数据热点严重,那么就可以 mod 4 进行扩容,并不影响范围外的数据

四、 商户 id 同时也有时间纬度的概念,可以针对某些旧商户进行归档清理

切分需求四阶段

系统想要预留另外一部分号段,用来提供一些测试账号,供客户试用。经历过前三轮的改造,我们可以很容易的对其进行规划。

End

为什么觉得redis-clusterslot设计是个鸡肋呢,因为它把路由规则给定死了,要我去设计我肯定要放在驱动层。

某些架构师潇洒的来,潇洒的走,留下了不可磨灭的痕迹。为了兼容这些遗留系统的路由代码,分支会更加复杂,每一个公司都有一堆故事,无非是骂娘和被骂。稳定性重如山,路由代码可能是最重要的没技术含量的if else。一动,都得死。

就问你怕不怕?

以上就是W3Cschool编程狮关于现实中的路由规则,可能比你想象中复杂的多的相关介绍了,希望对大家有所帮助。

git – 简明指南

thbcm阅读(449)

助你入门 git 的简明指南,木有高深内容 ;)

安装

下载 git OSX 版

下载 git Windows 版

下载 git Linux 版

创建新仓库

创建新文件夹,打开,然后执行

git init

以创建新的 git 仓库。

检出仓库

执行如下命令以创建一个本地仓库的克隆版本:

git clone /path/to/repository

如果是远端服务器上的仓库,你的命令会是这个样子:

git clone username@host:/path/to/repository

工作流

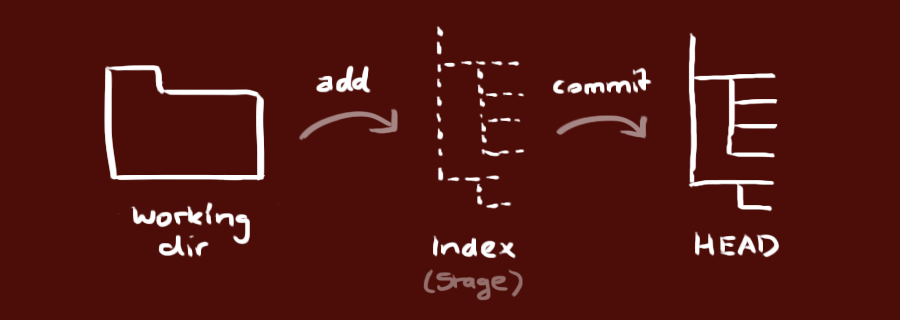
你的本地仓库由 git 维护的三棵“树”组成。第一个是你的 工作目录,它持有实际文件;第二个是 暂存区(Index),它像个缓存区域,临时保存你的改动;最后是 HEAD,它指向你最后一次提交的结果。

添加和提交

你可以提出更改(把它们添加到暂存区),使用如下命令:

git add <filename>
git add *

这是 git 基本工作流程的第一步;使用如下命令以实际提交改动:

git commit -m "代码提交信息"

现在,你的改动已经提交到了 HEAD,但是还没到你的远端仓库。

推送改动

你的改动现在已经在本地仓库的 HEAD 中了。执行如下命令以将这些改动提交到远端仓库:

git push origin master

可以把 master 换成你想要推送的任何分支。

如果你还没有克隆现有仓库,并欲将你的仓库连接到某个远程服务器,你可以使用如下命令添加:

git remote add origin <server>

如此你就能够将你的改动推送到所添加的服务器上去了。

分支

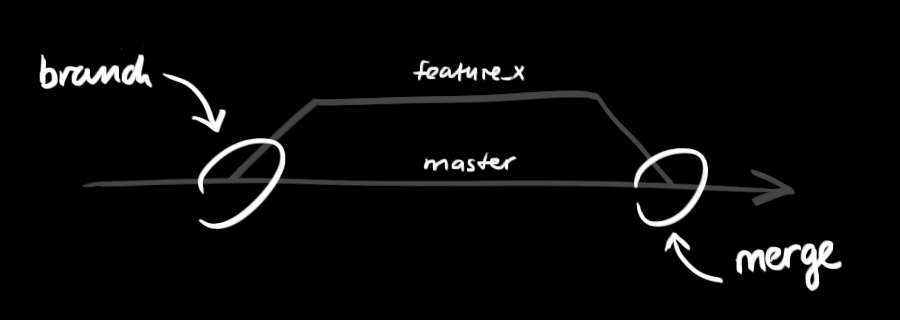
分支是用来将特性开发绝缘开来的。在你创建仓库的时候,master 是“默认的”分支。在其他分支上进行开发,完成后再将它们合并到主分支上。

创建一个叫做“feature_x”的分支,并切换过去:

git checkout -b feature_x

切换回主分支:

git checkout master

再把新建的分支删掉:

git branch -d feature_x

除非你将分支推送到远端仓库,不然该分支就是 不为他人所见的

git push origin <branch>

更新与合并

要更新你的本地仓库至最新改动,执行:

git pull

以在你的工作目录中 获取(fetch)合并(merge) 远端的改动。 要合并其他分支到你的当前分支(例如 master),执行:

git merge <branch>

在这两种情况下,git 都会尝试去自动合并改动。遗憾的是,这可能并非每次都成功,并可能出现冲突(conflicts)。 这时候就需要你修改这些文件来手动合并这些冲突(conflicts)。改完之后,你需要执行如下命令以将它们标记为合并成功:

git add <filename>

在合并改动之前,你可以使用如下命令预览差异:

git diff <source_branch> <target_branch>

标签

为软件发布创建标签是推荐的。这个概念早已存在,在 SVN 中也有。你可以执行如下命令创建一个叫做 1.0.0 的标签:

git tag 1.0.0 1b2e1d63ff

1b2e1d63ff 是你想要标记的提交 ID 的前 10 位字符。可以使用下列命令获取提交 ID:

git log

你也可以使用少一点的提交 ID 前几位,只要它的指向具有唯一性。

log

如果你想了解本地仓库的历史记录,最简单的命令就是使用:

git log

你可以添加一些参数来修改他的输出,从而得到自己想要的结果。 只看某一个人的提交记录:

git log --author=bob

一个压缩后的每一条提交记录只占一行的输出:

git log --pretty=oneline

或者你想通过 ASCII 艺术的树形结构来展示所有的分支, 每个分支都标示了他的名字和标签:

git log --graph --oneline --decorate --all

看看哪些文件改变了:

git log --name-status

这些只是你可以使用的参数中很小的一部分。更多的信息,参考:

git log --help

替换本地改动

假如你操作失误(当然,这最好永远不要发生),你可以使用如下命令替换掉本地改动:

git checkout -- <filename>

此命令会使用 HEAD 中的最新内容替换掉你的工作目录中的文件。已添加到暂存区的改动以及新文件都不会受到影响。

假如你想丢弃你在本地的所有改动与提交,可以到服务器上获取最新的版本历史,并将你本地主分支指向它:

git fetch origin
git reset --hard origin/master

实用小贴士

内建的图形化 git:

gitk

彩色的 git 输出:

git config color.ui true

显示历史记录时,每个提交的信息只显示一行:

git config format.pretty oneline

交互式添加文件到暂存区:

git add -i

链接与资源

图形化客户端

指南和手册

架构秘笈:移花接木。使用mysql模拟redis

thbcm阅读(298)

文章转载自公众号:小姐姐味道

这年头,你看到的东西未必就是你认为的东西。一个 mysql 协议的后面,可能是tidb;一个 linux 机器后面,可能是一个精简的 docker ;你觉得xjjdog是个女的,但可能ta自己也不太清楚;而当你大呼 php 万岁的时候,可能是研发人员和你开个玩笑,重写了后缀,而后端用的却是 java

大家都知道 redis 速度快,但它的容量和内存容量有关,很容易达到瓶颈。有些互联网公司,直接使用 redis 作为后端数据库(在下佩服)。当业务量暴增,就面临一个 redis 容量和价格的权衡问题。改业务代码是来不及了,只好用一些持久化存储 ,来模拟 redis 的一些数据结构。

redis 支持近十种数据类型,最常用的有5种。stringhashzsetsetlist等。本文将针对几种常见的数据结构,探讨一下常用操作的模拟实现。

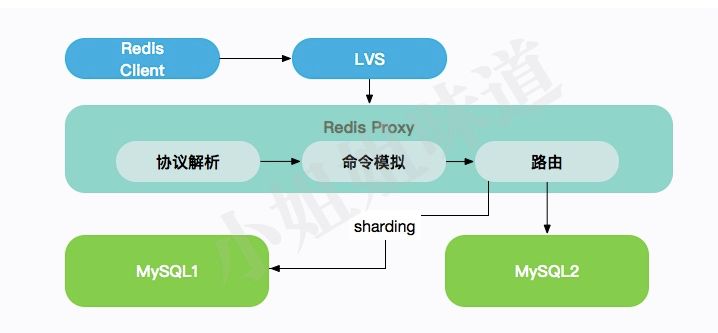
其实,我们所需要开发的,就是一个redis代理proxyredis的客户端,连接上我们的代理之后,会进行协议解析。解析出来的命令,将会被模拟,然后根据配置的路由,定位到相应的mysql中。

也就是你所使用的redis,其实使用mysql来存储数据的。没有rdb,也没有aof

Redis是文本协议

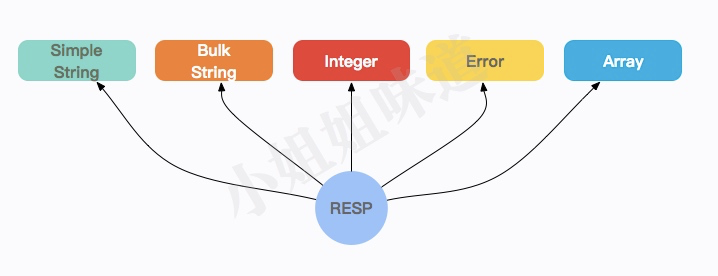
redis是文本协议,协议名称叫做RESPRESPRedis 序列化协议的简写。它是一种直观的文本协议,优势在于实现异常简单,解析性能极好。

如图,Redis 协议将传输的结构数据,可以总结为 5 种最小单元类型。每个单元结束时,统一加上回车换行符号 \r\n

下面是几个规则:

单行字符串 以 + 开头;
多行字符串 以 $ 开头,后跟字符串长度;
整数值 以 : 开头,后跟整数的字符串形式;
错误消息 以 - 符号开头;
数组 以 * 号开头,后跟数组的长度;

比如,下面这个就是数组[9,9,6]的报文。

*3\r\n:9\r\n:9\r\n:6\r\n

所以这个协议的解析和拼装,是非常简单的。拿netty来说,就有codec-redis 模块供我们使用。

实现:数据结构设计

在数据表的设计上,我们发现,kvhash在效率上没有什么差别,因为它能够直接根据key定位到。

反倒是zset,由于有排序的功能,造成了很多操作的执行效率都不尽人意。

另外,由于我们不同的数据结构,是使用不同的表进行存储的。所以删除操作,要在每张表上都执行一遍。

kv设计

kv,即string,是redis里最基本的数据类型。一个key对应一个valuestring类型的值最大能存储512MB。

设计专用的数据库表rstore_kv,其中,rkey是主键。

rkey        varchar
val     varchar
lastTime    bigint

set操作

insert into rstore_kv("rkey","val","lastTime") values($1,$2,$3)
on duplicate key update set "val"=$2,"lastTime"=$3

get操作

select val from rstore_kv where "rkey" = $1

del操作

delete from rstore_kv where "rkey" = $1

exists操作

select count(*) as n from rstore_kv where  "rkey" = $1

ttl操作

select lastTIme from rstore_kv  where  "rkey" = $1

hash设计

hash 是一个键值(key=>value)对集合。hash 特别适合用于存储对象。

设计专用的数据库表rstore_hash,其中,rkeyhkey是联合主键。

rkey        varchar
hkey        varchar
val     varchar
lastTime    bigint

hset操作

insert into rstore_hash("rkey","hkey","val","lastTime") values($1,$2,$3,$4)
on duplicate key update set "val"=$3,"lastTime"=$4

hget操作

select val from rstore_hash where "rkey" = $1 and "hkey" = $2

hgetall操作

select hkey,val from rstore_hash where "rkey" = $1

hdel操作

delete from rstore_hash where "rkey" = $1 and "hkey" = $2

del操作

delete from rstore_hash where "rkey" = $1

hlen,hexists操作

select count(*) as num from rstore_hash where "rkey" = $1

ttl操作

select max(lastTIme) from rstore_hash  where  "rkey" = $1

zset设计

Redis zsetset 一样也是string类型元素的集合,且不允许重复的成员。不同的是每个元素都会关联一个double类型的分数。redis正是通过分数来为集合中的成员进行从小到大的排序。它的底层结构是跳跃表,效率特别高,但是会占用大量内存。

设计专用的数据库表rstore_zset,其中,rkeymember是联合主键。

rkey        varchar
member        varchar
score     double
lastTime    bigint

zadd操作

insert into rstore_zset("rkey","member","score","lastTime") values($1,$2,$3,$4) on duplicate key update update set "score"=$3,"lastTime"=$4

zscore操作

select score from rstore_zset where "rkey" = $1 and "member" = $2

zrem操作

delete from rstore_zset where "rkey" = $1 and "member" = $2"

zcard,exists操作

select count(*) as num from rstore_zset where "rkey" = $1

zcount操作

select count(*) as num from rstore_zset where "rkey" = $1 and score>=$2 and score<=$3

zremrangebyscore操作

delete from rstore_zset where "rkey" = $1 and score>=$2 and score<=$3

zrangebyscore操作

select member,score from rstore_zset
where "rkey" = $1 and score>=$2 and score<=$3 order by score asc,member asc

zrange操作

select member,score from rstore_zset
where "rkey" = $1 order by score asc offset $2 limit $3

zrank操作

select rank from (select member,rank() over (order by "score" asc, "lastTime" asc) as rank from rstore_zset where "rkey" = $1 ) m where m."member"= $2;

ttl操作

select max(lastTIme) from rstore_zset  where  "rkey" = $1

del操作

delete from rstore_zset where "rkey" = $1

set设计

RedisSetstring类型的无序集合。

设计专用的数据库表rstore_set,其中,rkeymember是联合主键。

rkey        varchar
member        varchar
lastTime    bigint

sadd操作

insert into rstore_set("rkey","member","lastTime") values($1,$2,$3)
on duplicate key update update set "lastTime"=$3

scard操作

select count(*) as num from rstore_set where "rkey" = $1

sismember操作

select member from rstore_set where "rkey" = $1 and "member" = $2

smembers操作

select member from rstore_set where "rkey" = $1

srem操作

delete from rstore_set where "rkey" = $1 and "member" = $2

del操作

delete from rstore_set where "rkey" = $1

ttl操作

select max(lastTIme) from rstore_set  where  "rkey" = $1

End

本篇文章仅仅模拟了最常用数据结构的最常用功能,有很多很多功能是不支持的,比较明显的就是分布式锁setnx等。所以这个proxy层的开发,要想做到ok,并不是那么简单。

同时,我们以一种模拟的视角,来看一下redis的数据结构,在关系型数据库中的表现形式。这样,更能够加深我们对redis的认识,明白它存在的价值。

以上就是W3Cschool编程狮关于架构秘笈:移花接木。使用mysql模拟redis的相关介绍了,希望对大家有所帮助。

与亲生的Redis Cluster,来一次灵魂交流

thbcm阅读(296)

文章转载自公众号:小姐姐的味道

笔者曾经维护过千个 redis 实例,这些实例采用的简单主从结构,集群方案主要是客户端jar包。刚开始,个人并不是太喜欢redis cluster,因为它的路由实在是太死板,运维复杂。

但官方在推这个东西,注定了它的应用越来越广泛,这在平常的交流中就能够发现。虽然有这样那样的缺点,但总抵挡不了权威推动的浪潮。随着redis cluster越来越稳定,是时候和redis cluster来一次灵魂交流了。

简介

redis cluster是亲生的集群方案,目前,在高可用和稳定性方面,都有了很大的进步。据统计和观察,采用redis cluster架构的公司和社区越来越多,已经成为事实的标准。它的主要特点就是去中心化,无需proxy代理。其中一个主要设计目标就是达到线性可扩展性(linear scalability)。

仅仅靠redis cluster服务器本身,并不能完成官方承诺的功能。广义上的redis cluster应该既包含redis服务器,又包含客户端实现比如jedis等。它们是一个整体。

分布式存储无非就是处理分片和副本。redis cluster来说,核心概念就是槽(slot),了解了它,基本就了解了集群的管理方式。

优缺点

当了解这些特性以后,运维上其实是更简单了。我们先看下比较明显的优缺点。

优点

1、不再需要额外的Sentinel集群,为使用者提供了一致的方案,减少了学习成本。 2、去中心架构,节点对等,集群可支持上千个节点。 3、抽象出了slot概念,针对slot进行运维操作。 4、副本功能能够实现自动故障转移,大部分情况下无需人工介入。

缺点

1、客户端要缓存部分数据,实现Cluster协议,相对复杂。 2、数据是通过异步复制的,不能保证数据的强一致性。 3、资源隔离困难,经常流量不均衡,尤其是多个业务共用集群的时候。数据不知道在哪里,针对热点数据,也无法通过专项优化完成。 4、从库是完全的冷备,无法分担读操作,真是太太浪费了。需要做额外工作。 5、MultiOpPipeline支持有限,老代码要是进行架构升级,要小心了。 6、数据迁移是基于key而不是基于slot的,过程较慢。

基本原理

从槽到key,定位过程明显就是一个双层的路由。

key的路由

redis cluster和常用的一致性hash没什么关系,它主要采用了哈希槽的概念。当需要在其中存取一个key时,redis客户端会首先对这个key采用crc16算法算出一个值,然后对这个值进行mod操作。

crc16(key)mod 16384
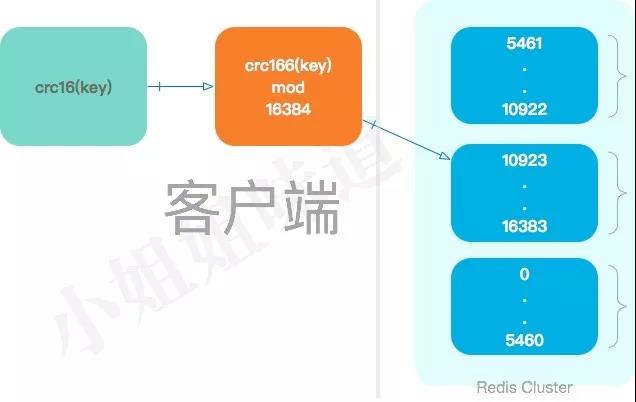
所以,每个key都会落在其中的一个hash槽上。16384 等同于 2^14(16k),redis节点发送心跳包时,需要把所有的槽信息放在这个心跳包里,所以要竭尽全力的优化,感兴趣的可以看下为什么默认的槽数量是 16384 。

服务端简单原理

上面谈到,redis cluster共定义了 16384 个槽,所有的集群操作都是围绕着这个槽数据进行编码。服务端使用一个简单的数组存储这些信息。

对于判断有无的操作,使用bitmap来存储是最节省空间的。redis cluster就是使用一个叫做slot的数组来保存当前节点是否持有了这个槽。

如图,这个数组的长度为 16384/8=2048 Byte,那么就可以使用 0 或者 1 来标识本节点对某个槽是否拥有。
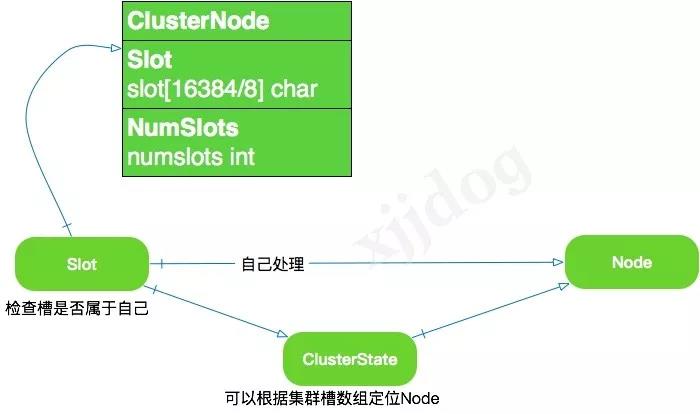
其实,只需要第一份数据ClusterState也能完成操作,保存另外一个维度的Slot数组,能够方便编码和存储。一个节点除了会将自己负责处理的槽记录在两个地方(clusterNode结构的slots和numslots),它还会将自己的slots数组通过消息发送给集群中的其他节点,以此来告诉其他节点自己目前拥有的槽。

当数据库中的 16384 个槽都有节点在处理时,集群处于上线状态(ok);相反地,如果数据库中有任何一个槽没有得到处理,那么集群处于下线状态(fail)。

当客户端向节点发送相关命令时,接收命令的节点会计算出命令要处理的key属于哪个槽,并检查这个槽是否指派给了自己。如果不是自己的,会指引客户端到正确的节点。

所以,客户端连接集群中的任意一台机器,都能够完成操作。

安装一个6节点集群

准备工作

假如我们要组装一个3分片的集群,每个分片有一个副本。那么总共需要的node实例就有 3*2=6 个。redis可以通过指定配置文件的方式启动,我们所做的工作就是修改配置文件。

复制6份默认的配置文件。

for i in {0..5}
do
cp redis.conf  redis-700$i.conf
done

修改其中的配置文件内容,拿redis-7000.conf来说,我们要启用它的cluster模式。

cluster-enabled yes
port 7000
cluster-config-file nodes-7000.conf

nodes-7000.conf会保存一些集群信息到当前节点,所以需要独立。

启动&关闭

同样的,我们使用脚本来启动它。

for i in {0..5}
do
nohup ./redis-server redis-700$i.conf &
done

为了演示,我们暴力把它关闭。

ps -ef| grep redis | awk '{print $2}' | xargs kill -9

组合集群

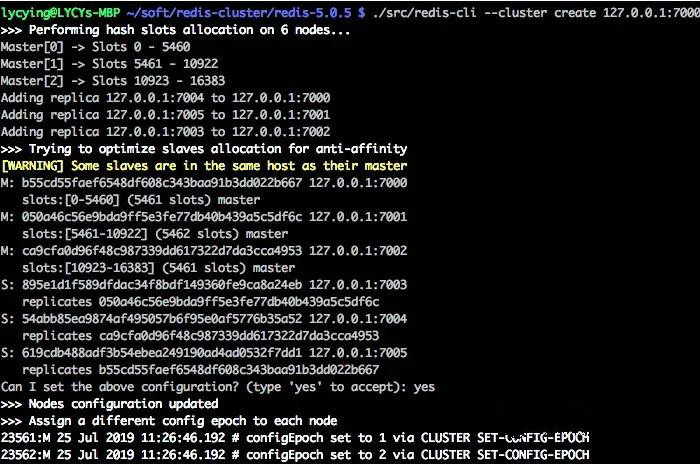
我们使用redis-cli进行集群的组合。redis将自动完成这个过程。这一系列的过程,是通过发送指令给每个节点进行组合的。

./redis-cli --cluster create 127.0.0.1:7000 127.0.0.1:7001 127.0.0.1:7002 127.0.0.1:7003 127.0.0.1:7004 127.0.0.1:7005 --cluster-replicas 1
几个高级原理

节点故障

集群中的每个节点都会定期地向集群中的其他节点发送ping消息,以此来检测对方是否在线,如果接收ping消息的节点没有在规定的时间内返回pong消息,那么发送ping消息的节点就会将接收ping消息的节点标记为疑似下线(PFAIL)。

如果在一个集群里面,半数以上节点都将某个主节点 x 报告为疑似下线,那么这个主节点x将被标记为已下线(FAIL),将x标记为FAIL的节点会向集群广播一条关于 x 的FAIL消息,所有收到这条FAIL消息的节点都会立即将 x 标记为FAIL

大家可以注意到这个过程,与 es 和 zk 的节点判断类似,都是半数以上才进行判断,所以主节点的数量一般都是奇数。由于没有最小组群配置,理论上会有脑裂(暂时并未遇到过)。

主从切换

当一个节点发现自己的主节点进入fail状态,将会从这个节点的从节点当中,选出一台,执行slaveof no one命令,变身为主节点。

新的节点完成自己的槽指派以后,会向集群广播一条pong消息,以便让其他节点立即知道自己的这些变化。它告诉别人:我已经是主节点了,我已经接管了有问题的节点,成为了它的替身。

redis内部对集群的这些管理,大量使用了已经定义好的这些指令。所以这些指令不仅仅供我们从命令行使用,redis自己内部也用。

数据同步

当一台从机连接到master之后,会发送一个sync指令。master在收到这个指令后,会在后台启动存盘进程。执行完毕后,master将整个数据库文件传输到slave,这样就完成了第一次全量同步。

接下来,master会把自己收到的变更指令,依次传送给slave,从而达到数据的最终同步。从redis 2.8开始,就支持主从复制的断点续传,如果主从复制过程中,网络连接断掉了,那么可以接着上次复制的地方,继续复制下去,而不是从头开始复制一份。

数据丢失

redis cluster中节点之间使用异步复制,并没有类似kafka这种ack的概念。节点之间通过gossip协议交换状态信息,用投票机制完成SlaveMaster的角色提升,完成这个过程注定了需要时间。在发生故障的过程中就容易存在窗口,导致丢失写入的数据。比如以下两种情况。

一、命令已经到到master,此时数据并没有同步到slavemaster会对客户端回复ok。如果这个时候主节点宕机,那么这条数据将会丢失。redis这样做会避免很多问题,但对一个对数据可靠性要求较高的系统,是不可忍受的。

二、由于路由表是在客户端存放的,存在一个时效问题。如果分区导致一个节点不可达,提升了某个从节点,但原来的主节点在这个时候又可以用了(并未完成failover)。这个时候一旦客户端的路由表并没有更新,那么它将会把数据写到错误的节点,造成数据丢失。

所以redis cluster在通常情况下运行的很好,在极端情况下某些值丢失问题,目前无解。

复杂的运维

redis cluster的运维非常的繁杂,虽然已经进行了抽象,但这个过程依然不简单。有些指令,必须在详细了解它的实现原理之后,才能真正放心的去用。
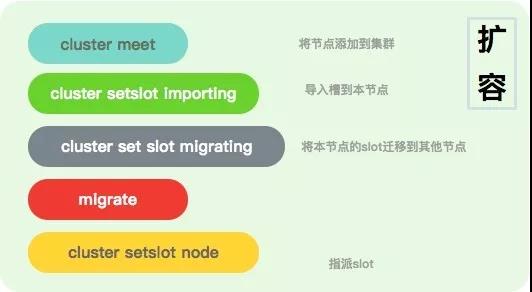
上图就是扩容会用到的一些命令。在实际使用的过程中,可能需要多次频繁地输入这些命令,且输入的过程中还要监视它的状态,所以基本上是不可能人工跑这些命令的。

运维的入口有两个。一个是使用redis-cli连接任意一台,然后发送cluster打头的命令,这部分命令大多数是对槽进行操作。 在开始组合集群时,就是反复调用这些命令进行的具体逻辑执行。

另外一个入口是使用redis-cli命令,加上--cluster参数和指令。这种形式主要是用来管控集群节点信息 ,比如增删节点等。所以推荐使用这种方式。

redis cluster提供了非常复杂的命令,难于操作和记忆。推荐使用类似CacheCloud的工具进行管理。

下面是几个例子。

通过向节点 A 发送 CLUSTER MEET 命令,客户端可以让接收命令的节点 A 将另一个节点 B 添加到节点 A 当前所在的集群里面:

CLUSTER MEET  127.0.0.1 7006

通过cluster addslots命令,可以将一个或者多个槽指派给某个节点负责。

127.0.0.1:7000> CLUSTER ADDSLOTS 0 1 2 3 4 . . . 5000

设置从节点。

CLUSTER REPLICATE <node_id>

redis-cli —cluster

redis-trib.rb是官方提供的Redis Cluster的管理工具,但最新版本已经推荐使用redis-cli进行操作。

向集群中添加新节点

redis-cli --cluster add-node 127.0.0.1:7006 127.0.0.1:7007 --cluster-replicas 1

从集群中删除节点

redis-cli --cluster del-node 127.0.0.1:7006 54abb85ea9874af495057b6f95e0af5776b35a52

迁移槽到新的节点

redis-cli --cluster reshard 127.0.0.1:7006 --cluster-from 54abb85ea9874af495057b6f95e0af5776b35a52 --cluster-to 895e1d1f589dfdac34f8bdf149360fe9ca8a24eb  --cluster-slots 108

类似的命令还有很多。

create:创建集群 check:检查集群 info:查看集群信息 fix:修复集群 reshard:在线迁移slot rebalance:平衡集群节点slot数量 add-node:添加新节点 del-node:删除节点 set-timeout:设置节点的超时时间 call:在集群所有节点上执行命令 import:将外部redis数据导入集群

其他方案概览

主从模式

redis最早支持的,就是M-S模式,也就是一主多从。redis单机qps可达到 10w+,但是在某些高访问量场景下,依然不太够用。一般通过读写分离来增加slave,减少主机的压力。

既然是主从架构,就面临着同步问题,redis主从模式的同步分为全同步和部分同步。当刚创建一个从机的时候,不可避免的要进行一次全量同步。等全量同步结束之后,进入增量同步阶段。这个和redis cluster是没什么区别的。

这种模式还是比较稳定的,但要额外做一些工作。用户需要自行开发主从切换的功能,也就是使用哨兵去探测每个实例的健康状况,然后通过指令进行集群状态的改变。

当集群规模增大,主从模式会很快遇到瓶颈。所以一般会采用客户端hash的方法进行扩展,包括类似于memcached的一致性哈希。
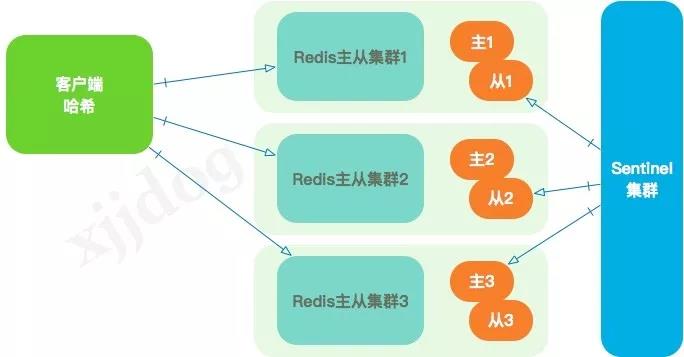
客户端hash的路由可能会很复杂,通常会通过发布jar包或者配置的方式维护这些meta信息,这也给线上环境增加了很多不确定性。

不过,通过加入类似ZK主动通知的功能,将配置维护在云端,可以显著降低风险。笔者曾经维护过的几千个redis节点,就是用这种方式进行管理的。

代理模式

代码模式在redis cluster出现之前,非常流行,比如codis。代理层通过把自己模拟成一个redis,接收来自客户端的请求,然后按照自定义的路由逻辑进行数据分片以及迁移,而业务方不需要改动任何代码。除了能够平滑的进行扩容,一些主从切换、FailOver的功能也在代理层完成,客户端甚至可以没有任何感知。这类程序又称为分布式中间件。

一个典型的实现如下图,背后的redis集群甚至可以是混合的。
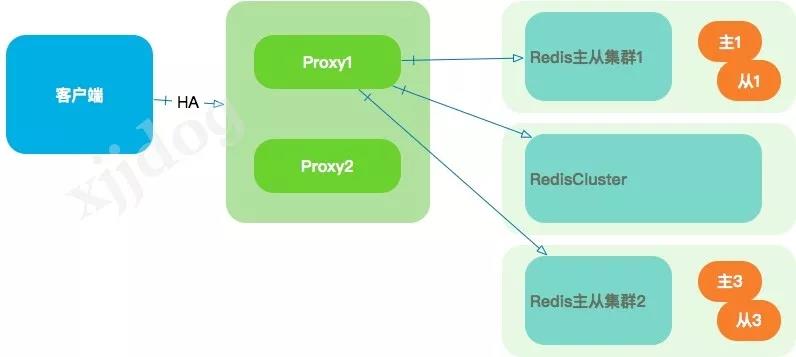
但这种方式的缺点也是显而易见的。首先,它引入了一个新的代理层,在结构上、运维上都显复杂。需要进行大量的编码,比如failover、读写分离、数据迁移等。另外,proxy层的加入,对性能也有相应的损耗。

多个proxy一般使用lvs等前置进行负载均衡的设计,如果proxy层的机器很少而后端redis的流量很高,那么网卡会成为主要的瓶颈。

Nginx也可以作为redis的代理层,比较专业的说法叫做Smart Proxy。这种方式较为偏门,如果你对nginx比较熟悉,不失为一种优雅的做法。

使用限制和坑

redis的速度特别的快。一般越快的东西,出问题的时候造成的后果越大。

不久之前,写过一篇针对于redis的规范:《Redis规范,这可能是最中肯的了》。规范和架构一样,适合自己公司环境的,才是最好的,但会提供一些起码的思路。

严格禁止的东西,一般都是前人踩坑的地方。除了这篇规范的内容,对于redis-cluster,补充以下几点。

1、redis cluster号称能够支持1k个节点,但你最好不要这么做。当节点数量增加到10,就能够感受到集群的一些抖动。这么大的集群证明你的业务已经很牛x了,考虑一下客户端分片吧。

2、一定要避免产生热点,如果流量全部打到了某个节点,后果一般很严重。

3、大key不要放redis,它会产生大量的慢查询,影响正常的查询。

4、如果你不是作为存储,缓存一定要设置过期时间。占着茅坑不拉屎的感觉是非常讨厌的。

5、大流量,不要开aof,开rdb即可。

6、redis cluster的操作,少用pipeline,少用multi-key,它们会产生大量不可预料的结果。

以上是一些补充,更全还是参考规范吧 《Redis规范,这可能是最中肯的了》。。。

End

redis 的代码才那么一丁点,肯定不会实现非常复杂的分布式供能。 redis 的定位就是性能、水平伸缩和可用性,对于简单的、一般流量的应用,已经足够了。生产环境无小事,对于复杂的高并发应用,注定了是一个组合的优化方案。

以上就是W3Cschool编程狮关于与亲生的Redis Cluster,来一次灵魂交流的相关介绍了,希望对大家有所帮助。

Redis集群方案这么多,我该用哪种呢?

thbcm阅读(309)

文章转载自公众号:小姐姐味道

redis速度快,可靠性高,是互联网公司的标配。它有单机、主从、哨兵、Cluster等四种部署模式。

下面,仅从部署模式上,来说明一下它们的优缺点。

单机模式

单机模式的redis非常简单,你只需要启动一个单一的节点就可以了,安装过程不超过5分钟。

通过redis-benchmark测试简单的命令,QPS可达到10w以上,不得不说非常的让人惊艳了。

单机模式的问题也非常明显。缺乏高可用的机制!

假如redis进程死了,进程就只能够穿透到底层的数据库中,对业务来说非常的危险。如果你把redis当作数据存储来用,情况会更加严重,甚至会丢失数据。

主从模式

所以最基本的redis部署,都会增加一个或者多个slave(现在叫replication)。

当主redis发生问题的时候,能够选取一个slave顶上去。

非常可惜的是,这种模式和传统的MySQL主从一样,切换起来比较蛋疼,需要借助外部的工具,比如keepalived等辅助进行切换,部署和维护难度直接飙升。

keepalived是一个基于VRRP协议来实现的高可用方案,通过 IP 漂移实现高可用。从描述上就可以看出它需要网络管理员的参与,和我们轻量级的redis背道而驰。

哨兵模式

哨兵模式就是使用额外的进程来替换keepalived的功能,对redis进程的存活性进行判断。在哨兵模式下,一旦主节点宕机,从节点作为主节点的备份可以随时顶上来。

但哨兵模式一个最大的问题,就是哨兵的数量太多,至少需要3个节点。

redis进行仲裁的时候,需要n/2+1个节点投票才能确认,这也是分布式系统的一般做法 (quorum)。和Zookeeper类似,哨兵节点做成奇数个,是非常合适的。

哨兵模式可以通过sentinel monitor配置同时检测多套集群,在集群数量适中的时候,还是比较好用的。

但哨兵模式有很多隐藏的坑,比如哨兵的启动,必须在master存活的情况下才能正常运行;另外,如果你的redis配置文件中使用RENAME屏蔽了一些危险命令时,哨兵也不能够启动。

客户端在连接redis的时候,就不能再直接连接redis的实例,它需要从哨兵转上一圈,以便获取一些变更信息。

集群模式

《与亲生的Redis Cluster,来一次灵魂交流》

集群模式可以说是这里面最优雅的方式了。你只需要部署多个对等的redis节点,然后使用客户端命令进行组群就可以了。

ip=192.169.0.23
./bin/redis-cli --cluster create  $ip:7001 $ip:7002 $ip:7003 $ip:7004 $ip:7005 $ip:7006 --cluster-replicas 1

它对节点的要求也是比较多的,一般是采用6个节点,三主三从。当节点超过10个,它的协调性就不那么灵活了,所以单集群的存储和性能上限也很快能到达。

集群模式的一些缺点很隐蔽。它的服务端节点倒是非常稳定了,但有些命令会严重影响性能。比如mget,pipeline等。它们需要把请求分散到多个节点执行、再聚合。节点越多,性能越低。

在下面这篇文章中,我们详细的描述了一些比较通用的redis使用规范,有些就是为了规避cluster模式引起的一些问题。

《Redis规范,这可能是最中肯的了》

其他方案

可以看到redis的这些集群模式,都不是完美的。应对小型的服务可能没有问题,如果是大型的集群和服务,这些部署方式对运维上,使用上来说,都有非常大的挑战。

使用客户端hash的方法,是大型互联网中常用的方式。参考下面的文章,现实中的路由规则,可能会相当复杂,但请求总能够精确的落在某个小的群组上面。

《现实中的路由规则,可能比你想象中复杂的多》

对于管理大型集群来说,我倒是倾向于主从模式,然后使用Java或者其他语言开发一个可以集中管控的哨兵系统,对上千个集群进行管理。

由于Redis是文本协议,协议非常简单,Netty甚至直接内置了它的解析器,所以开发这么一个哨兵系统是非常简单的。

一些中间层代理软件,也能分担一些路由工作,但由于是中间层,涉及到一层网络转发,对Redis这种以速度取胜的服务来说,就不是很实用。

变种有更多,比如下面这篇文章,使用的是Redis协议,但后端存储却是MySQL,所以你的命令会是被阉割的。

《架构秘笈:移花接木。使用mysql模拟redis》

从上面的描述中我们就可以看出,Redis 能用是一回事,用好是另一回事。

你可能花了一天时间搭建了一个单节点的 Redis ;我可能花了一周时间写了个 Java 版的哨兵,还有很多BUG。这两者在不懂技术的领导眼里,是没有区别的–它们都满足了业务的需求。但也不必过分计较,现实一般都比较残酷,计算机系统也没有想象中的那么稳定,墨菲定律总有一个时间会教会他们做人。

当然,领导每天都在教我做人。

以上就是W3Cschool编程狮关于Redis集群方案这么多,我该用哪种呢?的相关介绍了,希望对大家有所帮助。

2020前端面试都会问啥?

thbcm阅读(1000)

文章转载自公众号:前端工匠(微信号:frontJS)

2020年注定是不平凡的一年,找工作的竞争压力可想而知,如何从众多面试者中脱颖而出呢,总结了一波前端常见面试题,希望对大家有所帮助!

1. javascript 作用域与预解析

什么是预解析?

分两步执行:

第一步:(代码还没有执行。预览页面之前,写完之后)

找程序中var关键字,如果找到了提前给var定义的变量赋值undefined

找程序中的普通函数,如果找到了,函数提升,将整个函数赋值给函数名。

如果找的var的名字和函数名字相同,函数优先。

第二步: 逐行解析代码。按照上下顺序。如果碰到函数定义,忽略。

重点:函数内部同样适用于js预解析。

我们通过几道面试题,来了解下作用域和和预解析的原理

function fun(){ console.log(n); var n = 456; console.log(n); } var n = 123; fun(n);

猜一猜此题中输出的结果是?可能并不是你想的结果,why?

代码分析如下:

1-5行定义函数fun

6行定义变量 n

7行执行函数并传入变量 n

注意:fun函数内部有预解析。

预解析及执行步骤:

  1. Fun函数开始执行前,将var n提前执行,初始化为undefined
  1. 由于函数传入参数 n 并没有使用,忽略。
  1. 开始执行第2行,输出为undefined
  1. 执行第3行,此时即n = 456,即将n值重置为456。
  1. 执行第4行,输出改变后的n。

通过以上步骤分析,即可得知预解析的原理了(针对有var的变量提前赋初始值)

下面再看一题,看看函数预解析

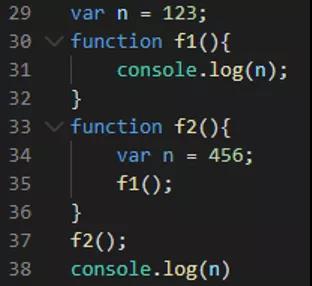
猜一猜此题中输出的结果是?可能并不是你想的结果,why?

代码分析如下:

29行定义一个全局变量

30-32行定义一个函数 f1

33-36行定义一个函数 f2

37行执行函数 f2

38行输出结果 n

预解析及执行步骤:

1.代码执行前,预解析先初始化变量 n, f1, f2,将它们都置为 undefined.

2.接着执行第29行,为变量n赋值

3.接着执行第30-32行,为函数变量 f1 赋值,即 f1 为函数了

4.接着执行第33-36行,为函数变量 f2 赋值

5.执行第37行,即执行 f2 函数。

  1. f2 函数执行前,同样预解析,先将 n 初始化为undefined,接着把 n 赋值为456,接着调用f1函数执行。
  1. f1 在 f2 中执行,那 f1 的作用域应该是 f2 ,应该输出456?

8.35行执行 f1 函数时无调用者,即 f1 函数为全局作用域,输出全局 n 为 123

9.第38行直接输出全局变量 n ,即123

继续深入,再来一题:

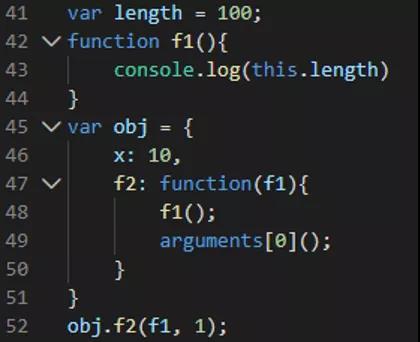
猜一猜此题中输出的结果是?可能并不是你想的结果,why?

代码分析如下:

预解析只针对varfunction定义的变量

预解析及执行步骤:

1.预解析先初始化变量length, obj, f1并赋值为undefined

2.接着为变量length赋值为 100

3.接着为函数变量 f1 赋值为函数

4.接着为变量`obj 赋值为对象

5.第52行,调用对象obj的 f2 函数执行,传入形参 f1 和1

6.第47行,f2 函数接收实参为 f1 , 接着执行 f1 函数

7.同上,f1 函数执行无调用者,作用域为全局,this指向window,输出全局变量length,即100

8.第47行,f2 函数接收实参 f1 ,若要取到所有实参则需要arguments对象,第一个参数arguments[0]==f1,第二个arguments[1]==1,依此类推。

9.第49行,arguments[0]()看上去是f1(),那也应该输出100?

10.注意arguments[0]作用域与f1的作用域并不相同,第48行直接执行f1,无调用者,作用域为全局作用域,但arguments[0]作用域为arguments对象,即thisarguments,则应输出 2,因为arguments对象的属性length为2。

2. 前端如何处理跨域

1、为什么会出现跨域问题

同源策略(Sameoriginpolicy)是一种约定,它是浏览器最核心也最基本的安全功能,如果缺少了同源策略,则浏览器的正常功能可能都会受到影响。可以说 Web 是构建在同源策略基础之上的,浏览器只是针对同源策略的一种实现。同源策略会阻止一个域的 javascript 脚本和另外一个域的内容进行交互。所谓同源(即指在同一个域)就是两个页面具有相同的协议(protocol),主机(host)和端口号(port)。

2、什么是跨域

当一个请求url的协议、域名、端口三者之间任意一个与当前页面url不同即为跨域。

当前页面url 被请求页面url 是否跨域 原因
http://www.w3cschool.cn/ http://www.w3cschool.cn/index.html 同源
http://www.w3cschool.cn/ https://www.w3cschool.cn/index.html 跨域 协议不同(http/https
http://www.w3cschool.cn http://www.baidu.cn/ 跨域 主域名不同(w3cschool/baidu
http://www.w3cschool.cn/ http://123.w3cschool.cn 跨域 子域名不同(www/123
www.test.com:8080/ www.test.com:7001 跨域 端口号不同

3、跨域解决方法

【1】设置document.domain解决无法读取非同源网页的 Cookie问题

【2】跨文档通信 API:window.postMessage()

【3】JSONP

【4】CORS

【5】Proxy

作为开发人员,最关心的跨域一般是2种交互的跨域,即ProxyCORS,很多开发只图一时方便,使用了Proxy,在打包后就发现又有跨域了,不知道怎么解决,下面我们通过实例一点点给大家解析。

跨域出现

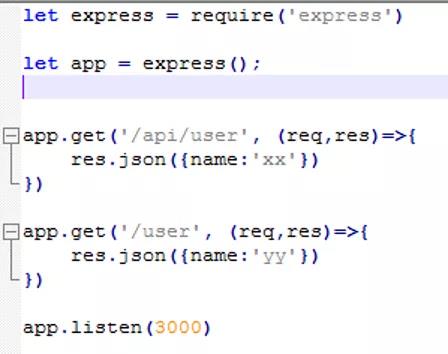
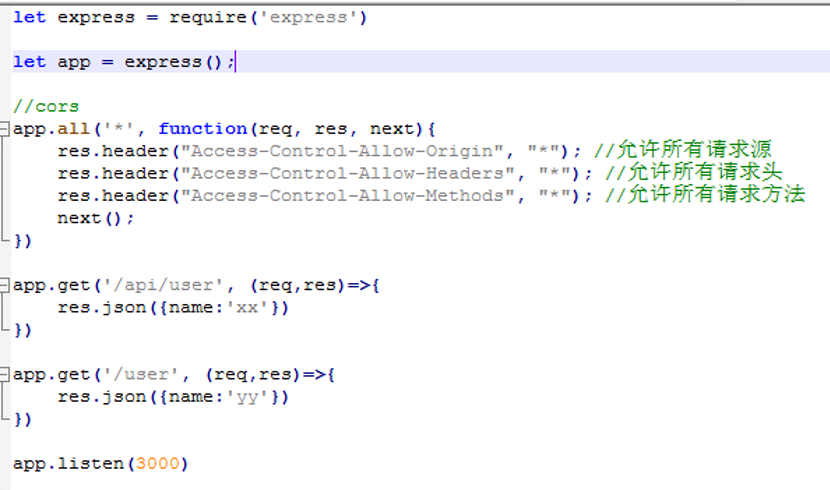
首先,需要重现跨域,先用node写一个简单的接口,如下

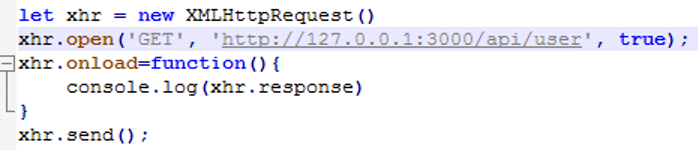
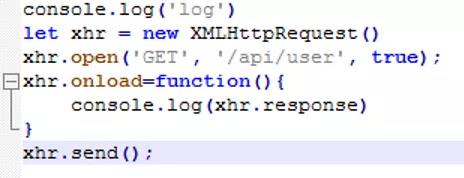
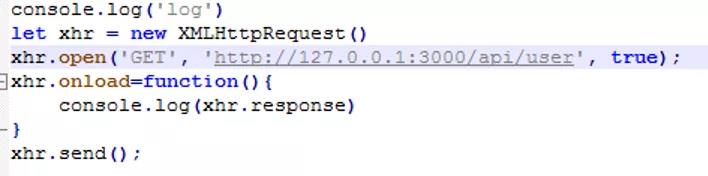
使用命令node启动这个服务,则搭建了一个最简单的后端服务接口,然后使用前端ajax来请求这个接口,如下

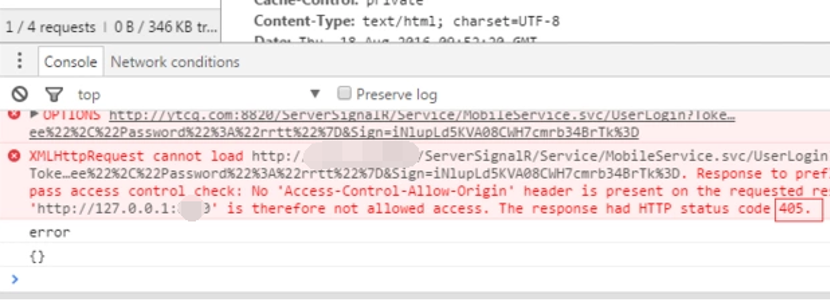
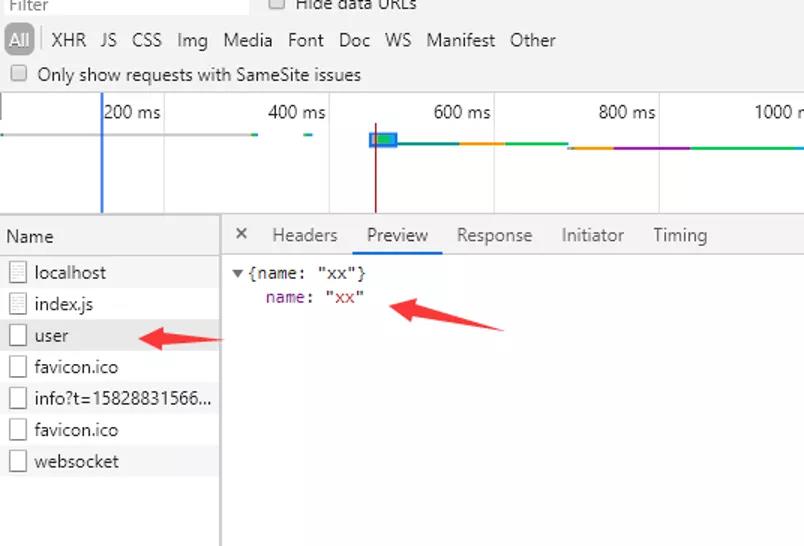
创建一个简单的html页面,再加上上面的简单ajax请求,在浏览器控制台就看到了跨域error

从日志上看出现了“Access-Control-Allow-Origin”,表示是访问源未被许可,即跨域了。

跨域解决之Proxy

现在项目一般都使用脚手架,即使用webpack,那可以使用webpack自带的proxy特性来处理跨域,下面我们来配置一个简单的webpack项目,如下

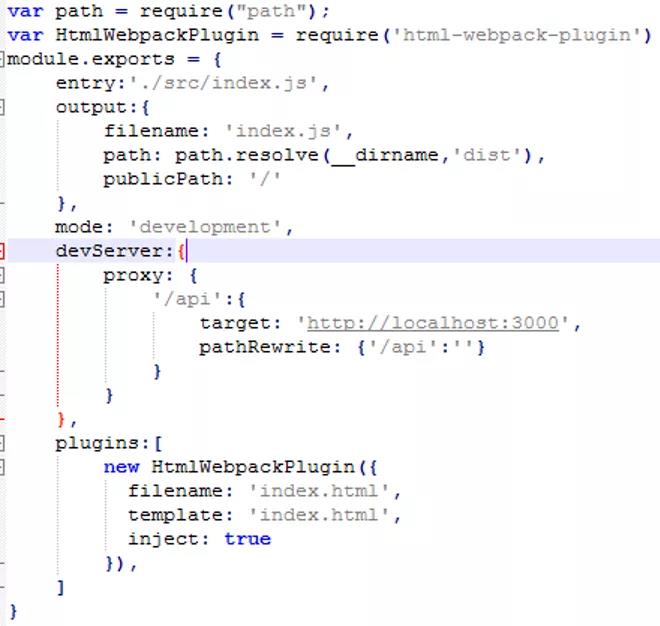
1.创建配置文件webpack.config.js

配置文件说明项目入口文件在srcindex.js,打包输出目录为dist,使用proxy处理跨域,即前端所有请求会自动跳转到target指定的url

注意这里有一个前缀,若没有可以不写。

2.创建src目录及index.js

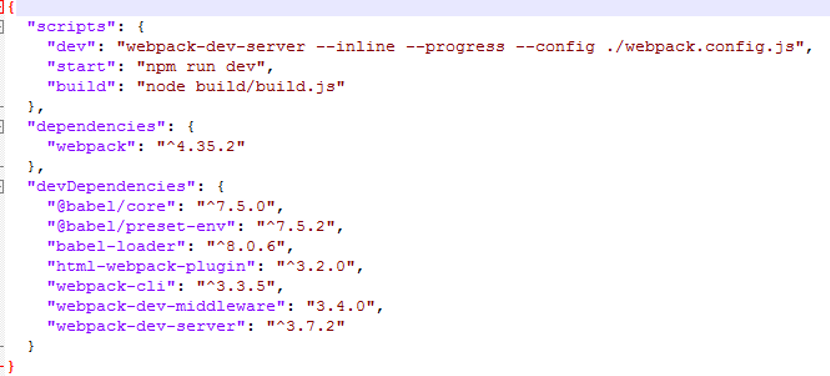
3.创建工程依赖文件package.json

依赖文件中配置了webpack启动命令

Npm run dev 启动服务

Npm run start 启动服务

Npm run build 打包命令

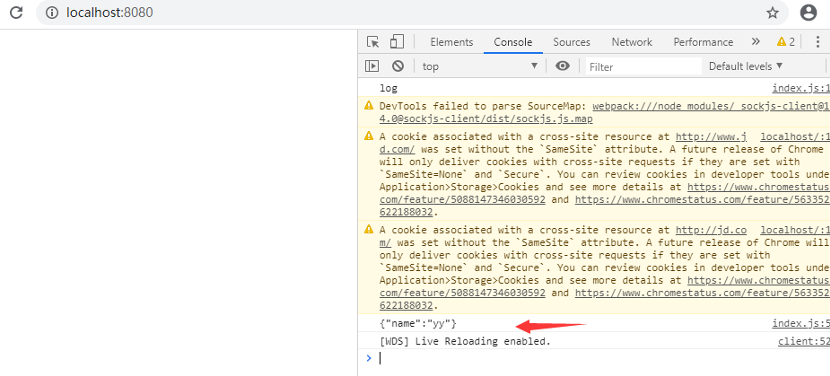
当启动服务后,打开浏览器输入 http://localhost:8080 ,即可看到一个空白页面,打开控制台可以看到ajax请求

拿到交互的数据了。

这种方式是开发最常用的,但是打包后就有问题了,因为打包后就不存在proxy了,跨域还是会存在,那应该怎么解决?

跨域解决之CORS

这种方式是在后端配置,配置CORS后,前端无需任何处理即可访问后端的接口,无论是在开发时还是部署时都是OK的。

下面,我们把proxy注释掉,使用CORS方式处理,如下:

配置了cors后,接口就可以随便访问了。

此时,还需要把前端请求地址改一下,改为直接请求后端接口,如下

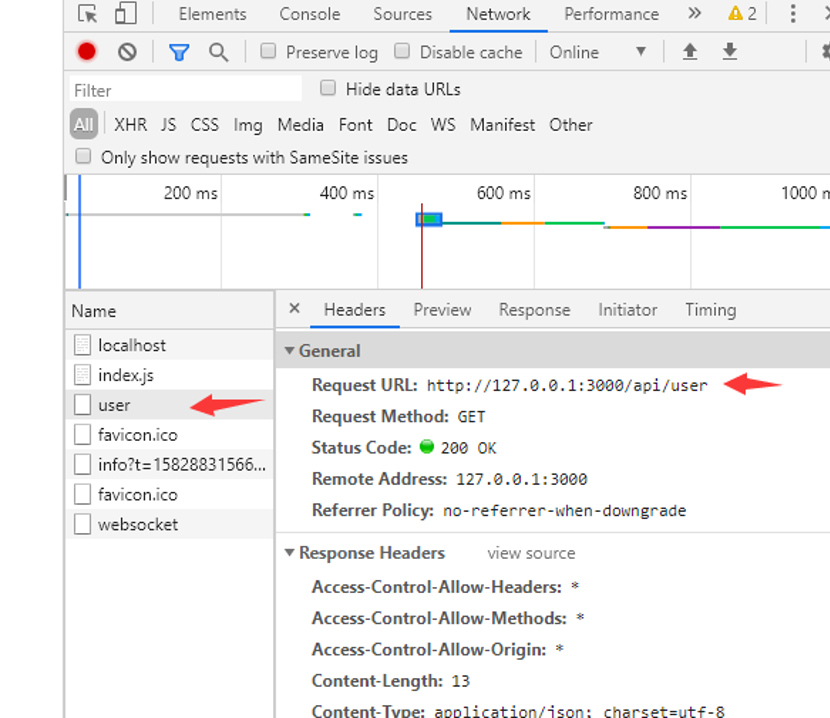
刷新页面,打开控制台可以看到请求地址为

通过此种方式,在开发阶段或部署都没有问题,这也是开发中最常用的2种方式。

3. 什么是闭包?如何理解

闭包(closure)是javascript的一大难点,也是它的特色。很多高级应用都要依靠闭包来实现。

要理解闭包,首先要理解javascript的全局变量和局部变量。

javascript语言的特别之处就在于:函数内部可以直接读取全局变量,但是在函数外部无法读取函数内部的局部变量。

如何从外部读取函数内部的局部变量?

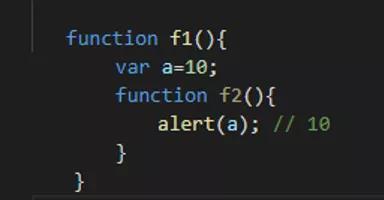
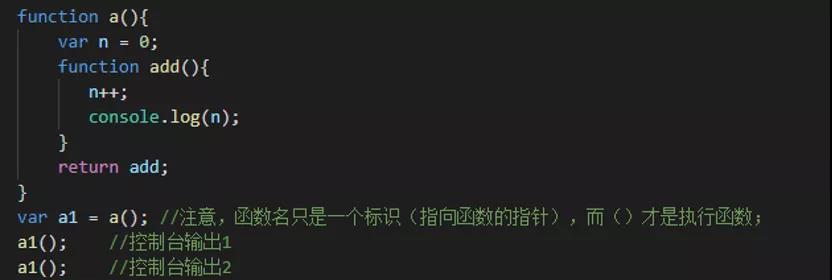
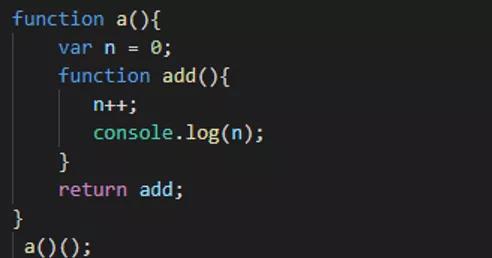
我们有时候需要获取到函数内部的局部变量,正常情况下,这是办不到的!只有通过变通的方法才能实现。那就是在函数内部,再定义一个函数。

1、闭包的概念

上面代码中的 f2 函数,就是闭包。

各种专业文献的闭包定义都非常抽象,我的理解是: 闭包就是能够读取其他函数内部变量的函数。

由于在javascript中,只有函数内部的子函数才能读取局部变量,所以说,闭包可以简单理解成“定义在一个函数内部的函数“。

所以,在本质上,闭包是将函数内部和函数外部连接起来的桥梁。

2、闭包的用途

闭包可以用在许多地方。它的最大用处有两个,一个是前面提到的可以读取函数内部的变量,另一个就是让这些变量的值始终保持在内存中,不会在 f1 调用后被自动清除。

为什么会这样呢?原因就在于 f1 是 f2 的父函数,而 f2 被赋给了一个全局变量,这导致 f2 始终在内存中,而 f2 的存在依赖于 f1 ,因此 f1 也始终在内存中,不会在调用结束后,被垃圾回收机制(garbage collection)回收。

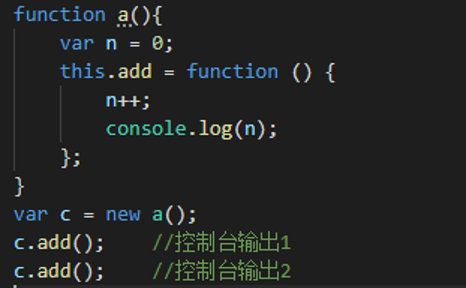
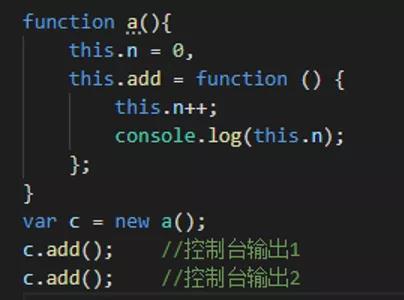
在我们平时的代码中经常会用到闭包,比如在构造函数中

//另一种写法

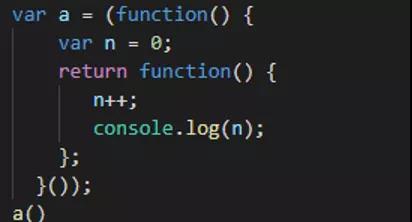
3、常见闭包的写法

另一种调用方法

//定义函数并立即调用

4、闭包的实际应用

使用闭包,我们可以做很多事情。比如模拟面向对象的代码风格;更优雅,更简洁的表达出代码;在某些方面提升代码的执行效率。

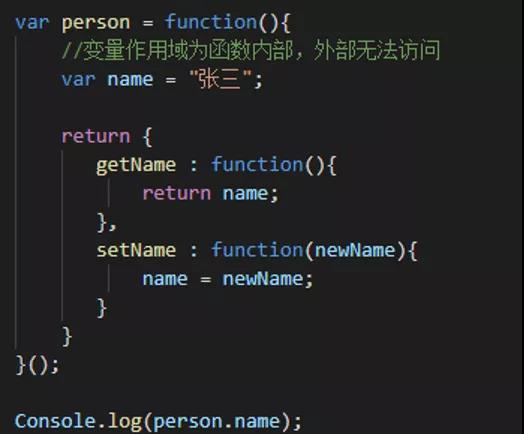
封装

通过person.name是无法获取到name的值,如果要获取到name的值可以通过

Console.log(person.getName()); //直接获取到 张三 person.setName(“李四”); //重新设置新的名字 print(person.getName()); //获取 李四

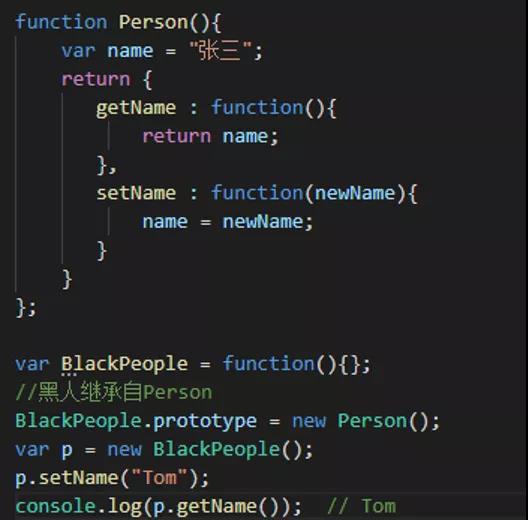
继承

总结:闭包就是一个函数引用另外一个函数的变量,因为变量被引用着所以不会被回收,因此可以用来封装一个私有变量。这是优点也是缺点,不必要的闭包只会徒增内存消耗!

以上就是W3Cschool编程狮关于2020前端面试都会问啥?的相关介绍了,希望对大家有所帮助。

JavaScript错误的10大经典问题

thbcm阅读(277)

本文转载自公众号:前端工匠(微信号:frontJS)

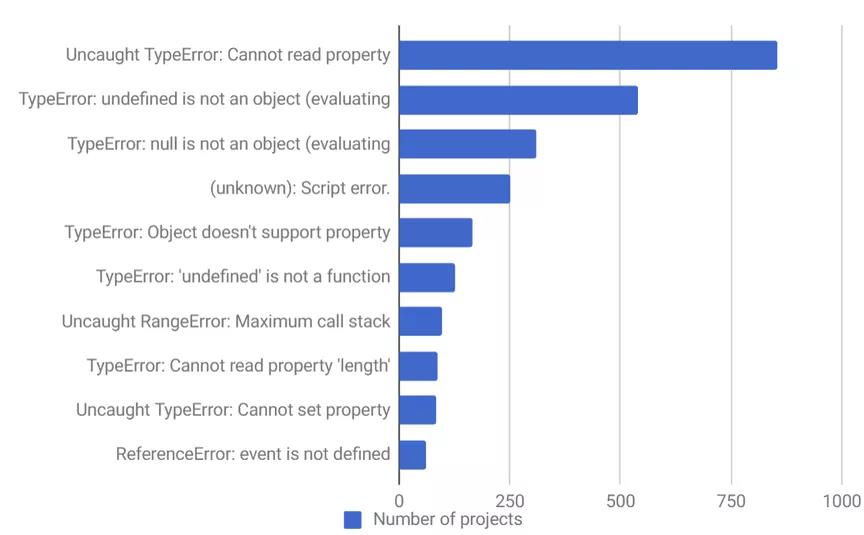
本文给大家带来了10个经典的JavaScript错误,为了便于阅读,每个错误都被缩短了,让我们更深入地研究每一个问题,以确定是什么导致了这些问题,以及如何避免产生这些问题。

1. Uncaught TypeError: Cannot read property

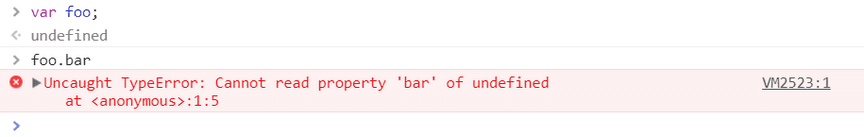
如果你是一个 JavaScript 开发人员,你可能已经看到过这个错误。当你读取属性或在未定义对象上调用方法时,Chrome 中就会发生这种情况。你可以在 Chrome 开发者控制台中轻松进行测试。

发生这种情况的原因有很多,但常见的原因是渲染 UI 组件时状态初始化不当。让我们来看一个在现实应用中如何发生这种情况的示例。我们将选择React,但是不正确初始化的相同原理也适用于AngularVue或任何其他框架。

class Quiz extends Component {
  componentWillMount() {
    axios.get('/thedata').then(res => {
      this.setState({items: res.data});
    });
  }
  render() {
    return (
      <ul>
        {this.state.items.map(item =>
          <li key={item.id}>{item.name}</li>
        )}
      </ul>
    );
  }
}

这里有两件重要的事情要意识到:

  • 组件的状态(例如 this.state)以 undefined 状态开始使用。
  • 当你异步获取数据时,无论数据是在构造函数 componentWillMount 还是 componentDidMount 中获取,组件都将在数据加载之前至少渲染一次。当Quiz第一次渲染时,this.state.itemsundefined。这反过来又意味着ItemList会得到未定义的items,你会在控制台中得到一个错误——”UncaughtTypeError: Cannot read property ‘map’ of undefined “的错误。

这很容易解决,最简单的方法:在构造函数中使用合理的默认值初始化状态。

class Quiz extends Component {
  // 添加了这个:
  constructor(props) {
    super(props);
    this.state = {
      items: [] // 默认值
    };
  }
  componentWillMount() {
    axios.get('/thedata').then(res => {
      this.setState({items: res.data});
    });
  }
  render() {
    return (
      <ul>
        {this.state.items.map(item =>
          <li key={item.id}>{item.name}</li>
        )}
      </ul>
    );
  }
}

你的应用程序中的实际代码可能会有不同,但我希望已经给了你足够的线索,让你在你的应用程序中修复或避免这个问题。如果没有,请继续阅读,因为我将在下面介绍有关相关错误的更多示例。

2. TypeError: ‘undefined’ is not an object (evaluating

这是在 Safari 中读取属性或调用undefined对象上的方法时发生的错误,你可以在Safari开发者控制台中非常轻松地进行测试。这基本上与上述针对 Chrome 的错误相同,但 Safari 使用了不同的错误消息。

3. TypeError: null is not an object (evaluating

这是在 Safari 中读取属性或调用null对象上的方法时发生的错误,你可以在 Safari 开发者控制台中非常轻松地进行测试。

有趣的是,在JavaScript中,nullundefined不相同,这就是为什么我们看到两个不同的错误消息的原因。undefined通常是尚未分配的变量,而null表示该值为空白。 要验证它们是否相等,请尝试使用严格相等运算符。

在实际示例中可能发生这种错误的一种方式是,在加载元素之前尝试在JavaScript中使用DOM元素,这是因为DOM API对于空白的对象引用返回null

任何执行和处理DOM元素的JS代码都应在创建DOM元素后执行。JS代码按照HTML格式从上到下进行解释,所以,如果在DOM元素之前有一个标签,那么在浏览器解析HTML页面的时候,脚本标签内的JS代码就会被执行。如果在加载脚本之前尚未创建DOM元素,则会出现此错误。

在此示例中,我们可以通过添加事件侦听器来解决该问题,该事件侦听器将在页面准备就绪时通知我们。一旦触发了 addEventListenerinit() 方法就可以使用DOM元素。

<script>
  function init() {
    var myButton = document.getElementById("myButton");
    var myTextfield = document.getElementById("myTextfield");
    myButton.onclick = function() {
      var userName = myTextfield.value;
    }
  }
  document.addEventListener('readystatechange', function() {
    if (document.readyState === "complete") {
      init();
    }
  });
</script>
<form>
  <input type="text" id="myTextfield" placeholder="Type your name" />
  <input type="button" id="myButton" value="Go" />
</form>

4. (unknown): Script error

当未捕获的JavaScript错误违反跨源策略跨越域边界时,将发生脚本错误。例如,如果你将你的JavaScript代码托管在CDN上,任何未被捕获的错误(冒泡到window.onerror处理程序中的错误,而不是在try-catch中被捕获的错误)都会被报告为 “Script error”,而不是包含有用的信息。这是一种浏览器安全措施,旨在防止跨域传递数据,否则该域将无法通信。

要获取真实的错误消息,请执行以下操作。

发送Access-Control-Allow-Origin标头

Access-Control-Allow-Origin 标头设置为 * 表示可以从任何域正确访问资源。你可以根据需要将 * 替换为您的域:例如,Access-Control-Allow-Origin:www.example.com。但是,处理多个域比较复杂,如果使用 CDN 可能会出现缓存问题,那么可能不值得花费精力。

以下是一些有关如何在各种环境中设置此标头的示例:

Apache

在将提供JavaScript文件的文件夹中,创建一个具有以下内容的 .htaccess 文件:

Header add Access-Control-Allow-Origin "*"

Nginx

add_header指令添加到提供JavaScript文件的location块中:

location ~ ^/assets/ {
    add_header Access-Control-Allow-Origin *;
}

HAProxy

将以下内容添加到提供JavaScript文件的asset后端:

rspadd Access-Control-Allow-Origin:\ *

在脚本标签上设置crossorigin =“ anonymous”

在你的HTML源代码中,对于您设置了 Access-Control-Allow-Origin 标头的每个脚本,在script标记上设置crossorigin="anonymous"。在script标记上添加 crossorigin 属性之前,请确保已验证是否已为脚本文件发送了标头。在Firefox中,如果存在 crossorigin 属性,但没有 Access-Control-Allow-Origin 标头,则不会执行脚本。

5. TypeError: Object doesn’t support property

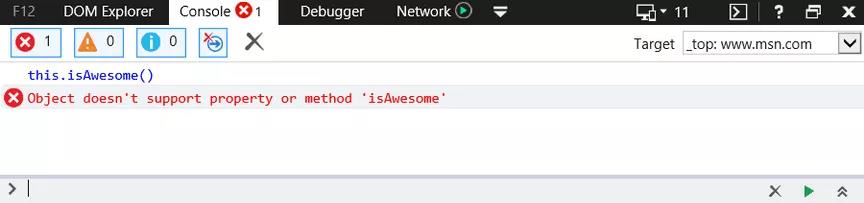
这是在 IE 中发生的错误,当您调用undefined的方法时,你可以在 IE 开发人员控制台中对此进行测试。

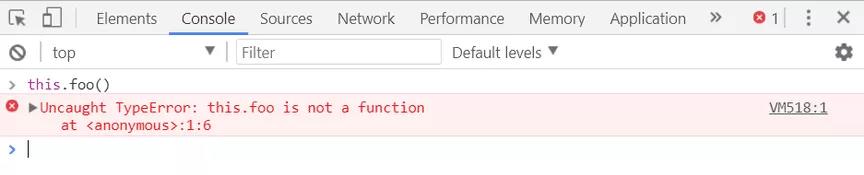
这等效于 Chrome 中的错误“ TypeError:‘undefined’ is not a function”。是的,对于相同的逻辑错误,不同的浏览器可能具有不同的错误消息。

这是 IE 在采用JavaScript命名空间的 Web 应用程序中常见的问题,在这种情况下,99.9%的问题是 IE 无法将当前名称空间中的方法绑定到 this 关键字。

例如,如果你的JS命名空间 Rollbar 使用 isAwesome 方法。通常,如果你在 Rollbar 名称空间中,则可以使用以下语法调用 isAwesome 方法:

this.isAwesome();

Chrome,Firefox 和 Opera 将很乐意接受此语法。另一方面,IE 则不会。因此,在使用 JS命名空间时,最安全的方法是用实际的命名空间作为前缀。

Rollbar.isAwesome();

6. TypeError: ‘undefined’ is not a function

这是在 Chrome 中发生的错误,当你调用undefined的函数时。你可以在 Chrome 开发者控制台和Mozilla Firefox开发者控制台中对此进行测试。

随着这些年来JavaScript的编码技术和设计模式越来越复杂,在回调和闭包中的自引用作用域也相应地增多,这也是相当常见的这种或那种混乱的根源。

考虑以下示例代码片段:

function clearBoard(){
  alert("Cleared");
}
document.addEventListener("click", function(){
  this.clearBoard(); // 这个 "this" 是什么?
});

如果执行上述代码,然后单击该页面,则会导致以下错误“ Uncaught TypeError:this.clearBoard not a function”。原因是正在执行的匿名函数是在文档的上下文中,而 clearBoard 是在 window 中定义的。

传统的、与旧浏览器兼容的解决方案是简单地将对它的引用保存在一个变量中,然后闭包可以继承这个变量。例如:

var self = this;
document.addEventListener("click", function(){
  self.clearBoard();
});

另外,在较新的浏览器中,可以使用 bind() 方法传递正确的引用:

document.addEventListener("click",this.clearBoard.bind(this));

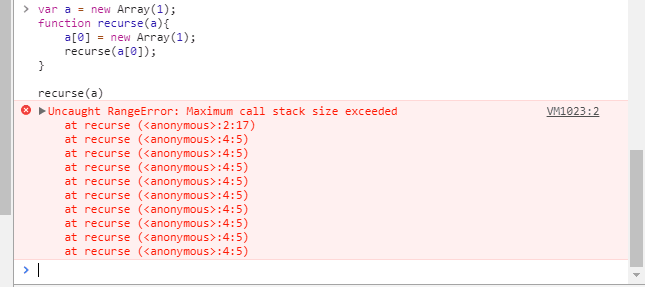
7. Uncaught RangeError: Maximum call stack

这是 Chrome 浏览器在几种情况下出现的错误,一种是调用不终止的递归函数。你可以在 Chrome 开发者控制台中对此进行测试。

如果将值传递给超出范围的函数,也可能会发生这种情况。许多函数的输入值仅接受特定范围的数字,例如,Number.toExponential(digits)Number.toFixed(digits) 接受0到20之间的数字,而Number.toFixed(digits) 接受1到21之间的数字。

var a = newArray(4294967295);  //OK
var b = newArray(-1); //range error


var num = 2.555555;
document.writeln(num.toExponential(4));  //OK
document.writeln(num.toExponential(-2)); //range error!


num = 2.9999;
document.writeln(num.toFixed(2));   //OK
document.writeln(num.toFixed(25));  //range error!


num = 2.3456;
document.writeln(num.toPrecision(1));   //OK
document.writeln(num.toPrecision(22));  //range error!

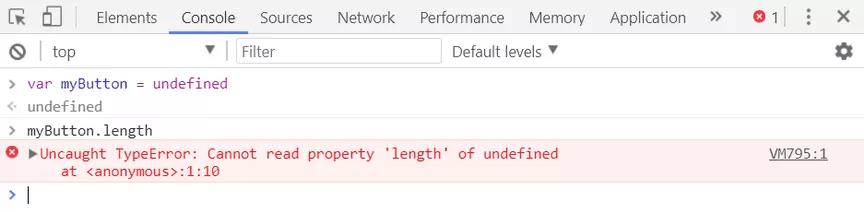
8. TypeError: Cannot read property ‘length’

这是 Chrome 浏览器中发生的错误,因为读取undefined的变量的length属性,你可以在 Chrome 开发者控制台中进行测试。

通常情况下,你可以在数组上找到定义的长度,但如果数组没有初始化或者变量名被隐藏在其他上下文中,你可能会遇到这个错误。通过以下示例让我们了解此错误。

var testArray= ["Test"];
function testFunction(testArray) {
    for (var i = 0; i < testArray.length; i++) {
      console.log(testArray[i]);
    }
}
testFunction();

当你声明一个带参数的函数时,这些参数就变成了局部参数。这意味着即使你具有名称为 testArray 的变量,函数内具有相同名称的参数仍将被视为局部参数。

你可以通过两种方式解决问题:

删除函数声明语句中的参数(事实证明,你想访问那些在函数外部声明的变量,因此你不需要为函数使用参数)

var testArray = ["Test"];


/* 前置条件:在函数外部定义testArray */
function testFunction(/* No params */) {
   for (var i = 0; i < testArray.length; i++) {
     console.log(testArray[i]);
   }
}


testFunction()

调用函数,将我们声明的数组传递给它。

var testArray = ["Test"];


function testFunction(testArray) {
  for (var i = 0; i < testArray.length; i++) {
     console.log(testArray[i]);
   }
}


testFunction(testArray);

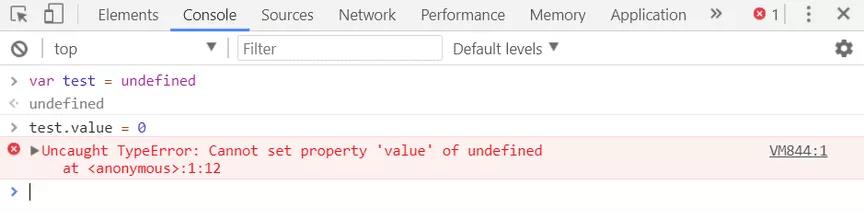
9. Uncaught TypeError: Cannot set property

当我们尝试访问未定义的变量时,它总是返回 undefined,我们无法获取或设置任何 undefined 属性。在这种情况下,应用程序将引发“ Uncaught TypeError:Cannot set property”。

例如,在 Chrome 浏览器中:

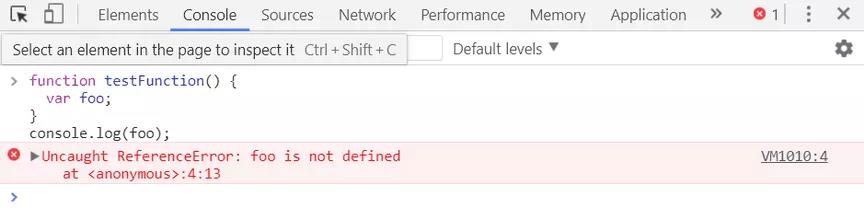
如果 test 对象不存在,则错误将引发“ Uncaught TypeError:Cannot set property”。

10. ReferenceError: event is not defined

当您尝试访问undefined 或超出当前范围的变量时,将引发此错误。你可以在Chrome浏览器中非常轻松地对其进行测试。

如果你在使用事件处理系统时收到这个错误,请确保你使用传入的事件对象作为参数。IE 等较旧的浏览器会提供全局变量事件,而 Chrome 会自动将事件变量附加到处理程序。 Firefox 不会自动添加它。jQuery 之类的库试图规范这种行为,尽管如此,最好还是使用传递给事件处理程序函数的方法。

document.addEventListener("mousemove", function (event) {
  console.log(event);
})

总结

事实证明,其中许多都是nullundefined的错误。如果使用严格的编译器选项,像Typescript这样的静态类型检查系统可以帮助你避免使用它们。它可以警告你,如果一个类型是预期的,但还没有被定义。

以上就是W3Cschool编程狮关于JavaScript错误的10大经典问题的相关介绍了,希望对大家有所帮助。

分布式服务注册发现与统一配置管理之 Consul

thbcm阅读(296)

文章转载自公众号:Java极客技术 作者:鸭血粉丝

今天这篇文章给大家介绍一个用于服务注册发现和管理配置的开源组件– Consul 。接下来让我们一起来看一下它的功能吧。

背景

目前分布式系统架构已经基本普及,很多项目都是基于分布式架构的,以往的单机模式基本已经不适应当下互联网行业的发展。随着分布式项目的普及,项目服务实例数目的增加,服务的注册与发现功能就成了一项必不可少的架构。服务的注册与发现的功能,有很多开源方案。包括早期的zookeeper,百度的disconf,阿里的diamond,基于Go语言的ETCDSpring集成的Eureka,以及前文提到的 Nacos 还有本文的主角Consul。这里不对上面提到的进行比较,本文仅介绍Consul,详细的对比,说明网上有很多资料,可以参考,例如:服务发现比较:Consul vs Zookeeper vs Etcd vs Eureka说到服务的注册与发现主要是下面两个主要功能:

  1. 服务注册与发现
  2. 配置中心即分布式项目统一配置管理

Consul 服务端配置使用

  1. 下载相应版本解压,并将可执行文件复制到/usr/local/consul目录下
  1. 创建一个service的配置文件
    silence$ sudo mkdir /etc/consul.d
    silence$ echo '{"service":{"name": "web", "tags": ["rails"], "port": 80}}' | sudo tee /etc/consul.d/web.json
  1. 启动代理
   silence$ /usr/local/consul/consul agent -dev -node consul_01 -config-dir=/etc/consul.d/ -ui

-dev 参数代表本地测试环境启动;-node 参数表示自定义集群名称;-config-drir 参数表示services的注册配置文件目录,即上面创建的文件夹-ui 启动自带的web-ui管理页面

  1. 集群成员查询方式
   silence-pro:~ silence$ /usr/local/consul/consul members

  1. HTTP协议数据查询
silence-pro:~ silence$ curl http://127.0.0.1:8500/v1/catalog/service/web
[
    {
        "ID": "ab1e3577-1b24-d254-f55e-9e8437956009",
        "Node": "consul_01",
        "Address": "127.0.0.1",
        "Datacenter": "dc1",
        "TaggedAddresses": {
            "lan": "127.0.0.1",
            "wan": "127.0.0.1"
        },
        "NodeMeta": {
            "consul-network-segment": ""
        },
        "ServiceID": "web",
        "ServiceName": "web",
        "ServiceTags": [
            "rails"
],
        "ServiceAddress": "",
        "ServicePort": 80,
        "ServiceEnableTagOverride": false,
        "CreateIndex": 6,
        "ModifyIndex": 6
    }
]
silence-pro:~ silence$

  1. web-ui管理 Consul Web UI

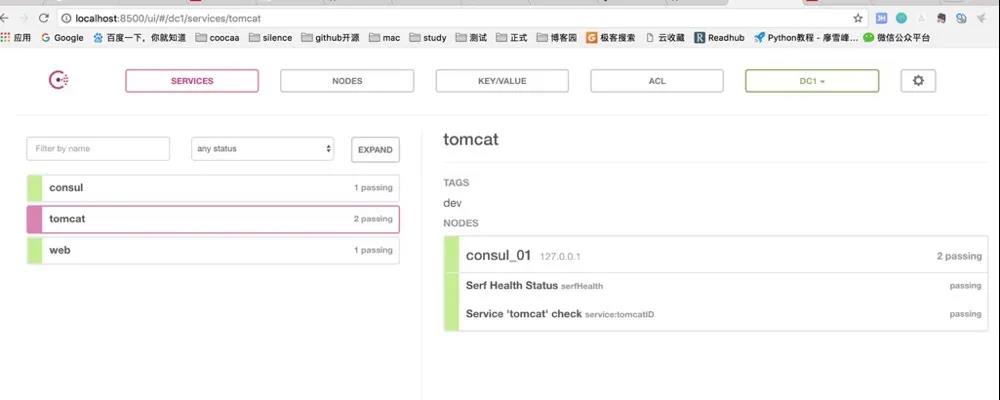
Consul的web-ui可以用来进行服务状态的查看,集群节点的检查,访问列表的控制以及KV存储系统的设置,相对于Eureka和ETCD,Consul的web-ui要好用的多。(Eureka和ETCD将在下一篇文章中简单介绍。)

7.KV存储的数据导入和导出

silence-pro:consul silence$ ./consul kv import @temp.json


silence-pro:consul silence$ ./consul kv export redis/

temp.json文件内容格式如下,一般是管理页面配置后先导出保存文件,以后需要再导入该文件

[
    {
        "key": "redis/config/password",
        "flags": 0,
        "value": "MTIzNDU2"
    },
    {
        "key": "redis/config/username",
        "flags": 0,
        "value": "U2lsZW5jZQ=="
    },
    {
        "key": "redis/zk/",
        "flags": 0,
        "value": ""
    },
    {
        "key": "redis/zk/password",
        "flags": 0,
        "value": "NDU0NjU="
    },
    {
        "key": "redis/zk/username",
        "flags": 0,
        "value": "ZGZhZHNm"
    }
]

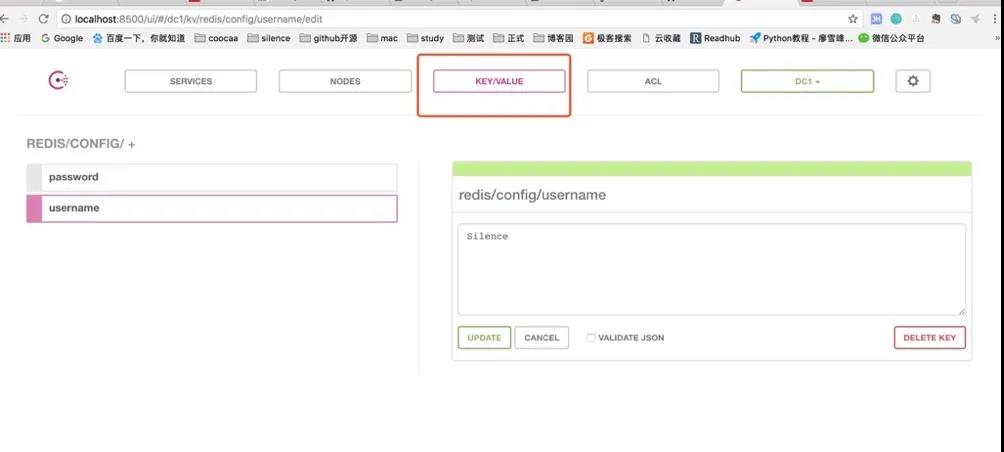
Consul的KV存储系统是一种类似zk的树形节点结构,用来存储相关key/value键值对信息的,我们可以使用KV存储系统来实现上面提到的配置中心,将统一的配置信息保存在KV存储系统里面,方便各个实例获取并使用同一配置。而且更改配置后各个服务可以自动拉取最新配置,不需要重启服务。

Consul Java 客户端使用

  1. maven pom依赖增加,版本可自由更换
<dependency>
    <groupId>com.orbitz.consul</groupId>
    <artifactId>consul-client</artifactId>
    <version>0.12.3</version>
</dependency>
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-actuator</artifactId>
</dependency>

  1. Consul 基本工具类,根据需要相应扩展
package com.coocaa.consul.consul.demo;


import com.google.common.base.Optional;
import com.google.common.net.HostAndPort;
import com.orbitz.consul.*;
import com.orbitz.consul.model.agent.ImmutableRegCheck;
import com.orbitz.consul.model.agent.ImmutableRegistration;
import com.orbitz.consul.model.health.ServiceHealth;


import java.net.MalformedURLException;
import java.net.URI;
import java.util.List;


public class ConsulUtil {


    private static Consul consul = Consul.builder().withHostAndPort(HostAndPort.fromString("127.0.0.1:8500")).build();


    /**


     * 服务注册


     */
    public static void serviceRegister() {
        AgentClient agent = consul.agentClient();


        try {
            /**


             * 注意该注册接口:
             * 需要提供一个健康检查的服务URL,以及每隔多长时间访问一下该服务(这里是3s)


             */
            agent.register(8080, URI.create("http://localhost:8080/health").toURL(), 3, "tomcat", "tomcatID", "dev");


        } catch (MalformedURLException e) {
            e.printStackTrace();
        }


    }


    /**


     * 服务获取


     *


     * @param serviceName


     */
    public static void findHealthyService(String serviceName) {
        HealthClient healthClient = consul.healthClient();
        List<ServiceHealth> serviceHealthList = healthClient.getHealthyServiceInstances(serviceName).getResponse();
        serviceHealthList.forEach((response) -> {
            System.out.println(response);
        });
    }


    /**


     * 存储KV


     */
    public static void storeKV(String key, String value) {
        KeyValueClient kvClient = consul.keyValueClient();
        kvClient.putValue(key, value);
    }


    /**


     * 根据key获取value


     */
    public static String getKV(String key) {
        KeyValueClient kvClient = consul.keyValueClient();
        Optional<String> value = kvClient.getValueAsString(key);
        if (value.isPresent()) {
            return value.get();
        }
        return "";
    }


    /**


     * 找出一致性的节点(应该是同一个DC中的所有server节点)


     */
    public static List<String> findRaftPeers() {
        StatusClient statusClient = consul.statusClient();
        return statusClient.getPeers();
    }


    /**


     * 获取leader


     */
    public static String findRaftLeader() {
        StatusClient statusClient = consul.statusClient();
        return statusClient.getLeader();
    }


    public static void main(String[] args) {
        AgentClient agentClient = consul.agentClient();
        agentClient.deregister("tomcatID");
    }
}

temp.json 和 ConsulUtil.java 文件以及上传到 GitHub 资源库,回复【源码仓库】获取代码地址。

3.通过上面的基本工具类可以实现服务的注册和KV数据的获取与存储功能

Consul集群搭建

  1. 三台主机Consul下载安装,我这里没有物理主机,所以通过三台虚拟机来实现。虚拟机IP分192.168.231.145,192.168.231.146,192.168.231.147
  1. 将145和146两台主机作为Server模式启动,147作为Client模式启动,Server和Client只是针对Consul集群来说的,跟服务没有任何关系!
  1. Server模式启动145,节点名称设为n1,数据中心统一用dc1
[root@centos145 consul]# ./consul agent -server -bootstrap-expect 2 -data-dir /tmp/consul -node=n1 -bind=192.168.231.145 -datacenter=dc1
bootstrap_expect = 2: A cluster with 2 servers will provide no failure tolerance. See https://www.consul.io/docs/internals/consensus.html#deployment-table
bootstrap_expect > 0: expecting 2 servers
==> Starting Consul agent...
==> Consul agent running!
           Version: 'v1.0.1'
           Node ID: '6cc74ff7-7026-cbaa-5451-61f02114cd25'
         Node name: 'n1'
        Datacenter: 'dc1' (Segment: '<all>')
            Server: true (Bootstrap: false)
       Client Addr: [127.0.0.1] (HTTP: 8500, HTTPS: -1, DNS: 8600)
      Cluster Addr: 192.168.231.145 (LAN: 8301, WAN: 8302)
           Encrypt: Gossip: false, TLS-Outgoing: false, TLS-Incoming: false


==> Log data will now stream in as it occurs:


    2017/12/06 23:26:21 [INFO] raft: Initial configuration (index=0): []
    2017/12/06 23:26:21 [INFO] serf: EventMemberJoin: n1.dc1 192.168.231.145
    2017/12/06 23:26:21 [INFO] serf: EventMemberJoin: n1 192.168.231.145
    2017/12/06 23:26:21 [INFO] agent: Started DNS server 127.0.0.1:8600 (udp)
    2017/12/06 23:26:21 [INFO] raft: Node at 192.168.231.145:8300 [Follower] entering Follower state (Leader: "")
    2017/12/06 23:26:21 [INFO] consul: Adding LAN server n1 (Addr: tcp/192.168.231.145:8300) (DC: dc1)
    2017/12/06 23:26:21 [INFO] consul: Handled member-join event for server "n1.dc1" in area "wan"
    2017/12/06 23:26:21 [INFO] agent: Started DNS server 127.0.0.1:8600 (tcp)
    2017/12/06 23:26:21 [INFO] agent: Started HTTP server on 127.0.0.1:8500 (tcp)
    2017/12/06 23:26:21 [INFO] agent: started state syncer
    2017/12/06 23:26:28 [ERR] agent: failed to sync remote state: No cluster leader
    2017/12/06 23:26:30 [WARN] raft: no known peers, aborting election
    2017/12/06 23:26:49 [ERR] agent: Coordinate update error: No cluster leader
    2017/12/06 23:26:54 [ERR] agent: failed to sync remote state: No cluster leader
    2017/12/06 23:27:24 [ERR] agent: Coordinate update error: No cluster leader
    2017/12/06 23:27:27 [ERR] agent: failed to sync remote state: No cluster leader
    2017/12/06 23:27:56 [ERR] agent: Coordinate update error: No cluster leader
    2017/12/06 23:28:02 [ERR] agent: failed to sync remote state: No cluster leader
    2017/12/06 23:28:27 [ERR] agent: failed to sync remote state: No cluster leader
    2017/12/06 23:28:33 [ERR] agent: Coordinate update error: No cluster leader

目前只启动了145,所以还没有集群

4.Server模式启动146,节点名称用n2,并在n2上启用了web-ui管理页面功能

[root@centos146 consul]# ./consul agent -server -bootstrap-expect 2 -data-dir /tmp/consul -node=n2 -bind=192.168.231.146 -datacenter=dc1 -ui
bootstrap_expect = 2: A cluster with 2 servers will provide no failure tolerance. See https://www.consul.io/docs/internals/consensus.html#deployment-table
bootstrap_expect > 0: expecting 2 servers
==> Starting Consul agent...
==> Consul agent running!
           Version: 'v1.0.1'
           Node ID: 'eb083280-c403-668f-e193-60805c7c856a'
         Node name: 'n2'
        Datacenter: 'dc1' (Segment: '<all>')
            Server: true (Bootstrap: false)
       Client Addr: [127.0.0.1] (HTTP: 8500, HTTPS: -1, DNS: 8600)
      Cluster Addr: 192.168.231.146 (LAN: 8301, WAN: 8302)
           Encrypt: Gossip: false, TLS-Outgoing: false, TLS-Incoming: false


==> Log data will now stream in as it occurs:


    2017/12/06 23:28:30 [INFO] raft: Initial configuration (index=0): []
    2017/12/06 23:28:30 [INFO] serf: EventMemberJoin: n2.dc1 192.168.231.146
    2017/12/06 23:28:31 [INFO] serf: EventMemberJoin: n2 192.168.231.146
    2017/12/06 23:28:31 [INFO] raft: Node at 192.168.231.146:8300 [Follower] entering Follower state (Leader: "")
    2017/12/06 23:28:31 [INFO] consul: Adding LAN server n2 (Addr: tcp/192.168.231.146:8300) (DC: dc1)
    2017/12/06 23:28:31 [INFO] consul: Handled member-join event for server "n2.dc1" in area "wan"
    2017/12/06 23:28:31 [INFO] agent: Started DNS server 127.0.0.1:8600 (tcp)
    2017/12/06 23:28:31 [INFO] agent: Started DNS server 127.0.0.1:8600 (udp)
    2017/12/06 23:28:31 [INFO] agent: Started HTTP server on 127.0.0.1:8500 (tcp)
    2017/12/06 23:28:31 [INFO] agent: started state syncer
    2017/12/06 23:28:38 [ERR] agent: failed to sync remote state: No cluster leader
    2017/12/06 23:28:39 [WARN] raft: no known peers, aborting election
    2017/12/06 23:28:57 [ERR] agent: Coordinate update error: No cluster leader
    2017/12/06 23:29:11 [ERR] agent: failed to sync remote state: No cluster leader
    2017/12/06 23:29:30 [ERR] agent: Coordinate update error: No cluster leader
    2017/12/06 23:29:38 [ERR] agent: failed to sync remote state: No cluster leader
    2017/12/06 23:29:57 [ERR] agent: Coordinate update error: No cluster leader

同样没有集群发现,此时n1和n2都启动起来,但是互相并不知道集群的存在!

5.将n1节点加入n2

   [silence@centos145 consul]$ ./consul join 192.168.231.146

此时n1和n2都打印发现了集群的日志信息

6.这个时候n1和n2两个节点已经是一个集群里面的Server模式的节点了

7.Client模式启动147

[root@centos147 consul]# ./consul agent -data-dir /tmp/consul -node=n3 -bind=192.168.231.147 -datacenter=dc1
==> Starting Consul agent...
==> Consul agent running!
           Version: 'v1.0.1'
           Node ID: 'be7132c3-643e-e5a2-9c34-cad99063a30e'
         Node name: 'n3'
        Datacenter: 'dc1' (Segment: '')
            Server: false (Bootstrap: false)
       Client Addr: [127.0.0.1] (HTTP: 8500, HTTPS: -1, DNS: 8600)
      Cluster Addr: 192.168.231.147 (LAN: 8301, WAN: 8302)
           Encrypt: Gossip: false, TLS-Outgoing: false, TLS-Incoming: false


==> Log data will now stream in as it occurs:


    2017/12/06 23:36:46 [INFO] serf: EventMemberJoin: n3 192.168.231.147
    2017/12/06 23:36:46 [INFO] agent: Started DNS server 127.0.0.1:8600 (udp)
    2017/12/06 23:36:46 [INFO] agent: Started DNS server 127.0.0.1:8600 (tcp)
    2017/12/06 23:36:46 [INFO] agent: Started HTTP server on 127.0.0.1:8500 (tcp)
    2017/12/06 23:36:46 [INFO] agent: started state syncer
    2017/12/06 23:36:46 [WARN] manager: No servers available
    2017/12/06 23:36:46 [ERR] agent: failed to sync remote state: No known Consul servers
    2017/12/06 23:37:08 [WARN] manager: No servers available
    2017/12/06 23:37:08 [ERR] agent: failed to sync remote state: No known Consul servers
    2017/12/06 23:37:36 [WARN] manager: No servers available
    2017/12/06 23:37:36 [ERR] agent: failed to sync remote state: No known Consul servers
    2017/12/06 23:38:02 [WARN] manager: No servers available
    2017/12/06 23:38:02 [ERR] agent: failed to sync remote state: No known Consul servers
    2017/12/06 23:38:22 [WARN] manager: No servers available
    2017/12/06 23:38:22 [ERR] agent: failed to sync remote state: No known Consul servers

8.在n3上面将节点n3加入集群

   [silence@centos147 consul]$ ./consul join 192.168.231.145

9.再次查看集群节点信息

10.此时三个节点的Consul集群搭建成功了!其实n1和n2是Server模式启动,n3是Client模式启动。

11.关于Consul的Server模式和Client模式主要的区别是这样的,一个Consul集群通过启动的参数-bootstrap-expect来控制这个集群的Server节点个数,Server模式的节点会维护集群的状态,并且如果某个Server节点退出了集群,则会触发Leader重新选举机制,在会剩余的Server模式节点中重新选举一个Leader;而Client模式的节点的加入和退出很自由。

12.在n2中启动web-ui

以上就是W3Cschool编程狮关于分布式服务注册发现与统一配置管理之 Consul的相关介绍了,希望对大家有所帮助。

JavaScript引擎V8 8.5 带来的三个实用新特性

thbcm阅读(263)

文章转载自公众号:code秘密花园

JavaScript 引擎 V8 发布了 8.5 版本,接下来带大家了解一下8.5版本的三个实用特性。

Promise.any

Promise 新增了一个 any 方法,它接收一个 Promise 数组,当数组中某一个 Promisefulfilled 后,它返回的 Promise 就会被返回。

const promises = [
  fetch('/endpoint-a').then(() => 'a'),
  fetch('/endpoint-b').then(() => 'b'),
  fetch('/endpoint-c').then(() => 'c'),
];
try {
  const first = await Promise.any(promises);
  // 任何一个 Promise 为 fulfilled 状态
  console.log(first);
  // →   'b'
} catch (error) {
  // 所有 Promise 都被 rejected 了
  console.assert(error instanceof AggregateError);
  // reject 结果数组
  console.log(error.errors);
}

如果所有输入的 Promise 都被拒绝,那么 Promise.any 将会返回一个 AggregateError 类型的异常,这个对象的 errors 属性包含所有 Promise被拒绝的属性。

注意不要和 Promise.race 方法弄混, race 方法是数组中有任何一个 Promise 被解决或拒绝就会返回,而 any 方法是必须有一个被解决,如果所有都被拒绝是会抛出异常的。

String.prototype.replaceAll

String.prototype.replaceAll 提供了一种简便的方式来替换子字符串的所有匹配,而不再需要创建全局 RegExp

看下面的例子,以前你要把 queryString 中所有的 + 替换掉,需要创建一个全局的正则:

const queryString = 'q=query+string+parameters';


queryString.replace(/\+/g, ' ');

现在你只需要使用 replaceAll 方法:

queryString.replaceAll('+', ' ');

逻辑赋值运算符

逻辑赋值运算符是一种新的复合赋值运算符,他可以把逻辑操作 &&,||或?? 与赋操作结合成一条命令。

x &&= y;
// 等同于 x && (x = y)
x ||= y;
// 等同于 x || (x = y)
x ??= y;
// 等同于 x ?? (x = y)

以上就是W3Cschool编程狮关于JavaScript引擎V8 8.5 带来的三个实用新特性的相关介绍了,希望对大家有所帮助。

联系我们