Kotlin跟Java比起来有什么优势?

thbcm阅读(367)

随着计算机语言的发展,从最初的CC++Java等初始语言,近些年来,又开始流行一些被称之为现代编程语言,比如:RustGoKotlinTypeScript等。现代语言流行的原因,小编总结为以下几点:

  1. 入门更容易
  2. 类型推断
  3. 空指针安全
  4. 内置的并发支持
  5. 减少模板代码(简洁)
  6. 操纵集合更容易
  7. 更智能的垃圾回收

以上不一定非常全,但是一定程度上概括了现代语言的特点,下面我们就基于KotlinJava的对比,来看下Kotlin的优势。

new个对象

new一个对象,是我们在编程中最常用的操作之一,让我们先看下如何在Javanew一个对象。

List<String> list =new ArrayList<String>();
list.add("hello world");

Java中,我们需要定义一个变量,然后通过new关键字声明一个ArrayList<String>的示例,这样我们就可以使用他了。

但是在Kotlinnew一个对象会更简洁。

var list:ArrayList<String> = ArrayList<String>()

直接省略了new关键字即可。

类型推断

对于以上的Kotlin代码,我们完全可以省略掉变量 : 后面的类型声明,因为kotlin可以自己推断出来。

val list = ArrayList<String>()

是不是觉得更简洁了?我们开发的效率也更高了。

空指针安全

Java中,变量,方法的参数等都是可以为null的,但是在Kotlin中默认是不允许的,通过这种强制的限制,更好的避免空指针异常。

var list = ArrayList<String>()
list = null

以上代码,在编译期你会得到一个错误提示:

Null can not be a value of a non-null type ArrayList<String>

如果我们的确需要null赋值怎么做呢?在Kotlin中需要开发者自己显示声明才可以。

var list:Array<String>? = null

如上所示,在类型后加 ? 即可。但是注意,我们不提倡这种做法,在实际的开发中,你会发现 ? 大部分都是为了兼容Java代码使用的。

属性

我们通常会把数据和对数据的处理封装到一个类中,如果类中有私有字段,我们还需要提供gettersetter方法提供访问和修改字段的方法。

//Person.java
public  class Person {
  private String name;


  public String getName() {
    return name;
  }


  public void setName(String name) {
    this.name = name;
  }
}
//Main.java
public static void main(String[] args) {
  Person p = new Person();
  p.setName("张三");
  System.out.println(p.getName());
}

以上是我们通过Java实现的一个Person类,并且定义了 name 私有字段,同时提供了gettersetter方法,这样我们才能够使用它。

通过以上代码,大家可以看到,我们为了实现一个 name 的存储,写了很多代码,如果一个类存在很多字段,我们会写更多的不必要的gettersetter方法。

现在我们看在Kotlin中如何实现上面的功能。

//Person.kt
class Person {
  var name:String = ""
}


//main.kt
fun main(){
  val p = Person()
  p.name = "张三"
  println(p.name)
}

是的,就是这么简单,只需要这么几行代码,就可以实现和Java一样的功能,因为Kotlin可以帮我们自动的生成gettersetter这些模板代码,就省了我们很多事情,大大的提高了我们的开发效率,并且整个代码也更简洁。

这里需要注意的是,如果字段是val声明的,那么只会生成getter方法,因为val是不可修改的,等价于Java中的final修饰符;如果字段是var的,可以同时生成gettersetter方法,这时候就可以对字段赋值了。

数据类

Kotlin的简洁不仅仅体现在gettersetter方法上,还有数据类。一个数据类是一个数据容器,它用来存放数据。

一个好的数据类的声明,不仅有私有的字段、gettersetter方法,还要有toStringequalshashCode方法的实现,以便对他们进行打印、比较以及更好的储存在map中。

还是以Person类为例,一个合格的数据类代码如下:

public static  class Person {
  private String name;


  public Person(String name) {
    this.name = name;
  }


  public String getName() {
    return name;
  }


  public void setName(String name) {
    this.name = name;
  }


  @Override
  public boolean equals(Object o) {
    if (this == o) return true;
    if (o == null || getClass() != o.getClass()) return false;


    Person person = (Person) o;


    return Objects.equals(name, person.name);
  }


  @Override
  public int hashCode() {
    return name != null ? name.hashCode() : 0;
  }


  @Override
  public String toString() {
    return "Person{" +
      "name='" + name + '\'' +
      '}';
  }
}

看下我们Java的实现,需要有这么30多行代码才能实现。如果我们使用Kotlin会是怎样的呢?

data class Person(val name: String) {}

只需要这么一行代码,以上的Java功能都会实现,这里的关键在于一个 data 修饰符,是不是很酸爽。

并发

Kotlin提供了协程来实现并发,相比JavaThreadExecutor等来说,它更轻便,简洁。我们对比下并发的基本实现。

public static void main(String[] args) throws InterruptedException {
  new MyThread().start();
  System.out.println(Thread.currentThread().getName()+":main");
  //保证JVM存活
  Thread.sleep(1000);
}


private static class MyThread extends Thread{
  @Override
  public void run() {
    try {
      Thread.sleep(500);
      System.out.println(Thread.currentThread().getName()+":Thread");
    } catch (InterruptedException e) {
      e.printStackTrace();
    }
  }
}

运行查看输出,我们发现MyThread并没有阻塞main的执行,也就是并发了。

main:main
Thread-0:Thread

但是要注意到,Java使用了两个线程,一个是main,一个是Thread-0。同样的功能,我们现在使用kotlin实现下:

fun main(){
  runBlocking {
    launch {
      delay(500)
      println("${Thread.currentThread().name}:Thread")
    }
    println("${Thread.currentThread().name}:main")
  }
}

相比Java来说更简洁,而且我们看下打印的输出:

main:main
main:Thread

竟然是在同一个线程上实现的并发,少了一个线程的申请开销,效率更高,这也是kotlin提出协程的概念。如果我们不想让它在main线程上执行,可以通过切换调度器来实现。

launch(Dispatchers.IO)

只需要把上面的代码的launch换成launch(Dispatchers.IO)即可,这样调度器就给我们分配了一个IO的线程池来执行我们的代码。如果我们使用Java来实现,要自己定义线程池,还要提交Runnable,整个代码是非常多的。

main:main
DefaultDispatcher-worker-1:Thread

kotlin的协程非常强大和简洁,通过以上的例子,不能完全展示它的特性,剩下的如协程上下文、调度器、Flow、通道等能力大家可以自己摸索。

小结

通过以上对比,我们应该可以看到作为一门现代编程语言的特点和具备的优势,而且关于Kotlin好用的特性我们还没有完全列举完,比如便捷的集合操作、属性委托、扩展函数等等。

文章来源:www.toutiao.com/a6862537179189477901/

以上就是W3Cschool编程狮关于Kotlin跟Java比起来有什么优势的相关介绍了,希望对大家有所帮助。
总结Python程序员常见的一些问题

thbcm阅读(356)

语用错误

让我们从基础开始,从那些刚学习编程的人钻研语法之前碰到的事情。开始如果你已经编过一些程了,那么以下这些可能看起来十分的简单。如果你曾经尝试过教新手们怎么编程,它们可能就不这么简单了。

在交互提示符中输入的Python代码

在>>>交互提示符中你只能输入的Python代码,而不是系统命令。时常有人在这个提示符下输入的emacsLS,或者编辑之类的命令,这些可不是Python的代码。在Python的代码中确实有办法来调用系统命令(例如os.system和os.popen),但可不是像直接输入命令这么直接。如果你想要在交互提示符中启动一个Python文件,请用导入文件,而不是系统命令python file.py.

打印语句(仅仅)是在文件中需要

因为交互解释器会自动的将表达式的结果输出,所以你不需要交互的键入完整的打印语句。这是个很棒的功能,但是记住在代码文件里,通常你只有用打印语句才能看得到输出。

小心的Windows里的自动扩展名

如果你在Windows里使用记事本来编辑代码文件的话,当你保持的时候小心选择“所有文件”(所有文件)这个类型,并且明确的给你的文件加一个.py的后缀。不然的话记事本会给你的文件加一个.TXT的扩展名,使得在某些启动方法中没法跑这个程序。更糟糕的是,像字或者是写字板一类的文字处理软件还会默认的加上一些格式字符,而这些字符Python语法是不认的。所以记得,在Windows下总是选“所有文件”(所有文件),并保存为纯文本,或者使用更加“编程友好”的文本编辑工具,比如IDLE 。在IDLE中,记得在保存时手动加上的.py的扩展名。

在视窗下点击图标的问题

在视窗下,你能靠点击Python的文件来启动一个Python的程序,但这有时会有问题。首先,程序的输出窗口在程序结束的瞬间也就消失了,要让它不消失,你可以在文件最后加一条的raw_input()的调用另外,记住如果有错的话,输出窗口也就立即消失了要看到你的错误信息的话,用别的方法来调用你的程序:。比如从系统命令行启动,通过提示符下用进口语句,或者IDLE菜单里的选项,等等。

导入只在第一次有效

你可以在交互提示符中通过输入一个文件来运行它,但是这只会在一个会话中起一次作用。接下来的进口仅仅是返回这个已经加载的模块要想强制Python的重新加载一个文件的代码,请调用函数重载(模块)来达到这个目的。注意对重新加载请使用括号,而进口不要使用括号。

空白行(仅仅)在交互提示符中有作用

在模块文件中空白行和注释统统会被忽略掉,但是在交互提示符中键入代码时,空白行表示一个复合语句的结束换句话说,空白行告诉交互提示符你完成了一个复合语句。在你真正完成之前不要键入回车事实上当你要开始一个新的语句时,你需要键入一个空行来结束当前的语句 – 交互提示符一次只运行一条语句。

代码错误

一旦你开始认真写的Python代码了,接下来一堆陷阱就更加危险了 , 这些都是一些跨语言特性的基本代码错误,并常常困扰不细心的程序员。

别忘了冒号

这是新手程序员最容易犯的一个错误:别忘了在复合语句的起始语句(if,while,for wait语句的第一行)结束的地方加上一个冒号“”。也许你刚开始会忘掉这个,但是到了很快这就会成为一个下意识的习惯。课堂里 75% 的学生当天就可以记住这个。

初始化变量

在的Python里,一个表达式中的名字在它被赋值之前是没法使用的这是有意而为的:这样能避免一些输入失误,同时也能避免默认究竟应该是什么类型的问题(0,无“,”,[] ,?)。记住把计数器初始化为 0 ,列表初始化为[],以此类推。

从第一列开始

确保把顶层的,未嵌套的代码放在最左边第一列开始。这包括在模块文件中未嵌套的代码,以及在交互提示符中未嵌套的代码.Python使用缩进的办法来区分嵌套的代码段,因此在你代码左边的空格意味着嵌套的代码块。除了缩进以外,空格通常是被忽略掉的。

缩进一致

在同一个代码块中避免讲选项卡和空格混用来缩进,除非你知道运行你的代码的系统是怎么处理标签的。否则的话,在你的编辑器里看起来是标签的缩进也许Python的看起来就会被视作是一些空格保险起见,在每个代码块中全都是用标签或者全都是用空格来缩进;用多少由你决定。

在函数调用时使用括号

无论一个函数是否需要参数,你必须要加一对括号来调用它。即,使用函数(),而不是function.Python的函数简单来说是具有特殊功能(调用)的对象,而调用是用括号来触发的。像所有的对象一样,他们也可以被赋值给变量,并且间接的使用他们:x = function:x()。在Python的培训中,这样的错误常常在文件的操作中出现。会看到新手用file.close来关闭一个问题,而不是用file.close()。因为在Python的中引用一个函数而不调用它是合法的,因此不使用括号的操作(file.close)无声的成功了,但是并没有关闭这个文件!

在导入时不要使用表达式或者路径

在系统的命令行里使用文件夹路径或者文件的扩展名,但不要在import语句中使用。即,使用import mod,而不是import mod.py,或者import dir / mod.py。在实际情况中,这大概是初学者常犯的第二大错误了。因为模块会有除了的.py以外的其他的后缀(例如,pyc文件),强制写上某个后缀不仅是不合语法的,也没有什么意义。和系统有关的目录路径的格式是从你的模块搜索路径的设置里来的,而不是import语句。你可以在文件名里使用点来指向包的子目录(例如,import dir1.dir2.mod) ,但是最左边的目录必须得通过模块搜索路径能够找到,并且没有在导入中没有其他路径格式。不正确的语句import mod.pyPython认为是要记载一个包,它先加载一个模块mod,然后试图通过在一个叫做MOD的目录里去找到叫做吡啶的模块,最后可能什么也找不到而报出一系列费解的错误信息。

不要在Python的中写Ç代码

以下是给不熟悉的Pythonç程序员的一些备忘贴士:

在和条件测试时,不用输入括号(例如,如果(X == 1):)。如果你喜欢的话,加上括号也无妨,只是在这里是完全多余的。

不要用分号来结束你的语句从技术上讲这在Python中里是合法的,但是这毫无用处,除非你要把很多语句放在同一行里(例如,X = 1。Y = 2; Z = 3)。

不要在while循环的条件测试中嵌入赋值语句(例如,while((x = next()!= NULL))。在Python中,需要表达式的地方不能出现语句,并且赋值语句不是一个表达式。

编程错误

下面终于要讲到当你用到更多的Python中的功能(数据类型,函数,模块,类等等)时可能碰到的问题了。由于篇幅有限,这里尽量精简,尤其是对一些高级的概念。要想了解更多的细节,敬请阅读学习Python,第2版的“小贴士”以及“Gotchas”章节。

打开文件的调用不使用模块搜索路径

当你在Python的中调用的open()来访问一个外部的文件时,Python中不会使用模块搜索路径来定位这个目标文件。它会使用你提供的绝对路径,或者假定这个文件是在当前工作目录中。模块搜索路径仅仅为模块加载服务的。

不同的类型对应的方法也不同

列表的方法是不能用在字符串上的,反之亦然。通常情况下,方法的调用是和数据类型有关的,但是内部函数通常在很多类型上都可以使用。举个例子来说,列表的反转方法仅仅对列表有用,但是LEN函数对任何具有长度的对象都适用

不能直接改变不可变数据类型

记住你没法直接的改变一个不可变的对象(例如,元组,字符串):

T = (1,  2,  3)
T[2]  =  4          # 错误

用切片,联接等构建一个新的对象,并根据需求将原来变量的值赋给它因为Python中会自动回收没有用的内存,因此这没有看起来那么浪费:

T = T[:2] + (4,)  # 没问题了: T 变成了 (1, 2, 4)

使用简单的用于循环而不是同时或者范围

当你要从左到右遍历一个有序的对象的所有元素时,用简单的for循环(例如,for x in seq :)相比于基于while-或者range-的计数循环而言会更容易写,通常运行起来也更快除非你一定需要,尽量避免在一个用于循环里使用范围:。让的Python来替你解决标号的问题在下面的例子中三个循环结构都没有问题,但是第一个通常来说更好;在Python的里,简单至上。

S = "lumberjack"for c in S: print c                   # 最简单for i in range(len(S)): print S[i]    # 太多了i = 0                                 # 太多了while i < len(S): print S[i]; i += 1

不要试图从那些会改变对象的函数得到结果

诸如像方法list.append()list.sort()一类的直接改变操作会改变一个对象,但不会将它们改变的对象返回出来(它们会返回无);正确的做法是直接调用它们而不要将结果赋值经常会看见初学者会写诸如此类的代码:

mylist = mylist.append(X)

目的是要得到附加的结果,但是事实上这样做会将无赋值给MYLIST,而不是改变后的列表。更加特别的一个例子是想通过用排序后的键值来遍历一个字典里的各个元素,请看下面的例子:

D = {...}
for k in D.keys().sort(): print D[k]

差一点儿就成功了--keys方法会创建一个键的列表,然后用某种方法来将这个列表排序 – 但是因为某种方法会返回无,这个循环会失败,因为它实际上是要遍历无(这可不是一个序列)要改正这段代码,将方法的调用分离出来,放在不同的语句中,如下:

Ks = D.keys()
Ks.sort()
for k in Ks: print D[k]

只有在数字类型中才存在类型转换

在的Python中,一个诸如123 + 3.145的表达式是可以工作的 – 它会自动将整数型转换为浮点型,然后用浮点运算但是下面的代码就会出错了。:

S = "42"
I = 1
X = S + I        # 类型错误

这同样也是有意而为的,因为这是不明确的:究竟是将字符串转换为数字(进行相加)呢,还是将数字转换为字符串(进行连接)呢在Python的中,我们认为“明确比含糊好“(即,EIBTI(明确比隐含更好)),因此你得手动转换类型:

X = int(S) + I   # 做加法: 43
X = S + str(I)   # 字符串联接: "421"

循环的数据结构会导致循环

尽管这在实际情况中很少见,但是如果一个对象的集合包含了到它自己的引用,这被称为循环对象(cyclic object)。如果在一个对象中发现一个循环,Python会输出一个[... ],以避免在无限循环中卡住:

>>> L = ['grail']  # 在 L中又引用L自身会
>>> L.append(L)    # 在对象中创造一个循环
>>> L['grail', [...]]

除了知道这三个点在对象中表示循环以外,这个例子也是很值得借鉴的。因为你可能无意间在你的代码中出现这样的循环的结构而导致你的代码出错。如果有必要的话,维护一个列表或者字典来表示已经访问过的对象,然后通过检查它来确认你是否碰到了循环。

赋值语句不会创建对象的副本,仅仅创建引用

这是的Python的一个核心理念,有时候当行为不对时会带来错误。在下面的例子中,一个列表对象被赋给了名为大号的变量,然后大号又在列表中号中被引用。内部改变大号的话,同时也会改变中号所引用的对象,因为它们俩都指向同一个对象。

>>> L = [1, 2, 3]        # 共用的列表对象
>>> M = ['X', L, 'Y']    # 嵌入一个到L的引用
>>> M
['X', [1, 2, 3], 'Y']
>>> L[1] = 0             # 也改变了M
>>> M
['X', [1, 0, 3], 'Y']

通常情况下只有在稍大一点的程序里这就显得很重要了,而且这些共用的引用通常确实是你需要的如果不是的话,你可以明确的给他们创建一个副本来避免共用的引用;对于列表来说,你可以通过使用一个空列表的切片来创建一个顶层的副本:

>>> L = [1, 2, 3]
>>> M = ['X', L[:], 'Y']   # 嵌入一个L的副本
>>> L[1] = 0               # 仅仅改变了L,但是不影响M
>>> L
[1, 0, 3]
>>> M
['X', [1, 2, 3], 'Y']

切片的范围起始从默认的 0 到被切片的序列的最大长度。如果两者都省略掉了,那么切片会抽取该序列中的所有元素,并创造一个顶层的副本(一个新的,不被公用的对象)。对于字典来说,使用字典的dict.copy()方法。

静态识别本地域的变量名

Python的默认将一个函数中赋值的变量名视作是本地域的,它们存在于该函数的作用域中并且仅仅在函数运行的时候才存在。从技术上讲,巨蟒是在编译DEF代码时,去静态的识别本地变量,而不是在运行时碰到赋值的时候才识别到的。如果不理解这点的话,会引起人们的误解。比如,看看下面的例子,当你在一个引用之后给一个变量赋值会怎么样:

>>> X = 99
>>> def func():
...     print X      # 这个时候还不存在
          ... 
        >>> func( )          # 出错了!

你会得到一个“未定义变量名”的错误,但是其原因是很微妙的。当编译这则代码时,Python中碰到给 X 赋值的语句时认为在这个函数中的任何地方X会被视作。一个本地变量名但是之后当真正运行这个函数时,执行打印语句的时候,赋值语句还没有发生,这样的Python便会报告一个“未定义变量名”的错误。

事实上,之前的这个例子想要做的事情是很模糊的:你是想要先输出那个全局的 X ,然后创建一个本地的 X 呢,还是说这是个程序的错误如果你真的是想要输出这个全局的 X ,你需要将它在一个全局语句中声明它,或者通过包络模块的名字来引用它。

默认参数和可变对象

在执行DEF语句时,默认参数的值只被解析并保存一次,而不是每次在调用函数的时候。这通常是你想要的那样,但是因为默认值需要在每次调用时都保持同样对象,你在试图改变可变的默认值(mutable defaults)的时候可要小心了。例如,下面的函数中使用一个空的列表作为默认值,然后在之后每一次函数调用的时候改变它的值:

>>> def saver(x=[]):   # 保存一个列表对象
...     x.append(1)    # 并每次调用的时候
...     print x        # 改变它的值
...
>>> saver([2])         # 未使用默认值
[2, 1]
>>> saver()            # 使用默认值
[1]
>>> saver()            # 每次调用都会增加!
[1, 1]
>>> saver()
[1, 1, 1]

有的人将这个视作Python中的一个特点 – 因为可变的默认参数在每次函数调用时保持了它们的状态,它们能提供像 ç 语言中静态本地函数变量的类似的一些功能但是,当你第一次碰到它时会觉得这很奇怪,并且在的Python中有更加简单的办法来在不同的调用之间保存状态(比如说类)。

要摆脱这样的行为,在函数开始的地方用切片或者方法来创建默认参数的副本,或者将默认值的表达式移到函数里面;只要每次函数调用时这些值在函数里,就会每次都得到一个新的对象:

>>> def saver(x=None):
  ...     if x is None: x = []   # 没有传入参数?
    ...     x.append(1)            # 改变新的列表
      ...     print x
        ...
          >>> saver([2])                 # 没有使用默认值
        [2, 1]
>>> saver()                    # 这次不会变了
        [1
        ]>>> saver()[1]

其他常见的编程陷阱

下面列举了其他的一些在这里没法详述的陷阱:

在顶层文件中语句的顺序是有讲究的:因为运行或者加载一个文件会从上到下运行它的语句,所以请确保将你未嵌套的函数调用或者类的调用放在函数或者类的定义之后。

重装不影响用从加载的名字:重装最好和导入语句一起使用如果你使用的语句,记得在重装之后重新运行一遍从,否则你仍然使用之前老的名字。

在多重继承中混合的顺序是有讲究的:这是因为对超类的搜索是从左到右的,在类定义的头部,在多重超类中如果出现重复的名字,则以最左边的类名为准。

在尝试语句中空的,除了子句可能会比你预想的捕捉到更多的错误。在尝试语句中空的,除了子句表示捕捉所有的错误,即便是真正的程序错误,和sys.exit()调用,也会被捕捉到。

以上就是W3Cschool编程狮关于总结Python程序员常见的一些问题的相关介绍了,希望对大家有所帮助。
如何对Linux上的文件进行合并和排序

thbcm阅读(359)

Linux上对文件进行合并和排序的方法有很多,但使用哪种就取决于你想怎么做,比如:你是只想将多个文件的内容放入一个文件中,还是以某种方式组织它,让它更易于使用。接下来,小编将带你看看一些用于排序和合并文件内容的命令,让你了解它们的特点。

使用 cat

如果你只想将一组文件放到单个文件中,那么 cat 命令是一个容易的选择。你所要做的就是输入 cat,然后按你希望它们在合并文件中的顺序在命令行中列出这些文件。将命令的输出重定向到要创建的文件。如果指定名称的文件已经存在,那么文件将被覆盖。例如:

$ cat firstfile secondfile thirdfile > newfile

如果要将一系列文件的内容添加到现有文件中,而不是覆盖它,只需将 > 变成 >>

$ cat firstfile secondfile thirdfile >> updated_file

如果你要合并的文件遵循一些方便的命名约定,那么任务可能更简单。如果可以使用正则表达式指定所有文件名,那就不必列出所有文件。例如,如果文件全部以 file 结束,如上所示,你可以进行如下操作:

$ cat *file > allfiles

请注意,上面的命令将按字母数字顺序添加文件内容。在 Linux 上,一个名为 filea 的文件将排在名为 fileA 的文件的前面,但会在 file7 的后面。毕竟,当我们处理字母数字序列时,我们不仅需要考虑 ABCDE,还需要考虑 0123456789aAbBcCdDeE。你可以使用 ls *file 这样的命令来查看合并文件之前文件的顺序。

注意:首先确保你的命令包含合并文件中所需的所有文件,而不是其他文件,尤其是你使用 * 等通配符时。不要忘记,用于合并的文件仍将单独存在,在确认合并后,你可能想要删除这些文件。

(推荐教程:Linux教程

按时间期限合并文件

如果要基于每个文件的时间期限而不是文件名来合并文件,请使用以下命令:

$ for file in `ls -tr myfile.*`; do  cat $file >> BigFile.$$; done

使用 -tr 选项(t = 时间,r = 反向)将产生按照最早的在最前排列的文件列表。例如,如果你要保留某些活动的日志,并且希望按活动执行的顺序添加内容,则这非常有用。

上面命令中的 $ $ 表示运行命令时的进程 ID。不是很必要使用此功能,但它几乎不可能会无意添加到现有的文件,而不是创建新文件。如果使用 $$,那么生成的文件可能如下所示:

$ ls -l BigFile.*
-rw-rw-r-- 1 justme justme   931725 Aug  6 12:36 BigFile.582914

合并和排序文件

Linux 提供了一些有趣的方式来对合并之前或之后的文件内容进行排序。

按字母对内容进行排序

如果要对合并的文件内容进行排序,那么可以使用以下命令对整体内容进行排序:

$ cat myfile.1 myfile.2 myfile.3 | sort > newfile

如果要按文件对内容进行分组,请使用以下命令对每个文件进行排序,然后再将它添加到新文件中:

$ for file in `ls myfile.?`; do sort $file >> newfile; done

对文件进行数字排序

要对文件内容进行数字排序,请在 sort 中使用 -n 选项。仅当文件中的行以数字开头时,此选项才有用。请记住,按照默认顺序,02 将小于 1。当你要确保行以数字排序时,请使用 -n 选项。

$ cat myfile.1 myfile.2 myfile.3 | sort -n > xyz

如果文件中的行以 2020-11-03 或 2020/11/03(年月日格式)这样的日期格式开头,-n 选项还能让你按日期对内容进行排序。其他格式的日期排序将非常棘手,并且将需要更复杂的命令。

使用 paste

paste 命令允许你逐行连接文件内容。使用此命令时,合并文件的第一行将包含要合并的每个文件的第一行。以下是示例,其中我使用了大写字母以便于查看行的来源:

$ cat file.a
A one
A two
A three


$ paste file.a file.b file.c
A one   B one   C one
A two   B two   C two
A three B three C thee
        B four  C four
                C five

将输出重定向到另一个文件来保存它:

$ paste file.a file.b file.c > merged_content

或者,你可以将每个文件的内容在同一行中合并,然后将文件粘贴在一起。这需要使用 -s(序列)选项。注意这次的输出如何显示每个文件的内容:

$ paste -s file.a file.b file.c
A one   A two   A three
B one   B two   B three B four
C one   C two   C thee  C four  C five

使用 join

合并文件的另一个命令是 joinjoin 命令让你能基于一个共同字段合并多个文件的内容。例如,你可能有一个包含一组同事的电话的文件,其中,而另一个包含了同事的电子邮件地址,并且两者均按个人姓名列出。你可以使用 join 创建一个包含电话和电子邮件地址的文件。

一个重要的限制是文件的行必须是相同的顺序,并在每个文件中包括用于连接的字段。

这是一个示例命令:

$ join phone_numbers email_addresses
Sandra 555-456-1234 bugfarm@gmail.com
Pedro 555-540-5405
John 555-333-1234 john_doe@gmail.com
Nemo 555-123-4567 cutie@fish.com

在本例中,即使缺少附加信息,第一个字段(名字)也必须存在于每个文件中,否则命令会因错误而失败。对内容进行排序有帮助,而且可能更容易管理,但只要顺序一致,就不需要这么做。

(推荐微课:Linux微课

总结

Linux 上,你有很多可以合并和排序存储在单独文件中的数据的方式。这些方法可以使原本繁琐的任务变得异常简单。

文章来源:www.toutiao.com/a6863629427096420875/

以上就是W3Cschool编程狮关于 如何对Linux上的文件进行合并和排序 的相关介绍了,希望对大家有所帮助。
mysql 主从复制配置说明

thbcm阅读(364)

MySQL数据库支持单向、双向、链式级联、环状等不同业务场景的复制。在复制过程中,一台服务器充当主服务器(Master),接收来自用户的内容更新,而一个或多个其他的服务器充当从服务器(Slave),接收来自主服务器binlog文件的日志内容,解析出SQL,重新更新到从数据库,使得主从服务器的数据达到一致。

mysql 主从复制 配置

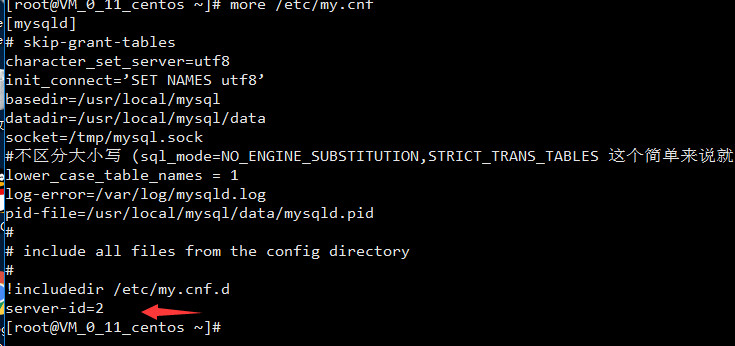
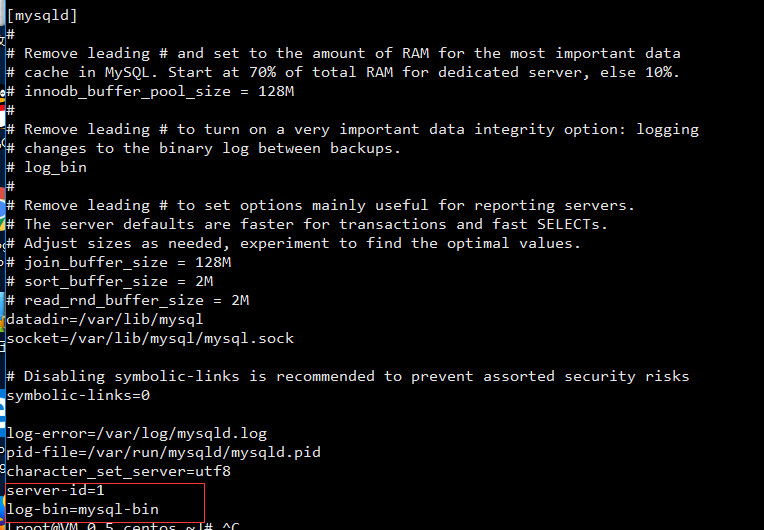
mysql 的 默认配置文件在 /etc/my.cnf

1 修改主库 配置文件:

设置 服务id,并且开启二进制日志文件。

server-id=1 log-bin=mysql-bin

2重启服务:service mysqld restart;

3 连接mysql创建用户,和授权:

 CREATE USER ‘zyk’@’132.232.37.228’ IDENTIFIED BY ‘zyk123’


  GRANT REPLICATION SLAVE ON *.* TO 'zyk'@'132.232.37.228';


  flush privileges;

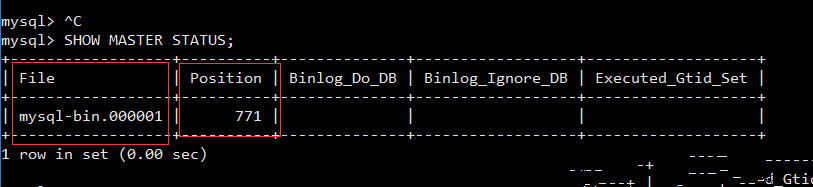
4 查看主机 master状态;

SHOW MASTER STATUS;

5 修改从库配置: 修改 服务Id ,保持唯一

6 在 mysql命令行执行 下面连接master 语句。 注意参数来源于上面的 过程。

CHANGE MASTER TO MASTER_HOST=’cxygg.top’, MASTER_USER=’zyk’, MASTER_PASSWORD=’zyk123′, MASTER_LOG_FILE=’mysql-bin.000001′, MASTER_LOG_POS=771;

7 启动从机模式

start slave;

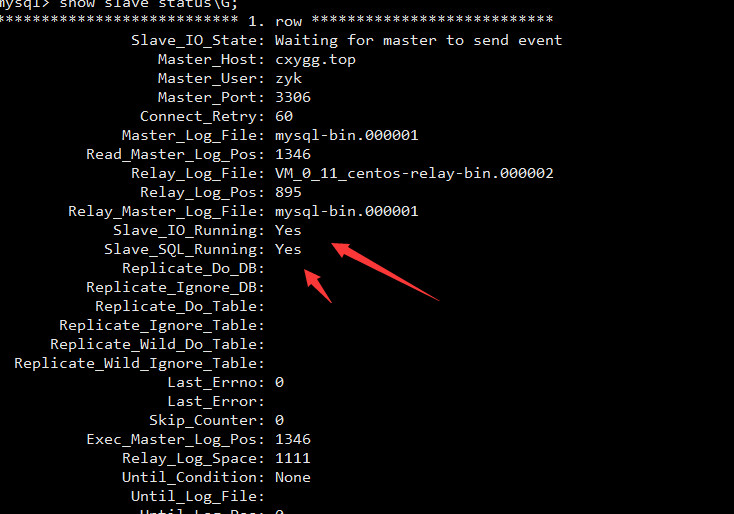
8 看看从库状态。 箭头 部分 Ok ,一般就没问题。

show slave status;  

以上就是W3Cschool编程狮关于 mysql 主从复制配置 的相关介绍了,希望对大家有所帮助。
MATLAB基于14种聚类方法的分析

thbcm阅读(314)

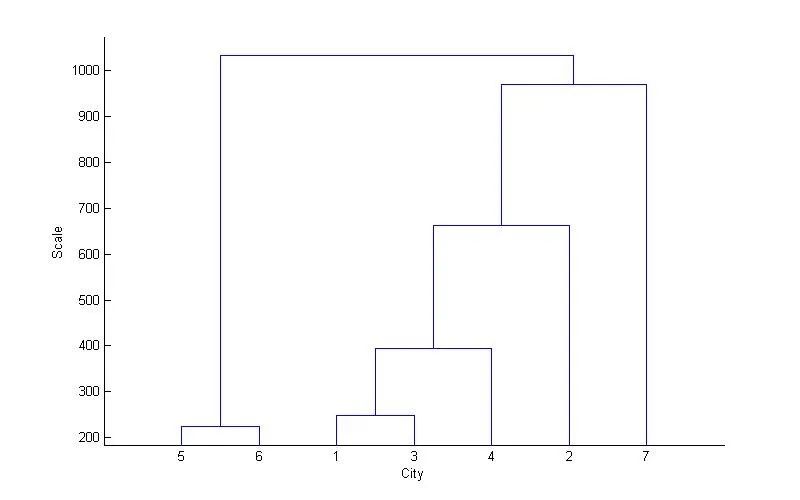
聚类分析又称群分析,它是用来研究样品分类问题的统计分析方法,同时也是一种重要的数据挖掘算法。聚类分析是由若干模式组成的,通常,模式是一个度量的向量,聚类分析以相似性为基础,在一个聚类中的模式之间比不在同一聚类中的模式之间具有更多的相似性。

对于聚类算法,大多数用SPSS软件实现,通常导入数据,并且选择聚类方法即可实现,本文借用MATLAB软件,基于14种不同的聚类分析方法,实现样品聚类。

14种聚类方法

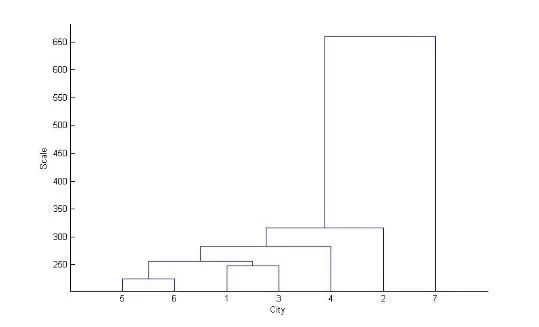
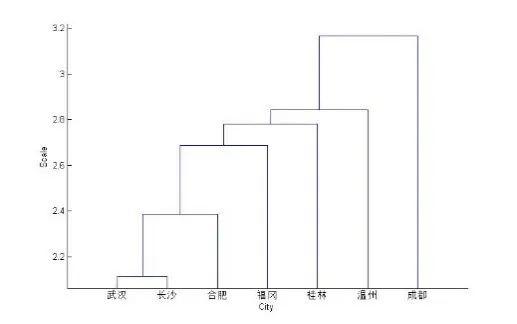
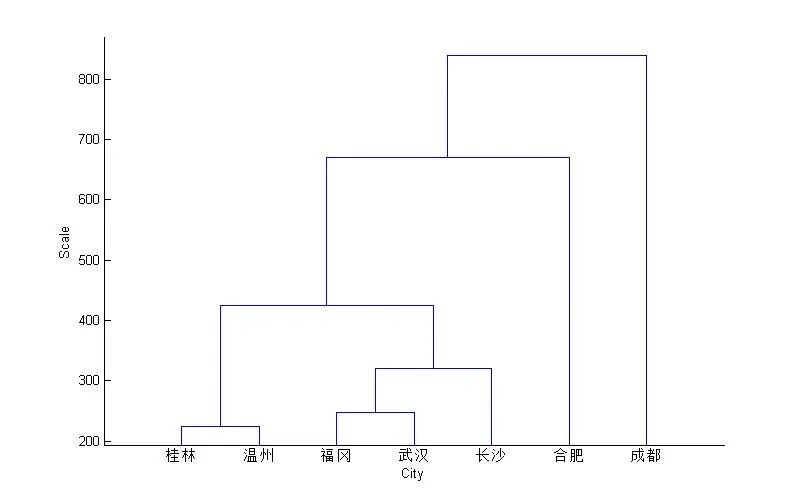
(1)最长距离法

X=[16.21492 2000 -8.2 6.2;
   15.7 970 2209 -20.6 1.9;
   16.3 1260 2085 -17.3 2.8;
   17.2 14221726 -9.5 4.6;
   18.8 1874 1709 -4.9 8.0;
   17.9 1698 1848 -4.5 7.5;
   16.3 976 1239-4.6 5.6];
D=pdist(X,'euclid');
M=squareform(D);
Z=linkage(D,'complete');
H=dendrogram(Z);
xlabel('City');
ylabel('Scale');
C=cophenet(Z,D);
T=cluster(Z,3);

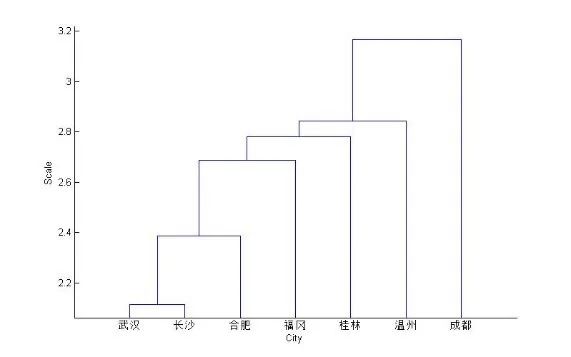
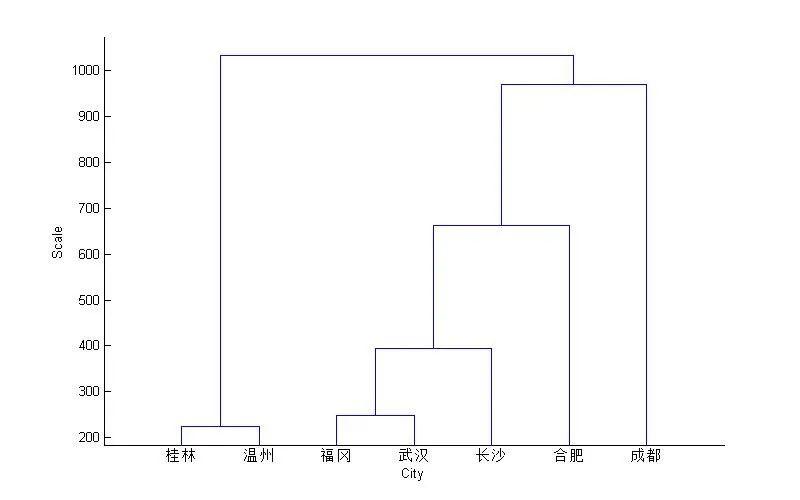
(2) 最短距离法

X=[16.21492 2000 -8.2 6.2;
   15.7 970 2209 -20.6 1.9;
   16.3 1260 2085 -17.3 2.8;
   17.2 14221726 -9.5 4.6;
   18.8 1874 1709 -4.9 8.0;
   17.9 1698 1848 -4.5 7.5;
   16.3 976 1239-4.6 5.6];
D=pdist(X,'euclid');
M=squareform(D);
Z=linkage(D,'single')
;H=dendrogram(Z);
xlabel('City');
ylabel('Scale');
C=cophenet(Z,D);
T=cluster(Z,'cutoff',0.8);

(3)综合聚类子程序

X=[16.21492 2000 -8.2 6.2;
   15.7 970 2209 -20.6 1.9;
   16.3 1260 2085 -17.3 2.8;
   17.2 14221726 -9.5 4.6;
   18.8 1874 1709 -4.9 8.0;
   17.9 1698 1848 -4.5 7.5;
   16.3 976 1239-4.6 5.6];
T=clusterdata(X,0.8);
Re=find(T=5)

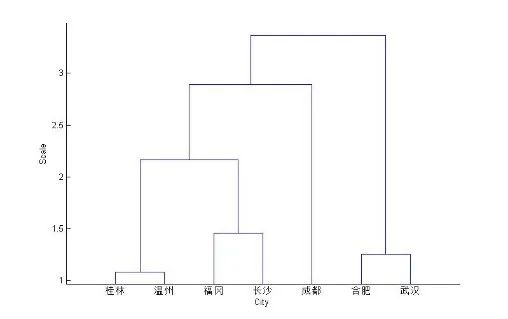
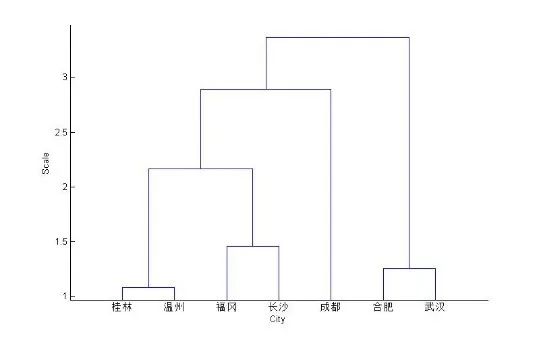
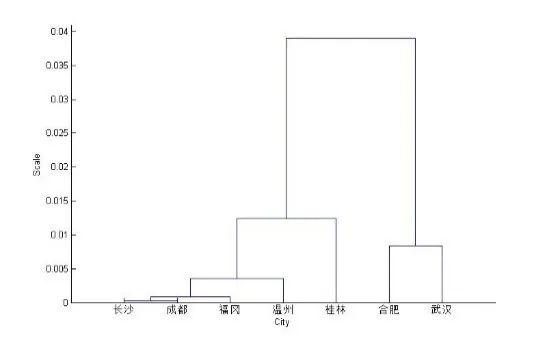
(4)重心法&标准欧氏距离

S=['福冈';'合肥';'武汉';'长沙';'桂林';'温州';'成都'];
X=[16.21492 2000 -8.2 6.2;
   15.7 970 2209 -20.6 1.9;
   16.3 1260 2085 -17.3 2.8;
   17.2 14221726 -9.5 4.6;
   18.8 1874 1709 -4.9 8.0;
   17.9 1698 1848 -4.5 7.5;
   16.3 976 1239-4.6 5.6];
D=pdist(X,'seuclid');
M=squareform(D);
Z=linkage(D,'centroid');
H=dendrogram(Z,'labels',S);
xlabel('City');
ylabel('Scale');
C=cophenet(Z,D);
T=cluster(Z,3);

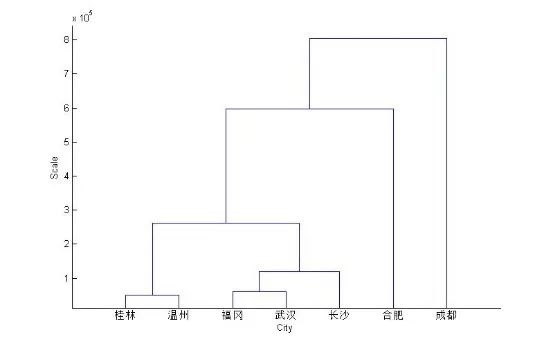
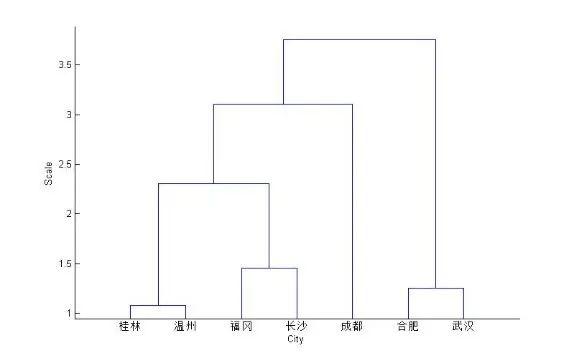
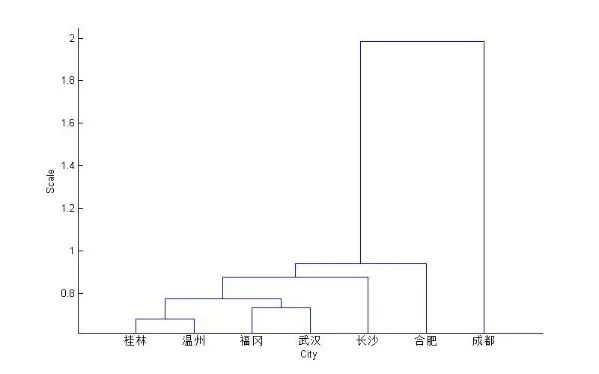
(5)重心法&欧氏距离平方

S=['福冈';'合肥';'武汉';'长沙';'桂林';'温州';'成都'];
X=[16.21492 2000 -8.2 6.2;
   15.7 970 2209 -20.6 1.9;
   16.3 1260 2085 -17.3 2.8;
   17.2 14221726 -9.5 4.6;
   18.8 1874 1709 -4.9 8.0;
   17.9 1698 1848 -4.5 7.5;
   16.3 976 1239-4.6 5.6];
D=pdist(X,'euclid');
D2=D.^2;
M=squareform(D2);
Z=linkage(D2,'centroid');
H=dendrogram(Z,'labels',S);
xlabel('City');
ylabel('Scale');
C=cophenet(Z,D2);
T=cluster(Z,3);

(6)重心法&精度加权距离

S=['福冈';'合肥';'武汉';'长沙';'桂林';'温州';'成都'];
X=[16.21492 2000 -8.2 6.2;
   15.7 970 2209 -20.6 1.9;
   16.3 1260 2085 -17.3 2.8;
   17.2 14221726 -9.5 4.6;
   18.8 1874 1709 -4.9 8.0;
   17.9 1698 1848 -4.5 7.5;
   16.3 976 1239-4.6 5.6];
[n,m]=size(X);
stdx=std(X);
X2=X./stdx(ones(n,1),:);
D=pdist(X2,'euclid');
M=squareform(D);
Z=linkage(D,'centroid');
H=dendrogram(Z,'labels',S);
xlabel('City');
ylabel('Scale');
C=cophenet(Z,D);
T=cluster(Z,3);

(7)最短距离法&基于主成分的标准欧式距离

S=['福冈';'合肥';'武汉';'长沙';'桂林';'温州';'成都'];
X=[16.21492 2000 -8.2 6.2;
   15.7 970 2209 -20.6 1.9;
   16.3 1260 2085 -17.3 2.8;
   17.2 14221726 -9.5 4.6;
   18.8 1874 1709 -4.9 8.0;
   17.9 1698 1848 -4.5 7.5;
   16.3 976 1239-4.6 5.6];
[E,score,eigen,T]=princomp(X);
D=pdist(score,'seuclid');
M=squareform(D);
Z=linkage(D,'single');
H=dendrogram(Z,'labels',S);
xlabel('City');
ylabel('Scale');
C=cophenet(Z,D);
T=cluster(Z,3);

(8)平均法&标准欧式距离

S=['福冈';'合肥';'武汉';'长沙';'桂林';'温州';'成都'];
X=[16.21492 2000 -8.2 6.2;
   15.7 970 2209 -20.6 1.9;
   16.3 1260 2085 -17.3 2.8;
   17.2 14221726 -9.5 4.6;
   18.8 1874 1709 -4.9 8.0;
   17.9 1698 1848 -4.5 7.5;
   16.3 976 1239-4.6 5.6];
D=pdist(X,'seuclid');
M=squareform(D);
Z=linkage(D,'average');
H=dendrogram(Z,'labels',S);
xlabel('City');
ylabel('Scale');
C=cophenet(Z,D);
T=cluster(Z,3);

(9)权重法&标准欧式距离

S=['福冈';'合肥';'武汉';'长沙';'桂林';'温州';'成都'];
X=[16.21492 2000 -8.2 6.2;
   15.7 970 2209 -20.6 1.9;
   16.3 1260 2085 -17.3 2.8;
   17.2 14221726 -9.5 4.6;
   18.8 1874 1709 -4.9 8.0;
   17.9 1698 1848 -4.5 7.5;
   16.3 976 1239-4.6 5.6];
D=pdist(X,'seuclid');
M=squareform(D);
Z=linkage(D,'weighted');
H=dendrogram(Z,'labels',S);
xlabel('City');
ylabel('Scale');
C=cophenet(Z,D);
T=cluster(Z,3);

(10)最短距离法&马氏距离

S=['福冈';'合肥';'武汉';'长沙';'桂林';'温州';'成都'];
X=[16.21492 2000 -8.2 6.2;
   15.7 970 2209 -20.6 1.9;
   16.3 1260 2085 -17.3 2.8;
   17.2 14221726 -9.5 4.6;
   18.8 1874 1709 -4.9 8.0;
   17.9 1698 1848 -4.5 7.5;
   16.3 976 1239-4.6 5.6];
D=pdist(X,'mahal');M=squareform(D);Z=linkage(D,'single');H=dendrogram(Z,'labels',S);xlabel('City');ylabel('Scale');C=cophenet(Z,D);T=cluster(Z,3);

(11)重心法&标准化数据的的欧式距离

S=['福冈';'合肥';'武汉';'长沙';'桂林';'温州';'成都'];
X=[16.21492 2000 -8.2 6.2;
   15.7 970 2209 -20.6 1.9;
   16.3 1260 2085 -17.3 2.8;
   17.2 14221726 -9.5 4.6;
   18.8 1874 1709 -4.9 8.0;
   17.9 1698 1848 -4.5 7.5;
   16.3 976 1239-4.6 5.6];
[n,m]=size(X);
mv=mean(X);
st=std(X);
x=(X-mv(ones(n,1),:))./st(ones(n,1),:);
D=pdist(X,'euclid');
M=squareform(D);
Z=linkage(D,'centroid');
H=dendrogram(Z,'labels',S);
xlabel('City');
ylabel('Scale');
C=cophenet(Z,D);
T=cluster(Z,3);

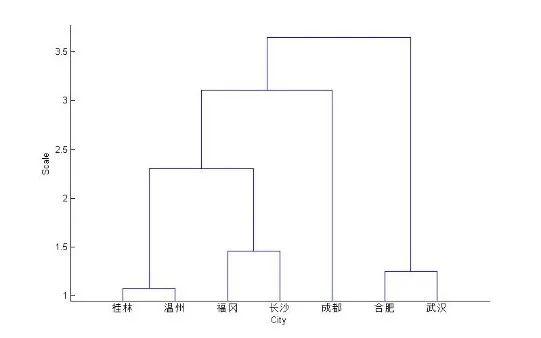
(12)最长距离法&欧式距离

S=['福冈';'合肥';'武汉';'长沙';'桂林';'温州';'成都'];
X=[16.21492 2000 -8.2 6.2;
   15.7 970 2209 -20.6 1.9;
   16.3 1260 2085 -17.3 2.8;
   17.2 14221726 -9.5 4.6;
   18.8 1874 1709 -4.9 8.0;
   17.9 1698 1848 -4.5 7.5;
   16.3 976 1239-4.6 5.6];
D=pdist(X,'euclid');
M=squareform(D);
Z=linkage(D,'complete');
[H tPerm]=dendrogram(Z,'labels',S);
xlabel('City');
ylabel('Scale');
C=cophenet(Z,D);
T=cluster(Z,3);

(13)平均法&相似系数

S=['福冈';'合肥';'武汉';'长沙';'桂林';'温州';'成都'];
X=[16.21492 2000 -8.2 6.2;
   15.7 970 2209 -20.6 1.9;
   16.3 1260 2085 -17.3 2.8;
   17.2 14221726 -9.5 4.6;
   18.8 1874 1709 -4.9 8.0;
   17.9 1698 1848 -4.5 7.5;
   16.3 976 1239-4.6 5.6];
D=pdist(X,'cosine');
M=squareform(D);
Z=linkage(D,'centroid');
T=dendrogram(Z,'labels',S);
xlabel('City');
ylabel('Scale');
C=cophenet(Z,D);
T=cluster(Z,3);

(14)最短距离法&基于主成分的标准欧式距离

S=['福冈';'合肥';'武汉';'长沙';'桂林';'温州';'成都'];
X=[16.21492 2000 -8.2 6.2;
   15.7 970 2209 -20.6 1.9;
   16.3 1260 2085 -17.3 2.8;
   17.2 14221726 -9.5 4.6;
   18.8 1874 1709 -4.9 8.0;
   17.9 1698 1848 -4.5 7.5;
   16.3 976 1239-4.6 5.6];
[E,score,eigen,T]=princomp(X);
PCA=[score(:,1),score(:,2)];
D=pdist(PCA,'seuclid');
M=squareform(D);
Z=linkage(D,'single');
H=dendrogram(Z,'labels',S);
xlabel('City');
ylabel('Scale');
C=cophenet(Z,D);
T=cluster(Z,3);

(推荐教程:MATLAB 教程

文章来源:www.toutiao.com/a6863649930347545091/

以上就是W3Cschool编程狮关于 MATLAB基于14种聚类方法的分析 的相关介绍了,希望对大家有所帮助。
Oracle数据库如何限制IP访问

thbcm阅读(304)

一、概述

本文将会给大家介绍在Oracle数据库该如何限制某个IP访问,或者限定某个IP段才能访问。

  1. 通过sqlnet.ora
  2. 通过/etc/hosts.deny/etc/hosts.allow
  3. 通过iptables

二、正式实验

本次实验环境是Centos6.10 + Oracle 11.2.0.4单实例,数据库服务器ip地址为192.168.31.71

1. 通过sqlnet.ora

a. 关闭数据库服务器上的防火墙,修改sqlnet.ora文件

该文件放在$ORACLE_HOME/network/admin下,如果没有就在该目录下创建一个即可 添加以下两行

tcp.validnode_checking = yes
tcp.invited_nodes = (192.168.31.71, 192.168.31.77)

这里需要注意的是必须把本机ip地址加进来(不能写成localhost和127.0.0.1),否则监听启动会报错

b. 重启监听,让sqlnet.ora的修改生效

lsnrctl stop
lsnrctl start

设置之后就只有这两个ip地址192.168.31.71, 192.168.31.77能访问数据库,其它ip地址访问会报ORA-12547: TNS:lost contact错误 tcp.invited_nodes 的意思是开通白名单,不在白名单中的一律拒绝访问,它也可以写成(192.168.31.*, 192.168.31.0/24)等方式,表明这个网段都能访问 另外还有个参数tcp.excluded_nodes,表示黑名单,这里不做介绍,有兴趣的可以自己去做做实验

(推荐教程:Oracle教程

2. 通过/etc/hosts.deny和/etc/hosts.allow

sqlnet.ora属于数据库层面的限制,但如果一个ip能够使用root或者oraclessh到这台数据库服务器的话,那么它依然能够访问数据库。为了避免这种情况,这时就需要通过/etc/hosts.allow/etc/hosts.deny去限制某个ip或者ip段才能ssh访问数据库服务器

先删除前面实验添加的sqlnet.ora,然后重启监听

lsnrctl stop
lsnrctl start

a. 修改/etc/hosts.deny

在文件尾部添加一行

all:all:deny

第一个all表示禁掉所有使用tcp_wrappers库的服务,举例来说就是sshtelnet等服务 第二个all表示所有网段

b. 修改/etc/hosts.allow

在前面一步中我禁掉所有的网段,所以在这一步中要开通指定的网段

修改/etc/hosts.allow,在文件尾部添加

all:192.168.31.71:allow
all:192.168.31.47:allow

格式与hosts.deny一样,第一行表示把本机放开,第二行表示给.47开通白名单

下面用我另外一台机器(即不在allow中的)sshtelnet连接 71 这个机器,就会出现如下报错

[oracle@oracle19c1 ~]$ ssh 192.168.31.71
ssh_exchange_identification: read: Connection reset by peer


[oracle@oracle19c1 ~]$ telnet 192.168.31.71 22
Trying 192.168.31.71...
Connected to 192.168.31.71.
Escape character is '^]'.
Connection closed by foreign host.

连数据库却不受影响,因为数据库服务不归hosts.denyhosts.allow

[oracle@oracle19c1 ~]$ sqlplus sys/xxxxx@192.168.31.71:1521/orcltest as sysdba


SQL*Plus: Release 19.0.0.0.0 - Production on Sun Aug 16 23:12:49 2020
Version 19.3.0.0.0


Copyright (c) 1982, 2019, Oracle.  All rights reserved.


Connected to:
Oracle Database 11g Enterprise Edition Release 11.2.0.4.0 - 64bit Production
With the Partitioning, OLAP, Data Mining and Real Application Testing options

其中 ip 地址也可以换成以下的写法 通配符的形式 192.168.31.*表示192.168.31这个网段 网段/掩码 192.168.31.0/255.255.255.0也表示192.168.31这个网段

3. 通过iptables

sqlnet.ora能够限制数据库的访问,/etc/hosts.deny/etc/hosts.allow能够限制ssh的访问,那有没有办法既能限制数据库的访问,也能限制ssh的访问呢,答案就是linux自带的防火墙功能了。 为了实验,将前面做的修改全部清除。

使用root执行以下命令

service iptables start  # 打开防火墙服务
iptables -I INPUT -s 192.168.31.0/24 -p tcp --dport 1521 -j ACCEPT  # 允许192.168.31网段的ip访问本机1521端口
iptables -I INPUT ! -s 192.168.31.0/24 -p tcp --dport 22 -j DROP  # 拒绝非192.168.31网段的ip访问本机22端口
service iptables save  # 规则保存到配置文件/etc/sysconfig/iptables中

这样就同时限制了其它ip对服务器的ssh和数据库访问

一些扩展知识: iptables -L -n --line-numbers #查看当前系统中的iptables iptables -D INPUT 2 #删除input链中编号为 2 的规则,编号数字可以通过上一个命令得到

(推荐微课:Oracle数据库入门到实战

三、总结

  1. 如果只是限制其它ip对数据库的访问,使用sqlnet.ora
  2. 如果要限制其它ip对数据库所在服务器上的ssh连接,使用/etc/hosts.deny/etc/hosts.allow
  3. 前面两个配合起来,基本上就能保证你的数据库安全了。但是如果你对linuxiptables很熟悉,那么直接使用iptables去限制。
  4. 使用/etc/hosts.denyiptables时一定要保证自己的操作机能连到服务器,不然很容易就把自己锁死在外面了。

文章来自(墨天轮),来源:www.modb.pro/db/29270?ywm= 作者:杨豹

以上就是W3Cschool编程狮关于 Oracle数据库如何限制IP访问 的相关介绍了,希望对大家有所帮助。
如何drop掉mysql库中的1TB表单

thbcm阅读(325)

如果问你怎么从MySQL数据库空drop一张表,很多人估计会说,很简单啊,用drop table t_test语句不就行了。这可真是初生牛犊不怕虎,你要真觉得这么简单的话,去线上业务库中drop掉一张1TB大小的表,造成长时间的业务无法访问数据库,更严重,导致数据库崩溃,宕机都是可能的。

下面就先聊聊,drop table语句背后的事情,语句执行之后,主要做2两件事情

1、清除Buffer Pool缓冲

drop table时,innodb引擎会清理该表在每个buffer pool实例中中对应的数据块页面,为了避免对系统的影响,这里的清除操作并不是真正的flush,而是将涉及到的页面从flush队列中摘除。但在摘除过程中,删除进程会持有每个buffer pool的全局锁,然后搜索这个buffer pool里对应的页面以便从flush list中删除。如果在buffer pool中需要被搜索并删除的页面过多,那么遍历时间就会增大,这就导致了其他事务操作被阻塞,严重时可导致数据库锁住。

(推荐课程:MySQL教程)

在这里还需要注意一件事情,如果数据库的buffer pool设置的很大,就会导致遍历时间变长 清理buffer pool时,还包含清理AHI包含此表的数据,AHI的功能在这里就不多说了,主要是当b+tree的层级变高时,为避免b+tree逐层搜索,AHI能根据某个检索条件,直接查询到对应的数据页,跳过逐层定位的步骤。其次AHI会占用 1/16 的buffer pool的大小,如果线上表数据不是特别大,不是超高并发,不建议将开启AHI,可以考虑关闭AHI功能

mysql> SHOW GLOBAL VARIABLES LIKE 'innodb_adaptive_hash_index';
+----------------------------+-------+
| Variable_name                   | Value |
+----------------------------+-------+
| innodb_adaptive_hash_index | ON    |
+----------------------------+-------+
1 row in set (0.01 sec)


mysql> SET GLOBAL innodb_adaptive_hash_index=OFF;
Query OK, 0 rows affected (0.00 sec)


mysql> SHOW GLOBAL VARIABLES LIKE 'innodb_adaptive_hash_index';
+----------------------------+-------+
| Variable_name                   | Value |
+----------------------------+-------+
| innodb_adaptive_hash_index | OFF   |
+----------------------------+-------+
1 row in set (0.01 sec)

2、删除对应的磁盘数据文件ibd

在删除数据文件时,如果数据文件过大,删除过程会产生大量的IO并耗费更多的时间,造成磁盘IO开销飙升,CPU负载过高,影响其他程序运行。我的一个好伙伴,就曾在线上库删除了一张 1TB 大小的表,结果20分钟,数据库无响应,最后库崩溃,重启了。

既然知道drop table做了2件事情,那就针对以上 2 个事情进行优化

在清除Buffer Pool缓冲上,为减少当个buffer pool的大小,可以合理设置innodb_buffer_pool_instances参数,减少buffer pool数据块列表扫描时间,同时关闭AHI功能

在步骤2上,可以巧妙的利用linux的硬连接特性,延迟删除真正的物理文件。

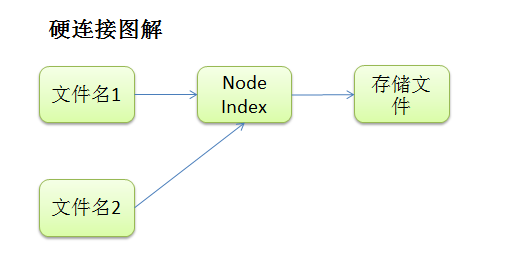
首先看看linux系统的硬链接示意图

当多个文件名同时指向同一个INODE时,这个INODE的引用数 N>1, 删除其中任何一个文件名都会很快.因为其直接的物理文件块没有被删除.只是删除了一个指针而已;当INODE的引用数 N=1 时, 删除文件需要去把这个文件相关的所有数据块清除,所以会比较耗时;

如果给数据库表的.ibd文件创建一个硬链接,当删除表时,删除物理文件时,其实删除的就是物理文件的一个指针,所以删除操作响应速度会非常快,大约不到1秒左右

下面就来演示一下具体的操作

先创建表文件的硬链接
ln t_test.ibd t_test.ibd.bak
删除表
drop table t_test;

最后就是要真正删除掉物理文件,释放文件所占用的磁盘空间,那么问题来了,如果优雅的删除物理文件呢,在这里推荐大家coreutils工具集中的truncate命令

当然需要你先安装相关的软件包

wget http://ftp.gnu.org/gnu/coreutils/coreutils-8.29.tar.xz


使用非root进行解压
tar -xvJf coreutils-8.29.tar.xz
cd coreutils-8.29
./configure
make
使用root进行make install

安装好之后,就可以写一个脚本,非常优雅的分布删除大文件,${i}G 表示,每次删除 10G

#!/bin/bash


TRUNCATE=/usr/local/bin/truncate
for i in `seq 2194 -10 10 `; 
do 
  sleep 2
  $TRUNCATE -s ${i}G /data/mysql/t_test.ibd.hdlk 
done
rm -rf /data/mysql/t_test.ibd.hdlk ;

最后,给大家一个建议,不要在业务高峰期做drop table操作,一定要在业务低峰期做。

(推荐微课:MySQL微课)

文章来源:www.toutiao.com/a6863864032139411975/

以上就是W3Cschool编程狮关于 如何drop掉mysql库中的1TB表单 的相关介绍了,希望对大家有所帮助。
学习Vue3.0,先从搭建环境开始

thbcm阅读(325)

本文将带您从零搭建一个基于Vue3.0viteVue3.0开发环境,通过本文的学习,你将学习到以下内容:

  1. 使用vite初始化Vue3.0项目
  2. 配置ts
  3. 配置vue-router
  4. 配置vuex
  5. 使用Vue3.0开发一个TodoList示例

使用vite初始化项目

vite 介绍

vite是尤大大在今年新鼓捣出来的一个工具,尤大大对vite的描述是这样的: Vite is an opinionated web dev build tool that serves your code via native ES Module imports during dev and bundles it with Rollup for production. 翻译成中文就是:Vite是一个由原生 ES Module驱动的 Web 开发构建工具。在开发环境下基于浏览器原生 ES imports 开发,在生产环境下基于Rollup打包。

上面这段话提到了一个关键字ES Module,这个是什么呢?详细的介绍大家可以访问 developer.mozilla.org/zh-CN/docs/Web/JavaScript/Guide/Modules 进行查看。此处我们长话短说。在最早的时候,还没有前端工程化,然后我们写javascript都是写到一个文件,然后通过script标签去引用,后来随着前端发展越来越壮大,js之间依赖越来越复杂,这时候就需要有一种可以将JavaScript 程序拆分为可按需导入的单独模块的机制来维护这个依赖,随之就诞生了AMD,CMD等等,而ES Module就是浏览器支持的原生模块依赖的功能。

为什么要用vite

为什么尤大大要推出vite,在我们使用webpack的时候,每次开发时候启动项目都需要几十秒甚至超过一分钟,比较慢,而且热更新也比较慢,而vite的主要特点就是快,官网对于vite的特点是这样描述的

  1. 快速的冷启动
  2. 即时的模块热更新
  3. 真正的按需编译

到底有多快呢,我们先新建一个项目试试

初始化vite项目

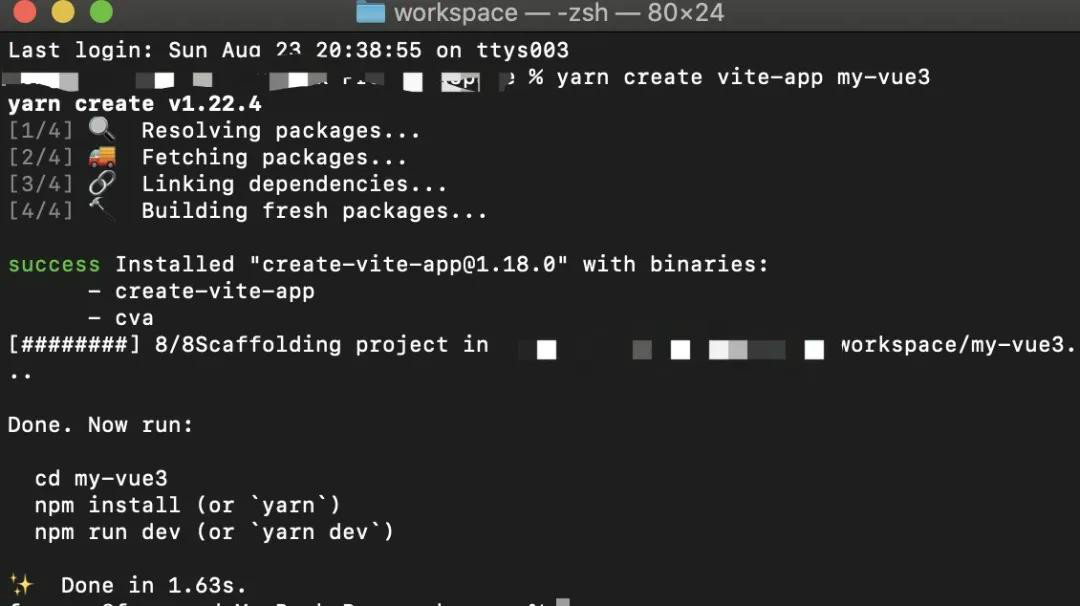
  1. 初始化项目, 在工作空间打开终端窗口,对于window用户即cmd,然后执行下面命令
   yarn create vite-app my-vue3

执行之后就会输出以下内容,可以看到新建项目特别快,仅仅用了1.63s

  1. 初始化完项目,通过cd my-vue3进行到项目里面,然后再执行yarn安装依赖(此处建议使用淘宝镜像,比较快)
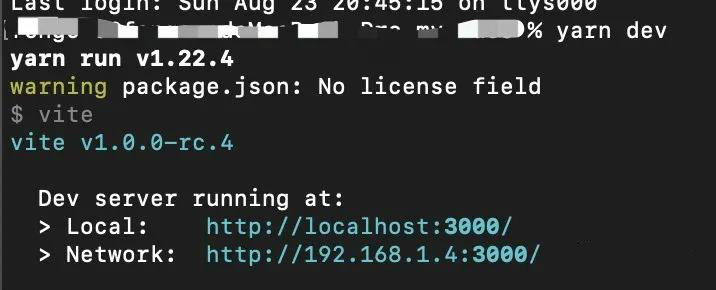
  1. 依赖安装完需要通过yarn dev启动项目

是不是瞬间体验到了秒启项目的感觉,启动之后就可以通过http://localhost:3000来访问项目了

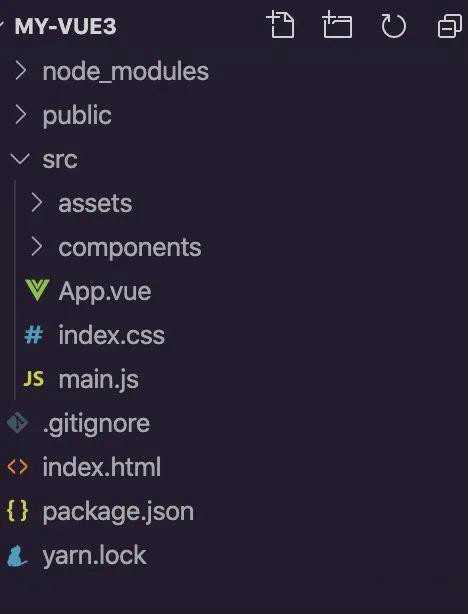
查看项目结构

使用vscode打开项目之后,可以查看到新建的项目结构与vue-cli4创建的项目结构基本一样,都是我们很熟悉的App.vuemain.js

查看main.js文件内容

打开main.js

import { createApp } from 'vue'
import App from './App.vue'
import './index.css'


createApp(App).mount('#app')

发现创建Vue的方式变了,原来是通过new Vue的方法来初始化Vue,在Vue3.0中,修改为了通过createApp的方式,关于Vue3.0的更多使用方式,我们将在后面的系列文章中逐渐为您带来讲解。

(推荐教程:Vue 2教程

配置typescript

typescript现在已经成为了前端必备技能之一,大量的项目也开始基于typescript进行开发。在使用Vue2.0的时候,因为Vue2.0没有对typescript进行支持,所以使用ts开发功能显示有些别扭。但到了Vue3,其自身源码便是基于ts开发的,所以对ts天生有着很好的支持。使用vite配置typescript很简单,只需要进行以下几步操作.

  1. 安装 typescript
   yarn add typescript -D

  1. 初始化tsconfig.json
   # 然后在控制台执行下面命令
   npx tsc --init

  1. main.js修改为main.ts,同时将index.html里面的引用也修改为main.ts, 通过还需要修改App.vueHelloWorld.vue文件,修改方式如下
   <!--将 <script> 修改为 <script lang="ts">-->
   <script lang="ts">
   import HelloWorld from './components/HelloWorld.vue'

   
   export default {
     name: 'App',
     components: {
       HelloWorld
     }
   }
   </script>

修改完之后,重启就可以访问项目了。虽然这样配置是可以了,但是打开main.ts会发现import App from App.vue会报错:Cannot find module './App.vue' or its corresponding type declarations.,这是因为现在ts还没有识别vue文件,需要进行下面的配置:

接下来你就可以开开心心的在组件中使用ts

    1. 在项目根目录添加shim.d.ts文件
  1. 添加以下内容
      declare module "*.vue" {
        import { Component } from "vue";
        const component: Component;
        export default component;
      }

配置 vue-router

Vue2.0中我们路由一般会选择使用vue-router,在Vue3.0依然可以使用vue-router,不过和Vue3.0一样当前vue-router的版本也是beta版本,在本文撰写的时候,版本是4.0.0-beta7

安装vue-router

因为当前vue-router针对vue3.0的版本还是beta版本,所以不能直接通过yarn add vue-router进行安装,而是需要带上版本号

yarn add vue-router@4.0.0-beta7

配置vue-router

在项目src目录下面新建router目录,然后添加index.ts文件,在文件中添加以下内容

import {createRouter, createWebHashHistory} from 'vue-router'


// 在 Vue-router新版本中,需要使用createRouter来创建路由
export default createRouter({
  // 指定路由的模式,此处使用的是hash模式
  history: createWebHashHistory(),
  // 路由地址
  routes: []
})

与新的Vue3.0初始化方式发生变化一样,vue-router的初始化方式也发生了变化,变成了通过createRouter来初始化路由。

router引入到main.ts

修改main.ts文件内容如下

import { createApp } from 'vue'
import App from './App.vue'
import './index.css'
import router from './router/index'


const  app = createApp(App)
// 通过use 将 路由插件安装到 app 中
app.use(router)
app.mount('#app')

配置 vuex

vue-router一样,新的vuex当前也处于beta版本,当前版本是4.0.0-beta.4

安装vuex

yarn add vuex@4.0.0-beta.4

配置vuex

在项目src目录下面新建store目录,并添加index.ts文件,文件中添加以下内容

import { createStore } from 'vuex'


interface State {
  userName: string
}


export default createStore({
  state(): State {
    return {
      userName: "子君",
    };
  },
});

引入到main.ts

import { createApp } from 'vue'
import App from './App.vue'
import './index.css'
import router from './router/index'
import store from './store/index'


const  app = createApp(App)
app.use(router)
app.use(store)
app.mount('#app')

开发TodoList

通过上面的一系列操作,我们的开发环境就已经配置完成了,接下来我们就通过新的开发环境先开发一个TodoList,来验证一下是否正常。

添加todolist页面

  1. 首先我们先在src目录下面新建一个views目录,然后在其中新建文件todo-list.vue,并为文件添加以下内容
   <template>
     <div class="todo-list">
       <div>
         <label>新增待办</label>
          <input v-model="state.todo" @keyup.enter="handleAddTodo">
       </div>
       <div>
         <h3>待办列表({{todos.length}})</h3>
         <ul>
           <li v-for="item in todos" :key="item.id" @click="handleChangeStatus(item, true)">
             <input type="checkbox">
             <label>{{item.text}}</label>
           </li>
         </ul>
       </div>
       <div><h3>已办列表({{dones.length}})</h3></div>
       <ul>
         <li v-for="item in dones" :key="item.id" @click="handleChangeStatus(item, false)">
             <input type="checkbox" checked>
             <label>{{item.text}}</label>
           </li>
       </ul>
     </div>
   </template>
   <script lang="ts">
    // 在vue2中 data 在vue3中使用 reactive代替
   import { reactive, computed } from 'vue'
   import { useRouter } from 'vue-router'
   export default {
     // setup相当于vue2.0的 beforeCreate和 created,是vue3新增的一个属性,所有的操作都在此属性中完成
     setup(props, context) {
       // 通过reactive 可以初始化一个可响应的数据,与Vue2.0中的Vue.observer很相似
       const state = reactive({
         todoList: [{
           id: 1,
           done: false,
           text: '吃饭'
         },{
           id: 2,
           done: false,
           text: '睡觉'
         },{
           id: 3,
           done: false,
           text: '打豆豆'
         }],
         todo: ''
       })
       // 使用计算属性生成待办列表
       const todos = computed(() => {
         return state.todoList.filter(item => !item.done)
       })

   
       // 使用计算属性生成已办列表
       const dones = computed(() => {
         return state.todoList.filter(item => item.done)
       })

   
       // 修改待办状态
       const handleChangeStatus = (item ,status) => {
         item.done = status
       }

       
       // 新增待办
       const handleAddTodo = () => {
         if(!state.todo) {
           alert('请输入待办事项')
           return
         }
         state.todoList.push({
           text: state.todo,
           id: Date.now(),
           done: false
         })
         state.todo = ''
       }

   
        // 在Vue3.0中,所有的数据和方法都通过在setup 中 return 出去,然后在template中使用
       return {
         state,
         todos,
         dones,
         handleChangeStatus,
         handleAddTodo
       }
     }
   }
   </script>
   <style scoped>
   .todo-list{
     text-align: center;
   }

   
   .todo-list ul li {
     list-style: none;
   }
   </style>

调整路由

a. 首先将App.vue文件内容修改为

<template> <router-view></router-view> </template>


<script lang="ts">


export default {
  name: 'App'
}
</script>

b. 然后修改 router/index.ts文件,添加新的路由

import {createRouter, createWebHashHistory} from ‘vue-router’


// 在 Vue-router新版本中,需要使用createRouter来创建路由
export default createRouter({
  // 指定路由的模式,此处使用的是hash模式
  history: createWebHashHistory(),
  // 路由地址
  routes: [{
    path: '/todolist',
    // 必须添加.vue后缀
    component: () => import('../views/todo-list.vue')
  }]
})

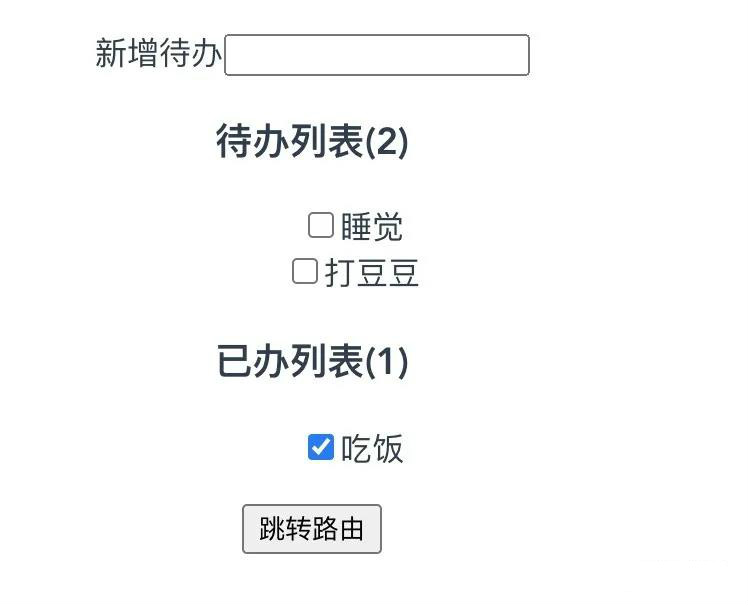
这时候我们就可以通过http://localhost:3000/#/todolist来访问TodoList了,效果如下图所示

(推荐微课:Vue 2.x 微课

总结

到此,我们Vue3.0的开发环境算是搭建完成了,当然现在还有好多好多要完善的东西,比如我们还需要去调整一下typescript的配置,然后添加eslint等等。同时如何在组件中跳转路由,使用vuex还没有去讲解,不过至少我们已经起步了。

文章来源:公众号–前端有的玩

作者:前端进击者

以上就是W3Cschool编程狮关于 学习Vue3.0,先从搭建环境开始 的相关介绍了,希望对大家有所帮助。
关于Node.js内存泄漏问题的分析

thbcm阅读(322)

本文将会先给大家介绍一些理论知识,随后再附上一个关于内存泄漏的案例,有兴趣的同学可以继续往下看。

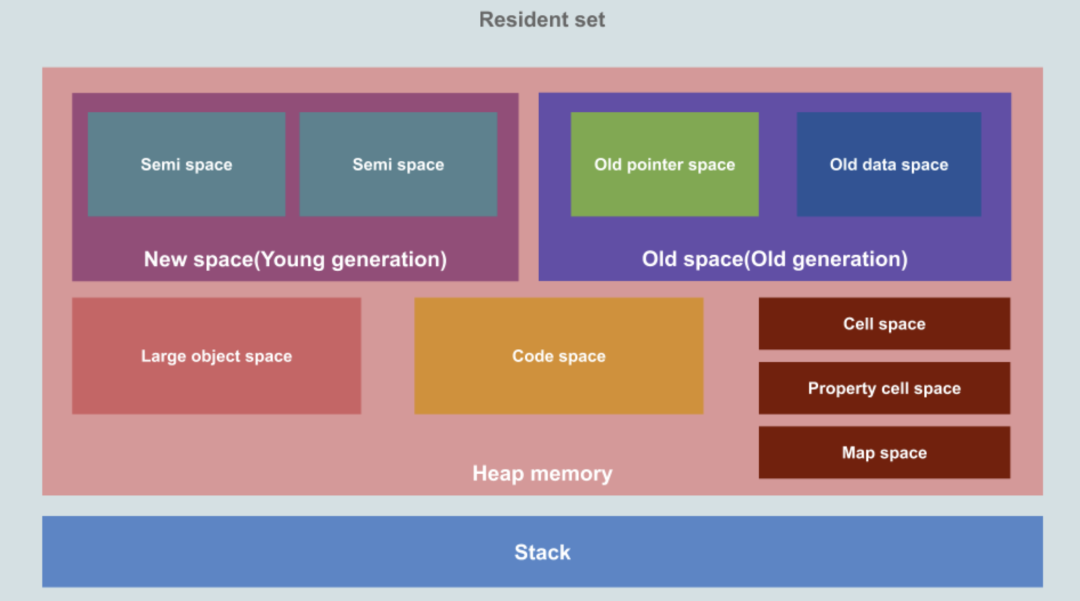
Node.js 使用 V8 引擎,它的特点是会自动进行垃圾回收(Garbage Collection,GC),所以我们在写代码的时候就不需要像C/C++ 一样去手动分配、释放内存空间,方便不少,不过仍然需要注意内存的使用,避免造成内存泄漏(Memory Leak)。

从上图中,可以看到 Node.js 的常驻内存(Resident Set)分为堆和栈两个部分,具体为:

    • 指针空间(Old pointer space):存储的对象含有指向其它对象的指针。
    • 数据空间(Old data space):存储的对象仅含有数据(不含指向其它对象的指针),例如从新生代移动过来的字符串等。
    • 新生代(New Space/Young Generation):用来临时存储新对象,空间被等分为两份,整体较小,采用 Scavenge(Minor GC) 算法进行垃圾回收。
    • 老生代(Old Space/Old Generation):用来存储存活时间超过两个 Minor GC 时间的对象,采用 标记清除 & 整理(Mark-Sweep & Mark-Compact,Major GC) 算法进行垃圾回收,内部可再划分为两个空间:
    • 代码空间(Code Space):用于存放代码段,是唯一的可执行内存(不过过大的代码段也有可能存放在大对象空间)。
    • 大对象空间(Large Object Space):用于存放超过其它空间对象限制(Page::kMaxRegularHeapObjectSize)的大对象(可以参考这个 V8 Commit),存放在此的对象不会在垃圾回收的时候被移动。
  • 栈:用于存放原始的数据类型,函数调用时的入栈出栈也记录于此。

栈的空间由操作系统负责管理,开发者无需过于关心;堆的空间由 V8 引擎进行管理,可能由于代码问题出现内存泄漏,或者长时间运行后,垃圾回收导致程序运行速度变慢。

(推荐教程:Node入门

我们可以通过下面代码简单的观察 Node.js 内存使用情况:

const format = function (bytes) {
  return `${(bytes / 1024 / 1024).toFixed(2)} MB`;
};


const memoryUsage = process.memoryUsage();


console.log(JSON.stringify({
    rss: format(memoryUsage.rss), // 常驻内存
    heapTotal: format(memoryUsage.heapTotal), // 总的堆空间
    heapUsed: format(memoryUsage.heapUsed), // 已使用的堆空间
    external: format(memoryUsage.external), // C++ 对象相关的空间
}, null, 2));

externalC++ 对象相关的空间,例如通过 new ArrayBuffer(100000); 申请一块 Buffer 内存的时候,可以明显看到 external 空间的增加。

可以通过下列参数调整相关空间的默认大小,单位为 MB:

  • –stack_size 调整栈空间
  • –min_semi_space_size 调整新生代半空间的初始值
  • –max_semi_space_size 调整新生代半空间的最大值
  • –max-new-space-size 调整新生代空间的最大值
  • –initial_old_space_size 调整老生代空间的初始值
  • –max-old-space-size 调整老生代空间的最大值

其中比较常用的是 --max_new_space_size--max-old-space-size

新生代的 Scavenge 回收算法、老生代的 Mark-Sweep & Mark-Compact 算法相关的文章已经很多,这里就不赘述了。

内存泄漏

由于不当的代码,有时候难免会发生内存泄漏,常见的有四个场景:

  1. 全局变量
  2. 闭包引用
  3. 事件绑定
  4. 缓存爆炸

接下来分别举个例子讲一讲。

全局变量

没有使用 var/let/const 声明的变量会直接绑定在 Global对象上(Node.js 中)或者 Windows 对象上(浏览器中),哪怕不再使用,仍不会被自动回收:

function test() {
  x = new Array(100000);
}


test();
console.log(x);

这段代码的输出为 [ <100000 empty items> ],可以看到 test 函数运行完后,数组 x 仍未被释放。

闭包引用

闭包引发的内存泄漏往往非常隐蔽,例如下面这段代码你能看出来是哪儿里有问题吗?

let theThing = null;
let replaceThing = function() {
  const newThing = theThing;
  const unused = function() {
    if (newThing) console.log("hi");
  };
  // 不断修改引用
  theThing = {
    longStr: new Array(1e8).join("*"),
    someMethod: function() {
      console.log("a");
    },
  };


  // 每次输出的值会越来越大
  console.log(process.memoryUsage().heapUsed);
};


setInterval(replaceThing, 100);

运行这段代码可以看到输出的已使用堆内存越来越大,而其中的关键就是因为 在目前的 V8 实现当中,闭包对象是当前作用域中的所有内部函数作用域共享的,也就是说 theThing.someMethodunUsed 共享同一个闭包的 context,导致 theThing.someMethod 隐式的持有了对之前的 newThing 的引用,所以会形成 theThing -> someMethod -> newThing -> 上一次 theThing ->...的循环引用,从而导致每一次执行 replaceThing 这个函数的时候,都会执行一次 longStr: new Array(1e8).join("*"),而且其不会被自动回收,导致占用的内存越来越大,最终内存泄漏。

对于上面这个问题有一个很巧妙的解决方法:通过引入新的块级作用域,将 newThing 的声明、使用与外部隔离开,从而打破共享,阻止循环引用。

let theThing = null;
let replaceThing = function() {
  {
    const newThing = theThing;
    const unused = function() {
      if (newThing) console.log("hi");
    };
  }
  // 不断修改引用
  theThing = {
    longStr: new Array(1e8).join("*"),
    someMethod: function() {
      console.log("a");
    },
  };


  console.log(process.memoryUsage().heapUsed);
};


setInterval(replaceThing, 100);

这里通过 { ... }形成了单独的块级作用域,而且在外部没有引用,从而 newThingGC 的时候会被自动回收,例如在我的电脑运行这段代码输出如下:

2097128
2450104
2454240
...
2661080
2665200
2086736 // 此时进行垃圾回收释放了内存
2093240

事件绑定

事件绑定导致的内存泄漏在浏览器中非常常见,一般是由于事件响应函数未及时移除,导致重复绑定或者 DOM 元素已移除后未处理事件响应函数造成的,例如下面这段 React 代码:

class Test extends React.Component {
  componentDidMount() {
    window.addEventListener('resize', function() {
      // 相关操作
    });
  }


  render() {
    return <div>test component</div>;
  }
}

<Test /> 组件在挂载的时候监听了 resize 事件,但是在组件移除的时候没有处理相应函数,假如 <Test /> 的挂载和移除非常频繁,那么就会在 window 上绑定很多无用的事件监听函数,最终导致内存泄漏。可以通过如下的方式避免这个问题:

class Test extends React.Component {
  componentDidMount() {
    window.addEventListener('resize', this.handleResize);
  }


  handleResize() { ... }


  componentWillUnmount() {
    window.removeEventListener('resize', this.handleResize);
  }


  render() {
    return <div>test component</div>;
  }
}

(推荐教程:Node.js教程

缓存爆炸

通过 Object/Map 的内存缓存可以极大地提升程序性能,但是很有可能未控制好缓存的大小和过期时间,导致失效的数据仍缓存在内存中,导致内存泄漏:

const cache = {};


function setCache() {
  cache[Date.now()] = new Array(1000);
}


setInterval(setCache, 100);

上面这段代码中,会不断的设置缓存,但是没有释放缓存的代码,导致内存最终被撑爆。

如果的确需要进行内存缓存的话,强烈建议使用 lru-cache这个 npm 包,可以设置缓存有效期和最大的缓存空间,通过 LRU 淘汰算法来避免缓存爆炸。

内存泄漏定位实操

当出现内存泄漏的时候,定位起来往往十分麻烦,主要有两个原因:

  1. 程序开始运行的时候,问题不会立即暴露,需要持续的运行一段时间,甚至一两天,才会复现问题。
  2. 出错的提示信息非常模糊,往往只能看到 heap out of memory 错误信息。

在这种情况下,可以借助两个工具来定问题:Chrome DevToolsheapdumpheapdump的作用就如同它的名字所说 – 将内存中堆的状态信息生成快照(snapshot)导出,然后我们将其导入到 Chrome DevTools 中看到具体的详情,例如堆中有哪些对象、占据多少空间等等。

接下来通过上文中闭包引用里内存泄漏的例子,来实际操作一把。首先 npm install heapdump 安装后,修改代码为下面的样子:

// 一段存在内存泄漏问题的示例代码
const heapdump = require('heapdump');


heapdump.writeSnapshot('init.heapsnapshot'); // 记录初始内存的堆快照


let i = 0; // 记录调用次数
let theThing = null;
let replaceThing = function() {
  const newThing = theThing;
  let unused = function() {
    if (newThing) console.log("hi");
  };


  // 不断修改引用
  theThing = {
    longStr: new Array(1e8).join("*"),
    someMethod: function() {
      console.log("a");
    },
  };


  if (++i >= 1000) {
    heapdump.writeSnapshot('leak.heapsnapshot'); // 记录运行一段时间后内存的堆快照
    process.exit(0);
  }
};


setInterval(replaceThing, 100);

在第 3 行和第 22 行,分别导出了初始状态的快照和循环了 1000 次后的快照,保存为 init.heapsnapshotleak.heapsnapshot

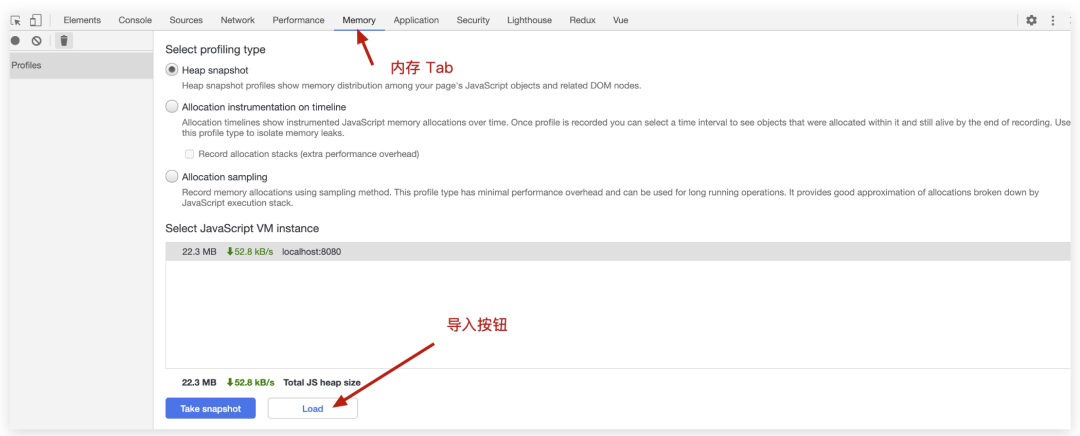
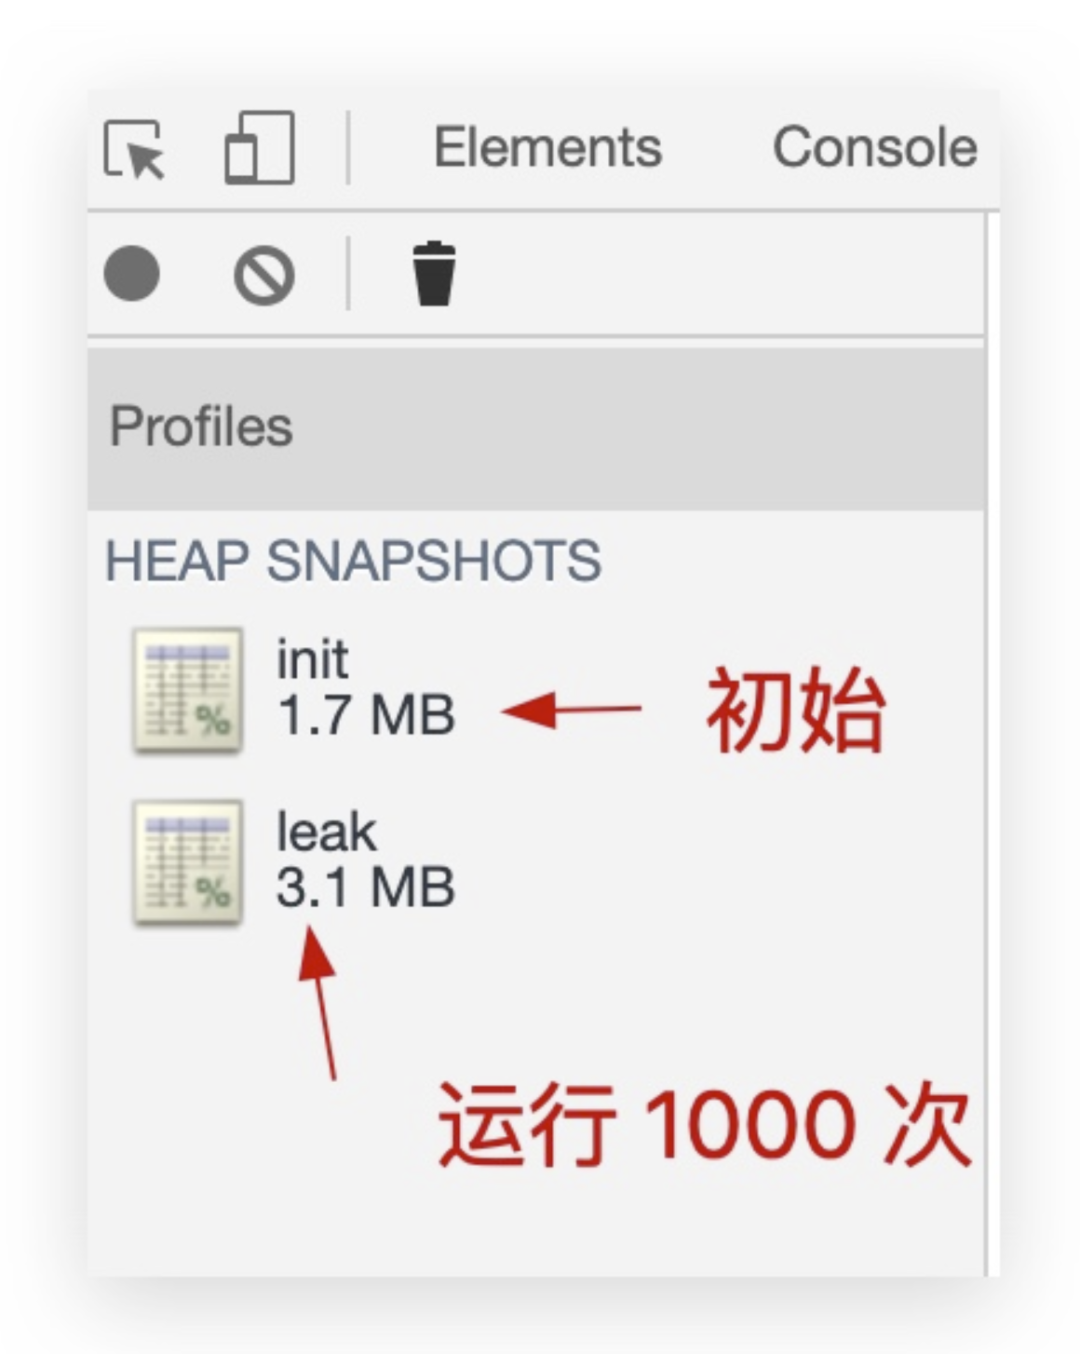
然后打开 Chrome 浏览器,按下 F12 调出DevTools 面板,点击 Memory 的 Tab,最后通过 Load 按钮将刚刚的两个快照依次导入:

导入后,在左侧可以看到堆内存有明显的上涨,从 1.7 MB 上涨到了 3.1 MB,几乎翻了一倍:

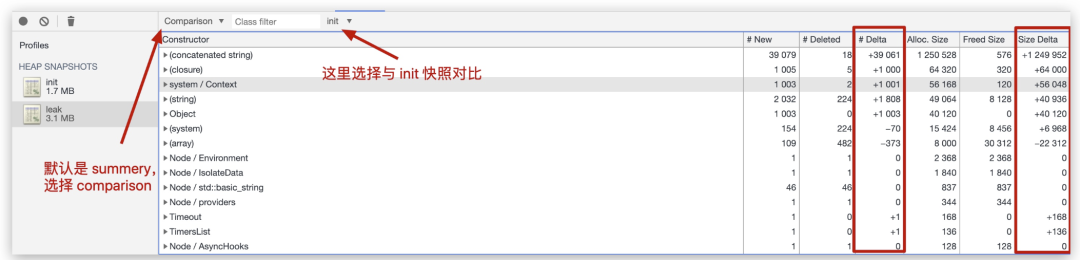
接下来就是最关键的步骤了,点击 leak 快照,然后将其与 init 快照进行对比:

右侧红框圈出来了两列:

  • Delta:表示变化的数量
  • Size Delta:表述变化的空间大小

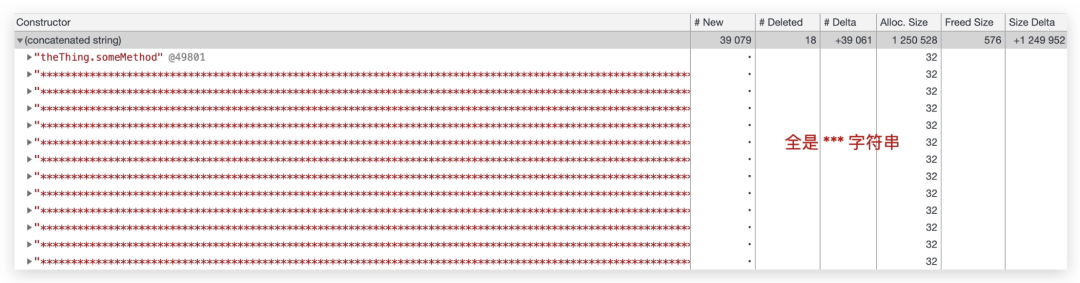
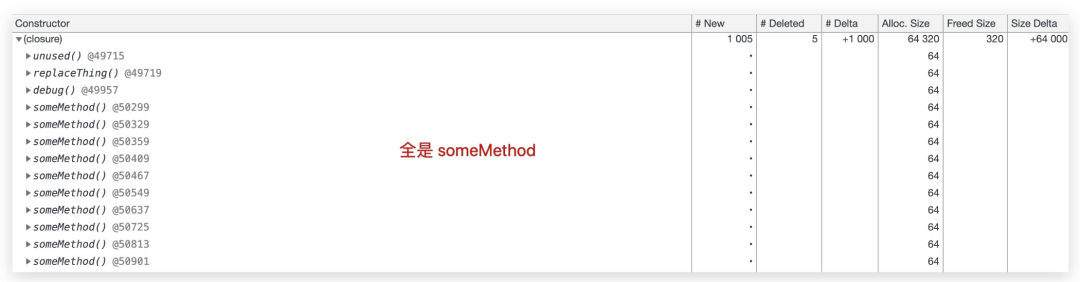
可以看到增长最大的前两项是 拼接的字符串(concatenated string ) 和 闭包(closure),那么我们点开来看看具体有哪些:

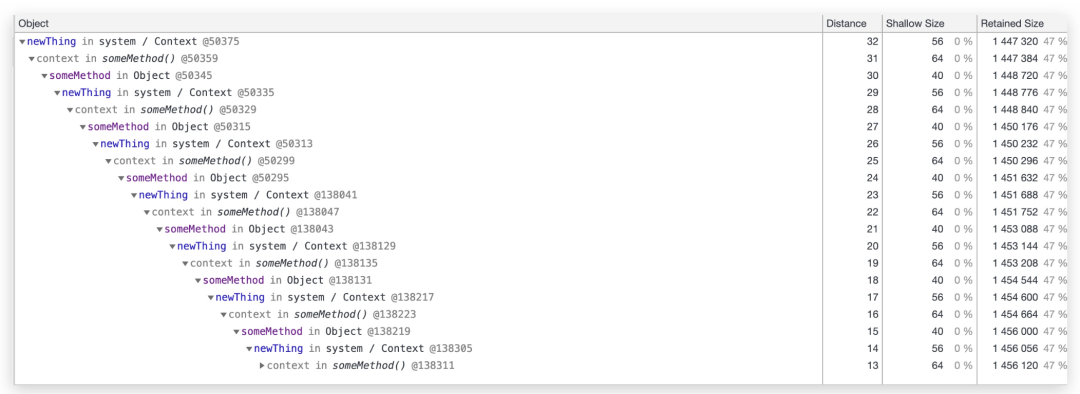
从这两个图中,可以很直观的看出来主要是 theThing.someMethod 这个函数的闭包上下文和 theThing.longStr 这个很长的拼接字符串造成的内存泄漏,到这里问题就基本定位清楚了,我们还可以点击下方的 Object 模块来更清楚的看一下调用链的关系:

图中很明显的看出来,内存泄漏原因就是因为 newTHing <- 闭包上下文 <- someMethod<- 上一次 newThing 这样的链式依赖关系导致内存的快速增长。图中第二列的 distance 表示的是该变量距离根节点的距离,因而最上级的 newThing 是最远的,表示的是下级引用上级的关系。

(推荐微课:Node.js微课

文章来源:www.toutiao.com/a6863362442957849102/

以上就是W3Cschool编程狮关于关于Node.js内存泄漏问题的分析的相关介绍了,希望对大家有所帮助。
Spring官方宣布:Spring OAuth 2.0 授权服务器已经来临

thbcm阅读(304)

今年四月份Spring官方发起Spring Authorization Server项目。该项目是由Spring Security主导的一个社区驱动的、独立的孵化项目。

由于我们熟悉而且正在使用的Spring Security OAuth已经处在项目生命周期的尽头,Spring Authorization Server将替代Spring Security OAuthSpring 社区提供OAuth2.0授权服务器支持。

经过四个月的努力,Spring Authorization Server项目中的OAuth2.0授权服务器开发库正式发布了第一个版本。

昨天Spring Security官方发布消息:新的Spring 授权服务器已经来了!

目前你可以通过 repo.spring.io 或者Maven中央仓库获取到它,Maven坐标如下:

 <dependency>
     <groupId>org.springframework.security.experimental</groupId>
     <artifactId>spring-security-oauth2-authorization-server</artifactId>
     <version>0.0.1</version>
 </dependency>

初始版本特性:

  • OAuth 2.0 授权码模式 — RFC 6749
  • OAuth 2.0 客户端凭据模式 — RFC 6749
  • JSON Web Token (JWT) — RFC 7519
  • JSON Web Signature (JWS) — RFC 7515
  • JSON Web Key (JWK) — RFC 7517
  • 密钥管理,用于在签署JWT(JWS)时提供密钥

简化模式和密码模式目前没有实现。

2019年11月下旬,Spring官方在Spring Security OAuth 2.0路线图中 指出2.3.x版本将在2020年3月到达项目生命周期的终点(End Of Life),随后将会发布2.4.x和2.5.x。

后续2.4.x和2.5.x补丁和安全修复程序支持将持续到2021年5月,另外2.5.x的安全修复支持将持续到2022年5月项目终止日期。相同的寿命终止时间表适用于对应的Spring Boot 2自动配置项目Spring Security OAuth 2.0会在2022年5月项目终止后开放给Spring社区中的成员直接管理。

(推荐课程:Spring教程

文章来源:www.toutiao.com/a6864378555522875912/

以上就是W3Cschool编程狮关于Spring官方宣布:Spring OAuth 2.0 授权服务器已经来临的相关介绍了,希望对大家有所帮助。

联系我们