给大数据分析实习生的面试经验题库

thbcm阅读(338)

大数据分析是一个有吸引力的领域。这是有利可图的,您有机会从事有趣的项目,而且您总是在学习新事物。因此,进入大数据分析领域极具竞争力。开始大数据分析事业的最佳方法之一是通过大数据分析实习。

在大数据分析实习生面试题库中,我们将研究所需的一般知识水平,典型面试过程的组成部分以及一些面试问题示例。注意,强调“通用”一词是因为具体情况因公司而异。

大数据分析实习面试会有什么期望?

大数据分析实习面试和专职大数据分析师之间的最大区别在于,通常不会期望您了解有关机器学习或深度学习概念的极其具体的细节。

但是,您将期望拥有能够在其上进行构建的基本构建块-包括PythonRSQL,统计和概率基础 以及 基本的机器学习概念。

Python和R

您应该具有脚本语言(最好是Python或R)的编程经验。如果您是Python程序员,则还应该对流行的库(如Scikit-learn 和 Pandas)有基本的了解 。

(推荐教程:python教程

您应该了解的内容: 您应该知道如何编写基本功能,并对各种数据结构及其用途有基本的了解。您还应该了解Scikit-learn的基本(但仍必不可少)功能,例如test_train_splitStandardScaler。对于Pandas,您应该像使用SQL编写查询那样舒适地操作DataFrame

例如,您可能需要构建一个简单的机器学习模型来预测产品的销售数量。在这种情况下,如果您是Python用户,那么了解Scikit-Learn库将非常有用,因为它已经提供了许多预构建的函数,例如上面提到的那些函数。

如何准备: 尝试在Kaggle上进行大数据分析项目或在Interview Query上进行实地考察,以了解您可能需要完成哪些项目。

为了更好地了解Scikit-Learn,最好使用它构建一个简单的机器学习模型,或者逐步完成其他人已经完成的一些大数据分析项目。

(推荐微课:python3基础微课

最后,尝试在Interview Query上练习Python问题,以了解他们可能会问您什么。

SQL

不会期望您在关系数据库方面有太多的经验,但是至少,您应该了解SQL的工作方式。 如果您正在争取大数据分析师的实习机会,那么您很可能会在拥有大量数据的公司工作。您将需要亲自浏览这些数据来解决问题。

(推荐课程:SQL教程)

您应该了解的内容: 您应该能够编写基本查询,并且应该知道如何使用SQL查询来操纵数据。对于公司而言,将SQL纳入其实际案例研究中非常普遍,因此,您必须非常了解SQL

示例问题

编写一个SQL查询以从Employee 表中获取第二高的薪水 。例如,给定下面的Employee表,查询应返回 200 作为第二高的薪水。如果没有第二高的薪水,则查询应返回 null

  + —- + ———- +

  | ID | 薪金|

  + —- + ———- +

  | 1 | 100 |

  | 2 | 200 |

  | 3 | 300 |

  + —- + ———- +

如何准备: 模式为学习基本SQL提供了很好的资源,可以在这里找到。此外,您还可以在线找到大量的SQL练习问题和练习案例研究。

(推荐微课:SQL微课)

统计与概率

您应该对基本统计数据和概率有所了解 。这些概念是大多数机器学习和大数据分析概念的基础。同样,许多要求大数据分析职位的面试问题都与统计有关。

您应该了解的内容: 您应该对基本概念有扎实的理解,包括但不限于概率基础,概率分布,估计和假设检验。统计数据的一个非常普遍的应用是条件概率,例如,假设客户购买了产品C,那么购买该产品B的概率是多少?

如何准备: 如果您对这些概念感到陌生,则可以利用许多免费资源,例如Khan AcademyGeorgia Institute of Technology

机器学习概念

虽然不希望您成为专家,但是您应该对基本的机器学习模型和概念有很好的了解 。如果职位描述表明您将要构建模型,则尤其如此。

您应该了解的内容: 这包括但不限于线性回归,支持向量机和聚类之类的概念。理想情况下,您应该对这些概念有基本的了解,并了解何时适合使用各种机器学习方法。

  例如,您可能需要对产品的价格点实施线性回归以确定销售数量。话虽如此,您将不需要生产或部署机器学习模型作为实习生。

领域知识

您应该对 所申请的领域具有 领域知识(如果没有,则应该学习)。

例如,如果您要申请市场营销部门的大数据分析职位,那么了解不同的营销渠道(例如社交媒体,会员,电视)以及核心指标(例如LTV, CAC)。

大数据分析实习面试流程

同样,面试过程最终取决于您所申请的公司。但是一般来说,大多数(如果不是全部)公司在面试过程中都有一些一般步骤,我将在下面进行解释。

作为实习生, 最糟糕的事情是不对公司的工作进行研究 ,这是文化使命和价值观。

初步筛选

通常,由公司的招聘人员或招聘经理进行初步筛选(通常是电话筛选)。这样做的目的是为了使受访者更好地了解其角色,并使访问者更好地了解受访者。

您应该期望他们询问您对这个职位和公司的兴趣,为什么认为自己很合适,以及与您过去的经历有关的问题。在极少数情况下,您可能还会被问到一个或两个简单的技术问题。

面试官只是在确保您对公司真正感兴趣,您是一个很好的沟通者,并且没有提出任何危险信号。

带回家的情况

对于现在的许多大数据分析实习,公司将要求您完成一项实战挑战。这意味着他们会给您一定的时间来完成他们给您的案例研究,这通常反映出您在实际角色中会遇到的问题。

这样做是为了了解您如何解决问题(即思考过程),以及您是否具有完成问题所需的基本知识。案例的示例包括 清理数据集 并 建立机器学习模型以做出给定的预测或查询数据集并分析数据或两者结合。

现场采访

最后是现场采访,可以包括一轮到多达六轮的采访。这些面试由行为和技术面试问题组成。您可能还需要现场完成一轮案件。

当他们试图确保您对成功担任该角色所需的基本知识有深刻的了解时,他们还将评估您的行为动机,并最终评估您是否适合团队或不。确保您处于最佳行为状态,但不要忘记做自己!

面试问题

以下是您希望了解的一些面试问题的几个示例:

  1)什么是p值?

  2)什么是正则化,它试图解决什么问题?

  3)您如何将年龄和收入之间的关系转换成线性模型?

  4)如果您有两个相等重量的骰子,总和为4的概率是多少?

  5)在整理和清理数据集时需要采取哪些步骤?

  6)什么是交叉验证,为什么有必要?

  7)举例说明在确定机器学习模型有效性时,准确性不是最佳指标。

  8)INNEROUTER JOIN有什么区别?

以上就是关于大数据大数据分析实习生的面试经验题库的相关介绍了,希望对大家有所帮助。

10条一行代码带你领略Python的魅力

thbcm阅读(436)

在了解Python并用它写了一次代码后,它的简单性,优秀的可读性和好用的一行代码深深的吸引了我。接下来,我会给大家介绍一些一行代码,或许对你的Python项目有所帮助。

1.交换两个变量

# a = 1; b = 2
a, b = b, a
# print(a,b) >> 2 1

让我们从一个经典的开始:通过简单地交换赋值位置来交换变量的值——在我看来,这是最直观的方法。不需要使用临时变量。它甚至适用于两个以上的变量。

2.多个变量赋值

a, b, *c = [1,2,3,4,5]
# print(a,b,c) >> 1 2 [3, 4, 5]

交换变量实际上是python能够一次分配多个变量的一种特殊情况。在这里,您可以使用它将列表元素分配给给定的变量,这也称为解表。 * 将再次打包剩下的值,这将导致c的子列表。它甚至可以用于*的其他位置(例如列表的开始或中间部分)。

3.对列表每隔两个元素求和

# a = [1,2,3,4,5,6]
s = sum(a[1::2])
# print(s) >> 12

这里不需要特殊的reduce函数,sum只是添加每个给定迭代的项。这里使用扩展的切片语法[::]来返回第二个元素。你可以将它读为[start: stop: step],所以[1::2]翻译为从索引 1 的元素开始(第二个元素),直到列表结束(第二个参数没有给出参数),并且总是采取两步。

(推荐教程:python教程

4.删除列表多个元素

# a = [1,2,3,4,5]
del a[::2]
# print(a) >> [2, 4]

扩展的切片语法也可以用来一次删除多个列表元素。

5.将文件读入行数组

c = [line.strip() for line in open('file.txt')]
# print(c) >> ['test1', 'test2', 'test3', 'test4']

使用python内联for循环,您可以轻松地将文件读入行数组中。需要使用strip()来删除后面的断线。如果你想保留它们或者它们对你来说不重要,你可以用更短的一行字:

c = list(open('file.txt'))
# print(c) >> ['test1\n', 'test2\n', 'test3\n', 'test4\n']

Python中读取文件真的很简单。附注:如果愿意,还可以使用readlines()方法。

6.将字符串写入文件

with open('file.txt', 'a') as f: f.write('hello world')
# print(list(open('file.txt'))) >> ['test1\n', 'test2\n', 'test3\n', 'test4\n', 'hello world']

With语句的帮助下,您可以直接将内容写入文件。确保使用正确的模式打开文件(这里“a”表示附加内容)。

7.创建列表

l = [('Hi ' + x) for x in ['Alice', 'Bob', 'Pete']]
# print(l) >> ['Hi Alice', 'Hi Bob', 'Hi Pete']

可以使用内联for循环从其他列表动态创建列表。您可以直接修改值,就像本例中的字符串连接一样。

8.列表映射

l = list(map(int, ['1', '2', '3']))
# print(l) >> [1, 2, 3]

还可以使用Pythons map()函数将每个列表元素强制转换为另一种类型。

(推荐微课:python3基础微课

9.集合创建

squares = { x**2 for x in range(6) if x < 4 }
# print(squares) >> {0, 1, 4, 9}

集合也是一样的。除了内联for循环之外,您甚至可以直接添加条件!

10.回文检查

# phrase = 'deleveled'
isPalindrome = phrase == phrase[::-1]
# print(isPalindrome) >> true

回文是一系列向前和向后读取相同的字符。如果给定字符串是回文,通常需要一些循环和条件来检查。在Python中,你只需要比较字符串和它的反向字符串。除了使用切片操作符[::-1]之外,您还可以使用reverse()函数来反转字符串。

以上就是关于Python一行代码的一些知识了,希望对大家有所帮助。

英文原文:dev.to/devmount/10-awesome-pythonic-one-liners-explained-3doc

Nodejs 与 Golang的对比,哪个更适合Web 开发

thbcm阅读(348)

互联网技术更新换代很快,全世界的开发人员都会关注技术趋势,这些技术最终将帮助他们在非常短的时间内设计出优秀的软件。很多时候,程序员很难根据客户的要求选择最佳语言来创建移动应用程序。Web 开发是发展最快的领域之一。每个行业都希望通过在线渠道扩展业务,以赢得更多的客户并加强营销。选择一流的技术(例如 Golang 应用程序开发或 NodeJS)变得至关重要。但是,哪个能为您的业务创造奇迹?

(推荐教程:Node入门

在当今的数字世界中,企业可以通过改进网站的不同部分(例如速度,外观、内容等)来吸引更多的客户。所有这些因素在吸引访问者和客户方面都起着重要的作用。功能丰富的编程语言的选择取决于两个重要因素,前端软件开发和后端软件开发。此外,移动应用程序的顺利运行还取决于用户的满意度。在本文,我们将讨论 NodeJSGolang 这两种广为人知的语言,开发人员可以选择这两种语言开发出色的软件和移动应用程序。

我们来谈谈 NodeJS

NodejsChrome V8平台上的一门功能强大的 javascript 语言运行时。它是一门很棒的开源语言,它使开发人员和编码人员(指前端人员)可以创建可在所有平台(Windows,ios,Android 等)上平稳运行的Web应用程序。另一个最佳方面是JS应用程序开发是一种跨平台的网页设计工具,可帮助简化编码人员的任务。集成到节点中的各种 javascript模块,允许程序员在基于Web的应用程序中添加独特的功能。工程师会发现,在服务器以及客户端部分上编写不同的代码很容易。最终减少了了解其他语言概念所花费的时间。

(推荐教程:Node.js教程

工程师可以使用这种有前途的语言在网络上进行软件开发。遇到棘手问题时,可以在社区中找到经验丰富的程序员大佬,在他们的帮助下轻松解决问题。它在I/O模型上运行,可轻松用于各种特定的Web应用程序。

  • 开发人员可以根据Web应用程序项目来个性化Node.js中的功能。
  • 作为一门服务端语言,可以有效地用于后端和前端,在技术领域是家喻户晓。
  • Node.js使开发人员可以轻松地多次使用代码。
  • Node.js中的 V8 技术使将编码合并到机器中变得更加简单。
  • Node.js还可以帮助开发人员在Web开发中缓存每个模块。

(推荐微课:Node.js微课

我们来谈谈 Golang

它由 Google开发,是一流的开源编程语言,可轻松创建 Web应用程序。使用Golang编写的Web应用程序可以在各种平台上稳定运行。对于大型的基于Web 的应用程序,Golang 是最佳选择。该语言以其管理Web应用程序的现有编码任务的能力而闻名。这也是开发人员即时学习的一种非常容易的语言。Golang使用的是C族的语法。

开发人员更喜欢 Golang应用程序开发,因为它可以在云上开发出大量 Web 应用程序。反过来,这减少了数据被盗的风险,因为信息只能由组织中的相关人员访问。而且,上级人员可以通过世界任何地方来访问信息。它使用 C 语言来简化编码, 开发人员都非常容易学习这种语言。Golang 的另一个最好的部分是垃圾收集。使用 Golang 设计的网络应用程序运行速度更快。通过 Golang 编写的 Web 程序也是非常的安全可靠。

  • Golang 允许开发人员轻松编写代码。此外,更改代码也非常简单。
  • Golang 的垃圾收集功能有助于降低工具的延迟率,以便开发可以通过简单的方法添加独特的算法。
  • Golang 创建的 Web 应用程序也可以扩展,因为它可以使用 goroutines 有效地处理众多任务。
  • Go 编译器集成,可以帮助开发人员快速编译出适合各种操作系统运行的二进制文件。

(推荐课程:Go教程

Nodejs 和 Golang 的区别

1. 语言的性能

如果 Web 应用程序执行效率高,则可以在不同平台上快速加载。这对于数字营销非常重要,因为网站的速度会吸引更多的访客。最终,它可以提高潜在用户的满意度,并增加口碑营销。Go 应用程序最终会被编译为机器语言。

Go 还包括垃圾收集器,可以轻松处理内存分配并释放不使用的内存。此过程有助于减少网络攻击,因为它可以轻松处理内存。当需要为网站访客开发一个 Web 应用程序时,Go 是最佳选择。

Nodejs 一般都用来做后端开发。它使用 Javascript 语言进行开发,不会阻碍 Web 应用程序的开发过程。开发可以在后端执行操作,前端部分完全不受影响。而且,V8 引擎是所有可用 JS 平台中最快的,这反过来又使 Nodejs 成为有前途的工具。另外,Nodejs 编写的代码可以在开发Web 应用程序中多次使用。

2. Web应用程序开发过程中的错误管理

关于 Nodejs,在 Web 应用程序开发过程中出现的问题可以一目了然。但是,对于 Golang 应用程序开发过程中出现的错误不会很清楚的分开展现。这最终会给后面的开发人员带来麻烦。GoogleGo Team 成员总是计划在短时间内添加独特的功能以吸引开发人员。因此,Nodejs 应用程序开发在这方面是最好的。

3. 在开发可扩展方面

请牢记在运行 Web 应用程序时 Golang 的可伸缩性。使用 Goroutine 有助于 Golang 应用开发。可以轻松,高效地执行许多任务。反过来,这又可以快速改善 Web 应用程序的功能。

对于 NodejsWeb 应用程序的设计方式非常不同。它在单个平台上运行,但是整个部分按正确的顺序进行。JS 中的所有编码过程都借助于 Node 中的回调功能完成。这就是为什么 Nodejs 中没有可伸缩性的原因。在这方面,Go 编程语言是不错的选择。

4. 开发中的技术

正确的技术和独特功能的使用使开发人员能够快速开发出超赞的网站。Nodejs 涉及各种技术和框架的集成,这使得一些有定制需求的 Web 应用程序创建变得更简单。此外,JavaScript 语言具有广泛的社区,来支持Web 应用程序项目设计。

另一方面,Go 编程语言受到程序员和工程师的高度评价,但仍处于早期发展阶段。尽管有多种可用的框架和技术,但不如 Nodejs 丰富。因此,在这种情况下,Nodejs 应用程序开发是赢家。

5. 两种编程语言都需要的学习时间

知道 JavaScript 概念的开发人员会发现,Nodejs 语言是能最快速度掌握的语言。如果工程师可以在更少的时间内学习该语言,那么他们将能够更快地开始开发 Web 应用程序。自古以来,IT 部门中都会存在 JavaScript 的使用。这就是为什么 Nodejs 能快速上手的原因。同时学习渠道以及资源丰富。Nodejs 中的新手可以向经验丰富的老手请教问题,来快速解决 Web 应用程序开发时遇到的问题。网上也有很多关于 NodeJs Web 应用程序开发的课程。

(推荐课程:Go Web编程

Golang 应用程序开发是 IT 领域的新概念。它适用于 Google 制定的另一套规则。通过 Golang 设计 Web 应用程序包括不同的过程,界面等。它由 Google 开发,其中包含许多其他技术,这些技术对于全球的程序员和编码人员而言都是相对较新的技术。Go 语言的另一个问题是,它仅用于 Web 应用程序后端设计。这样就不得不再招一些前端Web 应用程序开发人员。这将花费更多时间。作为老板,您的主要目标是利用您的时间来扩展业务并增加营业额和收入。您将无法参与Web 应用程序设计任务。而且 Golang 社区也没有 Nodejs 社区那么广泛。开发 Golang 应用程序需要开发对 Golang 有深入的研究。当通过 Golang 设计 Web 应用程序出现问题时,想要快速找到精通的人帮忙解决比较有难度。反过来,这是一个耗时的过程,对于有 deadline 的项目会比较有挑战。因此,Nodejs 非常适合Web应用程序开发的公司。吸引人的是,它能提供众多功能。公司充分利用 Nodejs 应用开发的潜力,为全球不同客户创建出色的 Web 应用。

6. 两种语言的社区

嗯,这两种语言都是完全开源的。每个都有自己的基础社区,以帮助新的开发人员和编码人员。但是,与 Golang 应用程序开发相比,Nodejs 平台拥有更广泛的社区。NodejsJavaScript 上起作用,JavaScriptWeb 应用程序开发中最常用的语言。而 Golang 的社区比 Nodejs 小得多。由 Google 开发的 Golang,开发人员举办许多活动,探讨对这种编程语言进行更新、实践和改进。

(推荐微课:Go微课

结束语

所以,现在您对这两种编程语言都有了深入的了解。现在可以得出结论,选择哪个编程语言是取决于当前的项目特点。如果 Web 开发人员是技术领域的新手,那么 Nodejs 将是理想的选择。但是,Golang 是新编程语言,当然学习需要很多时间。同样,这取决于工程师根据他们的要求来选择。

以上就是关于NodejsGolang 的比较,希望对大家有所帮助。

Github标星14K的一款国产Java工具类库

thbcm阅读(364)

最近在Github上面看到一款小而全的Java工具类库,已经接近14K Star了,想来这肯定是一款优秀的软件,现在给大家介绍一下。

![Hutool](https://atts.w3cschool.cn/attachments/image/20200814/1597384513592387.jpg “Hutool”)

Hutool 是什么

Hutool 是一个Java工具包类库,它可以对文件、流、加密解密、转码、正则、线程、XMLJDK方法进行封装,组成各种Utils工具类。

Hutool 即是Hu(谐音“糊涂”) + tool,前者致敬作者 “前任公司”,后者为工具之意,谐音“糊涂”,寓意追求“万事都作糊涂观,无所谓失,无所谓得”的境界。

(推荐教程:Java教程

Hutool如何改变我们的coding方式

Hutool的目标是使用一个工具方法代替一段复杂代码,从而最大限度的避免“复制粘贴”代码的问题,彻底改变我们写代码的方式。

以计算MD5为例:

【以前】打开搜索引擎 -> 搜“Java MD5加密” -> 打开某篇博客-> 复制粘贴 -> 改改好用

【现在】引入Hutool -> SecureUtil.md5() Hutool的存在就是为了减少代码搜索成本,避免网络上参差不齐的代码出现导致的bug

是不是很香,再也不要到处找这些工具类代码了

包含组件

一个Java基础工具类,对文件、流、加密解密、转码、正则、线程、XMLJDK方法进行封装,组成各种Util工具类,同时提供以下组件:

![包含组件](https://atts.w3cschool.cn/attachments/image/20200814/1597384589447484.jpg “包含组件”)

安装

Maven 在项目的 pom.xmldependencies中加入以下内容:

![安装](https://atts.w3cschool.cn/attachments/image/20200814/1597384660664063.jpg “安装”)

Gradle:

compile ‘cn.hutool:hutool-all:5.3.10’

这个类库还是咱国人程序员们开源的。

(推荐微课:Java微课

Hutool 也欢迎任何人为Hutool添砖加瓦,贡献代码,不过作者是一个强迫症患者,为了照顾病人,需要提交的pr(pull request)符合一些规范。

以上就是关于Github标星14K的一款国产Java工具类库:Hutool的相关介绍了,希望对大家有所帮助。

一文看懂React17新特性——启发式更新算法

thbcm阅读(373)

三天前,React团队发布了React17的第一个RC版本,这个版本最大的特性就是“无新特性”。

那么,从v16v17这一年多时间React团队究竟在做什么?

遥想从v15v16React团队花了两年时间将源码架构中的Stack Reconciler重构为Fiber Reconciler,事情一定没有这么简单。

事实上,这次版本更迭确实有“新特性” —— 替换了内部使用的启发式更新算法。

只不过这个特性对开发者是无感知的。

本文接下来将讲述如下内容:

  • 起源:为什么会出现启发式更新算法?
  • 现状:React16的启发式更新算法及他的不足
  • 未来:React17的启发式更新算法

为什么会出现启发式更新算法

框架的运行性能是框架设计者在设计框架时需要重点关注的点。

Vue使用模版语法,可以在编译时对确定的模版作出优化。

ReactJS写法太过灵活,使他在编译时优化方面先天不足。

所以,React的优化主要在运行时。

React15的痛点

在运行时优化方面,React一直在努力。

比如,React15实现了batchedUpdates(批量更新)。

即同一事件回调函数上下文中的多次setState只会触发一次更新。

但是,如果单次更新就很耗时,页面还是会卡顿(这在一个维护时间很长的大应用中是很常见的)。

这是因为React15的更新流程是同步执行的,一旦开始更新直到页面渲染前都不能中断。

为了解决同步更新长时间占用线程导致页面卡顿的问题,也为了探索运行时优化的更多可能,React开始重构并一直持续至今。

重构的目标是实现Concurrent Mode(并发模式)。

(推荐教程:React教程

Concurrent Mode

Concurrent Mode的目的是实现一套可中断/恢复的更新机制。

其由两部分组成:

  • 一套协程架构
  • 基于协程架构的启发式更新算法

其中,协程架构就是React16中实现的Fiber Reconciler

我们可以将Fiber Reconciler理解为React自己实现的Generator

Fiber Reconciler从理念到源码的详细介绍见这里

协程架构使更新可以在需要的时机被中断,这样浏览器就有时间完成样式布局与样式绘制,减少卡顿(掉帧)的出现。

当浏览器进入下一次事件循环,协程架构可以恢复中断或者抛弃之前的更新,重新开始新的更新流程。

启发式更新算法就是控制协程架构工作方式的算法。

React16的启发式更新算法

启发式更新算法的启发式指什么呢?

启发式指不通过显式的指派,而是通过优先级调度更新。

其中优先级来源于人机交互的研究成果。

比如:

人机交互的研究成果表明:

  • 当用户在输入框输入内容时,希望输入的内容能实时响应在输入框
  • 当异步请求数据后,即使等待一会儿再显示内容,用户也是可以接受的

基于此,在React16中

输入框输入内容触发的更新优先级 > 请求数据返回后触发更新优先级

算法实现 在React16、17中,在组件内执行this.setState后会在该组件对应的fiber节点内产生一种链表数据结构update

其中,update.expirationTimes为类似时间戳的字段,表示优先级。

expirationTimes从字面意义理解为过期时间。

该值离当前时间越接近,该update 优先级越高。

update.expirationTimes超过当前时间,则代表该update过期,优先级变为最高(即同步)。

一棵fiber树的多个fiber节点可能存在多个update

每次Fiber Reconciler调度更新时,会在所有fiber节点的所有update.expirationTimes中选择一个expirationTimes(一般选择最大的),作为本次更新的优先级。

并从根fiber节点开始向下构建新的fiber树。

构建过程中如果某个fiber节点包含update,且

update.expirationTimes >= expirationTimes

则该update对应的state变化会体现在本次更新中。

可以理解为:每次更新,都会选定一个优先级(expirationTimes),最终页面会渲染为该优先级对应update的快照。

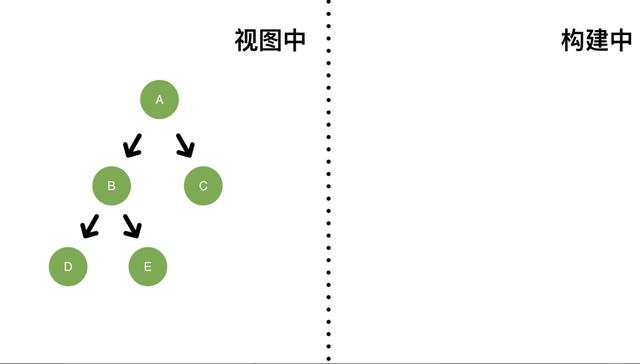
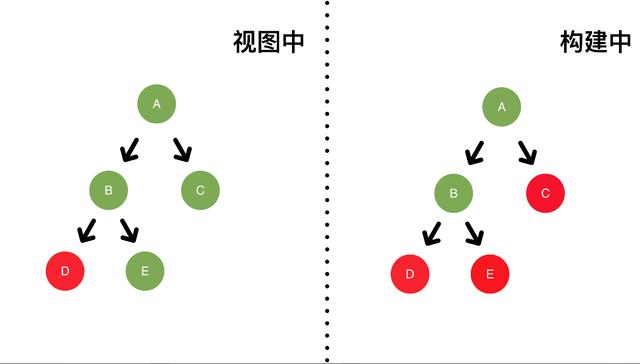
举个例子,我们有如图所示fiber树,当前还没有更新产生,所以没有构建中的fiber树。

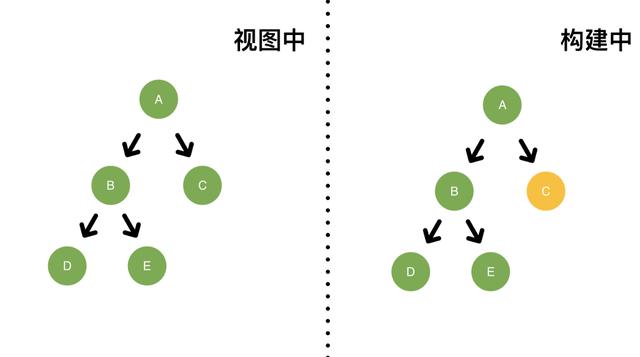
当在 C 创建一个低优先级update,调度更新,本次更新选择的优先级为低优先级。

开始构建新的fiber树(图右侧)。

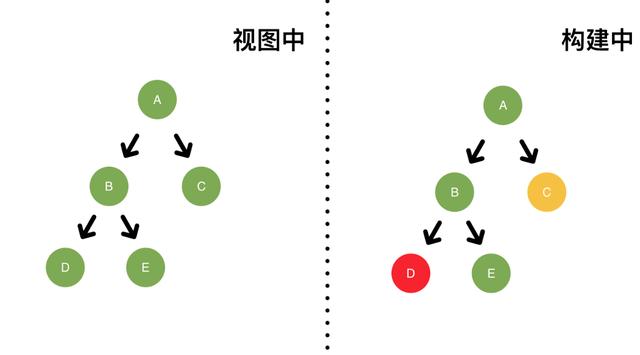
此时,我们在 D 创建一个高优先级update

这会中断进行中的低优先级更新,重新开始以高优先级生成一棵fiber树。

由于之前的更新被中断,还没有任何渲染操作,此时视图中(左图)还没有任何变化。

本次更新选定的优先级为高优先级,C 的update(低优先级)会被跳过。

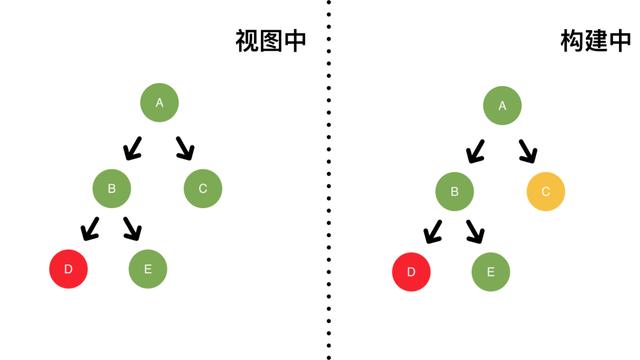
更新完成后新的fiber树会被渲染到视图中。

由于 C 被跳过,所以不会在视图(左图)中体现。

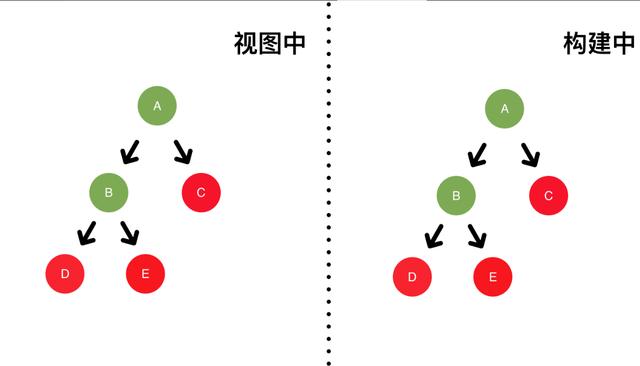
接下来我们在 E 触发一次高优先级update

C 虽然包含低优先级update,但随着时间的推移,他的expirationTimes已经过期,变为高优先级。

所以本次更新会有 C E 两个fiber节点产生变化。

最终完成更新后,视图如下:

算法缺陷

如果只考虑中断/继续这样的 CPU 操作,以expirationTimes大小作为衡量优先级依据的模型可以很好工作。

但是expirationTimes模型不能满足 IO 操作(Suspense)。

在该模型下,高优先级 IO 任务(Suspense)会中断低优先级 CPU 任务。

还记得么,每次更新,都是以某一优先级作为整棵树的优先级更新标准,而不仅仅是某一组件,即使更新的源头(update)确实是某个组件产生的。

expirationTimes模型只能区分是否>=expirationTimes这种情况。

为了拓展Concurrent Mode能力边界,需要一种更细粒度的启发式优先级更新算法。

(推荐教程:React入门实例教程

React17启发式更新算法

最理想的模型是:可以指定任意几个优先级,更新会以这些优先级对应update生成页面快照。

但是现有架构下,该方案实现上有瓶颈。

妥协之下,React17的解决方案是:指定一个连续的优先级区间,每次更新都会以区间内包含的优先级生成对应页面快照。

这种优先级区间模型被称为lanes(车道模型)。

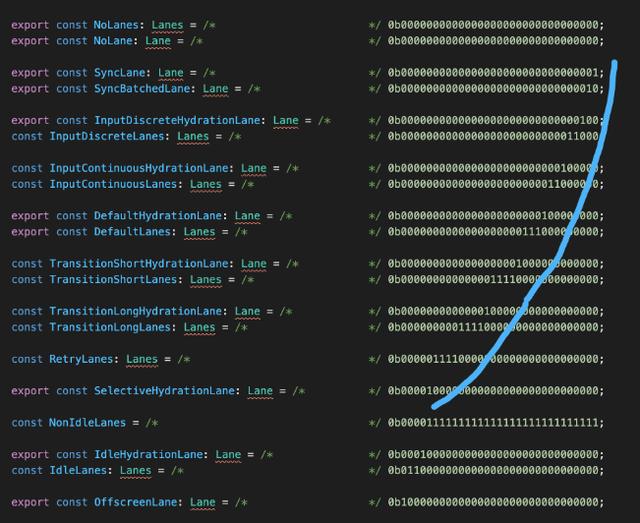
具体做法是:使用一个31位的二进制代表31种可能性。

  • 其中每个bit被称为一个lane(车道),代表优先级
  • 某几个lane组成的二进制数被称为一个lanes,代表一批优先级

可以从源码中看到,从蓝线一路划下去,每个bit都对应一个lanelanes

update产生,会根据React16同样的启发式方式,获得如下优先级的一种:

export const SyncLanePriority: LanePriority = 17; export const SyncBatchedLanePriority: LanePriority = 16; export const InputDiscreteLanePriority: LanePriority = 14; export const InputContinuousLanePriority: LanePriority = 12; export const DefaultLanePriority: LanePriority = 10; export const TransitionShortLanePriority: LanePriority = 8; export const TransitionLongLanePriority: LanePriority = 6;

其中值越高,优先级越大。

比如:

  • 点击事件回调中触发this.setState产生的update会获得InputDiscreteLanePriority
  • 同步的update会获得SyncLanePriority

接下来,update会以priority为线索寻找没被占用的lane

如果当前fiber树已经存在更新且更新的lanes包含了该lane,则update需要寻找其他lane

比如,InputDiscreteLanePriority对应的lanesInputDiscreteLanes

// 第4、5位为1 const InputDiscreteLanes: Lanes = 0b0000000000000000000000000011000;

lanes包含第4、5位 2 个 bit位。

如果其中

// 第五位为1 0b0000000000000000000000000010000

第五位的lane已经被占用,则该update可以尝试占有后一个,即

// 第四位为1 0b0000000000000000000000000001000

如果InputDiscreteLanes的两个lane都被占用,则该update的优先级会下降到InputContinuousLanePriority并继续寻找空余的lane

这个过程就像:购物中心每一层(不同优先级)都有一个露天停车场(lanes),停车场有多个车位(lane)。

我们先开车到顶楼找车位(lane),如果没有车位就下一楼继续找。

直到找到空余车位。

由于lanes可以包含多个lane,可以很方便的区分 IO 操作(Suspense)与 CPU 操作。

当构建fiber树进入构建Suspense子树时,会将Suspenselane插入本次更新选定的lanes中。

当构建离开Suspense子树时,会将Suspense lane从本次更新的lanes中移除。

(推荐微课:React微课

总结

React16expirationTimes模型只能区分是否>=expirationTimes决定节点是否更新。

React17lanes模型可以选定一个更新区间,并且动态的向区间中增减优先级,可以处理更细粒度的更新。

以上就是关于React17的新特性–启发式更新算法的相关介绍了,希望对大家有所帮助。

Spring Boot 2.x基础教程:使用集中式缓存Redis

thbcm阅读(355)

在本文中我们来学习一下,如何在Spring Boot的缓存支持中使用Redis实现数据缓存。

(推荐教程:Spring Boot 那些事)

动手试试

User实体的定义

@Entity @Data @NoArgsConstructor public class User implements Serializable {


    @Id
    @GeneratedValue
    private Long id;


    private String name;
    private Integer age;


    public User(String name, Integer age) {
        this.name = name;
        this.age = age;
    }
}

User实体的数据访问实现(涵盖了缓存注解)

@CacheConfig(cacheNames = “users”) public interface UserRepository extends JpaRepository<User, Long> {


    @Cacheable
    User findByName(String name);


}

(推荐课程:Spring教程

下面开始改造这个项目:

第一步pom.xml中增加相关依赖:

<dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-redis</artifactId> </dependency>


<dependency>
    <groupId>org.apache.commons</groupId>
    <artifactId>commons-pool2</artifactId>
</dependency>

Spring Boot 1.x的早期版本中,该依赖的名称为spring-boot-starter-redis,所以在Spring Boot 1.x基础教程中与这里不同。

第二步:配置文件中增加配置信息,以本地运行为例,比如:

spring.redis.host=localhost spring.redis.port=6379 spring.redis.lettuce.pool.max-idle=8 spring.redis.lettuce.pool.max-active=8 spring.redis.lettuce.pool.max-wait=-1ms spring.redis.lettuce.pool.min-idle=0 spring.redis.lettuce.shutdown-timeout=100ms

关于连接池的配置,需要注意:

Redis的连接池配置在 1.x 版本中前缀为spring.redis.poolSpring Boot 2.x有所不同。在 1.x 版本中采用jedis作为连接池,而在 2.x 版本中采用了lettuce作为连接池以上配置均为默认值,实际上生产需进一步根据部署情况与业务要求做适当修改.

再来试试单元测试:

@Slf4j @RunWith(SpringRunner.class) @SpringBootTest public class Chapter54ApplicationTests {


    @Autowired
    private UserRepository userRepository;


    @Autowired
    private CacheManager cacheManager;


    @Test
    public void test() throws Exception {
        System.out.println("CacheManager type : " + cacheManager.getClass());


        // 创建1条记录
        userRepository.save(new User("AAA", 10));


        User u1 = userRepository.findByName("AAA");
        System.out.println("第一次查询:" + u1.getAge());


        User u2 = userRepository.findByName("AAA");
        System.out.println("第二次查询:" + u2.getAge());
    }


}

执行测试输出可以得到:

CacheManager type : class org.springframework.data.redis.cache.RedisCacheManager Hibernate: select next_val as id_val from hibernate_sequence for update Hibernate: update hibernate_sequence set next_val= ? where nextval=? Hibernate: insert into user (age, name, id) values (?, ?, ?) 2020-08-12 16:25:26.954 INFO 68282 — [ main] io.lettuce.core.EpollProvider : Starting without optional epoll library 2020-08-12 16:25:26.955 INFO 68282 — [ main] io.lettuce.core.KqueueProvider : Starting without optional kqueue library Hibernate: select user0.id as id10, user0_.age as age20, user0_.name as name30 from user user0 where user0.name=? 第一次查询:10 第二次查询:10

(推荐微课:Spring微课)

可以看到:

  1. 第一行输出的CacheManager typeorg.springframework.data.redis.cache.RedisCacheManager,而不是上一篇中的EhCacheCacheManager
  2. 第二次查询的时候,没有输出SQL语句,所以是走的缓存获取

以上就是关于Spring Boot 2.x基础教程:使用集中式缓存Redis的相关介绍了,希望对大家有所帮助。

偷偷告诉你5个好用的Pandas技巧

thbcm阅读(426)

在工作中,效率是一个很关键的因素,一个人做事的效率高低,决定了花费时间的多少。所以当我们项目涉及到一些基础编码时,使用pandas库就能大大的节省你的时间,提高你的工作效率。

Pandas是一个开源包。它有助于用Python语言执行数据分析和数据操作。此外,它还为我们提供了灵活的数据结构。

接下来带你们了解一下pandas的几个实用技巧

1.行的条件选择

首先,数据探索是必要步骤。Pandas为进行各种分析提供了一种快速简便的方法。其中一个非常重要的技巧是根据条件选择行或过滤数据。

行的条件选择可以基于由逻辑运算符分隔的单个语句中的单个条件或多个条件。

例如,我使用一个关于贷款预测的数据集。

我们将挑选一排还没有毕业、收入低于5400英镑的客户。让我们看看我们该怎么做。

import pandas as pd
data = pd.read_csv('../Data/loan_train.csv')
data.head()
data2 = data.loc[(data['Education'] == 'Not Graduate') & (data['ApplicantIncome'] <= 5400)]
data2

注意:记住把每个条件放在括号内。

2.数据的存储

数据可以有两种类型-连续的和离散的,这取决于我们的分析要求。有时我们不需要连续变量中的精确值,但需要它所属的群体。

例如,你的数据中有一个连续变量,年龄。但你需要一个年龄组来进行分析,比如儿童、青少年、成人、老年人。实际上,Binning非常适合解决我们这里的问题。

为了执行Binning,我们使用cut()函数。这对于从连续变量到离散变量非常有用。

import pandas as pd


df = pd.read_csv('titanic.csv')
from sklearn.utils import shuffle


# 随机化
df = shuffle(df, random_state = 42)


df.head()


bins = [0,4,17,65,99]
labels =['Toddler','Child','Adult','Elderly']


category = pd.cut(df['Age'], bins = bins, labels = labels)


df.insert(2, 'Age Group', category)


df.head()


df['Age Group'].value_counts()


df.isnull().sum()

3.分组数据

这种操作在数据科学家和分析师的日常生活中经常执行。Pandas提供了一个基本的函数来执行数据分组,即Groupby

Groupby操作包括根据特定条件拆分对象,应用函数,然后组合结果。

让我们再看一次贷款预测数据集,假设我想看看给来自不同财产领域的人的平均贷款额,比如农村、半城市和城市。花点时间来理解这个问题陈述并思考如何解决它。

嗯,Pandasgroupby可以非常有效地解决这个问题。首先根据属性区域划分数据。其次,我们将mean()函数应用于每个类别。最后,我们将它们组合在一起,并将其打印为新的数据帧。

#导入数据集
import pandas as pd


df = pd.read_csv('../Data/loan_train.csv')
df.head()


# 男女平均收入
df.groupby(['Gender'])[['ApplicantIncome']].mean()


# 平均贷款金额不同的财产地区,如城市,农村
df.groupby(['Property_Area'])[['LoanAmount']].mean()


# 比较不同教育背景的贷款状况
df.groupby(['Education'])[['Loan_Status']].count()

4.Pandas map

map是另一个提供高度灵活性和实际应用的重要操作。

Pandas map()用于根据输入对应关系将序列中的每个值映射到其他值。实际上,这个输入可以是一个序列、字典,甚至是一个函数。

让我们举一个有趣的例子。我们有一个虚拟的雇员数据集。此数据集由以下列组成–姓名、年龄、职业、城市。

现在需要添加另一列,说明相应的状态。你会怎么做?如果数据集的范围是10行,你可以手动执行,但是如果有数千行呢?使用Pandas map会更有利。

#样本数据
data = {'name': ['A', 'B', 'C', 'D', 'E'], 
        'age': [22, 26, 33, 44, 50],
        'profession' : ['data engineer', 'data scientist', 'entrepreneur', 'business analyst', 'self-employed'], 
        'city': ['Gurgaon', 'Bangalore', 'Gurgaon', 'Pune', 'New Delhi']}


df = pd.DataFrame(data)
df


# 城市与州
map_city_to_states = { 'Gurgaon' : 'Haryana', 
                  'Bangalore' : 'Karnataka', 
                  'Pune' : 'Maharashtra', 
                  'New Delhi' : 'Delhi'}


# 将城市列映射为州
df['state'] = df['city'].map(map_city_to_states)
df

5.Pandas DataFrame的条件格式化

这是我最喜欢的Pandas技巧之一。这个技巧让我有能力直观地定位特定条件下的数据。

可以使用Pandasstyle属性将条件格式应用于数据框。事实上,条件格式是根据某种条件对数据帧应用视觉样式的操作。

虽然Pandas提供了大量的操作,但我将在这里向你展示一个简单的操作。例如,我们有对应于每个销售人员的销售数据。我想查看的是销售价值高于80的。

import pandas as pd


data = pd.read_excel("../Data/salesman_performance.xlsx")
data


data.style


def highlight_green(sales):
    color = 'green' if sales > 80 else 'black'
    return 'color: %s' % color


formatting = data.iloc[:,1:6].style.applymap(highlight_green)
formatting

(推荐教程:Pandas中文教程

结尾

以上就是关于Pandas的5个实用技巧的介绍了,希望这些技巧能帮大家更好更快的完成工作。

使用canal+Kafka进行数据库同步操作

thbcm阅读(396)

平时工作中数据库是我们经常使用的,在微服务拆分的架构中,各服务拥有自己的数据库,所以常常会遇到服务之间数据通信的问题。比如,B 服务数据库的数据来源于A服务的数据库;A 服务的数据有变更操作时,需要同步到 B 服务中。

第一种解决方案:

在代码逻辑中,有相关 A 服务数据写操作时,以调用接口的方式,调用 B 服务接口,B 服务再将数据写到新的数据库中。这种方式看似简单,但其实“坑”很多。在 A 服务代码逻辑中会增加大量这种调用接口同步的代码,增加了项目代码的复杂度,以后会越来越难维护。并且,接口调用的方式并不是一个稳定的方式,没有重试机制,没有同步位置记录,接口调用失败了怎么处理,突然的大量接口调用会产生的问题等,这些都要考虑并且在业务中处理。这里会有不少工作量。想到这里,就将这个方案排除了。

(推荐课程:SQL教程)

第二种解决方案:

通过数据库的binlog进行同步。这种解决方案,与 A 服务是独立的,不会和 A 服务有代码上的耦合。可以直接 TCP连接进行传输数据,优于接口调用的方式。 这是一套成熟的生产解决方案,也有不少binlog同步的中间件工具,所以我们关注的就是哪个工具能够更好的构建稳定、性能满足且易于高可用部署的方案。

经过调研,我们选择了canalcanal是阿里巴巴 MySQL binlog 增量订阅&消费组件,已经有在生产上实践的例子,并且方便的支持和其他常用的中间件组件组合,比如kafkaelasticsearch等,也有了canal-go go语言的client库,满足我们在go上的需求,其他具体内容参阅canalgithub主页。

原理简图

![原理简图](https://atts.w3cschool.cn/attachments/image/20200817/1597643005519402.jpg “原理简图”)

![原理简图](https://atts.w3cschool.cn/attachments/image/20200817/1597643026794359.jpg “原理简图”)

OK,开始干!现在要将 A 数据库的数据变更同步到 B 数据库。根据wiki很快就用docker跑起了一台canal-server服务,直接用canal-gocanal-client代码逻辑。用canal-go直接连canal-servercanal-servercanal-client之间是Socket来进行通信的,传输协议是TCP,交互协议采用的是 Google Protocol Buffer 3.0

工作流程

  1. Canal连接到 A 数据库,模拟slave
  2. canal-clientCanal建立连接,并订阅对应的数据库表
  3. A 数据库发生变更写入到binlogCanal向数据库发送dump请求,获取binlog并解析,发送解析后的数据给canal-client
  4. canal-client收到数据,将数据同步到新的数据库

Protocol Buffer的序列化速度还是很快的。反序列化后得到的数据,是每一行的数据,按照字段名和字段的值的结构,放到一个数组中 代码简单示例:

func Handler(entry protocol.Entry) { var keys []string rowChange := &protocol.RowChange{} proto.Unmarshal(entry.GetStoreValue(), rowChange) if rowChange != nil { eventType := rowChange.GetEventType() for _, rowData := range rowChange.GetRowDatas() { // 遍历每一行数据 if eventType == protocol.EventType_DELETE || eventType == protocol.EventType_UPDATE { columns := rowData.GetBeforeColumns() // 得到更改前的所有字段属性 } else if eventType == protocol.EventType_INSERT { columns := rowData.GetAfterColumns() // 得到更后前的所有字段属性 } …… } } }

遇到的问题

为了高可用和更高的性能,我们会创建多个canal-client构成一个集群,来进行解析并同步到新的数据库。这里就出现了一个比较重要的问题,如何保证canal-client集群解析消费binlog的顺序性呢?

我们使用的binlogrow模式。每一个写操作都会产生一条binlog日志。 举个简单的例子:插入了一条 a 记录,并且立马修改 a 记录。这样会有两个消息发送给canal-client,如果由于网络等原因,更新的消息早于插入的消息被处理了,还没有插入记录,更新操作的最后效果是失败的。

怎么办呢? canal可以和消息队列组合呀!而且支持kafkarabbitmqrocketmq多种选择,如此优秀。我们在消息队列这层来实现消息的顺序性。

选择canal+kafka方案

我们选择了消息队列的业界标杆: kafka UCloud提供了kafkarocketMQ消息队列产品服务,使用它们能够快速便捷的搭建起一套消息队列系统。加速开发,方便运维。

下面就让我们来一探究竟:

1.选择kafka消息队列产品,并申请开通

![kafka消息队列](https://atts.w3cschool.cn/attachments/image/20200817/1597643207499951.jpg “kafka消息队列”)

2.开通完成后,在管理界面,创建kafka集群,根据自身需求,选择相应的硬件配置

![硬件配置](https://atts.w3cschool.cn/attachments/image/20200817/1597643247605810.jpg “硬件配置”)

3.一个kafka + ZooKeeper集群就搭建出来了,给力!

![kafka+ZooKeeper集群](https://atts.w3cschool.cn/attachments/image/20200817/1597643275823817.jpg “kafka+ZooKeeper集群”)

并且包含了节点管理、Topic管理、Consumer Group管理,能够非常方便的直接在控制台对配置进行修改

监控视图方面,监控的数据包括kafka生成和消费QPS,集群监控,ZooKeeper的监控。能够比较完善的提供监控指标。

![监控指标](https://atts.w3cschool.cn/attachments/image/20200817/1597643316579478.jpg “监控指标”)

![监控指标](https://atts.w3cschool.cn/attachments/image/20200817/1597643347799100.jpg “监控指标”)

![监控指标](https://atts.w3cschool.cn/attachments/image/20200817/1597643363690805.jpg “监控指标”)

canal的kafka配置

canal配上kafka也非常的简单。 vi /usr/local/canal/conf/canal.properties

# 可选项: tcp(默认), kafka, RocketMQ
canal.serverMode = kafka
# ...
# kafka/rocketmq 集群配置: 192.168.1.117:9092,192.168.1.118:9092,192.168.1.119:9092
canal.mq.servers = 127.0.0.1:9002
canal.mq.retries = 0
# flagMessage模式下可以调大该值, 但不要超过MQ消息体大小上限
canal.mq.batchSize = 16384
canal.mq.maxRequestSize = 1048576
# flatMessage模式下请将该值改大, 建议50-200
canal.mq.lingerMs = 1
canal.mq.bufferMemory = 33554432
# Canal的batch size, 默认50K, 由于kafka最大消息体限制请勿超过1M(900K以下)
canal.mq.canalBatchSize = 50
# Canal get数据的超时时间, 单位: 毫秒, 空为不限超时
canal.mq.canalGetTimeout = 100
# 是否为flat json格式对象
canal.mq.flatMessage = false
canal.mq.compressionType = none
canal.mq.acks = all
# kafka消息投递是否使用事务
canal.mq.transaction = false


# mq config
canal.mq.topic=default
# dynamic topic route by schema or table regex
#canal.mq.dynamicTopic=mytest1.user,mytest2\\\\..*,.*\\\\..*
canal.mq.dynamicTopic=mydatabase.mytable
canal.mq.partition=0
# hash partition config
canal.mq.partitionsNum=3
canal.mq.partitionHash=mydatabase.mytable

解决顺序消费问题

看到下面这一行配置

canal.mq.partitionHash=mydatabase.mytable

我们配置了kafkapartitionHash,并且我们一个Topic就是一个表。这样的效果就是,一个表的数据只会推到一个固定的partition中,然后再推给consumer进行消费处理,同步到新的数据库。通过这种方式,解决了之前碰到的binlog日志顺序处理的问题。这样即使我们部署了多个kafka consumer端,构成一个集群,这样consumer从一个partition消费消息,就是消费处理同一个表的数据。这样对于一个表来说,牺牲掉了并行处理,不过个人觉得,凭借kafka的性能强大的处理架构,我们的业务在kafka这个节点产生瓶颈并不容易。并且我们的业务目的不是实时一致性,在一定延迟下,两个数据库保证最终一致性。

(推荐微课:SQL微课)

下图是最终的同步架构,我们在每一个服务节点都实现了集群化。全都跑在UCloudUK8s服务上,保证了服务节点的高可用性。

canal也是集群换,但是某一时刻只会有一台canal在处理binlog,其他都是冗余服务。当这台canal服务挂了,其中一台冗余服务就会切换到工作状态。同样的,也是因为要保证binlog的顺序读取,所以只能有一台canal在工作。

![最终同步架构](https://atts.w3cschool.cn/attachments/image/20200817/1597643437868571.jpg “最终同步架构”)

并且,我们还用这套架构进行缓存失效的同步。我们使用的缓存模式是:Cache-Aside。同样的,如果在代码中数据更改的地方进行缓存失效操作,会将代码变得复杂。所以,在上述架构的基础上,将复杂的触发缓存失效的逻辑放到kafka-client端统一处理,达到一定解耦的目的。

以上就是关于使用canal + Kafka进行数据库同步操作的相关介绍了,希望对大家有所帮助。

List 集合去重的 3 种方法

thbcm阅读(473)

问题由来

在实际开发的时候,我们经常会碰到这么一个困难:一个集合容器里面有很多重复的对象,里面的对象没有主键,但是根据业务的需求,实际上我们需要根据条件筛选出没有重复的对象。

比较暴力的方法,就是根据业务需求,通过两层循环来进行判断,没有重复的元素就加入到新集合中,新集合中已经有的元素就跳过。

操作例子如下,创建一个实体对象PenBean,代码如下:

/**
 * 笔实体
 */
public class PenBean {


    /**类型*/
    private String type;


    /**颜色*/
    private String color;


    //... 省略 setter 和 getter


    public PenBean(String type, String color) {
        this.type = type;
        this.color = color;
    }


    @Override
    public String toString() {
        return "PenBean{" +
                "type='" + type + '\'' +
                ", color='" + color + '\'' +
                '}';
    }
}

测试 demo,如下:

public static void main(String[] args) {
    //添加信息,PenBean中没有主键
    List<PenBean> penBeanList = new ArrayList<PenBean>();
    penBeanList.add(new PenBean("铅笔","black"));
    penBeanList.add(new PenBean("铅笔","white"));
    penBeanList.add(new PenBean("铅笔","black"));
    penBeanList.add(new PenBean("中性笔","white"));
    penBeanList.add(new PenBean("中性笔","white"));


    //新数据
    List<PenBean> newPenBeanList = new ArrayList<PenBean>();
    //传统重复判断
    for (PenBean penBean : penBeanList) {
        if(newPenBeanList.isEmpty()){
            newPenBeanList.add(penBean);
        }else{
            boolean isSame = false;
            for (PenBean newPenBean : newPenBeanList) {
                //依靠type、color来判断,是否有重复元素
                //如果新集合包含元素,直接跳过
                if(penBean.getType().equals(newPenBean.getType()) && penBean.getColor().equals(newPenBean.getColor())){
                    isSame = true;
                    break;
                }
            }
            if(!isSame){
                newPenBeanList.add(penBean);
            }
        }
    }

一般处理数组类型的对象时,可以通过这种方法来对数组元素进行去重操作,以筛选出没有包含重复元素的数组。

那有没有更加简洁的写法呢?

答案肯定是有的,List中的contains()方法就是!

(推荐教程:Java教程

1、利用list中contains方法去重

在使用contains()之前,必须要对PenBean类重写equals()方法,为什么要这么做?等会会详细解释!

我们先在PenBean类中重写equals()方法,内容如下:

@Override
public boolean equals(Object o) {
    if (this == o) return true;
    if (o == null || getClass() != o.getClass()) return false;
    PenBean penBean = (PenBean) o;
   //当type、color 内容都相等的时候,才返回true
    return Objects.equals(type, penBean.type) &&
            Objects.equals(color, penBean.color);
}

修改测试 demo,如下:

public static void main(String[] args) {
    //添加信息
    List<PenBean> penBeanList = new ArrayList<PenBean>();
    penBeanList.add(new PenBean("铅笔","black"));
    penBeanList.add(new PenBean("铅笔","white"));
    penBeanList.add(new PenBean("铅笔","black"));
    penBeanList.add(new PenBean("中性笔","white"));
    penBeanList.add(new PenBean("中性笔","white"));


    //新数据
    List<PenBean> newPenBeanList = new ArrayList<PenBean>();
    //使用contain判断,是否有相同的元素
    for (PenBean penBean : penBeanList) {
        if(!newPenBeanList.contains(penBean)){
            newPenBeanList.add(penBean);
        }
    }


    //输出结果
    System.out.println("=========新数据======");
    for (PenBean penBean : newPenBeanList) {
        System.out.println(penBean.toString());
    }
}

输出结果如下:

=========新数据======
PenBean{type='铅笔', color='black'}
PenBean{type='铅笔', color='white'}
PenBean{type='中性笔', color='white'}

如果PenBean对象不重写equals()contains()方法的都是false!新数据与源数据是一样的,并不能达到我们想要除去重复元素的目的

那么contains()是怎么做到,判断一个集合里面有相同的元素呢?

我们打开ArrayListcontains()方法,源码如下:

public boolean contains(Object o) {
    return indexOf(o) >= 0;
}

找到indexOf(o)方法,继续往下看,源码如下:

public int indexOf(Object o) {
    if (o == null) {
        for (int i = 0; i < size; i++)
            if (elementData[i]==null)
                return i;
    } else {
        for (int i = 0; i < size; i++)
           //对象通过 equals 方法,判断是否相同
            if (o.equals(elementData[i]))
                return i;
    }
    return -1;
}

此时,非常清晰了,如果传入的对象是null,for 循环判断数组中的元素是否有null,如果有就返回下标;如果传入的对象不是null,通过对象的equals()方法,for 循环判断是否有相同的元素,如果有就返回下标!

如果是数组返回的下标,肯定是大于0,否则返回-1!

这就是为什么在List中使用contains()方法,对象需要重写equals()方法的原因!

2、java 8中去重操作

当然,有些朋友可能会想到JDK1.8中的流式写法,例如 jdk1.8 中的集合元素去重写法如下:

public static void main(String[] args) {
    //添加信息
    List<PenBean> penBeanList = new ArrayList<PenBean>();
    penBeanList.add(new PenBean("铅笔","black"));
    penBeanList.add(new PenBean("铅笔","white"));
    penBeanList.add(new PenBean("铅笔","black"));
    penBeanList.add(new PenBean("中性笔","white"));
    penBeanList.add(new PenBean("中性笔","white"));


    //使用java8新特性stream进行List去重
    List<PenBean> newPenBeanList = penBeanList.stream().distinct().collect(Collectors.toList());


    //输出结果
    System.out.println("=========新数据======");
    for (PenBean penBean : newPenBeanList) {
        System.out.println(penBean.toString());
    }
}

利用 jdk1.8 中提供的Stream.distinct()列表去重,Stream.distinct()使用hashCode()equals()方法来获取不同的元素,因此使用这种写法,对象需要重写hashCode()equals()方法!

PenBean对象重写hashCode()方法,代码如下:

@Override
public int hashCode() {
    return Objects.hash(type, color);
}

在运行测试demo,结果如下:

=========新数据======
PenBean{type='铅笔', color='black'}
PenBean{type='铅笔', color='white'}
PenBean{type='中性笔', color='white'}

即可实现集合元素的去重操作!

那为什么当我们使用String类型的对象作为集合元素时,没有重写呢?

因为 java 中String原生类,已经重写好了,源码如下:

public final class String
implements java.io.Serializable, Comparable<String>, CharSequence {

 
 @Override
 public boolean equals(Object anObject) {
        if (this == anObject) {
            return true;
        }
        if (anObject instanceof String) {
            String anotherString = (String)anObject;
            int n = value.length;
            if (n == anotherString.value.length) {
                char v1[] = value;
                char v2[] = anotherString.value;
                int i = 0;
                while (n-- != 0) {
                    if (v1[i] != v2[i])
                        return false;
                    i++;
                }
                return true;
            }
        }
        return false;
    }

 
 @Override
 public int hashCode() {
    int h = hash;
    if (h == 0 && value.length > 0) {
        char val[] = value;


        for (int i = 0; i < value.length; i++) {
            h = 31 * h + val[i];
        }
        hash = h;
    }
    return h;
}
}

(推荐微课:Java微课

3、HashSet去重操作

在上面的分享中,我们介绍了 List 的集合去重操作!其中网友还提到了HashSet可以实现元素的去重!

的确,HashSet集合天然支持元素不重复!

实践代码如下!

还是先创建一个对象PenBean,同时重写Object中的equals()hashCode()方法,如下:

/**
 * 笔实体
 */
public class PenBean {
    /**类型*/
    private String type;
    /**颜色*/
    private String color;
    //... 省略 setter 和 getter
    public PenBean(String type, String color) {
        this.type = type;
        this.color = color;
    }
    @Override
    public String toString() {
        return "PenBean{" +
                "type='" + type + '\'' +
                ", color='" + color + '\'' +
                '}';
    }

 
 @Override
 public boolean equals(Object o) {
      if (this == o) return true;
      if (o == null || getClass() != o.getClass()) return false;
      PenBean penBean = (PenBean) o;
      //当type、color 内容都相等的时候,才返回true
      return Objects.equals(type, penBean.type) &&
          Objects.equals(color, penBean.color);
 }

 
 @Override
 public int hashCode() {
    return Objects.hash(type, color);
 }

  
}

创建测试 demo,如下:

public static void main(String[] args) {
    //添加信息
    List<PenBean> penBeanList = new ArrayList<PenBean>();
    penBeanList.add(new PenBean("铅笔","black"));
    penBeanList.add(new PenBean("铅笔","white"));
    penBeanList.add(new PenBean("铅笔","black"));
    penBeanList.add(new PenBean("中性笔","white"));
    penBeanList.add(new PenBean("中性笔","white"));


    //新数据
    List<PenBean> newPenBeanList = new ArrayList<PenBean>();
    //set去重
    HashSet<PenBean> set = new HashSet<>(penBeanList);
    newPenBeanList.addAll(set);


    //输出结果
    System.out.println("=========新数据======");
    for (PenBean penBean : newPenBeanList) {
        System.out.println(penBean.toString());
    }
}

输出结果如下:

=========新数据======
PenBean{type='铅笔', color='white'}
PenBean{type='铅笔', color='black'}
PenBean{type='中性笔', color='white'}

很明细,返回的新集合没有重复元素!

HashSet是怎么做的的呢?

打开HashSet的源码,查看我们传入的构造方法如下:

public HashSet(Collection<? extends E> c) {
    map = new HashMap<>(Math.max((int) (c.size()/.75f) + 1, 16));
    addAll(c);
}

很显然,首先创建了一个HashMap对象,然后调用addAll()方法,继续往下看这个方法!

public boolean addAll(Collection<? extends E> c) {
    boolean modified = false;
    for (E e : c)
        if (add(e))
            modified = true;
    return modified;
}

首先遍历List中的元素,然后调用add()方法,这个方法,源码如下:

public boolean add(E e) {
    return map.put(e, PRESENT)==null;
}

其实,就是向HashMap对象中插入元素,其中PRESENT是一个new Object()常量!

private static final Object PRESENT = new Object();

到这里就基本很清楚了,向HashSet中添加元素,其实等同于

Map<Object,Object> map = new HashMap<Object,Object>();
map.put(e,new Object);//e表示要插入的元素

其中插入的元素 e,就是HashMap中的key

我们知道HashMap,是通过equals()hashCode()来判断插入的key是否为同一个key,因此,当我们对PenBean对象进行重写equals()hashCode()时,保证判断是同一个key时,就可以达到元素去重的目的!

(推荐内容:Java面试基础题

最后,对已经去重的集合HashSet,再通过ArrayList中的addAll()方法进行包装,即可得到我们想要的不包含重复元素的数据!

文章来源于:mp.weixin.qq.com/s/LBjfarlK5Qv-A85Hey0btA
作者:鸭血粉丝

以上就是关于List集合去重的 3 种方法的相关介绍,希望对大家有所帮助。

Python实用小技巧,30个Python极简代码

thbcm阅读(425)

怎么学习编程最快,当然是各种小项目实战,只有自己去动脑想,动手做,印象才是最深刻的。本文是 30 个极简任务,初学者可以尝试着自己实现;本文同样也是 30 段代码,Python 开发者也可以看看是不是有没想到的用法。

Python 是机器学习最广泛采用的编程语言,它最重要的优势在于编程的易用性。如果读者对基本的 Python 语法已经有一些了解,那么这篇文章可能会给你一些启发。作者简单概览了 30 段代码,它们都是平常非常实用的技巧,我们只要花几分钟就能从头到尾浏览一遍。

1.重复元素判定

以下方法可以检查给定列表是不是存在重复元素,它会使用 set() 函数来移除所有重复元素。

def all_unique(lst):  
return len(lst)== len(set(lst))  
x = [1,1,2,2,3,2,3,4,5,6]  
y = [1,2,3,4,5]  
all_unique(x) # False  
all_unique(y) # True 

2.字符元素组成判定

检查两个字符串的组成元素是不是一样的。

from collections import Counter  
def anagram(first, second):  
return Counter(first) == Counter(second)  
anagram("abcd3", "3acdb") # True 

3.内存占用

import sys  
variable = 30  
print(sys.getsizeof(variable)) # 24 

4.字节占用

下面的代码块可以检查字符串占用的字节数。

def byte_size(string):  
return(len(string.encode('utf-8')))  
byte_size('') # 4  
byte_size('Hello World') # 11 

5.打印 N 次字符串

该代码块不需要循环语句就能打印 N 次字符串。

n = 2  
s ="Programming"  
print(s * n)  
# ProgrammingProgramming 

6.大写第一个字母

以下代码块会使用 title() 方法,从而大写字符串中每一个单词的首字母。

s = "programming is awesome"  
print(s.title())  
# Programming Is Awesome 

7.分块

给定具体的大小,定义一个函数以按照这个大小切割列表。

from math import ceil  
def chunk(lst, size):  
return list(  
map(lambda x: lst[x * size:x * size + size],  
list(range(0, ceil(len(lst) / size)))))  
chunk([1,2,3,4,5],2)  
# [[1,2],[3,4],5] 

8.压缩

这个方法可以将布尔型的值去掉,例如(False,None,0,“”),它使用 filter() 函数。

def compact(lst):  
return list(filter(bool, lst))  
compact([0, 1, False, 2, '', 3, 'a', 's', 34])  
# [ 1, 2, 3, 'a', 's', 34 ] 

9.解包

如下代码段可以将打包好的成对列表解开成两组不同的元组。

array = [['a', 'b'], ['c', 'd'], ['e', 'f']]  
transposed = zip(*array)  
print(transposed)  
# [('a', 'c', 'e'), ('b', 'd', 'f')] 

10.链式对比

我们可以在一行代码中使用不同的运算符对比多个不同的元素。

a = 3  
print( 2 < a < 8) # True  
print(1 == a < 2) # False 

(推荐教程:python教程

11.逗号连接

下面的代码可以将列表连接成单个字符串,且每一个元素间的分隔方式设置为了逗号。

hobbies = ["basketball", "football", "swimming"]  
print("My hobbies are: " + ", ".join(hobbies))  
# My hobbies are: basketball, football, swimming 

12.元音统计

以下方法将统计字符串中的元音 (‘a’, ‘e’, ‘i’, ‘o’, ‘u’) 的个数,它是通过正则表达式做的。

import re  
def count_vowels(str):  
return len(len(re.findall(r'[aeiou]', str, re.IGNORECASE)))  
count_vowels('foobar') # 3  
count_vowels('gym') # 0 

13.首字母小写

如下方法将令给定字符串的第一个字符统一为小写。

def decapitalize(string):  
return str[:1].lower() + str[1:]  
decapitalize('FooBar') # 'fooBar'  
decapitalize('FooBar') # 'fooBar' 

14.展开列表

该方法将通过递归的方式将列表的嵌套展开为单个列表。

def spread(arg):  
ret = []  
for i in arg: 
if isinstance(i, list):  
ret.extend(i)  
else:  
ret.append(i)  
return ret  
def deep_flatten(lst):  
result = []  
result.extend(  
spread(list(map(lambda x: deep_flatten(x) if type(x) == list else x, lst))))  
return result  
deep_flatten([1, [2], [[3], 4], 5]) # [1,2,3,4,5] 

15.列表的差

该方法将返回第一个列表的元素,其不在第二个列表内。如果同时要反馈第二个列表独有的元素,还需要加一句 set_b.difference(set_a)

def difference(a, b):  
setset_a = set(a)  
setset_b = set(b) 
comparison = set_a.difference(set_b)  
return list(comparison)  
difference([1,2,3], [1,2,4]) # [3] 

16.通过函数取差

如下方法首先会应用一个给定的函数,然后再返回应用函数后结果有差别的列表元素。

def difference_by(a, b, fn):  
b = set(map(fn, b))  
return [item for item in a if fn(item) not in b]  
from math import floor  
difference_by([2.1, 1.2], [2.3, 3.4],floor) # [1.2]  
difference_by([{ 'x': 2 }, { 'x': 1 }], [{ 'x': 1 }], lambda v : v['x'])  
# [ { x: 2 } ] 

17.链式函数调用

你可以在一行代码内调用多个函数。

def add(a, b):  
return a + b  
def subtract(a, b):  
return a - b  
a, b = 4, 5  
print((subtract if a > b else add)(a, b)) # 9 

18.检查重复项

如下代码将检查两个列表是不是有重复项。

def has_duplicates(lst):  
return len(lst) != len(set(lst))  
x = [1,2,3,4,5,5]  
y = [1,2,3,4,5]  
has_duplicates(x) # True  
has_duplicates(y) # False

19.合并两个字典

下面的方法将用于合并两个字典。

def merge_two_dicts(a, b):  
c = a.copy() # make a copy of a   
c.update(b) # modify keys and values of a with the once from b  
return c  
a={'x':1,'y':2}  
b={'y':3,'z':4}  
print(merge_two_dicts(a,b))  
#{'y':3,'x':1,'z':4} 

Python 3.5 或更高版本中,我们也可以用以下方式合并字典:

def merge_dictionaries(a, b)  
return {**a, **b}  
a = { 'x': 1, 'y': 2}  
b = { 'y': 3, 'z': 4}  
print(merge_dictionaries(a, b))  
# {'y': 3, 'x': 1, 'z': 4} 

20.将两个列表转化为字典

如下方法将会把两个列表转化为单个字典。

def to_dictionary(keys, values):  
return dict(zip(keys, values))  
keys = ["a", "b", "c"]  
values = [2, 3, 4]  
print(to_dictionary(keys, values))  
#{'a': 2, 'c': 4, 'b': 3} 

21.使用枚举

我们常用 For 循环来遍历某个列表,同样我们也能枚举列表的索引与值。

list = ["a", "b", "c", "d"]  
for index, element in enumerate(list):   
print("Value", element, "Index ", index, )  
# ('Value', 'a', 'Index ', 0)  
# ('Value', 'b', 'Index ', 1)  
#('Value', 'c', 'Index ', 2)  
# ('Value', 'd', 'Index ', 3) 

22.执行时间

如下代码块可以用来计算执行特定代码所花费的时间。

import time  
start_time = time.time()  
a = 1 
b = 2  
c = a + b  
print(c) #3  
end_time = time.time()  
total_time = end_time - start_time  
print("Time: ", total_time)  
# ('Time: ', 1.1205673217773438e-05)  

23.Try else

我们在使用 try/except 语句的时候也可以加一个 else 子句,如果没有触发错误的话,这个子句就会被运行。

try:  
2*3  
except TypeError:  
print("An exception was raised")  
else:  
print("Thank God, no exceptions were raised.")  
#Thank God, no exceptions were raised. 

24.元素频率

下面的方法会根据元素频率取列表中最常见的元素。

def most_frequent(list):  
return max(set(list), key = list.count)  
list = [1,2,1,2,3,2,1,4,2]  
most_frequent(list) 

25.回文序列

以下方法会检查给定的字符串是不是回文序列,它首先会把所有字母转化为小写,并移除非英文字母符号。最后,它会对比字符串与反向字符串是否相等,相等则表示为回文序列。

def palindrome(string):  
from re import sub  
s = sub('[\W_]', '', string.lower())  
return s == s[::-1]  
palindrome('taco cat') # True 

26.不使用 if-else 的计算子

这一段代码可以不使用条件语句就实现加减乘除、求幂操作,它通过字典这一数据结构实现:

import operator  
action = {  
"+": operator.add,  
"-": operator.sub, 
"/": operator.truediv,  
"*": operator.mul,  
"**": pow  
}  
print(action['-'](50, 25)) # 25 

27.Shuffle

该算法会打乱列表元素的顺序,它主要会通过 Fisher-Yates算法对新列表进行排序:

from copy import deepcopy  
from random import randint  
def shuffle(lst):  
temp_lst = deepcopy(lst)  
m = len(temp_lst)  
while (m):  
m -= 1  
i = randint(0, m)  
temp_lst[m], temp_lst[i] = temp_lst[i], temp_lst[m]  
return temp_lst  
foo = [1,2,3]  
shuffle(foo) # [2,3,1] , foo = [1,2,3] 

28.展开列表

将列表内的所有元素,包括子列表,都展开成一个列表。

def spread(arg):  
ret = []  
for i in arg:if isinstance(i, list):  
ret.extend(i) 
else:  
ret.append(i)  
return ret  
spread([1,2,3,[4,5,6],[7],8,9]) # [1,2,3,4,5,6,7,8,9] 

29.交换值

不需要额外的操作就能交换两个变量的值。

def swap(a, b):  
return b, a  
a, b = -1, 14  
swap(a, b) # (14, -1)  
spread([1,2,3,[4,5,6],[7],8,9]) # [1,2,3,4,5,6,7,8,9] 

30.字典默认值

通过Key 取对应的 Value 值,可以通过以下方式设置默认值。如果 get() 方法没有设置默认值,那么如果遇到不存在的 Key,则会返回 None

d = {'a': 1, 'b': 2}  
print(d.get('c', 3)) # 3  

(推荐微课:python3基础微课

以上就是关于Python实用小技巧,30个Python极简代码的相关介绍了,希望对大家有所帮助。

联系我们