Go 1.14.7 和 Go 1.13.15 更新;Go1.15 RC2 发布

thbcm阅读(332)

Go语言这次依旧还是小版本更新,包括 Go 1.14.7Go 1.13.15,主要解决最近报告的安全问题。为什么Go 每次更新都是发布两个版本?这是 Go 的惯例,会同时维护两个版本的更新,比如现在是 Go1.14Go1.13,如果 Go1.15 发布了,之后就会变成 Go1.15Go1.14

(推荐教程:Go Web 编程

因为涉及到安全问题,建议所有用户都进行相应版本更新(如果不确定哪个版本,请选择 Go 1.14.7)。

涉及到的具体问题如下:

  • encoding/binaryReadUvarintReadVarint 可以从无效输入中读取无限数量的字节。对 ReadUvarintReadVarint 的某些无效输入可能导致这些函数在返回错误之前从 ByteReader 参数读取无限数量的字节。当调用者直接从网络读取数据时,这可能导致处理的输入超出预期,并且依赖于 ReadUvarintReadVarint 甚至仅从无效输入中仅消耗少量的有限字节数。在更新后,ReadUvarintReadVarint 现在总是在消耗了一定数量的字节(特别是 MaxVarintLen64,即 10)之后返回。返回的结果没有改变;这些函数仅检测并返回一些错误,而无需读取过多的输入。具体 issue 见:https://github.com/golang/go/issues/40618

(推荐微课:Go 基础微课

在刚刚发布的 Go1.15 RC2 版本中,也修复了该问题。关于 Go1.15 的更多信息可以参见文档:https://tip.golang.org/doc/go1.15, 已经8月份了,Go1.15 正式发布应该不远了。

八大理由告诉你,为什么学python

thbcm阅读(357)

学习python的人有很多,你们是否询问过自己:“我为什么要学习python语言呢”,编程语言那么多,你选择了python,这是为什么呢?

Python是世界上公认的编程语言中需求最大和最流行的编程语言之一。在最新的StackOverflow调查中,Python已经超过了C语言C++Java,登上榜首。这就是为什么许多程序员和新手开发人员更愿意学习Python,并且认为Python语言是最受欢迎的编程语言之一。

为什么应该学习Python?

当你从基础知识开始学习,一切碎片化的知识都能变得充实。因此,在了解学习Python的原因之前,我们先来介绍一下Python,以便了解它作为编程语言的强大功能。

(推荐教程:python教程

1991年,吉多·范罗苏姆推出了Python。在开发这门语言时,他脑海中有一些想法,而且他成功地开发了一种编程语言,可以用于:

  • Web开发
  • 软件开发
  • 系统脚本
  • 数学问题

Python的特点

  • Python能够在不同的平台上无缝工作,比如MacWindowsLinuxRaspberry Pi等等。
  • 因为Python是在解释器系统上执行的,所以它可以实现快速的原型制作。也就是说,你可以在编写代码的瞬间运行它。
  • Python的语法就像英语一样,简单且易于理解(与其他语言相比)。这也使得开发人员工作更快,因为这种语言可以用更少的代码行进行编写。
  • 无论函数式还是程式,Python都可以满足程序员的需求。

Python的应用领域有哪些?

  • 快速的原型制作
  • 用于生产就绪的软件开发
  • 在软件中开发工作流程
  • 快速的原型制作
  • 用于生产就绪的软件开发
  • 在软件中开发工作流程
  • 当你想读取或更改/改进文件时,可以将Python连接到数据库系统
  • 它可以用于执行复杂的数学运算和管理大数据
  • 在服务器上用于建立网站应用程序

Python是一门通用语言,可以在许多项目、应用领域和函数中使用它。Python的主要应用领域有:

  • Web开发
  • 系统自动化及管理
  • 电脑绘图
  • 基本游戏开发
  • 安全和渗透测试
  • 数据科学
  • 金融和贸易
  • 科学与数学计算
  • 通用和特定于应用程序的脚本
  • 测绘及地理(GIS软件)

学习Python的8大数据驱动原因

学习Python有很多原因,让我用可靠的数据给你答案。

(推荐微课:python3基础微课

1.Python对初学者很友好

众所周知,Python是一门对初学者友好的语言,它的语法清晰易读,Python几乎没有不必要的标准化文档,这使得初学者和专家都可以专注于手头的工作,而不是代码。

此外,Python的可读性和效率使其成为顶尖大学里最常教授的入门语言。这也对未来的就业市场产生了一些影响, Python可能成为更受欢迎的技术选择。

2.Python待遇好

在某些国家和地区,特别是在美国,Python工程师的薪水是行业中最高的。根据美国技能和薪资分析平台Gooroo的数据,Python是美国第二高薪的编程语言(超过C++JavaJavaScript),年薪接近103500美元。

拥有Python技能的软件开发人员的平均工资大约是76746美元,初级开发人员更高,而高级开发人员则非常高;拥有Python技能的Web开发人员的收入约为59108美元,高级开发人员的收入为77000美元;拥有Python技能的数据科学家可以挣到97663美元,而经验丰富的专家可以挣到140000美元。

3.Python开发人员的需求量很大

根据Indeed.com上最新的工作趋势,对Python开发人员的需求正在增长。因此,拥有Python证书有助于求职者在很短的时间内找到一份工作。对具有Python技能的开发人员的需求显然超过了求职者的数量,Python开发人员的就业市场前景非常好。

4.数据科学的高度优先性

真正推动Python普及的,是它在数据科学和数据工程应用中的高度优先性。使用Python时,可以运用PandasNumPySciPy等最广泛使用的库,结合快速原型制作的能力以及其他工具,使数据工程师可以保持高效。

作为一门语言,Python在2020年得到了高度的普及。2020年2月的调查显示,Python语言排在第3位。之前它排在前50名之后,因此被誉为快速崛起的编程语言。根据PYPL(流行编程语言)索引,与其他编程语言相比,基于搜索引擎的搜索结果,Python被列为最流行的语言。

5.Python能够节约时间

我相信只要使用过一次Python的大多数开发人员都会同意这一观点,即用这种语言编写任何代码会比其他大多数技术节省大量时间。以下为PythonJava的一个对比,其结果相同,但请看编码:

Java演示的经典“Hello, world”程序,如下:

public classHelloWorld {
   public static void main(String[] args) {
      System.out.println("Hello,world");
   }
}

而要得到相同的结果,在Python中你所要做的就是:

print("Hello,world")

这足以证明Python的省时。

6.Python有大量的资源

Python拥有大量的资源来帮助它进行更新,包括一个内置的单元测试框架、一个大容量的内置功能标准库,以及足够的框架和环境,这使得开发人员能够专注于编写网站或应用程序。Django是最常用的Python web框架,还有Pyramidweb2pyFlaskZope 2等。

7.Python是可移植的和可扩展的

Python被称为可移植语言,因为拥有用于WindowsPython代码的用户可以在任何平台(如MacLinuxUnix)上执行和运行,无需修改代码。Python的可扩展特性允许用户将Python代码编写成CC++之类的语言。

8.大公司使用Python

你曾经梦想过在谷歌或脸书这样的科技巨头工作吗?Python可能就是你的敲门砖。因为这些公司,以及DropboxYouTubeInstagramQuoraMozillaIBM雅虎和许多其他公司都在使用Python来完成各种任务,并一直在雇用Python开发人员。

作为一种编程语言,Python将继续扩展到新的计算领域,它将成为物联网的主要编程语言。当前的市场趋势证明,Python开发人员在未来几年将有巨大的潜力。

无论您是一名有经验的程序员还是一名新手,学习python编程语言的最佳技巧都是找出自己的学习风格并深入编码的不二法门。这需要一定的时间,但稳扎稳打就能逐步实现。

以上就是关于为什么选择学习python的八大理由了,希望对大家有所帮助。

增加两行代码,却整整花了两天时间

thbcm阅读(324)

明明只是增加了两行代码,为什么却花了整整两天的时间?

这个问题看似合理,但其背后隐藏着一些可怕的假设:

  • 代码行数=工作量
  • 代码行数=价值
  • 所有代码行都一样

但这些统统不属实。

有人花了整整两天的时间改好了代码,但为什么我们回头去看的时候会觉得这些改动如此简单?

(推荐教程:python教程

因为问题报告对如何再现的描述非常模糊。

我花了好几个小时才成功地重现了问题。有些开发人员会立即去找报告问题的人,在获得更多信息之后再展开调查。而我会尽力使用已提供的信息。我知道有些开发人员不喜欢改bug,因此他们会想法设法逃避这种工作。声称信息量不足是及时甩锅的一个好办法,看起来你像是在努力帮忙,但又无需做任何工作。我知道报告错误非常困难,我非常感谢那些报告错误的人。我会尽可能利用已有信息,实在没办法再去请求报告错误的人提供更多信息,目的是为了表达对他们的感谢。

因为报告的问题与某个功能有关,但我不熟悉这个功能。

我很少使用与这个问题相关的功能,而且我并没有接触过与该功能相关的具体细节。因此,我花费了很长时间来理解如何使用这个功能,以及这个bug与软件交互的具体过程。

因为我花了很长时间调查引发问题的真正原因,而不仅仅是流于表面。

如果某些代码抛出了错误,则你只需把它包装在try..catch语句中即可抑制错误。没有错误,就没有问题。对吗?不好意思,在我看来,把问题藏起来并不等同于解决问题。掩盖错误很容易引发其他意料之外的副作用。我不想留到将来,再与它们打交道。

因为我调查了除了问题报告的步骤之外,是否还有其他方法可以再现这个问题。

通过一组再现步骤可以很容易地让错误浮现,但实际上它可能涉及更深层的问题。找到问题的确切原因,并研究解决问题的所有方法,才能提供有价值的见解。比如代码的实际使用方式,可能其他地方存在有待解决的问题,或者存在代码不一致,导致某个代码路径中引发了错误,而其他路径则不会。

因为我花时间验证了代码的其他部分是否会受到类似问题的影响。

如果某个错误引发了这个bug,那么代码库的其他地方可能也存在相同的错误。我可以借这个机会仔细检查一下。

(推荐课程:JavaScript教程

因为如果我找出了问题的根源,那么就可以寻求最简单的解决方法,同时引入副作用的风险也很小。

我不希望用最快捷的方法修复问题。我希望修复这个问题之后将来不会引起混乱或引发其他问题。

因为我对此次代码变更进行了彻底的测试,并验证了它能够解决所有受影响代码路径下的问题。

我不想依靠他人来测试我做的更改是否正确。我不希望以后等到我完全忘记此次更改之后再发现某个bug,迫使我不得不再次回头看这些代码。来回切换思维费时费力,又令人沮丧。我不希望让专职的测试人员再来检验同一个更改。

我不喜欢改bug的工作,部分原因是因为这种工作让人感觉是我之前的失误造成的。而我不喜欢改bug的另一个原因是,我更喜欢从事新的工作。

问:有什么是比改bug更糟糕的工作呢? 答:反复修复同一个bug。

我愿意花时间确保每次遇到的bug都会被完全修复,这样我就无需再面对这个bug,也无需再花时间调查、修复并测试这个bug

以上就是关于为什么有时候明明只增加了一点点代码,却花费了好几天时间的相关介绍了,希望对大家有所帮助。

原文:www.mrlacey.com/2020/07/youve-only-added-two-lines-why-did-that.html

参考来源:blog.csdn.net/csdnnews/article/details/107903206

Vue 中插槽是怎么发出数据的

thbcm阅读(351)

在工作中BUG的出现是在所难免的,但是在写代码的时候没法实时发现BUG,等事后再去解决BUG,还得花很多时间去进行log调试,这里给大家推荐一个不错的BUG监控工具:Fundebug

我们知道使用作用域插槽可以将数据传递到插槽中,但是如何从插槽传回来呢?

(推荐教程:Vue 1教程

将一个方法传递到我们的插槽中,然后在插槽中调用该方法。无法发出事件,因为插槽与父组件共享相同的上下文(或作用域)。

// Parent.vue <template> <Child> <template #default=”{ clicked }”> <button @click=”clicked”> Click this button </button> </template> </Child> </template>

// Child.vue <template> <div> <!– 将“handleClick” 作为 “clicked” 传递到我们的 slot –> <slot :clicked=”handleClick” /> </div> </template>

在本文中,我们将介绍其工作原理,以及:

  • 从插槽到父级的 emit
  • 当一个槽与父组件共享作用域时意味着什么
  • 从插槽到祖父组件的 emit
  • 更深入地了解如何使用方法从插槽通讯回来

从插槽到父级的 emit

现在看一下Parent组件的内容:

// Parent.vue <template> <Child> <button @click=””> Click this button </button> </Child> </template>

我们在 Child 组件的插槽内有一个button 。单击该按钮时,我们要在Parent 组件内部调用一个方法。

如果button 不在插槽中,而是直接在Parent组件的子组件中,则我们可以访问该组件上的方法:

// Parent.vue <template> <button @click=”handleClick”> Click this button </button> </template>

当该 button 组件位于插槽内时,也是如此:

/ Parent.vue <template> <Child> <button @click=”handleClick”> Click this button </button> </Child> </template>

之所以可行,是因为该插槽与 Parent 组件共享相同的作用域。

(推荐教程:Vue 2教程

插槽和模板作用域

模板作用域:模板内部的所有内容都可以访问组件上定义的所有内容。

这包括所有元素,所有插槽和所有作用域插槽。

因此,无论该按钮在模板中位于何处,都可以访问handleClick方法。

乍一看,这可能有点奇怪,这也是为什么插槽很难理解的原因之一。插槽最终渲染为Child 组件的子组件,但它不与Child 组件共享作用域。相反,它充当Parent 组件的子组件。

插槽向祖父组件发送数据

如果要从插槽把数据发送到祖父组件,常规的方式是使用的$emit方法:

// Parent.vue <template> <Child> <button @click=”$emit(‘click’)”> Click this button </button> </Child> </template>

因为该插槽与Parent 组件共享相同的模板作用域,所以在此处调用$emit将从Parent组件发出事件。

从插槽发回子组件

Child 组件通讯又如何呢?

我们知道如何将数据从子节点传递到槽中

// Child.vue <template> <div> <slot :data=”data” /> </div> </template>

以及如何在作用域内的插槽中使用它:

// Parent.vue <template> <Child> <template #default=”{ data }”> {{ data }} </template> </Child> </template>

除了传递数据,我们还可以将方法传递到作用域插槽中。如果我们以正确的方式连接这些方法,则可以使用它来与Child组件通信:

// Parent.vue <template> <Child> <template #default=”{ clicked }”> <button @click=”clicked”> Click this button </button> </template> </Child> </template>

// Child.vue
<template>
  <div>
    <!-- Pass `handleClick` as `clicked` into our slot -->
    <slot :clicked="handleClick" />
  </div>
</template>

每当单击按钮时,就会调用Child组件中的handleClick方法。

(推荐微课:Vue 2.x 微课

以上就是关于在Vue中插槽是怎么发送数据的详细内容了,希望对大家有所帮助。

原文:stackoverflow.com/questions/50942544/emit-event-from-content-in-slot-to-parent/50943093

Visual Studio开发利器,CodeRush新版本发布v20.1.6——支持Blazor

thbcm阅读(371)

CodeRush能帮助你以极高的效率创建和维护源代码。Consume-first 申明,强大的模板,智能的选择工具,智能代码分析和创新的导航以及一个无与伦比的重构集,在它们的帮助下能够大大的提高你效率。

具体更新内容如下:

Visual Studio 2019的CodeRush菜单位置自定义中的更改

Visual Studio 2019 16.4及更高版本现在允许您指定应放置CodeRush菜单的位置,因此已删除了较旧的CodeRush选项(位于Quick Setup选项页面上),这也使您在启动时性能得到提升(在典型的开发机器上节省了大约1600ms )。

(推荐课程:Visual Studio Code 使用教程

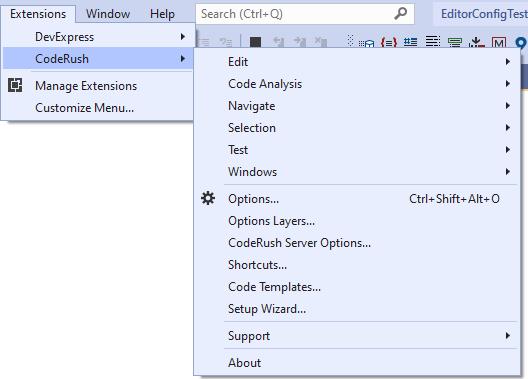
默认情况下,CodeRush菜单位于Visual Studio Extensions菜单中。

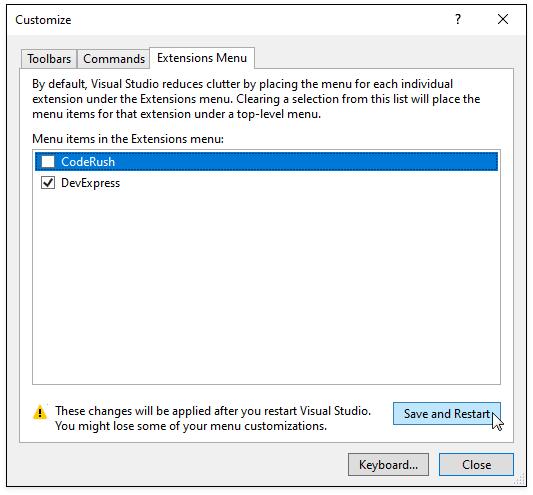
如果您想将CodeRush菜单重新定位到Visual Studio菜单栏的顶层(建议使用CodeRush获得更高效率编码体验的大多数开发人员),请按照以下步骤操作:

  • 打开Visual Studio 2019
  • 选择Extensions -> Customize Menu
  • Extensions Menu标签中取消选中CodeRush entry
  • 重新启动Visual Studio

支持Blazor

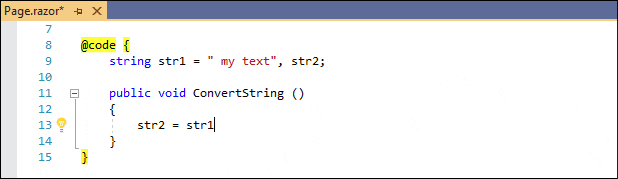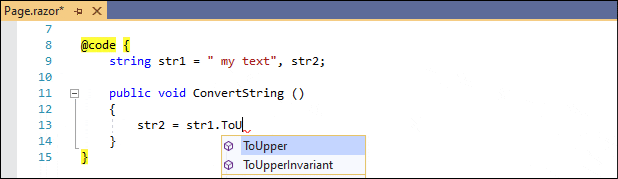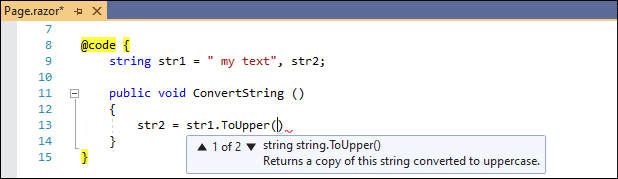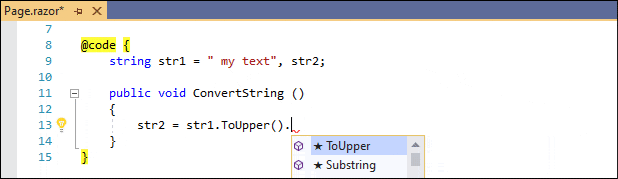
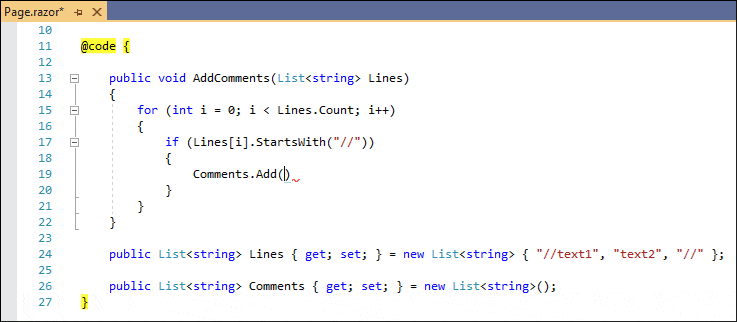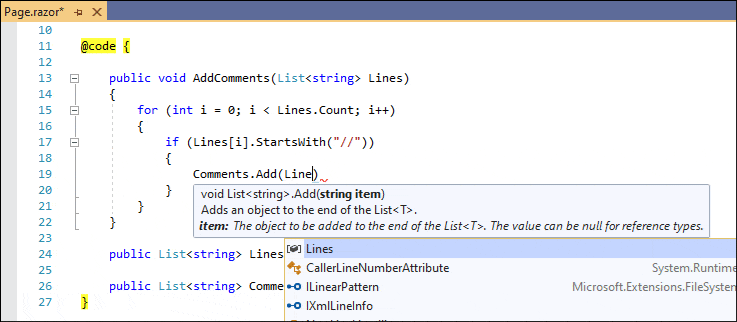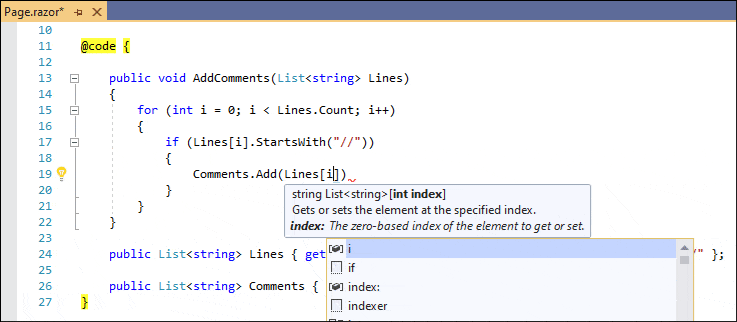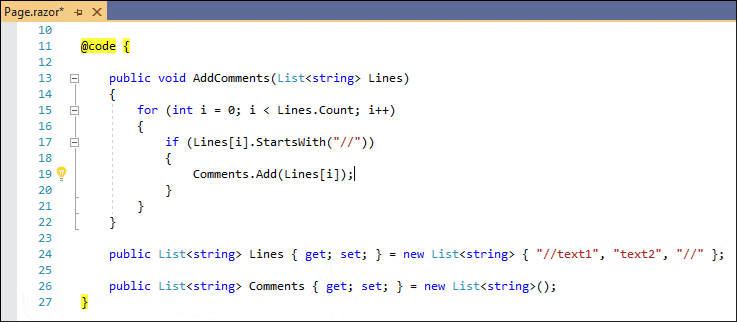
.razor文件中@code部分中现已提供以下CodeRush功能:

Smart Dot

Smart Semicolon

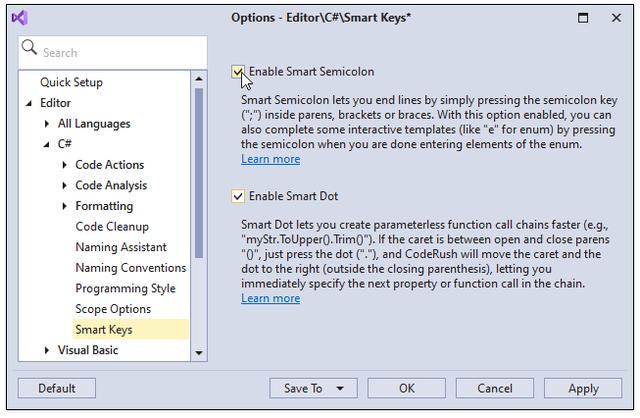
默认情况下,’Smart Dot‘和’Smart Semicolon‘被禁用,您可以在Editor | C# | Smart Keys选项页面启用这些功能。

重构

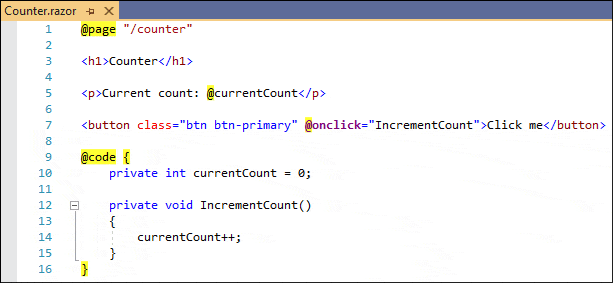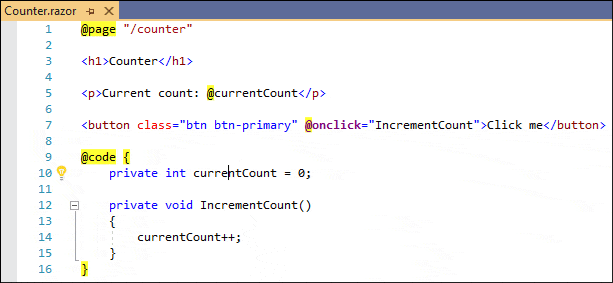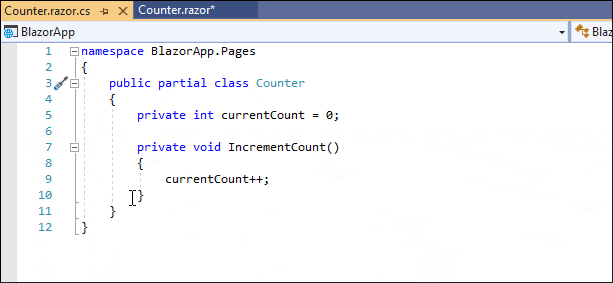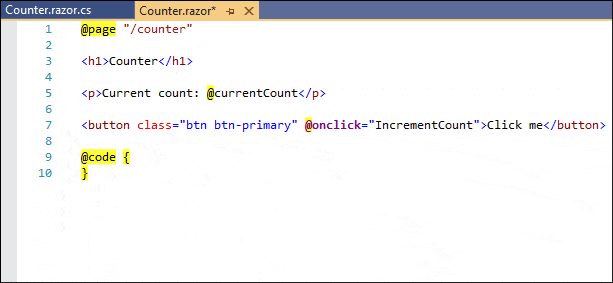
此版本新增 ‘Move to Code Behind‘重构,此重构将位于razor page @code部分中的代码移动到代码隐藏文件(.razor.cs)中。 如果没有代码隐藏文件,则此重构将创建一个。 此重构还带来了对代码隐藏文件的领先注释、属性和任何必要的引用。

要使用此重构,只需将插入号放在@code节中的代码中,然后按Ctrl+.Ctrl+~调用Code Actions菜单,选择”Move to Code Behind“,然后按Enter

增强代码样式

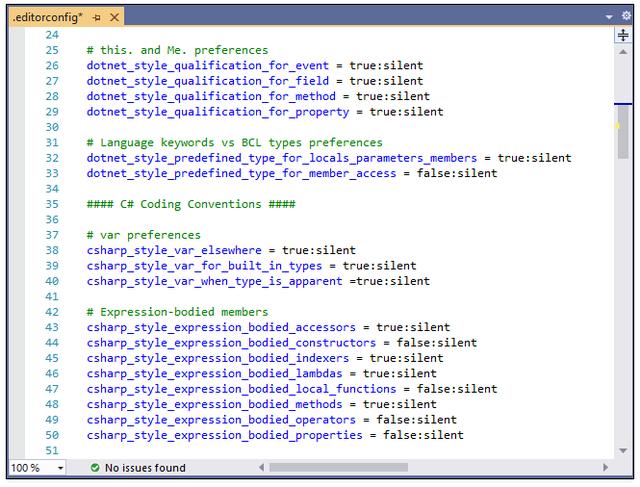
现在,您可以使用下面的Visual Studio选项和位于EditorConfig文件中的相应设置在CodeRush中配置代码样式:

  • ‘this.’ and ‘Me.’ preferences;
  • predefined type preferences;
  • ‘var’ preferences;
  • use expression body.

您还可以运行code cleanup来将这些设置应用于代码。

以上就是关于CodeRush新版本v20.1.6的详细内容了,希望对大家有所帮助。

信息安全学习:常用的攻击手段–SQL注入

thbcm阅读(397)

一、概述

1. 攻击原理

SQL注入是较常见的网络攻击方式之一,主要针对WEB应用,利用程序员编写代码的疏忽,对于连接数据库的应用,通过重组SQL语句,使服务器执行恶意SQL代码,从而获取到非授权的权限和资料。京东 16年12月10日 泄露12G用户账号信息。SQL注入OWASP20132017中排名都是在首位。

(推荐课程:SQL教程)

2. 如何判断有没有SQL注入漏洞

(1) 单引号判断

针对get请求带整数参数的,请求参数:?id=1',如果页面报SQL运行错误,则可能存在SQL注入。

(2) 数字型判断

有缺陷的代码语句:

select * from table where id=3

如果提交参数?id= x and 1=1构造成如下SQL

select * from table where id=1 and 1=2

如果页面报SQL运行错误,则可能存在SQL注入

(3) 字符型判断

有缺陷的代码语句:

select * from table where id=’x’

如果提交参数?id=x' and '1'='1构造如下SQL

select * from table where id= ‘x’ and ‘1’=’1′

如果页面报SQL运行错误,则可能存在 SQL注入

2. 应对方案

  • 不信任用户的输入
  • 输入字符串过滤
  • 字符转义
  • 避免用拼接字符串、组合成SQL语句的方式来执行SQL
  • 不要使用管理员权限连接数据库,数据库访问权限设置最小化
  • 机密信息加密或进行哈希处理
  • 程序异常时对错误进行捕获,避免原生错误返回给用户

(推荐微课:SQL微课)

二、觉见的SQL注入扫描工具

1. SQLIer

(1) 开源地址

github.com/BCable/sqlier

(2) 获取信息

./sqlier.sh -s 10 网址

(3) 参数

  • -c [host] 清除站点信息.
  • -o [file] 输出破解的密码.
  • -s [seconds] 每个请求间隔时间.
  • -u [usernames] 暴力破解猜测用户名,用逗号隔开.
  • -w [options] wget参数.

(4) 猜测表名字段

  • --table-names [table_names] 猜测表名,用逗号隔开。
  • --user-fields [user_fields] 猜测用户名字段,逗号隔开。
  • --pass-fields [pass_fields] 猜测密码字段,逗号隔开。

2. SQLmap

一款用来检测与利用SQL注入漏洞的工具。

安装:

pip install sqlmap

SQL注入点

可以提交SQL语句地方就是SQL注入点。想进入SQL注入,先找到SQL注入点。

python sqlmap.py -u “http://test/test.aspx?id=123

3. jSky

国内深圳宇造诺赛公司出品的一款WEB漏洞扫描工具,收费软件。

4. Pangolin(穿山甲)

也是宇造诺赛的产品,专门进行SQL注入扫描。

5. iiscan 亿思

在线免费的网站漏洞检测平台,可以检测SQL注入漏洞、跨站漏洞等。

6. MDCSOFT WEB应用防火墙

集WEB防护、网页保护、负载均衡、应用交付一体的WEB整体安全防护设备。

7. 其它工具

啊d注入工具 阿里云在线漏洞扫描

以上就是关于常用的攻击手段–SQL注入的相关介绍了,希望对大家有所帮助。

代码优化技巧 : 逻辑判断

thbcm阅读(349)

想成为一名合格的程序员,那么代码优化是相当重要的一部分,一份高质量的代码,可以让人一目了然,既方便自己,也方便他人。

if elseswitch case 是日常开发中最常见的条件判断语句,这种看似简单的语句,当遇到复杂的业务场景时,如果处理不善,就会出现大量的逻辑嵌套,可读性差并且难以扩展。

编写高质量可维护的代码,我们先从最小处入手,一起来看看在前端开发过程中,可以从哪些方面来优化逻辑判断?

下面我们会分别从 JavaScript 语法和 React JSX 语法两个方面来分享一些优化的技巧。

JavaScript 语法篇

嵌套层级优化

function supply(fruit, quantity) {
    const redFruits = ['apple', 'strawberry', 'cherry', 'cranberries'];
    // 条件 1: 水果存在
    if(fruit) {
        // 条件 2: 属于红色水果
        if(redFruits.includes(fruit)) {
            console.log('红色水果');
            // 条件 3: 水果数量大于 10 个
            if (quantity > 10) {
                console.log('数量大于 10 个');
            }
        }
    } else {
        throw new Error('没有水果啦!');
    }
}

分析上面的条件判断,存在三层 if 条件嵌套。

如果提前 return 掉无效条件,将 if else的多重嵌套层次减少到一层,更容易理解和维护。

function supply(fruit, quantity) {
    const redFruits = ['apple', 'strawberry', 'cherry', 'cranberries'];
    if(!fruit) throw new Error('没有水果啦'); // 条件 1: 当 fruit 无效时,提前处理错误
    if(!redFruits.includes(fruit)) return; // 条件 2: 当不是红色水果时,提前 return

    
    console.log('红色水果');

    
    // 条件 3: 水果数量大于 10 个
    if (quantity > 10) {
        console.log('数量大于 10 个');
    }
}

多条件分支的优化处理

当需要枚举值处理不同的业务分支逻辑时, 第一反应是写下 if else ?我们来看一下:

function pick(color) {
  // 根据颜色选择水果
  if(color === 'red') {
      return ['apple', 'strawberry']; 
  } else if (color === 'yellow') {
      return ['banana', 'pineapple'];
  } else if (color === 'purple') {
      return ['grape', 'plum'];
  } else {
      return [];
  }
}

在上面的实现中:

  • if else 分支太多
  • if else 更适合于条件区间判断,而 switch case 更适合于具体枚举值的分支判断

使用 switch case 优化上面的代码后:

function pick(color) {
  // 根据颜色选择水果
  switch (color) {
    case 'red':
      return ['apple', 'strawberry'];
    case 'yellow':
      return ['banana', 'pineapple'];
    case 'purple':
      return ['grape', 'plum'];
    default:
      return [];
  }
}

switch case 优化之后的代码看上去格式整齐,思路很清晰,但还是很冗长。继续优化:

  • 借助 Object{ key: value } 结构,我们可以在 Object 中枚举所有的情况,然后将 key 作为索引,直接通过 Object.key 或者 Object[key] 来获取内容
const fruitColor = {                                                                        
    red: ['apple', 'strawberry'],
    yellow: ['banana', 'pineapple'],
    purple: ['grape', 'plum'],
}
function pick(color) {
    return fruitColor[color] || [];
}

  • 使用 Map 数据结构,真正的 (key, value) 键值对结构 ;
const fruitColor = new Map()
.set('red', ['apple', 'strawberry'])
.set('yellow', ['banana', 'pineapple'])
.set('purple', ['grape', 'plum']);


function pick(color) {
  return fruitColor.get(color) || [];
}

优化之后,代码更简洁、更容易扩展。

为了更好的可读性,还可以通过更加语义化的方式定义对象,然后使用 Array.filter 达到同样的效果。

const fruits = [
    { name: 'apple', color: 'red' }, 
    { name: 'strawberry', color: 'red' }, 
    { name: 'banana', color: 'yellow' }, 
    { name: 'pineapple', color: 'yellow' }, 
    { name: 'grape', color: 'purple' }, 
    { name: 'plum', color: 'purple' }
];


function pick(color) {
  return fruits.filter(f => f.color == color);
}

(推荐教程:JavaScript教程

使用数组新特性简化逻辑判断

巧妙的利用 ES6 中提供的数组新特性,也可以让我们更轻松的处理逻辑判断。

多条件判断

编码时遇到多个判断条件时,本能的写下下面的代码(其实也是最能表达业务逻辑的面向过程编码)。

function judge(fruit) {
  if (fruit === 'apple' || fruit === 'strawberry' || fruit === 'cherry' || fruit === 'cranberries' ) {
    console.log('red');
  }
}

但是当 type 未来到 10 种甚至更多时, 我们只能继续添加 || 来维护代码么 ?

试试 Array.includes ~

// 将判断条件抽取成一个数组
const redFruits = ['apple', 'strawberry', 'cherry', 'cranberries'];
function judge(type) {
    if (redFruits.includes(fruit)) {
        console.log('red');
     }
}

判断数组中是否所有项都满足某条件

const fruits = [
    { name: 'apple', color: 'red' },
    { name: 'banana', color: 'yellow' },
    { name: 'grape', color: 'purple' }
  ];


function match() {
  let isAllRed = true;


  // 判断条件:所有的水果都必须是红色
  for (let f of fruits) {
    if (!isAllRed) break;
    isAllRed = (f.color === 'red');
  }


  console.log(isAllRed); // false
}

上面的实现中,主要是为了处理数组中的所有项都符合条件。

使用 Array.every 可以很容的实现这个逻辑:

const fruits = [
    { name: 'apple', color: 'red' },
    { name: 'banana', color: 'yellow' },
    { name: 'grape', color: 'purple' }
  ];


function match() {
  // 条件:所有水果都必须是红色
  const isAllRed = fruits.every(f => f.color == 'red');


  console.log(isAllRed); // false
}

判断数组中是否有某一项满足条件

Array.some ,它主要处理的场景是判断数组中是否有一项满足条件。

如果想知道是否有红色水果,可以直接使用 Array.some 方法:

const fruits = [
    { name: 'apple', color: 'red' },
    { name: 'banana', color: 'yellow' },
    { name: 'grape', color: 'purple' }
  ];


// 条件:是否有红色水果 
const isAnyRed = fruits.some(f => f.color == 'red');

还有许多其他数组新特性,比如 Array.findArray.sliceArray.findIndexArray.reduceArray.splice 等,在实际场景中可以根据需要选择使用。

函数默认值

使用默认参数

const buyFruit = (fruit,amount) => {
     if(!fruit){
        return
  }
  amount = amount || 1;
  console.log(amount)
}

我们经常需要处理函数内部的一些参数默认值,上面的代码大家都不陌生,使用函数的默认参数,可以很好的帮助处理这种场景。

const buyFruit = (fruit,amount = 1) => {
     if(!fruit){
        return
  }
  console.log(amount,'amount')
}

我们可以通过 Babel 的转译来看一下默认参数是如何实现的。
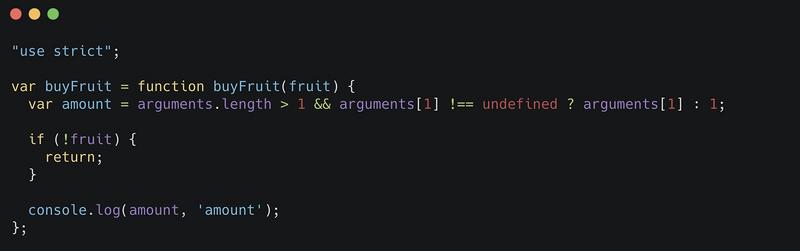
从上面的转译结果可以发现,只有参数为 undefined 时才会使用默认参数。

测试的执行结果如下:

buyFruit('apple','');  // amount
buyFruit('apple',null);  //null amount
buyFruit('apple');  //1 amount

所以使用默认参数的情况下,我们需要注意的是默认参数 amount=1 并不等同于 amount || 1

使用解构与默认参数

当函数参数是对象时,我们可以使用解构结合默认参数来简化逻辑。

Before:

const buyFruit = (fruit,amount) => {
    fruit = fruit || {};
    if(!fruit.name || !fruit.price){
        return;
    }
    ...
  amount = amount || 1;
  console.log(amount)
}

After:

const buyFruit = ({ name,price }={},amount) => {
  if(!name || !prices){
      return;
  }
  console.log(amount)
}

复杂数据解构

当处理比较简的对象时,解构与默认参数的配合是非常好的,但在一些复杂的场景中,我们面临的可能是更复杂的结构。

const oneComplexObj = {
    firstLevel:{
        secondLevel:[{
            name:"",
            price:""
        }]
    }
}

这个时候如果再通过解构去获取对象里的值。

const {
    firstLevel:{
        secondLevel:[{name,price]=[]
    }={}
} = oneComplexObj;        

可读性就会比较差,而且需要考虑多层解构的默认值以及数据异常情况。

这种情况下,如果项目中使用 lodash 库,可以使用其中的 lodash/get 方法。

import lodashGet from 'lodash/get';


const { name,price} = lodashGet(oneComplexObj,'firstLevel.secondLevel[0]',{});

策略模式优化分支逻辑处理

策略模式:定义一系列的算法,把它们一个个封装起来, 并且使它们可相互替换。

使用场景:策略模式属于对象行为模式,当遇到具有相同行为接口、行为内部不同逻辑实现的实例对象时,可以采用策略模式;或者是一组对象可以根据需要动态的选择几种行为中的某一种时,也可以采用策略模式;这里以第二种情况作为示例:

Before:

const TYPE = {
    JUICE:'juice',
    SALAD:'salad',
    JAM:'jam'
}
function enjoy({type = TYPE.JUICE,fruits}){
  if(!fruits || !fruits.length) {
        console.log('请先采购水果!');
           return;
    }
  if(type === TYPE.JUICE) {
    console.log('榨果汁中...');
      return '果汁';
  }
  if(type === TYPE.SALAD) {
      console.log('做沙拉中...');
      return '拉沙';
  }
  if(type === TYPE.JAM) {
    console.log('做果酱中...');
      return '果酱';
  }
  return;
}


enjoy({type:'juice',fruits});

使用思路:定义策略对象封装不同行为、提供策略选择接口,在不同的规则时调用相应的行为。

After:

const TYPE = {
    JUICE:'juice',
    SALAD:'salad',
    JAM:'jam'
}


const strategies = {
    [TYPE.JUICE]: function(fruits){
        console.log('榨果汁中...');
        return '果汁';
    },
    [TYPE.SALAD]:function(fruits){
        console.log('做沙拉中...');
        return '沙拉';
    },
    [TYPE.JAM]:function(fruits){
        console.log('做果酱中...');
        return '果酱';
    },
}


function enjoy({type = TYPE.JUICE,fruits}) {
    if(!type) {
        console.log('请直接享用!');
           return;
    }
    if(!fruits || !fruits.length) {
        console.log('请先采购水果!');
           return;
    }
    return strategies[type](fruits);
}


enjoy({type:'juice',fruits});

(推荐微课:JavaScript微课

框架篇之 React JSX 逻辑判断优化

JSX 是一个看起来很像 XMLJavaScript 语法扩展。一般在 React 中使用 JSX 来描述界面信息,ReactDOM.render()JSX 界面信息渲染到页面上。

JSX 中支持 JavaScript 表达式,日常很常见的循环输出子组件、三元表达式判断、再复杂一些直接抽象出一个函数。

JSX 中写这么多 JavaScript 表达式,整体代码看起来会有点儿杂乱。试着优化一下!

JSX-Control-Statements

JSX-Control-Statements 是一个 Babel 插件,它扩展了 JSX 的能力,支持以标签的形式处理条件判断、循环。

If 标签

<If> 标签内容只有在 conditiontrue 时才会渲染,等价于最简单的三元表达式。

Before:

{ condition() ? 'Hello World!' : null }

After:

<If condition={ condition() }>Hello World!</If>

注意:<Else /> 已被废弃,复杂的条件判断可以使用 <Choose> 标签。

Choose 标签

<Choose> 标签下包括至少一个 <When> 标签、可选的 <Otherwise> 标签。

<When> 标签内容只有在 conditiontrue 时才会渲染,相当于一个 if 条件判断分支。

<Otherwise> 标签则相当于最后的 else分支。

Before:

{ test1 ? <span>IfBlock1</span> : test2 ? <span>IfBlock2</span> : <span>ElseBlock</span> }

After:

<Choose>
  <When condition={ test1 }>
    <span>IfBlock1</span>
  </When>
  <When condition={ test2 }>
    <span>IfBlock2</span>
  </When>
  <Otherwise>
    <span>ElseBlock</span>
  </Otherwise>
</Choose>

For 标签

<For> 标签需要声明 ofeach 属性。

of 接收的是可以使用迭代器访问的对象。

each 代表迭代器访问时的当前指向元素。

Before:

{
  (this.props.items || []).map(item => {
      return <span key={ item.id }>{ item.title }</span>
  })
}

After:

<For each="item" of={ this.props.items }>
   <span key={ item.id }>{ item.title }</span>
</For>

注意:<For> 标签不能作为根元素。

With 标签

<With> 标签提供变量传参的功能。

Before:

renderFoo = (foo) => {
    return <span>{ foo }</span>;
}


// JSX 中表达式调用
{
    this.renderFoo(47)
}

After:

<With foo={ 47 }>
  <span>{ foo }</span>
</With>

使用这几种标签优化代码,可以减少 JSX 中存在的显式 JavaScript 表达式,使我们的代码看上去更简洁,但是这些标签封装的能力,在编译时需要转换为等价的 JavaScript 表达式。

总结

以上就是一些常见的逻辑判断优化技巧总结。当然,编写高质量可维护的代码,除了逻辑判断优化,还需要有清晰的注释、含义明确的变量命名、合理的代码结构拆分、逻辑分层解耦、以及更高层次的贴合业务的逻辑抽象等等,相信各位在这方面也有自己的一些心得。

Go语言多态和interface的使用

thbcm阅读(355)

作为一名编程人员,大家一定不会对多态感到陌生,因为在C++Java等语言以及面向对象中都有会看到它。

多态是面向对象范畴当中经常使用并且非常好用的一个功能,如果你之前没有学过的话也没有关系,我们用一个简单的例子来说明一下。多态主要是用在强类型语言当中,像是Python这样的弱类型语言,变量的类型可以随意变化,也没有任何限制,其实区别不是很大。

多态的含义

对于Java或者是C++而言,我们在使用变量的时候,变量的类型是明确的。但是如果我们希望它可以宽松一点,比如说我们用父类指针或引用去调用方法,但是在执行的时候,能够根据子类的类型去执行子类当中的方法。也就是说实现我们用相同的调用方式调出不同结果或者是功能的情况,这种情况就叫做多态。

(推荐课程:Go教程

举个非常经典的例子,比如说猫、狗和人都是哺乳动物。这三个类都有一个say方法,大家都知道猫、狗以及人类的say是不一样的,猫可能是喵喵叫,狗是汪汪叫,人类则是说话。

class Mammal {
    public void say() {
        System.out.println("do nothing")
    }
}


class Cat extends Mammal{
 public void say() {
  System.out.println("meow");
 }
}


class Dog extends Mammal{
 public void say() {
  System.out.println("woof");
 }
}


class Human extends Mammal{
 public void say() {
  System.out.println("speak");
 }
}

这段代码大家应该都不难看懂,这三个类都是Mammal的子类,假设这个时候我们有一系列实例,它们都是Mammal的子类的实例,但是这三种类型都有,我们希望用一个循环来一起全都调用了。虽然我们接收变量的时候是用的Mammal的父类类型去接收的,但是我们调用的时候却会获得各个子类的运行结果。

比如这样:

class Main {
    public static void main(String[] args) {
        List<Mammal> mammals = new ArrayList<>();
        mammals.add(new Human());
        mammals.add(new Dog());
        mammals.add(new Cat());

        
        for (Mammal mammal : mammals) {
            mammal.say();
        }
    }
}

不知道大家有没有get到精髓,我们创建了一个父类的List,将它各个子类的实例放入了其中。然后通过了一个循环用父类对象来接收,并且调用了say方法。我们希望虽然我们用的是父类的引用来调用的方法,但是它可以自动根据子类的类型调用对应不同子类当中的方法。

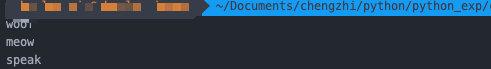
也就是说我们得到的结果应该是:

speak
woof
meow

这种功能就是多态,说白了我们可以在父类当中定义方法,在子类当中创建不同的实现。但是在调用的时候依然还是用父类的引用去调用,编译器会自动替我们做好内部的映射和转化。

抽象类与接口

这样实现当然是可行的,但其实有一个小小的问题,就是Mammal类当中的say方法多余了。因为我们使用的只会是它的子类,并不会用到Mammal这个父类。所以我们没必要实现父类Mammal中的say方法,做一个标记,表示有这么一个方法,子类实现的时候需要实现它就可以了。

这就是抽象类和抽象方法的来源,我们可以把Mammal做成一个抽象类,声明say是一个抽象方法。抽象类是不能直接创建实例的,只能创建子类的实例,并且抽象方法也不用实现,只需要标记好参数和返回就行了。具体的实现都在子类当中进行。说白了抽象方法就是一个标记,告诉编译器凡是继承了这个类的子类必须要实现抽象方法,父类当中的方法不能调用。那抽象类就是含有抽象方法的类。

我们写出Mammal变成抽象类之后的代码:

abstract class Mammal {
    abstract void say();
}

很简单,因为我们只需要定义方法的参数就可以了,不需要实现方法的功能,方法的功能在子类当中实现。由于我们标记了say这个方法是一个抽象方法,凡是继承了Mammal的子类都必须要实现这个方法,否则一定会报错。

(推荐课程:Go Web编程

抽象类其实是一个擦边球,我们可以在抽象类中定义抽象的方法也就是只声明不实现,也可以在抽象类中实现具体的方法。在抽象类当中非抽象的方法子类的实例是可以直接调用的,和子类调用父类的普通方法一样。但假如我们不需要父类实现方法,我们提出提取出来的父类中的所有方法都是抽象的呢?针对这一种情况,Java当中还有一个概念叫做接口,也就是interface,本质上来说interface就是抽象类,只不过是只有抽象方法的抽象类。

所以刚才的Mammal也可以写成:

interface Mammal {
    void say();
}

Mammal变成了interface之后,子类的实现没什么太大的差别,只不过将extends关键字换成了implements。另外,子类只能继承一个抽象类,但是可以实现多个接口。早先的Java版本当中,interface只能够定义方法和常量,在Java8以后的版本当中,我们也可以在接口当中实现一些默认方法和静态方法。

接口的好处是很明显的,我们可以用接口的实例来调用所有实现了这个接口的类。也就是说接口和它的实现是一种要宽泛许多的继承关系,大大增加了灵活性。

以上虽然全是Java的内容,但是讲的其实是面向对象的内容,如果没有学过Java的小伙伴可能看起来稍稍有一点点吃力,但总体来说问题不大,没必要细扣当中的语法细节,get到核心精髓就可以了。

讲这么一大段的目的是为了厘清面向对象当中的一些概念,以及接口的使用方法和理念,后面才是本文的重头戏,也就是Go语言当中接口的使用以及理念。

Golang中的接口

Golang当中也有接口,但是它的理念和使用方法和Java稍稍有所不同,它们的使用场景以及实现的目的是类似的,本质上都是为了抽象。通过接口提取出了一些方法,所有继承了这个接口的类都必然带有这些方法,那么我们通过接口获取这些类的实例就可以使用了,大大增加了灵活性。

但是Java当中的接口有一个很大的问题就是侵入性,说白了就是会颠倒供需关系。举个简单的例子,假设你写了一个爬虫从各个网页上爬取内容。爬虫爬到的内容的类别是很多的,有图片、有文本还有视频。假设你想要抽象出一个接口来,在这个接口当中定义你规定的一些提取数据的方法。这样不论获取到的数据的格式是什么,你都可以用这个接口来调用。这本身也是接口的使用场景,但问题是处理图片、文本以及视频的组件可能是开源或者是第三方的,并不是你开发的。你定义接口并没有什么卵用,别人的代码可不会继承这个接口。

当然这也是可以解决的, 比如你可以在这些第三方工具库外面自己封装一层,实现你定义的接口。这样当然是OK的,但是显然比较麻烦。

(推荐微课:Go微课

Golang当中的接口解决了这个问题,也就是说它完全拿掉了原本弱化的继承关系,只要接口中定义的方法能对应的上,那么就可以认为这个类实现了这个接口。

我们先来创建一个interface,当然也是通过type关键字:

type Mammal interface {
 Say()
}

我们定义了一个Mammal的接口,当中声明了一个Say函数。也就是说只要是拥有这个函数的结构体就可以用这个接口来接收,我们和刚才一样,定义CatDogHuman三个结构体,分别实现各自的Say方法:

type Dog struct{}


type Cat struct{}


type Human struct{}


func (d Dog) Say() {
 fmt.Println("woof")
}


func (c Cat) Say() {
 fmt.Println("meow")
}


func (h Human) Say() {
 fmt.Println("speak")
}

之后,我们尝试使用这个接口来接收各种结构体的对象,然后调用它们的Say方法:

func main() {
 var m Mammal
 m = Dog{}
 m.Say()
 m = Cat{}
 m.Say()
 m = Human{}
 m.Say()
}

出来的结果当然和我们预想的一样:

总结

今天我们一起聊了面向对象中多态以及接口的概念,借此进一步了解了为什么golang中的接口设计非常出色,因为它解耦了接口和实现类之间的联系,使得进一步增加了我们编码的灵活度,解决了供需关系颠倒的问题。但是世上没有绝对的好坏,golang中的接口在方便了我们编码的同时也带来了一些问题,比如说由于没了接口和实现类的强绑定,其实也一定程度上增加了开发和维护的成本。

总体来说这是一个仁者见仁的改动,有些写惯了Java的同学可能会觉得没有必要,这是过度解绑,有些人之前深受其害的同学可能觉得这个进步非常关键。但不论你怎么看,这都不影响我们学习它,毕竟学习本身是不带立场的。今天的内容当中包含一些Java面向对象的概念,只是用来引出后面golang的内容,如果存在部分不理解的地方,希望大家抓大放小,理解核心关键就好了,不需要细扣每一个细节。

以上就是关于Go语言多态的实现与interface使用的相关介绍了,希望对大家有所帮助。

文章参考来源:www.toutiao.com/i6855609145085985287/?group_id=6855609145085985287

Golang中神奇的interface,不仅是接口还是类型

thbcm阅读(387)

本文准备介绍interface的一些其他方法。关于interface的基础知识可以看一下另一篇文章:Go语言多态和interface的使用

万能类型interface

Java以及其他语言当中接口是一种写法规范,而在golang当中,interface其实也是一种值,它可以像是值一样传递。并且在它的底层,它其实是一个值和类型的元组。

这里我们来看下golang官方文档当中的一个例子:

package main


import (
 "fmt"
 "math"
)


type I interface {
 M()
}


type T struct {
 S string
}


func (t *T) M() {
 fmt.Println(t.S)
}


type F float64


func (f F) M() {
 fmt.Println(f)
}


func main() {
 var i I


 i = &T{"Hello"}
 describe(i)
 i.M()


 i = F(math.Pi)
 describe(i)
 i.M()
}


func describe(i I) {
 fmt.Printf("(%v, %T)\n", i, i)
}

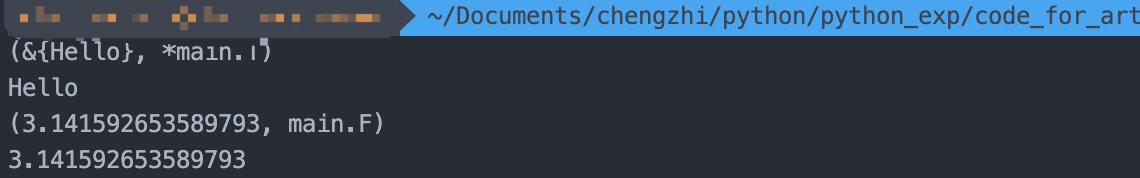
在上面的代码当中定义了一个叫做describe的方法,在这个方法当中我们输出了两个值,一个是接口i对应的值,另一个是接口i的类型。

(推荐课程:Go教程

我们输出的结果如下:

可以看到接口当中既存储了对应的结构体的实例的信息,也存储了结构体的类型。因此interface可以理解成一种特殊的类型。

实际上也的确如此,我们可以把interface理解成一种万能数据类型,它可以接收任何类型的值。我们看下下面这种用法:

var a1 interface{} = 1
var a2 interface{} = "abc"
list := make([]interface{}, 0)
list = append(list, a1)
list = append(list, a2)
fmt.Println(list)

在代码当中我们创建了一个interface{}类型的slice,它可以接收任何类型的值和实例。另外我们用interface{}这个类型也可以接收任何结构体的值。这里可能会有些迷惑,其实很容易想明白。interface表示一种类型,可以接收任何实现了interface当中规定的方法的类型的值。当我们定义inteface{}的时候,其实是定义了空的interface,相当于不需要实现任何方法的空interface,所以任何类型都可以接收,这也就是它成为万能类型的原因。

我们接收当然没有问题,问题是我们怎么使用这些interface类型的值呢?

一种方法是我们可以判断一个interface的变量类型。判断的方法非常简单,我们在interface的变量后面用.(type)的方法来判断。它和mapkey值判断一样,会返回一个值和bool类型的标记。我们可以通过这个标记判断这个类型是否正确。

if v, ok := a1.(int); ok {
    fmt.Println(v)
}

如果类型比较多的话使用switch也是可以的:

switch v := i.(type) {
case int:
    fmt.Println("int")
case string:
    fmt.Println("string")
}

空值nil

interface类型的空值是nil,和Python当中的None是一个意思,表示一个指针指向空。如果我们在Java或者是其他语言当中对一个空指针调用方法,那么会触发NullPointerMethodError,也就是空指针报错。这也是我们初学者在编程当中最容易遇到的错误,往往原因是忘记了对声明进行初始化导致的。

但是在golang当中不会,即使是nil也可以调用interface的方法。举个例子:

type T struct {
 S string
}


func (t *T) M() {
 fmt.Println(t.S)
}


func main() {
 var i I
 var t *T
 i = t
 i.M()
}

我们将t赋值给了i,问题是t并没有进行初始化,所以它是一个nil,那么我们的i也就会是一个nil。我们对nil调用M方法,在M方法当中我们打印了t的局部变量S。由于t此刻是一个nil,它并没有这个变量,所以会引发一个invalid memory address or nil pointer derefernce的错误,也就是对空指针进行寻址的错误。

要解决这个错误,其实很简单,我们可以在M方法当中对t进行判断,如果发现t是一个nil,那么我们则跳过执行的逻辑。当我们把M函数改成这样之后,就不会触发空指针的问题了。

func (t *T) M() {
    if t == nil {
        fmt.Println("nil")
        return
    }
 fmt.Println(t.S)
}

nil触发异常的问题也是初学者经常遇到的问题之一,这也要求我们在实现结构体内方法的时候一定要记得判断调用的对象是否为nil,避免不必要的问题。

(推荐课程:Go Web编程

赋值的类型选择

我们都知道golang当中通过interface来实现多态,只要是实现了interface当中定义的函数,那么我们就可以将对应的实例赋值给这个interface类型。

这看起来没有问题,但是在实际执行的时候仍然会有一点点小小的问题。比如说我们有这样一段代码:

type Integer int


type Operation interface {
 Less(b Integer) bool
 Add(b Integer)
}


func (a Integer) Less(b Integer) bool {
 return a < b
}


func (a *Integer) Add(b Integer) {
 *a += b
}

这段代码非常简单,我们定义了一个Operationinterface,并且实现了Integer类型的两个方法。表面上看一切正常,但是有一个细节。LessAdd这两个方法针对的类型是不同的,Less方法我们不需要修改原值,所以我们传入的是Integer的值,而Add方法,我们需要修改原值, 所以我们传入的类型是Integer的指针。

那么问题来了,这两个方法的类型不同, 我们还可以将它的值赋值给Operation这个interface吗?如果可以的话,我们应该传递的是值还是指针呢?下面代码当中的第二行和第三行究竟哪个是正确的呢?

var a Integer = 1
var b Operation = &a
var b Operation = a

答案是第二行的是正确的,原因也很简单,因为我们传入指针之后,golang的编译器会自动生成一个新的Less方法。在这个转换了类型的方法当中去调用了原本的方法,相当于做了一层中转。

func (a *Integer) Less(b Integer) bool{
    return (*a).Less(b)
}

那反过来行不行呢?我们也写出代码:

func (a Integer) Add (b Integer) {
    (&a).Add(b)
}

显然这样是不行的,因为函数执行之后修改的只能是Add这个方法当中a这个参数的值,而没办法修改原值。这和我们想要的不符合,所以golang没有选择这种策略。

(推荐微课:Go微课

总结

在今天的文章当中我们介绍了golang当中interface的一些高级用法,比如将它作为万能类型来接收各种格式的值。比如interface的空指针调用问题,以及interface中的两个函数接收类型不一致的问题。

也就是说在go语言当中,interface既是一种多态实现的规范,又有全能类型这样衍生的功能,这个设计的确是很惊艳的。对interface的熟练使用可以在一些问题当中大大降低我们编码的复杂度,以及运行的效率。这也是golang的原生优势之一。希望以上的相关介绍能对大家有所帮助。

文章参考来源:www.toutiao.com/a6859567247216771587/

JUC 之 BlockingQueue 接口以及 ArrayBlockingQueue 实现类详解

thbcm阅读(339)

队列是一种 FIFO(先进先出)的数据结构,本文要讲的 BlockingQueue 也是一种队列,而且强调了线程安全的特性。

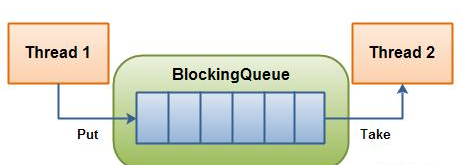
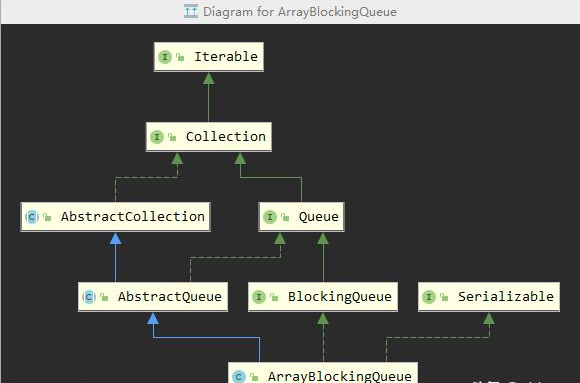
BlockingQueue全称:java.util.concurrent.BlockingQueue。它是是一个线程安全的队列接口,多个线程能够以并发的方式从队列中插入数据,取出数据的同时不会出现线程安全的问题。

生产者和消费者例子

BlockingQueue 通常用于消费者线程向队列存入数据,消费者线程从队列中取出数据,具体如下

  1. 生产者线程不停的向队列中插入数据,直到队列满了,生产者线程被阻塞
  2. 消费者线程不停的从队列中取出数据,直到队列为空,消费者线程被阻塞

(推荐教程:Java教程

BlockingQueue 方法

BlockingQueue 提供 4 种不同类型的方法用于插入数,取出数据以及检查数据,具体如下

  1. 操作失败,抛出异常
  2. 无论成功/失败,立即返回 true/false
  3. 如果队列为空/满,阻塞当前线程
  4. 如果队列为空/满,阻塞当前线程并有超时机制插入add(o) offer(o) put(o) offer(o, timeout, timeunit)取出remove(o) poll() take() poll(timeout, timeunit)检查element() peek()

BlockingQueue 的具体实现类

BlockingQueue 只是一个接口,在实际开发中有如下的类实现了该接口。

  1. ArrayBlockingQueue
  2. DelayQueue
  3. LinkedBlockingQueue
  4. PriorityBlockingQueue
  5. SynchronousQueue

ArrayBlockingQueue 的使用

这里以 BlockingQueue 接口的具体实现类 ArrayBlockingQueue 举例。通过 ArrayBlockingQueue实现一个消费者和生产者多线程模型。

核心内容如下:

  1. ArrayBlockingQueue 作为生产者和消费者的数据容器
  2. 通过 ExecutorService 启动 3 个线程,2 两个生产者,1 个消费者
  3. 指定数据总量

(推荐微课:Java微课

生产者线程

ArrayBlockingQueueProducer

import org.slf4j.Logger;
import org.slf4j.LoggerFactory;


import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.atomic.AtomicInteger;


/**
 * 生产者线程向容器存入指定总量的 任务
 *
 */
public class ArrayBlockingQueueProducer implements Runnable {


    private static final Logger logger = LoggerFactory.getLogger(ArrayBlockingQueueProducer.class);


    // 容器
    private ArrayBlockingQueue<String> queue;
    // 生产指定的数量
    private AtomicInteger numberOfElementsToProduce;


    public ArrayBlockingQueueProducer(ArrayBlockingQueue<String> queue, AtomicInteger numberOfElementsToProduce) {
        this.queue = queue;
        this.numberOfElementsToProduce = numberOfElementsToProduce;
    }


    @Override
    public void run() {
        try {
            while (numberOfElementsToProduce.get() > 0) {
                try {
                    // 向队列中存入任务
                    String task = String.format("task_%s", numberOfElementsToProduce.getAndUpdate(x -> x-1));
                    queue.put(task);
                    logger.info("thread {}, produce task {}", Thread.currentThread().getName(), task);


                    // 任务为0,生产者线程退出
                    if (numberOfElementsToProduce.get() == 0) {
                        break;
                    }
                } catch (Exception e) {
                    e.printStackTrace();
                }
            }
        } catch (Exception e) {
            logger.error(this.getClass().getName().concat(". has error"), e);
        }


    }
}

消费者线程

ArrayBlockingQueueConsumer

import org.slf4j.Logger;
import org.slf4j.LoggerFactory;


import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.atomic.AtomicInteger;


/**
 * 消费者线程向容器 消费 指定总量的任务
 *
 */
public class ArrayBlockingQueueConsumer implements Runnable {


    private static final Logger logger = LoggerFactory.getLogger(ArrayBlockingQueueConsumer.class);


    private ArrayBlockingQueue<String> queue;
    private AtomicInteger numberOfElementsToProduce;


    public ArrayBlockingQueueConsumer(ArrayBlockingQueue<String> queue, AtomicInteger numberOfElementsToProduce) {
        this.queue = queue;
        this.numberOfElementsToProduce = numberOfElementsToProduce;
    }


    @Override
    public void run() {
        try {
            while (!queue.isEmpty() || numberOfElementsToProduce.get() >= 0) {
                // 从队列中获取任务,并执行任务
                String task = queue.take();
                logger.info("thread {} consume task {}", Thread.currentThread().getName(),task);


                // 队列中数据为空,消费者线程退出
                if (queue.isEmpty()) {
                    break;
                }
            }
        } catch (Exception e) {
            logger.error(this.getClass().getName().concat(". has error"), e);
        }
    }
}

测试 TestBlockingQueue

import com.ckjava.synchronizeds.appCache.WaitUtils;


import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import java.util.concurrent.atomic.AtomicInteger;


/**
 * 1. 以 ArrayBlockingQueue 作为生产者和消费者的数据容器 <br>
 * 2. 通过 ExecutorService 启动 3 个线程,2 两个生产者,1 个消费者 <br>
 * 3. 指定数据总量
 */
public class TestBlockingQueue {
    public static void main(String[] args) {
        ArrayBlockingQueue<String> arrayBlockingQueue = new ArrayBlockingQueue<>(10);
        /*BlockingQueue delayQueue = new DelayQueue();
        BlockingQueue<String> linkedBlockingQueue = new LinkedBlockingQueue<>(10);
        BlockingQueue<String> priorityBlockingQueue = new PriorityBlockingQueue<>(10);
        BlockingQueue<String> synchronousQueue = new SynchronousQueue<>();*/


        ExecutorService executorService = Executors.newFixedThreadPool(3);
        // 最多生产 5 个数据
        AtomicInteger numberOfElementsToProduce = new AtomicInteger(5);


        // 2 个生产者线程
        executorService.submit(new ArrayBlockingQueueProducer(arrayBlockingQueue, numberOfElementsToProduce));
        executorService.submit(new ArrayBlockingQueueProducer(arrayBlockingQueue, numberOfElementsToProduce));
        // 1 个消费者线程
        executorService.submit(new ArrayBlockingQueueConsumer(arrayBlockingQueue, numberOfElementsToProduce));


        executorService.shutdown();
        WaitUtils.waitUntil(() -> executorService.isTerminated(), 1000L);
    }
}

输出如下:

13:54:17.884 [pool-1-thread-3] INFO  c.c.b.ArrayBlockingQueueConsumer - thread pool-1-thread-3 consume task task_5
13:54:17.884 [pool-1-thread-1] INFO  c.c.b.ArrayBlockingQueueProducer - thread pool-1-thread-1, produce task task_5
13:54:17.884 [pool-1-thread-2] INFO  c.c.b.ArrayBlockingQueueProducer - thread pool-1-thread-2, produce task task_4
13:54:17.887 [pool-1-thread-3] INFO  c.c.b.ArrayBlockingQueueConsumer - thread pool-1-thread-3 consume task task_4
13:54:17.887 [pool-1-thread-2] INFO  c.c.b.ArrayBlockingQueueProducer - thread pool-1-thread-2, produce task task_2
13:54:17.887 [pool-1-thread-1] INFO  c.c.b.ArrayBlockingQueueProducer - thread pool-1-thread-1, produce task task_3
13:54:17.887 [pool-1-thread-3] INFO  c.c.b.ArrayBlockingQueueConsumer - thread pool-1-thread-3 consume task task_3
13:54:17.887 [pool-1-thread-2] INFO  c.c.b.ArrayBlockingQueueProducer - thread pool-1-thread-2, produce task task_1
13:54:17.887 [pool-1-thread-3] INFO  c.c.b.ArrayBlockingQueueConsumer - thread pool-1-thread-3 consume task task_2
13:54:17.887 [pool-1-thread-3] INFO  c.c.b.ArrayBlockingQueueConsumer - thread pool-1-thread-3 consume task task_1

(推荐内容:Java面试基础题

以上就是关于JUCBlockingQueue 接口以及 ArrayBlockingQueue 实现类的相关介绍了,希望对大家有所帮助。

联系我们