5 种方法带你查看Linux系统服务

thbcm阅读(398)

Linux 系统服务有时也称为守护程序,是在Linux启动时自动加载并在Linux退出时自动停止的系统任务。

在本文中将为大家介绍如何列出 Linux 系统里所有运行的服务,以及如何检查某个服务的当前状态。

Centos/RHEL 7.X 的 systemd 系统服务查看

CentOS 7.x开始,CentOS开始使用 systemd 服务来代替 daemon ,原来管理系统启动和管理系统服务的相关命令全部由 systemctl 命令来代替。

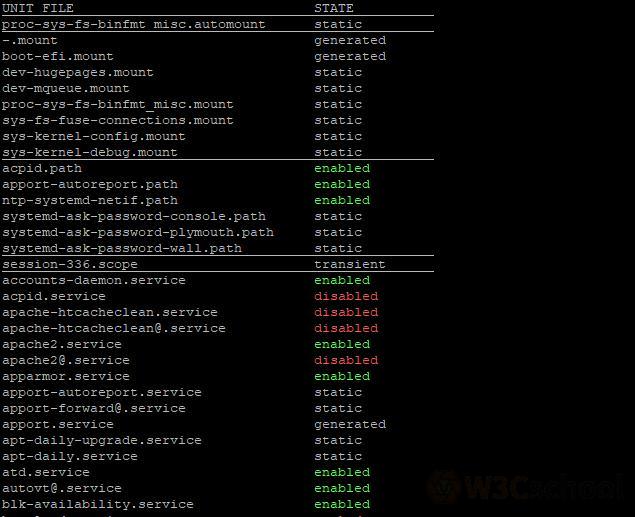
systemctl list-unit-files

命令的输出结果如下:

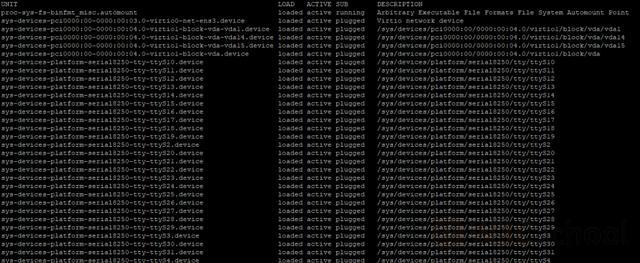
查看所有运行着的 systemd 服务可以运行以下命令:

systemctl | more

命令的输出结果如下:

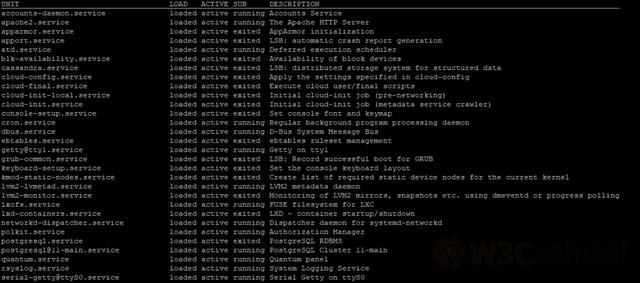
除此之外,你还可以使用以下命令:

systemctl list-units –type service

命令的输出结果如下:

如果你想要在结果里搜索某个特定的服务,可以使用管道及 grep 命令。

systemctl | grep “apache2”

命令的输出结果如下:

使用 netstat 命令查看系统服务

Netstat 命令是用来检查活动的网络连接、接口统计分析,以及路由表状态。这个命令在所有的 Linux 发行版都可用,我们接下来就用它来查看系统服务。

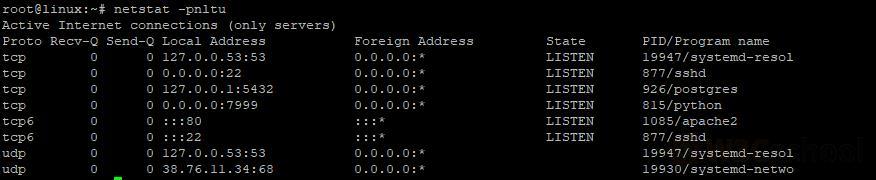
查看服务及它们所监听的端口:

netstat -pnltu

命令的输出结果如下:

通过系统服务配置文件查看系统服务

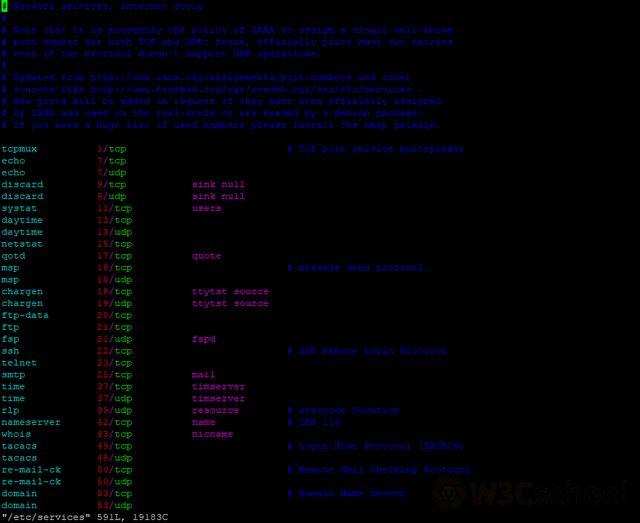
服务的配置文件是 /etc/services 是一个 ASCII 文件,它包含了一系列的用户程序可能用到的服务。在这个文件里,包括了服务名称,端口号,所使用的协议,以及一些别名。

对于这个文件,我们可以使用任意的文本工具查看,比如vim

vim /etc/services

命令的输出结果如下:

查看 systemd 服务状态

在一些新版的 Linux 系统,已经有些用 systemd 来取代 init 进程了。在这种系统里,如何去查看系统服务呢?我们可以使用以下语法:

systemctl status service_name

比如说,查看你系统上的 OpenSSH 是否在运行,可以运行:

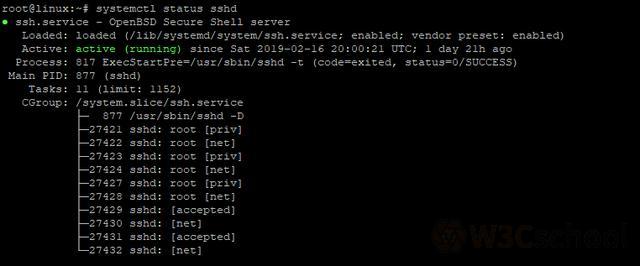
systemctl status sshd

命令的输出结果如下:

或者,你也可以使用以下命令格式去查看某个服务是否正在运行:

systemctl is-active service_name

如果使用这条命令的话,实现上面那个例子对应的命令为:

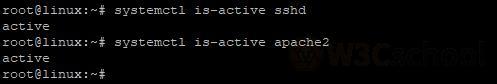
systemctl is-active sshd

命令的输出结果如下:

同时,你也可以查看一个服务是否已经被使能了,可以使用以下命令:

systemctl is-enabled service_name

比如,检查 OpenSSH 服务是否已经使能,可能输入以下命令:

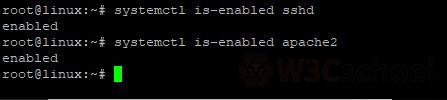
systemctl is-enabled sshd

命令的输出结果如下:

早期版本的服务状态查看

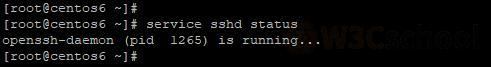
其实也不能说早期,现在依然还有很多这样的系统,上面跑着 SysV init 进程。对于这种系统,查看服务状态的命令为:

service service_name status

还是查看 OpenSSH 状态的例子,对应的命令为:

service sshd status

命令的输出结果如下:

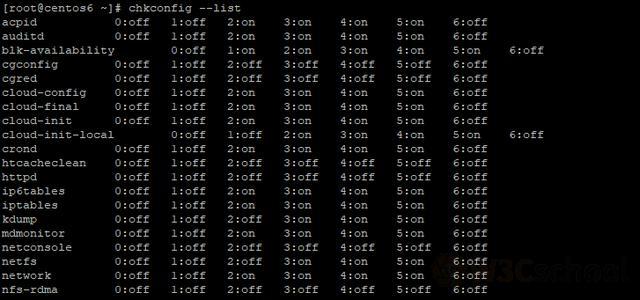
你也可以使用以下命令来查看所有的服务状态:

chkconfig –list

命令的输出结果如下:

以上就是查看Linux 系统服务的 5 大方法了。希望对大家有所帮助,对Linux有兴趣的同学可以看一下教程

Linux教程:https://www.w3cschool.cn/linux/

Linux微课:https://www.w3cschool.cn/minicourse/play/linuxcourse

Linux就该这么学:https://www.w3cschool.cn/linuxprobe/

带你认识现代C++,看看C++11常用特性

thbcm阅读(343)

C++11已经出来很久了,网上也早有很多优秀的C++11新特性的总结文章,所以本文就是对带你了解一下C++11的一些新特性。

C++ 是一个拥有用户群体相当大的语言,同时也在多个领域使用的语言。从 C++98 的出现到 C++11 的正式定稿经历了长达十年多之久的积累。

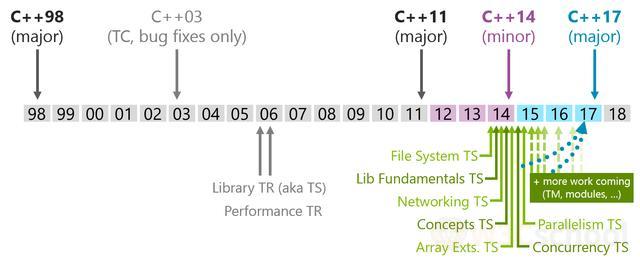
C++11C++ 的第二个主要版本(前一个是 C++98 而后一个是 C++17,C++14则是C++11的一次小的改进 ),并且是从 C++98 起的最重要更新。它引入了大量更改,标准化了既有实践,并改进了对 C++ 程序员可用的抽象。

C++14/17 则是作为对 C++11 的重要补充和优化, C++20 则将这门语言领进了现代化的大门,所有这些新标准中扩充的特性,给 C++ 这门语言注入了新的活力。

C++11是对目前C++语言的扩展和修正, C++11不仅包含核心语言的新技能,而且扩展了C++的标准程序库(STL) ,并入了大部分的C++ Technical Report 1(TR1) 程序库(数学的特殊函数除外)。

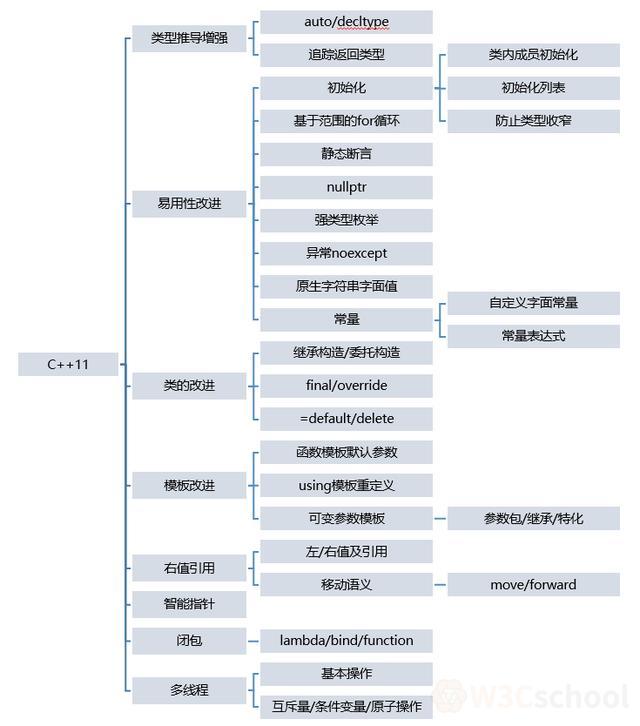
C++11关键新特性:

核心语言功能特性

  • auto 与 decltype
  • 预置与弃置的函数
  • final 与 override
  • 尾随返回类型
  • 右值引用
  • 移动构造函数与移动赋值运算符
  • 有作用域枚举
  • constexpr 与字面类型
  • 列表初始化
  • 委托与继承的构造函数
  • 花括号或等号初始化器
  • nullptr
  • long long
  • char16_t 与 char32_t
  • 类型别名
  • 变参数模板
  • 推广的(非平凡)联合体
  • 推广的 POD (平凡类型与标准布局类型)
  • Unicode 字符串字面量
  • 用户定义字面量
  • 属性
  • lambda 表达式
  • noexcept 说明符与 noexcept 运算符
  • alignof 与 alignas
  • 多线程内存模型
  • 线程局部存储
  • GC 接口
  • 范围 for (基于 Boost 库)
  • static_assert (基于 Boost 库)

库功能特性

头文件

<typeindex> <type_traits> <chrono> <initializer_list> <tuple> <scoped_allocator> <cstdint> <cinttypes> <system_error> <cuchar> <array> <forward_list> <unordered_set> <unordered_map> <random> <ratio> <cfenv> <regex> <atomic> <thread> <mutex> <future> <condition_variable>

库功能特性

  • 原子操作库
  • emplace() 与其他遍及既存标准库所有部分的右值引用使用
  • std::unique_ptr
  • std::move_iterator
  • std::initializer_list
  • 有状态及有作用域分配器
  • std::forward_list
  • chrono 库
  • ratio 库
  • 新算法
  • Unicode 转换平台
  • thread library
  • std::exception_ptr
  • std::error_code 与 std::error_condition
  • 迭代器改进:
  • std::begin
  • std::end
  • std::next
  • std::prev
  • Unicode 转换函数

一款新的APP开发框架–Flutter

thbcm阅读(360)

由于物联网的快速发展,新的APP开发热潮正在到来,谷歌、华为这些公司正在重新定义移动开发框架,而Flutter就是可选择之一。不敢说Flutter一定是移动技术的未来,但一定代表了移动技术的发展方向。

一、Flutter是什么

FlutterGoogle 于 2015 年 5 月 3 日推出的免费开源跨平台开发框架,可以快速在iOSAndroid上构建高质量的原生用户界面。Flutter旨在帮助开发者使用一套代码开发高性能、高稳定性、高帧率、低延迟的AndroidiOS应用。Flutter使用的是 Google 自己开发的网络编程语言——Dart语言

二、Flutter 的发展

2015年 05 月Flutter的第一个版本“Sky”在Dart开发者峰会上亮相;

2018年02月27日在世界移动大会 (MWC)上宣布了第一个 Beta 版发布;

2018年03月06日Beta 2版本发布;

2018年12月05日谷歌发布 Flutter 1.0 正式版;

2019年9月谷歌发布Flutter 1.9

目前很多大公司、开发者纷纷转型使用和学习 Flutter 进行跨平台应用的开发。全世界已经有多个公司开始使用 Flutter 来开发应用,包括 Abbey Road Studios阿里巴巴Capital OneGrouponHamilton京东Philips HueReflectly 以及腾讯等。Flutter 1.9于 2019 年 9月发布,这样的更新频率给开发者和公司增加了动力,Flutter 势必将成为未来跨平台开发主流趋势。

三、Flutter框架特性

快速开发

Flutter的热重载能力帮助开发者快捷方便的试验、重构UI、添加特性和修复bug。在仿真器、模拟器、ios、android硬件上体验亚秒级的重载,而不会丢失状态。

跨平台

Flutter基于图像绘制引擎进行渲染,在不同平台下绘制效果绝对一致,能做到真正的跨平台。

绚丽UI

通过Flutter内建的、漂亮的、有质感设计的Cupertino(ios-flavor)小工具、丰富的动画API,平滑的自然滚动和平台感知,让用户感受UI设计的快乐。

响应式

通过Flutter的现代响应式(Reactive)框架、丰富的平台布局、基础组件,能够轻松的构建用户界面。使用强大而灵活的API解决2D、动画、手势、效果等难题。

访问原生功能

通过平台api第三方sdk原生代码,使应用变得生动。Flutter可以重用现有的javaswiftObjc代码,并在iOSAndroid上访问原生特性和SDK

四、目前各种跨平台方案的对比

开发APP应用,如需要同时兼容iOSAndroid两种平台,有两种技术选择:

1、走原生开发路线,把界面和逻辑在不同平台分别实现;

2、用同一套代码兼容多个平台,但这往往意味着运行速度和产品体验的损失。

除了原生外,目前跨平台技术一般是混合开发,如采用 H5React NativeWeex、小程序等技术实现跨平台应用。不过这些混合开发,或多或少都能感觉到UI卡顿和体验不流畅,并且开发和学习成本非常高,有各自的局限性。

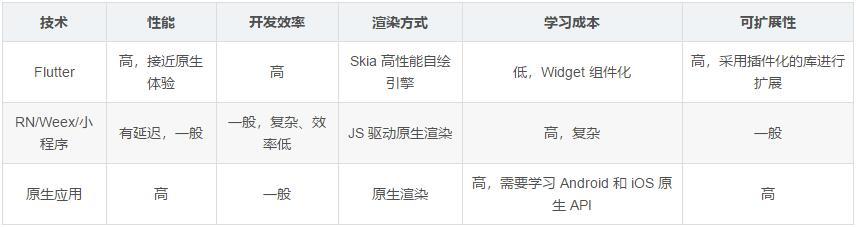
Flutter的出现,为开发者提供了一套两全其美的解决方案:既能用原生代码直接调用的方式来加速图形渲染和 UI 绘制,又能同时运行在两大主流移动操作系统上,并且体验和流畅度和原生基本一致、开发效率非常高、学习难度和成本低。

从上面的对比可以看出,Flutter 优势明显:高体验度、高开发效率、低学习成本、高可扩展性。未来 Google Flutter团队还将会使 Flutter 支持 PCWeb 的跨平台开发,实现真正全平台。 针对Flutter的跨平台特性,与react nativeweex做对比可以发现,其性能碾压后两者,采用自带Skia绘制引擎,性能堪比原生。

以上就是关于Flutter的一些介绍了,对Flutter感兴趣的同学可以看一下教程:

想在JavaScript更进一步,你需要掌握这 36 个概念

thbcm阅读(369)

你可能会经常听到一些人在抱怨 JS 很奇怪,有时甚至是一文不值。之所以有这种想法,是因为他们不太了解 JS 背后的运作方式。我也觉得 JS 在某些情况处理方式与其它语言不太一样,但这并不能怪它,它也只是以自己的方式展现给大家而已。

如果,你热爱一门编程语言,那么应该就会想深入了解并逐个掌握它的概念。

这里列出了36个JavaScript概念,你需要掌握这些概念才能成为一个更懂 JS 的前端开发者。

1.调用堆栈执行

我们都知道堆栈溢出,但是你知道堆栈溢出是由什么原因导致的吗? 堆栈溢出是与调用堆栈一些操作错误相关联的。

理解了调用堆栈,你就会清楚解像是JS 这们的编程语言是如何执行的。

2. 原始数据类型

const foo = "bar";
foo.length; // 3
foo === "bar"; // true

这里,我们将值bar分配给常量foo时,它属于原始类型string。这个每个人都知道。但是各位少侠想没想过一个问题,string是基本数据类型,怎么能调用方法了?

奇怪吗? 不。

这个特性称为自动装箱。每当读取一个基本类型的时候,JS 后台就会创建一个对应的基本包装类型对象,从而让我们能够调用一些方法来操作这些数据。

还是拿上面的例子开始:

const foo = "bar";
foo.length; // 3
foo === "bar"; // true

变量 foo 是一个基本类型值,它不是对象,它不应该有方法。但是 JS 内部为我们完成了一系列处理(即装箱),使得它能够调用方法,实现的机制如下:

  • 创建String类型的一个实例
  • 在实例上调用指定的方法
  • 销毁这个实例
const foo  = new String("bar");
foo.length
foo === 'bar'
foo = null

通过对原始数据类型有深入的了解,我们就应该知道这些“怪异”情况是如何发生的,以及它们背后的逻辑原因。

3.值类型和引用类型

最近,我对 “引用传递” 在 JS 是怎么工作的感到困惑。尽管我知道 CJava 等语言中有“按引用传递”和“按值传递”的概念,但是我不确定它在 JS 中如何工作。

你是否知道分配给 JS 中非原始值的变量对该值的引用?引用指向存储值的内存位置。。

var arr1 = [1,2,3];
var arr2 = arr1;
arr2.push(10);
console.log(arr2);
//[1, 2, 3, 10]
console.log(arr1);
//[1, 2, 3, 10]

上面的示例中可以看到,对arr2所做的任何修改也将体现在arr1上。这是因为它们仅保存值对应的内存地址的引用,而非值本身。

通过了解值类型和引用类型的概念,你就会更好地了解如何为变量分配值和内存引用。

4. 强制类型转换

这个概念主要解释了隐式和显式类型强制之间的区别。这是前端开发中对 JS 迷惑少数几个领域之一。对于隐式强制转换的概念尤其如此,因为它对不同的数据类型以不同的方式表现。

这是 JS 面试中最常被考的。

Number('789')   // 显式
+'789'          // 隐式
789 != '456'    // 隐式
9 > '5'         // 隐式
10/null          // 隐式
true | 0        // 隐式

掌握了类型显隐转换,恭喜你对 JS 了解就进一步了。

5. 比较运算符号 和 typeof 运算符

双等与三等,它们在大多数情况下在表面上看起来相同并且给出相同的结果,但是,它们有时候可能会给带来意想不到的错误。

为了了解这两亲兄弟的区别,我们可以借助 typeof 来查看被比较的值的类型。

typeof 3 // "number"
typeof "abc" // "string"
typeof {} // "object"
typeof true // "boolean"
typeof undefined // "undefined"
typeof function(){} // "function"
typeof [] // "object"
typeof null // "object"

6. JavaScript 作用域

作用域是 JS 中一个很重要的尴尬,JS 也一直在不断完善自己的作用域。根据Wissam的说法,作用域的简单定义是,编译器在需要时查找变量和函数。

了解作用域有助于我们有效地使用JavaScript。我们还需要了解全局作用域以及块和函数作用域,也称为词法作用域。JS 作用域一开始接触会感到很困惑,但是一旦你了解了事情的幕后原理,使用它就会非常令人兴奋。

(推荐教程: JavaScript教程

7. 语句和声明

JavaScript 程序是一系列可执行语句的集合。所谓语句,就是一个可执行的单元,通过该语句的执行,从而实现某种功能。通常一条语句占一行,并以分号结束。默认情况下,JavaScript 解释器按照语句的编写流程依次执行。如果要改变这种默认执行顺序,需要使用判断、循环等流程控制语句。

我们应该要知道 语句和声明 的区别,这对我们全面了解 JS 是很有帮助的。

8. 立即调用的函数表达式和模块

IIFE: Immediately Invoked Function Expression,意为立即调用的函数表达式,也就是说,声明函数的同时立即调用这个函数。它主要用于避免污染全局作用域。后来,引入了ES6模块,为避免全局作用域的污染提供了一种标准方法,尽管有人认为它不是IIFE的直接替代。

通过理解IIFE和模块,你可以构建较少由于全局空间处理不当而导致的错误的应用程序。当然,使用模块,我们还可以做很多事情。

9.消息队列和事件循环

正如MDN文档所说,JavaScript 有一个基于事件循环的并发模型,事件循环负责执行代码、收集和处理事件以及执行队列中的子任务。这个模型与其它语言中的模型截然不同,比如 CJava

在并发模型中,消息队列用于处理最早的消息。只要有事件发生,便会加入消息队列中。通过理解这些概念,你可以更好地理解JS在底层是如何工作的,以及知道你的代码是如果运行的。

10.时间间隔

想在 JS 有计划的调用的函数,可以使用下面两个函数:

  • setTimeout 允许我们在特定时间间隔后运行一次函数。
  • setInterval允许我们重复运行一个函数,从一个特定的时间间隔开始,然后以该间隔连续重复。 这些与前面的消息队列和事件处理程序的概念有些关联。因此,通过理解时间间隔方法,我们可以理解它们是如何工作的,并在我们的用例中有效地使用它们。

11.JS 引擎

JavaScript引擎是执行 JS 代码的计算机程序或解释器。JS 引擎可以用多种语言编写。例如,驱动Chrome浏览器的V8引擎是用 c++ 编写的,而驱动Firefox浏览器的SpiderMonkey引擎是用 Cc++ 编写的。

要想编写高效的代码,你必须了解所使用的 JS 引擎。使用webview的移动开发人员要特别注意这一点。

12.按位运算

按位运算操作将值视为位(0和1),而不是十进制,十六进制或八进制数字。按位运算符对此类二进制表示形式执行其操作,但是它们返回标准JavaScript数值。

通常,很少会在代码中使用这些操作,但是它们确实有一些用例。比如,可以使用它们来查找偶数和奇数值,颜色转换,颜色提取等等。

通过全面了解这些按位操作,您可以很好地使用 WebGL 之类的技术,因为它包含许多像素操作。

13. DOM 和布局树

我们大多数人都听说过文档对象模型(DOM),但只有少数人对此有深入的了解。你知道在浏览器中看到的不是DOM吗?而是渲染树,它实际上是DOMCSSOM的组合。

通过理解DOM的工作方式、结构以及页面的渲染方式,我们就能够在 JS 的帮助下动态地操作web页面。这对于确保我们的应用程序具有高标准的性能尤为必要。

14.类和工厂

JavaScript 不是一种面向对象的语言。但是,为了模仿OOP属性,使用了构造函数。根据Tania的说法,“JavaScript中的类实际上并没有提供其他功能,只是在原型和继承上提供语法糖,因为它们提供了更简洁,更优雅的语法。由于其他编程语言都使用类,因此 JS 中的类语法使开发人员在各种语言之间移动变得更加简单。”

工厂函数是不是返回对象的类或构造函数的函数。根据JS专家Eric Elliot的说法,“在JavaScript中,任何函数都可以返回一个新对象。如果它不是构造函数或类,则称为工厂函数。”

当开始开发规模更大的应用程序时,理解这两个概念是很有必要的。

15.this 关键字和 apply,call及bind方法

就我个人而言,我认为对于一个JS开发人员来说,理解this 关键字是至关重要的。如果你不能正确地理解它,将来你开发的项目也会经常遇到this相关的问题。

如果你对this关键字很清楚,则可以看看applycallbind方法,这些都可以解决 this 指向引发的问题。

16.构造函数和 “instanceOf” 运算符

构造函数就像常规函数一样。但是它们有很多差异,函数名称以大写字母开头,并且只能由new运算符执行。具有OOP开发经验的程序员会熟悉new关键字。

为了正确识别对象的类型,我们使用instanceOf运算符。简单来说,它检查一个对象是否是另一个对象的实例。

这才助于你理解对象如何相互继承,继承是通过原型实现的。

17.原型

这是 JS 中最令人困惑的概念之一,即使对于有十年经验的人来说也是如此。

JavaScript中的原型是在对象之间共享通用功能的机制。JavaScript中几乎所有对象都是Object的实例。对象会从Object.prototype继承所有属性和方法。

简单来说,原型是 JS 对象从中继承方法和属性的对象。

理解了原型,你就可以构建高效,快速的应用程序。

(推荐微课:JavaScript微课

18. 使用 new,Object.create 和 Object.assign 创建对象

创建对象有很多方法。但是,大都会选择Object.create方法而不是new关键字。这是有原因的,因为 使用Object.create方法时,可以将现有对象用作新创建的对象的原型。这样就可以重用现有对象的属性和功能,有点像OOP中的继承概念。

使用Object.assign方法时,可以将可枚举的自身属性从一个或多个源对象复制到目标对象。在这种情况下,目标对象的原型不包含源对象的属性。这是这两种方法之间的主要区别。

通过了解对象创建的这三种方式,可以根据实际情况适当地使用它们,以创建效率更高的程序。

19.map,filter, reduce 方法

当涉及到数组操作时,这三种方法非常有用。它们可以在Array原型中找到。

如果你有一个数组,并且想对每个元素做一些事情,那么您可以使用map方法。

如果你有一个数组,并且想通过某些条件来过滤一些值时,则可以使用filter方法。

reduce() 方法对数组中的每个元素执行一个由你提供的reducer函数(升序执行),将其结果汇总为单个返回值。

典型的例子就是对数组的所有元素进行求和:

let numbers = [1,2,3,4,5,6]
const reduced = numbers.reduce( (accumulator, currentValue) => accumulator + currentValue )
console.log(reduced)
// 21

请注意,上述三种方法不会更改原始数组的值。

20.纯函数,副作用和状态变更

这三个概念对于 JS 开发人员而言非常重要,状态变更对于使用 React 的开发人员尤其重要。

纯函数指的是一个函数的返回结果只依赖于它的参数,并且在执行过程里面没有副作用。

函数副作用是指当调用函数时,除了返回函数值之外,还对主调用函数产生附加的影响。副作用的函数不仅仅只是返回了一个值,而且还做了其他的事情,比如:

  • 修改了一个变量
  • 直接修改数据结构
  • 设置一个对象的成员
  • 抛出一个异常或以一个错误终止
  • 打印到终端或读取用户输入
  • 读取或写入一个文件
  • 在屏幕上画图

状态变更是指你更改变量值的地方。如果你对变量进行更改,则可能会影响到其他函数,具体取决于变量被更改之前的值。在React环境中,建议我不要改变状态。

21. 闭包

闭包很难理解。但是一旦理解,你会觉得 JS 其实也挺好的。在线上有足够的资源。你花足够的时间学习闭包,掌握理解它并不难。

使用闭包可以访问内部作用域中外部作用域的作用域。每次创建函数时都会在函数创建时创建JavaScript闭包。

22. 高阶函数

高阶函数是将其他函数作为参数或返回结果的函数。你可以创建仅负责一项任务的较小函数,然后在这些较小函数的帮助下构造复杂函数。这也会提交代码的可重用性。

23.递归

递归是所有编程语言中的一个常见概念。简单地说,递归就是把大问题分解成小问题,然后解决小问题一种思路。

尽管递归可能是一个让你头疼的令人困惑的概念,但是通过大量的练习,从一些小问题开始,你可以更好地理解它。

24.集合与生成器

ES6 中新引入了集合和生成器。新引入的集合有MapSetWeakSet和WeakMap。这些集合为我们提供一些很方便的操作。了解它们的方式至关重要,尤其是对于现代JavaScript

生成器有时很难理解,特别是对于初学者。生成器允许我们编写代码函数,从而能够暂停和重新启动函数,而不会阻止其他代码的执行,这在JavaScript中是很不常见的。

25. Promise

JecelynPromises 的解释如下:“想象一下你是个孩子。你妈妈向你保证,她下周会买一部新手机给你。”

你要到下周才能知道你是否能屋那部手机。你的妈妈要么真的给你买了一个全新的手机,要么因为不开心就不给你买。

这算是一个承诺。一个 Promise 有三个状态,分别是:

  1. Pending:你不知道你是否会能得到那个电话
  2. Fulfilled:妈妈高兴了,给你买了一部新手机
  3. Rejected:老妈不开心了,就是不给买,爱咋滴就咋滳

26.异步编程

要了解什么是异步编程,首先要先积善成德什么是同步编程。同步编程是线程阻塞的,由于 JS 是单线程的,因此代码将逐行执行。

但是使用异步代码,你可以执行一些比较耗时的任务。当你必须执行花费很长时间才能完成的多个任务时,此功能特别有用。但是在某些情况下,即使是需要执行很长时间的代码,也可能需要用同步的方式,这时就可以使用async/await

27. ES6 箭头函数

箭头函数是 ES6 的新增功能,是常规函数的语法替代。区别在于箭头函数不绑定到thisargumentssupernew.target关键字。这使得箭头函数在某些情况下是一个不错的选择,而在另一些情况下则是一个非常糟糕的选择。

因此,不要一上来就使用箭头函数。需要根据你实际情况还使用它们。

28. 数据结构

无论使用哪种编程语言,数据结构都是开发人员应具备的基本知识之一。

糟糕的程序员担心代码,好的程序员担心数据结构和它们之间的关系。

数据结构方面,你应该了解链表,队列,堆栈,树,图和哈希表。

29.时间复杂度

不管编程语言如何,时间复杂度分析也是计算机编程的另一个基础。为了构建更好的应用程序,你应该编写更好的解决方案。为此,你需要了解时间复杂度的概念。有时也称为BigO

30.算法

这也是在计算机基础课程中首先要教的内容之一。简而言之,算法是逐步实现目标的过程。程序员应该能够从算法的角度看任何问题。

尽管有成千上万个用例的大量算法,但是下面两个很常见:

  • 查找
  • 排序

这两个用例对程序员来说是非常常见的,至少应该了解实现它们的已知算法。没有固定的规则规定你应该使用这些算法之一,但是这些算法在性能方面是众所周知的,并且有很好的文档证明。

你甚至可以创建自己的算法,并将其介绍给世界。如果它比目前已知的算法更好,你可能会成为下一个编程明星。

31.继承,多态和代码重用

JS 中的继承可用于原型来实现。这是因为 JS 是非OOP语言。但是 JS 通过提供原型继承来提供OOP的某些功能。

多态是对象、变量或函数可以采用多种形式的概念。在 JS 中,要看到多态的效果有点困难,因为在静态类型的系统中,多态的经典类型更明显。

以上两个概念都可以帮助我们在 JS 中实现更好代码重用。

32.设计模式

设计模式(Design pattern)代表了最佳的实践,通常被有经验的面向对象的软件开发人员所采用。设计模式是软件开发人员在软件开发过程中面临的一般问题的解决方案。这些解决方案是众多软件开发人员经过相当长的一段时间的试验和错误总结出来的。

33. 函数式编程

函数式编程是一种编程范式,是一种构建计算机程序结构和元素的风格,它把计算看作是对数学函数的评估,避免了状态的变化和数据的可变。

你需要掌握函数式编程的几个概念:

  • 纯函数
  • 不可变
  • 引用透明性
  • 高阶函数

34. 简洁代码的原则

无论使用哪种编程语言,这都是每个开发人员都应该掌握的一项基本技能。每种编程语言都有一套单独的良好实践。尽管这些“良好”做法是主观的,并且在工作场所之间存在差异,但有些惯例被认为是“良好”。

通过遵循这些代码原则,可以确保每个人都可以阅读和维护你的代码。这也会帮助你和你的团队在应用程序开发过程中顺利合作。

35. 解构赋值

ES6中引入了解构赋值操作符,它非常有用。对于相同的用例,它们比以前的实现更简单、更有效。

36. ES2020新特性

编程的优点之一是,如果你不去不断学习,你永远不会成为该领域专家。编程语言会随着时间不断发展,因为每个主要版本中都引入了其他新的功能。

这也说明了你对某个概念的专业知识很可能在将来的10年后会过期,因为会有更好的替代版本与版本更新一起发布。对于任何编程语言,这都是非常常见的情况。

ES2020发布了几个新特性,包括可选链接、空值合并、动态导入等等。你必须学习这些新概念,以跟上快速变化的It世界。

掌握一门语言需要多年的经验和时间,但是知道要掌握什么会让事情变得更容易,希望这36个概念能对你有所帮助。

文章来源:medium.com/better-programming/36-javascript-concepts-you-need-to-master-to-become-an-expert-c6630ac41bf4

JavaWeb 中 Service 层异常是直接处理还是抛到Controller 层处理

thbcm阅读(332)

JavaWebService 层异常会怎么处理?这是个非常有启发意义的问题。

一般初学者学习编码和错误处理时,先知道编程语言有一种处理错误的形式或者约定(如Java就是抛异常),然后就开始用这些工具,但是却反过来忽视这个问题的本质:

处理错误是为了写出正确的程序

到底怎么算“正确”呢?是要由解决的问题决定的。问题不同,解决方案就不同。

比如,一个web接口接受用户的请求,这个请求需要传入一个参数“年龄”,也许业务要求这个字段应该是个0~150之间的整数。如果用户输入的是个字符串或者负数就肯定不被接受。一般在后端的某个地方都会做输入的合法性检查,检查不过就抛异常。但是归根到底这个问题的“正确”解决方法总是要以某种形式提示用户。而提示用户是某种前端工作,这就要看这个界面到底是appH5 + ajax还是类似于jsp那样的服务器产生的界面。不管哪种,你需要根据需求去”设计一个修复错误“的流程。比如一个常见的流程需要后端抛异常,然后一路到某个集中处理错误的代码,将其转换为某个HTTP的错误(某个特定业务错误码)提供给前端,前端再去做”提示“。如果用户输入了非法的请求,从逻辑上后端都没法自己修复,这是个“正确”的策略。

换一个例子,比如用户想上传一个头像,后端将图片发给某个云存储,结果云存储报500错误。怎么办呢?你可能想到了重试几次,因为也许问题仅仅是临时的网络抖动而已,重试就可以正常执行。但如果重试多次无效。如果做系统时设计了某种热备方案,那么就可能改为发到另外一个服务器上。“重试”和“使用备份的依赖”都是“立刻处理“。

(推荐教程:Java教程

但如果重试无效,所有的备份服务也无效,那么也许就能像上面那样把错误抛给前端,提示用户“服务器开小差”。从这个方案很容易看出来,你想把错误抛到哪里是因为那个catch的地方是处理问题最方便的地方。一个问题的解决方案可能要几个不同的错误处理组合起来才能办到。

另外一个例子,你的程序抛了一个NPE。这一般就是程序员的bug——要不就是程序员想要表达一个东西”没有“,结果在后续处理中忘了判断是否为null;要不就是在写代码时觉得100%不可能为null的地方出现了一个null。不管哪种情况,这个错误用户总会看到一个很含糊的报错信息,这远远不够。“正确”的办法是程序员自己能尽快发现它,并尽快修复。要做到这一点,需要监控系统不断的爬log,把问题报警出来。而不是等到用户找客服来吐槽。

再换一个例子,比如你的后端程序突然OOM,挂了。挂的程序是没法恢复自己的。要做到“正确”就必须得在服务之外的容器考虑这个问题。比如你的服务跑在k8s上,他们会监控你程序的状态,然后重新启动新的服务实例以弥补挂掉的服务,还得调整流量,把去往挂掉服务的流量切掉,重新换到新的实例上。这里的恢复因为跨系统所以不能仅仅用异常实现,但是道理是一样的。但光靠重启就是“正确”的吗?如果服务是完全无状态的,问题不大。但是如果是有状态的,部分用户数据可能就会被执行一半的请求搞乱套。因此重启时要留意先“恢复数据到合法状态”。这又回到了你需要知道怎么样才是“正确”的做法。只依靠简单的语法功能是不能无脑解决这个事的。

  • 我们可以推广下,一个工作线程的“外部容器“是管理工作线程的“master”。一个网络请求的“外部容器”是一个web server。一个用户进程的“外部容器”是操作系统。Erlang把这种supervisor-worker的机制融入到语言的设计中。

(推荐微课:Java微课

Web程序之所以很大程度上能够把异常抛给顶层,主要由于3个原因:

  • 请求来自于前端,对于因为用户请求有误(数据合法性、权限、用户上下文状态)造成的问题,最终大概率只能告诉用户。因此抛异常到一个集中处理错误的地方,把异常转换为某个业务错误码的方法是合理的。
  • 后端服务一般都是无状态的。这也是互联网系统设计的一般性原则。无状态就意味着可以随意重启。对于用户的数据因为下一条一般情况下不会出问题。
  • 后端对数据的修改依赖DB的事务。因此一个改了一半的没提交的事务是不会造成副副作用。

但你要清楚上面这3条并不是总是成立的。总会存在一些处理逻辑并非完全无状态,也并不是所有的数据修改都能用一个事务保护。尤其要注意对微服务的调用,对内存状态的修改是没有事务保护的,一不留神就会出现搞乱用户数据的问题。比如:

 try {
   int res1 = doStep1();
   this.statusVar1 += res1;
   int res2 = doStep2();
   this.statusVar2 += res2;
   int res3 = doStep3(); // throw an exception
   this.statusVar3 = statusVar1 + statusVar2 + res3;
} catch ( ...) { 
   // ...
}

先假设this.statusVar1, this.statusVar2, this.statusVar3之间需要维护某种不变的约束(invariant)。然后执行这段代码时,如果在doStep3那抛出一个异常下面对statusVar3的赋值就不会执行。这时如果不能将statusVar1statusVar2的修改rollback回去,就会造成数据违反约束的问题。而程序员一般是很难直接发现这个数据被改坏了。而坏掉的数据可能会偷偷的导致其他依赖这个数据的代码逻辑出错(比如原本应该给积分的,结果却没给)。而这种错误一般非常难调查,从大量数据里找到不正确的那一小撮是相当困难的事。

比起上面这段更难搞得定的是这样的代码:

// controller
void controllerMethod(/* some params*/) {
  try {
    return svc.doWorkAndGetResult(/* some params*/);
  } catch (Exception e) {
    return ErrorJsonObject.of(e);
  }
}


// class svc
void doWorkAndGetResult(/* some params*/) {
    int res1 = otherSvc1.doStep1(/* some params */);
    this.statusVar1 += res1;
    int res2 = otherSvc2.doStep2(/* some params */);
    this.statusVar2 += res2;
    int res3 = otherSvc3.doStep3(/* some params */);
    this.statusVar3 = statusVar1 + statusVar2 + res3;
    return SomeResult.of(this.statusVar1, this.statusVar2, this.statusVar3);
}

这段代码的可怕之处在于,你在写的时候可能会以为doStep1~3这种东西即使抛异常,也能被Controller里的catch。在svc这层是不用处理任何异常的,因此不写try……catch是天经地义的。但实际上doStep1doStep2doStep3任何一个抛异常都会造成svc的数据状态不一致。甚至你一开始都可以通过文档或者其他沟通方式确定doStep1doStep2doStep3一开始都是必然可以成功,不会抛错的,因此你写的代码一开始是对的。但是你可能无法控制他们的实现(比如他们是另外一个团队开发的lib提供的),而他们的实现可能会改成会抛错。你的代码可能在完全不自知的情况下从“不会出问题”变成了“可能出问题”…… 更可怕的是类似于这样的代码是不能正确工作的:

void doWorkAndGetResult(/* some params*/) {
    try {
       int res1 = otherSvc1.doStep1(/* some params */);
       this.statusVar1 += res1;
       int res2 = otherSvc2.doStep2(/* some params */);
       this.statusVar2 += res2;
       int res3 = otherSvc3.doStep3(/* some params */);
       this.statusVar3 = statusVar1 + statusVar2 + res3;
       return SomeResult.of(this.statusVar1, this.statusVar2, this.statusVar3);
   } catch (Exception e) {
     // do rollback
   }
}

你可能以为这样就会处理好数据rollback了,甚至你会觉得这种代码非常优雅。但是实际上doStep1~3每一个地方抛错,rollback的代码都不一样。你必须得这么写:

void doWorkAndGetResult(/* some params*/) {
    int res1, res2, res3;
    try {
       res1 = otherSvc1.doStep1(/* some params */);
       this.statusVar1 += res1;
    } catch (Exception e) {
       throw e;
    }


    try {
      res2 = otherSvc2.doStep2(/* some params */);
      this.statusVar2 += res2;
    } catch (Exception e) {
      // rollback statusVar1
      this.statusVar1 -= res1;
      throw e;
    }

  
    try {
      res3 = otherSvc3.doStep3(/* some params */);
      this.statusVar3 = statusVar1 + statusVar2 + res3;
    } catch (Exception e) {
      // rollback statusVar1 & statusVar2
      this.statusVar1 -= res1;
      this.statusVar2 -= res2;
      throw e;
   } 
}

这才是能得到正确结果的代码——在任何地方出现错误都能维护数据一致性。优雅吗?看起来很丑。这甚至比goif err != nil还丑。但如果一定要在正确性和优雅性上作出取舍,我会毫不犹豫的选择前者。作为程序员是不能直接认为抛异常可以解决任何问题的,你必须学会写出有正确逻辑的程序,哪怕很难,并且看起来很丑。为了达成很高的正确性,你不能总是把自己大部分注意力放在“一切都OK的流程上“,而把错误看作是可以随便搞一下的工作,或者简单的相信exception可以自动搞定一切。

总结一下,我希望所有程序员对错误处理都要有起码的敬畏之心。Java这边因为Checked Exception的设计问题不得不避免使用(见大宽宽 – Java设计出checked exception有必要吗?),而Uncaughted Exception实在是太过于弱鸡,是不能给程序员提供更好地帮助的。

因此,程序员在每次抛错或者处理错误的时候都要对自己灵魂三击:这个错误的处理是正确的吗?会让用户看到什么?会不会搞乱数据?不要以为自己抛了个异常就不管了。

此外,在编译器不能帮上太多忙的时候,好好写UT来保护代码脆弱的正确性。

以上就是w3cschool分享的JavaWeb 中 Service 层异常抛到 Controller 层处理还是直接处理。希望对大家有所帮助。

带你认识开源在线教学软件:BigBlueButton

thbcm阅读(354)

BigBlueButton 是一个为在线教学量身定制的开源视频会议工具。让我们来看看它提供了什么。

在 2020 年,在家远程工作是一种新常态。当然,你不可能远程完成所有事情,但是在线教学是可以的。

尽管许多老师和学校组织不熟悉那些所有的出色工具,但某些 最好的开源视频会议工具 在一定程度上满足了要求。

在我提到的视频通话软件中, BigBlueButton 引起了我的注意。在这里,我将为你简单介绍。

BigBlueButton:用于在线教学的开源 Web 会议系统

BigBlueButton 是一个开源的网络会议方案,它旨在简化在线学习。

它是完全免费的,但是需要你在自己的服务器上安装才能将其用作成熟的在线学习解决方案。

BigBlueButton 提供了非常好的一组功能。你可以轻松地尝试 演示实例 ,并在学校的服务器上进行安装。

(推荐教程:Linux教程

开始之前,请先了解以下功能:

BigBlueButton 的功能

BigBlueButton 为教师和学校的量身定制了一系列在线课堂的有用功能,你可以获得:

  • 现场白板
  • 给公共和私人发消息
  • 支持网络摄像头
  • 支持会话记录
  • 支持表情符号
  • 能够将用户分组以进行团队协作
  • 支持投票
  • 屏幕共享
  • 支持多用户白板
  • 能够自行托管
  • 提供用于轻松集成到 Web 应用中的 API

除了提供的功能外,你还能看到易于使用的 UI,即 Greenlight (BigBlueButton 的前端界面),当你在服务器上配置时可以安装它。

(推荐微课:Linux微课

你可以尝试演示实例来临时免费地教你的学生。但是,考虑到使用 演示实例 来尝试 BigBlueButton 的局限性(限制为 60 分钟),建议你将它托管在服务器上,以探索其提供的所有功能。

(推荐课程:Linux就该这么学

为了更清楚地了解这些功能是如何工作的,你可能需要看下它的 官方教程

在你的服务器上安装 BigBlueButton

他们提供了详细文档,它对每个开发人员都会有用。安装它最简单、最快捷的方法是使用 bbb-install 脚本 ,但是如果不成功,你也可以探索其他选项。

对于刚接触的人,你需要一台至少运行 Ubuntu 16.04 LTS的服务器。在为 BigBlueButton 部署服务器之前,你应该查看最低要求 。

你可以在它的 GitHub 页面 中进一步了解该项目。

如果你正在为在线教学寻求解决方案,那么BigBlueButton是一个不错的选择。

它可能不提供原生的智能手机应用,但你肯定可以用手机上的网络浏览器来访问它。当然,最好找一台笔记本电脑/计算机来访问在线教学平台,但它也可以在移动设备上使用。

以上就是关于开源在线教学软件:BigBlueButton的介绍,希望对大家有所帮助。

“==”和“is”有什么区别?一个问题检测你python水平

thbcm阅读(321)

在网上和学习工作中,你可能经常看到这个问题,但是依然有很多python初学者不了解这个问题,也不知道为什么这个问题会暴露自己是“菜鸟”。这个问题就是:

“==” 和 “is”之间有什么区别?

“==”和“is”都是 Python 中的运算符。对于初学者,他们可能会把“ a==b ”解释为“ a 等于 b ”,“a is b”也可以解释为“ a是b ”。这可能就是初学者在Python 中混淆“ == ”和“ is ”的原因。

在开始之前,我想先展示一些使用“==”和“is”的例子。

>>> a = 5
>>> b = 5
>>> a == b
True
>>> a is b
True

很简单,对吧?a == ba is b 都返回了结果 True。接下来我们看另一个示例:

>>> a = 1000
>>> b = 1000
>>> a == b
True
>>> a is b
False

WTF ?!? 从第一个示例到第二个示例的唯一变化就是 a 和 b 的值从 5 到 1000。但是返回的结果在 “==” 和 “is” 已经不同。我们再看另一个示例:

>>> a = []
>>> b = []
>>> a == b
True
>>> a is b
False

下面是最后一个例子,看完是不是觉得自己的脑子要爆炸?

>>> a = 1000
>>> b = 1000
>>> a == b
True
>>> a is b
False
>>> a = b 
>>> a == b
True
>>> a is b
True

==”的正式运算是相等,而“is”的运算是标识。 一般使用“==”来比较两个对象的值。 “ a == b”应解释为“ a的值是否等于b的值”。 在上述所有示例中,a 的值始终等于 b 的值(即使对于空列表示例也是如此)。 因此,“a == b”始终为真。

(推荐教程:python教程

在解释身份之前,我需要先介绍id 函数。 我们可以使用 id 函数获得对象的标识。 这个身份在整个时间内对于此对象都是唯一且恒定的。此标识在整个时间内对该对象是唯一且不变的。你可以把它看作是这个对象的地址。如果两个对象具有相同的标识,则它们的值也必须相同。

>>> id(a)
2047616

运算符“ is ”是比较两个对象的标识是否相同。“a is b”的意思是“a的身份与b的身份相同”。

如果你知道“ ==”和“ is”的实际含义,我们就可以开始研究上面的几个示例了。

首先是第一个和第二个示例中的结果不同。 显示不同结果的原因是Python存储了一个介于-5到256之间的整数的数组列表,每个整数具有固定的标识。当我们在此范围内分配整数变量时,Python会将此变量的标识分配为数组列表内整数的整数。 结果,对于第一个示例,由于ab的标识都是从数组列表中获得的,因此它们的标识当然是相同的,因此 “a is b” 为True

>>> a = 5
>>> id(a)
1450375152
>>> b = 5
>>> id(b)
1450375152

但是一旦该变量的值超出该范围,由于 Python 内部没有具有该值的对象,因此Python将为此变量创建一个新的标识并将该值分配给该变量。 如前所述,身份对于每个创建都是唯一的,因此,即使两个变量的值相同,其身份也永远不会相等。 这就是为什么“a is b”在第二个例子结果为False

>>> a = 1000
>>> id(a)
12728608
>>> b = 1000
>>> id(b)
13620208

PS:如果你打开了两个控制台,该值仍在该范围内,那么你将获得相同的标识。但是,如果该值不在该范围内,则结果就会发生改变。

如果你理解了第一示例和第二示例之间的区别,就很容易理解第三示例的结果。由于 Python 不存储“空列表”对象,因此 Python 创建了一个新对象并分配了“空列表”值。无论两个列表为空还是元素相同,结果都是相同的。

>>> a = [1,10,100,1000]
>>> b = [1,10,100,1000]
>>> a == b 
True
>>> a is b
False
>>> id(a)
12578024
>>> id(b)
12578056

接下来,我们转到最后一个示例。第二个和最后一个示例之间的唯一区别是还有一行代码 a = b,正是这行代码改变了变量 a 的命运。以下结果将告诉你真实原因:

>>> a = 1000
>>> b = 2000
>>> id(a)
2047616
>>> id(b)
5034992
>>> a = b
>>> id(a)
5034992
>>> id(b)
5034992
>>> a
2000
>>> b
2000

如上所示,在 a = b 之后,a 的身份更改为 b 的身份。a = b 将 b 的身份分配给 a 。因此 a 和 b 具有相同的标识,因此 a 的值现在与 b 的值相同(即2000)。

(推荐微课:python3基础微课

最后一个示例告诉我们一个重要消息,即我们可能会无意中更改对象的值,而不会事先通知,尤其是当对象是列表时。

>>> a = [1,2,3]
>>> id(a)
5237992
>>> b = a
>>> id(b)
5237992
>>> a.append(4)
>>> a
[1, 2, 3, 4]
>>> b
[1, 2, 3, 4]

在上面的示例中,由于 a 和 b 具有相同的标识,因此它们的值必须相同。 所以,在将新元素添加到 a 之后,b 的值也会受到影响。为避免这种情况,如果要将值从一个对象复制到另一个对象而不引用相同的标识,则所有方法之一是在 copy 模块中使用 deepcopy 。 对于列表,我们还可以通过 b = a [:] 执行。

>>> import copy
>>> a = [1,2,3]
>>> b= copy.deepcopy(a)
>>> id(a)
39785256
>>> id(b)
5237992

使用[:]将元素复制到新变量。

>>> a = [1,2,3]
>>> id(a)
39785256
>>> b = a[:]
>>> id(b)
23850216
>>> a.append(4)
>>> a
[1, 2, 3, 4]
>>> b
[1, 2, 3]

以上就是关于“==”和“is”有什么区别?的相关内容了,看完这些是不是觉得已经充分了解两者之间的区别。以后面试遇到这种问题,可别答错咯。

简化RESTful开发,Spring Data REST减轻你的工作量

thbcm阅读(354)

1.简介

SpringbootSpring MVC 简化了web应用中的RESTful开发,然而还有一种更简单的,那就是Spring Data RESTSpring Data REST 建立在Data Repository之上,它可以直接把resositoryHATEOAS风格暴露成Web服务,就不需要再手写Controller层。

  • HATEOAS,即Hypermedia as the Engine of Application State ,它是一种更成熟的REST模型,在资源的表达中包含了链接信息,客户端可以根据链接来发现可执行的动作。

Spring Data REST支持Spring Data JPASpring Data MongoDBSpring Data Neo4jSpring Data GenFireSpring Data Cassandra,这里选择大家比较熟悉的JPA

2 举个例子

我们用例子来感受一下吧。

2.1 创建项目

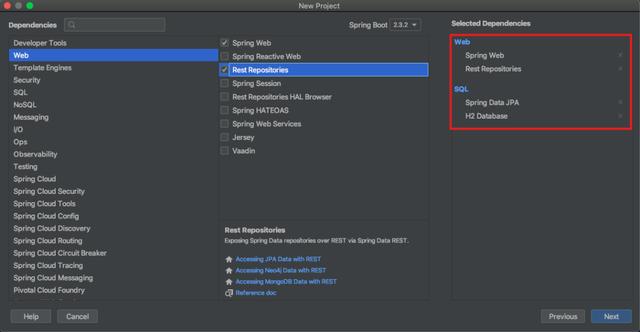
我们通过Spring Initializr来快速创建Springboot项目。选中的依赖组件如下:

  • (1)Spring Web:提供Web服务;
  • (2)Rest Repositories:提供Spring Data REST的支持;
  • (3)Spring Data JPA:通过JPA提供Repository方式的数据访问;
  • (4)H2 Database:H2数据库,为了方便简洁,使用该数据库。

(推荐课程:Spring教程

导入后对应的pom.xml中依赖如下:

<dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-jpa</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-rest</artifactId> </dependency> <dependency> <groupId>com.h2database</groupId> <artifactId>h2</artifactId> <scope>runtime</scope> </dependency>

2.2 实体类

创建一个实体类User,如下所示:

package com.pkslow.rest.entity;


import javax.persistence.Entity;
import javax.persistence.GeneratedValue;
import javax.persistence.GenerationType;
import javax.persistence.Id;


@Entity
public class User {
    @Id
    @GeneratedValue(strategy = GenerationType.AUTO)
    private Integer id;
    private String name;
    private Integer age;
    private String email;

  
  //getter & setter
}

2.3 Repository接口定义

定义Repository接口用于操作数据库,如下所示:

package com.pkslow.rest.repo;


import com.pkslow.rest.entity.User;
import org.springframework.data.repository.CrudRepository;
import org.springframework.data.rest.core.annotation.RepositoryRestResource;


@RepositoryRestResource(path = "user")
public interface UserRepository extends CrudRepository<User, Integer> {
}

注解RepositoryRestResourceData REST用于暴露Repositorypath为访问路径,设置为user,则访问地址为http://localhost:8080/user

2.4 启动访问

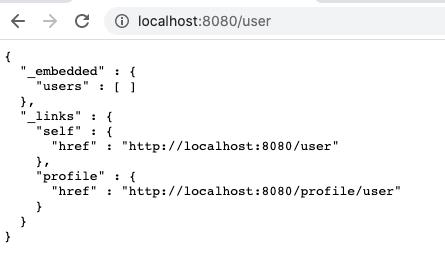
准备好以上代码,直接启动Springboot应用即可,我们把端口设置为8080,访问如下:

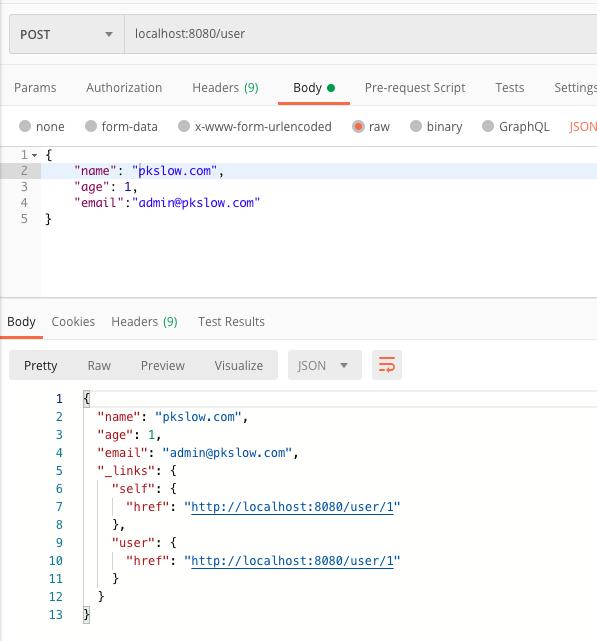
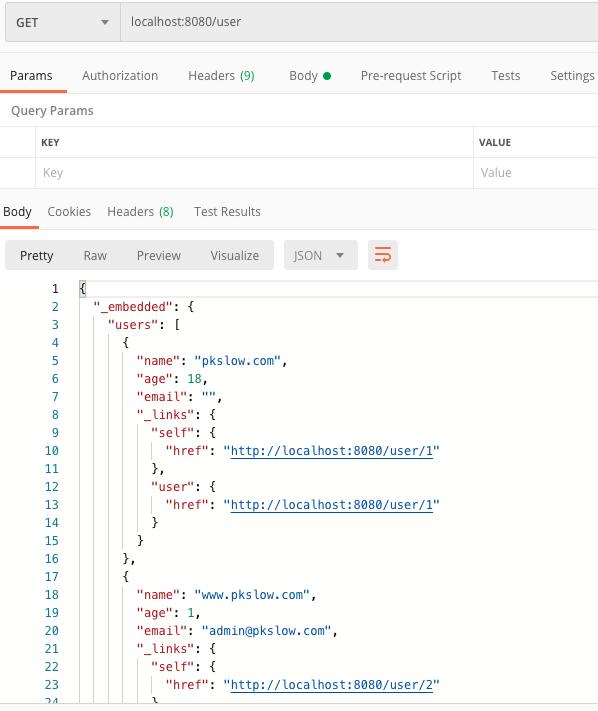
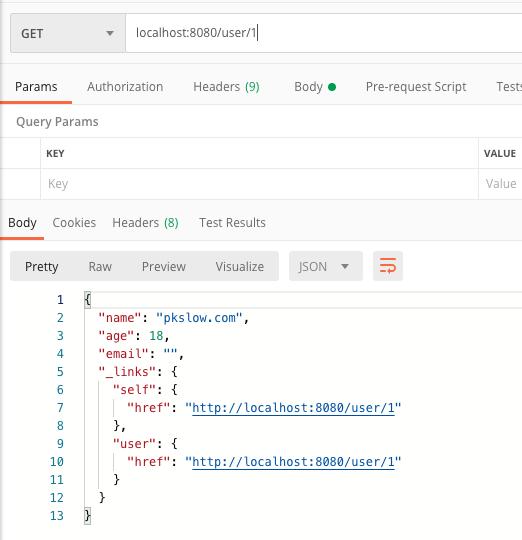
我们用Postman做一个基本操作。

新增:

查询:

通过主键ID查询:

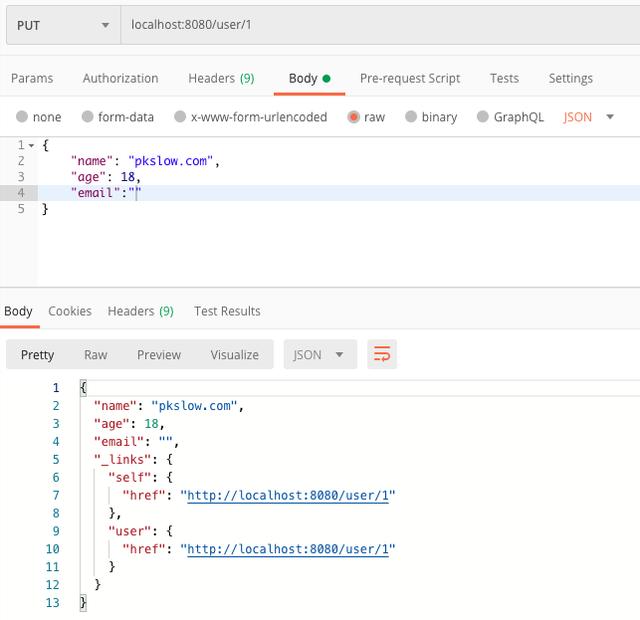
修改:

删除:

不难发现,返回的Json都带有链接,这就是HATEOAS风格。

3 更多探索

3.1 分页及排序功能

可以快速实现分页及排序功能,只需要把Repository的父接口改为PagingAndSortingRepository即可,如下所示:

@RepositoryRestResource(path = “user”) public interface UserRepository extends PagingAndSortingRepository<User, Integer> { }

其实就是多了两个方法findAll(Sort var1)findAll(Pageable var1),如下所示:

public interface PagingAndSortingRepository<T, ID> extends CrudRepository<T, ID> { Iterable<T> findAll(Sort var1);


    Page<T> findAll(Pageable var1);
}

查询http://localhost:8080/user?page=1&size=2&sort=id,desc,表示查询第二页,每页2条记录,以ID倒序展示。如下:

{ “_embedded”: { “users”: [ { “name”: “pkslow.com”, “age”: 18, “email”: “pkslow@pkslow.com”, “_links”: { “self”: { “href”: “http://localhost:8080/user/33” }, “user”: { “href”: “http://localhost:8080/user/33” } } }, { “name”: “pkslow.com”, “age”: 18, “email”: “pkslow@pkslow.com”, “_links”: { “self”: { “href”: “http://localhost:8080/user/32” }, “user”: { “href”: “http://localhost:8080/user/32” } } } ] }, “_links”: { “first”: { “href”: “http://localhost:8080/user?page=0&size=2&sort=id,desc” }, “prev”: { “href”: “http://localhost:8080/user?page=0&size=2&sort=id,desc” }, “self”: { “href”: “http://localhost:8080/user?page=1&size=2&sort=id,desc” }, “next”: { “href”: “http://localhost:8080/user?page=2&size=2&sort=id,desc” }, “last”: { “href”: “http://localhost:8080/user?page=17&size=2&sort=id,desc” }, “profile”: { “href”: “http://localhost:8080/profile/user” } }, “page”: { “size”: 2, “totalElements”: 35, “totalPages”: 18, “number”: 1 } }

可以发现page是从0开始的,1表示第二页;返回结果还提供了第一页、上一页、本页、下一页、最后一页的链接;以及分页信息。

(推荐微课:Spring微课)

3.2 事件监听

REST提供了8个基于Repository的事件,如下:

  • BeforeCreateEvent
  • AfterCreateEvent
  • BeforeSaveEvent
  • AfterSaveEvent
  • BeforeLinkSaveEvent
  • AfterLinkSaveEvent
  • BeforeDeleteEvent
  • AfterDeleteEvent

添加一个自定义事件如下:

package com.pkslow.rest.event;


import com.pkslow.rest.entity.User;
import org.springframework.data.rest.core.event.AbstractRepositoryEventListener;
import org.springframework.stereotype.Component;


@Component
public class PkslowEventListener extends AbstractRepositoryEventListener<User> {


    @Override
    public void onBeforeCreate(User entity) {
        System.out.println("pkslow creating:" + entity);
    }


    @Override
    public void onBeforeSave(User entity) {
        System.out.println("pkslow saving:" + entity);
    }


    @Override
    public void onAfterDelete(User entity) {
        System.out.println("pkslow deleted:" + entity);
    }
}

分别执行了增加、修改、删除后,日志如下:

pkslow creating:User{id=null, name=’pkslow.com’, age=18, email=’pkslow@pkslow.com’} pkslow saving:User{id=32, name=’pkslow.com’, age=20, email=’pkslow@pkslow.com’} pkslow deleted:User{id=14, name=’pkslow.com’, age=18, email=’pkslow@pkslow.com’}

说明事件成功执行,结合这个功能,可以实现很多业务逻辑,如删除后记录操作日志,并删除其它相关数据。

(推荐教程:Spring Boot 那些事)

3.3 路径

默认基础路径是/,可以通过spring.data.rest.base-path=api进行配置,这样就变成了localhost:8080/api/user

4 集成HAL Browser查看

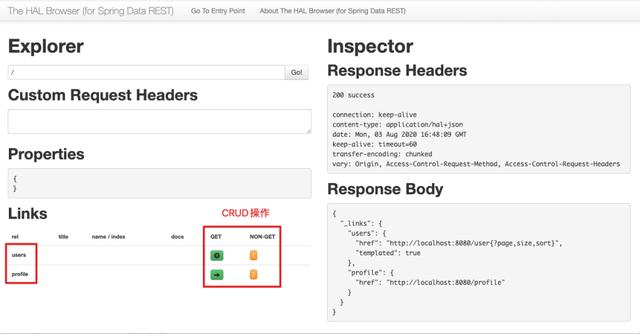
HAL Browser是一个专门用于浏览基于JSON Hypertext Application Language的前端工具。我们前面已经提供了HATEOAS风格的RESTful服务,HAL Browser可以方便查看。

加入依赖:

<dependency> <groupId>org.springframework.data</groupId> <artifactId>spring-data-rest-hal-browser</artifactId> <version>3.3.2.RELEASE</version> </dependency>

启动后访问http://localhost:8080/browser/index.html#/如下:

可以进行CRUD操作,具体就不一一展示了。

以上就是关于Spring Data REST的介绍,它可以方便大家使用RESTful开发,希望对大家有所帮助,虽然项目中使用的机会并不大,但也可以扩展一些知识面。

什么是Python Wheels? python.whl有什么用处?

thbcm阅读(310)

Python .whl文件(或wheels)是python很少被提到的一部分,不过它们对python包的安装过程相当重要。如果你已经使用pip安装了python包,那么很大可能轮子(wheels)使你的安装速度更快了,效率更高了。

轮子是Python生态系统的一个组件,它有助于使包的安装工作正常进行。它们允许更快的安装和更稳定的包分发过程。在本教程中,您将深入了解轮子是什么,它们提供了什么好处,以及它们是如何获得吸引力并使使用Python变得更方便的。

(推荐教程:python教程

轮子简介

在学习如何将项目打包到轮子中之前,从用户的角度了解使用轮子是什么样子是很有帮助的。

可以像往常一样在环境中安装一个Python包来开始这个实验。在这种情况下,安装uWSGI 2.0.x版本:

$ python -m pip install 'uwsgi==2.0.*'
 2 Collecting uwsgi==2.0.*
 3   Downloading uwsgi-2.0.18.tar.gz (801 kB)
 4      |████████████████████████████████| 801 kB 1.1 MB/s
 5 Building wheels for collected packages: uwsgi
 6   Building wheel for uwsgi (setup.py) ... done
 7   Created wheel for uwsgi ... uWSGI-2.0.18-cp38-cp38-macosx_10_15_x86_64.whl
 8   Stored in directory: /private/var/folders/jc/8_hqsz0x1tdbp05 ...
 9 Successfully built uwsgi
10 Installing collected packages: uwsgi
11 Successfully installed uwsgi-2.0.18

要完全安装uWSGI, pip需要经过几个不同的步骤:

  1. 在第3行,它下载一个名为uwsgi-2.0.18.tar.gzTAR文件(tarball),该文件是用gzip压缩的。
  2. 在第6行,它接受tarball并通过调用setup.py构建一个.whl文件。
  3. 在第7行,它将轮子标记为uWSGI-2.0.18-cp38-cp38-macosx_10_15_x86_64.whl
  4. 在第10行,它在构建了轮子之后安装实际的包。

pip检索的tar.gz tarball是一个源分发包,或sdist,而不是一个轮子。在某些方面,sdist是轮子的反义词。

源代码发行版包含源代码。这不仅包括Python代码,还包括与包绑定的任何扩展模块的源代码(通常用Cc++编写)。对于源发行版,扩展模块是在用户端而不是开发人员端编译的。

源分发版还包含一个元数据包,位于名为.egg-info的目录中。该元数据有助于构建和安装包,但用户实际上并不需要使用它做任何事情。

从开发人员的角度来看,当您运行以下命令时,会创建一个源分发包:

$ python setup.py sdist

现在尝试安装一个不同的包:chardet:

$ python -m pip install 'chardet==3.*'
 2 Collecting chardet
 3   Downloading chardet-3.0.4-py2.py3-none-any.whl (133 kB)
 4      |████████████████████████████████| 133 kB 1.5 MB/s
 5 Installing collected packages: chardet
 6 Successfully installed chardet-3.0.4

您可以看到一个与uWSGI安装明显不同的输出。

安装chardet时直接从PyPI下载一个.whl文件。车轮名称为chardet-3.0.4-py2.py3-none-anywhl遵循特定的命名约定,稍后您将看到。从用户的角度来看,更重要的是,当pipPyPI上找到一个兼容的滚轮时,并不存在构建阶段。

从开发人员的角度来看,轮子是运行以下命令的结果:

$ python setup.py bdist_wheel

为什么uWSGI给你一个源分布,而chardet提供一个轮子?您可以通过查看PyPI上每个项目的页面并导航到下载文件区域来了解原因。本节将向您展示pipPyPI索引服务器上实际看到的内容:

  1. 由于项目的复杂性,uWSGI只提供了一个源分发版(uWSGI -2.0.18.tar.gz)。
  2. chardet同时提供了一个轮盘和一个源代码发行版,但是如果与您的系统兼容,pip会更喜欢轮盘。稍后您将看到如何确定兼容性。

另一个用于轮子安装的兼容性检查示例是psycopg2,它为Windows提供了大量的车轮,但没有为LinuxmacOS客户端提供任何轮子。这意味着,根据您的具体设置,pip安装psycopg2可以获取一个滚轮或源分发版。

为了避免这些类型的兼容性问题,一些包提供了多个轮子,每个轮子都针对特定的Python实现和底层操作系统。

到目前为止,您已经看到了轮子和sdist之间的一些明显区别,但更重要的是这些区别对安装过程的影响。

(推荐微课:python3基础微课

轮子加速安装

在上面,您看到了获取预构建轮子的安装和下载sdist的安装的比较。轮子使得Python包的端到端安装速度更快,原因有两个:

  1. 在其他条件相同的情况下,轮子通常比源分发包更小,这意味着它们可以在网络中更快地移动。
  2. 直接从wheels安装避免了从源分发版构建包的中间步骤。

几乎可以保证,安装chardet只需uWSGI所需时间的一小部分。然而,这是一种不公平的比较,因为chardet是一个明显更小和更简单的包。使用不同的命令,您可以创建一个更直接的比较,它将演示轮子造成的差异有多大。

你可以通过-no-binary选项让pip忽略它对车轮的倾斜:

$ time python -m pip install \
      --no-cache-dir \
      --force-reinstall \
      --no-binary=:all: \
      cryptography

这个命令计算加密包的安装时间,告诉pip使用源分发包,即使有合适的轮可用。包括:all:使规则适用于密码学及其所有依赖关系。

在我的机器上,从开始到结束大约需要32秒。不仅安装要花费很长时间,而且构建加密还需要提供OpenSSL开发头,并可用于Python

现在可以重新安装密码学,但是这次要确保pip使用来自PyPIwheels。因为pip更喜欢轮子,所以这类似于完全不带参数调用pip install。但在这种情况下,你可以让意图显式通过要求车轮-纯二进制:

此选项仅花费4秒多一点的时间,即仅为密码学及其依赖项使用源分发版时所用时间的八分之一。

以上就是关于 Python Wheels 的相关介绍了,希望对大家有所帮助。

python中关于numpy库的介绍

thbcm阅读(375)

1.Numpy是什么?

NumPy(Numerical Python的缩写)是一个开源的Python科学计算库。使用NumPy,就可以很自然地使用数组和矩阵。 NumPy包含很多实用的数学函数,涵盖线性代数运算、傅里叶变换和随机数生成等功能。

这个库的前身是1995年就开始开发的一个用于数组运算的库。经过了长时间的发展,基本上成了绝大部分Python科学计算的基础包,当然也包括所有提供Python接口的深度学习框架。

2.为什么使用Numpy?

a)便捷:

对于同样的数值计算任务,使用NumPy要比直接编写Python代码便捷得多。这是因为NumPy能够直接对数组和矩阵进行操作,可以省略很多循环语句,其众多的数学函数也会让编写代码的工作轻松许多。

b)性能:

NumPy中数组的存储效率和输入输出性能均远远优于Python中等价的基本数据结构(如嵌套的list容器)。其能够提升的性能是与数组中元素的数目成比例的。对于大型数组的运算,使用NumPy的确很有优势。对于TB级的大文件,NumPy使用内存映射文件来处理,以达到最优的数据读写性能。

c)高效:

NumPy的大部分代码都是用C语言写成的,这使得NumPy比纯Python代码高效得多。

当然,NumPy也有其不足之处,由于NumPy使用内存映射文件以达到最优的数据读写性能,而内存的大小限制了其对TB级大文件的处理;此外,NumPy数组的通用性不及Python提供的list容器。因此,在科学计算之外的领域,NumPy的优势也就不那么明显。

(推荐教程:python教程

3.Numpy的安装:

  1. 官网安装:http://www.numpy.org/
  2. pip 安装:pip install numpy。
  3. LFD安装:针对windows用户http://www.lfd.uci.edu/~gohlke/pythonlibs/。
  4. Anaconda安装(推荐):Anaconda里面集成了很多关于python科学计算的第三方库,主要是安装方便。下载地址:https://www.anaconda.com/download/

4.numpy 基础:

NumPy的主要对象是同种元素的多维数组。这是一个所有的元素都是一种类型。在NumPy中维度(dimensions)叫做轴(axes),轴的个数叫做秩(rank)。NumPy的数组类被称作 ndarray(矩阵也叫数组 。通常被称作数组。

常用的ndarray对象属性有:

  • ndarray.ndim(数组轴的个数,轴的个数被称作秩),
  • ndarray.shape(数组的维度。这是一个指示数组在每个维度上大小的整数元组。例如一个n行m列的矩阵,它的shape属性将是(2,3),这个元组的长度显然是秩,即维度或者ndim属性),
  • ndarray.size(数组元素的总个数,等于shape属性中元组元素的乘积),
  • ndarray.dtype(一个用来描述数组中元素类型的对象,可以通过创造或指定dtype使用标准Python类型。另外NumPy提供它自己的数据类型)。

Numpy的数据类型:

import numpy as np
a = np.dtype(np.int_)     #  np.int64, np.float32 …
print(a) 

Numpy内置的特征码:

int8, int16, int32,int64 可以由字符串’i1’, ‘i2’,’i4’, ‘i8’代替,其余的以此类推。

import numpy as np
a = np.dtype(‘i8’)    # ’f8’, ‘i4’’c16’,’a30’(30个字符的字
# 符串), ‘>i4’…
print (a)

可以指明数据类型在内存中的字节序,’>’表示按大端的方式存储,’<’表示按小端的方式存储,’=’表示数据按硬件默认方式存储。大端或小端存储只影响数据在底层内存中存储时字节的存储顺序,在我们实际使用python进行科学计算时,一般不需要考虑该存储顺序。

(推荐微课:python3基础微课

5.创建数组并查看其属性:

(1) 用np.array从python列表和元组创建数组:

import numpy as np
a = np.array([[1,2,3], [4, 5, 6]], dtype=int)
print(a.shape)       #  a.ndim, a.size, a.dtype

import numpy as np
a = np.array([(1,2,3), (4, 5, 6)], dtype=float)
print(a.shape)      #  a.ndim, a.size, a.dtype

(2) 用np.arange().reshape()创建数组:

import numpy as np
a = np.arange(10).reshape(2, 5) # 创建2行5列的二维数组,
# 也可以创建三维数组,
# a = np.arange(12).reshape(2,3,2)
print(a)

判断下列三维数组的shape:

a = np.array([[[1,2,3], [4, 5, 6], [7, 8, 9]]])
b = np.array([[[1,2,3]], [[4, 5, 6]], [[7, 8, 9]]])

6.基本运算:

import numpy as np
a = np.random.random(6)
b = np.random.rand(6)
c = np.random.randn(6)
print(a-b)                    # print(a+b),print(a*c) …
# 二维数组运算
d = np.random.random((2,3))
e = np.random.randn(2, 3)
f = np.random.rand(2,3)
print(d-e)                    # print(d+f),print(e*f) …
print(np.dot(a,b))          #复习矩阵乘法
print(a.dot(b))
# Numpy 随机数模块np.random.random, np.random.randn, np.random.rand的比较
(1)rand 生成均匀分布的伪随机数。分布在(0~1)之间
(2)randn 生成标准正态分布的伪随机数(均值为0,方差为1)。

import numpy as np
a = np.ones((2,3)) 
b = np.zeros((2,3))
a*=3
b+=a

7.常用函数:

import numpy as np 
a = np.arange(10)
np.where()

8.索引,切片和迭代:

import numpy as np
 a = arange(10)**3
a[2]
a[2:5]
a[:6:2] = -1000
a[ : :-1]
for i in a:
    print i**(1/3.)


# 多维数组的索引
b = np.arange(20).reshape(5,4)
b[2,3]
b[0:5, 1]
b[ : ,1]
b[1:3, : ]
#当少于轴数的索引被提供时,确失的索引被认为是整个切片
b[-1]    #相当于b[-1,:]
# b[i] 中括号中的表达式被当作 i 和一系列 : ,来代表剩下的轴。NumPy也允许你使用“点”像 b[i,...] 。
#点 (…)代表许多产生一个完整的索引元组必要的分号。如果x是
#秩为5的数组(即它有5个轴),那么:x[1,2,…] 等同于 x[1,2,:,:,:],x[…,3] 等同于 x[:,:,:,:,3],x[4,…,5,:] 等同 x[4,:,:,5,:].


三维数组的索引:
c = np.arange(12).reshape(2,3,2)
c[1]
c[2,1]    # 等价于c[2][1]
c[2,1,1]  # 等价于c[2][1][1]


# 通过数组索引
d = np.arange(10)**2
e = np.array ([3, 5, 6])
d[e] = ?


#练习, 用同样的方法在二维数组中操作。
# 通过布尔数组索引
f = np.arange(12).reshape(3, 4)
g = f>4
print(g)
f [g]

迭代多维数组是就第一个轴而言的:

h = np.arange(12).reshape(3,4)
for i in h:
   print(i)

如果想对每个数组中元素进行运算,我们可以使用flat属性,该属性是数组元素的一个迭代器:

for i in h.flat:
print(i)

补充:flatten()的用法: np.flatten()返回一个折叠成一维的数组。但是该函数只能适用于numpy对象,即array或者mat,普通的list列表是不行的。

import numpy as np
a = np.array([[1,2], [3, 4], [5, 6]])

 
a.flatten()
b = np.mat([[1,2,3], [4, 5, 6]])
b.flatten()
c = [[1,2,3], [4, 5, 6]]
c.flatten() ?

想要list达到同样的效果可以使用列表表达式:

[y for x in a for y in x]

9. 形状操作:

ravel(),vstack(),hstack(),column_stack,row_stack, stack, split, hsplit, vsplit

import numpy as np


#增加维度
a = np.arange(5)
a[:, np.newaxis]
a[np.newaxis, :]
np.tile([1,2], 2)


#合并
a = np.arange(10).reshape(2,5)
print(a.ravel())
print(a.resize(5,2))
b = np.arange(6).reshape(2,3)
c = np.ones((2,3))
d = np.hstack((b,c))              # hstack:horizontal stack 左右合并
e = np.vstack((b,c))              # vstack: vertical stack 上下合并          
f = np.column_stack((b,c))
g = np.row_stack((b,c))
h = np.stack((b, c), axis=1)      # 按行合并
i = np.stack((b,c), axis=0)       # 按列合并
j = np.concatenate ((b, c, c, b), axis=0)   #多个合并

 
#分割
k = np.hsplit(i, 2)
l = np.vsplit(i, 2)
m = np.split(i, 2, axis=0)
n = np.split(i, 2,axis=1)

 
o = np.array_split(np.arange(10),3)   #不等量分割

10.深拷贝:

import numpy as np
a = np.arange (4)
b = a
c = a
d = b
a[0]=10  a = ? b = ? c= ? d = ?
b = a.copy()
a [0] = 9
b = ?

11.广播 Broadcasting

广播是一种强有力的机制,它让Numpy可以让不同大小的矩阵在一起进行数学计算。我们常常会有一个小的矩阵和一个大的矩阵,然后我们会需要用小的矩阵对大的矩阵做一些计算。

把一个向量加到矩阵的每一行:

    import numpy as np
    a = np.array ([[1,2,3], [4,5,6], [7,8,9]])
    b = np.array ([10,10,10])
    c = np.tile(b, (4,1))
    d = a + c
    #用广播机制:
    c = a + b

对两个数组使用广播机制要遵守下列规则:

  1. 如果数组的秩不同,使用1来将秩较小的数组进行扩展,直到两个数组的尺寸的长度都一样。
  2. 如果两个数组在某个维度上的长度是一样的,或者其中一个数组在该维度上长度为1,那么我们就说这两个数组在该维度上是相容的。
  3. 如果两个数组在所有维度上都是相容的,他们就能使用广播。
  4. 如果两个输入数组的尺寸不同,那么注意其中较大的那个尺寸。因为广播之后,两个数组的尺寸将和那个较大的尺寸一样。
  5. 在任何一个维度上,如果一个数组的长度为1,另一个数组长度大于1,那么在该维度上,就好像是对第一个数组进行了复制。

以上就是关于pythonnumpy库的相关知识了,希望对大家有所帮助。

联系我们