C++空指针可以用nullptr代替NULL

thbcm阅读(325)

首先了解一下什么是空指针,空指针就是void*

C/C++中,为了避免野指针(即指针没有指向任何地址)的出现,声明一个指针后,最好马上对其进行初始化。

如果暂时不明确指针指向哪个变量,则可以赋予NULL,如:

int* p = NULL;

除了NULL之外,C++11新标准引入了nullptr来表示一个空指针。

nullptr 既不是整型类型,也不是指针类型,nullptr 的类型是 std::nullptr_t,能转换成任意的指针类型。

为什么建议使用nullptr代替NULL呢?

这是因为在C++中,NULL是被定义为0的常量,当遇到函数重载时,就会出现问题。

比如有下面两个函数时:

  • void foo(int n)
  • void foo(char* s)

函数重载:C++允许在同一作用域中声明多个类似的同名函数,这些同名函数的形参列表(参数个数,类型,顺序)必须不同。

#include <iostream>
using namespace std;


void foo(int n) {
    cout << "foo(int n)" << endl;
}


void foo(char* s) {
    cout << "foo(char* s)" << endl;
}


int main()
{
    foo(NULL);
    return 0;
}

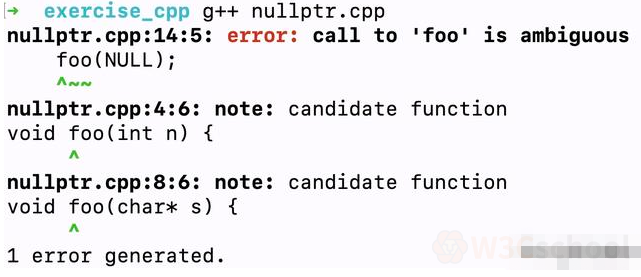
编译上述代码,结果如下图所示,编译器提示有两个函数都可能匹配,产生二义性。

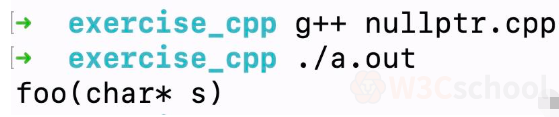
而用nullptr,编译器则会选择 foo(char* s)的函数,因为nullptr不是整数类型。

#include <iostream>
using namespace std;


void foo(int n) {
    cout << "foo(int n)" << endl;
}


void foo(char* s) {
    cout << "foo(char* s)" << endl;
}


int main()
{
    foo(nullptr);
    return 0;
}

运行结果如下图所示:

因此,当需要使用空指针时,优先使用nullptr,而非NULL

以上就是关于c++空指针为什么要用nullptr代替NULL的原因了,希望对大家有所帮助,然后想学习更多C++知识的同学可以看一下教程

C++教程:https://www.w3cschool.cn/cpp/

C++微课:https://www.w3cschool.cn/minicourse/play/cppminicourse

文章参考来源:www.toutiao.com/a6854549524803748356/

Vue 3 异步组件的重新“定义”

thbcm阅读(765)

首先我们来看一下有关于异步组件的变化:

  • 新增了一个方法:defineAsyncComponent,用来显式地定义异步组件
  • component 选项改名:loader
  • Loader 函数不再接受 resolvereject 作为参数,并且必须返回一个 Promise

曾经的异步组件

Vue 2.x 中,定义一个异步组件还是很方便的:

const asyncPage = () => import(‘./HugePageComponent.vue’);

如果需要一些高级的用法(我赌五毛钱你不知道这个用法):

import { ErrorComponent, LoadingComponent } from ‘xxx’; const asyncPage = { component: () => import(‘./HugePageComponent’), delay: 1000, timeout: 3000, error: ErrorComponent, loading: LoadingComponent, }

即将到来的 Vue 3 异步组件

因为在 Vue 3 中函数式组件均有普通函数来定义,所以异步组件需要通过 defineAsyncComponent 来进行显式地定义。

import { defineAsyncComponent } from ‘vue’; import { ErrorComponent, LoadingComponent } from ‘xxx’;


// 常规用法
const asyncPage = defineAsyncComponent(() => import('./HugePageComponent'));


// 高级用法
const asyncPageWithOptions = defineAsyncComponent({
  // 这里之前是 component,现在改叫 loader 了 
  loader: () => import('./HugePageComponent'),
  delay: 1000,
  timeout: 3000,
  errorComponent: ErrorComponent,
  loadingComponent: LoadingComponent,
});

另外,和 Vue 2.x 不同的是,loader 函数不再提供 resolvereject 作为默认参数了,而且必须返回一个 Promise

// 2.x 版本 const oldAsyncComponent = (resolve, reject) => { // }


// 3.x 版本
const newAsyncComponent = defineAsyncComponent(
 () => {
    return new Promise((resolve, reject) => {
      /* ... */
    });
  }
);

以上就是Vue 3 关于异步组件的改变,对Vue感兴趣的同学可以看一下教程

Vue 1教程:https://www.w3cschool.cn/vuejs/

Vue 2教程:https://www.w3cschool.cn/vuejs2/

Vue 2.x 微课:https://www.w3cschool.cn/minicourse/play/vuecourse

文章参考来源:www.toutiao.com/a6853814142684365320/

充满了汗水和泪水的编程经验,初学者请注意

thbcm阅读(328)

作为一名程序员,在编程中,难免会遇到很多坑。小编有过几年的编程经历,这中间为自己为别人挖过很多坑,也踩过别人的坑,帮别人填过坑。作为一名过来人,我把自己踩坑的经验总结一下,让大家参考一下,或许能避免一些坑。

1.任何修改都要经过测试才可以上线

小编有次在投产上线前发现自己的代码有bug,由于时间紧迫,小编改完后阅读了下代码自认为没有问题了,自测都没有进行,就把代码提交上线了。

结果第二天用户使用这个功能时,直接报错了,只得当天晚上重启服务器放上经过测试的代码。

此事被大领导通报批评,连累项目经理一起挨批。

2.sql防注入是最基本的常识

小编刚开始做项目的时候,看到项目组中有把入参拼接在sql中,没有采用预编译的方式输入参数,小编也跟着这样写。

而这些接口都是通过外网手机app端来调用的,危险性瞬间提高。

部门的安全组及时扫描识别出这些问题,小编花了整整一个元旦的假期才把这些sql拼接参数的代码换成预编译的方式,还改错了一个接口,还好修复完后没有大碍。

sql注入是一件极其危险的事情,使用预编译的方式避免sql注入是最有效的方式之一。当然,除了sql注入,还有命令注入等等注入。

3.编程的关键在于解耦以及可读性

小编之前的老板教小编,好的代码一定要具有良好的可读性,可读性是可维护性的基础。

小编写代码的时候就琢磨,这个类,这个方法,这个变量起什么名字好呢?好的代码是具有自解释的能力。

小编在维护之前同事的代码时,发现有的同事的代码写得又臭又长,变量有时是a1,a2,a3之类的。明明是个新增方法,偏偏用get开头;有的同事用魔鬼数字,看得小编莫名其妙。

解耦性呢,就是我做我该做的事情,你做你该做的事情,互不干涉内政,各自应对变化。

比如说大家继承了一个类或者实现了一个接口,就各自做好自己本分的工作就好了。

又比如说一个复杂的逻辑,可以分拆成多个子逻辑,每个子逻辑就解耦开来,修改一个方法,不会影响另一个方法的使用,方法的复杂度也降低了。

4.尽量不要重复造轮子

有的类或者jar包已经被广泛应用,没有什么问题了,自己有空研究就好,没有必要再写一个了。

之前小编做一个导入的功能时,由于要入库的数据很大,需要对集合分割分批导入。

小编就写了一个分割集合的方法,经项目另外一个同事的提醒,发现系统引入的开源jar包中已经有这个方法了,直接导包使用就行了。

集合的分组,过滤,listmap,list对象提取属性等使用java 8 的项目都可以通过java8的流来操作。

5.数据库建表要尽量遵循数据库表的范式

小编的项目组发现很多表都建立了不必要的冗余字段,比如名称这些。

当用户修改了基表的数据时,业务表的名称数据又没有修改过来,而查询的时候却不是关联基表去查询名称字段的,导致用户两边看到的数据不一致。

维护这些数据和修改查询功能花费了小编大量的时间。

6.尽量不要答应业务直接在后台数据库导数入库

数据库导入数绕过了代码逻辑,没有经过代码逻辑的拦截和业务规则的校验,有可能导致不合法的数据入库,甚至影响正常的业务流程。

而且导入的数据往往数量巨大,更加重的之后的维护成本。之前小编做的功能也导入过大量历史存量数据,结果这些数据很多有问题。

导完这些数据后,用户发现对现有的使用造成了影响,不得不一笔笔向业务确认,重新刷数,真是心累。

那么有想了解SQL数据库的同学,可以看一下教程

SQL教程:https://www.w3cschool.cn/sql/

MySQL微课:https://www.w3cschool.cn/minicourse/play/mysqlcourse

带你了解C语言自动变量的几种类型

thbcm阅读(320)

首先先了解一下什么是自动变量,属于自动存储类别的变量具有自动存储期、块作用域且无链接。默认情况下,声明在块或函数头中的任何变量都属于自动存储类别。一般情况下,不作专门说明的局部变量,均是自动变量。

关键字auto

为了更清楚地表达你的意图(例如,为了表明有意覆盖一个外部变量定义,或者强调不要把该变量改为其他存储类别),可以显式使用关键字auto,如下所示:

int main(void)
{
  auto int plox;

关键字auto是存储类别说明符(storage-class specifier)。auto关键字在C++中的用法完全不同,如果编写C/C++兼容的程序,最好不要使用auto作为存储类别说明符。

块作用域无链接意味着只有在变量定义所在的块中才能通过变量名访问该变量(当然,参数用于传递变量的值和地址给另一个函数,但是这是间接的方法)。另一个函数可以使用同名变量,但是该变量是存储在不同内存位置上的另一个变量。

变量具有自动存储期意味着,程序在进入该变量声明所在的块时变量存在,程序在退出该块时变量消失。原来该变量占用的内存位置现在可做他用。

嵌套快的情况

接下来分析一下嵌套块的情况。块中声明的变量仅限于该块及其包含的块使用。

int loop(int n)
{
     int m;          // m in scope
     scanf("%d", &m);
     {
          int i;    // both m and i in scope
          for (i = m; i < n; i++)
               puts("i is local to a sub-blockn");
     }
     return m;     // m in scope, i gone
}

在上面的代码中,i仅在内层块中可见。如果在内层块的前面或后面使用i,编译器会报错。通常,在设计程序时用不到这个特性。然而,如果这个变量仅供该块使用,那么在块中就近定义该变量也很方便。这样,可以在靠近使用变量的地方记录其含义。另外,这样的变量只有在使用时才占用内存。变量nm分别定义在函数头和外层块中,它们的作用域是整个函数,而且在调用函数到函数结束期间都一直存在。

如果内层块中声明的变量与外层块中的变量同名会怎样?内层块会隐藏外层块的定义。但是离开内层块后,外层块变量的作用域又回到了原来的作用域。程序hiding.c演示了这一过程。

// hiding.c -- variables in blocks
#include <stdio.h>
int main()
{
    int x = 30;      // original x


    printf("x in outer block: %d at %pn", x, &x);
    {
        int x = 77;  // new x, hides first x
        printf("x in inner block: %d at %pn", x, &x);
    }
    printf("x in outer block: %d at %pn", x, &x);
    while (x++ < 33) // original x
    {
        int x = 100; // new x, hides first x
        x++;
        printf("x in while loop: %d at %pn", x, &x);
    }
    printf("x in outer block: %d at %pn", x, &x);


    return 0;
}

下面是该程序的输出:

x in outer block: 30 at 0x7fff5fbff8c8
x in inner block: 77 at 0x7fff5fbff8c4
x in outer block: 30 at 0x7fff5fbff8c8
x in while loop: 101 at 0x7fff5fbff8c0
x in outer block: 34 at 0x7fff5fbff8c8

首先,程序创建了变量x并初始化为30,如第1条printf()语句所示。然后,定义了一个新的变量x,并设置为77,如第2条printf()语句所示。根据显示的地址可知,新变量隐藏了原始的x。第3条printf()语句位于第1个内层块后面,显示的是原始的x的值,这说明原始的x既没有消失也不曾改变。也许该程序最难懂的是while循环

while循环的测试条件中使用的是原始的x

while(x++ < 33)

在该循环中,程序创建了第3个x变量,该变量只定义在while循环中。所以,当执行到循环体中的x++时,递增为101的是新的x,然后printf()语句显示了该值。每轮迭代结束,新的x变量就消失。然后循环的测试条件使用并递增原始的x,再次进入循环体,再次创建新的x。在该例中,这个x被创建和销毁了3次。注意,该循环必须在测试条件中递增x,因为如果在循环体中递增x,那么递增的是循环体中创建的x,而非测试条件中使用的原始x

我们使用的编译器在创建while循环体中的x时,并未复用内层块中x占用的内存,但是有些编译器会这样做。

该程序示例的用意不是鼓励读者要编写类似的代码(根据C的命名规则,要想出别的变量名并不难),而是为了解释在内层块中定义变量的具体情况。

没有花括号的块

前面提到一个C99特性:作为循环或if语句的一部分,即使不使用花括号({}),也是一个块。更完整地说,整个循环是它所在块的子块(sub-block),循环体是整个循环块的子块。与此类似,if语句是一个块,与其相关联的子语句是if语句的子块。这些规则会影响到声明的变量和这些变量的作用域。程序forc99.c演示了for循环中该特性的用法。

// forc99.c -- new C99 block rules
#include <stdio.h>
int main()
{
    int n = 8;


    printf("   Initially, n = %d at %pn", n, &n);
    for (int n = 1; n < 3; n++)
        printf("      loop 1: n = %d at %pn", n, &n);
    printf("After loop 1, n = %d at %pn", n, &n);
    for (int n = 1; n < 3; n++)
    {
        printf(" loop 2 index n = %d at %pn", n, &n);
        int n = 6;
        printf("      loop 2: n = %d at %pn", n, &n);
        n++;
    }
    printf("After loop 2, n = %d at %pn", n, &n);


    return 0;
}

假设编译器支持C语言的这个新特性,该程序的输出如下:

Initially, n = 8 at 0x7fff5fbff8c8
loop 1: n = 1 at 0x7fff5fbff8c4
loop 1: n = 2 at 0x7fff5fbff8c4
After loop 1, n = 8 at 0x7fff5fbff8c8
loop 2 index n = 1 at 0x7fff5fbff8c0
loop 2: n = 6 at 0x7fff5fbff8bc
loop 2 index n = 2 at 0x7fff5fbff8c0
loop 2: n = 6 at 0x7fff5fbff8bc
After loop 2, n = 8 at 0x7fff5fbff8c8

需要注意的一点:

支持C99C11有些编译器并不支持C99/C11的这些作用域规则(Microsoft Visual Studio 2012就是其中之一)。有些编译会提供激活这些规则的选项。例如,撰写本书时,gcc默认支持了C99的许多特性,但是要用–std=c99选项激活程序清单12.2中使用的特性:

gcc –std=c99 forc99.c

与此类似,gccclang都要使用–std=c1x-std=c11选项,才支持C11特性

程序forc99.c第1个for循环头中声明的n,其作用域作用至循环末尾,而且隐藏了原始的n。但是,离开循环后,原始的n又起作用了。

第2个for循环头中声明的n作为循环的索引,隐藏了原始的n。然后,在循环体中又声明了一个n,隐藏了索引n。结束一轮迭代后,声明在循环体中的n消失,循环头使用索引n进行测试。当整个循环结束时,原始的n又起作用了。再次提醒读者注意,没必要在程序中使用相同的变量名。如果用了,各变量的情况如上所述。

自动变量的初始化

自动变量不会初始化,除非显式初始化它。考虑下面的声明:

int main(void)
{
  int repid;
  int tents = 5;

tents变量被初始化为5,但是repid变量的值是之前占用分配给repid的空间中的任意值(如果有的话),别指望这个值是0。可以用非常量表达式(non-constantexpression)初始化自动变量,前提是所用的变量已在前面定义过:

int main(void)
{
  int repid;
  int tents = 5;

以上就是关于C语言的几种自动变量的说明了,有兴趣的同学可以看一下C语言的相关教程

C教程:https://www.w3cschool.cn/c/

你知道C语言外部链接的静态变量有哪几种吗?

thbcm阅读(305)

上文说到了C语言自动变量的几种类型,这里就说一下c语言外部链接的静态变量的类型。

外部链接的静态变量具有文件作用域、外部链接和静态存储期。该类别有时称为外部存储类别(external storage class),属于该类别的变量称为外部变量(external variable)。把变量的定义性声明(defining declaration)放在所有函数的外面便创建了外部变量。

当然,为了指出该函数使用了外部变量,可以在函数中用关键字extern再次声明。如果一个源代码文件使用的外部变量定义在另一个源代码文件中,则必须用extern在该文件中声明该变量。如下所示:

int Errupt;           /* externally defined variable    */
double Up[100];       /* externally defined array       */
extern char Coal;     /* mandatory declaration if       */
                      /* Coal defined in another file   */
void next(void);
int main(void)
{
  extern int Errupt;  /* optional declaration           */


  extern double Up[]; /* optional declaration           */
  ...
}
void next(void)
{
  ...
}

注意,在main()中声明Up数组时(这是可选的声明)不用指明数组大小,因为第1次声明已经提供了数组大小信息。main()中的两条extern声明完全可以省略,因为外部变量具有文件作用域,所以ErruptUp从声明处到文件结尾都可见。它们出现在那里,仅为了说明main()函数要使用这两个变量。如果省略掉函数中的extern关键字,相当于创建了一个自动变量。去掉下面声明中的extern

extern int Errupt;

便成为:

int Errupt;

这使得编译器在main()中创建了一个名为Errupt的自动变量。它是一个独立的局部变量,与原来的外部变量Errupt不同。该局部变量仅main()中可见,但是外部变量Errupt对于该文件的其他函数(如next())也可见。简而言之,在执行块中的语句时,块作用域中的变量将“隐藏”文件作用域中的同名变量。如果不得已要使用与外部变量同名的局部变量,可以在局部变量的声明中使用auto存储类别说明符明确表达这种意图。外部变量具有静态存储期。因此,无论程序执行到main()next()还是其他函数,数组Up及其值都一直存在。下面3个示例演示了外部和自动变量的一些使用情况。示例1中有一个外部变量Hocus。该变量对main()magic()均可见。

/* Example 1 */
int Hocus;
int magic();
int main(void)
{
   extern int Hocus;  // Hocus declared external
   ...
}
int magic()
{
   extern int Hocus;  // same Hocus as above
   ...
}

示例2中有一个外部变量Hocus,对两个函数均可见。这次,在默认情况下对magic()可见。

/* Example 2 */
int Hocus;
int magic();
int main(void)
{
   extern int Hocus;  // Hocus declared external
   ...
}
int magic()
{
                      // Hocus not declared but is known
   ...
}

在示例3中,创建了4个独立的变量。main()中的Hocus变量默认是自动变量,属于main()私有。magic()中的Hocus变量被显式声明为自动,只有magic()可用。外部变量Hocusmain()magic()均不可见,但是对该文件中未创建局部Hocus变量的其他函数可见。最后,Pocus是外部变量,magic()可见,但是main()不可见,因为Pocus被声明在main()后面。

/* Example 3 */
int Hocus;
int magic();
int main(void)
{
  int Hocus;        // Hocus declared, is auto by default
   ...
}
int Pocus;
int magic()
{
   auto int Hocus;  // local Hocus declared automatic
   ...
}

这3个示例演示了外部变量的作用域是:从声明处到文件结尾。除此之外,还说明了外部变量的生命期。外部变量HocusPocus在程序运行中一直存在,因为它们不受限于任何函数,不会在某个函数返回后就消失。

初始化外部变量

外部变量和自动变量类似,也可以被显式初始化。与自动变量不同的是,如果未初始化外部变量,它们会被自动初始化为0。这一原则也适用于外部定义的数组元素。与自动变量的情况不同,只能使用常量表达式初始化文件作用域变量:

int x = 10;              // ok, 10 is constant
int y = 3 + 20;          // ok, a constant expression
size_t z = sizeof(int);  // ok, a constant expression
int x2 = 2 * x;          // not ok, x is a variable

(只要不是变长数组,sizeof表达式可被视为常量表达式。)

使用外部变量

下面来看一个使用外部变量的示例。假设有两个函数main()critic(),它们都要访问变量units。可以把units声明在这两个函数的上面,如程序清单12.4所示(注意:该例的目的是演示外部变量的工作原理,并非它的典型用法)。

/* global.c  -- uses an external variable */
#include <stdio.h>
int units = 0;         /* an external variable      */
void critic(void);
int main(void)
{
    extern int units;  /* an optional redeclaration */


    printf("How many pounds to a firkin of butter?n");
    scanf("%d", &units);
    while ( units != 56)
        critic();
    printf("You must have looked it up!n");


    return 0;
}


void critic(void)
{
    /* optional redeclaration omitted */
    printf("No luck, my friend. Try again.n");
    scanf("%d", &units);
}

下面是该程序的输出示例:

How many pounds to a firkin of butter?
14
No luck, my friend. Try again.
56
You must have looked it up!
(We did.)

注意,critic()是如何读取units的第2个值的。当while循环结束时,main()也知道units的新值。所以main()函数和critic()都可以通过标识符units访问相同的变量。用C的术语来描述是,units具有文件作用域、外部链接和静态存储期。

units定义在所有函数定义外面(即外部),units便是一个外部变量,对units定义下面的所有函数均可见。因此,critics()可以直接使用units变量。

类似地,main()也可直接访问units。但是,main()中确实有如下声明:

extern int units;

本例中,以上声明主要是为了指出该函数要使用这个外部变量。存储类别说明符extern告诉编译器,该函数中任何使用units的地方都引用同一个定义在函数外部的变量。再次强调,main()critic()使用的都是外部定义的units

外部名称

C99C11标准都要求编译器识别局部标识符的前63个字符和外部标识符的前31个字符。这修订了以前的标准,即编译器识别局部标识符前31个字符和外部标识符前6个字符。你所用的编译器可能还执行以前的规则。外部变量名比局部变量名的规则严格,是因为外部变量名还要遵循局部环境规则,所受的限制更多。

定义和声明

下面进一步介绍定义变量和声明变量的区别。考虑下面的例子:

int tern = 1;            /* tern defined                 */
main()
{
     external int tern;  /* use a tern defined elsewhere */

这里,tern被声明了两次。第1次声明为变量预留了存储空间,该声明构成了变量的定义。第2次声明只告诉编译器使用之前已创建的tern变量,所以这不是定义。第1次声明被称为定义式声明(defining declaration),第2次声明被称为引用式声明(referencing declaration)。关键字extern表明该声明不是定义,因为它指示编译器去别处查询其定义。

假设这样写:

extern int tern;
int main(void)
{

编译器会假设tern实际的定义在该程序的别处,也许在别的文件中。该声明并不会引起分配存储空间。因此,不要用关键字extern创建外部定义,只用它来引用现有的外部定义。

外部变量只能初始化一次,且必须在定义该变量时进行。假设有下面的代码:

// file one.c
char permis = 'N';
...
// file two.c
extern char permis = 'Y';   /* error */

file_two中的声明是错误的,因为file_one.c中的定义式声明已经创建并初始化了permis

以上就是关于C语言外部链接的静态变量类型的说明,对C语言有兴趣的同学可以看一下教程

C教程:https://www.w3cschool.cn/c/

Linux系统如何使用Vim读写远程文件

thbcm阅读(298)

这篇文章我们将说到Linux系统Vim的使用——读写远程文件。在实现这个功能之前,我们要先安装一个叫 netrw.vim的插件。

插件 netrw 是什么?

netrw(面向网络的读写和浏览 Network oriented reading, writing and browsing)插件不仅支持本地和远程终端跨网络编辑、读写文件,还能支持浏览本地和远程终端目录。需要了解这个插件的更多细节信息,在Vim会话输入 help netrw 即可查看。

下面让我们来看看怎么用 Vim 从本地系统读写存储在远程 Linux 系统上的文件。

使用 Linux 系统上的 Vim 读写远程文件

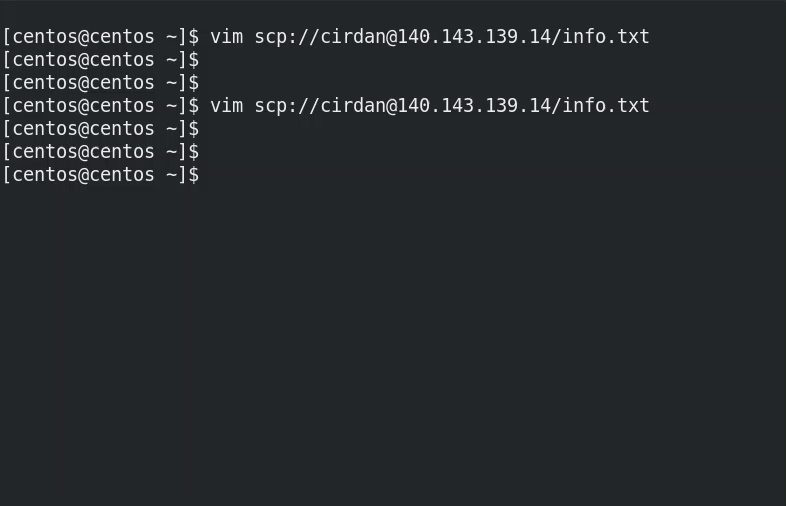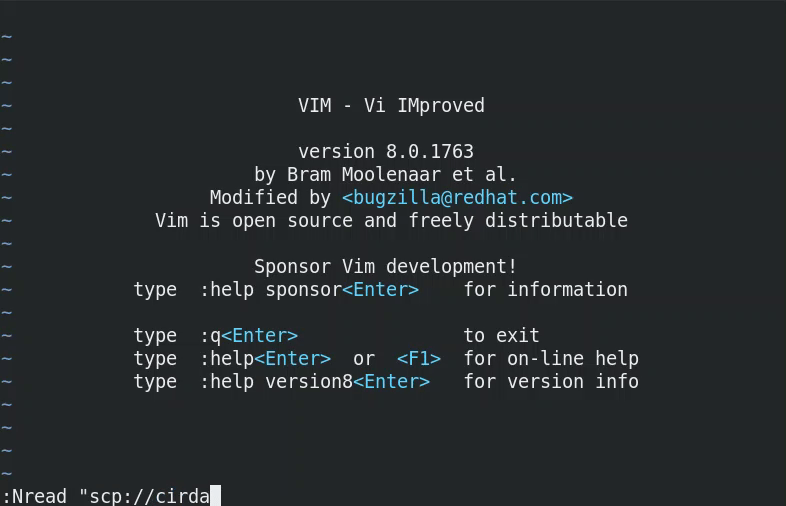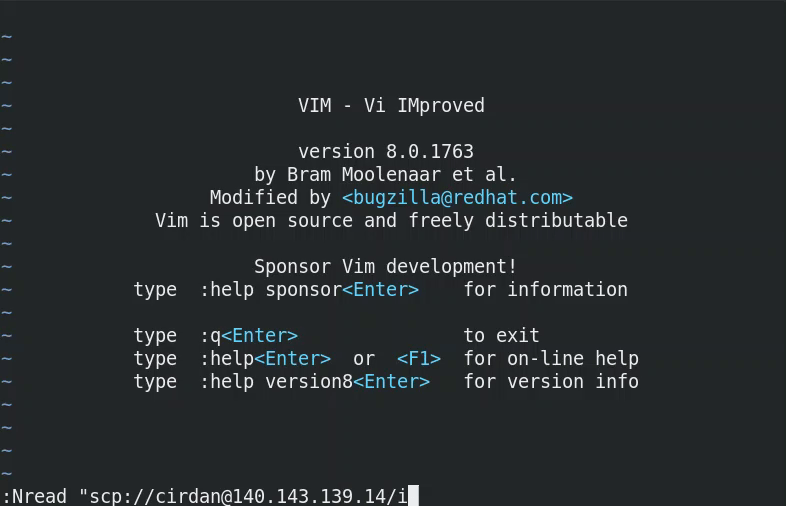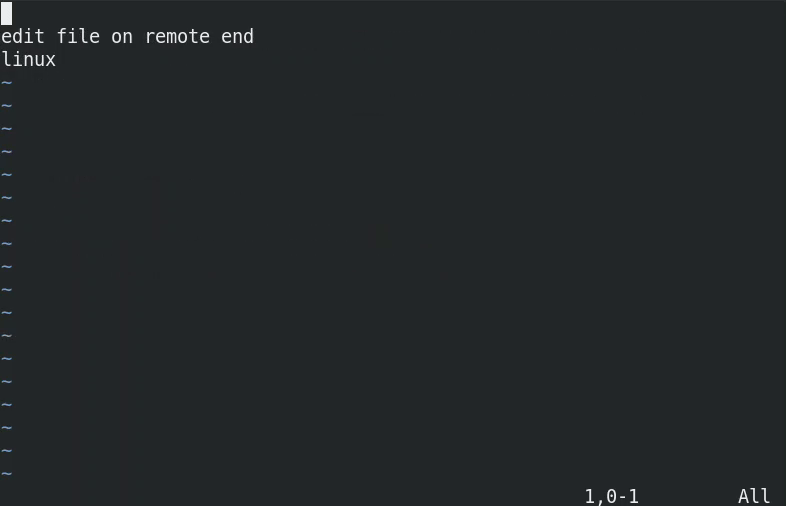
读写远程文件的方法几乎和编辑远程文件一样,需要从本地系统读取一个远程文件,我们可以简单的使用下面这个命令来打开它:

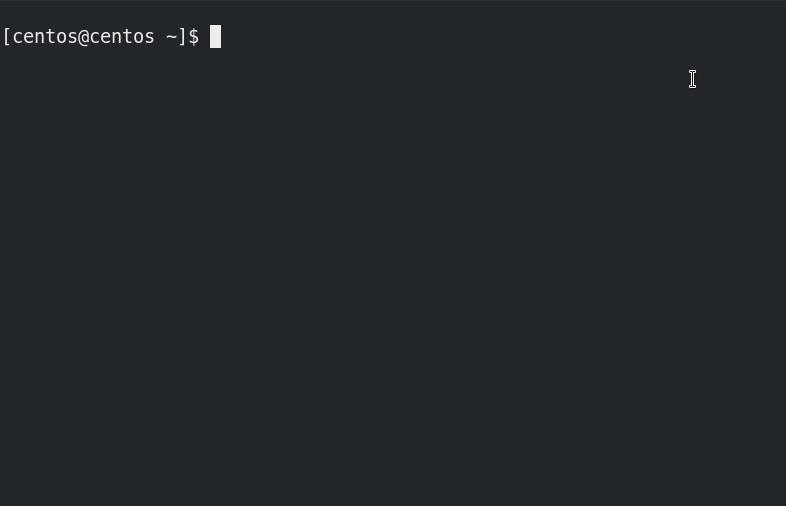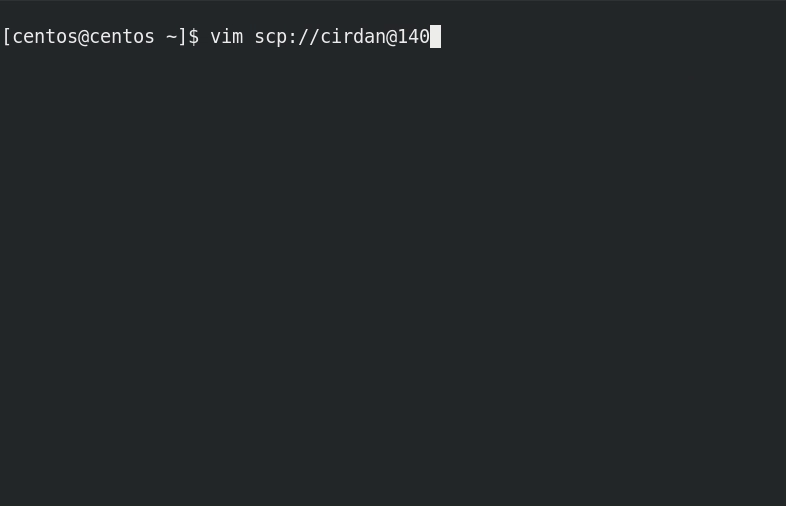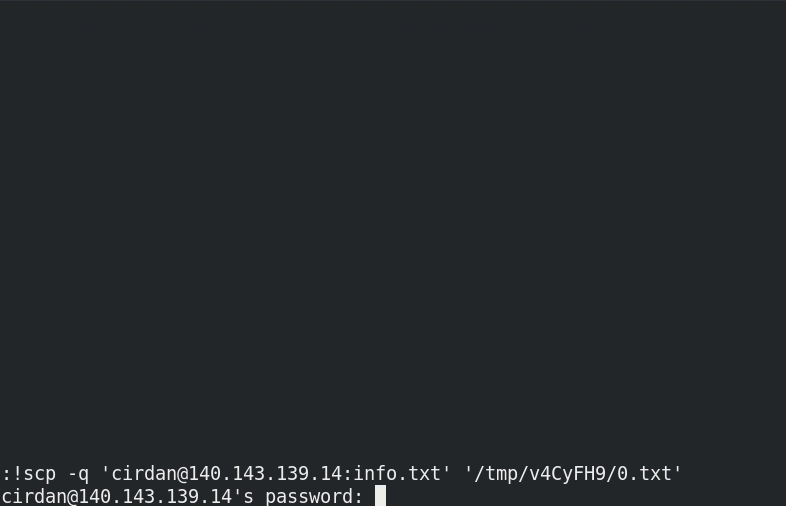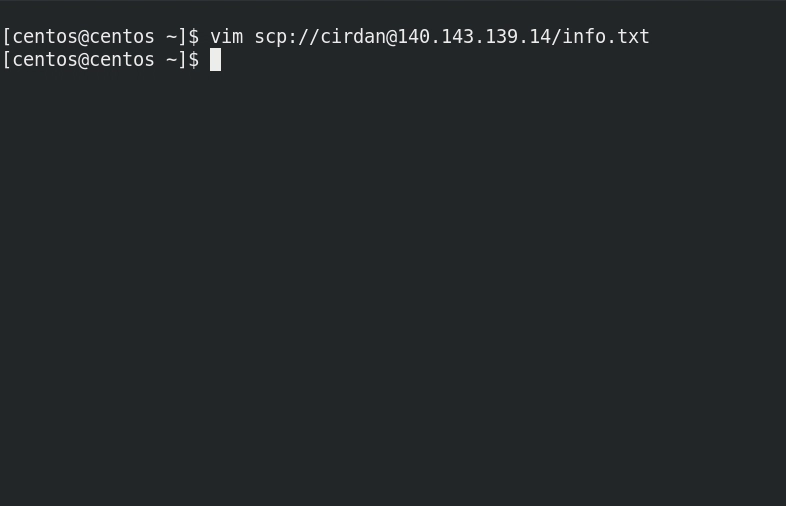
$ vim scp://cirdan@192.168.225.22/info.txt

输入 q 退出文件。

要从本地系统写一个远程文件,也是先用上述命令打开文件,之后再按 i 进入插入模式接着就可以往文件里写入了。等写完需要写入文件的内容之后,按 ESC 键退出插入模式,然后输入 wq 保存并退出。

命令背后的运行过程实际上是用 scp 命令将远程文件拷贝到本地系统的 /tmp 目录下,然后再打开文件编辑的。在你编辑完后,scp 命令再次将本地已编辑文件拷贝回远程系统。

要从本地查看远程文件内容是否真的改动过用这一条命令:

$ ssh cirdan@192.168.225.22 cat info.txt

请注意,如果你要用远程终端目录的绝对路径,应像如下所示命令一样使用双斜杠:

$ vim scp://cirdan@192.168.225.22//home/cirdan/Documents/info.txt

如果你已经因为安全原因改变了SSH端口,则应当显式地说明SSH端口号,如下所示:

$ vim scp://cirdan@192.168.225.22:2200/info.txt

这里端口 2200 就是我们自定义的端口号,大家可以根据具体情况使用自己的 ssh 端口号替代上述命令中的2200。

如果你没有 ssh/scp 的通道,也可以用其他协议来替代,如下所示:

$ vim ftp://user@remotesystem/path/to/file

在Vim会话里读写远程文件

如果你已经进入了一个 Vim 会话,则可以使用 Nread(NetRead)和 Nwrite(NetWrite)命令来读写远程文件。

假如,我们现在使用如下命令打开本地系统的Vim 编辑器:

$ vim

接着你就进入了 Vim 会话,要在本地新缓存中的 Vim 会话中读一个远程文件,只需要运行如下命令:

:e scp://cirdan@192.168.225.22/info.txt

除此之外,还可以用 Nread 命令如下所示:

:Nread scp://cirdan@192.168.225.22/info.txt

或者,这样输入:

:Nread “scp://cirdan@192.168.225.22/info.txt”

想要知道这个命令的详细信息,请在 Vim 会话中输入如下命令:

:Nread ?

读完说明文件后,输入 :q退出文件即可。

与之相似,要写入远程文件也应先使用如下命令:

:e scp://cirdan@192.168.225.22/info.txt

i 键进入插入模式就可以写入和修改文件了。

你也可以用 :w 创建并写文件,但是这个命令只能创建一个新的空文件:

:w scp://cirdan@192.168.225.22/info.txt

写完之后,按 ESC 键退出编辑,然后输入:wq保存并退出文件。

除此之外,还可以用 Nwrite 命令创建并写入文件,其用法示例如下:

:Nwrite scp://cirdan@192.168.225.22/info.txt

关于 Nwrite 命令的详细信息,在Vim会话中输入如下信息即可:

:Nwrite ?

以上就是Linux系统中Vim的使用技巧了,希望对大家有所帮助,对Linux感兴趣的同学可以看一下教程

Linux教程:https://www.w3cschool.cn/linux/

Linux微课:https://www.w3cschool.cn/minicourse/play/linuxcourse

Linux就该这么学:https://www.w3cschool.cn/linuxprobe/

带你了解Linux内核源代码编程规范

thbcm阅读(312)

这是一篇简短的文章,描述了描述了linux内核的首选代码风格。目的是为了分享,作为一名linux内核或者驱动开发工程师,很有必要了解这些内核开发规范。

  • 这些约定或者规范对我们阅读linux内核源码、了解设计思路有很大帮助。
  • 我们基于linux内核做开发,也要往内核里添加代码,遵守开发规范,有助于别人阅读和理解我们的代码。

linux内核代码规范约定如下:

1.强烈推荐单行的宽度为八十列。

任何一行超过八十列宽度的语句都应该拆分成多个行,除非超过八十列的部分可以提高可读性且不会隐藏信息。但是,千万不要把用户可见的字符串,比如 printk 的信息,拆分成多行,因为这样会导致使用 grep 的时候找不到这些信息。

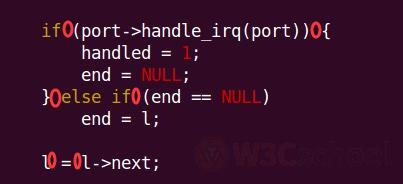
2.关于大括号

c语言里的ifdo, while, for语句都会使用到大括号,内核代码倾向于把左括号放在行末,把右括号放在行首,并且大括号和前面的语句,以及if和后面的语句,都保留一个空格,例如:

以上红圈标注都代表一个空格。

3.关于空格

这个还是单独列出来说明一下吧,因为内核代码里用到空格的地方太多了。

Linux 内核风格的空格主要用在一些关键字上,即在关键字之后添一个空格。值得关注的例外是一些长得像函数的关键字,比如:sizeof, typeof, alignof, attribute,在 Linux 中,这些关键字的使用都会带上一对括号,比如sizeof(int)

所以在下面这些关键字后面需要添加一个空格:

if, switch, case, for, do, while

但是, sizeof, typeof, alignof, attribute 之后则不需要添加空格:

s = sizeof(struct file);

在声明指针或者返回值为指针的函数时,星号的位置应该紧靠着变量名或函数名,而不是类型名,例如:

char linux_banner; unsigned long long memparse(char ptr, char *retptr); char match_strdup(substring_t *s);

在二元操作符和三元操作符周围添加一个空格,例如:

= + – < > * / % | & ^ <= >= == != ? :

但是不要在一元操作符之后添加空格:

& * + – ~ ! sizeof typeof alignof attribute defined

4.变量命名

C 是一种简洁粗旷的语言,因此,你的命名也应该是简洁的。linux内核里的变量定义应该尽可能简单,在不产生歧义的情况下,越简单越好。可以用下划线,但是绝对不推荐使用大写字母。所以,内核里的变量和函数定义不要使用驼峰命名法。

5.函数

函数应该短小精悍,一个函数只干一件事。几百行代码组成一个函数是不被推荐的。

关键函数的前面最好留有注释。这样其他人可以快速看懂你的代码意图:

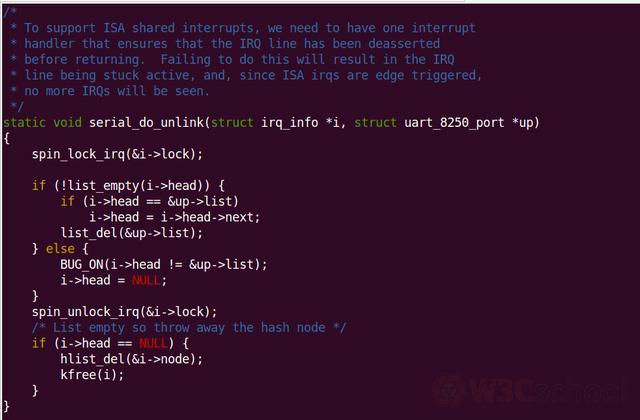
6.注释

多行注释推荐格式如下:

/*

  • To support ISA shared interrupts, we need to have one interrupt
  • handler that ensures that the IRQ line has been deasserted
  • before returning. Failing to do this will result in the IRQ
  • line being stuck active, and, since ISA irqs are edge triggered,
  • no more IRQs will be seen. */

7.推荐使用函数自注释

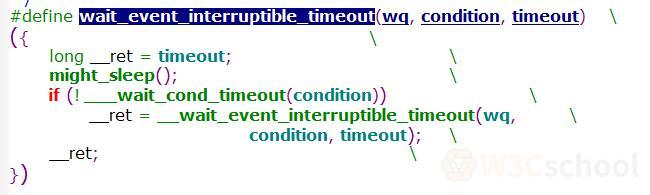
所谓函数自注释,就是从你的函数名就可以猜到你要干什么,比如内核的:

wait_event(), wait_event_interruptible(), wait_event_interruptible_timeout()等。

注意,写代码不只是写给现在的自己,也是写给以后的自己,也是写给其他人看的。如果你回看你一年前写的代码都很陌生,那说明你的代码规范是有问题的。

8.常量宏和枚举的命名都是大写的:

9.打印内核或者驱动信息

编写好的调试信息是一项巨大的挑战,一旦你完成了,这些信息会对远程调试产生巨大帮助

很多子系统在对应的 makefile 里都有 Kconfig 调试选项来打开 -DDEBUG,或者是在文件里定义宏 #define DEBUG。当调试信息可以被无条件打印,或者说已经编译了和调试有关的 #ifdef 段,那么 printk(KERN_DEBUG …) 就可以用来打印调试信息。

10.内联函数(inline)

Inline关键字会让编译器将指定的函数体插入并取代每一处调用该函数的地方(上下文),从而节省了每次调用函数带来的额外时间开支。然而,inline 关键字的泛滥,会使内核变大,从而使整个系统运行速度变慢,因为大内核会占用更多的CPU高速缓存,同时会导致可用内存页缓存减少。想象一下,一次页缓存未命中就会导致一次磁盘寻址,这至少耗费5毫秒。5毫秒足够CPU运行很多很多的指令。

好了,以上就是我们在阅读linux内核源码的时候的一些代码规范的约定。linux源码作为世界上最规范、最严谨的代码,确实有很多值得我们学习的地方。有时候欣赏内核代码的时候总有一种赏心悦目的感觉,这可能跟它们的良好的代码规范有关系吧。 希望这个对大家有所帮助,然后对Linux感兴趣的同学可以看一下教程

Linux教程:https://www.w3cschool.cn/linux/

Linux微课:https://www.w3cschool.cn/minicourse/play/linuxcourse

Linux就该这么学:https://www.w3cschool.cn/linuxprobe/

三分钟带你了解Laravel 模型的get find first用法

thbcm阅读(355)

首先我们来了解一下Laravel 模型,Laravel中是有两种集合,一个是 BaseCollection,一个是 EloquentCollection。后者继承前者,而且对部分方法进行了重载。分清楚之间的细微区别,可以让你在编程中不迷惑。

本文从一整套的例子,从数据库建表,写模型,写控制器,到模板渲染,从一个小bug,讲到集合的深层次原因。

学习时间

首先创建数据库表,我们不使用迁移,直接上SQL

CREATE TABLE `about`(
`id` int(10) UNSIGNED NOT NULL,
`title` varchar(500) COLLATE utf8_unicode_ci NOT NULL,
`content` text COLLATE utf8_unicode_ci,
)ENGINE=InnoDB DEFAULT CHARSET=utf8 COLLATE=utf8_unicode_ci

只有3列,一个是主键,一个是标题,一个是文本内容。注意数据库字段,表,均声明了utf-8编码。

然后创建模型 About,指定表名,我们此处略去,直接看控制器的一个方法:

public function index()
{
    $about = About::where('title', 'about-me')->get(); //id = 3
    return view('about', compact('about'));
}

SQL查询条件是根据标题返回所有的条目,然后将结果集通过 view 视图进行渲染。

然后重点来了,视图内这样写大家看会不会有问题!?

@section('title')
    {{$about->title}}
@stop


@section('content')
    {!! $about->content !!}
@stop 

如果不出意外,开启 debug = true 访问该页面时,你大概率会得到下面的错误提示:

Property [title] does not exist on this collection instance. 
(View: E:\laragon\www\newsite\resources\views\about.blade.php)

大家思考一下,这个故障是如何发生的?下一节我们给出解答。

正确写法

Laravel模型的get() 方法返回一个集合(EloquentCollection)。如果需要使用集合的属性,你首先需要进行遍历。像下面这样在视图文件内写:

@foreach ($collection as $object)
    {{ $object->title }}
@endforeach 

EloquentCollection 内的每一个元素,都是一个 About Model 对象。所以可以使用 $object->title 获取到title属性。

如果你的需求很简单,就是要第一个元素的标题,简写如下:

{{ $collection[0]->title }}

如果你要获取集合内的第一个元素,使用 first 方法:

{{ $collection->first() }}

深入一步

我们知道了问题来自 get() 方法,那么,如果要获取查询数据集的第一条数据,应该用哪个呢?find()或者first()

都会返回一个 About Model 对象,在视图中就可以愉快地写:

{{ $object->title }}

本文通过实际的例子,讲解了laravel模型中查询数据结果集的 find get first 的细微区别,希望能对大家有所帮助。想了解更多的同学可以看一下教程

Laravel 5中文文档:https://www.w3cschool.cn/qpmsiw/

Laravel入门到实战:https://www.w3cschool.cn/minicourse/play/laravelpre

文章参考来源:www.toutiao.com/a6855259233106002440/

一文带你深入了解Linux C Socket Api

thbcm阅读(368)

写这篇文章是为了让大家对Linux C Socket Api了解更加详细。

UNIX 环境高级编程对 Socket 通信的描述是套接字网络 IPC( 进程间通信 ) ,可以用于计算机间通信也可用于计算机内通信,管道、消息队列、信号量以及共享内存等都是属于计算机内通信的情况。
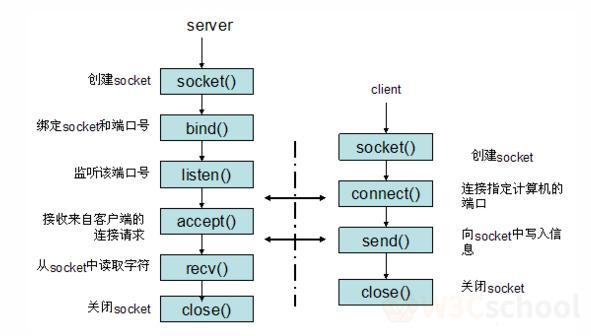
套接字Api详细介绍

1.套接字描述符

首先会先到的是文件描述符,对Linux一切皆文件的哲学又多懂了一点儿点儿。

套接字是通信端点的抽象。与应用程序使用文件描述符一样,访问套接字需要使用套接字描述符。套接字描述符在UNIX系统是用文件描述符实现的。

include <sys/socket.h>

int  socket (int domain, int type, int protocal);
返回值:成功返回文件(套接字)描述符,出错返回-1

参数 domain( 域 ) 确定通信的特性,包括地址格式。各个域都有自己的格式表示地址,表示各个域的常数都以 AF_开头,意指地址族 (address family).
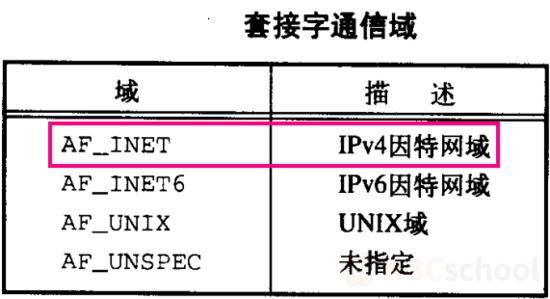
参数type确定套接字的类型,进一步确定通信特征。下图给出了一些类型,但在实现中可以自由增加对其他类型的支持。
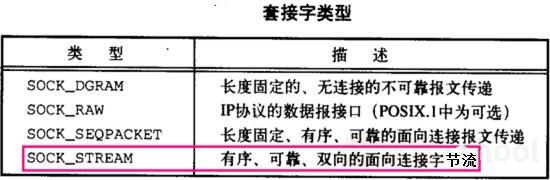
参数protocol通常是 0 ,表示按给定的域和套接字类型选择默认的协议。当对同一域和套接字类型支持多个协议时,可以使用 proticol 参数选择一个特定协议。在 A_FINET 通信域中套接字类型 SOCK_STREAM 的默认协议是 TCP( 传输控制协议 ) ; A_FINET 通信域中套接字类型 SOCK_DGRAM 的默认协议是 UDP( 用户数据报协议 ) 。

字节流(SOCK_STREAM)要求在交换数据之前,在本地套接字和远程套接字之间建立一个逻辑联系。

Tcp : 没有报文界限,提供的是字节流服务 。之前写过 Qt 传输图片的拆包与解包,原因就是如此吧。

调用socket与调用 open 类型,均可获得用于输入、输出的文件描述符。不用的时候记得 close 关闭。

2.寻址

如何确定一个目标通信进程?

进程的标识有两个部分:计算机的网络地址可以确定网络上与之想要通信的计算机

服务可以确定计算机上的特定进程。

2.1 字节序

在同一台计算机上进程间通信时,一般无需考虑字节序。

TCP/IP协议栈使用大端字节序。有关字节序大家可自行百度。

Linux系统是小端字节序。

2.2 地址格式

地址确定了特定通信域中的套接字端点,地址格式与特定的通信域相关。为使不同格式的地址能够被传入到套接字函数,地址被强转换成通用的地址结构sockaddr表示。

Linux中,sockaddr_in定义如下;

struct sockaddr_in { sa_family_t sin_family; in_port_t sin_port; struct in_addr sin_addr; unsigned char sin_zero[8]; };

其中成员sin_zero为填充字段,必须全部置0. 所以在网上搜到的例子有使用bzero.

我目前使用的ubuntu定义如下:

/ Structure describing an Internet socket address. / struct sockaddr_in { __SOCKADDRCOMMON (sin); in_port_t sin_port; / Port number. / struct in_addr sin_addr; / Internet address. /


    /* Pad to size of `struct sockaddr'.  */
    unsigned char sin_zero[sizeof (struct sockaddr) -
               __SOCKADDR_COMMON_SIZE -
               sizeof (in_port_t) -
               sizeof (struct in_addr)];
  };

还有很多关于地址查询的函数,这里就不一一列举了。

3. 将套接字与地址绑定

使用bind函数将地址绑定到一个套接字上。

include <sys/socket.h>

int bind(int  sockfd, const struct sockaddr * addr, socklen_t  len);
返回值:成功返回0,出错返回-1

参数socklen_t使用sizeof来计算就好了。

对于使用地址的一些限制:

端口号不能小于1024,除非该进程具有相应的特权(即为超级用户)。可见规则总是因人而异,计算机也是如此~

对于因特网域,如果指定IP地址为ADDR_ANY,套接字端点可以被绑定到所有的系统网络接口。

注意: linuxman命令可以查看api的详细说明,而且还有例子,也挺不错的。

4. 建立连接

1> connect

如果处理的是面向连接的网络服务(SOCK_STREAMSOCK_SEQPACKET),在开始交换数据前,需要在请求服务的进程套接字(客户端)和提供服务的进程套接字(服务器)之间建立一个连接。使用connect.

include <sys/socket.h>

int connect(int  sockfd, const struct sockaddr  *addr,  socklen_t  len);
返回值:成功返回0,出错返回-1

诶,这个参数好熟悉呀,和bind函数的参数一模一样呀~

client连接server时,由于一些原因,连接可能会失败。可以使用指数补偿的算法解决,了解一下即可。

2> listen

server调用listen来宣告可以接受连接请求:

include <sys/socket.h>

Int listen(int  sockfd, int  backlog);
返回值:成功返回0,出错返回-1

参数backlog提供了一个提示,用于表示该进程所要入队的连接请求数量。其值由系统决定,但上限由<sys/socket.h>SOMAXCONN指定。

一旦队列满,系统会拒绝多余的连接请求。

3> accept

一旦服务器调用了listen,套接字就能接收连接请求。使用函数accept获得连接请求并建立连接。

include <sys/socket.h>

Int accept(int sockfd,  struct sockaddr *restrict  addr, socklen_t *restrict  len);
返回值:成功返回文件(套接字)描述符,出错返回-1

函数accept所返回的文件描述符是套接字描述符,该描述符连接到调用connect的客户端。这个新的套接字描述符和原始套接字(sockfd)具有相同的套接字类型和地址族。传给accept的原始套接字没有关联到这个连接,而是继续保持可用状态并接受其他连接请求。

如果不关心客户端标识,可以将addrlen设置为NULL,否则addr存放的是连接的客户端的地址。

如果没有连接请求等待处理,accept会阻塞直到有请求到来。另外server可以使用pollselect来等待一个请求的到来。

5. 数据传输

既然将套接字端点表示为文件描述符,那么只要建立连接,就可以使用readwrite来通过套接字通信。readwrite函数我几乎不用,了解一下即可。

1> send

include <sys/socket.h>

Int send(int sockfd,  const void *buf,  size_t  nbytes,  int  flags);
返回值:成功返回发送的字节数,出错返回-1

注意:如果send成功返回,并不一定并表示连接的另一端的进程接收数据。可以保证的是数据已经无误的发送到网络上。

标志我一直用的是0
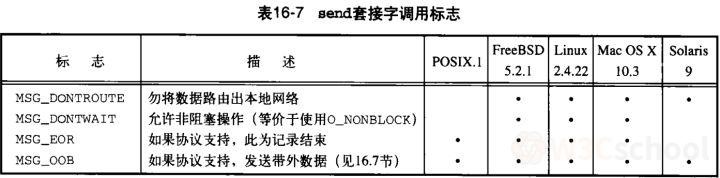
2> recv

include <sys/socket.h>

int recv(int sockfd,  const void *buf,  size_t  nbytes,  int  flags);
返回值:以字节计数的消息长度,若无可用消息或对方已经按序结束则返回0,         出错返回-1

仍然一直是0
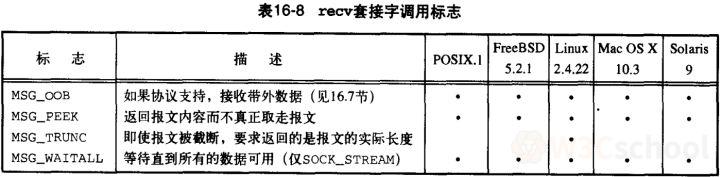
如果想定位发送者,可以使用recvfrom来得到数据发送者的源地址。

3> recvfrom

include <sys/socket.h>

int recv(int sockfd,  void *restrict buf, size_t len, int flag, 
struct sockaddr *restrict  addr, 
socklen_t *restrict  len);
返回值:以字节计数的消息长度,若无可用消息或对方已经按序结束则返回0,         出错返回-1

因为可以获得发送者的地址,recvfrom通常用于无连接套接字。否则,recvfrom等同于recv

以上就是关于 Linux C Socket Api的详解了,希望对大家有所帮助,对Linux感兴趣的同学可以看一下教程:

Linux教程:https://www.w3cschool.cn/linux/

Linux微课:https://www.w3cschool.cn/minicourse/play/linuxcourse

Linux就该这么学:https://www.w3cschool.cn/linuxprobe/

你知道C语言是如何处理fseek()和ftell()这两个I/O随机访问数吗?

thbcm阅读(321)

这篇文章中将会讨论到:fseek()ftell()函数的工作原理、如何使用二进制流、如何让程序可移植。

有了fseek()函数,便可把文件看作是数组,在fopen()打开的文件中直接移动到任意字节处。我们创建一个程序reverse.c演示fseek()ftell()的用法。注意,fseek()有3个参数,返回int类型的值;ftell()函数返回一个long类型的值,表示文件中的当前位置。

/* reverse.c -- displays a file in reverse order */
#include <stdio.h>
#include <stdlib.h>
#define CNTL_Z '032'   /* eof marker in DOS text files */
#define SLEN 81
int main(void)
{
    char file[SLEN];
    char ch;
    FILE *fp;
    long count, last;


    puts("Enter the name of the file to be processed:");
    scanf("%80s", file);
    if ((fp = fopen(file,"rb")) == NULL)
    {                               /* read-only mode   */
        printf("reverse can't open %sn", file);
        exit(EXIT_FAILURE);
    }


    fseek(fp, 0L, SEEK_END);        /* go to end of file */
    last = ftell(fp);
    for (count = 1L; count <= last; count++)
    {
        fseek(fp, -count, SEEK_END); /* go backward      */
        ch = getc(fp);
        if (ch != CNTL_Z && ch != 'r')  /* MS-DOS files */
            putchar(ch);
    }
    putchar('n');
    fclose(fp);


    return 0;
}

下面是对一个文件的输出:

Enter the name of the file to be processed: Cluv .C ni eno naht ylevol erom margorp a ees reven llahs I taht kniht I

该程序使用二进制模式,以便处理MS-DOS文本和UNIX文件。但是,在使用其他格式文本文件的环境中可能无法正常工作。

如果通过命令行环境运行该程序,待处理文件要和可执行文件在同一个目录(或文件夹)中。如果在IDE中运行该程序,具体查找方案序因实现而异。例如,默认情况下,Microsoft Visual Studio 2012在源代码所在的目录中查找,而Xcode 4.6则在可执行文件所在的目录中查找。

1 fseek()和ftell()的工作原理

fseek()的第1个参数是FILE指针,指向待查找的文件,fopen()应该已打开该文件。

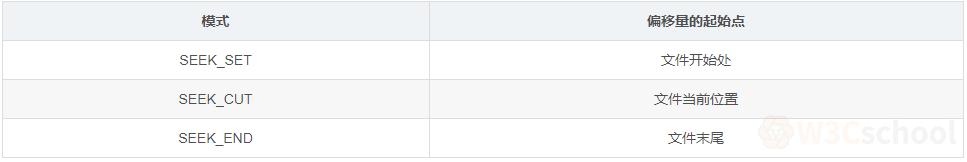
fseek()的第2个参数是偏移量(offset)。该参数表示从起始点开始要移动的距离(参见表13.3列出的起始点模式)。该参数必须是一个long类型的值,可以为正(前移)、负(后移)或0(保持不动)。

fseek()的第3个参数是模式,该参数确定起始点。根据ANSI标准,在stdio.h头文件中规定了几个表示模式的明示常量(manifest constant),如表13.3所示。

旧的实现可能缺少这些定义,可以使用数值0L、1L、2L分别表示这3种模式。L后缀表明其值是long类型。或者,实现可能把这些明示常量定义在别的头文件中。如果不确定,请查阅实现的使用手册或在线帮助。

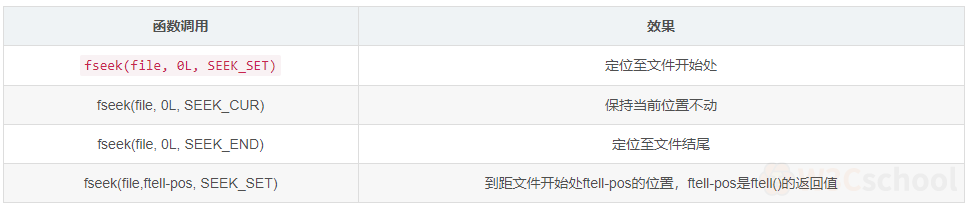
下面是调用fseek()函数的一些示例,fp是一个文件指针:

fseek(fp, 0L, SEEK_SET);   // go to the beginning of the file
fseek(fp, 10L, SEEK_SET);  // go 10 bytes into the file
fseek(fp, 2L, SEEK_CUR);   // advance 2 bytes from the current position
fseek(fp, 0L, SEEK_END);   // go to the end of the file
fseek(fp, -10L, SEEK_END); // back up 10 bytes from the end of the file

对于这些调用还有一些限制,我们稍后再讨论。

如果一切正常,fseek()的返回值为0;如果出现错误(如试图移动的距离超出文件的范围),其返回值为-1。

ftell()函数的返回类型是long,它返回的是参数指向文件的当前位置距文件开始处的字节数。ANSI-C把它定义在stdio.h中。在最初实现的UNIX中,ftell()通过返回距文件开始处的字节数来确定文件的位置。文件的第1个字节到文件开始处的距离是0,以此类推。ANSI C规定,该定义适用于以二进制模式打开的文件,以文本模式打开文件的情况不同。这也是程序reverse.c以二进制模式打开文件的原因。

下面,我们来分析程序reverse.c中的基本要素。首先,下面的语句:

 fseek(fp, 0L, SEEK_END);

把当前位置设置为距文件末尾0字节偏移量。也就是说,该语句把当前位置设置在文件结尾。下一条语句:

last = ftell(fp);

把从文件开始处到文件结尾的字节数赋给last。然后是一个for循环:

for (count = 1L; count <= last; count++)
{
  fseek(fp, -count, SEEK_END);    /* go backward */
     ch = getc(fp);
 }

第1轮迭代,把程序定位到文件结尾的第1个字符(即,文件的最后一个字符)。然后,程序打印该字符。下一轮迭代把程序定位到前一个字符,并打印该字符。重复这一过程直至到达文件的第1个字符,并打印。

2 二进制模式和文本模式

我们设计的程序reverse.cUNIXMS-DOS环境下都可以运行。UNIX只有一种文件格式,所以不需要进行特殊的转换。然而MS-DOS要格外注意。许多MS-DOS编辑器都用Ctrl+Z标记文本文件的结尾。以文本模式打开这样的文件时,C能识别这个作为文件结尾标记的字符。但是,以二进制模式打开相同的文件时,Ctrl+Z字符被看作是文件中的一个字符,而实际的文件结尾符在该字符的后面。文件结尾符可能紧跟在Ctrl+Z字符后面,或者文件中可能用空字符填充,使该文件的大小是256的倍数。在DOS环境下不会打印空字符,程序reverse.c中就包含了防止打印Ctrl+Z字符的代码。

二进制模式和文本模式的另一个不同之处是:MS-DOS\r\n组合表示文本文件换行。以文本模式打开相同的文件时,C程序把\r\n“看成”\n。但是,以二进制模式打开该文件时,程序能看见这两个字符。因此,程序reverse.c中还包含了不打印\r的代码。通常,UNIX文本文件既没有Ctrl+Z,也没有\r,所以这部分代码不会影响大部分UNIX文本文件。

ftell()函数在文本模式和二进制模式中的工作方式不同。许多系统的文本文件格式与UNIX的模型有很大不同,导致从文件开始处统计的字节数成为一个毫无意义的值。ANSI C规定,对于文本模式,ftell()返回的值可以作为fseek()的第2个参数。对于MS-DOSftell()返回的值把\r\n当作一个字节计数。

3 可移植性

理论上,fseek()ftell()应该符合UNIX模型。但是,不同系统存在着差异,有时确实无法做到与UNIX模型一致。因此,ANSI对这些函数降低了要求。下面是一些限制。

  • 在二进制模式中,实现不必支持SEEK_END模式。因此无法保证程序清单13.4的可移植性。移植性更高的方法是逐字节读取整个文件直到文件末尾。C预处理器的条件编译指令(第16章介绍)提供了一种系统方法来处理这种情况。
  • 在文本模式中,只有以下调用能保证其相应的行为。

不过,许多常见的环境都支持更多的行为。

4 getpos()和fsetpos()函数

fseek()ftell()潜在的问题是,它们都把文件大小限制在long类型能表示的范围内。也许20亿字节看起来相当大,但是随着存储设备的容量迅猛增长,文件也越来越大。鉴于此,ANSI C新增了两个处理较大文件的新定位函数:fgetpos()fsetpos()。这两个函数不使用long类型的值表示位置,它们使用一种新类型:fpos_t(代表file positiontype,文件定位类型)。fpos_t类型不是基本类型,它根据其他类型来定义。fpos_t类型的变量或数据对象可以在文件中指定一个位置,它不能是数组类型,除此之外,没有其他限制。实现可以提供一个满足特殊平台要求的类型,例如,fpos_t可以实现为结构。

ANSI-C定义了如何使用fpos_t类型。fgetpos()函数的原型如下:

nt fgetpos(FILE * restrict stream, fpos_t * restrict pos);

调用该函数时,它把fpos_t类型的值放在pos指向的位置上,该值描述了文件中的当前位置距文件开头的字节数。如果成功,fgetpos()函数返回0;如果失败,返回非0。

fsetpos()函数的原型如下:

: int fsetpos(FILE stream, const fpos_t pos);

调用该函数时,使用pos指向位置上的fpos_t类型值来设置文件指针指向偏移该值后指定的位置。如果成功,fsetpos()函数返回0;如果失败,则返回非0。fpos_t类型的值应通过之前调用fgetpos()获得。

以上就是关于C语言处理I/O的两个随机访问函数:fseek()ftell()的相关信息了,希望对大家有所帮助。想了解更多的知识,大家可以看一下教程

C教程:https://www.w3cschool.cn/c/

文章参考来源:www.toutiao.com/a6855410553498632708

联系我们