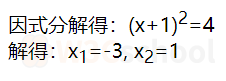放假期间发现一个好东西,突然感觉不喜欢再写for循环

thbcm阅读(767)

用过好多种遍历方法,发现其中还是for执行速度最快。因为它很简单,没有额外的函数调用栈和上下文。但是在实际开发中,我们也不能只考虑速度,而是要结合语义话,可读性和程序性能,去选择究竟使用哪种方案。下面来看for , foreach , map ,for...in , for...of五种方法现场battle。

自我介绍

for

我是最早出现的一方遍历语句,在座的各位需称我一声爷爷。我能满足开发人员的绝大多数的需求。

// 遍历数组
let arr = [1,2,3];
for(let i = 0;i < arr.length;i++){
    console.log(i) // 索引,数组下标
    console.log(arr[i]) // 数组下标所对应的元素
}


// 遍历对象
let profile = {name:"April",nickname:"二十七刻",country:"China"};
for(let i = 0, keys=Object.keys(profile); i < keys.length;i++){
    console.log(keys[i]) // 对象的键值
    console.log(profile[keys[i]]) // 对象的键对应的值
}


// 遍历字符串
let str = "abcdef";
for(let i = 0;i < str.length ;i++){
    console.log(i) // 索引 字符串的下标
    console.log(str[i]) // 字符串下标所对应的元素
}


// 遍历DOM 节点
let articleParagraphs = document.querySelectorAll('.article > p');
for(let i = 0;i<articleParagraphs.length;i++){
    articleParagraphs[i].classList.add("paragraph");
    // 给class名为“article”节点下的 p 标签添加一个名为“paragraph” class属性。
}

forEach

我是ES5版本发布的。按升序为数组中含有效值的每一项执行一次 callback 函数,那些已删除或者未初始化的项将被跳过(例如在稀疏数组上)。我是 for 循环的加强版。

// 遍历数组
let arr = [1,2,3];
arr.forEach(i => console.log(i))


// logs 1
// logs 2
// logs 3
// 直接输出了数组的元素


//遍历对象
let profile = {name:"April",nickname:"二十七刻",country:"China"};
let keys = Object.keys(profile);
keys.forEach(i => {
    console.log(i) // 对象的键值
    console.log(profile[i]) // 对象的键对应的值
})

map

我也是ES5版本发布的,我可以创建一个新数组,新数组的结果是原数组中的每个元素都调用一次提供的函数后的返回值。

let arr = [1,2,3,4,5];
let res = arr.map(i => i * i);


console.log(res) // logs [1, 4, 9, 16, 25]

for…in枚举

我是ES5版本发布的。以任意顺序遍历一个对象的除Symbol以外的可枚举属性。

// 遍历对象
let profile = {name:"April",nickname:"二十七刻",country:"China"};
for(let i in profile){
    let item = profile[i];
    console.log(item) // 对象的键值
    console.log(i) // 对象的键对应的值


// 遍历数组
let arr = ['a','b','c'];
for(let i in arr){
    let item = arr[i];
    console.log(item) // 数组下标所对应的元素
    console.log(i) // 索引,数组下标


// 遍历字符串
let str = "abcd"
for(let i in str){
    let item = str[i];
    console.log(item) // 字符串下标所对应的元素
    console.log(i) // 索引 字符串的下标
}

for…of迭代

我是ES6版本发布的。在可迭代对象(包括 ArrayMapSetStringTypedArrayarguments 对象等等)上创建一个迭代循环,调用自定义迭代钩子,并为每个不同属性的值执行语句。

// 迭代数组数组
let arr = ['a','b','c'];
for(let item of arr){
    console.log(item)
}
// logs 'a'
// logs 'b'
// logs 'c'


// 迭代字符串
let str = "abc";
for (let value of str) {
    console.log(value);
}
// logs 'a'
// logs 'b'
// logs 'c'


// 迭代map
let iterable = new Map([["a", 1], ["b", 2], ["c", 3]]
for (let entry of iterable) {
    console.log(entry);
}
// logs ["a", 1]
// logs ["b", 2]
// logs ["c", 3]


// 迭代map获取键值
for (let [key, value] of iterable) {
    console.log(key)
    console.log(value);
}


// 迭代set
let iterable = new Set([1, 1, 2, 2, 3, 3,4]);
for (let value of iterable) {
    console.log(value);
}
// logs 1
// logs 2
// logs 3
// logs 4


// 迭代 DOM 节点
let articleParagraphs = document.querySelectorAll('.article > p');
for (let paragraph of articleParagraphs) {
    paragraph.classList.add("paragraph");
    // 给class名为“article”节点下的 p 标签添加一个名为“paragraph” class属性。
}


// 迭代arguments类数组对象
(function() {
  for (let argument of arguments) {
    console.log(argument);
  }
})(1, 2, 3);
// logs:
// 1
// 2
// 3


// 迭代类型数组
let typeArr = new Uint8Array([0x00, 0xff]);
for (let value of typeArr) {
  console.log(value);
}
// logs:
// 0
// 255

经过第一轮的自我介绍和技能展示后,我们了解到:

  • for语句是最原始的循环语句。定义一个变量i(数字类型,表示数组的下标),按照一定的条件,对i进行循环累加。条件通常为循环对象的长度,当超过长度就停止循环。因为对象无法判断长度,所以搭配Object.keys()使用。
  • forEach ES5 提出。自称是for语句的加强版,可以发现它比for语句在写法上简单了很多。但是本质上也是数组的循环。forEach每个数组元素执行一次 callback 函数。也就是调用它的数组,因此,不会改变原数组。返回值是undefine
  • map ES5 提出。给原数组中的每个元素都按顺序调用一次 callback 函数。生成一个新数组,不修改调用它的原数组本身。返回值是新的数组。
  • for...in ES5 提出。遍历对象上的可枚举属性,包括原型对象上的属性,且按任意顺序进行遍历,也就是顺序不固定。遍历数组时把数组的下标当作键值,此时的i是个字符串型的。它是为遍历对象属性而构建的,不建议与数组一起使用。
  • for...of ES6 提出。只遍历可迭代对象的数据。

能力甄别

作为一个程序员,仅仅认识他们是远远不够的,在实际开发中鉴别他们各自的优缺点。因地制宜的使用他们,扬长避短。从而提高程序的整体性能才是能力之所在。

关于跳出循环体

在循环中满足一定条件就跳出循环体,或者跳过不符合条件的数据继续循环其它数据。是经常会遇到的需求。常用的语句是breakcontinue

简单的说一下二者的区别,就当复习好了。

  • break语句是跳出当前循环,并执行当前循环之后的语句;
  • continue语句是终止当前循环,并继续执行下一次循环;

注意forEachmap 是不支持跳出循环体的,其它三种方法均支持。

原理 :查看forEach实现原理,就会理解这个问题。

Array.prototype.forEach(callbackfn [,thisArg]{

    
}

传入的function是这里的回调函数。在回调函数里面使用break肯定是非法的,因为break只能用于跳出循环,回调函数不是循环体。

在回调函数中使用return,只是将结果返回到上级函数,也就是这个for循环中,并没有结束for循环,所以return也是无效的。

map() 同理。

map()链式调用

map()方法是可以链式调用的,这意味着它可以方便的结合其它方法一起使用。例如:reduce(),sort(), filter() 等。但是其它方法并不能做到这一点。forEach()的返回值是undefined,所以无法链式调用。

// 将元素乘以本身,再进行求和。
let arr = [1, 2, 3, 4, 5];
let res1 = arr.map(item => item * item).reduce((total, value) => total + value);


console.log(res1) // logs 55 undefined"

for…in会遍历出原型对象上的属性

Object.prototype.objCustom = function() {};
Array.prototype.arrCustom = function() {};
var arr = ['a', 'b', 'c'];
arr.foo = 'hello
for (var i in arr) {
    console.log(i);
}
// logs
// 0
// 1
// 2
// foo
// arrCustom
// objCustom

然而在实际的开发中,我们并不需要原型对象上的属性。这种情况下我们可以使用hasOwnProperty() 方法,它会返回一个布尔值,指示对象自身属性中是否具有指定的属性(也就是,是否有指定的键)。如下:

Object.prototype.objCustom = function() {};
Array.prototype.arrCustom = function() {};
var arr = ['a', 'b', 'c'];
arr.foo = 'hello
for (var i in arr) {
    if (arr.hasOwnProperty(i)) {
        console.log(i);
    }
}
// logs
// 0
// 1
// 2
// foo


// 可见数组本身的属性还是无法摆脱。此时建议使用 forEach

对于纯对象的遍历,选择for..in枚举更方便;对于数组遍历,如果不需要知道索引for..of迭代更合适,因为还可以中断;如果需要知道索引,则forEach()更合适;对于其他字符串,类数组,类型数组的迭代,for..of更占上风更胜一筹。但是注意低版本浏览器的是配性。

性能

有兴趣的读者可以找一组数据自行测试,文章就直接给出结果了,并做相应的解释。

for > for-of > forEach > map > for-in

for 循环当然是最简单的,因为它没有任何额外的函数调用栈和上下文;

  • for...of只要具有Iterator接口的数据结构,都可以使用它迭代成员。它直接读取的是键值。
  • forEach,因为它其实比我们想象得要复杂一些,它实际上是array.forEach(function(currentValue, index, arr), thisValue)它不是普通的 for 循环的语法糖,还有诸多参数和上下文需要在执行的时候考虑进来,这里可能拖慢性能;
  • map() 最慢,因为它的返回值是一个等长的全新的数组,数组创建和赋值产生的性能开销很大。
  • for...in需要穷举对象的所有属性,包括自定义的添加的属性也能遍历到。且for...inkeyString类型,有转换过程,开销比较大。

总结

在实际开发中我们要结合语义话、可读性和程序性能,去选择究竟使用哪种方案?

  • 如果你需要将数组按照某种规则映射为另一个数组,就应该用 map
  • 如果你需要进行简单的遍历,用 forEach 或者 for of
  • 如果你需要对迭代器进行遍历,用 for of
  • 如果你需要过滤出符合条件的项,用 filterr
  • 如果你需要先按照规则映射为新数组,再根据条件过滤,那就用一个 map加一个 filter

总而言之,要灵活应用,因地制宜,不同的环境下选择合适的语法。千万不要因为过分追求性能,而忽略了语义和可读性。在您的统治之下,他们5个只能是各自发挥长处,谁都别想称霸。

到最后给大家推荐一下Java的学习课程吧

Java教程:https://www.w3cschool.cn/java/

Java微课:https://www.w3cschool.cn/minicourse/play/javaminicourse

文章参考来源:www.toutiao.com/a6842942752037011976/
解析:JavaScript中的函数式编程

thbcm阅读(324)

JavaScript是一种很受欢迎的编程语言,今天整理这篇文章是为了让大家更深入了解一下JavaScript。下面我将展示一些有关如何在JavaScript中应用函数式编程的例子。

JavaScript中的函数式编程

即使函数式编程可以极大地改善应用程序的代码,但其原理在开始时可能会有些挑战。由于详细解释所有这些都将花费大量时间,因此我们决定使用两个实际的代码示例来介绍这些概念。

1.Maybe Monad

在第一个示例中,我们找到一种避免验证变量是否为Null的方法。假设在我们的应用程序中,我们可以找到具有以下格式的用户:

const someUser = {
 name: 'some_name',
 email: 'some@email.com',
 settings: {
  language: 'sp'
 }
};

有一个功能,可以以用户设置的语言返回欢迎消息。

const allGreetings = {
 'en': '嗨',
 'sp': '你好',
 'fr': '欢迎你'
};
const getGreetingForUser = (user) => {
 //将要执行
}

来看一个遵循命令式模型的“getGreetingForUser”函数的实现:

const getGreetingForUser = (user) => {
 if (!user) {
   return allGreetings.en;
 }
 if (user.settings && user.settings.language) {
   if (allGreetings[user.settings.language]) {
     return allGreetings[user.settings.language]
   } else {
     return allGreetings.en;
   }
 } else {
   return allGreetings.en;
 }
};
console.log(getGreetingForUser(someUser));

如上面所看到的,必须检查用户是否已经存在,是否已设置语言,以及是否已准备好欢迎消息。如果出现问题,我们将以默认语言返回一条消息。

现在,让我们看一下相同的函数,但是这次我们将在其实现中使用函数式编程:

const getGreetingForUser = (user) => {
  return RamdaFantasy.Maybe(user)
    .map(Ramda.path(['settings', 'language']))
    .chain(maybeGreeting);
};
const maybeGreeting = Ramda.curry((greetingsList, userLanguage) => {
  return RamdaFantasy.Maybe(greetingsList[userLanguage]);
})(allGreetings);
console.log(getGreetingForUser(someUser).getOrElse(allGreetings.en));

为了处理可能为null或未定义的情况,我们将使用Maybe Monad。这使我们可以在对象周围创建包装器,并为空对象分配默认行为。

让我们比较两种解决方案:

//代替验证用户是否为空
if (!user) {
  return allGreetings.en;
}
//我们将用:
RamdaFantasy.Maybe(user) //我们将用户添加到包装器中

//代替:
 if (user.settings && user.settings.language) {
   if (allGreetings[user.settings.language]) {
//我们将用:
 <userMaybe>.map(Ramda.path(['settings', 'language'])) //如果存在数据,映射将会用它

//不是在else中返回默认值:
 return indexURLs['en'];
.getOrElse(allGreetings。EN)
// 指定的默认值。

2 Either Monad

当我们知道存在空错误时的默认行为时,Maybe Monad非常有用。

但是,如果我们有一个引发错误的函数,或者我们将各种引发错误的函数链接在一起,并且我们想知道哪个发生了故障,则可以改用Either Monad

现在,让我们假设我们要计算产品的价格,同时考虑增值税和可能的折扣。我们已经有了以下代码:

const withTaxes = (tax, price) => {
 if (!_.isNumber(price)) {
 return new Error("Price is not numeric");
 }
 return price + (tax * price);
};
const withDiscount = (dis, price) => { 
  if (!_.isNumber(price)) { 
    return new Error("Price is not numeric"); 
  } 
  if (price < 5) 
    return new Error("Discounts not available for low-priced items"); 
  } 
  return price - (price * dis);5
}; 
const isError = (e) => e && e.name === 'Error';
const calculatePrice(price, tax, discount) => { 
//将要执行
}

让我们来看一个遵循命令式模型的“calculatePrice”函数的实现:

const calculatePrice = (price, tax, discount) => {
  const priceWithTaxes = withTaxes(tax, price);
  if (isError(priceWithTaxes)) {
    return console.log('Error: ' + priceWithTaxes.message);
  }
  const priceWithTaxesAndDiscount = withDiscount(discount, priceWithTaxes);
  if (isError(priceWithTaxesAndDiscount)) {
    return console.log('Error: ' + priceWithTaxesAndDiscount.message);
  }
  console.log('Total Price: ' + priceWithTaxesAndDiscount);
}
//我们计算出价值25的产品(含21%的增值税和10%的折扣)的最终价格。
 calculatePrice(25, 0.21, 0.10)

现在,让我们了解如何使用Either Monad重写此函数。

都有两个构造函数,LeftRight。我们要实现的是将异常存储到Left构造函数,并将正常结果(快乐路径)存储到Right构造函数。

首先,将更改已经存在的withTaxeswithDiscount函数,以便在出现错误时它们返回Left,在一切正常的情况下返回Right

const withTaxes = Ramda.curry((tax, price) => {
  if (!_.isNumber(price)) {
    return RamdaFantasy.Either.Left(new Error("Price is not numeric"));
  }
  return RamdaFantasy.Either.Right(price + (tax * price)); 
});
const withDiscount = Ramda.curry((dis, price) => {
  if (!_.isNumber(price)) {
    return RamdaFantasy.Either.Left(new Error("Price is not numeric")); 
  }
  if (price < 5) { 
    return RamdaFantasy.Either.Left(new Error("Discounts not available for low-priced items")); 
  } 
  return RamdaFantasy.Either.Right(price - (price * dis)); 
});

然后,我们为Right案例创建一个函数(显示价格),为Left案例创建另一个函数(显示错误),然后使用它们创建Either Monad

const showPrice = (total) => { console.log('Price: ' + total) }; 
const showError = (error) => { console.log('Error: ' + error.message); }; 
const eitherErrorOrPrice = RamdaFantasy.Either.either(showError, showPrice);

最后,只需要执行Monad来计算最终价格:

//计算出价值25的产品(含21%的增值税和10%的折扣)的最终价格。
 eitherErrorOrPrice(
   RamdaFantasy.Either.Right(25)
     .chain(withTaxes(0.21))
     .chain(withDiscount(0.1))
)

结论:JavaScript中的函数式编程

正如我们所看到的,一旦用MaybeEither单子分解了代码,就没有那么复杂了。如果使用得当,它们可以使我们的代码更易于阅读和维护。

唯一的不便是我们需要克服的初始障碍,但这可以通过在网上一些示例并进行一些测试来完成。

以上就是JavaScript中应用函数式编程的示例,希望能对大家有所帮助。然后想学习JavaScript的同学可以点以下链接

JavaScript教程:https://www.w3cschool.cn/javascript/

JavaScript微课:https://www.w3cschool.cn/minicourse/play/jscourse

文章参考来源:www.toutiao.com/a6836176173207126541/

Java练习题,包含类,方法,对象,属性调用,this使用和构造方法

thbcm阅读(370)

这是一篇Java练习贴,文章中布置了习题,讲解了需求,跟考点。后面也跟着习题的代码。有兴趣的同学可以自己写一下代码,然后再来跟文中的代码对比,看看有什么值得学习的地方。

Java习题第一题

题目:创建一个LOL中的英雄类和怪物类,要求:

怪物类中加入生命值属、等级属性,生命值=等级*1000

英雄类中加入“经验值”,“等级”,“攻击力”等属性变量,加入“击打”方法,击打的目标是怪物,击打的结果是怪物的生命值-英雄攻击力

考点:类的声明、方法的声明、对象的声明与属性调用

Hero类

public class Hero {


        int EXP;//经验值
        int grade;//等级
        int aggressivity;//攻击

        
        //击打的方法
        int strike(int x){
            return x - aggressivity;
        }

        
        public int getEXP() {
            return EXP;
        }


        public void setEXP(int EXP) {
            this.EXP = EXP;
        }


        public int getGrade() {
            return grade;
        }


        public void setGrade(int grade) {
            this.grade = grade;
        }


        public int getAggressivity() {
            return aggressivity;
        }


        public void setAggressivity(int aggressivity) {
            this.aggressivity = aggressivity;
        }


}

Monster 类

public class Monster {


        int grade;//等级
        int healthValue ;//生命值

        
        public int getGrade() {
            return grade;
        }
        public void setGrade(int grade) {
            this.grade = grade;
        }
        public int getHealthValue() {
            healthValue = grade*1000;
            return healthValue;
        }
        public void setHealthValue(int healthValue) {
            this.healthValue = healthValue;
        }


}

main

public class Work1 {


    public static void main(String[] args) {
        //怪物属性
        Monster m = new Monster();
        m.setGrade(5);
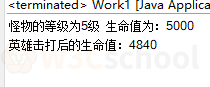
        System.out.println("怪物的等级为"+m.grade+"级  生命值为:"+m.getHealthValue());

        
        //英雄 
        Hero h = new Hero();
        h.setAggressivity(160);
        int a;
        a = h.strike(m.healthValue);
        m.setHealthValue(a);
        System.out.println("英雄击打后的生命值:"+m.healthValue);
    }
}

Java习题第二题

题目:自定义一个英雄类,要求:

英雄的级别最低为0,最高为30级,经验值最低为0,最高为30级时的经验值

该类中要求有一个含有参数的构造函数,参数为英雄的经验值,初始化时要保证经验值在要求范围之内,通过经验值计算英雄的级别,英雄的级别计算公式如下: N=当前级别,EXP(经验值)=30(N^3+5N)-80

构建一个无参的构造方法,将经验值设置为0

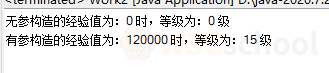
利用英雄类无参和带有参数的构造函数分别构建英雄对象,并输出英雄的等级和经验值。

考点:类的声明、构造方法、this的使用,方法的调用

Hero类

public class Hero2 {


    int EXP;//经验值
    int grade;//等级

    
    //有参的构造函数
    public Hero2(int EXP){
        this.EXP = EXP;//经验值
        }

    
    //无参的构造函数
    public Hero2(){
        EXP=0;//经验值
    }

    
}

main

public class Work2 {


    public static void main(String[] args) {
        //无参构造结果
        Hero2 e= new Hero2();
        System.out.print("无参构造的");
        System.out.println("经验值为:"+e.EXP+" 时,等级为:"+e.grade+" 级");

        
        //有参构造结果
        int a=120000;
        Hero2 h = new Hero2(a);
        System.out.print("有参构造的");
        for(int i = 1 ; i <=30 ; i++ ) {

            
            //System.out.println(i+"级经验值:"+(30*(i*i*i+5*i)-80));//输出1-30级每级的经验值所需经验
            if((30*(i*i*i+5*i)-80) <= h.EXP && (30*((i+1)*(i+1)*(i+1)+5*(i+1))-80)>h.EXP ) {
                h.grade=i;
                break;
            }
        }
        System.out.println("经验值为:"+h.EXP+" 时,等级为:"+h.grade+" 级");
    }


}

以上是两道Java的习题及代码,希望对同学们有所帮助。对Java感兴趣的同学可以看一下教程

文章参考来源:blog.csdn.net/d694046387/java/article/details/107620181

一篇文章带你了解什么是 Spring JPA

thbcm阅读(359)

同学们好,今天我跟大家伙们聊一下关于 Spring JPA 的相关知识,首先我们来了解一下什么 JPA

1.什么是JPA

JPA (Java Persistence API) 是 Sun 官方提出的 Java 持久化规范。它为 Java 开发人员提供了一种对象/关联映射工具来管理 Java 应用中的关系数据。他的出现主要是为了简化现有的持久化开发工作和整合 ORM 技术,结束现在 HibernateTopLinkJDO 等 ORM 框架各自为营的凌乱局面。JPA 在充分吸收了现有HibernateTopLinkJDOORM框架的基础上发展而来的,具有易于使用,伸缩性强等优点。从上面的解释中我们可以了解到JPA 是一套规范,而类似 HibernateTopLinkJDO这些产品是实现了 JPA 规范。

了解了什么是 JPA,我们来看看本文的主角——spring data jpa

2.spring data jpa

pring Data JPASpring 基于 ORM 框架、JPA规范的基础上封装的一套 JPA 应用框架,底层使用了 HibernateJPA 技术实现,可使开发者用极简的代码即可实现对数据的访问和操作。它提供了包括增删改查等在内的常用功能,且易于扩展!学习并使用 Spring Data JPA 可以极大提高开发效率。

什么意思呢?如果用过Hibernate 或者MyBatis 的话,就会知道对象关系映射(ORM)框架有多么方便。但是Spring Data JPA框架功能更进一步,为我们做了 一个数据持久层框架几乎能做的任何事情。以Springboot整合MyBatis为例,比如我们要向数据库中插入一些用户的数据,那么我们需要先定义用户的实体类,然后我们要定义一个UserDao

@Repository
public class UserDao {
    @Autowired
    JdbcTemplate jdbcTemplate;


    public int addUser(User user){
    return jdbcTemplate.update("INSERT INTO t_user(username,jobs,phone) VALUE (?,?,?)",
    user.getName,user.getJobs,user.getPhone);
    }
    public int updateUser(User user){
    return jdbcTemplate.update("UPDATE t_user SET username=?,jobs=?,phone=? WHERE id=?",
    user.getName,user.getJobs,user.getPhone,user.getId);
    }
    public int deleteUser(Integer id){
    return jdbcTemplate.update("DELETE FROM t_user WHERE id=?",id);
    }
    public User getUserById(Integer id){
    return jdbcTemplate.queryForObject("SELECT * FROM t_user WHERE id =?",new BeanPropertyRowMapper<>(User.class),id);
    }
    public List<User> getAllUser{
    return jdbcTemplate.query("SELECT * FROM t_user",new BeanPropertyRowMapper<>(User.class));
    }
}

以及UserService

@Service
public class UserService {


    @Autowired
    UserDao userDao;
    public int addUser(User user){
    return userDao.addUser(user);
    }
    public int updateUser(User user){
    return userDao.updateUser(user);
    }
    public int deleteUser(Integer id){
    return userDao.deleteUser(id);
    }
    public User getUserById(Integer id){
    return userDao.getUserById(id);
    }
    public List<User> getAllUser{
    return userDao.getAllUser;
    }
}

最后,我们在去调用对应的service 中的方法。这是传统的方式,如果使用mapper,会稍微简单一些,比如我们要添加mapper

@Mapper
public interface UserMapper {
    int addUser(User user);
    int deleteUser(int id);
    int updateUser(User user);
    User getUserById(Integer id);
    List<User> getAllUsers;


}

然后定义一个UserMapper.xml ,添加对应的CURD SQL语句,做好映射,然后改造service,例如

@Service
public class UserService {


    @Autowired
    UserMapper userMapper;
    public int addUser(User user){
    return userMapper.addUser(user);
    }
    public int updateUser(User user){
    return userMapper.updateUser(user);
    }
    public int deleteUser(Integer id){
    return userMapper.deleteUser(id);
    }
    public User getUserById(Integer id){
    return userMapper.getUserById(id);
    }
    public List<User> getAllUser{
    return userMapper.getAllUsers;
    }
}

发现什么问题了吗?如果我们要去实现多个表的操作,我们需要定义不同的实体类,然后实现对应的mapper,然后写同样的增删改查方法,最后调用。这也太麻烦了些,而Spring data jpa 则可以轻松的帮我们实现这些繁琐重复且没有技术含量的操作。我们一起看下吧!

3.案例演示

1.首先,我们需要配置pom.xml

<dependency>
        <groupId>mysql</groupId>
        <artifactId>mysql-connector-java</artifactId>
    </dependency>

 
    <dependency>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-data-jpa</artifactId>
    </dependency>

2.然后是application.properties 的配置

spring.datasource.url=jdbc:mysql://127.0.0.1:3306/test?useUnicode=true&characterEncoding=utf-8&serverTimezone=UTC&useSSL=true
spring.datasource.username=root
spring.datasource.password=123456
spring.datasource.driver-class-name=com.mysql.jdbc.Driver
spring.jpa.properties.hibernate.hbm2ddl.auto=create
spring.jpa.properties.hibernate.dialect=org.hibernate.dialect.MySQL5InnoDBDialect
spring.jpa.show-sql=true

这里重点简单介绍下spring.jpa.properties.hibernate.hbm2ddl.auto有几种配置:

  • create:表示每次加载Hibernate时都会删除上一次生成的表(包括数据),然后重新生成新表,即使两次没有任何修改也会这样执行。适用于每次执行单测前清空数据库的场景。
  • create-drop:表示每次加载Hibernate时都会生成表,但当SessionFactory关闭时,所生成的表将自动删除。
  • update:最常用的属性值,第一次加载Hibernate时创建数据表(前提是需要先有数据库),以后加载Hibernate时不会删除上一次生成的表,会根据实体更新,只新增字段,不会删除字段(即使实体中已经删除)。
  • validate:每次加载Hibernate时都会验证数据表结构,只会和已经存在的数据表进行比较,根据model修改表结构,但不会创建新表。
  • 不配置此项,表示禁用自动建表功能

spring.jpa.show-sql=true 该配置当在执行数据库操作的时候会在控制台打印 sql 语句,方便我们检查排错等。

spring.jpa.properties.hibernate.dialect=org.hibernate.dialect.MySQL5InnoDBDialect 这是数据库的方言配置。

3.接下来我们建立用户实体类

@Entity
public class User {

 
    @Id
    @GeneratedValue
    private long id;
    @Column(nullable = false, unique = true)
    private String userName;
    @Column(nullable = false)
    private String password;
    @Column(nullable = false)
    private int age;
}

这里的一些注解解释如下:

  • @Entity 是一个类注解,用来注解该类是一个实体类用来进行和数据库中的表建立关联关系,首次启动项目的时候,默认会在数据中生成一个同实体类相同名字的表(table),也可以通过注解中的 name 属性来修改表(table)名称, 如@Entity(name=“user”) , 这样数据库中表的名称则是 user。该注解十分重要,如果没有该注解首次启动项目的时候你会发现数据库没有生成对应的表。
  • @Table 注解也是一个类注解,该注解可以用来修改表的名字,该注解完全可以忽略掉不用,@Entity 注解已具备该注解的功能。
  • @Id 类的属性注解,该注解表明该属性字段是一个主键,该属性必须具备,不可缺少。
  • @GeneratedValue 该注解通常和 @Id 主键注解一起使用,用来定义主键的呈现形式,该注解通常有多种使用策略,先总结如下:
  • @GeneratedValue(strategy= GenerationType.IDENTITY) 该注解由数据库自动生成,主键自增型,在 mysql 数据库中使用最频繁,oracle 不支持。
  • @GeneratedValue(strategy= GenerationType.AUTO)  主键由程序控制,默认的主键生成策略,oracle 默认是序列化的方式,mysql 默认是主键自增的方式。
  • @GeneratedValue(strategy= GenerationType.SEQUENCE) 根据底层数据库的序列来生成主键,条件是数据库支持序列,Oracle支持,Mysql不支持。
  • @GeneratedValue(strategy= GenerationType.TABLE) 使用一个特定的数据库表格来保存主键,较少使用。

上面这些主键生成策略中,以 mysql 为例,  IDENTITY  AUTO 用的较多,二者当中IDENTIT 用的多些,以下文章当中演示的 demo 主键均使用 @GeneratedValue(strategy= GenerationType.IDENTITY) 的生成策略。

@Column 是一个类的属性注解,该注解可以定义一个字段映射到数据库属性的具体特征,比如字段长度,映射到数据库时属性的具体名字等。

@Transient  是一个属性注解,该注解标注的字段不会被映射到数据库当中。

4. 声明 UserRepository接口,继承JpaRepository,如下所示

public interface UserRepository extends JpaRepository<User, Long> {

 
}

这里的 JpaRepository继承了接口PagingAndSortingRepositoryQueryByExampleExecutor。而,PagingAndSortingRepository又继承CrudRepository

因此,JpaRepository接口同时拥有了基本CRUD功能以及分页功能。因此,这里我们可以继承JpaRepository,从而获得Spring为我们预先定义的多种基本数据操作方法。

5.然后我们定义一个测试类,  这里我们演示下添加操作, @Transactional 表示开启事务防止出现脏数据。


        ……
        @Autowired
    private UserRepository userRepository;

 
    @Test
    @Transactional
    public void userAddTest() {
        User user = new User();
        user.setUserName("吴彦祖");
        user.setAge(30);
        user.setPassword("123456");
        userRepository.save(user);
        User item = userRepository.findByUserName("wyk");
        log.info(JsonUtils.toJson(item));
    }

6.接下来我们说下查询,查询可以分为基本查询和自定义查询,一种是 spring data 默认已经实现,只需要要继承JpaRepository,一种是根据查询的方法来自动解析成 SQL

@Test
public void testQuery() throws Exception {
    User user=new User();
    userRepository.findAll();
    userRepository.findOne(1l);
    userRepository.save(user);
    userRepository.delete(user);
    userRepository.count();
    userRepository.exists(1l);
    ……
}

7.自定义的简单查询就是根据方法名来自动生成SQL,主要的语法是findXXBy,readAXXBy,queryXXBy,countXXBy, getXXBy后面跟属性名称,举几个例子:

User findByUserName(String userName);

 
User findByUserNameOrEmail(String username, String email);

 
Long deleteById(Long id);

 
Long countByUserName(String userName);

 
List<User> findByEmailLike(String email);

 
User findByUserNameIgnoreCase(String userName);

 
List<User> findByUserNameOrderByEmailDesc(String email);

8.接下来,我们说下复杂的查询,在实际的开发中我们需要用到分页、删选、连表等查询的时候就需要特殊的方法或者自定义 SQL,以分页查询为例,分页查询在实际使用中非常普遍了,spring data jpa已经帮我们实现了分页的功能,在查询的方法中,需要传入参数Pageable,当查询中有多个参数的时候Pageable建议做为最后一个参数传入。Pageablespring 封装的分页实现类,使用的时候需要传入页数、每页条数和排序规则

Page<User> findALL(Pageable pageable);

 
Page<User> findByUserName(String userName,Pageable pageable);

9.我们看下下面的测试用例

@Test
public void testPageQuery() throws Exception {
    int page=1,size=5;
    Sort sort = new Sort(Direction.DESC, "id");
    Pageable pageable = new PageRequest(page, size, sort);
    userRepository.findALL(pageable);
    userRepository.findByUserName("testName", pageable);
}

  1. Spring data 大部分的SQL都可以根据方法名定义的方式来实现,但是由于某些原因我们想使用自定义的 SQL 来查询,spring data 也是完美支持的,如下所示:
@Modifying
@Query("update User u set u.userName = ?1 where c.id = ?2")
int modifyByIdAndUserId(String  userName, Long id);

 
@Transactional
@Modifying
@Query("delete from User where id = ?1")
void deleteByUserId(Long id);

 
@Transactional(timeout = 10)
@Query("select u from User u where u.emailAddress = ?1")
User findByEmailAddress(String emailAddress);

以上就是关于spring data jpa 的介绍。对spring 或者 Java感兴趣的同学可以看一下教程

Spring教程:https://www.w3cschool.cn/wkspring/

Spring微课:https://www.w3cschool.cn/minicourse/play/springcourse

Java教程:https://www.w3cschool.cn/java/

Java微课:https://www.w3cschool.cn/minicourse/play/javaminicourse

文章参考来源:www.toutiao.com/a6843247617955070471/

springboot 定时任务,异步任务的案例分享

thbcm阅读(311)

整理这篇文章是为了给大家分享两个springboot的异步任务、定时任务的简单案例,让大家有个参考对象。

异步任务简单案例

在我们开发项目时,常常会用到异步处理任务,比如我们在网站上发送邮件,后台会去发送邮件,此时会造成前台响应不动,直到邮件发送完毕,响应才会成功,所以我们一般会采用多线程的方式去处理这些任务。

  1. 新建一个service
  1. 创建AsyncService
@Service
    public class AsyncService {

    
       public void hello(){
           try {
               Thread.sleep(3000);
          } catch (InterruptedException e) {
               e.printStackTrace();
          }
           System.out.println("业务进行中~~");
      }
    }

  1. 创建controller
  1. controller包下创建一个AsyncController
@RestController
    public class AsyncController {

    
       @Autowired
       AsyncService asyncService;

    
       @GetMapping("/hello")
       public String hello(){//调用方法后会延迟3秒在页面显示Success
           asyncService.hello();
           return "success";
      }

    
    }

此时访问Localhost:8080/hello的情况是:延迟3秒后,在页面输出Success,在后台会输出业务进行中~~

新问题:如果想页面直接输出信息“Success”,而让这个hello方法直接在后台用多线程操作,就需要加上@Async注解,这样spring boot就会自己开一个线程池进行调用

改进:给AsyncService加上注解

@Async//告诉Spring这是一个异步方法
    public void hello(){
       try {
           Thread.sleep(3000);
      } catch (InterruptedException e) {
           e.printStackTrace();
      }
       System.out.println("业务进行中~~");
    }

但是要让这个注解起作用,还需要在入口文件中开启异步注解功能

@EnableAsync //开启异步注解功能
@SpringBootApplication
    public class SpringbootTaskApplication {
           public static void main(String[] args) {
               SpringApplication.run(SpringbootTaskApplication.class, args);
          }
    }

此时再次测试,发现页面直接输出了Success,但是后台仍然是3秒后输出业务进行中

定时任务简单案例

工作中常常要设置一些定时任务,比如每天在某个时间分析一遍日志

所以Spring提供了异步执行任务调度的方式,提供了两个接口。

TaskExecutor接口

TaskScheduler接口

两个注解:

• @EnableScheduling

• @Scheduled

创建一个ScheduleService,里面编写一个hello方法,让它定时执行

@Service
publicclassScheduledService{


    //秒分时日月周几
    @Scheduled(cron="0 * * * * ?")
    //这里需要学习一些cron表达式的语法,明白时间如何设置,这里的意思是每当时间到0秒时就执行一次
    publicvoidhello(){
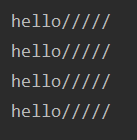
        System.out.println("hello/////");
    }
}

要使用定时功能,还需要在入口文件中加上@EnableScheduling,表明开启定时任务功能

@SpringBootApplication
    @EnableScheduling//开启定时任务注解功能
    @EnableAsync//开启异步注解功能
    publicclassSpringbootTaskApplication{

    
    publicstaticvoidmain(String[]args){
    SpringApplication.run(SpringbootTaskApplication.class,args);
    }

    
    }

此时测试运行,发现每当时间为0秒时就会在后台打印出 hello////

以上就是分享的两个简单案例,对SpringBootjava有学习兴趣的同学,可以看一下教程

Java教程:https://www.w3cschool.cn/java/

Java微课:https://www.w3cschool.cn/minicourse/play/javaminicourse

SpringBoot教程:https://www.w3cschool.cn/seansblog/

SpringBoot从入门到精通微课:https://www.w3cschool.cn/minicourse/play/springboot_my

HTML学习笔记之文本标签

thbcm阅读(347)

作为一名热爱学习的同学,每当学习一点新知识,咱就做一点笔记,以免学会的知识偷偷跑掉。毕竟“好记性不如烂笔头”。

p 段落标签

顾名思义,就是写一段话需要用到的标签,用法如下:

        <p>这是一段话(此处省略1500字)</p>

br 换行标签

有时候,写两句就需要换一下行,就可以用到b标签,与普通文档中的回车符意义相同,用法如下:

        <p>这是一段话(此处省略1500字)<br />这句我就换了行</p>

a 超链接标签

页面之间跳转就需要用到超链接,其中的href属性用于定义超链接的URL,用法如下:

        <a href="https://www.csdn.net/">这是一个超链接</a>

hr 水平线标签

当你需要一条长长的分割线时,或许可以考虑一下hr标签,用法如下:

        <p>
            我说完了,需要一条分割线结束
            <hr />
            第二部分
        </p>

h1-h6 标题标签

当需要字体大小不同的标题时,可以用标题标签,字体的大小从h1开始到h6越来越小,h1最大,h6最小,用法如下:

        <h1>这是h1标签,字体很大</h1>
        <h6>这是h6标签,字体很小</h6>

pre 预先格式化标签

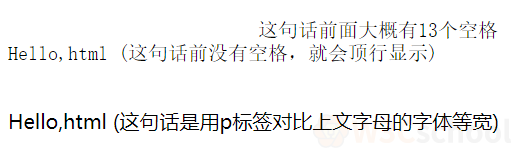
因为HTML很多标签会合并空格,所以当你想要展示很多个空格的时候,往往并不会像你想的那样,当然,pre标签可以满足你的要求,被包围在pre里的文本通常会保留空格和换行符,并且字体等宽。字体等宽:其实汉字一般都是等宽的,设置字体等宽对于字母比较明显,可以看下面示例:

        <pre>
             这句话前面大概有13个空格
Hello,html (这句话前没有空格,就会顶行显示)
        </pre>
        <p>Hello,html (这句话是用p标签对比上文字母的字体等宽)</p>

可以看到,pre里的lo宽度一样,而p标签里l宽度比o窄,这就是pre标签的字体等宽。

header 页眉标签

页眉标签即在页面最上方展示的内容,用法如下:

        <footer>这里是页脚</footer>

nav 导航栏标签

一般网页在页眉下面都有一条包含首页之类的导航栏,nav实现的就是这一效果,一般搭配a标签使用,用法如下:

            <nav>
                <a href="http://www.tup.tsinghua.edu.cn/index.html">清华大学出版社</a>
                <a href="https://www.w3cschool.com.cn">w3cschool在线教程</a>
            </nav>

section 节标签

section标签定义文档中的节(section、区段),比如章节、页眉、页脚或文档中的其他部分,用法上和div相差不大,用法如下:

        <section>
          <h1>标题</h1>
          <p>正文内容</p>
        </section>

b 加粗标签

b标签原本含义是加粗,现在表示“文体突出”文字,通俗讲就是普通段落文字中突出不安分的文字,并把这部分文本呈现为粗体文本,用法如下:

        <p>这句话突然有几个字被<b>加粗</b></p>

strong 加粗标签

strong在HTML4中,表示strong emphasized text,即“更强调的文本”,在HTML5中其含义变成了important text,即“重要的文本”。其效果大致与b相同,都是对文本进行加粗,用法如下:

        <p>是该<strong>强调</strong>几句话了</p>

i 倾斜标签

i标签原本只是倾斜,现在用来体现与文本中其余部分不同的部分,并把这部分文本呈现为斜体文本,用法如下:

        <p>有几个字走着走着就<i>倒</i>了</p>

em 倾斜标签

emHTML4HTML5中,都表示emphasized text,即“强调的文本”,也有说法认为HTML5中,em表示有压力的强调,意义基本一致。其效果大致与i相同,都是对文本进行倾斜处理,用法如下:

        <p>又有几个字也<em>倒</em>了下来</p>

cite 作品标题

cite用来定义作品(比如书籍、歌曲、电影、电视节目、绘画、雕塑等)的标题,其效果与倾斜类似,用法如下:

        <p>庄子的<cite>《逍遥游》</cite>我并没有看过</p>

small 小型文本标签

small将旁注呈现为小型文本。免责声明、注意事项、法律限制或版权声明等通常都使用小型文本,小型文本有时也用于新闻来源、许可要求等。对于由em元素强调过的或由strong元素标记为重要的文本,small元素不会取消对文本的强调,也不会降低这些文本的重要性。当然,bi标签也可以应用在small里,用法如下:

        <small>这里是<em>小型文本</em><strong>标签</strong></small>

ins&del 标记文本改变标签

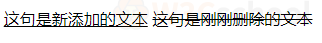
ins标记定义文档中的插入文本,和del标记一起使用,来描述对文档的更新和修正。del表示删除的文本,浏览器中通常以删除线文本显示,ins表示新添加的文本,浏览器中通常以下划线文本显示。用法及效果如下:

        <ins>这句是新添加的文本</ins>
        <del>这句是刚刚删除的文本</del>

sub&sup 文字上下标标签

sub标记可定义下标文本,sup标记可定义上标文本。用法及效果如下:

        <p>
            因式分解得:(x+1)<sup>2</sup>=4
            <br />
            解得:x<sub>1</sub>=-3, x<sub>2</sub>=1
        </p>

time 时间标签

time标记是HTML5的新增标记,用来定义日期时间。网页中经常会出现日期和时间信息,但过去一直没有标准的方式来标注,time标记的出现便是为了解决这个问题,其目的是让搜索引擎等其它程序可以更容易的提取日期时间信息,但在页面上似乎并不显示其内容,用法如下:

        <p>
            我每天早上<time>6:00</time>起床。
            我姐姐的<time datetime="1995-10-13">生日</time>马上要到了。
        </p>

var 变量标签

var标签经常与 codepre标签一起使用,用来显示计算机编程代码范例及类似方面的特定元素,用var标签标记的文本通常显示为斜体。

address 联系信息标签

address标签定义文档或文章的作者/拥有者的联系信息,address元素中的文本通常呈现为斜体,address元素通常连同其他信息被包含在footer元素中,其用法如下

        <address>
            Written by <a href="mailto:webmaster@example.com">Jon Doe</a>.<br> 
            Visit us at:<br>
            Example.com<br>
            Box 564, Disneyland<br>
            USA
        </address>

div 块级容器标签

div元素是块级元素,它是可用于组合其它HTML元素的容器,div元素没有特定的含义,如果与 CSS 一同使用,div元素可用于对大的内容块设置样式属性。在HTML5header等结构化元素出现之前,最常用的组容器就是div元素,它代表一个通用的内容块,结合CSS对文档赋予结构。其用法如下:

        <div style="color: red;">
            <h3>标题</h3>
            <p>文本内容</p>
        </div>

span 行内容器标签

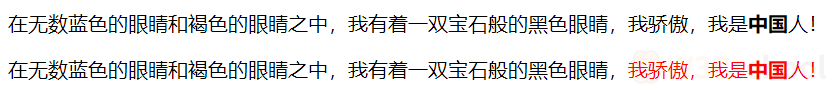
span元素是一个行内元素,它是div元素的一位表亲,同样是一个没有语义的通用元素,就其本身而言,span元素对文档的视觉效果没有任何影响,配合CSS使用时会发生变化,用法及效果如下:

        <p>
            在无数蓝色的眼睛和褐色的眼睛之中,我有着一双宝石般的黑色眼睛,<span>我骄傲,我是<strong>中国</strong>人!</span>
        </p>
        <p>
            在无数蓝色的眼睛和褐色的眼睛之中,我有着一双宝石般的黑色眼睛,<span style="color: red;">我骄傲,我是<strong>中国</strong>人!</span>
        </p>

ul 无序列表标签

无序列表类似于word中的项目符号列表,列表项排列没有顺序,只以项目符号作为分项标识。无序列表使用ul标记,需要为每一个列表项使用标记li标记,用法如下:

        <ul>
            <li>唱</li>
            <li>跳</li>
            <li>rap</li>
            <li>篮球</li>
        </ul>

ol 有序列表标签

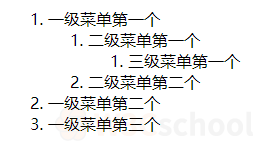
有序列表使用标记ol,其列表项仍然使用标记li,当需要子菜单或更多层次时,需要使用嵌套的方式实现,具体代码及效果如下:

        <ol>
            <li>一级菜单第一个</li>
            <ol>
                <li>二级菜单第一个</li>
                <ol>
                    <li>三级菜单第一个</li>
                </ol>
                <li>二级菜单第二个</li>
            </ol>
            <li>一级菜单第二个</li>
            <li>一级菜单第三个</li>
        </ol>

dl 描述列表标签

dl元素代表了一个描述列表,由0到多个“术语-描述”组构成,每一组都与一个或多个“术语”(dt元素的内容)以及一个或多个“描述”(dd元素的内容)相关,具体代码及效果如下:

        <dl>
            <dt>赤鷩</dt>
            <dd>鸟,可以御火</dd>
            <dd>赤鷩,山鸡之属,胸腹洞赤,冠金,背黄,头绿,尾中有赤,毛彩鲜明。</dd>
            <dt>鳢鱼</dt>
            <dd>鱼,其状如鳖,其音如羊</dd>
            <dt>肥囗</dt>
            <dd>蛇,六足四翼,见则天下大旱</dd>
        </dl>

附:使用字符实体表示特殊字符

大多数字母数字字符都可以在HTML文档中直接使用而不会有任何问题,然而,有一些字符在HTML中具有特殊含义,浏览器很可能会错误理解,这时,就需要使用一组不同的字符代替这些特殊字符,这就是字符实体(也叫转义字符),部分常用符号如下:

以上就是关于HTML文本标签的笔记了。有兴趣的同学可以用HTML编辑器测试一下代码效果。

想学习HTML的请往这走:

HTML教程:https://www.w3cschool.cn/html/

HTML零基础入门:https://www.w3cschool.cn/minicourse/play/html_txy

CSS学习笔记之基础与选择器

thbcm阅读(357)

这是一篇关于CSS基础跟选择器的笔记,毕竟自己的记性没有笔记本好用,所以记录一下,以后忘了也好有地方翻一下,复习重温。

CSS介绍

我们可以使用HTML构建稳定的结构基础,而页面的风格样式控制则交给CSS来完成。网页的样式包括各种元素的颜色、大小、线形、间距等等,这对于设计或维护一个数据较多的网站来说,工作量是巨大的。好在可以使用CSS来控制这些样式,这将大大提高网页设计和维护的效率,并且使网页的整体风格很容易做到统一。

CSS概述

CSS是英文Cascading Style Sheet的缩写,中文译为层叠样式表,也有人翻译为级联样式表,简称样式表。它是一种用来定义网页外观样式的技术,在网页中引入CSS规则,可以快捷高效地对页面进行布局设计,可以精确的控制HTML标记对象的宽度、高度、位置、字体、背景等外观效果。 CSS是一种标识性语言,不仅可以有效的控制网页的样式,更重要的是实现了网页内容与样式的分离,并允许将CSS规则单独存放于一个文档中, CSS文件的扩展名为“css”。

CSS3

CSS3标准早在1995年就开始制订, 2001年提上W3C研究议程,但是,10年来CSS3可以说是基本上没有什么很大的变化,一直到2011年6月才发布了全新版本的CSS3,目前,许多浏览器都广泛支持CSS3CSS3CSS技术的一个升级版本,CSS3语言CSS划分为更小的模块,在朝着模块化的方向发展。以前的版本是一个比较庞大而且比较复杂模块,所以,把它分解成为一个个小的简单的模块,同时也加入了更多新的模块。在CSS3中有字体、颜色、布局、背景、定位、边框、多列、动画、用户界面等等多个模块。

CSS的基本用法

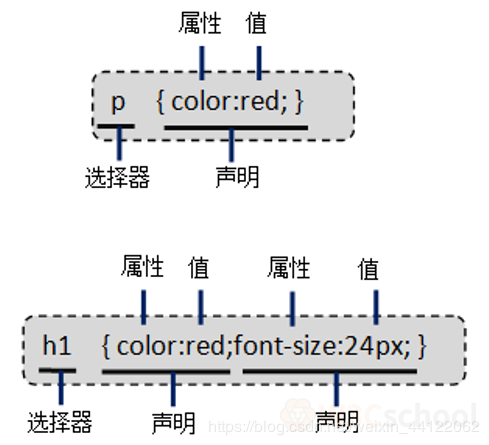
CSS的使用规则由两部分组成:选择器和一条或多条声明。其基本基本语法如下:

        选择器{
            属性1: 值;
            属性2: 值;
            …
            属性n: 值;
        }

CSS属性

CSS的属性按照相关功能进行了分组,包含了字体、文本、背景、列表、动画等多个分组,这些属性的具体使用方法和示例将会在后续中提到。

在HTML文档中使用CSS的方法

根据CSSHTML文档中的使用方法和作用范围不同,CSS样式表的使用方法分为三大类:行内样式、内部样式表和外部样式表,而外部样式表又可分为链入外部样式表和导入外部样式表。本节我们从四个分类来认识在HTML中使用CSS的方法。

  • 行内样式
  • 内部样式表
  • 外部样式表
  • 链入外部样式表
  • 导入外部样式表

行内样式

行内样式(inline style),也叫内联样式,它是CSS四种使用方法中最为直接的一种,它的实现借用HTML元素的全局属性style,把CSS代码直接写入其中即可。 严格意义上行内样式是一种不严谨的使用方式,它不需要选择器,这种方式下CSS代码和HTML代码混合在一起,因此不推荐使用行内样式。行内样式的基本语法如下:

        <标记 style="属性:值; 属性:值; …">

内部样式表

当单个文档需要特殊的样式时,应该使用内部样式表。内部样式表是将样式放在页面的head区里,这样定义的样式就应用到本页面中了,内部样式表使用style标记进行声明,是较为常用的一种使用方法。其基本语法如下:

    <head>
        <meta charset="utf-8" />
        <title></title>
        <style type="text/css">
            选择器1{属性:值;…}
            选择器2{属性:值;…}
            ……
            选择器n{属性:值;…}
        </style>
    </head>

style标记定义HTML文档的样式信息,规定的是HTML元素如何在浏览器中呈现,其中type用来指定元素中的内容类型。

链入外部样式表

当为了保证站点的风格统一,或当定义样式内容较多,且需要多个页面共享样式时,可使用外部样式表。链入外部样式表是把样式表保存为一个外部样式表文件,然后在页面中用link标记链接到这个样式表文件,link标记放在页面的head区内。其基本语法为:

    <head>
        <meta charset="utf-8" />
        <title></title>
        <link href="样式表路径" rel="stylesheet" type="text/css" />
    </head>

其中:

href:指出样式表存放的路径。

rel:用来定义链接的文件与HTML之间的关系,rel="stylesheet"是指在页面中使用这个外部的样式表。

type属性用于指定文件类型,“text/css”指文件的类型是样式表文本。

导入外部样式表

导入外部样式表是指在HTML文件头部的style元素里导入一个外部样式表,导入外部样式表采用import方式。导入外部样式表和链入样式表的方法很相似,但导入外部样式表的样式实质上相当于存在网页内部。其基本语法为:

    <head>
        <meta charset="utf-8" />
        <title></title>
        <style type="text/css">
            @import url("样式表路径");
        </style>
    </head>

CSS基本选择器

选择器是CSS中很重要的概念,它可以大幅度提高开发人员编写或修改样式表的工作效率。CSS3提供了大量的选择器,大体上可以分为基本选择器、组合选择器、属性选择器、伪类选择器和伪对象选择器等。由于浏览器支持情况,很多选择器在实际开发中很少用到,本篇主要记录最基本又最常用的几种选择器。 基本选择器包括标记选择器、类选择器、id选择器和通用选择器。

标记选择器

HTML文档中最基本的构成是HTML标记,如果要对文档中的所有同类标记都使用同一个CSS样式时,就应使用标记选择器。其基本语法为:

        标记名{ 属性1:值1; 属性2:值2;…}

例如要使所有P标签的文本居中时,语法如下:

            p{
                text-align: center;
            }

类选择器

类选择器的基本语法为:

        标记名.类名{属性1:值1;属性2:值2;…}

类选择器针对标记的全局属性class,引用方式为:

        <标记名 class="类名">

值得注意的是,这里的类名可以是任何合法的字符,由设计者定义。如果对所有的标记均可使用,则采用*.类名的形式,这里的*表示全部,当然,也可以省略。

下面举几个例子:

        <style type="text/css">
            p.text1{color:brown;font-size:14px;}
            /* 该形式下只允许<p>标记中类名为"text1"的标签引用该样式 */
            *.text1{ color:brown;font-size:14px; }
            或
            .text1{ color:brown;font-size:14px; }
            /* 表示所有类名为"text1"的标签都可引用该样式 */
        </style>

id选择器

id选择器和类选择器大致相同,不同的是定义时不使用“.”而使用“#”,作用于HTML标记的全局属性是“id”而不是“class”。 id选择器的基本语法为:

        标记名#id名{ 属性1: 值1;属性2: 值2;…}

id选择器针对标记的全局属性id,引用方式为:

        <标记名 id="id名">

当然,与类选择器一样,如果对所有的标记均使用时,则采用*#id名的形式,这里*表示全部,也可以省略。

通用选择器

通用选择器是一种特殊的选择器,用 * 表示,匹配网页中的所有元素,除非使用更为具体的选择器指定某一元素中对应的相同属性应使用其它值。通用选择器和对body元素设定样式稍有不同,因为通用选择器应用于每一个元素,而不依赖从应用于body元素的规则中继承的属性。其基本用法如下:

        <style type="text/css">
            *{
                属性1: 值1;
                属性2: 值2;
                …
            }
        </style>

其它CSS选择器

除了CSS基本选择器外,CSS还有许多其它选择器。

组合选择器

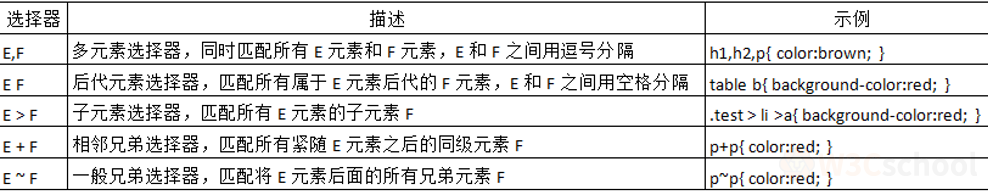
CSS中组合选择器,可以算作是基础选择器的升级版,也就是组合去使用基础选择器的意思。组合选择器主要有五个类别:多元素选择器、后代选择器、子选择器、相邻选择器和兄弟选择器。

多元素选择器

多元素选择器的基本语法为:

        E, F {属性1:值1;属性2:值2;… } 

这个很好理解,就是同时选中多个元素,中间用“,”隔开。

后代元素选择器

后代元素选择器的基本语法为:

        E F {属性1:值1;属性2:值2;… } 

这个也很好理解,就是匹配所有属于E元素后代的F元素E元素F元素用空格隔开,例如:

        table b{color:red; } 

就表示将表格中的所有b元素文字设置为红色。

子元素选择器

子元素选择器的基本语法为:

        E>F{属性1:值1;属性2:值2;…}

子元素选择器只能选择某元素的子元素,其中E为父元素,F为直接子元素,E>F所表示的是选择了E元素下的所有子元素F,其间用>连接。这和后代元素选择器不一样,在后代元素选择器中F是E的所有后代元素,而子元素选择器中F必须是E的子元素。

相邻兄弟选择器

相邻兄弟选择器的基本语法为:

        E+F{属性1:值1;属性2:值2;…}

相邻兄弟选择器可以选择紧接在另一元素后的元素,而且它们具有相同的父元素,其间用+号链接,换句话说,E和F具有同一个父元素,而且F元素在E元素后面并且紧紧相邻。

一般兄弟选择器

一般兄弟选择器的基本语法为:

        E~F{属性1:值1;属性2: 值2;…}

一般兄弟选择器将选择某元素后面的所有兄弟元素,其间用~号链接,它和相邻兄弟选择器类似,需要在同一个父元素之中,并且F元素在E元素之后。区别在于E ~ F 选择器匹配所有E元素后面的F元素,E+F仅匹配紧跟在E元素后边的F元素。

属性选择器

属性选择器是在标记后面加一个中括号,中括号中列出各种属性或者表达式。属性选择器的形式很多,我们这里通过示例简单介绍几个。

存在属性匹配

通过匹配存在的属性来控制元素的样式,一般要把匹配的属性包含在中括号中。 例如将任何带有href属性的a标记设置为综色:

        a[href]{color:brown;}

精确属性匹配 只有当属性值完全匹配指定的属性值时才会应用样式,id选择器和类选择器本质上就是精确属性匹配选择器。 例如将指向网址“http://www.w3cschool.cn” 的链接a标记设置为棕色:

        a[href="http://www.w3cschool.cn"]{color:brown;}

前缀匹配

只要属性值的开始字符串匹配指定字符串,即可对元素应用样式。前缀匹配使用[^=]形式实现,如:

        [id^="user"]{color:brown;}

那么下列的标签均可以变为棕色:

        <p id="userName">小明</p>
        <p id="userWeight">体重</p>
        <p id="userAge">年龄</p>

后缀匹配

与前缀匹配相反,只要属性值的结尾字符匹串配指定字符串,即可对元素应用样式。后缀匹配使用[$=]形式实现,如:

        [id$="Name"]{color:brown;}

那么下列的标签均可以变为棕色:

        <p id="JackName">杰克</p>
        <p id="RoseName">萝丝</p> 

子字符串匹配

只要属性中存在指定字符串即应用样式,使用[*=]形式实现,如:

        [id*="test"]{color:brown;}

那么下列的标签均可以变为棕色:

        <p id="Rosetest">段落1</p>
        <p id="testY">段落2</p> 
        <p id="xtesty">段落3</p>

以上就是CSS的学习笔记了,希望对大家有所帮助。然后对CSS感兴趣的同学可以看一下教程:

CSS教程:https://www.w3cschool.cn/css/

CSS微课:https://www.w3cschool.cn/minicourse/play/csscourse

如何在日常工作中合理使用VSCode Task

thbcm阅读(328)

在这篇文章你可以学到如何快速运行npm脚本,直接在VSCode中运行,并使用快捷方式。如果你没有使用过VSCode Task,那么你可以好好看一下。

为何使用VSCode Task

我工作过的所有 JavaScript 项目都有一组定义的脚本,你可以为一个应用程序执行。通常情况下,这些脚本都是命令,可以帮助你进行测试,构建或部署你的代码。我所合作过的大多数开发者都是用自己选择的命令行来运行这些命令。要么你必须死记硬背你的项目脚本,要么你的命令行可能有一些typeahead的功能,要么你就像我经常做的那样,搜刮历史记录来找到你过去运行的那个命令。

history | grep ‘npm run’

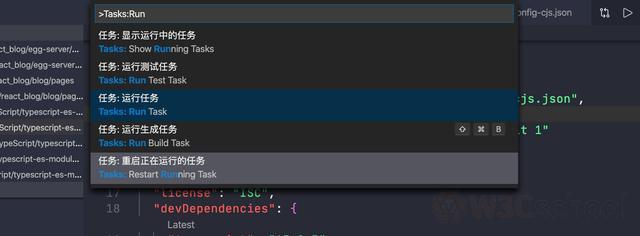
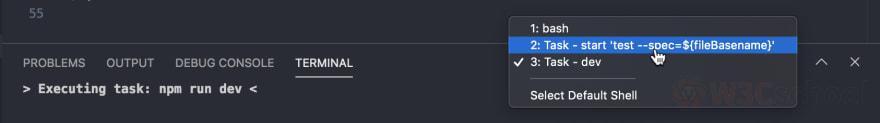
相反,你可以使用“Tasks”为您运行脚本。你可以先打开命令面板 Cmd + Shift + P ,然后选择“Tasks: Run Task”。

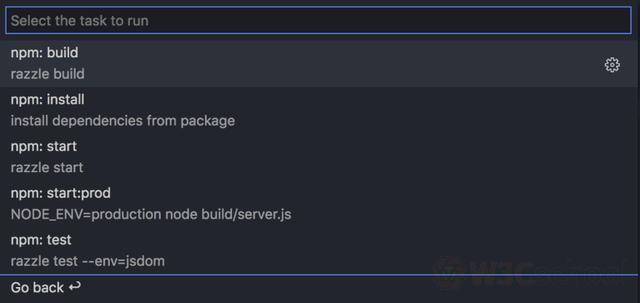
VSCode将为你提供它支持的多种任务类型。继续并选择“npm”。编辑器将快速扫描你的 package.json 并提供你定义的任务:

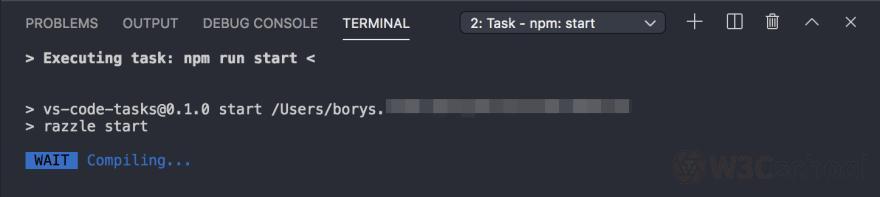
选择一个你的脚本,你就完成了!一个新的内置终端窗口被打开,你可以看到你的脚本的输出,并从你离开的地方继续工作。

好吧,这看起来很酷。但是你可能会想:“嘿,我的项目不是那么简单,我的任务中包含参数,不同的选项,也许我需要先打开子文件夹!”。

当然,你也可以这样做!

配置Tasks

假设你要为特定的测试文件运行单元测试,你的测试命令可能如下所示:

npm test 'my-component.js' --auto-watch --no-single-run

我通常的工作流程如下。我想在watch模式下运行我正在进行的单元测试。通常情况下,你需要在测试命令中插入文件名,但VSCode可以帮你完成。为了实现这个目标,我们可以使用一些为我们提供的替换变量。例如:${fileBasename}。可用变量的完整列表可以在这里的官方文档中找到。

现在,再次打开命令面板,选择“任务:运行任务”,然后选择“没有配置的任务。配置任务…”,然后选择要配置的任务。这将在项目中创建并打开一个新文件:.vscode/tasks.json。你可以将此文件添加到 .gitignore 或进行提交,因此你的团队也可以使用这些任务。

添加替换变量后,配置应如下所示:

{
  "version": "2.0.0",
    "tasks": [
      {
        "type": "npm",
        "script": "test ${fileBasename} --auto-watch --no-single-run",
        "problemMatcher": [],
        "label": "npm: test opened file",
        "detail": "npm test"
      }
    ]
}

然后,就这样,你的自定义任务就可以在命令面板中运行了。你的自定义任务现在就在你可以从Command Palette中运行的列表中。现在打开你要运行的测试文件,例如:my-component-test.js。运行 Cmd + Shift + P-> "Tasks: 运行任务",你应该会看到新配置的任务:”npm: test opened file“。选择它,它应该在终端中运行 npm test my-component-test.js --auto-watch --no-single-run。你还可以自定义脚本结果的显示方式。我想为这种类型的命令打开一个新的终端。为此,你只需要提供一个额外的 “演示 “配置即可。

{
  ...
  "presentation": {
    "panel": "dedicated",
  }
}

现在,你可以看到打开了多个终端窗口,可以在它们之间进行切换。

配置Shell Tasks

如果要执行其他Shell命令,VSCode也支持。现在,我们可以使用 shell 而不是使用 npm 类型。例如。

{
  "version": "2.0.0",
  "tasks": [
    {
      "label": "Run Cypress",
      "type": "shell",
      "command": "cd tests/e2e/cypress/ && npm run cypress",
    }
}

总结

基于上面的例子,你可以在几分钟内配置好您的自定义开发工作流,并享受到运行脚本并直接在编辑器中查看结果的完全集成体验。

本文告诉大家如何使用VSCode Task改善日常工作,希望对大家有所帮助。对JavaScript感兴趣的同学可以看一下教程

JavaScript教程:https://www.w3cschool.cn/javascript/

JavaScript微课:https://www.w3cschool.cn/minicourse/play/jscourse

文章参考来源:www.toutiao.com/a6849220174004879884

带你了解什么是Python操作MySQL数据库

thbcm阅读(367)

写这篇文章主要是为了介绍Python操作MySQL数据库,并结合相应的实例带你更加深入了解。文中的代码实例很详细,对大家有一定的参考学习价值。

1.什么是pymysql?

PyMySQL是在Python3.x版本中用于连接MySQL服务器的一个库,Python2中使用mysqldbPyMySql遵循Python数据库API v2.0的规范,并包含了pure-Python MySQL客户端库。

2.安装PyMySQL

 $ pip install pymysql

3.MySQL数据库安装与配置

在用PyMySQL连接MySQL数据库之前,请确保MySQL数据库安装配置完成,具体如何安装与配置MySQL数据库,请参考 MySQL 安装MySQL 管理

4.1.连接数据库操作

import pymysql


# 数据库服务器名
HOSTNAME = 'node05'
# 数据库用户名
USER = 'root'
# 数据库名
DATABASE = 'cayman'
# 数据库密码
PASSWORD = 'Love88me'


# 打开数据库连接
conn = pymysql.connect(HOSTNAME, USER, PASSWORD, DATABASE)


# 使用cursor()方法创建一个游标对象
cursor = conn.cursor()


# 使用execute()方法执行SQL查询语句
cursor.execute("select VERSION()")


# 使用fetchone()查询单条数据
data = cursor.fetchone()
print(f"Database Version: {data}")


# 关闭数据库连接
conn.close()

4.2.创建表操作

import pymysql


# 设置数据库配置项
HOSTNAME = 'node05'
USERNAME = 'root'
PASSWORD = 'Love88me'
DATABASE = 'cayman'


# 打开数据库连接
db = pymysql.connect(HOSTNAME, USERNAME, PASSWORD, DATABASE)


# 使用cursor对象创建一个流标对象
cursor = db.cursor()


# 使用execute()方法执行SQL, 如果表存在则删除
cursor.execute("DROP TABLE IF EXISTS employee")


# 使用预处理语句创建表
sql = """ CREATE TABLE employee(
    id bigint primary key auto_increment,
    user_name varchar(50) not null,
    age int,
    sex char(1),
    income float
)
"""


# 执行sql语句
cursor.execute(sql)


# 关闭数据库连接
db.close()

4.3.1.数据库插入单条语句

import pymysql


# 设置数据库配置项
HOSTNAME = 'node05'
USERNAME = 'root'
PASSWORD = 'Love88me'
DATABASE = 'cayman'


# 打开数据库连接
db = pymysql.connect(HOSTNAME, USERNAME, PASSWORD, DATABASE)


# 使用cursor对象创建一个流标对象
cursor = db.cursor()


# SQL语句
sql = """
 insert into employee(user_name, age, sex, income) values ('风清扬', 64, '男', 22000);
"""


try:
    # 执行sql语句
    cursor.execute(sql)
    # 提交
    db.commit()
except:
    # 如果发生错误就回滚
    db.rollback()


# 关闭数据库连接
db.close()

4.3.2.数据库插入多条语句

import pymysql


# 设置数据库配置项
HOSTNAME = 'node05'
USERNAME = 'root'
PASSWORD = 'Love88me'
DATABASE = 'cayman'


# 打开数据库连接
db = pymysql.connect(HOSTNAME, USERNAME, PASSWORD, DATABASE)


# 使用cursor对象创建一个流标对象
cursor = db.cursor()


# SQL语句
sql = " insert into employee(user_name, age, sex, income) values (%s, %s, %s, %s)"


data = (
    ('风清扬', 64, '男', 22000),
    ('令狐冲', 22, '男', 14000),
    ('任盈盈', 20, '男', 10000),
    ('东方不败', 32, '男', 18000),
    ('任我行', 56, '男', 17000),
    ('段誉', 33, '男', 19000),
    ('王语嫣', 26, '女', 9000),
    ('木婉清', 23, '女', 6000),
    ('乔峰', 38, '男', 23000),
    ('阿朱', 24, '女', 5000),
    ('阿紫', 22, '女', 5500),
    ('虚竹', 35, '男', 11000),
    ('梦姑', 25, '女', 6500),
    ('梅超风', 41, '女', 15000),
    ('陈玄风', 44, '男', 12000),
    ('杨过', 28, '男', 24000),
    ('小龙女', 38, '女', 15000),
    ('鸠摩智', 44, '男', 16000)
)


try:
    # 执行sql语句
    cursor.executemany(sql, data)
    # 提交
    db.commit()
except:
    # 如果发生错误就回滚
    db.rollback()


# 关闭数据库连接
db.close()

4.4.数据库查询

Python查询MySQL使用fetchone()获取单条数据,使用fetchall()方法获取多条数据。

  • fetchone(): 该方法获取下一个查询结果集。结果集是一个对象
  • fetchall(): 接收全部的返回结果行;
  • rowcount(): 这是一个只读属性,并返回执行execute()方法后影响的行数。

4.4.1.查询示例

查询employee表中income(工资)大于20000的所有数据

# 1.查询employee表中工资大于20000的员工信息
import pymysql


# 设置数据库配置项
HOSTNAME = 'node05'
USERNAME = 'root'
PASSWORD = 'Love88me'
DATABASE = 'cayman'


# 打开数据库连接
db = pymysql.connect(HOSTNAME, USERNAME, PASSWORD, DATABASE)


# 使用cursor对象创建一个流标对象
cursor = db.cursor()


# 查询语句
sql = "select * from employee where income >'%d' "%(20000)


try:
    # 执行sql语句
    cursor.execute(sql)
    # 获取所有满足条件的列表
    ret = cursor.fetchall()
    # 遍历打印结果
    for row in ret:
        user_name = row[1]
        age = row[2]
        sex = row[3]
        income = row[4]
        print(f"员工: {user_name},年龄: {age}, 性别: {sex}, 工资: {income}")
except:
    print("无满足条件的数据或查询出错!!")


# 关闭数据库连接
db.close()

4.5.数据库更新操作

import pymysql


# 设置数据库配置项
HOSTNAME = 'node05'
USERNAME = 'root'
PASSWORD = 'Love88me'
DATABASE = 'cayman'


# 打开数据库连接
db = pymysql.connect(HOSTNAME, USERNAME, PASSWORD, DATABASE)


# 使用cursor对象创建一个流标对象
cursor = db.cursor()


# 更新语句
sql = "update employee set income=income+income*0.1 where sex='%c'"%('女')


try:
    # 执行SQL语句
    cursor.execute(sql)
    # 提交
    db.commit()


except:
    # 发生错误时回滚
    db.rollback()


# 关闭数据库
db.close()

4.6.删除操作

import pymysql


# 设置数据库连接信息
HOSTNAME = 'node05'
USERNAME = 'root'
PASSWORD = 'Love88me'
DATABASE = 'cayman'


# 打开数据库连接
db = pymysql.connect(HOSTNAME, USERNAME, PASSWORD, DATABASE)


# 使用cursor()方法获取游标
cursor = db.cursor()


# 构建删除数据SQL语句
sql = "delete from employee where user_name = '%s'"%('鸠摩智')


try:
    # 执行sql语句
    cursor.execute(sql)
    # 提交
    db.commit()


except:
    # 发生异常时回滚
    db.rollback()


# 关闭数据库连接
db.close()

4.7 执行事务操作

在数据库操作中,事务机制可以保证数据的一致性。最基本的事务应当具备4个属性: 原子性、一致性、隔离性、和持久性。这四个属性被称作ACID特性。

  • 原子性(Atomicity): 一个事务是一个不可分割的工作单位,事务中包括的诸操作要么都做,要么都不做。
  • 一致性(Consistency): 事务必须是使数据库从一个一致性状态变到另一个一致性状态。一致性与原子性是密切相关的。
  • 隔离性(Isolation): 一个事务的执行不能被其他事务干扰。即一个事务内部的操作及使用的数据对并发的其他事务是隔离的,并发执行的各个事务之间不能互相干扰。
  • 持久性(Durability): 持续性也称永久性(permanence),指一个事务一旦提交,它对数据库中数据的改变就应该是永久性的。接下来的其他操作或故障不应该对其有任何影响。

Python DB API 2.0的事务提供了两个方法commitrollback。对于支持事务的数据库编程中,当流标建立时,就自动开启了一个隐形的数据库事务。

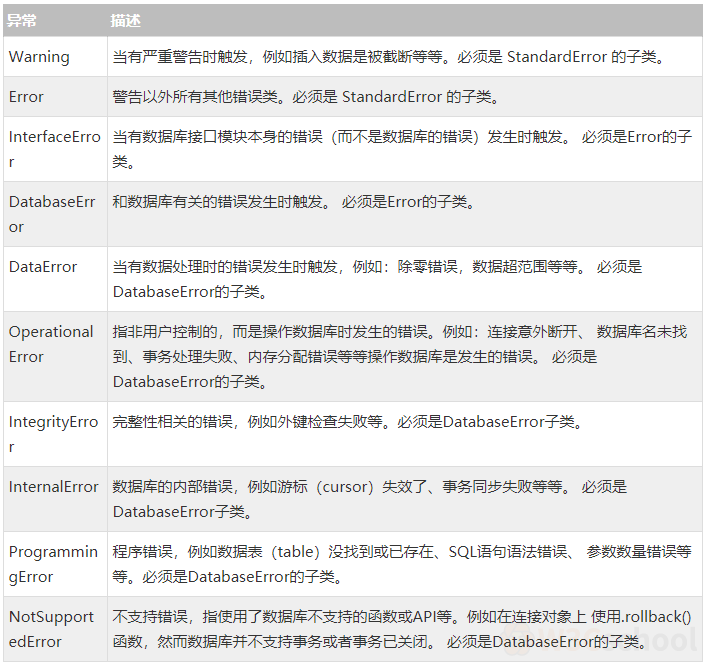
4.8 错误处理

DB API中定义了一些数据库操作的错误及异常,下表列出了这些错误和异常:

以上就是关于Python操作MySQL数据库的讲解了,希望对大家有所帮助,或许同学们也可以进入以下教程学习一下

python教程:https://www.w3cschool.cn/python/

python3基础微课:https://www.w3cschool.cn/minicourse/play/python3course

关于Linux重定向的用法详解

thbcm阅读(329)

我们平时都会需要复制黏贴数据,假如打开文件进行复制黏贴操作,那么就有的繁琐,那么能不能省掉这些步骤呢?

当然能,重定向是一种高效的方法,它无需大量的鼠标与键盘操作就可以完成数据的转移。重定向可以分为输入重定向以及输出重定向这两种类型。由于所有程序都有输入或者输出,因此输入和输出的重定向是任何编程语言或脚本语言都自带的功能。

每当你与计算机交互时,重定向就必然会发生。学会使用重定向,不仅可以让你与计算机更好地交互,还可以提高你的工作效率。接下来给大家讲解一下 Linux 系统中重定向的常见用法:

Linux 中的数据流

谈到 Linux 的重定向,就不得不提以下这3种数据流:

  • 输入信息会从 stdin 中读取(标准输入,通常是键盘或鼠标)。
  • 输出信息会被输出到 stdout (标准输出,一个文本文件或者数据流)。
  • 错误信息会被输出到 stderr

了解了这些数据流的存在,在你使用 Shell 时,你就可以更好地控制数据的流向了。

Linux 系统中,标准输入,标准输出以及标准错误都作为文件存在。 你可以在 /dev 目录下看到它们:

$ ls /dev/std* /dev/stderr /dev/stdin /dev/stdout

重定向输出

Linux 系统中,使用 > 字符表示重定向输出。例如,将 ls命令的输出重定向到一个文件中:

$ ls > list.txt

执行以上命令后,屏幕上并不会显示 ls 命令的输出信息,因为输出信息已经被重定向至 list.txt 文件中了。

除此之外,重定向还有许多用途,它还可以用于复制文件的内容,而且不限于复制文本文件,二进制文件也可以复制:

$ cat image.png > picture.png

如果你想要将一个文件的内容复制到另一个文件的末尾,你只需将> 字符换成 >> 字符串即可,像这样:

$ cat lxlinux >> alvin

重定向输入

与重定向输出相反,重定向输入使用的是 <字符。

输入重定向可以将输入信息重定向至命令中作为参数使用。该功能可能比较少用,但是,当命令需要一个参数列表时,而这些参数都存在一个文件中,然后你想快速地将它们从文件中复制粘贴到终端,这时这个功能就能派上用场了。

例如,package.list 里记录了你需要安装的包的列表,而你想要快速地安装所有的包,只需执行以下这一条命令,就能一次性安装 package.list 里的所有包:

$ sudo dnf install $(<package.list)

输入重定向的常见用法是 Here-document (简称 Here-doc) 以及 Here-string

Here-doc 将输入的文本块重定向至标准输入流,直至遇到特殊的文件结束标记符为止(文件结束标记符可以是任意的唯一的字符串,但大部分人都默认使用 EOF)。

你可以尝试在终端输入以下命令(直到第二个 EOF 字符串结束):

$ cat << EOF

alvin
lxlinux.net
EOF

预期的输出应该是这样的:

alvin lxlinux.net

Here-docBash 脚本编写者们将多行文本转储到文件或屏幕上的常用技巧。

Here-stringHere-doc 相似,但是它只有一个字符串,或者几个被引号括起来的字符串:

$ cat <<< alvin alvin $ cat <<< “alvin lxlinux.net” alvin lxlinux.net

重定向错误信息

错误信息默认会进入叫 stderr 的流,使用 2> 可以对其进行重定向。例如,将错误信息重定向到名为 output.log 的文件中:

$ ls /nope 2> output.log

重定向数据至 /dev/null

就像标准输入、标准输出以及标准错误一样,在 Linux 文件系统中,空,也存在一个文件与之对应,它叫做 null ,放在 /dev 目录下。为了方便读,人们经常省略斜杠,直接把他读作dev null

/dev/null 并不保存数据,被写入 /dev/null 的数据最终都会丢失,就像被丢进虚空中一样。因此,你可以使用重定向将不需要的数据输送到 /dev/null 。例如,find命令的输出往往很冗长,而且在搜索文件时还经常会报告权限冲突的错误,像这样:

$ find ~ -type f /home/seth/actual.file find: /home/seth/foggy': Permission denied find:/home/seth/groggy’: Permission denied find: `/home/seth/soggy’: Permission denied /home/seth/zzz.file

这时,你就可以将错误信息重定向到 /dev/null ,以过滤掉不必要的信息,像这样:

$ find ~ -type f 2> /dev/null /home/seth/actual.file /home/seth/zzz.file

善用重定向

Bash 中,重定向是转移数据的一种高效方法。你可能并不会总是使用重定向,但是学会如何使用重定向,在你需要的时候可以让你省掉许多不必要的复制粘贴操作,因此也节省了许多操作鼠标与键盘的时间。请不要执着于复制粘贴了,使用重定向可以提高你的工作效率,难道,它不香吗?

以上就是关于Linux 系统中的重定向的讲解了,希望对大家的工作有所帮助,想学习更多Linux知识的同学可以看一下教程:

Linux教程:https://www.w3cschool.cn/linux/

Linux微课:https://www.w3cschool.cn/minicourse/play/linuxcourse

Linux就该这么学:https://www.w3cschool.cn/linuxprobe/

文章参考来源:www.toutiao.com/a6854146447089074695/

联系我们