Apache-HTTP和Nginx哪家引擎比较强

thbcm阅读(319)

本文分别介绍了Apache-HTTPNginx这两个引擎,然后对比一下他们的差别。有什么不足之处欢迎大家补充。

HTTP中间件

当我们在浏览器中输入一个网页链接后,浏览器基于HTTP(s)传输协议向相应的服务器发送一个请求,服务器收到相应的请求后经过处理,返回相应的信息给浏览器,然后由浏览器解析http中的内容,以网页的形式表现出来。

服务器负责接收请求,并在处理之后返回相应的数据,而其中又可以细分为处理http连接的服务部分和执行服务内容的应用部分(WordPress使用PHP生成需要的页面,就属于应用部分)

而不论应用部分执行的是何种应用,处理http连接的部分几乎是相同的,所以出现了专门处理http连接的中间件,目前最常见的是ApacheNginx

Apache

正式名称是“Apache HTTP Server”,是一款开源的HTTP服务器中间件,诞生于1995年,曾经是HTTP服务领域的龙头老大,拥有大量的用户和丰富的社区资源。Apache的一大优点就是方便与WordPress等CMS软件进行集成,只需要简单的设定就能搭建一个基于CMS的网站。

Apache的内部处理模型

内部构造方面,Apache采用多进程的方式,每有一个连接就会为这个连接开辟一个进程,专门用于处理这个连接上的请求,直到连接结束。这样做的好处是:

  • 来自不同客户端的连接会立刻得到相应且互不干扰,而且不会因为某一个服务占用了较长的时间而使其它的连接得不到响应。

但是缺点也是显而易见的:

  • 当同时访问数比较多的时候,Apache会建立大量的进程,占用过多的内存资源。
  • 大量线程间的调度也会造成CPU处理能力的大量浪费。

由此产生了被称为C10K的难题,C即客户端(Client),10K是指1万,即不论服务器的性能和网络带宽有多高,Apache都难以同时处理1万个以上的连接。

Nginx

读作Engine-X,和Apache一样也是用于HTTP服务的开源中间件,诞生于2004年。NginxApache的历史要短,但是正因为是后来者,Nginx吸取了Apache的教训,在设计初期就考虑到了处理大量连接时的效率问题,解决了诸如C10K等随着互联网规模壮大而产生的难题。

Nginx的内部处理模型

Nginx采用了非阻塞IO和异步消息驱动的方式,即在称作worker的线程中使用循环来处理队列中的连接请求。而根据硬件的情况,可以设定多个worker线程,充分利用CPU的核心资源。

  • 解决了处理大量连接时消耗内存过多,调度效率低下的问题,同时还能充分的利用所有的CPU核心。在相同硬件下处理并发连接的能力是Apache的10到100倍。

但是Nginx这种方式也不是没有缺点。

  • 当服务器单核性能较差时,基于CMS的动态网站可能需要较长的时间来执行一个请求,此时来自其他客户端的请求将无法立即被执行。当CPU核心数较少,worker线程不足时会更加明显。

好在现在服务器的性能越来越强,在AMD的带领下CPU核心数也越来越多,Nginx的缺点足以被弥补,而高效的优势也愈发显现出来。

综合对比

Apache Nginx处理能力有限10-100倍是否会被复杂任务阻塞否有可能会设定难度比较简单相对复杂社区资源丰富相对较少

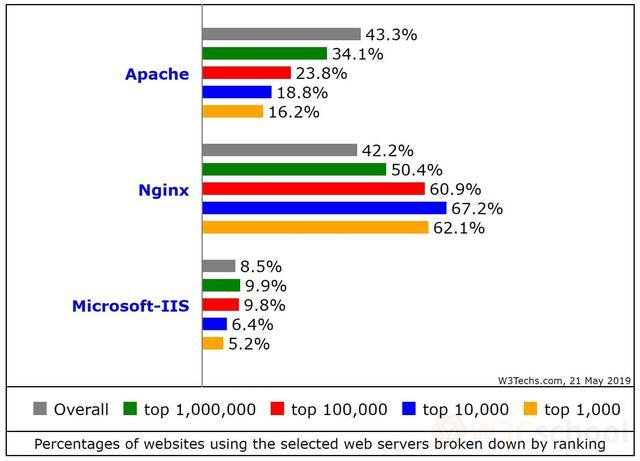
近年来,Nginx的市场占有率不断提高,2019年已经达到了和Apache持平的水平。而对于有极大访问量的大型网站,可以看到访问量越大,Nginx的占比也就越高。这也从侧面印证了Nginx在处理大量访问时的优越性能。

负载均衡

Nginx除了可以作为HTTP服务器使用,其强大的反向代理功能还被广泛地用作负载均衡前端服务器,逐渐取代了基于硬件的负载均衡器。

Nginx中可以配置若干个后端服务器,Nginx在收到HTTP请求之后按照一定规则(轮询,IP哈希,优先随机)等将请求转发给后端服务器,实现负载在多台服务器上的平均或加权分配。

同时作为负载均衡的前端还能缓存后端返回的数据,缓解后端服务器的压力。前端采用Nginx做负载均衡限制每个服务器的连接数,后端服务器运行Apache的模式也并不少见。

硬件负载均衡器的业界大佬F5 networks在2019年收购了Nginx,推出了包含收费服务的负载均衡解决方案Nginx+

以上是关于apachenginx的对比,希望对于刚接触apahcenginx的人有一定的帮助。使用一个产品不能糊里糊涂的使用,我们需要了解其优点和缺点,这样才能更好的使用它们。你也可以了解更多相关知识

Nginx 入门指南:https://www.w3cschool.cn/nginx/

Apache Beam 2.23.0 今日发布,更新了大数据批处理和流处理标准

thbcm阅读(319)

简介

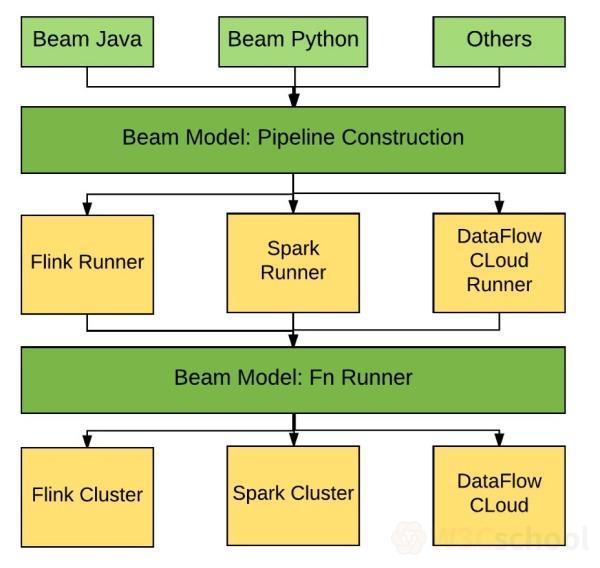
Apache Beam 2.23.0现已发布。Apache BeamGoogle 在 2016 年 2 月份贡献给 Apache基金会的项目,主要目标是统一批处理和流处理的编程范式,为无限、乱序、web-scale 的数据集处理提供简单灵活,功能丰富以及表达能力十分强大的 SDKApache Beam项目重点在于数据处理的编程范式和接口定义,并不涉及具体执行引擎的实现,Apache Beam 希望基于 Beam 开发的数据处理程序可以执行在任意的分布式计算引擎上。

主要更新内容:

Highlights

  • Twister2 Runner(BEAM-7304)。
  • Python 3.8支持(BEAM-8494)。

I/Os

  • 添加了对 Snowflake reading 的支持(Java)(BEAM-9722)。
  • 增加了对写入 Splunk 的支持(Java)(BEAM-8596)。
  • 添加了对 assume role 的支持(Java)(BEAM-10335)。
  • 已添加一个新的可从 BigQuery 读取的 transform:apache_beam.io.gcp.bigquery.ReadFromBigQuery。此 transform 是实验性的。它通过将数据导出到 Avro 文件并读取这些文件来从 BigQuery 读取数据。它还支持通过导出到 JSON 文件来读取数据。与时间和日期相关的字段在行为上有很小的差异。
  • SnowflakeIO.write 添加 dispositions(BEAM-10343)

New Features/Improvements

更新 Snowflake JDBC 依赖关系,并将 application=beam 添加到 connection URL(BEAM-10383)。

Breaking Changes

  • 在反序列化 JSON(Java)时,RowJson.RowJsonDeserializerJsonToRowPubsubJsonTableProvider现在默认接受“implicit nulls”。以前的 null 只能用 explicit null 值表示,例如 {"foo": "bar", "baz": null},而像{"foo": "bar"} 这样的 implicit null 值则会引发异常。现在,两个 JSON 字符串默认都会产生相同的结果。可以使用用RowJson.RowJsonDeserializer#withNullBehavior来覆盖此行为。
  • 修复 Python 中GroupIntoBatches实验转换中的一个错误,该错误实际上是按键对批次进行分组的。这将更改此转换的输出类型(BEAM-6696)。

Deprecations

  • 删除 Gearpump runner。(BEAM-9999)
  • 删除 Apex 运行程序。(BEAM-9999)
  • RedisIO.readAll() 已被弃用,将在 2 个版本中删除,用户必须使用 RedisIO.readKeyPatterns() 作为替代(BEAM-9747)。

文章参考来源:https://beam.apache.org/blog/beam-2.23.0/

还在为开发API烦恼吗?一份API开发指南献上

thbcm阅读(331)

每个开发人员对API这词应该都挺熟悉的,API是软件系统之间或不同组成部分之间进行连接的约定。特别是移动应用程序和微服务架构的不断普及,API就是他们成功背后的功臣,这个时候如何设计和开发API就显得格外重要,今天这篇文章就是一份完整的API开发指南,介绍了在开发API过程中的内容、工具和最佳实践。

一、API介绍

API它的全称是Application Programming Interface——应用程序编程接口,是一组指令、标准或要求,使软件或应用程序可以利用另一应用程序、平台或设备的功能/服务来获得更好的服务。简而言之,它可以让应用程序彼此通信。例如,当我们在使用支付宝、微信APP时,都会通过API请求后台服务器上的数据,在APP上进行展示。

API是处理数据或启动两个产品或服务之间的通信的所有应用程序的基础。它使移动应用程序或平台能够与其他应用程序或平台共享其数据,并在不涉及开发人员的情况下简化用户体验。最重要的是,API消除了从头开始构建类似程序或平台的需求。您可以使用其他一些应用程序/平台中的现有应用程序。基于这些原因,应用程序开发人员和业务主管都将重点放在API开发上。

在深入研究之前,先让我们看一下使您更容易理解该概念的基本术语。

二、API术语

  1. API Key:当一个API请求通过Header或参数来识别调用者时,传递到请求中的授权码就是API Key
  1. Endpoint:当一个API与另一个系统交互时,通信通道的两端被认为是Endpoint
  1. JSON:是用于API请求参数和响应主体的数据格式。
  1. GETRESTful APIHTTP方法,用于获取资源。
  1. POSTRESTful APIHTTP方法,用于创建资源。
  1. OAuth:它基本上是一个开放标准的授权框架,可以在不直接共享凭据的情况下从客户端进行访问。
  1. RESTREST(代表性状态转移)是一种编程体系结构的实现,用于提供两个设备/系统之间的通信效率。它是一个轻量级的,他是通过数据引用而不是数据副本的方式来共享数据,基于这个架构创建的系统称为“RESTful”系统,而RESTful系统中最著名的例子就是万维网。
  1. SOAPSOAP或简单对象访问协议是一种消息协议,用于在计算机网络中执行Web服务时共享结构化信息。它与XML信息集和应用程序层协议(如HTTPSMTP)一起使用,分别用于消息格式和消息协商与传输。
  1. 延迟:延迟定义为API从请求到响应的过程中所花费的总时间。
  1. 速率限制API速率限制是指定义最终用户可以访问API的速率的过程。也就是说限制用户每次可以向API发送的请求数。
  1. API限流:调节用户在特定时间段内使用API的过程称为限流。这可以用于API限制,比如,设置每天限制1000个API请求,当用户点击1001个请求时,服务器会返回429HTTP状态码,并带着“请求太多”的消息。

三、API的工作流程

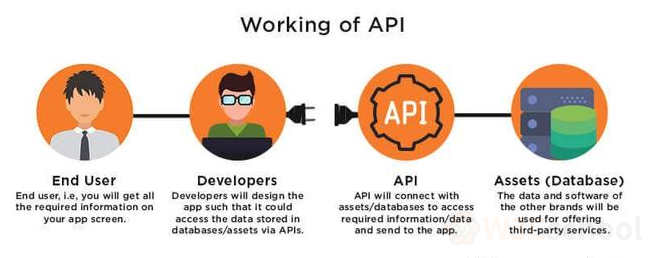
假如打开一些旅游应用程序/网站来预订航班,再填写了表格——输入了出发和返回日期,城市,航班以及其他相关详细信息——并提交了。只需几秒钟,屏幕上就会显示航班清单以及价格,时间,座位可用性以及其他详细信息。

为了提供这样严格的数据,该平台向航空公司的网站发送了请求,以访问其数据库并通过API获取相关数据。网站以API形式传递给平台数据作为响应,平台将其显示在屏幕上,基本的过程如下:

在此,航班预订应用程序/平台和航空公司的网站充当端点(EndPoint),而API充当简化数据共享过程的中介。在谈论端点通信时,API有两种形式,即RESTSOAP。尽管这两种方法都能带来有效的结果,但目前移动应用开发程序更喜欢使用REST而不是SOAP,因为SOAP API繁重且依赖于平台。

下面就介绍一下如何开发API?选择哪些工具和技术?

四、开发API的工具

在开发API的过程中有许多工具和技术可以使用,下面介绍几个用于为开发人员开发API的流行工具:

  1. Apigee:它是GoogleAPI管理工具,通过重新建立API方法来帮助开发人员和企业家在数字化转型方面取得成功。
  1. APIMatic and API Transformer:提供了复杂的自动生成工具,通过API特定格式构建高质量的SDK和代码片段,并将其转换为其他规范的形式,如RAMLAPI Blueprint等等。
  1. API Science:该工具主要用于评估内部API和外部API的性能。
  1. API Serverless Architecture:该产品借助云的服务器基础架构协助移动应用程序开发人员设计、构建、发布和托管API。
  1. API Platform:这是一个适用于Web API开发的开源PHP框架。
  1. OAuth2:这是一种用于身份验证和授权API的身份管理解决方案。
  1. ClearBlade:这是一个API管理程序,用于将IOT技术融入流程中。
  1. GitHub:这是一个开源的Git存储库,用来托管代码服务,可以提交代码、发布请求,版本控制。还可以将代码保存在私有存储库中。
  1. Postman:这是一个API工具链,使开发人员能够运行、测试、记录和评估其API的性能。

五、高效API的特性

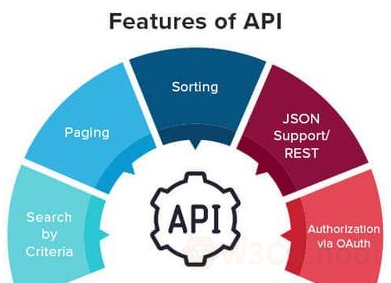
  1. 修改时间戳/按条件搜索API应该允许用户根据不同的条件(例如日期)搜索数据,并能对检索的数据进行修改(更新,编辑和删除),并能记录修改的时间戳。
  1. 分页:当数据量很大的时候,我们不希望每次都获取完整的数据列表。在这种情况下,API应该能够确定一次显示多少数据以及总页数,还应告知最终用户剩余的数据页数。
  1. 排序API应授权用户根据修改时间或其他条件对数据进行排序。
  1. JSON支持/ REST:尽量使用RESTful风格进行有效的API开发。REST API是无状态的,轻量级的。此外,JSON的语法类似于大多数编程语言的语法,这使移动应用程序开发人员可以轻松地将其解析为任何其他语言。
  1. 通过OAuth进行授权:由于API需要对外暴露,因此还需要通过OAuth进行授权-您只需单击一个按钮即可完成。

六、构建API的最佳实践

  1. 流量限制:流量限制是考虑流量溢出,并保护其免受Dos攻击的一种好习惯。
  1. 将API网关视为增强点:在设置限制规则、API 秘钥和OAuth的应用时,必须将API网关视为最佳实施点。只有正确的、合法的用户才能访问后面的数据,并能在网关这里加密消息或编辑私密消息,从而分析和管理API
  1. 允许覆盖HTTP方法:由于某些代理仅支持GETPOST方法,因此需要让RESTful API 覆盖HTTP方法,可以使用自动以HTTPX-HTTP-Method-Override
  1. 评估API和基础结构:当前,实时分析是可以实现的,但是如果API服务器存在内存泄漏、CPU耗尽或其他问题该怎么办?考虑到这种情况,可以使用一些工具来对API进行评估和排查。
  1. 文档:为API编写文档,可以使用OpenAPI的规范的格式,这样其他应用程序开发人员可以轻松的了解整个过程并利用这些信息来提供更好的用户体验。总之,良好的API文档可以减少项目实施的时间,提供API开发的效率。

以上就是一份关于API开发的指南文档了,希望对大家有所帮助。想了解更多的话,可以看一下相关文档

io.js API 中文文档:https://www.w3cschool.cn/fkcaso/

Fetch API官方文档:https://www.w3cschool.cn/fetch_api/

文章参考来源:appinventiv.com/blog/complete-guide-to-api-development/

带你认识Linux中的ELF文件

thbcm阅读(316)

Linux系统使用过程中,我们经常会看到elf32-i386ELF 64-bit LSB等字样。那么究竟ELF是什么呢?

几种常见的ELF文件

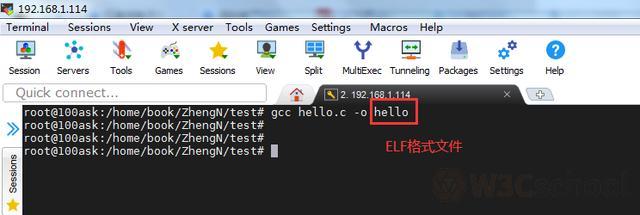
Linux下,我们经gcc编译之后生成的可执行文件属于ELF文件:

ELF是一类文件类型,而不是特指某一后缀的文件。ELF(Executable and Linkable Format,可执行与可链接格式)文件格式,在Linux下主要有如下三种文件:

  • 可执行文件(.out)Executable File,包含代码和数据,是可以直接运行的程序。其代码和数据都有固定的地址 (或相对于基地址的偏移 ),系统可根据这些地址信息把程序加载到内存执行。
  • 可重定位文件(.o文件)Relocatable File,包含基础代码和数据,但它的代码及数据都没有指定绝对地址,因此它适合于与其他目标文件链接来创建可执行文件或者共享目标文件。
  • 共享目标文件(.so)Shared Object File,也称动态库文件,包含了代码和数据,这些数据是在链接时被链接器(ld)和运行时动态链接器(ld.so.l、libc.so.l、ld-linux.so.l)使用的。

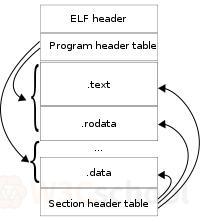
ELF格式可结构大致为:

ELF文件由4部分组成,分别是ELF头(ELF header)、程序头表(Program header table)、节(Section)和节头表(Section header table)。

实际上,一个文件中不一定包含全部内容,而且它们的位置也未必如同所示这样安排,只有ELF头的位置是固定的,其余各部分的位置、大小等信息由ELF头中的各项值来决定。

readelf工具的使用

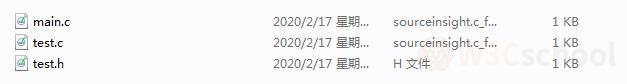
Linux下,我们可以使用readelf 命令工具可以查看ELF格式文件的一些信息。下面我们先准备一个动态链接相关的demo:

文件1(main.c)

include “test.h”


int main(void)
{
    print_hello();
    return 0;
}

文件2(test.c)

include “test.h”

void print_hello(void) { printf(“hello world\n”); }

文件3(test.h)

ifndef __TEST_H

#define __TEST_H


#include <stdio.h>


void print_hello(void);


#endif

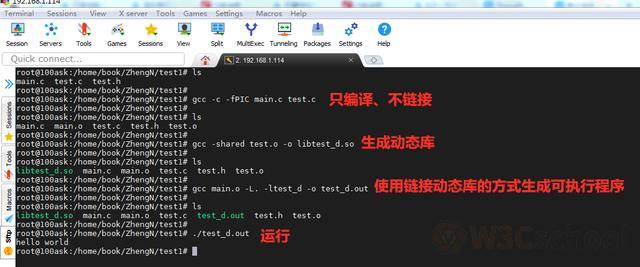
执行相关命令生成相关文件:.out文件.o文件.so文件。如:

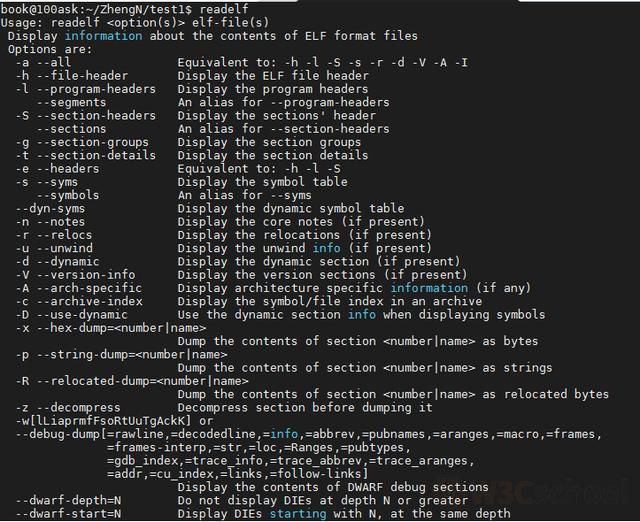
下面我们使用readelf命令来查看这三类文件的一些信息。readelf命令格式为:

readelf <option(s)> elf-file(s)

查看可执行文件头部信息:

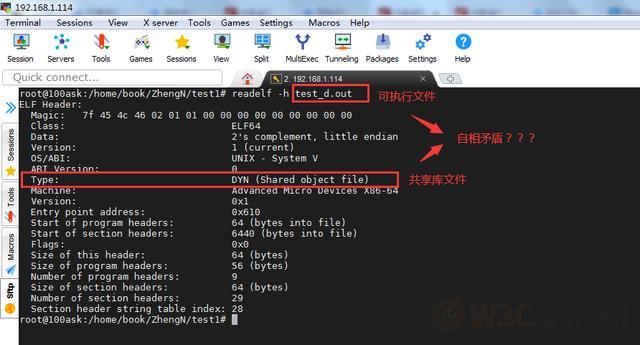
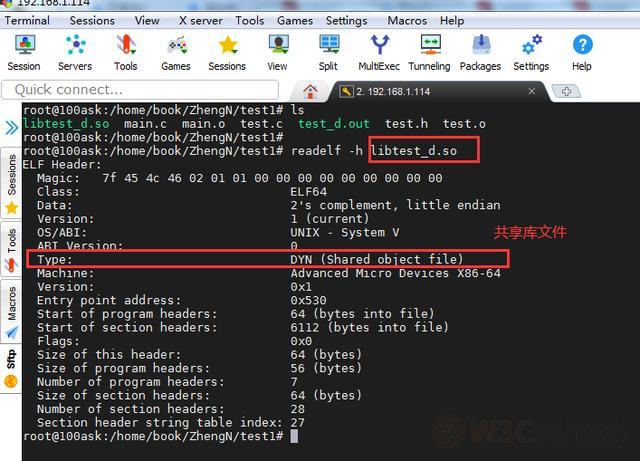
查看可执行文件头部信息是,我们发现这样一个问题,头部信息中的类型竟然是共享库文件,而我们查看的是可执行文件,自相矛盾?

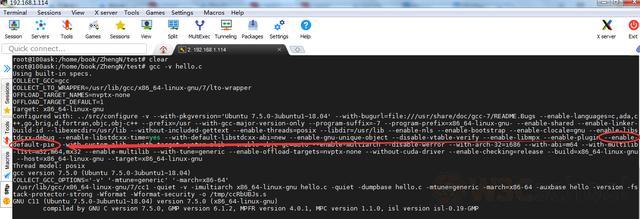
查了一些资料发现:gcc编译默认加了--enable-default-pie选项:

Position-Independent-ExecutableBinutilsglibcgcc的一个功能,能用来创建介于共享库和通常可执行代码之间的代码–能像共享库一样可重分配地址的程序,这种程序必须连接到Scrt1.o。标准的可执行程序需要固定的地址,并且只有被装载到这个地址时,程序才能正确执行。PIE能使程序像共享库一样在主存任何位置装载,这需要将程序编译成位置无关,并链接为ELF共享对象。

引入PIE的原因是让程序能装载在随机的地址,通常情况下,内核都在固定的地址运行,如果能改用位置无关,那攻击者就很难借助系统中的可执行码实施攻击了。类似缓冲区溢出之类的攻击将无法实施。而且这种安全提升的代价很小。

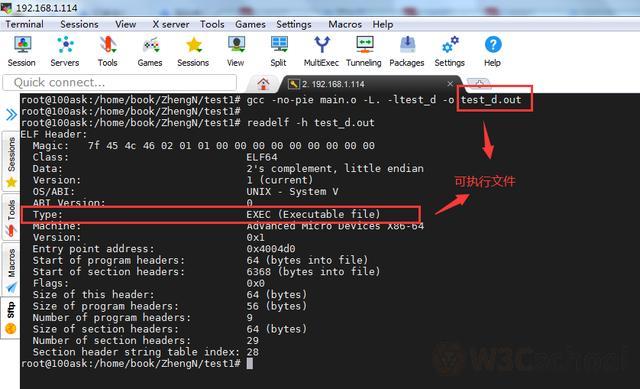
也就是说,pie这是一种保护我们可执行程序的一种手段。这里我们只是做实验,我们可以加-no-pie参数先把pie给关掉:

可以看到,类型终于对得上了。ELF头部信息还包含有Entry point address(入口地址)、Start of program headers(程序头的起始字节)、Start of section headers(节头的起始字节)等信息。

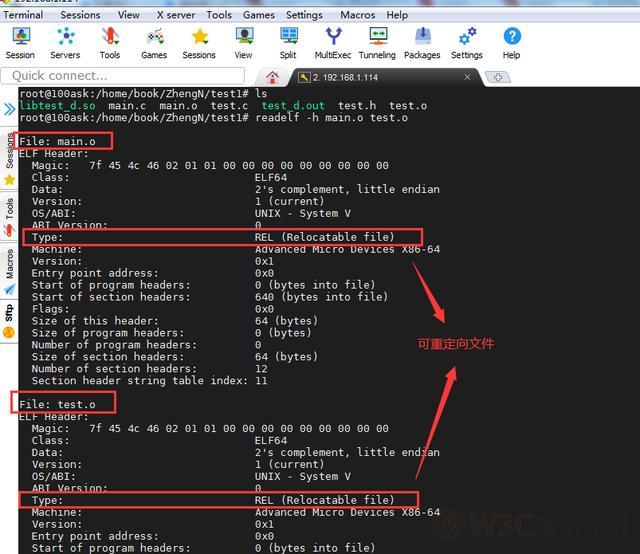
查看可重定位文件头部信息:

查看共享目标文件头部信息:

同样的,readelf 搭配其它参数可以查看ELF文件的其它信息:

objdump工具的使用

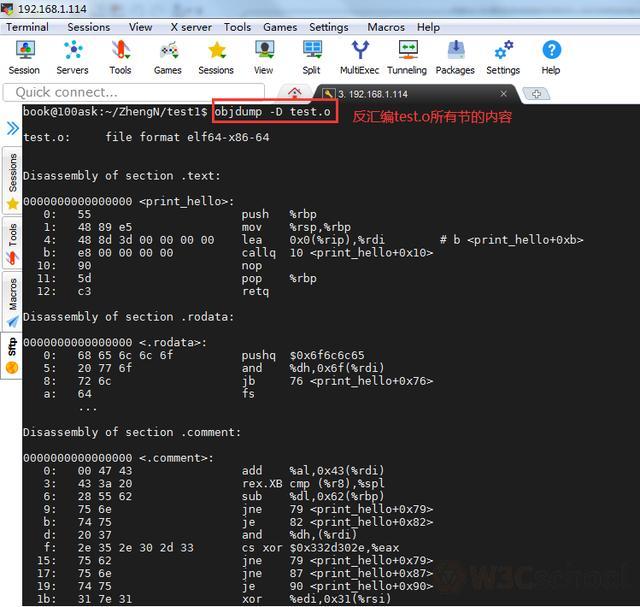
objdump工具用于显示一个或多个目标文件的信息。objdump命令格式:

objdump <option(s)> <file(s)>

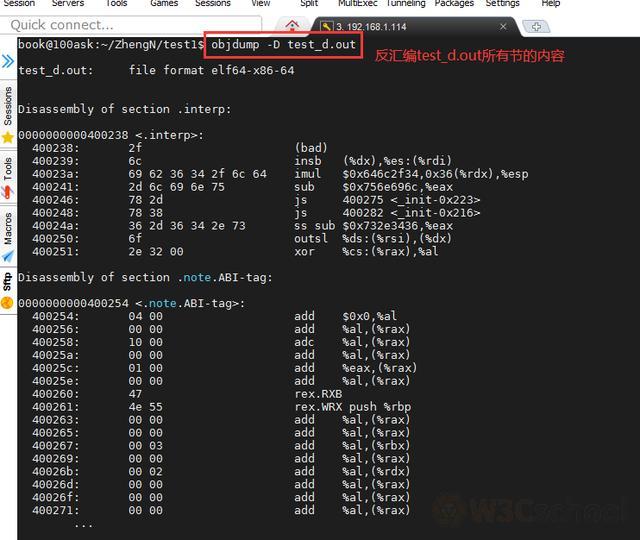
可执行文件、可重定位文件与共享目标文件都属于目标文件,所以都可以使用这个命令来查看一些信息。

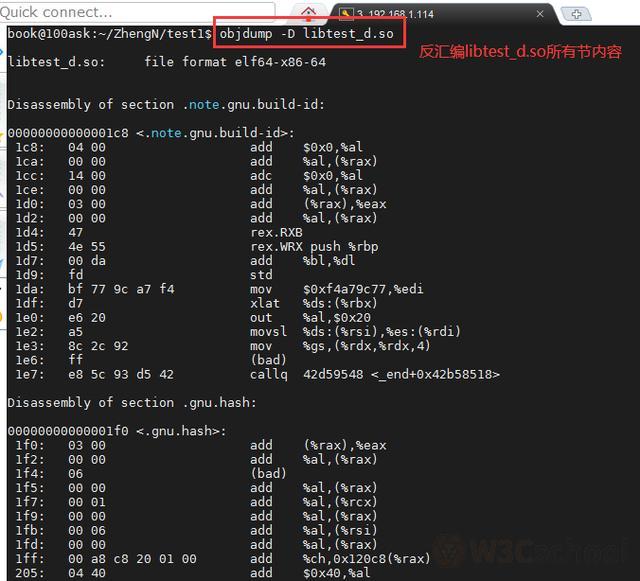
查看可重定位文件反汇编信息:

查看可执行文件反汇编信息:

查看共享目标文件反汇编信息:

总结

以上就是本次的分享。简单地介绍了ELF文件的一些信息,同时介绍了分析ELF文件的两个工具。ELF文件的内容很多,并且比较抽象,详细分析起来是个深坑。我们大致先进行一个简单的了解,我现在还没有这个能力或者说还没有这个需求去学习、分析这些底层的东西,之后如果深入学习时再做另外的分享。有兴趣的同学可以跟我一起学

Linux教程:https://www.w3cschool.cn/linux/

Linux微课:https://www.w3cschool.cn/minicourse/play/linuxcourse

Linux就该这么学:https://www.w3cschool.cn/linuxprobe/

JavaScript如何实现深拷贝

thbcm阅读(341)

JavaScript 开发工作中,我们经常会碰到需要进行深拷贝的情况,而且在面试中也经常会问到这个问题,那么什么是浅拷贝,什么是深拷贝?

什么是浅拷贝

关于浅拷贝的概念,我在网上看到一种说法,直接上代码。

var person = {name: "Jason", age: 18, car: {brand: "Ferrari", type: "430"}};
var person1 = person;       //他们认为这是浅拷贝

但是我个人认为,上面这个根本不涉及拷贝,只是一个简单的引用赋值。以我的理解,浅拷贝应该是不考虑对象的引用类型的属性,只对当前对象的所有成员进行拷贝,代码如下:

function copy(obj){
    var objCopy = {};
    for(var key in obj){
        objCopy[key] = obj[key];
    }
    return objCopy;
}


var person = {name: "Jason", age: 18, car: {brand: "Ferrari", type: "430"}};
var personCopy = copy(person);

上面这段代码中,person对象拥有两个基本类型的属性nameage,一个引用类型的属性car,当使用如上方法进行拷贝的时候,nameage属性会被正常的拷贝,但是car属性,只会进行引用的拷贝,这样会导致拷贝出来的对象personCopyperson会共用一个car对象。这样就是所谓的浅拷贝。

什么是深拷贝

深拷贝的就是在拷贝的时候,需要将当前要拷贝的对象内的所有引用类型的属性进行完整的拷贝,也就是说拷贝出来的对象和原对象之间没有任何数据是共享的,所有的东西都是自己独占的一份。

如何实现深拷贝

实现深拷贝需要考虑如下几个因素:

  • 传入的对象是使用对象字面量{}创建的对象还是由构造函数生成的对象
  • 如果对象是由构造函数创建出来的,那么是否要拷贝原型链上的属性
  • 如果要拷贝原型链上的属性,那么如果原型链上存在多个同名的属性,保留哪个
  • 处理循环引用的问题

第三方库实现深拷贝

jQuery的$.extend()

我们可以通过$.extend()方法来完成深复制。值得庆幸的是,我们在jQuery中可以通过添加一个参数来实现递归extend。调用$.extend(true, {}, ...)就可以实现深复制,参考下面的例子:

var x = {
    a: 1,
    b: { f: { g: 1 } },
    c: [ 1, 2, 3 ]
};


var y = $.extend({}, x),          //shallow copy
    z = $.extend(true, {}, x);    //deep copy


y.b.f === x.b.f       // true
z.b.f === x.b.f       // false

但是jQuery的这个$.extend()方法,有弊端,什么弊端呢?我们看下面的例子:

var objA = {};
var objB = {};


objA.b = objB;
objB.a = objA;


$.extend(true,{},a);


//这个时候就出现异常了
//Uncaught RangeError: Maximum call stack size exceeded(…)

也就是说,jQuery中的$.extend()并没有处理循环引用的问题。

使用JSON对象实现深拷贝

使用JSON全局对象的parsestringify方法来实现深复制也算是一个简单讨巧的方法。

function jsonClone(obj) {
    return JSON.parse(JSON.stringify(obj));
}
var clone = jsonClone({ a:1 });

然而使用这种方法会有一些隐藏的坑,它能正确处理的对象只有 Number, String, Boolean, Array, 扁平对象,即那些能够被 json 直接表示的数据结构。

自己造轮子

下面我们给出一个简单的解决方案,当然这个方案是参考别人的方式来实现的。希望对大家有用。

var clone = (function() {
    //这个方法用来获取对象的类型 返回值为字符串类型 "Object RegExp Date Array..."
    var classof = function(o) {
        if (o === null) {
            return "null";
        }
        if (o === undefined) {
            return "undefined";
        }
        // 这里的Object.prototype.toString很可能用的就是Object.prototype.constructor.name
        // 这里使用Object.prototype.toString来生成类型字符串
        var className = Object.prototype.toString.call(o).slice(8, -1);
        return className;
    };


    //这里这个变量我们用来存储已经保存过的属性,目的在于处理循环引用的问题
    var references = null;


    //遇到不同类型的对象的处理方式
    var handlers = {
        //正则表达式的处理
        'RegExp': function(reg) {
            var flags = '';
            flags += reg.global ? 'g' : '';
            flags += reg.multiline ? 'm' : '';
            flags += reg.ignoreCase ? 'i' : '';
            return new RegExp(reg.source, flags);
        },
        //时间对象处理
        'Date': function(date) {
            return new Date(+date);
        },
        //数组处理 第二个参数为是否做浅拷贝
        'Array': function(arr, shallow) {
            var newArr = [],
            i;
            for (i = 0; i < arr.length; i++) {
                if (shallow) {
                    newArr[i] = arr[i];
                } else {
                    //这里我们通过reference数组来处理循环引用问题
                    if (references.indexOf(arr[i]) !== -1) {
                        continue;
                    }
                    var handler = handlers[classof(arr[i])];
                    if (handler) {
                        references.push(arr[i]);
                        newArr[i] = handler(arr[i], false);
                    } else {
                        newArr[i] = arr[i];
                    }
                }
            }
            return newArr;
        },
        //正常对象的处理 第二个参数为是否做浅拷贝
        'Object': function(obj, shallow) {
            var newObj = {}, prop, handler;
            for (prop in obj) {
                //关于原型中属性的处理太过复杂,我们这里暂时不做处理
                //所以只对对象本身的属性做拷贝
                if (obj.hasOwnProperty(prop)) {
                    if (shallow) {
                        newObj[prop] = obj[prop];
                    } else {
                        //这里还是处理循环引用的问题
                        if (references.indexOf(obj[prop]) !== -1) {
                            continue;
                        }


                        handler = handlers[classof(obj[prop])];
                        //如果没有对应的处理方式,那么就直接复制
                        if (handler) {
                            references.push(obj[prop]);
                            newObj[prop] = handler(obj[prop], false);
                        } else {
                            newObj[prop] = obj[prop];
                        }
                    }
                }
            }
            return newObj;
        }
    };


    return function(obj, shallow) {
        //首先重置我们用来处理循环引用的这个变量
        references = [];
        //我们默认处理为浅拷贝
        shallow = shallow === undefined ? true : false;
        var handler = handlers[classof(obj)];
        return handler ? handler(obj, shallow) : obj;
    };
}());


(function() {
    //下面是一些测试代码
    var date = new Date();
    var reg = /hello word/gi;
    var obj = {
        prop: 'this ia a string',
        arr: [1, 2, 3],
        o: {
            wow: 'aha'
        }
    };
    var refer1 = {
        arr: [1, 2, 3]
    };
    var refer2 = {
        refer: refer1
    };
    refer1.refer = refer2;


    var cloneDate = clone(date, false);
    var cloneReg = clone(reg, false);
    var cloneObj = clone(obj, false);
    alert((date !== cloneDate) && (date.valueOf() === cloneDate.valueOf()));
    alert((cloneReg !== reg) && (reg.toString() === cloneReg.toString()));
    alert((obj !== cloneObj) && (obj.arr !== cloneObj.arr) && (obj.o !== cloneObj.o) && (JSON.stringify(obj) === JSON.stringify(cloneObj)));


    clone(refer2, false);
    alert("I'm not dead yet!");
    // Output:
    // true
    // true
    // true
    // I'm not dead yet!
}());

以上就是关于JavaScript拷贝的一些知识了,希望对大家有所帮助,对JavaScript有兴趣的同学可以看一下教程

JavaScript教程:https://www.w3cschool.cn/javascript/

JavaScript微课:https://www.w3cschool.cn/minicourse/play/jscourse

jQuery中的prop和attr区别在哪

thbcm阅读(727)

JQuery中,对CheckBox的操作分两个阶段,一个是JQuery1.6之前的版本,一个是1.6之后的版本

在1.6之前,我们这么做:

<input type =’checkbox’ id=’checkbox’/> <script> var isChecked = $(‘#checkbox’).attr(‘checked’); $(‘#checkbox’).attr(‘checked’,true); <script/>

但是细心的同学会发现,在jQuery1.6之后,如果还像上面这么做,那肯定会出问题: $('#checkbox').attr('checked');获取到的值并不是truefalse,而是checked或者undefined

那在1.6之后如何进行操作呢?

jQuery在之后的版本中对属性和特性进行了比较细致的区分,什么是特性呢? 特性就是像 checkedselectedIndex, tagName, nodeName, nodeType, ownerDocument, defaultChecked, 和defaultSelected等等这些。

那prop()和attr()到底有什么区别呢?

build-in属性,attributeproperty共享数据,attribute更改了会对property造成影响,反之亦然,但是两者的自定义属性是独立的数据,即使name一样,也互不影响,看起来是下面这张图,但是IE6、7没有作区分,依然共享自定义属性数据

并不是所有的attribute与对应的property名字都一致,比如刚才使用的attributeclass属性,使用property操作的时候应该是这样className t.className='active2';

对于值是true/falseproperty,类似于inputchecked attribute等,attribute取得值是HTML文档字面量值,property是取得计算结果,property改变并不影响attribute字面量,但attribute改变会一向property计算 <input id="test3" type="checkbox"/>

var t=document.getElementById(‘test3’); console.log(t.getAttribute(‘checked’));//null console.log(t.checked);//false


  t.setAttribute('checked','checked');
  console.log(t.getAttribute('checked'));//checked
  console.log(t.checked);//true


  t.checked=false;
  console.log(t.getAttribute('checked'));//checked
  console.log(t.checked);//false

对于一些和路径相关的属性,两者取得值也不尽相同,但是同样attribute取得是字面量,property取得是计算后的完整路径 <a id="test4" href="#">Click</a> js var

var t=document.getElementById(‘test4’); console.log(t.getAttribute(‘href’));//# console.log(t.href);//file:///C:Users/bsun/Desktop/ss/anonymous.html#

以上就是关于jQuery中的prop()attr()有什么区别的相关知识,希望对大家有所帮助,感兴趣的同学可以看一下教程

jQuery教程:https://www.w3cschool.cn/jquery/

jQuery微课:https://www.w3cschool.cn/minicourse/play/jquerycourse

面试冷知识,Redhat红帽/CentOS服务器的Linux内核实时系统

thbcm阅读(337)

本文分享了程序员面试关于 Linux 内核实时系统的冷知识。希望能让大家增长一点知识。

背景知识

Linux的调度策略包括SCHED_FIFO and SCHED_RR 和SCHED_OTHER

  • SCHED_FIFO(Round-robin线程调度策略)和SCHED_RR是“实时”策略。实现POSIX标准规定的固定优先级实时调度(fixed-priority real-time scheduling)。按照这些策略的任务会抢占其他所有任务。因为是抢占,如果它们不释放CPU,所以很容易使得某些低级别的任务得不到执行。
  • SCHED_FIFOSCHED_RR 之间的区别在于:在相同优先级的任务中,SCHED_RR 执行 round-robin 分配,每个任务都得到相同的cpu时间片策略。而SCHED_FIFO需要任务主动放弃cpu时间片。
  • SCHED_OTHER是常见的循环式分时调度策略,该调度策略根据系统中运行的其他任务为某个时间的调度任务。

SCHED_RR和SCHED_FIFO的问题:

红帽企业版Linux实时版中的两种实时调度策略具有一个主要特征:直到被更高优先级的线程抢占或直到它们“等待”(sleep/休眠或执行I/O)线程会一直运行。如果是SCHED_RR,在SCHED_RR优先级相同的线程中,操作系统可能会抢占一个线程,让另一个线程得以执行。

POSIX规范没有规定允许低优先级线程获得任何CPU时间的策略。

实时线程的这种特性意味着编写一个霸占100%的CPU的应用程序非常容易。乍一看,好像榨干了服务器是个不错的想法,但实际上,它引起了操作系统的许多问题。操作系统负责管理系统范围的资源和按CPU的资源,并且必须定期检查描述这些资源的数据结构,并对其执行内部管理活动。如果内核被SCHED_FIFO线程垄断,则它无法执行内务处理任务,最终整个系统将变得不稳定,从而可能导致崩溃。

中断处理程序以具有SCHED_FIFO优先级的线程(默认值:50)运行。具有或策略高于中断处理程序线程的cpuxiao hao x线程可能会阻止中断处理程序运行,并导致程序等待那些由中断发出的数据,从而使该程序饿死并失败。

红帽/CentOS的特殊策略/实时节流机制

在红帽企业版实时系统内核中,有个实时节流机制/SCHED_FIFOSCHED_RR限制实时调度的调度策略(real-time scheduler throttling)。

红帽企业版实时Linux内核带有一种保护机制,该机制使系统管理员可以分配资源配额以供实时任务使用。这个配额机制引入,算是一个保护机制。

这个机制用/proc文件系统中的两个参数控制。

/proc/sys/kernel/sched_rt_period_us定义时间周期,以微秒为单位,相当于100%的CPU资源带宽。默认值为1,000,000μs(1秒)。谨慎更改该时间段,时间段过长或太小都将危险。

/proc/sys/kernel/sched_rt_runtime_us定义所有实时任务可用的总带宽。默认值为950,000μs(0.95 s),即CPU带宽的95%。将该值设置为-1意味着实时任务最多可能占用100%的CPU时间。仅当在特殊场景实时任务经过精心设计并且没有明显的隐患(比如没有无限制的轮询循环)时,才可以这样配置。

对于实时调节机制的默认值定义的CPU时间的95%,意思是95%的cpu时间片可以通过实时任务中使用。剩余的5%将用于非实时任务(在SCHED_OTHER类似的调度策略下运行的任务)。而且需要注意,如果单个实时任务占用了95%的CPU时隙,则该CPU上剩余的实时任务将不会运行。剩下的5%的CPU时间仅由非实时任务使用。

默认值的设置带来两个好处:流氓实时任务不会通过不允许非实时任务运行来锁定系统,另一方面,实时任务最多具有95%的CPU他们的可用时间,可能会最大化效能。

聪明做法RT_RUNTIME_GREED

尽管SCHED_FIFOSCHED_RR/实时节流机制的工作原理是避免实时任务可能导致系统挂起,但是高级用户可能希望在没有非实时任务匮乏的情况下允许实时任务继续运行, 避免系统闲置。

启用后,此功能会在限制实时任务之前检查非实时任务是否饿死。如果实时任务被限制,则在系统空闲时或下一个周期开始时(以先到者为准),它将立即取消限制。

RT_RUNTIME_GREED通过以下命令 启用:

#echo RT_RUNTIME_GREED> /sys/kernel/debug/sched_features

要使所有CPU核都具有相同的rt_runtime,请禁用NO_RT_RUNTIME_SHARE逻辑:

#echo NO_RT_RUNTIME_SHARE> /sys/kernel/debug/sched_features

设置了这两个选项后,用户将保证所有CPU上的非RT任务都有一定的运行时间,同时使实时任务尽可能多地运行。

希望这个冷知识对大家有所帮助,对Linux感兴趣的同学可以看一下教程:

Linux教程:https://www.w3cschool.cn/linux/

Linux微课:https://www.w3cschool.cn/minicourse/play/linuxcourse

Linux就该这么学:https://www.w3cschool.cn/linuxprobe/

单元测试到底值不值得写?

thbcm阅读(461)

作为一名程序员,单元测试应该听过,但是很多同学没有用的过,可能是对单元测试有一些误解,例如:

  • 写单元测试需要花费更多的时间,我每天写产品代码都要加班,哪来时间写测试;
  • 写单元测试收益不大,还不是一样有bug;
  • 写单元测试有负担,改产品代码的结构,还得去改测试代码。

先尝试解答这几个问题。

写单元测试会花费更多的时间,这点描述其实不准确。准确地说,写单元测试需要花费更多「写代码的时间」,这点没什么可说的,毕竟要多写一些测试代码。但一个程序员,做一个需求的时候,花在纯写代码的时间其实不多。你得理以前代码的逻辑,设计类和方法,然后才是写代码,写完了再手动测试,可能有bug还要去debug,再修复,再测试。「真正写代码的时间,其实是很少的」。使用单元测试虽然可能占用了更多写代码的时间,但它可以帮你缩短其它时间,「会让你做这个需求花费的总时间更少」。

写单元测试会有bug吗?当然可能有了,我们是无法做到真正的bug free的,但是单元测试写好了,可以显著减小bug的数量。因为写单元测试发现bug的成本是非常低的,它可以在开发阶段就发现bug,而且可以测试很多边界的条件。但如果你「对需求和业务的认知本来都是有误」的,这是单元测试解决不了的,自然会产生bug。话说回来,写单元测试的收益远不止发现bug这么简单,它还具有「代码文档」的功能,以及「重构的安全网」存在。甚至它还可以帮你「理需求」,「设计代码」。

改产品代码需要维护对应的测试代码,这确实是带来了额外的成本。不过借助编辑器的「重构功能」,可以比较方便地批量修改需要修改的地方,其实代价没有想象中的那么大。而且重构后,再跑一遍单元测试,看哪些挂掉了,可以double-check你改的产品代码有没有问题。如果我们把单元测试当成是「产品代码的文档」来看,大概就更能够接受这个维护的成本了。

为什么需要单元测试?

前面提到,单元测试有很多功能。个人觉得单元测试最大的作用是“代码文档”和“重构安全网”。毕竟软件开发的漫长过程中,总少不了修修改改。如果没有足够的测试,改一段代码就像是在排地雷,改完后心里也总是打鼓,上线前需要先默默拜个神,生怕触发了什么bug

但如果有足够的测试(不只是单元测试),改完代码后可以跑一遍测试,看哪些挂掉了,是不是自己的改动导致的,该怎么修好测试。这样心里就有底气多了。

要知道,代码写出来是给人看的。而测试比产品代码更友好,因为它简单,直白,站在使用者的视角来描述,所以如果想要了解一段产品代码具有什么功能,看它的单元测试会更直观,更舒服。

很多团队会做测试,但绝大多数测试的工作是在开发后,由专门的测试同学去负责端到端的测试或者API测试。其实端到端的测试成本是非常大的,尤其是对于某些边界条件,构造数据和场景是非常麻烦的。而且一旦发现了bug,再去沟通,修改,提交,部署,需要花费很多时间。

而单元测试最大的优势就是“成本低”,想要测试产品代码的每个分支都比较容易,而且单元测试一般是开发同学自己写,可以用最小的时间发现bug,用最低的成本修改bug

什么是单元测试?

测试金字塔

并不是所有测试都是单元测试,测试其实分成很多种。业界比较广泛传播的“测试金字塔”描述了它们的区别和关系:
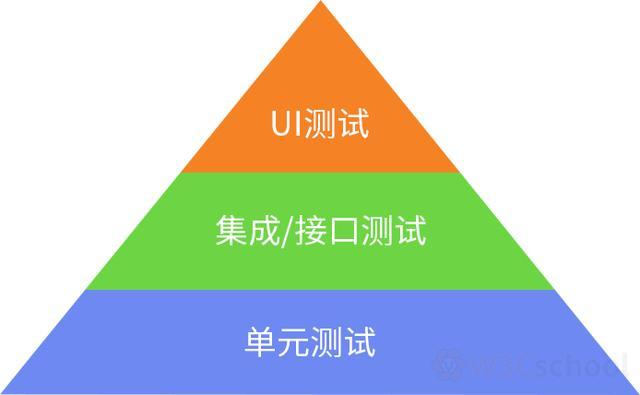
从测试金字塔模型来看,越在底层的测试,覆盖面应该更广,成本更低。单元测试处于测试金字塔的最低端,是整个测试金字塔的基础。

当然了,测试金字塔并不一定只有三层,中间可能会有其它的测试,比如“契约测试”等。

单元测试的特点

单元测试就像它的名字一样,“单元”(Unit),足够小,足够快,无依赖。单元测试只测你想测的那部分产品代码的逻辑,一个单元测试应该只测一个简单的业务逻辑。一般来说,运行一个单元测试是很快的,基本上在几毫秒到几十毫秒之间。如果有依赖的类,可以mock其他类,消除外部依赖。

什么不是单元测试?

很多同学容易将其他测试与单元测试搞混,最常见的是会启动Spring上下文的集成测试。比如使用@SpringBootTest注解可以启动Spring上下文,这可以测试依赖是否正常注入等Spring的功能,但运行一次需要耗费很多时间(因为要启动Spring上下文),也并不是真正的“单元测试”,因为它依赖了Spring框架。

如何写单元测试

那具体如何写单元测试呢?我们业界有一个叫做「TDD」(测试驱动开发)的方法论。TDD的核心在于“驱动”二字,它的理念是从测试视角出发,通过测试驱动出来产品代码。而在测试金字塔中,单元测试与开发人员最息息相关,所以这里的“测试”一般是指的单元测试。

TDD大概分这几个步骤:

  1. 理清需求
  1. 设计类和方法的出参和入参
  1. 写测试代码
  1. 驱动出产品代码
  1. 重构,循环3-5步。

首先要理清楚需求,因为只有理清楚了需求,才能保证我们使用TDD驱动出来的代码是跟业务期望的一致的。然后第二步是设计类和方法的过程,也称为Task List。这一步可以设计好类与类之间的关系,方法的出参和入参。其实不使用TDD也会有前面这两个步骤,只不过使用TDD的话,可以帮助你更好地从业务视角出发,先把该设计的东西都设计好,避免直接上手写代码,写到一半的时候觉得不对,再去改。

3-5步其实是一个循环的过程。因为刚开始写代码可能并没有太注意代码的格式、风格、性能,一气呵成写得比较快,让测试通过。等测试通过后,可以回过头来重构一下之前写的代码,重构后再跑一遍所有的单元测试,看是否有挂掉的单元测试,以此来检测重构是否对期望的输入输出有影响。

单元测试的结构

一个完整的单元测试,应该分为4个部分:

  1. 声明和参数
  1. 准备入参和mock
  1. 调用产品代码
  1. 验证,也叫断言

Java来说,单元测试框架有几个,最流行的应该是JUnitTestNG。笔者使用JUnit多一点,JUnit使用@Test注解在方法上来声明一个测试。JUnit最新版本是JUnit 5JUnit 5相较于上一个版本,在参数化测试方面做了很多改进,这样我们就不用写很多个高度相似的测试方法了(关于JUnit 5参数化测试,大家可以查看官方文档,也有对应的中文翻译,很方便阅读)。

一般来说,方法名需要尽可能可读,它可能比较长,但能够清晰地表述这个测试的意图,比如:

@Test void shouldReturn5WhenCalculateSumGiven2And3() {}


@Test
void should_return_5_when_calculate_sum_given_2_and_3() {}

具体使用驼峰命名法还是下划线,根据自己团队的规范来就好,尽量所有测试风格保持一致。(个人更喜欢下划线~)

入参一般是基本类型或者POJO对象,有些参数可以抽成变量,后面在验证阶段可能用得上。

如果产品代码有外部依赖,就需要用mock来消除外部依赖。常见的Mock框架有EasyMock、「Mockito」等,大家可以对比一下各个mock框架的区别,选择一个合适的。

很多同学刚开始写单元测试的时候不能理解为什么需要mock,觉得mock比较麻烦,甚至有点多此一举的感觉。其实不然,mock的意义在于,你「可以保证你的测试只测试了你要测的那部分代码」。这样如果测试不通过,你就可以知道一定是要测的那个方法有问题,不可能是外部依赖的问题,这样才能做到真正的“单元”化,才能保证每个测试足够小,足够纯粹。

准备好入参和mock后,会显式地调用一下要测的那个方法,这个一般只有简单的一行。

最后是验证,验证分为好几种,最常用的是验证出参是符合自己期望的。也有时候会验证异常等边界情况。JUnit等测试框架基本上自己带了验证的功能,但API都比较简单,个人感觉不是特别好用,推荐使用「AssertJ」,功能强大,API用起来也比较舒服。

举个例子吧:

@Test void shouldReturnUserWithOrgInfoWhenLoginWithUserId() { String userId = “userId”; String orgId = “orgId”; User user = UserFactory.getUser(userId); Org org = OrgFactory.getOrg(orgId); given(orgService.getOrgById(orgId)).willReturn(org);

    
    UserInfo userInfo = userService.login(userId);

    
    assertEquals(org, userInfo.getOrg());
}

单元测试常见问题

下面聊一聊单元测试常见的一些问题。

先写测试还是先写产品代码?

都可以。虽然有一种说法是TDD推荐的是先写测试,再写实现。但很多刚开始写单元测试的同学并不习惯这种方式。先写测试有一个好处,可以让你在设计代码的时候从业务视角去思考,而不是代码实现视角。大家可以尝试先写测试再写实现,体会一下这种感觉。

写单元测试需要花费大量额外的时间?

这个其实在文章开篇已经讨论过了。写单元测试确实会花费更多的“写代码”的时间,但是总的来说,它可以缩短整个需求开发周期的时间。所以写单元测试完全是一笔“划算的生意”。

什么代码最需要单元测试?

不自信的代码,逻辑复杂的代码,重要的代码。比如工具类、三层架构的Service层、DDD的聚合根和领域服务等,这些都应该写足够的单元测试。

入参对象构造太麻烦?

构造一个合适的入参对象比较麻烦,尤其是有些对象有非常多的参数,如果每个测试都要去从头构造的话,会让测试代码变得非常臃肿,可读性变差。这个时候可以使用工厂类来批量生产对象。这个工厂类放在测试目录下,并不会对生产代码造成影响。前面的例子里面,UserFactory就是一个User对象的工厂类。

返回值为void测什么?

返回值为void,说明方法没有出参,那方法内部必然有一些行为,它可能是「改变了内部属性的值」,也可能是「调用了某个外部类的方法」。

如果是改变内部的某个值,那可以通过对象的get参数来断言。这在使用DDD后的领域模型是一个问题,因为有可能本来产品代码不需要暴露出get方法的,但由于测试需要,暴露出了内部属性的get方法。虽然使用反射也可以拿到内部属性的值,但没有太大必要。权衡利弊,还是暴露领域模型的get方法好一点。

如果是调用某个外部的方法,可以用verify来验证是否调用了某个方法,可以用capture验证调用其它方法的入参。这样也可以验证产品代码是否如自己预期的设计在工作。

static方法如何mock?

static方法不好mock,需要用特殊的mock框架。比如PowerMockJMockit。一般来说,Utils类的方法很多是static的,我们用得很多的时间类LocalDateTime,获取当前时间,也是static的。这个时候需要用专门的mock框架来mock一下。

多线程如何测试?

多线程也不好测试。如果程序简单,可以用「睡眠」或者CountDownLatch等多线程工具类来辅助测试,等所有线程跑完,再统一验证。

如果程序相对复杂,需要使用专门的多线程测试框架,比如tempus-fugitThread WeaverMultithreadedTC、以及OpenJDKjcstress项目等。

关于具体的框架如何使用,以后有时间可以写一篇常用的注解的介绍。其实官方文档里面都有写,大家照着官网写几个例子就会了。比较推荐的基础套餐是junit 5 + mockito + assertj。关于static方法和多线程测试框架,大家有需要的时候再去了解也行。

想了解更多测试的看一下相关教程:

软件测试:https://www.w3cschool.cn/software_testing/

文章参考来源:www.toutiao.com/a6856755990545891848/

Linux的发展史:Stallman的GNU计划

thbcm阅读(389)

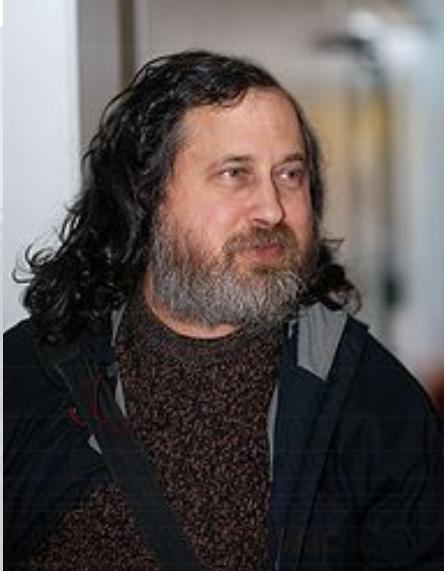
本文要说的是一个传奇人物————Richard Matthew Stallman,就是下图里这位不爱刮胡子的大叔。

Richard Matthew Stallman,1953年出生在美国纽约曼哈顿地区。在他生命的前十几年中,他并没有表现出什么过人的地方,但那是因为他没遇到一个叫做电脑的东西。

1 快乐的自由

高中的一个暑假,他去给IBM打工,花了两周的时间用Fortran语言编了一个数据处理的程序。这是他第一次接触计算机,或许就是这次相遇,确定了他未来行走的方向。1971年,他考上了哈佛大学,上学的同时,他还受聘于麻省理工学院的人工智能实验室,成为了一名职业黑客(黑客这个词没有贬义)。在人工智能实验室期间,他可没少干活,开发了很多有用的软件,其中最著名的就是Emacs编辑器。Emacs是一个可与Vi相抗衡的强大的编辑器。两者的操作方式完全不同,但同样强大,各自用自己独有的方式,提高着人们的编辑效率。直到今天,仍然有人争论到底Emacs好还是Vi好,信奉Emacs的人和信奉Vi的人形成了两个帮派,这两个帮派经常在互联网上用鼠标键盘相互灌水拍砖,拼个你死我活。哦,扯远了,咱还回来说Stallman

那时候的Stallman在人工智能实验室里工作得非常愉快,大家有BUG同当,有代码共享。那时候的软件工程师的世界,是一个“人人为我,我为人人”的理想世界。因为最初的计算机软件没有什么开源不开源的概念,那时候的软件天生就是自由的!卖计算机的同时会附带软件,包括软件的源代码和文档。计算机厂商卖的主要是计算机的硬件,软件只是附属品而已。用户可以根据自己的需要去修改软件,与别人分享软件。总之,软件是用户花钱买硬件时附带着买来的,用户想怎么玩就怎么玩。软件开发者的目的,也不是靠软件赚钱,而是靠软件支撑起硬件的功能,然后靠卖硬件赚钱。

2 自由逐渐远去

然而随着技术的发展,软件逐渐脱离硬件成为一个独立的产业,很多软件慢慢地只提供二进制代码而不提供源代码了,这就意味着你不能修改它,并且多数软件还规定最终用户没有二次分发的权利。也就是说,这东西你买了,只能你用,你再给别人就不行!这就好像我买了把菜刀,然后卖菜刀的告诉我“你这把菜刀不许借给你的邻居用,也不许私自给菜刀换刀把,否则我就告你!”

Stallman当时就遇到了类似这样的菜刀问题。那时候,他们实验室买的第一台打印机附带有驱动程序的源代码。他们那的黑客们可以随意修改这个驱动,根据自己的需要添加些小功能,改改BUG之类的,这为他们的工作带来了很大的方便。后来,实验室又买了一台激光打印机,这次厂商只提供了二进制的打印机驱动程序,它是实验室里仅有的一个没有源代码的软件。Stallman很不喜欢这样的产品,然而他没有选择,只能沉默。

后来出于工作的需要,Stallman想修改一下这个驱动程序,但是不行,没源代码啊。Stallman听说卡内基·梅隆大学有这个打印机的驱动程序源代码,他就去了那里,跟他们套近乎:“那啥,大家都是道上混的,谁还没个”马高蹬短”的时候?是兄弟的拉哥们儿一把,我也没啥事儿,就是我们那打印机老丢字,老把一些关键的字打成口口,我估计是驱动的问题,听说你们这有这驱动的源代码,能不能给我拷一份?”对方办事效率还是挺高的,很干脆地拒绝了他。因为他们和厂商签署了一份保密协议,协议要求他们不能向别人拷贝源代码。Stallman顿时感到他们背叛了自由的计算机社团,他非常生气,但是他没有办法改变什么,只好又选择了沉默。

这只是一件小事,只是一个时代的缩影。那个时代,正处在软件向私有化转变的过程中,也是软件逐渐商业化的过程。越来越多的软件选择了不开放源代码,不允许二次分发的发布方式。Stallman身边的同事,一个一个地跑到开发私有软件的公司去打工了,他们不再相互分享,不再相互交流。Stallman问:“你们那软件的查找算法做得不错啊,怎么实现的?”“对不起,无可奉告。”“你们的文档工具效率挺高啊。”“对不起,商业机密。”……面对这一切,Stallman又能说什么呢?他还是只有沉默。

3 不在沉默中爆发,就在沉默中灭亡

Stallman爆发了!他不能容忍软件世界里清新自由的空气被私有软件污染;他不能容忍被剥夺按照自己的需求修改软件的权利和乐趣;他不能容忍自己买条皮带尺寸不够时,自己竟然连在上面多打个洞的权利都没有!于是,他就爆发了。

他要重现当年那“人人为我,我为人人”的合作互助的软件世界;他要把使用、复制、研究、修改、分发软件的权利还给软件世界的每一个人民;他要用自己的行动告诉人们,软件天生就该是自由的!

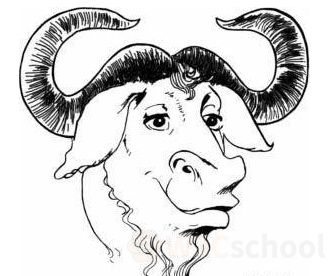
他要开辟一个新的世界,哪怕是一个人在战斗!于是,一个宏伟的计划——GNU计划在他心中产生了。它的目标是创建一套完全自由的操作系统。因为操作系统是电脑中最重要、最基础的软件,要创造自由的软件世界,自然先要有一套自由的操作系统,然后再以此系统为中心,开发各种各样自由的软件。1983年,Stallmannet.unix-wizards新闻组上公布了GNU计划,这个计划的标志是一头角马(也就是非洲牛羚),就是下图所示的这个。

提示:*GNU 是 “GNU is Not UNIX”的递归缩写,Stallman表示这个词应该读作/'gnu:/(发音类似“革奴”),以区别于表示非洲牛羚的单词gnu(发音与“new”相同)。

这个计划要创造一套自由的类UNIX操作系统。系统本身及系统上的软件都是自由软件,它们可以被免费获取,随意使用、修改和再分发。并且每个人都可以获得这个系统全部的源代码,每个人都可以为完善这个系统作出自己的贡献。这个系统要使用与UNIX相同的接口标准,这样,就可以由不同的人,分期分批地创作操作系统的不同部分而不必担心相互之间协同工作的问题。

4 实现GNU梦想

为了实施GNU计划,1985年,Stallman又创建了自由软件基金会。基金会的主要工作就是执行GNU计划,开发更多的自由软件。1989年,Stallman与基金会的一群律师们起草了广为使用的《GNU通用公共协议证书》也就是GPL协议,以此协议来保证GNU计划中所有软件的自由性。到了1990年,GNU计划中的这个系统已经初具规模,有了很多优秀的软件。其中有很多是世界各地的黑客们无偿提供的,也有一部分是利用自由软件基金会的基金雇用程序员来开发的,当然,Stallman自己也身先士卒,开发了EmacsGCCGDB等重要软件。当他看着这些丰富的自由软件的时候,感觉到那清新自由的空气,终于又回来了,以后,人们就可以拥有一个可以自由使用、自由修改、自由分发的、自由的操作系统了!不过等一下,好像还差点什么,哦,还……差个内核吧。

作为一个系统,没有内核是不行的,这么重要的部件Stallman当然不会忘记,所以才会有Hurd内核。这个内核被设计为一个遵守POSIX标准的微内核。所谓微内核,是相对于宏内核来说的。宏内核就像我们现在的Linux内核,是一个独立的程序,里面包含了进程管理、内存管理、文件管理等功能。而微内核则将一个内核需要的功能尽量地简化并且拆分,运行起来是几个独立的程序,有的专门负责进程管理,有的专门负责内存分配。内核是一个系统的核心,所以至关重要,StallmanHurd的开发也是精益求精,非常谨慎,以至于内核的进度有些落后于其他的系统软件,当其他软件都已经有比较优秀的版本的时候,Hurd内核依然不能够走出实验室投入真正的使用。这种情况一直持续到1991年,另一位英雄的出现——不过,这里先卖个关子,暂且不去说他。

无论怎样,到今天,Stallman理想中的自由世界,终于拉开了那沉重的幕布,展现出了自由的光彩。而Stallman并不满足,也确实没有满足的理由,这个自由的世界还需要成长,还需要更加丰富多彩,还需要有更多的人走进这个世界中来。于是Stallman奔走于世界各地,告诉人们有这么一个自由的世界,号召人们加入这个世界,鼓励人们为使这个世界更加自由而付出自己的力量。他是一个执着的苦行僧,为了他的梦想,为了他的自由世界,他会一直走下去……

以上就是Linux的发展史,Stallman和他的GNU计划。希望能扩展大家的知识面,然后对Linux有兴趣的同学可以看一下教程:

Linux教程:https://www.w3cschool.cn/linux/

Linux微课:https://www.w3cschool.cn/minicourse/play/linuxcourse

Linux就该这么学:https://www.w3cschool.cn/linuxprobe/

刷新你对进度条的认识,用python写出不一样的进度条

thbcm阅读(345)

1 简介

在日常工作中,我们运行程序经常会用到「循环迭代」,假如这个执行时间很短,那倒也无所谓。但是有一些过程耗时蛮长的,给其加上「进度条」(progress bar),可以帮我们监控代码执行进度,以及过程出现异常的情况,非常实用。这里为大家介绍Python中非常实用又风格迥异的两个进度条相关库——tqdmalive-progress的主要用法。

2 tqdm常用方法

tqdmPython中所有进度条相关库中最出名的,既然是最出名的,自然有它独到之处。

tqdm不仅可以生成基础的可在终端中显示的进度条,还可以配合jupyter notebookjupyter lab生成更加美观的网页「交互」部件形式的进度条,更是和pandas强强联手,为pandas中的一些操作提供专有的进度条功能。

下面我们来对tqdm的主要功能进行介绍。

2.1 基础用法

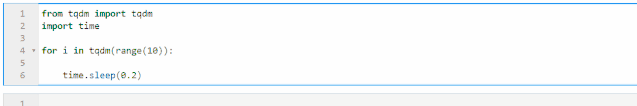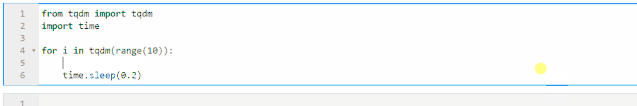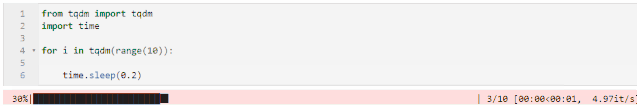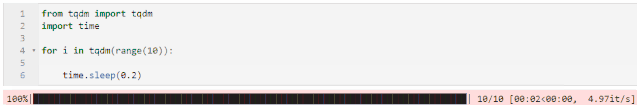
因为是第三方库,首先需要利用pip install tqdmconda install -c conda-forge tqdm对其进行安装,安装完成后先来看看它最基本的用法:

利用tqdm.tqdm,将for循环过程中进行迭代的对象简单包裹,就实现了为循环过程添加进度条以及打印执行速度、已运行时间与预估剩余运行时间等实用信息的功能,同样也可用于「列表推导」:

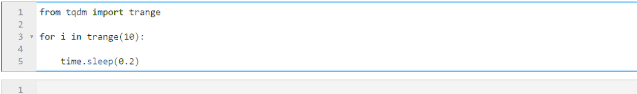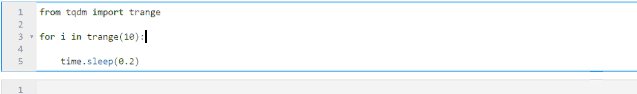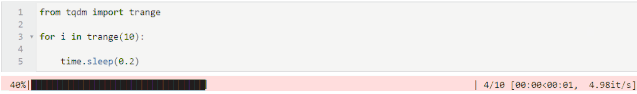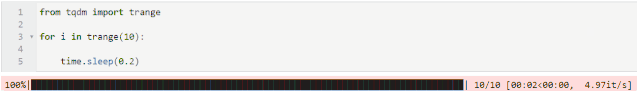
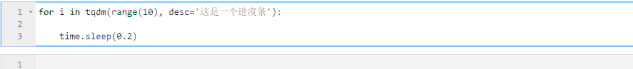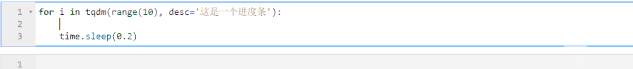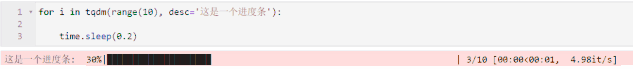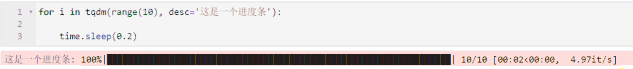
而针对迭代对象是range()的情况,tqdm还提供了简化版的trange()来代替tqdm(range())

其附带的参数desc还可以帮助我们设置进度条的说明文字:

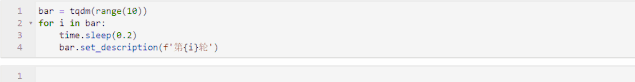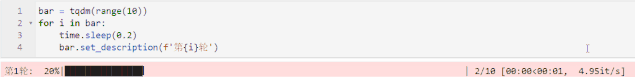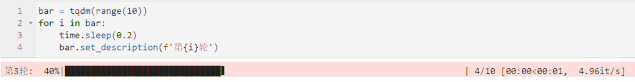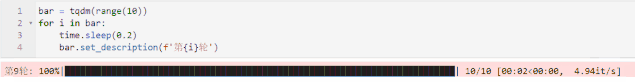
而如果想要在迭代过程中变更说明文字,还可以预先实例化进度条对象,在需要刷新说明文字的时候执行相应的程序:

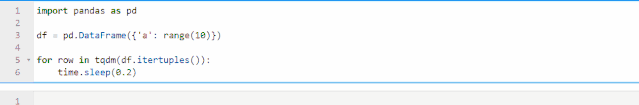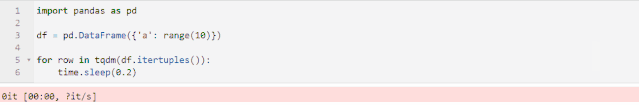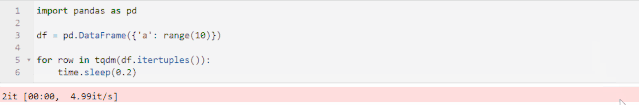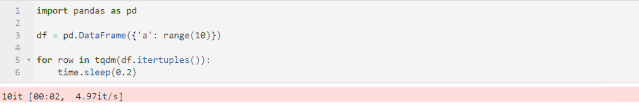
但当迭代的对象长度一开始未知时,譬如对pandas中的DataFrame.itertuples()进行迭代,我们就只能对其执行速度等信息进行估计,但无法看到进度条递增情况,因为tqdm不清楚迭代的终点如何:

2.2 配合jupyter notebook/jupyter lab的美观进度条

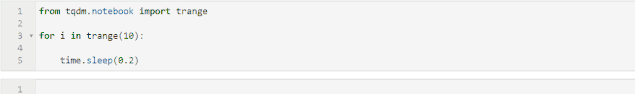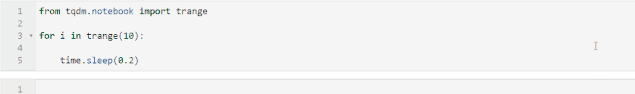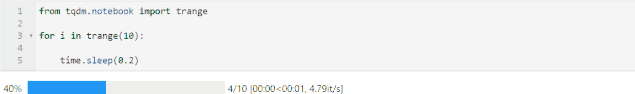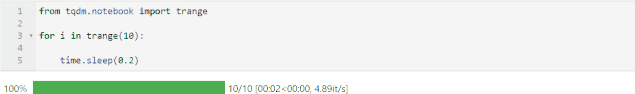
tqdmjupyter notebookjupyter lab有着特殊的支持,且使用方法非常简单,只需要将原有的from tqdm import XXX的相应功能导入格式修改为from tqdm.notebook import XXX就可以了,以trange为例:

2.3 配合pandas中的apply

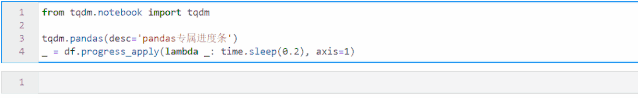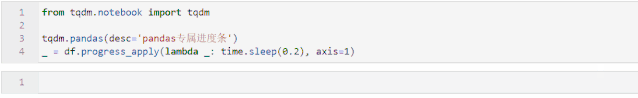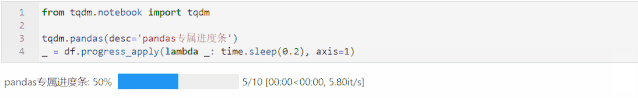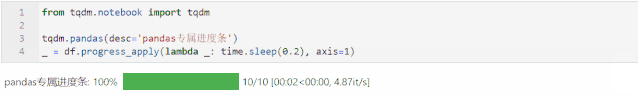
tqdmpandas中的apply()过程提供了特殊的支持,因为pandas中的apply()本质上就是串行循环运算,你可以将pandas中的任何apply操作替换为progress_apply,并且记住每个单独的progress_apply前要先执行tqdm.pandas(),就像下面的例子一样:

3 alive-progress常用方法

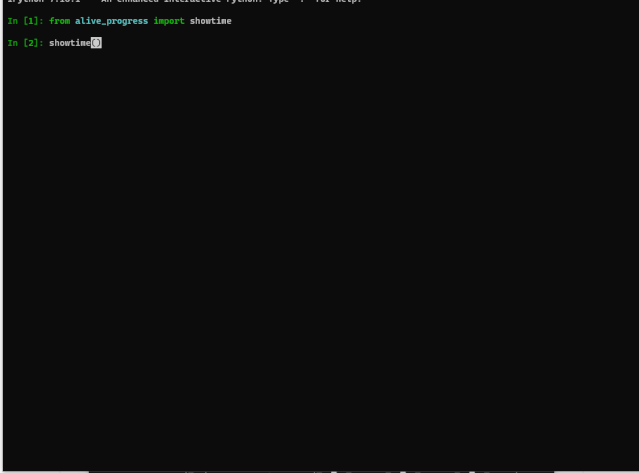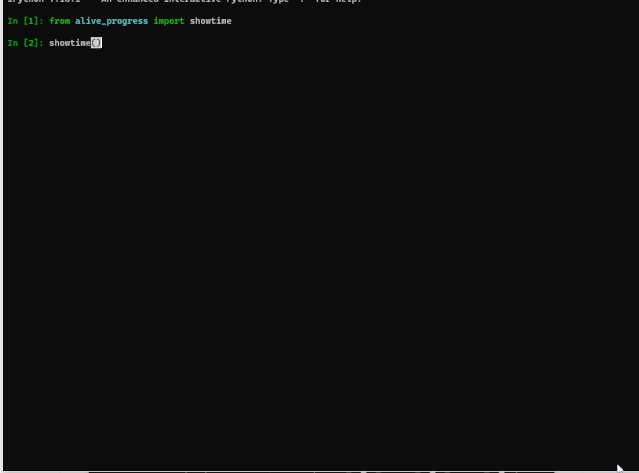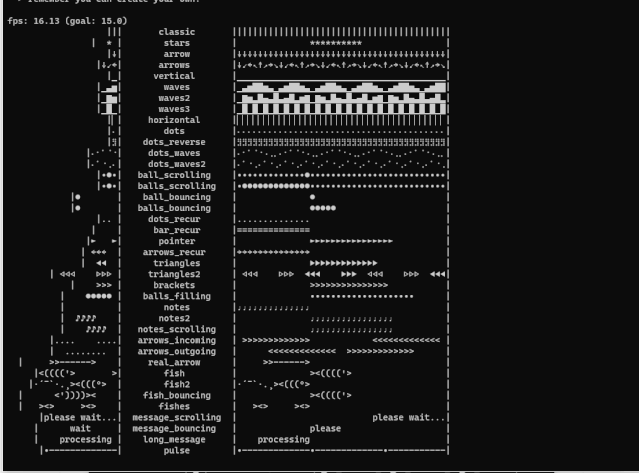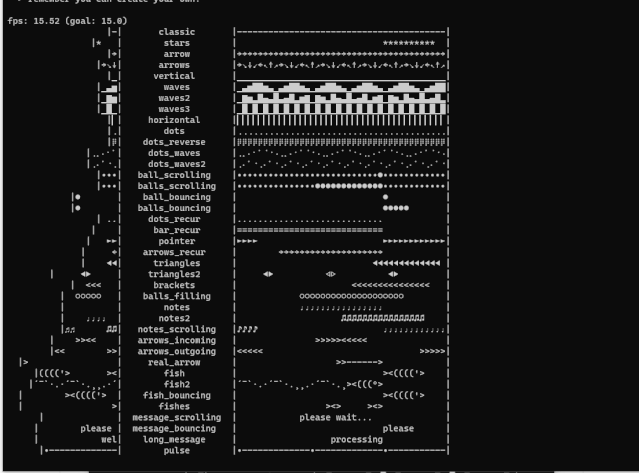
虽然与tqdm一样都是为了给循环过程加上进度条而诞生的库,但alive-progress相比tqdm增加了更多花样繁多的动态效果,我们通过调用其专门提供的showtime()函数可以查看所有可用的动态进度条样式:

同样类似地可以查看所有进度条样式:

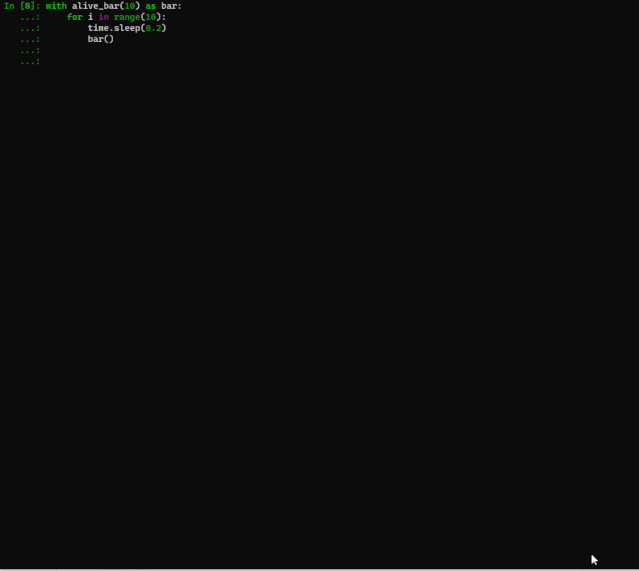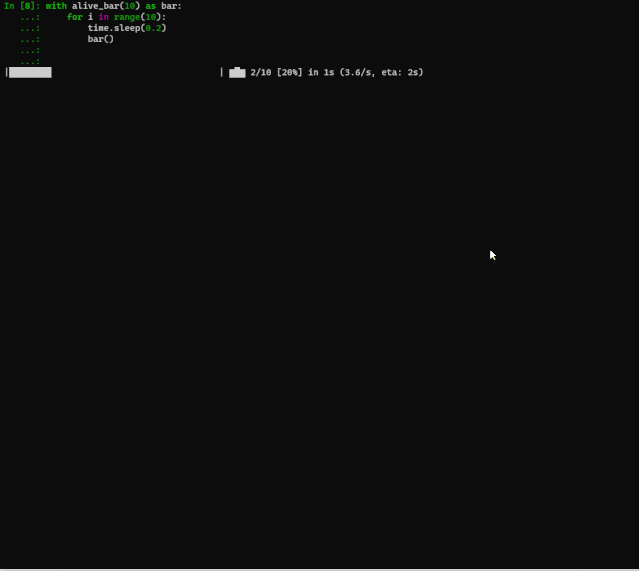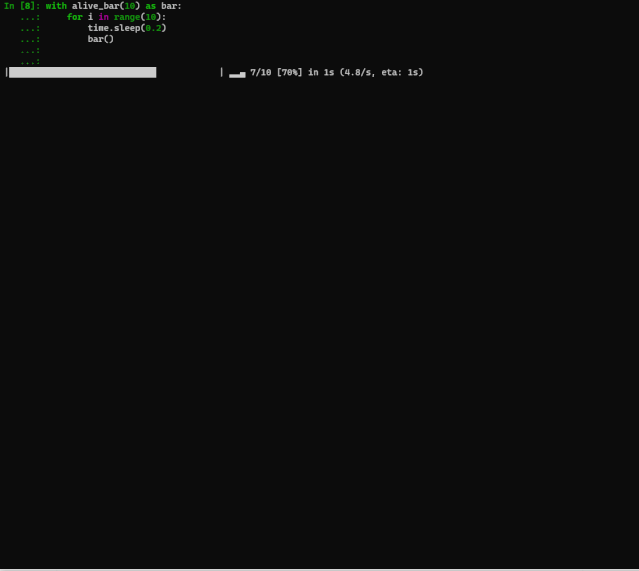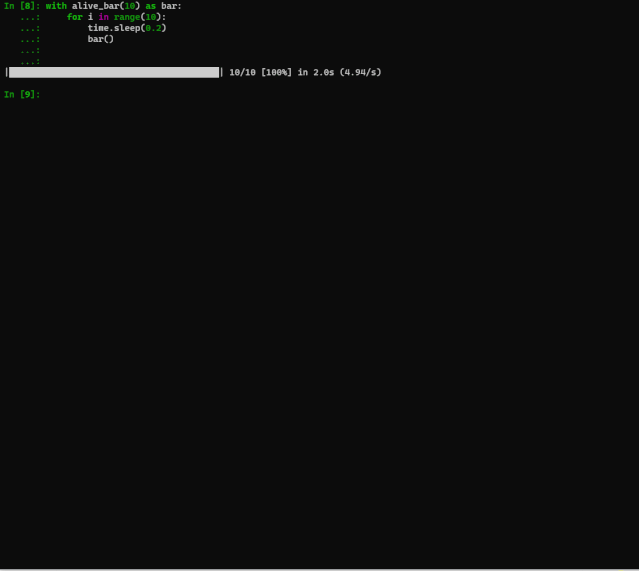
使用起来也是非常简单,但与tqdm用法区别很大,需要配合with关键词,譬如下面我们使用到alive_progress中的alive_bar来生成动态进度条:

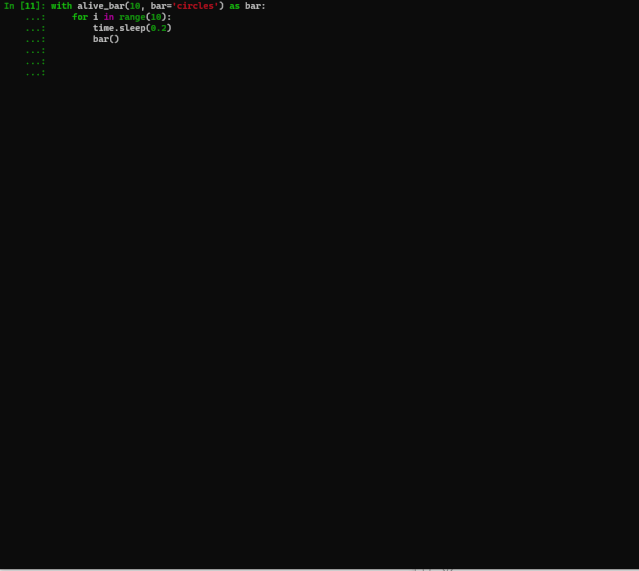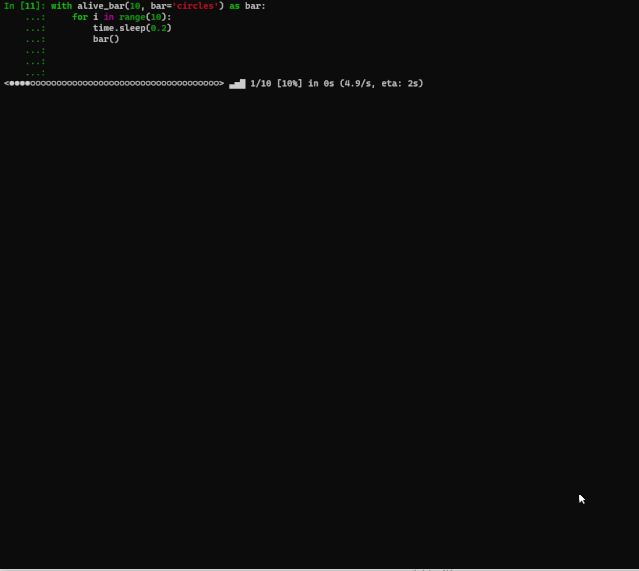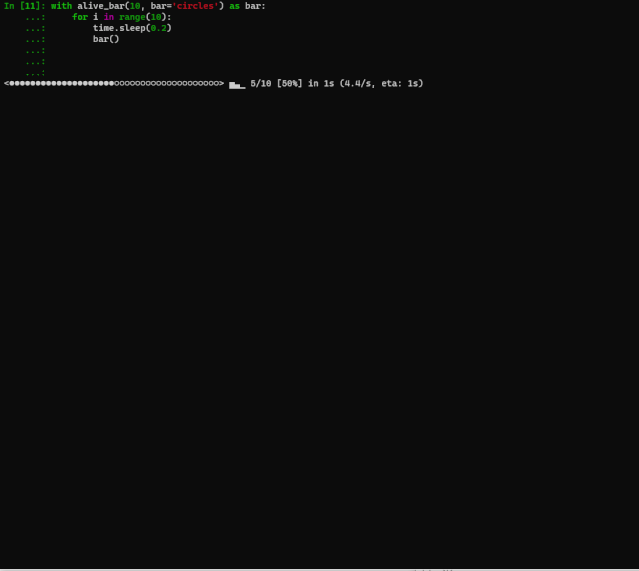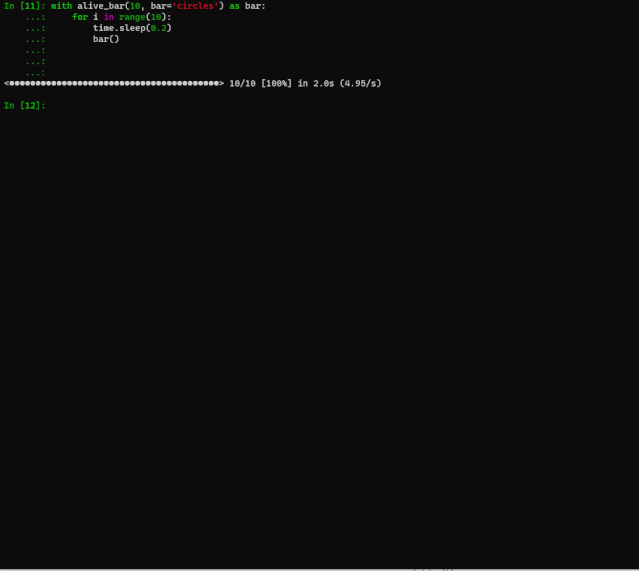
通过修改bar参数来改变进度条的样式:

比较遗憾的是目前的alive-progress只能在终端中运行,还没有为jupyter开发更美观的交互式部件,但你可以在譬如网络爬虫等任务中使用它,效果也是很不错的。然后想学习python的同学可以看一下教程。

python教程:https://www.w3cschool.cn/python/

python3基础微课:https://www.w3cschool.cn/minicourse/play/python3course

联系我们