了解一下函数式编程,送给沉迷面向对象的程序员

thbcm阅读(390)

今天给大家讲解一下函数式编程的小知识。函数式编程已经存在了60多年,但是到目前为止,它一直都很小众。只有像Google这样的改变游戏规则的企业才会依赖函数式编程,普通程序员对此几乎一无所知。

这种情况很快就要被改变了。像JavaPython这样的语言已经开始越来越多地开始采用函数编程,而像Haskell这样的新语言已经完全融入了函数式编程

简单来说,函数式编程就是为不可变变量构建函数。相反,面向对象的编程是要具有一组相对固定的函数,而我们主要是在修改或添加新变量。

函数式编程具有非常适合诸如数据分析和机器学习之类的需求任务的特性。但是这并不意味着我们应该告别面向对象编程,转而完全使用函数式编程。我们需要了解其中的基本原理,这样我们就能在适当的时候使用它们。

(推荐教程:傻瓜函数式编程

一切都是为了消除副作用

要了解函数式编程,我们需要首先了解函数。 这听起来可能很无聊,但总而言之,它很有见地。

简单地说,函数是将输入转换为输出的东西。只是事情并没有那么简单。思考一下,在Python中的下面这个函数的意义:

def square(x):
    return x*x

这个函数很简单。 它需要一个变量x,可能是一个int,或者是一个 floatdouble,然后输出该变量的平方。

再思考一下下面的这个函数:

global_list = []
def append_to_list(x):
    global_list.append(x)

乍一看,这个函数接受了一个变量 x,无论是哪种类型,由于没有 return 语句,它什么也不返回。事实真的是这样吗?

如果事先没有定义 global_list,那么这个函数就不能工作,它的输出是相同的列表,尽管经过了修改。虽然 global_list 没有声明输入,但当我们使用该函数时,它就会发生变化:

append_to_list(1)
append_to_list(2)
global_list

它返回了 [1,2],而不是空列表。这可能就是问题所在,列表确实是函数的一个输入,虽然我们没有明确说明。

1.不忠于函数

这些隐含的输入,或者其他情况下的输出,有一个官方名称:副作用。虽然我们只列举了一个简单的例子,但在更复杂的程序中,这些可能会让我们面临真正的困难。

大家可以思考一下该如何测试 append_to_list:我们不仅需要阅读第一行并使用任何 x 来测试函数,还需要阅读整个定义,了解其作用,定义 global_list 并以这种方式进行测试。这个例子告诉我们,当你在处理有数千行代码的程序时,简单的东西很快就会变得乏味。

好消息是,有一个简单的解决方法:对函数作为输入的内容诚实。这样更好:

newlist = []
def append_to_list2(x, some_list):
    some_list.append(x)
append_to_list2(1,newlist)
append_to_list2(2,newlist)
newlist

我们并没有作太大的改变,输出结果仍然是 [1,2],其他所有内容也保持不变。

但是,我们已经更改了一件事情:该代码现在没有副作用。

现在,当我们查看函数声明时,能确切知道发生了什么。如果程序运行不正常,我们也可以轻松地单独测试每个功能并查明哪个功能有问题。

2.函数式编程正在编写纯函数

具有明确声明的输入和输出的函数是没有副作用的函数,而没有副作用的函数就是纯函数。

函数编程的一个非常简单的定义是:仅用纯函数编写程序。纯函数永远不会修改变量,只会创建新的变量作为输出。

此外,对于给定输入的纯函数,我们可以得到特定的输出。相反,不纯函数可能依赖于某些全局变量。因此,如果全局变量不同,则相同的输入变量可能导致不同的输出。后者会让调试和代码维护变得更加困难。

这里有一个容易发现副作用的简单规则:由于每个函数必须具有某种输入和输出,因此没有任何输入或输出的函数声明必须是不纯的。如果采用函数式编程,这是你可能想要更改的第一个声明。

函数式编程不仅是 map 和 reduce

循环不是函数式编程中的东西。首先,我们先来思考以下的Python循环:

integers = [1,2,3,4,5,6]
odd_ints = []
squared_odds = []
total = 0
for i in integers:
    if i%2 ==1
        odd_ints.append(i)
for i in odd_ints:
    squared_odds.append(i*i)
for i in squared_odds:
    total += i

相较于我们要执行的简单操作,以上代码明显过长。而且也没有起到作用,因为我们正在修改全局变量。

相反,我们可以用以下代码替代:

from functools import reduce
integers = [1,2,3,4,5,6]
odd_ints = filter(lambda n: n % 2 == 1, integers)
squared_odds = map(lambda n: n * n, odd_ints)
total = reduce(lambda acc, n: acc + n, squared_odds)

这是完整的函数式。它比较短,也更快,因为我们不需要迭代太多的数组元素。如果你理解 filter, mapreduce 如何工作,代码也就不难理解了。

这并不意味着所有的函数代码都使用 mapreduce 等。这也不意味着你需要函数式编程来理解 mapreduce。只是当你抽象循环时,这些函数会弹出很多。

1.Lambda函数

在谈到函数式编程的历史时,许多人都是从lambda函数的发明开始的。 尽管 lambda 是函数式编程毫无疑问的基石,但它们并不是根本原因。

Lambda 函数是可用于使程序起作用的工具。 但是,我们也可以在面向对象的编程中使用lambda

2.静态类型

上面的示例虽然不是静态类型的,但是它依然是函数式的。

即使静态类型为我们的代码增加了一层额外的安全保护,但是其函数正常也并非必不可少。 不过,这可能是一个不错的补充。

有些编程语言的函数式编程越来越强

1.Perl

Perl 对副作用的处理方法与大多数编程语言截然不同。它包含了一个神奇的参数 $\Perl确实有它的优点,但我不会用它进行函数式编程。

(推荐教程:Perl教程

2.Java

如果你在用 Java 进行函数式编程,那我只能祝你好运了。因为你的程序有一半是由静态关键字组成的,而且其他 Java 开发人员也会把你的程序视为耻辱。

这并不是说 Java 有多糟糕,而是因为它并不是为那些用函数式编程解决问题而设计的,比如数据库管理或机器学习应用程序。

(推荐教程:Java教程

3.Scala

有趣的是:Scala 的目标是统一面向对象和函数式编程。如果你觉得这有点奇怪,那你不是一个人,因为所有人都这么觉得:函数式编程的目标是完全消除副作用,而面向对象编程是把副作用保留在对象内部。

尽管如此,很多开发人员认为 Scala 是一种帮助他们从面向对象编程过渡到函数式编程的语言。或许在未来几年里,它们会更容易全面发挥作用。

(推荐教程:Scala教程

4.Python

Python 鼓励函数式编程。一个事实就能看到这一点:每个函数在默认情况下至少有一个输入self。这很像Python的禅:显式比隐式好!

(推荐教程:python教程

5.Clojure

据它的创建者说,Clojure 大约有 80% 是函数式编程。默认情况下,所有值都是不可变的,就像在函数式编程中需要它们一样。但是,我们可以通过在这些不可变的值周围使用可变值包装器来解决这个问题。当你打开这样一个包装,你得到的东西又是不变的。

(推荐教程:Clojure教程

6.Haskell

这是为数不多的纯函数式和静态类型的语言之一。虽然在开发过程中这看起来像是一个时间消耗器,但在调试程序时,Haskell会付出巨大的代价。它不像其他语言那么容易学,但绝对值得投资!

(推荐教程:Real World Haskell 中文版

大数据时代带来了函数式编程

与面向对象编程相比,函数式编程仍然是一个新生儿。但是如果在 Python 和其他语言中包含函数式编程原理,具有不一样的意义,那么函数式编程就有可能获得关注。

函数式编程对于大型数据库、并行编程和机器学习非常有用。在过去的十年里,所有这些都在蓬勃发展。

虽然面向对象代码有着不可估量的优点,但函数代码的优点却不容忽视。只需要学习一些基本原理,就足以让我们成为一名开发人员,并为未来做好准备。

以上就是关于函数式编程的相关介绍了,希望对大家有所帮助。
DB-Engines 2020年8月数据库排名:前3仍然保持不变,Redis反超Elasticsearch

thbcm阅读(354)

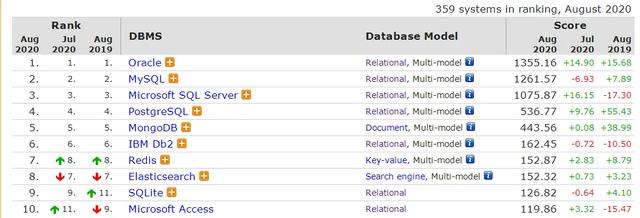
DB-Engines 近日发布了2020年8月份的数据库排名,该网站根据数据库管理系统的受欢迎程度对其进行排名。它实时统计了359种数据库的排名指数。前10名的排行情况详见下图:

相比上个月,本月前10排名整体变化并不大。OracleMySQLMicrosoft SQL Server 依旧稳居前三,一路遥遥领先。关系型数据库易于维护、使用方便,在国产数据库异军突起的背景下,前10名中,关系型数据库占了7席,依旧深受人们的喜爱。

抓眼球的红绿对称箭头绝对是最大的看点。Redis终于一甩千年老八的地位,以0.55之差超越了Elasticsearch,位居第七。较去年同期Redis上涨了8.79,较7月上涨了2.83。虽然涨幅不大,但Redis作为键值数据库的“老大”,逐渐变成了内存数据库的事实标准。

几年前,人们对Redis还充满了怀疑。然而,时至今日,经过大量的实践应用,Redis简洁高效、安全稳定的特性已经深入人心。无论是国内还是国外,从五百强公司到小型初创公司都在使用RedisRedis除了变得越来越受欢迎之外,另一个变化就是更新速度越来越快,功能也变得越来越多、越来越强大。

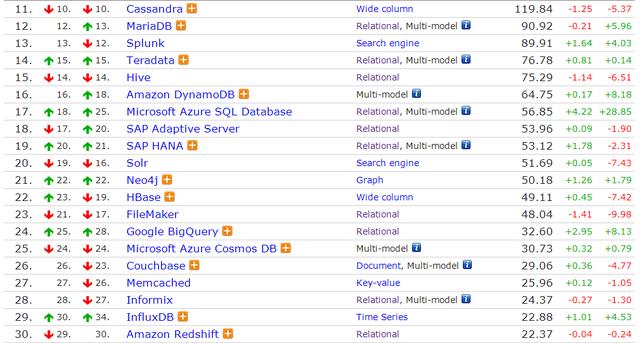
同样值得注意的是,Microsoft Access重新进入了 TIOBE 编程语言排行榜的 TOP 10名,下面列出了完整的 11-30 名:

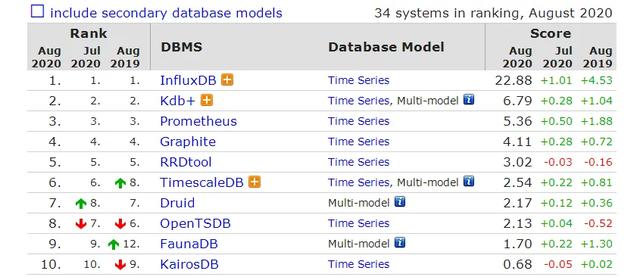
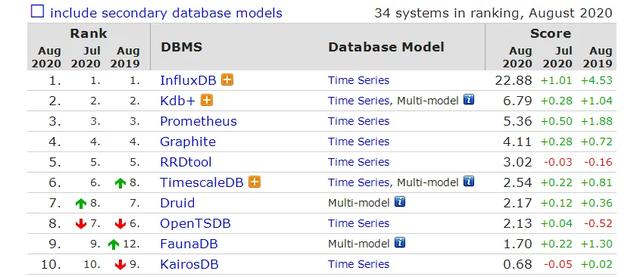
整体涨幅不大,都是一两位的上下浮动,值得注意的是,微软的Azure SQL较去年同期上升了8名,涨了28.85。时序数据库排名第一位的InfluxDB较去年上升了5名,较7月上升了1名。InfluxDB是一款非常优秀的时序数据库,直接推动监控技术进入了实时、纳秒级的新时代。

前100名中,本月同期涨幅榜冠军是ClicKHouse,上升了30名。

ClickHouse 是一款由俄罗斯Yandex公司开源的OLAP数据库,拥有者卓越的性能表现,在官方公布的基准测试中,ClickHouse的平均响应速度是Vertica的2.63倍、InfiniDB的17倍、MonetDB的27倍、Hive的126倍、MySQL的429倍以及Greenplum的10倍。

ClickHouse开源时间虽短,但是增势迅猛。自2016年开源以来,ClickHouse一直保持着飞速的发展,是目前业界公认的OLAP数据库黑马,已在头条、阿里、腾讯、新浪、青云等众多公司得以应用。

完整排名请看这里: db-engines.com/en/ranking

以上就是今年八月份数据库的排名情况了,希望对大家有所帮助。

在Go语言中三种管理Concurrency的方式

thbcm阅读(386)

相信大家踏入Go语言的世界,肯定是被强大的并发(Concurrency)所吸引,Go语言用最简单的关键字go就可以将任务丢到后台处理,但是开发者怎么有效率的控制并发,这是入门Go语言必学的技能,本章会介绍几种方式来带大家认识并发,而这三种方式分别对应到三个不同的名词:WaitGroupChannel,及 Context。下面用简单的范例带大家了解。

WaitGroup

先来了解有什么情境需要使用到 WaitGroup,假设您有两台机器需要同时上传最新的代码,两台机器分别上传完成后,才能执行最后的重启步骤。就像是把一个工作同时拆成好几份同时一起做,可以减少时间,但是最后需要等到全部做完,才能执行下一步,这时候就需要用到 WaitGroup 才能做到。

(推荐课程:Go教程

package main


import (
    "fmt"
    "sync"
)


func main() {
    var wg sync.WaitGroup
    i := 0
    wg.Add(3) //task count wait to do
    go func() {
        defer wg.Done() // finish task1
        fmt.Println("goroutine 1 done")
        i++
    }()
    go func() {
        defer wg.Done() // finish task2
        fmt.Println("goroutine 2 done")
        i++
    }()
    go func() {
        defer wg.Done() // finish task3
        fmt.Println("goroutine 3 done")
        i++
    }()
    wg.Wait() // wait for tasks to be done
    fmt.Println("all goroutine done")
    fmt.Println(i)
}

Channel

另外一种实际的案例就是,我们需要主动通知一个 Goroutine 进行停止的动作。换句话说,当 App 启动时,会在后台跑一些监控程序,而当整个 App 需要停止前,需要发个 Notification 给后台的监控程序,将其先停止,这时候就需要用到 Channel 来通知。看下下面这个例子:

package main


import (
    "fmt"
    "time"
)


func main() {
    exit := make(chan bool)
    go func() {
        for {
            select {
            case <-exit:
                fmt.Println("Exit")
                return
            case <-time.After(2 * time.Second):
                fmt.Println("Monitoring")
            }
        }
    }()
    time.Sleep(5 * time.Second)
    fmt.Println("Notify Exit")
    exit <- true //keep main goroutine alive
    time.Sleep(5 * time.Second)
}

上面的例子可以发现,用了一个 GogourtineChannel 来控制。可以想像当后台有无数个 Goroutine 的时候,我们就需要用多个 Channel 才能进行控制,也许 Goroutine 内又会产生 Goroutine,开发者这时候就会发现已经无法单纯使用 Channel 来控制多个 Goroutine 了。这时候解决方式会是传递 Context

(推荐课程:Go Web编程

Context

大家可以想像,今天有一个后台任务 A,A 任务又产生了 B 任务,B 任务又产生了 C 任务,也就是可以按照此模式一直产生下去,假设中途我们需要停止 A 任务,而 A 又必须告诉 B 及 C 要一起停止,这时候通过 context 方式是最快的了。

package main


import (
    "context"
    "fmt"
    "time"
)


func foo(ctx context.Context, name string) {
    go bar(ctx, name) // A calls B
    for {
        select {
        case <-ctx.Done():
            fmt.Println(name, "A Exit")
            return
        case <-time.After(1 * time.Second):
            fmt.Println(name, "A do something")
        }
    }
}


func bar(ctx context.Context, name string) {
    for {
        select {
        case <-ctx.Done():
            fmt.Println(name, "B Exit")
            return
        case <-time.After(2 * time.Second):
            fmt.Println(name, "B do something")
        }
    }
}


func main() {
    ctx, cancel := context.WithCancel(context.Background())
    go foo(ctx, "FooBar")
    fmt.Println("client release connection, need to notify A, B exit")
    time.Sleep(5 * time.Second)
    cancel() //mock client exit, and pass the signal, ctx.Done() gets the signal  time.Sleep(3 * time.Second)
    time.Sleep(3 * time.Second)
}

package main


import (
    "context"
    "fmt"
    "time"
)


func foo(ctx context.Context, name string) {
    go bar(ctx, name) // A calls B
    for {
        select {
        case <-ctx.Done():
            fmt.Println(name, "A Exit")
            return
        case <-time.After(1 * time.Second):
            fmt.Println(name, "A do something")
        }
    }
}


func bar(ctx context.Context, name string) {
    for {
        select {
        case <-ctx.Done():
            fmt.Println(name, "B Exit")
            return
        case <-time.After(2 * time.Second):
            fmt.Println(name, "B do something")
        }
    }
}


func main() {
    ctx, cancel := context.WithCancel(context.Background())
    go foo(ctx, "FooBar")
    fmt.Println("client release connection, need to notify A, B exit")
    time.Sleep(5 * time.Second)
    cancel() //mock client exit, and pass the signal, ctx.Done() gets the signal  time.Sleep(3 * time.Second)
    time.Sleep(3 * time.Second)
}

大家可以把 context 想成是一个 controller,可以随时控制不确定个数的 Goroutine,由上往下,只要宣告context.WithCancel后,再任意时间点都可以通过cancel()来停止整个后台服务。实际案例会用在当 App 需要重新启动时,要先通知全部 goroutine 停止,正常停止后,才会重新启动 App。

(推荐微课:Go微课

总结

根据不同的情境跟状况来选择不同的方式,做一个总结:

  • WaitGroup:需要将单一个工作分解成多个子任务,等到全部完成后,才能进行下一步,这时候用 WaitGroup 最适合了
  • Channel + SelectChannel 只能用在比较单纯的 Goroutine 情况下,如果要管理多个 Goroutine,建议还是 走 context 会比较适合
  • Context:如果您想一次控制全部的 Goroutine,相信用 context 会是最适合不过的,当然 context 不只有这特性,详细可以参考『用 10 分钟了解 Go 语言 context package 使用场景及介绍』

以上就是关于Go 语言中管理 Concurrency 的三种方式的相关介绍了,希望对大家有所帮助。

两个程序员的寓言故事:2500行代码的程序,一定比500行的好吗?

thbcm阅读(422)

2500行代码的程序一定比500行代码的程序好吗?写出简洁、高效、高可用的程序的开发者黯然离场,搞出庞大、复杂又难用的程序的人倒能加薪升职?究竟开发者的工作应该如何进行评价?来看看下面两个程序员的故事吧。

两个程序员的寓言

很久以前,有两家公司,分别是”Automated Accounting Applications Association “和 “Consolidated Computerized Capital Corporatio”,他们决定,需要一个程序来执行自己公司的某项业务,但这两家公司并不知道,对于他们的业务需求来说,要开发的程序是完全一样的。

Automated雇用了一位程序员分析师Alan来解决他们的问题。

与此同时,Consolidated决定让他们新招聘的一名初级程序员Charles来负责这项工作,看看他是否真的那么优秀。

Alan曾经有过操刀艰难的编程项目的经验,所以他决定使用PQR结构化设计方法。考虑到这一点,他要求部门经理再指派三名程序员作为编程团队。然后,这个团队就开始工作了,扑到了铺天盖地的初步报告和问题分析上。

再看Consolidated这边,Charles没忙着动手开干,他花了一些时间思考这个问题。Charles的同事们注意到,他经常坐在桌前,把脚抬起来放在桌子上,喝着咖啡。偶尔也会看到他在电脑前忙活,但同事们从他敲击键盘的节奏就能看出,他其实是在玩《太空侵略者》的游戏。

这时,Automated的团队已经开始写代码了。程序员们大约用了一半的项目时间来编写和编译代码,其余的时间都在开会,讨论各种模块之间的接口问题。

而Charles的同事注意到,他终于不再沉迷《太空侵略者》了。他现在要么就是把脚架在办公桌上喝咖啡,要么在小纸片上乱涂乱画。他写在小纸片上的字迹很潦草,当然看起来不是在玩Tic Tac Toe(一种游戏),但也没有什么意义。

(推荐教程:JavaScript教程

两个月过去了,Automated公司的团队终于发布了项目实施时间表。再过两个月,他们将发布一个测试版的程序。然后再经过两个月的测试和优化,便会得到一个完整的最终版程序。

另一头,Charles的经理一直看着Charles上班摸鱼,已经厌烦了,他对Charles失去了耐心,决定和他摊牌。但当他走进Charles的办公室时,却惊讶地看到他在电脑前忙着输入代码。他决定等等看会发生什么,所以打了个哈哈,然后离开了。他开始密切关注Charles,以便抓住机会当面好好教训他一番。但是预期中那令人不快的对话并没有出现,因为他很高兴地注意到,Charles似乎大部分时间都在忙碌,甚至有人看到Charles忙得连午餐都很晚去吃,而且一周有那么两三天,下班后他还会留下来加班。

三个月结束时,Charles宣布他已经完成了这个项目。他提交了一个包含500行代码的程序。程序似乎写得很清楚,经过测试,它可以满足项目既定的所有需求。事实上,它甚至还有一些额外的便利功能,可能会显著提高程序的可用性。该程序投入实际测试使用后,除了发现一个可以快速纠正的疏忽外,表现良好。

到这时,Automated的团队已经完成了项目所需的四个主要模块中的两个。这些模块目前正在进行测试,而其它模块已经完成。

又过了三周,Alan宣布,初级版比原计划提前一周完成。他提供了一份待纠正的缺陷列表。该程序开始进行实际测试使用。除了缺陷列表中列举的问题,用户还发现了一些其它的错误和缺陷。正如艾伦所解释的那样,这并不奇怪。毕竟这是一个初级版本嘛,有错误是意料之中的。

又经过大约两个多月的时间,程序的正式版本开发完毕。它由大约2500行代码组成。测试时,它似乎满足了大部分项目需求。但是它削减了一两个功能,而且对输入数据的格式非常挑剔。然而,公司还是决定上马该程序了。他们可以随时对数据录入人员进行培训,让他们严格按照要求的格式输入数据。此后该程序移交给了一些负责维护的程序员去补全缺失的功能。

(推荐教程:Java教程

后记:

起初,Charles的上司对他在这个项目上的表现还是比较满意的。但当他通读程序源代码的时候,他发现这个项目真的比他最初想象的要简单得多。现在看来,即使是对一个初学编程的人来说,这显然也不是什么难事。

Charles每天确实产出了大约5行代码,这或许是略高于业内平均水平。然而,基于程序是这么简单,他的表现也就并没有什么特别了,而且他的上司还记得他那两个月的“摸鱼劣迹”。

在下一次薪酬调整时,Charles得到了加薪,加薪幅度约为这一时期通货膨胀率的一半(很可怜吧),公司没有给他升职。大约一年后,他变得心灰意冷,离开了Consolidated。

在Automated公司,Alan因如期完成了项目而受到嘉奖。他的上级看了看他们编写的程序,他浏览了几分钟,恩,是遵守公司关于结构化编程的标准的。然后他很快就不再继续尝试往下看了,这程序看起来似乎很难理解。这时他意识到,这个项目确实比他原先设想的要复杂得多,他再次对Alan的成就表示祝贺。

Alan团队的每个程序员每天产出3行多的代码。这在业内大约是平均水平,但考虑到这个项目所要解决的问题的复杂性,可以说是很不错的产出啦。Alan因此获得了丰厚的加薪,并被提升为系统分析师,以表彰他的成就。

(推荐教程:python教程

来自Tim Mensch的评论

我曾经是一名年轻但是聪明的程序员,这个故事令我产生了强烈的共鸣。即使在我还是个职场新人的时候,我也能做到令很多资深开发人员都感到有挑战的事情。在我的第一份工作中(作为游戏开发者),我的经理说我在几天内创建的代码,感觉比一个更有经验的开发者经过几个月的推敲后完成的代码都要好(从物理意义上讲)。在我的第二份工作中,我对一个有十年以上经验的高级开发人员编写的工具程序进行了优化,使其只需几分之一秒就能完成一个任务,而不用花费几分钟。我的整个职业生涯充斥了这样一连串的奇闻轶事。

在我从事编程以来的多年开发和学习经历中,我意识到经验确实很重要。但是,底层技能也同样重要。实际上,就像上面讲到的两个程序员的寓言一样,底层技能可能比经验更重要,我认为这个事实已经被许多当代的开发者忽略了。

话虽如此,我也曾经踩过坑,跟上文提到的第二个开发者类似,创建了一个比实际所需要的复杂得多的系统。我知道一个复杂的解决方案,并且知道自己可以实现它,但这并不意味着它就是最好的解决方案,我需要时不时地提醒自己这个事实。

于是,我尝试做出妥协,甚至质疑我自己的解决方案,持续寻找能够改进和简化的方法。我曾遭到指责:因为我倾向于花费更多的时间去思考一个问题,而不是仅仅用显而易见的方法去解决它;我希望能找到更简洁的方法去解决问题。因为花了很多时间思考,看起来好像不务正业,但是充分地思考可以让我产出更好的结果—-代码量更少,更健壮、更可扩展而且更容易阅读。

这就是为什么我认为上面这个寓言如此重要的原因。开发经验固然重要,但在项目设计和实施上的技能都可以完胜经验,如果你同时具备经验和技能,就可以实现相当的奇迹。只要你持续质疑自己的想法并持续思考如何更好地完善它,而不要一味地认为自己的第一个设计构思就是足够完美的。

原文链接:realmensch.org/2017/08/25/the-parable-of-the-two-programmers/?

Go 1.15 正式发布,让我们来看看它有哪些值得关注的变化

thbcm阅读(414)

今天上午 Go Team 宣布 Go 1.15 正式发布。因为受到今年疫情的影响,所以这次版本虽然如期发布,但是变化的内容并不多。

它的大部分更改在工具链、运行时和库的实现。与往常一样,该版本保留了 Go 1 兼容性的承诺。这几乎保证所有的 Go 程序都能像以前一样正常编译和运行。

Go 1.15 包括对链接器的重大改进,改进了对具有大量内核的小对象的分配,并弃用了 X.509 CommonNameGOPROXY 现在支持跳过返回错误的代理,并添加了新的嵌入式 tzdata 包。

我们一起看看具体都有哪些值得关注的变化。

(推荐课程:Go教程

1、新的链接器

官方的设计文档地址:https://golang.org/s/better-linker, 从命名看,是一个更好的链接器(这是废话)。

此版本 Go 可减少链接器资源的使用(时间和内存)并提高代码的健壮性/可维护性。对于在 amd64 架构上运行的基于 ELF 的操作系统(LinuxFreeBSDNetBSDOpenBSDDragonflyS olaris),代表性的大型 Go 程序集的链接速度提高 20%,平均所需内存减少 30%。其他体系结构/OS 组合的改进。改进链接程序性能的关键因素是新设计的目标文件格式,以及内部阶段的改进以提高并发性(例如,将重定位并行应用于符号)。Go 1.15 中的目标文件比其 1.14 等价文件稍大。这些更改是对 Go 链接器进行现代化改造的多版本项目的一部分,这意味着将来的版本中有望对链接器进行其他改进。现在,链接器在 linux/amd64linux/arm64 上默认为 -buildmode=pie 的内部链接模式,因此这些配置不再需要 C 链接器。

2、编译器改进,包括略微小了些的二进制文件

unsafe 的安全规则允许在调用某些函数时将 unsafe.Pointer 转换为 uintptr。以前,在某些情况下,编译器允许进行多个链式转换(例如 syscall.Syscall(…,uintptr(uintptr(ptr)),…))。编译器现在只需要一次转换。使用多次转换的代码应进行更新以满足安全规则。

Go 1.14 相比,Go 1.15 通过消除某些类型的 GC 元数据和更积极地消除了未使用的类型元数据,与 Go 1.14 相比将典型的二进制大小减少了大约 5%。该工具链现在通过将函数与 32 字节边界对齐并填充跳转指令来缓解 GOARCH=amd64 上的 Intel CPU 勘误 SKX102。尽管此填充增加了二进制大小,但这远远超出了上述二进制大小改进所弥补的范围。

Go 1.15 向编译器和汇编器都添加了 -spectre 标志,以允许启用 Spectre 缓解措施。这些几乎是绝对不需要的,主要是作为“纵深防御”机制提供的。有关详细信息,请参见 Spectre Wiki页面。

现在,编译器将拒绝 //go: compiler 指令,这些指令对其所使用的声明无意义,并出现“放错位置的编译器指令”错误。此类错误使用的指令以前已被破坏,但编译器无声地忽略了它们。

现在,编译器的 -json 优化日志记录报告大(>= 128 字节)副本,并包含转义分析决策的说明。

(推荐课程:Go Web编程

3、内嵌 tzdata(时区数据)

增加了一个新包:time/tzdata,当系统找不到时区数据时(比如 Windows 等),通过导入这个包,在程序中内嵌时区数据,也可以通过编译时传递 -tags timetzdata 来实现同样的效果。

具体查看这个 issuehttps://github.com/golang/go/issues/38017 以及包 time/tzdata 的说明:https://golang.org/pkg/time/tzdata/

4、增加 testing.TB.TempDir

测试生成临时文件挺常见的,这个为了更好的解决此问题。详情见 issuehttps://github.com/golang/go/issues/35998

5、增加 testing.T.Deadline

context 引入 testing 包。详情见 issuehttps://github.com/golang/go/issues/28135

6、关于 Ports 部分

darwin/386darwin/arm 不再支持;riscv64 变得更好;linux/arm64 现在作为第一类 port 支持。

7、API 的变动

  1. net/url.URL RawFragmentEscapedFragment ,详情见 issue:https://github.com/golang/go/issues/37776
  1. net/url.URL.Redacted,详情见 issuehttps://github.com/golang/go/issues/34855

3.time.Ticker.Reset,我们知道 Timer 是有 Reset 的,这次为 Ticker 也增加,详情见 issuehttps://github.com/golang/go/issues/33184

  1. regexp.Regexp.SubexpIndex,详情见 issuehttps://github.com/golang/go/issues/32420
  1. sync.Map.LoadAndDelete,详情见 issuehttps://github.com/golang/go/issues/33762
  1. crypto/tls.Dialer.DialContext,详情见 issuehttps://github.com/golang/go/issues/18482

还有其他一些 API 变动,不一一列举。

8、工具链

  1. 增加 go env GOMODCACHEhttps://github.com/golang/go/issues/34527
  1. opt-in fallbacks in GOPROXYhttps://github.com/golang/go/issues/37367
  1. vet:warn about string(int)detect impossible interface assertionshttps://github.com/golang/go/issues/32479https://github.com/golang/go/issues/4483
  1. println 允许打印两个值。println(twoValues())
  1. panic:显示可打印的值而不是地址。比如:
type MyString string
panic(MyString("hello"))

现在打印:

panic: (main.MyString) (0x48aa00,0x4c0840)

期望打印:

panic: main.MyString("hello")

可读性会好很多。

9、性能

  1. amd64 上更好的写屏蔽;
  1. Linux 上,forkAndExec 使用 dup3
  1. sha512 算法速度提升 15%;
  1. ReadMemStats 延迟降低 95%;
  1. 关闭状态的 channel 接收速度提升 99%;
  1. 将小的 int 值转为 interface{} 不额外分配内存;

(推荐微课:Go微课

10、更详细的改动

更多详细的改动,见官方发布文档 https://golang.org/doc/go1.15

以上就是关于 Go 1.15正式发布一些值得注意的变化的相关介绍了,希望对大家有所帮助。

使用Node和MongoDB搭建一个图床或网盘

thbcm阅读(412)

1 文章起源

本文给大家分享一个关于Node+Mongodb的附件上传下载的项目,这个项目比较简单,看完的同学就可以很快的搭建一个小网盘或者图床了。

2 起手式

2.1 概念

首先我们得先去了解一下Mongodb的文件储存(GridFS)是啥,因为我们都是基于 GridFS 来进行文件储存

2.2 我们需要什么

了解了大概概念后就可以着手安装我们必须的插件了

  • express (这是啥不用我多说)
  • body-parser (Node解析body的中间件)
  • ejs (模板引擎,快速开发就不搞前后端分离了,有兴趣的小伙伴可以用Vue/React来搭建小网盘)
  • gridfs-stream (轻松地与MongoDB GridFS之间传输文件。)
  • method-override (我们用form表单简单上传,因为form表单不支持put/delete请求方式,所以把它安排上了,小伙伴可自行使用Ajax,就不需要这么麻烦了)
  • mongoose (用于连接mongodb必不可少的插件)
  • multer (Multer是用于处理多部分/表单数据的node.js中间件,主要用于上传文件。它被编写在busboy之上,以实现最大效率。)
  • multer-gridfs-storage (Multer的GridFS存储引擎可将上传的文件直接存储到MongoDb。)
  • nodemon (热更新)

(推荐教程:Node入门

以上就是我们需要准备的东西了

npm install express body-parser ejs gridfs-stream method-override mongoose multer multer-gridfs-storage // or yarn add express body-parser ejs gridfs-stream method-override mongoose multer multer-gridfs-storage

2.3 初始化一个项目

// 可自行补充信息 // npm init

然后在根目录新建一个入口文件app.js,和页面 views/index.ejs

3 现在项目开始了

3.1 先将基础部分完事

将我们安装的包引入,再跑跑看看

const express = require(‘express’) const path = require(‘path’) const crypto = require(‘crypto’) const mongoose = require(‘mongoose’) const multer = require(‘multer’) const GridFsStorage = require(‘multer-gridfs-storage’) const GridFsStream = require(‘gridfs-stream’) const methodOverride = require(‘method-override’) const bodyParser = require(‘body-parser’)


const app = express()


app.set('view engine', 'ejs') // 设置模板引擎


app.use(bodyParser.json()) 
app.use(methodOverride('_method'))


app.get('/', (req, res) => {
        res.render('index')
    })
})


const port = 5000
app.listen(port, () => {
    console.log(`App listering on port ${port}`)
})

一般来说启动了app.js的话我们在浏览器访问 http://localhost:5000 就能看到 views/index.ejs 中的界面了,如果没有,自行查看控制台是否报错

3.2 连接我们的Mongodb数据库

我这边用的本地mongodb数据库,线上也是一样的,我们可以用NoSQL manager for mongdb来查看我们数据库里面的数据,我们新建一个新的集合,我这边叫 grid_uploads。所以连接的话也是连接这个集合

// 数据库的链接 const mongoURL = ‘mongodb://localhost:27017/grid_uploads’


const connect = mongoose.createConnection(mongoURL, {
    useNewUrlParser: true,
    useUnifiedTopology: true
})

可以尝试在NoSQL写入一些数据,具体使用可以参考博客【MongoDB】NoSQL Manager for MongoDB 教程

3.3 美化一下界面(views/index.ejs)

作为一个小两年的前端工程师,已经练就了像素眼了,我们肯定不能把界面做的辣么丑对吧,眼睛过不去啊,所以我们简单的用bootstrap4来做个界面好了

<!DOCTYPE html>
<html lang="en">


<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>文件上传</title>
    <link rel="stylesheet" href="https://cdn.jsdelivr.net/npm/bootstrap@4.5.0/dist/css/bootstrap.min.css" integrity="sha384-9aIt2nRpC12Uk9gS9baDl411NQApFmC26EwAOH8WgZl5MYYxFfc+NcPb1dKGj7Sk" crossorigin="anonymous">
    <style>
        img {
            width: 100%;
        }
    </style>
</head>


<body>
    <div class="container">
        <div class="row">
            <div class="col-md-6 m-auto">
                <h2 class="text-center display-4 my-4">Mongo文件上传</h2>
                <form action="/upload" method="POST" enctype="multipart/form-data">
                    <div class="custom-file mb-3">
                        <input type="file" name="file" id="file" class="custom-file-input">
                        <label for="file" class="custom-file-label">选择文件</label>
                    </div>
                    <input class="btn btn-primary btn-block" type="submit" value="提交">
                </form>
                <hr>
            </div>
        </div>
    </div>
</body>
<script src="https://cdn.jsdelivr.net/npm/jquery@3.5.1/dist/jquery.slim.min.js" integrity="sha384-DfXdz2htPH0lsSSs5nCTpuj/zy4C+OGpamoFVy38MVBnE+IbbVYUew+OrCXaRkfj" crossorigin="anonymous"></script>
<script src="https://cdn.jsdelivr.net/npm/popper.js@1.16.0/dist/umd/popper.min.js" integrity="sha384-Q6E9RHvbIyZFJoft+2mJbHaEWldlvI9IOYy5n3zV9zzTtmI3UksdQRVvoxMfooAo" crossorigin="anonymous"></script>
<script src="https://cdn.jsdelivr.net/npm/bootstrap@4.5.0/dist/js/bootstrap.min.js" integrity="sha384-OgVRvuATP1z7JjHLkuOU7Xw704+h835Lr+6QL9UvYjZE3Ipu6Tp75j7Bh/kR0JKI" crossorigin="anonymous"></script>


</html>

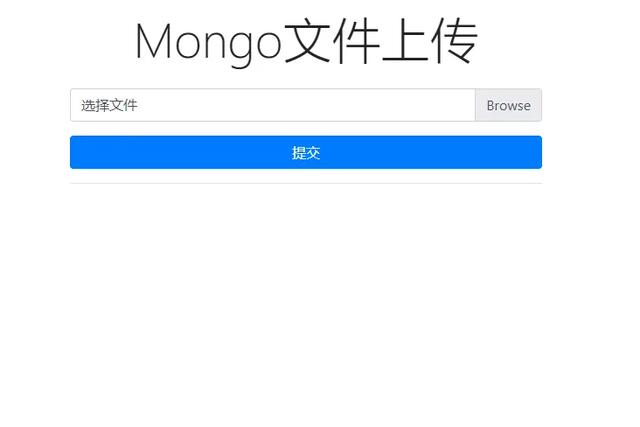
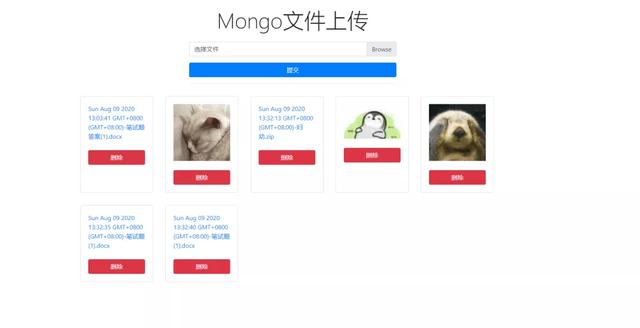
那么我们请求 http://localhost:5000 的话我们看到的应该是这样子的

(推荐教程:Node.js教程

3.4 做一些必须的处理

// 定义gfs变量,后续我们进行数据库文件操作的时候可不能少 let gfs; connect.once(‘open’, () => { // 监听数据库开启,通过 gridfs-stream 中间件和数据库进行文件的出入控制 gfs = GridFsStream(connect.db, mongoose.mongo) gfs.collection(‘upload’) // 它会在我们数据库中建立 upload.files(记录文件信息) upload.chunks(存储文件块) })


// 使用 multer-gridfs-storage Multer 中间件来讲我们上传的附件直接存储到MongoDb
const storage = new GridFsStorage({
    url: mongoURL,
    file: (req, file) => {
        return new Promise((resolve, reject) => {
            // 下面注释部分是给文件进行重命名的,如果想要原文件名称可以自行使用 file.originalname 返回,
            // 建议有时间的小伙伴存储两个文档,一个记录原文件名,一个记录加密文件名,然后返回到页面的时候可以将中文名返回去

            
            // crypto.randomBytes(16, (err, buf) => {
            //     if (err) {
            //         return reject(err)
            //     }
            //     const filename = buf.toString('hex') + path.extname(file.originalname)
            //     const fileinfo = {
            //         filename,
            //         bucketName: 'upload'
            //     }
            //     resolve(fileinfo)
            // })
            const fileinfo = {
                filename: new Date() + '-' + file.originalname,
                bucketName: 'upload'
            }
            resolve(fileinfo)
        })
    }
})


const upload = multer({ storage })

3.5 写我们上传第一个文件的接口

app.post(‘/upload’, upload.single(‘file’), (req, res) => { res.redirect(‘/’) })

看起来简简单单,请记着这么几件事

  • views/index.ejs中 (input type=file 指定的name得和接口的upload.single(‘file’) 一样
  • 上传完文件我们重定向回我们的首页 此时我们就可以在NoSql看到我们的两个文档有数据了

(推荐微课:Node.js微课

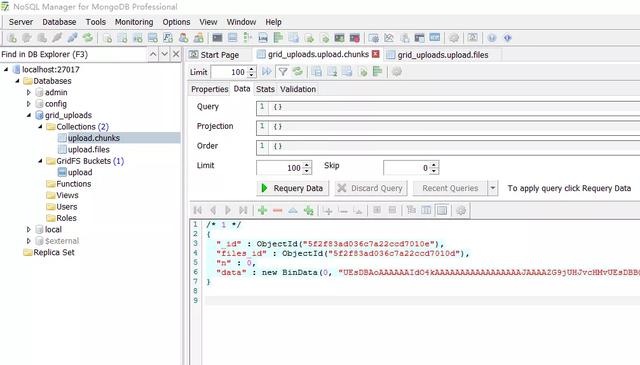
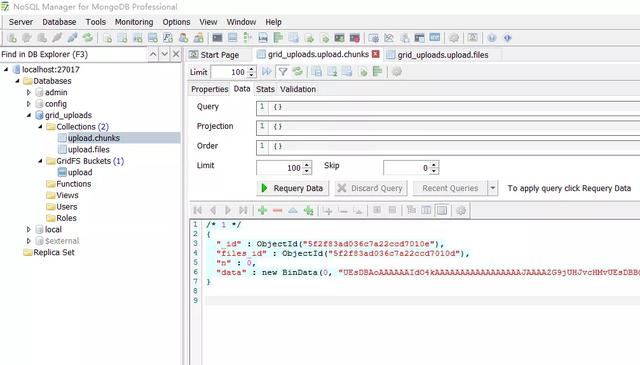
这是upload.chunks

这是upload.files

3.6 获取我们所有的文件信息

获取我们所有的文件

app.get(‘/files’, (req, res) => { // 通过查找返回一个数组对象回去 gfs.files.find().toArray((err, files) => { if (!files || files.length === 0) { return res.status(404).json({ err: ‘文件不存在!’ }) } return res.json(files) }) })

我们可以进行一些美化操作,比如我们可以将上传是图片的,返回到界面的话以图片显示,其他则以 a 标签的格式显示(可点击下载),所以我们可以将 views/index.ejs的界面进行美化改造(ejs语法用起来确实蛮麻烦的),进行重新排版以及添加删除按钮

<!DOCTYPE html> <html lang=”en”>


<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>文件上传</title>
    <link rel="stylesheet" href="https://cdn.jsdelivr.net/npm/bootstrap@4.5.0/dist/css/bootstrap.min.css"
        integrity="sha384-9aIt2nRpC12Uk9gS9baDl411NQApFmC26EwAOH8WgZl5MYYxFfc+NcPb1dKGj7Sk" crossorigin="anonymous">
    <style>
        img {
            width: 100%;
        }
    </style>
</head>


<body>
    <div class="container">
        <div class="row">
            <div class="col-md-6 m-auto">
                <h2 class="text-center display-4 my-4">Mongo文件上传</h2>
                <form action="/upload" method="POST" enctype="multipart/form-data">
                    <div class="custom-file mb-3">
                        <input type="file" name="file" id="file" class="custom-file-input">
                        <label for="file" class="custom-file-label">选择文件</label>
                    </div>
                    <input class="btn btn-primary btn-block" type="submit" value="提交">
                </form>
                <hr>
            </div>
        </div>
        <div class="row">
            <% if(files){ %>
            <% files.forEach(function(file){ %>
            <div class="col-sm card card-body m-3  col-md-2">
                <% if(file.isImage){ %>
                <img src="image/<%= file.filename %>" />
                <% } else { %>
                <a href="download/<%= file.filename %>"><%= file.filename %></a>
                <%}%>
                    <form action="/files/<%= file._id%>?_method=DELETE" method="POST">
                <button class="btn btn-danger btn-block mt-4">删除</button>
                </form>
            </div>
            <% }) %>
            <% }else { %>
            <p class="card card-body text-center display-4 my-4">文件不存在</p>
            <% } %>
        </div>
    </div>
</body>
<script src="https://cdn.jsdelivr.net/npm/jquery@3.5.1/dist/jquery.slim.min.js"
    integrity="sha384-DfXdz2htPH0lsSSs5nCTpuj/zy4C+OGpamoFVy38MVBnE+IbbVYUew+OrCXaRkfj"
    crossorigin="anonymous"></script>
<script src="https://cdn.jsdelivr.net/npm/popper.js@1.16.0/dist/umd/popper.min.js"
    integrity="sha384-Q6E9RHvbIyZFJoft+2mJbHaEWldlvI9IOYy5n3zV9zzTtmI3UksdQRVvoxMfooAo"
    crossorigin="anonymous"></script>
<script src="https://cdn.jsdelivr.net/npm/bootstrap@4.5.0/dist/js/bootstrap.min.js"
    integrity="sha384-OgVRvuATP1z7JjHLkuOU7Xw704+h835Lr+6QL9UvYjZE3Ipu6Tp75j7Bh/kR0JKI"
    crossorigin="anonymous"></script>


</html>

(推荐教程:MongoDB教程

要将 ejs 中的files变量获取到我们应该重写一下 get('/')接口,使其在访问localhost:5000的时候先去读取一下数据库文件信息并输出到页面中去

app.get(‘/’, (req, res) => { gfs.files.find().toArray((err, files) => { if (!files || files.length === 0) { res.render(‘index’, { files: false }) return } files.map(file => { // 如果是以下图片类型我们就在前端展示出来,其余一律按附件处理,通过 isImage 来区分图片和非图片 const imageType = [‘image/png’, ‘image/jpg’, ‘image/gif’, ‘image/jpeg’] if (imageType.includes(file.contentType)) { file.isImage = true } else { file.isImage = false } }) res.render(‘index’, { files: files }) }) })

完成上述的情况我们访问首页的话就行该是如下情况

3.7 单个文件下载

在这里我们通过a标签访问 /download/:filename 接口,filename是文件名,当然可以用其他的比如_id,当查找到有该附件的时候就将它合并成可读留,通过管道返回,这样在前端界面上点击文件标题就可以直接下载了

app.get(‘/download/:filename’, (req, res) => { gfs.files.findOne({ filename: req.params.filename }, (err, file) => { if (!file) { return res.status(404).json({ err: ‘文件不存在!’ }) } const readstream = gfs.createReadStream(file.filename) readstream.pipe(res) }) })

3.8 单个文件删除

在这里我们通过a标签访问 /files/:id 接口,id对应,点击删除按钮,就直接删除了,并重定向到首页

app.delete(‘/files/:id’, (req, res) => { gfs.remove({ _id: req.params.id, root: ‘upload’ }, (err) => { if (err) { return res.status(404).json({ err: ‘删除的文件不存在!’ }) } res.redirect(‘/’) }) })

由于我们一直用form做请求,但是form表单没有delete请求方式,所以我们用到了method-override插件,当然要是用Ajax就没关系了,我们项目毕竟速成嘛,主要看效果和过程。

(推荐微课:MongoDB入门与案例分析

4 完结撒花了

简简单单的告一段落了,学了的小伙伴们可以尝试更加深入的操作,所以我们就可以用此项目来做一个图床或者小网盘盘,还是简简单单滴。当然该附件上传也有一定的限制问题,比如大文件可能上传时间更久,我们就需要采用文件分片方式上传了。

以上就是个关于如何使用用Node+MongoDB搭建简单的图床或者网盘的相关介绍了,希望对大家有所帮助。

如何搭建MQTT测试服务器

thbcm阅读(384)

这段时间有个同事在开发一款物联网硬件,这需要将采集的传输到客户的MQTT服务器上,不过目前还在调试阶段,连接到对方服务器测试的话很不方便,于是他就想要搭建一个MQTT测试服务器。在网上搜索了常用的MQTT代理服务器,最终决定采用ActiveMQ Artemis

ActiveMQ介绍

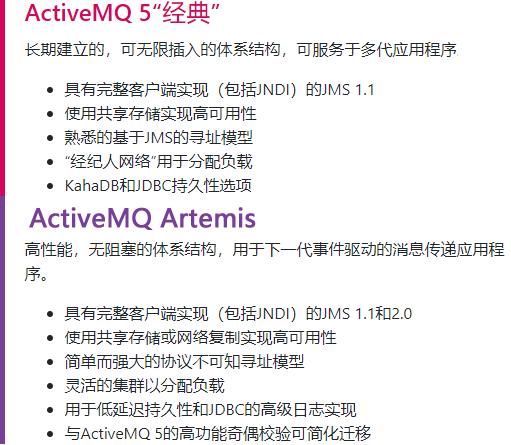
Apache ActiveMQ 是一款基于Java的消息服务器,支持多种协议可以使用CC++Python.Net等进行连接。ActiveMQ 官网介绍目前提供2个版本下载,ActiveMQ 经典版和ActiveMQ Artemis,其中Artemis为下一代高性能,非阻塞架构,基于事件驱动的消息系统。

ActiveMQ Artemis 安装

为了测试方便我们将ActiveMQ Artemis部署在windows平台,我们在activemq官网下载apache-artemis-2.14.0-bin.zip ,目前最新版本为2.14.0 (July 20, 2020)

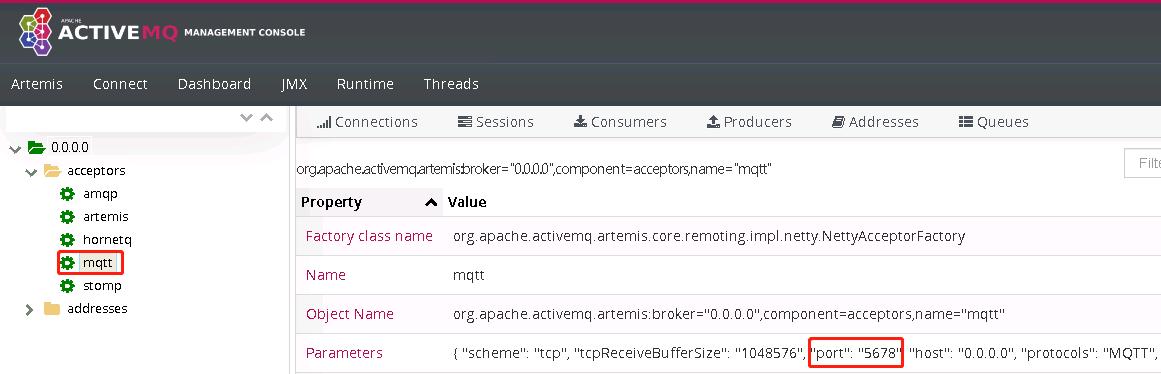
我们将下载的ZIP压缩包解压到D:\apache-artemis-2.14.0-boker。创建一个broker实例,实例需要新建一个文件夹F:\apache-artemis-2.14.0-boker,进入D:\apache-artemis-2.14.0-boker\bin目录执行(artemis create D:\apache-artemis-2.14.0-boker)创建broker实例,执行artemis create命令提示需要输入账号密码,按照提示输入即可。

创建成功后,执行artemis run启动broker实例。实例启动成功后,我们可以使用创建实例时输入的的账号密码登入管理面板。

ActiveMQ Artemis 配置

我们可以修改MQTT的默认端口,配置文件位置:实例文件夹\etc\broker.xml <!– MQTT Acceptor –> <acceptor name=”mqtt”>tcp://0.0.0.0:1883 我们将1883修改为我们需要的端口即可

修改管理面板WEB端口,配置文件位置:安装目录 \etc\bootstrap.xml <web bind=”localhost:8161″ path=”web”> 默认端口8161修改为你想要的端口

MQTT客户端测试

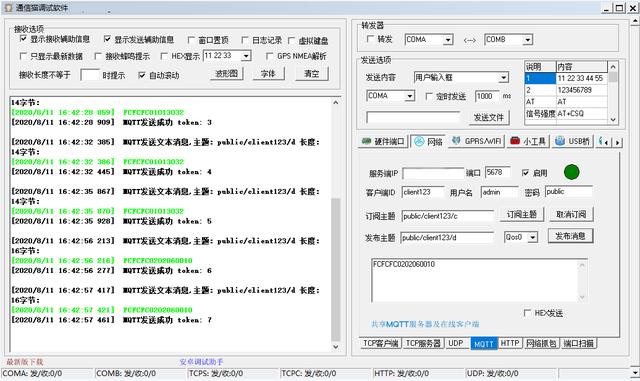
我们使用通讯猫调试软件,订阅硬件发布的主题消息。

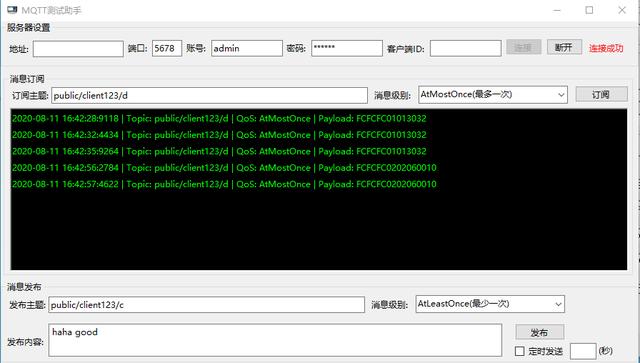
同事说能否自己弄一个简单的MQTT客户端,实时解析订阅收到的消息。客户端程序的话,用 C#winform写很方便,手撸一个MQTT客户端代码(使用MQTTnet)分分钟搞定。

以上就是关于如何搭建MQTT测试服务器的相关介绍了,希望对大家有所帮助。

Linux高性能I/O框架库Libevent介绍

thbcm阅读(388)

这篇文章主要讲一下Libevent库的内容,顺便对I/O库整体做个介绍。

Linux服务器程序必须处理的三类事件:

  • I/O事件
  • 信号
  • 定时事件

在处理这三类事件时我们通常需要考虑如下三个问题:

  • 统一事件源。很明显,统一处理这三类事件既能使代码简单易懂,又能避免一些潜在的逻辑错误。
  • 可移植性。不同的操作系统具有不同的I/O复用方式,比如Solarisdev/poll文件,FressBSDkqueue机制,Linuxepoll系统调用
  • 对并发编程的支持,在多进程和多线程环境下,我们需要考虑各执行实体如何协同处理客户连接、信号和定时器,以避免竞态条件。

幸运的是,开源社区提供了很多优秀的I/O框架库,他们不仅解决了上述问题,让开发者可以将精力完全放在程序的逻辑上,而且稳定性、性能等各方面都相当出色。而Libevent就是其中相对轻量级的框架库。

I/O框架库概述

I/O框架库以库函数的形式,封装了较为底层的系统调用,给应用程序提供了一组更便于使用的接口。这些库函数往往比程序员自己实现的同样功能的函数更合理、更高效、且更健壮。因为它们经受住了真实网络环境下的高压测试,以及时间的考验。

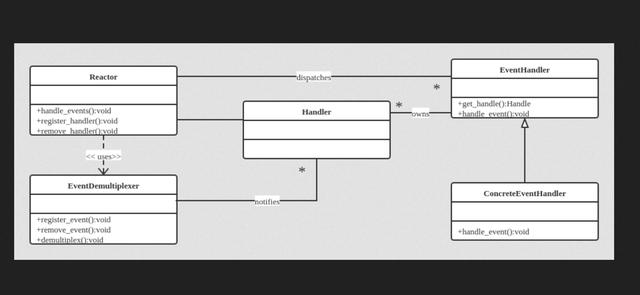
各种I/O框架库的实现原理基本相似,要么以Reactor模式实现,要么以Procator模式实现(高性能服务器程序框架 – 两种高效的事件处理模式),要么同时以这两种模式实现。举例来说,基于Reactor模式的I/O框架库包含如下几个组件:

  • 句柄Handle
  • 事件多路分发器EventDemultiplexer
  • 事件处理器Eventhandler
  • 具体的事件处理器ConcreteEventHandler
  • Reactor

(推荐教程:Linux教程

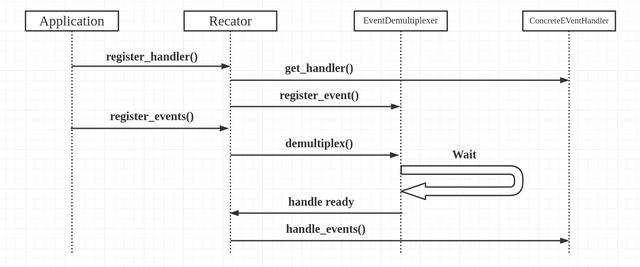
这些组件关系如下图:

  1. 句柄: I/O框架库要处理的对象,即I/O事件、信号和定时事件,统一称为事件源。一个事件源通常和一个句柄绑定在一起。句柄的作用是,当内核检测到就绪事件时,它将通过句柄来通知应用程序这一事件。在Linux环境下,I/O事件对应的句柄是文件描述符,信号事件对应的句柄就是信号值。
  2. 事件多路分发器:事件的到来是随机的、异步的。我们无法预知程序何时收到一个客户连接请求,又亦活收到一个暂停信号。所以程序需要循环地等待并处理事件,这就是事件循环。在事件循环中,等待事件一般使用I/O复用技术来实现。I/O框架库一般将系统支持的各种I/O复用系统调用封装成统一的接口,称为事件多路分发器。事件多路分发器的demultiplex方法是等待事件的核心函数,其内部调用的是selectpollepoll_wait等函数。此外事件多路分发器还需实现register_eventremove_event方法,以供调用者往事件多路分发器中添加事件和从事件多路分发器中删除事件。
  3. 事件处理器和具体时间处理器:事件处理器执行事件对应的业务逻辑。它通常包含一个或多个handle_event回调函数,这些回调函数在事件循环中被执行。I/O框架库提供的事件处理器通常是一个接口,用户需要继承它来实现自己的事件处理器,即具体事件处理器。因此,事件处理器中的回调函数一般被声明为需函数,以支持用户的扩展。此外,事件处理器一般还提供一个get_handle方法,它返回与该事件处理器关联的句柄。那么事件处理器和句柄有什么关系?当时间多路分发器检测到有事件发生时,它是通过句柄来通知应用程序的。因此,我们必须将事件处理器和句柄绑定,才能在事件发生时获取到正确的事件处理器。
  4. Reactor:Reactor是I/O框架的核心。它提供的几个主要方法是:
    • handle_events:该方法执行事件循环。它重复如下过程:等待事件,然后依次处理所有就绪事件对应的事件处理器。
    • register_handler: 该方法调用事件多路分发器的register_event方法来往事件多路分发器中注册一个事件。 –remove_handler:该方法调用事件多路分发器的remove_event方法来往删除事件多路分发器中注册一个事件。

I/O框架库的工作时序如下:

Libevent源码分析

Libevent是开源社区的一款高性能的I/O框架库,具有如下特点:

  • 跨平台支持
  • 统一事件源
  • 线程安全
  • 基于Reactor模式的实现

(推荐微课:Linux微课

一个实例

下面是用Libevent库实现的一个“Hello World”程序。

include <sys/signal.h>

#include <event2/event.h>


void signal_cb(int fd, short event, void *argc)
{
    struct event_base* base = (event_base*)argc;
    struct timeval delay = {2, 0};
    printf("Caught an interrupt signal; exiting cleanly in two seconds....\n");
    event_base_loopexit(base, &delay);
}


void timeout_cb(int fd, short event, void* argc)
{
    printf("timeout\n");
}


int main(int argc, char const *argv[])
{
    struct event_base* base = event_base_new();
    struct event* signal_event = evsignal_new(base, SIGINT, signal_cb, base);
    event_add(signal_event, NULL);


    timeval tv = {1, 0};
    struct event* timeout_event = evtimer_new(base, timeout_cb, NULL);
    event_add(timeout_event, &tv);


    event_base_dispatch(base);


    event_free(timeout_event);
    event_free(signal_event);
    event_base_free(base);


    return 0;
}

上述代码虽然简单,但却基本描述了Libevent库的主要逻辑:

  1. 调用event_base_new函数创建event_base对象。一个event_base相当于一个Reactor实例。
  2. 创建具体的事件处理器,并设置它们所从属的Reactor实例。evsignal_newevtimer_new分别用于创建信号事务处理器和定时事件处理器。它们是定义在如下:

define evsignal_new(b, x, cb, arg) \

    event_new((b), (x), EV_SIGNAL|EV_PERSIST, (cb), (arg))
#define evtimer_new(b, cb, arg)     event_new((b), -1, 0, (cb), (arg))

可见,他们的统一入口是event_new函数,即用于创建通用事件处理器的函数,定义如下:

event_new(struct event_base base, evutil_socket_t fd, short events, void (cb)(evutil_socket_t, short, void ), void arg)其中,base参数指定行

其中:

  • base参数指定新创建的事件处理器从属的Reactor
  • fd参数指定与事件处理器关联的句柄。创建I/O事件处理器时,应该给fd参数传递文件描述符;创建信号事件处理器时,应该给fd参数传递信号值,比如之前实例代码中的SIGINT;创建定时事件处理器时则应该给fd参数传递-1
  • events参数指定事件类型,定义如下:
    #define EV_TIMEOUT  0x01   /*定时事件*/
    #define EV_READ     0x02         /*可读事件*/
    #define EV_WRITE    0x04        /*可写事件*/
    #define EV_SIGNAL   0x08       /*信号事件*/
    #define EV_PERSIST  0x10     /*永久事件*/
    /*边缘触发事件,需要I/O复用系统调用支持,比如epoll */
    #define EV_ET       0x20

上述代码中,EV_PERSIST的作用是:事件被触发后,自动重新对这个event调用event_add函数。

  • cb参数指定目标事件对应的回调函数,相当于事件处理器handle_event方法.
  • arg则是Reactor传递给回调函数的参数。

event_new函数成功时返回一个event类型的对象,也就是Libevent的事件处理器。Libevent用单词“event”来描述事件处理器,而不是事件,所以约定如下:

  • 事件指的是一个句柄上绑定的事件,比如文件描述符 0 上的可读事件
  • 事件处理器,也就是event结构提类型的对象,除了包含事件必须具备的两个要素(句柄和事件类型)外,还有很多其他成员,比如回调函数
  • 事件由事件多路分发器管理,事件处理器则由事件队列管理,事件队列包括多种,比如event_base中的注册事件队列。
  • 事件循环对一个被激活事件(就绪事件)的处理,指的是执行该事件对应的事件处理器中的回调函数。
  1. 调用event_add函数,将事件处理器添加到注册事件队列中,并将该事件处理器对应的事件添加到事件多路分发器中。even_add函数相当于Reactor中的register_handler方法。
  2. 调用event_base_dispatch函数来执行事件循环
  3. 事件循环结束后,使用*_free系列释放系统资源

(推荐课程:Linux就该这么学

源代码组织结构

  • github地址:https://github.com/libevent/libevent
  • 头文件目录include/event2。该目录是自Libevent主板本升级到2.0之后引入的,是提供给应用程序使用的,比如event.h头文件是核心函数,http.h头文件提供HTTP协议相关服务,rpc.h头文件提供远程过程调用支持。
  • 源码根目录下的头文件。这些头文件分为两类:
  • 一类是对include/event2目录下的部分头文件的包装
  • 另外一类是供Libevent内部使用的辅助性头文件,它们的文件名都具有*-internal.h的形式。
  • 通用数据目录compat/sys。该目录下仅有一个文件—-queue.h。它封装了跨平台的基础数据结构,包括单向链表、双向链表、队列、尾队列和循环队列。
  • sample目录。提供一些示例代码
  • test目录。提供一次额测试代码
  • WIN32-Code。提供Windows平台上的一些专用代码。
  • event.c文件。该文件时间Libevent的整体框架,主要是eventevent_base两个结构体的相关操作。
  • debpoll.ckqueue.cevport.cselect.cwin32select.cpoll.cepoll.c文件。它们分别封装了如下I/O复用机制:/dev/pollkqueueevent portsPOSIX selectWindows selectpollepoll。这些文件的主要内容相似,都是针对结构体eventop所定义的接口函数的具体实现。
  • minheap-internal.h:该文件实现了一个事件堆,以提供对定时事件的支持。
  • signal.c:提供对信号的支持。其内容也是针对结构体eventop所定义的接口函数的具体实现
  • evmap.c文件:它维护句柄(文件描述符或信号)与时间处理器的映射关系
  • event_tagging.c:提供往缓冲区中添加标记数据,比如一个正数,以及从缓冲区中读取标记数据的函数
  • event_iocp文件:提供对Windows IOCP(Input/Output Completion Port,输入输出完成端口)的支持
  • buffer*.c文件:提供对网络I/O缓冲的控制,包括:输入输出数据过滤,传输速率限制,使用SSL(Secure Sockets Layer)协议对应用数据进行保护,以及零拷贝文件传输等。
  • evthread*.c文件:提供对多线程的支持
  • listener.c:封装了对监听socket的操作,包括监听连接和接受连接
  • logs.c文件。它是Libevent的日志文件系统
  • evutil.cevutil_rand.cstrlcpy.carc4random.c文件:提供了一些基本操作,比如生成随机数、获取socket地址信息、读取文件、设置socket属性等
  • evdns.chttp.cevrpc.c地址信息:分别提供了对DNS协议、HTTP协议和RPC(Remote Procddure Call,远程过程调用)协议的支持
  • epoll_sub.c文件,该文件未见使用

在整个源码中,event-internal.hinclude/event2/event_struct.hevent.cevmap.c等4个文件最为重要。它们定义了eventevent_base结构体,并实现了这两个结构体的相关操作。

以上就是关于Linux中高性能I/O框架库Libevent的相关介绍了,希望对大家有所帮助。

如何通过Go语言实现凯撒加密

thbcm阅读(392)

在 2 世纪, 发送机密消息的一个有效方法就是对每个字母进行位移, 使得 'a' 变为 'd''b' 变为 'e' , 依次类推。 这样处理产生的结果看上去就像是一门外语:

L fdph, L vdz, L frqtxhuhg. —— 尤利乌斯·凯撒(Julius Caesar)

正如代码清单 9-6 所示, 使用计算机以数值方式处理字符是非常容易的。

代码清单 9-6 处理单个字符: caesar.go

c := 'a'
c=c+3
fmt.Printf("%c", c)    // 打印出“d”

(推荐课程:Go教程

然而, 代码清单 9-6 展示的方法并不完美, 因为它没有考虑该如何处理字符 'x''y''z' , 所以它无法对 xylophonesyakszebras 这样的单词实施加密。 为了解决这个问题, 最初的凯撒加密法采取了回绕措施, 也就是将 'x' 变为 'a''y' 变为 'b' , 而 'z' 则变为 'c' 。 对于包含 26 个字符的英文字母表, 我们可以通过这段代码实现上述变换:

if c > 'z' {
    c = c - 26
}

凯撒密码的解密方法跟加密方法正好相反, 程序不再是为字符加上 3 而是减去 3 , 并且它还需要在字符过小也就是 c< 'a' 的时候, 将字符加上 26 以实施回绕。 虽然上述的加密方法和解密方法都非常直观, 但由于它们都需要处理字符边界以实现回绕, 因此实际的编码过程将变得相当痛苦。

回转 13 (rotate 13,简称ROT13)是凯撒密码在 20 世纪的一个变体, 该变体跟凯撒密码的唯一区别就在于, 它给字符添加的量是 13 而不是 3 , 并且 ROT13 的加密和解密可以通过同一个方法实现, 这是非常方便的。

现在, 假设搜寻外星智能 (Search for Extra-terrestrial Intelligence, SETI) 的相关机构在外太空扫描外星人通信信息的时候, 发现了包含以下消息的广播:

message := "uv vagreangvbany fcnpr fgngvba"

我们有预感, 这条消息很可能是使用 ROT13 加密的英文文本, 但是在解密这条消息之前, 我们还需要知悉其包含的字符数量, 这条消息包含 30 个字符, 可以通过内置的 len 函数来确定:

fmt.Println(len(message))    // 打印出“30”

注意 Go 拥有少量无须导入语句即可使用的内置函数, len 函数即是其中之一, 它可以测定各种不同类型的值的长度。 例如, 在上面的代码中, len 返回的就是 string 类型的字节长度。 代码清单 9-7 展示的就是外太空消息的解密程序, 你只需要在 Go Playground 运行这段代码, 就会知道外星人在说什么了。

代码清单 9-7 ROT13 消息解密: rot13.go

message := "uv vagreangvbany fcnpr fgngvba"


for i := 0; i < len(message); i++ {    // 迭代字符串中的每一个 ASCII 字符
    c := message[i]
    if c >= 'a' && c <= 'z' {    // 只解密英文字母,至于空格和标点符号则保持不变
        c = c + 13
        if c > 'z' {
            c = c - 26
        }
    }
    fmt.Printf("%c", c)
}

(推荐微课:Go微课

注意, 这段代码中的 ROT13 实现只能处理 ASCII 字符(字节), 它无法处理用西班牙语或者俄语撰写的消息, 不过接下来的一节将会给出这个问题的解决方案。

以上就是关于使用 Go语言实现凯撒加密的相关介绍了,希望对大家有所帮助。

Python版本管理工具与虚拟环境的介绍

thbcm阅读(414)

这里简单的介绍一下Python版本管理工具–pyenv和三个个虚拟环境,分别是virtualenvancondapipenv

版本管理工具–pyenv

这个呢是一个python版本管理的包,你可以通过git直接下载源码,安装方法里面都有https://github.com/pyenv/pyenv git地址,下载下来,然后一步一步跟着做就好了。

简单来看一下几个路径含义

  1. ~/.pyenv/shims/

这里面存放的python命令,是我们在终端输入python时候执行的,我们可以把PATH打印一下,可以看出,这个路径的命令是在最前面的。我们输入python后,pyenv会根据我们设置的去找真正要执行的python命令。

  1. ~/.pyenv/versions/

这个目录里面存放的就是我们安装的python版本。(注意:如果我们安装时候特别慢,不要着急.我们可以把终端打印出来的地址,放在浏览器里,然后下载下来,把下载的文件移动到~/.pyenv/cache/下就可以.刚开始要自己建这个cache目录的)

(推荐教程:python教程

python版本设置有两个命令

  1. pyenv local 名称:在当前目录使用这个python版本
  2. pyenv global 名称:将全局的python版本设置成这个版本

名称我们可以通过pyenv versions来查看,里面会有一个system的名称,这个是你机器原来的python版本,一般情况下我们都用local来针对某一个目录设置python,全局还是用我们系统的。用local我们可以在当前目录下找到一个.python_version的文件.pyenv应该就是读这个文件,知道你在当前目录要用什么版本的python

用过node的可能会发现,其实这个跟nodenvm差不多一样的性质。

虚拟环境–virtualenv

我最开始使用的虚拟环境是virtualenv,这个的用法,网上也有一大堆。简单说一下吧,因为我现在很少用。

安装:pip install virtualenv
创建:virtualenv env名称
进入虚拟环境:source env名称/bin/activate
退出虚拟环境:deactivate

进入环境,你就可以在里面用pip install了。安装的包就是在当前环境中。

虚拟环境–anconda

后来我看还有个anconda的包管理器,也能创建虚拟环境。这个也有很多安装教程。

安装:官网有教程,下载下来运行就可以了
创建:conda create -n env名称 python=2.7
进入:conda activate env名称
退出:conda deactivate

进入环境,你也可以在里面安装包,安装包用的是anconda的命令:conda install 包。这里面可能有一些包找不到,你也可以用pip install来安装。

注意:用pip来安装就有点坑,如果你本地机器上已经安装了这个包了,那pip install就安装不了,如果你pip install安装的包跟你本机的版本不一样,他会卸载了本机的包,然后重新在你的conda环境中新安装一个包。这样你本机就没有这个包了。对于一个新机器来说,可能比较好吧,毕竟以后运行项目都在虚拟环境,但是对于一些有在本机环境运行项目的人来说,就不那么友好,有可能你用着anconda,莫名其妙的本机就缺少包。当然你也可以再安装。

虚拟环境–pipenv

后来,最近我又发现了一个pipenv,这个感觉比较好。

安装:pip install pipenv
创建:pipenv install --python=2.7
进入:进入目录,pipenv shell
退出:deactivate

创建一个虚拟环境,存放在默认目录下,我的默认目录是~.local/share/下面,然后会在当前目录创建一个Pipfile的文件。里面记录着你安装的包。安装包用pipenv install ,安装的包,都会在Pipfile里面记录着,如果你当前目录已经有Pipfile,你pipenv install,他就会创建一个跟当前目录关联的虚拟环境,然后安装Pipfile中的包。里面可以设置下载包的源。以提高下载速度。安装完,会生成一个Pipfile.lock的文件。里面记录着真实的下载的包的一些信息,当项目迁移的时候,把这几个目录一起,不管在哪里,运行的环境都是一样的。这也是我比较喜欢的一点,有点像nodepackage.json文件的功能。

(推荐微课:python3基础微课

以上就是关于Python版本管理工具和虚拟环境的相关介绍了,希望对大家有所帮助。

联系我们