了解RXJS中四种Subject的区别

thbcm阅读(563)

「RxJS」全称 「Reactive Extensions for JavaScript」, RxJS 是一个库,它通过使用 observable 序列来编写异步和基于事件的程序。本文带你了解RXJS中四种Subject的使用。

介绍

Subject 是用于多播的Observable,这意味着Subject确保每个订阅都获得与订阅者之间共享可观察执行完全相同的值。

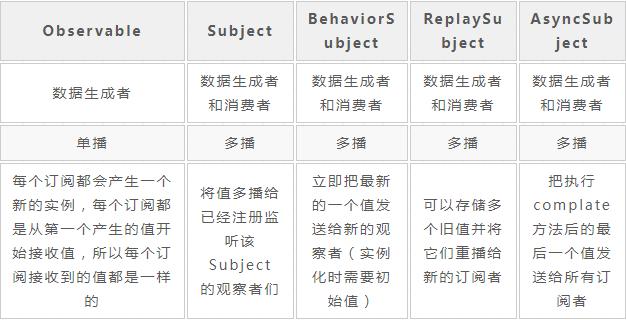
在介绍它们之前,我们先来看一下四种Subject与普通Observable的区别:

Subject

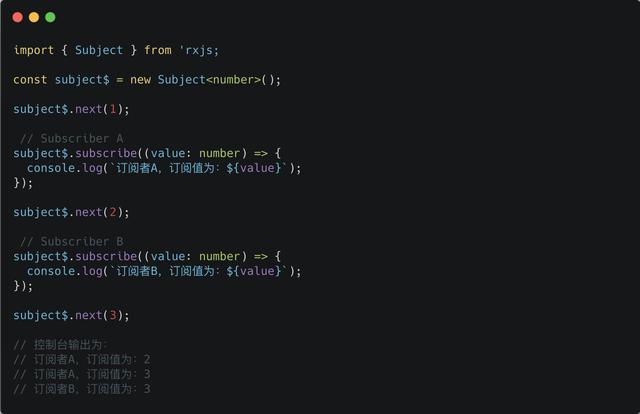
Subject其实是观察者模式的实现,所以当观察者订阅Subject对象时,它会把订阅者添加到观察者列表中,每当有接收到新值时,它就会遍历观察者列表,依次调用观察者内部的next方法,把值一一送出。我们先来看一下Subject的使用方法:

上面例子就比较容易理解:

  1. 我们创建了一个Subject
  2. 发出了一个值1,但由于此时并没有订阅者,所以这个值不会被订阅到
  3. 创建了订阅者 A
  4. 又发出一个值 2,这时候订阅者 A 会接收到这个值
  5. 又创建一个订阅者 B
  6. 最后发出一个值 3,这时候已经订阅的都会接收到这个值

BehaviorSubject

很多时候我们会希望Subject能代表当下的状态,而不是单纯的事件发送,也就是说如果当前有一个新的订阅,我们希望Subject能立即给出最新的值,而不是没有回应。这个时候我们就可以使用到BehaviorSubject

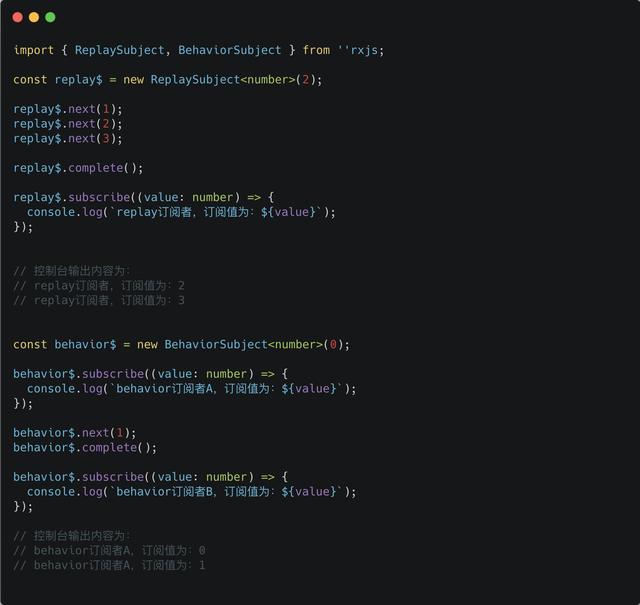
BehaviorSubject继承自Subject,它具有存储当前值的特征。这表示你可以始终直接从BehaviorSubject获取到最后发出的值。请参阅下面代码示例:

这段代码做了那些工作呢?

  1. 我们首先创建了一个BehaviorSubject的实例behavior$,并在实例化时传入初始值 0。
  2. 然后我们订阅了这个这个实例behavior$,由于BehaviorSubject的特点是把最新的值发布给订阅者,订阅者 A 会得到初始值 0,所以就会打引出订阅者 A,订阅值为:0
  3. behavior$使用内置的next方法发出一个新的值 1,这时候订阅者 A 将会收到新的值,打印出订阅者 A,订阅值为 1
  4. 我们增加一个订阅者 B,这时候它会得到最新的值 1,所以打印结果为订阅者B,订阅值为 1
  5. 最后我们再一次调用behavior$next方法,由于我们之前已经订阅了两次,所以订阅者 A 和订阅者 B 都会接收到新的value

(推荐教程:JavaScript教程

ReplaySubject

有时候我们创建一个Subject,但又想在每次新的订阅时,它都会重新发送最后几个值,这个时候我们就可以用到ReplaySubject

ReplaySubject可以将旧数据发送给新的订阅者,这点很像是BehaviorSubject,但是它还有一个额外的特性,它可以记录一部分的observable执行,所以它可以存储多个旧值并发送给它的新订阅者。

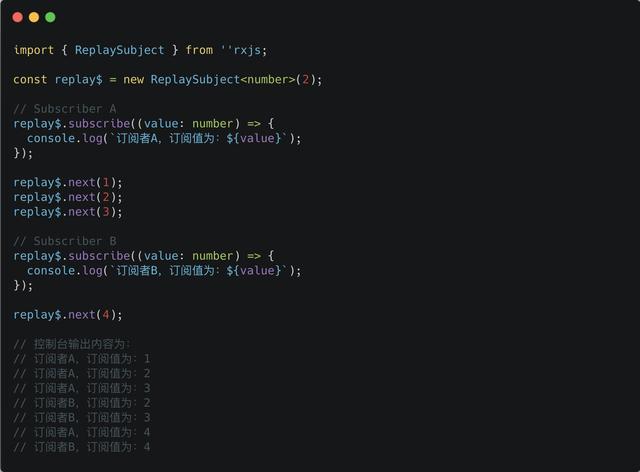
创建ReplaySubject时,可以指定要存储多少值以及要存储多长时间。它的第一个参数 bufferSize指定了缓存的大小,默认为 Infinity,即缓存所有发出的值,是一个「空间限制」。我们还可以向其传递第二个参数 windowTime,指定缓存的「时间限制」,默认为 Infinity,即不限制值的失效时间。请参阅下面代码示例:

这里发生了一些事情:

  1. 我们创建了一个ReplaySubject的实例replay$,并指定我们只想存储最后两个值
  2. 我们创建了一个订阅者 A
  3. 调用三次replay$next方法,把值发布给订阅者。这时订阅者 A 将会打印三次
  4. 现在就来体验ReplaySubject的魔力。我们使用replay$创建了一个新的订阅者 B,由于我们告诉ReplaySubject,存储两个值,因此它将直接向订阅者 B 发出这些最后的值,订阅者 B 将打印出这些值。
  5. replay$发出另外一个值,这时候,订阅者 A 和订阅者 B 都接收到值的改变,打印出另外一个值

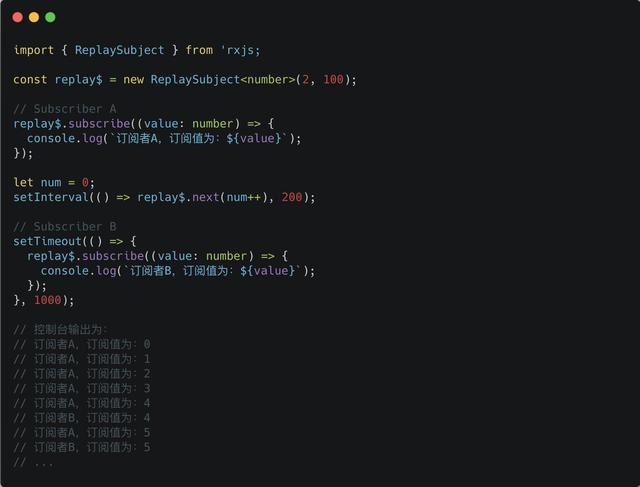
如前面所说的一样,你还可以指定值在ReplaySubject存储的时间,我们来看一个例子

上面代码中发生了那些事情呢:

  1. 我们创建了ReplaySubject,并指定它只存储最后两个值,但是不超过 100ms
  2. 创建一个订阅者 A
  3. 我们开始每 200ms 发出一个新的值。订阅者 A 会接收到发出的所有值
  4. 我们创建一个订阅者 B,由于是在 1000ms 后进行订阅。这意味着在开始订阅之前,replay$已经发出了 5 个值。在创建ReplaySubject时,我们指定最多存储 2 个值,并且不能超过 100ms。这意味着在 1000ms 后,订阅者 B 开始订阅时,由于replay$是 200ms 发出一个值,因此订阅者 B 只会接收到 1 个值。

有的同学看到这里,会感觉到ReplaySubject(1)是不是就等同于BehaviorSubject。但是,二者无论在概念上还是行为上,都是有所区别的。

首先概念上的区别是本质的,ReplaySubject只是缓存了最近的值,它仍然反映的是不断有值产生的流(「多值」),而BehaviorSubject反映的则是随时间变化的值(「单值」)。因此,BehaviorSubject需要传入一个初始值,然后这个值将不断变化,我们只能看见当前的值。

在行为上,由于ReplaySubject侧重于缓存,那么当它完成时,并不会影响我们继续观测它缓存的值。我们来看下面这个例子:

ReplaySubject在执行完complate时,我们订阅它仍然可以拿到缓存的值,而BehaviorSubject在执行完complate时,我们继续订阅它已经没有任何作用了。

AsyncSubject

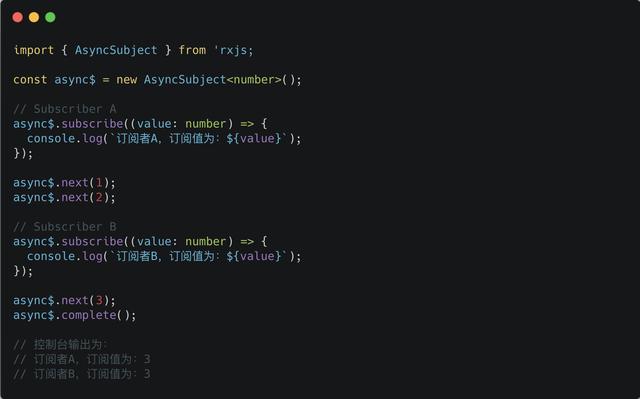
虽然BehaviorSubjectReplaySubject都存储值,但AsyncSubject的工作方式却有所不同。AsyncSubject是一个Subject变体,其中仅Observable执行的最后一个值发送到其订阅者,并且仅在执行完成时发送(类似于rxjs/operators里面的last方法)。请参考下面的示例代码:

这次没有太多的事情发生。但是,让我们看一下执行步骤:

  1. 我们创建AsyncSubject的实例async$
  2. 我们通过订阅者 A 进行订阅
  3. async$发出 2 个值,仍然没有发生变化
  4. 我们创建一个订阅者 B
  5. 发出新的值,但是两个订阅者都没有任何反应
  6. async$执行complate完成,这时候将最后一个值发送给所有订阅者

从上面的代码示例可以看出来AsyncSubject会在执行complate后才送出最后一个值,其实这个行为跟 Promise 很像,都是等到事情结束后送出一个值。在 Promise 中,我们可以通过 resolve(value)声明任务完成,并将获得的值发送出去,然后再通过Promise.then()方法中处理得到的值。

(推荐微课:JavaScript微课

以上就是关于RXJS中四种Subject的区别的相关介绍了,希望对大家有所帮助。

Java跟Linux内核距离有多远

thbcm阅读(424)

本文中我们将站在非内核开发者的角度,给大家介绍应用和系统工程师如何梳理 Linux 内核代码。希望大家读完之后能有所收获,也希望更多的开发者能够关注到内核开发领域,毕竟连祖师爷 Linus 都表示内核维护者要后继无人了呀!

Java 离内核有多远?

测试环境版本信息:

Ubuntu(lsb_release -a) Distributor ID: UbuntuDescription: Ubuntu 19.10Release: 19.10
Linux(uname -a) Linux yahua 5.5.5 #1 SMP … x86_64 x86_64 x86_64 GNU/Linux
Java Openjdk jdk14

玩内核的人怎么也懂 Java?这主要得益于我学校的 Java 课程和毕业那会在华为做 Android 手机的经历,几个模块从 APP/Framework/Service/HAL/Driver 扫过一遍,自然对 Java 有所了解。

每次提起 Java,我都会想到一段有趣的经历。刚毕业到部门报到第一个星期,部门领导(在华为算是 Manager)安排我们熟悉 Android。我花了几天写了个 Android 游戏,有些类似连连看那种。开周会的时候,领导看到我的演示后,一脸不悦,质疑我的直接领导(在华为叫 PL,Project Leader)没有给我们讲明白部门的方向。

emm,我当时确实没明白所谓的熟悉 Android 是该干啥,后来 PL 说,是要熟悉 xxx 模块,APP 只是其中一部分。话说如果当时得到的是肯定,也许我现在就是一枚 Java 工程师了(哈哈手动狗头)。

(推荐教程:Java教程

从 launcher 说起

世界上最远的距离,是咱俩坐隔壁,我在看底层协议,而你在研究 spring……如果想拉近咱俩的距离,先下载 openjdk 源码(openjdk),然后下载 glibcglibc),再下载内核源码kernel)。

Java 程序到 JVM,这个大家肯定比我熟悉,就不班门弄斧了。

我们就从 JVM 的入口为例,分析 JVM 到内核的流程,入口就是 main 函数了(java.base/share/native/launcher/main.c):

JNIEXPORT int
main(int argc, char **argv)
{
    //中间省略一万行参数处理代码
    return JLI_Launch(margc, margv,
                   jargc, (const char**) jargv,
                   0, NULL,
                   VERSION_STRING,
                   DOT_VERSION,
                   (const_progname != NULL) ? const_progname : *margv,
                   (const_launcher != NULL) ? const_launcher : *margv,
                   jargc > 0,
                   const_cpwildcard, const_javaw, 0);
}

JLI_Launch 做了三件我们关心的事。

首先,调用 CreateExecutionEnvironment 查找设置环境变量,比如 JVM 的路径(下面的变量 jvmpath),以我的平台为例,就是 /usr/lib/jvm/java-14-openjdk-amd64/lib/server/libjvm.sowindow 平台可能就是 libjvm.dll

其次,调用 LoadJavaVM 加载 JVM,就是 libjvm.so 文件,然后找到创建 JVM 的函数赋值给 InvocationFunctions 的对应字段:

jboolean LoadJavaVM(const char *jvmpath, InvocationFunctions *ifn)
{
void *libjvm;
//省略出错处理
    libjvm = dlopen(jvmpath, RTLD_NOW + RTLD_GLOBAL);
    ifn->CreateJavaVM = (CreateJavaVM_t)
        dlsym(libjvm, "JNI_CreateJavaVM");
    ifn->GetDefaultJavaVMInitArgs = (GetDefaultJavaVMInitArgs_t)
        dlsym(libjvm, "JNI_GetDefaultJavaVMInitArgs");
    ifn->GetCreatedJavaVMs = (GetCreatedJavaVMs_t)
        dlsym(libjvm, "JNI_GetCreatedJavaVMs");
    return JNI_TRUE;
}

dlopendlsym 涉及动态链接,简单理解就是 libjvm.so 包含 JNI_CreateJavaVMJNI_GetDefaultJavaVMInitArgsJNI_GetCreatedJavaVMs 的定义,动态链接完成后,ifn->CreateJavaVMifn->GetDefaultJavaVMInitArgsifn->GetCreatedJavaVMs 就是这些函数的地址。

不妨确认下 libjvm.so 有这三个函数。

objdump -D /usr/lib/jvm/java-14-openjdk-amd64/lib/server/libjvm.so | grep -E 
"CreateJavaVM|GetDefaultJavaVMInitArgs|GetCreatedJavaVMs" | grep ":$"
00000000008fa9d0 <JNI_GetDefaultJavaVMInitArgs@@SUNWprivate_1.1>:
00000000008faa20 <JNI_GetCreatedJavaVMs@@SUNWprivate_1.1>:
00000000009098e0 <JNI_CreateJavaVM@@SUNWprivate_1.1>:

openjdk 源码里有这些实现的(hotspot/share/prims/下),有兴趣的同学可以继续钻研。

最后,调用 JVMInit 初始化 JVMload Java 程序。

JVMInit 调用 ContinueInNewThread,后者调用 CallJavaMainInNewThread。插一句,我是真的不喜欢按照函数调用的方式讲述问题,a 调用 b,b 又调用 c,简直是在浪费篇幅,但是有些地方跨度太大又怕引起误会(尤其对初学者而言)。相信我,注水,是真没有,我不需要经验+3 哈哈。

CallJavaMainInNewThread 的主要逻辑如下:

int CallJavaMainInNewThread(jlong stack_size, void* args) {
    int rslt;
    pthread_t tid;
    pthread_attr_t attr;
    pthread_attr_init(&attr);
    pthread_attr_setdetachstate(&attr, PTHREAD_CREATE_JOINABLE);
    if (stack_size > 0) {
        pthread_attr_setstacksize(&attr, stack_size);
    }
    pthread_attr_setguardsize(&attr, 0); // no pthread guard page on java threads
    if (pthread_create(&tid, &attr, ThreadJavaMain, args) == 0) {
        void* tmp;
        pthread_join(tid, &tmp);
        rslt = (int)(intptr_t)tmp;
    } 
   else {
        rslt = JavaMain(args);
    }
    pthread_attr_destroy(&attr);
    return rslt;
}

看到 pthread_create 了吧,破案了,Java 的线程就是通过 pthread 实现的。此处就可以进入内核了,但是我们还是先继续看看 JVMThreadJavaMain 直接调用了 JavaMain,所以这里的逻辑就是,如果创建线程成功,就由新线程执行 JavaMain,否则就知道在当前进程执行JavaMain

JavaMain 是我们关注的重点,核心逻辑如下:

int JavaMain(void* _args)
{
    JavaMainArgs *args = (JavaMainArgs *)_args;
    int argc = args->argc;
    char **argv = args->argv;
    int mode = args->mode;
    char *what = args->what;
    InvocationFunctions ifn = args->ifn;
    JavaVM *vm = 0;
    JNIEnv *env = 0;
    jclass mainClass = NULL;
    jclass appClass = NULL; // actual application class being launched
    jmethodID mainID;
    jobjectArray mainArgs;
    int ret = 0;
    jlong start, end;
    /* Initialize the virtual machine */
    if (!InitializeJVM(&vm, &env, &ifn)) {    //1
        JLI_ReportErrorMessage(JVM_ERROR1);
        exit(1);
    }
    mainClass = LoadMainClass(env, mode, what);    //2
    CHECK_EXCEPTION_NULL_LEAVE(mainClass);
    mainArgs = CreateApplicationArgs(env, argv, argc);
    CHECK_EXCEPTION_NULL_LEAVE(mainArgs);
    mainID = (*env)->GetStaticMethodID(env, mainClass, "main",
                                       "([Ljava/lang/String;)V");    //3
    CHECK_EXCEPTION_NULL_LEAVE(mainID);
    /* Invoke main method. */
    (*env)->CallStaticVoidMethod(env, mainClass, mainID, mainArgs);    //4
    ret = (*env)->ExceptionOccurred(env) == NULL ? 0 : 1;
    LEAVE();
}

第 1 步,调用 InitializeJVM 初始化 JVMInitializeJVM 会调用 ifn->CreateJavaVM,也就是libjvm.so 中的 JNI_CreateJavaVM

第 2 步,LoadMainClass,最终调用的是 JVM_FindClassFromBootLoader,也是通过动态链接找到函数(定义在 hotspot/share/prims/ 下),然后调用它。

第 3 和第 4 步,Java 的同学应该知道,这就是调用 main 函数。

有点跑题了……我们继续以 pthread_create 为例看看内核吧。

其实,pthread_create 离内核还有一小段距离,就是 glibcnptl/pthread_create.c)。创建线程最终是通过 clone 系统调用实现的,我们不关心 glibc 的细节(否则又跑偏了),就看看它跟直接 clone 的不同。

(推荐微课:Java微课

以下关于线程的讨论从书里摘抄过来。

const int clone_flags = (CLONE_VM | CLONE_FS | CLONE_FILES | CLONE_SYSVSEM
   | CLONE_SIGHAND | CLONE_THREAD
   | CLONE_SETTLS | CLONE_PARENT_SETTID
   | CLONE_CHILD_CLEARTID
   | 0);
__clone (&start_thread, stackaddr, clone_flags, pd, &pd->tid, tp, &pd->tid);

各个标志的说明如下表(这句话不是摘抄的。。。)。

标志 描述
CLONE_VM 与当前进程共享VM
CLONE_FS 共享文件系统信息
CLONE_FILES 共享打开的文件
CLONE_PARENT 与当前进程共有同样的父进程
CLONE_THREAD 与当前进程同属一个线程组,也意味着创建的是线程
CLONE_SYSVSEM 共享sem_undo_list
…… ……

与当前进程共享 VM、共享文件系统信息、共享打开的文件……看到这些我们就懂了,所谓的线程是这么回事。

Linux实际上并没有从本质上将进程和线程分开,线程又被称为轻量级进程(Low Weight Process, LWP),区别就在于线程与创建它的进程(线程)共享内存、文件等资源。

完整的段落如下(双引号扩起来的几个段落),有兴趣的同学可以详细阅读:

fork 传递至 _do_forkclone_flags 参数是固定的,所以它只能用来创建进程,内核提供了另一个系统调用 cloneclone 最终也调用 _do_fork 实现,与 fork 不同的是用户可以根据需要确定 clone_flags,我们可以使用它创建线程,如下(不同平台下 clone 的参数可能不同):

SYSCALL_DEFINE5(clone, unsigned long, clone_flags, unsigned long, newsp,
 int __user *, parent_tidptr, int, tls_val, int __user *, child_tidptr)
{
return _do_fork(clone_flags, newsp, 0, parent_tidptr, child_tidptr);
}

Linux 将线程当作轻量级进程,但线程的特性并不是由 Linux 随意决定的,应该尽量与其他操作系统兼容,为此它遵循 POSIX 标准对线程的要求。所以,要创建线程,传递给 clone 系统调用的参数也应该是基本固定的。

创建线程的参数比较复杂,庆幸的是 pthread(POSIX thread)为我们提供了函数,调用pthread_create 即可,函数原型(用户空间)如下。

int pthread_create(pthread_t *thread, const pthread_attr_t *attr,
                          void *(*start_routine) (void *), void *arg);

第一个参数 thread 是一个输出参数,线程创建成功后,线程的 id 存入其中,第二个参数用来定制新线程的属性。新线程创建成功会执行 start_routine 指向的函数,传递至该函数的参数就是arg

pthread_create 究竟如何调用 clone 的呢,大致如下:

//来源: glibc
const int clone_flags = (CLONE_VM | CLONE_FS | CLONE_FILES | CLONE_SYSVSEM
   | CLONE_SIGHAND | CLONE_THREAD
   | CLONE_SETTLS | CLONE_PARENT_SETTID
   | CLONE_CHILD_CLEARTID
   | 0);
__clone (&start_thread, stackaddr, clone_flags, pd, &pd->tid, tp, &pd->tid);

clone_flags 置位的标志较多,前几个标志表示线程与当前进程(有可能也是线程)共享资源,CLONE_THREAD 意味着新线程和当前进程并不是父子关系。

clone 系统调用最终也通过 _do_fork 实现,所以它与创建进程的 fork 的区别仅限于因参数不同而导致的差异,有以下两个疑问需要解释。

首先,vfork 置位了 CLONE_VM 标志,导致新进程对局部变量的修改会影响当前进程。那么同样置位了 CLONE_VMclone,也存在这个隐患吗?答案是没有,因为新线程指定了自己的用户栈,由 stackaddr 指定。copy_thread 函数的 sp参数就是 stackaddrchildregs->sp = sp 修改了新线程的 pt_regs,所以新线程在用户空间执行的时候,使用的栈与当前进程的不同,不会造成干扰。那为什么 vfork 不这么做,请参考 vfork 的设计意图。

其次,fork 返回了两次,clone 也是一样,但它们都是返回到系统调用后开始执行,pthread_create 如何让新线程执行 start_routine 的?start_routine 是由 start_thread 函数间接执行的,所以我们只需要清楚 start_thread 是如何被调用的。start_thread 并没有传递给 clone 系统调用,所以它的调用与内核无关,答案就在 __clone 函数中。

(推荐教程:Linux教程

为了彻底明白新进程是如何使用它的用户栈和 start_thread 的调用过程,有必要分析 __clone 函数了,即使它是平台相关的,而且还是由汇编语言写的。

/*i386*/
ENTRY (__clone)
movl    $-EINVAL,%eax
movl    FUNC(%esp),%ecx /* no NULL function pointers */
testl   %ecx,%ecx
jz  SYSCALL_ERROR_LABEL
movl    STACK(%esp),%ecx    /* no NULL stack pointers */    //1
testl   %ecx,%ecx
jz  SYSCALL_ERROR_LABEL
andl    $0xfffffff0, %ecx  /*对齐*/    //2
subl    $28,%ecx
movl    ARG(%esp),%eax  /* no negative argument counts */
movl    %eax,12(%ecx)
movl    FUNC(%esp),%eax
movl    %eax,8(%ecx)
movl    $0,4(%ecx)
pushl   %ebx    //3
pushl   %esi
pushl   %edi
movl    TLS+12(%esp),%esi    //4
movl    PTID+12(%esp),%edx
movl    FLAGS+12(%esp),%ebx
movl    CTID+12(%esp),%edi
movl    $SYS_ify(clone),%eax
movl    %ebx, (%ecx)    //5
int $0x80    //6
popl    %edi    //7
popl    %esi
popl    %ebx
test    %eax,%eax    //8
jl  SYSCALL_ERROR_LABEL
jz  L(thread_start)
ret    //9
L(thread_start):    //10
movl    %esi,%ebp   /* terminate the stack frame */
testl   $CLONE_VM, %edi
je  L(newpid)
L(haspid):
call    *%ebx
/*…*/

__clone (&start_thread, stackaddr, clone_flags, pd, &pd->tid, tp, &pd->tid) 为例,

FUNC(%esp) 对应 &start_thread

STACK(%esp) 对应 stackaddr

ARG(%esp) 对应 pd(新进程传递给 start_thread 的参数)。

  • 第 1 步,将新进程的栈 stackaddr 赋值给 ecx,确保它的值不为 0。
  • 第 2 步,将 pd&start_thread 和 0 存入新线程的栈,对当前进程的栈无影响。
  • 第 3 步,将当前进程的三个寄存器的值入栈,esp寄存器的值相应减12。
  • 第 4 步,准备系统调用,其中将 FLAGS+12(%esp) 存入 ebx,对应 clone_flags,将clone 的系统调用号存入 eax。
  • 第 5 步,将 clone_flags 存入新进程的栈中。
  • 第 6 步,使用 int 指令发起系统调用,交给内核创建新线程。截止到此处,所有的代码都是当前进程执行的,新线程并没有执行。
  • 从第 7 步开始的代码,当前进程和新线程都会执行。对当前进程而言,程序将它第 3 步入栈的寄存器出栈。但对新线程而言,它是从内核的 ret_from_fork 执行的,切换到用户态后,它的栈已经成为 stackaddr 了,所以它的 edi 等于 clone_flagsesi 等于 0,ebx 等于&start_thread
  • 系统调用的结果由 eax 返回,第 8 步判断 clone 系统调用的结果,对当前进程而言,clone 系统调用如果成功返回的是新线程在它的 pid namespace 中的 id,大于 0,所以它执行 ret 退出__clone 函数。对新线程而言,clone 系统调用的返回值等于 0,所以它执行L(thread_start) 处的代码。clone_flagsCLONE_VM 标志被置位的情况下,会执行 call *%ebxebx 等于&start_thread,至此 start_thread 得到了执行,它又调用了提供给pthread_createstart_routine,结束。

如此看来,Java JVM glibc 内核,好像也没有多远。

(推荐微课:Linux微课

以上就是关于JavaLinux内核距离有多远的相关介绍了,希望对大家有所帮助。

学习Vue3.0,你需要先了解一下Proxy

thbcm阅读(395)

产品经理身旁过,需求变更逃不过。 测试姐姐眯眼笑,今晚bug必然多。

据悉Vue3.0的正式版将要在本月(8月)发布,从发布到正式投入到正式项目中,还需要一定的过渡期,但我们不能一直等到Vue3正式投入到项目中的时候才去学习,提前学习,让你更快一步掌握Vue3.0,升职加薪迎娶白富美就靠它了。不过在学习Vue3之前,还需要先了解一下Proxy,它是Vue3.0实现数据双向绑定的基础。

了解代理模式

一个例子

作为一个单身钢铁直男程序员,小王最近逐渐喜欢上了前端小妹,不过呢,他又和前台小妹不熟,所以决定委托与前端小妹比较熟的UI小姐姐帮忙给自己搭桥引线。小王于是请UI小姐姐吃了一顿大餐,然后拿出一封情书委托它转交给前台小妹,情书上写的 我喜欢你,我想和你睡觉,不愧钢铁直男。不过这样写肯定是没戏的,UI小姐姐吃人嘴短,于是帮忙改了情书,改成了我喜欢你,我想和你一起在晨辉的沐浴下起床,然后交给了前台小妹。虽然有没有撮合成功不清楚啊,不过这个故事告诉我们,小王活该单身狗。

其实上面就是一个比较典型的代理模式的例子,小王想给前台小妹送情书,因为不熟所以委托UI小姐姐UI小姐姐相当于代理人,代替小王完成了送情书的事情。

引申

通过上面的例子,我们想想Vue的数据响应原理,比如下面这段代码

const xiaowang = {
  love: '我喜欢你,我想和你睡觉'
}
// 送给小姐姐情书
function sendToMyLove(obj) {
    console.log(obj.love)
    return '流氓,滚'
}
console.log(sendToMyLove(xiaowang))

如果没有UI小姐姐代替送情书,显示结局是悲惨的,想想Vue2.0的双向绑定,通过Object.defineProperty来监听的属性 get,set方法来实现双向绑定,这个Object.defineProperty就相当于UI小姐姐

const xiaowang = {
  loveLetter: '我喜欢你,我想和你睡觉'
}
// UI小姐姐代理
Object.defineProperty(xiaowang,'love', {
  get() {
    return xiaowang.loveLetter.replace('睡觉','一起在晨辉的沐浴下起床')
  }
})


// 送给小姐姐情书
function sendToMyLove(obj) {
    console.log(obj.love)
    return '小伙子还挺有诗情画意的么,不过老娘不喜欢,滚'
}
console.log(sendToMyLove(xiaowang))

虽然依然是一个悲惨的故事,因为送奔驰的成功率可能会更高一些。但是我们可以看到,通过Object.defineproperty可以对对象的已有属性进行拦截,然后做一些额外的操作。

存在的问题

Vue2.0中,数据双向绑定就是通过Object.defineProperty去监听对象的每一个属性,然后在get,set方法中通过发布订阅者模式来实现的数据响应,但是存在一定的缺陷,比如只能监听已存在的属性,对于新增删除属性就无能为力了,同时无法监听数组的变化,所以在Vue3.0中将其换成了功能更强大的Proxy

(推荐教程:Vue 2教程

了解Proxy

ProxyES6新推出的一个特性,可以用它去拦截js操作的方法,从而对这些方法进行代理操作。

用Proxy重写上面的例子

比如我们可以通过Proxy对上面的送情书情节进行重写:

const xiaowang = {
  loveLetter: '我喜欢你,我想和你睡觉'
}
const proxy = new Proxy(xiaowang, {
  get(target,key) {
    if(key === 'loveLetter') {
      return target[key].replace('睡觉','一起在晨辉的沐浴下起床')
    }
  }
})
// 送给小姐姐情书
function sendToMyLove(obj) {
    console.log(obj.loveLetter)
    return '小伙子还挺有诗情画意的么,不过老娘不喜欢,滚'
}
console.log(sendToMyLove(proxy))

再看这样一个场景

请分别使用Object.definePropertyProxy完善下面的代码逻辑.

function observe(obj, callback) {}


const obj = observe(
  {
    name: '子君',
    sex: '男'
  },
  (key, value) => {
    console.log(`属性[${key}]的值被修改为[${value}]`)
  }
)


// 这段代码执行后,输出 属性[name]的值被修改为[妹纸]
obj.name = '妹纸'


// 这段代码执行后,输出 属性[sex]的值被修改为[女]
obj.name = '女'

看了上面的代码,希望大家可以先自行实现以下,下面我们分别用Object.definePropertyProxy去实现上面的逻辑.

  1. 使用Object.defineProperty
/**
 * 请实现这个函数,使下面的代码逻辑正常运行
 * @param {*} obj 对象
 * @param {*} callback 回调函数
 */
function observe(obj, callback) {
  const newObj = {}
  Object.keys(obj).forEach(key => {
    Object.defineProperty(newObj, key, {
      configurable: true,
      enumerable: true,
      get() {
        return obj[key]
      },
      // 当属性的值被修改时,会调用set,这时候就可以在set里面调用回调函数
      set(newVal) {
        obj[key] = newVal
        callback(key, newVal)
      }
    })
  })
  return newObj
}


const obj = observe(
  {
    name: '子君',
    sex: '男'
  },
  (key, value) => {
    console.log(`属性[${key}]的值被修改为[${value}]`)
  }
)


// 这段代码执行后,输出 属性[name]的值被修改为[妹纸]
obj.name = '妹纸'


// 这段代码执行后,输出 属性[sex]的值被修改为[女]
obj.name = '女'

  1. 使用Proxy
function observe(obj, callback) {
  return new Proxy(obj, {
    get(target, key) {
      return target[key]
    },
    set(target, key, value) {
      target[key] = value
      callback(key, value)
    }
  })
}


const obj = observe(
  {
    name: '子君',
    sex: '男'
  },
  (key, value) => {
    console.log(`属性[${key}]的值被修改为[${value}]`)
  }
)


// 这段代码执行后,输出 属性[name]的值被修改为[妹纸]
obj.name = '妹纸'


// 这段代码执行后,输出 属性[sex]的值被修改为[女]
obj.name = '女'

通过上面两种不同实现方式,我们可以大概的了解到Object.definePropertyProxy的用法,但是当给对象添加新的属性的时候,区别就出来了,比如

// 添加编程网站
obj.gzh = 'W3Cschool编程狮'

使用Object.defineProperty无法监听到新增属性,但是使用Proxy是可以监听到的。对比上面两段代码可以发现有以下几点不同

  • Object.defineProperty监听的是对象的每一个属性,而Proxy监听的是对象自身
  • 使用Object.defineProperty需要遍历对象的每一个属性,对于性能会有一定的影响
  • Proxy对新增的属性也能监听到,但Object.defineProperty无法监听到。

初识Proxy

概念与语法

MDN中,关于Proxy是这样介绍的: Proxy 对象用于定义基本操作的自定义行为(如属性查找、赋值、枚举、函数调用等)。什么意思呢?Proxy就像一个拦截器一样,它可以在读取对象的属性,修改对象的属性,获取对象属性列表,通过for in循环等等操作的时候,去拦截对象上面的默认行为,然后自己去自定义这些行为,比如上面例子中的set,我们通过拦截默认的set,然后在自定义的set里面添加了回调函数的调用

Proxy的语法格式如下

/**
* target: 要兼容的对象,可以是一个对象,数组,函数等等
* handler: 是一个对象,里面包含了可以监听这个对象的行为函数,比如上面例子里面的`get`与`set`
* 同时会返回一个新的对象proxy, 为了能够触发handler里面的函数,必须要使用返回值去进行其他操作,比如修改值
*/
const proxy = new Proxy(target, handler)

在上面的例子里面,我们已经使用到了handler里面提供的getset方法了,接下来我们一一看一下handler里面的方法。

handler 里面的方法列表

handler里面的方法可以有以下这十三个,每一个都对应的一种或多种针对proxy代理对象的操作行为

  1. handler.get

当通过proxy去读取对象里面的属性的时候,会进入到get钩子函数里面

  1. handler.set

当通过proxy去为对象设置修改属性的时候,会进入到set钩子函数里面

  1. handler.has

当使用in判断属性是否在proxy代理对象里面时,会触发has,比如

   const obj = {
     name: '子君'
   }
   console.log('name' in obj)

  1. handler.deleteProperty

当使用delete去删除对象里面的属性的时候,会进入deleteProperty`钩子函数

  1. handler.apply

proxy监听的是一个函数的时候,当调用这个函数时,会进入apply钩子函数

  1. handle.ownKeys

当通过Object.getOwnPropertyNames,Object.getownPropertySymbols,Object.keys,Reflect.ownKeys去获取对象的信息的时候,就会进入ownKeys这个钩子函数

  1. handler.construct

当使用new操作符的时候,会进入construct这个钩子函数

  1. handler.defineProperty

当使用Object.defineProperty去修改属性修饰符的时候,会进入这个钩子函数

  1. handler.getPrototypeOf

当读取对象的原型的时候,会进入这个钩子函数

  1. handler.setPrototypeOf

当设置对象的原型的时候,会进入这个钩子函数

  1. handler.isExtensible

当通过Object.isExtensible去判断对象是否可以添加新的属性的时候,进入这个钩子函数

  1. handler.preventExtensions

当通过Object.preventExtensions去设置对象不可以修改新属性时候,进入这个钩子函数

  1. handler.getOwnPropertyDescriptor

在获取代理对象某个属性的属性描述时触发该操作,比如在执行 Object.getOwnPropertyDescriptor(proxy, "foo") 时会进入这个钩子函数

Proxy提供了十三种拦截对象操作的方法,本文主要挑选其中一部分在Vue3中比较重要的进行说明,其余的建议可以直接阅读MDN关于Proxy的介绍。

详细介绍

get

当通过proxy去读取对象里面的属性的时候,会进入到get钩子函数里面

当我们从一个proxy代理上面读取属性的时候,就会触发get钩子函数,get函数的结构如下

/**
 * target: 目标对象,即通过proxy代理的对象
 * key: 要访问的属性名称
 * receiver: receiver相当于是我们要读取的属性的this,一般情况
 *           下他就是proxy对象本身,关于receiver的作用,后文将具体讲解
 */
handle.get(target,key, receiver)

示例

我们在工作中经常会有封装axios的需求,在封装过程中,也需要对请求异常进行封装,比如不同的状态码返回的异常信息是不同的,如下是一部分状态码及其提示信息:

// 状态码提示信息
const errorMessage = {
  400: '错误请求',
  401: '系统未授权,请重新登录',
  403: '拒绝访问',
  404: '请求失败,未找到该资源'
}


// 使用方式
const code = 404
const message = errorMessage[code]
console.log(message)

但这存在一个问题,状态码很多,我们不可能每一个状态码都去枚举出来,所以对于一些异常状态码,我们希望可以进行统一提示,如提示为系统异常,请联系管理员,这时候就可以使用Proxy对错误信息进行代理处理

// 状态码提示信息
const errorMessage = {
  400: '错误请求',
  401: '系统未授权,请重新登录',
  403: '拒绝访问',
  404: '请求失败,未找到该资源'
}


const proxy = new Proxy(errorMessage, {
  get(target,key) {
    const value = target[key]
    return value || '系统异常,请联系管理员'
  }
})


// 输出 错误请求
console.log(proxy[400])
// 输出 系统异常,请联系管理员
console.log(proxy[500])

set

当为对象里面的属性赋值的时候,会触发set

当给对象里面的属性赋值的时候,会触发set,set函数的结构如下

/**
 * target: 目标对象,即通过proxy代理的对象
 * key: 要赋值的属性名称
 * value: 目标属性要赋的新值
 * receiver: 与 get的receiver 基本一致
 */
handle.set(target,key,value, receiver)

示例

某系统需要录入一系列数值用于数据统计,但是在录入数值的时候,可能录入的存在一部分异常值,对于这些异常值需要在录入的时候进行处理, 比如大于100的值,转换为100, 小于0的值,转换为0, 这时候就可以使用proxyset,在赋值的时候,对数据进行处理

const numbers = []
const proxy = new Proxy(numbers, {
  set(target,key,value) {
    if(value < 0) {
      value = 0
    }else if(value > 100) {
      value = 100
    }
    target[key] = value
    // 对于set 来说,如果操作成功必须返回true, 否则会被视为失败
    return true
  }
})


proxy.push(1)
proxy.push(101)
proxy.push(-10)
// 输出 [1, 100, 0]
console.log(numbers)

对比Vue2.0

在使用Vue2.0的时候,如果给对象添加新属性的时候,往往需要调用$set, 这是因为Object.defineProperty只能监听已存在的属性,而新增的属性无法监听,而通过$set相当于手动给对象新增了属性,然后再触发数据响应。但是对于Vue3.0来说,因为使用了Proxy, 在他的set钩子函数中是可以监听到新增属性的,所以就不再需要使用$set

const obj = {
  name: '子君'
}
const proxy = new Proxy(obj, {
  set(target,key,value) {
    if(!target.hasOwnProperty(key)) {
      console.log(`新增了属性${key},值为${value}`)
    }
    target[key] = value
    return true
  }
})
// 新增 公众号 属性
// 输出 新增了属性gzh,值为前端有的玩
proxy.gzh = '前端有的玩'

has

当使用in判断属性是否在proxy代理对象里面时,会触发has

/**
 * target: 目标对象,即通过proxy代理的对象
 * key: 要判断的key是否在target中
 */
 handle.has(target,key)

示例

一般情况下我们在js中声明私有属性的时候,会将属性的名字以_开头,对于这些私有属性,是不需要外部调用,所以如果可以隐藏掉是最好的,这时候就可以通过has在判断某个属性是否在对象时,如果以_开头,则返回false

const obj =  {
  publicMethod() {},
  _privateMethod(){}
}
const proxy = new Proxy(obj, {
  has(target, key) {
    if(key.startsWith('_')) {
      return false
    }
    return Reflect.get(target,key)
  }
})


// 输出 false
console.log('_privateMethod' in proxy)


// 输出 true
console.log('publicMethod' in proxy)

deleteProperty

当使用delete去删除对象里面的属性的时候,会进入deleteProperty`拦截器

/**
 * target: 目标对象,即通过proxy代理的对象
 * key: 要删除的属性
 */
 handle.deleteProperty(target,key)

示例

现在有一个用户信息的对象,对于某些用户信息,只允许查看,但不能删除或者修改,对此使用Proxy可以对不能删除或者修改的属性进行拦截并抛出异常,如下

const userInfo = {
  name: '子君',
  gzh: '前端有的玩',
  sex: '男',
  age: 22
}
// 只能删除用户名和公众号
const readonlyKeys = ['name', 'gzh']
const proxy = new Proxy(userInfo, {
  set(target,key,value) {
    if(readonlyKeys.includes(key)) {
      throw new Error(`属性${key}不能被修改`)
    }
    target[key] = value
    return true
  },
   deleteProperty(target,key) {
    if(readonlyKeys.includes(key)) {
      throw new Error(`属性${key}不能被删除`)
      return
    }
    delete target[key]
    return true
  }
})
// 报错 
delete proxy.name

对比Vue2.0

其实与$set解决的问题类似,Vue2.0是无法监听到属性被删除的,所以提供了$delete用于删除属性,但是对于Proxy,是可以监听删除操作的,所以就不需要再使用$delete

其他操作

在上文中,我们提到了Proxyhandler提供了十三个函数,在上面我们列举了最常用的三个,其实每一个的用法都是基本一致的,比如ownKeys,当通过Object.getOwnPropertyNames,Object.getownPropertySymbols,Object.keys,Reflect.ownKeys去获取对象的信息的时候,就会进入ownKeys这个钩子函数,使用这个我们就可以对一些我们不像暴露的属性进行保护,比如一般会约定_开头的为私有属性,所以在使用Object.keys去获取对象的所有key的时候,就可以把所有_开头的属性屏蔽掉。关于剩余的那些属性,建议大家多去看看MDN中的介绍。

Reflect

在上面,我们获取属性的值或者修改属性的值都是通过直接操作target来实现的,但实际上ES6已经为我们提供了在Proxy内部调用对象的默认行为的API,即Reflect。比如下面的代码

const obj = {}
const proxy = new Proxy(obj, {
  get(target,key,receiver) {
    return Reflect.get(target,key,receiver)
  }
})

大家可能看到上面的代码与直接使用target[key]的方式没什么区别,但实际上Reflect的出现是为了让Object上面的操作更加规范,比如我们要判断某一个prop是否在一个对象中,通常会使用到in,即

const obj = {name: '子君'}
console.log('name' in obj)

但上面的操作是一种命令式的语法,通过Reflect可以将其转变为函数式的语法,显得更加规范

Reflect.has(obj,'name')

除了has,get之外,其实Reflect上面总共提供了十三个静态方法,这十三个静态方法与Proxyhandler上面的十三个方法是一一对应的,通过将ProxyReflect相结合,就可以对对象上面的默认操作进行拦截处理,当然这也就属于函数元编程的范畴了。

(推荐微课:Vue 2.x 微课

总结

有的同学可能会有疑惑,我不会ProxyReflect就学不了Vue3.0了吗?其实懂不懂这个是不影响学习Vue3.0的,但是如果想深入 去理解Vue3.0,还是很有必要了解这些的。比如经常会有人在使用Vue2的时候问,为什么我数组通过索引修改值之后,界面没有变呢?当你了解到Object.defineProperty的使用方式与限制之后,就会恍然大悟,原来如此。

来源公众号:前端有点玩

文章来源链接:mp.weixin.qq.com/s/JQDA6bP805xuN-tzuimtAA

作者:前端进击者

以上就是关于学习Vue3.0,你需要先了解一下Proxy的相关介绍了,希望对大家有所帮助。

跨平台C++开发工具Qt,开发GUI之前你可以了解一下Qt类

thbcm阅读(374)

Qt(发音为“ cute”,而不是“ cu-tee”)是一个跨平台框架,通常用作图形工具包,它不仅创建CLI应用程序中也非常有用。而且它也可以在三种主要的台式机操作系统以及移动操作系统(如Symbian,Nokia Belle,Meego Harmattan,MeeGo或BB10)以及嵌入式设备,Android(Necessitas)和 iOS 的端口上运行。

(推荐教程:C++教程

Qt广泛使用子类,尤其是在Widgets模块中。下图显示了其中一些继承关系:

QObjectQt中最基本的类。Qt中的大多数类都由衍生。QObject提供了一些非常强大的功能,例如:

  • 对象名称 :您可以为对象设置名称(字符串),然后按名称搜索对象。
  • 子系统(在以下部分中介绍)
  • 信号和插槽(在下一章中介绍)
  • 事件管理

小部件能够响应事件并使用子系统以及信号和插槽机制。所有小部件都继承自QObject。最基本的小部件是QWidgetQWidget包含用于描述窗口或窗口小部件的大多数属性,例如位置和大小,鼠标光标,工具提示等。

备注 :在Qt中,小部件也可以是窗口。在上一节中,我们显示了一个按钮,它是一个小部件,但它直接显示为窗口。不需要 “QWindow” 类。

几乎所有图形元素都从QWidget继承。我们可以列举例如:

QAbstractButton,所有按钮类型的基类 
QPushButton  
QCheckBox 
QRadioButton 。
QFrame,显示框架  
QLabel,显示文本或图片  

进行此子类是为了促进属性管理。大小和光标等共享属性可以在其他图形组件上使用,并且QAbstractButton提供了所有按钮共享的基本属性。

(推荐微课:C++微课

文章来源:www.toutiao.com/a6861850838445326852/

以上就是关于跨平台C++开发工具Qt的相关介绍了,希望对大家有所帮助。

10款强大的数据挖掘软件,你值得拥有

thbcm阅读(404)

数据是一种相当重要的资源,我们很多时候需要收集分析数据。然而,大多数数据是非结构化的,因此需要一个过程和方法从数据中提取有用的信息,并将其转换为可理解的和可用的形式。本文就给大家介绍10款强大的数据挖掘工具。

1、KNIME

KNIME可以完成常规的数据分析,进行数据挖掘,常见的数据挖掘算法,如回归、分类、聚类等等都有。而且它引入很多大数据组件,如HiveSpark等等。它还通过模块化的数据流水线概念,集成了机器学习和数据挖掘的各种组件,能够帮助商业智能和财务数据分析。

2、Rapid Miner

Rapid Miner,也叫YALE,以Java编程语言编写,通过基于模板的框架提供高级分析,是用于机器学习和数据挖掘实验的环境,用于研究和实践数据挖掘。使用它,实验可以由大量的可任意嵌套的操作符组成,而且用户无需编写代码,它已经有许多模板和其他工具,帮助轻松地分析数据。

3、SAS Data Mining

SAS Data Mining是一个商业软件,它为描述性和预测性建模提供了更好的理解数据的方法。SAS Data Mining有易于使用的GUI,有自动化的数据处理工具。此外,它还包括可升级处理、自动化、强化算法、建模、数据可视化和勘探等先进工具。

4、IBM SPSS Modeler

IBM SPSS Modeler适合处理文本分析等大型项目,它的可视化界面做得很好。它允许在不编程的情况下生成各种数据挖掘算法,而且可以用于异常检测、CARMACox回归以及使用多层感知器进行反向传播学习的基本神经网络。

5、Orange

Orange是一个基于组件的数据挖掘和机器学习软件套件,它以Python编写。它的数据挖掘可以通过可视化编程或Python脚本进行,它还包含了数据分析、不同的可视化、从散点图、条形图、树、到树图、网络和热图的特征。

6、Rattle

Rattle是一个在统计语言R编写的开源数据挖掘工具包,是免费的。它提供数据的统计和可视化汇总,将数据转换为便于建模的表单,从数据中构建无监督模型和监督模型,以图形方式呈现模型性能,并对新数据集进行评分。它支持的操作系统有GNU / LinuxMacintosh OS XMS / Windows

7、Python

Python是一个免费且开放源代码的语言,它的学习曲线很短,便于开发者学习和使用,往往很快就能开始构建数据集,并在几分钟内完成极其复杂的亲和力分析。只要熟悉变量、数据类型、函数、条件和循环等基本编程概念,就能轻松使用Python做业务用例数据可视化。

(推荐教程:python教程

8、Oracle Data Mining

Oracle数据挖掘功能让用户能构建模型来发现客户行为目标客户和开发概要文件,它让数据分析师、业务分析师和数据科学家能够使用便捷的拖放解决方案处理数据库内的数据, 它还可以为整个企业的自动化、调度和部署创建SQLPL / SQL脚本。

9、Kaggle

Kaggle是全球最大的数据科学社区,里面有来自世界各地的统计人员和数据挖掘者竞相制作最好的模型,相当于是数据科学竞赛的平台,基本上很多问题在其中都可以找到,感兴趣的朋友可以去看看。

10、Framed Data

最后介绍的Framed Data是一个完全管理的解决方案,它在云中训练、优化和存储产品的电离模型,并通过API提供预测,消除基础架构开销。也就是说,框架数据从企业获取数据,并将其转化为可行的见解和决策,这样使得用户很省心。

以上就是关于10款强大的数据挖掘软件的相关介绍了,希望对大家有所帮助。

高效使用GitHub的4个小技巧

thbcm阅读(421)

作为一名程序员,日常会经常使用到GitHub,在使用中我发现了4个小技巧,能提高我的效率。在这里给大家分享一下。

技巧1:用文件查找器快速、轻松地搜索仓库中的文件

GitHub提供使用Git进行软件开发和版本控制的托管,有数千个存储库、项目和文件。因此,如何高效地在GitHub上搜索文件是非常重要的。第一个技巧是使用GitHub在仓库中提供的快捷方式搜索仓库中的文件。

![更有效使用GitHub的4个技巧](https://atts.w3cschool.cn/attachments/image/20200818/1597734667167201.gif “更有效使用GitHub的4个技巧”)

如上图所示,在运行时的仓库页面,按键盘上的 t 键,那么GitHub就会激活文件查找器。然后你只需要输入目标文件名,比如ServiceProvider.cs 文件,文件查找器就会显示你想要的文件。

技巧2:使用搜索限定词搜索你想要的目标

现在,假设你不知道目标文件位于哪个仓库中,或者你想在组织中查找某个用户。然后,你可以使用搜索限定词在GitHub的任何页面上搜索所需的目标。

![更有效使用GitHub的4个技巧](https://atts.w3cschool.cn/attachments/image/20200818/1597734688699051.gif “更有效使用GitHub的4个技巧”) 如你在上面看到的,我们在Marketplace页面上,并希望在dotnet组织中搜索ConfigurationBuilder.cs文件。然后,你只需要输入搜索限定词即可表明此目的。

org:dotnet filename:ConfigurationBuilder.cs

GitHub就会显示你想要的文件。

技巧3:在Github个人资料页面上启用自述文件

是的,看来Github不仅在6月份重新设计了GitHub的UI,还增加了一些小秘密。你可以在Github个人资料页面上获得个人资料README。它是你自己的自述文件,而不是项目的自述文件。有趣!

![更有效使用GitHub的4个技巧](https://atts.w3cschool.cn/attachments/image/20200818/1597734709396913.png “更有效使用GitHub的4个技巧”)

启用它非常简单,你只需要创建一个与你的Github账户用户名相同的新仓库,这是一个特殊的仓库,你可以用它在你的Github配置文件中添加README.md

![更有效使用GitHub的4个技巧](https://atts.w3cschool.cn/attachments/image/20200818/1597734721435634.png “更有效使用GitHub的4个技巧”)

技巧4:将徽章添加到GitHub仓库中

从技术上讲,这不是GitHub提供的功能。但是,使用此小技巧可以使你的GitHub仓库页面更专业,并反映你项目的当前状态。

一些社区为开发者提供了自己的徽章,例如,你可以从Azure DevOps中获得如下所示的构建/部署状态徽章。

![更有效使用GitHub的4个技巧](https://atts.w3cschool.cn/attachments/image/20200818/1597734768786544.png “更有效使用GitHub的4个技巧”)

另一方面,你可以从一些供应商那里获得更通用的徽章,比如shields.ioshield.io 可以读取你项目的状态并生成相应的徽章。此外,你还可以在 shield.io 上创建自己的徽章。

![更有效使用GitHub的4个技巧](https://atts.w3cschool.cn/attachments/image/20200818/1597734791759739.gif “更有效使用GitHub的4个技巧”)

然后,你只需要将markdown链接复制并粘贴到GitHub仓库中的README.md文件中。

![更有效使用GitHub的4个技巧](https://atts.w3cschool.cn/attachments/image/20200818/1597734802918577.png “更有效使用GitHub的4个技巧”)

(推荐教程:Github教程

以上就是关于高效使用 GitHub 的 4 个小技巧的相关介绍了,希望对大家有所帮助。

SpringBoot:统一JSON信息返回

thbcm阅读(354)

调用后端服务后的返回结果有多种类型,如:StringIntegerBooleanListMap等,在一个项目中,为了保持统一性,我们方法返回结果可以全部使用JSON数据格式,如下:

{
    "code":200,
    "msg":"成功",
    "data":"JSON数据"
}

其中code 是本次请求处理结果对应的状态码,msg是状态码对应的解释信息,data是要返回的数据内容,可以是任意一个对象。

封装响应信息对象

public class ResponseEntity<T> implements Serializable {


    private static final long serialVersionUID = 3595741978061989861L;
    private Integer code;//状态码
    private String msg;//状态码对应信息
    private T data;//要返回的数据


    public Integer getCode() {
        return code;
    }


    public void setCode(Integer code) {
        this.code = code;
    }


    public String getMsg() {
        return msg;
    }


    public void setMsg(String msg) {
        this.msg = msg;
    }


    public T getData() {
        return data;
    }


    public void setData(T data) {
        this.data = data;
    }
}

状态码,Http请求状态码有多种,使用枚举列举,如下示例:

public enum ResponseEnum {


    SUCCESS(200, "成功"),
    FAIL(-1, "失败"),
    ERROR_400(400, "错误的请求"),
    ERROR_404(404, "访问资源不存在"),
    ERROR_500(500, "服务器异常");


    private Integer code;
    private String msg;


    ResponseEnum(Integer code, String msg) {
        this.code = code;
        this.msg = msg;
    }


    public Integer getCode() {
        return code;
    }


    public void setCode(Integer code) {
        this.code = code;
    }


    public String getMsg() {
        return msg;
    }


    public void setMsg(String msg) {
        this.msg = msg;
    }
}

创建一个公共类,生成响应对象

public class ResponseUtil {


    /**
     * 成功返回
     * @param object 返回数据
     * @return
     */
    public static ResponseEntity success(Object object){
        ResponseEntity resp = new ResponseEntity();
        resp.setCode(ResponseEnum.SUCCESS.getCode());
        resp.setMsg(ResponseEnum.SUCCESS.getMsg());
        resp.setData(object);
        return resp;
    }


    /**
     * 成功返回  无数据
     * @return
     */
    public static ResponseEntity success(){
        return success(null);
    }


    /**
     * 失败返回
     * @param responseEnum 响应标识
     * @return
     */
    public static ResponseEntity error(ResponseEnum responseEnum){
        ResponseEntity resp = new ResponseEntity();
        resp.setCode(responseEnum.getCode());
        resp.setMsg(responseEnum.getMsg());
        return resp;
    }
}

Spring中的控制器可以用 @Controller@RestController注解来声明,其中@Controller标识当前控制器是SpringMvc的控制器,要返回JSON对象数据,需要和@ResponseBody注解联合使用;@RestController主要用来构建Restful风格接口,返回客户端的请求数据,相当于同时使用@Controller@ResponseBody注解。

(推荐课程:Spring教程

创建Pojo包及对应的实体类

public class DemoEntity {


    private Integer id;
    private String name;


    public Integer getId() {
        return id;
    }


    public void setId(Integer id) {
        this.id = id;
    }


    public String getName() {
        return name;
    }


    public void setName(String name) {
        this.name = name;
    }
}

创建控制器

@Controller

@Controller
public class DemoController {


    @RequestMapping(value = "/users", method= RequestMethod.GET)
    @ResponseBody
    public ResponseEntity users(){
        List<DemoEntity> list = new ArrayList<DemoEntity>();
        DemoEntity demo = new DemoEntity();
        demo.setId(1);
        demo.setName("蜗牛");
        list.add(demo);
        DemoEntity demo1 = new DemoEntity();
        demo1.setId(2);
        demo1.setName("葡萄");
        list.add(demo1);
        return ResponseUtil.success(list);
    }
}

测试:启动服务后,在浏览器地址栏输入http://localhost:8080/users,可以看到页面上的输出信息

{"code":200,"msg":"成功","data":[{"id":1,"name":"蜗牛"},{"id":2,"name":"葡萄"}]}

@RestController

@RestController
public class DemoRestController {


    @RequestMapping(value = "/users1", method= RequestMethod.GET)
    public ResponseEntity users(){
        List<DemoEntity> list = new ArrayList<DemoEntity>();
        DemoEntity demo = new DemoEntity();
        demo.setId(1);
        demo.setName("蜗牛");
        list.add(demo);
        DemoEntity demo1 = new DemoEntity();
        demo1.setId(2);
        demo1.setName("葡萄");
        list.add(demo1);
        return ResponseUtil.success(list);
    }
}

请求后也能看到如上的结果。

(推荐教程:Spring Boot 那些事)

以上就是关于SpringBoot:统一JSON信息返回的相关介绍,希望对大家有所帮助。

Java并发 你了解CopyOnWrite吗?

thbcm阅读(357)

概念

CopyOnWrite 是什么呢,从字面上看,就是在写入时复制。看起来貌似很简单,那么写入时复制,具体是怎么实现的呢?

先来说说思想,具体怎么实现等下分析

CopyOnWrite 的思想就是:当向一个容器中添加元素的时候,不是直接在当前这个容器里面添加的,而是复制出来一个新的容器,在新的容器里面添加元素,添加完毕之后再将原容器的引用指向新的容器,这样就实现了写入时复制

你还记得在提到数据库的时候,一般都会说主从复制,读写分离吗?CopyOnWrite 的设计思想是不是和经常说的主从复制,读写分离如出一撤?

(推荐教程:Java教程

优缺点

了解概念之后,对它的优缺点应该就比较好理解了

优点就是,读和写可以并行执行,因为读的是原来的容器,写的是新的容器,它们之间互不影响,所以读和写是可以并行执行的,在某些高并发场景下,可以提高程序的响应时间

但是呢,你也看到了, CopyOnWrite 是在写入的时候,复制了一个新的容器出来,所以要考虑它的内存开销问题,又回到了在学算法时一直强调的一个思想:拿空间换时间

需要注意一下,它只保证数据的最终一致性。因为在读的时候,读取的内容是原容器里面的内容,新添加的内容是读取不到的

基于它的优缺点应该就可以得出一个结论:CopyOnWrite 适用于写操作非常少的场景,而且还能够容忍读写的暂时不一致 如果你的应用场景不适合,那还是考虑使用别的方法来实现吧

还有一点需要注意的是:在写入时,它会复制一个新的容器,所以如果有写入需求的话,最好可以批量写入,因为每次写入的时候,容器都会进行复制,如果能够减少写入的次数,就可以减少容器的复制次数

JUC 包下,实现 CopyOnWrite 思想的就是 CopyOnWriteArrayList & CopyOnWriteArraySet 这两个方法,本篇文章侧重于讲清楚 CopyOnWriteArrayList

CopyOnWriteArrayList

CopyOnWriteArrayList 中,需要注意的是 add 方法:

    public boolean add(E e) {
        final ReentrantLock lock = this.lock;
        // 在写入的时候,需要加锁,如果不加锁的话,在多线程场景下可能会被 copy 出 n 个副本出来
        // 加锁之后,就能保证在进行写时,只有一个线程在操作
        lock.lock();
        try {
            Object[] elements = getArray();
            int len = elements.length;
            // 复制原来的数组
            Object[] newElements = Arrays.copyOf(elements, len + 1);
            // 将要添加的元素添加到新数组中
            newElements[len] = e;
            // 将对原数组的引用指向新的数组
            setArray(newElements);
            return true;
        } finally {
            lock.unlock();
        }
    }

在写的时候需要加锁,但是在读取的时候不需要添加

因为读取的是原数组的元素,对新数组没有什么影响,加了锁反而会增加性能开销

public E get(int index) {
 return get(getArray(), index);
}

举个例子:

CopyOnWriteJUC 包下,那么它就保证了线程安全

咱们来做个小 demo 验证一下:

@Slf4j
public class ArrayListExample {


    // 请求总数
    public static int clientTotal = 5000;


    // 同时并发执行的线程数
    public static int threadTotal = 200;


    private static List<Integer> list = new ArrayList<>();


    public static void  main(String[] args) throws Exception{
        ExecutorService executorService = Executors.newCachedThreadPool();
        final Semaphore semaphore = new Semaphore(threadTotal);
        final CountDownLatch countDownLatch = new CountDownLatch(clientTotal);
        for (int i = 0; i < clientTotal; i++) {
            final int count = i;
            executorService.execute(()->{
                try {
                    semaphore.acquire();
                    update(count);
                    semaphore.release();
                } catch (Exception e) {
                    log.error("exception",e);
                }
                countDownLatch.countDown();
            });
        }
        countDownLatch.await();
        executorService.shutdown();
        log.info("size:{}",list.size());
    }
    private static void update(int i){
        list.add(i);
    }
}

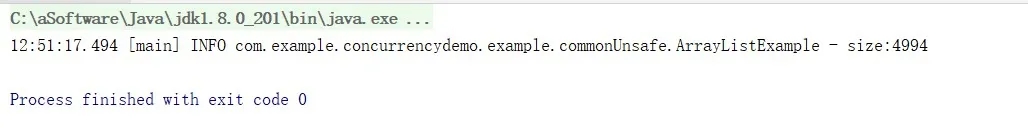
上面是客户端请求 5000 次,有 200 个线程在同时请求,我使用的是 ArrayList 实现,咱们看下打印结果:

如果是线程安全的话,那么最后的结果应该是 5000 才对,多运行几次你会发现,每次程序的执行结果都是不一样的

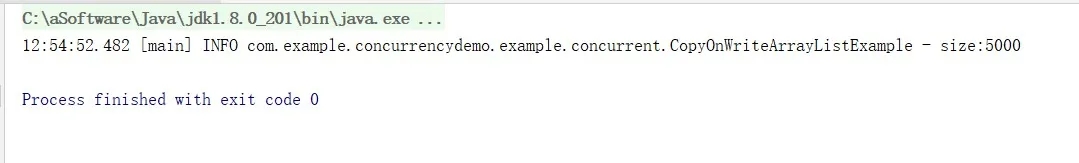
如果是 CopyOnWriteArrayList 呢?

@Slf4j
public class CopyOnWriteArrayListExample {


    // 请求总数
    public static int clientTotal = 5000;


    // 同时并发执行的线程数
    public static int threadTotal = 200;


    private static List<Integer> list = new CopyOnWriteArrayList<>();


    public static void  main(String[] args) throws Exception{
        ExecutorService executorService = Executors.newCachedThreadPool();
        final Semaphore semaphore = new Semaphore(threadTotal);
        final CountDownLatch countDownLatch = new CountDownLatch(clientTotal);
        for (int i = 0; i < clientTotal; i++) {
            final int count = i;
            executorService.execute(()->{
                try {
                    semaphore.acquire();
                    update(count);
                    semaphore.release();
                } catch (Exception e) {
                    log.error("excepiton",e);
                }
                countDownLatch.countDown();
            });
        }
        countDownLatch.await();
        executorService.shutdown();
        log.info("size:{}",list.size());
    }
    private static void update(int i){
        list.add(i);
    }
}

多运行几次,结果都是一样的:

由此可见,CopyOnWriteArrayList 是线程安全的。

(推荐微课:Java微课

文章来源 公众号:Java极客技术

作者:鸭血粉丝

以上就是关于 Java 并发 CopyOnWrite 的相关介绍了,希望对大家有所帮助。

10个加快Python编程的小技巧

thbcm阅读(349)

编程是一件很有意思的事情,而用Python编程就更加有趣了,因为在Python中实现一种功能,可以有很多种不同的方法。 但是,大多数时候都有一些首选的实现方法,有些人将其称为Pythonic。这些Pythonic的共同特征是实现的代码简洁明了。

Python或任何编码语言进行编程不是像火箭一样的科学,而主要是关于技巧。如果有意尝试使用Pythonic编码,那么这些技术将很快成为我们工具包的一部分,并且我们会发现在项目中使用它们变得越来越自然。因此,让我们探索其中的一些简单技巧。

1.负索引

人们喜欢使用序列,因为当我们知道元素的顺序,我们就可以按顺序操作这些元素。在Python中,字符串、元组和列表是最常见的序列数据类型。我们可以使用索引访问单个项目。与其他主流编程语言一样,Python支持基于 0 的索引,在该索引中,我们在一对方括号内使用零访问第一个元素。此外,我们还可以使用切片对象来检索序列的特定元素,如下面的代码示例所示。

>>> # Positive Indexing 
... numbers = [1, 2, 3, 4, 5, 6, 7, 8] 
... print("First Number:", numbers[0]) 
... print("First Four Numbers:", numbers[:4]) 
... print("Odd Numbers:", numbers[::2]) 
... First Number: 1 
First Four Numbers: [1, 2, 3, 4] 
Odd Numbers: [1, 3, 5, 7] 

但是,Python通过支持负索引而进一步走了一步。具体来说,我们可以使用 -1 来引用序列中的最后一个元素,并向后计数。例如,最后一个元素的索引为 -2,依此类推。重要的是,负索引也可以与切片对象中的正索引一起使用。

>>> # Negative Indexing
... data_shape = (100, 50, 4)
... names = ["John", "Aaron", "Mike", "Danny"] 
... hello = "Hello World!" 
... 
... print(data_shape[-1]) 
... print(names[-3:-1]) 
... print(hello[1:-1:2]) 
... 4 
['Aaron', 'Mike']
el ol 

2.检查容器是否为空

容器是指可以存储其他数据的那些容器数据类型。一些经常使用的内置容器是元组,列表,字典和集合。在处理这些容器时,我们经常需要在执行其他操作之前检查它们是否包含任何元素。确实,我们可以检查这些容器的长度,该长度与已存储项目的数量相对应。当长度为零时,容器为空。下面显示了一个简单的示例。

if len(some_list) > 0:
    # do something here when the list is not empty 
else:
    # do something else when the list is empty 

但是,这不是最好的Pythonic方式。相反,我们可以简单地检查容器本身,它将在容器True包含元素时进行评估。尽管以下代码向您展示了主要的容器数据类型,但这种用法也可以应用于字符串(即,任何非空字符串都是True)。

>>> def check_container_empty(container): 
...     if container: 
...         print(f"{container} has elements.") 
...     else: 
...         print(f"{container} doesn't have elements.") 
... 
... check_container_empty([1, 2, 3]) 
... check_container_empty(set()) 
... check_container_empty({"zero": 0, "one": 1}) 
... check_container_empty(tuple()) 
... [1, 2, 3] has elements. 
set() doesn't have elements.
{'zero': 0, 'one': 1} has elements. 
() doesn't have elements. 

3.使用Split()创建字符串列表

我们经常使用字符串作为特定对象的标识符。例如,我们可以使用字符串作为字典中的键。在数据科学项目中,字符串通常是数据的列名。选择多个列时,不可避免地需要创建一个字符串列表。确实,我们可以使用列表中的文字创建字符串。但是,我们必须编写成对的引号将每个字符串括起来,这对于“懒惰”的人来说有点繁琐。因此,我更喜欢利用字符串的split()方法来创建字符串列表,如下面的代码片段所示。

>>> # List of strings
... # The typical way
... columns = ['name', 'age', 'gender', 'address', 'account_type']
... print("* Literals:", columns)
...
... # Do this instead
... columns = 'name age gender address account_type'.split()
... print("* Split with spaces:", columns)
...
... # If the strings contain spaces, you can use commas instead
... columns = 'name, age, gender, address, account type'.split(', ')
... print("* Split with commas:", columns)
...
* Literals: ['name', 'age', 'gender', 'address', 'account_type']
* Split with spaces: ['name', 'age', 'gender', 'address', 'account_type']
* Split with commas: ['name', 'age', 'gender', 'address', 'account type']

如上所示,split()默认情况下,该方法使用空格作为分隔符,并根据字符串创建字符串列表。值得注意的是,当您创建包含某些包含空格的元素的字符串列表时,可以选择使用其他类型的分隔符(例如,逗号)。

这种用法受到一些内置功能的启发。例如,当你创建一个元组类,我们可以这样做:Student = namedtuple(“Student”, [“name”, “gender”, “age”])。字符串列表指定了元组的“属性”。但是,也可以通过以下方式定义该类来本地支持它:Student = namedtuple(“Student”, “name gender age”)。对于另一个实例,创建一个Enum类支持相同的替代解决方案。

(推荐教程:python教程

4.三元表达

在许多用例中,我们需要根据条件定义具有特定值的变量,并且我们可以简单地使用if ... else语句来检查条件。但是,它需要几行代码。如果仅处理一个变量的赋值,则可能需要使用三元表达式,该表达式检查条件并仅用一行代码即可完成赋值。此外,它的格式更短,从而使代码更加简洁。考虑以下示例。

# The typical way
if score > 90:
    reward = "1000 dollars"
else:
    reward = "500 dollars"
# Do this instead
reward = "1000 dollars" if score > 90 else "500 dollars"

有时,我们可以从已定义的函数中获取一些数据,并且可以利用这一点并编写三元表达式的简单操作,如下所示。

# Another possible scenario
# You got a reward amount from somewhere else, but don't know if None/0 or not
reward = reward_known or "500 dollars"
# The above line of code is equivalent to below
reward = reward_known if reward_known else "500 dollars"

5.带文件对象的语句

我们经常需要从文件读取数据并将数据写入文件。最常见的方法是使用内置open()函数简单地打开文件,该函数会创建一个我们可以操作的文件对象。

>>> # Create a text file that has the text: Hello World!
...
... # Open the file and append some new data
... text_file0 = open("hello_world.txt", "a")
... text_file0.write("Hello Python!")
...
... # Open the file again for something else
... text_file1 = open("hello_world.txt")
... print(text_file1.read())
...
Hello World!

在前面的代码片段中,我们从一个文本文件开始,该文件的文本为“ Hello World!”。然后,我们将一些新数据附加到文件中。但是,过了一会儿,我们想再次处理该文件。当我们读取文本文件时,它仍然具有旧数据。换句话说,附加的文本不包括在文本文件中。

这是因为我们首先没有关闭文件对象。如果不关闭文件,则无法保存更改。确实,我们可以close()在文件对象上显式调用该方法。但是,我们可以使用“with”语句执行此操作,该语句将自动为我们关闭文件对象,如下所示。完成对文件的操作后,我们可以通过访问文件对象的closed属性来验证文件已关闭。

>>> with open("hello_world.txt", "a") as file:
...     file.write("Hello Python!")
...
... with open("hello_world.txt") as file:
...     print(file.read())
...
... print("Is file close?", file.closed)
...
Hello World!Hello Python!Hello Python!
Is file close? True

用更笼统的术语来说,with语句是在Python中使用上下文管理器的语法。上一个示例涉及文件操作,因为这些文件是共享资源,我们负责释放这些资源。上下文管理器可以帮助我们完成工作。如前所示,文件操作结束后,将使用with语句自动关闭文件。

6.评估多个条件

通常,我们需要评估多个条件。有几种可能的方案。对于数值,我们可以对同一变量进行多次比较。在这种情况下,我们可以链接这些比较。

# Multiple Comparisons
# The typical way
if a < 4 and a > 1:
    # do something here# Do this instead
if 1 < a < 4:
    # do somerthing here

在其他一些情况下,我们可以进行多个相等比较,并且可以使用以下in关键字进行成员测试。

# The typical way
if b == "Mon" or b == "Wed" or b == "Fri" or b == "Sun":
    # do something here# Do this instead, you can also specify a tuple ("Mon", "Wed", "Fri", "Sun")
if b in "Mon Wed Fri Sun".split():
    # do something here

另一种技术是使用内置的all()any()函数用于评估多个条件的功能。具体而言,该all()函数将评估何时迭代中的元素全部为True,因此该函数适合于替换一系列AND逻辑比较。另一方面,该any()函数的计算结果为True当迭代中的任何元素为True,因此适合替换一系列OR逻辑运算。相关示例如下所示。

# The typical ways
if a < 10 and b > 5 and c == 4:
    # do somethingif a < 10 or b > 5 or c == 4:
    # do something# Do these instead
if all([a < 10, b > 5, c == 4]):
    # do somethingif any([a < 10, b > 5, c == 4]):
    # do something

7.在函数声明中使用默认值

在几乎所有的Python项目中,大多数代码都涉及创建和调用函数。换句话说,我们不断处理函数声明和重构。在许多情况下,我们需要多次调用一个函数。根据不同的参数集,该功能将略有不同。但是,有时一组参数可能比其他一组更常用,在这种情况下,我们在声明函数时应考虑设置默认值。考虑下面的简单示例。

# The original form:
def generate_plot(data, image_name):
    """This function creates a scatter plot for the data"""
    # create the plot based on the data
    ...
    if image_name:
        # save the image
        ...# In many cases, we don't need to save the image
generate_plot(data, None)# The one with a default value
def generate_plot(data, image_name=None):
    pass# Now, we can omit the second parameter
generate_plot(data)

要注意的一件事是,如果在设置默认值时要处理可变数据类型(例如列表,集合),请确保使用None而不是构造函数(例如arg_name = [])。由于Python在定义的位置创建函数对象,因此提供的空白列表将被函数对象“卡住”。换句话说,调用函数对象时不会立即创建它。相反,我们将在内存中处理相同的函数对象,包括其最初创建的默认可变对象,这可能会导致意外行为。

8.使用计数器进行元素计数

当我们在列表、元组或字符串中有多个项目时(例如,多个字符),我们经常想计算每项中有多少个元素。为此,可以为此功能编写一些乏味的代码。

>>> words = ['an', 'boy', 'girl', 'an', 'boy', 'dog', 'cat', 'Dog', 'CAT', 'an','GIRL', 'AN', 'dog', 'cat', 'cat', 'bag', 'BAG', 'BOY', 'boy', 'an']
... unique_words = {x.lower() for x in set(words)}
... for word in unique_words:
...     print(f"* Count of {word}: {words.count(word)}")
...
* Count of cat: 3
* Count of bag: 1
* Count of boy: 3
* Count of dog: 2
* Count of an: 5
* Count of girl: 1

如上所示,我们首先必须创建一个仅包含唯一单词的集合。然后,我们迭代单词集,并使用该count()方法找出每个单词的出现情况。但是,有一种更好的方法可以使用Counter类来完成此计数任务。

>>> from collections import Counter
...
... word_counter = Counter(x.lower() for x in words)
... print("Word Counts:", word_counter)
...
Word Counts: Counter({'an': 5, 'boy': 4, 'cat': 4, 'dog': 3, 'girl': 2, 'bag': 2})

该计数器类是在collections模块中可用的。要使用该类,我们只需创建一个generator:x.lower() for x in words每个项目都将被计数。如我们所见,Counter对象是类似dict的映射对象,每个键对应于单词列表的唯一项,而值是这些项的计数。

此外,如果我们有兴趣找出单词列表中最频繁出现的项目,我们可以利用Counter对象的most_common()方法。以下代码展示了这种用法。我们只需要指定一个整数(N),即可从列表中找出最频繁的 N 个项目。附带说明,该对象还将与其他序列数据一起使用,例如字符串和元组。

>>> # Find out the most common item
... print("Most Frequent:", word_counter.most_common(1))
Most Frequent: [('an', 5)]
>>> # Find out the most common 2 items
... print("Most Frequent:", word_counter.most_common(2))
Most Frequent: [('an', 5), ('boy', 4)]

9.按不同的订单要求排序

在许多项目中,对列表中的项目进行排序是一项普遍的任务。最基本的排序基于数字或字母顺序,我们可以使用内置sorted()函数。默认情况下,该sorted()函数将按升序对列表进行排序(实际上,它可以是可迭代的)。如果将reverse参数指定为True,则可以按降序获得项目。一些简单的用法如下所示。

>>> # A list of numbers and strings
... numbers = [1, 3, 7, 2, 5, 4]
... words = ['yay', 'bill', 'zen', 'del']
... # Sort them
... print(sorted(numbers))
... print(sorted(words))
...
[1, 2, 3, 4, 5, 7]
['bill', 'del', 'yay', 'zen']
>>> # Sort them in descending order
... print(sorted(numbers, reverse=True))
... print(sorted(words, reverse=True))
...
[7, 5, 4, 3, 2, 1]
['zen', 'yay', 'del', 'bill']

除了这些基本用法外,我们还可以指定key参数,以便可以对复杂项进行排序,例如元组列表。考虑这种情况的以下示例。

>>> # Create a list of tuples
... grades = [('John', 95), ('Aaron', 99), ('Zack', 97), ('Don', 92), ('Jennifer', 100), ('Abby', 94), ('Zoe', 99), ('Dee', 93)]
>>> # Sort by the grades, descending
... sorted(grades, key=lambda x: x[1], reverse=True)
[('Jennifer', 100), ('Aaron', 99), ('Zoe', 99), ('Zack', 97), ('John', 95), ('Abby', 94), ('Dee', 93), ('Don', 92)]
>>> # Sort by the name's initial letter, ascending
... sorted(grades, key=lambda x: x[0][0])
[('Aaron', 99), ('Abby', 94), ('Don', 92), ('Dee', 93), ('John', 95), ('Jennifer', 100), ('Zack', 97), ('Zoe', 99)]

上面的代码通过利用传递给key参数的lambda函数,向我们展示了两个高级排序的示例。第一个使用降序对项目进行排序,第二个使用默认的升序对项目进行排序。我们要结合这两个要求,如果考虑使用该reverse参数,则可能会得到一个错误的排序树,因为如果尝试按多个条件进行排序,则反向参数将适用于所有参数。请参见下面的代码段。

>>> # Requirement: sort by name initial ascending, and by grades, descending
... # Both won't work
... sorted(grades, key=lambda x: (x[0][0], x[1]), reverse=True)
[('Zoe', 99), ('Zack', 97), ('Jennifer', 100), ('John', 95), ('Dee', 93), ('Don', 92), ('Aaron', 99), ('Abby', 94)]
>>> sorted(grades, key=lambda x: (x[0][0], x[1]), reverse=False)
[('Abby', 94), ('Aaron', 99), ('Don', 92), ('Dee', 93), ('John', 95), ('Jennifer', 100), ('Zack', 97), ('Zoe', 99)]
>>> # This will do the trick
... sorted(grades, key=lambda x: (x[0][0], -x[1]))
[('Aaron', 99), ('Abby', 94), ('Dee', 93), ('Don', 92), ('Jennifer', 100), ('John', 95), ('Zoe', 99), ('Zack', 97)]

如您所见,通过将reverse参数设置为TrueFalse,都无效。取而代之的是,技巧是取反分数,因此,当您按默认的升序排序时,由于这些值的取反,分数将反向排序。但是,此方法有一个警告,因为取反只能用于数字值,而不能用于字符串。

10.不要忘记defaultdict

字典是一种有效的数据类型,它使我们能够以键值对的形式存储数据。它要求所有键都是可哈希的,存储这些数据可能涉及哈希表的使用。这种方法允许以 O(1) 效率实现数据检索和插入。但是,应注意,除了内置的dict类型外,我们还有其他可用的字典。其中,我想讨论defaultdict类型。与内置dict类型不同,defaultdict允许我们设置默认工厂函数,该工厂函数在键不存在时创建元素。

>>> student = {'name': "John", 'age': 18}
... student['gender']
...
Traceback (most recent call last):
  File "<input>", line 2, in <module>
KeyError: 'gender'

假设我们正在处理单词,并且想要将与列表相同的字符分组,并且这些列表与作为键的字符相关联。这是使用内置dict类型的幼稚实现。值得注意的是,检查dict对象是否具有letter键是至关重要的,因为如果键不存在,则调用该append()方法会引发KeyError异常。

>>> letters = ["a", "a", "c", "d", "d", "c", "a", "b"]
... final_dict = {}
... for letter in letters:
...     if letter not in final_dict:
...         final_dict[letter] = []
...     final_dict[letter].append(letter)
...
... print("Final Dict:", final_dict)
...
Final Dict: {'a': ['a', 'a', 'a'], 'c': ['c', 'c'], 'd': ['d', 'd'], 'b': ['b']}

让我们看看如何使用defaultdict编写更简洁的代码。尽管该示例很简单,但是它只是为我们提供了有关defaultdict类的一些想法,这使我们不必处理字典对象中不存在的键。

>>> from collections import defaultdict
...
... final_defaultdict = defaultdict(list)
... for letter in letters:
...     final_defaultdict[letter].append(letter)
...
... print("Final Default Dict:", final_defaultdict)
...
Final Default Dict: defaultdict(<class 'list'>, {'a': ['a', 'a', 'a'], 'c': ['c', 'c'], 'd': ['d', 'd'], 'b': ['b']})

(推荐微课:python3基础微课

结论

在阅读本文之前,我们可能已经了解了一些技巧,但是希望仍然对这些技巧有所了解。在项目中实践这些惯用用法将使您的Python代码更具可读性和性能。

文章来源:公众号 – 小白学视觉

作者:花生

以上就是关于10个加快Python编程的小技巧的相关介绍了,希望对大家有所帮助。

2020年超火的9个编程语言,快来了解一下

thbcm阅读(317)

物竞天择,适者生存的法则在什么地方都适用,那么在竞争激烈的编程语言界中,哪些编程语言比较受欢迎,哪些比较容易上手,哪些比较有影响力呢?本文给大家介绍2020年超火的9个编程语言。

1、Java

Java 虚拟机的帮助下,Java 可以无障碍的在 LinuxWindowsMac-OS 等多种操作系统下自由地穿梭,这使得它在企业级开发中非常受欢迎。Java 可以做网站开发、做安卓开发、做桌面级应用开发(Eclipse、NetBeans 等等)、做游戏开发,比如大名鼎鼎的《我的世界》就是用Java开发的。到目前为止,Java是最流行的应用程序编程语言之一。

2、JavaScript

JavaScript广泛用于客户端脚本编写、验证、动画、事件捕获、表单提交和其他常见任务。它运行在浏览器上,几乎各大网站都在使用它。有一个网页前端编程的三剑客的说法:HTML 负责结构, CSS 负责展示, 而 JavaScript 负责逻辑。值得一提的是,现在非常火热的前端框架Vue.js 是用 JavaScript 编写的,所以如果想从事前端开发工作,那么JavaScript 是必学的。

3、Python

Python广泛用于web应用程序开发、软件开发和信息安全,它深受编程人员的喜爱,因为它的学习成本很低,但应用的等级很高,比如说当下非常有深度的人工智能、机器学习、数据分析。总之,Python 的语法清晰而富有表现力,社区也非常活跃。但是通常Python 岗位对学历的要求很高哦。

4、C

C语言比Java更古老,但仍然非常流行,在系统编程中得到了广泛的应用。C 语言的设计影响了众多后来的编程语言,比如说 C++RubyPHPPythonJava等。C 和操作系统紧密相关,程序员必须亲自处理内存的分配细节,因此很难掌握。

5、C++

C++,从名字上就可以看得出来,它是 C 语言的亲儿子,是对 C 语言的扩展,旨在为C语言创造出面向对象的功能。c++在 IT 领域得到了广泛的应用,因为它兼容本地系统,并具有面向对象特性。随着时间的发展,C++ 进一步发展为具有最直接的内存访问和完整硬件控制的通用语言。正因为 C++ 提供了最广泛的通用功能,就导致掌握起来有一定的难度。

6、C#

C#C/C++ 有着亲密的关系,微软把 C# 设计成具有面向对象的,像C一样的编程语言。

刚开始C#Java很像,比如继承、接口,以及与Java 几乎同样的语法。但后来C#沉淀了丰富的类库和框架,开发人员可以在此基础上快速地编写各种基于 .NET 平台的应用程序。随着 Unity3D 的出现,跨平台的 C# 在开发游戏方面有很大优势,比如说编译速度快、类库充足等。

7、Ruby

Ruby 是一种解释性的高级通用编程语言,受PerlAdaLispSmalltalk的影响,专为高效和有趣的编程而设计。Ruby主要用于web应用程序开发,主要站点如TwitterHuluGroupon。很重合的一点是,它的学习曲线相对平坦,有助于提高开发人员的生产力。

8、Swift

Swift 是一种直观的编程语言,它由 Apple 创造,可用来为 iOSMacApple TVApple Watch 开发 app。它是一种快速而高效的语言,提供实时反馈,还可以被无缝集成到现有的 Objective-C 代码中,因此开发者能快速地编写出安全而可靠的代码。

9、Go

GoGoogle旗下的,它的语言设计简洁易用,解决开发扩展方面的能力出众,学起来也容易上手,这些优势使得Go 语言的迅速流行。国外如 GoogleAWSCloudflare等公司,国内如阿里,都已经有在大规模使用 Golang 开发其云计算相关的产品。

以上就是W3Cschool编程狮关于2020年超火的9个编程语言的相关介绍了,希望对大家有所帮助。

联系我们