如何用一行代码实现Python并行处理

thbcm阅读(319)

Python 在程序并行化方面多少有些声名狼藉。撇开技术上的问题,例如线程的实现和 GIL,我觉得错误的教学指导才是主要问题。常见的经典 Python 多线程、多进程教程多显得偏”重”。而且往往隔靴搔痒,没有深入探讨日常工作中最有用的内容。

传统的例子

简单搜索下”Python 多线程教程”,不难发现几乎所有的教程都给出涉及类和队列的例子:

import os
import PIL


from multiprocessing import Pool
from PIL import Image


SIZE = (75,75)
SAVE_DIRECTORY = 'thumbs'


def get_image_paths(folder):
    return (os.path.join(folder, f)
            for f in os.listdir(folder)
            if 'jpeg' in f)


def create_thumbnail(filename): 
    im = Image.open(filename)
    im.thumbnail(SIZE, Image.ANTIALIAS)
    base, fname = os.path.split(filename)
    save_path = os.path.join(base, SAVE_DIRECTORY, fname)
    im.save(save_path)


if __name__ == '__main__':
    folder = os.path.abspath(
        '11_18_2013_R000_IQM_Big_Sur_Mon__e10d1958e7b766c3e840')
    os.mkdir(os.path.join(folder, SAVE_DIRECTORY))


    images = get_image_paths(folder)


    pool = Pool()
    pool.map(creat_thumbnail, images)
    pool.close()
    pool.join()

哈,看起来有些像 Java 不是吗?

我并不是说使用生产者/消费者模型处理多线程/多进程任务是错误的(事实上,这一模型自有其用武之地)。只是,处理日常脚本任务时我们可以使用更有效率的模型。

问题在于…

首先,你需要一个样板类;

其次,你需要一个队列来传递对象;

而且,你还需要在通道两端都构建相应的方法来协助其工作(如果需想要进行双向通信或是保存结果还需要再引入一个队列)。

(推荐教程:python教程

worker 越多,问题越多

按照这一思路,你现在需要一个 worker 线程的线程池。下面是一篇 IBM 经典教程中的例子——在进行网页检索时通过多线程进行加速。

#Example2.py
'''
A more realistic thread pool example
'''


import time
import threading
import Queue
import urllib2


class Consumer(threading.Thread): 
    def __init__(self, queue): 
        threading.Thread.__init__(self)
        self._queue = queue


    def run(self):
        while True:
            content = self._queue.get()
            if isinstance(content, str) and content == 'quit':
                break
            response = urllib2.urlopen(content)
        print 'Bye byes!'


def Producer():
    urls = [
        'http://www.python.org', 'http://www.yahoo.com'
        'http://www.scala.org', 'http://www.google.com'
        # etc..
    ]
    queue = Queue.Queue()
    worker_threads = build_worker_pool(queue, 4)
    start_time = time.time()


    # Add the urls to process
    for url in urls:
        queue.put(url)  
    # Add the poison pillv
    for worker in worker_threads:
        queue.put('quit')
    for worker in worker_threads:
        worker.join()


    print 'Done! Time taken: {}'.format(time.time() - start_time)


def build_worker_pool(queue, size):
    workers = []
    for _ in range(size):
        worker = Consumer(queue)
        worker.start()
        workers.append(worker)
    return workers


if __name__ == '__main__':
    Producer()

这段代码能正确的运行,但仔细看看我们需要做些什么:构造不同的方法、追踪一系列的线程,还有为了解决恼人的死锁问题,我们需要进行一系列的 join 操作。这还只是开始……

至此我们回顾了经典的多线程教程,多少有些空洞不是吗?样板化而且易出错,这样事倍功半的风格显然不那么适合日常使用,好在我们还有更好的方法。

何不试试 map

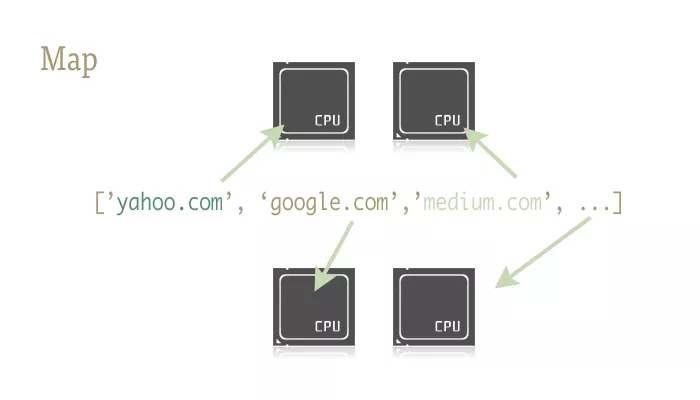
map 这一小巧精致的函数是简捷实现 Python 程序并行化的关键。map 源于 Lisp 这类函数式编程语言。它可以通过一个序列实现两个函数之间的映射。

    urls = ['http://www.yahoo.com', 'http://www.reddit.com']
    results = map(urllib2.urlopen, urls)

上面的这两行代码将 urls 这一序列中的每个元素作为参数传递到 urlopen 方法中,并将所有结果保存到 results 这一列表中。其结果大致相当于:

results = []
for url in urls:
    results.append(urllib2.urlopen(url))

map 函数一手包办了序列操作、参数传递和结果保存等一系列的操作。

为什么这很重要呢?这是因为借助正确的库,map 可以轻松实现并行化操作。

Python 中有个两个库包含了 map 函数:multiprocessing 和它鲜为人知的子库 multiprocessing.dummy.

这里多扯两句:multiprocessing.dummymltiprocessing库的线程版克隆?这是虾米?即便在 multiprocessing 库的官方文档里关于这一子库也只有一句相关描述。而这句描述译成人话基本就是说:”嘛,有这么个东西,你知道就成.”相信我,这个库被严重低估了!

dummymultiprocessing 模块的完整克隆,唯一的不同在于 multiprocessing 作用于进程,而 dummy 模块作用于线程(因此也包括了Python 所有常见的多线程限制)。 所以替换使用这两个库异常容易。你可以针对 IO 密集型任务和 CPU 密集型任务来选择不同的库。

动手尝试

使用下面的两行代码来引用包含并行化 map 函数的库:

from multiprocessing import Pool
from multiprocessing.dummy import Pool as ThreadPool

实例化 Pool 对象:

pool = ThreadPool()

这条简单的语句替代了 example2.pybuild*worker*pool 函数 7 行代码的工作。它生成了一系列的 worker 线程并完成初始化工作、将它们储存在变量中以方便访问。

Pool 对象有一些参数,这里我所需要关注的只是它的第一个参数:processes. 这一参数用于设定线程池中的线程数。其默认值为当前机器 CPU 的核数。

一般来说,执行 CPU 密集型任务时,调用越多的核速度就越快。但是当处理网络密集型任务时,事情有些难以预计了,通过实验来确定线程池的大小才是明智的。

pool = ThreadPool(4) # Sets the pool size to 4

线程数过多时,切换线程所消耗的时间甚至会超过实际工作时间。对于不同的工作,通过尝试来找到线程池大小的最优值是个不错的主意。

创建好 Pool 对象后,并行化的程序便呼之欲出了。我们来看看改写后的 example2.py

import urllib2
from multiprocessing.dummy import Pool as ThreadPool


urls = [
    'http://www.python.org',
    'http://www.python.org/about/',
    'http://www.onlamp.com/pub/a/python/2003/04/17/metaclasses.html',
    'http://www.python.org/doc/',
    'http://www.python.org/download/',
    'http://www.python.org/getit/',
    'http://www.python.org/community/',
    'https://wiki.python.org/moin/',
    'http://planet.python.org/',
    'https://wiki.python.org/moin/LocalUserGroups',
    'http://www.python.org/psf/',
    'http://docs.python.org/devguide/',
    'http://www.python.org/community/awards/'
    # etc..
    ]


# Make the Pool of workers
pool = ThreadPool(4)
# Open the urls in their own threads
# and return the results
results = pool.map(urllib2.urlopen, urls)
#close the pool and wait for the work to finish
pool.close()
pool.join()

实际起作用的代码只有 4 行,其中只有一行是关键的。map 函数轻而易举的取代了前文中超过 40 行的例子。为了更有趣一些,我统计了不同方法、不同线程池大小的耗时情况。

# results = []
# for url in urls:
#   result = urllib2.urlopen(url)
#   results.append(result)


# # ------- VERSUS ------- #


# # ------- 4 Pool ------- #
# pool = ThreadPool(4)
# results = pool.map(urllib2.urlopen, urls)


# # ------- 8 Pool ------- #


# pool = ThreadPool(8)
# results = pool.map(urllib2.urlopen, urls)


# # ------- 13 Pool ------- #


# pool = ThreadPool(13)
# results = pool.map(urllib2.urlopen, urls)

结果:

#        Single thread:  14.4 Seconds
#               4 Pool:   3.1 Seconds
#               8 Pool:   1.4 Seconds
#              13 Pool:   1.3 Seconds

很棒的结果不是吗?这一结果也说明了为什么要通过实验来确定线程池的大小。在我的机器上当线程池大小大于 9 带来的收益就十分有限了。

另一个真实的例子

生成上千张图片的缩略图

这是一个 CPU 密集型的任务,并且十分适合进行并行化。

基础单进程版本

import os
import PIL


from multiprocessing import Pool
from PIL import Image


SIZE = (75,75)
SAVE_DIRECTORY = 'thumbs'


def get_image_paths(folder):
    return (os.path.join(folder, f)
            for f in os.listdir(folder)
            if 'jpeg' in f)


def create_thumbnail(filename): 
    im = Image.open(filename)
    im.thumbnail(SIZE, Image.ANTIALIAS)
    base, fname = os.path.split(filename)
    save_path = os.path.join(base, SAVE_DIRECTORY, fname)
    im.save(save_path)


if __name__ == '__main__':
    folder = os.path.abspath(
        '11_18_2013_R000_IQM_Big_Sur_Mon__e10d1958e7b766c3e840')
    os.mkdir(os.path.join(folder, SAVE_DIRECTORY))


    images = get_image_paths(folder)


    for image in images:
        create_thumbnail(Image)

上边这段代码的主要工作就是将遍历传入的文件夹中的图片文件,一一生成缩略图,并将这些缩略图保存到特定文件夹中。

这我的机器上,用这一程序处理 6000 张图片需要花费 27.9 秒。

如果我们使用 map 函数来代替 for 循环:

import os
import PIL


from multiprocessing import Pool
from PIL import Image


SIZE = (75,75)
SAVE_DIRECTORY = 'thumbs'


def get_image_paths(folder):
    return (os.path.join(folder, f)
            for f in os.listdir(folder)
            if 'jpeg' in f)


def create_thumbnail(filename): 
    im = Image.open(filename)
    im.thumbnail(SIZE, Image.ANTIALIAS)
    base, fname = os.path.split(filename)
    save_path = os.path.join(base, SAVE_DIRECTORY, fname)
    im.save(save_path)


if __name__ == '__main__':
    folder = os.path.abspath(
        '11_18_2013_R000_IQM_Big_Sur_Mon__e10d1958e7b766c3e840')
    os.mkdir(os.path.join(folder, SAVE_DIRECTORY))


    images = get_image_paths(folder)


    pool = Pool()
    pool.map(creat_thumbnail, images)
    pool.close()
    pool.join()

5.6 秒!

虽然只改动了几行代码,我们却明显提高了程序的执行速度。在生产环境中,我们可以为 CPU 密集型任务和 IO 密集型任务分别选择多进程和多线程库来进一步提高执行速度——这也是解决死锁问题的良方。此外,由于 map 函数并不支持手动线程管理,反而使得相关的 debug工作也变得异常简单。

到这里,我们就实现了(基本)通过一行 Python 实现并行化。

(推荐微课:python3基础微课

以上就是关于如何用一行代码实现Python并行处理的相关介绍了,希望对大家有所帮助。

一款现代高效的Java构建工具–gradle的优点介绍

thbcm阅读(354)

学习Java的同学,相信你们都用过Maven这个经典实用的项目构建工具。但是假如你经常使用Maven的话,你或许会发现Maven一些让人不太舒服的地方:

  • 一来Maven的配置文件是XML格式的,假如你的项目依赖的包比较多,那么XML文件就会变得非常非常长;
  • 二来XML文件不太灵活,假如你需要在构建过程中添加一些自定义逻辑,搞起来非常麻烦;
  • 第三就是Maven非常的稳定,但是相对的就是对新版java支持不足,哪怕就是为了编译java11,也需要更新内置的Maven插件。

如果你对Maven的这些缺点也有所感触,准备尝试其他的构建工具,那么你可以试试gradle,这是一个全新的java构建工具,解决了Maven的一些痛点。

安装gradle

最传统的安装方法就是去gradle官网下载二进制包,解压,然后将路径添加到环境变量中。如果你没什么其他需求,可以使用这种安装方式。但是,gradle是一个非常新潮的项目,每隔几个月就会发布一个新版本,这种方式可能跟不上gradle的更新速度。

所以我更加推荐使用包管理器来安装gradle。如果你使用linux系统,那么不必多说。如果你使用Windows系统,我推荐使用scoop包管理器来安装gradle。它安装方便,而且使用SHIM目录来管理环境变量,在各种工具中配置gradle也很方便。

当然,如果你完全不喜欢安装这么多乱七八糟的东西,那也可以使用gradlegradle提供了一个名为gradle wrapper的工具,可以在没有安装gradle的情况下使用gradle。好吧,其实它就是个脚本文件,当你运行wrapper脚本的时候,如果脚本发现你电脑里没有gradle,就会自动替你下载安装一个。现在甚至还出现了Maven wrapper,也是个脚本文件,可以自动安装Maven

之前相信一些朋友听说过gradle,然后尝试使用它,结果因为速度太慢,最后放弃了。之前我也因为gradle的速度,放弃了它一段时间。不过现在使用gradle的话会方便很多。gradle官方在中国开设了CDN,使用gradle wrapper的时候下载速度非常快。可以说现在是一个学习使用gradle的好时候。

使用gradle wrapper

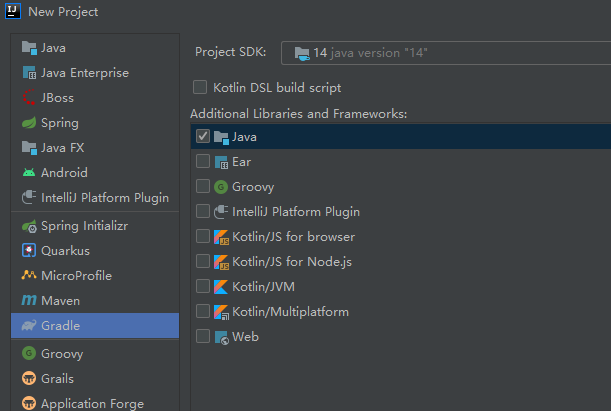
这里我使用的IDEA来创建和使用gradle项目。

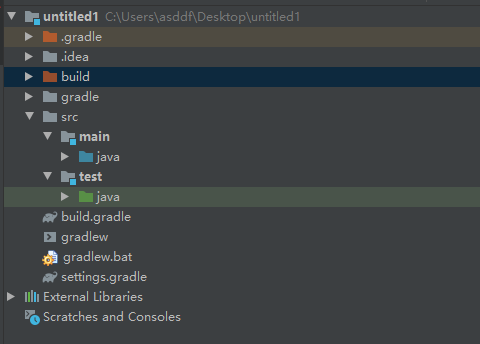
IDEA默认就会使用gradle wrapper来创建项目,所以无需安装gradle也可以正常运行。这时候项目结构应该类似下图所示,使用Maven的同学应该比较熟悉,因为这和Maven的项目结构几乎完全一致。gradle文件夹和gradlew那几个文件就是gradle wrapper的文件,而.gradle后缀名的文件正是gradle的配置文件,对应于Mavenpom.xml

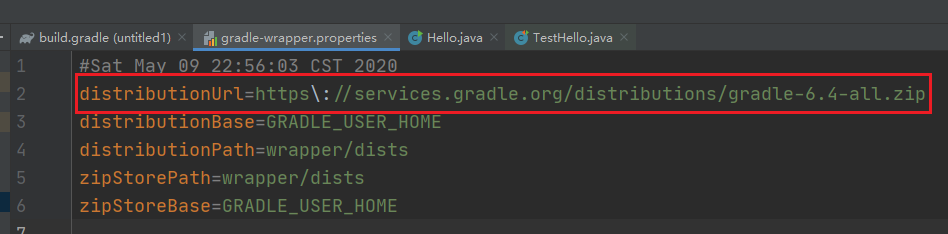
gradle wrapper的优点之一就是可以自定义下载的gradle的版本,如果是团队协作的话,这个功能就非常方便,简单设置即可统一团队的构建工具版本。这里我就设定成目前最新的gradle 6.4.默认下载安装的是bin版,仅包含二进制。如果你使用IDEA的话,它会推荐下载all版,包含源代码,这样IDEA就可以分析源代码,提供更加精确的gradle脚本支持。

依赖管理

下面来看看gradle的依赖管理功能,这也算是我们使用构建工具的主要目的之一了。这点也是gradle相较maven的优势之一了。相较于maven一大串的XML配置,gradle的依赖项仅需一行。

dependencies {
    testImplementation 'junit:junit:4.13'
    implementation 'com.google.code.gson:gson:2.8.6'
}

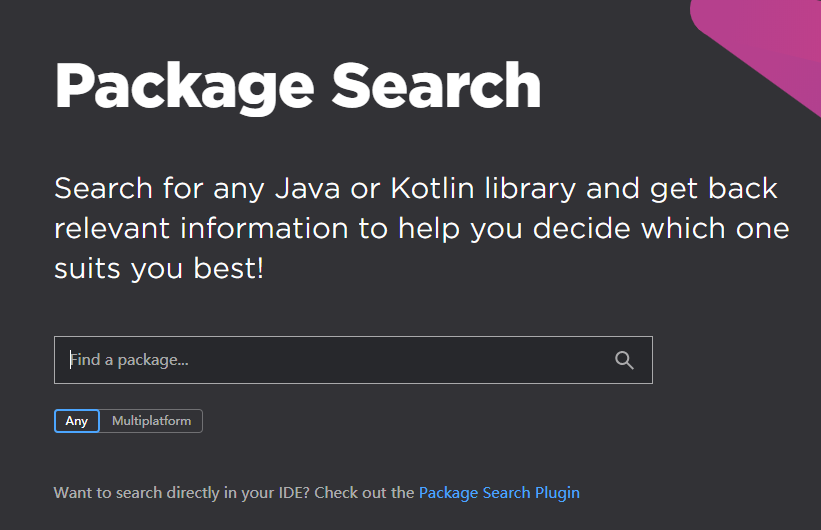
这里推荐一下Jetbrainspackage search网站,是寻找mavengradle依赖包的最佳网站,可以非常轻松的搜索和使用依赖项。

(推荐教程:Java教程

gradle依赖的粒度控制相较于Maven也更加精细,maven只有compileprovidedtestruntime四种scope,而gradle有以下几种scope

  • implementation,默认的scopeimplementation的作用域会让依赖在编译和运行时均包含在内,但是不会暴露在类库使用者的编译时。举例,如果我们的类库包含了gson,那么其他人使用我们的类库时,编译时不会出现gson的依赖。
  • api,和implementation类似,都是编译和运行时都可见的依赖。但是api允许我们将自己类库的依赖暴露给我们类库的使用者。
  • compileOnlyruntimeOnly,这两种顾名思义,一种只在编译时可见,一种只在运行时可见。而runtimeOnlyMavenprovided比较接近。
  • testImplementation,这种依赖在测试编译时和运行时可见,类似于Maventest作用域。
  • testCompileOnlytestRuntimeOnly,这两种类似于compileOnlyruntimeOnly,但是作用于测试编译时和运行时。

通过简短精悍的依赖配置和多种多样的作用与选择,Gradle可以为我们提供比Maven更加优秀的依赖管理功能。

gradle的任务和插件

gradle的配置文件是一个groovy脚本文件,在其中我们可以以编程方式自定义一些构建任务。因为使用了编程方式,所以这带给了我们极大的灵活性和便捷性。打个比方,现在有个需求,要在打包出jar的时候顺便看看jar文件的大小。在gradle中仅需在构建脚本中编写几行代码即可。而在Maven中则需要编写Maven插件,复杂程度完全不在一个水平。

当然,Maven发展到现在,已经存在了大量的插件,提供了各式各样的功能可以使用。但是在灵活性方面还是无法和Gradle相比。而且Gradle也有插件功能,现在发展也十分迅猛,存在了大量非常好用的插件,例如gretty插件。gretty原来是社区插件,后来被官方吸收为官方插件,可以在Tomcatjetty服务器上运行web项目,比Maven的相关插件功能都强大。

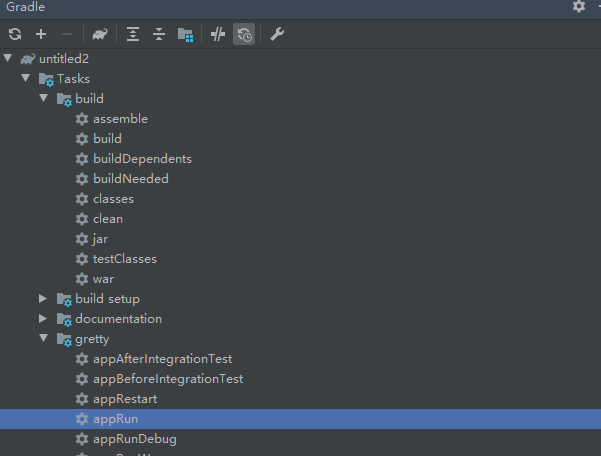
虽然gradle可以非常灵活的编写自定义脚本任务,但是其实一般情况下我们不需要编写构建脚本,利用现有的插件和任务即可完成相关功能。在IDEA里,也可以轻松的查看当前gradle项目中有多少任务,基本任务如buildtestMavenGradle都是相通的。

配置镜像

Maven官方仓库的下载速度非常慢,所以一般我们要配置国内的镜像源。gradle在这方面和Maven完全兼容,因此只需稍微配置一下镜像源,即可使用Maven的镜像。如果你用gradle构建过项目,应该就可以在用户目录的.gradle文件夹下看到gradle的相关配置和缓存。

(推荐微课:Java微课

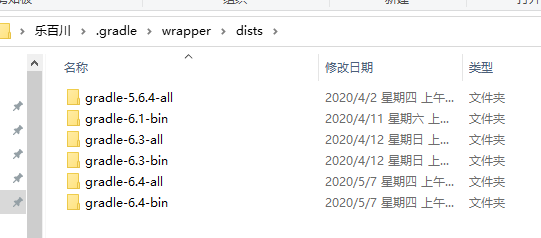
之前wrapper下载的gradle也存放在该文件夹下,位置是wrapper/dists

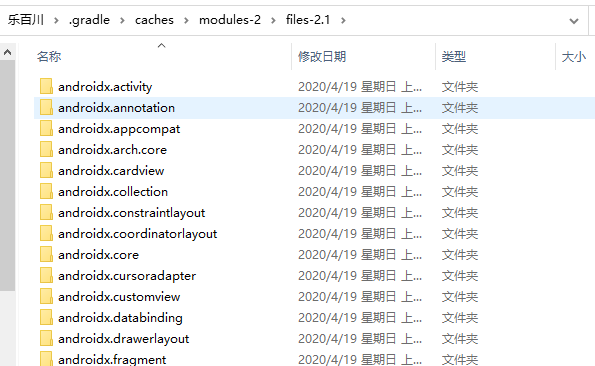
而依赖的本地缓存在caches\modules-2\files-2.1文件夹下。目录结构和Maven的本地缓存类似,都是包名+版本号的方式,但是gradle的目录结构最后一层和Maven不同,这导致它们无法共用本地缓存。

言归正传,在gradle中配置下载镜像需要在.gradle文件夹中直接新建一个init.gradle初始化脚本,脚本文件内容如下。这样一来,gradle下载镜像的时候就会使用这里配置的镜像源下载,速度会快很多。再加上gradle wrapper在中国设置了CDN,现在使用gradle的速度应该会很快。

allprojects {
   repositories {
       maven {
           url "https://maven.aliyun.com/repository/public"
       }
       maven {
           url "https://maven.aliyun.com/repository/jcenter"
       }
       maven {
           url "https://maven.aliyun.com/repository/spring"
       }
       maven {
           url "https://maven.aliyun.com/repository/spring-plugin"
       }
       maven {
           url "https://maven.aliyun.com/repository/gradle-plugin"
       }
       maven {
           url "https://maven.aliyun.com/repository/google"
       }
       maven {
           url "https://maven.aliyun.com/repository/grails-core"
       }
       maven {
           url "https://maven.aliyun.com/repository/apache-snapshots"
       }
   }
}

当然,如果你有代理的话,其实我推荐你直接为gradle设置全局代理。因为gradle脚本实在是太灵活了,有些脚本中可能依赖了github或者其他地方的远程脚本。这时候上面设置的下载镜像源就不管用了。

所以有条件还是干脆直接使用全局代理比较好。设置方式很简单,在.gradle文件夹中新建gradle.properties文件,内容如下。中间几行即是设置代理的配置项。当然其他几行我也建议你设置一下,把gradle运行时的文件编码设置为UTF8,增加跨平台兼容性。

org.gradle.jvmargs=-Xmx4g -XX:MaxPermSize=512m -XX:+HeapDumpOnOutOfMemoryError -Dfile.encoding=UTF-8
systemProp.http.proxyHost=127.0.0.1
systemProp.http.proxyPort=10800
systemProp.https.proxyHost=127.0.0.1
systemProp.https.proxyPort=10800
systemProp.file.encoding=UTF-8
org.gradle.warning.mode=all

为什么使用gradle?

看到这里,你应该对gradle有了基本的了解, 也可以将其用于你的项目之中。但是如果你Maven已经非常熟悉了,可能不太愿意使用gradle,因为貌似没有必要。但是既然gradle出现了,就说明有很多人对Maven还是有一定的意见。因此在这里我来总结一下gradle相比maven的优势。

1.速度

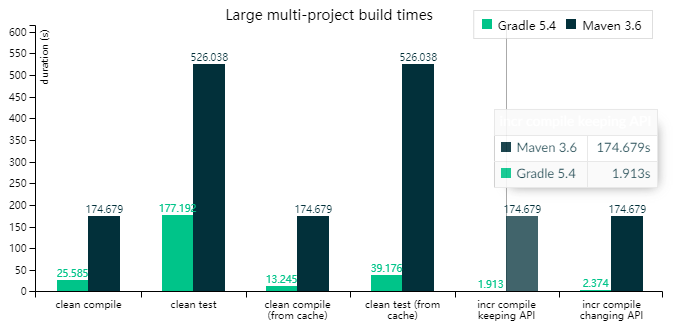
gradle使用构建缓存、守护进程等方式提高编译速度。结果就是gradle的编译速度要远超maven,平均编译速度比Maven快好几倍,而且项目越大,这个差距就越明显。

2.灵活性

gradle要比Maven灵活太多,虽然有时候灵活并不是一件好事情。但是大部分情况下,灵活一点可以极大的方便我们。Maven死板的XML文件方式做起事情来非常麻烦。很多Maven项目都通过执行外部脚本的方式来完成一些需要灵活性的工作。而在gradle中配置文件就是构建脚本,构建脚本就是编程语言(groovy编程语言),完全可以自给自足,无需外部脚本。

3.简洁性

完成同样的功能,gradle脚本的长度要远远短于maven配置文件的长度。虽然很多人都说XML维护起来不麻烦,但是我觉得,维护一个光是依赖就有几百行的XML文件,不见得就比gradle脚本简单。

也许是因为我上面说的原因,也许有其他原因,不得不承认的一件事情就是gradle作为一个新兴的工具已经有了广泛的应用。spring等项目已经从Maven切换到了gradle。开发安卓程序也只支持gradle了。因此不管是否现在需要将项目从maven切换到gradle,但是至少学习gradle是一件必要的事情。

(推荐教程:Gradle 教程

以上就是关于一款现代高效的 Java 构建工具– gradle 的优点介绍了,希望对大家所有帮助。

作者:百乐川

文章来源:www.toutiao.com/i6824937779193971207

Consul-template+Nginx 实现Thrift Consul负载均衡

thbcm阅读(394)

今天给大家分享一个采用 Consul 实现的负载均衡的方案,很多小伙伴都知道 Nginx 可以实现负载均衡,但是可能没实现过结合 Consul,今天就给大家分享一下。

整体架构

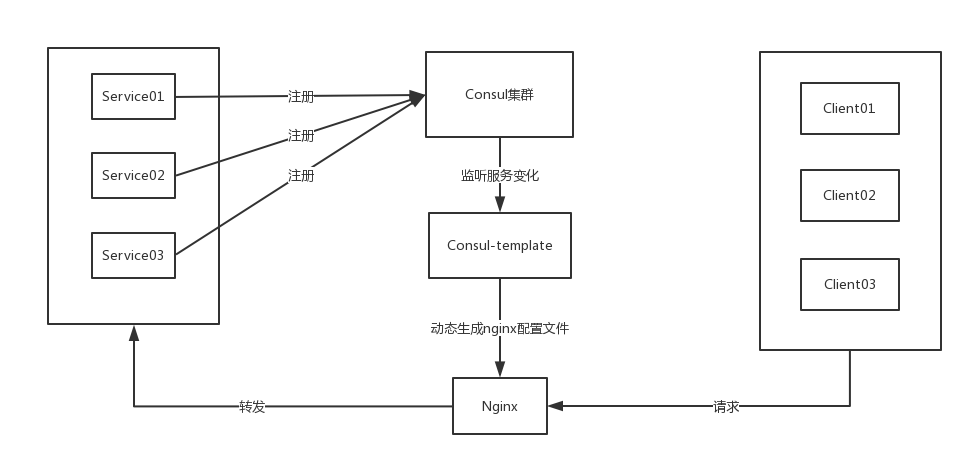
我们先看下整个框架的架构是什么样子的,这里我们有三个服务提供者和三个服务调用者,它们通过 ConsulNginx,以及 Consul-template 来实现负载均衡。

说明 本例子是进行 RPC 的负载均衡,RPC 是 tcp协议,所以 Nginx 要配置 tcp 模块,支持 tcp 负载均衡。

  1. Consul 集群 用于服务注册,注册多个服务实例,对外提供 RPC 服务。
  2. Consul-template 用于实时监测 Consul 中服务的状态,配合自身一个模板文件,生成 Nginx 的配置文件。
  3. Nginx 使用自身的配置文件和第二步生成的配置文件,进行负载均衡。

Nginx安装

  1. 安装最新版 Nginx,保证 Nginx 版本在 1.9.0 以上
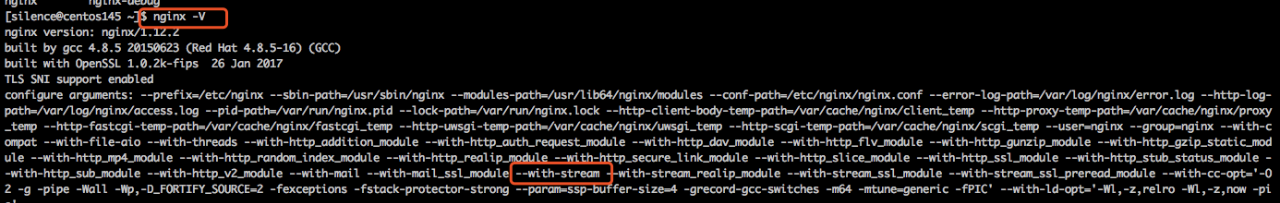
  2. 1.9.0 版本以上才支持 TCP 转发,据说不是默认安装了该模块,安装完成可以查询一下,如果有--with-stream参数,表示已经支持TCP。如果没有就重新编译增加参数安装。
  3. 我的 Nginx 安装在/etc/nginx目录下
  4. 安装完成使用nginx -t监测一下是否成功。

Consul-template

本文旨在负载均衡,Consul 集群搭建不作介绍。

1.下载对应系统版本文件 https://releases.hashicorp.com/consul-template/

2.解压,并复制到PATH路径下

[silence@centos145 ~]$ tar xzvf consul-template_0.19.4_linux_amd64.tgz
[silence@centos145 ~]$ mv ./consul-template /usr/sbin/consul-template

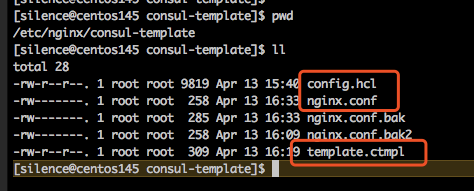
3.找个地方新建个文件夹,并创建三个文件

4.config.hcl主要用来配置consul-template的启动参数项,包括consul服务器的地址,模板文件的位置,生成的配置文件的位置等等。除了consultemplate块,其他参数可选。参考https://github.com/hashicorp/consul-template

5.Consul块配置Consul服务器地址和端口

consul {
  auth {
    enabled  = false
    username = "test"
    password = "test"
  }


  address = "172.20.132.196:8500"
  retry {
    enabled = true
    attempts = 12
    backoff = "250ms"
    max_backoff = "1m"
  }


}

6.template块配置模板的路径和生成文件的位置,以及生成文件后需要执行的命令。在我们这里我们需要nginx重新加载配置文件,所以设置的命令为nginx -s reload

template {
  source = "/etc/nginx/consul-template/template.ctmpl"
  destination = "/etc/nginx/consul-template/nginx.conf"
  create_dest_dirs = true
  command = "/usr/sbin/nginx -s reload"
  command_timeout = "30s"
  error_on_missing_key = false
  perms = 0600
  backup = true
  left_delimiter  = "{{"
  right_delimiter = "}}"
  wait {
    min = "2s"
    max = "10s"
  }
}

7.template.ctmpl编写,因为这里只需要服务器地址和端口号就可以,所以模板文件如下:

[root@centos145 consul-template]# cat template.ctmpl
stream {


    log_format main '$remote_addr - [$time_local] '
      '$status';


    access_log /var/log/nginx/tcp_access.log main;


    upstream cloudsocket {
 \{\{range service "ad-rpc-device-server"}}server \{\{.Address}}:\{\{.Port}};{{end}}
    }


    server {
 listen 8888;
 proxy_pass cloudsocket;
    }
}

8.启动consul-template consul-template -config=./config.hcl

使用config.hcl配置文件是为了简化命令 consul-template -consul-addr=172.20.132.196:8500 -template=./template.ctmpl:./nginx.conf

9.初始的nignx.conf文件为空的,在启动后内容为

[root@centos145 consul-template]# cat nginx.conf
stream {


    log_format main '$remote_addr - [$time_local] '
      '$status';


    access_log /var/log/nginx/tcp_access.log main;


    upstream cloudsocket {
 server 172.20.139.77:8183;
    }


    server {
 listen 8888;
 proxy_pass cloudsocket;
    }
}

确保服务已经成功注册到Consul中,即可以看到服务器地址和端口已经配置进去了。

10.在nginx的安装目录的nginx.conf中引入consul-template生成的配置文件 include /etc/nginx/consul-template/nginx.conf;

注意生成的配置文件不能喝nginx本身的配置文件中内容重复!!!

11.启动一个服务实例,查看生成的nginx.conf文件会发现在upstream cloudsocket{}中会动态增加服务列表,并且随着服务的加入和离开,动态变化。

[root@centos145 consul-template]# cat nginx.conf
stream {


    log_format main '$remote_addr - [$time_local] '
      '$status';


    access_log /var/log/nginx/tcp_access.log main;


    upstream cloudsocket {
 server 172.20.139.77:8183;
    }


    server {
 listen 8888;
 proxy_pass cloudsocket;
    }
}

再启动一个,服务列表变成两个了

[root@centos145 consul-template]# cat nginx.conf
stream {


    log_format main '$remote_addr - [$time_local] '
      '$status';


    access_log /var/log/nginx/tcp_access.log main;


    upstream cloudsocket {
 server 172.20.139.77:8183;server 172.20.139.77:8184;
    }


    server {
 listen 8888;
 proxy_pass cloudsocket;
    }
}

12.thrift客户端在调用的时候只需要配置Nginx的地址和端口就可以了,不需要配置服务的地址和端口了,Nginx会自动做转发。

(推荐教程:Nginx 入门指南

总结

今天给大家介绍了一个新的负载均衡实现方案,这种方案对于一些小规模的集群还是很不错的,当然如果是大集群,还是采用阿里云或者腾讯云提供的方案才是最好的。想自己实现的小伙伴环境去尝试搭建一下,还是很好玩的。

文章来源:公众号– Java极客技术

作者:鸭血粉丝

以上就是关于Consul-template+Nginx 实现Thrift Consul负载均衡的相关介绍了,希望对大家有所帮助。

Vue组件间的8种通讯方式

thbcm阅读(340)

前言

Vue 提供了各种各样的通讯,其中包括兄弟间的通讯和非兄弟间的通讯,借此机会做个总结,查阅起来方便。

1、props

目录结构

components
   ├── Parent.vue   // 父亲
   ├── Son1.vue     // 儿子1

代码结构

在父亲组件中使用儿子组件,给儿子通过:date="xxx"单向传值

<template>
  <div>
    <div>爸爸:{{date}}</div>
    <Son1 :date="date"></Son1>
  </div>
</template>
<script>
import Son1 from "./son1";
export default {
  components: { Son1 },
  data() {
    return {
      date: 1,
    };
  },
};
</script>

儿子组件通过props接受父组件传过来的值

<template>
  <div>儿子:{{date}}</div>
</template>
<script>
export default {
  props: {
    date: {
      type: Number, //校验类型
      default: "1",
    },
  },
};
</script>

2、$emit

目录结构

components
   ├── Parent.vue   // 父亲
   ├── Son1.vue     // 儿子1

代码结构

(推荐教程:Vue 2教程

子组件通过触自身的方法来触发$emit方法,再触发父组件的方法,通过回调传参的方式将修改的内容传递给父组件

<template>
  <div>
    <div>儿子:{{date}}</div>
    <button @click="changeNum">修改</button>
  </div>
</template>
<script>
export default {
  props: {
    date: {
      type: Number,
      default: "1",
    },
  },
  methods: {
    changeNum() {
      this.$emit("changeNum", 2);
    },
  },
};
</script>

父组件接受回调params参数,即爸爸需要给儿子绑定了一个自定义的事件,$on("changeNum",params)

<template>
  <div>
    <div>爸爸:{{date}}</div>
    <Son1 :date="date" @changeNum="changeNum"></Son1>
  </div>
</template>
<script>
import Son1 from "./son1";
export default {
  components: { Son1 },
  data() {
    return {
      date: 1,
    };
  },
  methods: {
    changeNum(params) {
      this.date = params;
    },
  },
};
</script>

.sync

目录结构

components
   ├── Parent.vue   // 父亲
   ├── Son1.vue     // 儿子1

代码结构

子组件通过$emit("update:xxx")发射事件

<template>
  <div>
    <div>儿子:{{date}}</div>
    <button @click="changeNum">修改</button>
  </div>
</template>
<script>
export default {
  props: {
    date: {
      type: Number,
      default: "1",
    },
  },
  methods: {
    changeNum() {
      this.$emit("update:date", 2);
    },
  },
};
</script>

父组件通过:xxx.sync="xxx"接受参数

<template>
  <div>
    <div>爸爸:{{date}}</div>
    <Son1 :date.sync="date"></Son1>
  </div>
</template>
<script>
import Son1 from "./son1";
export default {
  components: { Son1 },
  data() {
    return {
      date: 1,
    };
  },
};
</script>
<Son1 :date.sync="date"></Son1>
//这个写法是上面的替代品 默认组件内部触发 update:count 规定写法
<Son1 :date="date" @update:date="val=>date=val"></Son1>

v-model

目录结构

components
   ├── Parent.vue   // 父亲
   ├── Son1.vue     // 儿子1

代码结构

子组件触发的事件只能是input事件,接收props的属性名只能叫value

<template>
  <div>
    <div>儿子:{{value}}</div>
    <button @click="changeNum">修改</button>
  </div>
</template>
<script>
export default {
  props: {
    value: {
      type: Number,
      default: 1,
    },
  },
  methods: {
    changeNum() {
      this.$emit("input", 2);
    },
  },
};
</script>

父组件通过v-model接收参数

<template>
  <div>
    <div>爸爸:{{value}}</div>
    <Son1 v-model="value"></Son1>
  </div>
</template>
<script>
import Son1 from "./son1";
export default {
  components: { Son1 },
  data() {
    return {
      value: 1,
    };
  },
};
</script>
<Son1 :value="value" @input="val=>value=val"></Son1>
//这个写法是上面的替代品 默认组件内部触发 input 规定写法
<Son1 v-model="value"></Son1>


<br> v-model` 局限只能传递一个属性 如果只有一个 可以使用`v-model` 多个依然需要使用`.sync
<br> ```

3、$parent和 $children

目录结构

components
   ├── Parent.vue   // 父亲
   ├── Son1.vue     // 儿子1
   ├── Grandson1.vue  //孙子1

代码结构

如下场景:孙子想要给爷爷传递数据,孙子需要找到爷爷身上的事件去传递$parent.$emit

<template>
  <div>
    <div>孙子{{value}}</div>
    <button @click="$parent.$emit('change',3)">修改</button>
  </div>
</template>
<script>
export default {
  props: {
    value: {
      type: Number,
      default: "",
    },
  },
};
</script>

儿子组件使用孙子组件

<template>
  <div>
    <div>儿子:{{value}}</div>
    <grandson1 :value="value"></grandson1>
  </div>
</template>
<script>
import grandson1 from "./grandson1";
export default {
  components: {
    grandson1,
  },
  props: {
    value: {
      type: Number,
      default: 1,
    },
  },
};
</script>

爸爸身上给孙子自定义change事件

<template>
  <div>
    <div>爸爸:{{value}}</div>
    <Son1 @change="val=>value=val" :value="value"></Son1>
  </div>
</template>
<script>
import Son1 from "./son1";
export default {
  components: { Son1 },
  data() {
    return {
      value: 1,
    };
  },
};
</script>

如果层级很深那么就会出现$parent.$parent.....我们可以封装一个$dispatch方法向上进行派发

Vue.prototype.$dispatch = function $dispatch(eventName, data) {
  let parent = this.$parent;
  while (parent) {
    parent.$emit(eventName, data);
    parent = parent.$parent;
  }
};

相同的道理,如果既然能够向上寻找父亲,就能向下寻找儿子,也可以封装一个向下派发的方法$broadcast

Vue.prototype.$broadcast = function $broadcast(eventName, data) {
  const broadcast = function () {
    this.$children.forEach((child) => {
      child.$emit(eventName, data);
      if (child.$children) {
        $broadcast.call(child, eventName, data);
      }
    });
  };
  broadcast.call(this, eventName, data);
};

4、$attrs和 $listeners

目录结构

components
   ├── Parent.vue   // 父亲
   ├── Son1.vue     // 儿子1
   ├── Grandson1.vue  //孙子1

$attrs批量向下传入属性

<template>
  <div>
    <div>爸爸:{{value}}</div>
    <Son1 @change="val=>value=val" :value="value"></Son1>
  </div>
</template>
<script>
import Son1 from "./son1";
export default {
  components: { Son1 },
  data() {
    return {
      value: 1,
    };
  },
};
</script>

在儿子组件中使用 $attrs 属性,配合v-bind可以将属性继续向下传递

<template>
  <div>
    <div>儿子:{{$attrs.value}}</div>
    <grandson1 v-bind="$attrs"></grandson1>
  </div>
</template>
<script>
import grandson1 from "./grandson1";
export default {
  components: {
    grandson1,
  },
  mounted() {
    console.log(this.$attrs);
  },
};
</script>

注意一点:在使用 $attrs 的时候,如果组件中使用了props 就会将属性从当前 attrs移除掉

在孙子组件中使用 $attrs属性,可以将属性继续向下传递

<template>
  <div>
    <div>孙子{{$attrs.value}}</div>
  </div>
</template>
<script>
export default {
  //props: {
  //  value: Number,
  //},
  mounted() {
    console.log(this.$attrs);
  },
};
</script>

如果爸爸传递给儿子元素, 儿子有三个属性用不到, 孙子传递给孙子,但是不想在页面上这个属性,可以设置inheritAttrs: false

$listeners批量向下传入方法

<template>
  <div>
    <div>爸爸:{{value}}</div>
    <Son1 @click="change" :value="value"></Son1>
  </div>
</template>
<script>
import Son1 from "./son1";
export default {
  components: { Son1 },
  data() {
    return {
      value: 1,
    };
  },


  methods: {
    change() {
      this.value = 2;
    },
  },
};
</script>

可以在 son1 组件中使用$listeners属性,配合v-on可以将方法继续向下传递

<template>
  <div>
    <div>儿子:{{$attrs.value}}</div>
    <grandson1 v-bind="$attrs" v-on="$listeners"></grandson1>
  </div>
</template>
<script>
import grandson1 from "./grandson1";
export default {
  components: {
    grandson1,
  },
  mounted() {
    console.log(this.$attrs);
    console.log(this.$listeners);
  },
};
</script>

孙子组件可以直接使用$listeners上的方法

<template>
  <div>
    <div>孙子{{$attrs.value}}</div>
    <button @click="$listeners.click"></button>
  </div>
</template>
<script>
export default {
  mounted() {
    console.log(this.$attrs);
    console.log(this.$listeners);
  },
};
</script>

5、Provide & Inject

目录结构

app.vue
components
   ├── Parent.vue   // 父亲
   ├── Son1.vue     // 儿子1
   ├── Grandson1.vue  //孙子1

代码结构

在父级声明一个公共数据

export default {
  provide() {
    return { vm: this };
  },
};

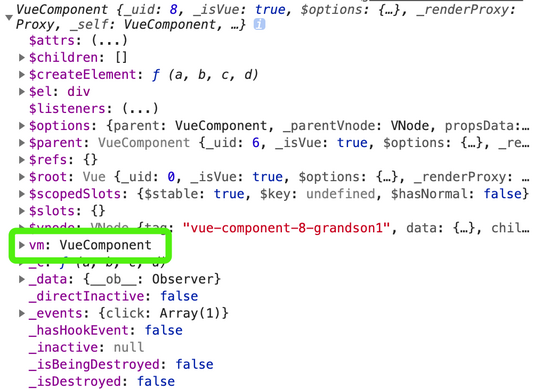
在子组件中可以注入原理,会将数据挂载在当前实例上

<template>
  <div>
    <div>孙子</div>
  </div>
</template>
<script>
export default {
  inject: ["vm"],
  mounted() {
    console.log(this);
  },
};
</script>

注意事项:这个方法使用之后比较混乱,它一般不会在业务代码中使用,经常是在组件库或者多级通信,为了方便你可以使用provide

6、ref

目录结构

components
   ├── Parent.vue   // 父亲
   ├── Son1.vue     // 儿子1

代码结构

ref获取的是真实的 dom 元素,如果放到组件上代表的是当前组件的实例。父组件中可以直接获取子组件的方法或者数据。

<template>
  <div>
    <div>爸爸</div>
    <Son1 ref="son"></Son1>
  </div>
</template>
<script>
import Son1 from "./son1";
export default {
  components: { Son1 },
  mounted() {
    this.$refs.son.show();
  },
};
</script>
<template>
  <div>
    <div>儿子</div>
  </div>
</template>
<script>
export default {
  methods: {
    show() {
      console.log(1);
    },
  },
};
</script>

注意事项:ref不要重名, 但是当且仅当使用v-for的时候会导致出现数组情况

7、EventBus

目录结构

main.js
components
   ├── Grandson1.vue   // 孙子1
   ├── Son2.vue     // 儿子2

代码结构

EventBus可用于跨组件通知(不复杂的项目可以使用这种方式)

Vue.prototype.$bus = new Vue();

Grandson1 组件和Son2相互通信

<template>
  <div>孙子1</div>
</template>
<script>
export default {
  mounted() {
    this.$nextTick(() => {
      this.$bus.$emit("test", "go");
    });
  },
};
</script>

这里的儿子 2 组件只能使用$on来触发 Grandson1 组件事件

<template>
  <div>儿子2</div>
</template>
<script>
export default {
  mounted() {
    this.$bus.$on("test", (data) => {
      console.log(data);
    });
  },
};
</script>

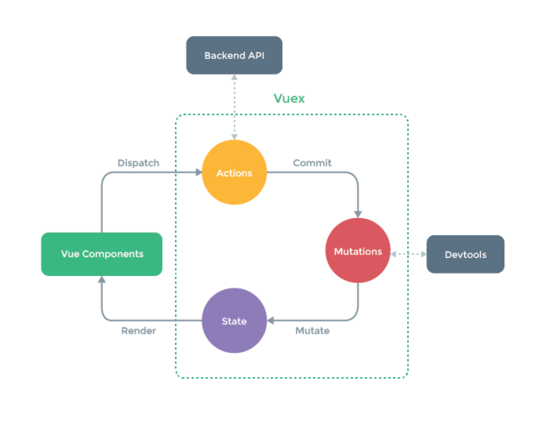
8、Vuex

Vuex 是一个专为 Vue.js 应用程序开发的状态管理模式。

(推荐微课:Vue 2.x 微课

文章来源:公众号——小丑的小屋

作者:小丑

以上就是W3Cschool编程狮关于Vue组件间的8种通讯方式的相关介绍了,希望对大家有所帮助。

Java中常见的一些坑,汇总篇

thbcm阅读(331)

1.前言

中国有句老话叫”事不过三”,指一个人犯了同样的错误,一次两次三次还可以原谅,超过三次就不可原谅了。有人指出这个“三”是虚数,用来泛指多次,所以”事不过三”不包括“三”。至于”事不过三”包不包括“三”,可能跟每个人的底线有关系,属于哲学范畴,不在本文的讨论范围之内。

写代码也是如此,同一个代码“坑”,踩第一次叫”长了经验”,踩第二次叫”加深印象”,踩第三次叫”不长心眼”,踩三次以上就叫”不可救药”。在本文中,笔者总结了一些代码坑,描述了问题现象,进行了问题分析,给出了避坑方法。希望大家在日常编码中,遇到了这类代码坑,能够提前避让开来。

1.对象比较方法

JDK1.7 提供的 Objects.equals 方法,非常方便地实现了对象的比较,有效地避免了繁琐的空指针检查。

1.1.问题现象

在 JDK1.7 之前,在判断一个短整型、整型、长整型包装数据类型与常量是否相等时,我们一般这样写:

Short shortValue = (short)12345;
System.out.println(shortValue == 12345); // true
System.out.println(12345 == shortValue); // true
Integer intValue = 12345;
System.out.println(intValue == 12345); // true
System.out.println(12345 == intValue); // true
Long longValue = 12345L;
System.out.println(longValue == 12345); // true
System.out.println(12345 == longValue); // true

从 JDK1.7 之后,提供了 Objects.equals 方法,并推荐使用函数式编程,更改代码如下:

Short shortValue = (short)12345;
System.out.println(Objects.equals(shortValue, 12345)); // false
System.out.println(Objects.equals(12345, shortValue)); // false
Integer intValue = 12345;
System.out.println(Objects.equals(intValue, 12345)); // true
System.out.println(Objects.equals(12345, intValue)); // true
Long longValue = 12345L;
System.out.println(Objects.equals(longValue, 12345)); // false
System.out.println(Objects.equals(12345, longValue)); // false

为什么直接把 == 替换为 Objects.equals 方法会导致输出结果不一样?

1.2.问题分析

通过反编译第一段代码,我们得到语句"System.out.println(shortValue == 12345);"的字节码指令如下:

7   getstatic java.lang.System.out : java.io.PrintStream [22]
10  aload_1 [shortValue]
11  invokevirtual java.lang.Short.shortValue() : short [28]
14  sipush 12345
17  if_icmpne 24
20  iconst_1
21  goto 25
24  iconst_0
25  invokevirtual java.io.PrintStream.println(boolean) : void [32]

原来,编译器会判断包装数据类型对应的基本数据类型,并采用这个基本数据类型的指令进行比较(比如上面字节码指令中的sipushif_icmpne等),相当于编译器自动对常量进行了数据类型的强制转化。

为什么采用 Objects.equals 方法后,编译器不自动对常量进行数据类型的强制转化?通过反编译第二段代码,我们得到语句 "System.out.println(Objects.equals(shortValue, 12345));" 的字节码指令如下:

7   getstatic java.lang.System.out : java.io.PrintStream [22]
10  aload_1 [shortValue]
11  sipush 12345
14  invokestatic java.lang.Integer.valueOf(int) : java.lang.Integer [28]
17  invokestatic java.util.Objects.equals(java.lang.Object, java.lang.Object) : boolean [33]
20  invokevirtual java.io.PrintStream.println(boolean) : void [39]

原来,编译器根据字面意思,认为常量 12345 默认基本数据类型是 int ,所以会自动转化为包装数据类型 Integer

在 Java 语言中,整数的默认数据类型是 int ,小数的默认数据类型是 double 。

下面来分析一下 Objects.equals 方法的代码实现:

public static boolean equals(Object a, Object b) {
   return (a == b) || (a != null && a.equals(b));
}

其中,语句 “a.equals(b)” 将会使用到 Short.equals方法。

Short.equals 方法的代码实现为:

public boolean equals(Object obj) {
   if (obj instanceof Short) {
       return value == ((Short)obj).shortValue();
  }
   return false;
}

通过代码实现分析:对应语句"System.out.println(Objects.equals(shortValue, 12345));",因为Objects.equals的两个参数对象类型不一致,一个是包装数据类型 Short ,另一个是包装数据类型 Integer ,所以最终的比较结果必然是 false 。同样,语句 “System.out.println(Objects.equals(intValue, 12345));” ,因为 Objects.equals 的两个参数对象类型一致,都是包装数据类型Integer且取值一样,所以最终的比较结果必然是 true

1.3.避坑方法

1、保持良好的编码习惯,避免数据类型的自动转化

为了避免数据类型自动转化,更科学的写法是直接声明常量为对应的基本数据类型。

第一段代码可以这样写:

Short shortValue = (short)12345;
System.out.println(shortValue == (short)12345); // true
System.out.println((short)12345 == shortValue); // true
Integer intValue = 12345;
System.out.println(intValue == 12345); // true
System.out.println(12345 == intValue); // true
Long longValue = 12345L;
System.out.println(longValue == 12345L); // true
System.out.println(12345L == longValue); // true

第二段代码可以这样写:

Short shortValue = (short)12345;
System.out.println(Objects.equals(shortValue, (short)12345)); // true
System.out.println(Objects.equals((short)12345, shortValue)); // true
Integer intValue = 12345;
System.out.println(Objects.equals(intValue, 12345)); // true
System.out.println(Objects.equals(12345, intValue)); // true
Long longValue = 12345L;
System.out.println(Objects.equals(longValue, 12345L)); // true
System.out.println(Objects.equals(12345L, longValue)); // true

2、借助开发工具或插件,及早地发现数据类型不匹配问题

Eclipse 的问题窗口中,我们会看到这样的提示:

Unlikely argument type for equals(): int seems to be unrelated to Short
Unlikely argument type for equals(): Short seems to be unrelated to int
Unlikely argument type for equals(): int seems to be unrelated to Long
Unlikely argument type for equals(): Long seems to be unrelated to int

通过 FindBugs 插件扫描,我们会看到这样的警告:

Call to Short.equals(Integer) in xxx.Xxx.main(String[]) [Scariest(1), High confidence]
Call to Integer.equals(Short) in xxx.Xxx.main(String[]) [Scariest(1), High confidence]
Call to Long.equals(Integer) in xxx.Xxx.main(String[]) [Scariest(1), High confidence]
Call to Integer.equals(Long) in xxx.Xxx.main(String[]) [Scariest(1), High confidence]

3、进行常规性单元测试,尽量把问题发现在研发阶段

“勿以善小而不为”,不要因为改动很小就不需要进行单元测试了,往往 Bug 都出现在自己过度自信的代码中。像这种问题,只要进行一次单元测试,是完全可以发现问题的。

2.三元表达式拆包

三元表达式是 Java 编码中的一个固定语法格式:“条件表达式?表达式 1 :表达式 2 ”。

三元表达式的逻辑为:“如果条件表达式成立,则执行表达式 1 ,否则执行表达式 2 ”。

2.1.问题现象

boolean condition = false;
Double value1 = 1.0D;
Double value2 = 2.0D;
Double value3 = null;
Double result = condition ? value1 * value2 : value3; // 抛出空指针异常

当条件表达式 condition 等于 false 时,直接把 Double 对象 value3 赋值给 Double 对象result,按道理没有问题呀,为什么会抛出空指针异常(NullPointerException)?

2.2.问题分析

通过反编译代码,我们得到语句"Double result = condition ? value1 * value2 : value3;"的字节码指令如下:

17  iload_1 [condition]
18  ifeq 33
21  aload_2 [value1]
22  invokevirtual java.lang.Double.doubleValue() : double [24]
25  aload_3 [value2]
26  invokevirtual java.lang.Double.doubleValue() : double [24]
29  dmul
30  goto 38
33  aload 4 [value3]
35  invokevirtual java.lang.Double.doubleValue() : double [24]
38  invokestatic java.lang.Double.valueOf(double) : java.lang.Double [16]
41  astore 5 [result]
43  getstatic java.lang.System.out : java.io.PrintStream [28]
46  aload 5 [result]

在第 33 行,加载 Double 对象 value3 到操作数栈中;在第 35 行,调用 Double 对象 value3doubleValue 方法。这个时候,由于 value3 是空对象 null ,调用 doubleValue 方法必然抛出抛出空指针异常。但是,为什么要把空对象 value3 转化为基础数据类型 double

查阅相关资料,得到三元表达式的类型转化规则:

  1. 若两个表达式类型相同,返回值类型为该类型;
    2. 若两个表达式类型不同,但类型不可转换,返回值类型为Object类型;
    3. 若两个表达式类型不同,但类型可以转化,先把包装数据类型转化为基本数据类型,然后按照基本数据类型的转换规则(byte<short(char)<int<long<float<double)来转化,返回值类型为优先级最高的基本数据类型。

根据规则分析,表达式 1(value1 * value2)计算后返回基础数据类型 double ,表达式 2(value3) 返回包装数据类型 double ,根据三元表达式的类型转化规则判断,最终的返回类型为基础数据类型 double 。所以,当条件表达式 condition 等于 false 时,需要把空对象 value3 转化为基础数据类型 double ,于是就调用了 value3doubleValue 方法抛出了空指针异常。

可以用以下案例验证三元表达式的类型转化规则:

boolean condition = false;
Double value1 = 1.0D;
Double value2 = 2.0D;
Double value3 = null;
Integer value4 = null;
// 返回类型为Double,不抛出空指针异常
Double result1 = condition ? value1 : value3;
// 返回类型为double,会抛出空指针异常
Double result2 = condition ? value1 : value4;
// 返回类型为double,不抛出空指针异常
Double result3 = !condition ? value1 * value2 : value3;
// 返回类型为double,会抛出空指针异常
Double result4 = condition ? value1 * value2 : value3;

2.3.避坑方法

1、尽量避免使用三元表达式,可以采用 if-else 语句代替

如果三元表达式中有算术计算和包装数据类型,可以考虑利用 if-else 语句代替。改写代码如下:

boolean condition = false;
Double value1 = 1.0D;
Double value2 = 2.0D;
Double value3 = null;
Double result;
if (condition) {
   result = value1 * value2;
} else {
   result = value3;
}

2、尽量使用基本数据类型,避免数据类型的自动转化

如果三元表达式中有算术计算和包装数据类型,可以考虑利用 if-else 语句代替。改写代码如下:

boolean condition = false;
double value1 = 1.0D;
double value2 = 2.0D;
double value3 = 3.0D;
double result = condition ? value1 * value2 : value3;

3、进行覆盖性单元测试,尽量把问题发现在研发阶段

像这种问题,只要编写一些单元测试用例,进行一些覆盖性测试,是完全可以提前发现的。

(推荐教程:Java教程

3.泛型对象赋值

Java 泛型是 JDK1.5 中引入的一个新特性,其本质是参数化类型,即把数据类型做为一个参数使用。

3.1.问题现象

在做用户数据分页查询时,因为笔误编写了如下代码:

1、PageDataVO.java

/** 分页数据VO类 */
@Getter
@Setter
@ToString
@NoArgsConstructor
@AllArgsConstructor
public class PageDataVO<T> {
   /** 总共数量 */
   private Long totalCount;
   /** 数据列表 */
   private List<T> dataList;
}

2、UserDAO.java

/** 用户DAO接口 */
@Mapper
public interface UserDAO {
   /** 统计用户数量 */
   public Long countUser(@Param("query") UserQueryVO query);
   /** 查询用户信息 */
   public List<UserDO> queryUser(@Param("query") UserQueryVO query);
}

3、UserService.java

/** 用户服务类 */
@Service
public class UserService {
   /** 用户DAO */
   @Autowired
   private UserDAO userDAO;


   /** 查询用户信息 */
   public PageDataVO<UserVO> queryUser(UserQueryVO query) {
       List<UserDO> dataList = null;
       Long totalCount = userDAO.countUser(query);
       if (Objects.nonNull(totalCount) && totalCount.compareTo(0L) > 0) {
           dataList = userDAO.queryUser(query);
      }
       return new PageDataVO(totalCount, dataList);
  }
}

4、UserController.java

/** 用户控制器类 */
@Controller
@RequestMapping("/user")
public class UserController {
   /** 用户服务 */
   @Autowired
   private UserService userService;


   /** 查询用户 */
   @ResponseBody
   @RequestMapping(value = "/query", method = RequestMethod.POST)
   public Result<PageDataVO<UserVO>> queryUser(@RequestBody UserQueryVO query) {
       PageDataVO<UserVO> pageData = userService.queryUser(query);
       return ResultBuilder.success(pageData);
  }
}

以上代码没有任何编译问题,但是却把 UserDO中一些涉密字段返回给前端。细心的读者可能已经发现了,在 UserService 类的 queryUser 方法的语句" return new PageDataVO(totalCount, dataList);"中,我们把List<UserDO>对象dataList赋值给了PageDataVO<UserVO>List<UserVO>字段dataList

问题是:为什么开发工具不报编译错误啦?

3.2.问题分析

由于历史原因,参数化类型和原始类型需要兼容。我们以 ArrayList 举例子,来看看如何兼容的。

以前的写法:

ArrayList list = new ArrayList();

现在的写法:

ArrayList<String> list = new ArrayList<String>();

考虑到与以前的代码兼容,各种对象引用之间传值,必然会出现以下的情况:

// 第一种情况
ArrayList list1 = new ArrayList<String>();
// 第二种情况
ArrayList<String> list2 = new ArrayList();

所以, Java 编译器对以上两种类型进行了兼容,不会出现编译错误,但会出现编译告警。但是,我的开发工具在编译时真没出现过告警。

再来分析我们遇到的问题,实际上同时命中了两种情况:

1、把 List<UserDO> 对象赋值给 List ,命中了第一种情况;

2、把 PageDataVO 对象赋值给PageDataVO<UserVO> ,命中了第二种情况。

最终的效果就是:我们神奇地把 List<UserDO> 对象赋值给了 List<UserVO>

问题的根源就是:我们在初始化 PageDataVO 对象时,没有要求强制进行类型检查。

3.3.避坑方法

1、在初始化泛型对象时,推荐使用 diamond 语法

在《阿里巴巴 Java 开发手册》中,有这么一条推荐规则:

【推荐】集合泛型定义时,在 JDK7 及以上,使用 diamond 语法或全省略。说明:菱形泛型,即 diamond,直接使用<&来指代前边已经指定的类型。正例:


// <& diamond 方式
HashMap<String, String& userCache = new HashMap<&(16);
// 全省略方式
ArrayList<User& users = new ArrayList(10);

其实,初始化泛型对象时,全省略是不推荐的。这样会避免类型检查,从而造成上面的问题。

在初始化泛型对象时,推荐使用diamond语法,代码如下:

return new PageDataVO<>(totalCount, dataList);

现在,在 Eclipse 的问题窗口中,我们会看到这样的错误:

Cannot infer type arguments for PageDataVO<>

于是,我们就知道忘了把 List<UserDO> 对象转化为 List<UserVO> 对象了。

2、在进行单元测试时,需要对比数据内容

在进行单元测试时,运行正常是一个指标,但数据正确才是更重要的指标。

4.泛型属性拷贝

SpringBeanUtils.copyProperties 方法,是一个很好用的属性拷贝工具方法。

4.1.问题现象

根据数据库开发规范,数据库表格必须包含 idgmt_creategmt_modified 三个字段。其中, id这个字段,可能根据数据量不同,采用 intlong 类型(注意:阿里规范要求必须是 long 类型,这里为了举例说明,允许为 int 或 long 类型)。

所以,把这三个字段抽出来,定义了一个 BaseDO 基类:

/** 基础DO类 */
@Getter
@Setter
@ToString
public class BaseDO<T> {
   private T id;
   private Date gmtCreate;
   private Date gmtModified;
}

针对 user 表,定义了一个 UserDO 类:

/** 用户DO类 */
@Getter
@Setter
@ToString
public class UserDO extends BaseDO<Long>{
   private String name;
   private String description;
}

对于查询接口,定义了一个 UserVO 类:

/** 用户VO类 */
@Getter
@Setter
@ToString
public static class UserVO {
   private Long id;
   private String name;
   private String description;
}

实现查询用户服务接口,实现代码如下:

/** 用户服务类 */
@Service
public class UserService {
   /** 用户DAO */
   @Autowired
   private UserDAO userDAO;


   /** 查询用户 */
   public List<UserVO> queryUser(UserQueryVO query) {
       // 查询用户信息
       List<UserDO> userDOList = userDAO.queryUser(query);
       if (CollectionUtils.isEmpty()) {
           return Collections.emptyList();
      }


       // 转化用户列表
       List<UserVO> userVOList = new ArrayList<>(userDOList.size());
       for (UserDO userDO : userDOList) {
           UserVO userVO = new UserVO();
           BeanUtils.copyProperties(userDO, userVO);
           userVOList.add(userVO);
      }


       // 返回用户列表
       return userVOList;
  }
}

通过测试,我们会发现一个问题——调用查询用户服务接口,用户 ID 的值并没有返回。

[{"description":"This is a tester.","name":"tester"},...]

4.2.问题分析

按道理,UserDO 类和 UserVO 类的 id 字段,类型都是 Long 类型,不存在类型不可转化,应该能够正常赋值。尝试手工赋值,代码如下:

for (UserDO userDO : userDOList) {
   UserVO userVO = new UserVO();
   userVO.setId(userDO.getId());
   userVO.setName(userDO.getName());
   userVO.setDescription(userDO.getDescription());
   userVOList.add(userVO);
}

经过测试,上面代码返回结果正常,用户ID的值成功返回。

那么,就是 BeanUtils.copyProperties 工具方法的问题了。用 Debug 模式运行,进入到 BeanUtils.copyProperties 工具方法内部,得到以下数据:

原来, UserDO 类的 getId 方法返回类型不是 Long类型,而是被泛型还原成了 Object 类型。而下面的 ClassUtils.isAssignable 工具方法,判断是否能够把 Object 类型赋值给 Long 类型,当然会返回 false 导致不能进行属性拷贝。

为什么作者不考虑”先获取属性值,再判断能否赋值”?建议代码如下:

Object value = readMethod.invoke(source);
if (Objects.nonNull(value) && ClassUtils.isAssignable(writeMethod.getParameterTypes()[0], value.getClass())) {
  ... // 赋值相关代码
}

4.3.避坑方法

1、不要盲目地相信第三方工具包,任何工具包都有可能存在问题

Java 中,存在很多第三方工具包,比如:Apachecommons-lang3commons-collectionsGoogleguava …… 都是很好用的第三方工具包。但是,不要盲目地相信第三方工具包,任何工具包都有可能存在问题。

2、如果需要拷贝的属性较少,可以手动编码进行属性拷贝

BeanUtils.copyProperties 反射拷贝属性,主要优点是节省了代码量,主要缺点是导致程序性能下降。所以,如果需要拷贝的属性较少,可以手动编码进行属性拷贝。

3、一定要进行单元测试,一定要对比数据内容

在编写完代码后,一定要进行单元测试,一定要对比数据内容。切莫想当然地认为:工具包很成熟、代码也很简单,不可能出现问题。

5.Set对象排重

Java 语言中, Set 数据结构可以用于对象排重,常见的 Set 类有 HashSetLinkedHashSet 等。

5.1.问题现象

编写了一个城市辅助类,从 CSV 文件中读取城市数据:

/** 城市辅助类 */
@Slf4j
public class CityHelper {
   /** 测试主方法 */
   public static void main(String[] args) {
       Collection<City> cityCollection = readCities2("cities.csv");
       log.info(JSON.toJSONString(cityCollection));
  }


/** 读取城市 */
   public static Collection<City> readCities(String fileName) {
       try (FileInputStream stream = new FileInputStream(fileName);
           InputStreamReader reader = new InputStreamReader(stream, "GBK");
           CSVParser parser = new CSVParser(reader, CSVFormat.DEFAULT.withHeader())) {
           Set<City> citySet = new HashSet<>(1024);
           Iterator<CSVRecord> iterator = parser.iterator();
           while (iterator.hasNext()) {
               citySet.add(parseCity(iterator.next()));
          }
           return citySet;
      } catch (IOException e) {
           log.warn("读取所有城市异常", e);
      }
       return Collections.emptyList();
  }


/** 解析城市 */
   private static City parseCity(CSVRecord record) {
       City city = new City();
       city.setCode(record.get(0));
       city.setName(record.get(1));
       return city;
  }


   /** 城市类 */
   @Getter
   @Setter
   @ToString
   private static class City {
       /** 城市编码 */
       private String code;
       /** 城市名称 */
       private String name;
  }
}

代码中使用 HashSet 数据结构,目的是为了避免城市数据重复,对读取的城市数据进行强制排重。

当输入文件内容如下时:

编码,名称
010,北京
020,广州
010,北京

解析后的 JSON 结果如下:

[{"code":"010","name":"北京"},{"code":"020","name":"广州"},{"code":"010","name":"北京"}]

但是,并没有对城市“北京”进行排重。

5.2.问题分析

当向集合 Set 中增加对象时,首先集合计算要增加对象的 hashCode ,根据该值来得到一个位置用来存放当前对象。如在该位置没有一个对象存在的话,那么集合 Set 认为该对象在集合中不存在,直接增加进去。如果在该位置有一个对象存在的话,接着将准备增加到集合中的对象与该位置上的对象进行 equals 方法比较:如果该 equals 方法返回 false ,那么集合认为集合中不存在该对象,就把该对象放在这个对象之后;如果 equals 方法返回 true ,那么就认为集合中已经存在该对象了,就不会再将该对象增加到集合中了。所以,在哈希表中判断两个元素是否重复要使用到 hashCode 方法和 equals 方法。hashCode 方法决定数据在表中的存储位置,而 equals 方法判断表中是否存在相同的数据。

分析上面的问题,由于没有重写 City 类的 hashCode 方法和 equals 方法,就会采用 Object 类的 hashCode 方法和 equals 方法。其实现如下:

public native int hashCode();
public boolean equals(Object obj) {
   return (this == obj);
}

可以看出:Object 类的 hashCode 方法是一个本地方法,返回的是对象地址;Object 类的 equals 方法只比较对象是否相等。所以,对于两条完全一样的北京数据,由于在解析时初始化了不同的 City 对象,导致 hashCode 方法和 equals 方法值都不一样,必然被 Set 认为是不同的对象,所以没有进行排重。

那么,我们就重写把 City 类的hashCode 方法和 equals 方法,代码如下:

/** 城市类 */
@Getter
@Setter
@ToString
private static class City {
   /** 城市编码 */
   private String code;
   /** 城市名称 */
   private String name;


   /** 判断相等 */
   @Override
   public boolean equals(Object obj) {
       if (obj == this) {
           return true;
      }
       if (Objects.isNull(obj)) {
           return false;
      }
       if (obj.getClass() != this.getClass()) {
           return false;
      }
       return Objects.equals(this.code, ((City)obj).code);
  }


   /** 哈希编码 */
   @Override
   public int hashCode() {
       return Objects.hashCode(this.code);
  }
}

重新支持测试程序,解析后的JSON结果如下:

[{"code":"010","name":"北京"},{"code":"020","name":"广州"}]

结果正确,已经对城市“北京”进行排重。

5.3.避坑方法

1、当确定数据唯一时,可以使用List代替Set

当确定解析的城市数据唯一时,就没有必要进行排重操作,可以直接使用 List 来存储。

List<City> citySet = new ArrayList<>(1024);
Iterator<CSVRecord> iterator = parser.iterator();
while (iterator.hasNext()) {
   citySet.add(parseCity(iterator.next()));
}
return citySet;

2、当确定数据不唯一时,可以使用 Map 代替 Set

当确定解析的城市数据不唯一时,需要安装城市名称进行排重操作,可以直接使用 Map 进行存储。为什么不建议实现 City 类的 hashCode 方法,再采用 HashSet 来实现排重呢?首先,不希望把业务逻辑放在模型 DO 类中;其次,把排重字段放在代码中,便于代码的阅读、理解和维护。

Map<String, City> cityMap = new HashMap<>(1024);
Iterator<CSVRecord> iterator = parser.iterator();
while (iterator.hasNext()) {
   City city = parseCity(iterator.next());
   cityMap.put(city.getCode(), city);
}
return cityMap.values();

3、遵循Java语言规范,重写hashCode方法和equals方法

不重写hashCode方法和equals方法的自定义类不应该在Set中使用。

(推荐微课:Java微课

6.公有方法代理

SpringCGLIB 代理生成的代理类是一个继承被代理类,通过重写被代理类中的非 final 的方法实现代理。所以, SpringCGLIB 代理的类不能是 final 类,代理的方法也不能是final 方法,这是由继承机制限制的。

6.1.问题现象

这里举例一个简单的例子,只有超级用户才有删除公司的权限,并且所有服务函数被 AOP 拦截处理异常。例子代码如下:

1、UserService.java:

/** 用户服务类 */
@Service
public class UserService {
   /** 超级用户 */
   private User superUser;


/** 设置超级用户 */
   public void setSuperUser(User superUser) {
       this.superUser = superUser;
  }


   /** 获取超级用户 */
   public final User getSuperUser() {
       return this.superUser;
  }
}

2、CompanyService.java:

/** 公司服务类 */
@Service
public class CompanyService {
   /** 公司DAO */
   @Autowired
   private CompanyDAO companyDAO;
   /** 用户服务 */
   @Autowired
   private UserService userService;


   /** 删除公司 */
   public void deleteCompany(Long companyId, Long operatorId) {
       // 设置超级用户
       userService.setSuperUser(new User(0L, "admin", "超级用户"));


       // 验证超级用户
       if (!Objects.equals(operatorId, userService.getSuperUser().getId())) {
           throw new ExampleException("只有超级用户才能删除公司");
      }


       // 删除公司信息
       companyDAO.delete(companyId, operatorId);
  }
}

3、AopConfiguration.java:

/** AOP配置类 */
@Slf4j
@Aspect
@Configuration
public class AopConfiguration {
   /** 环绕方法 */
   @Around("execution(* org.changyi.springboot.service..*.*(..))")
   public Object around(ProceedingJoinPoint joinPoint) {
       try {
           log.info("开始调用服务方法...");
           return joinPoint.proceed();
      } catch (Throwable e) {
           log.error(e.getMessage(), e);
           throw new ExampleException(e.getMessage(), e);
      }
  }
}

当我们调用 CompanyService的deleteCompany 方法时,居然也抛出空指针异常(NullPointerException),因为调用 UserService 类的 getSuperUser 方法获取的超级用户为 null 。但是,我们在 CompanyService 类的 deleteCompany 方法中,每次都通过 UserService 类的 setSuperUser 方法强制指定了超级用户,按道理通过 UserService 类的 getSuperUser 方法获取到的超级用户不应该为 null 。其实,这个问题也是由 AOP 代理导致的。

6.2.问题分析

使用SpringCGLIB代理类时,Spring会创建一个名为 UserService$$EnhancerBySpringCGLIB$$????????的代理类。反编译这个代理类,得到以下主要代码:

public class UserService$$EnhancerBySpringCGLIB$$a2c3b345 extends UserService implements SpringProxy, Advised, Factory {
  ......
   public final void setSuperUser(User var1) {
       MethodInterceptor var10000 = this.CGLIB$CALLBACK_0;
       if (var10000 == null) {
           CGLIB$BIND_CALLBACKS(this);
           var10000 = this.CGLIB$CALLBACK_0;
      }


       if (var10000 != null) {
           var10000.intercept(this, CGLIB$setSuperUser$0$Method, new Object[]{var1}, CGLIB$setSuperUser$0$Proxy);
      } else {
           super.setSuperUser(var1);
      }
  }
  ......
}

可以看出,这个代理类继承了 UserService 类,代理了 setSuperUser 方法,但是没有代理 getSuperUser 方法。所以,当我们调用 setSuperUser 方法时,设置的是原始对象实例的 superUser 字段值;而当我们调用 getSuperUser 方法时,获取的是代理对象实例的 superUser 字段值。如果把这两个方法的 final 修饰符互换,同样存在获取超级用户为 null 的问题。

6.3.避坑方法

1、严格遵循 CGLIB 代理规范,被代理的类和方法不要加 final 修饰符

严格遵循 CGLIB 代理规范,被代理的类和方法不要加 final 修饰符,避免动态代理操作对象实例不同(原始对象实例和代理对象实例),从而导致数据不一致或空指针问题。

2、缩小 CGLIB 代理类的范围,能不用被代理的类就不要被代理

缩小 CGLIB 代理类的范围,能不用被代理的类就不要被代理,即可以节省内存开销,又可以提高函数调用效率。

7.公有字段代理

fastjson 强制升级到 1.2.60 时踩过一个坑,作者为了开发快速,在 ParseConfig 中定义了:

public class ParseConfig {
   public final SymbolTable symbolTable = new SymbolTable(4096);
  ......
}

在我们的项目中继承了该类,同时又被 AOP 动态代理了,于是一行代码引起了一场“血案”。

7.1.问题现象

仍然使用上章的例子,但是把获取、设置方法删除,定义了一个公有字段。例子代码如下:

1、UserService.java

/** 用户服务类 */
@Service
public class UserService {
   /** 超级用户 */
   public final User superUser = new User(0L, "admin", "超级用户");
  ......
}

2、CompanyService.java

/** 公司服务类 */
@Service
public class CompanyService {
   /** 公司DAO */
   @Autowired
   private CompanyDAO companyDAO;
   /** 用户服务 */
   @Autowired
   private UserService userService;


   /** 删除公司 */
   public void deleteCompany(Long companyId, Long operatorId) {
       // 验证超级用户
       if (!Objects.equals(operatorId, userService.superUser.getId())) {
           throw new ExampleException("只有超级用户才能删除公司");
      }


       // 删除公司信息
       companyDAO.delete(companyId, operatorId);
  }
}

3、AopConfiguration.java

同上一章 AopConfiguration.java

当我们调用 CompanyService的deleteCompany 方法时,居然抛出空指针异常(NullPointerException)。经过调试打印,发现是 UserServicesuperUser 变量为null。如果把AopConfiguration删除,就不会出现空指针异常,说明这个问题是由AOP代理导致的。

7.2.问题分析

使用 SpringCGLIB 代理类时, Spring 会创建一个名为 UserService$$EnhancerBySpringCGLIB$$????????的代理类。这个代理类继承了 UserService 类,并覆盖了 UserService 类中的所有非 finalpublic 的方法。但是,这个代理类并不调用 super 基类的方法;相反,它会创建的一个成员 userService 并指向原始的 UserService 类对象实例。现在,内存中存在两个对象实例:一个是原始的 UserService 对象实例,另一个指向 UserService 的代理对象实例。这个代理类只是一个虚拟代理,它继承了 UserService 类,并且具有与 UserService 相同的字段,但是它从来不会去初始化和使用它们。所以,一但通过这个代理类对象实例获取公有成员变量时,将返回一个默认值 null

7.3.避坑方法

1、当确定字段不可变时,可以定义为公有静态常量

当确定字段不可变时,可以定义为公有静态常量,并用类名称+字段名称访问。类名称+字段名称访问公有静态常量,与类实例的动态代理无关。

/** 用户服务类 */
@Service
public class UserService {
   /** 超级用户 */
   public static final User SUPER_USER = new User(0L, "admin", "超级用户");
  ......
}


/** 使用代码 */
if (!Objects.equals(operatorId, UserService.SUPER_USER.getId())) {
   throw new ExampleException("只有超级用户才能删除公司");
}

2、当确定字段不可变时,可以定义为私有成员变量

当确定字段不可变时,可以定义为私有成员变量,提供一个公有方法获取该变量值。当该类实例被动态代理时,代理方法会调用被代理方法,从而返回被代理类的成员变量值。

/** 用户服务类 */
@Service
public class UserService {
   /** 超级用户 */
   private User superUser = new User(0L, "admin", "超级用户");
   /** 获取超级用户 */
   public User getSuperUser() {
       return this.superUser;
  }
  ......
}


/** 使用代码 */
if (!Objects.equals(operatorId, userService.getSuperUser().getId())) {
   throw new ExampleException("只有超级用户才能删除公司");
}

3、遵循 JavaBean 编码规范,不要定义公有成员变量

遵循 JavaBean 编码规范,不要定义公有成员变量。JavaBean 规范如下:

(1)JavaBean类必须是一个公共类,并将其访问属性设置为public,如:public class User{......}

(2)JavaBean类必须有一个空的构造函数:类中必须有一个不带参数的公用构造器

(3)一个JavaBean类不应有公共实例变量,类变量都为private,如:private Integer id;

(4)属性应该通过一组getter/setter方法来访问。

(推荐内容:Java面试基础题

后记

人类受益于“类比”思维,举一反三就是人类的智慧,每当遇到新生事物时,人们往往用类似的已知事物作为参考,能够加速对新生事物的认知。而人类又受制于“定势”思维,因为已知事物并不能代表新生事物,而人们又容易形成先入为主的概念,最终导致对新生事物产生误判。

文章来源:公众号–阿里巴巴中间件 ,作者:常意

以上就是W3Cschool编程狮关于Java中常见的一些坑汇总了,希望对大家有所帮助。

如何配置一台适合Java开发的电脑

thbcm阅读(341)

作为一名程序员,一台适合自己使用编程语言的电脑就很关键。接下来 W3Cschool小编 就带你了解一下,如何挑选适合Java开发的电脑。因为我自己家里的主机已经带不动两个 IDEA 了,更别提开个 Docker 啥了,我也搞了一台新的主机,下面是配置:

操作系统  Microsoft Windows 10 专业版 (64位)
CPU  (英特尔)Intel(R) Core(TM) i5-10400 CPU @ 2.90GHz(2904 MHz)
主板  七彩虹 CVN B460M GAMING PRO
内存  32.00 GB ( 2667 MHz)
主硬盘  500 GB (Samsung SSD 970 EVO Plus)
显卡  CPU 核显
显示器  三星 C27R502 32位真彩色 64Hz

价格: 2036(CPU+主板)+ 836(内存)+780(SSD 固态 500G)+220(Thermaltake 启航者 F1 机箱+400W 电源)= ¥ 3872

这个是我挑选的比较经济的配置了,和显示器加起来也就¥ 5000多 。萝卜青菜各有所爱各有所爱,反正我觉得用着还行,前一段 Linus 大神也转 AMD 阵营了,晒出了他 AMD 线程撕裂者的主力机配置,还喷了“牙膏厂”一顿。所以下面的都是我个人的一些观点,如果有大神有其它看法可以留言讨论。

笔记本还是台式机

笔记本还是台式机往往是你买电脑的第一个选项。笔记本的优势是便携性,不管是出差还是去游玩,你都可以把它放包里带出去。可以让你在天台上,草丛中,树林里,越野车中编写你的代码。笔记本的占地空间小,不必担心家里的空间不够用,随时随地哪里都可以放。当然这个是以牺牲了一些性能和扩展性为代价的。

台式机的优势就是性能和可扩展性,它的性价比高,虽然机器比较笨重,但是在性能方面,同样的价钱,是笔记本没有办法比较的。劣势就是没有便携性,只能让你宅在家。选择笔记本还是台式机就看你个人使用场景和习惯了,有能力双持才是王道。

这里如何选择笔记本?首先看预算多少。在满足预算的前提下,然后看模具散热如何,模具不好散热不行的,再高的配置没有用,所以多去搜索相关的信息。

笔记本的 CPU 总体比同型号台式的 CPU 能力要弱一些,所以尽量高配一些,其它的指标可依据下面给出的台式机的一些参考。这里我给出的能让你开发 Java

不卡壳的笔记本不应该低于¥ 6000,越高越好。

下面无论是你自己买硬件装机,还是去电脑城让奸商“坑”,都要简单懂得一些知识。

AMD 还是 Intel

目前来说,Intel 同等 AMD 档次的贵那么一点点。如果没有好恶之分,挑一个自己能接受的价格即可,但是注意,对于开发用的 CPU 怎么来说也得用¥ 1000以上的,没错看性能最直观的就是看钱。

最低 16G 内存

对于开发来说,特别是 Java 开发来说内存必须大一些,不低于16G。你想啊,本来 Java 就比较消耗内存,而且我们使用的 IntelliJ IDEA 还是个内存大户,动不动就占用 2 个 G 的内存。如果你在本机上安装使用数据库、DockerRedisMQ这些东西又需要很多内存,所以16G是一个基本保证,有能力就越大越好。

注意现在的装机的内存都是不低于DDR4DDR5还没有上市)的,同时频率也不应低于2666,购买时请注意甄别。

主板要适配

选主板一定要和你的其它硬件适配,AMDCPU 只能配 AMD 平台的主板,IntelCPU 只能使用 Intel 平台的主板;同时还要看你选择的内存频率是否支持,最大内存数、DDR 代数;还要看看是否支持 M.2 接口(这是为后面买 SSD 固态考虑的);还有就是主板大小一定要和机箱适配,买的时候一定要问清楚这些。

硬盘必须有 SSD

硬盘目前有两种配置风格,一种是 SSD 固态硬盘+机械硬盘,SSD 用来装系统和常用的软件,机械盘用来当数据盘;还有一种就是全 SSD,我目前就是全 SSD

SSD 固态是提高你使用体验最直观的硬件产品了,秒开!秒加载!SSD 接口目前有SATAM.2两种,SATA比较占地方,当然目前主板都支持SATA;而M.2速度更快,但是需要主板的支持。你可以根据需要自行选择这两种方式。

显卡按需购买

CPU 一样,显卡有 N 卡和 A 卡之争。如果你要搞搞机器学习,目前只能买 NVIDIA 独立显卡,而且必须是大内存的高端系列。如果是偶尔玩玩一些游戏,根据你的钱包而定,可以去看看最新的显卡天梯图,别买到比你核显性能还差的“亮机卡”就行。

如果只是搞搞开发,偶尔影音,核显完全够了,可以省下几千块呢。

电源不要买杂牌

电源是个容易被人忽略的东西,什么电源合适呢?首先还是价格,你能出得起的最高的价格一定是好的。但是如果你没用独立显卡却装了个 1000W 的电源也是一种浪费。在没有独立显卡的情况下,一般 350W 足够了,有独立显卡的情况下要考虑下显卡的功耗。

那么其它指标呢?主要从转化率、保护机制上考虑,你不希望一个劣质电源毁了你的电脑吧。所以什么 80 PLUS、主动 PFC、全模组这些特性多多益善。总的来说不要买一些杂牌电源就好,价格建议选择¥ 200以上的。

显示器多多益善

不闪+广角,刷新率能上 120hz 的 IPS 大屏是首选。防蓝光方面显示器有护眼模式。最好能升降,旋转,有条件搞个支架。显示器个数多多益善,一个看文档,一个撸代码,一个看电影,爽飞了。你配的电脑都是为了显示给你看,所以这才是根本。

要装Win10专业版

如果你用 Windows 开发的话建议使用 Win10 专业版,专业版以上才可以使用 Docker。如果用 MacOS,不建议搞黑苹果,驱动太费劲,而且不稳定,很容易崩溃,攒钱买台 Macbook Pro 吧。你也可以试试 UbuntuDeepinLinux 系统,其实它们单纯搞搞开发也是不错的,就是软件生态不友好。

其它

电脑对我们开发来说就是生产力工具,一定要用着顺手,这样才有产出,所以该花的钱一定不要省。

还有个问题就是售后,电子产品一个很重要的就是售后,所以你一定要通过可靠渠道购买,保证售后能够及时跟进不影响你的使用。

(推荐教程:Java教程

文章来源:www.toutiao.com/a6862936059651555854/

以上就是W3Cschool编程狮关于如何配置一台适合Java开发的电脑的相关介绍了,希望对大家有所帮助。

给面试官讲解hashmap底层原理后,他表示很看好我

thbcm阅读(342)

作为一名程序员,你面试的时候肯定被问过HashMap这个知识点,它的基本实现原理是每个面试者都该掌握的,当我们熟练的掌握了HashMap 的内部实现原理。面对面试官的询问,就能应答自如,接下来小编将带大家了解 JDK7 版本的 HashMap基础及其实现原理。

一、 HashMap介绍

HashMap简介: HashMap 是一个散列表,它存储的内容是键值对(key-value)映射。 HashMap 继承于AbstractMap,实现了MapCloneablejava.io.Serializable接口。 HashMap 的实现不是同步的,这意味着它不是线程安全的。它的keyvalue都可以为null。此外,HashMap中的映射不是有序的。 HashMap 的实例有两个参数影响其性能:“初始容量” 和 “加载因子”。容量 是哈希表中桶的数量,初始容量 只是哈希表在创建时的容量。加载因子 是哈希表在其容量自动增加之前可以达到多满的一种尺度。当哈希表中的条目数超出了加载因子与当前容量的乘积时,则要对该哈希表进行rehash操作(即重建内部数据结构),从而哈希表将具有大约两倍的桶数。 通常,默认加载因子是 0.75, 这是在时间和空间成本上寻求一种折衷。加载因子过高虽然减少了空间开销,但同时也增加了查询成本(在大多数 HashMap 类的操作中,包括 getput 操作,都反映了这一点)。在设置初始容量时应该考虑到映射中所需的条目数及其加载因子,以便最大限度地减少 rehash 操作次数。如果初始容量大于最大条目数除以加载因子,则不会发生 rehash 操作。

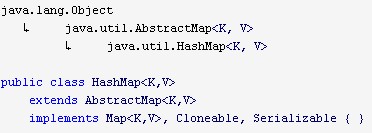
HashMap的继承关系:

HashMap与Map关系如下图

HashMap的构造函数

HashMap共有4个构造函数,如下:

// 默认构造函数。
HashMap()
// 指定“容量大小”的构造函数
HashMap(int capacity)
// 指定“容量大小”和“加载因子”的构造函数
HashMap(int capacity, float loadFactor)
// 包含“子Map”的构造函数
HashMap(Map<? extends K, ? extends V> map)

二、JDK7 中 HashMap 底层原理

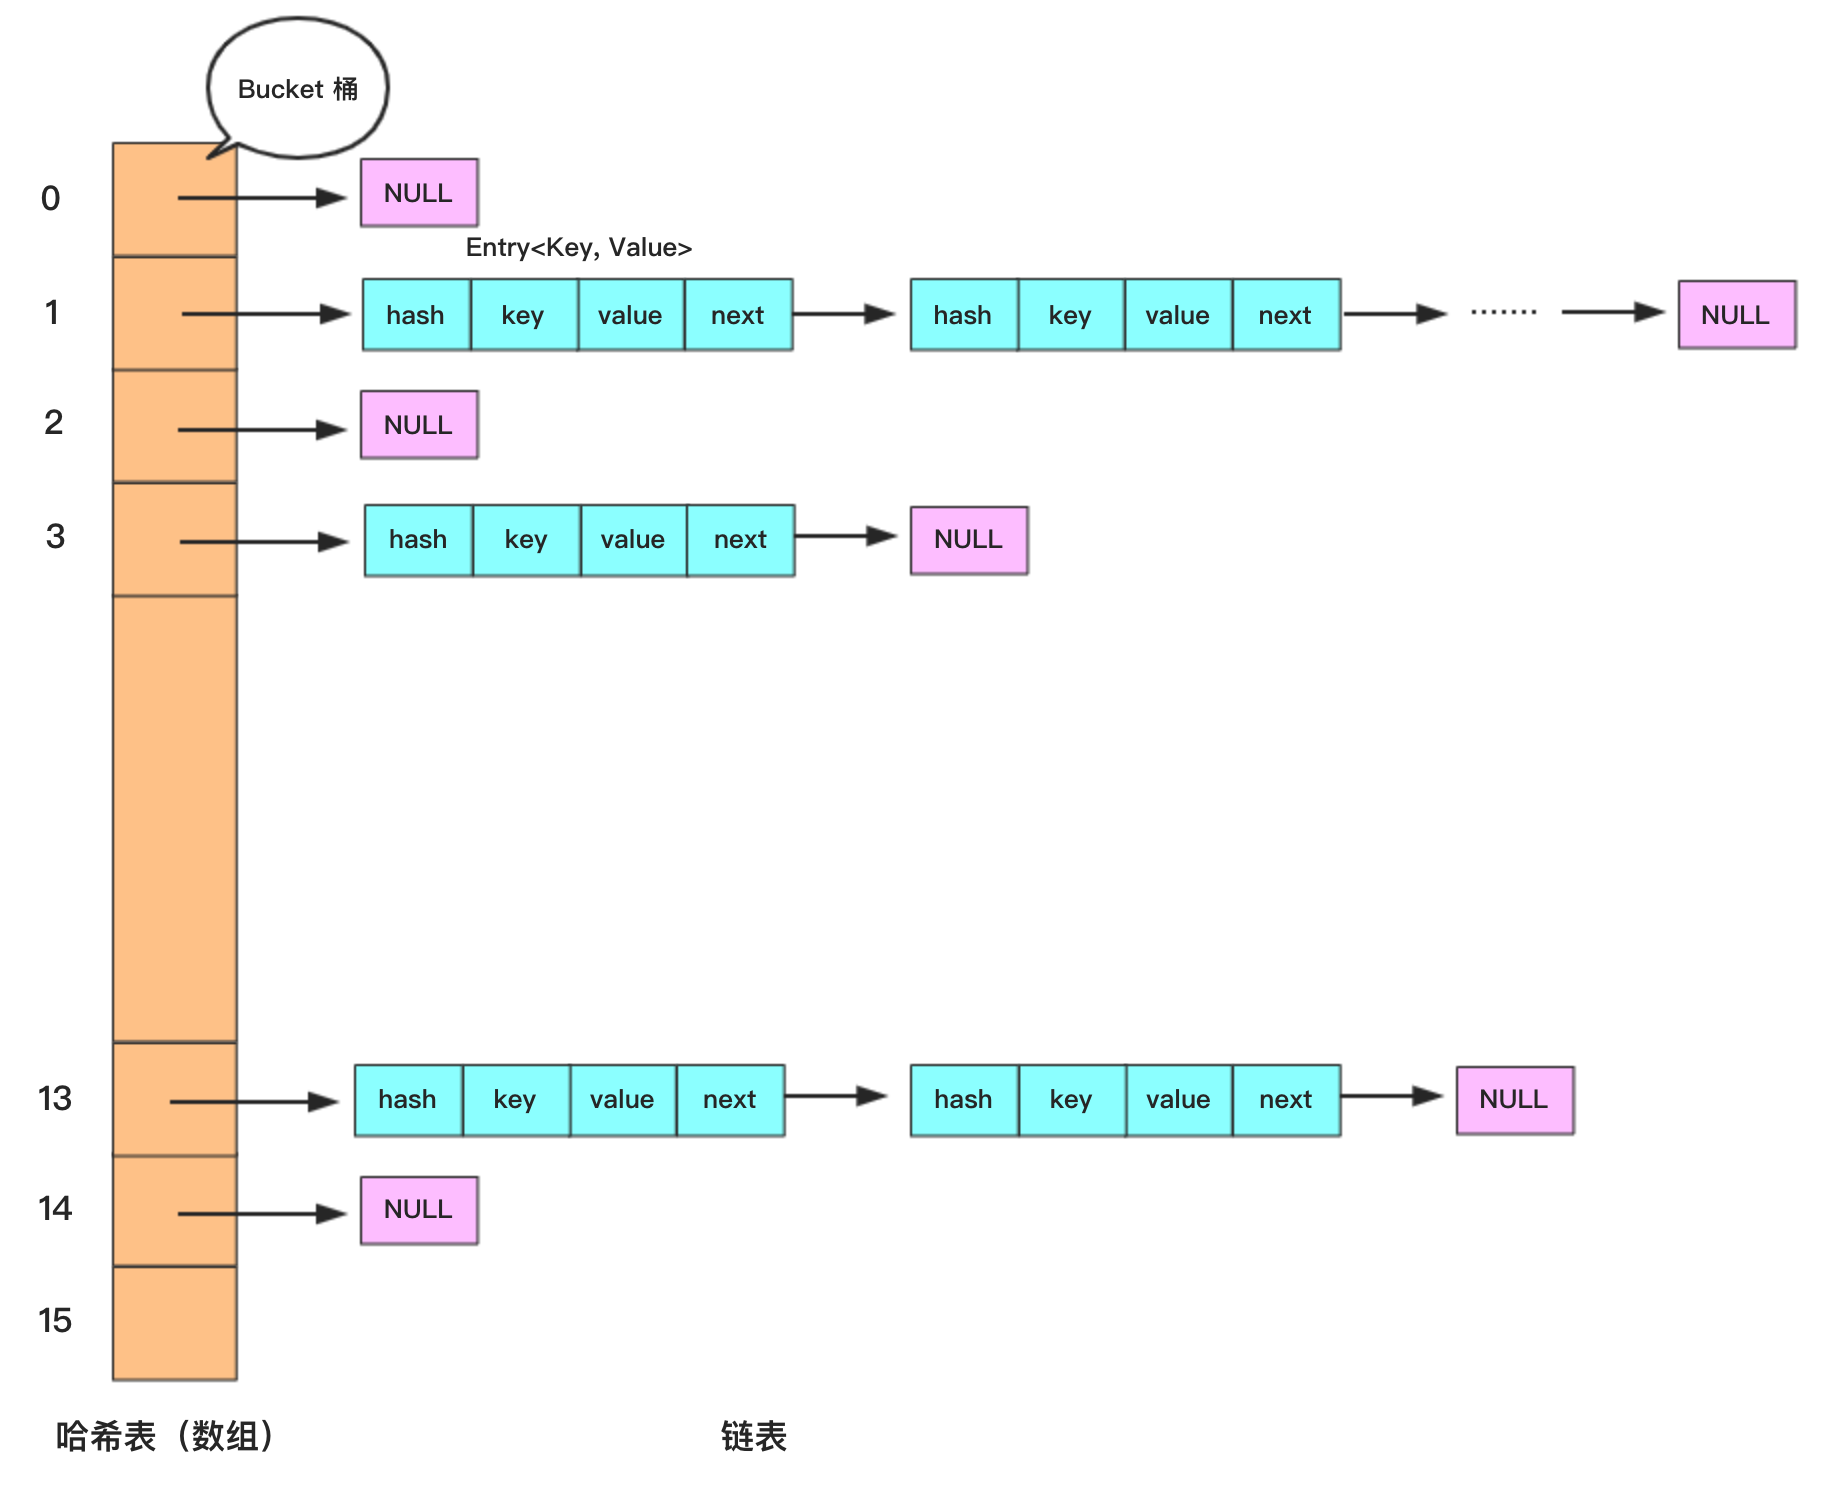
HashMapJDK7 或者 JDK8 中采用的基本存储结构都是数组+链表形式。本节主要是研究 HashMapJDK7 中的底层实现,其基本结构图如下所示:

上图中左边橙色区域是哈希表,右边蓝色区域为链表,链表中的元素类型为 Entry,它包含四个属性分别是:

  • K key
  • V value
  • int hash
  • Entry next

那么为什么会出现数组+链表形式的存储结构呢?这里简单地阐述一下,后续将以源码的形式详细介绍。 我们在使用 HashMap.put("Key", "Value")方法存储数据的时候,底层实际是将keyvalueEntry的形式存储到哈希表中,哈希表是一个数组,那么它是如何将一个 Entry 对象存储到数组中呢?是如何确定当前 keyvalue 组成的 Entry 该存到数组的哪个位置上,换句话说是如何确定 Entry 对象在数组中的索引的呢?通常情况下,我们在确定数组的时候,都是在数组中挨个存储数据,直到数组全满,然后考虑数组的扩容,而 HashMap 并不是这么操作的。在 Java 及大多数面向对象的编程语言中,每个对象都有一个整型变量 hashcode,这个 hashcode 是一个很重要的标识,它标识着不同的对象,有了这个 hashcode,那么就很容易确定 Entry 对象的下标索引了,在 Java 语言中,可以理解 hashcode 转化为数组下标是按照数组长度取模运算的,基本公式如下所示:

int index = HashCode(key) % Array.length

实际上,在 JDK 中哈希函数并没有直接采取取模运算,而是利用了位运算的方式来提高性能,在这里我们理解为简单的取模运算。 我们知道了对 Key 进行哈希运算然后对数组长度进行取模就可以得到当前 Entry 对象在数组中的下标,那么我们可以一直调用 HashMapput 方法持续存储数据到数组中。但是存在一种现象,那就是根据不同的 Key 计算出来的结果有可能会完全相同,这种现象叫作“哈希冲突”。既然出现了哈希冲突,那么发生冲突的这个数据该如何存储呢?哈希冲突其实是无法避免的一个事实,既然无法避免,那么就应该想办法来解决这个问题,目前常用的方法主要是两种,一种是开放寻址法,另外一种是链表法。 开放寻址法是原理比较简单,就是在数组里面“另谋高就”,尝试寻找下一个空档位置。而链表法则不是寻找下一个空档位置,而是继续在当前冲突的地方存储,与现有的数据组成链表,以链表的形式进行存储。HashMap 的存储形式是数组+链表就是采用的链表法来解决哈希冲突问题的。具体的详细说明请继续往下看。 在日常开发中,开发者对于 HashMap 使用的最多的就是它的构造方法、put 方法以及get 方法了,下面就开始详细地从这三个方法出发,深入理解HashMap 的实现原理。

三、HashMap put、get 方法流程图

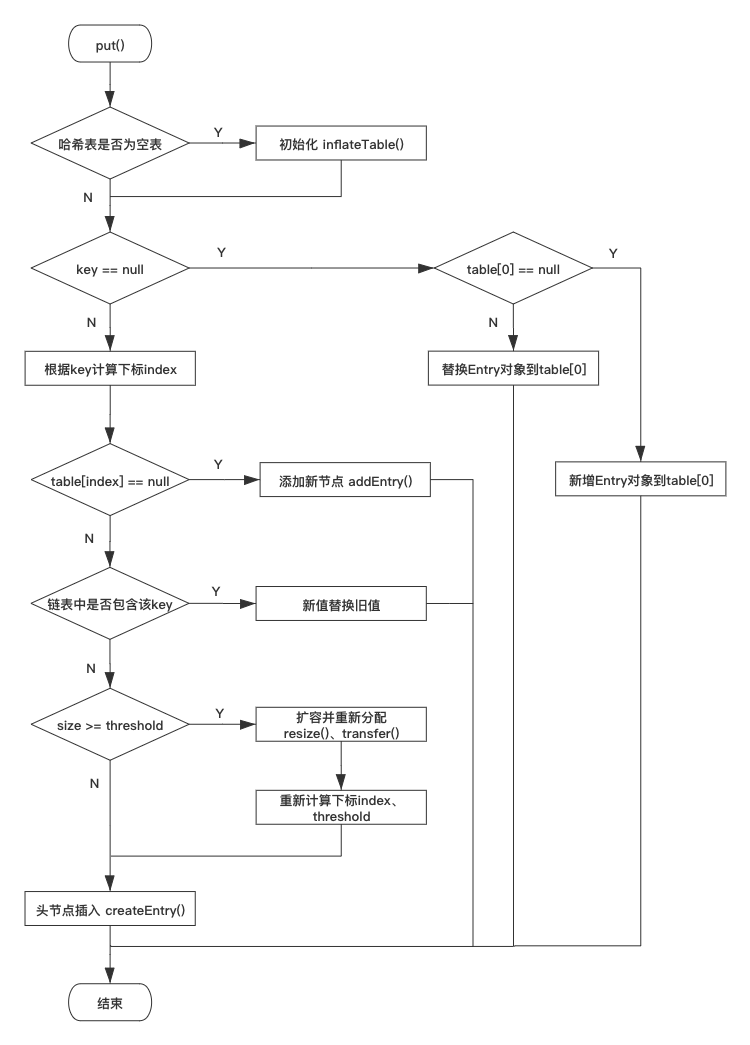
这里提供一个 HashMapput 方法存储数据的流程图供读者参考:

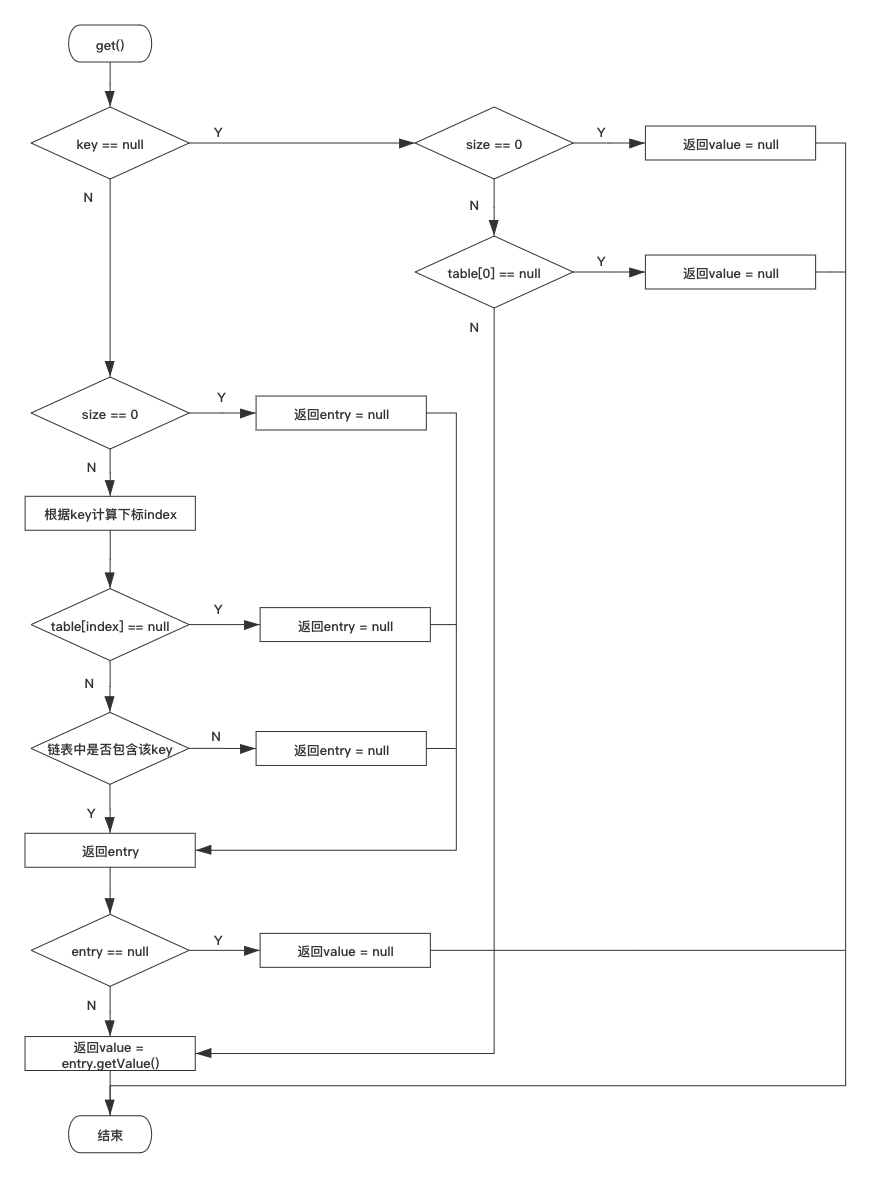
这里提供一个 HashMapget 方法获取数据的流程图供读者参考:

上面中 get 流程图画得稍微比正常的要复杂一些,只是为了描述流程更加清晰。

四、常见的 HashMap 的迭代方式

在实际开发过程中,我们对于 HashMap 的迭代遍历也是常见的操作,HashMap 的迭代遍历常用方式有如下几种:

  • 方式一:迭代器模式
Map<String, String> map = new HashMap<>(16);
Iterator<Map.Entry<String, String>> iterator = map.entrySet().iterator();
while (iterator.hasNext()) {
    Map.Entry<String, String> next = iterator.next();
    System.out.println(next.getKey() + ":" + next.getValue());
}

  • 方式二:遍历 Set>方式
Map<String, String> map = new HashMap<>(16);
for (Map.Entry<String, String> entry : map.entrySet()) {
    System.out.println(entry.getKey() + ":" + entry.getValue());
}

  • 方式三:forEach 方式(JDK8 特性,lambda)
Map<String, String> map = new HashMap<>(16);
map.forEach((key, value) -> System.out.println(key + ":" + value));

  • 方式四:keySet 方式
Map<String, String> map = new HashMap<>(16);
Iterator<String> keyIterator = map.keySet().iterator();
while (keyIterator.hasNext()) {
    String key = keyIterator.next();
    System.out.println(key + ":" + map.get(key));
}

(推荐微课:Java微课

把这四种方式进行比较,前三种其实属于同一种,都是迭代器遍历方式,如果要同时使用到 keyvalue,推荐使用前三种方式,如果仅仅使用到 key,那么推荐使用第四种。

文章来源:www.toutiao.com/a6862688709423137294/

以上就是W3Cschool编程狮关于hashmap底层原理的相关介绍了,希望对大家有所帮助。

Array.apply(),new Array(),arr =[] 三者的区别

thbcm阅读(738)

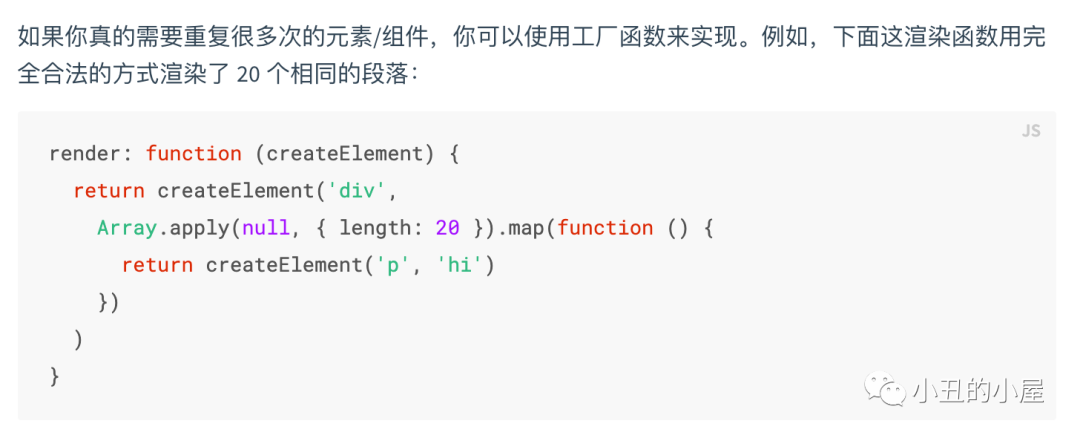
为什么会写这篇文章呢?看Vue文档渲染函数的时候发现一个问题很好奇,Array.apply(null, { length: 20 })为什么这样定义数组?然后查阅资料做了一个小结记录一下,麻雀虽小,五脏俱全。

Array.apply()

apply()在MDN中解释是这样的:

func.apply(thisArg, [argsArray])

thisArg 必选的。在 func 函数运行时使用的 this 值。请注意,this可能不是该方法看到的实际值:如果这个函数处于非严格模式下,则指定为 null 或 undefined 时会自动替换为指向全局对象,原始值会被包装。

argsArray 可选的。一个数组或者类数组对象,其中的数组元素将作为单独的参数传给 func 函数。如果该参数的值为 null 或 undefined,则表示不需要传入任何参数。从ECMAScript 5 开始可以使用类数组对象

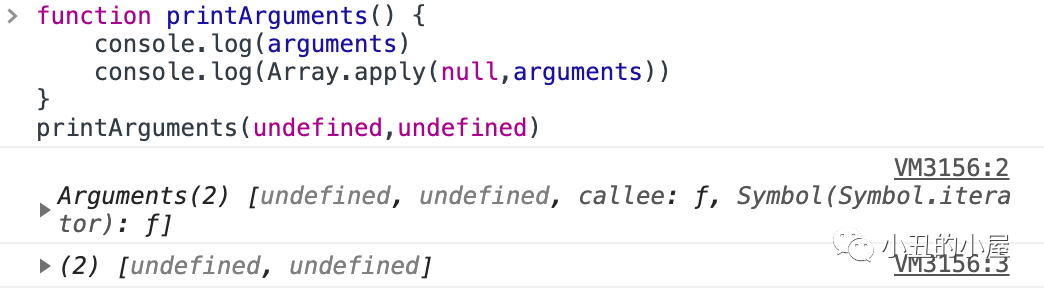
function printArguments() {
    console.log(arguments)
    Array.prototype.forEach.call(arguments, function (item) {
        console.log(item);
    });
}
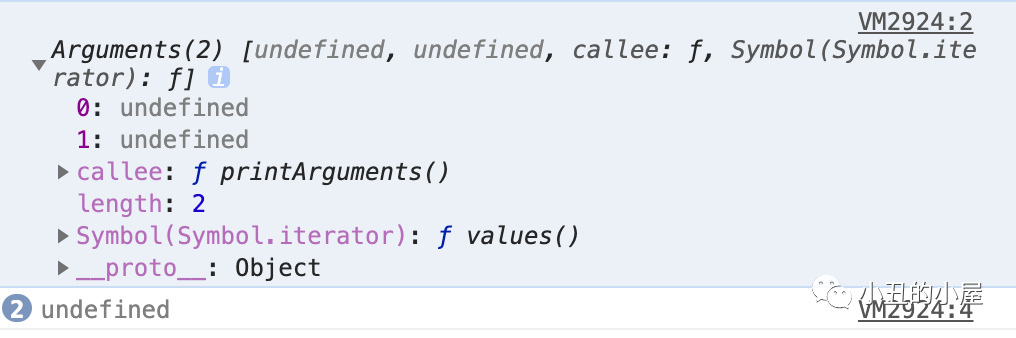
printArguments(undefined,undefined)

由此可见{length:20}是个类数组argument只提供了length的属性相当于创建了一个长度为20,每个元素为undefined的数组

(20) [undefined, undefined, undefined, undefined, undefined, undefined, undefined, undefined, undefined, undefined, undefined, undefined, undefined, undefined, undefined, undefined, undefined, undefined, undefined, undefined]

new Array()

new Array(20)Array(20)只是创建了一个长度为20,元素是空的数组

(20) [empty × 20]

arr = []

let arr=[];
arr.length= 20
(20) [empty × 20]

由此可见new Array(20)let arr=[];arr.length= 20等价

Array.from()

Array.from() 方法从一个类似数组或可迭代对象创建一个新的,浅拷贝的数组实例。

Array.from({length:20})
(20) [undefined, undefined, undefined, undefined, undefined, undefined, undefi

文章来源:公众号–小丑的小屋 作者:小丑

以上就是W3Cschool编程狮关于Array.apply(),new Array(),arr =[] 三者的区别的相关介绍了,希望对大家有所帮助。

前端性能分析工具,Keepfast 发布新版本 v0.6.2

thbcm阅读(373)

Keepfast 是一个性能分析工具,能够分析网站的资源构建性能和页面性能,生成性能报告并提供优化建议,让性能监控更方便。

主要特性:

分析并生成构建性能报告,可直观的对比两个版本的构建性能,以便尽早发现构建性能问题

基于 Lighthouse 对网站进行性能测试,给出各方面性能指标和相关建议

预置 Gitee API 支持,能够在 Gitee 仓库中有新的提交时为其生成一个性能报告,随时跟踪性能指标和得分

Keepfast v0.6.2 发布了,Keepfast 目前已用在码云内部为前端项目提供性能监控支持。

相比上次发布的 v0.2.1 版本,有如下改动:

问题修复

  • 报告文件未正确加载 (d10ef63)
  • 表格数据高亮效果不正确 (074b72d)
  • ps aux 命令在 Windows 上无效 (2241531)
  • 上传错误未被正确捕获 (0bf4f06)
  • 报错时未正确设置进程退出码 (8ff6245)
  • 配置项无法使用 null 作为值 (7c5b77a)

新特性

  • 添加 upload.writer.performance 配置 (1e602bc)
  • 添加 lighthouse.locale 配置 (8473eca)
  • 设置 lighthouse 报告的默认语言为中文 (771f1ac)
  • 添加 –use-message 选项 (78776b9)
  • 添加构建耗时限制 (ef9d242)

以上就是W3Cschool编程狮关于前端性能分析工具,Keepfast 发布新版本 v0.6.2 的相关介绍了,希望对大家有所帮助。

硬核!一文带你深入了解SpringMVC

thbcm阅读(381)

一丶SpringMVC概述

  • Spring 为展现层提供的基于 MVC 设计理念的优秀的Web 框架,是目前最主流的 MVC 框架之一
  • Spring3.0 后全面超越 Struts2,成为最优秀的 MVC 框架
  • Spring MVC 通过一套 MVC 注解,让 POJO 成为处理请求的控制器,而无须实现任何接口。
  • 支持 REST 风格的 URL 请求
  • 采用了松散耦合可插拔组件结构,比其他 MVC 框架更具扩展性和灵活性

二丶SpringMVC简单使用

1)在 web.xml 中配置 DispatcherServlet:

<!-- 配置 DispatcherServlet -->
    <servlet>
        <servlet-name>dispatcherServlet</servlet-name>
        <servlet-class>org.springframework.web.servlet.DispatcherServlet</servlet-class>
        <!-- 配置 DispatcherServlet 的一个初始化参数: 配置 SpringMVC 配置文件的位置和名称 -->
        <!-- 
            实际上也可以不通过 contextConfigLocation 来配置 SpringMVC 的配置文件, 而使用默认的.
            默认的配置文件为: /WEB-INF/<servlet-name>-servlet.xml
        -->
        <init-param>
            <param-name>contextConfigLocation</param-name>
            <param-value>classpath:springmvc.xml</param-value>
        </init-param>
        <load-on-startup>1</load-on-startup>
    </servlet>
    <servlet-mapping>
        <servlet-name>dispatcherServlet</servlet-name>
        <url-pattern>/</url-pattern>
    </servlet-mapping>

2)加入 Spring MVC 的配置文件

<?xml version="1.0" encoding="UTF-8"?>
<beans xmlns="http://www.springframework.org/schema/beans"
    xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
    xmlns:context="http://www.springframework.org/schema/context"
    xmlns:mvc="http://www.springframework.org/schema/mvc"
    xsi:schemaLocation="http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans.xsd
        http://www.springframework.org/schema/context http://www.springframework.org/schema/context/spring-context-4.0.xsd
        http://www.springframework.org/schema/mvc http://www.springframework.org/schema/mvc/spring-mvc-4.0.xsd">


    <!-- 配置自定扫描的包 -->
    <context:component-scan base-package="cbuc.life.springmvc"></context:component-scan>


    <!-- 配置视图解析器: 如何把 handler 方法返回值解析为实际的物理视图 -->
    <bean class="org.springframework.web.servlet.view.InternalResourceViewResolver">
        <property name="prefix" value="/WEB-INF/views/"></property>
        <property name="suffix" value=".jsp"></property>
    </bean>


</beans>

3)编写处理请求的处理器,并使用@Controller 注解标识为处理器

@Controller
public class HelloWorldController {
    /**
       1. 使用 @RequestMapping 注解来映射请求的 URL
       2. 返回值会通过视图解析器解析为实际的物理视图, 对于 InternalResourceViewResolver 视图解析器, 会做如下的解析:
          通过 prefix + returnVal + 后缀 这样的方式得到实际的物理视图, 然会做转发操作
          ==> /WEB-INF/views/success.jsp
     */
    @RequestMapping("/helloworld")
    public String hello(){
        System.out.println("hello world");
        return "success";
    }
}

4) 编写视图 JSP

在/WEB-INF/views/目录下创建一个succes.jsp

<%@ page language="java" contentType="text/html; charset=UTF-8" pageEncoding="UTF-8"%>
<%@ taglib prefix="fmt" uri="http://java.sun.com/jsp/jstl/fmt" %>
<!DOCTYPE html PUBLIC "-//W3C//DTD HTML 4.01 Transitional//EN" "http://www.w3.org/TR/html4/loose.dtd">
<html>
<head>
<meta http-equiv="Content-Type" content="text/html; charset=UTF-8">
<title>Insert title here</title>
</head>
<body>
    <h1>成功跳转页面</h1>
</body>
</html>

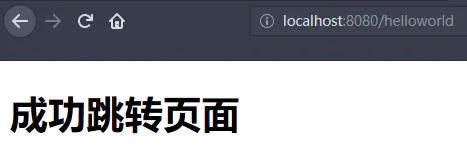
5)将项目运行起来访问 :localhost:8080/hellowoorld

(推荐课程:Spring教程

三丶使用 @RequestMapping 映射请求

  • Spring MVC 使用 @RequestMapping 注解为控制器指定可以处理哪些 URL 请求
  • 在控制器的 定义及方法定义处都可标注
  • 类定义:提供初步的请求映射信息。相对于 WEB 应用的根目录
  • 方法:提供进一步的细分映射信息。相对于类定义处的 URL。若类定义处未标注 @RequestMapping,则方法处标记的 URL 相对于WEB 应用的根目录
  • DispatcherServlet 截获请求后,就通过控制器上@RequestMapping 提供的映射信息确定请求所对应的处理 方法。

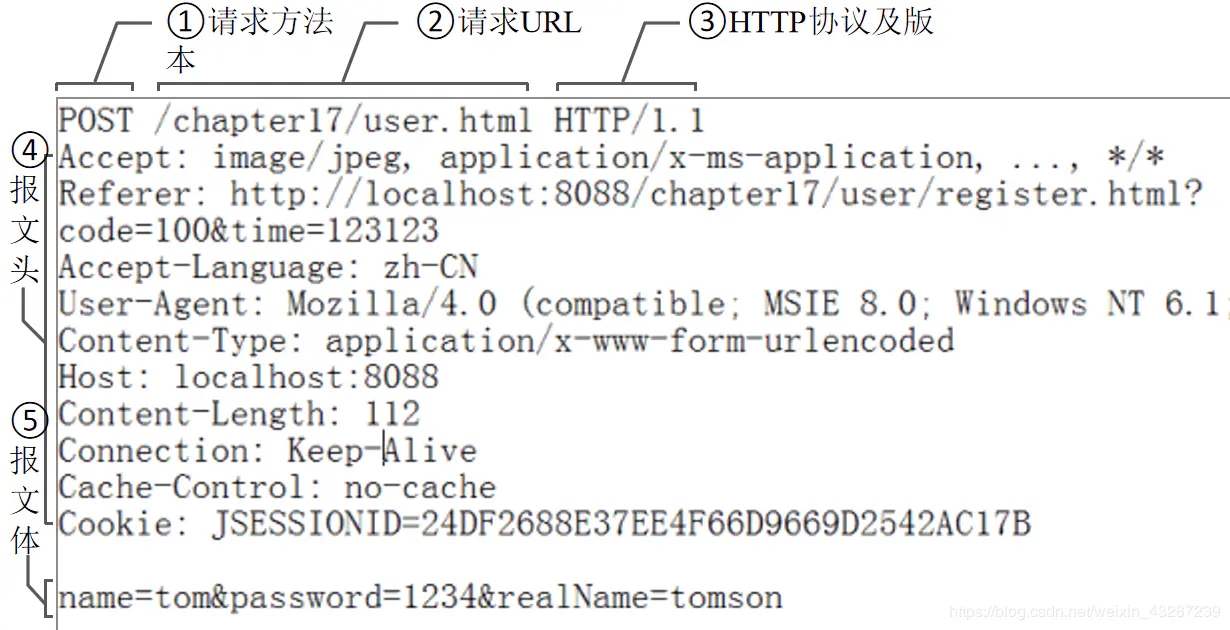
1)标准请求头

2)@RequestMapping

@RequestMapping 的valuemethodparamsheads 分别表示请求 URL请求方法请求参数请求头的映射条件,他们之间是 的关系,联合使用多个条件可让请求映射更加精确化。

/**
     * 可以使用 params 和 headers 来更加精确的映射请求. params 和 headers 支持简单的表达式.
     * 
     * @return
     */
    @RequestMapping(value = "testParamsAndHeaders",
                    params = { "username","age!=10" },
                    headers = { "Accept-Language=en-US,zh;q=0.8" },
                    method = RequestMethod.POST)
    public String test() {
        System.out.println("test...");
        return "success";
    }

3)支持Ant 风格

  • ? :匹配文件名中的一个字符

/user/createUser?

匹配 /user/createUsera 或者 user/createUserb 等 URL

  • * :匹配文件名中的任意字符

/user/*/createUser

匹配 /user/aaa/createUser 或者 /user/bbb/createUser 等 URL

  • ** :匹配多层路径

/user/\/createUser**

匹配 /user/createUser 或者 /user/aaa/bbb/createUser 等 URL

四丶@PathVariable

映射 URL 绑定的占位符

  • 带占位符的 URL 是 Spring3.0 新增的功能,该功能在 SpringMVC 向 REST 目标挺进发展过程中具有里程碑的意义
  • 通过@PathVariable可以将 URL 中占位符参数绑定到控制器处理方法的入参中:URL 中的 {xxx} 占位符可以通过@PathVariable("xxx") 绑定到操作方法的入参中。
/**
 * @PathVariable 可以来映射 URL 中的占位符到目标方法的参数中.
 */
@RequestMapping("/testPathVariable/{id}")
public String test(@PathVariable("id") Integer id) {
    System.out.println("id: " + id);
    return "success";
}
复制代码

五丶REST风格

REST:即 Representational State Transfer。(资源)表现层状态转化。是目前最流行的一种互联网软件架构。它结构清晰、符合标准、易于理解、扩展方便, 所以正得到越来越多网站的采用

示例

  • /order/1 HTTP GET得到 id = 1 的 order 记录
  • /order/1 HTTP DELETE删除 id = 1的 order 记录
  • /order/1 HTTP PUT更新 id = 1的 order 记录
  • /order HTTP POST新增 一条order记录

六丶@RequestParam 绑定请求参数值

  • 在处理方法入参处使用 @RequestParam 可以把请求参数传递给请求方法
  • value:参数名
  • required:是否必须;默认为 true,表示请求参数中必须包含对应的参数,若不存在,将抛出异常
/**
 * @RequestParam 来映射请求参数. value 值即请求参数的参数名 required 该参数是否必须. 默认为 true
 *               defaultValue 请求参数的默认值
 */
@RequestMapping(value = "/testRequestParam")
public String testRequestParam(
        @RequestParam(value = "username") String username,
        @RequestParam(value = "age", required = false, defaultValue = "0") int age) {
    System.out.println("testRequestParam, username: " + username + ", age: " + age);
    return "success";
}

七丶@RequestHeader 绑定请求报头的属性值

/**
 *   映射请求头信息 用法同 @RequestParam
 */
@RequestMapping("/testRequestHeader")
public String testRequestHeader(
        @RequestHeader(value = "Accept-Language") String al) {
    System.out.println("testRequestHeader, Accept-Language: " + al);
    return "success";
}

八丶@CookieValue 绑定请求中的 Cookie 值

/**
 * @CookieValue: 映射一个 Cookie 值. 属性同 @RequestParam
 */
@RequestMapping("/testCookieValue")
public String testCookieValue(@CookieValue("JSESSIONID") String sessionId) {
    System.out.println("testCookieValue: sessionId: " + sessionId);
    return "success";
}

九丶POJO 对象绑定请求参数值

/**
 * Spring MVC 会按请求参数名和 POJO 属性名进行自动匹配, 自动为该对象填充属性值。支持级联属性。
 * 如:dept.deptId、dept.address.tel 等
 */
@RequestMapping("/testPojo")
public String testPojo(User user) {
    System.out.println("testPojo: " + user);
    return "success";
}

十丶MVC 中Handler 方法可以接收的ServletAPI 类型的参数

  • HttpServletRequest
  • HttpServletResponse
  • HttpSession
  • Writer
  • java.security.Principal
  • Locale
  • InputStream
  • OutputStream
  • Reader

(推荐微课:Spring微课)

十一丶处理模型数据

1)ModelAndView

处理方法返回值类型为 ModelAndView时,方法体可通过该对象添加模型数据,ModelAndView中既包含视图信息,也包含模型数据信息

2)Map 及 Model

入参为 org.springframework.ui.Modelorg.springframework.ui.ModelMapjava.uti.Map 时,处理方法返回时,Map 中的数据会自动添加到模型中。

3)@SessionAttributes:

将模型中的某个属性暂存到HttpSession中,以便多个请求之间可以共享这个属性(从session域中获取)

  • 若希望在多个请求之间共用某个模型属性数据,则可以在 控制器上标注一个 @SessionAttributes,Spring MVC 将在模型中对应的属性暂存到 HttpSession 中。
  • @SessionAttributes除了可以通过属性名指定需要放到会话中的属性外,还可以通过模型属性的对象类型指定哪些模型属性需要放到会话中

1)@SessionAttributes(types=User.class): 会将隐含模型中所有类型为 User.class 的属性添加到会话中

2)@SessionAttributes(value={“user1”, “user2”}):会将隐含模型中对象名为user1user2 的属性添加到会话中

3)@SessionAttributes(types={User.class, Dept.class}):会将隐含模型中所有类型为 User.classDept.class 的属性添加到会话中

4)@SessionAttributes(value={“user1”, “user2”}, types={Dept.class}):会将隐含模型中对象名为user1user2 的属性和所有类型为 Dept.class 的属性添加到会话中

4)@ModelAttribute

方法入参标注该注解后, 入参的对象就会放到数据模型中

十二丶@ModelAttribute

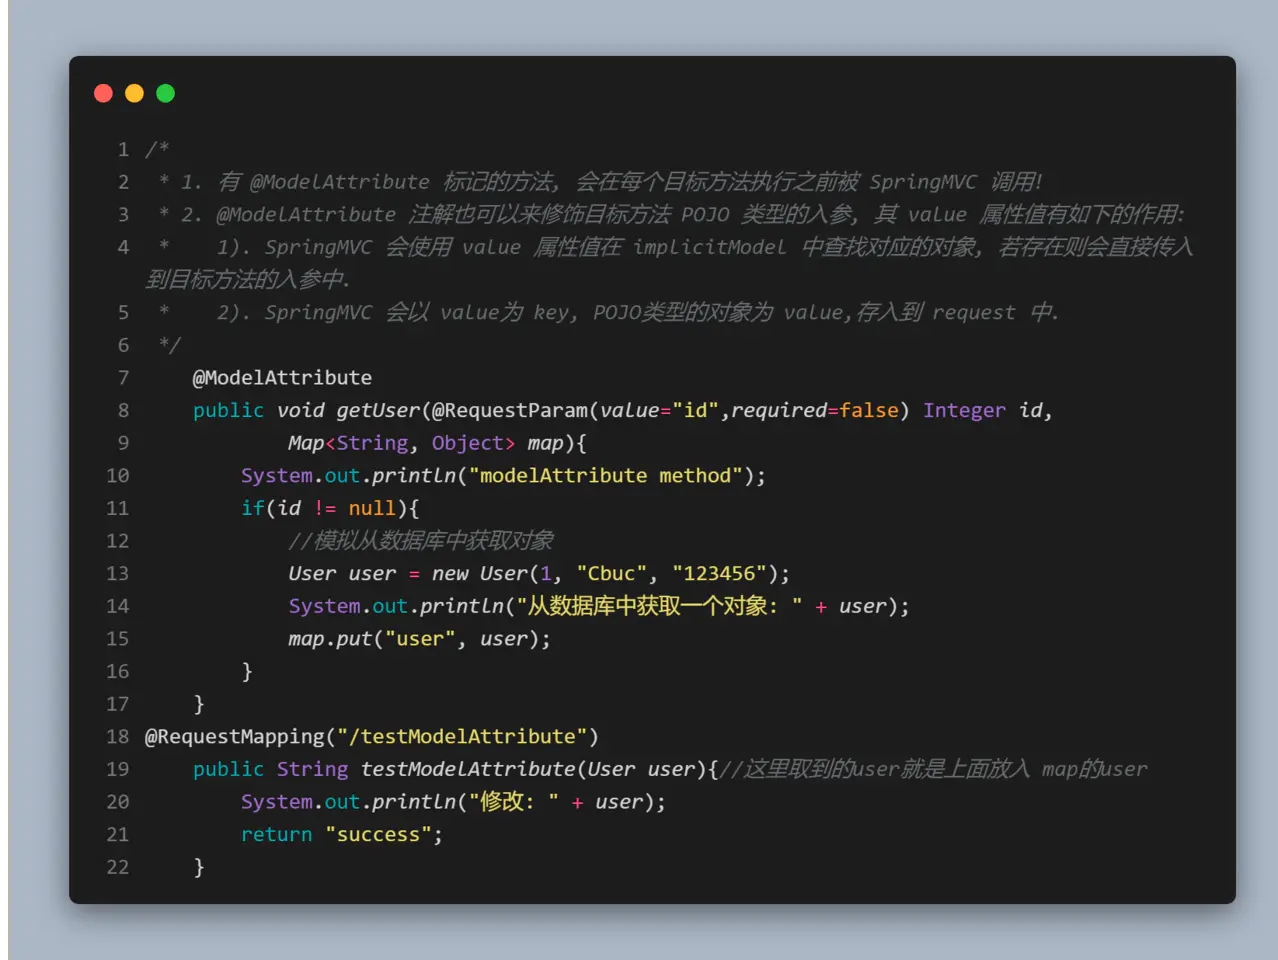
  • 在方法定义上使用 @ModelAttribute 注解:Spring MVC在调用目标处理方法前,会先逐个调用在方法级上标注了@ModelAttribute 的方法。
  • 在方法的入参前使用 @ModelAttribute 注解:
  • 可以从隐含对象中获取隐含的模型数据中获取对象,再将请求参数绑定到对象中,再传入入参
  • 将方法入参对象添加到模型中
示例

十三丶视图和视图解析器

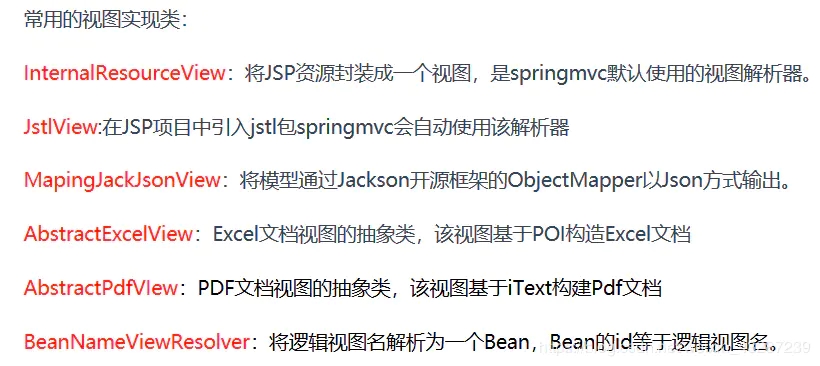
  • 请求处理方法执行完成后,最终返回一个 ModelAndView 对象。对于那些返回 StringViewModeMap 等类型的处理方法,Spring MVC 也会在内部将它们装配成一个 ModelAndView 对象,它包含了逻辑名模型对象的视图
  • Spring MVC 借助视图解析器(ViewResolver)得到最终的视图对象(View),最终的视图可以是 JSP,也可能是 ExcelJFreeChart等各种表现形式的视图。
  • 对于最终究竟采取何种视图对象对模型数据进行渲染,处理器并不关心,处理器工作重点聚焦在生产模型数据的工 作上,从而实现 MVC 的充分解耦。

1)视图

我们只需要实现View这个接口就可以自定义视图

示例

@Component
public class HelloView implements View{
    @Override
    public String getContentType() {
        return "text/html";
    }
    @Override
    public void render(Map<String, ?> model, HttpServletRequest request,
            HttpServletResponse response) throws Exception {
        response.getWriter().print("hello view, time: " + new Date());
    }
}
@RequestMapping("/testView")
    public String testView(){
        System.out.println("testView");
        return "helloView"; //这里返回的就是我们自定义的视图
    }

2)视图解析器

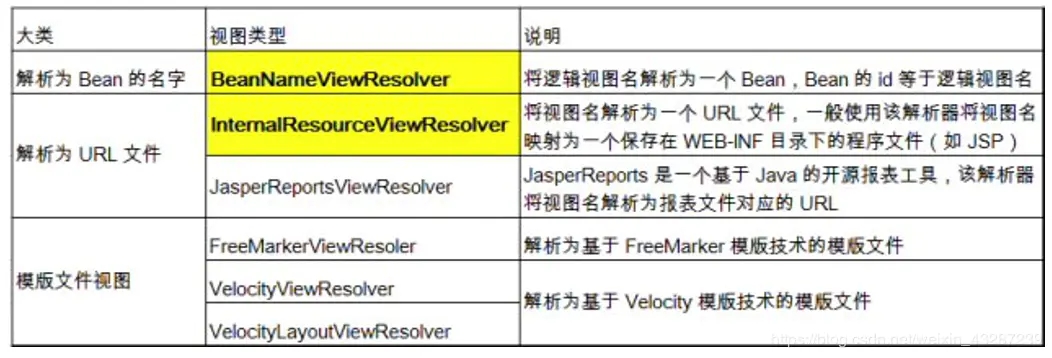
  • SpringMVC 为逻辑视图名的解析提供了不同的策略,可以在 Spring WEB 上下文中配置一种多种解析策略,并指定他们之间的先后顺序。每一种映射策略对应一个具体的视图解析器实现类。
  • 视图解析器的作用比较单一,将逻辑视图解析为一个具体的视图对象
  • 所有的视图解析器都必须实现 ViewResolver 接口。
  • 程序员可以选择一种视图解析器或混用多种视图解析器。
  • 每个视图解析器都实现了Ordered接口并开放出一个 order 属性,可 以通过order 属性指定解析器的优先顺序,order 越小优先级越高
  • SpringMVC 会按视图解析器顺序的优先顺序对逻辑视图名进行解析,直到解析成功并返回视图对象,否则将抛出 ServletException 异常

SpringMVC.xml中的配置

<!-- 配置视图解析器: 如何把 handler 方法返回值解析为实际的物理视图 -->
<bean class="org.springframework.web.servlet.view.InternalResourceViewResolver">
    <property name="prefix" value="/WEB-INF/views/"></property>
    <property name="suffix" value=".jsp"></property>
</bean>


<!-- 配置视图  BeanNameViewResolver 解析器: 使用视图的名字来解析视图 -->
<!-- 通过 order 属性来定义视图解析器的优先级, order 值越小优先级越高 -->
<bean class="org.springframework.web.servlet.view.BeanNameViewResolver">
    <property name="order" value="100"></property>
</bean>

来源:公众号–小菜良记 作者:蔡不菜

以上就是W3Cschool编程狮关于(硬核!一文带你深入了解SpringMVC)的相关介绍了,希望对大家有所帮助。

联系我们