高效终端命令行工具 – 给你的终端美个容

thbcm阅读(299)

文章转载自公众号:若川视野

在我的微信交流群中听闻很多前端没有买mac电脑(比如我),也没有用过ohmyzsh

这篇文章没啥难度,很快就能看完,主要还是希望读者你看完后可以安装开始使用高效终端工具。有了这么强大的终端工具后我发现Windows很好用呀,瞬间感觉都不需要买mac了。

主要就是:

  • 利用WindowsLinux 子系统功能
  • 安装Ubuntu系统,安装ohmyzsh和一些插件
  • 安装windows Terminal工具
  • 安装vscode remote-wsl插件
  • 安装 tig 查看 git 记录

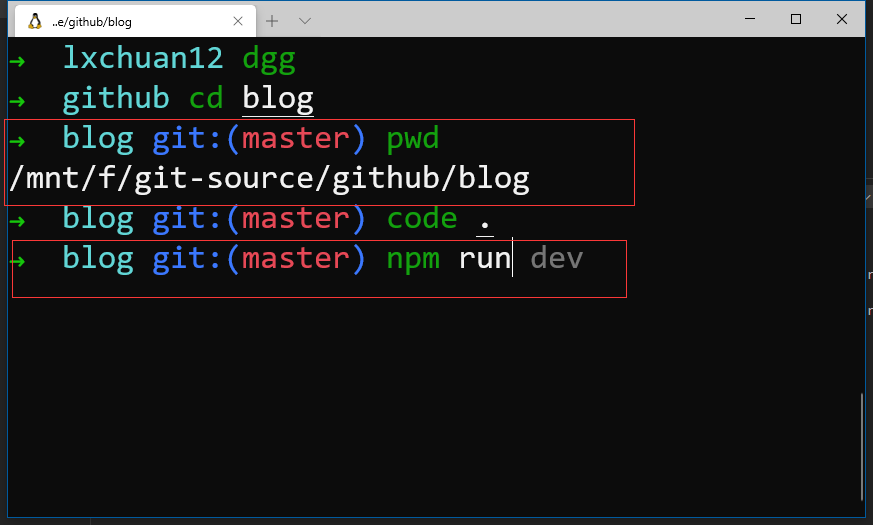
先看下效果。反正我用了ohmyzsh后,离不开了。

windows 安装 Ubuntu 子系统 and 安装 windows Terminal

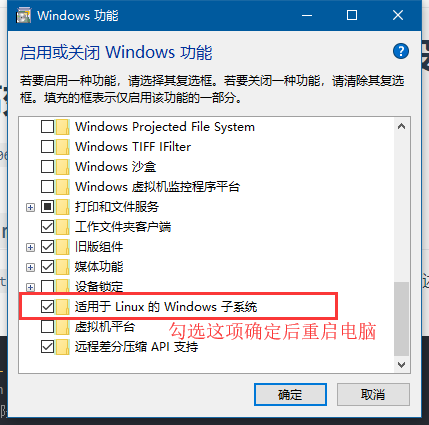
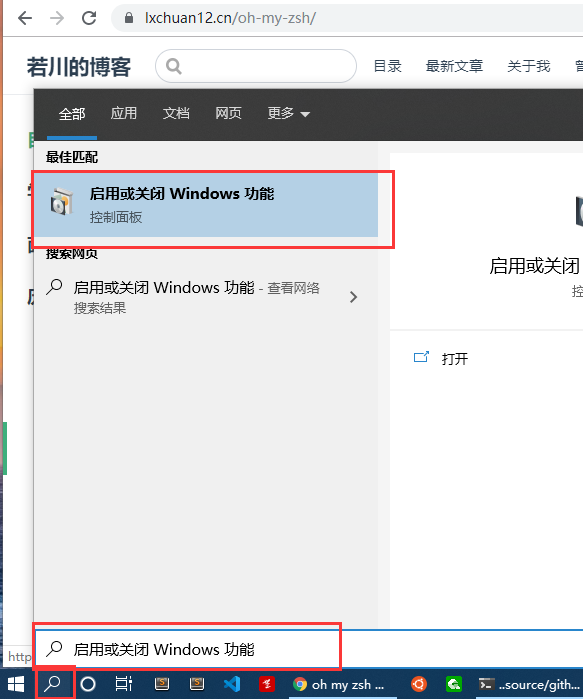
搜索启用或关闭 windows 功能,勾选适用于 LinuxWindows 子系统,确定后重启电脑。

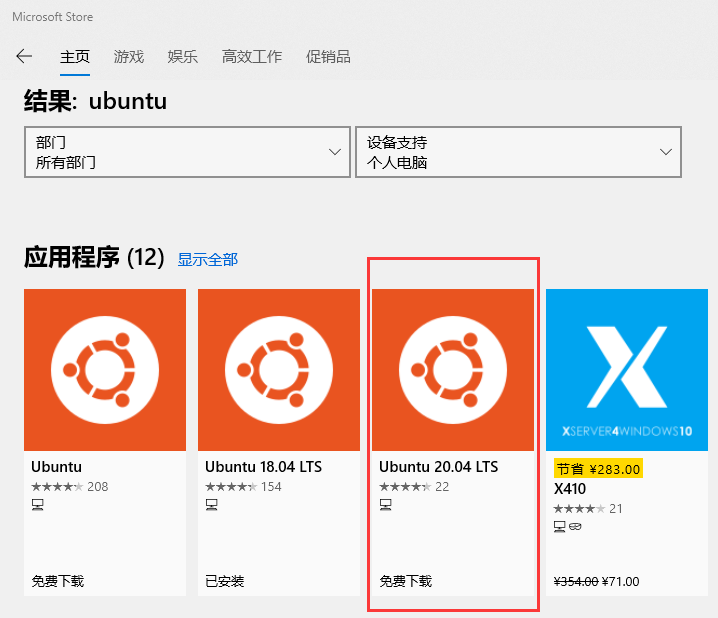
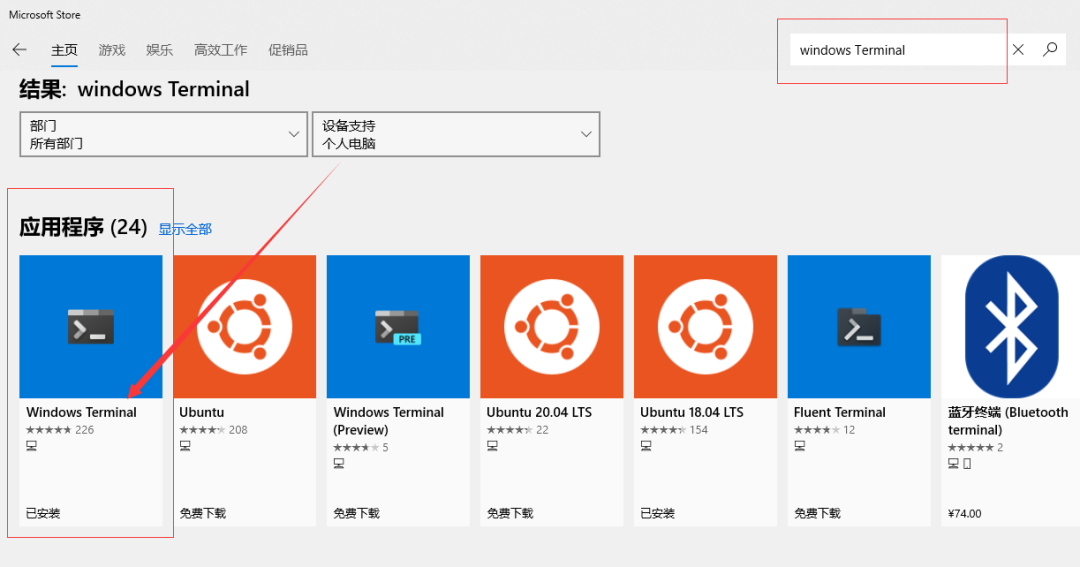
搜索 Ubuntuwindows Terminal 并安装(windows Terminal 可能要求win10系统比较高的版本,一般更新到最新版本即可)

Ubuntu安装好后会要求设置用户名和密码。
建议安装最新版 Ubuntu 20.04
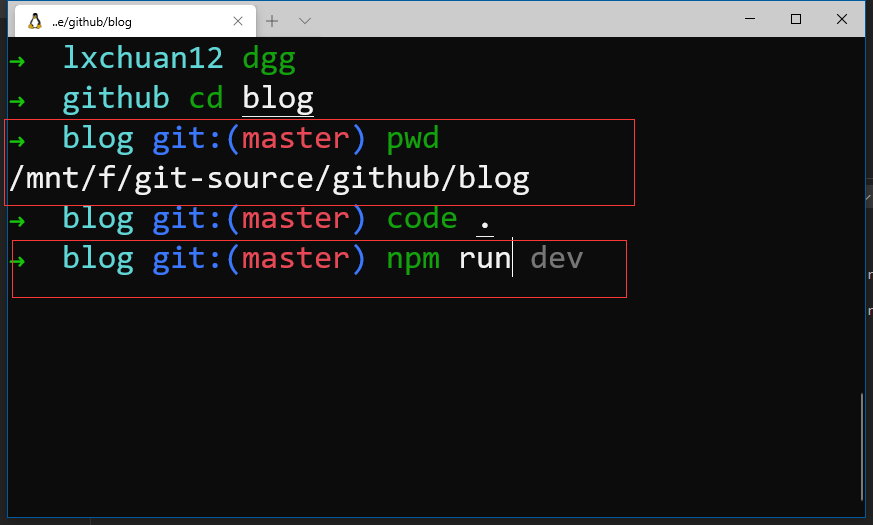
win10安装了ubuntu子系统和oh my zsh后,则可以通过/mnt/f/访问win10下的f盘,或者其他盘。也就有上面的pwd效果图。

安装 vscode remote-wsl 插件

下载安装vscode,并且安装remote-wsl插件。
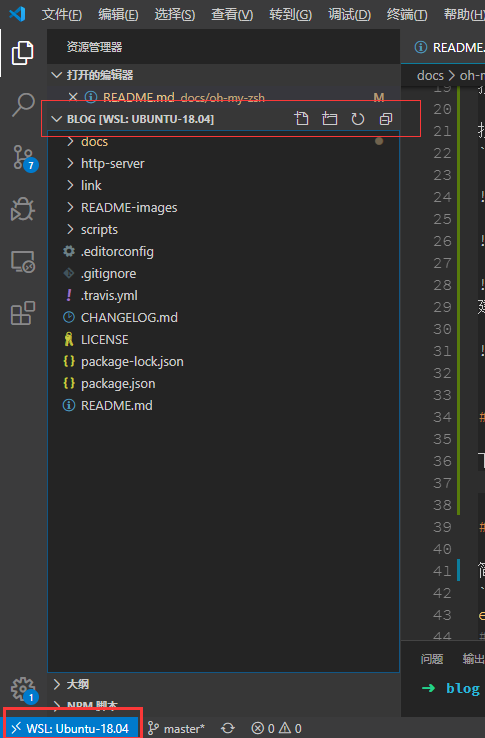
安装 oh my zsh

简述下oh my zshoh my zsh官网的安装方法。github ohmyzsh

安装oh my zsh部分适用于Ubuntumac系统。

echo $SHELL
# /bin/bash 默认是bash
# 查看下有哪些shells
cat /etc/shells
# 安装 zsh
sudo apt-get install zsh -y
# 查看zsh版本
zsh --version
# 5.1.1
# 安装后zsh 后cat /etc/shells 才有/bin/zsh /usr/bin/zsh


# 切换成zsh
chsh -s $(which zsh)
# 或者这条命令
# chsh -s /usr/bin/zsh
# 三种安装方案可供选择:
# Via curl
$ sh -c "$(curl -fsSL https://raw.github.com/ohmyzsh/ohmyzsh/master/tools/install.sh)"


# Via Wget
$ sh -c "$(wget https://raw.github.com/ohmyzsh/ohmyzsh/master/tools/install.sh -O -)"


# 如果上面两种情况还安装不了,可以使用如下方式。


# via git clone
git clone https://github.com/ohmyzsh/ohmyzsh.git ~/.oh-my-zsh
cp ~/.oh-my-zsh/templates/zshrc.zsh-template ~/.zshrc
chsh -s $(which zsh)
# 打开新的终端会应用新的zshrc配置

如果以上三种方式还装不了,可以查看oh my zsh文档

安装成功后,配置信息会在~/.zshrc。可以通过code ~/.zshrc(如果没安装vscode,可以用vim ~/.zshrc)打开编辑zsh配置信息,可以看到默认配置了git 插件Plugin:git。也就是说,可以更加简便的使用git 相关的一些别名。

# 比如
`git status`时,只需要输入`gst`。
`git pull` 时,只需要输入`gl`。
`git push` 时,只需要输入`gp`等等。

是因为配置里有这些简写,还有更多可以查看这里oh my zsh plugin git.plugin.zsh文档配置,github oh my zsh plugin git.plugin.zsh文件地址。安装成功后,同时会创建~/.oh-my-zsh的文件夹,其实就是.oh-my-zshgit 仓库master分支。可以发现文件夹中有一个plugins文件夹,内置了很多插件。可以自定义主题theme,具体可以看example.zsh-theme。custom自定义相关。插件相关会安装在这里,更多可以查看example.plugin.zsh

我暂时安装了这几个插件。

plugins=(
  # 内置插件,启用即可
  git
  cp
  mv
  # 按两下esc键,用sudo权限
  sudo
  # 记录历史输入的zsh命令,自动提示,快速使用
  zsh-autosuggestions
  # zsh 命令高亮
  zsh-syntax-highlighting
)

顺带讲下后面两个插件的安装方法 安装 zsh-autosuggestions

git clone git://github.com/zsh-users/zsh-autosuggestions $ZSH_CUSTOM/plugins/zsh-autosuggestions

安装zsh-syntax-highlighting

git clone https://github.com/zsh-users/zsh-syntax-highlighting.git $ZSH_CUSTOM/plugins/zsh-syntax-highlighting

$ZSH_CUSTOM 其实是个变量,代表这个路径~/.oh-my-zsh/custom, 也就是安装到了这个目录下。还有很多高效插件,等您发掘~oh my zsh官网,不过插件安装多了,感觉会有些卡顿~

# 每次修改了这个`.zshrc`配置文件,需要重载一下,才能生效。
source .zshrc
# 也可以封装成一个简写命令 alias
alias rl='source ~/.zshrc'

也可以在这个配置文件中配置更多alias

# ~/.zshrc
# 比如跳转到工作目录
alias dgg='cd /mnt/f/git-source/github'
# vscode 打开要编辑的文件或文件夹
code blog

这也就是开头的效果图了。
那不是win10,也想通过设置别名来提高效率,是不是就没有办法了呢,可以使用git bash设置alias,安装git,自带git bash

windows git bash 设置别名提高效率

windows 桌面或任意资源管理器位置,右击,选择Git Bash Here,即打开了git bash命令行。先设置下主题,右击选择options, Looks > theme > dracula我选择的是dracula主题,看起来比较舒适。还可以设置字体等。

# 跳转到根路径
cd ~
# 查看下是否有.bash_profile文件
la
# 如果没有.bash_profile文件,需要创建
touch .bash_profile
# 打开编辑 (我这里安装了vscode,所以直接用其打开文件)
code .bash_profile

可以根据修改设置一些别名。比如我们常用的git status命令,可以封装成gst。清屏clear命令封装成cls

alias gst='git status'
alias cls='clear'

每次修改这个文件需要输入source ~/.bash_profile重载这个文件,才会生效。code ~/.bash_profile,用vscode编辑这个配置文件,封装成一个命令。比如:

alias rl='source ~/.bash_profile'
alias bashconfig='code ~/.bash_profile'

这样每次修改保存后就只需要输入rl,即可重载生效了。还可以把一些工作目录封装,我的一些项目是放在/f/git-source/github文件下。

# github上的项目
alias dgg='cd F:/git-source/github'
# 周报相关
alias dcwk='cd F:/git-source/coding/weekly'

每次进入项目,就直接dgg,即可跳转到这个目录,然后选择相应的目录即可。比如dgg进入工作目录,cd analyse-vue-cli进入项目目录,(输入analtab键智能提示)

#  /f/git-source/github/analyse-vue-cli (dev)
# 查看状态 git status
gst
# 用vscode 打开这个文件夹,开始编辑~
code ./

git 相关的, 例举一些平时用的比较多的。

alias g='git'
alias ga='git add'
alias gaa='git add -all'
alias gp='git push'
alias gl='git pull'
alias gcmsg='git commit -m'
# 分支相关
alias gb='git branch'
alias gbr='git branch -r'
alias gba='git branch -a'
# checkout
alias gco='git checkout'
alias gcb='git checkout -b'
# merge
alias gm='git merge'
# diff
alias gd='git diff'
alias gdw='git diff --word-diff'

更多可以把oh my zsh的插件一些命令拷贝过来,留alias相关的即可,oh my zsh plugin git.plugin.zshPlugin:git wiki相当于解锁了oh my zshgit插件。还有很多插件,比如npm点击查看, node 等,都可以研究下。

git bash,有没有类似oh my zsh的插件呢,我暂时没发现,如果您知道,欢迎告诉我。目录相关的操作,也可以设置一些别名。比如:

# 回退到上一级
alias ..='cd ..'
alias ...='cd ../..'
alias ....='cd ../../..'
alias .....='cd ../../../..'
alias ......='cd ../../../../..'

更多别名可以自定义~windows上命令行工具还可以使用cmder点击查看cmder官网命令行工具。虽然我几年前就安装了,但发现还是git bash用的顺畅些,可能是我还不太习惯cmder。关于cmder配置相关,这里推荐晚晴幽草轩轩主的一篇文章:《Win下必备神器之Cmder》

也有cygwin,也是windows命令行工具,也可以安装on my zsh

当然,git也是可以设置别名的。

git设置别名,使用tig神器

# git status => git st
git config --global alias.st status

更多可以查看廖雪峰老师的这篇文章git 配置别名。不过可能大多数人不知道,他们可能用着可视化工具。我觉得可视化工具也是对git的一些封装,具体背后是什么命令,我们还是需要去了解熟悉的。命令行使用git,我推荐使用tiggit log增强版,性能很好。Ubuntulinuxmac可以直接安装,windows稍微麻烦些。具体安装方法查看tig github仓库中的官方安装文档,或者查看这篇文章:颠覆 Git 命令使用体验的神器 — tig

小结

磨刀不误砍柴工,花时间折腾研究工具,有利于提高开发效率。

以上就是W3Cschool编程狮关于高效终端命令行工具 – 给你的终端美个容的相关介绍了,希望对大家有所帮助。
阿里面试官:HashMap 熟悉吧?好的,那就来聊聊 Redis 字典吧!

thbcm阅读(315)

文章转载自公众号:Java极客技术 作者:鸭血粉丝

最近,阿粉的一个朋友出去面试,回来跟阿粉抱怨,面试官不按套路出牌,直接打乱了他的节奏。

事情是这样的,前面面试问了几个 Java 的相关问题,我朋友回答还不错,接下来面试官就问了一句:看来 Java 基础还不错,Java HashMap 你熟悉吧?

我朋友回答。工作经常用,有看过源码。

我朋友本来想着,你随便来吧,这个问题之前已经准备好了,随便问吧。

谁知道,面试官下面一句:

「那好的,我们来聊聊 Redis 字典吧。」

直接将他整蒙逼。

阿粉的朋友由于没怎么研究过 Redis 字典,所以这题就直接回答不知道了。

「当然,如果面试中真不知道,那就回答不了解,直接下一题,不要乱答。」

不过这一题,阿粉觉得还是很可惜,其实 Redis 字典基本原理与 HashMap 差不多,那我们其实可以套用这其中的原理,不求回答满分,但是怎么也可以得个及格分吧~

面试过程真要碰到这个问题,我们可以从下面三个方面回答。

  • 数据结构
  • 元素增加过程
  • 扩容

字典数据结构

说起字典,也许大家比较陌生,但是我们都知道 Redis 本身提供 KV 查询的方式,这个 KV 就是其实通过底层就是通过字典保存。

另外,Redis 支持多种数据类型,其中一种类型为 Hash 键,也可以用来存储 KV 数据。

阿粉刚开始了解的这个数据结构的时候,本来以为这个就是使用字典实现。其实并不是这样的,初始创建 Hash 键,默认使用另外一种数据结构-「ZIPLIST」(压缩列表),以此节省内存空间。

不过一旦以下任何条件被满足,Hash 键的数据结构将会变为字典,加快查询速度。

  • 哈希表中某个键或某个值的长度大于 server.hash_max_ziplist_value (默认值为 64 )。
  • 压缩列表中的节点数量大于 server.hash_max_ziplist_entries (默认值为 512 )。

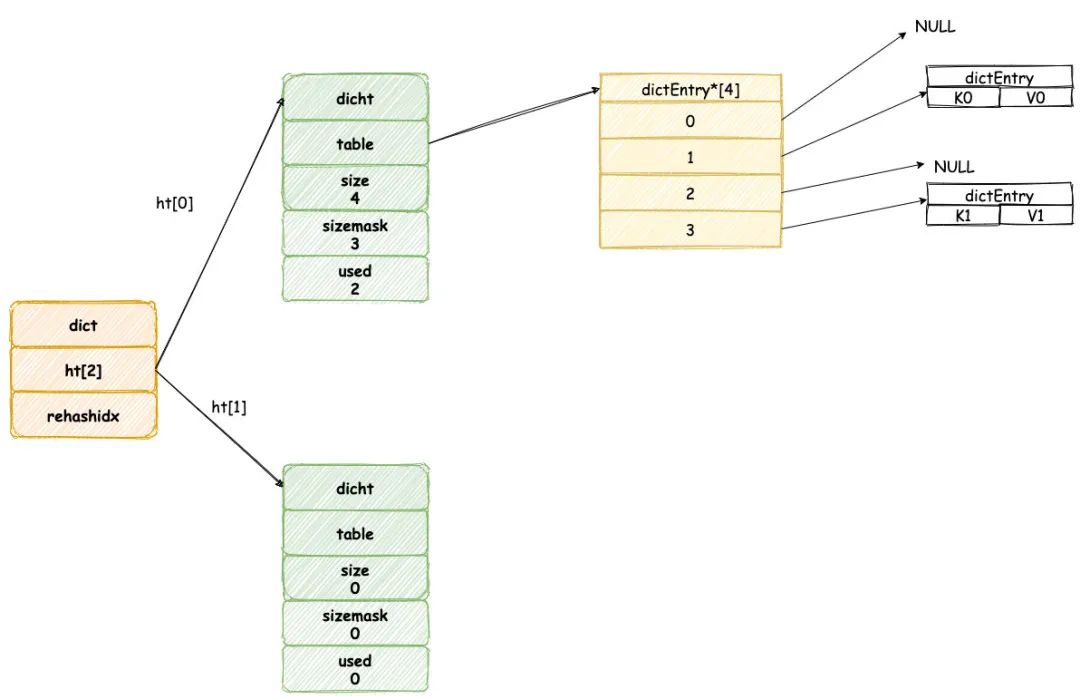
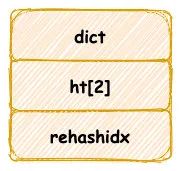
Redis 字典新建时默认将会创建一个哈希表数组,保存两个哈希表。

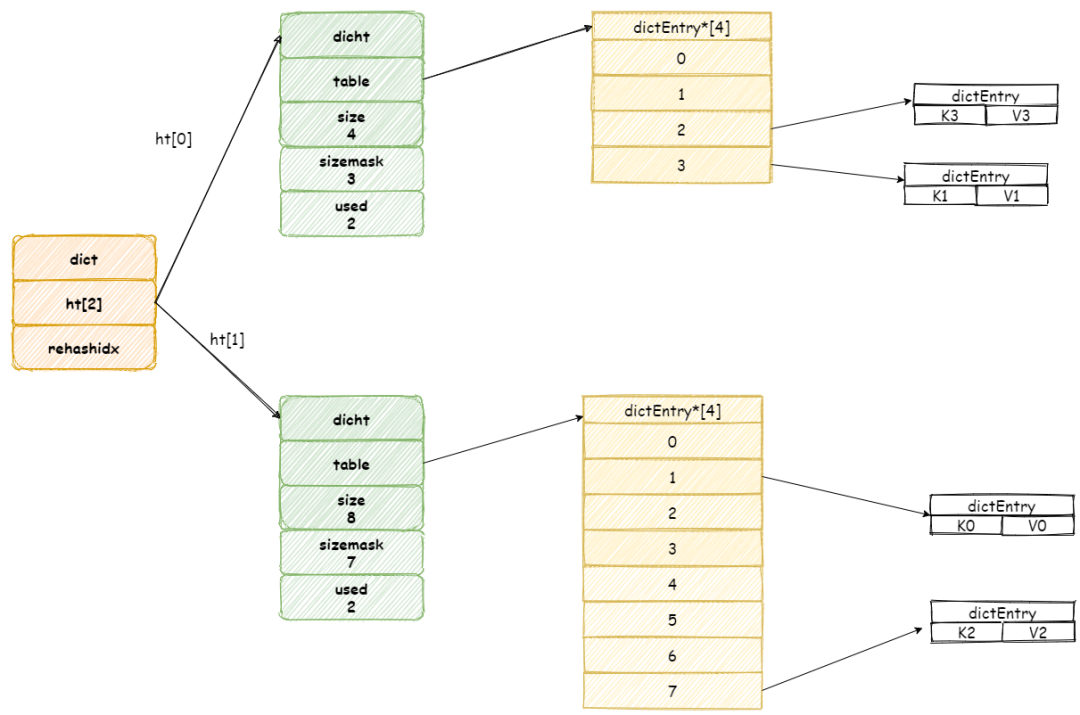
其中 ht[0] 哈希表在第一次往字典中添加键值时分配内存空间,而另一个 ht[1] 将会在下文中扩容/缩容才会进行空间分配。

字典中哈希表其实就等同于Java HashMap,我们知道 Java 采用数组加链表/红黑树的实现方式,其实哈希表也是使用类似的数据结构。

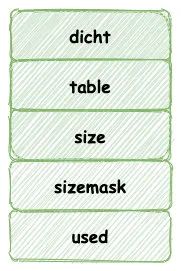
哈希表结构如下所示:

其中 table 属性是个数组, 其中数组元素保存一种 dictEntry的结构,这个结构完全类似与 HashMap 中的 Entry 类型,这个结构存储一个 KV 键值对。

同时,为了解决 hash 碰撞的问题,dictEntry 存在一个 next 指针,指向下一个dictEntry ,这样就形成 dictEntry 的链表。

现在,我们回头对比 JavaHashMap,可以发现两者数据结构基本一致。

只不过 HashMap 为了解决链表过长问题导致查询变慢,JDK1.8 时在链表元素过多时采用红黑树的数据结构。

下面我们开始添加新元素,了解这其中的原理。

元素增加过程

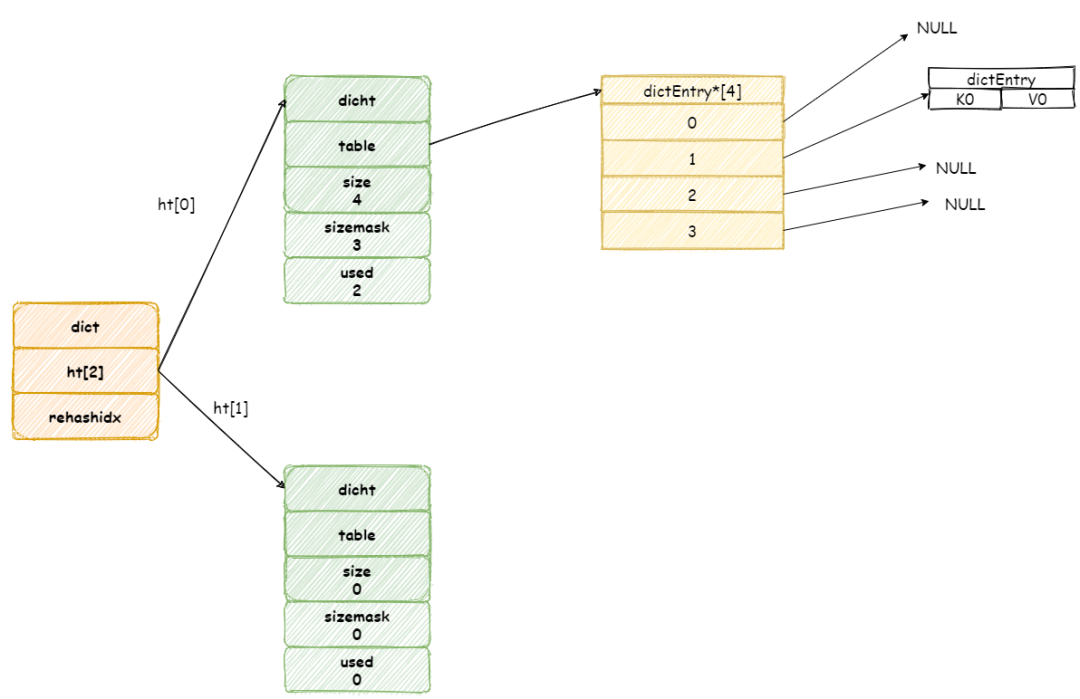
当我们往一个新字典中添加元素,默认将会为字典中 ht[0] 哈希表分配空间,默认情况下哈希表 table 数组大小为 4(「DICT_HT_INITIAL_SIZE」)。

新添加元素的键值将会经过哈希算法,确定哈希表数组的位置,然后添加到相应的位置,如图所示:

继续增加元素,此时如果两个不同键经过哈希算法产生相同的哈希值,这样就发生了哈希碰撞。

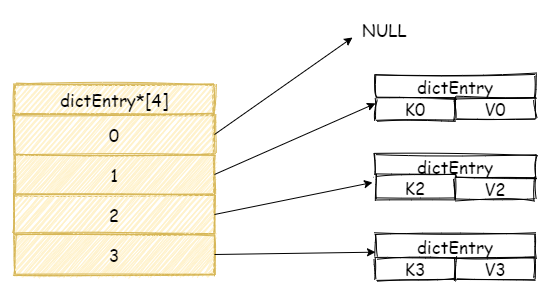
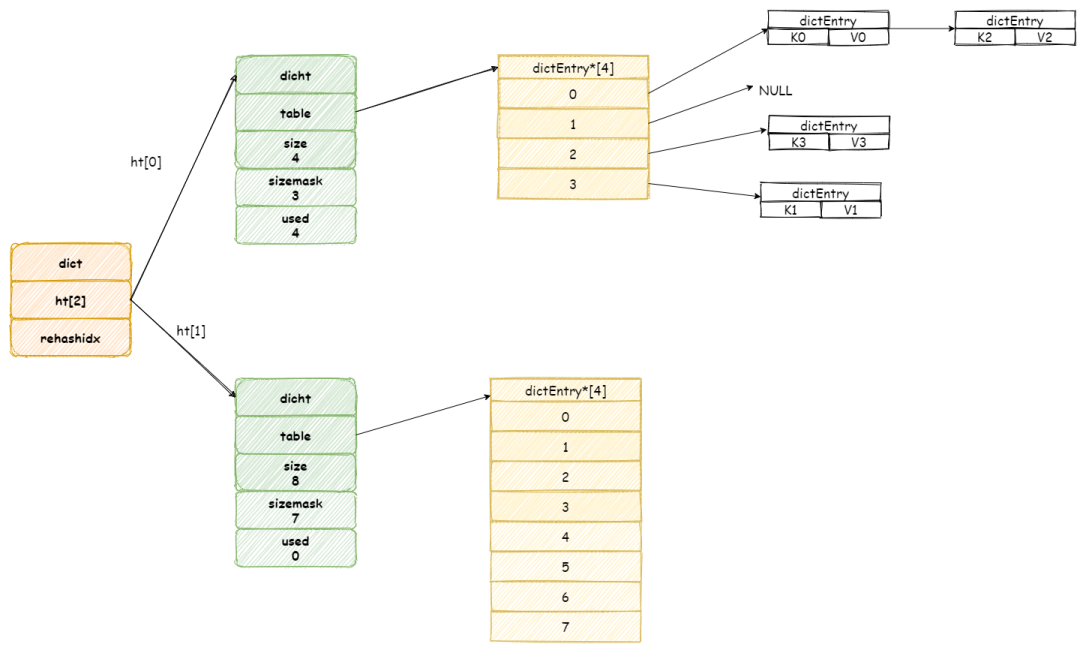
假设现在我们哈希表中拥有是三个元素,:

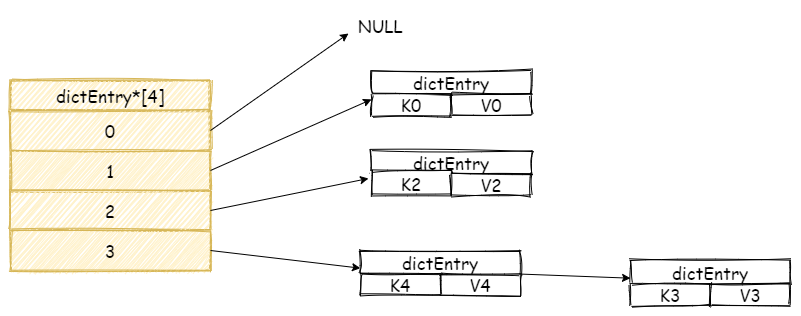
我们再增加一个新元素,如果此时刚好在数组 3 号位置上发生碰撞,此时 Redis 将会采用链表的方式解决哈希碰撞。

「注意,新元素将会放在链表头结点,这么做目的是因为新增加的元素,很大概率上会被再次访问,放在头结点增加访问速度。」

这里我们在对比一下元素添加过程,可以发现 Redis 流程其实与 JDK 1.7 版本的 HashMap 类似。

当我们元素增加越来越多时,哈希碰撞情况将会越来越频繁,这就会导致链表长度过长,极端情况下 O(1) 查询效率退化成 O(N) 的查询效率。

为此,字典必须进行扩容,这样就会使触发字典 rehash 操作。

扩容

当 Redis 进行 Rehash 扩容操作,首先将会为字典没有用到 ht[1]哈希表分配更大空间。

画外音:ht[1] 哈希表大小为第一个大于等于ht[0].used*2 的 2^2(2的n 次方幂)

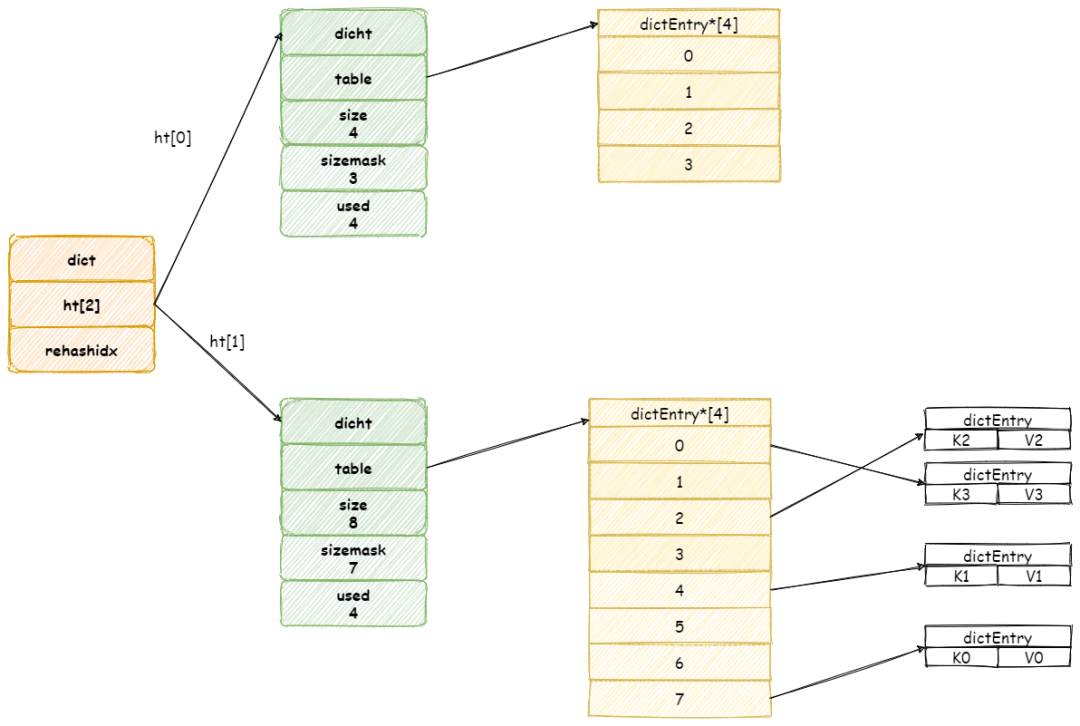
然后再将 ht[0] 中所有键值对都迁移到 ht[1] 中。

简单起见,忽略指向空节点

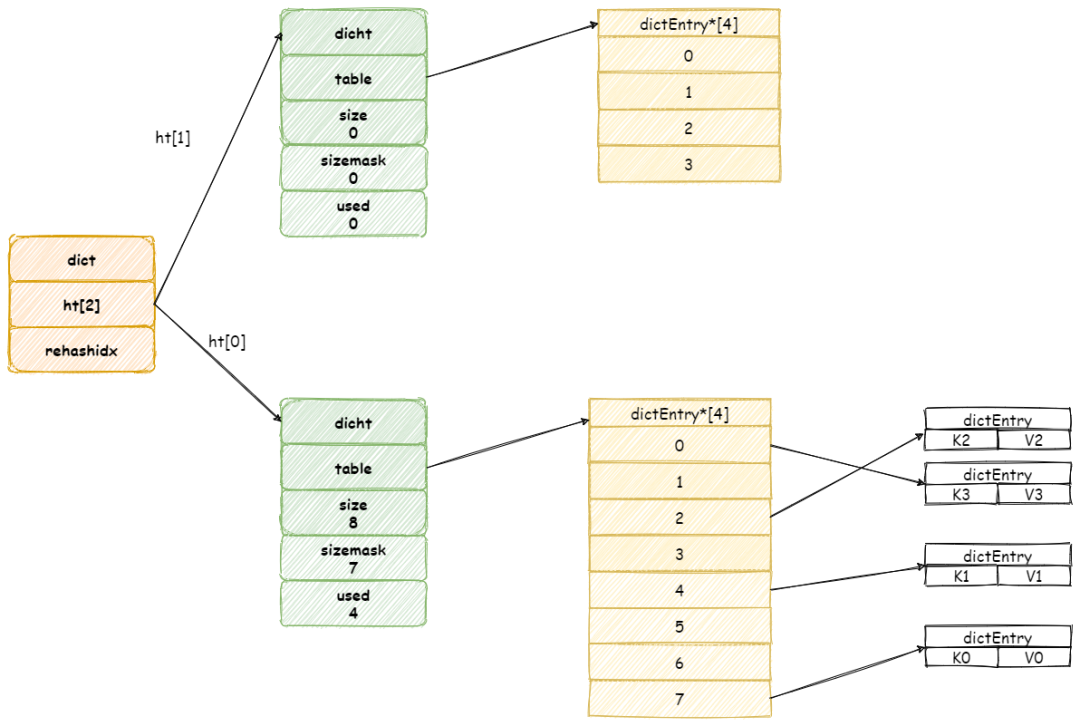
当节点全部迁移完毕,将会释放 ht[0]占用空间,并将 ht[1] 设置为 ht[0]

扩容 操作需要将 ht[0]所有键值对都 Rehashht[1] 中,如果键值过多,假设存在十亿个键值对,这样一次性的迁移,势必导致服务器会在一段时间内停止服务。

另外如果每次 rehash 都会阻塞当前操作,这样对于客户端处理非常不友好。

为了避免 rehash对服务器的影响,Redis 采用渐进式的迁移方式,慢慢将数据迁移分散到多个操作步骤。

这个操作依赖字典中一个属性 rehashidx,这是一个索引位置计数器,记录下一个哈希表 table 数组上元素,默认情况为值为 「-1」

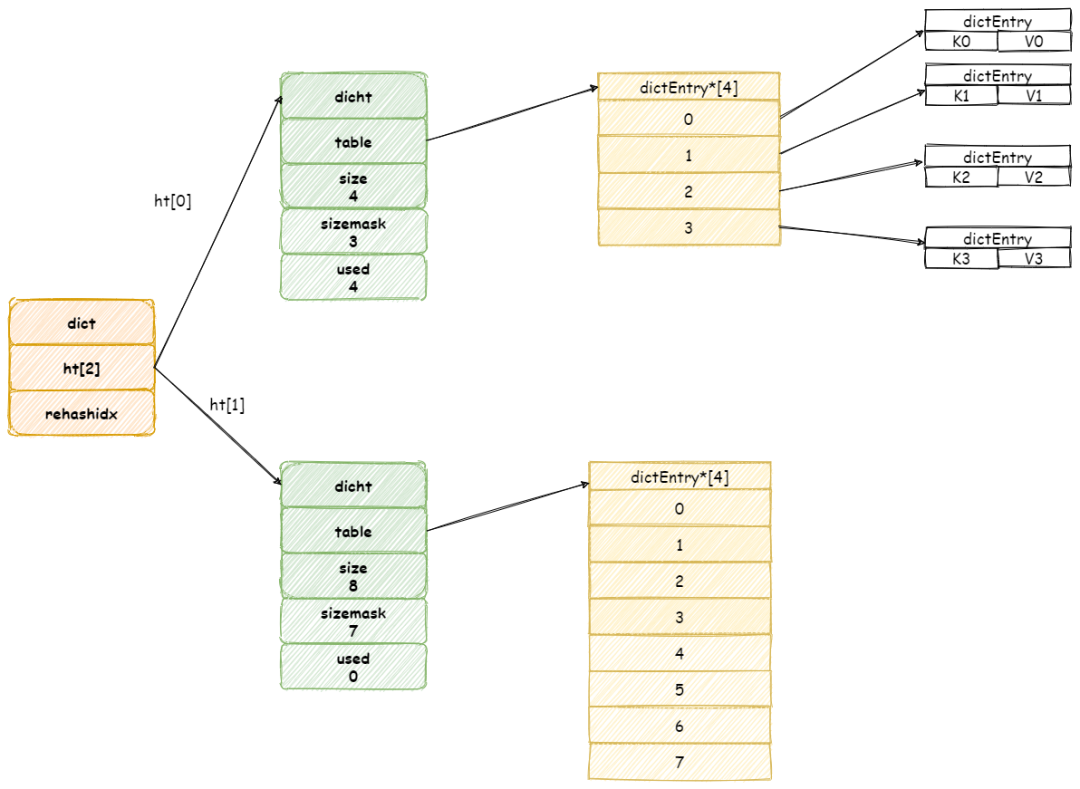
假设此时扩容前字典如图所示:

当开始 rehash 操作,rehashidx将会被设置为 「0」

这个期间每次收到增加,删除,查找,更新命令,除了这些命令将会被执行以外,还会顺带将 ht[0]哈希表在 rehashidx 位置的元素 rehash 到 ht[1] 中。

假设此时收到一个 「K3」 键的查询操作,Redis 首先执行查询操作,接着 Redis 将会为 ht[0]哈希表上table 数组第 rehashidx索引上所有节点都迁移到 ht[1] 中。

当操作完成之后,再将 rehashidx 属性值加 1。

最后当所有键值对都 rehashht[1]中时,rehashidx将会被重新设置为 -1。

虽然渐进式的 rehash 操作减少了工作量,但是却带来键值操作的复杂度。

这是因为在渐进式 rehash 操作期间,Redis 无法明确知道键到底在ht[0]中,还是在 ht[1] 中,所以这个时候 Redis 不得不查找两个哈希表。

以查找为例,Redis 首先查询 ht[0] ,如果没找到将会继续查找 ht[1],除了查询以外,更新,删除也会执行如上的操作。

添加操作其实就没这么麻烦,因为ht[0]不会在使用,那就统一都添加到 ht[1] 中就好了。

最后我们再对比一下 Java HashMap 扩容操作,它是一个一次性操作,每次扩容需要将所有键值对都迁移到新的数组中,所以如果数据量很大,消耗时间就会久。

总结

Redis 字典使用哈希表作为底层实现,每个字典包含两个哈希表,一个平时使用,一个仅在 rehash 操作中使用。

哈希表总的来说,跟 Java HashMap 真的很类似,底层实现也是一个数组加链表数据结构。

最后,当对哈希表进行扩容操作时间,将会采用渐进性 rehash 操作,慢慢将所有键值对迁移到新哈希表中。

其实了解 Redis 字典的其中的原理,再去比较 Java HashMap ,其实可以发现这两者有如此多的相似点。

所以学习这类知识时,不要仅仅去背,我们要了解其底层原理,知其然知其所以然。

以上就是W3Cschool编程狮关于阿里面试官:HashMap 熟悉吧?好的,那就来聊聊 Redis 字典吧!的相关介绍了,希望对大家有所帮助。
Vue 3.0 有了它,Vuex或许可以提前退休了

thbcm阅读(273)

文章转载自公众号:code秘密花园

Vuex 是一个很棒的状态管理库。它很简单,并与 Vue 集成的非常好。为什么会有人放弃Vuex ? 原因可能是即将发布的 Vue3 版本公开了底层的响应式系统,并介绍了构建应用程序的新方法。新的响应式系统非常强大,它可以直接用于集中的状态管理。

你需要状态共享吗?

在某些情况下,多个组件之间的数据流转变得非常困难,因此需要集中的状态管理。这些情况包括:

  • 多个组件使用相同数据的
  • 组件深嵌套

如果以上情况都不成立,答案很简单,你不再需要状态共享了。

但是,如果你有以上一种情况呢?最直接的答案就是使用 Vuex 。这是一个久经考验的解决方案,而且效果不错。

但是,如果你不想添加其他依赖项或发现设置过于复杂怎么办?新的Vue3 版本以及 Composition API 可以通过其内置方法解决这些问题。

新的解决方案

共享状态必须符合两个条件:

  • 响应式:当状态改变时,使用它们的组件也应更新
  • 可用性:可以在任何组件中访问状态

响应式

Vue3 通过众多功能公开了其响应式系统。你可以使用 reactive 函数创建响应式变量(替代方法是 ref 函数)。

import { reactive } from 'vue';


export const state = reactive({ counter: 0 });

reactive 函数返回的 Proxy 对象是可以跟踪其属性更改的对象。在组件模板中使用时,当响应值发生更改时,组件都会重新渲染。

<template>
  <div>{{ state.counter }}</div>
  <button type="button" @click="state.counter++">Increment</button>
</template>


<script>
  import { reactive } from 'vue';


  export default {
    setup() {
      const state = reactive({ counter: 0 });
      return { state };
    }
  };
</script>

可用性

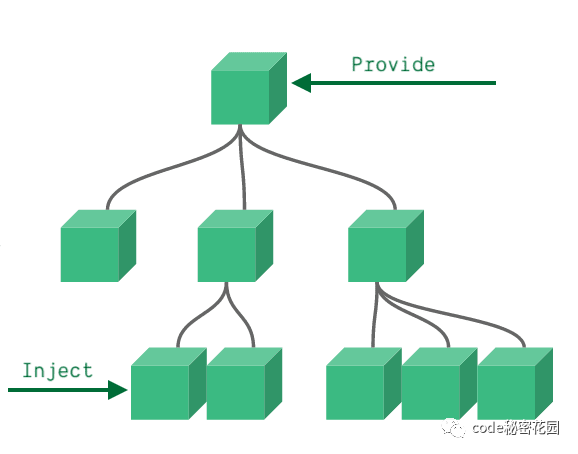
上面的示例对于单个组件非常有用,但是其他组件无法访问状态。为了克服这个问题,你可以使用 provideinject 方法,使 Vue 3 应用中任何指都能访问到。

import { reactive, provide, inject } from 'vue';


export const stateSymbol = Symbol('state');
export const createState = () => reactive({ counter: 0 });


export const useState = () => inject(stateSymbol);
export const provideState = () => provide(
  stateSymbol, 
  createState()
);

当您将 Symbol 作为键和值传递给 provide 方法时,该方法中的任何子组件都可以使用该值。Symbol 提供和检索值时,key 使用相同的名称。

这样,如果你在最顶层的组件上提供值,那么它将在所有组件中可用。另外,还可以在主应用程序实例上调用 provide

import { createApp, reactive } from 'vue';
import App from './App.vue';
import { stateSymbol, createState } from './store';


const app = createApp(App);
app.provide(stateSymbol, createState());
app.mount('#app');
<script>
  import { useState } from './state';


  export default {
    setup() {
      return { state: useState() };
    }
  };
</script>

让代码更加健壮

上面的解决方案有效,但有一个缺点:你不知道是谁修改了什么。状态可以直接更改,没有限制。

你可以使用 readonly 函数将状态包装起来,用以保护状态。它覆盖了在Proxy 对象中传递的变量,该代理对象阻止任何修改(在尝试修改时发出警告)。这些变化可以由能够访问可写存储的单独函数来处理。

import { reactive, readonly } from 'vue';


export const createStore = () => {
  const state = reactive({ counter: 0 });
  const increment = () => state.counter++;


  return { increment, state: readonly(state) };
}

外部将只能访问只读状态,并且只有导出的函数可以修改可写状态。

通过保护状态免受不必要的修改,新解决方案相对接近 Vuex

总结

通过使用 Vue 3 的响应式系统和依赖项注入机制,我们已经从本地状态转变为可以在较小的应用程序中替代 Vuex 的集中状态管理。

现在我们有;一个状态对象,该对象是只读的,并且可以对模板的更改作出响应。状态只能通过特定的方法来修改,比如 Vuex 中的 actions/mutations。可以使用 computed 函数定义其他 getter

Vuex 具有更多的功能,例如模块处理,但有时我们并不需要。

以上就是W3Cschool编程狮关于Vue 3.0 有了它,Vuex或许可以提前退休了的相关介绍了,希望对大家有所帮助。
3种SpringBoot时间格式化的方法,轻松减少你的代码量

thbcm阅读(328)

文章转载自公众号:程序员内点事

时间格式化在项目中使用频率是非常高的,当我们的 API 接口返回结果,需要对其中某一个 date 字段属性进行特殊的格式化处理,通常会用到 SimpleDateFormat 工具处理。

SimpleDateFormat dateFormat = new SimpleDateFormat("yyyy-MM-dd");
Date stationTime = dateFormat.parse(dateFormat.format(PayEndTime()));

可一旦处理的地方较多,不仅 CV 操作频繁,还产生很多重复臃肿的代码,而此时如果能将时间格式统一配置,就可以省下更多时间专注于业务开发了。

可能很多人觉得统一格式化时间很简单啊,像下边这样配置一下就行了,但事实上这种方式只对 date 类型生效。

spring.jackson.date-format=yyyy-MM-dd HH:mm:ss
spring.jackson.time-zone=GMT+8

而很多项目中用到的时间和日期API 比较混乱, java.util.Datejava.util.Calendarjava.time LocalDateTime 都存在,所以全局时间格式化必须要同时兼容性新旧 API

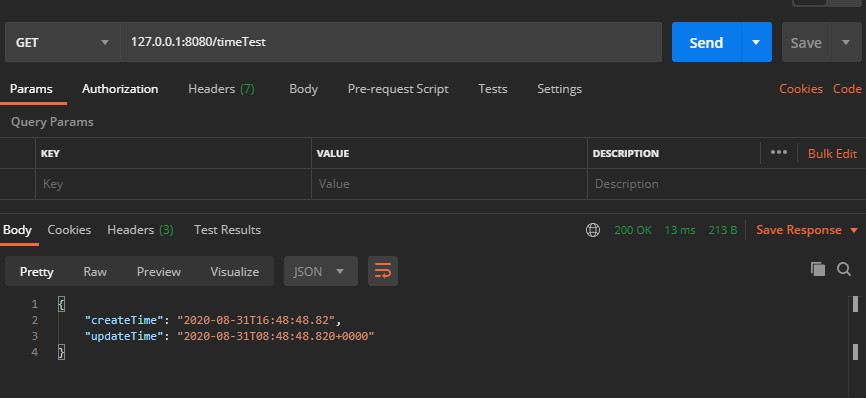
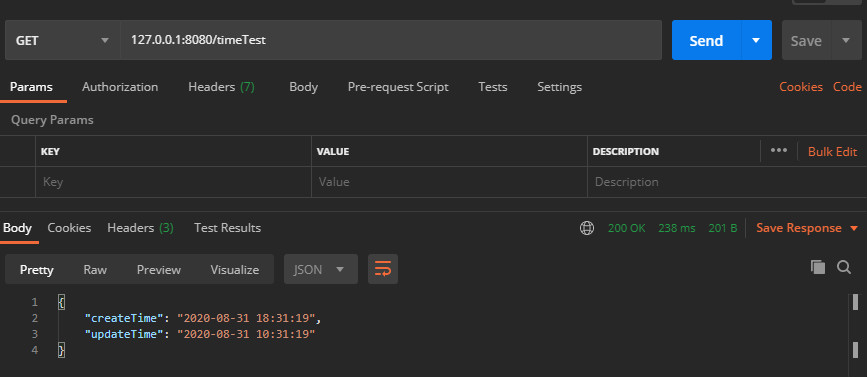
看看配置全局时间格式化前,接口返回时间字段的格式。

@Data
public class OrderDTO {


    private LocalDateTime createTime;


    private Date updateTime;
}

很明显不符合页面上的显示要求(有人抬杠为啥不让前端解析时间,我只能说睡服代码比说服人容易得多~

一、@JsonFormat 注解

@JsonFormat 注解方式严格意义上不能叫全局时间格式化,应该叫部分格式化,因为@JsonFormat 注解需要用在实体类的时间字段上,而只有使用相应的实体类,对应的字段才能进行格式化。

@Data
public class OrderDTO {


    @JsonFormat(locale = "zh", timezone = "GMT+8", pattern = "yyyy-MM-dd")
    private LocalDateTime createTime;


    @JsonFormat(locale = "zh", timezone = "GMT+8", pattern = "yyyy-MM-dd HH:mm:ss")
    private Date updateTime;
}

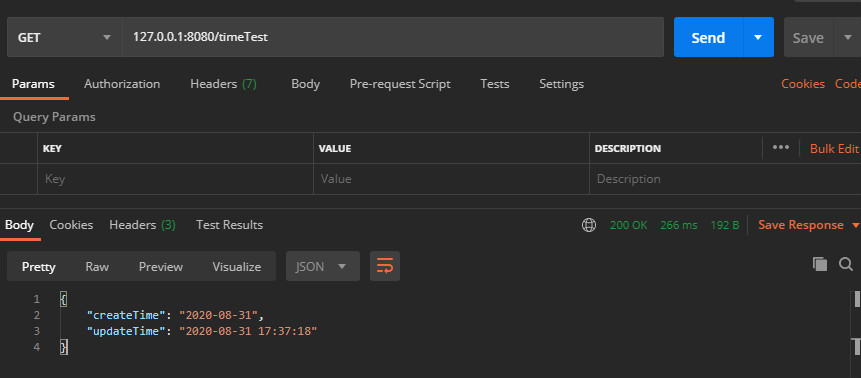
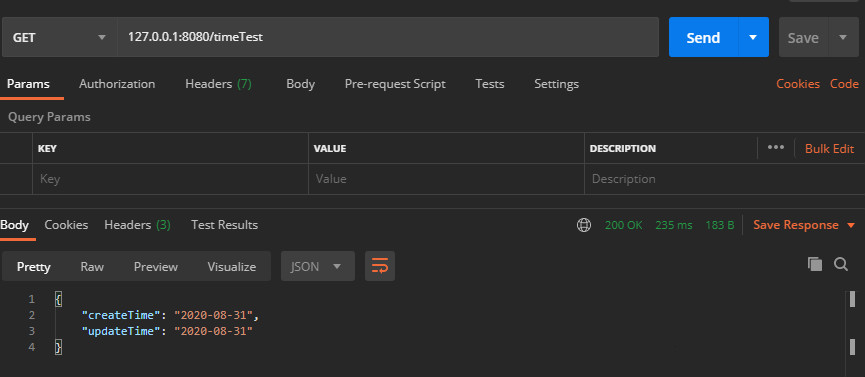
字段加上 @JsonFormat 注解后,LocalDateTimeDate 时间格式化成功。

二、@JsonComponent 注解(推荐)

这是我个人比较推荐的一种方式,前边看到使用 @JsonFormat 注解并不能完全做到全局时间格式化,所以接下来我们使用 @JsonComponent注解自定义一个全局格式化类,分别对 DateLocalDate 类型做格式化处理。

@JsonComponent
public class DateFormatConfig {


    @Value("${spring.jackson.date-format:yyyy-MM-dd HH:mm:ss}")
    private String pattern;


    /**
     * @author xiaofu
     * @description date 类型全局时间格式化
     * @date 2020/8/31 18:22
     */
    @Bean
    public Jackson2ObjectMapperBuilderCustomizer jackson2ObjectMapperBuilder() {


        return builder -> {
            TimeZone tz = TimeZone.getTimeZone("UTC");
            DateFormat df = new SimpleDateFormat(pattern);
            df.setTimeZone(tz);
            builder.failOnEmptyBeans(false)
                    .failOnUnknownProperties(false)
                    .featuresToDisable(SerializationFeature.WRITE_DATES_AS_TIMESTAMPS)
                    .dateFormat(df);
        };
    }


    /**
     * @author xiaofu
     * @description LocalDate 类型全局时间格式化
     * @date 2020/8/31 18:22
     */
    @Bean
    public LocalDateTimeSerializer localDateTimeDeserializer() {
        return new LocalDateTimeSerializer(DateTimeFormatter.ofPattern(pattern));
    }


    @Bean
    public Jackson2ObjectMapperBuilderCustomizer jackson2ObjectMapperBuilderCustomizer() {
        return builder -> builder.serializerByType(LocalDateTime.class, localDateTimeDeserializer());
    }
}

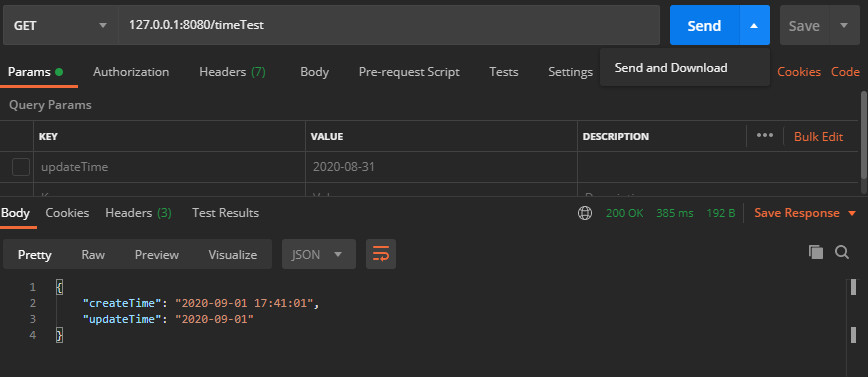
看到 DateLocalDate 两种时间类型格式化成功,此种方式有效。

但还有个问题,实际开发中如果我有个字段不想用全局格式化设置的时间样式,想自定义格式怎么办?

那就需要和 @JsonFormat 注解配合使用了。

@Data
public class OrderDTO {


    @JsonFormat(locale = "zh", timezone = "GMT+8", pattern = "yyyy-MM-dd")
    private LocalDateTime createTime;


    @JsonFormat(locale = "zh", timezone = "GMT+8", pattern = "yyyy-MM-dd")
    private Date updateTime;
}

从结果上我们看到 @JsonFormat 注解的优先级比较高,会以 @JsonFormat 注解的时间格式为主。

三、@Configuration 注解

这种全局配置的实现方式与上边的效果是一样的。

注意:在使用此种配置后,字段手动配置@JsonFormat 注解将不再生效。

@Configuration
public class DateFormatConfig2 {


    @Value("${spring.jackson.date-format:yyyy-MM-dd HH:mm:ss}")
    private String pattern;


    public static DateFormat dateFormat = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss");


    @Bean
    @Primary
    public ObjectMapper serializingObjectMapper() {
        ObjectMapper objectMapper = new ObjectMapper();
        JavaTimeModule javaTimeModule = new JavaTimeModule();
        javaTimeModule.addSerializer(LocalDateTime.class, new LocalDateTimeSerializer());
        javaTimeModule.addDeserializer(LocalDateTime.class, new LocalDateTimeDeserializer());
        objectMapper.registerModule(javaTimeModule);
        return objectMapper;
    }


    /**
     * @author xiaofu
     * @description Date 时间类型装换
     * @date 2020/9/1 17:25
     */
    @Component
    public class DateSerializer extends JsonSerializer<Date> {
        @Override
        public void serialize(Date date, JsonGenerator gen, SerializerProvider provider) throws IOException {
            String formattedDate = dateFormat.format(date);
            gen.writeString(formattedDate);
        }
    }


    /**
     * @author xiaofu
     * @description Date 时间类型装换
     * @date 2020/9/1 17:25
     */
    @Component
    public class DateDeserializer extends JsonDeserializer<Date> {


        @Override
        public Date deserialize(JsonParser jsonParser, DeserializationContext deserializationContext) throws IOException {
            try {
                return dateFormat.parse(jsonParser.getValueAsString());
            } catch (ParseException e) {
                throw new RuntimeException("Could not parse date", e);
            }
        }
    }


    /**
     * @author xiaofu
     * @description LocalDate 时间类型装换
     * @date 2020/9/1 17:25
     */
    public class LocalDateTimeSerializer extends JsonSerializer<LocalDateTime> {
        @Override
        public void serialize(LocalDateTime value, JsonGenerator gen, SerializerProvider serializers) throws IOException {
            gen.writeString(value.format(DateTimeFormatter.ofPattern(pattern)));
        }
    }


    /**
     * @author xiaofu
     * @description LocalDate 时间类型装换
     * @date 2020/9/1 17:25
     */
    public class LocalDateTimeDeserializer extends JsonDeserializer<LocalDateTime> {
        @Override
        public LocalDateTime deserialize(JsonParser p, DeserializationContext deserializationContext) throws IOException {
            return LocalDateTime.parse(p.getValueAsString(), DateTimeFormatter.ofPattern(pattern));
        }
    }
}

总结

分享了一个简单却又很实用的 Springboot 开发技巧,其实所谓的开发效率,不过是一个又一个开发技巧堆砌而来,聪明的程序员总是能用最少的代码完成任务。

以上就是W3Cschool编程狮关于3种SpringBoot时间格式化的方法,轻松减少你的代码量的相关介绍了,希望对大家有所帮助。
10个简单的技巧让你的 vue.js 代码更优雅

thbcm阅读(731)

文章转载自公众号:前端人

前言

作为深度代码洁癖,我们都希望能写出简单高效的代码,让我们的代码看起来更加优雅,让我们抛弃繁杂的代码,一起开启简单的旅程~~

slots 新语法向 3.0 看齐

使用带有“#”的新命名插槽缩写语法,在Vue 2.6.0+中可用

举个例子:

构建插槽时,最好规划一下布局。这就是我的文章布局。构建插槽与构建组件没有什么不同。本质上,插槽是具有超强功能的组件,让我们细分一下上面的布局,组件的外观如下:

<!-- TidbitPage.vue -->
<template>
  <article-layout>


    <template #articleHeader>
      <h1>I am the header</h1>
    </template>


    <template #articleContent>
      <p>I am the content</p>
    </template>


    <template #articleFooter>
      <footer>I am the footer</footer>
    </template>


    <template #side>
      <aside>I am the side stuff</aside>
    </template>


    <template #banner>
      <div>I am the banner</div>
    </template>


  </article-layout>
<template>

动态指令参数

指令参数现在可以接受动态 JavaScript 表达式 动态参数值应该是字符串,但允许null作为一个明确指示应该删除绑定的特殊值,那将会很方便。任何其他非字符串值都可能出错,并会触发警告。(仅适用于v-bind和v-on

<div v-bind:[attr]="attributeName"></div>
//简写
<div :[attr]="attributeName"></div>

这里的 attributeName 会被作为一个JavaScript表达式进行动态求值,求得的值将会作为最终的参数来使用。例如,如果你的 Vue 实例有一个 data 属性 attributeName,其值为 href,那么这个绑定将等价于 v-bind:href

同样地,你可以使用动态参数为一个动态的事件名绑定处理函数:

<button v-on:[eventName]="handler"></button>
//简写
<button @[eventName]="handler"></button>

eventName 的值为 focus 时,v-on:[eventName] 将等价于v-on:focus

同样可以适用于插槽绑定:

<my-component>
<template v-slot:[slotName]>
Dynamic slot name
</template>
</my-component>
//简写
<foo>
<template #[name]>
Default slot
</template>
</foo>

动态参数预期会求出一个字符串,异常情况下值为 null。这个特殊的 null 值可以被显性地用于移除绑定。任何其它非字符串类型的值都将会触发一个警告。

<!-- 这会触发一个编译警告 且 无效 -->
<a v-bind:['foo' + bar]="value"> ... </a>

变通的办法是使用没有空格或引号的表达式,或用计算属性替代这种复杂表达式。

@hook那些事

处理组件内定时器的步骤。通常我们一般都是这样操作的:

<script>
  export default {
    mounted() {
      this.timer = setInterval(() => { ... }, 1000);
    },
    beforeDestroy() {
      clearInterval(this.timer);
    }
  };
</script>

但是其实更好的做法是:

<script>
  export default {
    mounted() {
      const timer = setInterval(() => { ... }, 1000);
      this.$once('hook:beforeDestroy', () => clearInterval(timer);)
    }
  };
</script>

设想一个场景 如果我们需要在数据渲染到页面的之前让页面 loadingmounted 之后停止 loadingbeforeUpdata 时开始 loadingupdatad 之后停止 loading

最简单的方法就是改写组件的生命周期函数,使其在 mounted/beforeUpdata /updatad 时通知父组件显示或者隐藏 loading。

这样做显示不好,因为侵入了自组件的逻辑,增加的逻辑也和组件本身的功能好不关联。最好的办法就是使用 v-on="hook:xxx" 的方式:

<v-chart
    @hook:mounted="loading = false"
    @hook:beforeUpdated="loading = true"
    @hook:updated="loading = false"
    :data="data"
/>

这样,就实现了对子组件生命周期的监听。对任意的组件都有效果,包括引入的第三方组件。

vue中的$props$attrs$listeners(可用来二次封装组件)

$props:当前组件接收到的 props 对象。Vue 实例代理了对其 props 对象属性的访问。

假如有个 input 输入框。我们有很多的原生属性,比如:name、placeholder、disabled 等等。我们如果都定义在props显示接收,未免太过繁琐。所以官网出现了:v-bind="$props"这样的操作。如果父组件传递很多的原生属性,那么我们在子组件中直接可以:

//good
<input v-bind="$props">

 
//bad
//而不是下面这样,如果很多的属性就特别繁琐
<input :name="name" :placeholder="placeholder" :disabled="disabled">

我们可以利用以下方式$attrs 将原生属性直接传递给子组件,这是 Vue 在2.4.0新增的属性,包含了父作用域中不作为 prop 被识别 (且获取) 的特性绑定 (class 和 style 除外)。当一个组件没有声明任何 prop 时,这里会包含所有父作用域的绑定 (class 和 style 除外),并且可以通过 v-bind=”$attrs” 传入内部组件——在创建高级别的组件时非常有用。

<input
   v-bind="$attrs"
   :value="value"
   @focus=$emit('focus', $event)"
   @input="$emit('input', $event.target.value)"
>

$listeners:包含了父作用域中的 (不含 .native修饰器的) v-on 事件监听器。它可以通过 v-on="$listeners" 传入内部组件——在创建更高层次的组件时非常有用。

如果子组件不在父组件的根目录下,则可以将所有事件侦听器从父组件传递到子组件,如下所示:

<template>
<div>
  ...
<childComponent v-on="$listeners" />...
</div>
</template>

响应式数据(2.6.0新增)

我们习惯于用 Vuex 去解决状态的共享问题,但是在小项目中使用就会有增大代码体积和将代码复杂化的烦恼,所以在后来的版本中Vue新增

Vue.observable( object ) 让一个对象可响应,Vue 内部会用它来处理 data 函数返回的对象。

返回的对象可以直接用于渲染函数和 计算属性 内,并且会在发生改变时触发相应的更新。也可以作为最小化的跨组件状态存储器,用于简单的场景:

官方示例:

const state = Vue.observable({ count: 0 })


const Demo = {
  render(h) {
    return h('button', {
      on: { click: () => { state.count++ }}
    }, `count is: ${state.count}`)
  }
}

jsx模板组件

以下面的一组状态判断按钮为例,我们很容易就下意识地在模板内写下这种代码

<button v-if="status === 1" class="btn1" :class="status === 1" @click="">未开始</button>
<button v-if="status === 2" class="btn2" :class="status === 2" @click="">进行中</button>
<button v-if="status === 3" class="btn3" :class="status === 3" @click="">可领取</button>
<button v-if="status === 4" class="btn4" :class="status === 4" @click="">已领取</button>

但是如果我们利用渲染函数可以将上面的代码抽取成优雅的使用组件

<!DOCTYPE html>
<html lang="en">


<body>
    <div id="app">
        <child :status="status"></child>
    </div>
    <script src="https://cdn.jsdelivr.net/npm/vue/dist/vue.js"></script>
    <script>
        Vue.component('child', {
            props: {
                status: {
                    type: Number,
                    required: true
                }
            },
            render(createElement) {
                const innerHTML = ['未开始', '进行中', '可领取', '已领取'][this.status]
                return createElement('button', {
                    class: {
                        active: this.status
                    },
                    attrs: {
                        id: 'btn'
                    },
                    domProps: {
                        innerHTML
                    },
                    on: {
                        click: () => console.log(this.status)
                    }
                })
            }
        })
        var app = new Vue({
            el: '#app',
            data: {
                status: 0
            }
        })
    </script>
</body>


</html>

我们将所有的逻辑封装进渲染函数内,外部只需要传递一个状态参数即可改变

<child :status="status"></child>

动态组件

通过 Vue 的 元素加一个特殊的 is attribute 可以实现动态组件的效果

如图,这是一个 v-for 渲染的列表(只是目前这个版块才刚开始做,目前只有一个),圆圈内的就是一个组件,也就是要 v-for 动态组件

实际使用

一开始就是基本的组件引入了

import ColorIn from '@/components/Magic/ColorIn.vue'
import LineIn from "@/components/Magic/LineIn.vue";
import Header from "@/components/Magic/Header.vue";
import Footer from "@/components/Magic/Footer.vue";


export default{
      components:{
        ColorIn,
        LineIn,
        Header,
        Footer
    }
}

接下来就是动态 v-for 动态组件的使用,componentList:['ColorIn','LineIn','Header','Footer']使用下面的代码即可将代码依次循环

<component v-for="(item,index) in componentList" :key="index" :is="item"></component>

编译以后的效果就是

<ColorIn></ColorIn>
<LineIn></LineIn>
<Header></Header>
<Footer></Footer>

Vue.filter

简单介绍一下过滤器,顾名思义,过滤就是一个数据经过了这个过滤之后出来另一样东西,可以是从中取得你想要的,或者给那个数据添加点什么装饰,那么过滤器则是过滤的工具。例如,从[‘abc’,’abd’,’ade’]数组中取得包含‘ab’的值,那么可通过过滤器筛选出来‘abc’和‘abd’;把‘Hello’变成‘Hello World’,那么可用过滤器给值‘Hello’后面添加上‘ World’;或者把时间节点改为时间戳等等都可以使用过滤器。

场景:时间戳转化成年月日这是一个公共方法,所以可以抽离成过滤器使用

// 使用
// 在双花括号中
{{ message | capitalize }}


// 在 `v-bind` 中
<div v-bind:id="rawId | formatId"></div>


// 全局注册
Vue.filter('stampToYYMMDD', (value) =>{
  // 处理逻辑
})


// 局部注册
filters: {
  stampToYYMMDD: (value)=> {
    // 处理逻辑
  }
}


// 多个过滤器全局注册
// /src/common/filters.js
let dateServer = value => value.replace(/(\d{4})(\d{2})(\d{2})/g, '$1-$2-$3')
export { dateServer }
// /src/main.js
import * as custom from './common/filters/custom'
Object.keys(custom).forEach(key => Vue.filter(key, custom[key]))

.sync 语法糖

sync 就是为了实现prop 进行“双向绑定”仅此而已(父对子,子对父,来回传)

当你有需要在子组件修改父组件值的时候这个方法很好用,它的实现机制和v-model是一样的。

利用 object.freeze 提升性能

Object.freeze() 方法可以冻结一个对象。一个被冻结的对象再也不能被修改;冻结了一个对象则不能向这个对象添加新的属性,不能删除已有属性,不能修改该对象已有属性的可枚举性、可配置性、可写性,以及不能修改已有属性的值。此外,冻结一个对象后该对象的原型也不能被修改。 freeze() 返回和传入的参数相同的对象。

比方我们需要渲染一个非常大的数组对象,例如用户列表,对象列表,文章列表等等。

export default {
  data: () => ({
    users: {}
  }),
  async created() {
    const users = await axios.get("/api/users");
    this.users = users;
  }
};

vue 会将 data 对象中的所有的属性加入到 vue 的响应式系统中,当这些属性的值发生改变时,视图将会产生 响应,若对象的体积比较大,会消耗很多浏览器解析时间。

所以我们可以通过减少数据的响应式转换来提供前端的性能。

export default {
  data: () => ({
    users: {}
  }),
  async created() {
    const users = await axios.get("/api/users");
    this.users = Object.freeze(users);
  }
};

以上就是W3Cschool编程狮关于10个简单的技巧让你的 vue.js 代码更优雅的相关介绍了,希望对大家有所帮助。
MySQL的主键为啥不能用uuid

thbcm阅读(317)

原文链接:cnblogs.com/wyq178/p/12548864.html

前言

mysql 中设计表的时候, mysql 官方推荐不要使用 uuid 或者不连续不重复的雪花id (long形且唯一,单机递增),而是推荐连续自增的主键 id,官方的推荐是 auto_increment ,那么为什么不建议采用 uuid ,使用 uuid 究竟有什么坏处?

本篇文章我们就来分析这个问题,探讨一下内部的原因。

一、mysql和程序实例

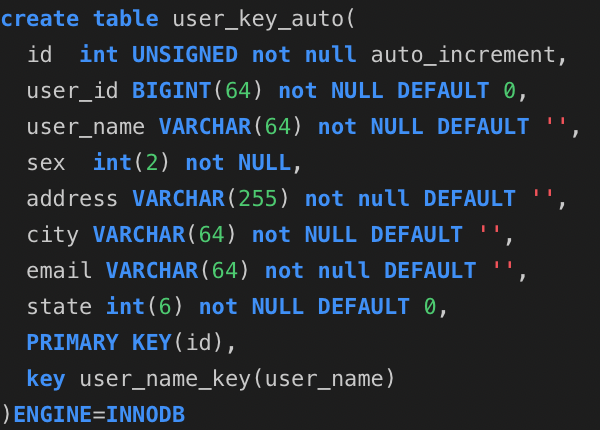
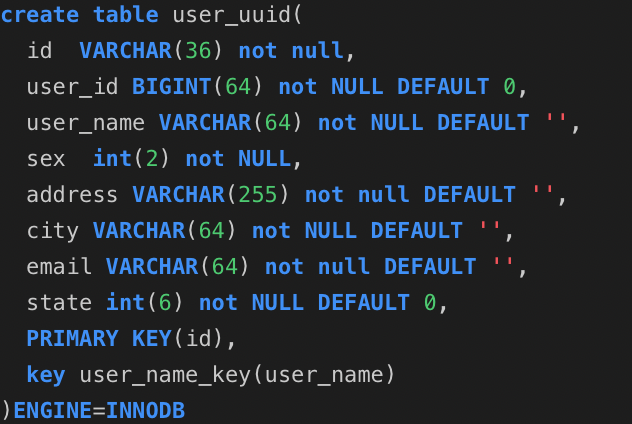
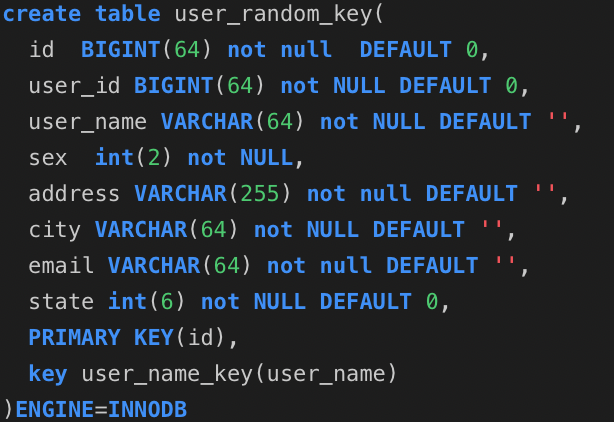
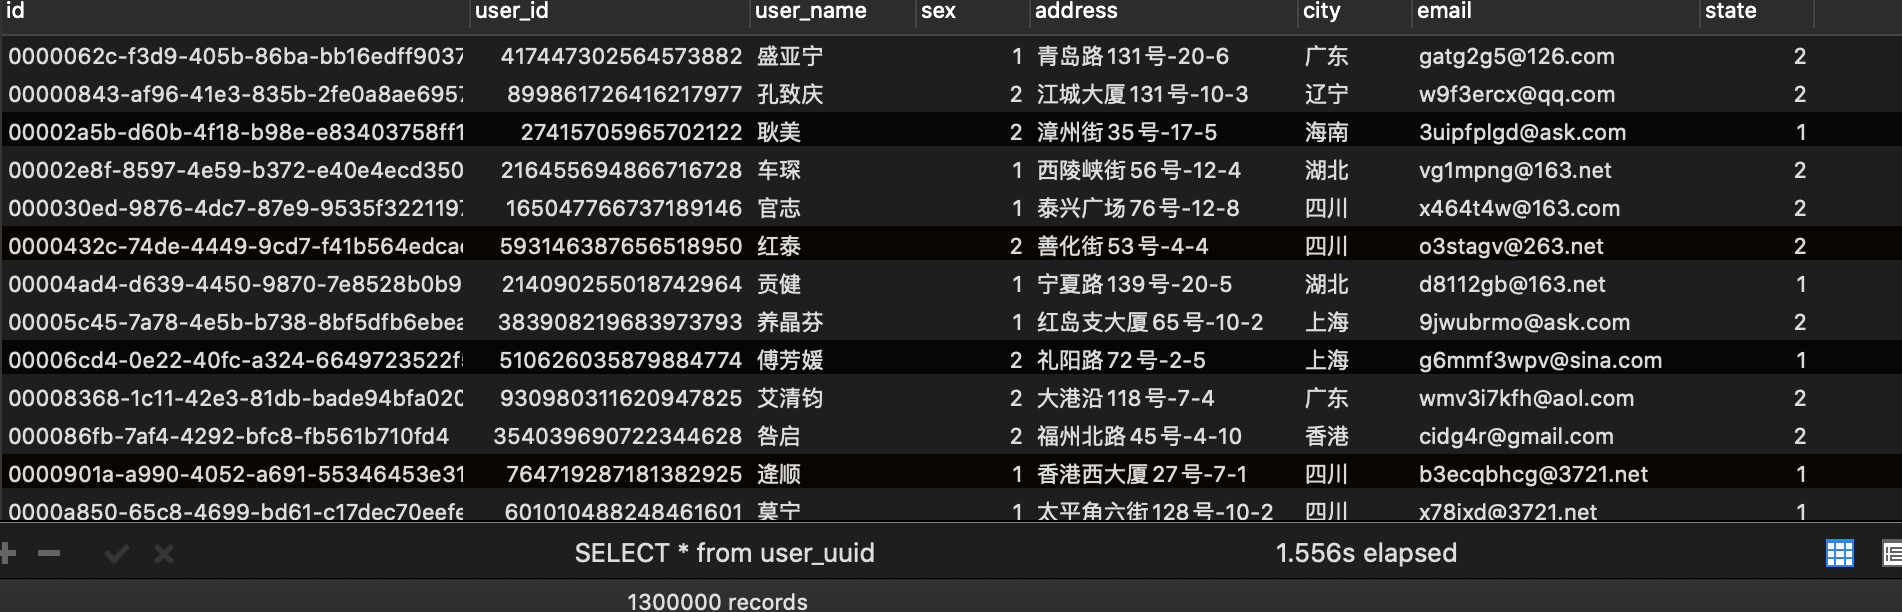
1.1.要说明这个问题,我们首先来建立三张表

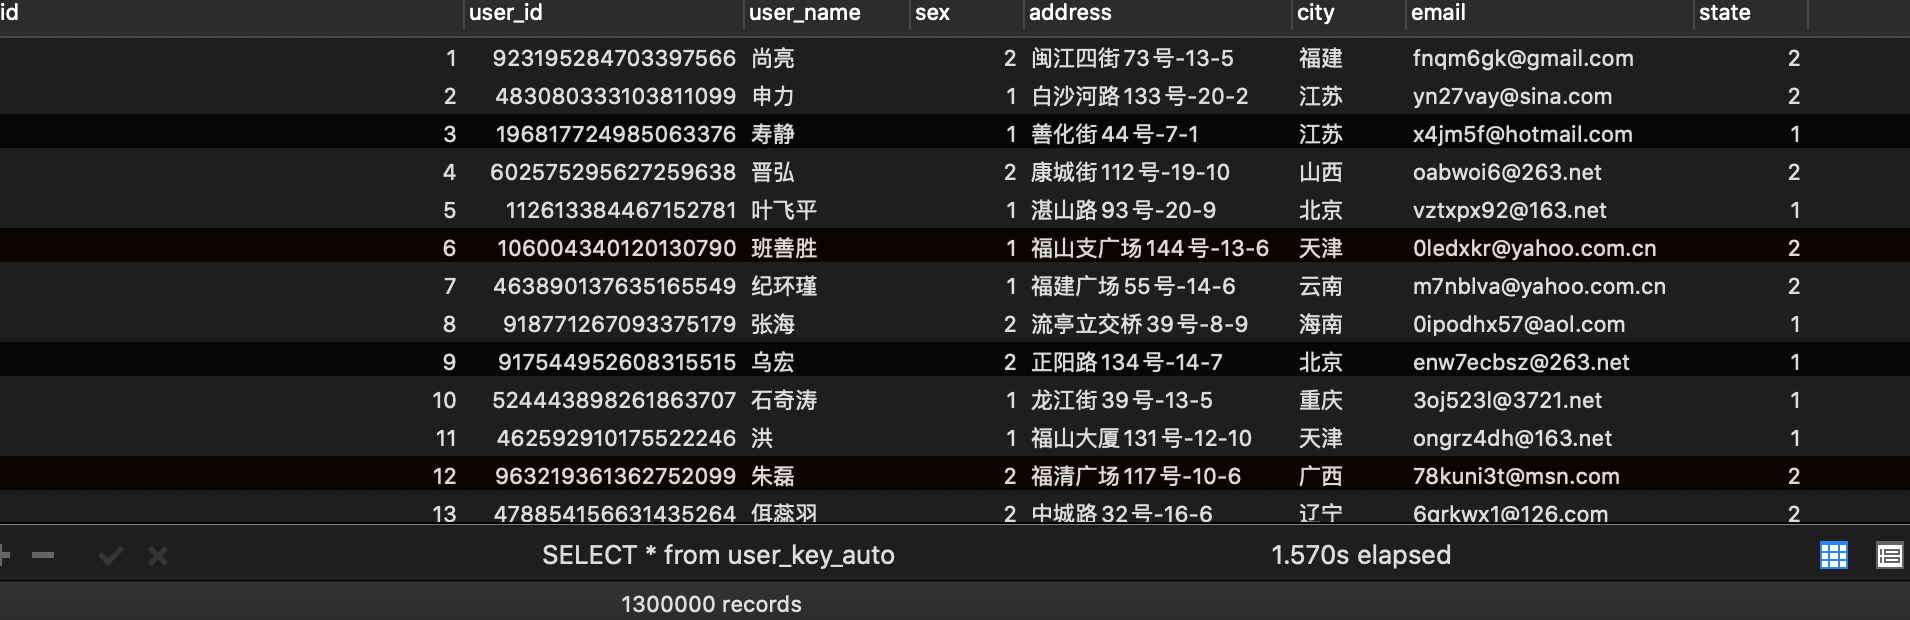
分别是user_auto_key,user_uuid,user_random_key,分别表示自动增长的主键,uuid作为主键,随机key作为主键,其它我们完全保持不变.

根据控制变量法,我们只把每个表的主键使用不同的策略生成,而其他的字段完全一样,然后测试一下表的插入速度和查询速度:

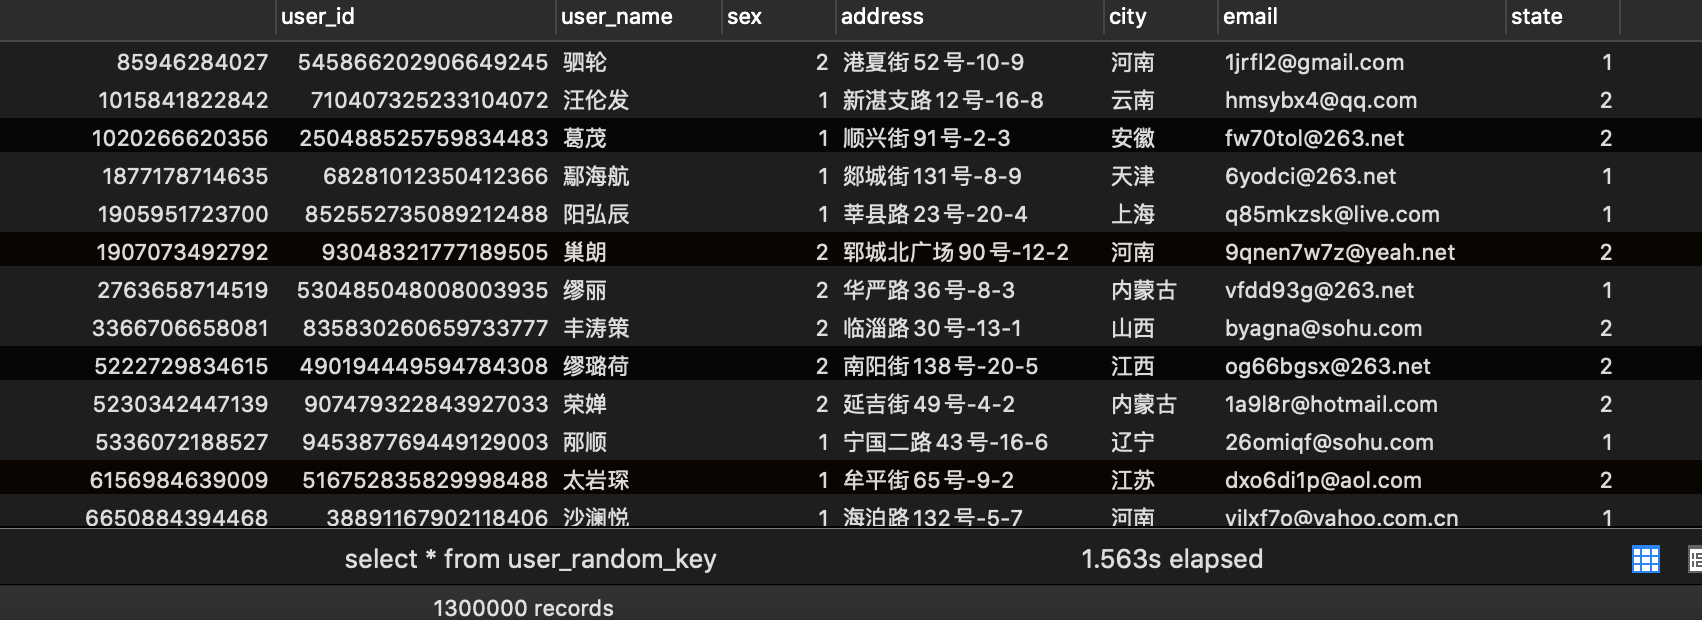
注:这里的随机key其实是指用雪花算法算出来的前后不连续不重复无规律的id:一串18位长度的long值

id自动生成表:

用户uuid表

随机主键表:

1.2.光有理论不行,直接上程序,使用spring的jdbcTemplate来实现增查测试:

技术框架:springboot+jdbcTemplate+junit+hutool,程序的原理就是连接自己的测试数据库,然后在相同的环境下写入同等数量的数据,来分析一下insert插入的时间来进行综合其效率,为了做到最真实的效果,所有的数据采用随机生成,比如名字、邮箱、地址都是随机生成。

package com.wyq.mysqldemo;
import cn.hutool.core.collection.CollectionUtil;
import com.wyq.mysqldemo.databaseobject.UserKeyAuto;
import com.wyq.mysqldemo.databaseobject.UserKeyRandom;
import com.wyq.mysqldemo.databaseobject.UserKeyUUID;
import com.wyq.mysqldemo.diffkeytest.AutoKeyTableService;
import com.wyq.mysqldemo.diffkeytest.RandomKeyTableService;
import com.wyq.mysqldemo.diffkeytest.UUIDKeyTableService;
import com.wyq.mysqldemo.util.JdbcTemplateService;
import org.junit.jupiter.api.Test;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.boot.test.context.SpringBootTest;
import org.springframework.util.StopWatch;
import java.util.List;
@SpringBootTest
class MysqlDemoApplicationTests {


    @Autowired
    private JdbcTemplateService jdbcTemplateService;


    @Autowired
    private AutoKeyTableService autoKeyTableService;


    @Autowired
    private UUIDKeyTableService uuidKeyTableService;


    @Autowired
    private RandomKeyTableService randomKeyTableService;


    @Test
    void testDBTime() {


        StopWatch stopwatch = new StopWatch("执行sql时间消耗");


        /**
         * auto_increment key任务
         */
        final String insertSql = "INSERT INTO user_key_auto(user_id,user_name,sex,address,city,email,state) VALUES(?,?,?,?,?,?,?)";


        List<UserKeyAuto> insertData = autoKeyTableService.getInsertData();
        stopwatch.start("自动生成key表任务开始");
        long start1 = System.currentTimeMillis();
        if (CollectionUtil.isNotEmpty(insertData)) {
            boolean insertResult = jdbcTemplateService.insert(insertSql, insertData, false);
            System.out.println(insertResult);
        }
        long end1 = System.currentTimeMillis();
        System.out.println("auto key消耗的时间:" + (end1 - start1));


        stopwatch.stop();


        /**
         * uudID的key
         */
        final String insertSql2 = "INSERT INTO user_uuid(id,user_id,user_name,sex,address,city,email,state) VALUES(?,?,?,?,?,?,?,?)";


        List<UserKeyUUID> insertData2 = uuidKeyTableService.getInsertData();
        stopwatch.start("UUID的key表任务开始");
        long begin = System.currentTimeMillis();
        if (CollectionUtil.isNotEmpty(insertData)) {
            boolean insertResult = jdbcTemplateService.insert(insertSql2, insertData2, true);
            System.out.println(insertResult);
        }
        long over = System.currentTimeMillis();
        System.out.println("UUID key消耗的时间:" + (over - begin));


        stopwatch.stop();


        /**
         * 随机的long值key
         */
        final String insertSql3 = "INSERT INTO user_random_key(id,user_id,user_name,sex,address,city,email,state) VALUES(?,?,?,?,?,?,?,?)";
        List<UserKeyRandom> insertData3 = randomKeyTableService.getInsertData();
        stopwatch.start("随机的long值key表任务开始");
        Long start = System.currentTimeMillis();
        if (CollectionUtil.isNotEmpty(insertData)) {
            boolean insertResult = jdbcTemplateService.insert(insertSql3, insertData3, true);
            System.out.println(insertResult);
        }
        Long end = System.currentTimeMillis();
        System.out.println("随机key任务消耗时间:" + (end - start));
        stopwatch.stop();


        String result = stopwatch.prettyPrint();
        System.out.println(result);
    }

1.3.程序写入结果

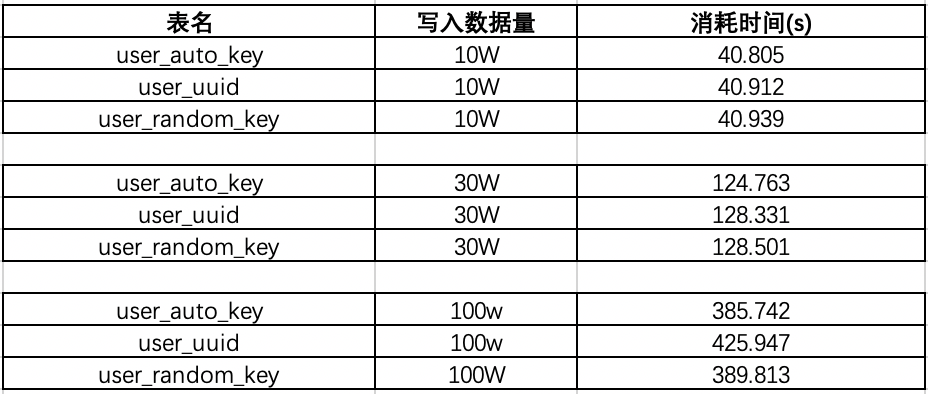
user_key_auto写入结果:

user_random_key写入结果:

user_uuid表写入结果:

1.4.效率测试结果

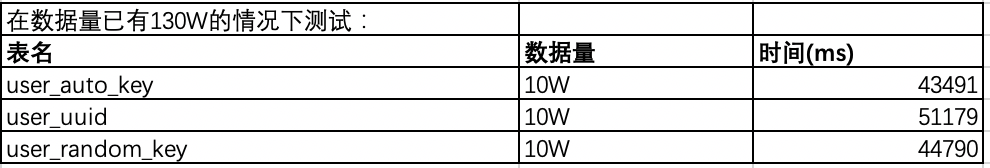
在已有数据量为130W的时候:我们再来测试一下插入10w数据,看看会有什么结果:

可以看出在数据量100W左右的时候,uuid的插入效率垫底,并且在后序增加了130W的数据,uudi的时间又直线下降。

时间占用量总体可以打出的效率排名为:auto_key>random_key>uuid,uuid的效率最低,在数据量较大的情况下,效率直线下滑。那么为什么会出现这样的现象呢?带着疑问,我们来探讨一下这个问题:

二、使用uuid和自增id的索引结构对比

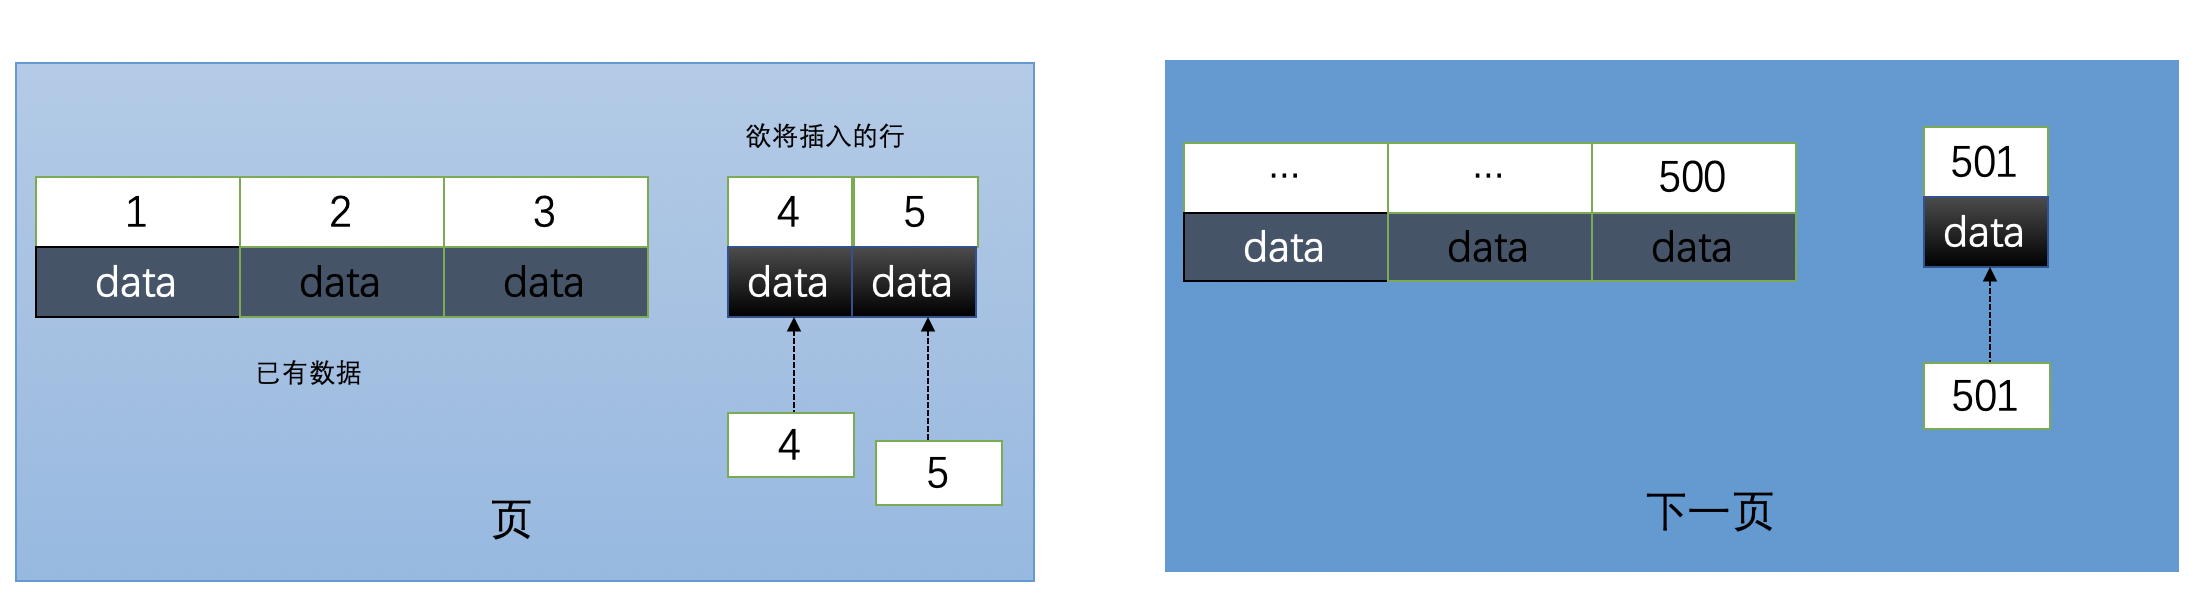
2.1.使用自增id的内部结构

自增的主键的值是顺序的,所以Innodb把每一条记录都存储在一条记录的后面。当达到页面的最大填充因子时候(innodb默认的最大填充因子是页大小的15/16,会留出1/16的空间留作以后的 修改):

  1. 下一条记录就会写入新的页中,一旦数据按照这种顺序的方式加载,主键页就会近乎于顺序的记录填满,提升了页面的最大填充率,不会有页的浪费
  2. 新插入的行一定会在原有的最大数据行下一行,mysql定位和寻址很快,不会为计算新行的位置而做出额外的消耗
  3. 减少了页分裂和碎片的产生

2.2.使用uuid的索引内部结构

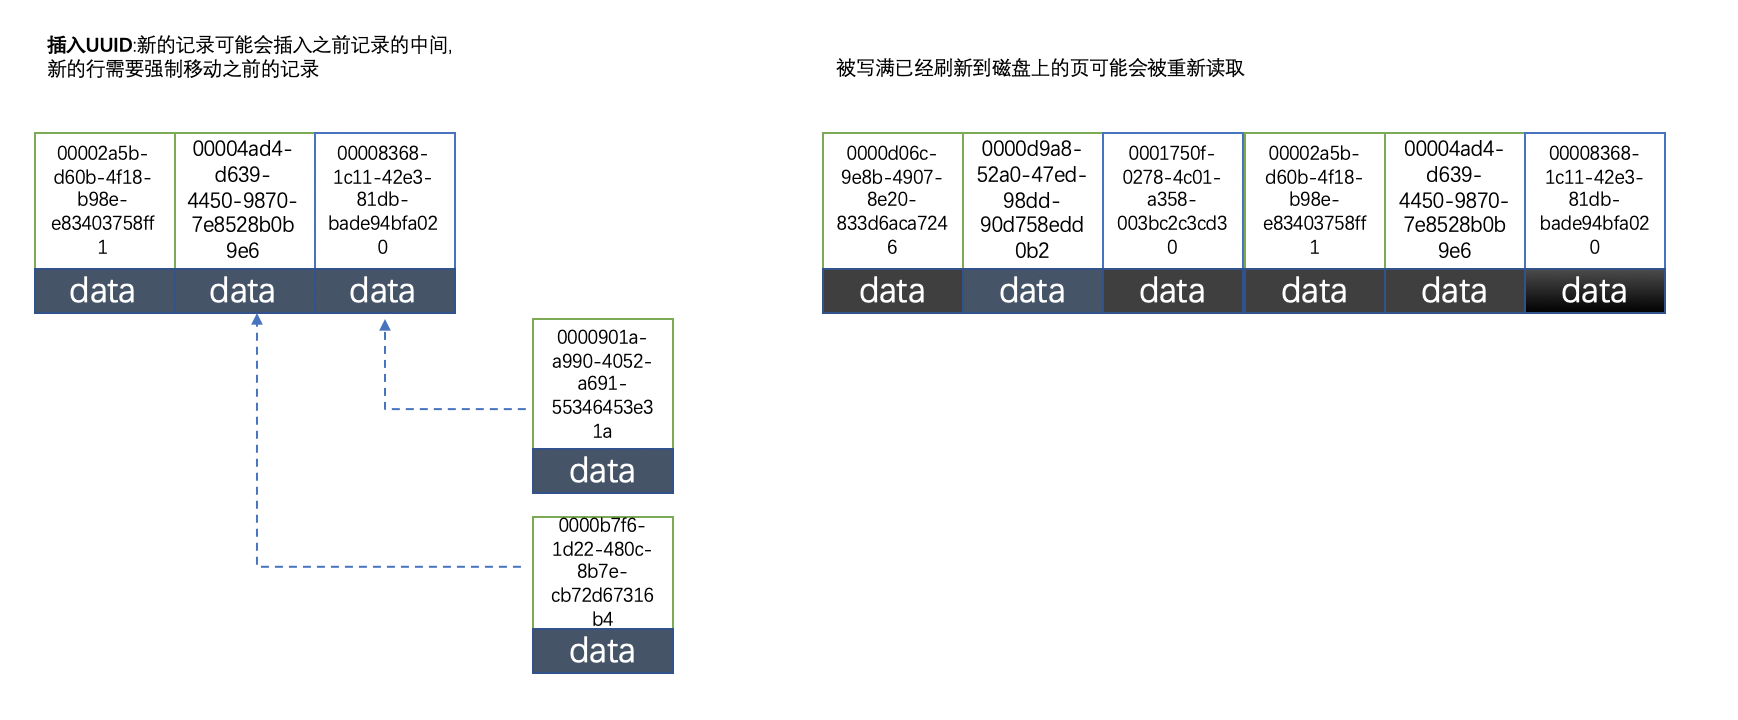
因为uuid相对顺序的自增 id 来说是毫无规律可言的,新行的值不一定要比之前的主键的值要大,所以innodb无法做到总是把新行插入到索引的最后,而是需要为新行寻找新的合适的位置从而来分配新的空间。

这个过程需要做很多额外的操作,数据的毫无顺序会导致数据分布散乱,将会导致以下的问题:

  1. 写入的目标页很可能已经刷新到磁盘上并且从缓存上移除,或者还没有被加载到缓存中,innodb在插入之前不得不先找到并从磁盘读取目标页到内存中,这将导致大量的随机 IO
  2. 因为写入是乱序的,innodb不得不频繁的做页分裂操作,以便为新的行分配空间,页分裂导致移动大量的数据,一次插入最少需要修改三个页以上
  3. 由于频繁的页分裂,页会变得稀疏并被不规则的填充,最终会导致数据会有碎片

在把随机值(uuid和雪花id)载入到聚簇索引(innodb默认的索引类型)以后,有时候会需要做一次OPTIMEIZE TABLE来重建表并优化页的填充,这将又需要一定的时间消耗。

结论:使用innodb应该尽可能的按主键的自增顺序插入,并且尽可能使用单调的增加的聚簇键的值来插入新行

2.3.使用自增id的缺点

那么使用自增的 id 就完全没有坏处了吗?并不是,自增 id 也会存在以下几点问题:

  1. 别人一旦爬取你的数据库,就可以根据数据库的自增 id 获取到你的业务增长信息,很容易分析出你的经营情况
  2. 对于高并发的负载,innodb在按主键进行插入的时候会造成明显的锁争用,主键的上界会成为争抢的热点,因为所有的插入都发生在这里,并发插入会导致间隙锁竞争
  3. Auto_Increment锁机制会造成自增锁的抢夺,有一定的性能损失

附:Auto_increment的锁争抢问题,如果要改善需要调优innodb_autoinc_lock_mode的配置

三、总结

本篇文章首先从开篇的提出问题,建表到使用jdbcTemplate去测试不同 id 的生成策略在大数据量的数据插入表现,然后分析了 id 的机制不同在 mysql 的索引结构以及优缺点,深入的解释了为何uuid和随机不重复 id 在数据插入中的性能损耗,详细的解释了这个问题。

在实际的开发中还是根据 mysql 的官方推荐最好使用自增 id,mysql 博大精深,内部还有很多值得优化的点需要我们学习。

以上就是W3Cschool编程狮关于MySQL的主键为啥不能用uuid的相关介绍了,希望对大家有所帮助。
HA(高可用)就像套娃,像胖子,剥掉一层还有一层

thbcm阅读(305)

文章转载自公众号:小姐姐味道

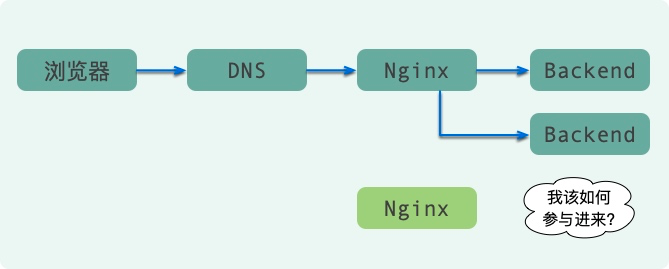
目前HTTP协议,乃至WebSocket协议,乃至采用了MQTT协议的WebSocket协议,都不可避免的使用了 Nginx 。所谓病从口入,祸从口出。作为入口,Nginx 承担的责任非常的重要。假如某个时刻不能用了,那可真是灾难。

如何保证 Nginx 的高可用呢?这是个问题。不论你用什么样的方案,到最后总是要归为单一,很让人苦恼。

所谓的高可用,无非两种方式。一种方式就是在组件自身上做文章,另外一种方式,就是加入一个中间层。我们通常希望在高可用的时候,同时还能够负载均衡,典型的猫和狗都想要,贪婪的很。

每当解决不了问题的时候,我们都会加入一个中间层,然后把希望寄托在这个新生的组件上。

如果这个中间层解决不了问题,我们就可以加入另外一个中间层。就这样一层套一层,到最后系统高可用架构就会变得非常复杂。

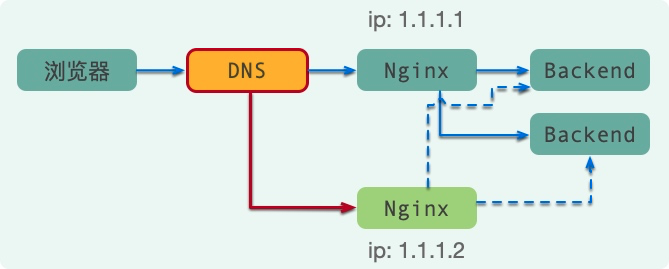
DNS保证高可用

第一种方式当然是要在 DNS 上做文章了。通过在 DNS 上,绑定多个 Nginx 的 IP 地址,即可完成高可用。不仅能够完成高可用,还能顺便完成负载均衡。

但这玩意有一个致命的问题,那就是故障的感知时间。

我们的浏览器在访问到真正的 Nginx 之前,需要把域名转化为真正的 IP 地址,DNS 就是干解析这个动作的,每次需要耗费20-20ms不等。

为了加快解析速度,一般都会有多级的缓存。比如浏览器就有 DNS 的缓存;你使用的 PC 机上也有这样的缓存;IPS 服务提供商,也会有缓存;再加上有的企业为了加速访问所自建的 DNS 服务器,中间的缓存层就更多了。

只有所有的缓存都不命中的情况下,DNS 才会查询真正的 IP 地址。所以,如果有一台 Nginx 当机了,这个故障的感知能力就会特别的差。总有一部分用户的请求,会落在这台已经死亡的机器上。

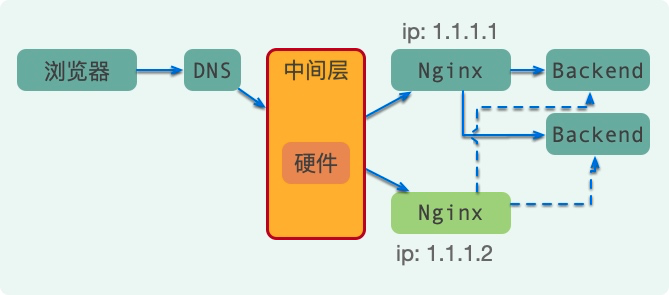
硬件保证高可用

我们前面说了。解决不了的问题,就可以加中间层,即使这个中间层是硬件,比如F5

这种架构一般的企业玩不起,只有那些采购有回扣有油水的公司,才会喜欢这个。互联网中用的很少,就不过多介绍了。

当然,F5同样有单点的问题。虽然硬件肯定要比软件稳定上一点,但是总归是一个隐患。就像 Oracle 无论再厉害,它还是有出问题的时候,到时候备机是必须的。

有的厂商在卖硬件的时候,推荐你一次买3个!为啥呢?这也有理由。

你的一台硬件正在服务,有两台备份机器。当你服务的这台机器出现问题时,就可以选取备份机中的其中一台作为主机,另一台依然是备机,集群还是高可用的。

这理由真让人陶醉。按照这个逻辑,碰到傻子,我可以卖出100台!

主备模式

硬的不行,就要来软的。采用主备的模式,使用软件来完成切换过程。

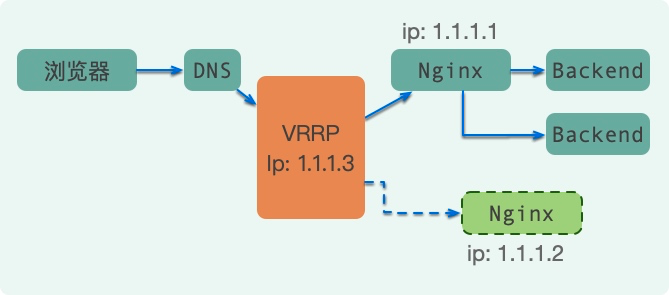
如图,使用keepalived组件,通过VRRP协议,即可完成最简单的高可用配置。

我们把DNS的地址绑定在VIP上,当正在服务的Nginx发生问题,VIP会发生漂移,转移到另外一台Nginx上。

可以看到,备份的Nginx,正常情况下是无法进行服务的,它也叫做影子节点,只有主Nginx发生问题的时候才有用。如果你的节点非常多,这种模式下,会有非常大的浪费。

除了浪费,还有一个非常大的问题。那就是,单台 Nginx 无论性能多么牛X,总是有上限的。当网卡的流量达到顶峰,接下来何去何从呢?

这种模式肯定是不满足需求的。

简单组合模式

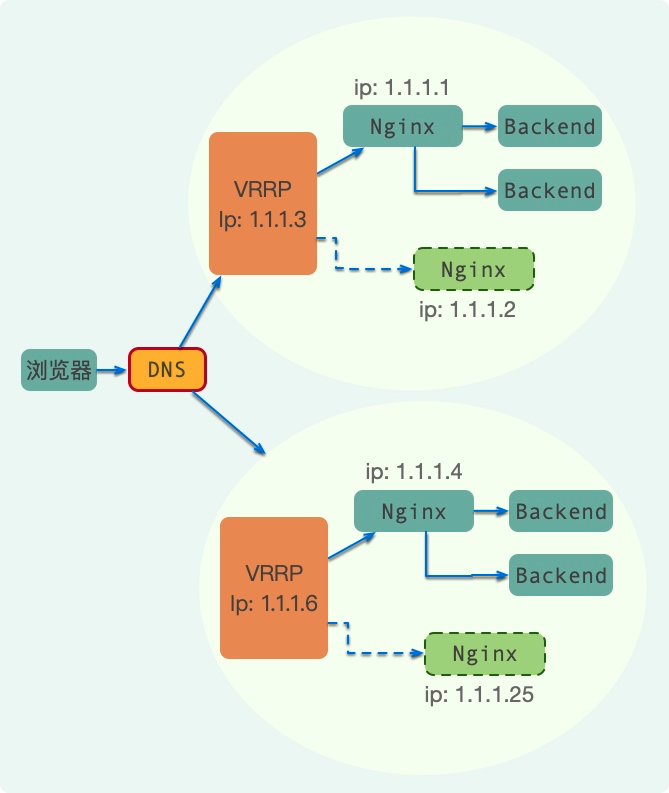
这个时候,我们就可以配合 DNS 解析,以及主备模式做文章了。如下图,DNS 解析到两个 VIP 上,VIP 本身也做了高可用。这样就能够缩短故障时间,同时也能够保证每个组件的高可用。

这种架构模式思路是非常清晰的,但依然存在影子节点的浪费。

LVS+KeepAlived+Nginx

LVSLinux Virtual Server 的简称,也就是 Linux 虚拟服务器。现在 LVS 已经是 Linux 标准内核的一部分,从 Linux2.4 内核以后,已经完全内置了 LVS 的各个功能模块,无需给内核打任何补丁,可以直接使用 LVS 提供的各种功能。

LVS 工作在 OSI 模型的第4层:传输层,比如 TCP/UDP,所以像7层网络的 HTTP 协议,它是识别不出来的。也就是说,我们不能拿 HTTP 协议的一些内容来控制路由,它的路由切入层次更低一些。

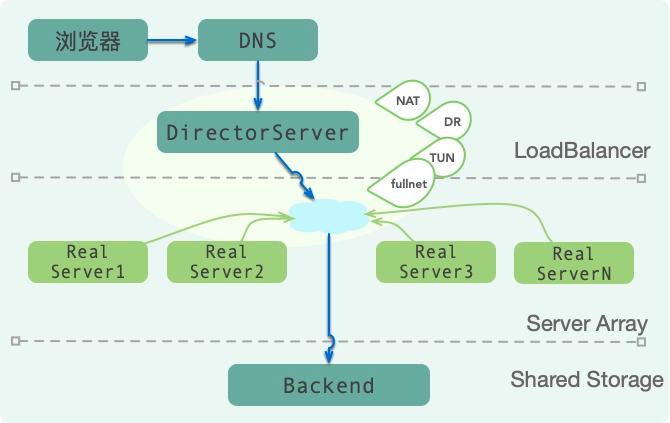
如下图,LVS 架设的服务器集群系统有三个部分组成:

  • 最前端的负载均衡层,用 Load Balancer 表示
  • 中间的服务器集群层,用 Server Array 表示
  • 最底端的数据共享存储层,用 Shared Storage 表示

DR(直接路由)模式可将响应数据包直接返回给用户浏览器,避免负载均衡服务器网卡带宽成为瓶颈,是目前采用最为广泛的方式(数据不详,fullnat模式使用也比较广泛)。

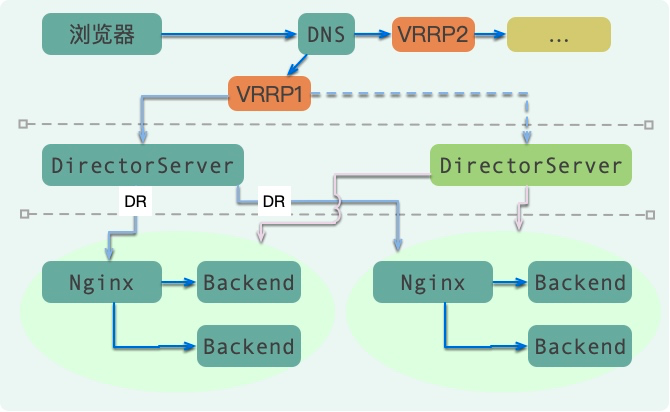
所以,配合 DNS 的负载均衡,加上LVS的负载均衡,可以实现双层的负载均衡和高可用。

如图,DNS 可以将请求绑定在 VIP 上。由于 LVS DR 模式的效率非常高,网卡要达到瓶颈也需要非常大的请求量(只有入口流量才走LVS),所以一般通过 LVS 做 nginx 的负载均衡就足够了。如果 LVS 还有瓶颈,那么就可以在 DNS 上再做文章。

还有哪些挑战?

其实,我们上面谈到的这些方案,大多数是在同机房的。如果在多个机房,如何让用户选择最快的节点、如何保证负载均衡,又是一个大的问题。另外,你可以看到数据包经过层层的转发和协调,还有多种负载均衡算法参与其中,如何保持会话,也是一个挑战。一般的,四层会话会通过 IP 地址去实现,七层会话会通过 cookie 或者头信息等去实现。

开发人员一般情况下接触不到这么入口级的东西,但一旦遇到了,可能会受忙脚乱。本文是xjjdog根据一些即有的经验进行整理,希望你在公司需要一些高可用方案的时候,能够助你一臂之力。

什么叫方案?你只需要 当时 把你的领导哄好,让他感觉很认同的样子就行了。至于要不要做,具体怎么做,那都是后面的事。君不见,扯了这么半天,很多企业其实一个nginx,就可以走天下。

以上就是W3Cschool编程狮关于HA(高可用)就像套娃,像胖子,剥掉一层还有一层的相关介绍了,希望对大家有所帮助。
Google鼓励的13条代码审查标准

thbcm阅读(324)

文章分享自公众号: DevOps云学堂

如何在代码审查方面表现出色

在本文中,我们将简要介绍13种代码审查标准,这些标准可以极大地帮助改善软件的运行状况并保持开发人员满意。

顾名思义,代码审查是一个过程,其中一个或多个开发人员审查或筛选另一位开发者(作者)编写的代码,以确保:

  • 代码没有任何错误或问题。
  • 符合所有质量要求和标准。
  • 代码执行了预期的测试。
  • 合并后,它将使代码库的运行状况保持更好。

这就是为什么代码审查是软件开发的关键部分的原因。代码审阅者充当代码库管理员,负责确定代码是否处于要成为代码库的一部分并进入生产的状态。

Google以其卓越的技术而著称,它们具有有效的代码审查标准,这些标准似乎突出了审查代码时要记住的一些要点。在Google,代码审查的主要目的是确保Google代码库的整体代码运行状况随着时间的推移而不断改善。

这是您在查看更改列表时要记住的事项列表。

审查标准

1.该代码改善了系统的整体运行状况

每个更改列表(Pull Request)都会改善系统的整体运行状况。想法是,由于进行了如此小的改进,每次合并后,软件或代码库的运行状况都会得到改善。

2.快速的代码审查,响应和反馈

首先,不要延迟推送(合并)更好的代码。不要指望代码是完美的。如果它的状况可以改善系统的整体运行状况,则请推送。

“这里的关键是没有’完美’的代码,只有更好的代码。”

如果您不在一项重点任务的中间,那么请在代码完成后立即进行检查;但是,一个工作日是响应拉取请求所需的最长时间。预计变更列表将在一天之内获得多轮的部分/完整代码审查。

3.在代码审查期间进行教育和启发

通过尽可能共享知识和经验,在代码审查期间提供指导。

4.审查代码时遵循标准

始终牢记,编码标准此类文档是代码审查期间的绝对权威。例如,要在制表符和空格之间保持一致性,可以引用编码约定。

5.解决代码审查冲突

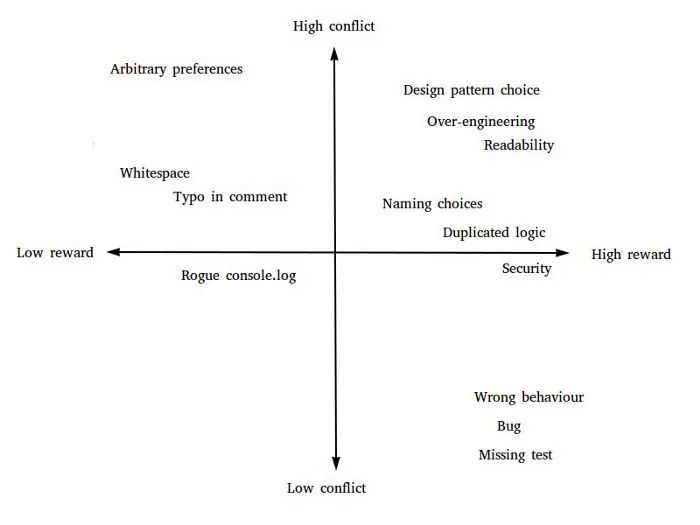
通过遵循样式指南和编码标准文档中商定的最佳实践,并寻求其他在产品领域具有更多知识和经验的人的建议,来解决冲突。根据严重性,处理冲突有所不同。

如果您的评论是可选的或次要的,请在评论中进行说明,然后由作者决定是解决还是忽略它们。作为代码审阅者,您至少可以建议在没有样式指南或编码标准的情况下,更改列表(请求)与其余代码库保持一致。

6.演示UI更改是代码审查的一部分

如果更改列表(Pull Request)更改了用户界面,则除了代码查看之外,还必须进行演示以确保外观上的所有外观均符合预期并与模拟匹配。

对于前端变更列表(Pull Request),始终建议进行演示/演练,或确保变更列表还包括必要的UI自动化测试,以验证添加/更新的功能。

7.确保代码审查伴随所有测试

除非紧急情况,否则拉取请求(更改列表)应伴随所有必要的测试,例如单元,集成,端到端等。

紧急情况可能是需要尽快修复的错误或安全漏洞,以后可以添加测试。在这种情况下,请确保创建了适当的问题,并确保有人在完成热修复或部署后立即拥有所有权才能完成。

没有足够的理由跳过测试。如果由于时间限制,某些目标有无法实现的风险,那么解决方案不是跳过测试,而是要对可交付成果进行范围界定。

8.专注时,不要打扰自己进行代码审查

如果您正处于重点工作中,请不要打扰自己,因为这可能需要很长时间才能恢复正常。换句话说,打断专注的开发人员所付出的代价比让开发人员等待代码审查要高得多。在计划的休息时间(例如午餐,咖啡等)之后进行代码检查。

期望并非总是在同一天完成并合并整个代码审查过程。重要的是迅速给作者一些反馈。例如,您可能无法进行完整的检查,但是您可以快速指出一些可以研究的内容。这将极大地减少代码审查期间的挫败感。

9.复习一切,不要做任何假设

查看分配给您检查的每一行代码。不要对人工编写的类和方法做任何假设,并且应该确保您了解代码在做什么。

确保了解您正在检查的代码。如果没有,请进行澄清或要求代码演练/解释。如果您有部分代码不具备审阅的资格,请确保还有其他合格的开发人员可以审阅代码的那些部分。

10.回顾代码时要顾全大局

从更广泛的背景来看变化通常是有帮助的。例如,更改了文件,并添加了四行代码。不要只查看四行代码;相反,请考虑查看整个文件并检查新添加的内容。它们会降低现有代码的质量,还是会使现有功能成为重构的候选对象?

如果不在函数/方法或类的上下文中检查此类简单的添加项,则随着时间的流逝,您将继承一个类,该类是不可维护的,超级复杂的,难以测试的,无法完成的所有工作,并且难以扩展或重构。

请记住,随着时间的推移,很少的改进加起来就可以产生具有最少数量缺陷的优质产品,同样,随着时间的流逝,轻微的代码降级或技术负担也会加重并导致产品难以维护和扩展。

11.认可并鼓励代码评审期间的良好工作

如果您在变更列表中看到了一些不错的东西,请别忘了喊出作者的出色作品并鼓励他们。这是我个人以前从未做过的事情。代码审查的目的不仅应该是发现错误,还应该鼓励和指导开发人员所做的出色工作。

12.在代码审查中要谨慎,尊重,友善和清晰

至关重要的是,在代码审阅期间,您要善良,清晰,礼貌和尊重,同时也要对作者非常清楚和乐于助人。查看代码时,请确保对代码而不是开发人员做出评论。

13.解释您的代码审查注释,并牢记范围

每当代码审阅意见提出替代方法或进行标记时,至关重要的是要解释原因并根据您的知识和经验提供示例,以帮助开发人员了解您的建议将如何帮助提高代码质量。

当建议修复或更改时,请在如何指导作者修复代码方面找到适当的平衡。例如,我很欣赏指导,解释,一些提示或建议,而不是整个解决方案。

以上就是W3Cschool编程狮关于Google鼓励的13条代码审查标准的相关介绍了,希望对大家有所帮助。
Java版本新发现:JDK15的14个新特性和变化

thbcm阅读(345)

Java Development Kit 15Oracle 对 Java SE(标准版)下一个版本的实现,已于8月初进入了发布候选阶段。JDK 15 的亮点包括文本块、隐藏类、外部内存访问 API ,以及密封类和记录的预览。

OpenJDK 15的新特性和变化包括:

1)外内存访问API(foreign-memory access API)

外内存访问 API 的第二个孵化器,它将使 Java 程序能够安全和有效地访问 Java 堆之外的外部内存。此 API 能够操作各种类型的外部内存,如本机、持久和托管堆。有许多 Java 程序是访问外部内存的,比如 IgniteMapDB。该API将有助于避免与垃圾收集相关的成本以及与跨进程共享内存以及通过将文件映射到内存来序列化和反序列化内存内容相关的不可预测性。该Java API目前没有为访问外部内存提供令人满意的解决方案。但是在新的提议中,API不应该破坏JVM的安全性。在JDK 14中,这个功能正在经历早期的孵化阶段,在JDK 15中还提供了改进。

2)密封类(sealed classes)的预览

与接口一样,密封类也限制其他类或接口可以扩展或实现它们。这个特性的目标包括——允许类或接口的作者来控制哪些代码负责实现、提供了比限制使用超类的访问修饰符声明方式更多选择,并通过支持对模式的详尽分析而支持模式匹配的未来发展。

3)相关支持的删除

删除对Solaris/SPARCSolaris/x64Linux/SPARC端口的源代码和构建支持,而在JDK 14中不赞成删除这些端口,但可在将来的版本中删除它们。许多正在开发的项目和功能(如Valhalla、Loom和Panama)需要进行重大更改以适应 CPU 架构和操作系统特定代码。放弃对SolarisSPARC端口的支持将使OpenJDK社区的贡献者加快开发新特性,从而推动平台向前发展。近年来,SolarisSPARC都被Linux操作系统和Intel处理器所取代。

4)记录结构(Records)

记录是充当不可变数据的透明载体类,在 JDK 14 中作为早期预览进行了首次调试之后,它将被包含在 JDK 15 的第二个预览版本中。计划的目标包括设计一个面向对象的结构,表达一个简单的聚合值,帮助程序员关注建模不可变的数据,而不是扩展行为,自动实现数据驱动的方法,如如equalsassessors,并保留 Java 中长期存在的原则,如名义类型和迁移兼容性 。Records(记录)可以被认为是名义元组。

5)数字签名算法

基于Edwards-Curve数字签名算法(EdDSA-Edwards-Curve Digital Signature Algorithm)的加密签名。EdDSA是一种现代的椭圆曲线方案,具有 JDK 中现有签名方案的优点。EdDSA将只在SunEC提供商中实现。EdDSA与其他签名方案相比,具有更高的安全性和性能,因此备受关注;它已经在OpenSSLBoringSSL等加密库中得到支持。

6)套接字的更新实现

通过将java.net.datagram.Socketjava.net.MulticastSocket API的底层实现替换为更简单、更现代的实现来重新实现遗留的DatagramSocket API。新的实现:

1.易于调试和维护;

2.与Project Loom中正在探索的虚拟线程协同。

新的计划是 JDK Enhancement Proposal 353的后续,该方案重新实现了遗留的套接字 API。java.net.datagram.Socketjava.net.MulticastSocket的当前实现可以追溯到 JDK 1.0,那时 IPv6 还在开发中。因此,当前的多播套接字实现尝试调和 IPv4 和 IPv6 难以维护的方式。

7)禁用偏向/偏置锁定

在默认情况下禁用偏向锁定,并弃用所有相关命令行选项。目标是确定是否需要继续支持偏置锁定的高维护成本的遗留同步优化,HotSpot虚拟机使用该优化来减少非竞争锁定的开销。尽管某些 Java 应用程序在禁用偏向锁后可能会出现性能下降,但偏向锁的性能提高通常不像以前那么明显。

8)instanceof模式匹配

此为第二个预览版,之前是 JDK 14 中的首次预览。模式匹配允许程序中的通用逻辑(主要是有条件地从对象中提取组件)得到更精确的表达。像Haskellc#这样的语言已经包含了模式匹配,因为它的简易性和安全性。

9)隐藏类(Hidden classes)

即不能被其他类的字节码直接使用的类,是为在运行时生成类并通过反射间接使用类的框架使用的。隐藏类可以定义为访问控制嵌套的成员,并且可以独立于其他类卸载。该提议将通过支持一个标准 API 来定义不可发现且生命周期有限的隐藏类,从而提高 JVM 上所有语言的效率。JDK 内部和外部的框架将能够动态生成类,而这些类可以定义隐藏类。许多构建在 JVM 上的语言都依赖动态类生成来获得灵活性和效率。这个提议的目标包括:允许框架将类定义为无法发现的框架实现细节,这样它们就不能被其他类链接,也不能通过反射被发现;支持扩展带有不可发现类的访问控制嵌套;并支持主动卸载不可发现的类,因此框架可以根据需要灵活地定义多个类。另一个目标是弃用非标准API misc.Unsafe::defineAnonymousClass,目的是为了在将来的版本中删除。另外, Java 语言不会因为这个建议而改变。

10)ZGC产品化

在这个提案下,Z垃圾收集器(ZGC-Z Garbage Collector)将从一个实验特性升级为产品。 ZGC 集成到2018年9月发布的JDK 11中,是一个可扩展的、低延迟的垃圾收集器。 ZGC 是作为一种实验性的功能引入的,因为 Java 开发人员决定应该小心地、逐步地引入这种规模和复杂性的特性。从那时起,添加了许多改进,从并发类卸载、未使用内存的解除提交、对类数据共享的支持到改进的 NUMA 感知和多线程堆预处理。此外,最大堆大小从4TB增加到16TB。支持的平台包括LinuxWindowsMacOS

11)文本块

JDK 14JDK 13中都预览版文本块,它旨在简化编写 Java 程序的任务,方法是简化表达跨越几行源代码的字符串,同时在常见情况下避免转义序列。文本块是一个多行字符串文字,它可以避免使用大多数转义序列、自动以可预测的方式格式化字符串,并在需要时为开发人员提供对格式的控制。文本块建议的一个目标是增强 Java 程序中表示用非J Java 语言编写的代码的字符串的可读性。另一个目标是通过规定任何新构造都可以将相同的字符串集表示为字符串文字,解释相同的转义序列,并以与字符串文字相同的方式操作,从而支持字符串文字的迁移。OpenJDK 开发人员希望添加转义序列来管理显式的空格和换行控件。

12)LPT GC正式可用

Shenandoah低暂停时间(low-pause-time)垃圾收集器将成为一个生产特性,不再处于实验阶段。它在一年前被集成到JDK 12中。

13)删除Nashorn

2014年3月在jdk8中首次亮相的Nashorn被移除,由于其被GraalVM等技术淘汰。OpenJDK 15 提议要求删除Nashorn APIs和用于调用Nashornjjs命令行工具。

14)RMI Activation进入不推荐期

不推荐 RMI 激活机制,以便将来删除。RMI 激活机制是 RMI 中一个过时的部分,自 Java 8 以来一直是可选的。RMI 激活机制增加了持续的维护负担。RMI 的其他部分将不被弃用。

JDK 15的早期访问版本可以在java.jdk.net网站中找到。JDK 15将是一个短期的特性发布,根据 Oracle 的6个月发布周期,它将被支持6个月。下一个长期支持(LTS-long-term support)版本是JDK 17,预计将于2021年9月发布,它将获得几年的支持。当前的LTS版本是JDK 11,是于2018年9月发布。

以上就是W3Cschool编程狮关于Java版本新发现:JDK15的14个新特性和变化的相关介绍了,希望对大家有所帮助。
Python 3中被忽视了的三大重要功能

thbcm阅读(304)

文章转载自公众号:读芯术

Python 3 上线已有一段时间,大多数开发人员(特别是那些首次编程的人)已经在使用它了。

不过,你确定已经对 Python 3 研究透彻了吗?事实上,其中还有许多新功能对大多数人来说仍处于未知状态。本文就将讨论 Python 3 中三个鲜为人知但非常有用的功能,我在其他语言中接触到并爱上了这些功能,它们的加入使得使 Python 3 体验更佳。

枚举

枚举是在 JavaSwift 中常使用到的功能,我把它扩展到Python中。在 Python 中创建枚举非常简单,在 Python 3 之前的版本中也可使用(尽管功能更受限):

from enum importEnum
             classState(Enum):
        AIR=0
        LAND=1
        SEA=2
        myState =State.AIR
             # Prints 0
      print(myState.value)
      # Prints AIR
      print(myState.name)

在上述代码中,可以看到通过构造一个类并使其成为枚举的子类,便可以轻松构造枚举。在这里只需在下面的行中定义每个状态。就我而言,我有 AIR、LAND、SEA。

Python 3 的新功能是运行.value.name。这能获得与状态相关联的整数值或与之相关联的字符串。

在上面的代码中,输入State.LAND.name 返回LAND,因此功能不仅仅是一个整数枚举。

当需要描述性常量时,代码中的枚举类型十分有用。例如,与其检查状态是 0 还是 1 ,不如检查它是否是State.MOVINGState.STATIONARY状态。常量可能会改变,如果有人在看你的代码,MOVING比 0 更有意义,代码的可读性也会大大提高。

格式

Python 3.6中添加的fstring是格式化文本的一种很好的方式。它们的可读性强,而且不容易出错。fstringPython以前使用的格式更易读。以下是使用格式的示例:

name = Brett 
       blog_title = Medium 
             # Hi, my name isBrett and I am writing on my Medium blog.
       a ="Hi, myname is {} and I am writing on my {} blog.".format(name,blog_title)

如上所示,在字符串中打入括号,然后按顺序列出每个变量的名称。相同代码任务很多,但fstring极大地增加了代码的可读性,尤其是类似于用Swift格式化字符串。

name = Brett 
       blog_title = Medium
             # Hi, my name isBrett and I am writing on my Medium blog.
       a =f"Hi, myname is {name} and I am writing on my {blog_title} blog."

为了完成这个更简洁的字符串,只需在引号前面加上字母 f ,然后将变量或数据直接放入括号中,而不是使用空括号。由于变量本身是写在括号内的,所以不必计算格式中写入的项的数量来确定变量的位置,变量就在应在的位置。

相比于字符串连接或格式化字符串,fstring可以生成更可读、更可靠的代码。

数据类

数据类可能要比上述所谈更为晦涩难懂,所以我将简要地解释一下。我在Kotlin中逐渐喜欢上了数据类,因此很想在Python中使用它们。

数据类实际上是一个类,其唯一目的是保存数据的类。类将具有可以访问和写入的变量,但上面没有额外的逻辑。

假设你有一个程序,在不同的类之间传递一个字符串和一个数字数组。使用pass(str,arr)这样的方法也可行,最好是创建一个只包含字符串作为字段和数组的数据类。通过创建一个数据类,你所做的将更加清晰,单元测试也将更加容易。

下面这个示例将说明如何创建一个表示三维向量的简单数据类,但这可以很容易地扩展为表示不同数据的任意组合:

from dataclasses import dataclass
             # Definedataclass
           @dataclass
           classVector3D:
              x: int
              y: int
              z: int


           # Create a vector
           u =Vector3D(1,1,-1)
             # Outputs: Vector3D(x=1,y=1, z=-1)
           print(u)

在这里,你可以看到数据类的定义与声明普通类非常相似,只是我们先用了@dataclass,然后每个字段的名称都是name:type

虽然我们创建的Vector3D功能有限,但是数据类的目的只是提高效率并减少代码中的错误,传递Vector3D比传递int变量要好得多。

以上就是W3Cschool编程狮关于Python 3中被忽视了的三大重要功能的相关介绍了,希望对大家有所帮助。
联系我们