进程和线程的区别:理解多任务处理的基本概念

thbcm阅读(276)

在计算机科学领域,进程和线程是多任务处理的基本概念。虽然它们都代表了可以同时执行的任务,但它们在实现方式、资源管理和执行上有着重要的区别。本文将详细介绍进程和线程的定义、特点和区别,帮助读者更好地理解这两个概念。

进程

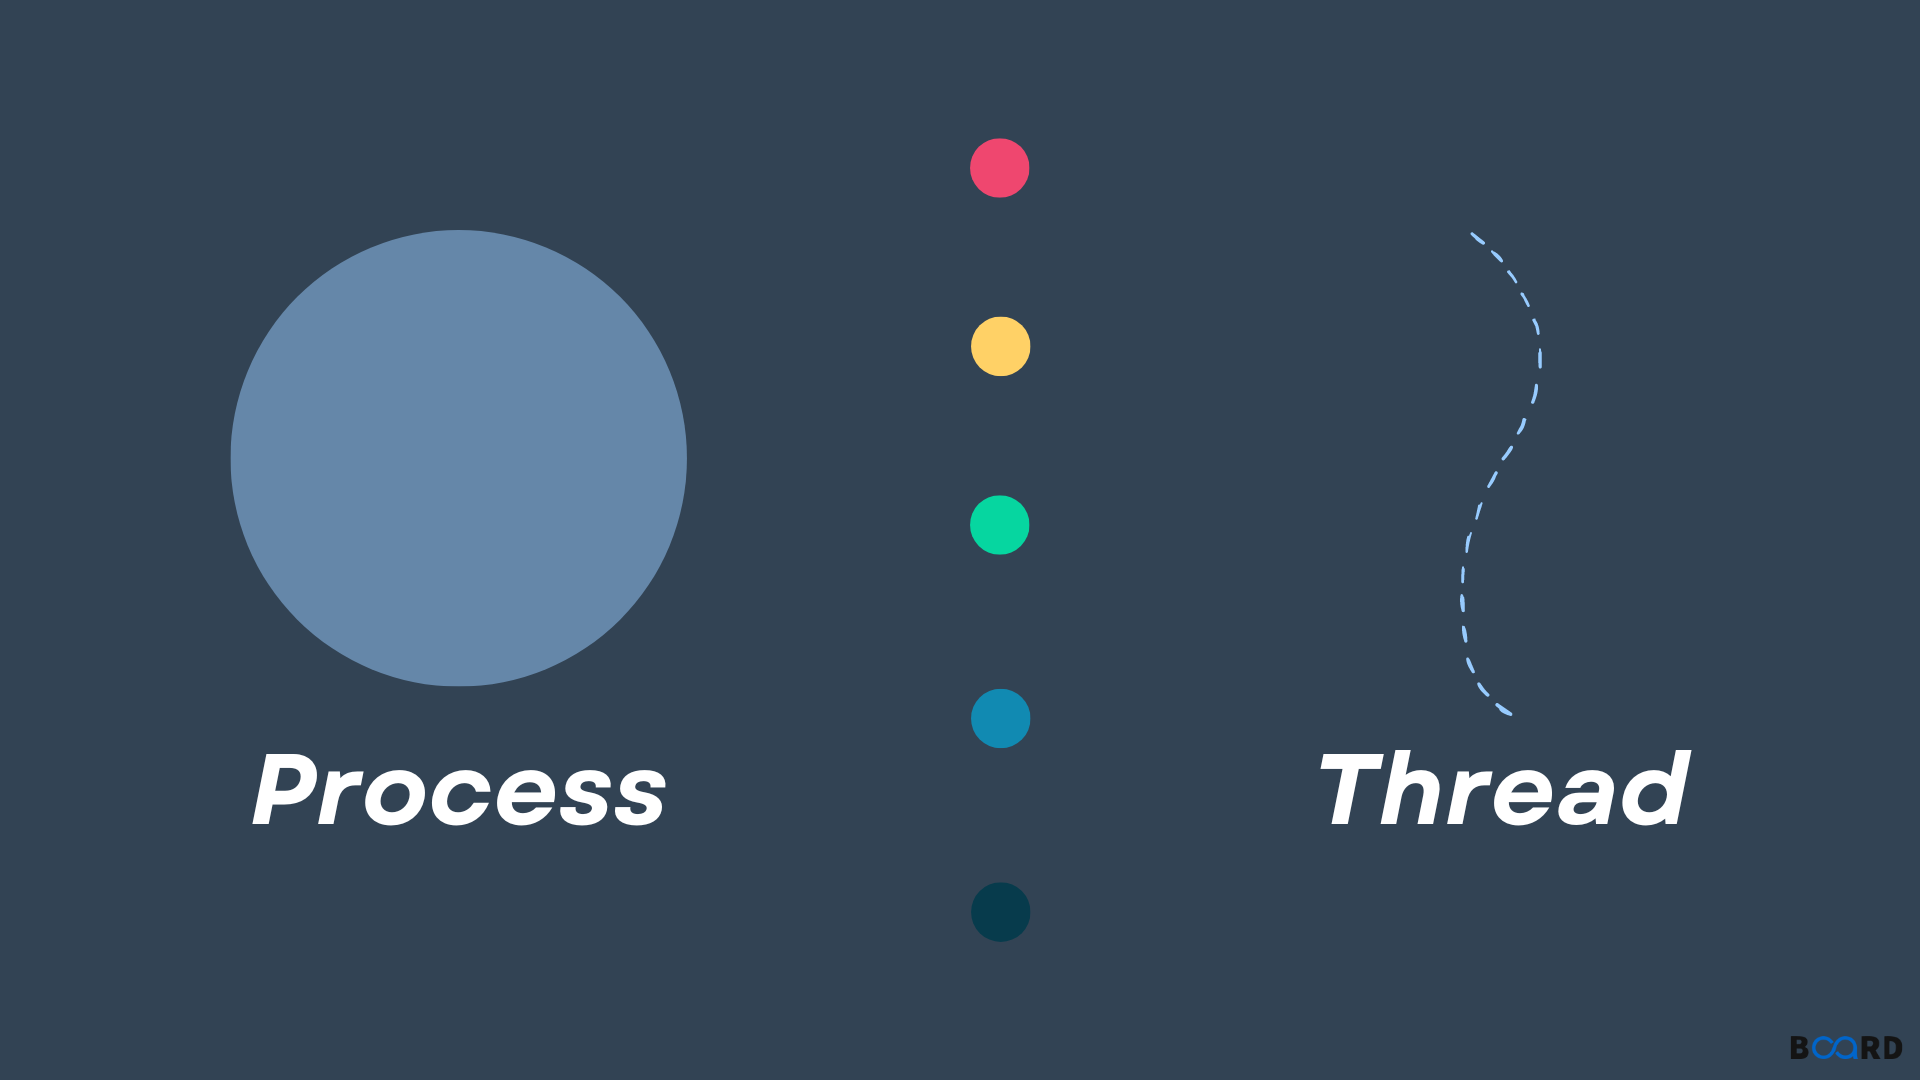
进程是操作系统中的一个执行单元,可以看作是一个正在运行的程序的实例。每个进程都有自己的地址空间、系统资源和执行状态。以下是进程的主要特点:

  • 独立性:每个进程都是独立运行的实体,它们之间彼此隔离,相互之间不共享内存和资源。
  • 资源分配:每个进程拥有独立的系统资源,如内存、文件描述符和设备句柄等。进程可以申请和释放资源,操作系统负责管理和分配这些资源。
  • 调度和切换:操作系统通过进程调度算法来决定哪个进程在给定的时间片内执行。进程切换涉及保存和恢复进程的上下文,这是一种开销较大的操作。
线程

线程是进程内的一个执行单位,它与其他线程共享相同的地址空间和系统资源。一个进程可以包含多个线程,线程之间可以并发执行不同的任务。以下是线程的主要特点:

  • 共享性:线程之间共享所属进程的地址空间和资源,它们可以访问相同的变量和数据结构。这使得线程之间的通信和数据共享更加方便和高效。
  • 调度和切换:线程调度和切换相对于进程来说更加轻量级。由于线程共享资源,切换线程的开销较小,因此线程切换的速度更快。
  • 行单元:线程是进程内的执行单元,它可以独立执行任务。不同的线程可以并发执行,从而实现多任务处理。
进程和线程的区别

进程和线程之间有以下主要区别:

资源和开销

  • 进程是独立的执行实体,每个进程都有自己的资源和开销。它们之间的通信和数据共享需要通过进程间通信(IPC)机制,如管道、消息队列和共享内存等。进程切换的开销较大,因为需要保存和恢复进程的完整上下文。
  • 线程是进程内的执行单位,共享相同的资源和开销。线程之间可以通过共享内存来进行通信和数据共享,这使得线程之间的通信更加高效。线程切换的开销较小,因为只需要保存和恢复线程的部分上下文。

并发性和扩展性

  • 由于进程之间相互独立,每个进程都有自己的地址空间,因此进程之间的并发性较低。进程的创建和销毁开销较大,对系统资源的管理较为复杂。
  • 线程之间共享相同的地址空间和资源,因此线程之间的并发性更高。线程的创建和销毁开销较小,使得线程的切换更加轻量级。线程的扩展性也更好,可以更容易地实现并行计算和多核处理。

安全

  • 进程间的安全性较高,因为它们彼此隔离,不共享内存和资源。每个进程有自己的地址空间,因此一个进程的错误不会直接影响其他进程。
  • 线程之间共享相同的地址空间和资源,因此线程之间的安全性较低。一个线程的错误可能会影响同一进程内的其他线程,导致数据竞争和不一致的结果。
总结

进程和线程是多任务处理的重要概念,它们在资源管理、执行和安全性等方面有着明显的区别。进程是独立的执行实体,每个进程有自己的地址空间和资源。进程之间彼此隔离,通信和数据共享需要通过进程间通信机制。进程切换的开销较大,适合处理相对独立的任务。线程是进程内的执行单位,共享相同的地址空间和资源。线程之间可以并发执行不同的任务,通过共享内存进行通信和数据共享。线程切换的开销较小,适合处理并发性较高的任务。理解进程和线程的区别对于合理设计和编写多任务处理的程序非常重要,可以充分利用计算机资源,提高程序的性能和效率。
C++中的volatile:穿越编译器的屏障

thbcm阅读(282)

在C++编程中,我们经常会遇到需要与硬件交互或多线程环境下访问共享数据的情况。为了确保程序的正确性和可预测性,C++提供了关键字volatile来修饰变量。本文将深入解析C++中的volatile关键字,介绍其作用、使用场景以及与多线程编程相关的注意事项。

volatile关键字的作用

volatile是C++中的一个关键字,用于修饰变量,告知编译器该变量的值可能会在意料之外的情况下被修改,从而禁止对该变量进行某些优化。主要作用如下:

  • 禁止编译器优化:编译器在优化代码时可能会对变量进行一些假设,比如认为变量的值不会被其他代码修改,从而进行一些优化操作,如寄存器缓存、重排指令等。使用volatile关键字可以告诉编译器不要对该变量进行优化,强制从内存中读取变量的值,确保程序的行为符合预期。
  • 与硬件交互:在与硬件交互的场景中,特定的变量可能会被硬件设备修改,而这个修改的过程不受程序的控制。使用volatile关键字可以确保在每次访问该变量时都从内存中读取最新的值,而不是使用缓存的旧值。
  • 多线程环境下的数据共享:在多线程编程中,多个线程可能同时访问共享数据。如果一个变量被多个线程共享,并且至少有一个线程对其进行写操作,那么需要使用volatile关键字来确保对该变量的读写操作都是可见的,避免出现数据不一致的情况。

volatile关键字的使用场景

下面是一些常见的使用场景,适合使用volatile关键字:

  • 访问硬件寄存器:当我们需要访问硬件设备的寄存器时,这些寄存器的值可能会在任何时刻被修改。为了确保每次访问都能获得最新的值,应该使用volatile修饰对应的变量。
    volatile int *deviceRegister = (volatile int *)0x1234; // 假设0x1234是一个硬件寄存器的地址
    int value = *deviceRegister; // 从硬件寄存器读取最新的值
  • 多线程共享变量:在多线程编程中,如果多个线程同时访问共享变量,且至少有一个线程对其进行写操作,应该使用volatile关键字来确保对该变量的读写操作的可见性。
    volatile int sharedVariable; // 多个线程共享的变量
    
    // 线程1
    sharedVariable = 10;
    
    // 线程2
    int value = sharedVariable; // 从内存中读取最新的值

volatile与多线程编程的注意事项

在多线程编程中,使用volatile关键字并不能保证线程安全。volatile只能确保对变量的读写操作的可见性,但无法解决并发访问的问题。以下是一些与多线程编程相关的注意事项:

  • 原子性问题:volatile关键字不能保证对变量的复合操作的原子性。如果需要在多线程环境下进行原子操作,应该使用互斥锁、原子操作等线程同步机制。
  • 内存顺序问题:volatile关键字不能解决内存顺序问题,即多个线程对共享变量的操作可能会出现乱序执行的情况。为了保证正确的内存顺序,需要使用原子操作或显式的内存屏障指令来进行同步。
  • 使用原子类型:在C++11及更高版本中,可以使用std::atomic模板类来实现对共享变量的原子操作,它提供了更强大的原子操作支持,并且能够保证线程安全。
    std::atomic<int> sharedVariable; // 多个线程共享的变量
    
    // 线程1
    sharedVariable.store(10);
    
    // 线程2
    int value = sharedVariable.load(); // 从内存中读取最新的值

总结

volatile关键字在C++中用于修饰变量,用于告知编译器该变量的值可能会在意料之外的情况下被修改。它主要用于禁止编译器优化、与硬件交互以及多线程环境下的数据共享。然而,使用volatile关键字并不能解决所有的多线程问题,需要结合其他线程同步机制来确保线程安全。在C++11及更高版本中,推荐使用std::atomic模板类来进行原子操作和线程安全编程。

JavaScript中的变量监听:实时捕捉变化的利器

thbcm阅读(315)

在JavaScript开发中,经常需要监听变量的改变,并在变量值发生变化时执行相应的操作。这种实时捕捉变化的功能对于构建交互性强的应用程序至关重要。本文将介绍如何在JavaScript中监听变量的改变,以及常用的方法和技巧,帮助你更好地利用这个强大的特性。

JavaScript中监听变量的好处

  • 实时更新UI:监听变量的改变可以帮助我们实时更新用户界面(UI)。例如,在一个表单中,当用户输入或选择某个值时,我们可以监听相应的变量,并在变量改变时立即更新UI,以提供实时的反馈和交互体验。
  • 数据绑定:变量的改变往往与应用程序中其他部分的状态和数据有关联。通过监听变量的改变,我们可以实现数据绑定,确保相关数据的一致性。当变量的值改变时,我们可以自动更新与之相关联的数据,以保持应用程序的状态同步。
  • 触发特定操作:在某些情况下,我们希望在变量的值发生改变时执行特定的操作或逻辑。通过监听变量的改变,我们可以捕捉到变化的事件,并在事件发生时触发相应的操作。例如,在游戏中,当玩家的得分变化时,我们可以监听得分变量,并在得分改变时更新游戏界面或执行其他与得分相关的逻辑。
  • 数据验证:在表单验证和数据处理中,监听变量的改变可以帮助我们实时验证数据的有效性。当用户输入或更改数据时,我们可以监听相应的变量,并在变量改变时立即进行数据验证,以提供及时的错误提示和反馈。
  • 监控和调试:通过监听变量的改变,我们可以实时监控应用程序的状态和数据流动,帮助我们调试和排查问题。当变量的值改变时,我们可以记录日志、打印调试信息或触发断点,以便更好地理解应用程序的行为和状态。

Getter和Setter方法

JavaScript提供了Getter和Setter方法,可以用于在获取和设置变量值时执行自定义的操作。通过这种方式,我们可以捕捉变量的改变,并在变化时执行相应的逻辑。

let _name = '';

// 定义Getter和Setter方法
Object.defineProperty(this, 'name', {
  get: function() {
    return _name;
  },
  set: function(value) {
    _name = value;
    console.log('变量name发生了改变');
    // 执行其他操作
  }
});

// 设置变量值
this.name = 'John';

在这个例子中,我们使用Object.defineProperty()方法定义了一个名为name的属性,其中包括了Getter和Setter方法。当设置name属性的值时,Setter方法会被触发,我们可以在Setter方法中编写自定义的操作。在这个例子中,我们在Setter方法中添加了一条打印语句,用于捕捉变量name的改变。

Proxy对象

ES6引入的Proxy对象是JavaScript中的另一个强大工具,可以用于监听对象的操作,并在操作发生时执行相应的逻辑。通过Proxy对象,我们可以监听变量的改变,并在变化时触发回调函数。

let data = {
  name: 'John'
};

// 创建一个Proxy对象
let proxy = new Proxy(data, {
  set: function(target, key, value) {
    target[key] = value;
    console.log(`变量${key}发生了改变`);
    // 执行其他操作
    return true;
  }
});

// 设置变量值
proxy.name = 'Jane';

在这个例子中,我们使用new Proxy()语法创建了一个Proxy对象,其中定义了一个set方法。当设置Proxy对象的属性值时,set方法会被触发,我们可以在set方法中编写自定义的操作。在这个例子中,我们通过设置Proxy对象的name属性值来捕捉变量改变的事件,并触发相应的回调函数。

监听DOM元素的改变

除了监听变量的改变,我们还可以监听DOM元素的改变。JavaScript提供了MutationObserver接口,用于监听DOM树的变化,并在变化发生时执行相应的操作。

// 目标元素
let target = document.getElementById('my-element');

// 创建一个MutationObserver实例
let observer = new MutationObserver(function(mutations) {
  mutations.forEach(function(mutation) {
    console.log('DOM元素发生了改变');
    // 执行其他操作
  });
});

// 配置观察选项
let config = { attributes: true, childList: true, subtree: true };

// 开始观察目标元素
observer.observe(target, config);

在这个例子中,我们首先通过document.getElementById()获取目标元素,然后创建了一个MutationObserver实例,并定义了一个回调函数。回调函数会在观察的DOM元素发生变化时被触发,我们可以在其中编写自定义的操作。最后,通过调用observe()方法,将目标元素和观察选项传递给MutationObserver实例,开始监听DOM元素的改变。

总结

通过Getter和Setter方法、Proxy对象以及MutationObserver接口,JavaScript提供了多种方式来监听变量的改变。这些方法使开发者能够实时捕捉变化,并在变量值发生改变时执行相应的操作。无论是构建交互性强的应用程序、实现数据绑定还是监听DOM元素的改变,这些技巧都是非常有用的。希望本文对你理解如何在JavaScript中监听变量改变有所帮助,并能在实际开发中灵活运用这些技术,提升应用程序的交互性和响应性。

拯救中文乱码!Java开发者必备解决方案!

thbcm阅读(269)

在Java开发中,中文乱码问题是一个常见而又令人头疼的难题。本文将深入分析Java中文乱码问题的原因,并提供一些解决方案,帮助开发者解决中文乱码困扰,确保程序能够正确处理中文字符。

字符集和编码概念

  • 字符集(Charset):字符集是字符的集合,用于表示文本中的字符。常见的字符集包括UTF-8、UTF-16、GBK等。 
  • 编码(Encoding):编码是将字符集中的字符映射为二进制数据的过程。不同的编码方式会产生不同的字节序列。

中文乱码问题的原因

中文乱码通常是由于字符编码不一致或不正确的处理所引起的。以下是几个常见的中文乱码问题的原因:

  • 字符编码不匹配:Java使用Unicode字符集来表示字符,而在传输、存储或显示过程中,需要将Unicode字符转换为特定的编码格式,如UTF-8、GBK等。如果在不同的环境中对字符的编码方式不一致,就会导致中文乱码。
  • 文件编码问题:当使用不同的文本编辑器打开或保存一个文本文件时,可能会导致文件的编码方式发生变化。如果文件的编码方式与Java代码中使用的编码方式不一致,读取文件内容时就可能出现中文乱码。
  • 数据库编码设置错误:如果在与数据库进行数据交互时,数据库的编码设置与Java代码中的编码方式不匹配,读取或写入包含中文字符的数据时就会出现乱码。

解决中文乱码问题的常用方法

为了解决中文乱码问题,可以采取以下几种常用的方法:

  • 确定正确的字符编码:首先,需要确保在所有涉及中文字符处理的环节中,使用一致且正确的字符编码。常用的字符编码包括UTF-8、GBK、ISO-8859-1等。确保代码中使用的字符编码与其他环境(如数据库、文本文件)中的编码方式保持一致。
  • 字符串编码转换:如果遇到已经出现乱码的字符串,可以使用Java提供的字符编码转换功能进行修复。可以使用String类的构造函数或​getBytes()​方法来将字符串从一种编码转换为另一种编码。
  • 文件编码设置:在处理文本文件时,确保文件的编码方式与代码中的编码方式一致。可以通过指定编码方式来读取或写入文件内容。
  • 数据库编码设置:在与数据库交互时,需要确保数据库的编码设置与代码中的编码方式一致。可以在连接数据库时指定编码方式,或者通过修改数据库的默认编码设置来解决中文乱码问题。

总结

中文乱码问题是Java开发中常见的挑战之一。为了避免和解决中文乱码问题,开发者需要确保字符编码一致、字符串编码转换正确、文件编码设置准确以及数据库编码设置正确。通过正确处理字符编码,我们能够确保Java程序能够正确地处理和显示中文字符,提升应用的用户体验和可靠性。

aiofiles:解锁异步文件操作的神器

thbcm阅读(296)

在Python的异步编程领域,文件操作一直是一个具有挑战性的任务。传统的文件操作函数在异步环境下无法发挥其最大的潜力,而aiofiles库应运而生。aiofiles是一个针对异步I/O操作的Python库,它简化了异步文件处理的复杂性,并提供了高效、可靠的解决方案。本文将介绍aiofiles库的功能和特点,并通过实例演示其在异步文件处理中的应用。无论是异步读取还是写入文件,aiofiles都将带给您高效、可靠的解决方案。

aiofiles是什么?

aiofiles是一个Python库,它让文件读写操作可以在异步程序中使用。它是基于Python的asyncio库构建的,asyncio是Python标准库中的一个用于编写并发代码的模块。简单来说,aiofiles就是为了让你能够在不阻塞事件循环的前提下,进行文件的读写操作。

aiofiles库的功能和特点

aiofiles库提供了一组异步文件操作函数,包括异步读取、写入、追加、删除等。以下是aiofiles库的主要功能和特点:

  • 异步支持:aiofiles库充分利用了Python的asyncio库,提供了异步版本的文件操作函数。这使得您可以在异步程序中实现高效的文件处理操作,而无需担心阻塞和线程管理的问题。
  • 易于使用:aiofiles的API设计简洁明了,与Python的内置文件操作函数兼容度高。这意味着您可以轻松地将现有的同步文件操作代码迁移到异步环境中,而无需太多修改。
  • 高性能:aiofiles库使用了底层的异步文件I/O机制,充分发挥了异步编程的优势。相比于传统的同步文件操作,aiofiles在处理大型文件或高并发场景下表现更出色,提供更好的性能和响应能力。
  • 异常处理:aiofiles库提供了对文件操作中常见异常的处理机制。它使用Python的异常处理机制,使您可以轻松地捕获和处理文件操作中可能出现的错误情况,确保程序的稳定性和可靠性。

aiofiles的使用示例

下面通过几个示例演示aiofiles库在异步文件处理中的应用:

安装aiofiles

pip install aiofiles

异步读取文件

import aiofiles
import asyncio

async def read_file():
    async with aiofiles.open('file.txt', mode='r') as f:
        contents = await f.read()
        print(contents)

asyncio.run(read_file())

异步写入文件

import aiofiles
import asyncio

async def write_file():
    async with aiofiles.open('file.txt', mode='w') as f:
        await f.write('Hello, aiofiles!')

asyncio.run(write_file())

异步追加文件

import aiofiles
import asyncio

async def append_file():
    async with aiofiles.open('file.txt', mode='a') as f:
        await f.write('This is an appended line.')

asyncio.run(append_file())

总结

aiofiles是一个强大的Python库,为异步文件处理提供了便捷、高效的解决方案。通过利用aiofiles的异步文件操作函数,您可以轻松地在异步编程环境中处理文件的读取、写入和追加等操作。其优势在于异步支持、易用性、高性能和异常处理。无论是处理大型文件、高并发的文件操作,还是在异步编程中需要进行文件处理,aiofiles都是您的绝佳选择。

窥探俄罗斯人的世界级软件奇迹

thbcm阅读(306)

俄罗斯在软件开发领域拥有令人瞩目的实力,许多世界级软件的成功故事都源自这个国家。本文将介绍几个俄罗斯人的世界级软件,包括Kaspersky、Yandex、Telegram等,揭示其在安全、搜索、通信等领域的杰出贡献和全球影响力。

俄罗斯作为一个技术实力雄厚的国家,在软件开发领域展现出了令人瞩目的成就。许多世界级软件的成功故事都与俄罗斯人的智慧和创新力息息相关。下面介绍几个俄罗斯人的世界级软件,它们在各自领域取得了巨大的成功,并为全球用户带来了极大的便利和影响力。

Kaspersky

Kaspersky是全球知名的网络安全公司,成立于1997年,由俄罗斯的尤金·卡巴谢夫(Eugene Kaspersky)创立。Kaspersky Lab开发了一系列优秀的安全产品,包括反病毒软件、防火墙和网络安全解决方案等。其产品以卓越的恶意软件检测和防护能力而闻名,并在全球范围内受到广泛的认可和信赖。Kaspersky的成功证明了俄罗斯在网络安全领域的杰出技术实力。

Yandex

Yandex是俄罗斯最大的互联网公司之一,也是俄语搜索引擎的领军者。类似于谷歌,Yandex提供了广泛的搜索服务,包括网页搜索、图片搜索、新闻搜索等。此外,Yandex还涉足在线广告、地图导航、音乐流媒体等领域。该公司的技术实力和创新能力使其成为俄罗斯互联网行业的领导者,并且在国际市场上有一定的影响力。

Telegram

Telegram是一款由俄罗斯企业家帕维尔·杜罗夫(Pavel Durov)开发的即时通讯应用程序。这个应用程序以其强大的加密功能和高度私密性而闻名,成为一种安全和可靠的通信工具。Telegram提供了文本消息、语音通话、文件传输等功能,并且具有用户友好的界面和丰富的扩展性。该应用程序在全球范围内拥有庞大的用户群体,并在保护用户数据和隐私方面赢得了用户的信任。

JetBrains

JetBrains是一家俄罗斯软件开发工具公司,以其出色的集成开发环境(IDE)而闻名。该公司开发了一系列受欢迎的开发工具,如PyCharm、IntelliJ IDEA、WebStorm等。这些工具在软件开发领域广泛应用,为开发人员提供了高效、智能的开发环境和丰富的功能。JetBrains的产品受到全球开发者的认可和喜爱,为俄罗斯软件开发行业赢得了极高的声誉。

7-zip

7-Zip是一款由俄罗斯软件工程师伊戈尔·帕夫洛夫(Igor Pavlov)开发的开源压缩和解压缩软件。它支持多种压缩格式,包括7z、ZIP、RAR、GZIP等,并具有出色的压缩比和快速的解压速度。7-Zip在全球范围内广受欢迎,被许多用户和开发者用于文件压缩、备份和归档。

Nginx

Nginx(发音为”engine x”)是一款由俄罗斯人创建和开发的高性能Web服务器软件。它采用异步、事件驱动的架构,能够高效地处理大量并发连接。Nginx在处理静态文件、反向代理和负载均衡方面表现出色,成为许多网站和应用程序的首选服务器软件。

俄罗斯方块

俄罗斯方块是一款经典的电子游戏,由俄罗斯人阿列克谢·帕基特诺夫(Alexey Pajitnov)在1984年创造。这款游戏通过移动和旋转不同形状的方块,使它们在底部形成完整的水平行,以消除方块并得分。俄罗斯方块在全球范围内广受欢迎,并成为了一种经典的休闲游戏。

总结

俄罗斯的世界级软件在各自领域展现出了令人瞩目的实力和创新能力。从网络安全到搜索引擎,再到通信工具和开发工具,这些软件为全球用户提供了安全、便利和高效的解决方案。不仅在俄罗斯国内赢得了用户的信赖和认可,这些软件还在国际市场上展现出了强大的影响力。这些软件的成功离不开俄罗斯软件开发者们的智慧和创新。他们不仅注重技术的发展和创新,还致力于提供高质量的产品和用户体验。他们的努力和成就不仅为俄罗斯软件行业树立了榜样,也为全球的软件开发者们提供了启示。随着技术的不断进步和全球化的趋势,俄罗斯人大众的世界级软件将继续发展壮大。无论是在安全领域、搜索领域还是通信和开发工具领域,俄罗斯的软件开发者们将继续创造出更多令人惊叹的软件奇迹,为全球用户带来更多便利和创新。

C++编程的终极对决:const vs. #define

thbcm阅读(295)

C++编程中的常量定义方式一直是个讨论的热点话题。在这场终极对决中,我们将探索const和#define两种常量定义方式的优势和劣势。通过深入剖析作用域、类型检查、编译时期和代码调试等方面的差异,帮助您选择最佳的常量定义策略,以提高代码质量和可维护性。

使用 const 定义常量

  • 类型安全:const​ 定义的常量具有明确的类型,可以进行类型检查。这有助于避免类型相关的错误。
  • 作用域限制:const​ 定义的常量有特定的作用域,通常是在它被声明的块中。这有助于避免命名冲突,并增加了代码的可维护性。
  • 调试友好:const​ 定义的常量在调试过程中可以被看到,因为它们是符号名称。
  • 内存分配:const​ 常量通常会分配存储空间(尽管编译器可能会优化),可以取地址。
示例:
const int MAX_VALUE = 100;

使用 #define 定义常量

  • 预处理器指令:#define​ 是一个预处理器指令,用于在编译之前替换文本。它不进行类型检查,也没有数据类型。
  • 全局替换:#define​ 创建的宏在它被定义后的所有地方有效,直到被​#undef​指令取消或文件结束。
  • 不占用存储空间:宏通常不分配存储空间,因为它们在编译前就被替换成相应的值或表达式。
  • 可能导致意外的行为:由于文本替换的方式,​#define​ 宏可能导致一些意外的行为,尤其是在复杂的表达式中。
示例:
#define MAX_VALUE 100

区别总结

  • 类型安全:const​ 比 ​#define​ 提供更好的类型安全。
  • 作用域控制:const​ 变量有特定的作用域,而 ​#define​ 没有作用域概念,它是全局替换。
  • 调试:const​ 常量在调试时更容易追踪。
  • 内存分配:const​ 可能会占用存储空间,而 ​#define​ 不会。
  • 编译器优化:现代编译器通常能够对 ​const​ 常量进行优化,尤其是在它们没有被取地址时。

因此,在C++中,通常推荐使用​const​来定义常量,因为它提供了更好的类型安全、作用域控制和调试能力。然而,在某些特殊情况下,例如当需要定义宏函数或进行条件编译时,​#define​ 仍然非常有用。

什么时候用 const 、什么时候用 define ?

  • 使用 ​const​:当你需要定义一个具有特定类型的不变值,并且这个值只在某个特定区域(比如一个函数或类中)有效时。例如,你想在一个函数中定义一个不会改变的整数或浮点数:
    const int maxUsers = 100;
    const double pi = 3.14159;

    const 保证了类型安全(比如你不能不小心把字符串赋给一个整数类型的 const),并且让代码更容易理解和维护。

  • 使用 define当你需要定义一个全局常量,或者需要创建一个宏(比如一个简单的代码片段)时。这种情况下,类型不是主要关注点,而且这个值或代码片段将在整个程序中有效。

    #define PI 3.14159
    #define MAX(a, b) ((a) > (b) ? (a) : (b))

    define 是在编译之前进行文本替换,所以它不关心类型安全,也不受作用域的限制。

总结

const​和​#define​在C++中用于定义常量,但它们有着明显的区别。​const​常量具有作用域、类型检查、编译时期和代码调试等优势,能够提高代码的可读性、可维护性和可调试性。相比之下,使用​#define​定义的常量在处理作用域、类型检查和调试方面存在一些限制和不便。因此,在C++编程中,推荐使用​const​来定义常量,以获得更好的代码质量和可维护性。只有在特定情况下,如宏定义和条件编译等需要使用​#define​时,才应该考虑使用它来定义常量。关键是根据具体需求和上述区别,选择适合的常量定义方式,以提高代码的可读性和可维护性。

htmx:简化前端开发的现代Web技术

thbcm阅读(305)

htmx是一种经过设计的JavaScript库,旨在简化前端开发中的交互性操作。本文将介绍htmx的概念、原理和关键特性,以及它在实际项目中的应用和优势。通过了解htmx,您将发现如何使用这一现代Web技术提高开发效率和用户体验。

htmx是什么?

htmx是一个轻量级的JavaScript库,构建在现有Web标准(HTML、CSS和JavaScript)之上。它通过简化前端开发中的交互性操作,提供了一种更简单、更灵活的方式来构建现代Web应用。

关键特性

  • 基于HTML:htmx使用HTML扩展属性(称为HX属性)来标记和定义交互行为,使得开发人员能够直观地将交互操作与现有的HTML结构集成在一起。
  • 轻量级:htmx的核心库非常小巧,仅需几KB的文件大小,可以轻松集成到现有项目中,无需引入庞大的前端框架。
  • 无依赖性:htmx不依赖于特定的后端技术或框架,可以与任何服务器端编程语言和框架一起使用,为开发人员提供了更大的灵活性和选择性。

原理

htmx利用现代Web标准中的一些关键特性,如XMLHttpRequest、Fetch API和服务器发送事件(SSE),来实现实时数据更新和局部刷新。它通过监听浏览器事件和处理服务器返回的数据,动态地更新Web页面的内容,从而提供交互性操作。

应用场景

htmx适用于各种Web应用场景,包括单页应用程序、动态表单验证、实时更新和数据展示等。它可以用于改善用户界面的交互性,提供更流畅的用户体验,并减少对服务器的不必要请求,从而提高性能和响应速度。

优势

  • 简化开发:htmx通过将交互操作纳入HTML标记中,减少了开发人员编写大量JavaScript代码的需求,使得前端开发更加简洁和高效。
  • 提高用户体验:htmx的实时更新和局部刷新能力使得用户界面更具响应性,提升了用户体验和互动性。
  • 加速开发进程:htmx提供了一种快速构建交互性前端功能的方法,通过减少开发时间和调试工作,加速了项目的开发进程。
  • 兼容性和可扩展性:htmx与现有的Web技术和工具兼容,且可与不同后端技术和框架集成,具有较高的兼容性和可扩展性。

总结

htmx是一个现代Web技术,通过简化前端开发中的交互性操作,提供了一种快速构建现代Web应用的方法。它的轻量级、基于HTML的特性以及与现有Web标准的兼容性,使得开发人员能够更快速地构建交互性且用户友好的应用程序。随着htmx在开

su与sudo:理解和区分两种权限提升方式

thbcm阅读(319)

在Linux操作系统中,su(切换用户)和sudo(以超级用户权限运行)是两种常见的权限提升方式,用于在Unix和类Unix操作系统中执行需要较高权限的操作。本文将介绍su和sudo的定义、原理和使用方法,以及它们之间的区别。通过了解su和sudo,您将能够更好地理解如何管理和控制用户权限,并确保系统安全。

su(切换用户)

su是一种命令,允许用户切换到其他用户账户。通常,用户需要输入目标用户的密码才能成功切换。一旦成功切换,用户将拥有目标用户的权限,可以执行所有与目标用户相关的操作。

使用示例:
su targetuser

用户需要输入目标用户的密码才能完成切换。

sudo(以超级用户权限运行)

sudo是一种命令,允许普通用户以超级用户(root)权限执行特定的命令。sudo提供了更加细粒度的权限控制,可以限制用户只能执行特定的命令或命令集合,而无需暴露完整的超级用户权限。

使用示例:
sudo command

用户需要输入自己账户的密码,而不是目标用户的密码。

区别

  • 权限范围:su切换到目标用户后,用户将获得目标用户的完整权限,可以执行目标用户拥有的所有操作。而sudo允许用户以超级用户权限执行特定的命令,提供了更细粒度的权限控制。
  • 密码要求:su需要用户输入目标用户的密码来完成切换,而sudo需要用户输入自己账户的密码。这意味着sudo可以记录和审计用户的操作,而su无法提供这种级别的安全性。
  • 审计和日志记录:sudo提供了更好的审计和日志记录功能,可以跟踪用户以超级用户权限执行的命令,方便追溯和安全审计。而su切换后的操作无法直接追踪到目标用户。
  • 推荐用途:一般来说,推荐使用sudo来管理和控制用户权限。sudo允许管理员为特定用户分配特定的权限,并提供了更好的安全性和可控性。su则更适合在需要暂时切换到其他用户执行操作的情况下使用,例如系统管理人员需要临时切换到root用户来进行维护工作。

安全注意事项

  • 不要滥用sudo权限:管理员应该谨慎分配sudo权限,避免普通用户过度使用超级用户权限,从而降低系统的安全性。
  • 使用强密码:为了防止未经授权的su和sudo使用,确保用户账户具有强密码,定期更换密码并避免密码泄露。
  • 定期审计和监控:定期审计和监控su和sudo的使用记录,以便及时发现异常行为和安全漏洞。

总结

su和sudo是Linux操作系统中常用的权限提升方式。su允许用户切换到其他用户账户并获得完整的目标用户权限,而sudo允许用户以超级用户权限执行特定的命令,提供了更细粒度的权限控制和审计功能。管理员应根据实际需求和安全考虑,合理分配和管理su和sudo权限,并定期审计和监控其使用记录,以确保系统的安全性和可控性。

Java的Duration类:掌握时间间隔的魔法

thbcm阅读(382)

在Java编程中,处理时间间隔是一项常见任务。Java 8引入了Duration类,提供了方便的方法来处理和计算时间间隔。本文将介绍Duration类的定义、常见用法以及与其他时间类的比较。

Duration概述

Duration类是Java 8中引入的一个时间类,用于表示时间间隔的持续时间。它以纳秒为基本单位,可以处理从纳秒到天的范围。

创建Duration对象

可以使用不同的方式创建Duration对象:

  • 使用静态工厂方法​of()​创建Duration对象,指定时间量和时间单位。例如:
    Duration duration = Duration.ofSeconds(30);
  • 使用​between()​方法创建Duration对象,计算两个时间点之间的时间间隔。例如:
    LocalDateTime start = LocalDateTime.now();
    LocalDateTime end = start.plusMinutes(15);
    Duration duration = Duration.between(start, end);

常见操作和方法

  • 获取时间间隔的值:可以使用​toXxx()​方法获取时间间隔的不同时间单位的值,如​toNanos()​、​toMillis()​、​toMinutes()​等。
  • 比较两个Duration对象:可以使用​compareTo()​方法比较两个Duration对象的大小。
  • 增加或减少时间间隔:可以使用​plusXxx()​和​minusXxx()​方法对Duration对象进行增加或减少时间间隔的操作,如​plusHours()​、​minusDays()​等。
  • 判断是否为负时间间隔:可以使用​isNegative()​方法判断Duration对象是否表示负时间间隔。

与其他时间类的比较

  • 与Instant类的比较:Duration类可以与Instant类一起使用,计算两个时间点之间的时间间隔。
  • 与Period类的比较:Duration类用于处理较小的时间间隔,而Period类用于处理较大的时间间隔,例如天、周和月。

示例代码

下面是一些示例代码,展示了Duration类的常见用法:

Duration duration = Duration.ofMinutes(30);
long minutes = duration.toMinutes(); // 获取时间间隔的分钟数
Duration halfDay = Duration.ofHours(12);
Duration updatedDuration = duration.plusMinutes(15); // 增加15分钟的时间间隔
boolean isNegative = duration.isNegative(); // 判断是否为负时间间隔

总结

Duration类是Java 8引入的用于处理时间间隔的类。它提供了方便的方法来创建、操作和计算时间间隔。与其他时间类相比,Duration类适用于较小的时间间隔处理。通过熟练掌握Duration类的用法,您可以更轻松地处理时间间隔,并在Java编程中更加高效地操作时间。

联系我们