JavaScript的垃圾回收机制:内存管理与自动回收

thbcm阅读(289)

JavaScript作为一种高级编程语言,在执行过程中需要管理内存资源,包括分配和释放内存。垃圾回收机制是JavaScript中的一项重要功能,它可以自动释放不再使用的内存,避免内存泄漏和资源浪费。本文将探讨JavaScript的垃圾回收机制的原理、常见的回收算法以及一些优化技巧,帮助你更好地理解和应用JavaScript中的内存管理。

垃圾回收机制的原理

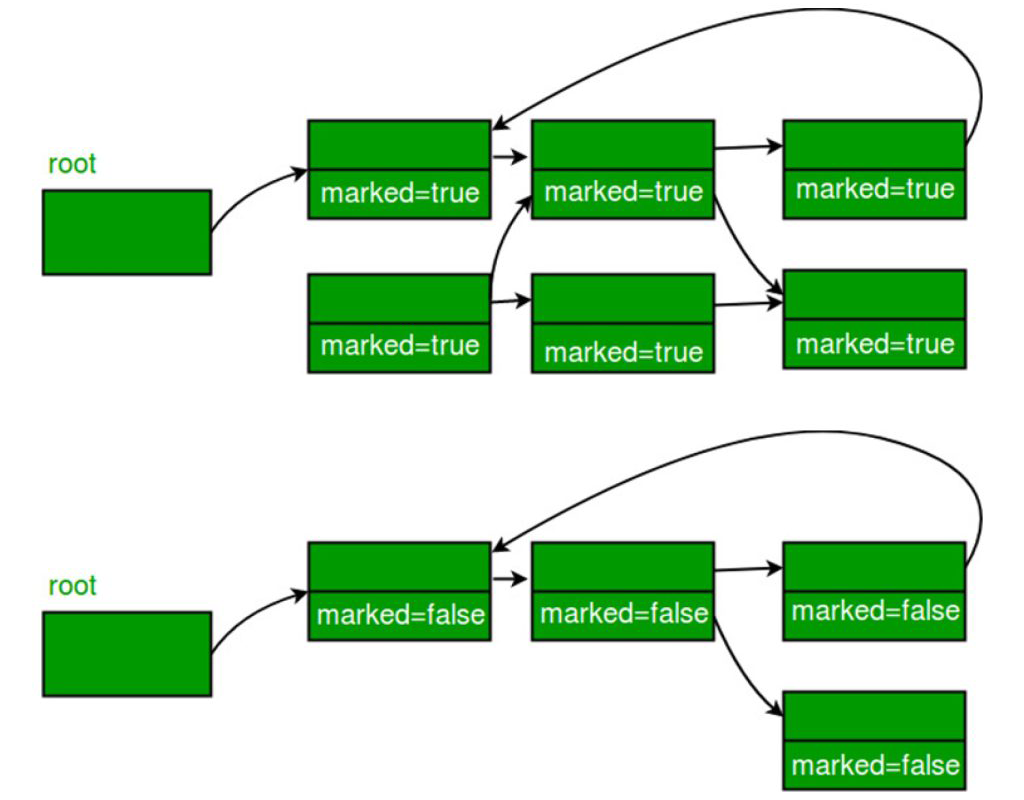
JavaScript中的垃圾回收机制通过标记和清除的方式来管理内存。当变量不再被引用或无法访问时,垃圾回收器会将其标记为垃圾,并在适当的时候进行清理。

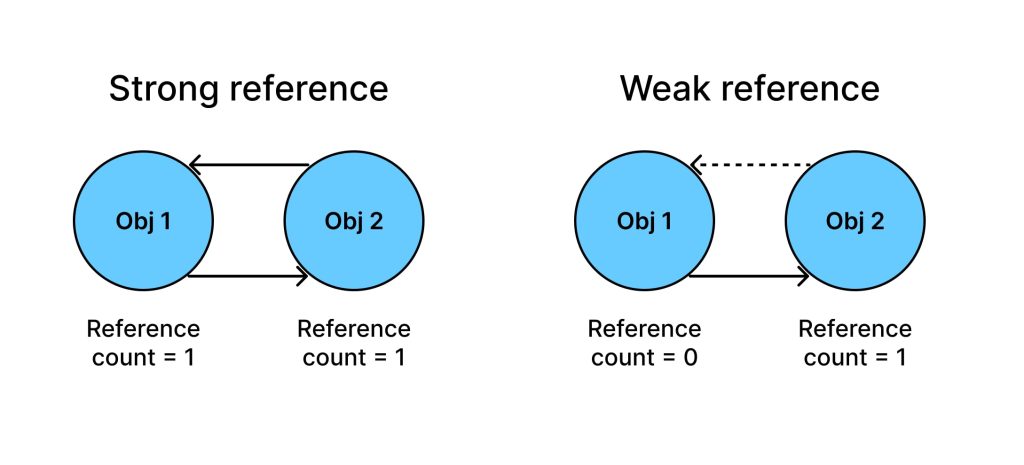
  • 引用计数:最简单的垃圾回收算法是引用计数。该算法跟踪每个值被引用的次数。当引用次数变为0时,表示该值不再被使用,可以被回收。然而,引用计数算法无法解决循环引用的情况,导致循环引用的对象无法被回收。

  • 标记清除:标记清除是一种常见的垃圾回收算法。它通过遍历内存中的对象,标记所有可达的对象,然后清除未被标记的对象。可达对象是指可以通过引用链访问到的对象。垃圾回收器会定期执行标记清除算法,将不再可达的对象回收。

常见的垃圾回收算法

除了标记清除算法,还有其他一些常见的垃圾回收算法,包括:

  • 标记-压缩:标记-压缩算法在标记阶段和清除阶段之后,会对存活的对象进行压缩,使它们在内存中连续排列。这样可以解决内存碎片化的问题,提高内存利用率。
  • 分代回收:分代回收算法根据对象的存活时间将内存分为不同的代。新创建的对象被分配在新生代,经过多次垃圾回收仍然存活的对象会被提升到老生代。分代回收算法根据不同代的特点采用不同的回收策略,提高垃圾回收的效率。

优化技巧与注意事项

为了优化JavaScript的垃圾回收机制,可以考虑以下技巧和注意事项:

  • 减少变量的作用域:通过减少变量的作用域,可以尽早释放不再使用的变量,帮助垃圾回收器更快地回收内存。
  • 显式释放资源:对于一些占用大量内存的对象,可以在不再使用时显式释放资源,如关闭文件、断开网络连接等。
  • 避免循环引用:避免循环引用是防止内存泄漏的重要步骤。确保及时解除对象之间的循环引用,以便垃圾回收器能够正确地回收对象。
  • 使用对象池:对于频繁创建和销毁的对象,可以使用对象池来重复利用对象,减少内存分配和回收的开销。

总结

JavaScript的垃圾回收机制是一项重要的内存管理功能,通过标记和清除的方式自动回收不再使用的内存。在实现上,常见的垃圾回收算法包括标记清除、标记-压缩和分代回收等。为了优化垃圾回收效率,我们可以采取一些技巧和注意事项,如减少变量作用域、显式释放资源、避免循环引用和使用对象池等。通过理解和应用JavaScript的垃圾回收机制,我们可以更好地管理内存,提高程序的性能和稳定性。

PHP组合比较符:简化条件表达式的编写

thbcm阅读(313)

在PHP编程中,经常需要编写条件表达式来进行逻辑判断。为了简化条件表达式的编写,PHP 7引入了组合比较符(Combination Comparison Operator),它可以将多个比较操作符组合成一个更简洁的表达式。本文将详细介绍PHP组合比较符的使用方法和常见应用场景,帮助你提高代码的可读性和简洁性。

组合比较符的语法

PHP的组合比较符使用三个连续的大于号(>)表示(<=>),它可以组合多个比较操作符。

组合比较符的语法如下:

$expression = $value1 <=> $value2;

其中,$value1$value2是需要进行比较的值。

组合比较符的返回值

组合比较符的返回值是一个整数,表示比较的结果。

  • 如果​$value1​小于​$value2​,返回​-1​。
  • 如果​$value1​等于​$value2​,返回​0​。
  • 如果​$value1​大于​$value2​,返回​1​。

组合比较符的应用场景

组合比较符可以简化多个条件的判断和比较,常见的应用场景包括:

  • 排序:组合比较符可以用于排序操作,通过比较两个值的大小来确定它们在排序结果中的顺序。
    $numbers = [3, 1, 5, 2, 4];
    usort($numbers, function($a, $b) {
        return $a <=> $b;
    });

    上述示例中,使用组合比较符对数组$numbers进行排序,按升序排列。

  • 条件判断:组合比较符可以用于条件判断,简化多个条件的组合。
    $age = 25;
    $isAdult = ($age <=> 18) >= 0 ? true : false;

    上述示例中,判断年龄$age是否成年,如果年龄大于等于18,则$isAdulttrue,否则为false

  • 自定义比较函数:组合比较符也可以与自定义的比较函数一起使用,用于自定义对象的比较操作。
    class Person {
        public $name;
        public $age;
        
        public function __construct($name, $age) {
            $this->name = $name;
            $this->age = $age;
        }
    }
    
    $persons = [
        new Person('John', 30),
        new Person('Alice', 25),
        new Person('Bob', 35)
    ];
    
    usort($persons, function($a, $b) {
        return $a->age <=> $b->age;
    });

    上述示例中,使用组合比较符对$persons数组中的Person对象按年龄进行排序。

总结

PHP的组合比较符是一个强大的工具,可以简化条件表达式的编写,提高代码的可读性和简洁性。通过将多个比较操作符组合成一个表达式,我们可以更直观地进行排序、条件判断以及自定义对象的比较操作。利用PHP的组合比较符,你可以编写更简洁、优雅的代码,提高开发效率和代码质量。

Vue 3中的数据监测神器:watch vs watchEffect

thbcm阅读(317)

Vue 3作为一种现代的JavaScript框架,引入了一些新的特性和改进。其中,watch和watchEffect是Vue 3中用于响应式数据监测的重要功能。本文将深入探讨Vue 3中watch和watchEffect的区别,帮助你理解它们的用法和适用场景。

watch的使用和特点

watch​是Vue 3中的一个选项,可以用于监测数据的变化并执行相应的操作。它的使用方式如下:

watch(source, callback, options);

其中,source是需要监测的数据,可以是一个响应式数据或计算属性。callback是数据变化时执行的回调函数,可以进行相应的操作。options是一个可选的选项对象,用于配置watch的行为。

watch的特点

  • 需要明确指定监测的数据源,可以是单个数据或多个数据的数组。
  • 在初始化时不会立即执行回调函数,而是在监测的数据发生变化时触发。
  • 可以通过配置选项来控制​watch​的行为,如深度监测、立即执行回调等。

watchEffect的使用和特点

watchEffect是Vue 3中的一个函数,用于创建一个响应式的副作用。它的使用方式如下:

watchEffect(effect, options);

其中,effect是一个函数,包含需要响应式监测的代码逻辑。options是一个可选的选项对象,用于配置​watchEffect​的行为。

watchEffect的特点

  • 不需要明确指定监测的数据源,它会自动追踪和依赖于使用到的响应式数据。
  • 在初始化时会立即执行​effect​函数,并在其依赖的响应式数据发生变化时重新执行。
  • 不需要显式地停止或销毁​watchEffect​,它会自动停止和清理相关的副作用。

watch和watchEffect的区别

  • 使用方式:watch​需要明确指定监测的数据源,而​watchEffect​不需要,它会自动追踪和依赖于使用到的响应式数据。
  • 初始化执行:watch​在初始化时不会立即执行回调函数,而​watchEffect​会立即执行​effect​函数。
  • 自动停止:watch​需要手动停止或销毁,而​watchEffect​会自动停止和清理相关的副作用。
  • 适用场景:watch​适用于需要精确控制和处理数据变化的场景,而​watchEffect​适用于需要简洁处理副作用的场景,如数据的异步请求、更新UI等。

总结

在Vue 3中,​watch​和​watchEffect​是用于响应式数据监测的重要功能。​watch​需要明确指定监测的数据源,可以进行精确的数据处理;而​watchEffect​不需要指定数据源,适用于处理简洁副作用的场景。根据具体的需求和场景,选择合适的监测方式可以提高代码的可读性和效率。无论是使用​watch​还是​watchEffect​,Vue 3都提供了强大的响应式机制,帮助开发者构建出更加可靠和高效的应用程序。

IPVS:高性能负载均衡的利器

thbcm阅读(337)

在现代的网络应用中,负载均衡是实现高可用性和性能扩展的关键。IPVS(IP Virtual Server)作为Linux内核的一部分,是一种高性能的负载均衡解决方案。本文将详细介绍IPVS的原理和功能,以及其在实际应用中的优势和使用方法。

IPVS的原理

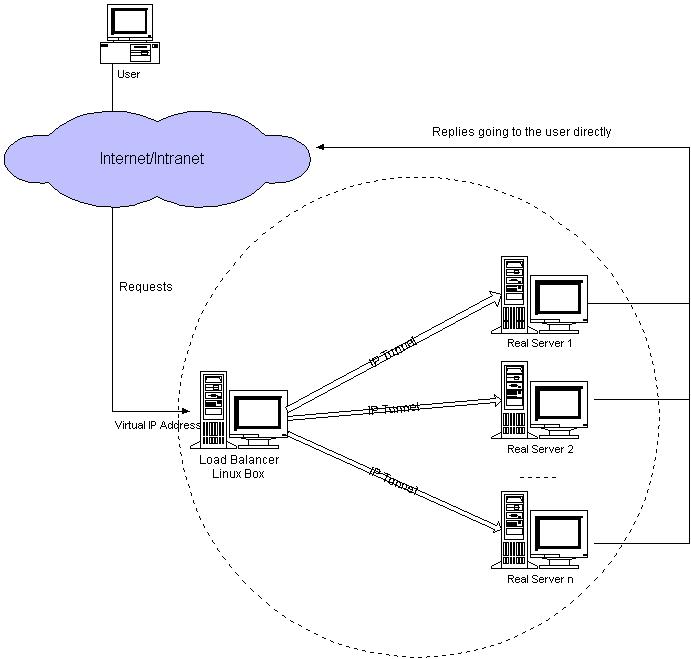
IPVS基于Linux内核的Netfilter框架,通过在网络层对数据包进行转发和处理,实现负载均衡的功能。其工作原理如下:

  1. IPVS通过拦截到达负载均衡器的数据包,并根据预先配置的规则进行转发。
  2. IPVS维护一个虚拟服务地址(Virtual Service Address),将客户端的请求转发给后端的真实服务器(Real Server)。
  3. IPVS支持多种负载均衡算法,如轮询、加权轮询、最少连接等,根据配置选择合适的算法进行转发。
  4. IPVS还提供会话保持(Session Persistence)的功能,确保同一客户端的请求都转发到同一后端服务器,保持会话的连续性。

IPVS的功能和优势

  • 高性能:IPVS是基于内核的负载均衡解决方案,具有卓越的性能和吞吐量。它利用多核处理、零拷贝技术等优化手段,能够应对高并发和大流量的网络环境。
  • 扩展性:IPVS支持水平扩展,可以通过添加更多的真实服务器来增加系统的容量和负载能力。
  • 灵活的负载均衡算法:IPVS提供多种负载均衡算法,可以根据实际需求选择合适的算法,如轮询、加权轮询、最少连接等,以实现更精细的负载均衡策略。
  • 会话保持:IPVS支持会话保持功能,确保同一客户端的请求都转发到同一后端服务器,保持会话的连续性,适用于需要保持状态的应用场景。
  • 高可用性:IPVS可以自动检测后端服务器的状态,当有服务器故障时,会自动将请求转发到其他正常的服务器,提供高可用性的服务。

IPVS的使用方法

使用IPVS可以通过命令行工具ipvsadm进行配置和管理,也可以通过一些第三方工具和管理界面进行操作。以下是一个简单的示例,演示如何使用ipvsadm配置IPVS:

# 添加一个虚拟服务
ipvsadm -A -t <虚拟服务IP:端口> -s <负载均衡算法>

# 添加后端真实服务器
ipvsadm -a -t <虚拟服务IP:端口> -r <真实服务器IP:端口> -g

# 查看IPVS配置
ipvsadm -L

通过以上命令,可以添加虚拟服务和后端真实服务器,并查看当前的IPVS配置。

IPVS的应用场景

IPVS广泛应用于各种网络应用中,特别适用于以下场景:

  • 高访问量的Web服务:通过IPVS实现负载均衡,分摊请求压力,提升系统的响应速度和可用性。
  • 分布式应用架构:在分布式环境中,使用IPVS可以轻松实现负载均衡和扩展性,提供高可用的服务。
  • 实时时通信:IPVS可以作为负载均衡器,用于实时通信应用,如聊天、游戏等,确保稳定和低延迟的连接。

总结

IPVS作为Linux内核的一部分,是一种高性能的负载均衡解决方案。它通过在网络层对数据包进行转发和处理,实现负载均衡的功能,并具备高性能、扩展性、灵活的负载均衡算法、会话保持和高可用性等优势。使用IPVS可以通过命令行工具ipvsadm进行配置和管理,适用于各种网络应用场景,提供稳定、高可用和高性能的服务。无论是大规模的Web应用、分布式架构还是实时通信应用,IPVS都是实现负载均衡的利器。

为什么重写equals()方法时必须重写hashCode()方法?

thbcm阅读(290)

在Java中,当我们在类中重写equals()方法来比较对象的相等性时,必须同时重写hashCode()方法。本文将解释为什么这两个方法需要一起重写,并讨论它们之间的关系以及为什么违反这个规则可能导致问题。

equals()和hashCode()的关系

在Java中,​equals()​方法被用于比较对象的相等性,而​hashCode()​方法则用于生成对象的哈希码。这两个方法在处理对象的相等性时密切相关。根据Java规范,如果两个对象通过​equals()​方法相等,那么它们的​hashCode()​方法必须返回相同的值。因此,当我们重写​equals()​方法来定义对象的相等条件时,为了遵循这个规则,也必须重写​hashCode()​方法。

hashCode()的作用

hashCode()​方法的作用是返回一个整数值,它用于支持基于哈希表的数据结构,如HashMap、HashSet等。这些数据结构在存储对象时使用哈希码来快速定位对象。当我们将对象存储在哈希表中时,首先会根据对象的哈希码计算出一个索引位置,然后在该位置上进行查找或存储操作。如果两个对象通过​equals()​方法相等但它们的​hashCode()​方法返回不同的值,那么它们可能会被错误地存储在不同的位置,导致无法正确地获取或比较这些对象。

一致性的重要性

为了解决哈希表等数据结构中的问题,Java规范要求​equals()​方法和​hashCode()​方法在逻辑上保持一致。具体来说,如果两个对象通过​equals()​方法相等,那么它们的​hashCode()​方法必须返回相同的值。这确保了当我们将这些对象存储在哈希表中时,它们会被正确地放置在相应的位置上。当我们使用​equals()​方法来比较对象相等性时,通常是首先比较它们的哈希码,然后再比较它们的具体属性,以提高效率。

违反一致性规则的后果

违反​equals()​和​hashCode()​的一致性规则可能导致一些问题。例如,如果我们将一个对象添加到HashSet或HashMap中,并且后续尝试使用另一个相等的对象查找或删除它,由于哈希码不同,我们将无法正确地找到该对象。这会导致数据结构中存在重复的对象或无法正确地操作对象。

正确重写equals()和hashCode()的指导原则

为了正确地重写​equals()​和​hashCode()​方法,我们可以遵循以下指导原则:

  • equals()​方法的重写应该基于对象的内容,而不仅仅是基于引用的相等性。比较对象的属性值来确定它们是否相等。
  • hashCode()​方法的重写应该与​equals()​方法的比较条件保持一致。即,如果两个对象通过​equals()​方法相等,它们的​hashCode()​方法应该返回相同的值。
  • 如果在类中使用可变的属性作为​equals()​和​hashCode()​方法的比较依据,确保在修改这些属性时同时更新​hashCode()​的计算,以保持一致性。
  • 使用IDE工具(如Eclipse、IntelliJ IDEA)可以自动生成​equals()​和​hashCode()​方法的模板代码,避免手动编写时出现错误。

示例代码

public class Person {
    private String name;
    private int age;

    public Person(String name, int age) {
        this.name = name;
        this.age = age;
    }

    // 重写equals()方法
    @Override
    public boolean equals(Object obj) {
        if (this == obj) {
            return true;
        }
        if (obj == null || getClass() != obj.getClass()) {
            return false;
        }
        Person person = (Person) obj;
        return age == person.age && Objects.equals(name, person.name);
    }

    // 重写hashCode()方法
    @Override
    public int hashCode() {
        return Objects.hash(name, age);
    }
}

总结

在Java中,重写​equals()​方法时必须同时重写​hashCode()​方法,以保证这两个方法的一致性。违反这个规则可能导致对象无法正确地存储和比较。通过正确地重写这两个方法,我们可以确保对象在使用哈希表等数据结构时能够正常运行,并且能够正确地比较对象的相等性。因此,在设计类时,务必记得同时重写​equals()​和​hashCode()​方法,以遵循Java规范并确保代码的正确性和可靠性。

setup()函数:构建Vue 3组件的新时代

thbcm阅读(280)

Vue 3引入了一个新的组合式API,并且其中最重要的部分是setup()函数。本文将深入探讨Vue 3中的setup()函数的用途和优势,以及它如何改变我们编写组件的方式。

什么是setup()函数?

在Vue 3中,setup()函数是组合式API的核心。它是在组件实例创建之前调用的一个函数,用于设置组件的状态、计算属性、方法等。setup()函数接收两个参数:props和context。其中,props是组件接收的属性,而context包含了一些与组件实例相关的上下文信息。

setup()函数的用途

setup()函数的主要用途是进行组件的初始化设置和响应式数据的声明。通过在setup()函数中声明响应式数据,我们可以使用Vue 3的新响应式系统来追踪数据的变化并自动更新视图。此外,我们还可以在setup()函数中定义计算属性、监听器、方法等,以及引入其他自定义的组合式函数。

setup()函数的优势

使用setup()函数带来了一些重要的优势:

更灵活的组合逻辑

在Vue 2中,我们通常需要在不同的生命周期钩子函数中编写逻辑代码,导致代码分散和难以维护。而在Vue 3中,我们可以使用setup()函数将相关逻辑组合在一起,使代码更加清晰和可维护。通过将相关代码封装在setup()函数中,我们可以更好地组织和复用逻辑。

更好的类型推导和编辑器支持

由于Vue 3使用了TypeScript,并且setup()函数的返回值是一个对象,我们可以获得更好的类型推导和编辑器支持。编辑器可以根据setup()函数中的声明推断出组件的类型,并提供相应的代码提示和错误检查,从而提高开发效率和代码质量。

更好的性能

Vue 3的响应式系统经过了重写,相比Vue 2有更好的性能表现。通过在setup()函数中声明响应式数据,Vue 3可以更好地跟踪数据变化并进行优化。这意味着在组件更新时,Vue 3可以更精确地重新渲染需要更新的部分,从而提高性能。

setup()函数的使用示例

以下是一个简单的示例,展示了如何使用setup()函数:

<template>
  <div>
    <p>Count: {{ count }}</p>
    <button @click="increment">Increment</button>
  </div>
</template>

<script>
import { ref } from 'vue';

export default {
  setup() {
    const count = ref(0);

    const increment = () => {
      count.value++;
    };

    return {
      count,
      increment
    };
  }
};
</script>

在上述示例中,我们使用了ref函数来创建一个响应式的count变量,并在setup()函数中定义了increment方法来增加count的值。最后,我们将count和increment作为返回值,使它们在模板中可用。

总结

Vue 3中的setup()函数为我们提供了更灵活、更好类型推导和编辑器支持以及更好性能的组件编写方式。通过将相关逻辑和状态封装在setup()函数中,我们可以更好地组织和复用代码,同时享受到Vue 3的新特性和优势。在开发Vue 3应用程序时,我们应该充分利用setup()函数,发挥其强大的能力,提高开发效率和代码质量。

C++标准库与Boost库:功能丰富的开发工具集

thbcm阅读(262)

C++是一种强大的编程语言,而C++标准库和Boost库则为C++开发者提供了广泛的工具和功能。本文将深入探讨C++标准库和Boost库,介绍它们的特点、提供的功能以及如何在项目中使用它们来加速开发过程和提高代码质量。

C++标准库

C++标准库是C++语言的一部分,提供了一组丰富的标准功能和容器类。它包含了各种头文件和命名空间,涵盖了输入输出、字符串处理、容器、算法、异常处理等方面的功能。

标准容器

C++标准库提供了多种容器类,包括向量(vector)、链表(list)、集合(set)、映射(map)等。这些容器类提供了高效的数据存储和操作方式,可用于解决各种问题。

算法和迭代器

C++标准库还提供了一系列算法和迭代器,用于对容器中的元素进行操作和遍历。这些算法包括排序、查找、变换等,而迭代器则提供了一种通用的访问容器元素的方式。

输入输出和字符串处理

标准库提供了输入输出流(iostream)和文件流(fstream),使得输入输出操作变得简单和灵活。此外,标准库还提供了字符串处理相关的功能,包括字符串查找、替换、分割等操作。

Boost库

Boost库是一个开源的、跨平台的C++库集合,为C++开发者提供了一系列高质量、可移植和易于使用的工具和组件。Boost库的目标是扩展C++标准库,填补标准库中的一些空白和不足之处。

泛型编程和元编程

Boost库对C++的泛型编程和元编程提供了强大支持。它提供了各种元编程工具,如类型特性、类型转换、类型推导等,使得开发者能够在编译期间进行更加灵活和高效的编程。

异常处理和错误处理

Boost库提供了一些增强的异常处理机制和错误处理工具,如异常指针、错误码、错误处理策略等。这些工具可以帮助开发者更好地处理异常情况和错误情况,提高代码的健壮性和可靠性。

并发编程和多线程

Boost库提供了丰富的并发编程和多线程支持,包括线程、互斥锁、条件变量、原子操作等。这些工具使得开发者能够更容易地编写并发安全的代码,并发控制和同步操作更加简单和高效。

应用场景和使用建议

C++标准库和Boost库在各种应用场景中都有广泛的应用。以下是一些常见的应用场景和使用建议:

  • 使用C++标准库的容器和算法来处理数据集合,例如使用向量进行动态数组的操作,使用映射进行键值对的存储和查找。
  • 使用C++标准库的输入输出和字符串处理功能来处理文件和字符串的读写、解析和格式化操作。
  • 当需要进行泛型编程、元编程和高级异常处理时,使用Boost库提供的工具和组件来增强C++的功能和灵活性。
  • 在并发编程和多线程场景下,使用Boost库提供的工具和组件来实现线程安全和高效的并发控制和同步操作。

总之,C++标准库和Boost库是C++开发者的重要工具集,它们提供了丰富的功能和组件,帮助开发者更加高效地编写C++代码。无论是日常的应用开发还是复杂的系统编程,都可以从中受益。建议开发者在项目中充分利用这些库,提高开发效率和代码质量。

总结

C++标准库和Boost库是C++开发者的得力工具,为我们提供了广泛的功能和组件,用于解决各种问题和应对不同的编程需求。C++标准库提供了基本的功能和容器类,而Boost库则进一步扩展了C++的功能,提供了更多的工具和组件。通过熟练掌握和灵活运用这些库,我们能够更加高效地开发C++应用程序,并提高代码的质量和可维护性。

SAX解析器:PHP快速高效的XML解析工具

thbcm阅读(322)

PHP是一种广泛应用于Web开发的脚本语言,而其内置的SAX(Simple API for XML)解析器为开发者提供了一种快速高效的XML解析工具。本文将介绍PHP中的SAX解析器,探讨其原理、使用方法以及与其他XML解析方法的对比,帮助读者了解如何利用SAX解析器处理XML数据并提升代码性能。

 SAX解析器简介

SAX解析器是一种基于事件驱动的XML解析器,其目标是在解析XML文档时以最小的内存开销和最高的性能提供数据的顺序访问。相对于DOM(Document Object Model)解析器,SAX解析器不需要将整个XML文档加载到内存中,而是通过逐行扫描文档并触发相应的事件来解析XML数据。
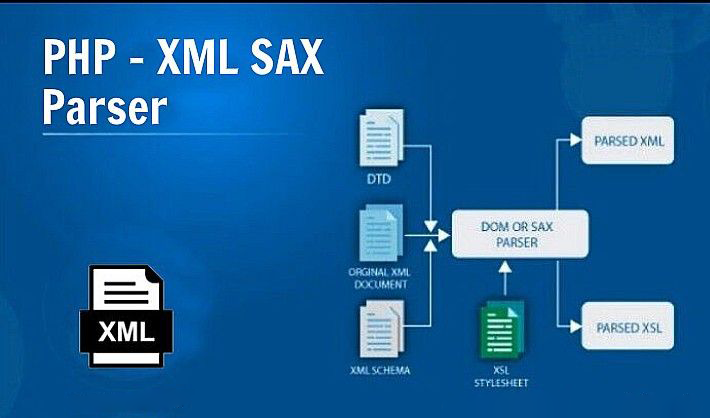
PHP中的SAX解析器

在PHP中,SAX解析器通过​xml_parser_create()​函数创建,并使用​xml_set_element_handler()、​​xml_set_character_data_handler()​等函数来注册事件处理函数。以下是SAX解析器的基本工作流程:

  1. 创建SAX解析器对象:使用​xml_parser_create()​函数创建一个SAX解析器对象。
  2. 注册事件处理函数:使用​xml_set_element_handler()​、​xml_set_character_data_handler()​等函数注册事件处理函数,以指定在解析XML时触发的相应事件。
  3. 解析XML数据:使用​xml_parse()​函数逐行解析XML数据。
  4. 处理事件:SAX解析器在解析XML数据时将触发相应的事件,例如开始元素、结束元素和字符数据等。
  5. 释放解析器:使用​xml_parser_free()​函数释放SAX解析器对象。

使用SAX解析器的示例

以下是一个简单的示例,演示如何使用PHP的SAX解析器解析XML数据:

<?php
// 创建SAX解析器对象
$parser = xml_parser_create();

// 注册事件处理函数
function startElement($parser, $element_name, $element_attrs) {
    // 处理开始元素事件
}

function endElement($parser, $element_name) {
    // 处理结束元素事件
}

function characterData($parser, $data) {
    // 处理字符数据事件
}

xml_set_element_handler($parser, "startElement", "endElement");
xml_set_character_data_handler($parser, "characterData");

// 解析XML数据
$xml_data = "<root><item>Value 1</item><item>Value 2</item></root>";
xml_parse($parser, $xml_data);

// 释放解析器
xml_parser_free($parser);
?>

在上述示例中,通过​xml_parser_create()​函数创建了一个SAX解析器对象,然后使用​xml_set_element_handler()​和​xml_set_character_data_handler()​函数注册了相应的事件处理函数。接下来,使用​xml_parse()​函数解析XML数据,并在解析过程中触发相应的事件处理函数。最后,使用​xml_parser_free()​函数释放了SAX解析器对象。

SAX解析器的优势与适用场景

SAX解析器在以下方面具有优势:

  • 内存效率:相对于DOM解析器,SAX解析器以流式处理的方式逐行解析XML数据,不需要将整个文档加载到内存中,因此在处理大型XML文件时能够节省大量内存。
  • 性能高效:由于SAX解析器采用事件驱动的方式,仅在解析到特定事件时触发相应的处理函数,因此具有更高的解析速度和更低的资源消耗。
  • 适用于大型XML文件:由于SAX解析器不需要将整个XML文件加载到内存中,因此适用于处理大型XML文件,尤其是那些超出可用内存限制的文件。
  • 数据流处理:SAX解析器以流式处理的方式逐行解析XML数据,因此非常适合处理数据流,例如从网络或文件中逐行读取并解析XML数据。

SAX解析器与DOM解析器的对比

SAX解析器和DOM解析器都是处理XML数据的工具,但它们在解析方式和适用场景上存在一些区别。

  • 解析方式:SAX解析器采用基于事件的解析方式,通过逐行扫描XML文档并触发相应的事件来解析数据。而DOM解析器将整个XML文档加载到内存中,生成一个树形结构(DOM树),开发者可以通过遍历树来访问和操作XML数据。
  • 内存消耗:由于DOM解析器需要将整个XML文档加载到内存中,因此对于大型XML文件,特别是超出可用内存限制的文件,可能导致内存消耗过大,而SAX解析器在解析过程中只需要保持当前解析位置的状态,因此内存消耗更低。
  • 数据访问方式:SAX解析器以事件驱动的方式逐行解析XML数据,适合于顺序处理数据流。而DOM解析器将整个XML文档加载到内存中,可以随机访问和操作XML数据,适合于需要频繁访问和修改XML结构的场景。
  • 性能比较:由于SAX解析器避免了将整个XML文档加载到内存中的开销,并采用事件驱动的方式,因此在处理大型XML文件时具有更高的性能和更低的资源消耗。DOM解析器适用于需要频繁访问和修改XML结构的场景,但对于大型XML文件可能存在性能和内存方面的限制。

总结

SAX解析器是PHP中一种快速高效的XML解析工具,通过基于事件的解析方式和流式处理的特性,能够有效地处理大型XML文件并节省内存开销。相比于DOM解析器,SAX解析器更适合于顺序处理数据流和处理大型XML文件的场景。通过掌握SAX解析器的原理和使用方法,开发者可以更好地处理XML数据并提升代码性能。

Golang Playground: 轻松提升你的技能

thbcm阅读(285)

Golang Playground 是一个在线工具,允许用户在方便且友好的环境中实验、练习和提升他们的编码技能。无论是初学者还是开发人员,Golang Playground 都提供了一个无需本地安装的环境,可以轻松编写、编译和执行 Go 代码。在这篇博文中,我们将探讨 Golang Playground 的各种功能、好处和技巧。

Golang Playground简介

Golang Playground是一个由Go团队开发的在线编程环境,它允许用户在浏览器中编写、运行和共享Golang代码。通过Golang Playground,开发者可以即时看到代码的运行结果,并进行调试和测试。

功能与优势

  • 即时编译与运行:Golang Playground提供了即时的编译和运行功能。当你在编辑器中输入代码后,它会立即进行编译,并在输出窗口中显示运行结果。这使得你能够快速验证和调试代码,减少了本地设置和配置的复杂性。
  • 交互式学习环境:Golang Playground提供了一个交互式的学习环境,使得学习Golang变得更加简单和直观。你可以尝试不同的代码片段,立即看到结果,并进行修改和实验。这种实时反馈的机制有助于加深对Golang语法和特性的理解。
  • 代码分享与协作:Golang Playground允许用户将他们的代码片段保存并生成一个分享链接,这样其他人就可以轻松查看、运行和修改这些代码。这种分享和协作的能力使得开发者能够更好地与他人进行交流和学习。
  • 无需本地设置:使用Golang Playground,你无需在本地配置Golang开发环境。它提供了一个完整的Golang编程环境,包括标准库和常用的工具,让你能够立即开始编写和运行代码,而无需担心本地设置和依赖问题。

如何利用Golang Playground提升技能

  • 学习Golang语法和特性:Golang Playground是学习Golang的理想工具。你可以通过编写简单的代码片段来熟悉Golang的语法和特性。尝试使用不同的数据类型、控制结构和函数,观察它们的行为和结果。通过实践和实时反馈,你将更快地掌握Golang的基础知识。
  • 解决算法和问题:Golang Playground提供了一个良好的环境来解决算法和问题。尝试解决一些常见的算法题或编程挑战,例如排序算法、查找问题或字符串处理等。通过不断尝试和优化代码,你将增强自己的算法思维和问题解决能力。
  • 测试和调试代码:Golang Playground具有良好的调试功能,你可以使用它来测试和调试代码。尝试编写一些有错误或边界情况的代码,并观察运行结果。通过调试器和输出窗口的信息,你将学会如何定位和修复代码中的问题。
  • 学习和探索开源项目:Golang Playground还可以用于学习和探索开源项目。许多开源项目都提供了Golang Playground的示例代码和演示,你可以通过它们来了解项目的实现和使用方式。这是学习和参与开源社区的一个很好的途径。

总结

Golang Playground是一个强大的在线编程环境,它为Golang开发者提供了许多便利和优势。通过利用Golang Playground,你可以轻松学习、练习和分享Golang代码,提升自己的技能并加速学习过程。无论是初学者还是有经验的开发者,Golang Playground都是一个必备的工具,它将为你的学习和开发带来很多便利和乐趣。

DrissionPage:简化Web自动化与数据抓取的强大工具

thbcm阅读(266)

DrissionPage是一个基于Python的网页自动化工具,集成了Selenium和Requests,提供了无缝切换和简化的接口,使开发者在Web自动化和数据抓取任务中能够高效、灵活地操作。无论是渲染JavaScript生成的动态内容还是静态页面数据抓取,DrissionPage都能轻松胜任。本文将介绍DrissionPage的特点和安装方法,并提供示例代码,展示其在会话模式登录和页面数据抓取方面的应用。

DrissionPage是什么?

DrissionPage是一个集成了Selenium和Requests的库,类似 selenuium 的网页自动化工具。这是一个基于 Python 的网页自动化工具,支持 Chromium 内核浏览器。它将控制浏览器和收发请求两大功能合二为一,并提供了统一、简洁的接口。无论是需要渲染JavaScript生成的动态内容,还是简单的静态页面数据抓取,DrissionPage都能轻松应对。这个库的设计哲学是提高开发者在Web自动化任务中的工作效率,同时降低编码复杂度。

特点

  • 无缝切换:DrissionPage 允许开发者在Selenium的浏览器驱动和Requests的会话之间无缝切换,这意味着您可以在需要渲染页面时使用Selenium,而在需要高速数据抓取时使用Requests。
  • 简化的接口:通过提供统一的接口,DrissionPage简化了Web自动化和数据抓取的流程。开发者不需要分别学习和使用两个库的复杂API,从而节省了学习和开发时间。
  • 灵活高效:DrissionPage 设计考虑到了灵活性和效率,不仅支持动态内容的抓取,还能处理大量的数据抓取任务。其性能优化和易用性使其成为处理Web自动化和数据抓取任务的强大工具。

安装方法

通过pip安装DrissionPage,安装命令如下:

pip install DrissionPage

示例代码

  • 登录会话模式:DrissionPage允许您在Driver模式下进行登录,可以自行替换帐号密码来进行登录体验:
    from DrissionPage import ChromiumPage
    
    # 创建页面对象,并启动或接管浏览器
    page = ChromiumPage()
    # 跳转到登录页面
    page.get('https://gitee.com/login')
    
    # 定位到账号文本框,获取文本框元素
    ele = page.ele('#user_login')
    # 输入对文本框输入账号
    ele.input('您的账号')
    # 定位到密码文本框并输入密码
    page.ele('#user_password').input('您的密码')
    # 点击登录按钮
    page.ele('@value=登 录').click()
  • 抓取页面数据:在任何模式下,DrissionPage都提供了简单的方法来抓取和处理页面数据:
    from DrissionPage import SessionPage
    
    # 创建页面对象
    page = SessionPage()
    
    # 爬取3页
    for i in range(1, 4):
        # 访问某一页的网页
        page.get(f'https://gitee.com/explore/all?page={i}')
        # 获取所有开源库<a>元素列表
        links = page.eles('.title project-namespace-path')
        # 遍历所有<a>元素
        for link in links:
            # 打印链接信息
            print(link.text, link.link)

这两段代码展示了如何使用DrissionPage进行会话模式的登录和页面数据的抓取。这种灵活性和简化的接口让它在Web自动化和数据抓取领域非常有用。

高级应用

接下来,我们深入一项需要一定开发经验和难度的功能:使用Selenium模式进行复杂的交互操作。

# 首先,我们导入页面对象WebPage类。
from DrissionPage import WebPage

# 接下来,我们创建一个WebPage对象。
page.get('https://gitee.com/explore')
# 然后控制浏览器访问 gitee。
page('#q').input('DrissionPage')
page('t:button@tx():搜索').click()
page.wait.load_start()

# 抓取交互后的页面数据
# 对ele元素进行模拟点击,如判断被遮挡也会点击
ele.click()

# 用js方式点击ele元素,无视遮罩层
ele.click(by_js=True)

# 如元素不被遮挡,用模拟点击,否则用js点击
ele.click(by_js=None)

通过这段代码,您可以在Web模式下执行复杂的页面交互,如点击按钮、填写表单等操作,并抓取交互后的页面数据。

总结

DrissionPage是一款强大的网页自动化工具,通过集成Selenium和Requests,它简化了Web自动化和数据抓取的流程,并提供了统一、简洁的接口。无论是处理动态内容抓取还是简单的页面数据获取,DrissionPage都表现出灵活性和高效性。通过示例代码,我们展示了DrissionPage在会话模式登录和页面数据抓取方面的应用,以及如何利用其在Web模式下执行复杂的交互操作。对于开发者来说,DrissionPage是一个值得尝试的工具,可以提高工作效率并降低编码复杂度。

联系我们