OpenAI Sora:距离黑客帝国仅一步之遥

thbcm阅读(288)

16日,OpenAI 宣布了 2024 年迄今为止最重要的人工智能模型:Sora,这是一种最先进的文本转视频模型,可以生成不同长宽比的高质量、高保真 1 分钟视频。Sora领先于该领域的其他任何事物数英里。它是通用的、可扩展的,而且它也是……一个世界模拟器?

OpenAI不仅介绍了Sora,还发布了一些令人瞠目结舌的AI生成视频供全世界观看。根据OpenAI的说法,这些视频拥有三个显著特点:它们的时长为60秒,提供单个视频内的多角度拍摄,并且融合了世界模型。本质上,OpenAI在视频生成效果上实现了质的飞跃,使Sora与之前的模型大不相同。这一成就不仅仅是技术上的突破,更是对视频创作和内容展现方式的一次革命。Sora的这些特点展现了OpenAI在模拟现实世界和创造性表达方面的前所未有的能力。

  • 60秒视频长度:这一特点使得Sora生成的视频不仅局限于短暂的片段,而是能够讲述更完整的故事,提供更丰富的信息和情感表达。
  • 多角度拍摄:这一功能模拟了真实世界中的摄影技术,为观众提供了从不同视角观察场景的机会,增加了视频的立体感和沉浸感。
  • 世界模型融合(incorporate world models):通过融合世界模型,Sora能够在视频中创造出更加复杂和真实的环境,使得生成的内容不仅仅是视觉上的,还包含了对环境的深入理解和表达。

OpenAI,通过其在人工智能领域的持续创新和研究,实现了接近真实的AI视频生成技术,主要归功于其在自然语言处理、深度学习、以及生成模型等方面的突破。Sora项目的成功,特别是其能够生成极其真实和富有想象力的视频内容,标志着OpenAI在视频生成领域达到了一个新的里程碑。下面我们将探讨这种AI视频生成技术的技术优势以及它可能对我们的生活乃至整个人类社会产生的影响。

Sora 的黑科技

Sora的技术究竟包含了哪些突破性的特征,使其能够如此深刻地理解并构建人类的指令语言呢?让我们来深入探讨OpenAI所暗示的“提供模型的多帧预测”这一突破以及其它相关技术特性。

多帧预测的能力

OpenAI通过社交媒体暗示的“提供模型的多帧预测”可能意味着Sora具有通过自我学习深入、情感化地理解和构建人类发出的通用指令语言的能力。这表明Sora不仅能够生成单一静态画面,而且能够预测并生成一系列连续的动态画面,这些画面在逻辑上连贯且情感上丰富,为观众提供了流畅且连续的视觉故事。

“通用语言”理解

Sora能够以极简的方式生成视频,只需用英语(或其他语言)描述所需场景,完全绕过了传统3D视频生成的复杂性。这种对人类语言的深刻理解和基于该理解构建视频的能力确实令人印象深刻。视频生成所需的细节和深度远超文本描述,这展示了在从文本到视频的转换中所体现的指数级复杂性和深度。

情感的传达

AI生成的图像和视频在传达人类情感方面历来面临挑战。然而,Sora模型展示的角色展现出了令人难以置信的自然、合乎逻辑且细腻的情感,这些情感能够无缝地适应它们所处的环境,仿佛是“带有灵魂的演员”,比实际的人还要逼真。

“构建”现实世界的能力

OpenAI强调的“世界模型”概念中,Big Ivan认为“构建”是最关键的方面。真实世界按照特定的物理定律运作,例如对象遵循重力,风吹动头发,脆弱物品掉落时会按照可预测的方式破碎。Sora在这一方面展现了接近现实的惊人能力。️️ 它发布的AI视频展示了金色的拉布拉多狗狗在雪中嬉戏、一只奇异生物玩弄蜡烛,以及人们在日本樱花季节悠闲地漫步。这些视频严格遵循物理定律,展现了与因果完美对齐的无缝过渡和逻辑序列。

Sora的“构建”能力能够实现接近真实世界的无限细节。与传统3D建模受到帧数限制不同,Sora能够无限复制细节。结合其接近真实的感知和听觉能力,这种构建世界的能力确实令人敬畏。

总结

Sora是一个开创性的人工智能模型,能够根据文本提示生成既真实又富有想象力的视频。作为OpenAI愿景的产物,Sora旨在创造能够惠及人类并促进创造力发展的人工智能。Sora拥有多项特性,使其成为一个强大且多用途的工具,包括高度真实感、丰富想象、多样化和可扩展性等。通过一种名为扩散变换器的创新人工智能架构,结合潜在扩散和变换器技术,Sora能够在一个广泛且多样化的视频数据集上进行自我学习,掌握从数据本身学习的能力。随着Sora未来向公众开放的可能性,我们期待这项技术将如何继续推动视频创作的边界,激发全球创作者的无限潜力。Sora不仅仅是技术的突破,它是向每个人展示创意无限、想象力无边界的一扇窗。在Sora的帮助下,每个人都有机会成为故事的讲述者,用视频捕捉和分享世界的无限可能。

Executor与ExecutorService:异步任务执行的差异

thbcm阅读(312)

在Java中,Executor和ExecutorService是用于管理和执行异步任务的关键工具。本文将深入探讨Executor和ExecutorService的定义、功能以及它们之间的区别。通过了解这两个工具的不同之处,您将能够更好地选择适合您需求的任务执行方式。

概述

Executor和ExecutorService是Java中用于管理和执行异步任务的接口和类。它们提供了一种机制来解耦任务的提交和执行过程,并提供了灵活的线程池管理和任务调度功能。

Executor接口

Executor是一个简单的接口,其中定义了一个用于执行任务的方法execute(Runnable command)。它允许将任务提交给线程池进行执行,但无法对任务的执行结果进行管理和控制。

使用示例

import java.util.concurrent.Executor;  
  
public class SimpleExecutor implements Executor {  
    @Override  
    public void execute(Runnable command) {  
        new Thread(command).start();  
    }  
}
public class Main {  
    public static void main(String[] args) {  
        SimpleExecutor executor = new SimpleExecutor();  
        executor.execute(() -> System.out.println("Task running in a new thread: " + Thread.currentThread().getName()));  
    }  
}

ExecutorService接口

ExecutorService是Executor的子接口,扩展了任务执行的功能。它提供了一组方法来提交、执行和管理任务,并且可以控制任务的执行过程、获取任务的执行结果以及管理线程池的生命周期。

使用示例

import java.util.concurrent.ExecutorService;  
import java.util.concurrent.Executors;  
  
public class ExecutorServiceExample {  
    public static void main(String[] args) {  
        // 创建一个单线程的ExecutorService  
        ExecutorService executorService = Executors.newSingleThreadExecutor();  
  
        // 提交任务  
        executorService.submit(() -> {  
            System.out.println("Task is running in thread: " + Thread.currentThread().getName());  
        });  
    }  
}

功能对比

  • 任务提交:Executor只提供了​execute()​方法用于提交任务,而ExecutorService提供了多种方式提交任务,如​submit()​、​invokeAny()​和​invokeAll()​等。这些方法允许任务返回Future对象,用于获取任务的执行结果或控制任务的取消。
  • 任务管理和控制:ExecutorService提供了一系列方法来管理和控制任务的执行,如​shutdown()​、​awaitTermination()​和​shutdownNow()​等。这些方法允许您优雅地关闭线程池,等待任务的完成或立即停止所有任务的执行。
  • 线程池管理:ExecutorService提供了更丰富的线程池管理功能,如动态调整线程池大小、设置线程池的闲置时间和队列容量等。这些功能使得线程池的管理更加灵活和高效。

使用场景

  • Executor适用于简单的任务提交场景,当您只关心任务的提交而不需要对任务进行管理和控制时,可以使用Executor接口。
  • ExecutorService适用于更复杂的任务执行场景,当您需要对任务进行管理、控制和获取执行结果时,可以使用ExecutorService接口。

总结

Executor和ExecutorService是Java中用于管理和执行异步任务的重要接口和类。Executor提供了基本的任务提交功能,而ExecutorService在此基础上提供了更多的任务管理和控制功能,同时支持获取任务的执行结果。根据您的需求,选择适合的接口和类可以使任务的执行更加高效和灵活。通过深入理解Executor和ExecutorService的区别,您将能够更好地利用它们来处理异步任务。

Node.js Addon:扩展Node.js的原生能力

thbcm阅读(349)

Node.js是一个基于V8引擎构建的JavaScript运行时环境,它通过事件驱动和非阻塞I/O模型提供了高性能和可扩展性。然而,有时候使用纯JavaScript无法满足特定需求,这时就需要借助Node.js Addon来扩展Node.js的原生能力。Node.js Addon是一项强大的功能,允许开发者使用C++或其他编程语言编写原生模块,并将其无缝集成到Node.js应用程序中。本文将介绍Node.js Addon的定义、优势以及开发过程,帮助您了解如何利用Addon扩展Node.js的功能和性能。

什么是Node.js Addon

Node.js Addon是一种扩展机制,允许开发者使用C++或其他编程语言编写原生模块,并将其集成到Node.js应用程序中。Addon充当了Node.js和底层C/C++库之间的桥梁,通过使用原生代码来提供更高性能、更底层的系统访问权限和更丰富的功能。

Node.js Addon的优势

  • 高性能:使用原生代码可以显著提高应用程序的性能,特别是在处理计算密集型任务时。
  • 系统访问权限:原生模块可以直接访问底层硬件、操作系统API和其他系统资源,提供更底层的系统控制能力。
  • 与现有库集成:可以利用现有的C/C++库或框架,如图像处理库、加密库或音频处理库,无需重新实现功能。

开发Node.js Addon的过程

  1. 编写C++模块:使用C++或其他编程语言编写原生模块,实现所需的功能。
  2. 绑定到JavaScript:编写绑定代码,将C++函数和对象映射到JavaScript中,以便在Node.js环境中进行调用。
  3. 编译为共享库:将C++模块编译为共享库,以便在Node.js中加载和使用。
  4. 加载和使用Addon:在Node.js应用程序中加载Addon,并使用其提供的功能和性能优势。

示例代码

下面是一个简单的示例代码,展示了Node.js Addon的用法:

#include <napi.h>

Napi::String Hello(const Napi::CallbackInfo& info) {
    Napi::Env env = info.Env();
    return Napi::String::New(env, "Hello from Node.js Addon!");
}

Napi::Object Init(Napi::Env env, Napi::Object exports) {
    exports.Set("hello", Napi::Function::New(env, Hello));
    return exports;
}

NODE_API_MODULE(addon, Init)

应用场景

  • 访问底层硬件或系统功能:如文件系统、网络通信或操作系统API。
  • 使用现有C/C++库或框架:如图像处理库、加密库或音频处理库。
  • 提高性能:通过使用原生代码替代JavaScript来执行计算密集型任务。

总结

Node.js Addon是一项强大的功能,允许开发者使用C++或其他编程语言编写原生模块,并将其集成到Node.js应用程序中。通过利用Addon,开发者可以提高应用程序的性能、获得更底层的系统访问权限,并与现有的C/C++库集成。深入了解Node.js Addon的开发过程和应用场景,将为您提供更多开发Node.js Addon的过程和应用场景,帮助您更好地扩展Node.js的功能和性能。

父组件直接调用子组件的方法:Vue中的组件间通信

thbcm阅读(342)

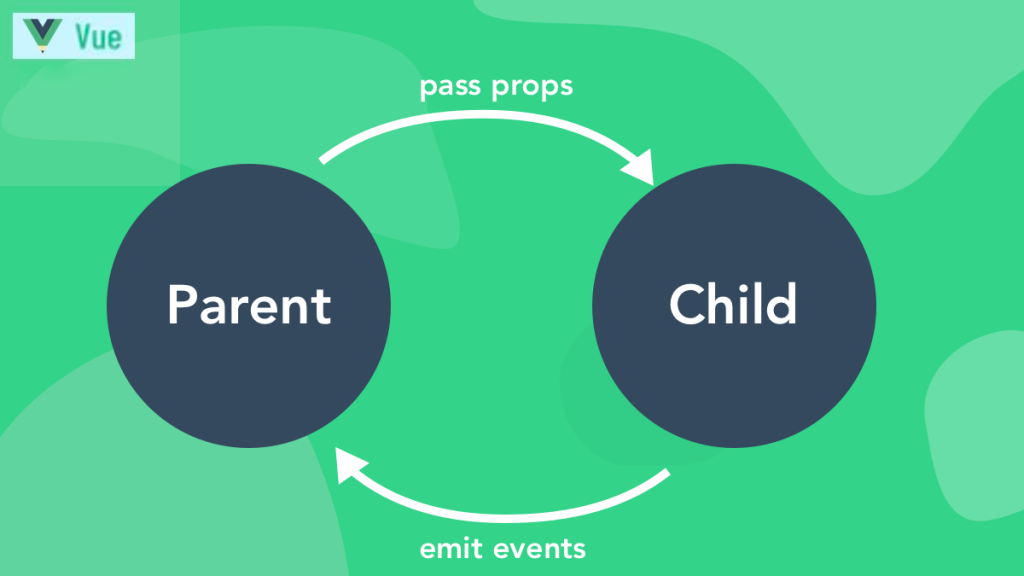
在Vue开发中,组件化是一种重要的模式,而父组件和子组件之间的通信是一个常见的需求。组件可以独立开发、维护和重用,但在某些情况下,父组件需要直接调用子组件的方法来实现更灵活的交互和通信。本文将探讨在Vue中如何实现父组件直接调用子组件方法的方法,以实现组件间的通信。

父组件向子组件传递方法

在Vue中,父组件可以通过属性(prop)的方式向子组件传递方法。在父组件中定义一个方法,然后将该方法通过属性绑定传递给子组件。子组件可以通过调用该属性来触发父组件的方法。

子组件中触发父组件方法的步骤

  • 在子组件中,通过​this.$emit​方法触发一个自定义事件,同时传递需要传递给父组件的数据。
  • 在父组件中,通过在子组件上使用​@自定义事件名​或​v-on:​自定义事件名的方式监听该事件。
  • 在父组件的事件处理函数中,可以调用子组件传递的方法或做其他操作。

示例代码

父组件

<template>
  <div>
    <ChildComponent :childMethod="childMethod" />
    <button @click="callChildMethod">调用子组件方法</button>
  </div>
</template>

<script>
import ChildComponent from './ChildComponent.vue';

export default {
  components: {
    ChildComponent,
  },
  methods: {
    childMethod() {
      console.log('子组件方法被调用');
    },
    callChildMethod() {
      this.$refs.childComponentRef.childMethod();
    },
  },
};
</script>

子组件

<template>
  <div>
    <p>子组件</p>
  </div>
</template>

<script>
export default {
  methods: {
    childMethod() {
      console.log('子组件方法被调用');
      this.$emit('custom-event');
    },
  },
};
</script>

解释示例代码

  • 父组件中,通过​:childMethod="childMethod"​将父组件的​childMethod​方法传递给子组件。
  • 父组件中的​callChildMethod​方法中,通过​this.$refs.childComponentRef.childMethod()​调用子组件的方法。
  • 子组件中的​childMethod​方法中,通过​this.$emit('custom-event')​触发一个自定义事件。
  • 父组件中使用​@custom-event​或​v-on:custom-event​监听子组件触发的自定义事件,并在事件处理函数中调用需要的方法。

总结

在Vue中,父组件直接调用子组件的方法是通过属性传递方法,子组件通过触发自定义事件来实现的。这种方法可以实现父组件与子组件之间的灵活通信和交互。通过示例代码,我们展示了如何在Vue中实现父组件直接调用子组件方法的过程。

Pdoc:生成优雅Python API文档的工具

thbcm阅读(325)

在开发Python项目时,文档是至关重要的。它不仅提供了对代码功能和用法的了解,还为其他开发人员提供了参考和使用的便利。Pdoc是一个流行的文档生成工具,专为生成Python API文档而设计。本文将介绍Pdoc的定义、特性和使用方法,以帮助您轻松生成清晰、可读性强的Python API文档。

什么是Pdoc

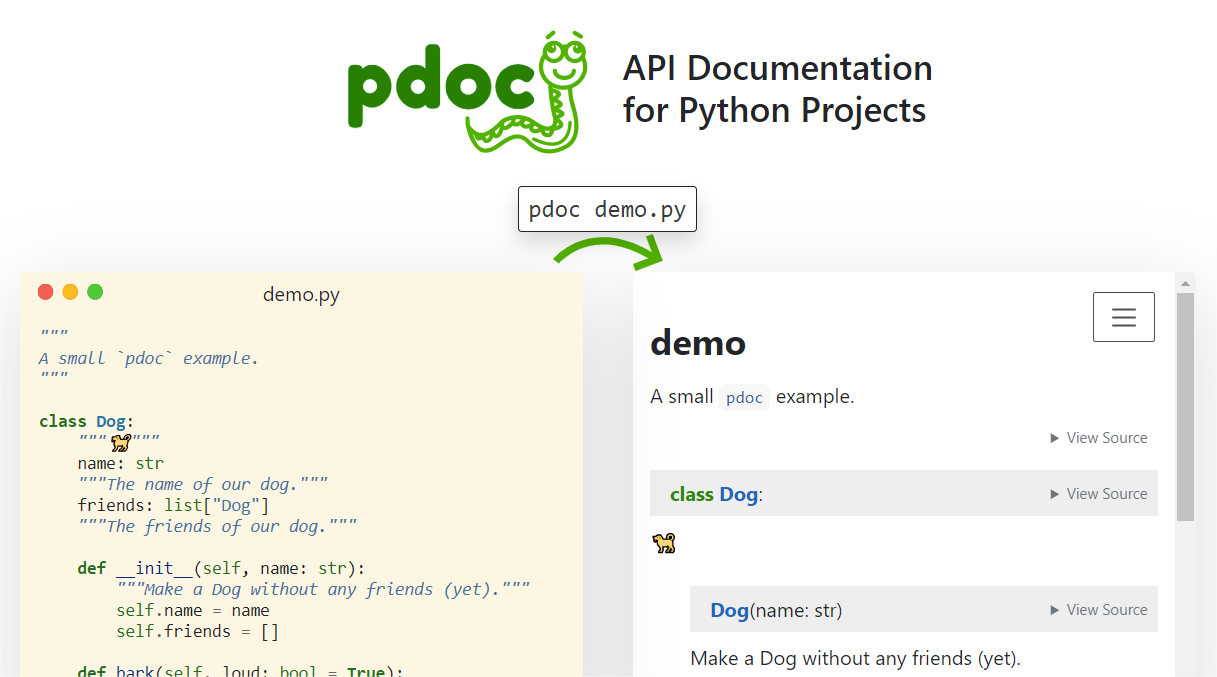
Pdoc是一个用于Python项目的文档生成工具。它通过解析Python源代码中的注释和文档字符串,生成可读性强、格式整齐的文档。Pdoc支持多种文档格式,具有灵活的配置选项和模板,帮助开发人员生成美观且易于阅读的Python API文档。

Pdoc的特性

  • 自动文档生成:Pdoc可以自动解析Python源代码中的注释和文档字符串,并根据其生成相应的文档页面。
  • 支持多种文档格式:Pdoc支持生成HTML、Markdown和PDF等多种文档格式,以满足不同的需求。
  • Jupyter Notebook支持:Pdoc可以解析Jupyter Notebook中的代码,并生成相应的文档页面。
  • 可定制的模板:Pdoc提供了灵活的模板系统,允许您自定义生成的文档样式和布局。
  • 交互式文档:Pdoc生成的文档页面具有交互式特性,包括源代码链接、自动搜索和导航栏等。

使用Pdoc生成文档的

安装Pdoc

pdoc 支持 Python 3.6 以上版本,安装非常简便,只需使用pip命令安装Pdoc到您的Python环境中。

pip install pdoc

基本用法

使用 pdoc,你只需要执行一个简单的命令即可生成你的项目文档:

pdoc your_python_module

或者,针对一个具体的文件,可以这样:

pdoc ./my_project.py

pdoc 还有内置的  web  服务器支持实时重新加载。如果你想查看 pdoc 自己的文档,可以运行:

pdoc pdoc

想查看支持的命令行选项,运行:

pdoc --help

或者,你可以访问官方文档来获取更多信息。

在线预览

有时你可能需要直接预览生成的文档。pdoc 提供了在线预览的功能,只需一个命令:

pdoc -o ./html pdoc

生成的网站示例可以在这里查看官方文档

总结

Pdoc是一个功能强大且易于使用的Python文档生成工具,可以帮助开发人员生成清晰、可读性强的Python API文档。通过使用Pdoc,可以轻松为Python项目生成优雅的文档,使其更易于理解和使用。良好的文档不仅有助于开发人员的协作和理解,还能提高项目的可维护性。利用Pdoc工具,为Python代码生成高质量的文档,提升项目的开发效率和质量。

Panic与Recover:Go异常处理的救命稻草

thbcm阅读(343)

异常处理是每个程序员都应该关注的重要问题。在Go语言中,Panic和Recover是用于异常处理的两个关键概念。Panic用于触发异常,而Recover用于捕获和处理异常。本文将深入探讨Panic和Recover的区别,以及它们的最佳实践,帮助读者更好地理解和应用异常处理机制。

Panic概述

Panic是Go语言中的异常机制,用于表示遇到了无法继续执行的错误。当程序遇到不可恢复的错误或不满足预期条件时,可以通过调用panic函数触发Panic异常。Panic会立即终止当前函数的执行,并沿调用栈向上逐级展开,执行延迟(defer)函数,并打印堆栈跟踪信息。

Panic的使用场景

  • 当程序遭遇无法恢复的错误或异常情况时,可以使用Panic。
  • 在处理异常时,如果无法继续执行,可以使用Panic中断当前流程。
  • Panic通常用于检查和处理程序的非预期情况,如空指针、越界等。

Recover概述

Recover是Go语言中用于捕获和处理Panic异常的内建函数。Recover只能在延迟函数(defer)中使用,并且必须在发生Panic后的代码块中调用。它可以阻止Panic继续向上展开,并返回Panic的值。如果没有发生Panic,调用Recover将返回nil。

Recover的使用场景

  • 在延迟函数(defer)中使用Recover来捕获和处理Panic异常。
  • 通过Recover可以恢复程序的执行,并采取相应的措施来处理异常情况。
  • Recover通常用于防止程序因为单个协程发生Panic而导致整个程序崩溃。

Panic和Recover的区别

  • 触发和处理:Panic用于触发异常,而Recover用于捕获和处理异常。
  • 使用位置:Panic可以在任何地方触发,但Recover只能在延迟函数中使用。
  • 效果和行为:Panic会立即终止当前函数的执行并展开堆栈,而Recover可以恢复程序的执行并返回Panic的值。
  • 使用场景:Panic用于处理无法恢复的错误或异常,Recover用于防止程序崩溃并采取措施处理异常情况。

示例代码

package main

import (
    "fmt"
    "errors"
)

func main() {
    defer func() {
        if err := recover(); err != nil {
            fmt.Println("Recovered:", err)
        }
    }()

    fmt.Println("Before Panic")
    panic(errors.New("Something went wrong"))
    fmt.Println("After Panic") // 不会执行到这里
}

在上述代码中,当程序执行到panic(errors.New("Something went wrong"))时,会触发Panic异常,导致程序立即停止执行,并打印Panic的错误信息。但由于在延迟函数中使用了Recover,程序会继续执行,并打印”Recovered: Something went wrong”。需要注意的是,fmt.Println("After Panic")这行代码不会执行到,因为在触发Panic后,程序已经被中断。

总结

Panic和Recover是Go语言中处理异常的两个重要机制。正确使用Panic和Recover可以帮助我们处理异常情况,保证程序的稳定性。在使用时,需要根据具体情况合理触发Panic,并在延迟函数中使用Recover来处理异常。同时,建议在Recover中采取适当的措施来恢复程序的执行或进行错误日志记录,以便排查和修复问题。

GROUP BY vs. PARTITION BY:数据分组与分区的差异

thbcm阅读(302)

在大规模数据处理和分析的场景中,对数据进行分组和分区是非常常见的需求。MySQL作为一种流行的关系型数据库管理系统,提供了GROUP BY和PARTITION BY两个关键字,用于实现数据的分组和分区操作。虽然它们在功能上有一定的相似性,但在实际应用中存在一些重要的区别。本文将详细探讨GROUP BY和PARTITION BY的区别,并介绍它们各自的使用场景。

GROUP BY

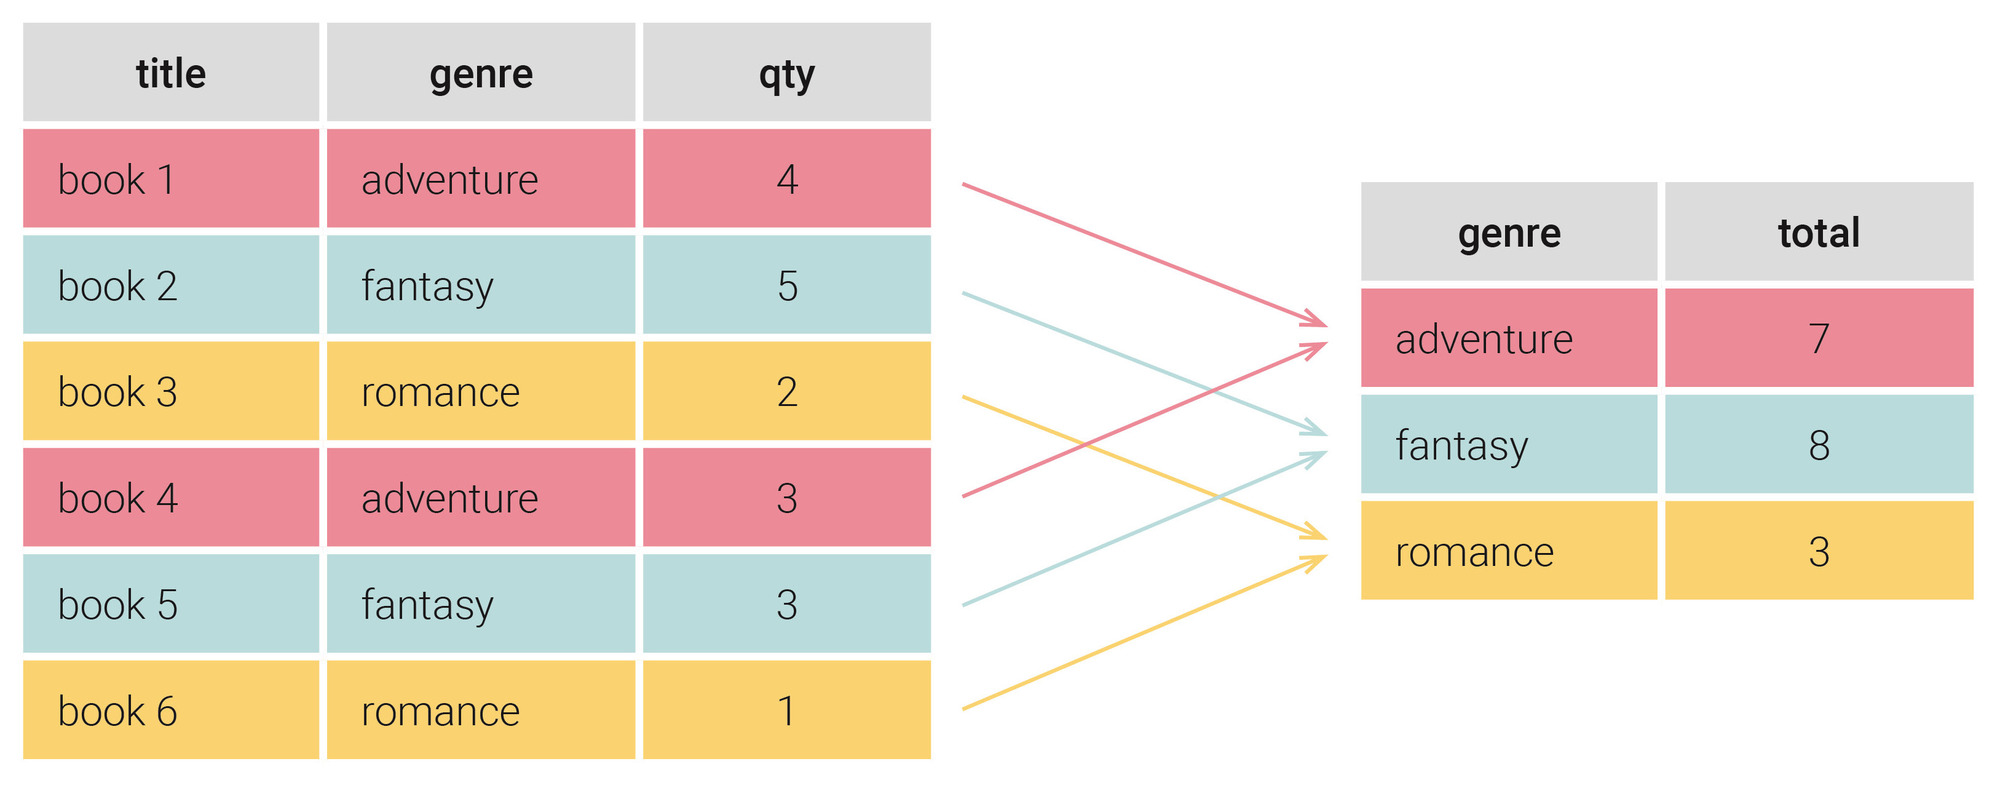
GROUP BY用于将数据按照某个或多个列的值进行分组,然后对每个分组进行聚合操作。GROUP BY通常与聚合函数(如SUM、COUNT、AVG等)一起使用,以计算每个分组的统计结果。GROUP BY生成的结果集中,每个分组都有唯一的键值,并且可以使用HAVING子句对结果进行进一步过滤。

PARTITION BY

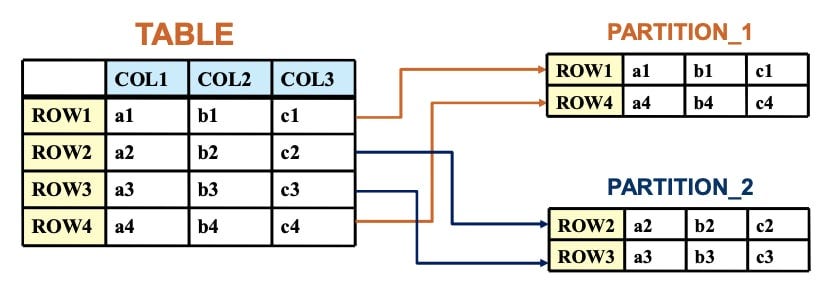
PARTITION BY用于将表或索引的数据划分为多个分区,每个分区可以单独进行管理和操作。PARTITION BY通常用于优化大型表的查询性能,通过将数据分散存储在不同的分区中,可以减少查询的范围。PARTITION BY可以按照列的值范围、列表或哈希值等方式进行分区,提供了灵活的分区策略选择。

区别分析

  • 功能不同:GROUP BY用于对数据进行分组和聚合,得到每个分组的统计结果。PARTITION BY用于将表或索引的数据划分为多个分区,以提高查询性能。
  • 数据操作层面不同:GROUP BY操作在查询结果集上进行,不会改变数据表的物理存储结构。PARTITION BY操作在数据表或索引的存储层面进行,会改变数据的物理分布。
  • 使用场景不同:GROUP BY适用于对查询结果进行分组和聚合操作,常用于统计分析、报表生成等场景。PARTITION BY适用于大表的数据管理和查询优化,常用于分布式存储、数据仓库等场景。

最佳实践

  • 在使用GROUP BY时,注意选择适当的聚合函数和列进行分组,并合理使用HAVING子句进行结果过滤。
  • 在使用PARTITION BY时,考虑表的大小、查询频率和数据分布等因素,选择合适的分区策略。
  • 注意对分区表进行维护和管理,及时调整分区策略以适应数据的变化。

总结

GROUP BY和PARTITION BY是MySQL中常用的关键字,用于数据的分组和分区操作。尽管它们在功能上有一定的相似性,但在实际应用中存在重要的区别。GROUP BY适用于对查询结果进行分组和聚合,常用于统计分析和报表生成等场景。PARTITION BY适用于大表的数据管理和查询优化,常用于分布式存储和数据仓库等场景。在实际使用中,我们应该根据具体需求选择合适的关键字,并结合最佳实践进行正确的数据处理和分析操作,以提高查询性能和数据管理效率。

深度解析限流原理:Sentinel守护你的系统

thbcm阅读(380)

在现代的分布式系统中,高并发环境下的流量控制是保障系统稳定性和可用性的重要手段。Sentinel作为一款开源的流量控制组件,提供了丰富的限流策略和实时监控功能,被广泛应用于微服务架构中。本文将详细介绍Sentinel是如何实现限流的,包括其核心概念、限流规则和工作机制。

Sentinel限流原理概述

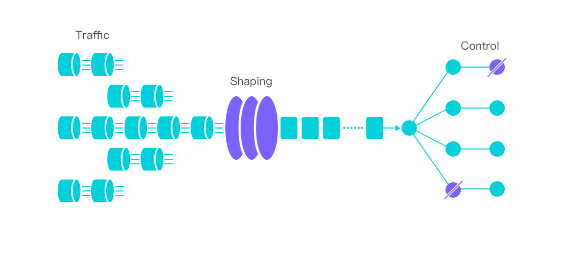
Sentinel基于令牌桶算法和漏桶算法等流控算法实现限流功能。Sentinel通过统计系统的流量和资源使用情况,根据预设的限流规则对请求进行拦截或调节。

Sentinel核心概念

  • 流控规则(Flow Rule):流控规则定义了对请求流量的限制条件,包括并发数、QPS(每秒请求数)、线程数等。Sentinel支持基于URL、资源名、IP等维度的流控规则配置。
  • 统计信息(Statistical Information):Sentinel会统计请求的通过量、错误量、平均响应时间等信息,用于限流决策。统计信息可以通过滑动窗口、令牌桶等算法进行实时计算和更新。
  • 实时监控(Real-time Monitoring):Sentinel提供了实时监控的功能,可以对系统的流量、资源使用和限流情况进行可视化展示。实时监控可以帮助开发者及时发现问题、调整限流策略。

Sentinel限流工作机制

  • 请求拦截:当一个请求到达系统时,Sentinel会根据流控规则和统计信息判断是否允许该请求通过。如果请求超出了限制条件,Sentinel会拦截该请求并执行相应的限流策略(如返回错误信息或延迟处理)。
  • 统计信息更新:Sentinel会根据请求的处理情况,实时更新统计信息,包括通过量、错误量、响应时间等指标。统计信息的更新可以通过滑动窗口、令牌桶等算法进行高效计算。
  • 动态调整限流规则:Sentinel支持动态调整限流规则,开发者可以通过API或配置中心实时更新流控规则。动态调整规则可以根据系统的实际情况,灵活地调整限流策略,提升系统的弹性和可用性。

示例代码

import com.alibaba.csp.sentinel.Entry;
import com.alibaba.csp.sentinel.SphU;
import com.alibaba.csp.sentinel.slots.block.BlockException;

public class SentinelDemo {
    public static void main(String[] args) {
        // 定义资源名称
        String resourceName = "demoResource";

        // 设置限流规则
        Entry entry = null;
        try {
            // 获取资源的许可
            entry = SphU.entry(resourceName);
            // 执行业务逻辑
            // ...
        } catch (BlockException ex) {
            // 被限流,执行限流处理逻辑
            // ...
        } finally {
            if (entry != null) {
                entry.exit();
            }
        }
    }
}

上述示例代码中,我们首先定义了资源名称(demoResource),然后使用SphU.entry()方法获取资源的许可。如果该资源超过了限流规则定义的条件,将会抛出BlockException异常,我们可以在catch块中编写相应的限流处理逻辑。最后,在finally块中,确保许可的释放,以便让其他请求能够继续访问资源。

Sentinel的应用场景

微服务架构:Sentinel可以在微服务架构中对不同服务进行流量控制,保护系统的稳定性。

API网关:Sentinel可以作为API网关的一部分,对外部请求进行限流和保护后端服务。

限制第三方访问:Sentinel可以针对某些敏感接口或第三方集成进行限流,保护系统安全性和资源的可用性。

总结

Sentinel是一款强大的流量控制组件,通过流控规则、统计信息和实时监控等机制,实现了灵活的限流策略和动态调整能力。它在微服务架构和高并发环境下具有广泛的应用场景,可以保护系统免受过载和崩溃的风险。对于开发者来说,深入理解Sentinel的限流原理和工作机制,将有助于优化系统的性能和稳定性。

Immer:无可变数据结构的魔术师

thbcm阅读(316)

在 JavaScript 应用程序中,管理和更新状态是一项重要的任务。然而,传统的状态管理方式往往需要进行手动的深拷贝和合并操作,这不仅繁琐而且容易引入错误。Immer 是一个令人兴奋的库,它通过使用不可变数据结构来简化状态管理过程,并提供了一种易于使用且高效的方式来更新状态。本文将深入介绍 Immer 的核心概念和工作原理,并展示如何在实际应用中使用 Immer。

Immer 的基本概念

Immer 基于不可变数据结构的理念,即数据一旦创建就不能被修改。不可变数据结构的好处包括更容易追踪状态变化、更好的性能和更简洁的代码。Immer 提供了一种简单而强大的方式来创建新的不可变状态。通过使用 Immer 提供的 produce 函数,可以在一个函数中描述状态的变化,而不需要手动复制和合并对象。

Immer 的工作原理

  • 结构共享:Immer 使用结构共享技术,即在创建新状态时,会尽量共享原始状态和中间状态的结构,以避免不必要的复制操作。这种结构共享的方式使得 Immer 在处理大型状态树时具有出色的性能。
  • 代理模式:Immer 使用 JavaScript 的代理(Proxy)特性来拦截对状态的修改操作,并根据修改操作的类型创建新的状态。这种代理模式不仅能够保护原始状态的不可变性,还能够跟踪状态的变化并生成新的不可变状态。

示例代码

下面是一个简单的示例代码,展示了如何使用 Immer 来创建和更新不可变数据:

import produce from 'immer';

// 初始状态
const initialState = {
    counter: 0,
    todos: []
};

// 更新状态
const newState = produce(initialState, draftState => {
    draftState.counter += 1;
    draftState.todos.push('New todo');
});

console.log(newState);

上述示例代码中,我们首先定义了初始状态 initialState,然后使用 produce 函数创建一个新的状态 newState。在 produce 函数的回调中,我们可以按照正常的方式更新状态,而 Immer 会自动处理状态的不可变性和结构共享。最后,我们打印出新的状态 newState,可以看到状态已经被正确地更新了。

Immer 的优势和应用场景

  • 简化状态管理:Immer 使得状态管理变得更加简单和直观,不再需要手动处理深拷贝和合并操作。
  • 性能优化:Immer 的结构共享和代理模式使得在处理大型状态树时具有出色的性能表现。
  • Redux 和 MobX 的整合:Immer 可以与流行的状态管理库(如 Redux 和 MobX)很好地配合使用,提供更好的状态管理体验。

总结

Immer 是一个强大且简单易用的 JavaScript 库,通过提供不可变数据结构和简化状态更新的方式,极大地简化了状态管理的过程。本文介绍了 Immer 的基本概念、工作原理以及实际应用示例。使用 Immer 可以使代码更加清晰、易于维护,并提升应用程序的性能。无论是在小型应用还是大型项目中,Immer 都是一个值得尝试的工具,它将成为开发者的魔术师,帮助管理和更新状态变得更加轻松和愉快。

掌握array_walk()函数:解锁PHP数组操作的神奇力量!

thbcm阅读(307)

在 PHP 开发过程中,我们经常需要对数组进行遍历和处理。array_walk() 函数是 PHP 函数库中的一个重要工具,它提供了一种便捷的方式来对数组中的每个元素执行自定义操作。本文将深入探讨 array_walk() 函数的使用方法和内部机制,帮助开发者更好地理解和应用该函数。

array_walk() 函数的基本概念

array_walk() ​函数用于对数组中的每个元素应用用户自定义的回调函数。通过 ​array_walk()​ 函数,我们可以实现对数组的遍历、修改、删除或其他自定义操作。

array_walk() 函数的语法

array_walk($array, $callback, $userdata)
  • $array​:要遍历的数组(传递的是引用)。
  • $callback​:要应用于数组每个元素的自定义回调函数。
  • $userdata​(可选):传递给回调函数的额外参数。

array_walk() 函数的工作原理

  • array_walk()​ 函数遍历数组中的每个元素,并将其传递给用户自定义的回调函数进行处理。
  • 在回调函数中,我们可以对数组元素进行任何操作,如修改元素值、删除元素或其他自定义操作。
  • array_walk()​ 函数通过引用传递数组,因此在回调函数中对数组的修改将影响原始数组。

示例代码

下面是几个示例代码,展示了如何使用 ​array_walk()​ 函数对数组进行遍历和修改:

  • 示例 1:将数组中的元素转换为大写
    $array = ['apple', 'banana', 'cherry'];
    
    function convertToUpper(&$item)
    {
        $item = strtoupper($item);
    }
    
    array_walk($array, 'convertToUpper');
    
    print_r($array);
  • 示例 2:删除数组中的空值
    $array = ['apple', '', 'banana', '', 'cherry'];
    
    function removeEmptyValues(&$item)
    {
        if ($item === '') {
            $item = null;
        }
    }
    
    array_walk($array, 'removeEmptyValues');
    $array = array_filter($array);
    
    print_r($array);
  • 示例 3:自定义操作
    $array = [1, 2, 3, 4, 5];
    
    function customOperation(&$item, $key, $userData)
    {
        $item = $item * $userData;
    }
    
    array_walk($array, 'customOperation', 10);
    
    print_r($array);

array_walk() 函数的优势和应用场景

  • 灵活性:array_walk()​ 函数允许开发者自定义操作,对数组进行灵活的遍历和修改。
  • 代码简洁性:通过使用 ​array_walk()​ 函数,可以避免编写显式的循环结构,使代码更加简洁和易读。
  • 数组操作的便捷性:array_walk()​ 函数提供了一种方便的方式来对数组进行修改、删除或其他自定义操作。

总结

array_walk()​ 函数是 PHP 函数库中一个强大而灵活的工具,可以简化对数组的遍历和处理。本文详细介绍了 ​array_walk()​ 函数的基本概念、语法和工作原理,并通过示例代码演示了其用法。通过​array_walk()​ 函数,开发者可以更加便捷地对数组进行自定义操作,提高代码的灵活性和简洁性。无论是对数组元素的转换、删除还是其他自定义操作,​array_walk()​ 函数都是一个强大的工具。掌握 ​array_walk()​ 函数的使用方法,将为 PHP 开发带来更多可能性和便利性。

联系我们