解密C++成员初始化列表的高效之道

thbcm阅读(260)

在C++中,对象的构造过程是一个重要的环节。其中,成员变量的初始化是构造过程中必不可少的一部分。C++提供了多种方式来初始化成员变量,其中成员初始化列表(Member Initialization List)被认为是一种高效的初始化方式。相比于在构造函数体内进行赋值操作,它具有更高的效率和一些额外的优势。本文将深入探讨C++成员初始化列表的原理和优势,以及为什么它被认为是一种高效的初始化方式。
成员初始化列表的原理

成员初始化列表是在构造函数的参数列表之后,使用冒号分隔的一组初始化语句。它可以在构造函数体执行之前,直接对成员变量进行初始化。示例如下:

class MyClass {
private:
    int myInt;
    double myDouble;
public:
    MyClass(int i, double d) : myInt(i), myDouble(d) {}
};

在上述示例中,构造函数MyClass(int i, double d)的成员初始化列表部分为: myInt(i), myDouble(d)。通过成员初始化列表,可以直接对myIntmyDouble进行初始化赋值。

成员初始化列表的优势

成员初始化列表相比于在构造函数体内进行赋值操作,具有以下几个优势:

  • 效率高:成员初始化列表可以直接在对象构造之初对成员变量进行初始化,避免了先调用默认构造函数再进行赋值的过程,从而提高了初始化的效率。
  • 避免不必要的初始化:通过成员初始化列表,可以精确地对成员变量进行初始化,避免了不必要的默认初始化。这对于非内置类型的成员变量来说尤为重要,因为它们可能需要进行昂贵的构造过程。
  • 对常量成员和引用成员的必要性:在C++中,常量成员和引用成员必须在对象构造时进行初始化。成员初始化列表提供了在构造函数中初始化这些特殊类型成员的唯一方式。
  • 支持初始化非静态常量成员:成员初始化列表允许对非静态常量成员进行初始化。这是因为非静态常量成员在对象构造之前就需要确定其值,而成员初始化列表可以满足这一需求。

应用场景

成员初始化列表尤其适用于以下情况:

  • 初始化常量成员和引用成员:常量成员和引用成员必须在对象构造时进行初始化,而成员初始化列表是唯一支持这种初始化的方式。
  • 避免不必要的默认初始化:如果成员变量的默认构造函数执行开销较大,或者需要传递参数进行初始化,使用成员初始化列表可以避免不必要的默认初始化。
  • 初始化非静态常量成员:非静态常量成员在对象构造之前需要确定其值,成员初始化列表可以满足这一需求。

值得注意的是,对于简单的成员变量,使用成员初始化列表并不一定会带来巨大的性能提升。在这种情况下,选择更符合代码可读性和维护性的方式可能更为合适。

总结

C++成员初始化列表是一种高效的初始化方式,它可以直接在对象构造之初对成员变量进行初始化,提高了初始化的效率并避免了不必要的默认初始化。通过成员初始化列表,可以精确地对常量成员和引用成员进行初始化,同时支持非静态常量成员的初始化。在适用的场景下,成员初始化列表是一种推荐使用的初始化方式,可以提升代码的效率和可读性。
DoWhy:Python 中的因果推断库

thbcm阅读(337)

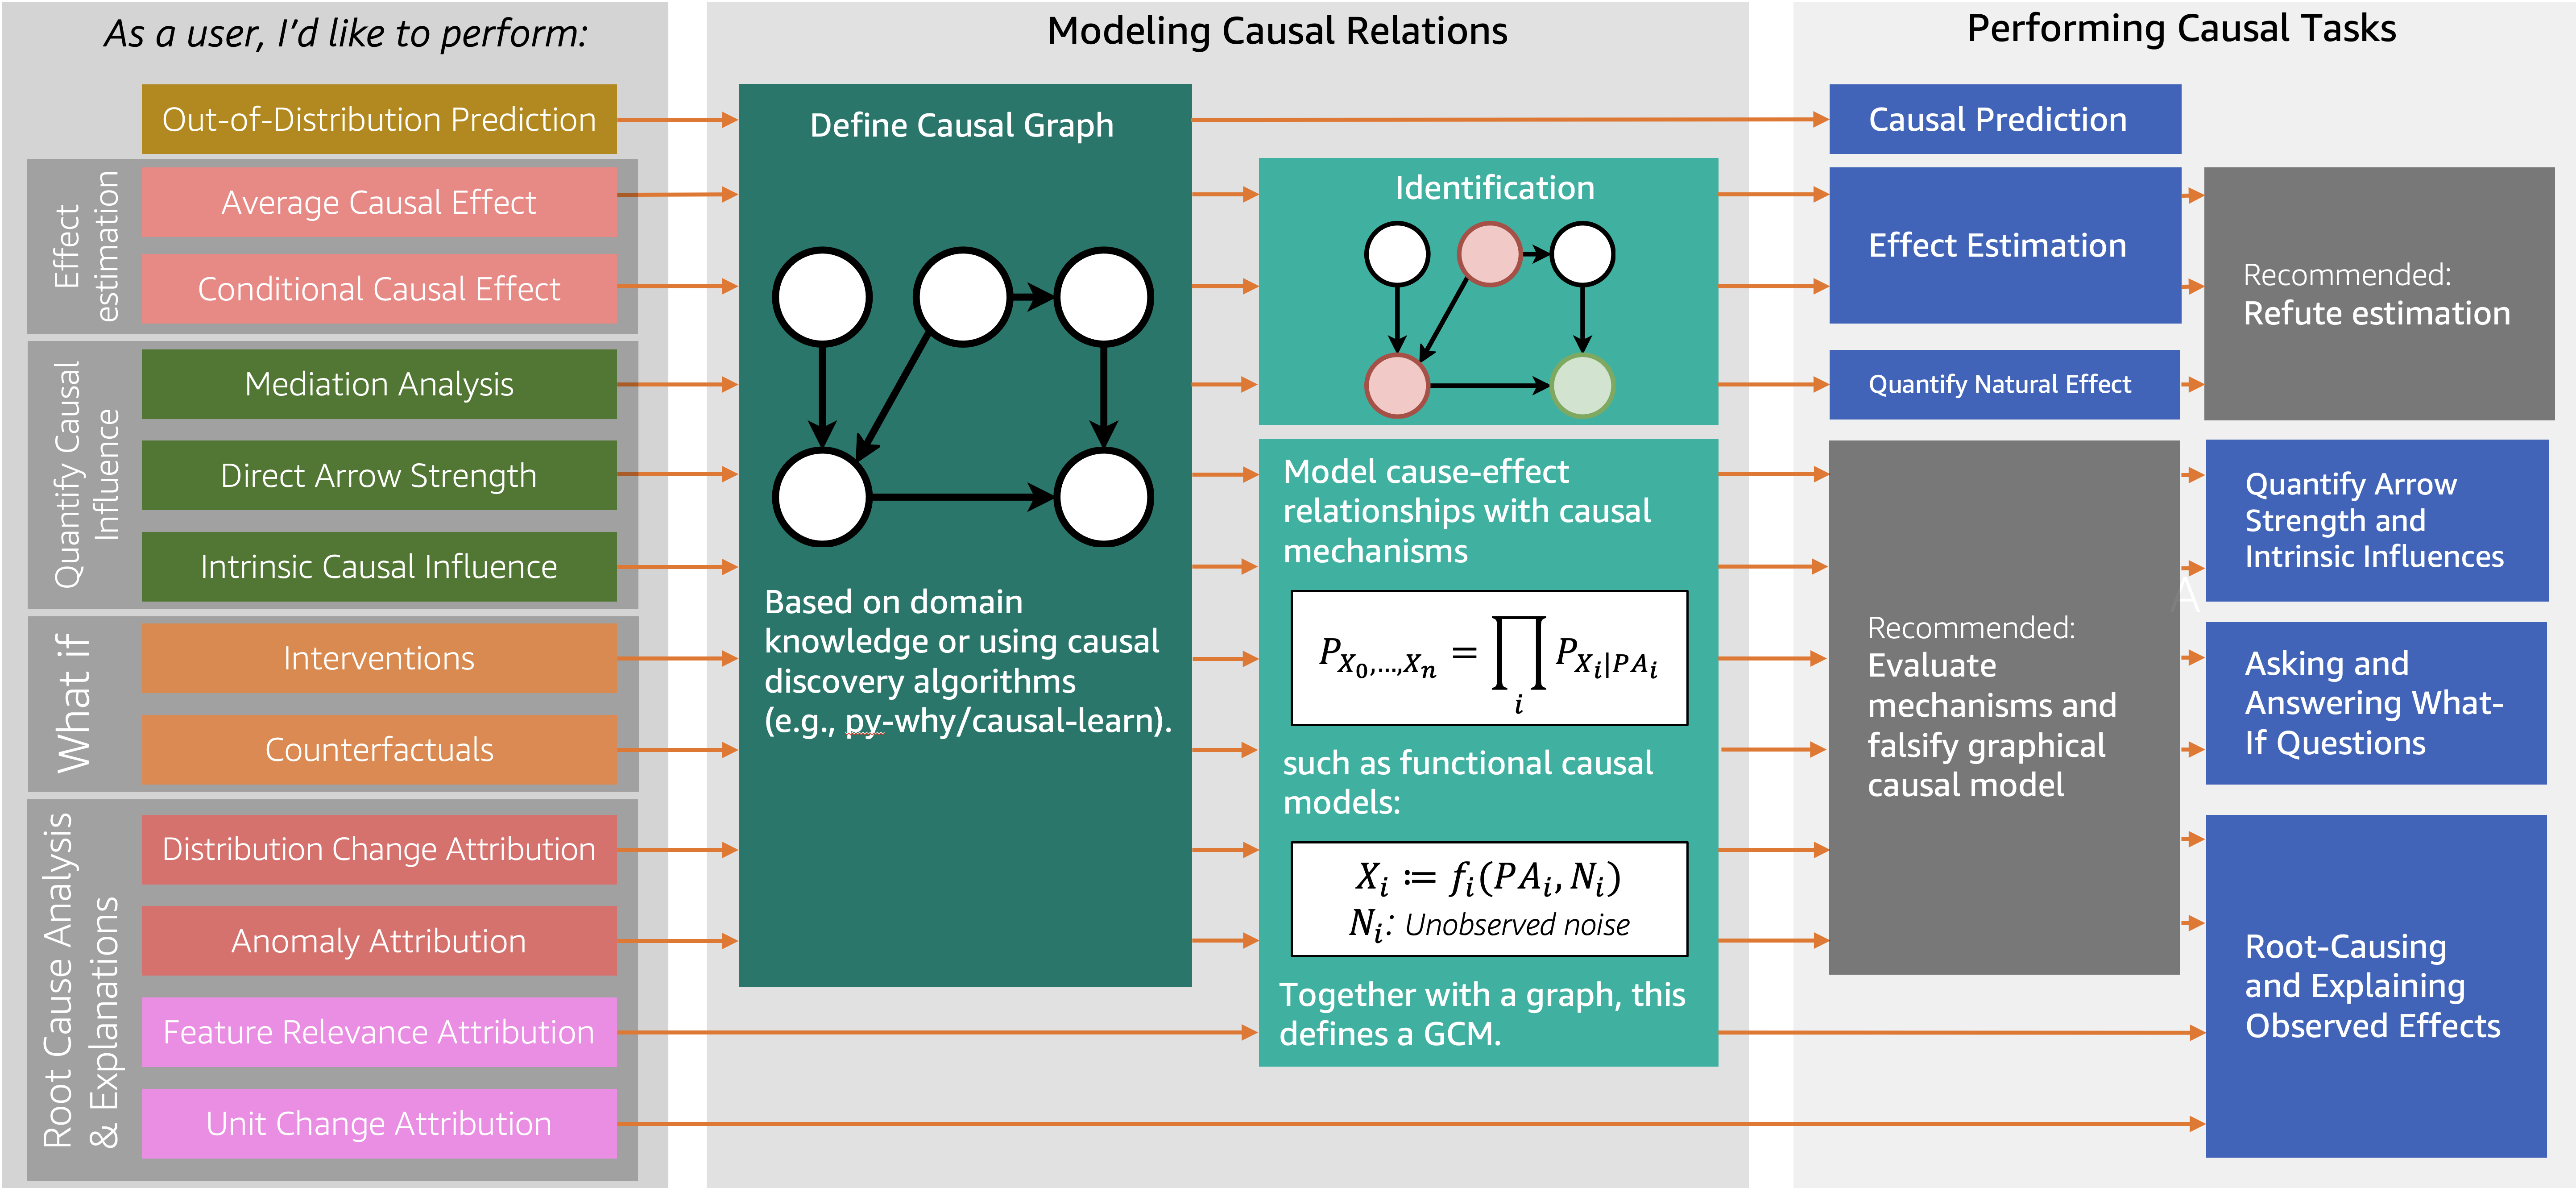
DoWhy 是一个强大的 Python 库,用于因果推断和因果推断分析。本文将介绍 DoWhy 的基本概念、主要功能和使用方法,帮助读者了解如何利用该库进行因果推断,并解决因果关系的相关问题。

什么是DoWhy?

DoWhy 是一个在 Python 中开发的因果推断库,旨在帮助研究人员和数据科学家分析和理解因果关系。它提供了一个框架,使得因果推断变得简单而直观,同时充分利用了现有的因果推断方法和工具。

DoWhy 的核心思想是通过建立因果模型来分析因果关系。它基于因果图的概念,将因果关系表示为变量之间的有向图。利用这个图,DoWhy 可以自动执行因果推断算法,并提供因果效应估计、因果关系识别和因果问题评估等功能。

DoWhy 的主要功能

DoWhy 提供了一系列功能,使得进行因果推断和因果推断分析变得更加容易。

  • 因果模型建立:DoWhy 允许用户根据问题领域的特定需求,构建因果模型。通过定义因果图中的变量和因果关系,您可以明确指定因果模型的结构。
  • 因果效应估计:DoWhy 支持对因果效应进行估计。它可以帮助您确定一个变量对另一个变量的因果影响,并提供因果效应的估算结果和置信区间。
  • 因果关系识别:DoWhy 可以帮助您识别数据中的因果关系。通过分析因果图和执行因果推断算法,DoWhy 可以确定变量之间的因果关系,并揭示数据中的潜在因果机制。
  • 因果问题评估:DoWhy 支持评估因果问题的合理性和可解释性。通过执行因果推断分析,您可以验证因果模型的合理性,并评估因果关系的解释力和预测能力。
  • 可视化和解释:DoWhy 提供了可视化工具和解释功能,帮助用户理解和解释因果推断的结果。它可以生成因果图的可视化表示,并提供解释因果效应的结果。

DoWhy 的使用示例

下面是一个简单的示例,演示如何使用 DoWhy 进行因果推断分析:

from dowhy import CausalModel

# 创建因果模型
model = CausalModel(
    data=data,
    treatment='X',
    outcome='Y',
    graph='graph.dot'
)

# 估计因果效应
identified_estimand = model.identify_effect(proceed_when_unidentifiable=True)
estimate = model.estimate_effect(identified_estimand,
                                 method_name='backdoor.propensity_score_matching')

# 可视化和解释结果
model.view_model()
model.show_graph()
print(estimate)

在上述示例中,我们首先导入 DoWhy 库,并创建一个 CausalModel 对象。我们指定了数据、处理变量(treatment)、结果变量(outcome)和因果图(graph)。

然后,我们使用 identify_effect() 方法识别因果效应,并使用 estimate_effect() 方法对因果效应进行估计。我们选择了基于倾向得分匹配的方法进行估计。

最后,我们使用 view_model() 和 show_graph() 方法可视化因果图,并打印出估计的因果效应结果。

总结

DoWhy 是一个强大的 Python 库,用于因果推断和因果推断分析。它提供了简单直观的框架,使得因果推断变得容易,并充分利用现有的因果推断方法和工具。DoWhy 提供了建立因果模型、估计因果效应、识别因果关系、评估因果问题和可视化解释结果等功能。通过使用 DoWhy,研究人员和数据科学家可以更轻松地进行因果推断分析,并解决与因果关系相关的问题。它为用户提供了一个强大的工具,帮助他们理解和解释数据中的因果关系,从而做出更准确和可靠的决策。希望本文能够帮助读者了解 DoWhy 的基本概念、主要功能和使用方法,并激发您在因果推断分析中利用 DoWhy 的创造力。

Django中的SQL注入攻击防御策略

thbcm阅读(290)

SQL注入是一种常见的网络安全威胁,可以导致数据库被非法访问和数据泄露。本文将介绍在Django框架中防止SQL注入攻击的关键方法,包括使用参数化查询、使用ORM、进行输入验证和使用安全的编码实践。

SQL注入是一种利用应用程序对用户输入的不当处理而导致的安全漏洞。攻击者可以通过恶意构造的输入来执行恶意的SQL语句,从而访问、修改或删除数据库中的数据。为了保护您的Django应用程序免受SQL注入攻击,您可以采取以下关键方法:

一、使用参数化查询

参数化查询是防止SQL注入的首要方法之一。它通过将用户输入作为查询参数而不是直接将其嵌入到SQL语句中来实现。Django中的ORM和原生SQL查询都支持参数化查询。

使用ORM(对象关系映射)是一种推荐的方法,它可以自动处理参数化查询。ORM会将用户输入转换为安全的查询参数,并确保输入的值不会被误解为SQL代码。

示例:

from django.db import models

# 使用ORM进行参数化查询
def get_user(username):
    return User.objects.raw('SELECT * FROM users WHERE username = %s', [username])

使用ORM

Django的ORM提供了一个安全的数据库访问接口,可以防止SQL注入。ORM会自动转义和引用输入,以防止恶意代码的注入。

使用ORM的主要好处之一是它可以处理输入的转义和引用,而无需手动编写SQL查询。ORM负责生成安全的SQL查询,并确保用户输入不会被误解为SQL代码。

示例:

from django.contrib.auth.models import User

# 使用ORM进行查询
def get_user(username):
    return User.objects.filter(username=username)

进行输入验证

进行输入验证是防止SQL注入的关键步骤之一。在接受用户输入之前,始终对输入进行验证和过滤。确保只接受预期的输入,并拒绝包含恶意代码的输入。

在Django中,可以使用表单验证或DRF(Django REST Framework)的序列化器来验证用户输入。这些验证机制可以帮助您确保输入的数据符合预期格式和类型,并排除潜在的恶意代码。

示例:

from django import forms

# 使用Django表单进行输入验证
class LoginForm(forms.Form):
    username = forms.CharField()
    password = forms.CharField(widget=forms.PasswordInput)

# 在视图中使用表单验证
def login(request):
    if request.method == 'POST':
        form = LoginForm(request.POST)
        if form.is_valid():
            username = form.cleaned_data['username']
            password = form.cleaned_data['password']
            # 处理用户登录逻辑
    else:
        form = LoginForm()
    return render(request, 'login.html', {'form': form})

使用安全的编码实践

编写安全的代码是防止SQL注入攻击的重要方面。确保您的代码遵循安全的编码实践,包括:

  • 不要将用户输入直接拼接到SQL查询中。
  • 不要信任用户输入,始终对输入进行验证和过滤。
  • 使用框架提供的安全机制,如Django的ORM和表单验证。
  • 定期更新和维护框架和依赖项,以获取最新的安全补丁和修复。

总结

保护您的Django应用程序免受SQL注入攻击是至关重要的。通过使用参数化查询、ORM、进行输入验证和采用安全的编码实践,您可以大大降低SQL注入的风险。遵循这些关键方法,您可以增强您的应用程序的安全性,并保护用户数据不受攻击的威胁。请记住,安全是一个持续的过程。除了上述方法之外,定期审查您的代码和安全策略,保持与Django社区和安全专家的沟通,以及及时更新和修复潜在的安全漏洞,都是确保应用程序安全的重要步骤。

Spring Boot的打包方式:JAR vs. WAR 打包方式

thbcm阅读(298)

Spring Boot是一个流行的Java开发框架,提供了快速、便捷的应用程序开发和部署方式。本文将介绍Spring Boot的两种常见打包方式:JAR和WAR。我们将深入探讨它们的特点、适用场景和部署方式,帮助开发人员选择适合他们应用程序的打包方式。

在使用Spring Boot开发应用程序时,打包是一个重要的环节。它决定了应用程序的部署方式和运行环境。Spring Boot提供了两种常见的打包方式:JAR(Java Archive)和WAR(Web Archive)。

JAR(Java Archive)打包方式

JAR是一种常见的Java打包格式,也是Spring Boot默认的打包方式。使用JAR方式打包的应用程序可以直接运行,不需要额外的应用服务器。

JAR打包方式的特点

  • 独立运行:JAR打包方式将应用程序和所有依赖的库打包到一个可执行的JAR文件中。这意味着应用程序可以独立运行,不依赖于外部的应用服务器。只需通过命令行或双击JAR文件即可启动应用程序。
  • 内嵌服务器:JAR打包方式内置了一个嵌入式的Servlet容器(通常是Tomcat、Jetty或Undertow),用于处理HTTP请求。这样一来,开发人员无需手动配置和部署外部的应用服务器,简化了部署和维护的复杂性。
  • 快速部署:由于JAR文件包含了所有依赖的库和运行时环境,因此部署非常简单快速。只需将JAR文件复制到目标服务器上,即可运行应用程序。
  • 可执行性:JAR文件可以被视为一个可执行的应用程序,可以在不同的操作系统上运行。这使得应用程序的交付和运行更加灵活和可移植。

WAR(Web Archive)打包方式

WAR是一种常见的Java Web应用程序打包格式,适用于传统的Java Web应用程序。使用WAR方式打包的应用程序需要部署到外部的Java应用服务器,如Tomcat、Jetty或WebSphere等。

WAR打包方式的特点

  • 传统Web部署:WAR打包方式适用于传统的Java Web应用程序,可以通过将WAR文件部署到外部的Java应用服务器来运行。开发人员可以利用Java EE的功能和特性来构建复杂的Web应用程序。
  • 外部服务器:WAR文件需要部署到外部的Java应用服务器中,该服务器负责处理HTTP请求和管理应用程序的生命周期。这样一来,开发人员可以选择不同的应用服务器来满足特定的需求。
  • 分离部署:WAR文件可以与应用服务器进行分离部署,使得应用程序的开发、测试和部署可以分别进行。这种分离性可以提高开发和部署的效率,同时也使得系统更易于维护和升级。

如何选择打包方式?

选择适合应用程序的打包方式需要考虑多个因素,包括应用程序的类型、部署环境和需求等。

使用JAR打包方式的场景

  • 开发独立的、自包含的应用程序。
  • 构建微服务或独立可执行的应用程序。
  • 希望快速部署和简化部署过程。
  • 偏重前端开发,不需要传统的Java Web应用程序功能和容器。

使用WAR打包方式的场景

  • 开发传统的Java Web应用程序,需要使用Java EE的功能和特性。
  • 需要与外部的Java应用服务器集成,如Tomcat、Jetty或WebSphere等。
  • 希望利用应用服务器的管理和监控功能。
  • 已有的应用程序基于WAR打包方式,需要与现有的部署环境兼容。

需要注意的是,Spring Boot提供了灵活的配置选项,可以根据需要自定义打包方式。开发人员可以根据具体情况选择JAR或WAR打包方式,或者进行混合部署,以满足特定的需求。

总结

本文介绍了Spring Boot的两种常见打包方式:JAR和WAR。JAR打包方式适用于独立运行的应用程序,它内嵌了Servlet容器,可以快速部署和独立运行。WAR打包方式适用于传统的Java Web应用程序,需要部署到外部的Java应用服务器中,并利用Java EE的功能和特性。选择适合应用程序的打包方式需要考虑应用程序的类型、部署环境和需求等因素。Spring Boot提供了灵活的配置选项,使开发人员能够根据具体情况选择适合的打包方式。

通俗易懂:快速排序算法全解析

thbcm阅读(271)

快速排序(Quick Sort)是一种高效的分治排序算法,它以其出色的性能和广泛的应用而闻名。本文将深入讲解快速排序的原理、步骤和时间复杂度,并探讨其优势和应用场景。

快速排序原理

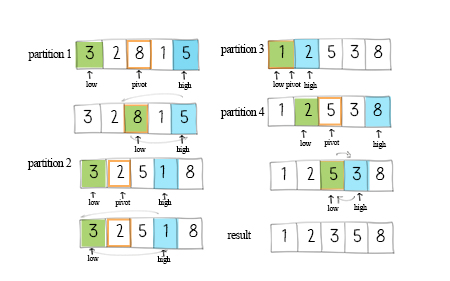
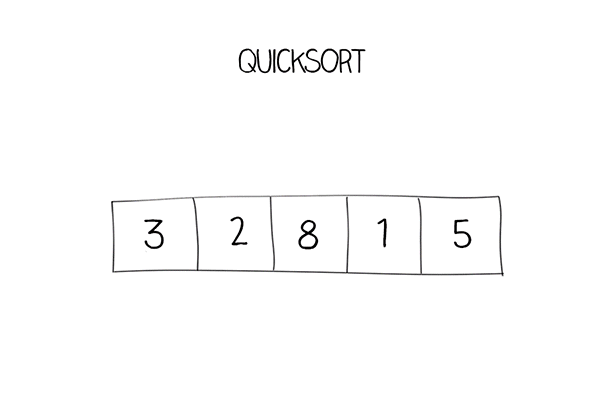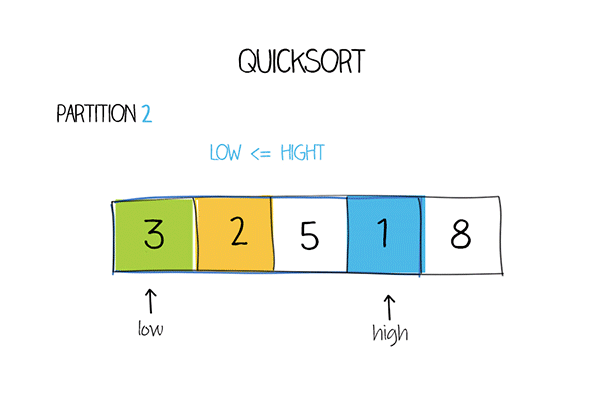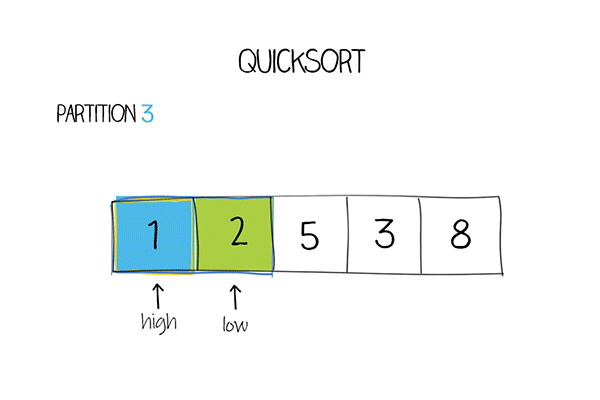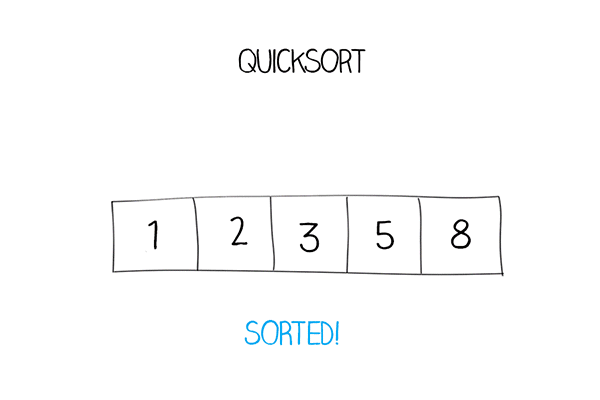
快速排序的核心思想是通过选择一个基准元素,将待排序数组分割为两个子数组,一部分小于基准,一部分大于基准。然后对两个子数组分别进行递归排序,最终将它们合并起来得到有序的结果。

快速排序步骤

具体步骤如下:

  1. 选择一个基准元素(通常是第一个或最后一个元素)。
  2. 设定两个指针,一个指向数组的起始位置,一个指向数组的末尾位置。
  3. 从右向左找到第一个小于基准的元素,从左向右找到第一个大于基准的元素,交换它们的位置。
  4. 重复步骤3,直到两个指针相遇。
  5. 将基准元素与指针相遇位置的元素进行交换,此时基准元素位于正确的位置。
  6. 对基准元素左边和右边的子数组分别进行递归排序,重复上述步骤。

示例代码

public class QuickSort {
	public static void quickSort(int[] a, int low, int high) {
            // low为起始索引,high为结束索引
	    int index = partition(a, low, high);
            // 对分割后的左半部分进行递归排序
	    if (low < index-1) quickSort(a, low, index-1);

            // 对分割后的左半部分进行递归排序

if (index < high) quickSort(a, index, high); } private static int partition(int[] a, int low, int high) {                 // 将数组a根据基准元素进行分割,并返回分割后基准元素的索引 int mid = low + (high-low)/2;// 计算数组的中间位置 int pivot = a[mid]; // 选择中间位置的元素作为基准元素      while (low <= high) {                     // 在基准元素左边找到第一个大于等于基准元素的元素的索引      while (a[low] < pivot) low ++;                     // 在基准元素右边找到第一个小于等于基准元素的元素的索引
     while (a[high] > pivot) high --;                     // 若找到的两个元素的索引仍满足low<=high,则交换两个元素的位置      if (low <= high) { swap(a, low, high);      low ++;     high --;     }      }             // 返回基准元素的索引,用于后续的递归排序 return low; }         // 交换数组两个元素的位置 private static void swap(int[] a, int i, int j) { int tmp = a[i]; a[i] = a[j]; a[j] = tmp; } }

时间复杂度

快速排序的平均时间复杂度为O(nlogn),其中n为待排序数组的长度。这是因为每次分割都将数组划分为大致相等的两部分,而递归的深度为logn。在最坏情况下,如果每次划分都不平衡,时间复杂度可能达到O(n^2)。

为了避免最坏情况的发生,可以采用一些优化策略,如随机选择基准元素或使用三数取中法来选择基准元素,以提高算法的性能和稳定性。

快速排序的优势

快速排序具有以下优势:

  • 高效性能:平均情况下,快速排序是最快的排序算法之一,尤其适用于大规模数据的排序。
  • 原地排序:快速排序可以在原始数组上进行排序,不需要额外的空间。
  • 适应性:快速排序在处理部分有序数组时仍然具有较好的性能。

总结

快速排序是一种高效的分治排序算法,通过选择基准元素和不断划分子数组来实现排序。它具有优秀的性能和广泛的应用场景,特别适合处理大规模数据集。了解快速排序的原理和步骤,以及掌握优化策略,可以帮助开发人员选择合适的算法,并编写出高效的排序代码。

NumPy:Python的强大数值计算库

thbcm阅读(281)

NumPy(Numerical Python)是Python中最常用和最强大的数值计算库之一。它提供了高性能的多维数组对象和广泛的数学函数,使得在Python中进行科学计算和数据分析变得更加简单和高效。本文将介绍NumPy的主要特点、常用功能和应用场景,以展示它在数据科学领域的重要性和价值。

NumPy的主要特点

NumPy具有以下主要特点:

  • 多维数组对象:NumPy的核心是ndarray(N-dimensional Array)对象,它是一个多维同类数据容器。这意味着可以在NumPy中高效地存储和操作多维数组,例如向量、矩阵和张量等。ndarray对象具有统一的数据类型和固定的大小,能够在不同的数值计算任务中提供高效的数据存储和处理。
  • 快速数值计算:NumPy通过使用底层高效的C语言编写的函数库,实现了对大规模数组的快速数值计算。它提供了丰富的数学和科学函数,例如线性代数、傅里叶变换、随机数生成等,以及广播(broadcasting)机制,使得对整个数组或数组之间的元素进行快速操作成为可能。
  • 内存效率:NumPy的ndarray对象在内存中以连续的块存储数据,这样可以减少内存开销并提高数据访问速度。与Python内置的列表相比,NumPy的数组可以更高效地处理大量数据,从而节省内存和提升计算性能。

常用功能和示例

  • 创建NumPy数组:使用NumPy可以方便地创建各种类型的数组,例如一维数组、二维数组和随机数组等。以下是创建NumPy数组的几个常见方法:
    import numpy as np
    
    # 创建一维数组
    arr1 = np.array([1, 2, 3, 4, 5])
    
    # 创建二维数组
    arr2 = np.array([[1, 2, 3], [4, 5, 6]])
    
    # 创建全零数组
    zeros_arr = np.zeros((3, 3))
    
    # 创建全一数组
    ones_arr = np.ones((2, 2))
    
    # 创建随机数组
    random_arr = np.random.rand(3, 3)
  • 数组操作和运算:NumPy提供了丰富的数组操作和运算功能,使得对数组的操作变得简单和高效。以下是一些常见的操作和运算示例:
    import numpy as np
    
    # 数组形状操作
    arr = np.array([[1, 2, 3], [4, 5, 6]])
    shape = arr.shape  # 获取数组形状
    reshaped_arr = arr.reshape((3, 2))  # 改变数组形状
    
    # 数组索引和切片
    element = arr[0, 1]  # 获取数组元素
    sliced_arr = arr[:, 1:3]  # 切片获取子数组
    
    # 数组运算
    arr1 = np.array([1, 2, 3])
    arr2 = np.array([4, 5, 6])
    sum_arr = arr1 + arr2  # 数组相加
    dot_product = np.dot(arr1, arr2)  # 数组点积
  • 科学计算和数据分析:NumPy在科学计算和数据分析领域得到广泛应用。它与其他数据科学库(如Pandas、SciPy和Matplotlib)的无缝集成使得数据处理、统计分析和可视化等任务更加便捷。以下是一些常见的科学计算和数据分析示例:
    import numpy as np
    
    # 数组形状操作
    arr = np.array([[1, 2, 3], [4, 5, 6]])
    shape = arr.shape  # 获取数组形状
    reshaped_arr = arr.reshape((3, 2))  # 改变数组形状
    
    # 数组索引和切片
    element = arr[0, 1]  # 获取数组元素
    sliced_arr = arr[:, 1:3]  # 切片获取子数组
    
    # 数组运算
    arr1 = np.array([1, 2, 3])
    arr2 = np.array([4, 5, 6])
    sum_arr = arr1 + arr2  # 数组相加
    dot_product = np.dot(arr1, arr2)  # 数组点积

NumPy的应用场景

NumPy在众多领域中发挥着重要作用,特别是在以下领域:

  • 科学计算和数值模拟:NumPy的高性能和丰富的数学函数使得在科学计算和数值模拟中能够高效地处理大规模数据和复杂计算任务。
  • 数据分析和统计建模:NumPy与其他数据科学库的结合,为数据分析、统计建模和机器学习提供了强大的基础工具,例如数据清洗、特征提取和模型训练等。
  • 图像处理和计算机视觉:NumPy的多维数组和快速运算能力使得图像处理和计算机视觉算法的实现更加高效和简洁。
  • 信号处理和音频处理:NumPy提供了信号处理和音频处理相关的函数和工具,例如傅里叶变换、滤波器设计和音频特征提取等。

总结

NumPy是Python中一款强大且广泛应用的数值计算库,它提供了高性能的多维数组对象和丰富的数学函数,使得在Python中进行科学计算和数据分析变得更加简单和高效。通过NumPy,我们可以方便地创建、操作和运算多维数组,并在科学计算、数据分析和图像处理等领域中发挥重要作用。无论是初学者还是专业人士,掌握NumPy都是进行Python数据科学和数值计算的重要基础。

Zustand:简化状态管理的现代React状态库

thbcm阅读(349)

Zustand是一个用于管理状态的现代React状态库。它提供了简洁、可扩展和高效的状态管理解决方案,使得在React应用中处理复杂的状态逻辑变得更加容易和直观。本文将介绍Zustand的主要特点、使用方法以及它在React开发中的优势和应用场景。

Zustand的主要特点

Zustand具有以下主要特点:

  • 简洁和直观:Zustand的API设计简洁直观,易于上手和使用。它采用了类似于React Hook的函数式编程风格,使得状态管理代码可以与组件逻辑紧密结合,减少了样板代码的编写。
  • 可扩展和灵活:Zustand提供了灵活的状态定义和更新方式。它支持使用纯JavaScript对象定义状态,并通过使用immer库实现了无需手动编写不可变更新逻辑。此外,Zustand还支持使用中间件来扩展其功能,例如日志记录、异步操作和持久化等。
  • 高性能:Zustand通过使用React的Context API和浅层比较来实现高性能的状态更新。它仅会通知相关的订阅者进行重新渲染,而不需要整个应用重新渲染。这种精细的状态更新机制可以提高应用的性能和响应能力。

使用Zustand

  1. 安装和引入:要使用Zustand,首先需要在React项目中安装它:
    npm install zustand

    然后,在需要使用状态管理的组件中引入Zustand:

    import create from 'zustand';
  2. 定义状态和更新函数:使用Zustand,可以通过调用create函数来定义状态和更新函数。以下是一个简单的示例:
    const useCounter = create((set) => ({
      count: 0,
      increment: () => set((state) => ({ count: state.count + 1 })),
      decrement: () => set((state) => ({ count: state.count - 1 })),
    }));

    在上面的例子中,create函数接受一个回调函数,该回调函数接受一个set函数作为参数,用于更新状态。在这个回调函数中,我们定义了一个count状态和两个更新函数incrementdecrement

  3. 在组件中使用状态:在组件中,可以使用useCounter自定义钩子来获取状态和更新函数,然后在组件中使用它们:
    import React from 'react';
    import { useCounter } from './useCounter';
    
    function Counter() {
      const { count, increment, decrement } = useCounter();
    
      return (
        <div> <p>Count: {count}</p> <button onClick={increment}>Increment</button> <button onClick={decrement}>Decrement</button> </div> ); }

    在上面的例子中,我们使用useCounter钩子获取了count状态和incrementdecrement更新函数,并在组件中展示了计数器和两个按钮。

Zustand的优势和应用场景

Zustand在React开发中具有一些重要的优势和适用场景:

  • 简化状态管理:Zustand通过简洁的API和直观的设计,大大简化了状态管理的复杂性。它使得开发人员可以更专注于组件逻辑,而无需花费太多精力在状态管理上。
  • 高性能和可伸缩性:Zustand的高性能状态更新机制和精细的订阅机制使得应用程序能够实现高性能和可伸缩性。它只会更新与状态相关的组件,而不需要重新渲染整个应用程序。这对于大型和复杂的应用程序特别有用。
  • 中间件支持:Zustand提供了中间件支持,可以通过中间件扩展其功能。这使得在状态管理中实现一些常见的功能,如异步操作、日志记录和持久化等,变得更加容易和灵活。
  • 适用于小型和中型应用:Zustand尤其适用于小型和中型应用程序,其中状态管理需求相对较简单。它提供了一种轻量级的状态管理解决方案,避免了引入过多的复杂性和学习成本。

总结

Zustand是一个简洁、可扩展和高性能的React状态库。它简化了状态管理的复杂性,提供了直观的API和灵活的状态更新方式。通过使用Zustand,开发人员可以更加专注于组件逻辑,同时实现高性能和可伸缩性的状态管理。无论是小型还是中型的React应用程序,Zustand都是一个值得考虑的状态管理解决方案。

JavaScript中的for循环和map方法

thbcm阅读(351)

在JavaScript中,循环是一种常见的编程技巧,用于重复执行一段代码。for循环和map方法都可以用于循环操作,但它们在语法和应用场景上存在一些区别。本文将详细讲解JavaScript中的for循环和map方法,以及它们之间的区别和适用场景。

for循环

for循环是JavaScript中最基本和常见的循环结构之一。它的语法如下:

for (初始化表达式; 条件表达式; 更新表达式) {
  // 循环体代码
}

for循环由三个部分组成:

  • 初始化表达式(Initialization Expression):用于初始化循环变量的值,只在循环开始时执行一次。
  • 条件表达式(Condition Expression):用于判断循环是否继续执行,如果条件为真,则执行循环体代码;如果条件为假,则跳出循环。
  • 更新表达式(Update Expression):在每次循环迭代结束后执行,用于更新循环变量的值。

for循环的优点是灵活性高,可以根据需要自定义循环变量的初始值、循环条件和每次循环迭代后的更新操作。它适用于需要精确控制循环过程和迭代次数的情况。

以下是一个使用for循环计算数组中元素总和的示例:

const numbers = [1, 2, 3, 4, 5];
let sum = 0;

for (let i = 0; i < numbers.length; i++) {
  sum += numbers[i];
}

console.log(sum); // 输出:15

map方法

map方法是JavaScript数组对象的一个内置方法,用于对数组中的每个元素执行指定的操作,并返回一个新数组。它的语法如下:

array.map(function(currentValue, index, array) {
  // 返回新数组元素的操作代码
}, thisArg);

map方法接受一个回调函数作为参数,回调函数可以接受三个参数:

  • currentValue:当前正在被处理的数组元素。
  • index(可选):当前元素在数组中的索引。
  • array(可选):被调用的数组对象。

回调函数中的操作代码将应用于数组中的每个元素,并将返回的值组成一个新的数组。

map方法的优点是它提供了一种简洁的方式来对数组进行遍历和转换,它会自动遍历整个数组,并返回一个新的数组,而不会改变原始数组。它适用于需要对数组中的每个元素进行操作并生成新数组的情况。

以下是一个使用map方法将数组中的每个元素加倍的示例:

const numbers = [1, 2, 3, 4, 5];
const doubledNumbers = numbers.map(function(num) {
  return num * 2;
});

console.log(doubledNumbers); // 输出:[2, 4, 6, 8, 10]

区别

for循环和map方法在语法和应用场景上存在一些区别:

  • 语法:for循环需要手动编写循环变量的初始化、条件判断和更新操作,而map方法则通过回调函数自动遍历数组中的每个元素,并返回一个新数组。
  • 原数组改变:for循环不会改变原始数组,而map方法返回一个新数组,不改变原始数组。
  • 循环中断:for循环可以通过break语句提前跳出循环,而map方法会遍历整个数组。
  • 返回值:for循环没有固定的返回值,而map方法始终返回一个新数组。

应用场景

  • for循环适用于需要精确控制循环过程和迭代次数的情况,可以灵活地定义循环变量的初始值、循环条件和更新操作。它通常用于需要在循环过程中执行复杂的逻辑、条件判断或者控制流程的情况下。
  • map方法适用于需要对数组中的每个元素进行操作,并返回一个新数组的情况。它提供了一种简洁的方式来遍历数组,并对每个元素执行相同的操作。常见的应用场景包括对数组中的元素进行转换、筛选、映射等操作。

总结

for循环,灵活性高,适用于精确控制循环过程和迭代次数的情况。map方法,简洁性高,适用于对数组中的每个元素进行操作并生成新数组的情况。在实际应用中,根据具体需求和情况选择使用for循环还是map方法,可以提高代码的可读性和开发效率。

Golang中的fmt包:格式化输入输出的利器

thbcm阅读(320)

在软件开发的世界里,fmt包就像是一位忠实的伙伴,始终陪伴着开发人员。它简化了格式化输入输出的过程,让打印和扫描数据变得轻松自如。无论是向控制台输出简单的消息,还是处理复杂的字符串格式化,fmt包都展现出了其强大而灵活的特性。它是开发人员的得力助手,让我们能够以更高效、更有表现力的方式与程序交互。

fmt包是什么

在Go语言中,fmt包是一个非常重要且常用的标准库,提供了格式化输入输出的功能。它被广泛用于打印和扫描数据,以及进行字符串和日志的处理。fmt包为开发人员提供了强大而灵活的工具,使得处理各种输入输出需求变得简单而直观。

格式化输出

fmt包提供了多个函数用于格式化输出,最常用的是Printf、Println和Print函数。下面是它们的简单示例:

  • Printf函数:用于格式化输出到标准输出。它接受一个格式字符串作为第一个参数,类似于C语言中的printf函数。
    fmt.Printf("Hello, %s! You are %d years old.\n", "John", 25)
    // 输出:Hello, John! You are 25 years old.
  • Println函数:用于输出到标准输出,并在输出的末尾添加一个换行符。
    fmt.Println("Hello, World!")
    // 输出:Hello, World!
  • Print函数:用于输出到标准输出,不添加换行符。
    fmt.Print("Hello, ")
    fmt.Print("World!")
    // 输出:Hello, World!

这些函数都支持格式化字符串中的占位符,可以按照指定的格式输出各种类型的数据。

格式化输入

除了输出,fmt包还提供了Scan和Scanf函数用于格式化输入。这些函数可以从标准输入读取用户输入,并将输入的内容存储到指定的变量中。

  • Scan函数:用于读取用户输入,并将输入的内容存储到指定的变量中。
    var name string
    fmt.Print("Enter your name: ")
    fmt.Scan(&name)
    fmt.Printf("Hello, %s!\n", name)
  • Scanf函数:用于读取用户输入,并按照指定的格式将输入的内容存储到指定的变量中。
    var age int
    fmt.Print("Enter your age: ")
    fmt.Scanf("%d", &age)
    fmt.Printf("You are %d years old.\n", age)

这些函数在读取用户输入时会阻塞程序的执行,直到用户输入完成并按下回车键。

错误处理与调试

fmt包的另一个重要功能是错误处理和调试信息输出。其中,Errorf函数和Fprintf函数是常用的函数:

  • Errorf函数:用于生成格式化的错误信息,并返回一个错误值。
    import "errors"
    
    func divide(a, b float64) (float64, error) {
        if b == 0 {
            return 0, fmt.Errorf("division by zero")
        }
        return a / b, nil
    }
    
    result, err := divide(10, 0)
    if err != nil {
        fmt.Println("Error:", err)
    }
  • Fprintf函数:用于将格式化的字符串输出到指定的io.Writer。
    import "os"
    
    fmt.Fprintf(os.Stderr, "An error occurred: %s\n", err)

这些函数可以帮助我们在程序中捕捉错误并输出有用的调试信息,以便进行错误处理和调试。

更多函数和高级用法

除了上述介绍的常用函数,fmt包还提供了许多其他有用的函数,如Sprintf、Scanln、Fscan和Fprintln等。这些函数可以满足更复杂的格式化输入输出需求。

此外,fmt包还支持自定义类型的格式化输出,通过实现Stringer接口和Error接口来自定义类型的字符串输出和错误处理。

总结

fmt包是Go语言中一个非常强大和实用的标准库,提供了丰富的格式化输入输出功能,可以满足我们的日常开发需求。通过学习和掌握fmt包的使用,我们可以实现数据的格式化输出、读取用户输入、错误处理和调试信息输出等操作,提高代码的可读性和开发效率。无论是在控制台应用程序还是Web应用程序中,fmt包都是我们经常使用的工具之一。通过合理地利用fmt包的函数和功能,我们可以更好地处理输入输出和错误处理,使程序更加健壮和可靠。

软件架构与系统架构:区别与联系的分析

thbcm阅读(290)

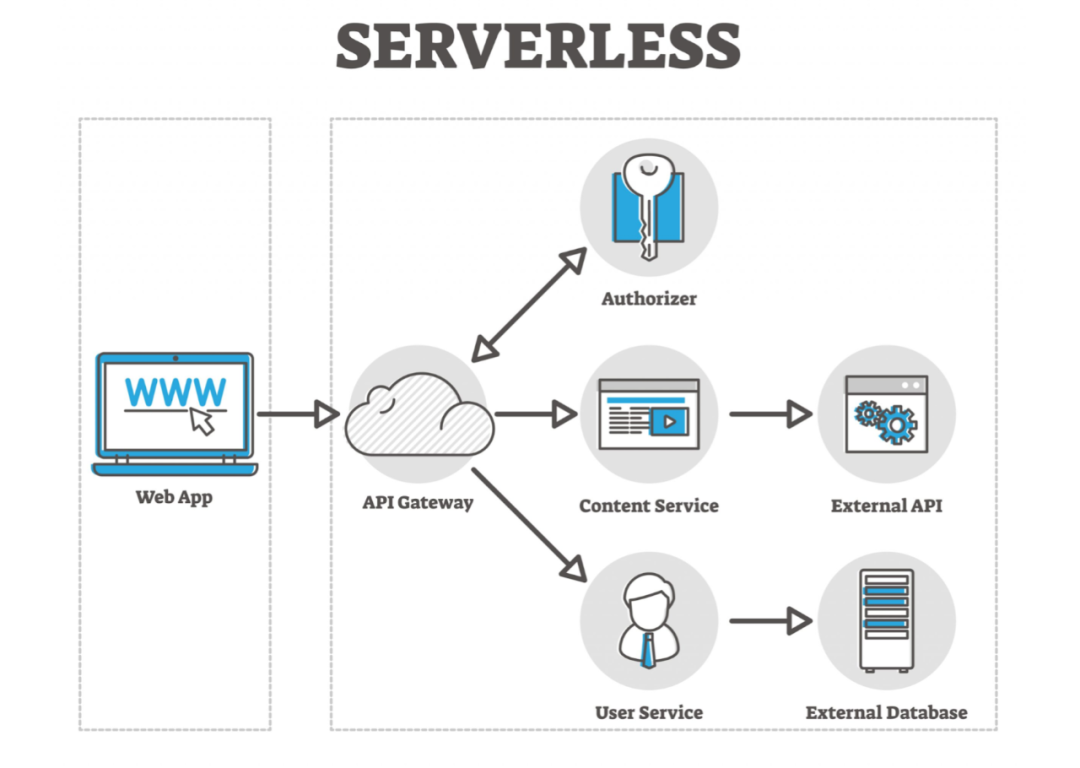
在信息技术领域,软件架构和系统架构这两个术语经常被提及。尽管它们在某些方面有重叠,但它们确实代表了不同的概念和聚焦点。理解这两种架构之间的区别和联系对于任何从事技术开发和设计的专业人士都是至关重要的。本文旨在深入探讨软件架构与系统架构的定义、差异以及它们之间的相互关系。

软件架构的定义与特点

软件架构关注于软件系统的内部结构和设计。它包括软件系统的组件、这些组件之间的关系以及它们与外部环境的交互方式。软件架构的主要目标是确保软件系统的可维护性、可扩展性和性能。常见的软件架构模式包括微服务、MVC(模型-视图-控制器)、事件驱动架构等。

系统架构的定义与特点

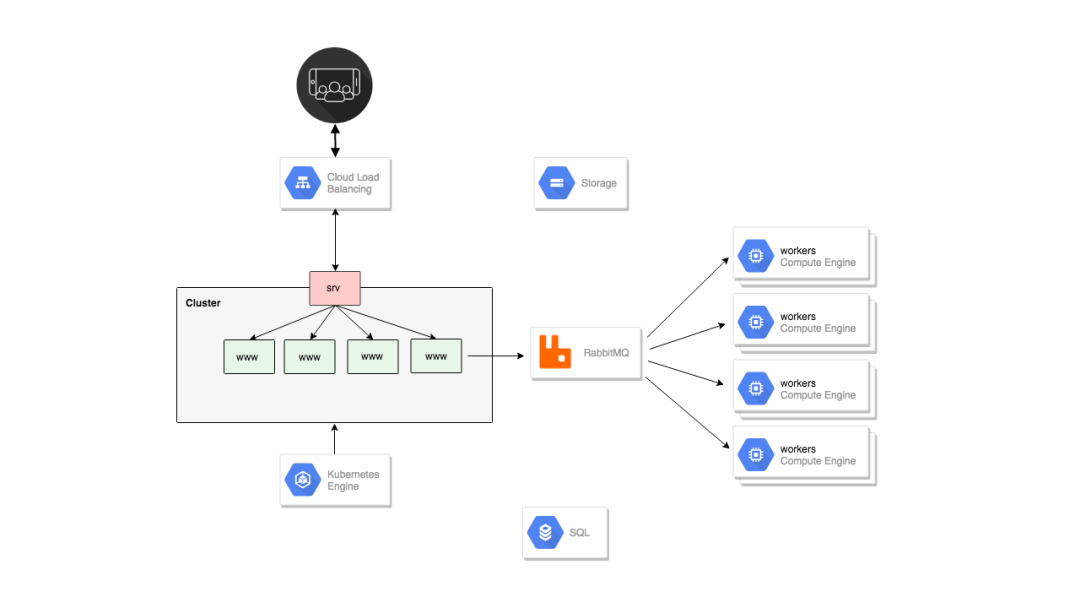
系统架构是一个更为宽泛的概念,它不仅包括软件组件,还涵盖了系统中的硬件部分和各个组件之间的交互。系统架构关注整个信息技术解决方案的结构设计,包括硬件、软件、网络、数据存储和数据流等方面。它的主要目标是确保整个系统的高效性、稳定性和可靠性。

软件架构与系统架构的区别

虽然软件架构是系统架构的一部分,但两者在聚焦点和设计考虑因素上有显著差异:

  • 聚焦范围:软件架构更专注于软件的内部结构和设计,而系统架构则涵盖了包括软件在内的整个IT系统。
  • 设计考虑:软件架构在设计时重点考虑如何组织代码、模块间接口等,系统架构则需考虑硬件选择、网络布局、系统安全等更多元素。
  • 所需技能:软件架构师通常专注于软件开发的技术细节,而系统架构师需要对整个IT系统的各个方面都有深入的了解。

软件架构与系统架构的联系

尽管软件架构和系统架构在许多方面有所不同,但它们之间存在密切的联系:

  • 相互依赖:一个有效的系统架构需要考虑其内部的软件架构如何与整个系统的其他部分协同工作。
  • 共同目标:无论是软件架构还是系统架构,它们的最终目标都是为了创建一个高效、可靠且满足用户需求的技术解决方案。
  • 互相影响:软件架构的决策会影响整个系统的性能和功能,而系统架构的布局又会影响软件架构的选择和设计。

总结

软件架构和系统架构虽然是两个不同的领域,但它们在实际应用中是相辅相成的。一个成功的技术项目需要软件架构师和系统架构师之间的紧密合作,以及对两种架构的深入理解和考虑。通过正确地识别和应用这两种架构的特点,可以有效地提升项目的整体质量和性能。

联系我们