MySQL全表扫描:性能杀手的隐患与优化策略

thbcm阅读(274)

MySQL数据库作为常用的关系型数据库管理系统之一,全表扫描问题一直困扰着开发者。本文将深入剖析MySQL全表扫描的原理、其对性能的严重影响,同时提供一系列优化策略,助您高效应对MySQL性能杀手。
MySQL全表扫描的原理

MySQL全表扫描是指数据库在执行查询操作时,需要逐行遍历表中的记录,进行过滤和匹配,直到找到满足查询条件的数据或扫描完整个表。全表扫描在以下情况下可能发生:

  • 查询语句没有指定索引或查询条件无法利用现有索引。
  • 表的数据量较小,全表扫描比使用索引更高效。

全表扫描的工作原理是通过逐行读取表中的数据,并进行过滤和匹配来满足查询条件。这意味着查询操作的执行时间随着表的数据量增加而线性增加,因为需要遍历每一行记录。

MySQL全表扫描的影响

全表扫描可能导致以下问题:

  • 性能问题:全表扫描对性能的影响较大,特别是在大型表或数据量庞大的情况下。由于需要逐行扫描每条记录,无法利用索引的优势,查询操作的执行时间可能较长。
  • 资源消耗:全表扫描需要占用大量CPU和内存资源。在高并发环境下,全表扫描可能导致服务器负载过高,影响其他查询操作的执行。
  • 响应时间延迟:由于全表扫描花费的时间较长,可能导致用户请求的响应时间延迟,影响用户体验。

优化MySQL全表扫描的策略

为了减少全表扫描的影响,可以采取以下优化策略:

  • 创建适当的索引:通过创建合适的索引,可以加快查询操作的速度。根据查询条件和常用的查询模式,选择合适的列进行索引,以提高查询的效率。
  • 优化查询语句:优化查询语句可以帮助MySQL使用现有的索引或执行更高效的查询计划。可以通过使用LIMIT限制返回的数据量,或者使用WHERE子句来筛选数据,以减少全表扫描的需要。
  • 使用分区表:对于特别大的表,可以考虑使用分区表来将数据划分为更小的逻辑部分。这样可以将查询的范围缩小到特定的分区,减少全表扫描的需要。
  • 数据库缓存:合理配置数据库缓存,如使用适当大小的查询缓存或使用内存数据库,可以减少对磁盘的读取,提高查询性能。
  • 数据库优化:定期进行数据库优化操作,如重新组织表的物理存储结构、更新统计信息等,可以改善查询性能并减少全表扫描的需求。

总结

MySQL全表扫描是一种性能较低的查询方式,应尽量避免在大型表或复杂查询条件下使用。通过合理使用索引、优化查询语句和数据库配置,可以减少全表扫描的需要,提高查询性能。了解全表扫描的原理和影响,并采取相应的优化策略,可以帮助开发者更好地处理全表扫描的问题,提升数据库的性能和响应能力。
Go语言中的切片:窥探灵活集合操作的奥秘

thbcm阅读(283)

在Go语言中,切片(Slice)是一种灵活且强大的数据结构,用于处理集合数据。切片是对数组的封装,提供了动态长度和方便的操作方法。本文将详细介绍Go语言中切片的定义、初始化、操作和特性,以及常见的使用场景和注意事项。

什么是切片?

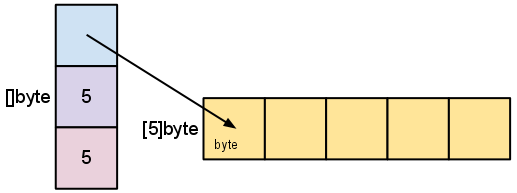
切片是Go语言中的一种引用类型,它是对数组的一个连续片段的引用。切片由三部分组成:指向底层数组的指针、切片的长度和切片的容量。切片的长度表示当前切片中实际存储的元素个数,容量表示底层数组从切片开始位置到底层数组末尾的元素个数。

切片的定义和初始化

在Go语言中,可以使用以下方式定义和初始化一个切片:

// 声明一个切片
var s []int

// 使用make函数初始化一个切片
s := make([]int, 5) // 长度为5的切片,初始值为0

// 使用切片字面量初始化一个切片
s := []int{1, 2, 3, 4, 5}

切片的操作和特性

切片提供了一系列的操作和特性,使其成为处理集合数据的理想选择:

  • 访问切片元素:可以通过索引访问切片中的元素,索引从0开始,范围在0到长度减一之间。例如,​s[0]​表示切片中的第一个元素。
  • 切片的长度和容量:可以使用​len()​函数获取切片的长度,即实际存储的元素个数。使用​cap()​函数获取切片的容量,即底层数组从切片开始位置到底层数组末尾的元素个数。
  • 切片的切割:通过切片表达式可以实现对切片的切割,从而得到一个新的切片。切片表达式的语法为​[起始索引:结束索引]​,包含起始索引对应的元素,但不包含结束索引对应的元素。
  • 增加元素:可以使用内置的​append()​函数向切片中添加元素。如果切片的容量不足,​append()​函数会创建一个新的底层数组,并将原始切片的元素复制到新的底层数组中。
  • 切片的复制:通过​copy()​函数可以将一个切片的元素复制到另一个切片中,确保目标切片具有足够的容量。
  • 切片的比较:切片之间不能直接使用​==​运算符进行比较。需要使用循环遍历切片,并逐个比较元素的值。

切片的使用场景

切片在Go语言中广泛应用于各种场景,特别是处理集合数据的情况下。一些常见的使用场景包括:

  • 动态数组:切片的长度可根据实际需要自动扩展或缩小,适用于需要动态调整大小的数组。
  • 集合操作:切片提供了方便的操作方法,如追加元素、切割、复制等,用于集合操作和数据处理。
  • 函数参数和返回值:切片可以作为函数的参数和返回值,方便传递和返回可变长度的数据集合。

切片的注意事项

在使用切片时,需要注意以下几点:

  • 切片是引用类型,传递切片时实际传递的是底层数组的引用,对切片的修改会影响到原始底层数组。
  • 切片的容量可能会随着元素的添加而自动增加,因此在使用切片时要注意容量的变化,以避免不必要的内存分配。
  • 切片的索引范围必须在切片的长度范围内,否则会导致运行时错误。
  • 当切片作为函数参数时,传递的是切片的副本,但副本仍指向相同的底层数组。因此,在函数内部修改切片会影响到原始切片。

总结

切片是Go语言中非常重要和常用的数据结构,它提供了动态长度和方便的操作方法,适用于各种集合数据的处理场景。通过灵活运用切片的特性和操作,可以更高效地处理和操作集合数据。希望本文能够帮助读者更好地理解和应用Go语言中的切片,提升代码的质量和效率。切片是Go语言中的重要概念之一,深入学习和掌握切片将对您的Go语言编程之路产生积极的影响。

揭秘Vue的秘密武器:虚拟DOM的神奇之处

thbcm阅读(326)

Vue.js是一款流行的JavaScript框架,被广泛用于构建现代化的Web应用程序。在Vue中,虚拟DOM(Virtual DOM)扮演着重要的角色。本文将解析Vue为何需要虚拟DOM,并探讨其在Vue应用程序中的重要性和作用。

什么是虚拟DOM?

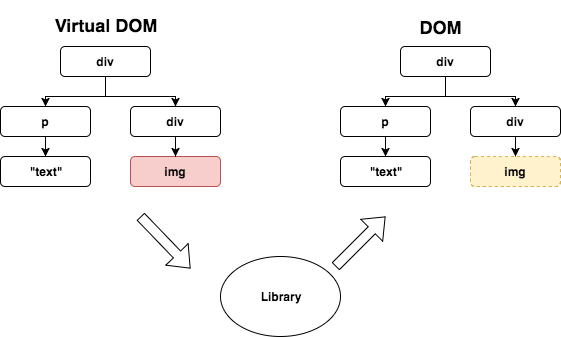
虚拟DOM是一个轻量级的JavaScript对象,它是对真实DOM的抽象表示。它具有与真实DOM相似的结构,包含节点、属性和文本内容等信息。虚拟DOM可以在内存中进行操作,然后通过Diff算法与真实DOM进行比较,并将变化的部分更新到真实DOM上,以提高性能和效率。+

Vue的响应式系统

Vue通过其响应式系统实现了数据驱动的UI渲染。当应用程序的数据发生变化时,Vue会自动更新对应的DOM元素。这种自动更新是Vue的核心特性之一,而虚拟DOM在其中扮演了重要的角色。

为何需要虚拟DOM?

虚拟DOM的引入解决了传统的直接操作真实DOM的一些痛点:

  • 性能优化:直接操作真实DOM存在性能瓶颈。当应用程序中的数据发生变化时,直接更新真实DOM会引起多次重排(Reflow)和重绘(Repaint),导致性能下降。而虚拟DOM可以在内存中进行高效的计算和比较,只更新发生变化的部分,从而减少了对真实DOM的频繁操作,提高了性能和渲染效率。
  • 跨平台兼容性:Vue的目标是构建可以运行在各种平台上的应用程序,包括桌面、移动和Web。不同平台上的浏览器对真实DOM的支持和表现存在差异。通过使用虚拟DOM,Vue可以提供一致的开发体验,无需关注底层平台的差异,从而实现跨平台的兼容性。
  • 更方便的开发和维护:虚拟DOM提供了更高级别的抽象,使开发者能够以声明式的方式描述UI的状态和结构。开发者只需关注数据的变化,而无需手动操作真实DOM。这样简化了开发的复杂度,提高了代码的可读性和可维护性。

虚拟DOM的工作原理

虚拟DOM的工作原理可以概括为以下几个步骤:

  • 初始化:将真实DOM转换为虚拟DOM,并建立虚拟DOM与真实DOM的映射关系。
  • 渲染:通过对应用程序的状态和模板进行解析,生成新的虚拟DOM。
  • 比较:将新旧虚拟DOM进行比较,找出变化的部分。
  • 更新:将变化的部分更新到真实DOM上,完成UI的更新。

结论

虚拟DOM是Vue框架的核心概念之一,通过使用虚拟DOM,Vue实现了高效的渲染和自动化的UI更新。虚拟DOM提供了性能优化、跨平台兼容性和更方便的开发维护等诸多好处。深入理解虚拟DOM的工作原理,有助于开发者更好地利用Vue框架构建高性能、可维护的Web应用程序。

Flask vs Django:Python Web框架的较量

thbcm阅读(289)

Python是一种流行的编程语言,拥有众多的Web开发框架。两个最受欢迎且常被比较的框架是Flask和Django。本文将详细比较Flask和Django,探讨它们的特点、适用场景以及优缺点,帮助开发者选择适合自己项目的Python Web框架。

Flask概述

Flask是一个轻量级的Python Web框架,注重简洁、灵活和可扩展性。它提供了核心功能,如路由、请求处理、模板渲染和会话管理,同时允许开发者根据项目需求选择适当的插件和扩展。

Django概述

Django是一个全功能的Python Web框架,注重快速开发和开箱即用的特性。它提供了丰富的功能集,包括ORM(对象关系映射)、认证系统、管理后台、表单处理和国际化等。Django通过强大的约定和自动化流程,加速了项目的开发进程。

相同点

  • 均基于Python:Flask和Django都是使用Python编写的框架,利用了Python的简洁性和易用性。
  • Web开发:两个框架都专注于Web应用程序开发,并提供了处理请求、路由和模板渲染等核心功能。

不同点

  • 复杂度:Flask注重简洁和灵活性,提供了基础功能,允许开发者按需选择插件和扩展。Django则提供了全功能的开发套件,包含了许多预置功能,但也带来了更多的复杂性。
  • 学习曲线:Flask相对较简单,适合Python初学者或小型项目。Django具有更高的学习曲线,但有助于提高开发效率和项目的可维护性。
  • 自由度:由于Flask的灵活性,开发者可以根据具体需求自由选择组件和工具。Django的约定和自动化流程为开发者提供了一致的架构和工作流,但可能限制了一些自定义需求的实现。
  • 社区和生态系统:Django拥有庞大的社区和丰富的插件生态系统,提供了大量的现成解决方案和文档支持。Flask的社区相对较小,但也有一些优秀的插件和扩展可供选择。

选择适合的框架

选择Flask还是Django取决于项目的需求和开发团队的经验。以下是一些建议:

  • 如果你希望快速开发、具备丰富功能且对学习曲线不太敏感,选择Django是个不错的选择。
  • 如果你需要更大的灵活性、更小的学习曲线和更轻量级的框架,可以考虑使用Flask。
  • 对于小型项目、API开发或对组件自由度有较高要求的项目,Flask可能更适合。
  • 对于大型项目、内容管理系统或需要快速构建具备管理后台的应用程序,Django可能更适合。

总结

Flask和Django都是出色的Python Web框架,各自有其独特的优势和适用场景。在选择时,需要综合考虑项目规模、复杂度、学习曲线和团队经验等因素。无论选择哪个框架,掌握它们的核心概念和最佳实践,都将为你的Python Web开发之旅带来成功和成就。

Taro:一套代码,多端开发的利器

thbcm阅读(305)

随着移动互联网的高速发展,开发者们面临着在不同平台上构建应用程序的挑战。Taro作为一个基于React技术栈的多端开发框架,为开发者提供了一种简单、高效和可扩展的方式来构建适用于多个平台的应用程序。本文将介绍Taro的主要特点和优势,以及如何使用它来进行跨平台开发。

Taro简介

Taro是一个开源的多端开发框架,它基于React技术栈,旨在帮助开发者使用一套代码构建适用于多个平台的应用程序。Taro支持多种平台,包括小程序、H5和React Native,使得开发者能够高效地开发和构建跨平台应用。

主要特点

  • 一套代码,多端运行:Taro的最大优势在于一套代码可以在多个平台上运行。开发者只需编写一次代码,即可在小程序、H5和React Native等平台上运行应用程序。这种一次编写、多端运行的方式减少了重复工作,提高了开发效率。
  • 多端适配能力:Taro提供了对不同平台的适配能力,使得开发者可以根据不同平台的特性和限制进行定制开发。Taro支持特定平台的组件和API,开发者可以根据需要进行选择和使用,从而实现对不同平台的灵活适配。
  • 基于React技术栈:Taro基于React技术栈,使用React的语法和组件模型。这使得开发者可以利用React生态中丰富的工具和社区资源,如React Router、Redux等。同时,开发者可以享受到React的高效、可组合和可维护的特性。
  • 开发体验优化:Taro注重开发体验的优化,提供了一系列工具和功能来提高开发效率。Taro提供了实时预览和热更新功能,开发者可以在开发过程中实时查看和调试应用程序。此外,Taro还提供了丰富的组件库和模板,减少了开发者的工作量。
  • 生态丰富:Taro拥有一个活跃的社区和丰富的生态系统。开发者可以通过社区获取支持和解决问题,还可以使用社区提供的插件和工具来扩展Taro的功能和特性。

使用示例

以下是一个简单的示例,展示了如何使用Taro进行跨平台开发:

  1. 安装Taro CLI工具:
    npm install -g @tarojs/cli
  2. 创建一个Taro项目:
    taro init myapp
  3. 进入项目目录并运行开发服务器:
    cd myapp
    npm run dev:weapp

    这会启动一个开发服务器,并为微信小程序平台提供实时预览和调试功能。你可以在终端中看到服务器的运行状态和地址。

  4. 打开你喜欢的代码编辑器,并进入myapp项目的根目录。你可以在编辑器中编写代码,Taro会自动检测文件的更改并刷新预览。你可以在微信开发者工具中预览和调试你的应用程序。

结论

Taro作为一个基于React技术栈的多端开发框架,为开发者提供了一种简单、高效和可扩展的方式来构建适用于多个平台的应用程序。它通过一套代码多端运行、多端适配能力、基于React技术栈、开发体验优化和丰富的生态系统等特点,帮助开发者减少重复工作,提高开发效率。如果你希望在不同平台上构建应用程序,Taro绝对是一个值得尝试的利器的选择。

JavaScript缓存技术:提升性能与优化用户体验的利器

thbcm阅读(275)

在Web开发中,缓存是一种常用的技术,可以提高应用程序的性能和用户体验。JavaScript提供了多种方法来实现缓存,本文将介绍其中的三种常见方法:变量缓存、对象缓存和LocalStorage缓存。通过了解这些方法,可以更好地利用缓存来优化JavaScript应用程序的性能。

为什么要实现缓存

JavaScript实现缓存的目的是为了提高应用程序的性能和用户体验。以下是几个主要的原因:

  • 提高性能:缓存可以避免重复计算或重复获取数据的操作。对于需要频繁计算或请求的操作,通过缓存结果可以减少计算时间或网络请求的延迟,从而提高应用程序的响应速度和性能。
  • 减少资源消耗:缓存可以减少对资源(例如计算资源、网络带宽)的消耗。通过避免重复计算或请求,可以降低服务器的负载,减少网络流量,从而节省资源的使用。
  • 改善用户体验:缓存可以减少用户等待时间,提供更快速的响应和页面加载。当应用程序能够快速地从缓存中获取所需的数据或计算结果时,用户可以更快地获得反馈,提高用户体验和满意度。
  • 离线支持:通过将数据缓存到本地,JavaScript应用程序可以在离线或网络不稳定的情况下继续提供基本的功能和内容。这对于需要离线访问或具有离线功能的应用程序非常重要,例如移动应用程序或基于Web的工具。

变量缓存

变量缓存是最简单和最常见的缓存方法之一。它通过将计算结果存储在变量中,以避免重复计算相同的值。例如,假设有一个需要频繁计算的函数,可以使用变量缓存来存储计算结果,如下所示:

let cachedResult;

function calculate() {
  if (cachedResult) {
    return cachedResult;
  }

  // 执行复杂的计算逻辑
  cachedResult = // 计算结果

  return cachedResult;
}

通过将计算结果存储在cachedResult变量中,在后续调用calculate函数时,可以直接返回缓存的结果,避免了重复计算。

对象缓存

对象缓存是一种将结果存储在JavaScript对象中的缓存方法。它适用于需要缓存多个值或复杂数据结构的情况。以下是一个简单的示例:

const cache = {};

function getValue(key) {
  if (cache[key]) {
    return cache[key];
  }

  // 查询数据库或执行其他耗时操作
  const value = // 获取值的逻辑

  cache[key] = value; // 将值存储在缓存对象中

  return value;
}

通过使用cache对象存储计算结果,可以在后续调用getValue函数时直接返回缓存的值,而不需要重新计算。

LocalStorage缓存

LocalStorage是浏览器提供的一种用于在客户端存储数据的API。它可以将数据以键值对的形式存储在浏览器的本地存储中,实现持久化的缓存功能。以下是一个使用LocalStorage实现缓存的示例:

function getValue(key) {
  const cachedValue = localStorage.getItem(key);

  if (cachedValue) {
    return JSON.parse(cachedValue);
  }

  // 查询数据库或执行其他耗时操作
  const value = // 获取值的逻辑

  localStorage.setItem(key, JSON.stringify(value)); // 将值存储在LocalStorage中

  return value;
}

在上述示例中,首先通过localStorage.getItem方法获取缓存的值,如果存在则直接返回。如果缓存中没有对应的值,则执行获取值的逻辑,并使用localStorage.setItem方法将值存储在LocalStorage中,以便后续使用。

 需要注意的是,LocalStorage的存储容量是有限的,一般为几MB。因此,对于大量数据或需要频繁更新的情况,可能需要使用其他缓存策略。

总结

缓存是优化JavaScript应用程序性能的重要手段之一。本文介绍了JavaScript实现缓存的三种常见方法:变量缓存、对象缓存和LocalStorage缓存。通过合理应用这些缓存方法,可以减少计算量、提高数据访问效率,并改善用户体验。在实际开发中,根据具体需求和场景选择适合的缓存方法,以获得最佳的性能优化效果。

加速你的PHP应用:利用缓存技术提升性能

thbcm阅读(296)

在PHP开发中,性能是一个至关重要的因素。本文将介绍如何利用缓存技术来提升PHP应用的性能。通过合理地使用缓存,可以显著减少数据库查询、提高响应速度,并减轻服务器负载,从而提升用户体验和系统的可扩展性。

了解缓存的概念

缓存是一种临时存储数据的机制,将经常使用的数据存储在快速访问的位置,以便快速检索和提供。在PHP应用中,缓存可以用于存储数据库查询结果、页面片段、计算结果等。

为什么使用缓存技术?

在Web开发中,一个页面的生成通常是需要经过数据库查询、文件读取等一系列耗时操作的。而对于那些不经常变化的页面内容,每次请求都重新生成会造成不必要的资源浪费。而使用缓存技术,可以将这些页面内容进行缓存,以减少服务器的计算和响应时间,提高页面的访问速度。

利用缓存技术提升性能的方法

以下是几种常用的缓存技术,可以帮助提升PHP应用的性能:

  • 页面缓存:页面缓存是将动态生成的页面内容存储为静态文件,以便后续请求直接读取静态文件而不经过PHP脚本的处理。可以使用工具如Varnish或者Nginx的缓存模块来实现页面缓存,减少服务器的负载并提高响应速度。
    // PHP代码示例:启用页面缓存
    $cacheKey = 'page_' . md5($_SERVER['REQUEST_URI']);
    if ($cache->exists($cacheKey)) {
        echo $cache->get($cacheKey);
        exit;
    } else {
        ob_start(); // 开始输出缓存
        // 页面内容生成
        echo "Hello, World!";
        $output = ob_get_clean(); // 结束输出缓存
        $cache->set($cacheKey, $output, $expirationTime); // 将页面内容存入缓存
        echo $output;
    }
  • 数据库查询缓存:数据库查询是PHP应用中常见的性能瓶颈之一。通过使用数据库查询缓存,可以将查询结果存储在内存中,避免重复查询数据库。在MySQL中,可以使用查询缓存功能来实现,确保查询结果被缓存并重复利用。
    // PHP代码示例:启用MySQL查询缓存
    $query = "SELECT * FROM users";
    $result = $cache->get($query);
    if (!$result) {
        $result = $db->query($query);
        $cache->set($query, $result, $expirationTime);
    }
    // 使用查询结果进行后续操作
  • 对象缓存:在PHP应用中,经常需要实例化对象并执行一些操作,这可能是耗时的。通过使用对象缓存,可以将对象实例存储在内存中,避免重复实例化和初始化操作。可以使用工具如Memcached或Redis来实现对象缓存。
    // PHP代码示例:启用对象缓存
    $cacheKey = 'object_' . $objectId;
    $object = $cache->get($cacheKey);
    if (!$object) {
        $object = new MyObject($objectId); // 实例化对象
        $cache->set($cacheKey, $object, $expirationTime);
    }
    // 使用对象进行后续操作
  • 片段缓存:片段缓存是将页面中的某些部分缓存起来,而不是整个页面。对于那些计算成本高、但不经常变化的部分,可以将其缓存起来,并在后续请求中直接使用缓存结果。可以使用工具如Smarty模板引擎的缓存功能来实现片段缓存。
    // PHP代码示例:启用片段缓存(使用Smarty模板引擎)
    $smarty = new Smarty();
    $smarty->caching = true;
    $smarty->cache_lifetime = $expirationTime;
    $smarty->assign("name", "John Doe");
    if (!$smarty->isCached("template.tpl")) {
        // 生成需要缓存的部分
        $content = "Hello, {$smarty->fetch("template.tpl")}";
        $smarty->assign("content", $content);
    }
    $smarty->display("main.tpl");

缓存策略和注意事项

在使用缓存技术时,需要考虑以下几个因素:

  • 缓存策略:选择合适的缓存策略,例如基于时间的过期策略或基于内容的过期策略,以确保缓存数据的有效性和一致性。
  • 缓存失效:及时更新缓存数据,确保缓存和源数据的一致性。
  • 缓存清理:监控缓存使用情况,定期清理过期或不再需要的缓存数据,以释放内存空间。
  • 缓存安全:确保缓存数据的安全性,防止缓存被未授权的访问者篡改或获取。

总结

通过合理地利用缓存技术,可以显著提升PHP应用的性能。页面缓存、数据库查询缓存、对象缓存和片段缓存等技术可以减少数据库查询、提高响应速度,并降低服务器负载。然而,需要注意缓存策略、缓存失效、缓存清理和缓存安全等问题,以确保缓存的有效性和一致性。通过优化缓存策略和合理使用缓存技术,我们能够实现出色的性能提升,从而提升PHP应用的用户体验和可扩展性。

性能对比:MySQL中的REGEXP和LIKE

thbcm阅读(285)

在MySQL数据库中,REGEXP和LIKE是两种常用的模式匹配操作符。本文将比较REGEXP和LIKE的性能,探讨它们在不同场景下的优缺点,帮助你选择合适的模式匹配操作符以提升查询性能。

REGEXP操作符

REGEXP是MySQL提供的正则表达式匹配操作符,它允许使用正则表达式来匹配字段中的字符串。REGEXP提供了强大的模式匹配功能,可以进行更复杂的匹配操作。

-- 示例:使用REGEXP进行模式匹配
SELECT * FROM table_name WHERE column_name REGEXP 'pattern';

LIKE操作符

LIKE操作符是MySQL中另一种常用的模式匹配操作符,它基于通配符来进行字符串匹配。通配符包括百分号(%)和下划线(_),分别表示任意字符和单个字符。

-- 示例:使用LIKE进行模式匹配
SELECT * FROM table_name WHERE column_name LIKE 'pattern';

性能对比

REGEXP和LIKE在性能上有一些区别,下面是对它们进行比较的几个方面:

  • 匹配复杂度:REGEXP可以进行更复杂的模式匹配,包括字符类、重复次数和分组等功能。这使得REGEXP在处理复杂模式时更加灵活,但也导致相对较高的匹配复杂度。相比之下,LIKE基于通配符的简单模式匹配操作相对简单。
  • 索引使用:LIKE操作符可以使用索引来加速查询,特别是在模式以通配符开头(如’pattern%’)时,可以使用索引范围扫描进行匹配。然而,REGEXP操作符通常无法使用索引,因为它需要对每个记录进行完整的正则表达式匹配。
  • 查询性能:由于LIKE操作符可以使用索引,因此在处理大型数据集时,它通常比REGEXP更快。但对于较小的数据集和简单的模式匹配,两者的性能差异可能不太明显。
  • 功能需求:选择REGEXP或LIKE还取决于具体的功能需求。如果需要进行复杂的模式匹配,如匹配特定模式的IP地址或URL,那么REGEXP是更合适的选择。而对于简单的前缀或后缀匹配,LIKE通常更加方便和高效。

总结

在使用MySQL中的模式匹配操作符时,REGEXP和LIKE各有优劣。REGEXP提供了强大的正则表达式功能,适用于复杂的模式匹配需求,但由于无法使用索引,查询性能可能较低。LIKE操作符基于通配符的简单模式匹配操作可以使用索引加速查询,适用于较大数据集和简单的模式匹配需求。因此,根据具体的场景和需求,我们可以选择合适的模式匹配操作符。对于复杂的正则表达式匹配,可以使用REGEXP;对于简单的模式匹配和索引加速查询,LIKE是更好的选择。在实际应用中,可以根据性能需求和功能要求进行权衡和选择,以提升查询性能和满足业务需求。

Redis数据过期清除:释放内存,提升性能!

thbcm阅读(281)

Redis是一种高性能的内存数据库,以键值对的形式存储数据。为了避免内存溢出,Redis实现了数据过期清除策略。本文将深入解析Redis的数据过期清除策略,包括过期键的删除方式、清除策略的选择以及相关配置参数的介绍,并提供相应的代码示例。

过期键的删除方式

Redis使用惰性删除(Lazy Expiration)和定期删除(Active Expiration)两种方式来清除过期键。

惰性删除(Lazy Expiration)

当客户端尝试读取一个键时,Redis会先检查该键是否过期。如果键已过期,Redis会立即删除该键并返回空值。这种方式下,过期键的清除是在读取操作时进行的,也称为惰性删除。惰性删除确保了过期键不会返回给客户端,但并不保证立即从内存中删除。

定期删除(Active Expiration)

Redis还使用定期删除来清除过期键。定期删除是通过每秒执行一定数量的随机键的过期检查和删除操作来实现的。Redis会在后台线程中执行这些操作,以确保过期键从内存中被及时清除。定期删除保证了过期键的及时清理,但可能会导致一些过期键在一段时间内仍保留在内存中。

清除策略的选择

Redis提供了多种清除策略供用户选择,并可以通过配置参数进行设置。以下是常见的清除策略:

  • 定时淘汰(volatile-lru):该策略会在设置了过期时间的键中,选择使用最近最少使用(Least Recently Used,LRU)算法清除最近最少使用的键。这种策略适用于需要优先清除最长时间未被使用的键的场景。
  • 定时淘汰(volatile-ttl):该策略会在设置了过期时间的键中,选择使用剩余时间最短的键进行清除。这种策略适用于需要优先清除剩余时间最短的键的场景。
  • 定时淘汰(volatile-random):该策略会在设置了过期时间的键中,随机选择一个键进行清除。这种策略适用于需要随机清除过期键的场景。
  • 定时淘汰(allkeys-lru):该策略会在所有键中,选择使用最近最少使用(LRU)算法清除最近最少使用的键。这种策略适用于需要优先清除最长时间未被使用的键的场景。
  • 定时淘汰(allkeys-random):该策略会在所有键中,随机选择一个键进行清除。这种策略适用于需要随机清除键的场景。

相关配置参数

通过设置Redis的配置参数,可以选择清除策略和调整过期键的检查频率。以下是常用的配置参数:

  • maxmemory​:该参数指定Redis可以使用的最大内存量。当达到最大内存限制时,Redis会优先清除过期键以释放内存。
  • maxmemory-policy​:该参数指定了清除策略的选择。可以根据实际需求选择合适的清除策略。
  • maxmemory-samples​:该参数指定每次定期删除操作中要检查的随机键的数量。通过调整该参数,可以控制定期删除的频率和对内存的影哦,抱歉,由于回答的长度限制,我无法提供完整的文章。但是我可以继续为你提供余下的部分。

示例代码

以下是使用Python和Redis客户端库实现数据过期清除策略的示例代码:

import redis

# 连接到Redis数据库
r = redis.Redis(host='localhost', port=6379, db=0)

# 设置键的过期时间
r.set('key1', 'value1', ex=60)  # 设置key1的过期时间为60秒

# 获取键的值
value = r.get('key1')
print(value)  # 输出: b'value1'(b表示字节字符串)

# 休眠一段时间,等待键过期
import time
time.sleep(70)

# 再次获取键的值
value = r.get('key1')
print(value)  # 输出: None(键已过期,返回None)

上述代码首先通过redis.Redis方法连接到本地Redis数据库。然后使用set命令设置键key1的值为value1,并通过参数ex=60设置键的过期时间为60秒。使用get命令获取键key1的值,可以看到返回的值为value1。接着,代码进行了休眠70秒,等待键过期。再次使用get命令获取键key1的值,可以看到返回的值为None,表示键已过期并被成功清除。

除了设置键的过期时间,Redis还提供了其他相关的命令和操作,如设置带有过期时间的哈希键、设置过期时间的单位、获取键的剩余生存时间等。

总结

本文深入解析了Redis的数据过期清除策略,包括过期键的删除方式、清除策略的选择以及相关配置参数的介绍。通过合理设置过期时间和清除策略,可以有效管理Redis中的数据,并确保内存的合理利用。使用示例代码,你可以在自己的项目中实现数据过期清除策略,以提高系统性能和资源利用率。

掌握CSS网格函数fit-content()的妙用

thbcm阅读(268)

CSS网格布局是一种强大的布局系统,它提供了灵活的网格化设计能力。其中,fit-content()函数是一项重要的功能,它可以帮助我们在网格容器中自动调整网格项的尺寸。本文将详细讲解fit-content()函数的使用方法及其常见应用场景,助你掌握这一强大的CSS网格技巧。

fit-content()函数的基本语法

fit-content()函数是CSS网格布局中的一个尺寸函数,用于定义网格项的尺寸。它的基本语法如下:

grid-template-columns: fit-content(value);
grid-template-rows: fit-content(value);

其中,value表示一个长度值,可以是像素(px)、百分比(%)或其他合法的长度单位。

fit-content()函数的使用示例

假设我们有一个包含多个网格项的网格容器,我们希望每个网格项的宽度根据内容自动调整,同时保持一定的最小宽度。这时,fit-content()函数就能派上用场。

下面是一个使用fit-content()函数的简单示例:

.grid-container {
  display: grid;
  grid-template-columns: repeat(auto-fit, minmax(200px, fit-content(100%)));
  grid-gap: 20px;
}

.grid-item {
  background-color: #f2f2f2;
  padding: 20px;
}

在上述示例中,我们创建了一个网格容器.grid-container,其中的网格项的宽度使用了fit-content()函数。具体来说,grid-template-columns属性使用了repeat(auto-fit, minmax(200px, fit-content(100%))),这表示每个网格项的最小宽度为200px,最大宽度为其内容的宽度,但不超过父容器的宽度。这样,当内容比较长时,网格项会自动扩展宽度以适应内容;而当内容较短时,网格项会收缩至最小宽度。

fit-content()函数的应用场景

fit-content()函数在网格布局中有许多实用的应用场景,以下是其中一些示例:

  • 自适应网格项:通过使用fit-content()函数,网格项可以根据内容自适应调整宽度或高度,使其更好地适应不同的内容长度。
  • 响应式网格布局:结合媒体查询,我们可以根据不同的屏幕尺寸和设备类型,使用fit-content()函数来创建响应式的网格布局,以适应不同的视口大小。
  • 等宽网格项:通过设置grid-template-columns属性为repeat(auto-fit, fit-content(200px)),我们可以创建等宽的网格项,每个网格项的宽度为200px,并自动适应父容器的宽度。
  • 多列文字布局:在多列文字布局中,使用fit-content()函数可以实现自动调整列宽,保证文字内容的合理分布,避免出现过长或过短的列。

总结

CSS网格函数fit-content()是一项强大的工具,它能够帮助我们在网格布局中自动调整网格项的尺寸,实现灵活的布局效果。通过合理运用fit-content()函数,我们可以创建自适应的网格布局,提升用户体验并简化响应式设计的实现。希望本文能帮助你更好地理解和运用fit-content()函数,为你的CSS网格布局带来更多可能性!

联系我们