选择排序:理解原理与实现

thbcm阅读(328)

在计算机科学中,排序算法是一项重要的任务。选择排序是一种简单而高效的排序算法,它通过不断选择最小(或最大)的元素,并将其放置在已排序部分的末尾,逐步完成对整个列表的排序。本文将详细解析选择排序算法的原理、步骤和性能分析。

选择排序是什么?

选择排序(Selection Sort)是一种简单而直观的排序算法,它的基本思想是每次从未排序的元素中选择最小(或最大)的元素,并将其放置在已排序部分的末尾。通过不断重复这个过程,直到所有元素都被放置在正确的位置上,完成整个列表的排序。

算法步骤

  1. 遍历未排序部分的每个元素。
  2. 在当前未排序部分中找到最小(或最大)的元素。
  3. 将最小(或最大)元素与未排序部分的第一个元素进行交换。
  4. 将交换后的元素视为已排序部分的末尾。
  5. 重复上述步骤,直到所有元素都被放置在正确的位置上。

代码示例

下面是使用Java语言实现冒泡排序的示例代码:

import java.util.Arrays;
 
public class SelectionSort {	
    public static void selectionSort(int[] arr) {
        int n = arr.length;
        // 遍历数组
        for (int i = 0; i < n-1; i++) {
            int min = i;
            //遍历选择最小的数
            for (int j = i+1; j < n; j++) {
                if (arr[j] < arr[min]) min = j;
            }
            //交换位置
            swap(arr, i, min);   		
        }  
    }  
	
	
    private static void swap(int[] a, int i, int j) {
        int tmp = a[i];
        a[i] = a[j];
        a[j] = tmp;
    }
}

性能分析

  • 时间复杂度:选择排序的时间复杂度为O(n^2),其中n是待排序列表的长度。由于需要进行两层循环,每一轮都需遍历未排序部分。
  • 空间复杂度:选择排序的空间复杂度为O(1),因为只需要常量级的额外空间进行元素交换。
  • 稳定性:选择排序是一种不稳定的排序算法,因为相等元素可能在交换过程中改变相对顺序。

总结

选择排序是一种简单而高效的排序算法,适用于小规模的数据集。它的原理简单,步骤清晰,时间复杂度为O(n^2),空间复杂度为O(1)。虽然选择排序不是最快的排序算法,但它的实现相对容易,对于简单的排序任务来说是一个不错的选择。理解选择排序的原理和步骤有助于更好地理解和应用其他排序算法。

5个实用的IntelliJ IDEA插件:提升开发效率与改善代码质量

thbcm阅读(317)

当提到开发者最喜爱的集成开发环境(IDE)之一时,IntelliJ IDEA往往名列前茅。它是一款功能强大、灵活且可扩展的IDE,提供了许多插件来增强开发体验。在本文中,我将介绍五个非常实用的IntelliJ IDEA插件,它们可以提高开发效率、减少重复工作并改善代码质量。

Key Promoter X

在编码过程中,有时繁琐的鼠标操作是个阻碍,频繁使用鼠标会降低开发速度。作为替代,可以寻找键盘快捷键。这个插件就可以帮助更好地使用快捷键。

当你在IDE中使用鼠标点击一个按钮时,这个插件会提醒你可以使用的键盘快捷键。如果经常使用一个没有键盘快捷键的按钮,”Key Promoter X”会提示创建一个快捷键。如果已经很熟悉了某个快捷键,该插件支持设置了”不再显示”的选项。

安装链接:https://plugins.jetbrains.com/plugin/9792-key-promoter-x

Lombok

Lombok是一个Java库,旨在减少冗余代码的编写。通过使用注解,可以实现该功能。它可以消除编写重复代码的需求,例如​getter​、​setter​和构造函数等。只需使用相应的注解即可达到相同的效果。这些注解大多都很直观,如​@Getter​、​@Setter​、​@ToString​、​@NoArgsConstructor​等等。Lombok是一个非常实用的插件,能够简化编码任务并减少不必要的冗余代码。

安装链接:https://plugins.jetbrains.com/plugin/6317-lombok

Rainbow Brackets

这个插件可以提升用户的视觉体验。它可以简化识别由括号包围的代码块的过程。尤其是对于嵌套的循环,由于多个括号的相互嵌套,有时可能非常复杂。但是,通过这个插件,可以通过为括号着色并使用作用域高亮功能来解决这个问题。这样一来,与每对括号相关的代码块将会得到突出显示,使其更加易于辨认。

安装链接:https://plugins.jetbrains.com/plugin/10080-rainbow-brackets/

下面是使用Ctrl + right mouse click右键单击选择的作用域高亮示例。但正如上文提到的”Key Promoter X”,开发人员可以用自己喜欢的快捷键替代这个操作。

Codota

在编程过程中,经常遇到重复的代码片段。重复输入相同的代码会消耗大量的时间。此外,除了经常使用的选项,我们可能不了解其他可用的编码选项。

Codota可以根据常见的编码模式自动提供代码补全建议,这可以节省浏览时间。Codota通过使用开源项目中可用的大量Java程序实现了这一功能。

该工具非常有用,因为它可以节省寻找可实现代码的各种选项的浏览时间。

安装链接:https://plugins.jetbrains.com/plugin/7638-codota-ai-autocomplete-for-java-and-javascript

String Manipulation

字符串处理是另一个可以节省编码时间的有用插件。以下是该插件提供的一些功能。

  • 在驼峰式、蛇形命名法和短横线命名法之间切换大小写。
  • 编码/解码为Base64、URL、十六进制等。
  • 转义和反转义。
  • 对函数进行对齐。
  • 增加和减少数字。
  • 区分大小写和不区分大小写的行排序和洗牌。
  • 反转、修剪和删除空白/重复行。

安装链接:https://plugins.jetbrains.com/plugin/2162-string-manipulation

总结

这些插件只是IntelliJ IDEA插件生态系统中的一小部分,但它们都提供了独特且有价值的功能,可以显著提高开发效率和代码质量。你可以根据自己的需求和偏好,在IntelliJ IDEA的插件市场中探索更多插件,并发现更多适合你的工具和扩展。无论是代码导航、代码质量分析、快捷键使用,还是版本控制,IntelliJ IDEA的插件可以帮助你更高效地开发和管理项目。

Java中Integer封装:100和1000的相等性之谜

thbcm阅读(332)

在Java中,Integer封装类的相等性比较常常让人感到困惑。为什么当我们比较100和100时,结果为true,但比较1000和1000时,结果却为false?这个现象涉及到Java的整数缓存和对象引用的差异。在本文中,我们将揭示这个有趣的现象的原因,并解释如何正确比较整数封装类的相等性。

在Java中,对于整数类型的封装类Integer,我们经常会遇到一个有趣的现象:当比较两个小整数相等性时,例如100和100,结果为​true​;但当比较两个大整数相等性时,例如1000和1000,结果却为​false​。这种现象背后隐藏着Java中整数对象缓存和对象引用的一些细微差别。

public class Main {
    public static void main(String[] args) {
        Integer a = 1000;
        Integer b = 1000;
        System.out.println(a == b);

        Integer c = 100;
        Integer d = 100;
        System.out.println(c == d);
    }
}
/**
 * 运行结果
 * false
 * true
 */

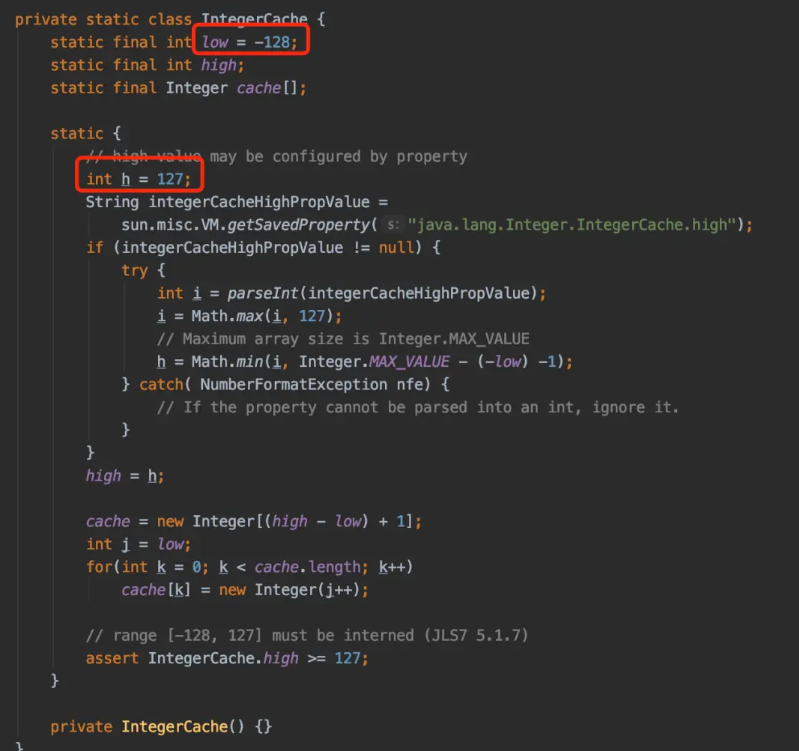
为了提高性能和节省内存,Java在内部维护了一个整数缓存池,范围是-128到127。当我们创建一个Integer对象时,如果数值在这个范围内,Java会尝试从缓存池中获取已经存在的Integer对象。这样,当我们使用相同数值的两个Integer对象进行比较时,它们实际上是同一个对象的引用,因此比较结果为​true​。这种情况下,我们可以说它们是相等的。

然而,当整数超出了缓存池的范围,例如1000,Java会在堆中创建新的Integer对象,而不是从缓存池中获取。尽管它们的数值相同,但它们在内存中是不同的对象,具有不同的引用。因此,当我们比较两个大整数的相等性时,由于比较的是对象的引用而不是数值本身,结果为​false​。

这种行为可以通过Java的自动装箱(Autoboxing)和拆箱(Unboxing)机制来解释。当我们使用​==​运算符比较两个Integer对象时,实际上是在比较它们的引用,而不是数值。如果我们想要比较它们的数值是否相等,应该使用​equals()​方法,因为在Integer类中,​equals()​方法被重写以进行数值的比较。

public class Main {
    public static void main(String[] args) {
        Integer a = 1000;
        Integer b = 1000;
        System.out.println(a.equals(b));

        Integer c = 100;
        Integer d = 100;
        System.out.println(c == d);
    }
}
/**
 * 运行结果
 * true
 * true
 */

需要注意的是,这种整数缓存的行为只适用于整数类型的封装类Integer,而不适用于其他封装类如Long、Double等。

为了避免这种混淆和潜在的错误,我们应该始终使用​equals()​方法来比较两个封装类的相等性,尤其是在使用自动装箱和拆箱的情况下。此外,如果我们需要比较大整数的相等性,建议使用​equals()​方法或将整数转换为基本数据类型进行比较。

总结

Java中的整数封装类Integer存在一个缓存池,对于-128到127之间的整数,它们是同一个对象的引用,因此比较结果为true;对于超出该范围的整数,它们是不同的对象,比较结果为false。这是由于自动装箱和对象引用的特性所导致的,我们应该谨慎使用==运算符来比较封装类的相等性,而是使用equals()方法来进行数值的比较。

Git神奇撤销术:Revert vs. Reset,究竟谁更胜一筹?

thbcm阅读(346)

在Git版本控制系统中,有两个常用的命令用于撤销提交或回滚修改:revert和reset。尽管它们都可以用于撤销变更,但它们的工作原理和使用场景有所不同。本文将深入探讨Git中revert和reset命令的区别,帮助开发人员更好地理解和应用这两个命令。

 Revert命令

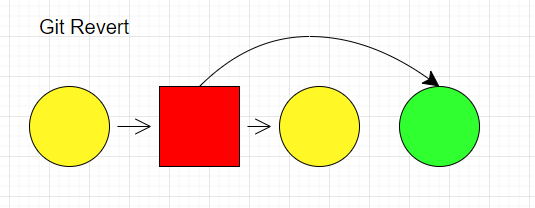
Revert命令用于创建一个新的提交,以撤销之前的提交。它不会更改Git的提交历史,而是通过创建一个新的提交来实现撤销。这个新的提交将包含之前提交的相反的变更,即将之前的修改还原回去。

使用示例

# 撤销指定提交
git revert <commit-hash>

# 撤销多个非连续的提交 -n 代表不自动提交
git revert -n <commit-hash-1> <commit-hash-2>
git commit -m "Revert multiple commits"

# 撤销多个连续的提交
git revert -n <commit-hash-a>..<commit-hash-b>
git commit -m "Revert multiple commits"

# 使用`--abort`取消回撤
git revert --abort

Revert命令特点

  • 创建新的提交:Revert命令会创建一个新的提交,这意味着原始提交仍然存在于Git历史中。
  • 保留提交历史:Revert操作不会更改之前的提交历史,而是通过添加新的提交来撤销之前的变更。
  • 安全性:Revert是一种安全的操作,因为它不会更改Git历史,也不会影响其他开发人员的工作。

使用场景

  • 撤销单个提交:当需要撤销单个提交时,可以使用Revert命令。这种情况下,Revert会创建一个新的提交,将之前提交的修改还原回去。
  • 保留提交历史:如果需要保留完整的提交历史,并在撤销变更时能够清晰地看到每个撤销操作,Revert是更适合的选择。

Reset命令

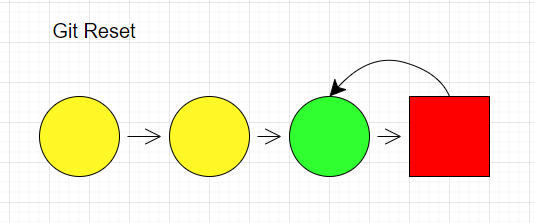
Reset命令用于移动当前分支的指针,从而改变当前分支的状态。它可以用于撤销提交、移动HEAD指针和分支指针,以及修改暂存区和工作目录的状态。

使用示例

# 回退到指定版本
git reset <commit-hash>

# 等同于 `git reset <commit-hash>`, `<commit-hash>`之后的提交内容都会保留到工作区
git reset --mixed <commit-hash>

# `<commit-hash>`之后的提交内容会保留到暂存区,但是工作区不会改变
git reset --soft <commit-hash>

# `<commit-hash>`之后的提交内容都不会被保留,直接被移除掉了
git reset --hard <commit-hash>

# 回退到上一个版本
git reset HEAD^

# 回退到上两个版本
git reset HEAD~2

Reset命令特点

  • 移动指针:Reset命令可以移动HEAD指针和分支指针,使其指向不同的提交。这会改变当前分支的状态。
  • 修改暂存区和工作目录:根据Reset命令的选项,可以选择是否将暂存区和工作目录恢复到指定提交的状态。
  • 潜在风险:Reset命令是一种更强大的操作,它可以改变Git历史和丢弃提交。因此,在使用Reset命令时需要小心,以免不小心丢失重要的提交。

使用场景

  • 撤销多个提交:如果需要撤销多个连续的提交,可以使用Reset命令将分支指针移动到指定的提交上,从而丢弃这些提交。
  • 清理工作目录:如果需要彻底清理工作目录和暂存区,并还原到指定的提交状态,可以使用Reset命令。

总结

尽管Revert和Reset命令都可用于撤销变更,但它们的工作原理和效果有所不同。Revert通过创建新的提交来撤销之前的提交,保留完整的提交历史。而Reset命令通过移动分支指针来改变当前分支的状态,可以修改暂存区和工作目录的内容。在选择使用哪个命令时,需要根据具体情况和需求权衡其特点和潜在风险。无论是Revert还是Reset,都是Git版本控制系统中强大的撤销和回滚工具,开发人员应根据实际需求来选择使用哪个命令。熟练掌握它们的区别和使用场景,将有助于更好地管理和维护代码库的变更。

PHP防御CSRF攻击:保护应用免受威胁

thbcm阅读(380)

随着 Web 应用程序的发展和普及,网络安全问题变得越来越重要。跨站请求伪造(CSRF)攻击成为了其中一种常见的攻击手段。CSRF攻击是指攻击者通过仿冒合法用户的请求来执行一些恶意操作,例如在用户没有意识到的情况下转账、修改密码等。为了保护用户和 Web 应用程序的安全,开发者需要采取措施来防御此类攻击。本文将介绍如何使用 PHP 来防御CSRF攻击。

什么是CSRF?

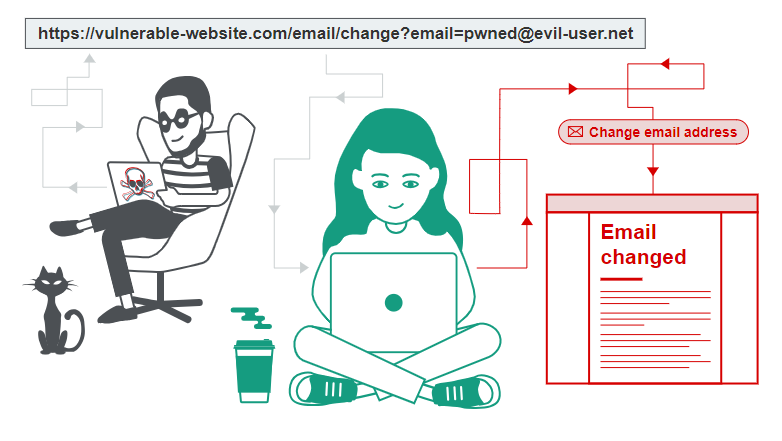
CSRF,全称为Cross-Site Request Forgery(跨站请求伪造),是一种常见的网络安全漏洞和攻击方式。它利用了Web应用程序中的信任机制,通过欺骗用户在已登录的状态下执行非意愿的操作,从而导致未经授权的请求被发送到目标网站。

CSRF攻击的基本原理

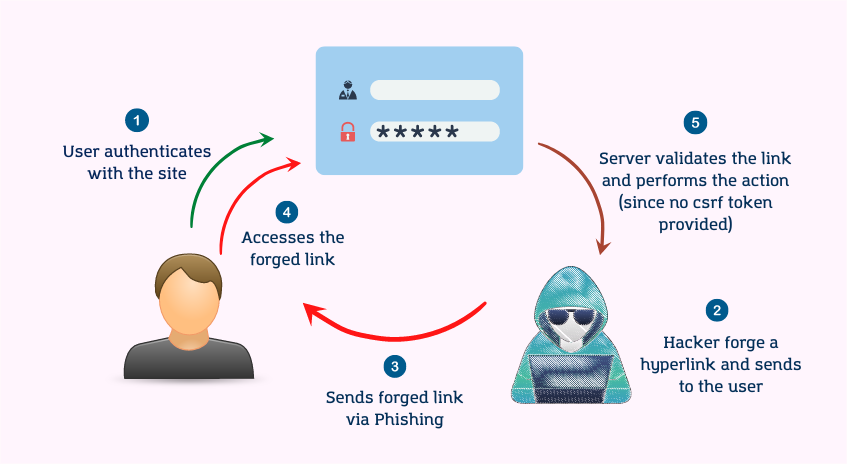
  1. 用户在已登录的状态下访问恶意网站或点击恶意链接。
  2. 恶意网站或链接中包含了对目标网站的请求,该请求可能是修改用户个人信息、进行资金转账、删除数据等未经授权的操作。
  3. 用户的浏览器会自动发送该请求,因为用户已经在目标网站中登录并保留了有效的身份验证凭证(如Cookie)。
  4. 目标网站接收到请求后,无法分辨这是来自用户的合法请求还是恶意请求,并按照请求执行了相应的操作。

生成和验证CSRF令牌

生成CSRF令牌
session_start();
$token = bin2hex(random_bytes(32)); // 生成32个字节的随机令牌
$_SESSION['csrf_token'] = $token; // 将令牌存储在会话中
在表单中嵌入CSRF令牌
<form action="process.php" method="POST">
  <input type="hidden" name="csrf_token" value="<?php echo $_SESSION['csrf_token']; ?>">
  <!-- 其他表单字段 -->
  <button type="submit">提交</button>
</form>
验证CSRF令牌
session_start();
if ($_SERVER['REQUEST_METHOD'] === 'POST') {
  if (!isset($_POST['csrf_token']) || $_POST['csrf_token'] !== $_SESSION['csrf_token']) {
    // 令牌验证失败,执行相应的错误处理
    die("CSRF攻击检测到!请求被拒绝。");
  }
  // 令牌验证成功,继续处理请求
}

同源检测

检查请求的来源头部

if ($_SERVER['REQUEST_METHOD'] === 'POST') {
  $referer = $_SERVER['HTTP_REFERER'];
  $origin = $_SERVER['HTTP_ORIGIN'];
  
  $allowedOrigins = array('https://example.com', 'https://www.example.com'); // 允许的合法来源
  
  if (!in_array($referer, $allowedOrigins) || !in_array($origin, $allowedOrigins)) {
    // 来源验证失败,执行相应的错误处理
    die("CSRF攻击检测到!请求被拒绝。");
  }
  // 来源验证成功,继续处理请求
}

添加验证码

生成和验证验证码
session_start();
$randomNumber = rand(1000, 9999); // 生成随机验证码
$_SESSION['captcha'] = $randomNumber; // 将验证码存储在会话中

// 在表单中显示验证码图像
<img src="captcha.php" alt="验证码">

// 验证用户输入的验证码
session_start();
if ($_SERVER['REQUEST_METHOD'] === 'POST') {
  if (!isset($_POST['captcha']) || $_POST['captcha'] !== $_SESSION['captcha']) {
    // 验证码验证失败,执行相应的错误处理
    die("验证码验证失败!请求被拒绝。");
  }
  // 验证码验证成功,继续处理请求
}

设置HTTP头部

设置SameSite属性为Strict或Lax
header('Set-Cookie: mycookie=value; SameSite=Strict');

header('Set-Cookie: mycookie=value; SameSite=Lax');

总结

保护PHP应用免受CSRF攻击是至关重要的安全措施。通过生成和验证CSRF令牌、进行同源检测、添加验证码、设置HTTP头部和使用安全框架等方法,可以防止恶意用户利用CSRF攻击来执行未经授权的操作。开发人员应该根据具体应用的需求和安全级别选择合适的防御措施,并定期审查和更新这些措施,以确保应用的安全性。通过采取适当的CSRF防御措施,可以防止潜在的安全威胁,保护用户和应用的数据安全。

Python库Bleach:保护应用免受XSS攻击

thbcm阅读(364)

在当今的网络环境中,跨站脚本攻击(XSS)是一种常见而严重的安全威胁。为了保护我们的应用程序免受XSS攻击,我们可以使用Python库Bleach。本文将介绍Bleach库的基本概念、功能和用法,以及如何使用它来保护我们的应用程序。

什么是XSS攻击?

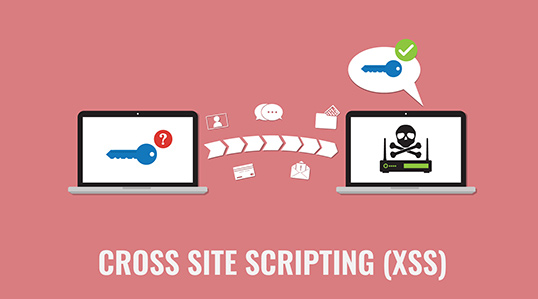
在深入了解Bleach之前,让我们先了解一下什么是跨站脚本攻击(XSS)。XSS攻击是一种利用Web应用程序中的漏洞来注入恶意脚本代码的攻击技术。攻击者可以通过在用户浏览器中执行恶意脚本,窃取用户的敏感信息、篡改页面内容或执行其他恶意操作。XSS攻击通常分为三类:存储型XSS、反射型XSS和DOM-based XSS。存储型XSS将恶意脚本存储在目标服务器上,用户访问受感染的页面时会执行该脚本。反射型XSS将恶意脚本作为参数附加到受感染的URL中,当用户点击包含恶意代码的链接时,恶意脚本会被执行。DOM-based XSS则利用了DOM(文档对象模型)的漏洞,通过篡改页面的DOM结构来执行恶意脚本。

介绍Bleach库

Bleach是一个Python库,旨在帮助开发者过滤和清理用户提供的HTML内容,以防止XSS攻击。它使用了一系列的过滤器和策略,可以清除或转义HTML标签、属性和事件处理程序,从而防止恶意脚本的注入。Bleach库还支持自定义策略和配置,以满足不同应用程序的需求。

Bleach库的安装与使用

安装Bleach库

在开始使用Bleach之前,我们需要先安装它。可以使用pip命令来安装Bleach库:

pip install bleach

使用Bleach库

下面是一个简单的示例,演示了如何使用Bleach库来过滤用户输入的HTML内容:

import bleach

# 用户输入的HTML内容
user_input = '<script>alert("XSS攻击");</script><p>欢迎访问我们的网站!</p>'

# 使用Bleach过滤HTML内容
cleaned_input = bleach.clean(user_input)

# 打印过滤后的内容
print(cleaned_input)

输出:

&lt;p&gt;欢迎访问我们的网站!&lt;/p&gt;

在上面的示例中,我们首先导入了Bleach库,然后定义了用户输入的HTML内容。接下来,我们使用bleach.clean()函数对用户输入进行过滤处理,并将过滤后的内容赋值给cleaned_input变量。最后,我们打印出过滤后的内容。通过使用Bleach库,恶意的<script>标签被转义为&lt;script&gt;,从而防止了XSS攻击。只有纯文本内容被保留,而HTML标签和脚本被过滤掉。

自定义策略和配置

Bleach库还支持自定义策略和配置,以满足不同应用程序的需求。我们可以使用bleach.sanitizer模块中的函数来定义自定义策略。例如,我们可以允许某些特定的HTML标签和属性,并且可以指定允续的CSS样式。

下面是一个示例,演示了如何使用Bleach库来自定义策略和配置:

import bleach

# 用户输入的HTML内容
user_input = '<p style="color: red;">欢迎访问我们的网站!</p>'

# 自定义策略和配置
allowed_tags = ['p']
allowed_attributes = {'p': ['style']}
allowed_styles = ['color']
custom_config = bleach.sanitizer.ALLOWED_CONFIG.copy()
custom_config.update({
    'tags': allowed_tags,
    'attributes': allowed_attributes,
    'styles': allowed_styles
})

# 使用自定义策略和配置过滤HTML内容
cleaned_input = bleach.clean(user_input, **custom_config)

# 打印过滤后的内容
print(cleaned_input)

输出:

<p style="color: red;">欢迎访问我们的网站!</p>

在上面的示例中,我们定义了允许的HTML标签、属性和CSS样式。然后,我们创建了一个自定义的配置对象,并使用bleach.clean()函数的**custom_config参数来使用自定义策略和配置进行过滤。最后,我们打印出过滤后的内容。通过自定义策略和配置,我们可以更精细地控制Bleach库对HTML内容的过滤处理,以满足应用程序的特定需求。

总结

XSS攻击是一种常见的网络安全威胁,但通过使用适当的工具和技术,我们可以保护我们的应用程序免受这种类型的攻击。Bleach库是一个强大的Python库,可以帮助我们过滤和清理用户提供的HTML内容,从而防止XSS攻击。通过使用Bleach,我们可以轻松地实现对用户输入的HTML内容进行安全过滤和清理。请记住,在保护应用程序免受XSS攻击方面,Bleach库只是防御策略的一部分。其他安全措施,如输入验证、输出编码和安全的开发实践,也同样重要。综合使用这些安全措施,我们可以最大程度地保护我们的应用程序和用户的安全。

CSS局限属性contain:优化渲染性能的利器

thbcm阅读(343)

在网页开发中,优化渲染性能是一个重要的目标。CSS局限属性contain是一个强大的工具,可以帮助我们提高网页的渲染性能。本文将介绍contain属性的基本概念、用法和优势,以及如何使用它来优化网页的渲染过程。

什么是contain属性?

contain​属性是CSS中的一个新属性,它用于定义元素的渲染边界。通过使用​contain​属性,我们可以告诉浏览器某个元素是否独立于其它元素进行渲染,从而优化渲染性能。​contain​属性有四个可能的值:​none​、​strict​、​content​和​size​。

  • none默认值,表示元素不具有任何渲染优化。它的子元素和后代元素可能会影响整个渲染树。
  • strict表示元素的样式和布局不会受到其子元素和后代元素的影响。这可以提高渲染性能,特别是在大型网页中。
  • content表示元素的样式和布局不会受到其子元素的影响,但会受到后代元素的影响。这对于具有复杂结构的元素很有用。
  • size表示元素的样式和布局不会受到其子元素和后代元素的影响,同时还会告诉浏览器元素的尺寸不会改变。这对于具有已知尺寸的元素非常有用。

使用contain属性优化渲染性能

通过使用​contain​属性,我们可以精确地控制元素的渲染边界,从而提高渲染性能。下面是一些使用​contain​属性的示例:

  • 使用​strict​值:假设我们有一个具有复杂结构的元素,其子元素经常发生变化。在这种情况下,我们可以将​contain​属性设置为​strict​,以告诉浏览器该元素的样式和布局不会受到其子元素的影响。这样可以减少浏览器重新计算样式和布局的次数,提高性能。
    .container {
      contain: strict;
    }
  • 使用​size​值:对于已知尺寸的元素,我们可以将​contain​属性设置为​size​,以告诉浏览器该元素的尺寸不会发生改变。这样可以减少浏览器重新计算布局的次数,进一步提高性能。
    .box {
      contain: size;
      width: 200px;
      height: 200px;
    }
  • 使用​content​值:有时候,我们希望某个元素的样式和布局不受其子元素的影响,但受到后代元素的影响。在这种情况下,我们可以将​contain​属性设置为​content​。
    .box {
      contain: size;
      width: 200px;
      height: 200px;
    }

兼容性和注意事项

尽管​contain​属性对于优化渲染性能非常有用,但它的兼容性并不完美。目前,​contain​属性的支持主要集中在现代浏览器上。在使用​contain​属性之前,务必先进行兼容性检查,并根据实际情况决定是否使用。

另外,需要注意的是,​contain​属性并不是万能的解决方案。在使用​contain​属性时,我们仍然需要注意其他性能优化技术,如避免过度渲染、减少布局回流等的操作。综合运用多种技术手段,才能最大程度地提升网页的渲染性能。

总结

CSS的contain属性是一个强大的工具,可以帮助我们优化网页的渲染性能。通过精确控制元素的渲染边界,我们可以减少浏览器重新计算样式和布局的次数,提高性能。然而,需要注意的是,contain属性的兼容性有限,且它并非解决所有性能问题的万能方案。在使用contain属性时,我们应综合考虑其他性能优化技术,以实现最佳的渲染性能。

InstantID:开源AI写真生成工具的新星

thbcm阅读(341)

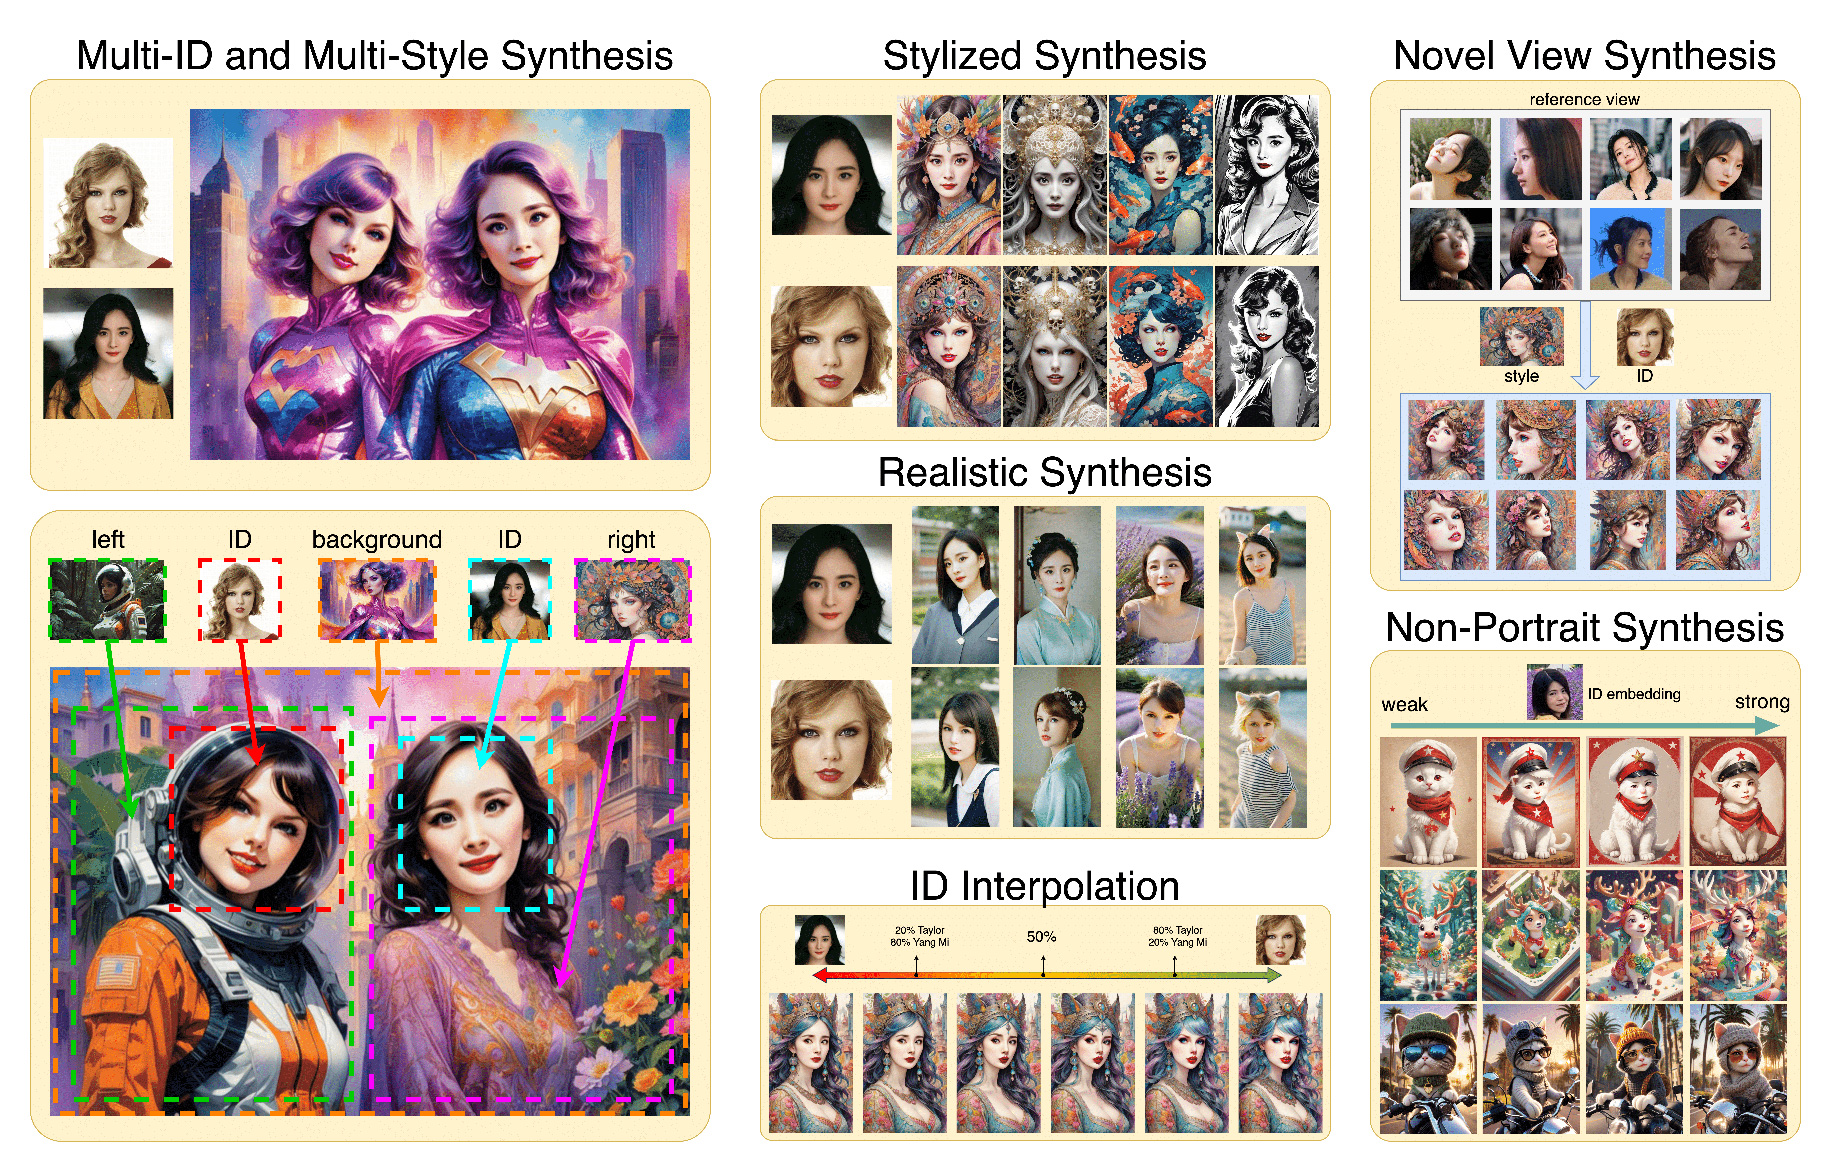
随着人工智能技术的快速发展,AI写真生成工具成为了近年来备受关注的热门话题之一。在GitHub上,一款名为InstantID的开源AI写真生成工具近期引起了广泛的关注和讨论。开源一周这款工具已经获得了5.4千颗星星,表明了开发者和社区的高度认可。

InstantID是什么?

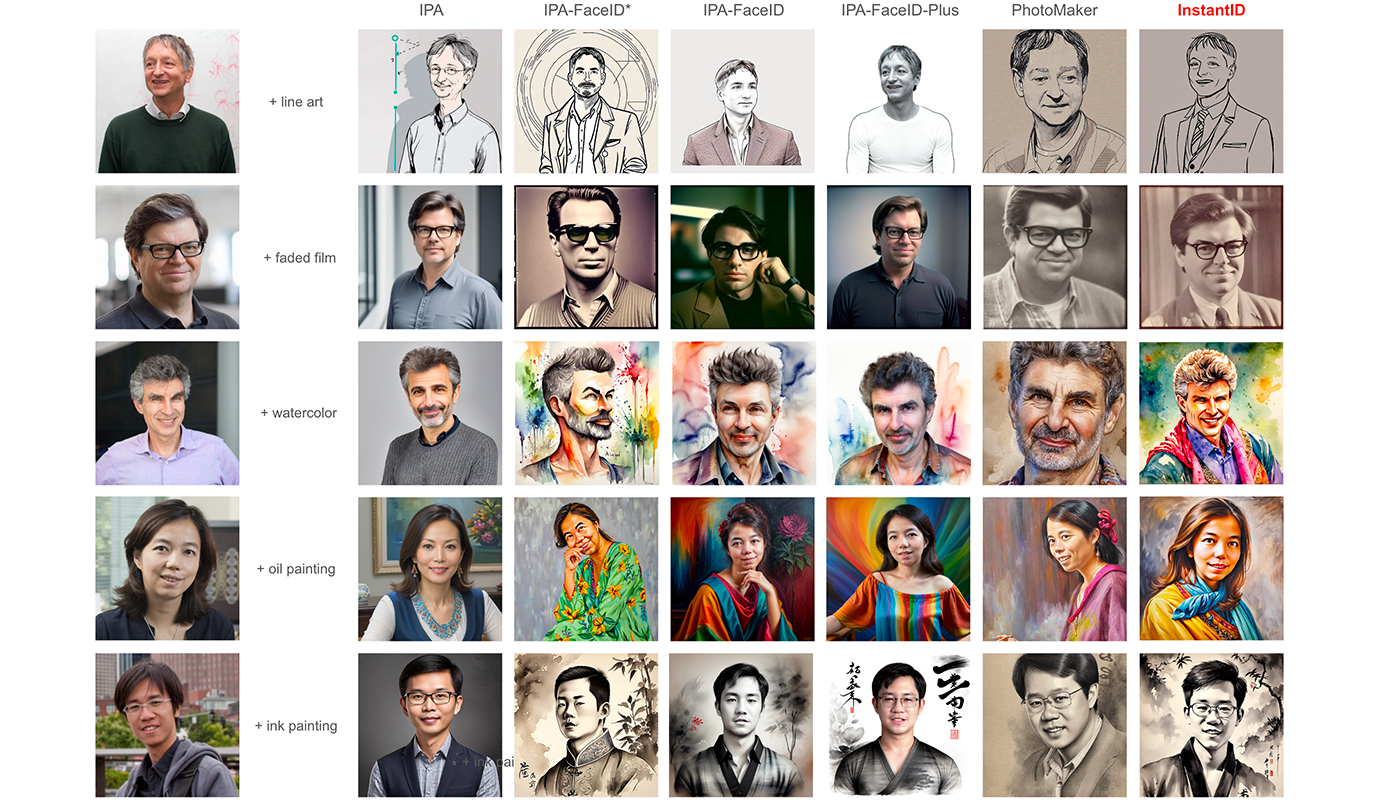
InstantID 是一种新的、最先进的、免调整的方法,只需一张图像即可生成 ID 保留的生成。身份保留生成是指生成的图像和数据保留原始人或主体的身份(ID)。简单来说,例如在生成人脸时,它是一种确保生成的人脸看起来与原始人相同的技术。这使得可以在不丢失人的特征和个性的情况下生成新的图像和数据。所有这一切只需一张图像即可实现

InstantID的设计旨在解决现有个性化图像合成方法在实际应用中的一些限制,例如高存储需求、漫长的微调过程以及需要多张参考图像。InstantID不需要训练任何额外的模型,也不需要测试时的微调,只需要一次前向推理,就能与社区中的流行的预训练文本到图像的扩散模型无缝集成,作为一个灵活的插件。

InstantID是一个来自中国的开源项目,由InstantX团队开发。主要的成员是小红书的员工。

InstantID是如何做到的?

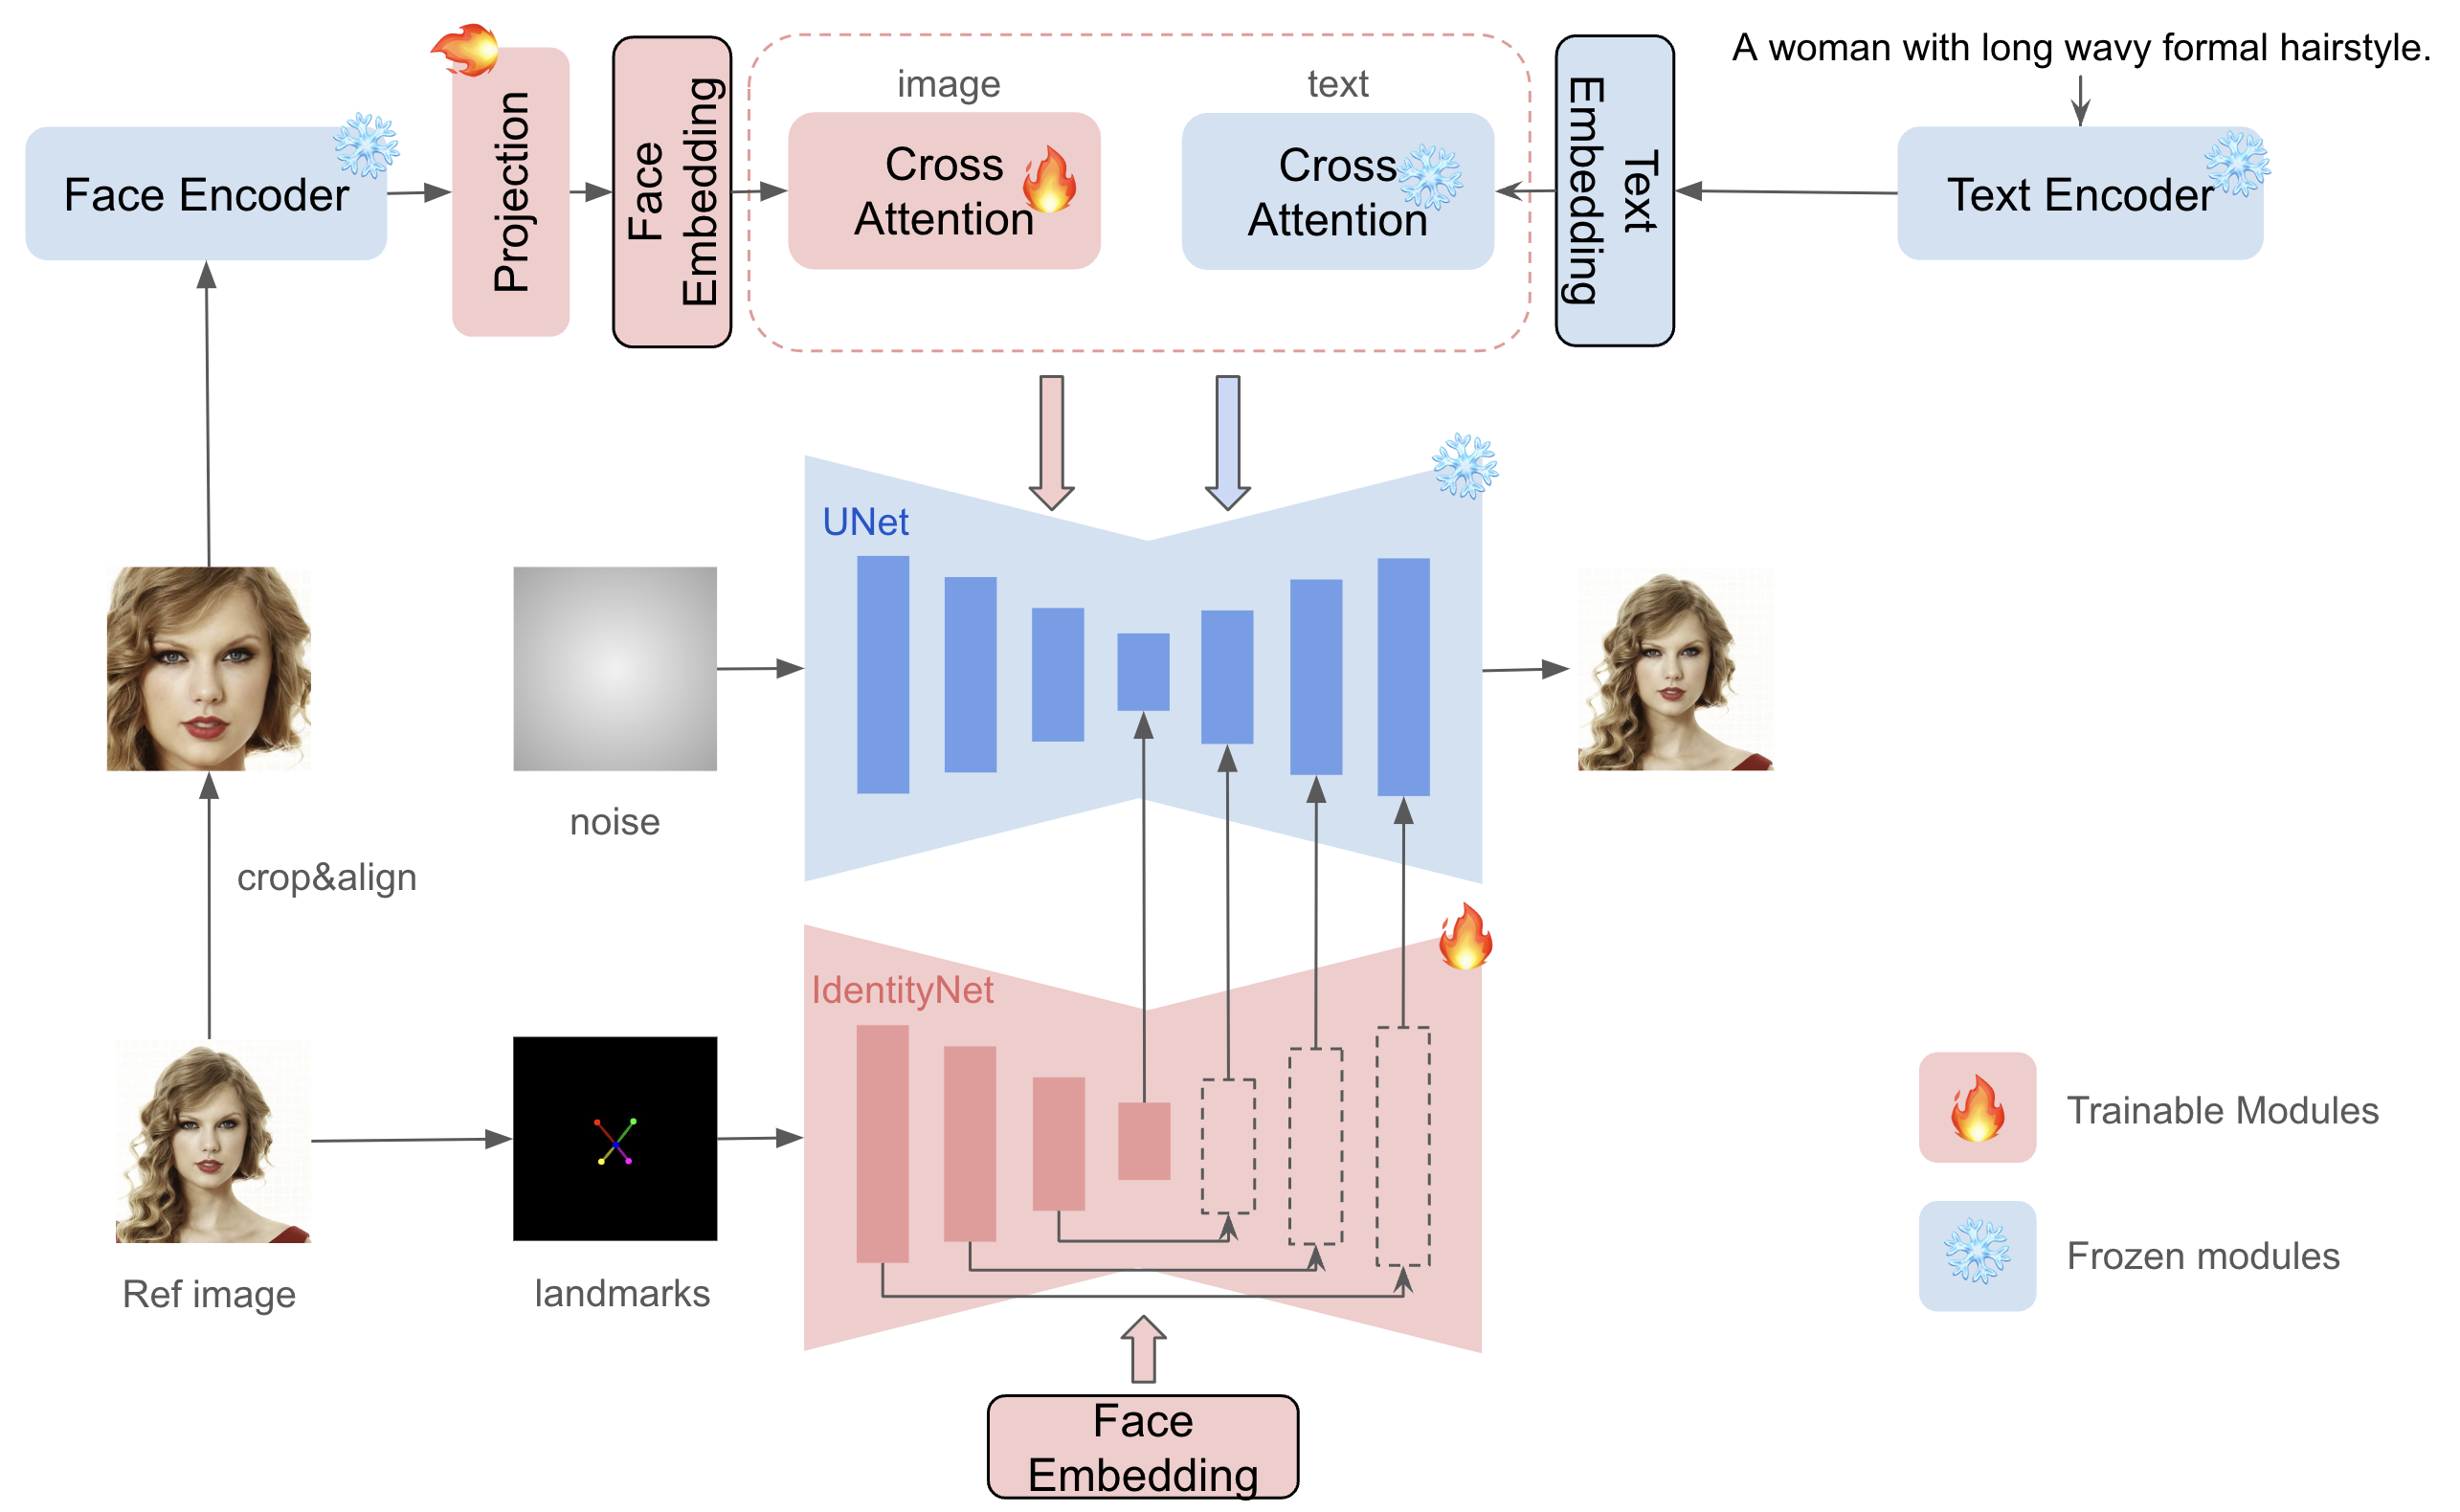
InstantID 仅提供一张参考 ID 图像,旨在从单个参考 ID 图像生成具有各种姿势或样式的自定义图像,同时确保高保真度。 它包含三个关键组件:

  • 捕获强大的语义人脸信息的ID嵌入;
  • 具有解耦交叉注意力的轻量级适配模块,便于使用图像作为视觉提示;
  •  一个 IdentityNet,它通过额外的空间控制对参考面部图像中的详细特征进行编码。

几个方面与以往不同:

  • 不训练UNet,因此可以保留原始文本到图像模型的生成能力,并与社区中现有的预训练模型和ControlNets兼容;
  • 不需要测试时调优,所以对于一个特定的角色,不需要收集多张图片进行微调,只需要对一张图片进行一次推断;
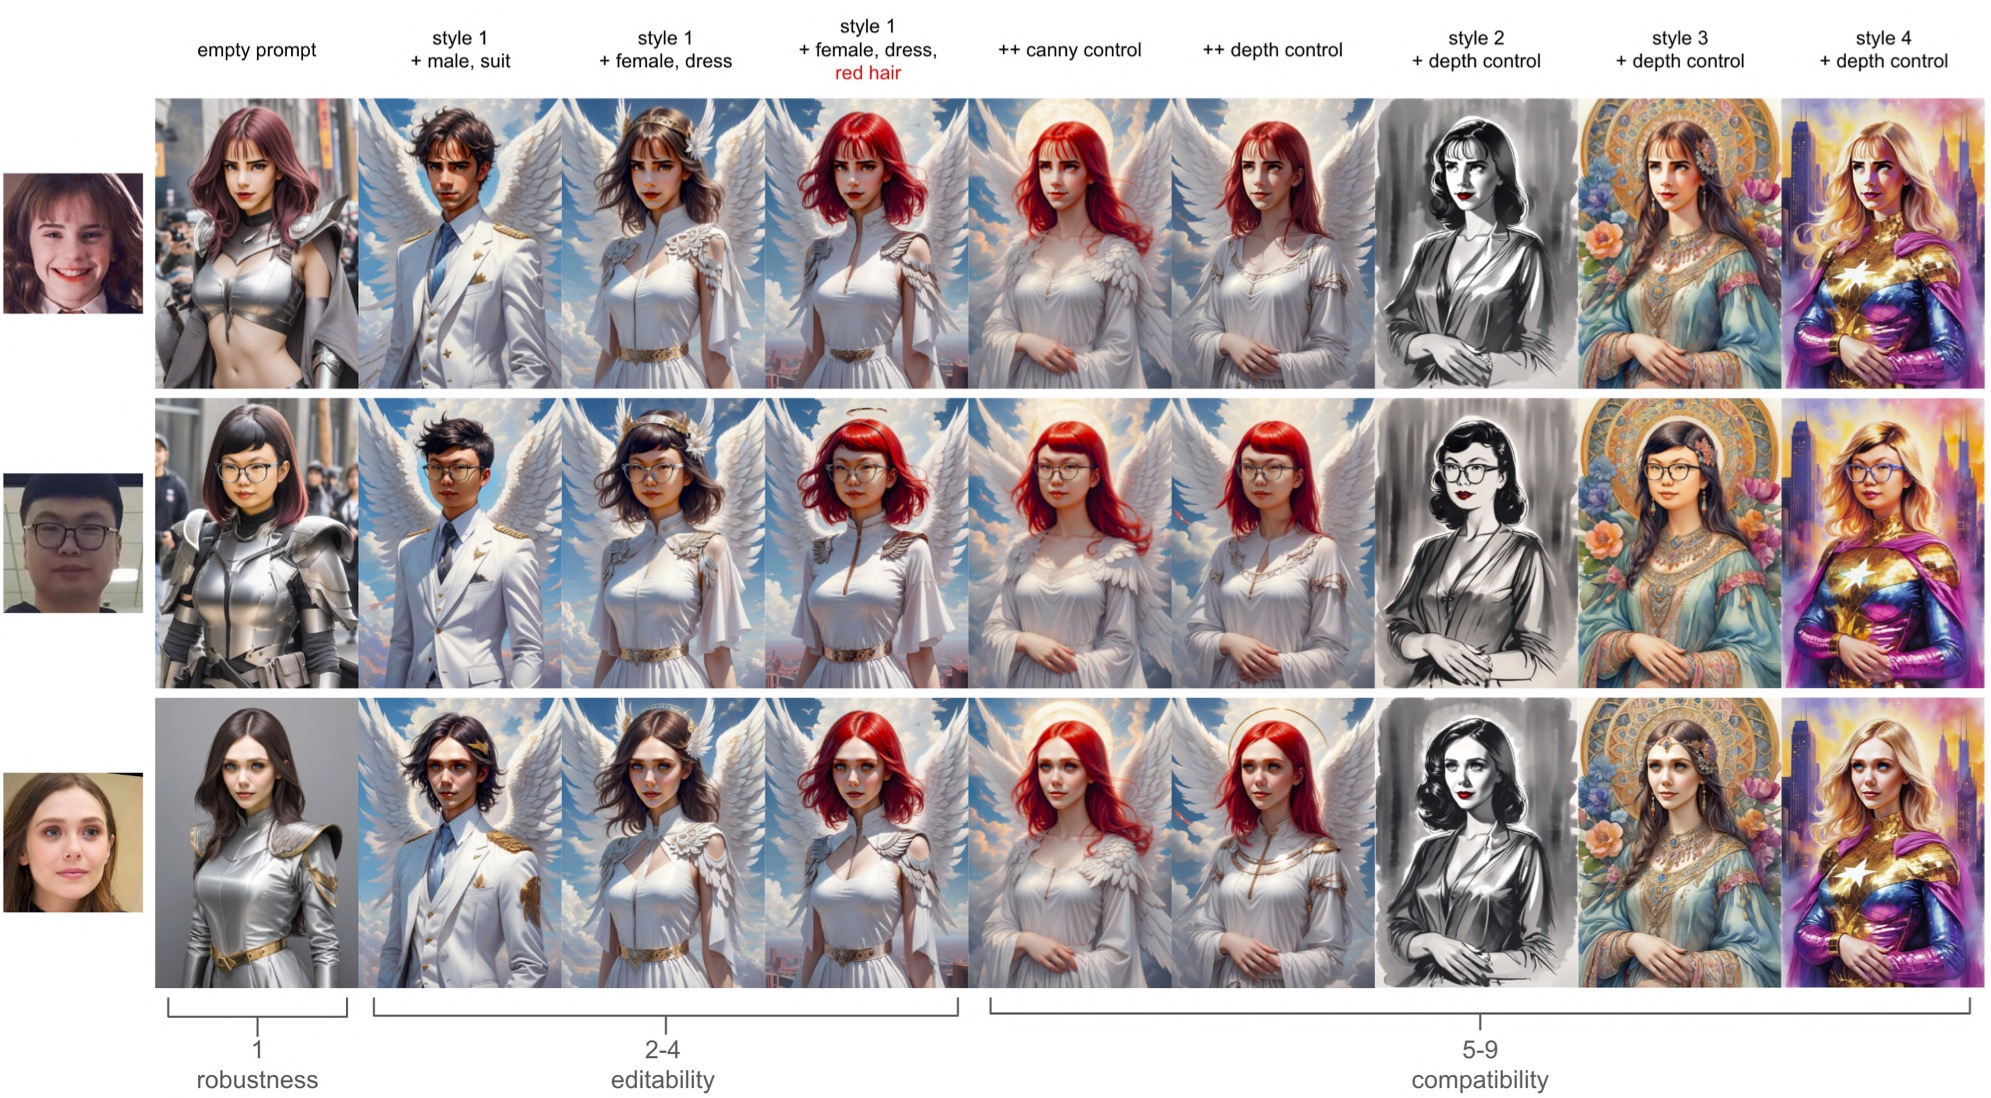
  • 实现了更好的人脸保真度,并保留了文本的可编辑性。

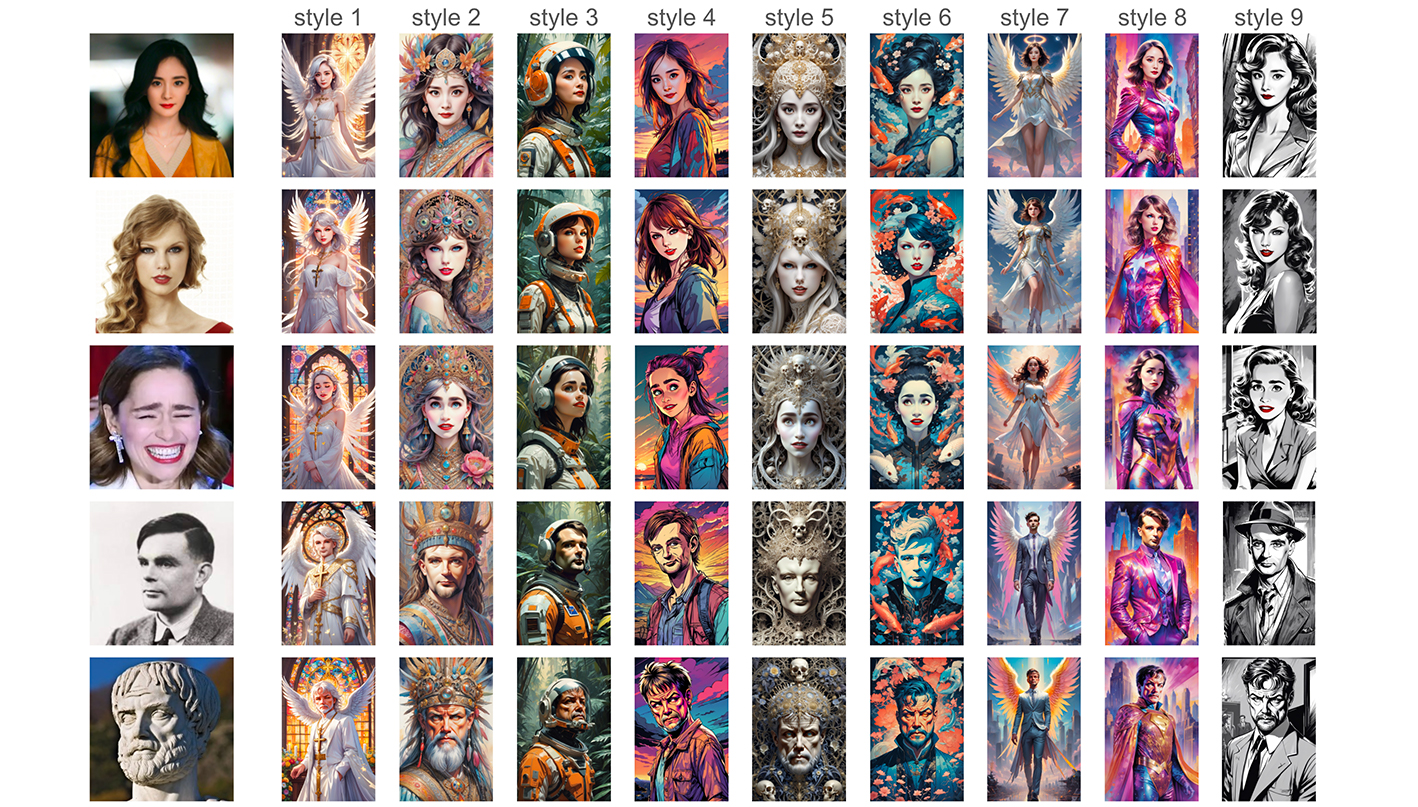
InstantID的效果非常惊艳,它能够在各种风格中生成高保真的个性化图像,例如卡通、油画、素描、动漫、游戏等。用户只需要输入一张面部图像和一段文本描述,就能得到满意的结果。InstantID不仅能够生成各种风格的个性化图像,还能够保持文本的可编辑性,即用户可以随时修改文本描述,来改变图像的生成效果。

InstantID 的创新之处

  • 人脸特征提取:InstantID 利用预训练的人脸编码器,比如 InsightFace 的 antelopev 模型,来提取强语义的人脸特征,以增强图像生成的语义准确性。这样,扩散模型就能更好地识别和保留人脸的细节,比如眼睛、鼻子、嘴巴等。
  • Cross-Attention 机制:InstantID 通过解耦的交叉注意力机制,将人脸特征作为 Image Prompt 嵌入,增强文本提示的效果,同时保持对生成图像的精细控制。这样,扩散模型就能更好地根据文本的要求,来调整图像的风格,比如颜色、光照、背景等。
  • IdentityNet:InstantID 引入 IdentityNet 对人脸图像进行编码,通过强语义和弱空间的条件控制,进一步提升 ID 的保真度。IdentityNet 是一个可插拔的模块,它可以和任何预训练的文本到图像扩散模型兼容,而无需重新训练。

总结

InstantID作为一款开源的AI写真生成工具,受到了广泛的关注和认可。对AI写真生成领域产生了积极的影响,推动了技术的进步、应用的拓展和社会讨论的展开。随着开源社区的不断发展和用户需求的不断增加,我们可以期待InstantID在未来的发展中发挥更大的作用,为用户创造更多的可能性。

行式存储 vs 列式存储:数据存储的巅峰对决

thbcm阅读(296)

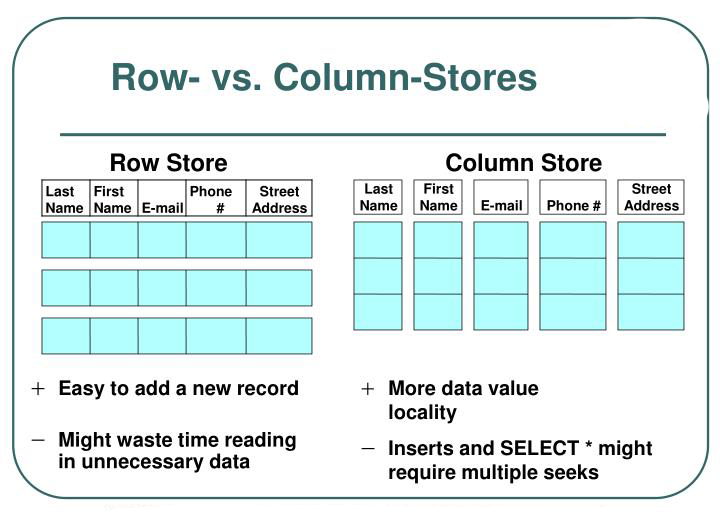
在数据处理和分析领域,数据存储是一个关键问题。行式存储和列式存储是两种常见的数据存储方式,它们在数据存储和检索的方式上有着显著的差异。本文将深入探讨行式存储和列式存储的概念、工作原理以及它们在实际应用中的优缺点。

行式存储

定义

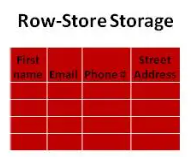
行式存储是一种将数据按行存储的方式。在行式存储中,每一行数据都包含了多个列或字段,类似于传统的关系型数据库表格。

工作原理

行式存储将一条记录的所有字段值存储在一起,这样可以更快地检索整个记录。当需要查询某个字段时,行式存储可以直接读取整行数据,并返回所需的字段值。

优点

  • 适合事务型应用:行式存储对于频繁进行更新和插入操作的事务型应用非常有效,因为每次操作只需要修改一行数据。
  • 简单的数据模型:行式存储的数据模型类似于传统的关系型数据库,易于理解和使用。
  • 灵活的查询:行式存储可以方便地进行各种查询操作,如连接、聚合和过滤等。

列式存储

定义

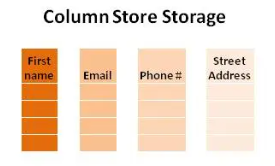
列式存储是一种将数据按列存储的方式。在列式存储中,每个列的值都存储在一起,不同列的值可以分别进行压缩和编码。

工作原理

列式存储将同一列的数据值存储在一起,这样可以更高效地进行列级别的数据压缩和编码。当需要查询某个字段时,列式存储只需要读取该列的数据,而不需要读取其他列的数据,从而提高了查询性能。

优点

  • 高压缩率:由于列式存储可以对每列数据进行独立的压缩和编码,可以实现更高的压缩率,节省存储空间。
  • 高查询性能:列式存储只需要读取所需的列数据,避免了读取不必要的数据,从而提高了查询性能。
  • 分析型应用:列式存储在数据分析和聚合等场景下表现出色,因为它可以快速提取某个特定字段的所有值,并进行高效的计算。

行式存储与列式存储的比较

  • 适用场景:行式存储适用于事务型应用,如数据库系统,其中频繁进行数据更新和插入操作。列式存储适用于分析型应用,如数据仓库和大规模数据分析,其中需要高效地进行数据聚合和计算。
  • 存储效率:行式存储在存储效率上相对较低,因为每一行数据都包含了多个字段,可能存在冗余。列式存储在存储效率上相对较高,由于每个列的值都存储在一起,可以实现更高的压缩率。
  • 查询性能:行式存储在单行查询和事务处理方面表现良好,但在大规模数据分析和聚合查询时可能效率较低。列式存储在大规模数据分析和聚合查询方面表现出色,由于只需要读取所需的列数据,可以提高查询性能。
  • 数据更新和插入性能:行式存储在数据更新和插入操作方面表现较好,因为每次操作只需要修改一行数据。列式存储在数据更新和插入操作方面相对较差,因为需要对每列数据进行修改。

总结

行式存储和列式存储是两种常见的数据存储方式,各自在不同的应用场景下具有优势。行式存储适用于事务型应用,具有简单的数据模型和灵活的查询能力,适合频繁进行数据更新和插入操作。列式存储适用于分析型应用,具有高压缩率和查询性能,适合大规模数据分析和聚合查询。在选择数据存储方式时,需要根据具体的应用需求和性能要求进行评估和选择,以获得最佳的存储效率和查询性能。

Lua: 一门轻量级、高效的脚本语言

thbcm阅读(337)

在当今软件开发的领域中,寻找一门既灵活又高效的脚本语言,一直是开发者们追求的目标。Lua作为一门小巧、高效、可嵌入的脚本语言,已经成为了众多开发者的首选之一。无论是游戏开发、嵌入式系统、Web 开发还是其他领域,Lua 都展现出了其强大的应用价值和广泛的适用性。本文将深入探讨 Lua 的特点、应用领域和基本语法,带您一起探索 Lua 这门脚本语言的奥秘。

Lua简介

Lua(发音为“loo-ah”)是一种小巧、高效、可嵌入的脚本语言,它被设计成一种通用的扩展语言,并且具有简单而强大的语法特性。Lua 广泛应用于游戏开发、嵌入式系统、Web 开发和各种其他领域,因其轻量级、灵活性和高性能而备受开发者青睐。本文将介绍 Lua 的特点、应用领域和基本语法。

Lua的特点

  • 轻量级和快速:Lua 是一种轻量级的语言,设计简洁、代码紧凑,执行效率高,适用于各种资源受限的环境。由于 Lua 的设计目标是速度和尽可能少的资源消耗,它通常具有很高的执行效率。
  • 可嵌入性:Lua 是一种可嵌入的语言,可以很容易地集成到其他应用程序中。许多软件和系统都选择 Lua 作为扩展语言,以提供灵活性和可定制性。
  • 动态类型:Lua 是一种动态类型的语言,变量无需预先声明类型,可以根据需要自动推断类型。这种灵活性使得 Lua 编程更加简洁和易于理解。
  • 垃圾回收:Lua 具有内置的垃圾回收机制,可以自动管理内存,帮助开发者避免内存泄漏和资源浪费的问题。

Lua的应用领域

  • 游戏开发:Lua 在游戏开发领域得到了广泛应用。许多游戏引擎和框架(如 Unity、Corona SDK)都支持 Lua 作为脚本语言,开发者可以使用 Lua 脚本来编写游戏逻辑、界面和 AI。
  • 嵌入式系统:由于 Lua 的轻量级和可嵌入性,它在嵌入式系统中被广泛采用。例如,路由器、智能家居设备、工业控制系统等都可以使用 Lua 来编写自定义脚本。
  • Web 开发:虽然 Lua 并不是主流的 Web 开发语言,但它仍然被用于编写 Web 应用程序的某些部分,特别是在一些高性能的 Web 服务器(如 Nginx)中,开发者可以使用 Lua 脚本来扩展服务器的功能。
  • 数据配置和脚本处理:Lua 也经常用于数据配置文件和脚本处理。许多软件和游戏使用 Lua 来定义配置文件,以及执行各种自动化任务和脚本处理。

Lua的基本语法

Lua 的基本语法简单而直观,类似于其他脚本语言。以下是一个简单的 Lua 示例:

-- 定义函数
function greet(name)
    print("Hello, " .. name .. "!")
end

-- 调用函数
greet("Lua")

-- 定义表(table)
person = {name = "Alice", age = 30, gender = "female"}

-- 访问表中的元素
print("Name: " .. person.name)
print("Age: " .. person.age)
print("Gender: " .. person.gender)

总结

Lua 是一种小巧而强大的脚本语言,具有许多优秀的特性和广泛的应用领域。它的简单、灵活和高性能使得 Lua 成为许多开发者的首选语言之一。无论是游戏开发、嵌入式系统、Web 开发还是其他领域,Lua 都展现出了其强大的应用价值,为开发者提供了丰富的工具和资源。

联系我们