再也不用为多张Excel表汇总发愁了,Python 秒处理真香!

thbcm阅读(457)

文章来源于公众号:Python技术 作者:派森酱

为何非程序员学 Python 的越来越多了?他们可能并不是想去爬取一些网站的数据,而是在工作中碰到很多数据分析处理的问题,用 Python 就可以简单高效地解决。本文就通过一个实际的例子来给大家展示一下 Python 是如何应用于实际工作中高效解决复杂问题的。

背景

小明就职于一家户外运动专营公司,他们公司旗下有好多个品牌,并且涉及到很多细分的行业。小明在这家公司任数据分析师,平时都是通过 Excel 来做数据分析的。今天老板丢给他一个任务:下班前筛选出集团公司旗下最近一年销售额前五名的品牌以及销售额。

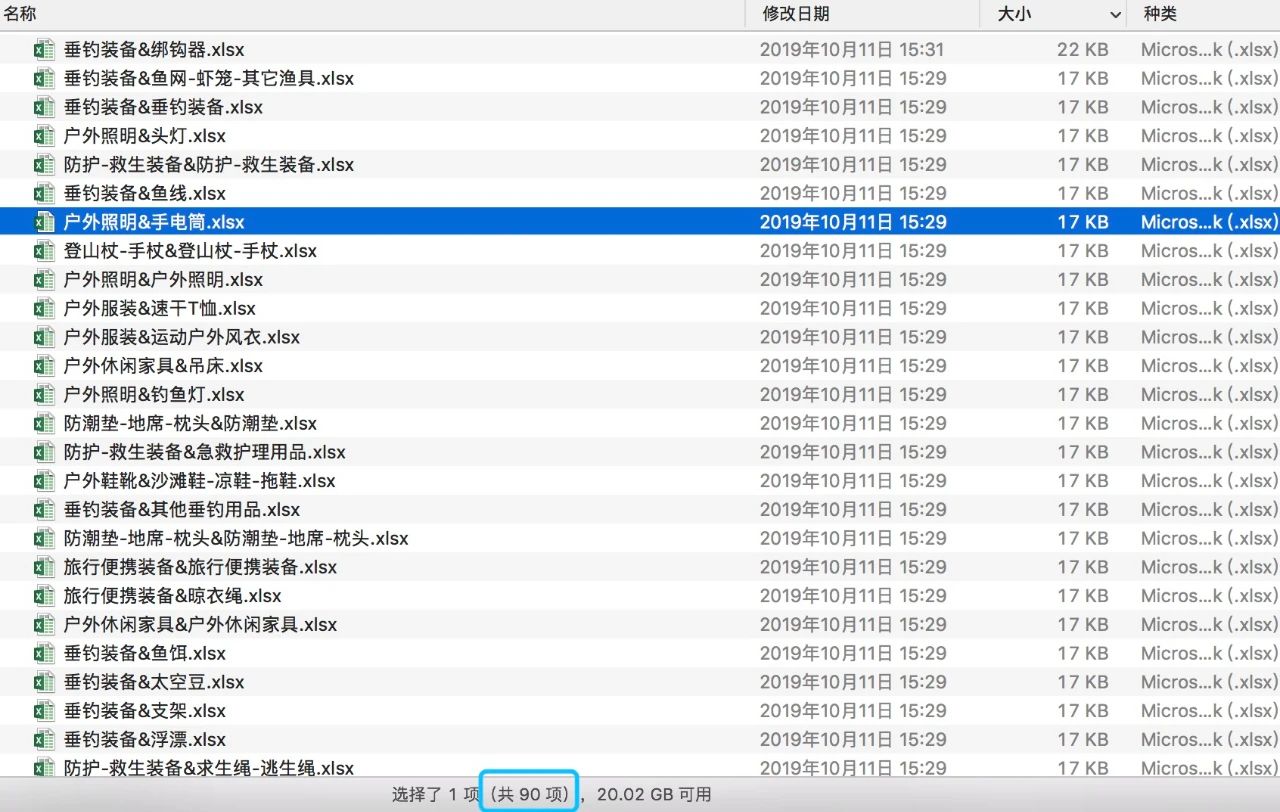
对于 Excel 大佬来说,这不就是分分钟的事吗?小明并没有放在眼里,直到市场部的同事将原始的数据文件发给他,他才意识到事情并没有那么简单:

这并不是想象中的排序取前五就行了。这总共有90个文件,按常规的思路来看,他要么将所有文件的内容复制到一张表中进行分类汇总,要么将每张表格进行分类汇总,然后再最最终结果进行分类汇总。

想想这工作量,再想想截止时间,小明挠了挠头,感觉到要渐渐头秃。

思路分析

这种体力活,写程序解决是最轻松的啦。小明这时候想到了他的程序员好朋友小段,于是他把这个问题抛给了小段。

小段缕了下他那所剩无几的头发,说:so easy,只需要找潘大师即可。

小明说:你搞不定吗?还要找其他人!

小段苦笑说:不不不,潘大师是 Python 里面一个处理数据的库,叫 Pandas ,俗称 潘大师。

小明说:我不管什么大师不大师,就说需要多久搞定。

小段说:给我几分钟写程序,再跑几秒钟就好了!

小明发过去了膜拜大佬的表情。

小段略微思考了下,整理了一下程序思路:

  • 计算每张表每一行的销售额,用“访客数 转化率 客单价”就行。
  • 将每张表格根据品牌汇总销售额。
  • 将所有表格的结果汇总成一张总表
  • 在总表中根据品牌汇总销售额并排序

编码

第零步,读取 Excel :

import pandas as pd


df = pd.read_excel("./tables/" + name)

第一步,计算每张表格内的销售额:

df['销售额'] = df['访客数'] * df['转化率'] * df['客单价']

第二步,将每张表格根据品牌汇总销售额:

df_sum = df.groupby('品牌')['销售额'].sum().reset_index()

第三步,将所有表格的结果汇总成一张总表:

result = pd.DataFrame()
result = pd.concat([result, df_sum])

第四步,在总表中根据品牌汇总销售额并排序:

final = result.groupby('品牌')['销售额'].sum().reset_index().sort_values('销售额', ascending=False)

最后,我们来看看完整的程序:

import pandas as pd
import os


result = pd.DataFrame()


for name in os.listdir("./tables"):
    try:
        df = pd.read_excel("./tables/" + name)
        df['销售额'] = df['访客数'] * df['转化率'] * df['客单价']
        df_sum = df.groupby('品牌')['销售额'].sum().reset_index()
        result = pd.concat([result, df_sum])
    except:
        print(name)
        pass


final = result.groupby('品牌')['销售额'].sum().reset_index().sort_values('销售额', ascending=False)
pd.set_option('display.float_format', lambda x: '%.2f' % x)
print(final.head())

最后的结果是这样的:

       品牌           销售额
15   品牌-5 1078060923.62
8   品牌-17 1064495314.96
4   品牌-13 1038560274.21
3   品牌-12 1026115153.00
13   品牌-3 1006908609.07

可以看到最终的前五已经出来了,整个程序运行起来还是很快的。

几分钟之后,小段就把结果给小明发过去了,小明感动得内牛满面,直呼改天请吃饭,拜师学艺!

总结

本文主要是想通过一个实际的案例来向大家展示潘大师(Pandas)的魅力,特别是应用于这种表格处理,可以说是太方便了。写过程序的可能都有点熟悉的感觉,这种处理方式有点类似于 SQL 查询语句。潘大师不仅能使我们的程序处理起来变得更简单高效,对于需要经常处理表格的非程序员也是非常友好的,上手起来也比较简单。

以上就是W3Cschool编程狮关于再也不用为多张Excel表汇总发愁了,Python 秒处理真香!的相关介绍了,希望对大家有所帮助。

你也可以理解的React Fiber,学废了吗

thbcm阅读(421)

文章来源于公众号:前端时光屋 作者:小豪

Fiber出现的背景?

在早期的 React 版本中,也就是 React16.8 版本之前。

大量的同步计算任务阻塞了浏览器的UI渲染。默认情况下,JS运算、页面布局和页面绘制渲染都是运行在浏览器的主线程当中,他们之间是互斥的关系。

如果 JS 运算持续占用主线程,页面就没法得到及时的更新,当我们调用setState更新页面的时候,React 会遍历应用的所有节点,与老的 dom 节点进行 diff 算法的对比,最小代价更新页面,即使这样,整个过程也是一气呵成,不能被打断的,如果页面元素很多,整个过程占用的时间就可能超过16毫秒,出现掉帧的现象。

针对这一现象,React 团队从框架层面对 web 页面的运行机制做了优化,此后,Fiber诞生了。

说到16ms,我们来看这样的一个概念

屏幕刷新率

  • 目前大多数设备的屏幕刷新率为60次/秒
  • 浏览器的渲染动画或页面的每一帧的速率也需要跟设备屏幕的刷新率保持一致。
  • 页面是一帧一帧绘制出来的,当每秒绘制的帧数(FPS)达到60时,页面是流畅的,小于这个值时,用户会感觉到卡顿。
  • 每个帧的预算时间是16.66毫秒(1秒/60)
  • 1s 60帧,所以我们书写代码时尽量不让一帧的工作量超过16ms

Fiber的诞生

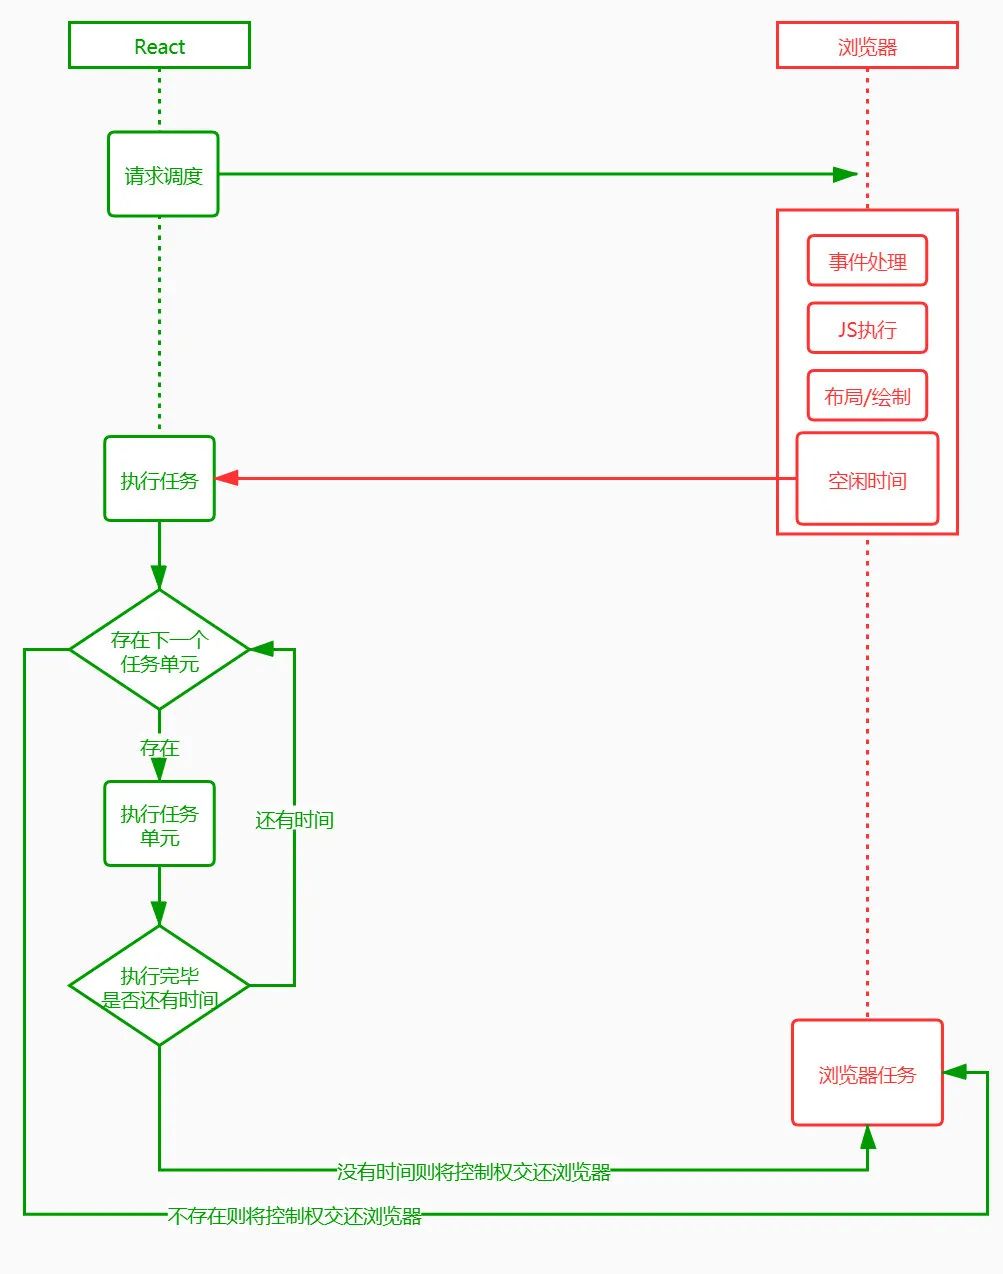
解决主线程长时间被 JS 晕眩占用这一问题的基本思路,是将运算切割为多个步骤,分批完成。也就是说在完成一部分任务之后, 将控制权交回给浏览器,让浏览器有时间再进行页面的渲染。等浏览器忙完之后,再继续之前React未完成的任务。

旧版 React 通过递归的方式进行渲染,使用的是 JS 引擎自身的函数调用栈,它会一直执行到栈空为止。

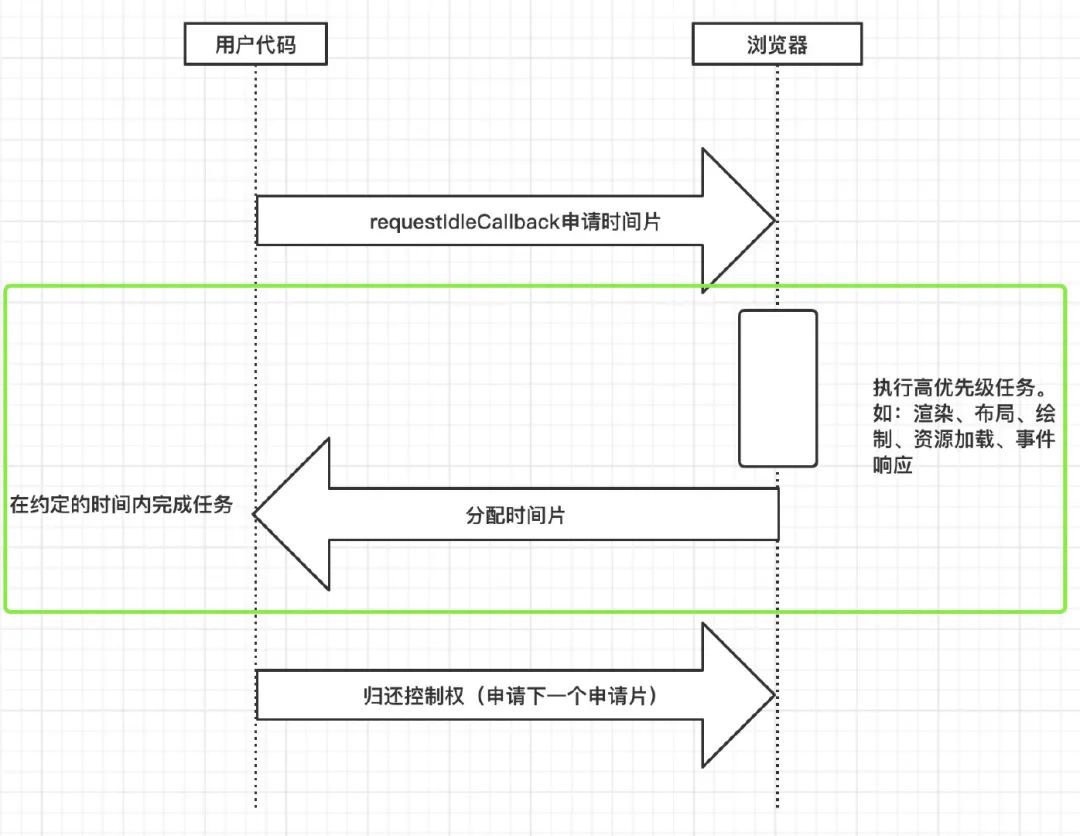
而Fiber实现了自己的组件调用栈,它以链表的形式遍历组件树,可以灵活地暂停、继续和丢弃执行的任务。实现的方式是使用了 浏览器的requestIdleCallback这一 API。官方的解释是这样的:

window.requestIdleCallback()会在浏览器空闲时期依次调用函数,这就可以让开发者在主事件循环中执行后台或优先级低的任务,而且不会像对动画和用户交互这些延迟触发产生关键的事件影响。函数一般会按先进先调用的顺序执行,除非函数在浏览器调用它之前就到了它的超时时间。

requestIdleCallback的核心用法

  • 希望快速响应用户,让用户觉得够快,不能阻塞用户的交互行为
  • requestIdleCallback 使开发者能够在主事件循环上执行后台和低优先级的工作,而不会影响延迟关键事件,例如动画和输入的响应
  • 正常帧任务完成后没超过16ms,说明时间有赋予,此时就会执行requestIdleCallback里注册的任务

requestIdleCallback执行流程

Fiber是什么

Fiber是一个执行单元

Fiber 是一个执行单元,每次执行完一个执行单元, React 就会检查现在还剩多少时间,如果没有时间就将控制权让出去

Fiber是一种数据结构

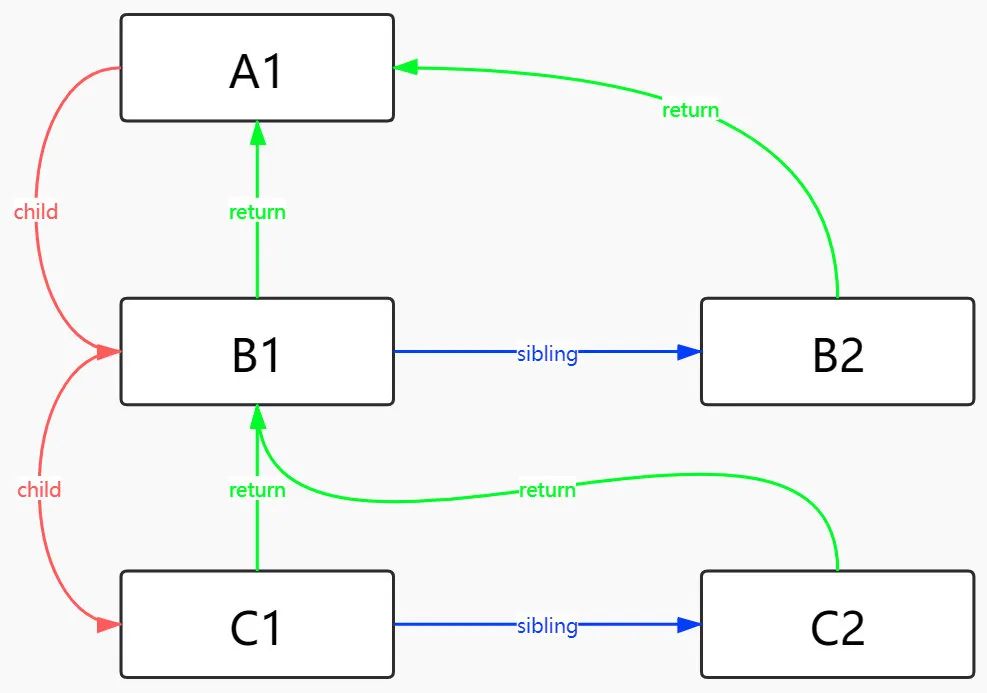
React 目前的做法是使用链表, 每个 VirtualDOM 节点内部表示为一个Fiber,它可以用一个 JS 对象来表示:

const fiber = {
  stateNode, // 节点实例
  child,     // 子节点
  sibling,   // 兄弟节点
  return,    // 父节点
}

Fiber之前的协调阶段

  • React 会递归比对VirtualDOM树,找出需要变动的节点,然后同步更新它们。这个过程 React 称为Reconcilation(协调)
  • 在Reconcilation期间,React 会一直占用着浏览器资源,一则会导致用户触发的事件得不到响应, 二则会导致掉帧,用户可能会感觉到卡顿
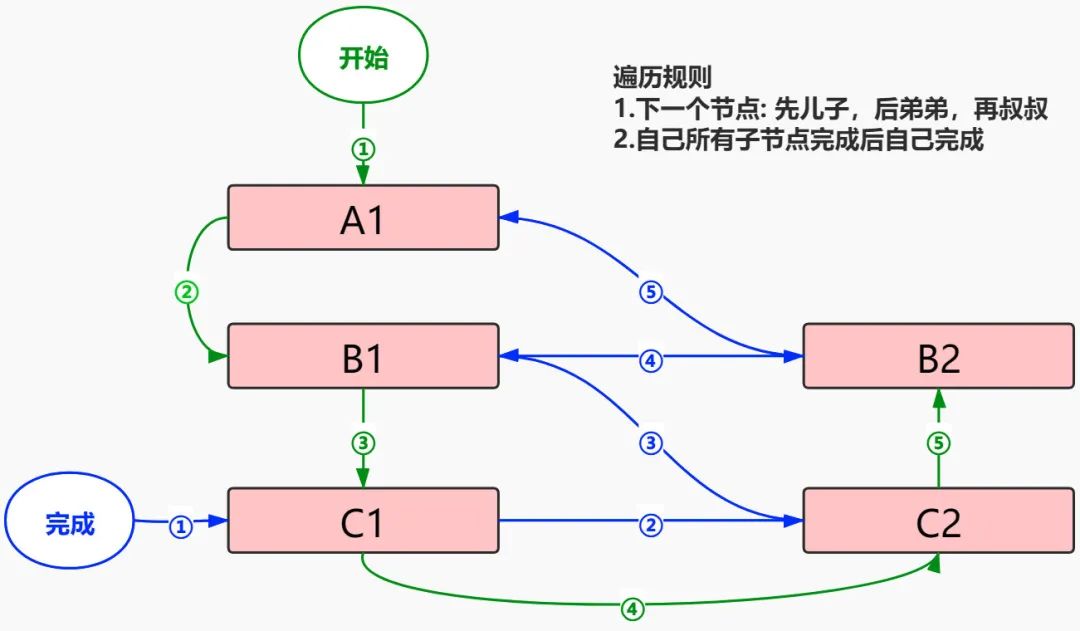
let root = {
  key: 'A1',
  children: [
    {
      key: 'B1',
      children: [
        {
          key: 'C1',
          children: []
        },
        {
          key: 'C2',
          children: []
        }
      ]
    },
    {
      key: 'B2',
      children: []
    }
  ]
}


function walk(element) {
  doWork(element);
  element.children.forEach(walk);
}


function doWork(element) {
  console.log(element.key);
}
walk(root);

在 Fiber 出现之前, React 会不断递归遍历虚拟 DOM 节点,占用着浏览器资源,积极地浪费性能,造成卡顿现象,且协调阶段是不能被打断的。

Fiber 出现之后,通过某些 Fiber 调度策略合理分配 CPU 资源,让自己的协调阶段变成可被终端,适时地让 CPU(浏览器)执行权,提高了性能优化。

Fiber执行阶段

每次渲染有两个阶段:Reconciliation(协调\render阶段)和Commit(提交阶段)

  • 协调阶段: 这个阶段可以被中断, 通过Dom-Diff算法找出所有节点变更,例如节点新增、删除、属性变更等等, 这些变更React 称之为副作用(Effect)
  • 提交阶段: 将上一个阶段计算出来的需要处理的副作用(Effects)一次性执行了。这个阶段必须同步执行,不能被打断

简单理解的话

  • 阶段1:生成Fiber树,得出需要更新的节点信息。(可打断)
  • 阶段2:将需要更新的节点一次性地批量更新。(不可打断)

Fiber的协调阶段,可以被优先级较高的任务(如键盘输入)打断。

阶段1可被打断的特性,让优先级更高的任务先执行,从框架层面大大降低了页面掉帧的概率。

Fiber执行流程

render阶段

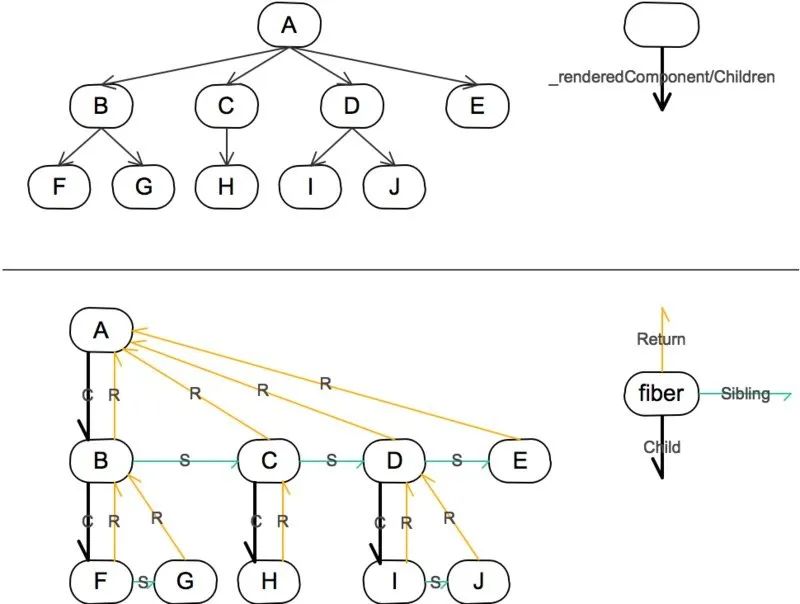
Fiber Reconciliation(协调) 在阶段一进行 Diff 计算的时候,会生成一棵 Fiber 树。这棵树是在 Virtual DOM 树的基础上增加额外的信息生成来的,它本质来说是一个链表。

commit提交阶段

Fiber 树在首次渲染的时候会一次过生成。在后续需要 Diff 的时候,会根据已有树和最新 Virtual DOM 的信息,生成一棵新的树。这颗新树每生成一个新的节点,都会将控制权交回给主线程,去检查有没有优先级更高的任务需要执行。如果没有,则继续构建树的过程。

1.如果过程中有优先级更高的任务需要进行,则 Fiber Reconciler 会丢弃正在生成的树,在空闲的时候再重新执行一遍。

2.在构造 Fiber 树的过程中,Fiber Reconciler 会将需要更新的节点信息保存在Effect List当中,在阶段二执行的时候,会批量更新相应的节点。

细节拓展

render阶段是如何遍历,生成Fiber树的?

<div>


</div>

  • 从顶点开始遍历
  • 如果有第一个儿子,先遍历第一个儿子
  • 如果没有第一个儿子,标志着此节点遍历完成
  • 如果有弟弟遍历弟弟
  • 如果有没有下一个弟弟,返回父节点标识完成父节点遍历,如果有叔叔遍历叔叔
  • 没有父节点遍历结束

commit阶段,是如何commit的?

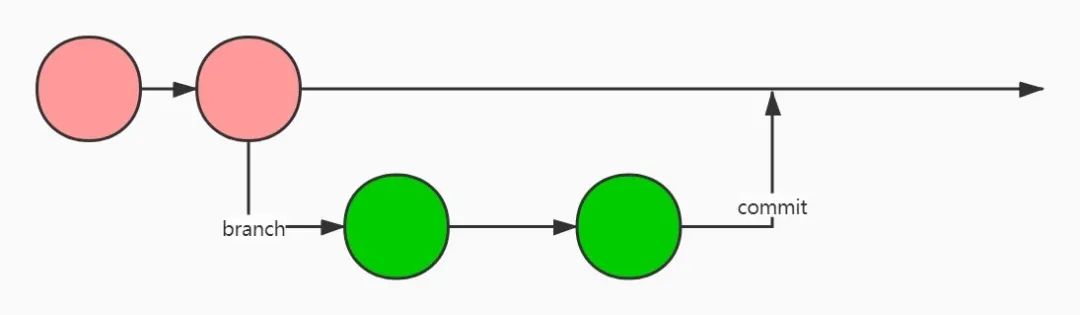
类比 Git 分支功能,从旧树中 fork 出来一份,在新分支进行添加、删除和更新操作,经过测试后进行提交。

以上就是W3Cschool编程狮关于你也可以理解的React Fiber,学废了吗的相关介绍了,希望对大家有所帮助。

11个JavaScript代码重构最佳实践

thbcm阅读(433)

文章来源于公众号:Vue中文社区

模式和重构之间有着一种与生俱来的关系。从某种角度来看,设计模式的目的就是为许多重构行为提供目标。

1.提炼函数

在 JavaScript 开发中,我们大部分时间都在与函数打交道,所以我们希望这些函数有着良好的命名,函数体内包含的逻辑清晰明了。如果一个函数过长,不得不加上若干注释才能让这个函数显得易读一些,那这些函数就很有必要进行重构。

如果在函数中有一段代码可以被独立出来,那我们最好把这些代码放进另外一个独立的函数中。这是一种很常见的优化工作,这样做的好处主要有以下几点。

  • 避免出现超大函数。
  • 独立出来的函数有助于代码复用。
  • 独立出来的函数更容易被覆写。
  • 独立出来的函数如果拥有一个良好的命名,它本身就起到了注释的作用。

比如在一个负责取得用户信息的函数里面,我们还需要打印跟用户信息有关的 log ,那么打印 log 的语句就可以被封装在一个独立的函数里:

var getUserInfo = function(){
    ajax( 'http:// xxx.com/userInfo', function( data ){
        console.log( 'userId: ' + data.userId );
        console.log( 'userName: ' + data.userName );
        console.log( 'nickName: ' + data.nickName );
    });
};


改成:


var getUserInfo = function(){
    ajax( 'http:// xxx.com/userInfo', function( data ){
        printDetails( data );
    });
};


var printDetails = function( data ){
    console.log( 'userId: ' + data.userId );
    console.log( 'userName: ' + data.userName );
    console.log( 'nickName: ' + data.nickName );
};

2.合并重复的条件片段

如果一个函数体内有一些条件分支语句,而这些条件分支语句内部散布了一些重复的代码,那么就有必要进行合并去重工作。假如我们有一个分页函数 paging,该函数接收一个参数 currPage,currPage 表示即将跳转的页码。在跳转之前,为防止 currPage 传入过小或者过大的数字,我们要手动对它的值进行修正,详见如下伪代码:

var paging = function( currPage ){
    if ( currPage = totalPage ){
        currPage = totalPage;
        jump( currPage );    // 跳转
    }else{
        jump( currPage );    // 跳转
    }
};

可以看到,负责跳转的代码jump( currPage )在每个条件分支内都出现了,所以完全可以把这句代码独立出来:

var paging = function( currPage ){
    if ( currPage = totalPage ){
        currPage = totalPage;
    }
    jump( currPage );    // 把jump函数独立出来
};

3.把条件分支语句提炼成函数

在程序设计中,复杂的条件分支语句是导致程序难以阅读和理解的重要原因,而且容易导致一个庞大的函数。假设现在有一个需求是编写一个计算商品价格的getPrice函数,商品的计算只有一个规则:如果当前正处于夏季,那么全部商品将以8折出售。代码如下:

var getPrice = function( price ){
    var date = new Date();
    if ( date.getMonth() >= 6 && date.getMonth() = 6 && date.getMonth() = 6 && date.getMonth() 30 ){
                flag = true;
                break;
            }
        }
        if ( flag === true ){
            break;
        }
    }
};

第二种做法是设置循环标记:

var func = function(){
    outerloop:
    for ( var i = 0; i < 10; i++ ){
        innerloop:
        for ( var j = 0; j < 10; j++ ){
            if ( i * j >30 ){
                break outerloop;
            }
        }
    }
};

这两种做法无疑都让人头晕目眩,更简单的做法是在需要中止循环的时候直接退出整个方法:

var func = function(){
    for ( var i = 0; i < 10; i++ ){
        for ( var j = 0; j < 10; j++ ){
            if ( i * j >30 ){
                return;
            }
        }
    }
};

当然用return直接退出方法会带来一个问题,如果在循环之后还有一些将被执行的代码呢?如果我们提前退出了整个方法,这些代码就得不到被执行的机会:

var func = function(){
    for ( var i = 0; i < 10; i++ ){
        for ( var j = 0; j < 10; j++ ){
            if ( i * j >30 ){
                return;
            }
        }
    }
    console.log( i );    // 这句代码没有机会被执行
};

为了解决这个问题,我们可以把循环后面的代码放到return后面,如果代码比较多,就应该把它们提炼成一个单独的函数:

var print = function( i ){
    console.log( i );
};


var func = function(){
    for ( var i = 0; i < 10; i++ ){
        for ( var j = 0; j < 10; j++ ){
            if ( i * j >30 ){
                return print( i );
            }
        }
    }
};


func();

以上就是W3Cschool编程狮关于11个JavaScript代码重构最佳实践的相关介绍了,希望对大家有所帮助。

使用 Spring 实现策略模式原来可以这么简单!

thbcm阅读(455)

文章来源于Python极客技术 作者:鸭血粉丝

最近看同事的代码时候,学到了个小技巧,在某些场景下非常挺有用的,这里分享一下给大家。

Spring 中 @Autowired注解,大家应该不会陌生,用过 Spring 的肯定也离不开这个注解,通过这个注解可以帮我们自动注入我们想要的 Bean。

除了这个基本功能之外,@Autowired 还有更加强大的功能,还可以注入指定类型的数组,List/Set 集合,甚至还可以是 Map 对象。

比如说当前应用有一个支付接口 PayService,分别需要对接支付宝、微信支付、银行卡,所以分别有三个不同实现类 AliPayService,WechatPayservice,BankCardPayService。

四个类的关系如下图所示:

如果此时我需要获取当前系统类所有 PayService Bean,老的方式我们只能通过 BeanFactory或者 ApplicationContext 获取。

// 首先通过 getBeanNamesForType 获取 PayService 类型所有的 Bean
String[] names = ctx.getBeanNamesForType(PayService.class);
List anotherPayService = Lists.newArrayList();
for (String beanName : names) {
    anotherPayService.add(ctx.getBean(beanName, PayService.class));
}
// 或者通过 getBeansOfType 获取所有 PayService 类型
Map beansOfType = ctx.getBeansOfType(PayService.class);
for (Map.Entry entry : beansOfType.entrySet()) {
    anotherPayService.add(entry.getValue());
}

但是现在我们可以不用这么麻烦了,我们可以直接使用 @Autowired 注入 PayService Bean 数组,或者 PayService List/Set 集合,甚至,我们还可以注入 PayService 的 Map 集合。

@Autowired
List payServices;


@Autowired
PayService[] payServicesArray;

知道了这个功能,当我们需要使用 Spring 实现策略模式就非常简单。

可能有的小伙伴不太了解策略模式,没关系,这类阿粉介绍一个业务场景,通过这个场景给大家介绍一下策略模式。

还是上面的例子,我们当前系统需要对接微信支付、支付宝、以及银行卡支付。

当接到这个需求,我们首先需要拿到相应接口文档,分析三者的共性。

假设我们这里发现,三者模式比较类似,只是部分传参不一样。

所以我们根据三者的共性,抽象出一组公共的接口 PayService,

public interface PayService {
    PayResult epay(PayRequest request);
}

然后分别实现三个实现类,都继承这个接口。

那么现在问题来了,由于存在三个实现类,如何选择具体的实现类?

其实这个问题很好解决,请求参数传入一个唯一标识,然后我们根据标识选择相应的实现类。

比如说我们在请求类 PayRequest 搞个 channelNo 字段,这个代表相应支付渠道唯一标识,比如说支付宝为:00000001,微信支付为 00000002,银行卡支付为 00000003。

接着我们需要把唯一标识与具体实现类一一映射起来,刚好我们可以使用 Map 存储这种映射关系。

我们实现一个 RouteService,具体代码逻辑如下:

@Service
public class RouteService {


    @Autowired
    Map payServiceMap;


    public PayResult epay(PayRequest payRequest) {
        PayService payService = payServiceMap.get(payRequest.getChannelNo());
        return  payService.epay(payRequest);
    }


}

我们在 RouteService 自动注入 PayService 所有相关 Bean,然后使用唯一标识查找实现类。

这样我们对外就屏蔽了支付渠道的差异,其他服务类只要调用 RouteService 即可。

但是这样实现还是有点小问题,由于我们唯一标识为一串数字,如果像我们上面直接使用 @Autowired注入 Map,这就需要我们实现类的 Bean 名字为 00000001 这些。

但是这样命名不是很优雅,这样会让后来同学很难看懂,不好维护。

所以我们需要做个转换,我们可以这么实现。

首先我们改造一下 PayService 这个接口,增加一个方法,每个具体实现类通过这个方法返回其唯一标识。

public interface PayService {


    PayResult epay(PayRequest request);


    String channel();
}

具体举个支付宝实现类的代码,其他实现类实现类似。

@Service("aliPayService")
public class AliPayService implements PayService {


    @Override
    public PayResult epay(PayRequest request) {
        // 业务逻辑
        return new PayResult();
    }
    @Override
    public String channel() {
        return "00000001";
    }
}

最后我们改造一下 RouteService,具体逻辑如下:

@Service
public class RouteService {


    @Autowired
    Set payServiceSet;

    
    Map payServiceMap;


    public PayResult epay(PayRequest payRequest) {
        PayService payService = payServiceMap.get(payRequest.getChannelNo());
        return  payService.epay(payRequest);
    }


    @PostConstruct
    public void init() {
        for (PayService payService : payServiceSet) {
            payServiceMap = new HashMap();
            payServiceMap.put(payService.channel(), payService);
        }
    }
}

上面代码首先通过自动注入 PayService 一个集合,然后我们再将其转为一个 Map,这样内部存储刚好是唯一标识与实现类的映射了。

以上就是W3Cschool编程狮关于使用 Spring 实现策略模式原来可以这么简单!的相关介绍了,希望对大家有所帮助。

Web 性能优化的10 个快速有效手段

thbcm阅读(444)

文章来源于公众号:充实的脑洞 ,作者:疯狂的技术宅

优化网站的性能需要花费大量的时间,并且如果要根据自己的需求进行优化则花费的时间可能更多。

在本文中,我将向你展示 10 个快速优化 Web 性能的手段,能在 5 分钟内用于你自己的网站。这些捷径对你的代码库或服务器配置几乎没有什么影响。它们简单且容易实现,无需详细了解它们的原理,并且能够对你的性能产生重大影响。

1. 使用文本压缩

使用文本压缩,可以最大程度地减少通过网络传输的字节数。有几种压缩算法。gzip[1] 是最受欢迎的,但Brotli[2] 是一种更新甚至更好的压缩算法。如果要检查服务器是否支持Brotli,则可以使用 Brotli.pro[3] 工具。

如果你的服务器不支持 Brotli ,则可以按照以下简单指南进行安装:

  • Nginx on Linux[4]
  • Apache[5]
  • NodeJs – Express[6]

这是你能够免费得到的第一个优化手段,大多数托管平台或 CDN 默认都会提供压缩。

2. 图像压缩

未压缩的图像是潜在的巨大性能瓶颈。如果不对图像进行压缩,将会消耗很大的带宽。有几种有用的工具可用于快速压缩图像,而不会损失可见质量。我通常使用 Imagemin[7]。它支持多种图像格式,你可以在命令行界面下使用[8]或使用 npm 模块[9]。

imagemin img/* --out-dir=dist/images

你可以将 npm 模块用到 webpack、gulp 或 grunt 等打包程序中。

const imagemin = require('imagemin');
const imageminMozjpeg = require('imagemin-mozjpeg');


(async() => {
  const files = await imagemin(
      ['img/*.jpg'],
      {
        destination: 'dist/img',
        plugins: [
          imageminMozjpeg({quality: 60}),
        ]
      }
  );
  console.log(files);
})();

一般情况下可将 4MB 大小的文件减小到 100kB。可以在 Github中查看演示代码[10]。

单位 文件大小,无压缩 压缩文件大小 文件大小减少百分比
Bytes 4156855 Bytes 103273 Bytes -97%
MB/kB 4MB 103 kB -97%

3.图片格式

使用现代图像格式可以真正提高性能。WebP 图像比 JPEG 和 PNG 都小,通常小 25%~35%。WebP 得到了浏览器的广泛支持[11]。

我们使用 imagemin npm 包并为其添加 WebP 插件[12]。以下代码可将图像的 WebP 版本输出到 dist 文件夹中。

const imagemin = require('imagemin');
const imageminWebp = require('imagemin-webp');


(async() => {
  const files = await imagemin(
      ['img/*.jpg'],
      {
        destination: 'dist/img',
        plugins: [
          imageminWebp({quality: 50})
        ]
      }
  );
  console.log(files);
})();

再看一下文件大小:

单位 文件大小,无压缩 压缩文件大小 文件大小减少百分比
Bytes 4156855 Bytes 58940 Bytes -98%
MB/kB 4MB 59 kB -98%

结果表明,与原始图像相比,文件大小减少了 98%,并且与压缩的 JPG 文件相比,WebP 更加明显的压缩了图像。WebP 版本比压缩的 JPEG 版本小 43%。

4. 图像惰性加载

图像惰性加载是一种在以后加载暂时不显示在屏幕上的图像的技术。当解析器遇到图像时立即加载的话会减慢初始页面的加载速度。使用惰性加载,可以加速页面加载过程并稍后加载图像。使用 lazysizes[13] 可以轻松完成此操作。你可以把下面这样的代码:

<img src="image.jpg" alt="">

改为:

<img data-src="image.jpg" class="lazyload" alt="">

lazysizes 库会处理其余的工作,可以使用浏览器进行验证。打开你的站点并找到图像标签。如果该 class 从 lazyload 变成了 lazyloaded,则意味着它可以正常工作。

5. 缓存你的资源:HTTP 缓存头

缓存是一种可以快速提高网站速度的方法。它减少了老用户的页面加载时间。如果你有权限访问服务器缓存,则用起来非常简单。

你可以使用以下API进行缓存:

  • Cache-Control[14]
  • ETag[15]
  • Last-Modified[16]

6. 内联关键 CSS:推迟非关键 CSS

CSS 是渲染阻止的。这意味着浏览器必须先下载并处理所有 CSS 文件,然后才能绘制像素。通过内联关键的 CSS,可以大大加快此过程。

你可以按照以下步骤进行操作:

识别关键的 CSS

如果你不知道你的关键 CSS 是什么,则可以通过 Critcal[17]、CriticalCSS[18] 或 Penthouse[19] 来帮忙。这些库都用来从给定视口中可见的 HTML 文件中提取 CSS。

下面是使用 criticalCSS 的例子。

var criticalcss = require("criticalcss");


var request = require('request');
var path = require( 'path' );
var criticalcss = require("criticalcss");
var fs = require('fs');
var tmpDir = require('os').tmpdir();


var cssUrl = 'https://web.dev/app.css';
var cssPath = path.join( tmpDir, 'app.css' );
request(cssUrl).pipe(fs.createWriteStream(cssPath)).on('close', function() {
  criticalcss.getRules(cssPath, function(err, output) {
    if (err) {
      throw new Error(err);
    } else {
      criticalcss.findCritical("https://web.dev/", { rules: JSON.parse(output) }, function(err, output) {
        if (err) {
          throw new Error(err);
        } else {
          console.log(output);
          // 将其保存到文件以进行第 2 步
        }
      });
    }
  });
});

内联关键CSS

当 HTML 解析器遇到 style 标签时会立即处理关键的 CSS。


  body {...}
  /* ... 其余的关键CSS */


延迟不重要的CSS

非关键的 CSS 不需要立即进行处理。浏览器可以在 onload 事件之后再加载它,使用户不必等待。


7. JavaScript 异步及延迟加载

JavaScript 是 HTML 解析器阻止的。浏览器必须等待 JavaScript 执行才能完成对 HTML 的解析。但是你可以告诉浏览器等待 JavaScript 执行。

异步加载 JavaScript

通过 async 属性,你可以告诉浏览器异步加载脚本。


Defer JavaScript

defer 属性告诉浏览器在 HTML 解析器完成文档解析之后再运行脚本,但在事件发生之前,将会触发DOMContentLoaded。


调整内联脚本的位置

内联脚本会立即执行,浏览器对其进行解析。因此,你可以将它们放在 HTML 的末尾,紧接在 body 标记之前。

8. 使用资源提示加快交付速度。

资源提示[20]能够诉浏览器以后可能加载什么页面。该规范定义了四个原语:

  • preconnect(预连接)
  • dns-prefetch(DNS预取)
  • prefetch(预取)
  • prerender(预渲染)

另外,关于资源提示,我们将 preload[21] 关键字用于 link 属性。

preconnect

下面的代码告诉浏览器你要建立与另一个域的连接。浏览器将为此连接做准备。使用预连接链接标签可以将加载时间缩短 100–500 ms。那么什么时候应该用它呢?直白的说:当你知道在哪里拿东西但不知道该怎么拿。比如哈希样式文件(styles.2f2k1kd.css)这类的东西。


dns-prefetch

如果你想告诉浏览器将要建立与非关键域的连接,则可以用 dns-prefetch 进行预连接。这大约能够为你节省 20–120 毫秒。


prefetch

使用预取,你可以告诉浏览器下载链接标记中所指的整个网站。你可以预取页面或资源。预取在加快网站速度方面非常有用,但是要注意有可能降低网站速度的情况。

低端设备或网速较慢的情况下可能会遇到问题,因为浏览器会一直忙于预取。你可以考虑将预取与自适应加载结合使用,也可以将智能预取与 quicklink[22] 和 Guess.js[23] 结合使用:


prerender


使用预渲染时,将会先加载内容,然后在后台渲染。当用户导航到预渲染的内容时,内容会立即显示。

preload

借助预加载功能,浏览器会得到引用的资源很重要的提示,应尽快获取。现代浏览器很擅长于对资源进行优先级排序,所以应该只对关键资源使用预加载。可考虑用预连接和预取代替,或者尝试使用instant.page[24]。


9. 使用 Google Fonts

Google Fonts 很不错。他们提供了优质的服务,并且应用广泛。如果你不想自己托管字体,那么 Google 字体是一个很不错的选择。但是你应该注意如何实现它们。Harry Roberts[25] 写了一篇非常出色的文章,内容涉及怎样用 Google Fonts 来为网站加速[26]。强烈建议阅读。

如果你只想知道怎样用,可以通过下面的代码段进行 Google 字体集成,但功劳归功于 Harry。


10. 用 service worker 来缓存你的资源

service worker 是浏览器在后台运行的脚本。缓存是最常用的功能之一,也是你最应该使用的功能。我认为这不是选择问题。通过 service worker 实施缓存,可以使用户与你的站点之间的交互速度更快,而且即使用户断网也可以访问你的网站。

总结

在本文中,我向你介绍 10 个快速优化 Web 性能的手段,能在 5 分钟内用于你自己的网站。你可以在GitHub 中找到相关资源[27]。

以上就是W3Cschool编程狮关于 Web 性能优化的10 个快速有效手段的相关介绍了,希望对大家有所帮助。

参考资料

[1]gzip: https://www.youtube.com/watch?v=whGwm0Lky2s&feature=youtu.be&t=14m11s

[2]Brotli: https://opensource.googleblog.com/2015/09/introducing-brotli-new-compression.html

[3]Brotli.pro: https://www.brotli.pro/

[4]Nginx on Linux: https://computingforgeeks.com/how-to-enable-gzip-brotli-compression-for-nginx-on-linux/

[5]Apache: https://bash-prompt.net/guides/apache-brotoli/

[6]NodeJs – Express: https://web.dev/codelab-text-compression-brotli/

[7]Imagemin: https://github.com/imagemin/imagemin

[8]在命令行界面下使用: https://github.com/imagemin/imagemin-cli

[9]npm 模块: https://www.npmjs.com/package/imagemin

[10]Github中查看演示代码: https://github.com/marcradziwill/web-performance-quick-wins-tutorial

[11]WebP 得到了浏览器的广泛支持: https://caniuse.com/#feat=webp

[12]WebP 插件: https://www.npmjs.com/package/imagemin-webp

[13]lazysizes: https://github.com/aFarkas/lazysizes

[14]Cache-Control: https://developer.mozilla.org/de/docs/Web/HTTP/Headers/Cache-Control#Browser_compatibility

[15]ETag: https://developer.mozilla.org/docs/Web/HTTP/Headers/ETag#Browser_compatibility

[16]Last-Modified: https://developer.mozilla.org/docs/Web/HTTP/Headers/Last-Modified#Browser_compatibility

[17]Critcal: https://github.com/addyosmani/critical

[18]CriticalCSS: https://github.com/filamentgroup/criticalCSS

[19]Penthouse: https://github.com/pocketjoso/penthouse

[20]资源提示: https://www.w3.org/TR/resource-hints/

[21]preload: https://www.w3.org/TR/preload/

[22]quicklink: https://github.com/GoogleChromeLabs/quicklink

[23]Guess.js: https://github.com/guess-js

[24]instant.page: https://instant.page/

[25]Harry Roberts: https://csswizardry.com/

[26]怎样用 Google Fonts 来为网站加速: https://csswizardry.com/2020/05/the-fastest-google-fonts/

[27]GitHub 中找到相关资源: https://github.com/marcradziwill/web-performance-quick-wins-tutorial

怎么使用js操作符【新语法】优化代码?

thbcm阅读(454)

文章来源于公众号:前端人 作者:鬼哥

最近在我在技术群聊天时,看到有个小伙伴提出关于可选链语法的问题。那这篇文章我们就来聊一下几个js的骚操作(`我认为是代码优化技巧)

在很多场景下,使用可选链语法来编码,是非常有优势的,尤其是数据层级较深,或者数据层级属性不明确的时候,使用可选链语法大大简化了代码,和提升代码效率!

可选链操作符( ?. )

const UserObj = {
  getAge:()=>{}
};
// ***********************
//1.使用普通的判断语法
var name = UserObj.info?UserObj.info.name:"";
console.log(name);


//2.使用可选链 语法
var name = UserObj.info?.name;
console.log(name);
// 输出undefined   而不会报错


// ***********************
//1.使用普通的判断语法(暂不做函数类型判断)
var name;
if(UserObj.getName){
 name=UserObj.getName();
}
console.log(name);
// 输出undefined


//2.使用可选链 语法
var name =UserObj.getName?.();
console.log(name);
// 不存在,默认输出undefined   而不会报错


// ***********************
// 如果层级较深的话,优势就很明显了
const UserObj = {
  logList:[]
};
//1.使用普通的判断语法
var name;
if(UserObj.logList&&UserObj.logList[0]&&UserObj.logList[0].user&&UserObj.logList[0].user.name){
    name=UserObj.logList&&UserObj.logList[0]&&UserObj.logList[0].user&&UserObj.logList[0].user.name;
}
console.log(name);
// 输出undefined


//2.使用可选链 语法
var name =UserObj.logList?.[0]?.user?.name;
// 输出undefined 


//这个优势就很明显了,所以为什么人家的代码写的好,这就是原因

?. 操作符的功能类似于 . 链式操作符,不同之处在于,单引用属性为 (null 或者 undefined) 的情况下不会引起错误,。与函数调用一起使用时,如果给定的函数不存在,则返回 undefined

可选链操作符( ?. ),允许获取当前对象的属性的值,而不必明确当前对象的属性是否有效(存在)

管道运算符(实验中的功能)

管道操作符 |>允许以一种易读的方式去对函数链式调用。本质上来说,管道操作符是单参数函数调用的语法糖,它允许你像这样执行一个调用:

let url = "%21" |> decodeURI;

使用传统语法写的话,等效的代码是这样的:

let url = decodeURI("%21");

从这个小例子确实看不出啥优势,但是你看下这个呢?

const getWeChat = (name) => `${name},请关注公众号【前端人】`;
const getInfo = (name) => `${name},我今年18岁`;
const getName = (title) => title+"鬼哥";


// 普通js语法
getWeChat(getInfo(getName("我的名字叫:")))


// 管道操作符语法
"我的名字叫:" |> getName |> getInfo|> getWeChat; 


// 输出 我的名字叫:鬼哥,我今年18岁

写到这,我思考了很久,还是同意说出,使用管道操作符语法,语意上确实更加直观

~~运算符

【~~】运算符,简单一点的用法就是可以将一些变量转化为Number(数字)类型的。

// 将数字类型的字符串转化为纯数字。


// 普通js代码
var numStr = '123';
console.log(parseInt("123")); 
// 输出数字类型的123


// `~~`运算符
var numStr = '123';
console.log(~~numStr); 
// 输出数字类型的123


// ***********************
// 但是如果数据本身错误呢?
var numStr = '我不是数字123';
console.log(parseInt("123"));
// 输出NaN


var numStr = '我不是数字123';
console.log(~~numStr); 
// 输出数字类型的0


// 这种情况他的优势就出来了,使用`~~`即使是数据错误,但是他返回的数据类型不会影响后续数据格式的处理

好了,今天的几个代码优化,前端进阶小技巧就到这里了,下次继续!

以上就是W3Cschool编程狮关于怎么使用js操作符【新语法】优化代码?的相关介绍了,希望对大家有所帮助。

Python同步与异步有何不同?

thbcm阅读(453)

文章来源于公众号:架构头条 作者:Miguel

你是否有别人说过,异步 Python 代码比“普通(或同步)Python 代码更快?那么事实真的是这样吗?

“同步”和“异步”是什么意思?

Web 应用程序通常要处理许多请求,这些请求在短时间内来自不同的客户端。为避免处理延迟,必须考虑并行处理多个请求,这通常称为“并发”。

在本文中,我将继续使用 Web 应用程序作为例子,但还有其它类型的应用程序也从并发中获益。因此,这个讨论并不仅仅是针对 Web 应用程序的。

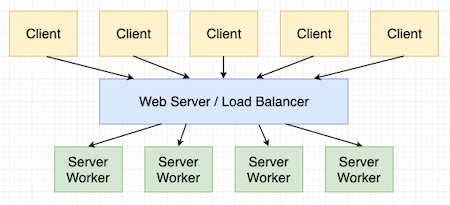
术语“同步”和“异步”指的是编写并发应用程序的两种方式。所谓的“同步”服务器使用底层操作系统支持的线程和进程来实现这种并发性。下面是同步部署的一个示意图:

在这种情况下,我们有 5 台客户端,都向应用程序发送请求。这个应用程序的访问入口是一个 Web 服务器,通过将服务分配给一个服务器 worker 池来充当负载均衡器,这些 worker 可以实现为进程、线程或者两者的结合。这些 worker 执行负载均衡器分配给他们的请求。你使用 Web 应用程序框架(例如 Flask 或 Django)编写的应用程序逻辑运行在这些 worker 中。

这种类型的方案对于有多个 CPU 的服务器比较好,因为你可以将 worker 的数量设置为 CPU 的数量,这样你就能均衡地利用你的处理器核心,而单个 Python 进程由于全局解释器锁(GIL)的限制无法实现这一点。

在缺点上,上面的示意图也清楚展示了这种方案的主要局限。我们有 5 个客户端,却只有 4 个 worker。如果这 5 个客户端在同一时间都发送请求,那么负载均衡器会将某一个客户端之外的所有请求发送到 worker 池,而剩下的请求不得不保留在一个队列中,等待有 worker 变得可用。因此,五分之四的请求会立即响应,而剩下的五分之一需要等一会儿。服务器优化的一个关键就在于选择适当数量的 worker 来防止或最小化给定预期负载的请求阻塞。

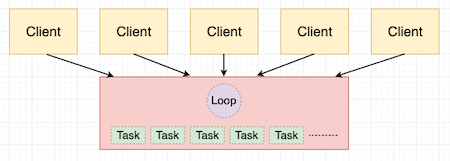
一个异步服务器的配置很难画,但是我尽力而为:

这种类型的服务器运行在单个进程中,通过循环控制。这个循环是一个非常有效率的任务管理器和调度器,创建任务来执行由客户端发送的请求。与长期存在的服务器 worker 不同,异步任务是由循环创建,用来处理某个特定的请求,当那个请求完成时,该任务也会被销毁。任何时候,一台异步服务器都会有上百或上千个活跃的任务,它们都在循环的管理下执行自己的工作。

你可能想知道异步任务之间的并行是如何实现的。这就是有趣的部分,因为一个异步应用程序通过唯一的协同多任务处理来实现这点。这意味着什么?当一个任务需要等待一个外部事件(例如,一个数据库服务器的响应)时,不会像一个同步的 worker 那样等待,而是会告诉循环,它需要等待什么,然后将控制权返回给它。循环就能够在这个任务被数据库阻塞的时候发现另外一个准备就绪的任务。最终,数据库将发送一个响应,而那时循环会认为第一个的任务已经准备好再次运行,并将尽快恢复它。

异步任务暂停和恢复执行的这种能力可能在抽象上很难理解。为了帮你应用到你已经知道的东西,可以考虑在 Python 中使用await或yield关键字这一方法来实现,但你之后会发现,这并不是唯一实现异步任务的方法。

一个异步应用程序完全运行在单个进程或线程中,这可以说是令人吃惊的。当然,这种类型的并发需要遵循一些规则,因此,你不能让一个任务占用 CPU 太长时间,否则,剩余的任务会被阻塞。为了异步执行,所有的任务需要定时主动暂停并将控制权返还给循环。为了从异步方式获益,一个应用程序需要有经常被 I/O 阻塞的任务,并且没有太多 CPU 工作。Web 应用程序通常非常适合,特别是当它们需要处理大量客户端请求时。

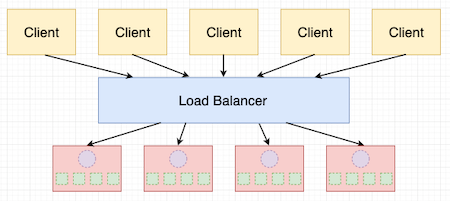
在使用一个异步服务器时,为了最大化多 CPU 的利用率,通常需要创建一个混合方案,增加一个负载均衡器并在每个 CPU 上运行一个异步服务器,如下图所示:

Python 中实现异步的 2 种方法

我敢肯定,你知道要在 Python 中写一个异步应用程序,你可以使用 asyncio package,这个包是在协程的基础上实现了所有异步应用程序都需要的暂停和恢复特性。其中yield关键字,以及更新的async和await都是asyncio构建异步能力的基础。

https://docs.python.org/3/library/asyncio.html

Python 生态系统中还有其它基于协程的异步方案,例如 Trio 和 Curio。还有 Twisted,它是所有协程框架中最古老的,甚至出现得比asyncio都要早。

如果你对编写异步 Web 应用程序感兴趣,有许多基于协程的异步框架可以选择,包括 aiohttp、sanic、FastAPI 和 Tornado。

很多人不知道的是,协程只是 Python 中编写异步代码的两种方法之一。第二种方法是基于一个叫做 greenlet 的库,你可以用 pip 安装它。Greenlets 和协程类似,它们也允许一个 Python 函数暂停执行并稍后恢复,但是它们实现这点的方式完全不同,这意味着 Python 中的异步生态系统分成两大类。

协程与 greenlets 之间针对异步开发最有意思的区别是,前者需要 Python 语言特定的关键字和特性才能工作,而后者并不需要。我的意思是,基于协程的应用程序需要使用一种特定的语法来书写,而基于 greenlet 的应用程序看起来几乎和普通 Python 代码一样。这非常酷,因为在某些情况下,这让同步代码可以被异步执行,这是诸如asyncio之类的基于协程的方案做不到的。

那么在 greenlet 方面,跟asyncio对等的库有哪些?我知道 3 个基于 greenlet 的异步包:Gevent、Eventlet 和 Meinheld,尽管最后一个更像是一个 Web 服务器而不是一个通用的异步库。它们都有自己的异步循环实现,而且它们都提供了一个有趣的“monkey-patching”功能,取代了 Python 标准库中的阻塞函数,例如那些执行网络和线程的函数,并基于 greenlets 实现了等效的非阻塞版本。如果你有一些同步代码想要异步运行,这些包会对你有所帮助。

据我所知,唯一明确支持 greenlet 的 Web 框架只有 Flask。这个框架会自动监测,当你想要运行在一个 greenlet Web 服务器上时,它会自我进行相应调整,而无需进行任何配置。这么做时,你需要注意不要调用阻塞函数,或者,如果你要调用阻塞函数,最好用猴子补丁来“修复”那些阻塞函数。

但是,Flask 并不是唯一受益于 greenlets 的框架。其它 Web 框架,例如 Django 和 Bottle],虽然没有 greenlets,但也可以通过结合一个 greenlet Web 服务器并使用 monkey-patching 修复阻塞函数的方式来异步运行。

异步比同步更快吗?

对于同步和异步应用程序的性能,存在着一个广泛的误解——异步应用程序比同步应用程序快得多。

对此,我需要澄清一下。无论是用同步方式写,还是用异步方式写,Python 代码运行速度是几乎相同的。除了代码,有两个因素能够影响一个并发应用程序的性能:上下文切换和可扩展性。

上下文切换

在所有运行的任务间公平地共享 CPU 所需的工作,称为上下文切换,能够影响应用程序的性能。对同步应用程序来说,这项工作是由操作系统完成的,而且基本上是一个黑箱,不需要配置或微调选项。对异步应用程序来说,上下文切换是由循环完成的。

默认的循环实现由asyncio提供,是用 Python 编写的,效率不是很高。而 uvloop 包提供了一个备选的循环方案,其中部分代码是用 C 编写的来实现更好的性能。Gevent 和 Meinheld 所使用的事件循环也是用 C 编写的。Eventlet 用的是 Python 编写的循环。

高度优化的异步循环比操作系统在进行上下文切换方面更有效率,但根据我的经验,要想看到实际的效率提升,你运行的并发量必须非常大。对于大部分应用程序,我不认为同步和异步上下文切换之间的性能差距有多明显。

扩展性

我认为异步更快这个神话的来源是,异步应用程序通常会更有效地使用 CPU、能更好地进行扩展并且扩展方式比同步更灵活。

如果上面示意图中的同步服务器同时收到 100 个请求,想一下会发生什么。这个服务器同时最多只能处理 4 个请求,因此大部分请求会停留在一个队列中等待,直到它们被分配一个 worker。

与之形成对比的是,异步服务器会立即创建 100 个任务(或者使用混合模式的话,在 4 个异步 worker 上每个创建 25 个任务)。使用异步服务器,所有请求都会立即开始处理而不用等待(尽管公平地说,这种方案也还会有其它瓶颈会减慢速度,例如对活跃的数据库连接的限制)。

如果这 100 个任务主要使用 CPU,那么同步和异步方案会有相似的性能,因为每个 CPU 运行的速度是固定的,Python 执行代码的速度总是相同的,应用程序要完成的工作也是相同的。但是,如果这些任务需要做很多 I/O 操作,那么同步服务器只能处理 4 个并发请求而不能实现 CPU 的高利用率。而另一方面,异步服务器会更好地保持 CPU 繁忙,因为它是并行地运行所有这 100 个请求。

你可能会想,为什么你不能运行 100 个同步 worker,那样,这两个服务器就会有相同的并发能力。要注意,每个 worker 需要自己的 Python 解释器以及与之相关联的所有资源,再加上一份单独的应用程序拷贝及其资源。你的服务器和应用程序的大小将决定你可以运行多少个 worker 实例,但通常这个数字不会很大。另一方面,异步任务非常轻量,都运行在单个 worker 进程的上下文中,因此具有明显优势。

综上所述,只有如下场景时,我们可以说异步可能比同步快:

  • 存在高负载(没有高负载,访问的高并发性就没有优势)
  • 任务是 I/O 绑定的(如果任务是 CPU 绑定的,那么超过 CPU 数目的并发并没有帮助)
  • 你查看单位时间内的平均请求处理数。如果你查看单个请求的处理时间,你不会看到有很大差别,甚至异步可能更慢,因为异步有更多并发的任务在争夺 CPU。

结论

希望本文能解答异步代码的一些困惑和误解。我希望你能记住以下两个关键点:

  • 异步应用程序只有在高负载下才会比同步应用程序做得更好
  • 多亏了 greenlets,即使你用一般方式写代码并使用 Flask 或 Django 之类的传统框架,也能从异步中受益。

以上就是W3Cschool编程狮关于Python同步与异步有何不同?的相关介绍了,希望对大家有所帮助。

一文带你上手Vue3中新增的API

thbcm阅读(391)

不久前,Vue 3.0 版本正式发布了,这篇文章就带大家了解一下 Vue 3 新增的API。

1. 初始化项目

// ① npm i -g @vue/cli
// ② vue create my-project
// ③ npm install @vue/composition-api -S


// ④ main,js
import Vue from 'vue'
import VueCompositionApi from '@vue/composition-api'
Vue.use(VueCompositionApi)

2. setup方法

setup 是 vue3.x 中新的操作组件属性的方法,它是组件内部暴露出所有的属性和方法的统一API。

2.1 执行时机

setup的执行时机在:beforeCreate 之后 created之前

setup(props, ctx) {
    console.log('setup')
  },
  beforeCreate() {
    console.log('beforeCreate')
  },
  created() {
    console.log('created')
  },

2.2 接受props数据


// 通过 setup 函数的第一个形参,接收 props 数据:
setup(props) {
  console.log(props)
},
// 在 props 中定义当前组件允许外界传递过来的参数名称:
props: {
    p1: String
}
/*
{}
p1: "传值给 com-setup"
get p1: ƒ reactiveGetter()
set p1: ƒ reactiveSetter(newVal)
__proto__: Object
*/

2.3 context

setup 函数的第二个形参是一个上下文对象,这个上下文对象中包含了一些有用的属性,这些属性在 vue 2.x 中需要通过 this 才能访问到,在 vue 3.x 中,它们的访问方式如下:

setup(props, ctx) {
    console.log(ctx)
    console.log(this) // undefined
  },
/*
attrs: Object
emit: ƒ ()
listeners: Object
parent: VueComponent
refs: Object
root: Vue
...
*/

注意:在 setup() 函数中无法访问到 this

3. reactive

reactive 函数接收一个普通函数,返回一个响应式的数据对象。

reactive 函数等价于 vue 2.x 中的 Vue.observable() 函数,vue 3.x 中提供了 reactive() 函数,用来创建响应式的数据对象,基本代码示例如下:


  <div>

    
    <p>当前的 count 值为:{{count}}</p>
    <button @click="count += 1">+1</button>
  </div>


import {reactive} from '@vue/composition-api'
export default {
  setup(props, ctx) {
    // 创建响应式数据对象,得到的 state 类似于 vue 2.x 中 data() 返回的响应式对象
    const state = reactive({ count: 0 })
    state.count += 1
    console.log(state)
     // setup 函数中将响应式数据对象 return 出去,供 template 使用
    return state
  }
}

4. ref

ref() 函数用来根据给定的值创建一个响应式的数据对象,ref() 函数调用的返回值是一个对象,这个对象上只包含一个 .value 属性:


  <div>
    <h3>02.ref.vue 文件</h3>
    <p>refCount:{{refCount}}</p>
    <button @click="refCount += 1">+1</button>
  </div>


import { ref } from '@vue/composition-api'
export default {
  setup() {
    // / 创建响应式数据对象 count,初始值为 0
    const refCount = ref(0)
    // 如果要访问 ref() 创建出来的响应式数据对象的值,必须通过 .value 属性才可以,只有在setup内部才需要 .value 属性
    console.log(refCount.value) // 输出 0
    // 让 refCount 的值 +1
        refCount.value++
    // 再次打印 refCount 的值
        console.log(refCount.value) // 输出 1
    return {
      refCount
    }
  }
}

4.1 在 reactive 对象中访问 ref 创建的响应式数据

当把 ref() 创建出来的响应式数据对象,挂载到 reactive() 上时,会自动把响应式数据对象展开为原始的值,不需通过 .value 就可以直接被访问,例如:

setup() {
  const refCount = ref(0)
  const state = reactive({refCount})
  console.log(state.refCount) // 输出 0
  state.refCount++ // 此处不需要通过 .value 就能直接访问原始值
  console.log(refCount) // 输出 1
  return {
    refCount
  }
}

注意:新的 ref 会覆盖旧的 ref,示例代码如下:

setup() {
  // 创建 ref 并挂载到 reactive 中
  const c1 = ref(0);
  const state = reactive({ c1 });


  // 再次创建 ref,命名为 c2
  const c2 = ref(9);
  // 将 旧 ref c1 替换为 新 ref c2
  state.c1 = c2;
  state.c1++;


  console.log(state.c1); // 输出 10
  console.log(c2.value); // 输出 10
  console.log(c1.value); // 输出 0
}

5. isRef

isRef() 用来判断某个值是否为 ref() 创建出来的对象;应用场景:当需要展开某个可能为 ref() 创建出来的值的时候,例如:

import { ref, reactive, isRef } from "@vue/composition-api";
export default {
  setup() {
    const unwrapped = isRef(foo) ? foo.value : foo
  }
};

6. toRefs

toRefs() 函数可以将 reactive() 创建出来的响应式对象,转换为普通的对象,只不过,这个对象上的每个属性节点,都是 ref() 类型的响应式数据。


  <div>
    <h3>03.toRefs.vue文件</h3>
    <p>{{ count }} - {{ name }}</p>
    <button @click="count += 1">+1</button>
    <button @click="add">+1</button>
  </div>


import { reactive, toRefs } from "@vue/composition-api";
export default {
  setup() {
    // 响应式数据
    const state = reactive({ count: 0, name: "zs" });
    // 方法
    const add = () => {
      state.count += 1;
    };
    return {
      // 非响应式数据
      // ...state,
      // 响应式数据
      ...toRefs(state),
      add
    };
  }
};

7. computed计算属性

7.1 只读的计算属性


  <div>
    <h3>04.computed.vue文件</h3>
    <p>refCount: {{refCount}}</p>
    <p>计算属性的值computedCount : {{computedCount}}</p>
    <button @click="refCount++">refCount + 1</button>

        
    <button @click="computedCount++">计算属性的值computedCount + 1</button>
  </div>


import { computed, ref } from '@vue/composition-api'
export default {
  setup() {
    const refCount = ref(1)
    // 只读
    let computedCount = computed(() => refCount.value + 1)
    console.log(computedCount)
    return {
      refCount,
      computedCount
    }
  }
};

7.2 可读可写的计算属性


  <div>
    <h3>04.computed.vue文件</h3>
    <p>refCount: {{refCount}}</p>
    <p>计算属性的值computedCount : {{computedCount}}</p>
    <button @click="refCount++">refCount + 1</button>
  </div>


import { computed, ref } from '@vue/composition-api'
export default {
  setup() {
    const refCount = ref(1)
    // 可读可写
    let computedCount = computed({
      // 取值函数
      get: () => refCount.value + 1,
      // 赋值函数
      set: val => {
        refCount.value = refCount.value -5
      }
    })
    console.log(computedCount.value)
    // 为计算属性赋值的操作,会触发 set 函数
    computedCount.value = 10
    console.log(computedCount.value)
    // 触发 set 函数后,count 的值会被更新
    console.log(refCount.value)
    return {
      refCount,
      computedCount
    }
  }
};

8. watch

watch() 函数用来监视某些数据项的变化,从而触发某些特定的操作,使用之前需要按需导入:

import { watch } from '@vue/composition-api'

8.1 基本用法


  <div>
    <h3>05.watch.vue文件</h3>
    <p>refCount: {{refCount}}</p>
  </div>


import { watch, ref } from '@vue/composition-api'
export default {
  setup() {
    const refCount = ref(100)
    // 定义 watch,只要 count 值变化,就会触发 watch 回调
    // 组件在第一次创建的时候执行一次 watch
    watch(() => console.log(refCount.value), { lazy: false})
    setInterval(() => {
      refCount.value += 2
    }, 5000)
    return {
      refCount
    }
  }
};

8.2 监视数据源

监视 reactive 类型的数据源:


  <div>
    <h3>05.watch.vue文件</h3>
    <p>count: {{count}}</p> // 不是响应式数据
  </div>


import { watch, ref, reactive } from '@vue/composition-api'
export default {
  setup() {
    const state = reactive({count: 100})
    watch(
      // 监听count
      () => state.count,
      // 如果变换 执行以下函数
      (newVal, oldVala) => {
        console.log(newVal, oldVala)
      },
      { lazy: true }
    )
    setInterval(() => {
      state.count += 2
    }, 5000)
    return state
  }
};

监视 ref 类型的数据源:

export default {
  setup() {
    // 定义数据源
    let count = ref(0);
    // 指定要监视的数据源
    watch(count, (count, prevCount) => {
      console.log(count, prevCount)
    })
    setInterval(() => {
      count.value += 2
    }, 2000)
    console.log(count.value)
    return {
      count
    }
  }
};

8.3 监听多个数据源

监视 reactive 类型的数据源:

export default {
  setup() {
    const state = reactive({count: 100, name: 'houfei'})
    watch(
      // 监听count name
      [() => state.count, () => state.name],
      // 如果变换 执行以下函数
      ([newCount, newName], [oldCount, oldName]) => {
        console.log(newCount, oldCount)
        console.log(newName, oldName)
      },
      { lazy: true} // 在 watch 被创建的时候,不执行回调函数中的代码
    )
    setTimeout(() => {
      state.count += 2
      state.name = 'qweqweewq'
    }, 3000)
    return state
  }
};

监视 ref 类型的数据源:

export default {
  setup() {
    // 定义数据源
    const count = ref(10)
    const name = ref('zs')
    // 指定要监视的数据源
    watch(
      [count, name],
      ([newCount, newName], [oldCount, oldName]) => {
        console.log(newCount, oldCount)
        console.log(newName, oldName)
      },
      { lazy: true}
    )
    setInterval(() => {
      count.value += 2
    }, 2000)
    console.log(count.value)
    return {
      count
    }
  }
};

8.4 清除监视

在 setup() 函数内创建的 watch 监视,会在当前组件被销毁的时候自动停止。如果想要明确地停止某个监视,可以调用 watch() 函数的返回值即可,语法如下:


// 创建监视,并得到 停止函数
const stop = watch(() => {
  /* ... */
})


// 调用停止函数,清除对应的监视
stop()


  <div>

    
    <p>count: {{ count }}</p>
    <button @click="stopWatch">停止监听</button>
  </div>


import { watch, ref, reactive } from "@vue/composition-api";
export default {
  setup() {
    // 定义数据源
    const count = ref(10)
    const name = ref('zs')
    // 指定要监视的数据源
    const stop = watch(
      [count, name],
      ([newCount, newName], [oldCount, oldName]) => {
        console.log(newCount, oldCount)
        console.log(newName, oldName)
      },
      { lazy: true}
    )
    setInterval(() => {
      count.value += 2
      name.value = 'houyue'
    }, 2000)
    // 停止监视
    const stopWatch = () => {
      console.log("停止监视,但是数据还在变化")
      stop()
    }
    console.log(count.value)
    return {
      stop,
      count,
      stopWatch
    }
  }
};


8.5 在watch中清除无效的异步任务

有时候,当被 watch 监视的值发生变化时,或 watch 本身被 stop 之后,我们期望能够清除那些无效的异步任务,此时,watch 回调函数中提供了一个 cleanup registrator function 来执行清除的工作。这个清除函数会在如下情况下被调用:

watch 被重复执行了

watch 被强制 stop 了

Template 中的代码示例如下:


  <div>

    
    <input type="text" v-model="keywords" />
    <p>keywords:--- {{ keywords }}</p>
  </div>

Script 中的代码示例如下:


import { watch, ref, reactive } from "@vue/composition-api";


export default {
  setup() {
    // 定义响应式数据 keywords
    const keywords = ref("");


    // 异步任务:打印用户输入的关键词
    const asyncPrint = val => {
      // 延时 1 秒后打印
      return setTimeout(() => {
        console.log(val);
      }, 1000);
    };


    // 定义 watch 监听
    watch(
      keywords,
      (keywords, prevKeywords, onCleanup) => {
        // 执行异步任务,并得到关闭异步任务的 timerId
        const timerId = asyncPrint(keywords);
        // 如果 watch 监听被重复执行了,则会先清除上次未完成的异步任务
        onCleanup(() => clearTimeout(timerId));
      },
      // watch 刚被创建的时候不执行
      { lazy: true }
    );


    // 把 template 中需要的数据 return 出去
    return {
      keywords
    };
  }
};

9. provide & inject 组件传值

provide() 和 inject() 可以实现嵌套组件之间的数据传递。这两个函数只能在 setup() 函数中使用。父级组件中使用 provide() 函数向下传递数据;子级组件中使用 inject() 获取上层传递过来的数据。

9.1 共享普通数据

app.vue 根组件:


  <div id="app">
    <h1>父组件</h1>
    <button @click="color = 'blue'">蓝色</button>
    <button @click="color = 'red'">红色</button>
    <button @click="color = 'yellow'">黄色</button>


  </div>


import { ref, provide } from '@vue/composition-api'
import Son from './components/06.son.vue'


export default {
  name: 'app',
  components: {
    'son': Son
  },
  setup() {
    const color = ref('green')
    provide('themecolor', color)
    return {
     color
    }
  }
}

06.son.vue son 组件:


  <div>
    <h3 :style="{color: color}">son 组件</h3>

    
  </div>


import { inject } from '@vue/composition-api'
import Grandson from './07.grandson.vue'
export default {
    components: {
    'grandson': Grandson
  },
  setup() {
    const color = inject('themecolor')
    return {
     color
    }
  }
}

07.grandson.vue son 组件:


  <div>
    <h5 :style="{color: color}">grandson 组件</h5>
  </div>


import { inject } from '@vue/composition-api'
export default {
  setup() {
    const color = inject('themecolor')
    return {
      color
    }
  }
}

9.2 共享ref响应式数据

app.vue 根组件:


  <div id="app">
    <h1>父组件</h1>

    
  </div>


import { provide } from '@vue/composition-api'
import Son from './components/06.son.vue'


export default {
  name: 'app',
  components: {
    'son': Son
  },
  setup() {
    provide('themecolor', 'red')
  }
}

06.son.vue son 组件:


  <div>
    <h3 :style="{color: color}">son 组件</h3>

    
  </div>


import { inject } from '@vue/composition-api'
import Grandson from './07.grandson.vue'
export default {
    components: {
    'grandson': Grandson
  },
  setup() {
    const color = inject('themecolor')
    return {
      color
    }
  }
}

07.grandson.vue son 组件:

template>
  <div>
    <h5 :style="{color: color}">grandson 组件</h5>
  </div>


import { inject } from '@vue/composition-api'
export default {
  setup() {
    const color = inject('themecolor')
    return {
      color
    }
  }
}

10. 节点的引用 template ref

10.1 dom的引用


  <div>
    <h3 ref="h3Ref">TemplateRefOne</h3>
  </div>


import { ref, onMounted } from '@vue/composition-api'


export default {
  setup() {
    // 创建一个 DOM 引用
    const h3Ref = ref(null)


    // 在 DOM 首次加载完毕之后,才能获取到元素的引用
    onMounted(() => {
      // 为 dom 元素设置字体颜色
      // h3Ref.value 是原生DOM对象
      h3Ref.value.style.color = 'red'
    })


    // 把创建的引用 return 出去
    return {
      h3Ref
    }
  }
}

10.2 组件的引用

App父组件:


  <div id="app">
    <h1>父组件</h1>
    <button @click="showComRef">展示子组件的值</button>

    
  </div>


import Son from './components/06.son.vue'


export default {
  name: 'app',
  components: {
    'son': Son
  },
  setup() {
    const comRef = ref(null) 
    const showComRef = () => {
      console.log(comRef)
      console.log('str1的值是' + comRef.value.str1)
      comRef.value.setStr1()
    }
    return {
      comRef,
      showComRef
    }
  }
}

06.son.vue子组件:


  <div>
    <h3 :style="{color: color}">son 组件</h3>
    <p>{{str1}}</p>
  </div>


import { ref } from '@vue/composition-api'
export default {
  setup() {
    const str1 = ref('这是一个子组件!!')
    const setStr1 = () => {
      str1.value = '被赋值了'
    }
    return {
      str1,
      setStr1
    }
  }
}

11 nextTick


  <div>
    <h3>09.nextTick 组件</h3>
    <p>学习 $nextTick</p>
    <button v-if="isShowInput === false" @click="showInput">展示文本框</button>
    <input type="text" v-else ref="ipt">
  </div>


export default {
  data() {
    return {
      isShowInput: false
    }
  },
  methods: {
    showInput() {
      this.isShowInput = !this.isShowInput
      // console.log(this.$refs)
      this.$nextTick(() => {
        this.$refs.ipt.focus()
      })
    }
  }
}

以上就是W3Cschool编程狮关于一文带你上手Vue3中新增的API的相关介绍了,希望对大家有所帮助。
TypeScript中的六个重新让你认知的知识点

thbcm阅读(434)

文章来源于公众号:前端人 作者:鬼哥

之所以会写这篇文章,是因为在技术群里有小伙伴在讨论的时候,提出需要来提升对 TypeScript 理解,本文将讲述几个 TypeScript 常见并且不易理解的几个知识点,简单的使用就自行官网文档了!

Typescript中的几个重要概念

1.any 和 T(泛型)的区别

/**
any 和 T ,一个是任意类型,一个是泛类型
卧槽,这也太难让人理解他的区别了吧,字面意思几乎一样,
但是我连续读了:泛..泛.泛    任意..任意类型,读了十遍,还是感受到了差异
*/


any:任意类型,代表的是所有类型
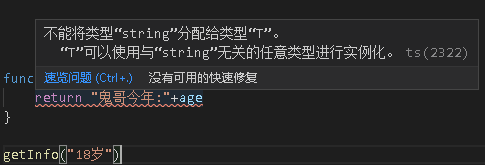
泛型:泛型他就是所有类型中的一种类型,并不是完全的所有类型,所以在函数中返回的类型要和定义的类型一摸一摸,不能修改他原有的类型


// 在这种场景下,有区别体现


//正确
function getInfo(age: any): any {
    return "鬼哥今年:"+age
}
getInfo("18岁")


//错误
function getInfo(age: T): T {
    return "鬼哥今年:"+age
}
getInfo("18岁")
//这里直接报错

2.type interface enum

  • type:用来约束数据类型(数据结构,数据属性且可以是联合类型,元组类型)
  • interface:用来约束数据类型(数据结构,数据属性且不可以是联合类型,元组类型)
  • enum:用来约束数据类型的值,而并非数据类型

使用场景如:

//人
interface People {
}
//动物
interface Animal {
}


// type和interface区别1


// 正确(人既可以是动物,也可以是人)
type User=People | Animal;


// 错误(人既可以是动物,也可以是人),使用interface定义却是不可以的
interface User { People | Animal };


其实从语法上可以看出他们两的区别,`type` 是用`=`符号,既然是等于,那肯定就存在多种情况的,`interface`使用的是`{}`符号,是一种`定义`的形式,既然是`定义`,那肯定就是觉得性质的,只会有一种可能


/**************************************/


// type和interface区别2
既然`interface`是一种数据结构,那肯定是可以实现这种数据结构的,所以`interface`可以实现的功能


// 比如运用interface用来定义接口,然后实现接口的功能:
interface UserModelApi {
    getUserList:()=>Promise,
    getOrderList:()=>Promise,
}


class HtppApi implements UserModelApi{
    getUserList(){
        return new Promise((resolve)=>{
        });
    }
    getOrderList(){
        return new Promise(()=>{
        });
    }
}


// enum和const的区别
/**
他们两者的相同点,都是定义数据,
且定义的数据不可更改.不同点在于
1)其实和上面描述`type`与`interface`一样,
他们都是一个是定义,一个是赋值
2)下面的代码是不是从感觉使用枚举看上去语法的阅读性更强
3)`enum`枚举可以用来定义类型
*/


// 正确(语法理解上一看就知道,是这个对象有哪种情况)
enum Sex { M = "男", F = "女" }
// `enum` Sex枚举可以用来定义类型
const getInfo=function(sex:Sex){
    return `我的性别为:${sex}`;
}


/**************************************/


// 错误(而这种语法看上去就是,这个对象有哪些值)
const Sex ={
    M:"男",
    F:"女"
}
// `const` Sex 不可以用来定义类型
const getInfo=function(sex:Sex){
    return `我的性别为:${sex}`;
}

3.映射类型

将对象或数组中类型转换为另一个类型

// 假设一个系统账号登录的场景:


//定义一个用户信息的接口类型
interface User {
    age: number
    name: string
    password:string
}
//登录成功设置用户数据
const UserInfo:User={
    age:1,
    name: "鬼哥",
    password:"123456"
}


//输出密码为:123456
console.log(UserInfo.password)


//此时当设置用户数据成功后,User接口定义就不能再修改了,那我们就可以使用`映射类型`


//设置所有属性为只读
* keyof:获取当前对象所有属性{"age" | "name" | "password"}
* T:泛型
* P: 当前属性


type SetReadonly ={
    readonly [P in keyof T]:T[P];
}
//新建只读用户数据对象
type ReadonlyUser = SetReadonly;
const UserInfo:ReadonlyUser={
    age:1,
    name: "鬼哥",
    password:"123456"
}
//直接报错,因为UserInfo实力中的每个属性都不可以修改
console.log(UserInfo.password)


//当然这样的举例说服我们去使用确实还缺少一些说服力,但是他的场景就是:在定义类型之后,可以重新设置定义类型的属性值

4.交叉类型

/**
意思其实就是,共同的意思(数学中的并集的概念)


这个和extends功能上相差不大,但是extends如果是类的话需要调用父函数构造函数


大致使用如下:
*/


interface UserApi {
    getOrderList():void
}


// extends方式
interface AppApi extends UserApi {
    getUserList():void
}


const appApi:AppApi={
    getOrderList(){
    },
    getUserList(){


    }
}


//交叉类型方式
const appApi:AppApi&UserApi={
    getOrderList(){
    },
    getUserList(){
    }
}

5.联合类型

/**
意思其实就是,相同部分的意思(数学中的交集的概念)
*/


interface UserApi {
    getUserList():void
}


interface AppApi{
    getUserList():void
}
//联合类型方式
const appApi:AppApi|AppApi={
    getUserList(){
    }
}

6.元组

/**
这个从字面上就很好理解
元:元素(代码里就是对象的意思)
组:数组


所以意思就是:一个包含多个类型对象的数组集合,这个不要想太多就是这么个东西
*/
type regionType={
    province:string,
    city:string
}
const region:regionType={
    province:"上海省",
    city:"上海市"
}
const tableList = ["鬼哥",15,region];

以上就是W3Cschool编程狮关于TypeScript中的六个重新让你认知的知识点的相关介绍了,希望对大家有所帮助。

如何用 Python 画国家的国旗

thbcm阅读(422)

文章来源于公众号:Python技术 作者:派森酱

国旗作为一个国家的象征,反映出该国的特色和传统。国旗起源于近代的欧洲,它是一个国家完整,主权意识增强后得必然产物。本文我们使用 Python 来画几面国旗,使用的 Python 库是大家比较熟悉的 turtle。

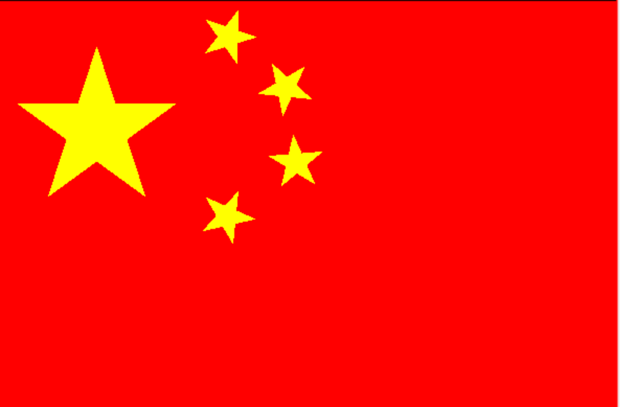
五星红旗

五星红旗是中华人民共和国的国旗,它是由四颗小的黄五角星环绕一颗大的黄五角星组成的,底色为红色,实现代码如下:

turtle.setup(600,400,0,0)
turtle.bgcolor("red")
turtle.fillcolor("yellow")
turtle.color('yellow')
turtle.speed(10)
# 主星
turtle.begin_fill()
turtle.up()
turtle.goto(-280,100)
turtle.down()
for i in range (5):
    turtle.forward(150)
    turtle.right(144)
turtle.end_fill()
# 副星
turtle.begin_fill()
turtle.up()
turtle.goto(-100,180)
turtle.setheading(305)
turtle.down()
for i in range (5):
    turtle.forward(50)
    turtle.left(144)
turtle.end_fill()
turtle.begin_fill()
turtle.up()
turtle.goto(-50,110)
turtle.setheading(30)
turtle.down()
for i in range (5):
    turtle.forward(50)
    turtle.right(144)
turtle.end_fill()
turtle.begin_fill()
turtle.up()
turtle.goto(-40,50)
turtle.setheading(5)
turtle.down()
for i in range (5):
    turtle.forward(50)
    turtle.right(144)
turtle.end_fill()
turtle.begin_fill()
turtle.up()
turtle.goto(-100,10)
turtle.setheading(300)
turtle.down()
for i in range (5):
    turtle.forward(50)
    turtle.left(144)
turtle.end_fill()
turtle.hideturtle()
turtle.done()

实现效果如下:

青天白日旗

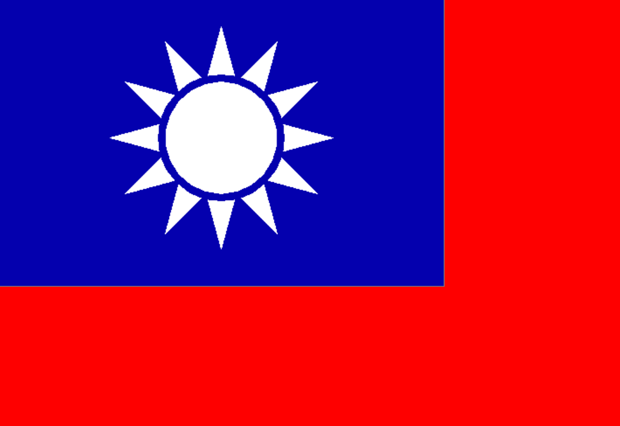
青天白日旗是民国时期的国旗,旗面作蓝色以示青天,旗中置一射出叉光的白日图案,实现代码如下:

t.colormode(255)
rcblue=(4,0,174)
rcred=(254,0,0)
def ol(r):
    na = 15 / 180 * math.pi
    ol=2*r*math.cos(na)
    ol=int(round(ol))
    return ol
def loop(r):
    t.fd(ol(r))
    t.right(150)
def main0(a,b):
    t.color(rcred)
    t.penup()
    t.goto(-a/2,b/2)
    t.pendown()
    t.begin_fill()
    t.goto(-a/2,-b/2)
    t.goto(a/2,-b/2)
    t.goto(a/2,b/2)
    t.end_fill()
    t.penup()
    t.goto(-a/4,b/4)
    t.pendown()
def main1(a1,b1):
    t.color('gray',rcblue)
    t.penup()
    t.right(90)
    t.fd(b1/2)
    t.left(90)
    t.pendown()
    t.begin_fill()
    t.fd(a1/2)
    t.left(90)
    t.fd(b1)
    t.left(90)
    t.fd(a1)
    t.left(90)
    t.fd(b1)
    t.left(90)
    t.fd(a1/2)
    t.end_fill()
    t.penup()
    t.goto(-a/4,b/4)
    t.seth(0)
    t.pendown()
def main2(r):
    t.pensize = 20
    t.color('white', 'white')
    t.penup()
    t.fd(r)
    t.right(180 - 30 / 2)
    t.pendown()
    t.begin_fill()
    for i in range(12):
        loop(r)
    t.end_fill()
    t.penup()
    t.goto(-a/4,b/4)
    t.seth(0)
    t.pendown()
def main3(r1,r2):
    t.color(rcblue, rcblue)  
    t.begin_fill()
    t.up()
    t.right(90)
    t.fd(r1)
    t.left(90)
    t.pd()
    t.circle(r1)
    t.end_fill()
    t.penup()
    t.goto(-a/4,b/4)
    t.pendown()
    t.color('white', 'white')
    t.begin_fill()
    t.pu()
    t.right(90)
    t.fd(r2)
    t.left(90)
    t.pd()
    t.circle(r2)
    t.end_fill()
    t.penup()
    t.goto(-a/4,b/4)
    t.seth(0)
    t.pendown()
def main(a,b):
    a1 = a / 2
    b1 = b / 2
    r = a1 / 4
    r2 = a1 / 8
    r1 = b1 * 17 / 80
    main0(a,b)
    main1(a1,b1)
    main2(r)
    main3(r1,r2)
a=1020
b=680
t.setup(1100,700,100,0)

实现效果如下:

红底白十字旗

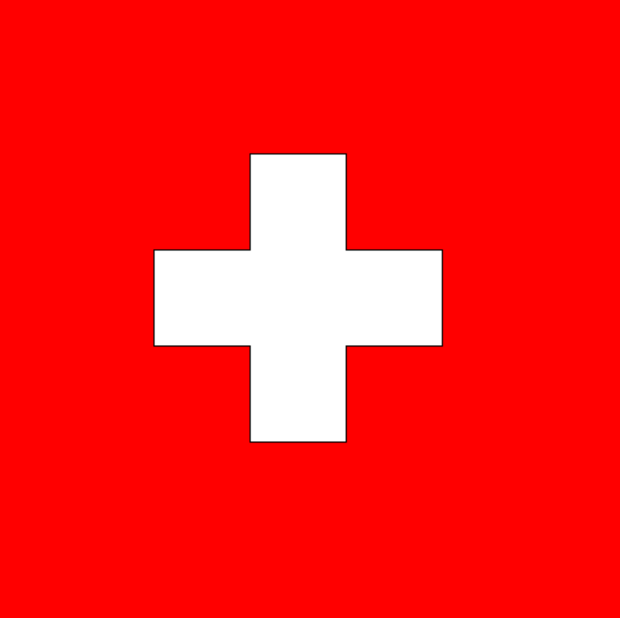
红底白十字旗是瑞士的国旗,与其他国家有点不同,瑞士的国旗形状是正方形的,代表了该国坚守中立的政策,实现代码如下:

def draw_crossshaped(aTurtle, width=0, height=0, color=None):
    aTurtle = turtle.Turtle()
    aTurtle.hideturtle()
    aTurtle.penup()
    aTurtle.goto(30, 50)
    aTurtle.begin_fill()
    aTurtle.fillcolor(color)
    for i in range(4):
        aTurtle.pendown()
        aTurtle.fd(width)
        aTurtle.rt(90)
        aTurtle.fd(height)
        aTurtle.rt(90)
        aTurtle.fd(width)
        aTurtle.lt(90)
    aTurtle.end_fill()
def draw_RQ(times=20.0):
    width, height = 26 * times, 26 * times
    window = turtle.Screen()
    aTurtle = turtle.Turtle()
    aTurtle.hideturtle()
    aTurtle.speed(10)
    aTurtle.penup()
    aTurtle.goto(-width / 2, height / 2)
    aTurtle.pendown()
    aTurtle.begin_fill()
    aTurtle.fillcolor('red')
    aTurtle.fd(width)
    aTurtle.right(90)
    aTurtle.fd(height)
    aTurtle.right(90)
    aTurtle.fd(width)
    aTurtle.right(90)
    aTurtle.fd(height)
    aTurtle.right(90)
    aTurtle.end_fill()
    draw_crossshaped(aTurtle, width=80, height=80, color='white')
    window.exitonclick()

实现效果如下:

星条旗

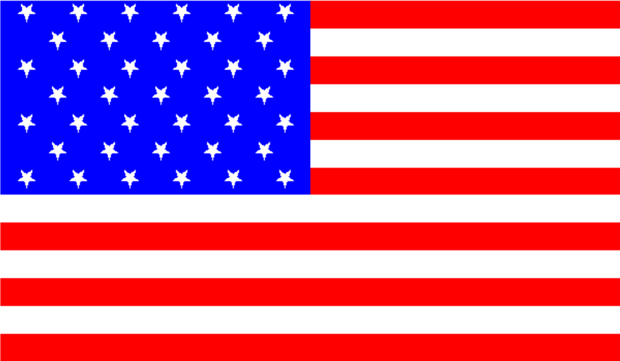
星条旗是美国的国旗,由两部分组成,旗的左上方蓝底上排列着 50 颗白色的星,其余部分是 13 道红白相间的条子,实现代码如下:

# 画条纹
def drawSquar():
    turtle.color('black', 'red')
    turtle.begin_fill()
    for i in range(7):
        turtle.forward(600)
        turtle.left(90)
        turtle.forward(350 / 13)
        turtle.left(90)
        turtle.forward(600)
        turtle.right(90)
        turtle.forward(350 / 13)
        turtle.right(90)
    turtle.end_fill()
# 画左上角的小矩形
def drawSmallsqure():
    turtle.color('blue')
    turtle.begin_fill()
    turtle.left(90)
    turtle.forward(350 / 2)
    turtle.left(90)
    turtle.forward(300)
    turtle.left(90)
    turtle.forward(350 * 7 / 13)
    turtle.left(90)
    turtle.forward(300)
    turtle.end_fill()
# 画左上角的星星
def drawSrarts():
    x = -10
    y = 0
    for k in range(4):
        x = -15
        for i in range(6):
            turtle.goto(x, y)
            turtle.color('white')
            turtle.begin_fill()
            for j in range(5):
                turtle.left(144)
                turtle.forward(20)
            x -= 50
            turtle.end_fill()
        y += 350 / 13 * 2
    x = -10
    y = 350 / 13
    for i in range(3):
        x = -35
        for j in range(5):
            turtle.goto(x, y)
            turtle.color('white')
            turtle.begin_fill()
            for k in range(5):
                turtle.left(144)
                turtle.forward(20)
            x -= 50
            turtle.end_fill()
        y += 350 / 13 * 2
turtle.setup(0.8, 0.8, -100, -100)
turtle.speed(10)
turtle.pu()
turtle.forward(300)
turtle.left(90)
turtle.forward(350 / 2)
turtle.left(90)
drawSquar()
turtle.home()
drawSmallsqure()
turtle.home()
drawSrarts()
turtle.hideturtle()
turtle.done()

实现效果如下:

以上就是W3Cschool编程狮关于如何用 Python 画国家的国旗的相关介绍了,希望对大家有所帮助。

联系我们