Vue 进阶面试必问,异步更新机制和 nextTick 原理

thbcm阅读(455)

以下文章来源于前端下午茶 ,作者SHERlocked93

vue 已是目前国内前端web端三分天下之一,同时也作为本人主要技术栈之一,在日常使用中知其然也好奇着所以然,另外最近的社区涌现了一大票 vue 源码阅读类的文章,在下借这个机会从大家的文章和讨论中汲取了一些营养,同时对一些阅读源码时的想法进行总结,出产一些文章,作为自己思考的输出

目标Vue版本:2.5.17-beta.0

vue 源码注释:github.com/SHERlocked93/vue-analysis

声明:文章中源码的语法都使用 Flow,并且源码根据需要都有删节(为了不被迷糊 @_@),如果要看完整版的请进入上面的github地址

1. 异步更新

上一篇文章我们在依赖收集原理的响应式化方法 defineReactive 中的 setter 访问器中有派发更新 dep.notify() 方法,这个方法会挨个通知在 dep 的 subs 中收集的订阅自己变动的 watchers 执行 update 。一起来看看 update 方法的实现:

// src/core/observer/watcher.js


/* Subscriber接口,当依赖发生改变的时候进行回调 */
update() {
  if (this.computed) {
    // 一个computed watcher有两种模式:activated lazy(默认)
    // 只有当它被至少一个订阅者依赖时才置activated,这通常是另一个计算属性或组件的render function
    if (this.dep.subs.length === 0) { // 如果没人订阅这个计算属性的变化
      // lazy时,我们希望它只在必要时执行计算,所以我们只是简单地将观察者标记为dirty
      // 当计算属性被访问时,实际的计算在this.evaluate()中执行
      this.dirty = true
    } else {
      // activated模式下,我们希望主动执行计算,但只有当值确实发生变化时才通知我们的订阅者
      this.getAndInvoke(() => {
        this.dep.notify() // 通知渲染watcher重新渲染,通知依赖自己的所有watcher执行update
      })
    }
  } else if (this.sync) {   // 同步
    this.run()
  } else {
    queueWatcher(this) // 异步推送到调度者观察者队列中,下一个tick时调用
  }
}

如果不是 computed watcher 也非 sync 会把调用 update 的当前 watcher 推送到调度者队列中,下一个 tick 时调用,看看 queueWatcher :

// src/core/observer/scheduler.js


/* 将一个观察者对象push进观察者队列,在队列中已经存在相同的id则
 * 该watcher将被跳过,除非它是在队列正被flush时推送
 */
export function queueWatcher (watcher: Watcher) {
  const id = watcher.id
  if (has[id] == null) { // 检验id是否存在,已经存在则直接跳过,不存在则标记哈希表has,用于下次检验
    has[id] = true
    queue.push(watcher) // 如果没有正在flush,直接push到队列中
    if (!waiting) { // 标记是否已传给nextTick
      waiting = true
      nextTick(flushSchedulerQueue)
    }
  }
}


/* 重置调度者状态 */
function resetSchedulerState () {
  queue.length = 0
  has = {}
  waiting = false
}

这里使用了一个 has 的哈希map用来检查是否当前 watcher 的 id 是否存在,若已存在则跳过,不存在则就 push 到 queue 队列中并标记哈希表 has,用于下次检验,防止重复添加。这就是一个去重的过程,比每次查重都要去 queue 中找要文明,在渲染的时候就不会重复patch 相同 watcher 的变化,这样就算同步修改了一百次视图中用到的 data,异步 patch的时候也只会更新最后一次修改。

这里的 waiting 方法是用来标记 flushSchedulerQueue 是否已经传递给 nextTick 的标记位,如果已经传递则只 push 到队列中不传递 flushSchedulerQueue 给 nextTick,等到 resetSchedulerState 重置调度者状态的时候 waiting 会被置回 false 允许 flushSchedulerQueue 被传递给下一个 tick 的回调,总之保证了 flushSchedulerQueue 回调在一个 tick 内只允许被传入一次。来看看被传递给 nextTick 的回调 flushSchedulerQueue 做了什么:

// src/core/observer/scheduler.js


/* nextTick的回调函数,在下一个tick时flush掉两个队列同时运行watchers */
function flushSchedulerQueue () {
  flushing = true
  let watcher, id


  queue.sort((a, b) => a.id - b.id)  // 排序


  for (index = 0; index < queue.length; index++) {   // 不要将length进行缓存
    watcher = queue[index]
    if (watcher.before) { // 如果watcher有before则执行
      watcher.before()
    }
    id = watcher.id
    has[id] = null // 将has的标记删除
    watcher.run() // 执行watcher
    if (process.env.NODE_ENV !== 'production' && has[id] != null) { // 在dev环境下检查是否进入死循环
      circular[id] = (circular[id] || 0) + 1 // 比如user watcher订阅自己的情况
      if (circular[id] > MAX_UPDATE_COUNT) { // 持续执行了一百次watch代表可能存在死循环
        warn()  // 进入死循环的警告
        break
      }
    }
  }
  resetSchedulerState() // 重置调度者状态
  callActivatedHooks() // 使子组件状态都置成active同时调用activated钩子
  callUpdatedHooks() // 调用updated钩子
}

在 nextTick 方法中执行 flushSchedulerQueue 方法,这个方法挨个执行 queue 中的watcher的 run 方法。我们看到在首先有个 queue.sort() 方法把队列中的 watcher 按 id 从小到大排了个序,这样做可以保证:

  1. 组件更新的顺序是从父组件到子组件的顺序,因为父组件总是比子组件先创建。
  2. 一个组件的 user watchers (侦听器watcher)比 render watcher 先运行,因为 user watchers 往往比 render watcher 更早创建
  3. 如果一个组件在父组件 watcher 运行期间被销毁,它的 watcher 执行将被跳过

在挨个执行队列中的 for 循环中,index < queue.length 这里没有将 length 进行缓存,因为在执行处理现有 watcher 对象期间,更多的 watcher 对象可能会被 push 进 queue。

那么数据的修改从 model 层反映到 view 的过程:数据更改 -> setter -> Dep -> Watcher -> nextTick -> patch -> 更新视图

2. nextTick原理

2.1 宏任务/微任务

这里就来看看包含着每个 watcher 执行的方法被作为回调传入 nextTick 之后,nextTick对这个方法做了什么。不过首先要了解一下浏览器中的 EventLoop、macro task、micro task几个概念,不了解可以参考一下 JS 与 Node.js 中的事件循环 这篇文章,这里就用一张图来表明一下后两者在主线程中的执行关系:

解释一下,当主线程执行完同步任务后:

  1. 引擎首先从 macrotask queue 中取出第一个任务,执行完毕后,将 microtask queue 中的所有任务取出,按顺序全部执行;
  2. 然后再从 macrotask queue 中取下一个,执行完毕后,再次将 microtask queue 中的全部取出;
  3. 循环往复,直到两个 queue 中的任务都取完。

浏览器环境中常见的异步任务种类,按照优先级:

  • macro task :同步代码、setImmediate、MessageChannel、setTimeout/setInterval
  • micro task:Promise.then、MutationObserver

有的文章把 micro task 叫微任务,macro task 叫宏任务,因为这两个单词拼写太像了 -。- ,所以后面的注释多用中文表示~

先来看看源码中对 micro task与 macro task 的实现:macroTimerFunc、microTimerFunc

// src/core/util/next-tick.js


const callbacks = [] // 存放异步执行的回调
let pending = false // 一个标记位,如果已经有timerFunc被推送到任务队列中去则不需要重复推送


/* 挨个同步执行callbacks中回调 */
function flushCallbacks() {
  pending = false
  const copies = callbacks.slice(0)
  callbacks.length = 0
  for (let i = 0; i < copies.length; i++) {
    copies[i]()
  }
}


let microTimerFunc // 微任务执行方法
let macroTimerFunc // 宏任务执行方法
let useMacroTask = false // 是否强制为宏任务,默认使用微任务


// 宏任务
if (typeof setImmediate !== 'undefined' && isNative(setImmediate)) {
  macroTimerFunc = () => {
    setImmediate(flushCallbacks)
  }
} else if (typeof MessageChannel !== 'undefined' && (
  isNative(MessageChannel) ||
  MessageChannel.toString() === '[object MessageChannelConstructor]' // PhantomJS
)) {
  const channel = new MessageChannel()
  const port = channel.port2
  channel.port1.onmessage = flushCallbacks
  macroTimerFunc = () => {
    port.postMessage(1)
  }
} else {
  macroTimerFunc = () => {
    setTimeout(flushCallbacks, 0)
  }
}


// 微任务
if (typeof Promise !== 'undefined' && isNative(Promise)) {
  const p = Promise.resolve()
  microTimerFunc = () => {
    p.then(flushCallbacks)
  }
} else {
  microTimerFunc = macroTimerFunc // fallback to macro
}

flushCallbacks 这个方法就是挨个同步的去执行 callbacks 中的回调函数们, callbacks 中的回调函数是在调用 nextTick 的时候添加进去的;那么怎么去使用 micro task 与 macro task 去执行 flushCallbacks 呢,这里他们的实现 macroTimerFunc、microTimerFunc 使用浏览器中宏任务/微任务的 API 对flushCallbacks 方法进行了一层包装。比如宏任务方法 macroTimerFunc=()=>{ setImmediate(flushCallbacks) },这样在触发宏任务执行的时候 macroTimerFunc() 就可以在浏览器中的下一个宏任务 loop 的时候消费这些保存在 callbacks 数组中的回调了,微任务同理。同时也可以看出传给 nextTick 的异步回调函数是被压成了一个同步任务在一个 tick 执行完的,而不是开启多个异步任务。

注意这里有个比较难理解的地方,第一次调用 nextTick 的时候 pending 为 false ,此时已经 push 到浏览器 event loop 中一个宏任务或微任务的 task,如果在没有 flush 掉的情况下继续往 callbacks 里面添加,那么在执行这个占位 queue 的时候会执行之后添加的回调,所以 macroTimerFunc、microTimerFunc 相当于 task queue 的占位,以后 pending 为 true 则继续往占位 queue 里面添加,event loop 轮到这个 task queue 的时候将一并执行。执行 flushCallbacks 时 pending 置 false,允许下一轮执行 nextTick 时往 event loop 占位。

可以看到上面 macroTimerFunc 与 microTimerFunc 进行了在不同浏览器兼容性下的平稳退化,或者说降级策略:

  1. macroTimerFunc :setImmediate -> MessageChannel -> setTimeout。首先检测是否原生支持 setImmediate,这个方法只在 IE、Edge 浏览器中原生实现,然后检测是否支持 MessageChannel,如果对 MessageChannel 不了解可以参考一下这篇文章,还不支持的话最后使用 setTimeout;为什么优先使用 setImmediate与 MessageChannel 而不直接使用 setTimeout呢,是因为 HTML5 规定 setTimeout 执行的最小延时为4ms,而嵌套的 timeout 表现为10ms,为了尽可能快的让回调执行,没有最小延时限制的前两者显然要优于 setTimeout。
  2. microTimerFunc:Promise.then -> macroTimerFunc 。首先检查是否支持Promise,如果支持的话通过 Promise.then 来调用 flushCallbacks 方法,否则退化为 macroTimerFunc ;vue2.5之后 nextTick 中因为兼容性原因删除了微任务平稳退化的 MutationObserver 的方式。

2.2 nextTick实现

最后来看看我们平常用到的 nextTick 方法到底是如何实现的:

// src/core/util/next-tick.js


export function nextTick(cb?: Function, ctx?: Object) {
  let _resolve
  callbacks.push(() => {
    if (cb) {
      try {
        cb.call(ctx)
      } catch (e) {
        handleError(e, ctx, 'nextTick')
      }
    } else if (_resolve) {
      _resolve(ctx)
    }
  })
  if (!pending) {
    pending = true
    if (useMacroTask) {
      macroTimerFunc()
    } else {
      microTimerFunc()
    }
  }
  if (!cb && typeof Promise !== 'undefined') {
    return new Promise(resolve => {
      _resolve = resolve
    })
  }
}


/* 强制使用macrotask的方法 */
export function withMacroTask(fn: Function): Function {
  return fn._withTask || (fn._withTask = function() {
    useMacroTask = true
    const res = fn.apply(null, arguments)
    useMacroTask = false
    return res
  })
}

nextTick 在这里分为三个部分,我们一起来看一下;

  1. 首先 nextTick 把传入的 cb 回调函数用 try-catch 包裹后放在一个匿名函数中推入callbacks数组中,这么做是因为防止单个 cb 如果执行错误不至于让整个JS线程挂掉,每个 cb 都包裹是防止这些回调函数如果执行错误不会相互影响,比如前一个抛错了后一个仍然可以执行。
  2. 然后检查 pending 状态,这个跟之前介绍的 queueWatcher 中的 waiting 是一个意思,它是一个标记位,一开始是 false 在进入 macroTimerFunc、microTimerFunc方法前被置为 true,因此下次调用 nextTick 就不会进入 macroTimerFunc、microTimerFunc 方法,这两个方法中会在下一个 macro/micro tick 时候flushCallbacks 异步的去执行callbacks队列中收集的任务,而 flushCallbacks 方法在执行一开始会把 pending 置 false,因此下一次调用 nextTick 时候又能开启新一轮的 macroTimerFunc、microTimerFunc,这样就形成了vue中的 event loop。
  3. 最后检查是否传入了 cb,因为 nextTick 还支持Promise化的调用:nextTick().then(() => {}),所以如果没有传入 cb 就直接return了一个Promise实例,并且把resolve传递给_resolve,这样后者执行的时候就跳到我们调用的时候传递进 then 的方法中。

Vue源码中 next-tick.js 文件还有一段重要的注释,这里就翻译一下:

在vue2.5之前的版本中,nextTick基本上基于 micro task 来实现的,但是在某些情况下micro task 具有太高的优先级,并且可能在连续顺序事件之间(例如#4521,#6690)或者甚至在同一事件的事件冒泡过程中之间触发(#6566)。但是如果全部都改成 macro task,对一些有重绘和动画的场景也会有性能影响,如 issue #6813。vue2.5之后版本提供的解决办法是默认使用 micro task,但在需要时(例如在v-on附加的事件处理程序中)强制使用 macro task。

为什么默认优先使用 micro task 呢,是利用其高优先级的特性,保证队列中的微任务在一次循环全部执行完毕。

强制 macro task 的方法是在绑定 DOM 事件的时候,默认会给回调的 handler 函数调用withMacroTask 方法做一层包装 handler = withMacroTask(handler),它保证整个回调函数执行过程中,遇到数据状态的改变,这些改变都会被推到 macro task 中。以上实现在 src/platforms/web/runtime/modules/events.js 的 add 方法中,可以自己看一看具体代码。

刚好在写这篇文章的时候思否上有人问了个问题 vue 2.4 和2.5 版本的 @input 事件不一样 ,这个问题的原因也是因为2.5之前版本的DOM事件采用 micro task ,而之后采用 macro task,解决的途径参考 < Vue.js 升级踩坑小记> 中介绍的几个办法,这里就提供一个在mounted钩子中用 addEventListener 添加原生事件的方法来实现,参见 CodePen。

3. 一个例子

说这么多,不如来个例子,执行参见 CodePen

<div id="app">
  <span id='name' ref='name'>{{ name }}</span>
  <button @click='change'>change name</button>
  <div id='content'></div>
</div>
<script>
  new Vue({
    el: '#app',
    data() {
      return {
        name: 'SHERlocked93'
      }
    },
    methods: {
      change() {
        const $name = this.$refs.name
        this.$nextTick(() => console.log('setter前:' + $name.innerHTML))
        this.name = ' name改喽 '
        console.log('同步方式:' + this.$refs.name.innerHTML)
        setTimeout(() => this.console("setTimeout方式:" + this.$refs.name.innerHTML))
        this.$nextTick(() => console.log('setter后:' + $name.innerHTML))
        this.$nextTick().then(() => console.log('Promise方式:' + $name.innerHTML))
      }
    }
  })
</script>

执行以下看看结果:

同步方式:SHERlocked93
setter前:SHERlocked93
setter后:name改喽
Promise方式:name改喽
setTimeout方式:name改喽

为什么是这样的结果呢,解释一下:

  1. 同步方式: 当把data中的name修改之后,此时会触发name的 setter 中的 dep.notify 通知依赖本data的render watcher去 update,update 会把flushSchedulerQueue 函数传递给 nextTick,render watcher在 flushSchedulerQueue 函数运行时 watcher.run 再走 diff -> patch 那一套重渲染 re-render 视图,这个过程中会重新依赖收集,这个过程是异步的;所以当我们直接修改了name之后打印,这时异步的改动还没有被 patch 到视图上,所以获取视图上的DOM元素还是原来的内容。
  2. setter前: setter前为什么还打印原来的是原来内容呢,是因为 nextTick 在被调用的时候把回调挨个push进callbacks数组,之后执行的时候也是 for 循环出来挨个执行,所以是类似于队列这样一个概念,先入先出;在修改name之后,触发把render watcher填入 schedulerQueue 队列并把他的执行函数 flushSchedulerQueue 传递给nextTick ,此时callbacks队列中已经有了 setter前函数 了,因为这个 cb 是在 setter前函数 之后被push进callbacks队列的,那么先入先出的执行callbacks中回调的时候先执行 setter前函数,这时并未执行render watcher的 watcher.run,所以打印DOM元素仍然是原来的内容。
  3. setter后: setter后这时已经执行完 flushSchedulerQueue,这时render watcher已经把改动 patch 到视图上,所以此时获取DOM是改过之后的内容。
  4. Promise方式: 相当于 Promise.then 的方式执行这个函数,此时DOM已经更改。
  5. setTimeout方式: 最后执行macro task的任务,此时DOM已经更改。

注意,在执行 setter前函数 这个异步任务之前,同步的代码已经执行完毕,异步的任务都还未执行,所有的 $nextTick 函数也执行完毕,所有回调都被push进了callbacks队列中等待执行,所以在setter前函数 执行的时候,此时callbacks队列是这样的:[setter前函数,flushSchedulerQueue,setter后函数,Promise方式函数],它是一个micro task队列,执行完毕之后执行macro task setTimeout,所以打印出上面的结果。

另外,如果浏览器的宏任务队列里面有setImmediate、MessageChannel、setTimeout/setInterval 各种类型的任务,那么会按照上面的顺序挨个按照添加进event loop中的顺序执行,所以如果浏览器支持MessageChannel, nextTick 执行的是macroTimerFunc,那么如果 macrotask queue 中同时有 nextTick 添加的任务和用户自己添加的 setTimeout 类型的任务,会优先执行 nextTick 中的任务,因为MessageChannel 的优先级比 setTimeout的高,setImmediate 同理。

以上就是W3Cschool编程狮关于Vue 进阶面试必问,异步更新机制和 nextTick 原理的相关介绍了,希望对大家有所帮助。
JDK15正式发布,新增功能预览!

thbcm阅读(415)

文章来源于公众号:Java中文社群 作者:磊哥

JDK 15 在 2020 年 9 月 15 号正式发布了,这次发布的主要功能有:

  • JEP 339:EdDSA 数字签名算法
  • JEP 360:密封类(预览)
  • JEP 371:隐藏类
  • JEP 372:删除 Nashorn JavaScript 引擎
  • JEP 373:重新实现 Legacy DatagramSocket API
  • JEP 374:重新实现 DatagramSocket API
  • JEP 375:实例模式匹配(第二次预览)
  • JEP 377:ZGC:一个可扩展的低延迟垃圾收集器
  • JEP 378:文本块
  • JEP 379:低暂停时间垃圾收集器
  • JEP 381:移除 Solaris 和 SPARC 端口
  • JEP 383:外部存储器访问 API(第二个内置程序)
  • JEP 384:Records(第二次预览)
  • JEP 385:不推荐的 RMI 激活去除

JEP:JDK Enhancement Proposals,JDK 增强建议,也就是 JDK 的特性新增和改进提案。

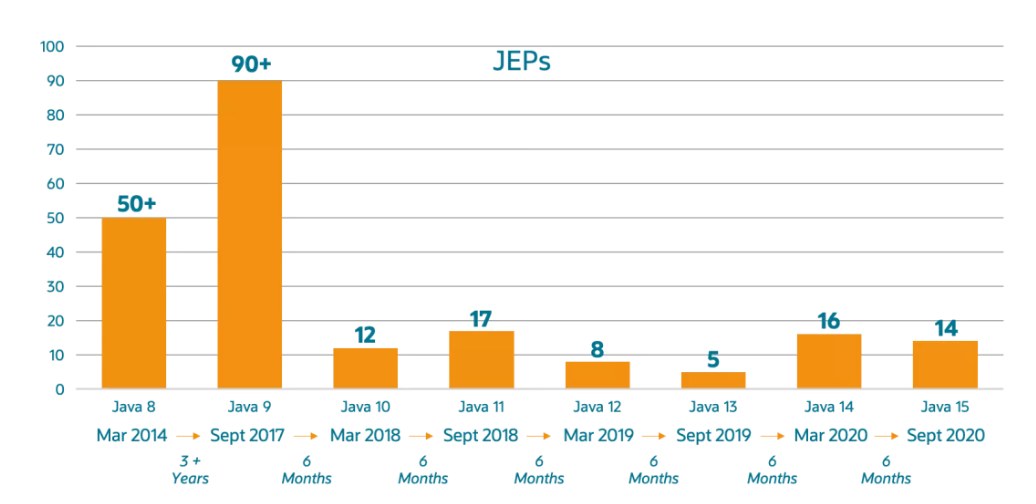
这些年发布的版本对应的 JEPs 数量如下图所示:

发布版本说明

根据发布的规划,这次发布的 JDK 15 将是一个短期的过度版,只会被 Oracle 支持(维护)6 个月,直到明年 3 月的 JDK 16 发布此版本将停止维护。而 Oracle 下一个长期支持版(LTS 版)会在明年的 9 月份候发布(Java 17),LTS 版每 3 年发布一个,上一次长期支持版是 18 年 9 月发布的 JDK 11。

JDK 15 新功能说明

JDK 15 为用户提供了十四项主要的增强/更改,包括一个孵化器模块,三个预览功能,两个不推荐使用的功能以及两个删除功能。

1、EdDSA 数字签名算法

新加入 Edwards-Curve 数字签名算法(EdDSA)实现加密签名。在许多其它加密库(如 OpenSSL 和 BoringSSL)中得到支持。与 JDK 中的现有签名方案相比,EdDSA 具有更高的安全性和性能。这是一个新的功能。

2、隐藏类

此功能可帮助需要在运行时生成类的框架。框架生成类需要动态扩展其行为,但是又希望限制对这些类的访问。隐藏类很有用,因为它们只能通过反射访问,而不能从普通字节码访问。此外,隐藏类可以独立于其他类加载,这可以减少框架的内存占用。这是一个新的功能。

3、重新实现 DatagramSocket API

重新实现旧版 DatagramSocket API,更简单、更现代的实现来代替java.net.DatagramSocket和java.net.MulticastSocketAPI 的基础实现,提高了 JDK 的可维护性和稳定性。

4、ZGC 功能转正

ZGC 已由JEP 333集成到JDK 11 中,其目标是通过减少 GC 停顿时间来提高性能。借助 JEP 377,ZGC 从预览功能转变为生产功能。

5、文本块功能转正

文本块由JEP 355在 2019 年提出,文本块是一种多行字符串文字,它避免了大多数转义序列的需要,以一种可预测的方式自动设置字符串的格式,并在需要时使开发人员可以控制格式。借助 JEP 378,文本块已成为 Java 语言的永久功能。

6、Shenandoah 垃圾回收算法转正

Shenandoah 垃圾回收从实验特性变为产品特性。这是一个从 JDK 12 引入的回收算法,该算法通过与正在运行的 Java 线程同时进行疏散工作来减少 GC 暂停时间。Shenandoah 的暂停时间与堆大小无关,无论堆栈是 200 MB 还是 200 GB,都具有相同的一致暂停时间。

7、密封类(预览)

通过密封的类和接口来增强 Java 编程语言,用于限制超类的使用,密封的类和接口限制其它可能继承或实现它们的其它类或接口。

8、instanceof 自动匹配模式(预览)

旧写法:

// 先判断类型
if (obj instanceof String) {
    // 然后转换
    String s = (String) obj;
    // 然后才能使用
}

新写法:

if (obj instanceof String s) {
    // 如果类型匹配 直接使用
} else {
    // 如果类型不匹配则不能直接使用
}

这是第二次预览该功能,我们已经在 Java 14 中首次预览过该特性。

9、Records Class(预览)

Records Class 也是第二次出现的预览功能,它在 JDK 14 中也出现过一次了,使用 Record 可以更方便的创建一个常量类,使用的前后代码对比如下。

旧写法:

class Point {
    private final int x;
    private final int y;


    Point(int x, int y) { 
        this.x = x;
        this.y = y;
    }


    int x() { return x; }
    int y() { return y; }


    public boolean equals(Object o) { 
        if (!(o instanceof Point)) return false;
        Point other = (Point) o;
        return other.x == x && other.y = y;
    }


    public int hashCode() {
        return Objects.hash(x, y);
    }


    public String toString() { 
        return String.format("Point[x=%d, y=%d]", x, y);
    }
}

新写法:

record Point(int x, int y) { }

也就是说在使用了 record 之后,就可以用一行代码编写出一个常量类,并且这个常量类还包含了构造方法、toString()、equals() 和 hashCode() 等方法。

10、外部存储器访问 API(预览)

目的是引入一个 API,以允许 Java 程序安全有效地访问 Java 堆之外的外部内存。这同样是 Java 14 的一个预览特性。

11、其它功能

其它功能里面还有一些弃用和不建议使用的功能,比如移除了 Nashorn JavaScript 引擎,同时也移除了删除 Solaris 和 SPARC 端口,并标记了一些弃用功能。

以上就是W3Cschool编程狮关于JDK15正式发布,新增功能预览!的相关介绍了,希望对大家有所帮助。
查询ElasticSearch:用SQL代替DSL

thbcm阅读(424)

文章来源于公众号:码农知识点 ,作者Monica2333

ES7.x 版本的 x-pack 自带 ElasticSearch SQL,我们可以直接通过 SQL REST API、SQL CLI 等方式使用 SQL 查询。

SQL REST API

在Kibana Console中输入:

POST /_sql?format=txt
{
  "query": "SELECT * FROM library ORDER BY page_count DESC LIMIT 5"
}

将上述 SQL 替换为你自己的 SQL 语句,即可。返回格式如下:

    author      |        name        |  page_count   | release_date
-----------------+--------------------+---------------+------------------------
Peter F. Hamilton|Pandora's Star      |768            |2004-03-02T00:00:00.000Z
Vernor Vinge     |A Fire Upon the Deep|613            |1992-06-01T00:00:00.000Z
Frank Herbert    |Dune                |604            |1965-06-01T00:00:00.000Z

SQL CLI

elasticsearch-sql-cli 是安装 ES 时 bin 目录的一个脚本文件,也可单独下载。我们在 ES 目录运行

./bin/elasticsearch-sql-cli https://some.server:9200

输入 SQL 即可查询

sql> SELECT * FROM library WHERE page_count > 500 ORDER BY page_count DESC;
     author      |        name        |  page_count   | release_date
-----------------+--------------------+---------------+---------------
Peter F. Hamilton|Pandora's Star      |768            |1078185600000
Vernor Vinge     |A Fire Upon the Deep|613            |707356800000
Frank Herbert    |Dune                |604            |-144720000000

SQL To DSL

在Kibana输入:

POST /_sql/translate
{
  "query": "SELECT * FROM library ORDER BY page_count DESC",
  "fetch_size": 10
}

即可得到转化后的 DSL query:

{
  "size": 10,
  "docvalue_fields": [
    {
      "field": "release_date",
      "format": "epoch_millis"
    }
  ],
  "_source": {
    "includes": [
      "author",
      "name",
      "page_count"
    ],
    "excludes": []
  },
  "sort": [
    {
      "page_count": {
        "order": "desc",
        "missing": "_first",
        "unmapped_type": "short"
      }
    }
  ]
}

因为查询相关的语句已经生成,我们只需要在这个基础上适当修改或不修改就可以愉快使用 DSL 了。

下面我们详细介绍下 ES SQL 支持的SQL语句 和 如何避免错误使用。

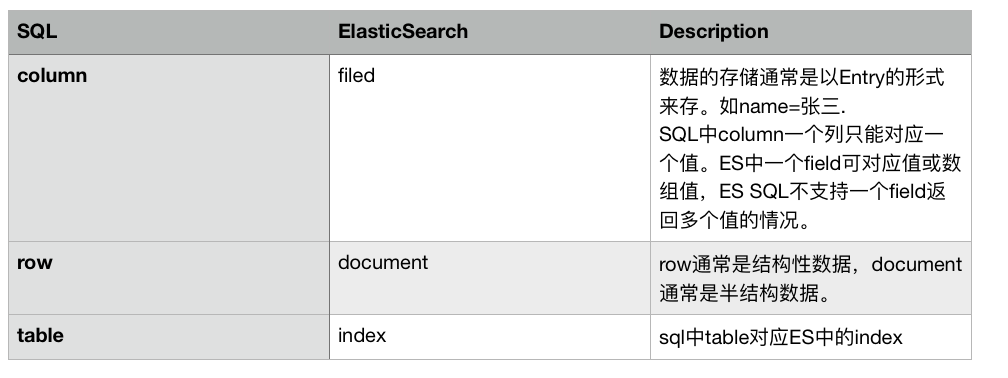
首先需要了解下 ES SQL 支持的 SQL 语句中,SQL 术语和ES术语的对应关系:

ES SQL 的语法支持大多遵循 ANSI SQL 标准,支持的 SQL 语句有 DML 查询和部分 DDL 查询。 DDL 查询如:DESCRIBE table,SHOW COLUMNS IN table略显鸡肋,我们主要看下对SELECT,Function的DML查询支持。

SELECT

语法结构如下:

SELECT [TOP [ count ] ] select_expr [, ...]
[ FROM table_name ]
[ WHERE condition ]
[ GROUP BY grouping_element [, ...] ]
[ HAVING condition]
[ ORDER BY expression [ ASC | DESC ] [, ...] ]
[ LIMIT [ count ] ]
[ PIVOT ( aggregation_expr FOR column IN ( value [ [ AS ] alias ] [, ...] ) ) ]

表示从0-N个表中获取行数据。SQL 的执行顺序为:

  1. 获取所有 FROM中的关键词,确定表名。
  2. 如果有WHERE条件,过滤掉所有不符合的行。
  3. 如果有GROUP BY条件,则分组聚合;如果有HAVING条件,则过滤聚合的结果。
  4. 上一步得到的结果经过select_expr运算,确定具体返回的数据。
  5. 如果有 ORDER BY条件,会对返回的数据排序。
  6. 如果有 LIMIT or TOP条件,会返回上一步结果的子集。

与常用的SQL有两点不同,ES SQL 支持TOP [ count ]和PIVOT ( aggregation_expr FOR column IN ( value [ [ AS ] alias ] [, ...] ) )子句。
TOP [ count ] :如SELECT TOP 2 first_name FROM emp表示最多返回两条数据,不可与LIMIT条件共用。
PIVOT子句会对其聚合条件得到的结果进行行转列,进一步运算。这个我是没用过,不做介绍。

FUNCTION

基于上面的 SQL 我们其实已经能有过滤,聚合,排序,分页功能的 SQL 了。但是我们需要进一步了解 ES SQL 中 FUNCTION 的支持,才能写出丰富的具有全文搜索,聚合,分组功能的 SQL。 使用SHOW FUNCTIONS 可列举出支持的函数名称和所属类型。

SHOW FUNCTIONS;


      name       |     type
-----------------+---------------
AVG              |AGGREGATE
COUNT            |AGGREGATE
FIRST            |AGGREGATE
FIRST_VALUE      |AGGREGATE
LAST             |AGGREGATE
LAST_VALUE       |AGGREGATE
MAX              |AGGREGATE
MIN              |AGGREGATE
SUM              |AGGREGATE
........

我们主要看下聚合,分组,全文搜索相关的常用函数。

全文匹配函数

MATCH:相当于 DSL 中的match and multi_match查询。

MATCH(
    field_exp,       --字段名称
    constant_exp,       --字段的匹配值
    [, options])       --可选项

使用举例:

SELECT author, name FROM library WHERE MATCH(author, 'frank');


    author     |       name
---------------+-------------------
Frank Herbert  |Dune
Frank Herbert  |Dune Messiah
SELECT author, name, SCORE() FROM library WHERE MATCH('author^2,name^5', 'frank dune');


    author     |       name        |    SCORE()
---------------+-------------------+---------------
Frank Herbert  |Dune               |11.443176
Frank Herbert  |Dune Messiah       |9.446629

QUERY:相当于 DSL 中的 query_string 查询。

QUERY(
    constant_exp      --匹配值表达式
    [, options])       --可选项

使用举例:

SELECT author, name, page_count, SCORE() FROM library WHERE QUERY('_exists_:"author" AND page_count:>200 AND (name:/star.*/ OR name:duna~)');


      author      |       name        |  page_count   |    SCORE()
------------------+-------------------+---------------+---------------
Frank Herbert     |Dune               |604            |3.7164764
Frank Herbert     |Dune Messiah       |331            |3.4169943

SCORE():返回输入数据和返回数据的相关度relevance. 使用举例:

SELECT SCORE(), * FROM library WHERE MATCH(name, 'dune') ORDER BY SCORE() DESC;


    SCORE()    |    author     |       name        |  page_count   |    release_date
---------------+---------------+-------------------+---------------+--------------------
2.2886353      |Frank Herbert  |Dune               |604            |1965-06-01T00:00:00Z
1.8893257      |Frank Herbert  |Dune Messiah       |331            |1969-10-15T00:00:00Z

聚合函数

AVG(numeric_field) :计算数字类型的字段的平均值。

SELECT AVG(salary) AS avg FROM emp;

COUNT(expression):返回输入数据的总数,包括COUNT()时field_name对应的值为null的数据。 COUNT(ALL field_name):返回输入数据的总数,不包括field_name对应的值为null的数据。 COUNT(DISTINCT field_name):返回输入数据中field_name对应的值不为null的总数。 SUM(field_name):返回输入数据中数字字段field_name对应的值的总和。 MIN(field_name):返回输入数据中数字字段field_name对应的值的最小值。 MAX(field_name):返回输入数据中数字字段field_name对应的值的最大值。

分组函数

这里的分组函数是对应 DSL 中的bucket分组。

HISTOGRAM:语法如下:

HISTOGRAM(
           numeric_exp,    --数字表达式,通常是一个field_name
           numeric_interval    --数字的区间值
)


HISTOGRAM(
           date_exp,      --date/time表达式,通常是一个field_name
           date_time_interval      --date/time的区间值
)

如下返回每年1月1号凌晨出生的数据:

ELECT HISTOGRAM(birth_date, INTERVAL 1 YEAR) AS h, COUNT(*) AS c FROM emp GROUP BY h;


           h            |       c
------------------------+---------------
null                    |10
1952-01-01T00:00:00.000Z|8
1953-01-01T00:00:00.000Z|11
1954-01-01T00:00:00.000Z|8
1955-01-01T00:00:00.000Z|4
1956-01-01T00:00:00.000Z|5
1957-01-01T00:00:00.000Z|4
1958-01-01T00:00:00.000Z|7
1959-01-01T00:00:00.000Z|9
1960-01-01T00:00:00.000Z|8
1961-01-01T00:00:00.000Z|8
1962-01-01T00:00:00.000Z|6
1963-01-01T00:00:00.000Z|7
1964-01-01T00:00:00.000Z|4
1965-01-01T00:00:00.000Z|1

ES SQL局限性

因为ES SQL和ES DSL在功能上并非完全匹配,官方文档提到的 SQL 局限性有:

大的查询可能抛ParsingException

在解析阶段,极大的查询会占用过多的内存,在这种情况下,Elasticsearch SQL引擎将中止解析并抛出错误。

nested类型字段的表示方法

SQL 中不支持nested类型的字段,只能使用

[nested_field_name].[sub_field_name]

这种形式来引用内嵌子字段。 使用举例:

SELECT dep.dep_name.keyword FROM test_emp GROUP BY languages;

nested类型字段不能用在where 和 order by 的Scalar函数上

如以下 SQL 都是错误的

SELECT * FROM test_emp WHERE LENGTH(dep.dep_name.keyword) > 5;


SELECT * FROM test_emp ORDER BY YEAR(dep.start_date);

不支持多个nested字段的同时查询

如嵌套字段nested_A和nested_B无法同时使用。

nested内层字段分页限制

当分页查询有nested字段时,分页结果可能不正确。这是因为:ES 中的分页查询发生在Root nested document上,而不是它的内层字段上。

keyword类型的字段不支持normalizer

不支持数组类型的字段

这是因为在 SQL 中一个field只对应一个值,这种情况下我们可以使用上面介绍的 SQL To DSL 的 API 转化为 DSL 语句,用 DSL 查询就好了。

聚合排序的限制

  • 排序字段必须是聚合桶中的字段,ES SQL CLI突破了这种限制,但上限不能超过512行,否则在sorting阶段会抛异常。推荐搭配Limit子句使用,如:
SELECT * FROM test GROUP BY age ORDER BY COUNT(*) LIMIT 100;

  • 聚合排序的排序条件不支持Scalar函数或者简单的操作符运算。聚合后的复杂字段(比如包含聚合函数)也是不能用在排序条件上的。

以下是错误例子:

SELECT age, ROUND(AVG(salary)) AS avg FROM test GROUP BY age ORDER BY avg;


SELECT age, MAX(salary) - MIN(salary) AS diff FROM test GROUP BY age ORDER BY diff;

子查询的限制

子查询中包含GROUP BY or HAVING 或者比SELECT X FROM (SELECT ...) WHERE [simple_condition]这种结构复杂,都是可能执行不成功的。

TIME 数据类型的字段不支持GROUP BY条件和HISTOGRAM函数

如以下查询是错误的:

SELECT count(*) FROM test GROUP BY CAST(date_created AS TIME);


SELECT HISTOGRAM(CAST(birth_date AS TIME), INTERVAL '10' MINUTES) as h, COUNT(*) FROM t GROUP BY h

但是将 TIME 类型的字段包装为Scalar函数返回是支持 GROUP BY 的,如:

SELECT count(*) FROM test GROUP BY MINUTE((CAST(date_created AS TIME));

返回字段的限制 如果一个字段不在 source 中存储,是无法查询到的。keyword, date, scaled_float, geo_point, geo_shape这些类型的字段不受这种限制,因为他们不是从_source中返回,而是从docvalue_fields中返回。

以上就是W3Cschool编程狮关于查询ElasticSearch:用SQL代替DSL的相关介绍了,希望对大家有所帮助。
(ES5版)深入理解 JavaScript 执行上下文和执行栈

thbcm阅读(447)

文章来源于公众号:前端桃园 ,作者桃翁

最近在研究 JavaScript 基础性的东西,但是看到对于执行上下文的解释我发现有两种,一种是执行上下文包含:scope(作用域)、variable object(变量对象)、this value(this 值),另外一个种是包含:lexical environment(词法环境)、variable environment(变量环境)、this value(this 值)。

后面我查阅了不少博客以及 ES3 和 ES5 的规范才了解到,第一种是 ES3 的规范,经典书籍《JavaScript 高级程序设计》第三版就是这样解释的,也是网上广为流传的一种,另一种是 ES5 的规范。

然后我接着又去翻了 ES2018 中的,发现又有变化了,已经增加了更多的内容了,考虑到这部分内容颇为复杂,准备后面再进行总结分享,查资料的时候看到这篇讲执行上下文(ES5 )的还不错,所以就翻译出来先分享给大家。

以后看到变量对象、活动对象知道是 ES3 里面的内容,而如果是词法环境、变量环境这种词就是 ES5 以后的内容。

以下是正文:

什么是执行上下文?

简而言之,执行上下文是计算和执行 JavaScript 代码的环境的抽象概念。每当 JavaScript 代码在运行的时候,它都是在执行上下文中运行。

执行上下文的类型

JavaScript 中有三种执行上下文类型。

  • 全局执行上下文 — 这是默认或者说基础的上下文,任何不在函数内部的代码都在全局上下文中。它会执行两件事:创建一个全局的 window 对象(浏览器的情况下),并且设置 this 的值等于这个全局对象。一个程序中只会有一个全局执行上下文。
  • 函数执行上下文 — 每当一个函数被调用时, 都会为该函数创建一个新的上下文。每个函数都有它自己的执行上下文,不过是在函数被调用时创建的。函数上下文可以有任意多个。每当一个新的执行上下文被创建,它会按定义的顺序(将在后文讨论)执行一系列步骤。
  • Eval 函数执行上下文 — 执行在 eval 函数内部的代码也会有它属于自己的执行上下文,但由于 JavaScript 开发者并不经常使用 eval,所以在这里我不会讨论它。

执行栈

执行栈,也就是在其它编程语言中所说的“调用栈”,是一种拥有 LIFO(后进先出)的数据结构,被用来存储代码运行时创建的所有执行上下文。

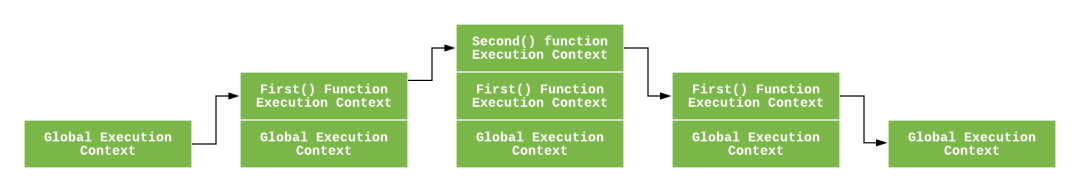
当 JavaScript 引擎第一次遇到你的脚本时,它会创建一个全局的执行上下文并且压入当前执行栈。每当引擎遇到一个函数调用,它会为该函数创建一个新的执行上下文并压入栈的顶部。

引擎会执行处于栈顶的执行上下文的函数。当该函数执行结束时,执行上下文从栈中弹出,控制流程到达当前栈中的下一个上下文。

让我们通过下面的代码示例来理解:

let a = 'Hello World!';


functionfirst() {
  console.log('Inside first function');
  second();
  console.log('Again inside first function');
}


functionsecond() {
  console.log('Inside second function');
}


first();
console.log('Inside Global Execution Context');

当上述代码在浏览器加载时,JavaScript 引擎创建了一个全局执行上下文并把它压入当前执行栈。当遇到 first() 函数调用时,JavaScript 引擎为该函数创建一个新的执行上下文并把它压入当前执行栈的顶部。

当从 first() 函数内部调用 second() 函数时,JavaScript 引擎为 second() 函数创建了一个新的执行上下文并把它压入当前执行栈的顶部。当 second() 函数执行完毕,它的执行上下文会从当前栈弹出,并且控制流程到达下一个执行上下文,即 first() 函数的执行上下文。

当 first() 执行完毕,它的执行上下文从栈弹出,控制流程到达全局执行上下文。一旦所有代码执行完毕,JavaScript 引擎从当前栈中移除全局执行上下文。

怎么创建执行上下文?

到现在,我们已经看过 JavaScript 怎样管理执行上下文了,现在让我们了解 JavaScript 引擎是怎样创建执行上下文的。

创建执行上下文有两个阶段:1) 创建阶段 和 2) 执行阶段。

创建阶段

在 JavaScript 代码执行前,执行上下文将经历创建阶段。在创建阶段会发生三件事:

  1. this 值的决定,即我们所熟知的 this 绑定。
  2. 创建词法环境组件。
  3. 创建变量环境组件。

所以执行上下文在概念上表示如下:

ExecutionContext = {
  ThisBinding = <this value>,
  LexicalEnvironment = { ... },
  VariableEnvironment = { ... },
}

this 绑定:**

在全局执行上下文中,this 的值指向全局对象。(在浏览器中,this引用 Window 对象)。

在函数执行上下文中,this 的值取决于该函数是如何被调用的。如果它被一个引用对象调用,那么 this 会被设置成那个对象,否则 this 的值被设置为全局对象或者 undefined(在严格模式下)。例如:

let foo = {
  baz: function() {
  console.log(this);
  }
}


foo.baz();   // 'this' 引用 'foo', 因为 'baz' 被
             // 对象 'foo' 调用


let bar = foo.baz;


bar();       // 'this' 指向全局 window 对象,因为
             // 没有指定引用对象

词法环境

官方的 ES6 文档把词法环境定义为

词法环境是一种规范类型,基于 ECMAScript 代码的词法嵌套结构来定义标识符和具体变量和函数的关联。一个词法环境由环境记录器和一个可能的引用outer词法环境的空值组成。

简单来说词法环境是一种持有标识符—变量映射的结构。(这里的标识符指的是变量/函数的名字,而变量是对实际对象[包含函数类型对象]或原始数据的引用)。

现在,在词法环境的内部有两个组件:(1) 环境记录器和 (2) 一个外部环境的引用。

  1. 环境记录器是存储变量和函数声明的实际位置。
  2. 外部环境的引用意味着它可以访问其父级词法环境(作用域)。

译者注:外部环境已经跟 ES3 规定的作用域的作用类似

词法环境有两种类型:

  • 全局环境(在全局执行上下文中)是没有外部环境引用的词法环境。全局环境的外部环境引用是null。它拥有内建的 Object/Array/等、在环境记录器内的原型函数(关联全局对象,比如 window 对象)还有任何用户定义的全局变量,并且 this的值指向全局对象。
  • 在函数环境中,函数内部用户定义的变量存储在环境记录器中。并且引用的外部环境可能是全局环境,或者任何包含此内部函数的外部函数。

环境记录器也有两种类型(如上!):

  1. 声明式环境记录器存储变量、函数和参数。
  2. 对象环境记录器用来定义出现在全局上下文中的变量和函数的关系。

简而言之,

  • 在全局环境中,环境记录器是对象环境记录器。
  • 在函数环境中,环境记录器是声明式环境记录器。

注意 — 对于函数环境,声明式环境记录器还包含了一个传递给函数的 arguments 对象(此对象存储索引和参数的映射)和传递给函数的参数的 length。

抽象地讲,词法环境在伪代码中看起来像这样:

GlobalExectionContext = {
  LexicalEnvironment: {
    EnvironmentRecord: {
      Type: "Object",
      // 在这里绑定标识符
    }
    outer: <null>
  }
}


FunctionExectionContext = {
  LexicalEnvironment: {
    EnvironmentRecord: {
      Type: "Declarative",
      // 在这里绑定标识符
    }
    outer: <Global or outer function environment reference>
  }
}

变量环境:

它同样是一个词法环境,其环境记录器持有变量声明语句在执行上下文中创建的绑定关系。

如上所述,变量环境也是一个词法环境,所以它有着上面定义的词法环境的所有属性。

在 ES6 中,词法环境组件和变量环境的一个不同就是前者被用来存储函数声明和变量(let 和 const)绑定,而后者只用来存储 var 变量绑定。

我们看点样例代码来理解上面的概念:

let a = 20;
const b = 30;
var c;


function multiply(e, f) {
 var g = 20;
 return e * f * g;
}


c = multiply(20, 30);

执行上下文看起来像这样:

GlobalExectionContext = {


  ThisBinding: <Global Object>,


  LexicalEnvironment: {
    EnvironmentRecord: {
      Type: "Object",
      // 在这里绑定标识符
      a: < uninitialized >,
      b: < uninitialized >,
      multiply: < func >
    }
    outer: <null>
  },


  VariableEnvironment: {
    EnvironmentRecord: {
      Type: "Object",
      // 在这里绑定标识符
      c: undefined,
    }
    outer: <null>
  }
}


FunctionExectionContext = {
  ThisBinding: <Global Object>,


  LexicalEnvironment: {
    EnvironmentRecord: {
      Type: "Declarative",
      // 在这里绑定标识符
      Arguments: {0: 20, 1: 30, length: 2},
    },
    outer: <GlobalLexicalEnvironment>
  },


VariableEnvironment: {
    EnvironmentRecord: {
      Type: "Declarative",
      // 在这里绑定标识符
      g: undefined
    },
    outer: <GlobalLexicalEnvironment>
  }
}

注意 — 只有遇到调用函数 multiply 时,函数执行上下文才会被创建。

可能你已经注意到 let 和 const 定义的变量并没有关联任何值,但 var 定义的变量被设成了undefined。

这是因为在创建阶段时,引擎检查代码找出变量和函数声明,虽然函数声明完全存储在环境中,但是变量最初设置为 undefined(var 情况下),或者未初始化(let 和 const 情况下)。

这就是为什么你可以在声明之前访问 var 定义的变量(虽然是 undefined),但是在声明之前访问 let 和 const 的变量会得到一个引用错误。

这就是我们说的变量声明提升。

执行阶段

这是整篇文章中最简单的部分。在此阶段,完成对所有这些变量的分配,最后执行代码。

注意 — 在执行阶段,如果 JavaScript 引擎不能在源码中声明的实际位置找到 let 变量的值,它会被赋值为 undefined。

结论

我们已经讨论过 JavaScript 程序内部是如何执行的。虽然要成为一名卓越的 JavaScript 开发者并不需要学会全部这些概念,但是如果对上面概念能有不错的理解将有助于你更轻松,更深入地理解其他概念,如变量声明提升,作用域和闭包。

以上就是W3Cschool编程狮关于(ES5版)深入理解 JavaScript 执行上下文和执行栈的相关介绍了,希望对大家有所帮助。
这10个有用的HTML5功能,你肯定没用过!

thbcm阅读(448)

文章来源于公众号:前端人

HTML5 不是新事物。自从最初发布(2008年1月)以来,我们一直在使用它的一些功能。今天给大家分享的是一些让你意想不到的效果,和特性!到目前为止,我还没有真正使用过它!

在本文中,我列出了十个 HTML5 我过去没用过但现在发现有用的功能。

1.输出标签

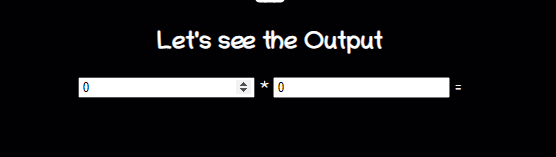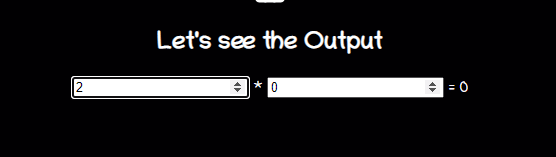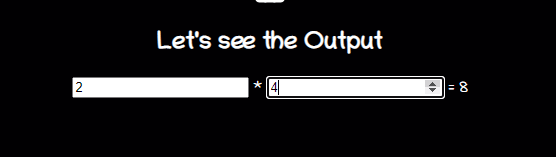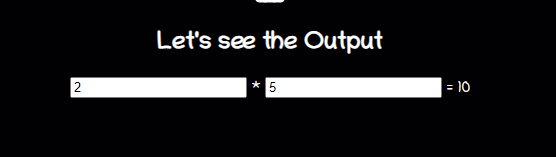
<output>标签表示的运算的结果。通常,此元素定义一个区域,该区域将用于显示某些计算得出的文本。

代码如下:

<form oninput="x.value=parseInt(a.value) * parseInt(b.value)">
   <input type="number" id="a" value="0">
          * <input type="number" id="b" value="0">
                = <output name="x" for="a b"></output>
</form>

效果如下:

小小提示

如果您要在客户端JavaScript中执行任何计算,并且希望结果反映在页面上,请使用<output>标记。您不必走动使用即可获取元素的额外步骤getElementById()。

2.详细信息标签

该<details>标签提供随需应变的细节给用户。如果需要按需向用户显示内容,请使用此标记。默认情况下,小部件是关闭的。打开后,它将展开并显示其中的内容。

该<summary>标签使用<details>来为它指定一个可见的标题。

代码如下:

<details>
  <summary>Click Here to get the user details</summary>
   <table>
      <tr>
          <th>#</th>
          <th>Name</th>
          <th>Location</th>
          <th>Job</th>
      </tr>
      <tr>
          <td>1</td>
          <td>Adam</td>
          <td>Huston</td>
          <td>UI/UX</td>
      </tr>
    </table>
</details>

效果如下:

3.内容可编辑

contenteditable属性是可以在元素上设置以使内容可编辑的属性。它可与DIV,P,UL等元素一起使用。使用方法如下:

<element contenteditable="true|false"/>

注意,如果contenteditable未在元素上设置,则会从其父级继承该属性。

代码如下:

<h2> Shoppping List(Content Editable) </h2>
 <ul class="content-editable" contenteditable="true">
     <li> 1. Milk </li>
     <li> 2. Bread </li>
     <li> 3. Honey </li>
</ul>

效果如下:

小小提示

可以使span或div元素可编辑,并且可以使用css样式向其添加任何丰富的内容。这将比使用输入字段处理它更好。试试看!

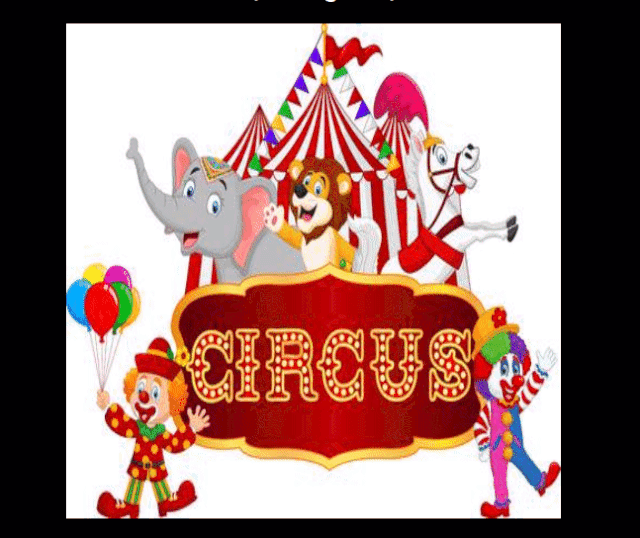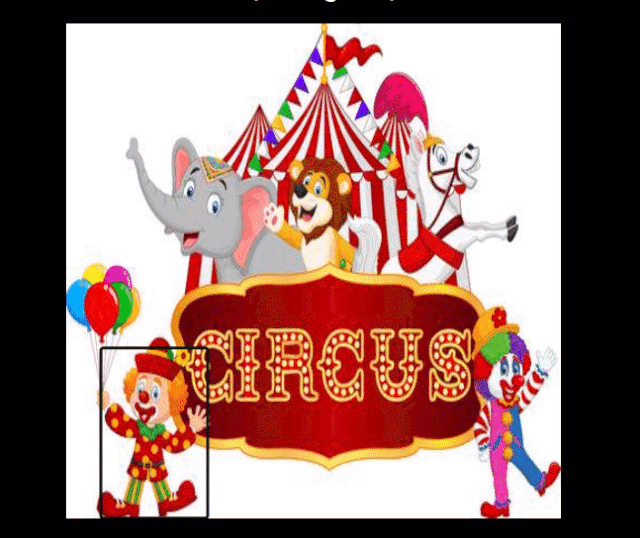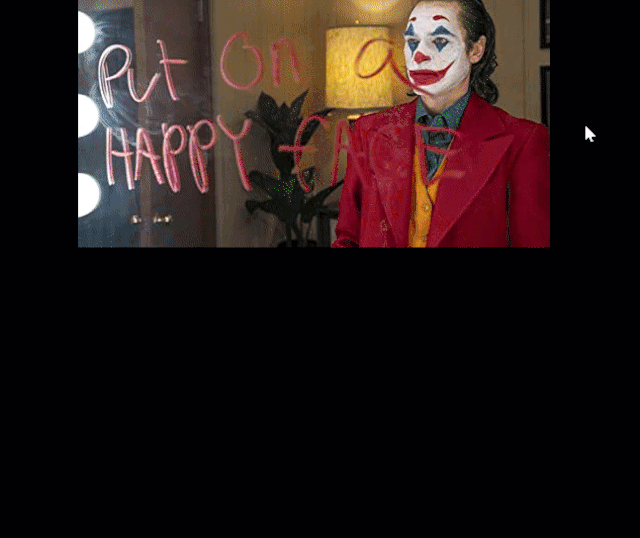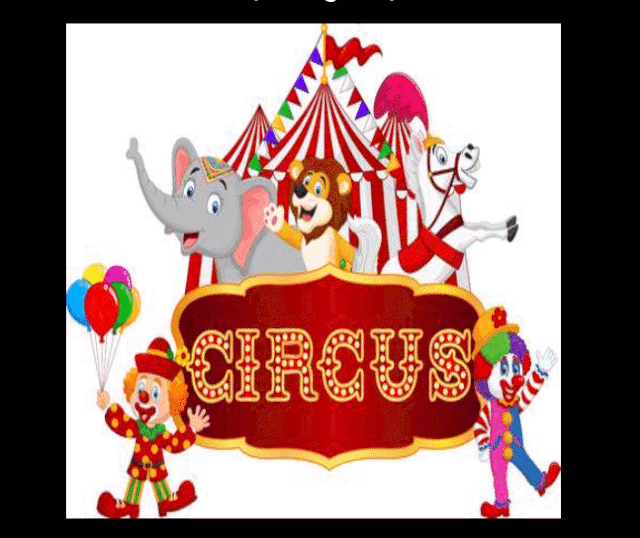
4.地图

该<map>标签可以帮助定义图像映射。图像映射是其中具有一个或多个可单击区域的任何图像。map标签与<area>标签一起确定可点击区域。可点击区域可以是矩形,圆形或多边形区域中的任意一种。如果未指定任何形状,它将考虑整个图像。

代码如下:

<div>
    <img src="circus.jpg" width="500" height="500" alt="Circus" usemap="#circusmap">
    <map name="circusmap">
        <area shape="rect" coords="67,114,207,254" href="elephant.htm">
        <area shape="rect" coords="222,141,318, 256" href="lion.htm">
        <area shape="rect" coords="343,111,455, 267" href="horse.htm">
        <area shape="rect" coords="35,328,143,500" href="clown.htm">
        <area shape="circle" coords="426,409,100" href="clown.htm">
    </map>
 </div>

效果如下:

小小提示

图像贴图有其自身的缺点,但是您可以将其用于视觉演示。如何用全家福照片尝试一下并深入研究个人照片(可能是我们一直以来都怀有的旧照片!)。

5.标记内容

使用<mark>标记突出显示任何文本内容。

代码如下:

 <p> 我为何这么帅? <mark>"这该死的魅力"</mark> 是吗? </p>

效果如下:

小小提示

您还可以使用CSS更改突出显示颜色,标记功能确实能够做出很多有意思的东西!

mark {
  background-color: green;
  color: #FFFFFF;
}

6.data- *属性

这些data-*属性用于存储页面或应用程序专用的自定义数据。可以在JavaScript代码中使用存储的数据来创建更多的用户体验。

data- *属性由两部分组成:

  • 属性名称不得包含任何大写字母,并且前缀“ data-”后必须至少长一个字符
  • 属性值可以是任何字符串

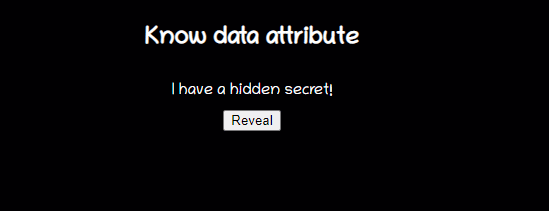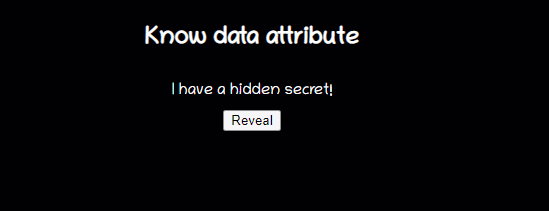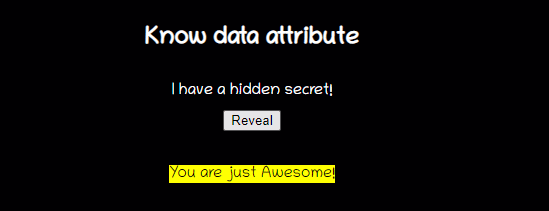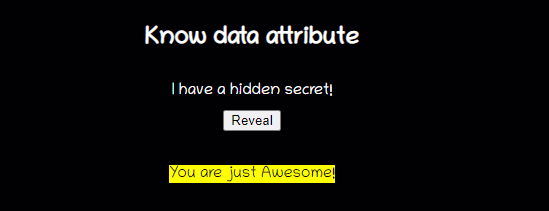
代码如下:

<h2> 你准备好了吗 </h2>
 <div class="data-attribute" 
      id="data-attr" 
      data-custom-attr="You are just Awesome!"> 
      我有个秘密!
  </div>
 <button onclick="reveal()">点击看我的咪咪</button>
function reveal() {
   let dataDiv = document.getElementById('data-attr');
    let value = dataDiv.dataset['customAttr'];
   document.getElementById('msg').innerHTML = `<mark>${value}</mark>`;
}

效果如下:

小小提示

要在JavaScript中读取这些属性的值,可以使用getAttribute()它们的完整HTML名称(即data-custom-attr),但是该标准定义了一种更简单的方法:使用dataset属性。

7.数据清单

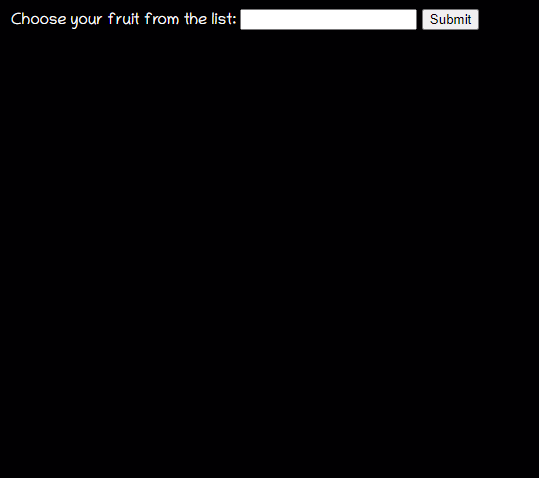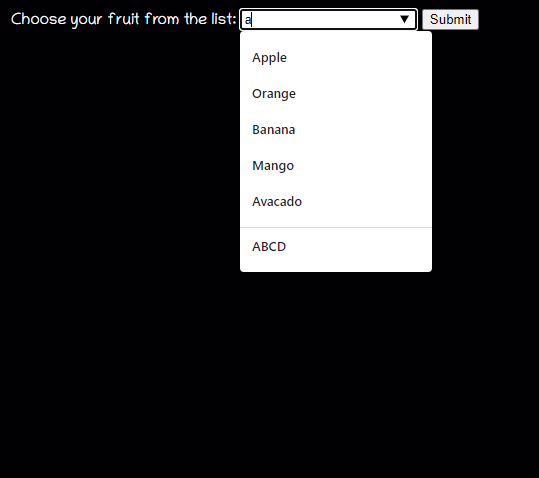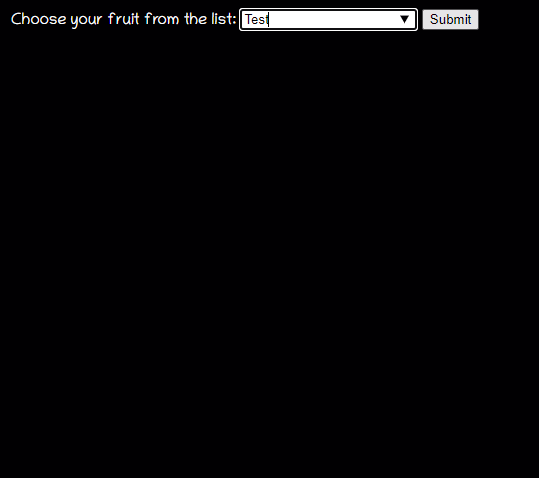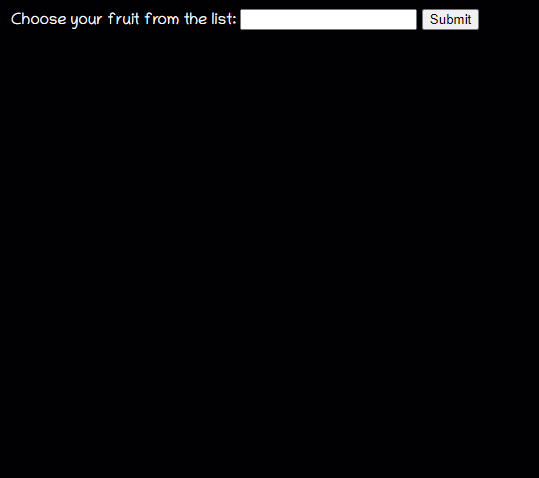
<datalist>标签指定的预先定义的选项列表,并允许用户添加更多了。它提供了一项autocomplete功能,使您可以提前输入所需的选项

代码如下:

<form action="" method="get">
    <label for="fruit">从列表中选择你的水果:</label>
    <input list="fruits" name="fruit" id="fruit">
        <datalist id="fruits">
           <option value="Apple">
           <option value="Orange">
           <option value="Banana">
           <option value="Mango">
           <option value="Avacado">
        </datalist>
     <input type="submit">
 </form>  

效果如下:

小小提示

与传统<select>-<option>标签有何不同?选择标记用于从选项中选择一个或多个项目,您需要浏览列表以进行选择。Datalist是具有自动完成功能的高级功能。

8.范围(滑块)

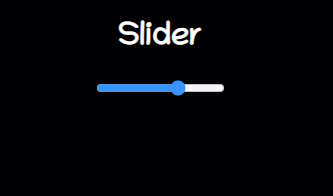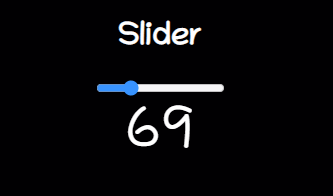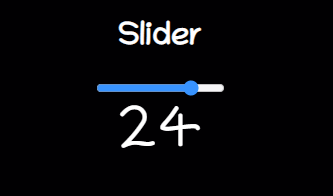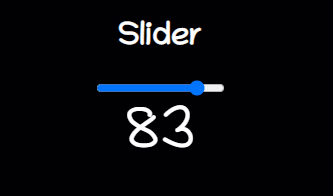
range是给定的一个样滑块范围选择的输入类型。

代码如下:

<form method="post">
    <input type="range" 
           name="range" 
           min="0" 
           max="100" 
           step="1" 
           value=""
           onchange="changeValue(event)"/>
 </form>
 <div class="range">
      <output id="output" name="result">  </output>
 </div> 

小小提示

sliderHTML5中没有任何毛病

9.测量标签

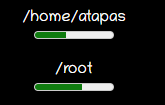
使用<meter>标签测量给定范围内的数据。

代码如下:

<label for="home">/home/atapas</label>
<meter id="home" value="4" min="0" max="10">2 out of 10</meter><br>


<label for="root">/root</label>
<meter id="root" value="0.6">60%</meter><br>

效果如下:

小小提示

不要将<meter>标签用于进度指示器,以实现用户体验。我们有<Progress>HTML5 的标记。

<label for="file">Downloading progress:</label>
<progress id="file" value="32" max="100"> 32% </progress>

10.输入(这个没什么新鲜的,凑数吧!)

我们最了解这部分的用法,例如文本,密码等输入类型。输入类型的特殊用法很少,

必填

将输入字段标记为必填

<input type="text" id="username1" name="username" required>

效果如下:

自动对焦

通过将光标放在输入元素上来自动将焦点放在输入元素上。

<input type="text" id="username2" name="username" required autofocus>

正则表达式验证

您可以使用正则表达式指定模式以验证输入。

<input type="password" 
       name="password" 
       id="password" 
       placeholder="6-20 chars, at least 1 digit, 1 uppercase and one lowercase letter" 
       pattern="^(?=.*\d)(?=.*[a-z])(?=.*[A-Z]).{6,20}$" autofocus required>

选色器

<input type="color" onchange="showColor(event)">
<p id="colorMe">Color Me!</p>

以上就是W3Cschool编程狮关于这10个有用的HTML5功能,你肯定没用过!的相关介绍了,希望对大家有所帮助。
OkHttp透明压缩,收获性能10倍,外加故障一枚

thbcm阅读(397)

文章来源于公众号:小姐姐味道 ,作者小姐姐养的狗

要使用OkHttp,一定要知道它的透明压缩,否则死都不知道怎么死的;或者活也不知道为什么活的不舒坦。

反正不是好事。

什么叫透明压缩呢?OkHttps 在发送请求的时候,会自动加入 gzip 请求头Accept-Encoding:gzip。所以,当返回的数据带有 gzip 响应头时Content-Encoding=gzip,OkHttps 会自动帮我们解压数据。(Accept-Encoding和Content-Encoding是一对请求头,分别对应着请求和返回)

为什么要进行压缩呢?因为它能大幅减少传输的容量。像一些 CPU 资源占用不高的服务,比如 Kafka ,我们就可以开启 gzip 压缩,加快信息的流转。

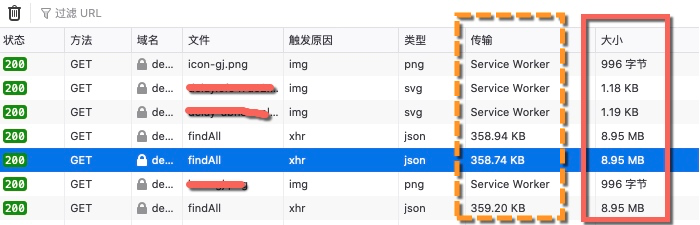
这个压缩比有多高呢?可以看下下面实实在在的截图,对于普通的xml或者json,数据可以由9MB压缩到350KB左右,压缩比足足达到了26。

它让系统性能飞起来

SpringCloud微服务体系,现在有非常多的公司在用。即使是一些传统企业,一些大数据量的toB企业,也想尝一尝螃蟹。

对于一个简单的 SpringBoot 服务,我们只需要在 yml 文件中配置上相应的压缩就可以了。这样,我们就打通了浏览器到 Web 服务的这一环。这种压缩方式,对于大数据量的服务来说,是救命式的!

具体配置如下。

server:
  port: 8082
  compression:
    enabled: true
    min-response-size: 1024
    mime-types: ["text/html","text/xml","application/xml","application/json","application/octet-stream"]

它所对应的 Spring 配置类是org.springframework.boot.web.server.Compression。

但是不要高兴太早。由于是分布式环境,这里面调用链就会长一些。即使是在内网,动辄十几MB的网络传输,也会耗费可观的时间。

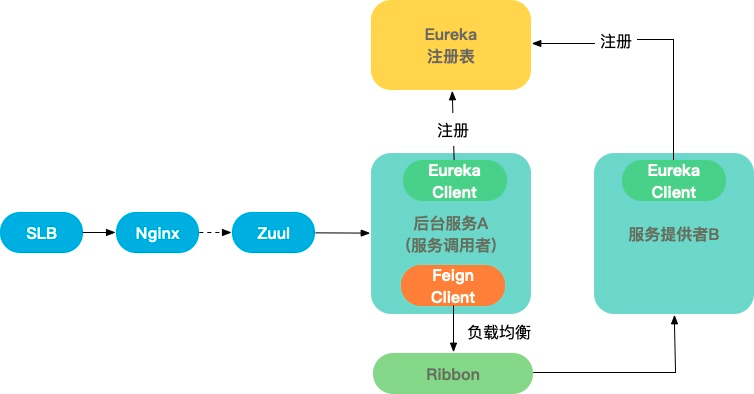
如上图,一个请求从浏览器到达真正的服务节点,可能要经过很多环节。

  • nginx转发请求到微服务网关zuul
  • zuul转发到具体的微服务A
  • 微服务A通过Feign接口调用微服务B

如果我们的数据,大多数是由微服务B提供的,那么上面的任何一个环节传输效率慢,都会影响请求的性能。

所以,我们需要开启 Feign 接口的 gzip 压缩。使用 OkHttps 的透明代理是最简单的方式。

首先,在项目中引入 feign 的 jar 包。

<dependency>
            <groupId>io.github.openfeign</groupId>
            <artifactId>feign-okhttp</artifactId>
</dependency>

其次,在 yml 文件中启用 OkHttps 作为 feign 的客户端请求工具包。稳妥起见,我们同时屏蔽了 httpclient ,这个东西太重太老了。

feign:
  httpclient:
    enabled: false
  okhttp:
    enabled: true

到此为止,我们就可以享受 OkHttps 的透明代理带来的便捷性了。

假如你的应用数据包大,调用链长,这种方式甚至会给你的服务带来数秒的性能提升。 xjjdog 就曾经靠调整几个参数,就让一个蜗牛系统飞了起来。大家惊呼:原来B端也可以C一下。

OkHttp是如何实现透明压缩的?

OkHttps 对于透明压缩的处理,是通过拦截器来做的。具体的类,就是okhttp3.internal.http.BridgeInterceptor。

具体代码如下,当判断没有Accept-Encoding头的时候,就自行加入一个。

// If we add an "Accept-Encoding: gzip" header field we're responsible for also decompressing
// the transfer stream.
boolean transparentGzip = false;
if (userRequest.header("Accept-Encoding") == null && userRequest.header("Range") == null) {
  transparentGzip = true;
  requestBuilder.header("Accept-Encoding", "gzip");
}

最关键的代码在下面。

if (transparentGzip
    && "gzip".equalsIgnoreCase(networkResponse.header("Content-Encoding"))
    && HttpHeaders.hasBody(networkResponse)) {
  GzipSource responseBody = new GzipSource(networkResponse.body().source());
  Headers strippedHeaders = networkResponse.headers().newBuilder()
      .removeAll("Content-Encoding")
      .removeAll("Content-Length")
      .build();
  responseBuilder.headers(strippedHeaders);
  String contentType = networkResponse.header("Content-Type");
  responseBuilder.body(new RealResponseBody(contentType, -1L, Okio.buffer(responseBody)));
}

可以看到if语句里,有三个条件。

  • 程序没有设置Accept-Encoding,启用了透明压缩
  • 服务端有Content-Encoding头,并启用了gzip压缩
  • 有数据包

只有同时满足这三个条件,OkHttps 的透明压缩才会起作用,帮我们自动解压。

它挖的坑有点深

可惜的是,上面的关键代码,只有if,没有else,也就是当其中的任何一个条件不满足,后端的数据包将原封不动的返回。

2、3两个条件是没有什么问题的,原样返回后端数据并没有什么损害,问题就出在第一个条件里。

如果你在代码中,使用了下面的代码:

Request.Builder builder = chain.request()
                .newBuilder()
                .addHeader("Accept", "application/json")
                .addHeader("Accept-Encoding", "gzip");

也就是手动设置了Accept-Encoding头信息。这很常见,因为这体现了程序员思维的严谨。

正是这种严谨,造成了问题。

假如你的后端应用刚开始是没有开启gzip压缩的,这时候两者相安无事;但如果你的后端应用突然有一天开启了gzip压缩,你的这段代码将全部over。

原因就是,服务端gzip数据包会原样返回,你需要手动处理gzip数据包。

所以,不加是好事,加了反而会坏事,除非你想自己处理gzip数据。

由于OkHttp在Android上应用也非常广泛,如果你不知道这个细节,造成的后果就是灾难性的。客户端更新慢,只能老老实实回退服务端了。

智能的背后,总有些肉眼不可见的细节。就像是xjjdog纯情的背后,总有一份羞涩。只有深入了解,你才会知道它的美。

以上就是W3Cschool编程狮关于OkHttp透明压缩,收获性能10倍,外加故障一枚的相关介绍了,希望对大家有所帮助。

API 接口,统一格式返回!你学到了么

thbcm阅读(380)

文章来源于公众号:Java旅途

前言

在移动互联网,分布式、微服务盛行的今天,现在项目绝大部分都采用的微服务框架,前后端分离方式,(题外话:前后端的工作职责越来越明确,现在的前端都称之为大前端,技术栈以及生态圈都已经非常成熟;以前后端人员瞧不起前端人员,那现在后端人员要重新认识一下前端,前端已经很成体系了)。

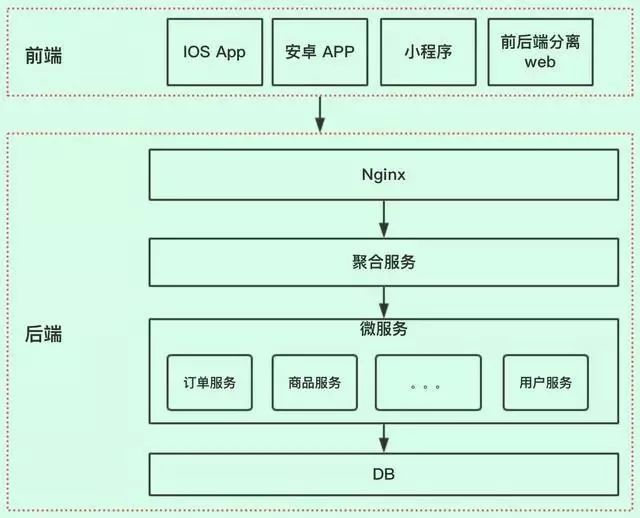
一般系统的大致整体架构图如下:

需要说明的是,有些小伙伴会回复说,这个架构太简单了吧,太low了,什么网关啊,缓存啊,消息中间件啊,都没有。因为老顾这篇主要介绍的是API接口,所以我们聚焦点,其他的模块小伙伴们自行去补充。

接口交互

前端和后端进行交互,前端按照约定请求URL路径,并传入相关参数,后端服务器接收请求,进行业务处理,返回数据给前端。

针对URL路径的restful风格,以及传入参数的公共请求头的要求(如:app_version,api_version,device等),老顾这里就不介绍了,小伙伴们可以自行去了解,也比较简单。

后端服务器如何实现把数据返回给前端?

返回格式

后端返回给前端我们一般用 JSON 体方式,定义如下:

{
  #返回状态码
  code:integer,
  #返回信息描述
  message:string,
  #返回值
  data:object
}

CODE状态码

code 返回状态码,一般小伙伴们是在开发的时候需要什么,就添加什么。

如接口要返回用户权限异常,我们加一个状态码为101吧,下一次又要加一个数据参数异常,就加一个102的状态码。这样虽然能够照常满足业务,但状态码太凌乱了

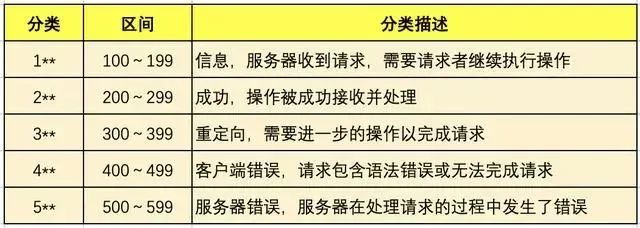
我们应该可以参考 HTTP 请求返回的状态码

:下面是常见的HTTP状态码:
200 - 请求成功
301 - 资源(网页等)被永久转移到其它URL
404 - 请求的资源(网页等)不存在
500 - 内部服务器错误

我们可以参考这样的设计,这样的好处就把错误类型归类到某个区间内,如果区间不够,可以设计成4位数。

#1000~1999 区间表示参数错误
#2000~2999 区间表示用户错误
#3000~3999 区间表示接口异常

这样前端开发人员在得到返回值后,根据状态码就可以知道,大概什么错误,再根据 message 相关的信息描述,可以快速定位。

Message

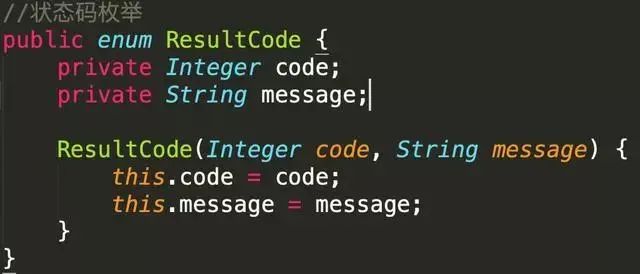
这个字段相对理解比较简单,就是发生错误时,如何友好的进行提示。一般的设计是和code状态码一起设计,如

再在枚举中定义,状态码

状态码和信息就会一一对应,比较好维护。

Data

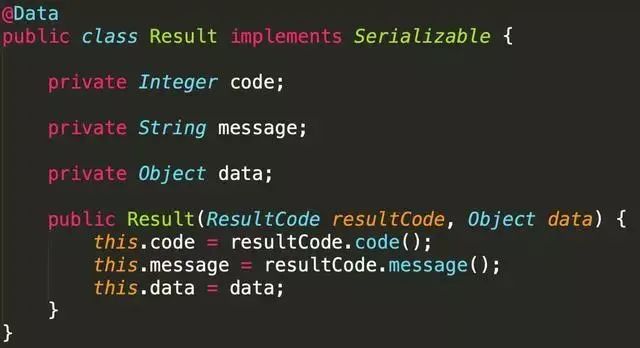
返回数据体,JSON 格式,根据不同的业务又不同的 JSON 体。

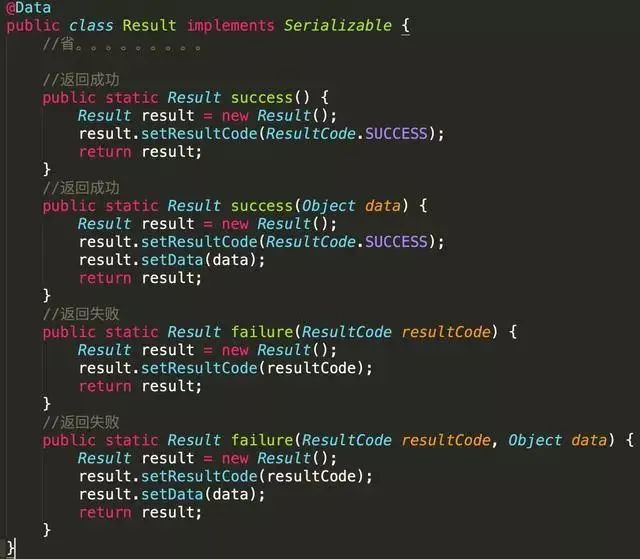
我们要设计一个返回体类 Result

控制层Controller

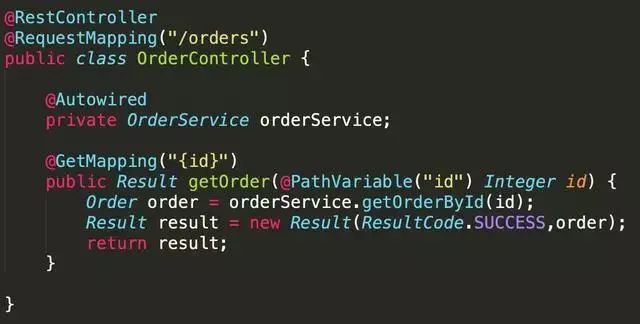
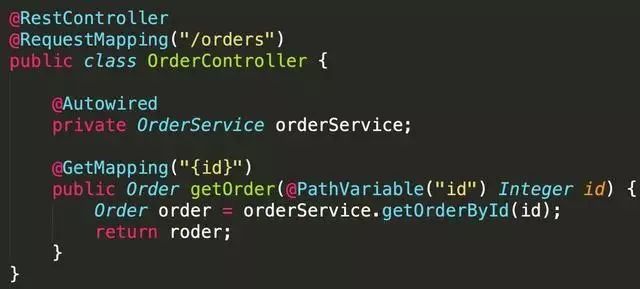
我们会在controller层处理业务请求,并返回给前端,以order订单为例

我们看到在获得 order 对象之后,我们是用的 Result 构造方法进行包装赋值,然后进行返回。小伙伴们有没有发现,构造方法这样的包装是不是很麻烦,我们可以优化一下。

美观美化

我们可以在 Result 类中,加入静态方法,一看就懂

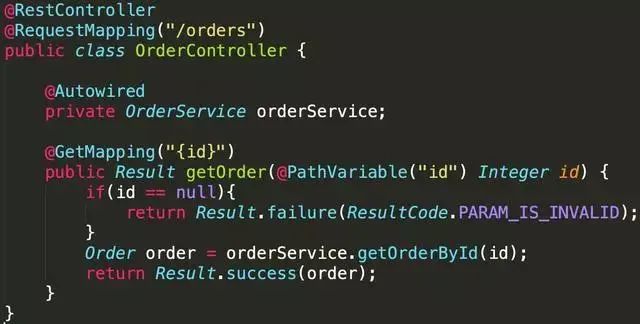
那我们来改造一下 Controller

代码是不是比较简洁了,也美观了。

优雅优化

上面我们看到在 Result 类中增加了静态方法,使得业务处理代码简洁了。但小伙伴们有没有发现这样有几个问题:

1、每个方法的返回都是Result封装对象,没有业务含义

2、在业务代码中,成功的时候我们调用Result.success,异常错误调用Result.failure。是不是很多余

3、上面的代码,判断id是否为null,其实我们可以使用hibernate validate做校验,没有必要在方法体中做判断。

我们最好的方式直接返回真实业务对象,最好不要改变之前的业务方式,如下图

这个和我们平时的代码是一样的,非常直观,直接返回 order 对象,这样是不是很完美。那实现方案是什么呢?

实现方案

小伙伴们怎么去实现是不是有点思路,在这个过程中,我们需要做几个事情

1、定义一个注解@ResponseResult,表示这个接口返回的值需要包装一下

2、拦截请求,判断此请求是否需要被@ResponseResult注解

3、核心步骤就是实现接口ResponseBodyAdvice和@ControllerAdvice,判断是否需要包装返回值,如果需要,就把Controller接口的返回值进行重写。

注解类

用来标记方法的返回值,是否需要包装

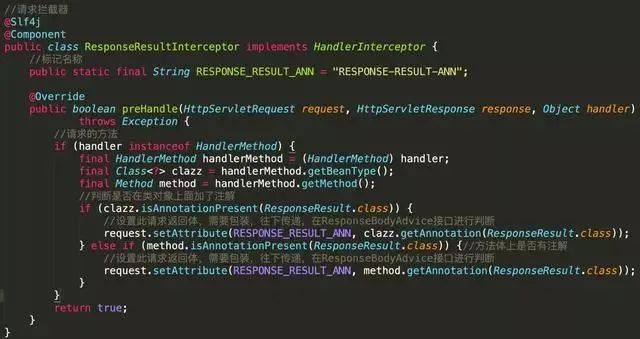
拦截器

拦截请求,是否此请求返回的值需要包装,其实就是运行的时候,解析 @ResponseResult 注解

此代码核心思想,就是获取此请求,是否需要返回值包装,设置一个属性标记。

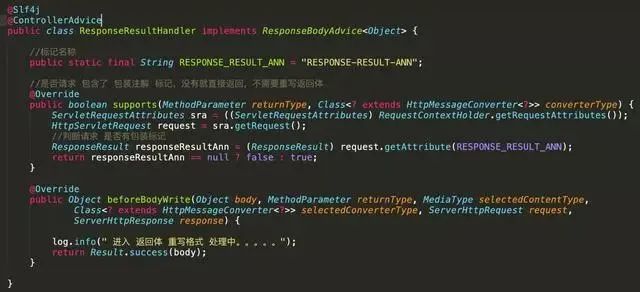
重写返回体

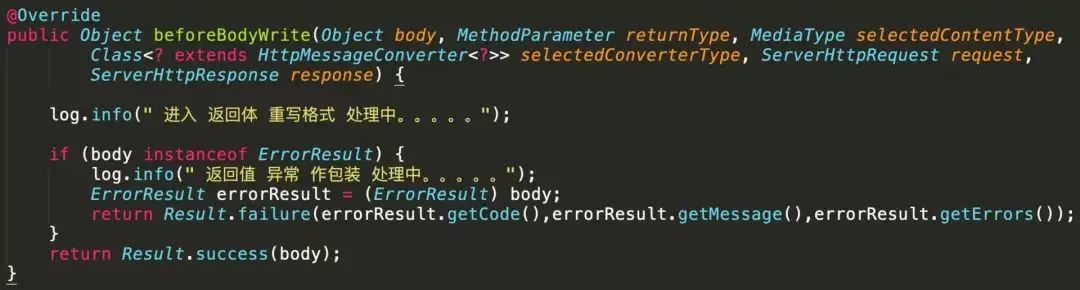
上面代码就是判断是否需要返回值包装,如果需要就直接包装。这里我们只处理了正常成功的包装,如果方法体报异常怎么办?处理异常也比较简单,只要判断 body 是否为异常类。

怎么做全局的异常处理,篇幅原因,老顾这里就不做介绍了,只要思路理清楚了,自行改造就行。

重写Controller

在控制器类上或者方法体上加上 @ResponseResult 注解,这样就 ok 了,简单吧。到此返回的设计思路完成,是不是又简洁,又优雅。

这个方案还有没有别的优化空间,当然是有的。如:每次请求都要反射一下,获取请求的方法是否需要包装,其实可以做个缓存,不需要每次都需要解析。当然整体思路了解,小伙伴们就可以在此基础上面自行扩展。

以上就是W3Cschool编程狮关于API 接口,统一格式返回!你学到了么的相关介绍了,希望对大家有所帮助。
Vue3.0版本发布,让我们看看有什么更新

thbcm阅读(409)

文章来源于公众号:前端森林

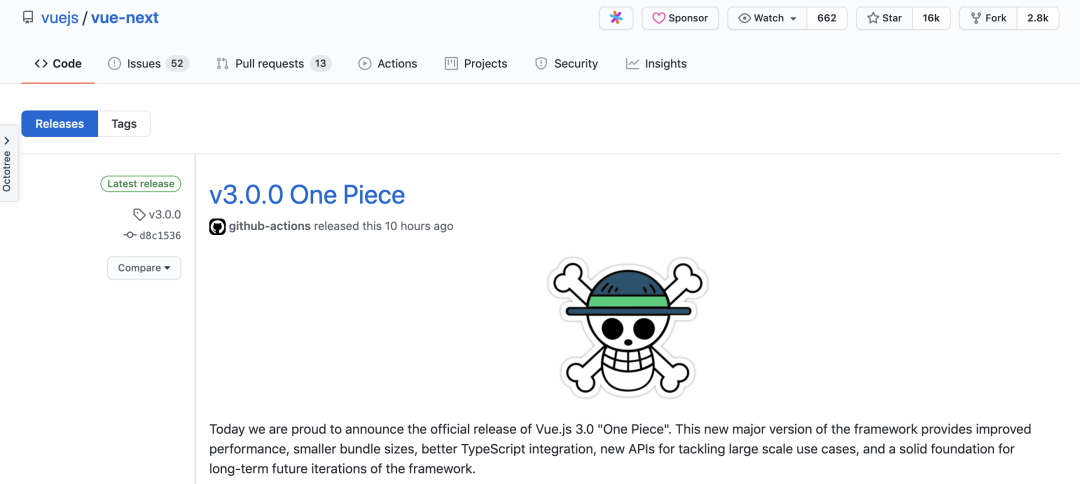
Vue 官方团队终于发布了Vue3.0版本,就在 2020 年 9 月 18 日晚 11 点半左右,代号为One Piece。

其实Vue3.0版本发布的消息,我是昨天晚上刷朋友圈看到的(已经差不多凌晨 1 点了),然后我就立刻起来,打开电脑,看了一下github,把官方发布文档过了一遍。其实我感觉这次版本更新,最主要的还是Composition API以及对于TypeScript的支持,而且早在 4 月 21 日,尤大在 B 站关于Vue.js 3.0 Beta最新进展的分享上就已经提到了这些改动。

此次Vue3.0版本更新提供了改进的性能,更小的捆绑包大小,更好的TypeScript集成,以及用于处理大规模用例的新API,为框架的长期未来迭代奠定了坚实的基础。

这里我就参考官方releases给大家大概说一下主要更新(更详细的直接查看 releases docs):

进一步推进“渐进框架”概念

Vue一开始就秉承这样的原则:成为任何人都能快速学习且平易近人的框架。(时至今日,作为Vue的资深用户,我觉得他做到这一点了)。当然Vue3.0将这种灵活性进一步提升。

分层内部模块

Vue 3.0内核仍然可以通过一个简单的<script>标签使用,但其内部结构已被彻底重写为一组解耦的模块。新的体系结构提供了更好的可维护性,并允许最终用户通过tree-shaking来减少运行时体积大小的一半。

解决规模问题的新 API

Vue 3.0引入了Composition API一套全新的API,旨在解决大型应用程序中Vue使用的难点。Composition API建立在响应式API之上,与2.x基于对象的API方式相比,可实现类似于React Hook的逻辑组成和复用,拥有更灵活的代码组织模式以及更可靠的类型推断能力。

性能改进

与Vue 2相比,Vue 3在bundle包大小方面通过tree-shaking减轻了多达41%的体积),初始渲染速度加快了55%,更新速度提升了133%,内存使用率方面表现出了显著的性能改进最多可减少54%。

改进与TypeScript的兼容

Vue 3.0的代码库是用TypeScript编写的,具有自动生成、测试并构建类型声明。同时,Vue 3已全面支持TSX。

未来计划

紧接着,Vue官方团队计划要做的事情如下:

  • 迁移版本
  • IE11支持
  • 新devtools中的Router和Vuex集成
  • Vetur中模板类型推断的进一步改进

快速上手

如果你已经迫不及待的想去学习Vue3了呢,这里放上对应的链接:

参考

Vue 官方发布文档

以上就是W3Cschool编程狮关于Vue3.0版本发布,让我们看看有什么更新的相关介绍了,希望对大家有所帮助。
Vue3.0正式发布,本次发布所有总结,一起看看!

thbcm阅读(381)

文章来源于公众号:前端人 作者:鬼哥

2020年09月18日,Vue.js 3.0 正式发布。本次发布框架本身带来了几个大点的改进,以及功能和历程的一些总结!

1.Vue3.0历程

  • 3.0版本代表了2年多的开发工作
  • 具有30多个RFC
  • 2600多个提交
  • 来自99个贡献者
  • 628个拉取请求
  • 大量开发和文档工作

2.Vue的使命

成为任何人都可以快速学习的易于接近的框架

3.性能方面的优化

  • 路由懒加载
  • keep-alive缓存页面
  • 使用v-show复用DOM
  • v-for 遍历避免同时使用 v-if
  • 长列表性能优化
  • 事件的销毁
  • 图片懒加载
  • 第三方插件按需引入
  • 无状态的组件标记为函数式组件
  • 子组件分割
  • 变量本地化
  • SSR

4.更好的TypeScript集成

  • 改进的TypeScript支持,编辑器能提供强有力的类型检查和错误及警告
  • 更好的调试支持

5.用于处理大规模用例的新API

  • reactive
  • ref
  • computed
  • readonly
  • watchEffect
  • watch
  • unref
  • toRef
  • toRefs
  • isRef
  • isProxy
  • isReactive
  • isReadonly
  • customRef
  • markRaw
  • shallowReactive
  • shallowReadonly
  • shallowRef
  • toRaw

6.分层内部模块

Vue 3.0内核仍然可以通过一个简单的“标签使用,但其内部结构已被彻底重写为一组解耦的模块。新的体系结构提供了更好的可维护性,并允许最终用户通过摇树来减少运行时大小的一半。

模块如下:

模块提供的功能点:

1.编译器支持用于构建时自定义的自定义AST转换(例如,构建时i18n)

2.核心运行时提供API用于创建针对不同渲染目标(例如本机移动设备,WebGL或终端)的自定义渲染器。默认DOM渲染器使用相同的API构建。

3.该@vue/reactivity模块导出的功能可以直接访问Vue的反应系统,并且可以用作独立程序包。它可以与其他模板解决方案(例如lit-html)配对,甚至可以用于非UI方案。

7.composition-api设计目的

旨在解决大型应用程序中Vue使用的难点。Composition API建立在反应性API之上,与2.x基于对象的API相比,可实现类似于React挂钩的逻辑组成和重用,更灵活的代码组织模式以及更可靠的类型推断。

8.性能改进(相对Vue2)

  • 通过摇树(减轻了多达41%的资源大小)
  • 初始渲染(加快了多达55%的速度)
  • 更新速度:(加快了133%的速度)
  • 内存占用:(最多减少54%)

9.提供的两个实验性功能

用于在SFC中使用Composition API的语法糖

SFC中状态驱动的CSS变量

迁移3.0指南

10.兼容IE11

计划在2020年第四季度重点关注它们。因此,计划迁移现有v2应用程序的用户或者需要IE11支持人员此时应意识到这些限制。

11.后续计划

  • 迁移版本
  • IE11支持
  • 新devtools中的Router和Vuex集成
  • Vetur中模板类型推断的进一步改进

新文档链接:

  • 新官网: v3.vuejs.org/
  • 官方介绍: github.com/vuejs/vue-next/releases/tag/v3.0.0
  • 迁移指南 : v3.vuejs.org/guide/migration/introduction.html
  • Composition API : v3.vuejs.org/guide/composition-api-introduction.html

以上就是W3Cschool编程狮关于Vue3.0正式发布,本次发布所有总结,一起看看!的相关介绍了,希望对大家有所帮助。
有个程序媛女朋友是什么体验?

thbcm阅读(380)

文章来源于公众号:Java极客技术 作者:鸭血粉丝

有人问阿粉,有个程序媛女朋友是一种什么体验。阿粉虽然没有,但是身边有案例,这不为了满足大家的好奇心,去问了一圈,结果问下来之后,阿粉酸了…

程序员 A :你问我有个程序媛女朋友是啥体验?第一体验就是脱单了!还有什么体验比这更好么?

阿粉摸了摸自己的头发,默默的低下了头

程序员 B :记得有次跟我女朋友表白,告诉她我爱她,在我心里她永远都是第一位的,结果遭到她的质问,在我心里谁是第零?!!!

程序员 C :我女朋友就是程序媛,然后有次她在家也加班来着,让我帮忙看一下代码

“你为啥要用要敲空格键呢?用 tab 键不香么?”“用空格键不管怎么看,格式都不会变”“怎么会有人用空格?空格键除了制造噪音外哪里比 tab 强了,而且我跟你讲,用 tab 键可以让减少文件的占用空间”“我就用空格键怎么了,我就爱用怎么了”“你是老大,代码自己看吧”

程序员 D :什么体验么?和程序媛在一起,周末的时候就不是逛街了,是对着撸代码,时不时再吐吐槽对方的代码写的都是啥

阿粉想到周末都是自己在看技术视频,我的眼泪才没有流下来,我明明在笑…

程序员 E :我调试喜欢打 log ,女朋友调试喜欢打断点,每次都是她求我让我帮忙看看她的程序,然后调着调着我俩就开始抢笔记本了,“你给我,你这么写不行,给我我来写”“不要,我觉得是这里的问题,让我再试试,肯定是这里的问题”“不对不对,不是那里的问题,我有思路,把笔记本给我,我给你写”……到最后我俩差点儿打起来,好委屈,刚开始不是她来求我的么,而且还要嘲笑我一番喜欢打 log ,调试明明打 log 无敌好吧……

程序员 F :乖,咱们左括号换个行成不

对方:不要!!!

遇上这么一个女朋友,我能怎样?

程序员 G :最大的体验就是,平时的饭就不要想着在家吃了,特别是晚饭,在家吃是不可能的,因为 50% 的概率大家都加班, 50% 的概率一个人等另一个人加班

以上就是W3Cschool编程狮关于有个程序媛女朋友是什么体验?的相关介绍了,希望对大家有所帮助。

联系我们