如何设计一个看起来很牛逼的API接口

thbcm阅读(376)

文章来源于各种:Java旅途 作者:周明尧

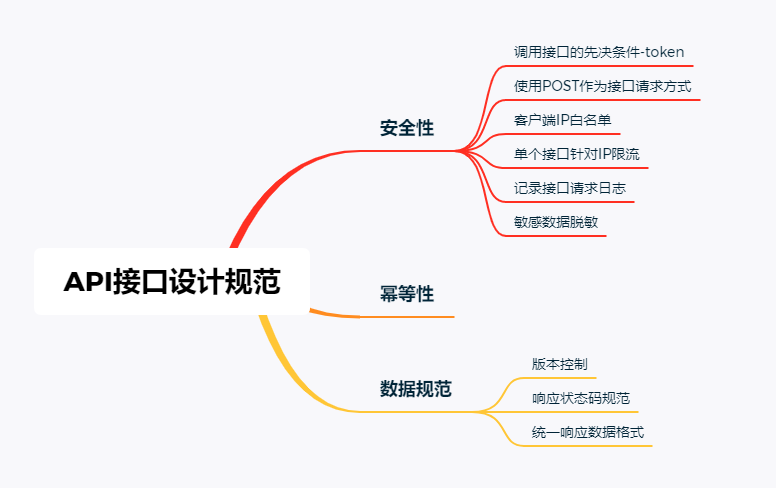
在平时工作中,总会接触到多种接口。前后端数据传输接口,第三方业务平台接口。一个平台的前后端数据传输接口一般都会在内网环境下通信,而且会使用安全框架,所以安全性可以得到很好的保护。这篇文章重点讨论一下提供给第三方平台的业务接口应当如何设计?我们应该考虑哪些问题?

主要从以上三个方面来设计一个安全的API接口。

一 安全性问题

安全性问题是一个接口必须要保证的规范。如果接口保证不了安全性,那么你的接口相当于直接暴露在公网环境中任人蹂躏。

1.1 调用接口的先决条件-token

获取 token 一般会涉及到几个参数appid,appkey,timestamp,nonce,sign。我们通过以上几个参数来获取调用系统的凭证。

appid和appkey可以直接通过平台线上申请,也可以线下直接颁发。appid是全局唯一的,每个appid将对应一个客户,appkey需要高度保密。

timestamp是时间戳,使用系统当前的 unix 时间戳。时间戳的目的就是为了减轻 DOS 攻击。防止请求被拦截后一直尝试请求接口。服务器端设置时间戳阀值,如果请求时间戳和服务器时间超过阀值,则响应失败。

nonce是随机值。随机值主要是为了增加sign的多变性,也可以保护接口的幂等性,相邻的两次请求nonce不允许重复,如果重复则认为是重复提交,响应失败。

sign是参数签名,将appkey,timestamp,nonce拼接起来进行md5加密(当然使用其他方式进行不可逆加密也没问题)。

token,使用参数appid,timestamp,nonce,sign来获取token,作为系统调用的唯一凭证。token可以设置一次有效(这样安全性更高),也可以设置时效性,这里推荐设置时效性。如果一次有效的话这个接口的请求频率可能会很高。token推荐加到请求头上,这样可以跟业务参数完全区分开来。

1.2 使用POST作为接口请求方式

一般调用接口最常用的两种方式就是 GET 和 POST 。两者的区别也很明显,GET 请求会将参数暴露在浏览器 URL 中,而且对长度也有限制。为了更高的安全性,所有接口都采用 POST 方式请求。

1.3 客户端IP白名单

ip 白名单是指将接口的访问权限对部分 ip 进行开放。这样就能避免其他 ip 进行访问攻击,设置 ip 白名单比较麻烦的一点就是当你的客户端进行迁移后,就需要重新联系服务提供者添加新的 ip 白名单。设置 ip 白名单的方式很多,除了传统的防火墙之外,spring cloud alibaba 提供的组件 sentinel 也支持白名单设置。为了降低 api 的复杂度,推荐使用防火墙规则进行白名单设置。

1.4 单个接口针对ip限流

限流是为了更好的维护系统稳定性。使用 redis 进行接口调用次数统计,ip+接口地址作为 key,访问次数作为 value ,每次请求 value+1,设置过期时长来限制接口的调用频率。

1.5 记录接口请求日志

使用 aop 全局记录请求日志,快速定位异常请求位置,排查问题原因。

1.6 敏感数据脱敏

在接口调用过程中,可能会涉及到订单号等敏感数据,这类数据通常需要脱敏处理,最常用的方式就是加密。加密方式使用安全性比较高的RSA非对称加密。非对称加密算法有两个密钥,这两个密钥完全不同但又完全匹配。只有使用匹配的一对公钥和私钥,才能完成对明文的加密和解密过程。

二 幂等性问题

幂等性是指任意多次请求的执行结果和一次请求的执行结果所产生的影响相同。说的直白一点就是查询操作无论查询多少次都不会影响数据本身,因此查询操作本身就是幂等的。但是新增操作,每执行一次数据库就会发生变化,所以它是非幂等的。

幂等问题的解决有很多思路,这里讲一种比较严谨的。提供一个生成随机数的接口,随机数全局唯一。调用接口的时候带入随机数。第一次调用,业务处理成功后,将随机数作为key,操作结果作为 value,存入 redis,同时设置过期时长。第二次调用,查询 redis,如果 key 存在,则证明是重复提交,直接返回错误。

三 数据规范问题

3.1 版本控制

一套成熟的 API 文档,一旦发布是不允许随意修改接口的。这时候如果想新增或者修改接口,就需要加入版本控制,版本号可以是整数类型,也可以是浮点数类型。一般接口地址都会带上版本号,http://ip:port//v1/list。

3.2 响应状态码规范

一个牛逼的 API,还需要提供简单明了的响应值,根据状态码就可以大概知道问题所在。我们采用 http 的状态码进行数据封装,例如200表示请求成功,4xx表示客户端错误,5xx表示服务器内部发生错误。状态码设计参考如下:

分类 描述
1xx 信息,服务器收到请求,需要请求者继续执行操作
2xx 成功
3xx 重定向,需要进一步的操作以完成请求
4xx 客户端错误,请求包含语法错误或无法完成请求
5xx 服务端错误

状态码枚举类:

public enum CodeEnum {


    // 根据业务需求进行添加
    SUCCESS(200,"处理成功"),
    ERROR_PATH(404,"请求地址错误"),
    ERROR_SERVER(505,"服务器内部发生错误");

    
    private int code;
    private String message;

    
    CodeEnum(int code, String message) {
        this.code = code;
        this.message = message;
    }


    public int getCode() {
        return code;
    }


    public void setCode(int code) {
        this.code = code;
    }


    public String getMessage() {
        return message;
    }


    public void setMessage(String message) {
        this.message = message;
    }
}

3.3 统一响应数据格式

为了方便给客户端响应,响应数据会包含三个属性,状态码(code),信息描述(message),响应数据(data)。客户端根据状态码及信息描述可快速知道接口,如果状态码返回成功,再开始处理数据。

响应结果定义及常用方法:

public class R implements Serializable {


    private static final long serialVersionUID = 793034041048451317L;


    private int code;
    private String message;
    private Object data = null;


    public int getCode() {
        return code;
    }
    public void setCode(int code) {
        this.code = code;
    }


    public String getMessage() {
        return message;
    }
    public void setMessage(String message) {
        this.message = message;
    }


    public Object getData() {
        return data;
    }


    /**
     * 放入响应枚举
     */
    public R fillCode(CodeEnum codeEnum){
        this.setCode(codeEnum.getCode());
        this.setMessage(codeEnum.getMessage());
        return this;
    }


    /**
     * 放入响应码及信息
     */
    public R fillCode(int code, String message){
        this.setCode(code);
        this.setMessage(message);
        return this;
    }


    /**
     * 处理成功,放入自定义业务数据集合
     */
    public R fillData(Object data) {
        this.setCode(CodeEnum.SUCCESS.getCode());
        this.setMessage(CodeEnum.SUCCESS.getMessage());
        this.data = data;
        return this;
    }
}

总结

本篇文章从安全性、幂等性、数据规范等方面讨论了 API 设计规范。除此之外,一个好的 API 还少不了一个优秀的接口文档。接口文档的可读性非常重要,虽然很多程序员都不喜欢写文档,而且不喜欢别人不写文档。为了不增加程序员的压力,推荐使用 swagger 或其他接口管理工具,通过简单配置,就可以在开发中测试接口的连通性,上线后也可以生成离线文档用于管理API。

以上就是W3Cschool编程狮关于如何设计一个看起来很牛逼的API接口的相关介绍了,希望对大家有所帮助。

Vue 3.0 diff 新特性 – 静态节点提升

thbcm阅读(377)

文章来源于公众号:Code center ,作者五柳

前言

「静态节点提升」是「Vue3」针对 VNode 更新过程性能问题而提出的一个优化点。众所周知,在大型应用场景下,「Vue2.x」 的 patchVNode 过程,即 diff 过程是非常缓慢的,这是一个十分令人头疼的问题。

虽然,对于面试常问的 diff 过程在一定程度上是减少了对 DOM 的直接操作。但是,「这个减少是有一定成本的」。因为,如果是复杂应用,那么就会存在父子关系非常复杂的 VNode,而这也就是 diff 的痛点,它会不断地递归调用 patchVNode,不断堆叠而成的几毫秒,最终就会造成 VNode 更新缓慢。

也因此,这也是为什么我们所看到的大型应用诸如阿里云之类的采用的是基于「React」的技术栈的原因之一。所以,「Vue3」也是痛改前非,重写了整个 Compiler 过程,提出了静态提升、靶向更新等优化点,来提高 patchVNode 过程。

那么,回到今天的正题,我们从源码角度看看在整个编译过程「Vue3」静态节点提升究竟是「何许人也」?

什么是 patchFlag

由于,在 compile 过程的 transfrom 阶段会提及 AST Element 上的 patchFlag 属性。所以,在正式认识 complie 之前,我们先搞清楚一个概念,什么是 patchFlag?

patchFlag 是 complier 时的 transform 阶段解析 AST Element 打上的「优化标识」。并且,顾名思义 patchFlag,patch 一词表示着它会为 runtime时的 patchVNode 提供依据,从而实现靶向更新 VNode 的效果。因此,这样一来一往,也就是耳熟能详的 Vue3 巧妙结合 runtime 与 compiler 实现靶向更新和静态提升。

而在源码中 patchFlag 被定义为一个「数字枚举类型」,每一个枚举值对应的标识意义会是这样:
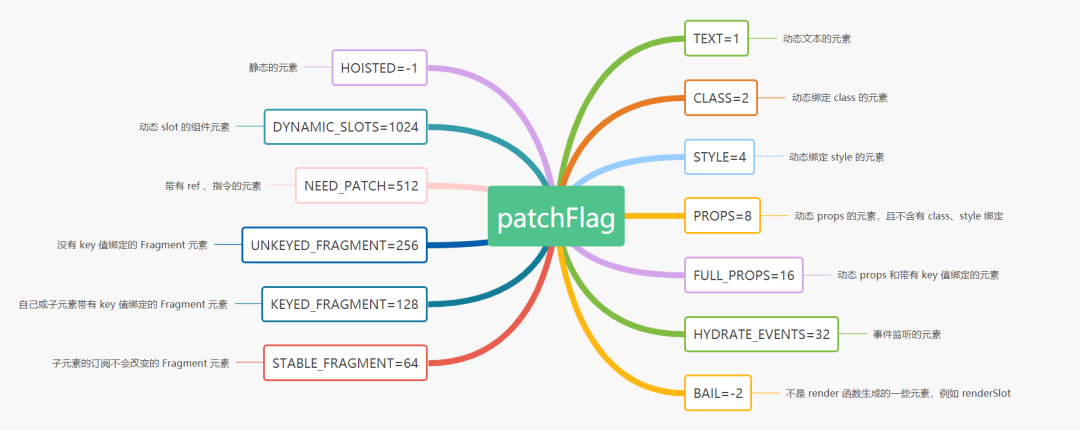
并且,值得一提的是整体上 patchFlag 的分为两大类:

  • 当 patchFlag 的值「大于」 0 时,代表所对应的元素在 patchVNode 时或 render 时是可以被优化生成或更新的。
  • 当 patchFlag 的值「小于」 0 时,代表所对应的元素在 patchVNode 时,是需要被 full diff,即进行递归遍历 VNode tree 的比较更新过程。

其实,还有两类特殊的 flag:shapeFlag 和 slogFlag,这里我就不对此展开,有兴趣的同学可以自行去了解。

Compile 编译过程

对比 Vue2.x 编译过程

了解过「Vue2.x」源码的同学,我想应该都知道在「Vue2.x」中的 Compile 过程会是这样:

  • parse 编译模板生成原始 AST。
  • optimize 优化原始 AST,标记 AST Element 为静态根节点或静态节点。
  • generate 根据优化后的 AST,生成可执行代码,例如 _c、_l 之类的。
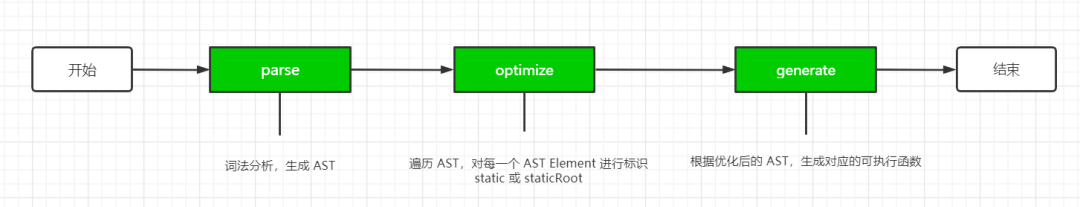
而在「Vue3」中,整体的 Compile 过程仍然是三个阶段,但是不同于「Vue2.x」的是,第二个阶段换成了正常编译器都会存在的阶段 transform。所以,它看起来会是这样:
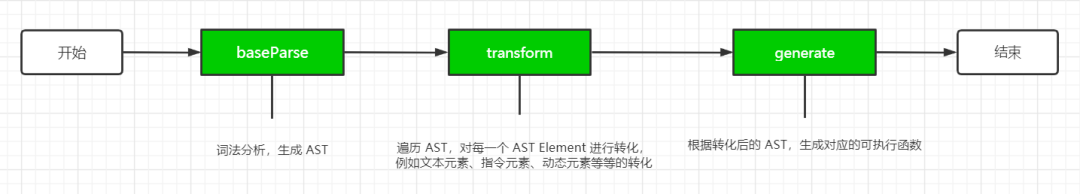
在源码中,它对应的伪代码会是这样:

export function baseCompile(
  template: string | RootNode,
  options: CompilerOptions = {}
): CodegenResult {
  ...
  const ast = isString(template) ? baseParse(template, options) : template
  ...
  transform(
    ast,
    extend({}, options, {....})
  )


  return generate(
    ast,
    extend({}, options, {
      prefixIdentifiers
    })
  )
}

那么,我想这个时候大家可能会问为什么会是 transform?它的职责是什么?

通过简单的对比「Vue2.x」编译过程的第二阶段的 optimize,很明显,transform并不是「无米之炊」,它仍然有着「优化」原始 AST 的作用,而具体职责会表现在:

  • 对所有 AST Element 新增 codegen 属性来帮助 generate 更准确地生成「最优」的可执行代码。
  • 对静态 AST Element 新增 hoists 属性来实现静态节点的「单独创建」。
  • …

此外,transform 还标识了诸如 isBlock、helpers 等属性,来生成最优的可执行代码,这里我们就不细谈,有兴趣的同学可以自行了解。

baseParse 构建原始抽象语法树(AST)

baseParse 顾名思义起着「解析」的作用,它的表现和「Vue2.x」的 parse 相同,都是解析模板 tempalte 生成「原始 AST」。

假设,此时我们有一个这样的模板 template:

<div><div>hi vue3</div><div>{{msg}}</div></div>

那么,它在经过 baseParse 处理后生成的 AST 看起来会是这样:

{
  cached: 0,
  children: [{…}],
  codegenNode: undefined,
  components: [],
  directives: [],
  helpers: [],
  hoists: [],
  imports: [],
  loc: {start: {…}, end: {…}, source: "<div><div>hi vue3</div><div>{{msg}}</div></div>"},
  temps: 0,
  type: 0
}

如果,了解过「Vue2.x」编译过程的同学应该对于上面这颗 AST 的大部分属性不会陌生。AST 的本质是通过用对象来描述「DSL」(特殊领域语言),例如:

  • children 中存放的就是最外层 div 的后代。
  • loc 则用来描述这个 AST Element 在整个字符串(template)中的位置信息。
  • type 则是用于描述这个元素的类型(例如 5 为插值、2 为文本)等等。

并且,可以看到的是不同于「Vue2.x」的 AST,这里我们多了诸如 helpers、codegenNode、hoists 等属性。而,这些属性会在 transform 阶段进行相应地赋值,进而帮助 generate 阶段生成「更优的」可执行代码。

transfrom 优化原始抽象语法树(AST)

对于 transform 阶段,如果了解过「编译器」的工作流程的同学应该知道,一个完整的编译器的工作流程会是这样:

  • 首先,parse 解析原始代码字符串,生成抽象语法树 AST。
  • 其次,transform 转化抽象语法树,让它变成更贴近目标「DSL」的结构。
  • 最后,codegen 根据转化后的抽象语法树生成目标「DSL」的可执行代码。

而在「Vue3」采用 Monorepo 的方式管理项目后,compile 对应的能力就是一个编译器。所以,transform 也是整个编译过程的重中之重。换句话说,如果没有 transform 对 AST 做诸多层面的转化,「Vue」仍然会挂在 diff 这个「饱受诟病」的过程。

相比之下,「Vue2.x」的编译阶段没有完整的 transform,只是 optimize 优化了一下 AST,可以想象在「Vue」设计之初尤大也没想到它以后会「这么地流行」!

那么,我们来看看 transform 函数源码中的定义:

function transform(root: RootNode, options: TransformOptions) {
  const context = createTransformContext(root, options)
  traverseNode(root, context)
  if (options.hoistStatic) {
    hoistStatic(root, context)
  }
  if (!options.ssr) {
    createRootCodegen(root, context)
  }
  // finalize meta information
  root.helpers = [...context.helpers]
  root.components = [...context.components]
  root.directives = [...context.directives]
  root.imports = [...context.imports]
  root.hoists = context.hoists
  root.temps = context.temps
  root.cached = context.cached
}

可以说,transform 函数做了什么,在它的定义中是「一览无余」。这里我们提一下它对静态提升其决定性作用的两件事:

  • 将原始 AST 中的静态节点对应的 AST Element 赋值给根 AST 的 hoists 属性。
  • 获取原始 AST 需要的 helpers 对应的键名,用于 generate 阶段的生成可执行代码的获取对应函数,例如 createTextVNode、createStaticVNode、renderList 等等。

并且,在 traverseNode 函数中会对 AST Element 应用具体的 transform 函数,大致可以分为两类:

  • 静态节点 transform 应用,即节点不含有插值、指令、props、动态样式的绑定等。
  • 动态节点 transform 应用,即节点含有插值、指令、props、动态样式的绑定等。

那么,我们就来看看对于静态节点 transform 是如何应用的?

静态节点 transform 应用

这里,对于上面我们说到的这个栗子,静态节点就是这个部分:

<div>hi vue3</div>

而它在没有进行 transform 应用之前,它对应的 AST 会是这样:

{
  children: [{
    content: "hi vue3"
    loc: {start: {…}, end: {…}, source: "hi vue3"}
    type: 2
  }],
  codegenNode: undefined,
  isSelfClosing: false,
  loc: {start: {…}, end: {…}, source: "<div>hi vue3</div>"},
  ns: 0,
  props: [],
  tag: "div",
  tagType: 0,
  type: 1
}

可以看出,此时它的 codegenNode 是 undefined。而在源码中各类 transform函数被定义为 plugin,它会根据 baseParse 生成的 AST 「递归应用」对应的 plugin。然后,创建对应 AST Element 的 codegen 对象。

所以,此时我们会命中 transformElement 和 transformText 两个 plugin的逻辑。

「transformText」

transformText 顾名思义,它和「文本」相关。很显然,此时的 AST Element 所属的类型就是 Text。那么,我们先来看一下 transformText 函数对应的伪代码:

export const transformText: NodeTransform = (node, context) => {
  if (
    node.type === NodeTypes.ROOT ||
    node.type === NodeTypes.ELEMENT ||
    node.type === NodeTypes.FOR ||
    node.type === NodeTypes.IF_BRANCH
  ) {
    return () => {
      const children = node.children
      let currentContainer: CompoundExpressionNode | undefined = undefined
      let hasText = false


      for (let i = 0; i < children.length; i++) { // {1}
        const child = children[i]
        if (isText(child)) {
          hasText = true
          ...
        }
      }
      if (
        !hasText ||
        (children.length === 1 &&
          (node.type === NodeTypes.ROOT ||
            (node.type === NodeTypes.ELEMENT &&
              node.tagType === ElementTypes.ELEMENT)))
      ) { // {2}
        return
      }
      ...
    }
  }
}

可以看到,这里我们会命中 「{2}」 的逻辑,即如果对于「节点含有单一文本」 transformText 并不需要进行额外的处理,即该节点仍然在这里仍然保留和「Vue2.x」版本一样的处理方式。

而 transfromText 真正发挥作用的场景是当模板中存在这样的情况:

<div>ab {a} {b}</div>

此时 transformText 需要将两者放在一个「单独的」 AST Element 下,在源码中它被称为「Compound Expression」,即「组合的表达式」。这种组合的目的是为了 patchVNode 这类 VNode 时做到「更好地定位和实现 DOM 的更新」。反之,如果是一个文本节点和插值动态节点的话,在 patchVNode 阶段同样的操作需要进行两次,例如对于同一个 DOM 节点操作两次。

「transformElement」

transformElement 是一个所有 AST Element 都会被执行的一个 plugin,它的核心是为 AST Element 生成最基础的 codegen 属性。例如标识出对应 patchFlag,从而为生成 VNode 提供依据,例如 dynamicChildren。

而对于静态节点,同样是起到一个初始化它的 codegenNode 属性的作用。并且,从上面介绍的 patchFlag 的类型,我们可以知道它的 patchFlag 为默认值 0。所以,它的 codegenNode 属性值看起来会是这样:

{
  children: {
    content: "hi vue3"
    loc: {start: {…}, end: {…}, source: "hi vue3"}
    type: 2
  },
  directives: undefined,
  disableTracking: false,
  dynamicProps: undefined,
  isBlock: false,
  loc: {start: {…}, end: {…}, source: "<div>hi vue3</div>"},
  patchFlag: undefined,
  props: undefined,
  tag: ""div"",
  type: 13
}

generate 生成可执行代码

generate 是 compile 阶段的最后一步,它的作用是将 transform 转换后的 AST 生成对应的「可执行代码」,从而在之后 Runtime 的 Render 阶段时,就可以通过可执行代码生成对应的 VNode Tree,然后最终映射为真实的 DOM Tree 在页面上。

同样地,这一阶段在「Vue2.x」也是由 generate 函数完成,它会生成是诸如 _l、_c 之类的函数,这本质上是对 _createElement 函数的封装。而相比较「Vue2.x」版本的 generate,「Vue3」改变了很多,其 generate 函数对应的伪代码会是这样:

export function generate(
  ast: RootNode,
  options: CodegenOptions & {
    onContextCreated?: (context: CodegenContext) => void
  } = {}
): CodegenResult {
  const context = createCodegenContext(ast, options)
  if (options.onContextCreated) options.onContextCreated(context)
  const {
    mode,
    push,
    prefixIdentifiers,
    indent,
    deindent,
    newline,
    scopeId,
    ssr
  } = context
  ...
  genFunctionPreamble(ast, context)
  ...


  if (!ssr) {
    ...
    push(`function render(_ctx, _cache${optimizeSources}) {`)
  }
  ....


  return {
    ast,
    code: context.code,
    // SourceMapGenerator does have toJSON() method but it's not in the types
    map: context.map ? (context.map as any).toJSON() : undefined
  }
}

所以,接下来,我们就来「一睹」带有静态节点对应的 AST 生成的可执行代码的过程会是怎样。

CodegenContext 代码生成上下文

从上面 generate 函数的伪代码可以看到,在函数的开始调用了 createCodegenContext 为当前 AST 生成了一个 context。在整个 generate 函数的执行过程「都依托」于一个 CodegenContext 「生成代码上下文」(对象)的能力,它是通过 createCodegenContext 函数生成。而 CodegenContext 的接口定义会是这样:

interface CodegenContext
  extends Omit {
  source: string
  code: string
  line: number
  column: number
  offset: number
  indentLevel: number
  pure: boolean
  map?: SourceMapGenerator
  helper(key: symbol): string
  push(code: string, node?: CodegenNode): void
  indent(): void
  deindent(withoutNewLine?: boolean): void
  newline(): void
}

可以看到 CodegenContext 对象中有诸如 push、indent、newline 之类的方法。而它们的作用是在根据 AST 来生成代码时用来「实现换行」、「添加代码」、「缩进」等功能。从而,最终形成一个个可执行代码,即我们所认知的 render 函数,并且,它会作为 CodegenContext 的 code 属性的值返回。

下面,我们就来看下静态节点的可执行代码生成的核心,它被称为 Preamble 前导。

genFunctionPreamble 生成前准备

整个静态提升的可执行代码生成就是在 genFunctionPreamble 函数部分完成的。并且,大家仔细「斟酌」一番静态提升的字眼,静态二字我们可以不看,但是「提升二字」,直抒本意地表达出它(静态节点)被「提高了」。

为什么说是提高了?因为在源码中的体现,确实是被提高了。在前面的 generate 函数,我们可以看到 genFunctionPreamble 是先于 render 函数加入context.code 中,所以,在 Runtime 时的 Render 阶段,它会先于 render 函数执行。

geneFunctionPreamble 函数(伪代码):

function genFunctionPreamble(ast: RootNode, context: CodegenContext) {
  const {
    ssr,
    prefixIdentifiers,
    push,
    newline,
    runtimeModuleName,
    runtimeGlobalName
  } = context
  ...
  const aliasHelper = (s: symbol) => `${helperNameMap[s]}: _${helperNameMap[s]}`
  if (ast.helpers.length > 0) {
    ...
    if (ast.hoists.length) {
      const staticHelpers = [
        CREATE_VNODE,
        CREATE_COMMENT,
        CREATE_TEXT,
        CREATE_STATIC
       ]
        .filter(helper => ast.helpers.includes(helper))
        .map(aliasHelper)
        .join(', ')
      push(`const { ${staticHelpers} } = _Vue\n`)
    }
  }
  ...
  genHoists(ast.hoists, context)
  newline()
  push(`return `)
}

可以看到,这里会对前面我们在 transform 函数提及的 hoists 属性的长度进行判断。显然,对于前面说的这个栗子,它的 ast.hoists.length 长度是大于 0 的。所以,这里就会根据 hoists 中的 AST 生成对应的可执行代码。因此,到这里,生成的可执行代码会是这样:

const _Vue = Vue
const { createVNode: _createVNode } = _Vue
// 静态提升部分
const _hoisted_1 = _createVNode("div", null, "hi vue3", -1 /* HOISTED */)
// render 函数会在这下面

小结

静态节点提升在整个 compile 编译阶段体现,从最初的 baseCompile 到 transform 转化原始 AST、再到 generate 的优先 render 函数处理生成可执行代码,最后交给 Runtime 时的 Render 执行,这种设计可以说是非常精妙!所以,这样一来,就完成了我们经常看到在一些文章提及的「Vue3」对于静态节点在整个生命周期中它只会执行「一次创建」的源码实现,这在一定程度上降低了性能上的开销。

以上就是W3Cschool编程狮关于Vue 3.0 diff 新特性 – 静态节点提升的相关介绍了,希望对大家有所帮助。
解决Java异常的10个实践经验

thbcm阅读(478)

文章来源于公众号:Java之道 ,作者Hollis

异常处理对于编写健康茁壮的Java应用起着极其重要的作用。异常处理并不是功能性需求,在实践中,异常处理不单单是知道语法这么简单。下面给大家展示10个最佳实践。

线上代码不要使用printStackTrace()

写完代码后请一定要检查下,代码中千万不要有printStackTrace()。因为printStackTrace()只会在控制台上输出错误的堆栈信息,他只适合于用来代码调试。

真正需要记录异常,请使用日志记录。

永远不要在catch块中吞掉异常

catch (NoSuchMethodException e) {
     return null;
  }

永远不要不处理异常,而是返回 null,这样异常就会被吞掉,无法获取到任何失败信息,会给日后的问题排查带来巨大困难。

在需要的地方声明特定的受检异常

 public void foo() throws Exception { //错误做法
  }

一定要尽量避免上面的代码,因为他的调用者完全不知道错误的原因到底是什么。

在方法声明中,可以由方法抛出一些特定受检异常。如果有多个,那就分别抛出多个,这样这个方法的使用者才会分别针对每个异常做特定的处理,从而避免发生故障。

public void foo() throws SpecificException1, SpecificException2 { 
//正确做法
}

始终只捕获那些可以处理的异常

catch (NoSuchMethodException e) 
{
    throw e; //这代码一点用都没有
}

这是一个基本概念,当你能够处理他时,你再捕获这个异常,否则永远都不要捕获他。

如果你不能在catch块中处理它,那么就不要先捕获再直接抛出,这样没有任何意义。

尽量捕获特定的子类,而不是直接捕获Exception类

try {
      someMethod();
  }
  catch (Exception e) 
  {
      LOGGER.error("method has failed", e);
  }

以上代码,最大的问题就是,如果someMethod()的开发者在里面新增了一个特定的异常,并且预期是调用方能够特殊的对他进行处理。

但是调用者直接catch了Exception类,就会导致永远无法知道someMethod的具体变化细节。这久可能导致在运行的过程中在某一个时间点程序崩溃。

永远不要捕获Throwable类

这是一个严重的问题,因为 Java 中的Error也可以是Throwable的子类。但是Error是 Java 虚拟机本身无法控制的。Java 虚拟机甚至可能不会在出现任何错误时请求用户的catch子句。

始终在自定义异常中覆盖原有的异常,这样堆栈跟踪就不会丢失

 catch (NoSuchMethodException e) 
  {
  throw new MyServiceException("Some information: " + e.getMessage());  //错误做法
  }

上面的命令可能会丢失掉主异常的堆栈跟踪。正确的方法是:

catch (NoSuchMethodException e) {
     throw new MyServiceException("Some information: " , e);  //正确做法
}

可以记录异常或抛出异常,但不要同时做

catch (NoSuchMethodException e) {
     LOGGER.error("Some information", e);
     throw e;
  }

如上面的代码所示,抛出和日志记录可能会在日志文件中产生多个日志消息。

这就会导致同一个问题,却在日志中有很多不同的错误信息,使得开发人员陷入混乱。

永远不要在finally中抛出异常

try {
  someMethod();  //抛出 exceptionOne
}
 finally
{
  cleanUp();    //如果在这里再抛出一个异常,那么try中的exceptionOne将会丢失forever
}

在上面的例子中,如果someMethod()抛出一个异常,并且在finally块中,cleanUp()也抛出一个异常,那么初始的exceptionOne(正确的错误异常)将永远丢失。

如果您不打算处理异常,请使用finally块而不是catch块

try {
  someMethod();
}
finally
{
  cleanUp();
}

这也是一个很好的实践。如果在你的方法中访问其他方法,而该方法抛出了异常你不想处理,但是仍然需要做一些清理工作,那么在finally块中进行清理。不要使用catch块。

以上就是W3Cschool编程狮关于解决Java异常的10个实践经验的相关介绍了,希望对大家有所帮助。

用 Python 诠释啥叫硬核老爸

thbcm阅读(454)

文章来源于公众号:Python技术 作者:派森酱

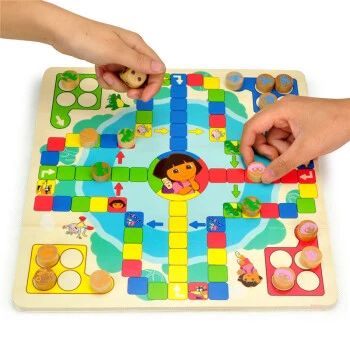
前几天,给儿子买了个飞行棋,甚是喜欢,每天都要和我来两盘,昨天准备大战一场时,发现骰子弄丢了,没有骰子就没法玩了,正想要用橡皮做一个,突然想到了个更好的办法,经过一顿折腾,终于搞定了,结果……

构思

骰子是个立方体,有六个面,每个面上,标有不同地点,从 1 个 到 6 个,代表 1 到 6 六个数字,玩的时候,将骰子一掷,等它停下,朝上的面是几点,就表示摇到了几。

不同的游戏中,对摇到的点数有不同的玩法,例如飞行棋中,摇到 5 或者 6,可以起飞一架飞机。

现在我需要用程序来模拟这个过程,实际上就是产生 1 到 6 直接的随机数,直接用 random.randint(1, 6) 就可以搞定,不过我不想就这样简单完成,一是对于小孩子来说,直接给出数字不够直观,二是,能有机会给儿子炫技一把,何乐不为?

于是构思如下:

  • 找一些骰子的素材,需要有每个数字向上的图片
  • 为了制造骰子的转动效果,还需要一些处于转动中间状态的图片
  • 随机产生 0 到 5 之间的数字,0 代表点数 1,1 代表点数 2,依次类推,5 代表点数 6,为什么不直接生成 1 到 6 呢?后面有解答
  • 掷骰子过程有两种状态,即 显示点数 和 转动,那么就需要有触发机制,考虑到小孩子对鼠标操作不灵活,选用空格键来控制,按一下就相当于掷一次

实现

构思好后,赶紧实现!

素材

先从网上找了些骰子的素材,最终选择了以微信掷骰子表情图为元素的一系列 gif 图片,通过图片解析工具,从 gif 图片中提取出每个帧,其中包括了点数朝上的图片,和转动中间的图片,这样图片素材就搞定了。

实践时如果不方便获得图片素材,可从本文示例代码中获得

接下来,就是编程部分了,使用 pygame 这个 python 游戏引擎库。

骰子

首先,写一个 骰子类,用来定义骰子的各种资源,以及管理骰子的状态,代码如下:

import random
import pygame


class Dice:
    def __init__(self):
        self.diceRect = pygame.Rect(200, 225, 100, 100)
        self.diceSpin = [
            pygame.image.load("asset/rolling/4.png"),
            pygame.image.load("asset/rolling/3.png"),
            pygame.image.load("asset/rolling/2.png"),
            pygame.image.load("asset/rolling/1.png")
        ]
        self.diceStop = [
            pygame.image.load("asset/dice/1.png"),
            pygame.image.load("asset/dice/2.png"),
            pygame.image.load("asset/dice/3.png"),
            pygame.image.load("asset/dice/4.png"),
            pygame.image.load("asset/dice/5.png"),
            pygame.image.load("asset/dice/6.png")
        ]


        self.StopStatus = random.randint(0, 5)
        self.SpinStatus = 0


    def move(self):
        self.SpinStatus += 1
        if self.SpinStatus == len(self.diceSpin):
            self.SpinStatus = 0

  • 初始化方法中,用 pygame.Rect 方法设定了一个矩形区域,即游戏窗口坐标为(200, 225),高度和宽度都为 100,这个矩形区域是为了在游戏窗口中绘制骰子用的
  • diceSpin 存储了骰子转动过程中的图片素材,注意需要用 pygame.image.load 方法加载图片资源
  • diceStop 存储了骰子点数的图片素材
  • StopStatus 记录骰子停止状态的点数值,在 0 ~ 5 之间,初始化为一个随机数
  • SpinStatus 记录转动过程中当前帧的图片索引,默认为 0
  • move 方法相当于一个转动控制器,每调用一次会改变一次转动中图片的索引,骰子转动过程中会反复被调用

引擎

接下来,编写一个游戏引擎类,用于驱动游戏过程,代码如下:

import random
import sys
import pygame


class Game:
    def __init__(self, width=500, height=600):
        pygame.init()
        size = width, height
        self.screen = pygame.display.set_mode(size)
        self.clock = pygame.time.Clock()
        self.screen.fill((255, 255, 255))


        self.rollTimes = 0  # 掷骰子过程的帧数记录
        self.Dice = Dice()
        self.start = False  # 状态标识
        self.rollCount = random.randint(3, 10)  # 初始投掷帧数


    def roll(self):
        self.screen.blit(self.Dice.diceSpin[self.Dice.SpinStatus], self.Dice.diceRect)
        self.Dice.move()
        self.rollTimes += 1
        if self.rollTimes > self.rollCount:
            self.start = False
            self.rollCount = random.randint(3, 10)
            self.Dice.StopStatus = random.randint(0, 5)
            self.rollTimes = 0


    def stop(self):
        self.screen.blit(self.Dice.diceStop[self.Dice.StopStatus], self.Dice.diceRect)


    def run(self):
        while True:
            self.clock.tick(10)
            for event in pygame.event.get():
                if event.type == pygame.QUIT:
                    sys.exit()
                if ((event.type == pygame.KEYDOWN and event.key==pygame.K_SPACE) \
                or event.type == pygame.MOUSEBUTTONDOWN) \
                and self.start == False:
                    self.start = True


            if self.start:
                self.roll()
            else:
                self.stop()
            pygame.display.update()

  • 初始化方法中,做了游戏窗口的初始化,并设定了窗口大小,然后对过程中的控制类变量做了初始化
  • roll 方法为抛掷,抛掷过程中会被反复调用,先设置一个转动中图片,然后,调用骰子的 move 方法,得到一个新的转动状态
  • roll 方法中,接下来是一个控制器,如果达到了设定的转动次数,就停止,并得到随机的点数
  • stop 方法,在停止转动时调用,将转动停止时的点数图片绘制到窗口上,这里StopStatus 范围是 0 ~ 5,刚好对应 diceStop 列表的索引,这就是随机数范围是 0~5 的原因
  • run 方法是引擎的启动入口,它启动了一个事件循环
  • 循环中,检查一遍事件记录,如果接收到了退出事件,则结束循环
  • 如果接收到了按下空格键或者鼠标键,且投掷状态为停止时,将投掷状态设置为开始
  • 检查完事件记录,判断投掷状态,如果是开始状态,调用 roll 方法,否则调用 stop 方法
  • 最后每次循环都需要调用 pygame.display.update() 刷新一次窗口

这里需要说明下 clock.tick,它的作用是让循环每秒执行多少次,抽象来说可以理解为动画的帧,即每秒多少帧。

相对于 clock.tick,我们更熟悉 time.sleep,后者表示等待多久再执行,那么 clock.tick(10) 的效果就相当于 time.sleep(0.1),即每秒执行 10 次,就等于每次等待十分之一秒。

运行

if __name__ == '__main__':
    Game().run()

注意:将目录切换到代码目录下运行,否则可能提示找不到图片文件。

运行效果如下,像那么回事吧:

折腾完后,我迫不及待地去儿子跟前炫耀,结果,他已经睡着了,身旁散落着一些飞行棋子儿……

总结

无论在生活或者工作中,编程技能越来越重要了,编程已然成为了思考和创造的工具了,习得一项编程技能,不仅能帮助自己,也许可以省一笔少儿编程的花费,在提高孩子逻辑思维能力的同时,还能增进与孩子的感情,不得不说,当儿子使用我编写的骰子玩飞行棋时,更开心了。

做硬核家长,我用 Python !

以上就是W3Cschool编程狮关于用 Python 诠释啥叫硬核老爸的相关介绍了,希望对大家有所帮助。

动图演示:手撸堆栈的两种实现方法!

thbcm阅读(407)

文章来源于公众号:Java中文社群 作者:磊哥

随着软件开发行业竞争的日益激烈,面试的难度也在逐渐增加,因为企业要从众多的面试人中选出最优秀的人,只能提高面试的难度,而算法和数据结构比较烧脑的硬核技能之一,自然也就成了面试的首选科目。并且随着时间的推移,算法和数据结构出现的频率和占比也会不断增加,因此为了顺应时代发展的潮流,我们也要做一些调整,所以在后面的一些文章中,我会陆续更新一些关于算法和数据结构的文章,希望大家能够喜欢。

PS:当然随着智能系统的普及(如今日头条和抖音),算法和数据结构在企业中应用也越来越多,因此学习算法和数据结构也是迫在眉睫的事了。

栈定义

栈(Stack)又叫堆栈(简称栈),它是在同一端进行插入和删除数据的线性表。

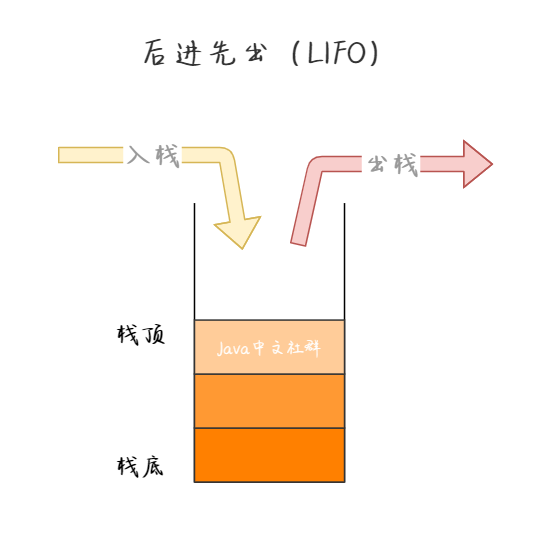
栈是最基础也是最常见的数据结构之一,它的数据结构和操作流程如下图所示:

其中,允许进行插入和删除的一端叫作栈顶(Top),另一端叫作栈底(Bottom),栈底固定,栈顶浮动。

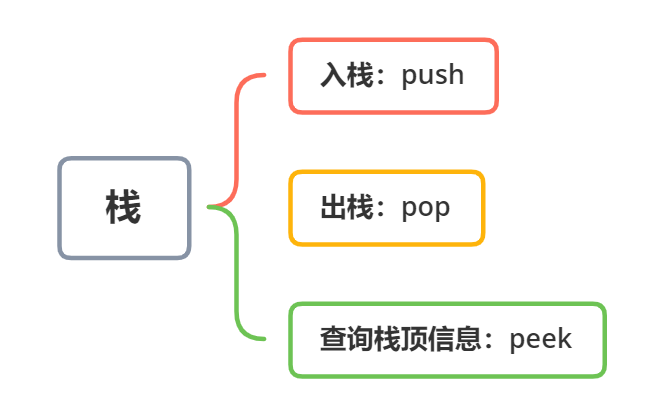
当栈中的元素为零时,该栈叫作空栈。添加数据时一般叫作入栈或进栈(Push),删除数据叫作出栈或退栈(Pop)。栈是后进先出(Last In First Out,LIFO)的线性表。

物理结构 & 逻辑结构

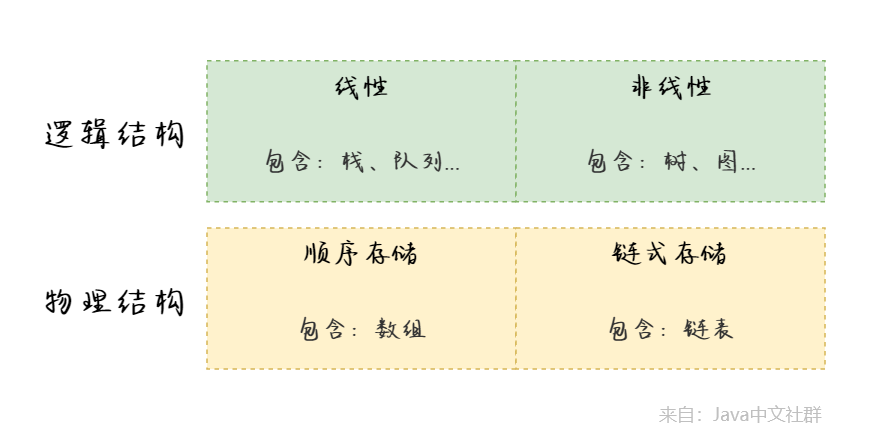
在手撸算法之前,我们先来认识一下数据结构中的两个重要概念:物理结构和逻辑结构。

当谈到“物理”和“逻辑”一词时,我们可以会想到数据库中的逻辑删除和物理删除。

所谓的物理删除是指通过删除命令真实的将数据从物理结构中删除的过程;而逻辑删除是指通过修改命令将数据更改为“已删除”的状态,并非真实的删除数据。

这里的逻辑结构和物理结构和上面的概念类似,所谓的物理结构是指可以将数据存储在物理空间中,比如数组和链表都属于物理数据结构;而逻辑结构则是用于描述数据间的逻辑关系的,比如本文要讲的栈就属于逻辑结构。

可能有些人看到这里就蒙了,没关系,我这里举一个例子你就明白了。

如果用人来表示物理结构和逻辑结构的话,那么真实存在的有血有肉的人就属于物理结构,而人的思想和信念就属于逻辑结构了。

自定义栈I:数组实现

通过上面的内容,我们知道了栈属于逻辑结构,因此它的实现方式就可以有很多种了,比如数组的实现方式或者是链表的实现方式。那么我们就先用数组实现一下,栈的主要方法有:

① 定义结构

那么我们先来定义它的结构:

public class MyStack {
    private Object[] value = null; // 栈存储容器
    private int top = -1; // 栈顶(的指针)
    private int maxSize = 0; // 栈容量


    // 构造函数(初始化默认容量)
    MyStack() {
        this.maxSize = 10;
    }


    // 有参构造函数
    MyStack(int initSize) throws Exception {
        if (initSize  Hello


从上述代码可以看出,我们添加栈的顺序是 `Hello`、`Java` 而输出的顺序是 `Java`、 `Hello` 符合栈的定义(后进先出)。


## 自定义栈II:链表实现


除了数组之外,我们可以还可使用链表来实现栈结构,它的实现稍微复杂一些,我们先来看链表本身的数据结构:


![链表的数据结构](https://atts.w3cschool.cn/attachments/image/20200923/1600831705876009.png "链表的数据结构")


使用链表实现栈的流程如下:


![链表实现栈的流程](https://atts.w3cschool.cn/attachments/image/20200923/1600831725907957.gif "链表实现栈的流程")


也就是说,入栈时我们将数据存储在链表的头部,出栈时我们从头部进行移除,并将栈顶指针指向原头部元素的下一个元素,实现代码如下。


我们先来定义一个链表节点:

public class Node { Object value; // 每个节点的数据 Node next; // 下一个节点

public Node(Object value) { this(value, null); }

/**

  • 创建新节点
  • @param value 当前节点数据
  • @param next 指向下一个节点(头插法) */ public Node(Object value, Node next) { this.value = value; this.next = next; } }

接下来我们使用链表来实现一个完整的栈:


public class StackByLinked {


    private Node top = null; // 栈顶数据
    private int maxSize = 0; // 栈最大容量
    private int leng = 0; // 栈实际容量


    public StackByLinked(int initSize) throws Exception {
        if (initSize = maxSize;
    }


    /**
     * 是否为空
     * @return
     */
    public boolean isEmpty() {
        return leng  Java
>
> Hello


## 总结


本文我们使用了数组和链表等物理结构来实现了栈,当然我们也可以使用其他容器来实现,比如 [Java](https://www.w3cschool.cn/java/) 中的 `List`,我们只需要保证在操作栈时是后进先出的执行顺序,并且至少包含 3 个重要方法:入栈、出栈和查询栈顶元素就可以了。


## 最后


**算法和数据结构的学习是 3 分学 7 分练**,只看不练是没办法学好算法的,而且**学习算法和数据结构是一个循序渐进的过程,短时间内不会有明显的收效**。因为这些算法经过了几百年的发展和积累才得以流传下来的,所以想要“玩得转”还需要一点耐心。


这里给你讲一个学习算法的“秘诀”:**看不懂的知识要反复看,如果反复看还是看不懂,那么别着急,休息一下再继续看!**相信我,对于学习算法这件事,所有人的过程都是一样的。


以上就是`W3Cschool编程狮`关于**动图演示:手撸堆栈的两种实现方法!**的相关介绍了,希望对大家有所帮助。

TypeScript 中的class和interface

thbcm阅读(389)

文章来源于公众号:小丑的小屋

前言

刚刚的vue3.0一发布,各大网址和社区以及公众号已经被 Vue3.0 的One Piece版本所霸屏,出现不同的标题有着同样内容的现象,借此热度我们不如好好回顾一下ts基础知识,备战vue3.0的正式使用。

TypeScript 这个东西说实在的,真的是容易忘记,一段时间不用就感觉特别陌生,但是回过头来看看,又有一种熟悉的感觉,有句话是这么说的:ts越用越香,它确实能够规范我们的书写的格式,语法校验和类型校验等。之前写过react+ts的一个demo,但是时间久了就忘记了,现在也是趁着热度再回顾一下ts的内容,以及一些高阶语法,现在我们回顾一下ts中常见的类和接口。

class

首页我们要清楚的一点是 TypeScript 中类和 JavaScript 中ES6语法类的区别,千万不要混淆。ts 中相比于 js 添加了声明属性的类型和参数的类型以及返回结果类型。这个地方一看就会一写就不对,如果不声明 ts 会报错。

class Person{
    name:string;
    constructor(name:string){
        this.name = name;
    }
    getName():void{
        console.log(this.name);
    }
}
class Person{
    constructor(name){
        this.name = name;
    }
    getName(){
        console.log(this.name);
    }
}

ES5编辑后的结果

var Person = /** @class */ (function () {
    function Person(name) {
        this.name = name;
    }
    Person.prototype.getName = function () {
        console.log(this.name);
    };
    return Person;
}());

类的get和set

ts 在编译 get 和 set 的时候默认是 es3 编译,vscode 编辑器会报错error TS1056: Accessors are only available when targeting ECMAScript 5 and higher需要编译到版本 ES5 或以上,解决办法:$ tsc xxx.ts -t es5。

class User{
    myname:string;
    constructor(myname:string){
        this.myname = myname
    }
    get name(){
        return this.myname
    }
    set name(newName:string){
        this.myname = newName
    }
}

ES5编译后的结果

var User = /** @class */ (function () {
    function User(myname) {
        this.myname = myname;
    }
    Object.defineProperty(User.prototype, "name", {
        get: function () {
            return this.myname;
        },
        set: function (newName) {
            this.myname = newName;
        },
        enumerable: false,
        configurable: true
    });
    return User;
}());

这里有几个思考问题,答案见文末:

var u = new User("a");
console.log(u);
console.log(u.myname);
u.myname = 'b';
console.log(u.myname);
console.log(u.hasOwnProperty("name"));
console.log(Object.getPrototypeOf(u));
console.log(Object.getPrototypeOf(u).hasOwnProperty("name"));

抽象类

abstract关键字表示抽象类,抽象类是不能被实例化即new,只能被继承,抽象类一般是用来封装一些公共的,提供给子类使用的方法和属性的

abstract class Animal{
    public readonly name:string;
    protected age:number = 38;
    private money:number = 10;
    constructor(name:string){
        this.name = name
    }
}
class Dog extends Animal{
    static className = 'Dog'
    static getClassName(){
        console.log(this.className)
    }
    getName(){
        console.log(this.name)
    }
    getAge(){
        console.log(this.age)
    }
}
let a = new Animal("ss");

这里打印看一下继承的结果:

console.log(a); //Dog { age: 38, money: 10, name: 'ss' }

这里顺便说一下访问修饰符 public protected private

  • public 里里外外都能访问,包括自己、自己的子类、其他类都能
  • protected 自己和子类能访问但是其他地方不能访问
  • private 私有的(只有自己能访问,子类的其他都不能访问)

interface

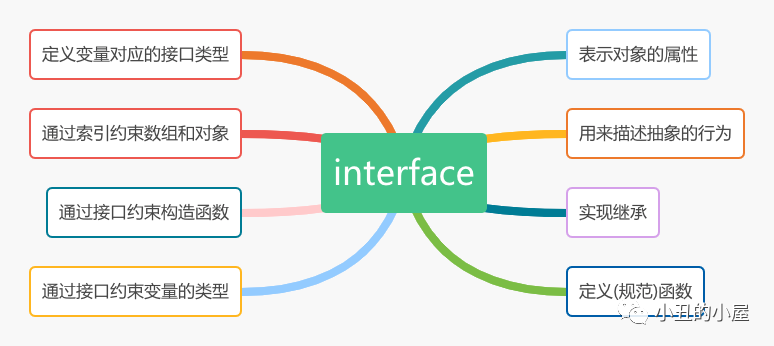
接口表示对象的属性

interface Rectangle {
    width: number;
    height: number
}


let r: Rectangle = {
    width: 100, height: 10
}


interface Speakable {
    speak(): void;
    name?: string
}


let speaker: Speakable = {
    //name:"bdt",
    speak() { }
}

接口用来描述抽象的行为

interface AnimalLink {
    eat(): void;
    move(): void
}

接口可以实现继承

interface PersonLike extends AnimalLink {
    speak(): void
}
class Person2 implements PersonLike {
    speak() { };
    eat() { };
    move() { }
}

通过接口约束变量类型

interface Person3 {
    readonly id: number;
    name: string;
    [PropName: string]: any
}
let p1: Person3 = {
    id: 1,
    name: "sss"
}

通过接口约束(规范)函数

interface DiscountInterface{
    (price:number):number
}
let discount:DiscountInterface = function (price: number): number {
    return price * .8
}

通过索引约束数组和对象

interface UserInterface{
    [index:number]:string
}


let arr:UserInterface = ['aa','bb']


interface UserInterface2{
    [index:string]:string
}
let obj:UserInterface2  = {name:"sss"}

通过接口约束构造函数

class Animal3{
    constructor(public name:string){}
}
interface WithClassName{
    new (name:string):Animal3
}
function createClass(clazz:WithClassName,name:string){
    return new clazz(name)
}
let a3 = createClass(Animal3,"别抖腿");
console.log(a3)

class和interface的区别

  • class 类声明并实现方法
  • interface 接口声明,但是不能实现方法
abstract class Animal{
    name:string="111";
    abstract speak():void;  //抽象类和方法不包含具体实现  必须在子类中实现
}
//接口里的方法都是抽象的
interface Flying{
    fly():void
}
interface Eating{
    eat():void
}
class Dog extends Animal{
    speak(){
        console.log("汪汪汪")   //重写:子类重写继承自父类中的方法
    }
}
class Cat extends Animal implements Flying,Eating{
    speak(){   //继承抽象类的方法必须实现
        console.log("喵喵喵")
    }
    fly(){
        console.log("我是一只飞货")
    }
    eat(){
        console.log("我是一只吃货")
    }
}

写在最后

文中答案

User { myname: 'a' }
a
b 
false
User { name: [Getter/Setter] }
true

以上就是W3Cschool编程狮关于TypeScript 中的class和interface的相关介绍了,希望对大家有所帮助。

SpringBoot 项目接入 Redis 集群

thbcm阅读(423)

文章来源于公众号:Java极客技术 作者:鸭血粉丝

想必大家一定对 Redis 不会陌生,平常工作中或多或少都会用到,不管是用来存储登录信息还是用来缓存热点数据,对我们来说都是很有帮助的。但是 Redis 的集群估计并不是每个人都会用到,因为很多业务场景或者系统都是一些简单的管理系统,并不会需要用到 Redis 的集群环境。

阿粉之前也是这样,项目中用的的 Redis 是个单机环境,但是最近随着终端量的上升,慢慢的发现单机已经快支撑不住的,所以思考再三决定将 Redis 的环境升级成集群。下面阿粉给大家介绍一下在升级的过程中项目中需要调整的地方,这篇文章不涉及集群的搭建和配置,感兴趣的同学自行搜索。

配置参数

因为这篇文章不介绍 Redis 集群的搭建,这里我们假设已经有了一个 Redis 的集群环境,我们项目中需要调整以下几个部分

  1. 修改配置参数,集群的节点和密码配置;
  2. 确保引入的 Jedis 版本支持设置密码,spring-data-redis 1.8 以上,SpringBoot 1.5 以上才支持设置密码;
  3. 注入 RedisTemplate;
  4. 编写工具类;

修改配置参数

############### Redis 集群配置 #########################
spring.custome.redis.cluster.nodes=172.20.0.1:7001,172.20.0.2:7002,172.20.0.3:7003
spring.custome.redis.cluster.max-redirects=3
spring.custome.redis.cluster.max-active=500
spring.custome.redis.cluster.max-wait=-1
spring.custome.redis.cluster.max-idle=500
spring.custome.redis.cluster.min-idle=20
spring.custome.redis.cluster.timeout=3000
spring.custome.redis.cluster.password=redis.cluster.password

引入依赖(如果需要)

确保 SpringBoot 的版本大于 1.4.x 如果不是的话,采用如下配置,先排除 SpringBoot 中旧版本 Jedis 和 spring-data-redis,再依赖高版本的 Jedis 和 spring-data-redis。


            org.springframework.boot
            spring-boot-starter-data-redis


                    redis.clients
                    jedis


                    org.springframework.data
                    spring-data-redis


            redis.clients
            jedis
            2.9.0


            org.springframework.data
            spring-data-redis
            1.8.0.RELEASE


注入 RedisTemplate

注入 RedisTemplate 我们需要三个组件,分别是JedisConnectionFactory 、RedisClusterConfiguration、JedisPoolConfig,下面是注入RedisTempalte 的代码。先根据配置创建 JedisConnectFactory 同时需要配置 RedisClusterConfiguration、JedisPoolConfig,最后将JedisConnectionFactory 返回用于创建RedisTemplate

import com.fasterxml.jackson.annotation.JsonAutoDetect;
import com.fasterxml.jackson.annotation.PropertyAccessor;
import com.fasterxml.jackson.databind.ObjectMapper;
import org.apache.commons.pool2.impl.GenericObjectPoolConfig;
import org.springframework.beans.factory.annotation.Value;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Primary;
import org.springframework.data.redis.connection.RedisClusterConfiguration;
import org.springframework.data.redis.connection.RedisNode;
import org.springframework.data.redis.connection.jedis.JedisClientConfiguration;
import org.springframework.data.redis.connection.jedis.JedisConnectionFactory;
import org.springframework.data.redis.core.RedisTemplate;
import org.springframework.data.redis.serializer.Jackson2JsonRedisSerializer;
import org.springframework.data.redis.serializer.StringRedisSerializer;


import java.time.Duration;
import java.util.ArrayList;
import java.util.List;


public class RedisClusterConfig {


    @Bean(name = "redisTemplate")
    @Primary
    public RedisTemplate redisClusterTemplate(@Value("${spring.custome.redis.cluster.nodes}") String host,
                                     @Value("${spring.custome.redis.cluster.password}") String password,
                                     @Value("${spring.custome.redis.cluster.timeout}") long timeout,
                                     @Value("${spring.custome.redis.cluster.max-redirects}") int maxRedirect,
                                     @Value("${spring.custome.redis.cluster.max-active}") int maxActive,
                                     @Value("${spring.custome.redis.cluster.max-wait}") int maxWait,
                                     @Value("${spring.custome.redis.cluster.max-idle}") int maxIdle,
                                     @Value("${spring.custome.redis.cluster.min-idle}") int minIdle) {


        JedisConnectionFactory connectionFactory =  jedisClusterConnectionFactory(host, password,
                timeout, maxRedirect, maxActive, maxWait, maxIdle, minIdle);
        return createRedisClusterTemplate(connectionFactory);
    }


    private JedisConnectionFactory jedisClusterConnectionFactory(String host, String password,
                                                                   long timeout, int maxRedirect, int maxActive, int maxWait, int maxIdle, int minIdle) {
        RedisClusterConfiguration redisClusterConfiguration = new RedisClusterConfiguration();
        List nodeList = new ArrayList();
        String[] cNodes = host.split(",");
        //分割出集群节点
        for (String node : cNodes) {
            String[] hp = node.split(":");
            nodeList.add(new RedisNode(hp[0], Integer.parseInt(hp[1])));
        }
        redisClusterConfiguration.setClusterNodes(nodeList);
        redisClusterConfiguration.setPassword(password);
        redisClusterConfiguration.setMaxRedirects(maxRedirect);


        // 连接池通用配置
        GenericObjectPoolConfig genericObjectPoolConfig = new GenericObjectPoolConfig();
        genericObjectPoolConfig.setMaxIdle(maxIdle);
        genericObjectPoolConfig.setMaxTotal(maxActive);
        genericObjectPoolConfig.setMinIdle(minIdle);
        genericObjectPoolConfig.setMaxWaitMillis(maxWait);
        genericObjectPoolConfig.setTestWhileIdle(true);
        genericObjectPoolConfig.setTimeBetweenEvictionRunsMillis(300000);


        JedisClientConfiguration.DefaultJedisClientConfigurationBuilder builder = (JedisClientConfiguration.DefaultJedisClientConfigurationBuilder) JedisClientConfiguration
                .builder();
        builder.connectTimeout(Duration.ofSeconds(timeout));
        builder.usePooling();
        builder.poolConfig(genericObjectPoolConfig);
        JedisConnectionFactory connectionFactory = new JedisConnectionFactory(redisClusterConfiguration, builder.build());
        // 连接池初始化
        connectionFactory.afterPropertiesSet();


        return connectionFactory;
    }


    private RedisTemplate createRedisClusterTemplate(JedisConnectionFactory redisConnectionFactory) {
        RedisTemplate redisTemplate = new RedisTemplate();
        redisTemplate.setConnectionFactory(redisConnectionFactory);


        Jackson2JsonRedisSerializer<Object> jackson2JsonRedisSerializer = new Jackson2JsonRedisSerializer(Object.class);
        ObjectMapper om = new ObjectMapper();
        om.setVisibility(PropertyAccessor.ALL, JsonAutoDetect.Visibility.ANY);
        om.enableDefaultTyping(ObjectMapper.DefaultTyping.NON_FINAL);
        jackson2JsonRedisSerializer.setObjectMapper(om);


        StringRedisSerializer stringRedisSerializer = new StringRedisSerializer();
        // key采用String的序列化方式
        redisTemplate.setKeySerializer(stringRedisSerializer);
        // hash的key也采用String的序列化方式
        redisTemplate.setHashKeySerializer(stringRedisSerializer);
        // value序列化方式采用jackson
        redisTemplate.setValueSerializer(jackson2JsonRedisSerializer);
        // hash的value序列化方式采用jackson
        redisTemplate.setHashValueSerializer(jackson2JsonRedisSerializer);
        redisTemplate.afterPropertiesSet();


        return redisTemplate;
    }
}

相关代码已经提交到GitHub,公众号回复【源码仓库】即可获取。这里一定要注意 Jedis 的 Spring-data-redis 的版本支持设置密码,毕竟生产环境是一定要配置密码的。

编写工具类

其实到这里基本上已经完成了,我们可以看到 SpringBoot 项目接入 Redis 集群还是比较简单的,而且如果之前单机环境就是采用RedisTemplate 的话,现在也就不需要编写工具类,之前的操作依旧有效。不过作为贴心的阿粉,我还是给大家准备了一个工具类,代码太长,我只贴部分,需要完成代码的可以到公众号回复【源码仓库】获取。

/**
     *  删除KEY
     * @param key
     * @return
     */
    public boolean delete(String key) {
        try {
            return getTemplate().delete(key);
        } catch (Exception e) {
            log.error("redis hasKey() is error");
            return false;
        }
    }


    /**
     * 普通缓存获取
     *
     * @param key 键
     * @return 值
     */
    public Object get(String key) {


        return key == null ? null : getTemplate().opsForValue().get(key);
    }


    /**
     * 普通缓存放入
     *
     * @param key   键
     * @param value 值
     * @return true成功 false失败
     */
    public boolean set(String key, Object value) {


        try {
            getTemplate().opsForValue().set(key, value);
            return true;
        } catch (Exception e) {
            log.error("redis set() is error");
            return false;
        }


    }


    /**
     * 普通缓存放入并设置时间
     *
     * @param key   键
     * @param value 值
     * @param time  时间(秒) time要大于0 如果time小于等于0 将设置无限期
     * @return true成功 false 失败
     */
    public boolean set(String key, Object value, long time) {
        try {
            if (time > 0) {
                getTemplate().opsForValue().set(key, value, time, TimeUnit.SECONDS);
            } else {
                set(key, value);
            }
            return true;
        } catch (Exception e) {
            log.error("redis set() is error");
            return false;
        }
    }


    /**
     * 计数器
     *
     * @param key 键
     * @return 值
     */
    public Long incr(String key) {


        return getTemplate().opsForValue().increment(key);
    }


    public Long incrBy(String key, long step) {


        return getTemplate().opsForValue().increment(key, step);
    }


    /**
     * HashGet
     *
     * @param key  键 不能为null
     * @param item 项 不能为null
     * @return 值
     */
    public Object hget(String key, String item) {


        return getTemplate().opsForHash().get(key, item);
    }


    /**
     * 获取hashKey对应的所有键值
     *
     * @param key 键
     * @return 对应的多个键值
     */
    public Map hmget(String key) {


        return getTemplate().opsForHash().entries(key);
    }


    /**
     * 获取hashKey对应的批量键值
     * @param key
     * @param values
     * @return
     */
    public List<Object> hmget(String key, List values) {


        return getTemplate().opsForHash().multiGet(key, values);
    }

上面随机列了几个方法,更多方案等待你的探索。

总结

今天阿粉给大家介绍了一下 SpringBoot 项目如何接入 Redis 集群,需要的朋友可以参考一下,不过阿粉还是要说一下,系统的设计不能过于冗余,如果短期内还能支撑业务的发展,那就暂时不要考虑太复杂,毕竟系统的架构是需要不断的完善的,不可能刚开始的时候就设计出一套很完善的系统框架。随着业务的不断发展,当真正发现单机 Redis 已经无法满足业务需求的时候再接入也不迟!

以上就是W3Cschool编程狮关于SpringBoot 项目接入 Redis 集群的相关介绍了,希望对大家有所帮助。

小程序云开发支持公众号网页开发了

thbcm阅读(385)

文章来源于公众号:Vue中文社区 作者:性感超人

小程序云开发,这波更新有料!

云开发(Tencent Cloud Base)

做前端的同学基本上或多或少都接触过 小程序 ,但是,接触过小程序的同学不一定接触过云开发

普及一下

云开发是一种典型的 Serverless 架构的实现方式,这里可能还有同学对 Serverless 不熟悉

我们再把这个词拆开,Server(服务器) less(不重要),可以理解为“无服务器”

试想一下,大多数公司和开发者在开发应用时和部署服务时,无论是选择公有云还是自建数据中心,都需要提前考虑服务器、存储和数据库等需求,并且需要花费时间精力在部署应用、依赖。那么是否有一种架构可以帮我们节省这部分的成本呢?有,就是我们的 Serverless(无服务器)架构

具体来说,Serverless 架构是指由第三方服务商负责后端基础结构的维护,以服务的方式为开发者提供如数据库、消息、身份验证等功能,架构的目的就是要让开发人员只需要专注业务本身

现在我们在回到小程序云开发本身,云开发官方封装了云函数、存储、云数据库的能力,一个函数调用,直接就实现了鉴权、文件上传、更新数据等最最常用的功能

两个字来说,就是真香

我们以一个更具体的功能来说

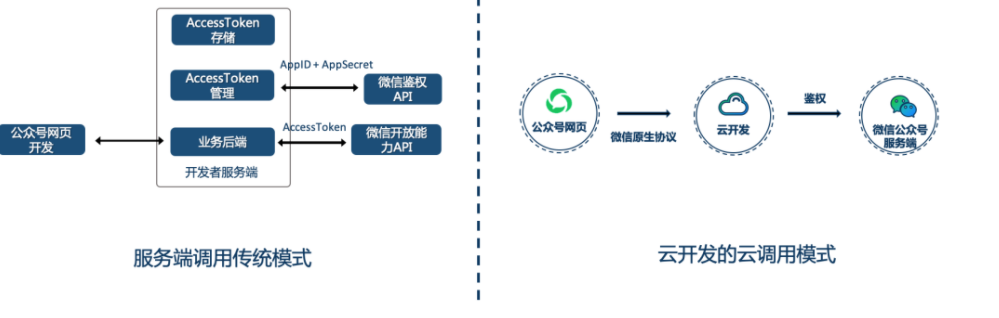
传统模式下我们想要调用微信登录,需要将 code 传给服务端,服务端将 code 拿去微信服务换取用户信息,自做存储,更新

而使用云开发时,我们只要调用一个api,没看错,就是一个api,一行代码完事

我们看下图对比一下

跨账号环境共享

小程序 的云开发一直都是一个appid对应一个独立云环境,这个怎么理解呢?

还是以实际场景举例,比如你有A,B,C三个小程序产品,你的某些数据可能需要共享的,如用户信息共享,商品信息共享

这个在发文前小程序云开发是没有这个能力处理的,所以想要实现要么就是自建共享数据服务,要么就是直接弃用云服务

好在今天它来了

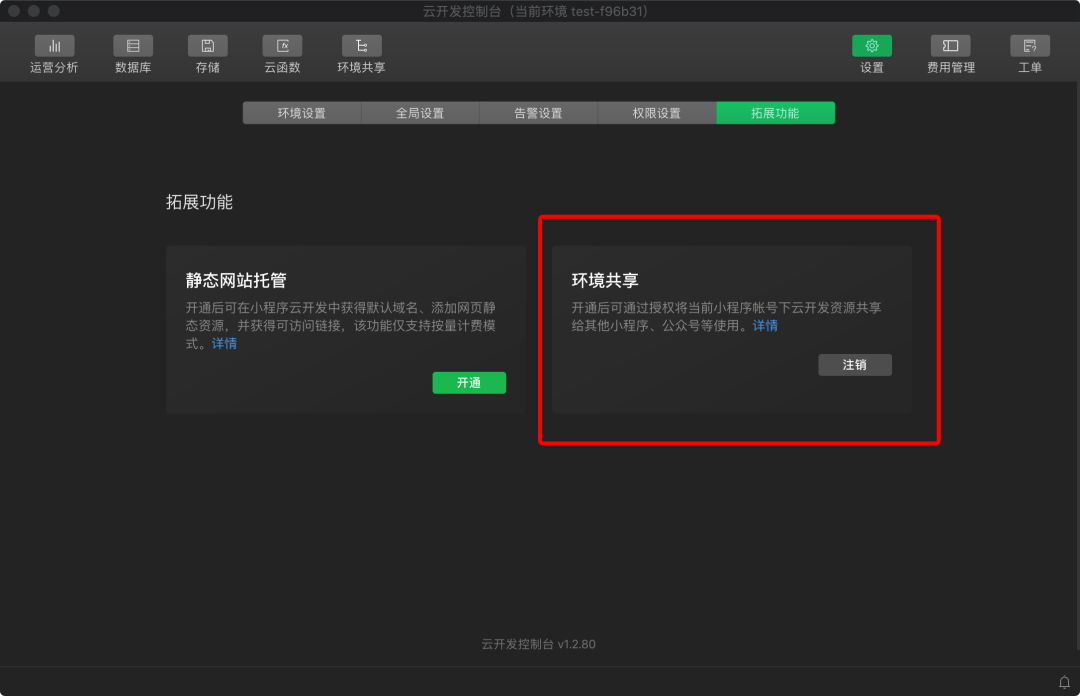
云开发支持跨账号环境(资源)共享,也就是一个小程序 的云开发资源可以授权给其他小程序 / 公众号使用

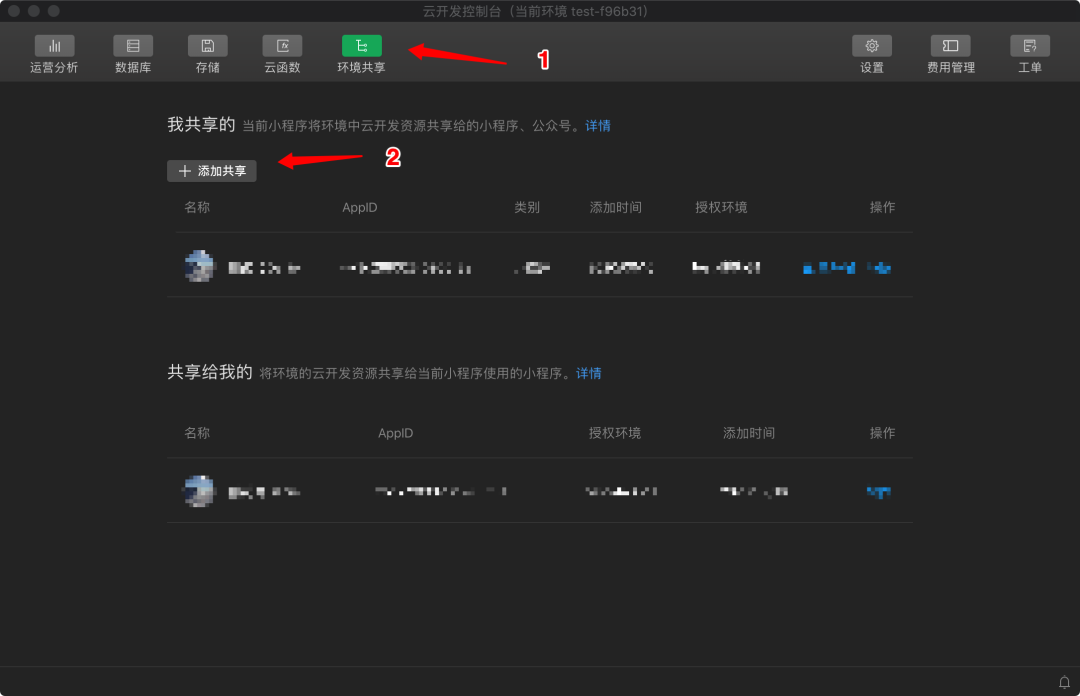
开通方式也很简单,只需要在云开发的后台进行给相应的小程序 / 公众号授权即可,如下图

公众号环境打通

细心的同学可能已经发现了,上面有提到公众号

What? 公众号也有云服务了吗?

是滴,这次更新云开发打通了公众号体系,公众号只要小程序给开通授权,再引入云开发的Web sdk 就可以直接使用小程序的云服务

对我们来说有什么好处

  • 资源复用

云开发小程序所有资源都可以在web端复用

  • 能力复用

云开发小程序所有能力都可以在web端复用(如你花两个星期写好的一个全是bug的云函数)

更直观的感受,比如我们之前 jssdk 的签名方式

wx.config({
  appId: '公众号 AppID', // 必填,公众号的唯一标识
  timestamp: res.timestamp + '', // 必填,生成签名的时间戳
  nonceStr: res.nonceStr, // 必填,生成签名的随机串
  signature: res.signature,// 必填,签名
  jsApiList: ['JS API 名'] // 必填,需要使用的JS接口列表
})

现在我们只需要这样

const res = await cloud.getJSSDKSignature({
  url: '要签名的网页 URL'
})

静态网站托管

这个词相信大家已经很熟了

当我们想布署一个静态的网页应用,博客,手头上暂时又没有域名,服务器的时候,我们可以将静态网站托管到第三方平台,比如同性交友github

那么小程序云开发的静态网站托管跟其它的有什么不同吗?

原则上没什么不同,但作为微信生态的一部分,在微信中有着天然优势

比如:

  • 小程序 webview

小程序不用配置业务域名即可在打开云开发静态网站托管的域名(仅支持能够使用标签的小程序)

  • 免鉴权直接打开小程序

非个人主体的认证的小程序,使用静态网站托管的网页,可以免鉴权跳转任意合法合规的小程序

写到这里,帅编突然邪魅一笑,是不是可以用静态网站托管做一个微信小程序的应用分发,然后躺着挣流量钱

最后

虽然吹了一波云开发,但还是得给个中肯建议

个人项目、功能简单的小程序可以尝试使用,那是真香

规模稍大以及企业级项目现阶段不建议完全使用,可按需混合使用

以上就是W3Cschool编程狮关于小程序云开发支持公众号网页开发了的相关介绍了,希望对大家有所帮助。

Moment.js官方推荐使用其它时间处理库代替

thbcm阅读(430)

文章来源于公众号:印记中文 译者:Phobal

近期,Moment.js 在官方文档中发布了项目状态,文中写道:Momentjs 正式进入维护期,不会再提供大版本更新,推荐使用其他时间处理库代替或使用 JavaScript 处于实验阶段的提案 Temporal。

以下是针对这篇项目状态的中文翻译。

Moment.js 已广泛应用于数百万个项目中,能帮助你处理网站中日期和时间的问题,我们感到万分荣幸。截至 2020 年 9 月,Moment 每周下载量超 1200 万次!然而 Moment 是为 JavaScript 生态系统的上一个时代而构建的。这些年 Web 发生翻天覆地的变化,Moment 紧随其后,但其设计与 2011 年创建时基本相同。鉴于有很多项目依赖它,所以我们优先考虑稳定性而非新功能。

Moment 对象是可变对象(mutable),这点经常被用户所诟病。尽管我们在 使用指南 中写明了如何解决此问题,但还是会有很多新用户犯错。而如果将 Moment 变为不可变对象(immutable)这会对已使用 Moment 的项目产生破坏性的影响。让 Moment 支持 immutable 本身就是件艰巨的任务,这将使 Moment 变为另外一个库,现阶段已有很多类似的库实现这个特性,所以让 Moment 保持 mutable 也没什么不好。

而大家所诟病的另一点就是 Moment 包的体积大小,而 tree shaking 对 Moment 无效,导致应用的包体积剧增。如果你的应用中需要用到国际化和时区,那么 Moment 可能会大到超乎想象。现代 Web 浏览器(和 Node.js)通过Intl 对象(其编号为 ECMA-402)实现了对国际化和时区支持。而像 Luxon 之类的库就利用了这一优势来降低库文件的大小。

最近,Chrome 开发工具会建议用户更换 Moment。我们也赞成此举动。

社区针对这个问题发表过很多文章:

  • 你可能不再需要 Moment.js
  • 你(可能)不需要 Moment.js
  • 为什么你不需要使用 Moment.js…
  • 4 个可替代 moment.js 的库,用于日期国际化

Moment 团队也针对这些问题做过详细的讨论。我们意识到可能已有项目会继续使用 Moment。但我们并不推荐你在新项目中使用它,相反,我们向大家 推荐 一些能更好应用于现代 web 的库。同时还推荐大家试用 JavaScript 处理时间的新提案 – Temporal,该提案需要大家的支持和贡献。

我们正式宣布 Moment 进入维护期,但并非消亡,只是完成了使命。

事实上,这意味着:

  • 不再添加新功能。
  • 不会将 API 变为 immutable。
  • 不会解决 tree shaking 及包体积的问题。
  • 不会进行任何重大更改(不会有 v3)。
  • 可能选择不对 bug 进行修复,特别是长期存在的已知 bug。

关于 Moment 的国际化语言环境文件:

  • 我们可能选择不接受对语言环境字符串或本地化日期格式的更正,特别是它们的现有格式已被论证时。
  • 语言环境发生重大改变时,必须提出令人信服的依据来支持你的立场。
  • 如果你要更改字符串或格式,那么你必须先在 CLDR 上提交更改申请并被接受后才可更改。

但是,由于 Moment 使用者还很多,当遇到以下问题时我们会及时进行处理:

  • 当出现严重的安全问题时,我们将予以解决。
  • 我们将在 IANA 时区数据库 发布更新后更新 Moment-Timezone 的数据。

需要继续使用 Moment 的场景

在大多数情况下,新项目请不要选择 Moment。但是,在一些特殊的场景下你可能还是需要使用它。

浏览器支持

Moment 能在 IE8 下完美运行。相比之下,Luxon 只能在 IE 10 及更高版本上运行,并且还需要搭配 polyfill 使用。你可以在 Luxon 的文档中了解更多相关内容。

其他库在 Safari 上也有相同的问题,尤其是在移动设备上。如果你必须要支持旧版浏览器,那可能还要继续使用 Moment。

但是,Day.js 支持 IE8 及更高版本,如果有兼容性相关的需求,你可以考虑使用它。

其他库的依赖

有些库,尤其是日期选择器和图形库,都将 Moment 作为依赖项,如果你正在使用类似的组件,且找不到替代方案,那么你的项目已经依赖了 Moment。你可以在项目中继续使用 Moment,而不需要再引入日期时间库。

忠实粉丝

如果你是 Moment 的忠实粉丝,那么你肯定非常了解它的 API 和局限性。如果是这样,并且不 care 上述问题,那可以继续使用它。

推荐一些替代库

有很多不错的库可以代替 Moment。

在做选择时,请考虑下面几点:

  • 有些库会被分割为模块,插件及配套库。
  • 有些库将 ECMAScript 的 Intl API 用于语言环境、时区或两者皆有。
  • 有些库仍像 Moment 和 Moment-Timezone 一样提供自己的语言环境和时区文件。

以下是我们推荐的替代方案:

Luxon

Luxon 可以认为是 Moment 的演变,它由 Moment 的长期撰稿人 Isaac Cambron 撰写。请阅读为什么会存在Luxon?以及 Luxon 文档中的 For Moment用户 相关文档。

  • 语言环境:Intl 实现
  • 时区:Intl 实现

Day.js

使用类似的 API,Day.js 被设计为 Moment.js 的极简替代品。它不是临时替代品,如果你习惯使用 Moment 的 API 并希望快速入门,请考虑使用 Day.js。

  • 语言环境:可以单独导入的自定义数据文件
  • 时区:Intl 通过插件实现

date-fns

Date-fns 提供了一系列用于处理 JavaScript Date 对象的函数。欲了解更多详细信息,请到date-fns 主页中阅读 “为什么使用 date-fns?” 一节。

  • 语言环境:可以单独导入的自定义数据文件
  • 时区:Intl 通过单独的库实现

js-Joda

js-Joda 是 Java 的 Three-Ten Backport 的 JavaScript 版本,该 backport 是根据 Java SE 8 java.time 包中 JSR-310 实现的基础。如果你熟悉java.time,Joda-Time 或 Noda Time,你会发现 js-Joda 具有可比性。

  • 语言环境:通过附加模块的自定义数据文件
  • 时区:通过附加模块的自定义数据文件

不使用任何第三方库

JavaScript 一直有一个 Date 对象,遵循了 ECMAScript(ECMA-262)的规范。

使用 Date 对象时,请注意以下几点:

  • 该 Date 对象内部具有毫秒精度的 Unix 时间戳。它提供了可以在系统本地时区之间来回转换的功能,但是内部始终是 UTC。与 Moment 对象不同,不能将其设置为使用其他时区。它并不存在“模式”的概念。
  • 使用 Date.parse 或 new Date() 在过去一直存在 bug,且实现不一。当前的规范 支持定义解析 ISO 8601 的字符串,其中只有日期的形式会(如 "2020-09-14")被解析为 UTC,而非 ISO 8601 中的当地时间。即便如此,也不是所有的现代浏览器都会按照这个标准来实现(例如 Safari)。其他类型的字符串也可以使用,但是解析它们是额外实现的,并且可能会有很大的不同,特别是对于旧版本的浏览器来说。实现方式以及传入字符串的不同,可能会产生不同的结果。由于这些原因,我们同意 MDN 的声明,即 强烈反对使用 Date 对象对字符串进行解析。

现代 JavaScript 环境也实现了 ECMA-402 的规范,提供了 Intl 对象,并在 Date 对象上定义了toLocaleString,toLocaleDateString 以及 toLocaleTimeString 等方法。

使用 Intl 对象时,请注意以下几点:

  • 并非每个环境都会实现完整的规范。特别是,Node.js 环境依赖 ICU 提供的国际化支持。有关更多详细信息,请参见 Node.js 文档。
  • ECMAScript Intl 兼容性列表 (由 kangax 提供) ,方便查询支持情况。
  • 多数较新的环境提供了通过 IANA 时区支持 timeZone 的 Intl.DateTimeFormat 构造函数(以及 Date.toLocaleString,Date.toLocaleDateString 和 Date.toLocaleTimeString)选项。该选项可用于获取对象的内部基于 UTC 的时间戳和获取已转换为命名时区的字符串。但是,它不能将 Date 对象转换为其他时区。

如果 Date 和 Intl 对象能满足你的需求,并且你完全了解它们的局限性,则可以考虑直接使用它们。

未来

Temporal – 使用 JavaScript 自带时间和日期处理方式会更好

将来,我们希望不再需要使用 JavaScript 相关的日期和时间处理库。而是直接使用 JavaScript 语言本身的特性。尽管今天有 Date 和提供了一些特性的 Intl,但我们从以往的经验和数据来看,它们仍有很大的改进空间。

从 ECMA TC39 的临时提案可以看出,组织正在努力为 JavaScript 语言编写更好的日期和时间 API。目前已处于 TC39 流程的第二阶段。

Temporal 将是一个充当顶级名称空间(如 Math)的新全局对象。它暴露了许多不同的类型的对象,包括 Temporal.Absolute,Temporal.DateTime,Temporal.Date,Temporal.Time,Temporal.TimeZone等。Temporal Cookbook 中包含了许多案例,并举例说明了如何在不同情况下使用这些对象。

你可以通过这个 实验性的 polyfill 来体验它,但还是不要在生产环境中使用它。

如果你有使用 Moment 或其他日期时间处理库的经验,并且对 temporal 提案感兴趣,欢迎参与讨论和开发。

以上就是W3Cschool编程狮关于Moment.js官方推荐使用其它时间处理库代替的相关介绍了,希望对大家有所帮助。

前端算法入门之「数据结构」

thbcm阅读(411)

前端算法入门 — 数据结构

1)什么叫算法?

算法就是计算或解决问题的步骤。

2)算法和程序有什么区别?

区别在于,程序是以计算机能够理解的编程语言编写的,可以在计算机上运行,而算法是以人类能够理解的数学方式来描述的,用于编程之前。但,算法和编程没有具体边界。

3)如何选择算法?

同样的问题,不同的开发者解法不同,不同的编程语言,写法不同,为算法设立评判标准的目的在于选择最优标准的算法。评判算法的优劣有两个标准:一是从运行到计算出结果需要耗费空间的大小,另一个是从运行到计算出结果需要花费多少时间。分别称为, 空间复杂度 、 时间复杂度 。通常,复杂度越低,耗费内存越少,执行越快,也更容易被人理解。一般, 最为重视的是算法的运行时间 。

4)如何反映算法的运行时间?

算法不同、设备不同、数据量不同都会导致算法时间有差异,通过理论计算出的运行时间是一个多项式,而我们需要能最直观的了解到时间随数据量变化的关系,常常会忽略掉非重要项,得到一个最简单的并且最能反映运行时间趋势的表达式,我们把:忽略掉不重要项、能最简表示运行时间随数据量变化关系写成O(n)的形式,其中O是大写,表示忽略重要项以外的内容,读音同order;n表示参与算法的数据量。

数据结构

为什么要有多种数据结构?

根据使用目的的不同,使用不同的数据类型,可以提供内存空间利用率。

1)链表

链表是数据结构之一,其数据呈线性排列;在内存空间中,数据是分散存储于内存中的,每个数据都由两部分组成,一部分是数据本身,另一部分是一个指针,它指向下一块存储空间。当对数据进行访问时,只能顺着指针指向一一往下访问,直到找到或者访问到末尾,如果链表中的数据量是n,那么,查找到一个数据,最快需要一次,最多需要查找n次;当需要在链表中添加或者删除一个数据时,只需要改变其中某一个或两个的数据指针即可,与链表的数据量无关,是常量级的。

小结:

链表数据是线性的,存储空间是不连续的,访问的时间复杂度为O(n),增删的时间复杂度为O(1)。

拓展:

循环链表:链表尾部的数据是没有指针的,当为尾部数据添加一个指向链表头部数据的指针时,链表指针之间就形成了环形结构,称为循环链表或环形链表。

双向链表:当链表内部指针既可以从前一个数据指向后一个数据同时也可以从后一个元素指向前一个数据时,就形成了双向链表。

这里要注意:在给出定义时就说了,数据由数据体本身和指针共同组成,当指针增加时,数据需要的存储空间也会增加,就会占用更多的内存。同时,当指针越多,增删数据时,需要改变的指针也就越复杂,需要改变指向的指针也越多。

2)数组

数组也是线性排列的数据结构之一,它与链表不同的地方在于,数组在内存空间的存储是连续的。当访问数组时,只需要根据数组索引找到对应位置即可,查找复杂度是常量级的,表示为O(1);而当对数组进行增加时,如果在数组头部增加,则需要先将数组扩容。然后将每一个元素都依次向后移动,这个过程复杂度是O(n),而如果在数组尾部增加一个元素,复杂度变成了O(1),同理,删除一个元素,尾部删除时为O(1),头部删除时为O(n)。可以看出,相比于链表,数组虽然查询方便了,但是操作复杂度却高了。

3)栈

栈是一种线性数据结构,当为栈添加一个元素时,这个元素被添加到了栈的最顶端,当取出元素时,只能单向的从最前面的位置读取,然后才能读取后面的元素,也就是说,最后被添加的,反而是最先被读取的,因此,栈被称为是后进先出(LIFO)模式,添加和删除数据的方式也被称为是入栈和出栈。由于栈具有的LIFO的特点,它常常被用来保存最新的数据。

4)队列

队列也是线性结构的数据结构,它与栈很像,都是单向的有序操作,但是,后进先出,而队列就像排队,先来的排在前面,后来的排在后面,属于先进先出(FIFO),要访问后面的元素,只能把前面的元素都访问完了,才能访问到目标元素。添加和删除队列的操作也被称为入队和出队。

5)哈希表

哈希表存储的是以键值对组合的数据,一般,把键当做数据的标识,而把值当做数据的内容。哈希表通常与哈希函数组合使用,在建立哈希表的过程中,需要使用哈希函数计算数据的哈希值,将其存在数组中,这样在访问时就可以快速使用数组的特性访问到;如果在建立数组的时候存在多个位于同一个数组位置的值,则再次使用链表存储相同的值。

哈希表的使用,加快了数组查询的速度,在灵活性和高效性上有很大的优势。在编程中,关联数组时常常会用到哈希表。

6)堆

堆是图的一种,是二维的数据结构,其示意可以用二位的树状图表示,子节点的数据值总比父节点大。在堆中,顶端的数据始终是最小的,所以无论多少数据量,取出最小值的复杂度始终都是O(1)。另外,由于取出数据后需要将最后的数据移动到最顶端,然后一边比较它与子节点数据的大小,一边往下移动,所以,取出数据需要的运行时间和树的高度成正比,假设数据量为n,根据堆的形状特点可知,树的高度为log2n,那么重构树的复杂度就是O(logn).添加数据也一样,在堆的最后添加数据,数据一边比较它与父节点的大小,一边往上移动,知道满足堆的条件为止。

如果需要频繁的从数据中取出最小值,那么,堆,是一种很好的选择。

7)二叉查找树

二叉查找树也叫作二叉搜索树,或二叉排序树。是二维的图结构的一种。它的特点是:每个节点最多有两个节点,分别称为左子树和右子树,每一个节点上的值均大于其左子树上的值,每个节点上的值均小于其右子树上的值。

根据这两个特点可知: 二叉查找树查找最小值要往左下末端找,查找最大值要往右下末端找 。

数据结构到底选哪种要根据使用目的来确定,前端常用的为以上7种。

以上就是W3Cschool编程狮关于前端算法入门之「数据结构」的相关介绍了,希望对大家有所帮助。

文章来源:www.toutiao.com/i6858491700608762380/

联系我们