Bootstrap框架如何用呢?快速上手

thbcm阅读(317)

什么是 Bootstrap?

Bootstrap 是一个用于快速开发 Web 应用程序和网站的前端框架。由 Twitter 的 Mark Otto 和 Jacob Thornton 合作开发的一套 HTML、CSS 和 JS 框架。Bootstrap 是基于 HTML5 和 CSS3 开发的,它在 jQuery 的基础上进行了更为个性化和人性化的完善,形成一套自己独有的网站风格,并兼容大部分 jQuery 插件。用过 HTML5 和 CSS3 的人都知道,现在一些高大上的网站都少不了 html5 和 css3。而Bootstrap 正式基于这些设计出来的,它为我们封装好了现成的 CSS 样式合集。供咱们直接引用。 初次接触,大家可以把它理解为一推 css 样式合集即可。

Bootstrap 有什么“过人之处”?

Bootstrap 内置样式非常漂亮,而且够用。与其把网站搞得花里胡哨,不如一切从简。Bootstrap 在 reset 浏览器样式之余,又添加了类 Twitter 的页面元素,咱们要做的只是使用,肆无忌惮地、放心地用,不用琢磨这个行高、计算那个宽度、让不小心忘记定义的页面元素尴尬地显示在页面上。因为这些Twitter 已经为咱们考虑设计好了, 而且出自 Twitter 之手,毕竟经受了亿万用户的考验,外加 Twitter 强大的设计团队的支持,更让这套框架显得与众不同。

当然 Bootstrap 的好处不止如此,不然 Bootstrap 也不会一经发布,就迅速红遍大江南北。

  • 移动设备优先:自 Bootstrap 3 起,框架包含了贯穿于整个库的移动设备优先的样式。
  • 浏览器支持:所有的主流浏览器都支持 Bootstrap。
  • 容易上手:只要具备 HTML 和 CSS 的基础知识,就可以开始学习 Bootstrap。下面会给出具体了例子,演示如何快速使用Bootstrap。
  • 响应式设计:Bootstrap 的响应式 CSS 能够自适应于台式机、平板电脑和手机。
  • 最主要的一点原因,它不仅好,而且是开源的。

(关于响应式设计这块是咱们web开发者将来所必所面对的,因为随着各种移动设备的不断发展,手机平板的盛行。这些移动设备大有成为主流之势。所以咱们必须要跟上潮流,搞好PC网站的同时也必须要考虑让网站适应其他终端。 )

Bootstrap的简单使用

这一部分主要说明一下 Bootstrap 的环境安装,文件结构,并且通过一个 demo 演示如何使用 Bootstrap。

首先下载 Bootstrap 的最新版本: http://v3.bootcss.com/getting-started/#download Bootstrap 提供了两种形式的压缩包,在下载下来的压缩包内可以看到以下目录和文件,这些文件按照类别放到了不同的目录内,并且提供了压缩与未压缩两种版本。 下载压缩包之后,将其解压缩到任意目录即可看到以下(压缩版的)目录结构: bootstrap/ ├── css/ │ ├── bootstrap.css │ ├── bootstrap.css.map │ ├── bootstrap.min.css │ ├── bootstrap-theme.css │ ├── bootstrap-theme.css.map │ └── bootstrap-theme.min.css ├── js/ │ ├── bootstrap.js │ └── bootstrap.min.js └── fonts/ ├── glyphicons-halflings-regular.eot ├── glyphicons-halflings-regular.svg ├── glyphicons-halflings-regular.ttf ├── glyphicons-halflings-regular.woff └── glyphicons-halflings-regular.woff2

上面展示的就是 Bootstrap 的基本文件结构:这里提供了编译好的 CSS 和 JS (bootstrap.) 文件,还有经过压缩的 CSS 和 JS (bootstrap.min.) 文件。同时还提供了 CSS 源码映射表(bootstrap.*.map) ,可以在某些浏览器的开发工具中使用。同时还包含了来自 Glyphicons 的图标字体,在附带的 Bootstrap 主题中使用到了这些图标。

关于压缩版和未经压缩版,使用的时候引用其中一个即可。

Demo

下面是使用了 Bootstrap 的 html 代码,给按钮添加了一些 Bootstrap 样式。

<!DOCTYPE html>
<html>
<head>
  <title>Bootstrap 实例 - 按钮选项</title>
<!-- 添加对Bootstrap的引用 -->
  <link href="http://libs.baidu.com/bootstrap/3.0.3/css/bootstrap.min.css" rel="stylesheet">
  <script src="http://libs.baidu.com/jquery/2.0.0/jquery.min.js"></script>
  <script src="http://libs.baidu.com/bootstrap/3.0.3/js/bootstrap.min.js"></script>
</head>
<body>

<!-- 标准的按钮 -->
<button type="button" class="btn btn-default">默认按钮</button>

<!-- 提供额外的视觉效果,标识一组按钮中的原始动作 -->
<button type="button" class="btn btn-primary">原始按钮</button>

<!-- 表示一个成功的或积极的动作 -->
<button type="button" class="btn btn-success">成功按钮</button>

<!-- 信息警告消息的上下文按钮 -->
<button type="button" class="btn btn-info">信息按钮</button>

<!-- 表示应谨慎采取的动作 -->
<button type="button" class="btn btn-warning">警告按钮</button>

<!-- 表示一个危险的或潜在的负面动作 -->
<button type="button" class="btn btn-danger">危险按钮</button>

<!-- 并不强调是一个按钮,看起来像一个链接,但同时保持按钮的行为 -->
<button type="button" class="btn btn-link">链接按钮</button>

</body>
</html>

演示效果:


可以看到上面的 html 代码中没有写任何其他的 css 代码,完全是引用 Bootstrap 的按钮样式。其中关键代码部分: class=”btn btn-default” btn:继承圆角灰色按钮的默认外观。 btn-default 是默认/标准按钮的样式。 要想更换其他的样式就更好其他的类即可,比如 btn-danger 是危险按钮。这些样式都在 bootstrap.min.css 文件中写好的一些样式,大家可以打开文件浏览一下。

就这样在不知不觉中就完成了对 Bootstrap 的使用,其他控件也都是不同的一些 class。在使用的时候注意经常查看官方文档,收获会很多。

另外,在引用 Bootstrap 的时候还需要特别注意一点:那就是 jquery.min.js 和 bootstrap.min.js 文件的引用顺序, 因为 Bootstrap 的所有 JavaScript 插件都依赖 jQuery,因此 jQuery 必须在 Bootstrap 之前引入。

关于 Bootstrap 的介绍先说这么多,我也是第一次接触到这个框架。但是通过这一个月的学习和使用情况来看,这套框架的确是有许许多多的优点,上手快、大大提高网页前段的设计效率、和质量等等。能够帮助我们以最短的时间搭建出一个高大上的网站。

技术人如何加速成长?提升你的思维和学习方式

thbcm阅读(361)

作者:涵爸

来源:阿里技术(ali_tech)

阿里妹导读:每个人都会经历一个新人的阶段,不管是初入职场,还是到一个新的工作环境。作为技术新人,我们常常会面临哪些困惑?普通人和非凡人的差异在哪里?除了体力上的勤奋,还有哪些方法可以加速成长?本文从第一性原理、结构化思维和多维度思考等方面分享如何从思维深度上提升自己,分享关于技术人成长之道的心得体会。

一 摘要

阿里优秀的人很多,他们身上共同的特质是什么?让我最佩服的是思考力强的人,对事情有深入洞见和观点的人。大多数人还停留在表面看问题,很多看法禁锢在思想里逃不出来。古人说,立德立言立功为三不朽,立言就是思考力和认知力,人和人的差异,在长久的职场中或者生活中,除去运气外,其实就是认知和思考力的差异。

这篇文章是给新人讲我个人的总结,技能的升级通过体力上的勤奋可以到达普通人的高度,当然到达比较好的段位,还需要天赋。但是认知和思考力的升级,不仅仅要靠勤奋,而且要有敏感和好奇心。因此本文首先立足于如何从思维深度上提升自己,只有在思维上体现不同,有深度,才能借助于阿里这么好的平台,才能做长足的发展。

二 新人的困惑

每个人都有新人的经历,也有新人的困惑,过几年后新人也慢慢变成了老人,有多少人能够真正收获成长呢?

  • 如何融入团队,如何在繁忙的业务中提升自己
  • 进来后发现和想象中有很大的差别,没有沉淀,完成功能为主
  • 业务对技术的挑战不多,学不到东西
  • 新人如何保证先活下来,然后再求发展
  • 事情很多,但是总不能很快拿到结果
  • 有没有快速成长的路线,能够有明显的进步和成长
  • 要学的东西太多,没人告诉我如何成长
  • 如何借助阿里的平台,有更好的收获

三 从普通人到非凡人的四个阶段,思维决定高度

我们大多数人生而平凡,但是如何让自己在看似平凡的工作和事业中,也有让自己小小的成就感和满足感,也能不枉此生?我们先看从普通的人到非凡人的差异,也给我们自己立个目标,超越自己。很多时候,我们在事业上停滞不前,往往是思维上禁锢了自己。人的思维层次很大程度上决定了人的发展。我从支付宝到集团,从AE到保险、到企业智能,见过让我非常佩服的人,他们的思维层次和格局、看问题的独特视角,让我受益非常多:

四 理解阿里的技术文化——新人成长的第一步

阿里有众多不同类型的业务,也有非常复杂的架构,也有很多文章阐述这些架构的来龙去脉到沉淀成今天的样子,这些架构都是非常好的学习案例。例如做供应链的业务,对履约、大宝、交易、库存、物流等核心系统的架构都有机会去了解,在企业智能也能学习到 ToB 业务的底层支撑架构、中间件(业务编排、服务编排、元数据、多租户、规则引擎、人财事物场的组织中台业务)。任何地方都有自己可以学习的地方,所以告诉新人的一点是,如果感觉到学习不到东西,可能是我们自己的认知出了问题,也可能是自己学习的方法不对。实际上阿里的技术文化,是促进成长的文化,但是这个文化,需要你去实践和执行、行动才能学到更多的东西:

其中最重要的是任何事情,不管做成这样的,别人说的,还是自己设计的架构和技术方案,都要问自己背后的 why 是什么。多问自己背后的 why 是锻炼思考力最基本的方式,锻炼多了,自己的思考力也会慢慢起来,未来无论做技术方案,还是对业务的理解、架构的理解,都有自己独到的思考。这也是学习各种技术框架,做架构设计最关键的基本的思考力。例如当一个新的技术出现,背后的驱动力到底是什么,为什么会出现这个技术,解决了什么问题,还有什么不足或者适配的使用场景?这些问题的背后也体现了对技术的好奇心和热爱,是成为一个好的技术人的关键。如果仅仅是为了 KPI,为了完成功能,永远做不好事情,也无法到达一定高度,枉费了此生。

五 从思维方式上入手,思考力提升后,成长就有了坚实的基础

1 第一性原理——锻炼了解背后的本质的能力,是提升思考力和做事逻辑的有力助手

第一性原理是因为马斯克而火起来,他非常擅长于把很多业务按照背后的本质和原理,再进行拆分。例如他创建的 SpaceX,如何低成本、安全地把人送到火星?假如单人送往火星的成本要1亿美金,要送 100 个人,如果每个人的成本降低 100 倍,那就变成了 100 万美金。特斯拉电动车如何降低成本?电动车的成本主要在电池上,去松下购买需要600美金/千瓦时,如果自己去做原料只需要 80 美金,因此马斯克选择了自己做电池厂。

做稳定性的时候,我们经常听老板或者架构师说要梳理依赖,但是背后具体是什么?所以后来我总结了稳定性公式,要提高稳定性,就要从梳理依赖走起,要么减少依赖(很多常见的手段去解决这个问题),要么提高依赖链路的可用性,要么用多冗余链路来提升稳定性。

学习技术框架也一样。我们要知道新的技术框架的第一性的是什么,解决了其它框架没有解决的问题是什么,这样的学习效率是最高的。很多人学习了很多技术,但是到最后也不知道,这些技术到底解决了什么问题,很多人只是停留在使用上。

很多时候,我们并不能很快了解背后的本质,但是我们可以慢慢沉淀、慢慢总结这些东西。有了这个方法后,我们的思维方式就不是从表面看问题,而是问自己背后的本质是什么,如同鲁肃关于技术人成长说到的,要化繁为简。对业务本质的理解,这个本质就是第一性。所以领域建模水平的高低,并不是一个简单的把用例梳理出来并提取名词来识别领域对象,更多的时候,是对业务本质的把控和理解,是对业务的问题域的精准理解。

2 结构化思维——让你解决问题的思路、表达更清晰

结构化思维,在说事情、做规划、做述职、做总结以及解决问题时,都有很多的应用场景。很多时候我们说不清楚问题,思维混乱,总结和述职的时候,直接线性思维,直接说明结果,但是背后的 why 是什么却不清楚。任何事情都有自己内在的结构,把结构解构出来,非常有助于解决问题,并且非常有逻辑,找到关键要素,去解决它,往往更有成效。

  • 结论先行:这个是初学者都会犯的错误,表述事情,说了一堆理由,最后告诉你一个结论,听起来费劲,逻辑也不清楚。结论先行,然后再表达推导这个结论的结构,思路要清晰很多。

  • 解构:将问题进行解构,可以形成完整的思维闭环,处理事情也不会形成遗漏。例如做资金安全的保障,要从事前、事中、事后的结构来解决资金安全的问题,往往不会形成遗漏,方案也更加清晰。

3 多维度思考——提高自己思考、设计、方案的全面性和深度

在辅导团队同学的时候,发现很多同学的思维非常线性,思考角度单一,让人感觉技术没有深度。

一个事情是多个角度、多个维度共同作用的结果,架构也是多个关注点分离分别满足的过程。从技术上来说,一定要有多维度思考的习惯,把方方面面考虑到,自然就有深度。

六 技术人的逻辑思维——理解环境变化、业务、组织阶段来制定策略

听过很多的技术规划,大多数没有任何策略,想到哪里做到哪里。策略是用来平衡组织人力、技术现状、业务现状的。事情永远是做不完的,人永远是不够的,任何一个事情,都不是一触而就的,不是所有的问题都要解决,但是一定要解决业务最痛的那个问题,解决最痛的点,并且制定出合理的路经,就是策略。所有脱离于实际和现状的规划都是纸上谈兵。策略是逐步走到远方的捷径,是最能匹配业务发展的方法,也是解决问题众多路经的最合理的路经之一。技术人一定要有策略思维,这也是逻辑思维的关键体现。

下面这个案例是以前团队做稳定性的时候,提出的治理策略,这一年稳定性实现了 0 故障、0 故障分(之前是故障多、故障分高)。策略因组织现状、人员现状、业务阶段、技术阶段不同而不同,一定是实例化的,稳定性治理不是把所有的规范、全景的治理方法照搬过来进行实施和操作,一定要找到关键的问题点去做策略,这样才能到达最好的结果。

七 后序

关于思考力,我其实有很多的感触。我们一直在路上奔波,很累很辛苦,但是成长却甚微。如今小时候的很多疑问也得到了解惑,小时候特别不解鲁迅为什么要弃医从文,也不理解周游列国的孔子,也不理解靠八股文、写文章写的好的人就能中进士中状元。人和人最大的差异就是认知和思考的能力,当然思考后也要有行动力,有思考也要有落地的能力。

新人从外面公司进来,有很多需要注意的地方。从思想上改变,从体力上的伪勤奋到思考上的真勤奋,是每一个新人的成长之道:

  • 总结自己行事的方法:解构、重组。从时间维度解构问题、按照业务节点解构问题。

  • 在不同的业务做实例化的架构和策略:要有逻辑的解构,把关键的点找到,并有逻辑地定义问题和制定策略,用四两拨千金的方式去拿到关键结果,把关键的问题解掉。

  • 总结属于自己独特的思考和逻辑:在支持业务时,我们总能接收到不同的信息,在做技术时,我们也能从外界得到很多输入和经验,但是一定要消化前人的总结,并根据自己的业务和技术的痛点,总结属于自己的观点。例如高内聚,低耦合,实际上在支撑业务时,表现出来的是边界错位,导致维护困难,形成缠绕式依赖。面对这种情况,我们可以自己总结成:边界原则,一个领域的边界确定了,职责就会清晰,依赖就简单了,维护性就更高了。

  • 做每件事,想想做这件事情的结构是什么:对业务来说,我们根据业务活动形成业务的闭环思维,这样可以把问题各个击破。如果要解决线上问题,一般可以按照时间序,将问题的处理分成前中后,这样就能找到关键的薄弱项进行优化,解决线上问题的效率会事半功倍。定义问题和分析价值,要能升维到客户思维、战略思维,不仅仅从自己的局部的业务看,我们总能找到最关键的价值去支持,去做策略。

  • 做每件事情,想想有没有更好的设计方案,每个方案的缺点是什么,学会用同一个维度来评价方案的优劣,这样深度就有了。

  • 先立再破:看别人的设计或者观点,有没有自己要学习的地方,先学习可以学习的地方,再去用辩证的思维看。很多时候,别人的设计和别人说的话,不一定是对的。

  • 对技术要有严格的逻辑思维,对每个链路的架构设计,对每个分层的复用架构,对每个名词,都要思考逻辑是否正确。

如何使用CSS?

thbcm阅读(322)

导读:本章主要讲解在 HTML 页面中如何使用 CSS 样式以及 CSS 的语法结构。通过本小节的学习,我们将掌握 CSS 语法中最为基础核心的内容。这些内容也将成为后续我们编写 CSS 样式代码必备的内容。

如何使用 CSS

CSS 样式主要的应用场景是在 HTML 页面中,其作用就是为 HTML 页面设置在浏览器运行后的显示效果。而在 HTML 页面使用 CSS 样式具有三种方式:

  • 内联样式
  • 内嵌样式表
  • 外联样式表

内联样式

HTML 元素的 style 属性的作用是为该元素设置 CSS 样式。如下示例代码所示展示了内联样式的写法:

<div style="color: lightcoral;">这是测试内容.</div>

内联样式的语法结构如下图所示:

但使用内联样式的缺点也非常明显,具体缺点如下:

  1. HTML 内容与 CSS 样式属于强耦合,并没有实现网页的内容和样式的有效分离。
  2. 如果为不同元素设置相同的 CSS 样式的话,会导致相同的 CSS 样式代码被重复定义,产生冗余代码。

内联样式表

HTML 元素中的 元素可以用来为当前 HTML 页面的元素设置 CSS 样式。如下示例代码所示展示了内嵌样式表的写法:

<style type="text/css">
p {
color: lightcoral;
font-size: 24px;
}
</style>

使用内嵌样式表的优点在于解决内联样式中的两个问题:

  • HTML 内容与 CSS 样式的强耦合问题,使得网页的内容和样式有效地分离。
  • 如果为不同元素设置相同的 CSS 样式的话,只需要定义一次 CSS 样式代码。

但内嵌样式表依旧编写在 HTML 文件中。如果一个 HTML 页面中包含大量的 CSS 样式的话,会导致 HTML 文件变得很大,从而浏览器加载 HTML 页面时耗时变长。

外联样式

CSS 样式代码可以定义在一个 CSS 文件中,这样有效地解决了内嵌样式表中的问题。具体的做法如下所示:

  1. 创建一个扩展名为 .css 的文件,并且将 CSS 样式代码编写在这个文件中。
  2. 在 HTML 页面中,通过 元素中的 元素将创建的 CSS 文件引入到 HTML 页面中。如下示例代码所示展示了 “ 元素如何引入 CSS 文件:<link rel=”stylesheet” href=”style/demo.css”>1rel 属性:用来定义引入文件与当前 HTML 页面的关系,该属性值必须是链接类型值。href 属性:用来定义引入文件的 URL。说明:一个 HTML 页面允许引入多个 CSS 文件,多个 CSS 文件的加载顺序按照 HTML 页面引入的顺序进行加载。

外联样式表的加载过程

需要注意的是,外联样式表不会与 HTML 页面同步被浏览器加载。具体的加载过程如下所示:

  1. 浏览器会加载 HTML 页面并进行解析。
  2. 解析到 <link> 元素引入的 CSS 文件,并通过 href 属性读取到 CSS 文件的路径。
  3. 根据读取的路径,开始加载 CSS 文件并进行解析。

如下图所示展示了外联样式表的加载过程:

CSS语法结构

无论是以上三种方式引入 CSS 样式的哪一种,我们都需要学习 CSS 的语法结构,这也是学习 CSS 后续内容的基础。 如下示例所示展示了 CSS 样式的基本代码结构:

p {
color: lightcoral;
font-size: 24px;
}

如下图所示展示了CSS 的语法结构以及相关概念:

CSS 语法的基本结构可分为:

  • 选择器(Selector):用来定位当前 HTML 页面中的元素,可以是一个元素也可以是多个元素(元素集)。
  • 声明块(Declaration block):用来包含一个或多个 CSS 声明,其语法结构是一对花括号。

CSS 声明

CSS 语法结构中除了选择器之外,就是声明了。CSS 声明是一个由 CSS 定义的规则,具体的语法结构是一对键/值对形式。

CSS 声明的语法结构可分为:

  • 属性(Properties):用来定义 HTML 元素样式的方式,是由 CSS 给定的。例如 color 属性是用来定义元素的文本颜色等。
  • 属性的值(Property value):用来定义 HTML 元素的样式。例如 color 属性的值可以是 lightcoral 等。注意:不同的 CSS 属性对应的属性值是不同的。具体的可以参考 MDN提供的参考文档
  • 分隔符:是一个冒号(:),用来分隔 CSS 属性和值的。
  • 结束符:是一个分号(;),用来表示一个 CSS 声明结束。

CSS注释

CSS 与 HTML 同样提供了注释,其作用也与 HTML 的注释类似。不过 CSS 的注释语法与 HTML 不同,如下图所示展示了 CSS 注释的语法结构:

总结

本小节讲解了在 HTML 页面引入 CSS 样式的三种方式和 CSS 的语法结构,以及注释等内容。其中:

  • 三种引入 CSS 样式的方式,每一种都存在优点和缺点,要根据实际开发的情况选择使用哪一种引入 CSS 样式。
  • CSS 的语法结构,主要分为选择器和声明两块内容,这也是我们在后续章节中继续进行讲解的内容。
  • CSS 注释的作用与 HTML 注释类似,但语法结构不同。在实际开发中不要混淆。

际开发的情况选择使用哪一种引入 CSS 样式。

  • CSS 的语法结构,主要分为选择器和声明两块内容,这也是我们在后续章节中继续进行讲解的内容。
  • CSS 注释的作用与 HTML 注释类似,但语法结构不同。在实际开发中不要混淆。

CSS 中如何定义变量并使用

thbcm阅读(352)

CSS 中原生的变量定义语法是:–,变量使用语法是:var(–) ; 其中*表示我们的变量名称;

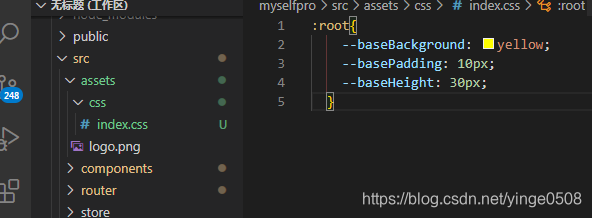
vue 项目中定义 css 全局变量的话:

1,首先在 assets 目录下新建 index.css 文件:(

:root 文档的根元素,这是一个放自定义属性的好地方,因为我们可以根据其他个别特别的样式的选择性来覆盖自定义属性)

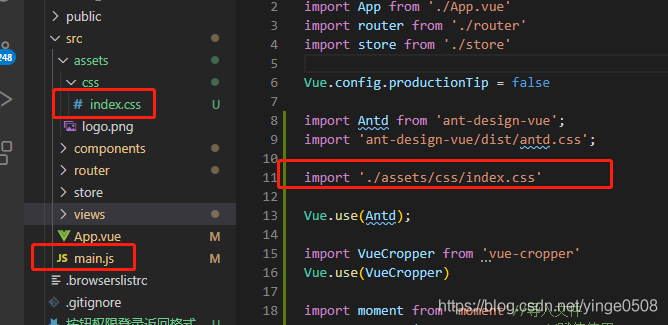
2,然后在 main.js 文件中引入:

3,使用:在 .vue 文件中的 style 中使用:

background:var(–baseBackground);

更多介绍:

css中定义变量
定义变量可分多种情况:
1、定义全局变量
:root {
--borderColor: #ccc;
}
使用:width:var(--borderColor);

2、定义某元素下的变量
.look{
--borderColor: #ccc;
}

3、定义媒体查询下的变量
@media screen and (min-width: 1025px) {
  :root {
      --borderColor: #ccc;
   }
}
使用:
.has-border-table > tr > td {
border-right: 1px solid var(--borderColor);
}
less中定义变量
定义:
@bg-color : #d9d9d9;
使用:
.has-border-table > tr > td {
border-right: 1px solid var(@bg-color);
}
sass中定义变量
定义:
$bg-color : #d9d9d9;
使用:
.has-border-table > tr > td {
border-right: 1px solid var($bg-color);
}

利用Python爬取当当、京东、亚马逊图书信息代码实例源码

thbcm阅读(314)

本文主要介绍了利用 Python 来爬取当当、京东、亚马逊平台上的图书信息代码实例,具有一定借鉴价值,正在学习Python爬虫 或正好有需要的朋友可以参考下。

注:

1.本程序采用 MSSQLserver 数据库存储,请运行程序前手动修改程序开头处的数据库链接信息;

2.需要 bs4、requests、pymssql 库支持;

3.支持多线程。

源码

from bs4 import BeautifulSoup 
import re,requests,pymysql,threading,os,traceback 

 
try: 
  conn = pymysql.connect(host='127.0.0.1', port=3306, user='root', passwd='root', db='book',charset="utf8") 
  cursor = conn.cursor() 
except: 
  print('\\\\n错误:数据库连接失败') 

 
#返回指定页面的html信息 
def getHTMLText(url): 
  try: 
    headers = {'User-Agent':'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/56.0.2924.87 Safari/537.36'} 
    r = requests.get(url,headers = headers) 
    r.raise_for_status() 
    r.encoding = r.apparent_encoding 
    return r.text 
  except: 
    return '' 
#返回指定url的Soup对象 
def getSoupObject(url): 
  try: 
    html = getHTMLText(url) 
    soup = BeautifulSoup(html,'html.parser') 
    return soup 
  except: 
    return '' 
#获取该关键字在图书网站上的总页数 
def getPageLength(webSiteName,url): 
  try: 
    soup = getSoupObject(url) 
    if webSiteName == 'DangDang': 
      a = soup('a',{'name':'bottom-page-turn'}) 
      return a[-1].string 
    elif webSiteName == 'Amazon': 
      a = soup('span',{'class':'pagnDisabled'}) 
      return a[-1].string 
  except: 
    print('\\\\n错误:获取{}总页数时出错...'.format(webSiteName)) 
    return -1 

 
class DangDangThread(threading.Thread): 
  def __init__(self,keyword): 
    threading.Thread.__init__(self) 
    self.keyword = keyword 
  def run(self): 
    print('\\\\n提示:开始爬取当当网数据...') 
    count = 1 

   
    length = getPageLength('DangDang','http://search.dangdang.com/?key={}'.format(self.keyword))#总页数 
    tableName = 'db_{}_dangdang'.format(self.keyword) 

 
    try: 
      print('\\\\n提示:正在创建DangDang表...') 
      cursor.execute('create table {} (id int ,title text,prNow text,prPre text,link text)'.format(tableName)) 
      print('\\\\n提示:开始爬取当当网页面...') 
      for i in range(1,int(length)): 
        url = 'http://search.dangdang.com/?key={}&page_index={}'.format(self.keyword,i) 
        soup = getSoupObject(url) 
        lis = soup('li',{'class':re.compile(r'line'),'id':re.compile(r'p')}) 
        for li in lis: 
          a = li.find_all('a',{'name':'itemlist-title','dd_name':'单品标题'}) 
          pn = li.find_all('span',{'class': 'search_now_price'}) 
          pp = li.find_all('span',{'class': 'search_pre_price'}) 

 
          if not len(a) == 0: 
            link = a[0].attrs['href'] 
            title = a[0].attrs['title'].strip() 
          else: 
            link = 'NULL' 
            title = 'NULL' 

 
          if not len(pn) == 0: 
            prNow = pn[0].string 
          else: 
            prNow = 'NULL' 

 
          if not len(pp) == 0: 
            prPre = pp[0].string 
          else: 
            prPre = 'NULL' 
          sql = "insert into {} (id,title,prNow,prPre,link) values ({},'{}','{}','{}','{}')".format(tableName,count,title,prNow,prPre,link) 
          cursor.execute(sql) 
          print('\\\\r提示:正在存入当当数据,当前处理id:{}'.format(count),end='') 
          count += 1 
          conn.commit() 
    except: 
      pass 


class AmazonThread(threading.Thread): 
  def __init__(self,keyword): 
    threading.Thread.__init__(self) 
    self.keyword = keyword 

 
  def run(self): 
    print('\\\\n提示:开始爬取亚马逊数据...') 
    count = 1 
    length = getPageLength('Amazon','https://www.amazon.cn/s/keywords={}'.format(self.keyword))#总页数 
    tableName = 'db_{}_amazon'.format(self.keyword) 

     
    try: 
      print('\\\\n提示:正在创建Amazon表...') 
      cursor.execute('create table {} (id int ,title text,prNow text,link text)'.format(tableName)) 

   
      print('\\\\n提示:开始爬取亚马逊页面...') 
      for i in range(1,int(length)): 
        url = 'https://www.amazon.cn/s/keywords={}&page={}'.format(self.keyword,i) 
        soup = getSoupObject(url) 
        lis = soup('li',{'id':re.compile(r'result_')}) 
        for li in lis: 
          a = li.find_all('a',{'class':'a-link-normal s-access-detail-page a-text-normal'}) 
          pn = li.find_all('span',{'class': 'a-size-base a-color-price s-price a-text-bold'}) 
          if not len(a) == 0: 
            link = a[0].attrs['href'] 
            title = a[0].attrs['title'].strip() 
          else: 
            link = 'NULL' 
            title = 'NULL' 

 
          if not len(pn) == 0: 
            prNow = pn[0].string 
          else: 
            prNow = 'NULL' 

 
          sql = "insert into {} (id,title,prNow,link) values ({},'{}','{}','{}')".format(tableName,count,title,prNow,link) 
          cursor.execute(sql) 
          print('\\\\r提示:正在存入亚马逊数据,当前处理id:{}'.format(count),end='') 
          count += 1 
          conn.commit() 
    except: 
      pass 


class JDThread(threading.Thread): 
  def __init__(self,keyword): 
    threading.Thread.__init__(self) 
    self.keyword = keyword 
  def run(self): 
    print('\\\\n提示:开始爬取京东数据...') 
    count = 1 

 
    tableName = 'db_{}_jd'.format(self.keyword) 

     
    try: 
      print('\\\\n提示:正在创建JD表...') 
      cursor.execute('create table {} (id int,title text,prNow text,link text)'.format(tableName)) 
      print('\\\\n提示:开始爬取京东页面...') 
      for i in range(1,100): 
        url = 'https://search.jd.com/Search?keyword={}&page={}'.format(self.keyword,i) 
        soup = getSoupObject(url) 
        lis = soup('li',{'class':'gl-item'}) 
        for li in lis: 
          a = li.find_all('div',{'class':'p-name'}) 
          pn = li.find_all('div',{'class': 'p-price'})[0].find_all('i') 

 
          if not len(a) == 0: 
            link = 'http:' + a[0].find_all('a')[0].attrs['href'] 
            title = a[0].find_all('em')[0].get_text() 
          else: 
            link = 'NULL' 
            title = 'NULL' 

           
          if(len(link) > 128): 
            link = 'TooLong' 

 
          if not len(pn) == 0: 
            prNow = '¥'+ pn[0].string 
          else: 
            prNow = 'NULL' 
          sql = "insert into {} (id,title,prNow,link) values ({},'{}','{}','{}')".format(tableName,count,title,prNow,link) 
          cursor.execute(sql) 
          print('\\\\r提示:正在存入京东网数据,当前处理id:{}'.format(count),end='') 
          count += 1 
          conn.commit() 
    except : 
      pass 
def closeDB(): 
  global conn,cursor 
  conn.close() 
  cursor.close() 

 
def main(): 
  print('提示:使用本程序,请手动创建空数据库:Book,并修改本程序开头的数据库连接语句') 
  keyword = input("\\\\n提示:请输入要爬取的关键字:") 

 
  dangdangThread = DangDangThread(keyword) 
  amazonThread = AmazonThread(keyword) 
  jdThread = JDThread(keyword) 
   dangdangThread.start() 
  amazonThread.start() 
  jdThread.start() 
  dangdangThread.join() 
  amazonThread.join() 
  jdThread.join() 
   closeDB() 
   print('\\\\n爬取已经结束,即将关闭....') 
  os.system('pause') 

   
main() 

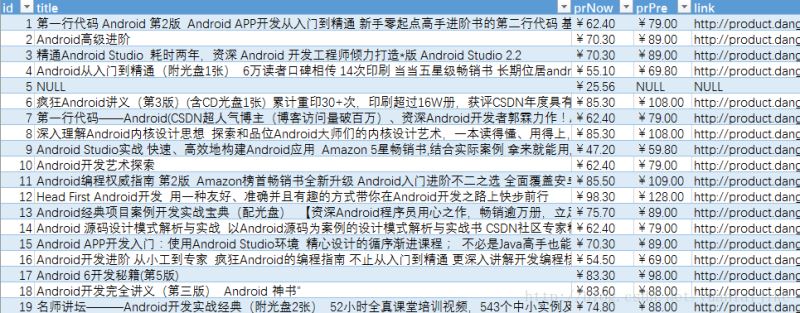
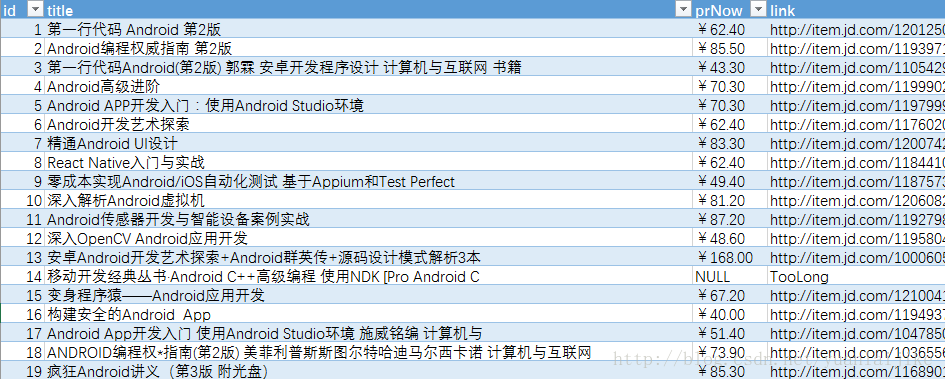
示例截图:

关键词:Android 下的部分运行结果(以导出至 Excel

总结

以上就是编程狮(w3cschool.cn) 为你整理的关于Python爬取当当、京东、亚马逊图书信息代码实例的全部内容,希望对大家有所帮助。

HTML页面中的head头部区域的编码书写规范

thbcm阅读(261)

我们这里所说的head区域,是指网页html代码的<head></head>之间的内容。在w3cschool.cn的文章中,主要介绍了大量的csshtml 入门知识,及其他前后端、Python 等编程技术教程。

今天我们简单的介绍一下head区域主要放置了哪些内容。这里就不强调css和javascript 了,这两者大家应该都有所了解了,如有不明白可在编程狮w3cschool查阅相关教程。

head区一般必须加入的标识有:

公司版权注释

<!--- the site is designed by W3Cschool 01/2021 ---> 

网页显示字符集

简体中文:

<meta http-equiv="content-type" content="text/html; charset=gb2312">

繁体中文:

<meta http-equiv="content-type" content="text/html; charset=big5">

英 语:

<meta http-equiv="content-type" content="text/html; charset=iso-8859-1">
或者:
<meta http-equiv="content-type" content="text/html; charset=utf-8">

原始制作者信息

<meta name="author" content="52css@w3cschool.cn"> 

网站简介

<meta name="description" content="这里填您网站的简介"> 

搜索关键字

<meta name="keywords" content="关键字1,关键字2,关键字3,..."> 

网页的css规范

<link href="style/style.css" rel="stylesheet" type="text/css"> 

网页标题

<title>这里是你的网页标题</title> 

head区可选加入的标识有:

<!--- 设定网页的到期时间。一旦网页过期,必须到服务器上重新调阅。 ---> 
<meta http-equiv="expires" content="wed, 26 feb 2058 08:21:57 gmt"> 


<!--- 禁止浏览器从本地机的缓存中调阅页面内容。 ---> 
<meta http-equiv="pragma" content="no-cache"> 


<!--- 用来防止别人在框架里调用你的页面。 ---> 
<meta http-equiv="window-target" content="_top"> 


<!--- 自动跳转(5指时间停留5秒)。 ---> 
<meta http-equiv="refresh" content="5;url=www.w3cschool.cn">


<!--- 网页搜索机器人向导.用来告诉搜索机器人哪些页面需要索引,哪些页面不需要索引。 ---> 
<meta name="robots" content="none">
<!--- content的参数有all,none,index,noindex,follow,nofollow。默认是all。  ---> 


<!--- 收藏夹图标 ---> 
<link rel = "shortcut icon" href="favicon.ico"> 

以上就是编程狮(w3cschool.cn)为你整理的关于HTML页面中的head头部区域的编码书写规范,希望对你有所帮助~

如何利用Python开发APP?

thbcm阅读(335)

作者:nmask

来源:WinTogether安全团队

我很早之前就想开发一款 app 玩玩,无奈对java不够熟悉,之前也没有开发 app 的经验,因此一直耽搁了。最近想到尝试用 python 开发一款 app ,google 搜索了一番后,发现确实有路可寻,目前也有了一些相对成熟的模块,于是便开始了动手实战,过程中发现这其中有很多坑,好在最终依靠 google 解决了,因此小记一番。

说在前面的话

python 语言虽然很万能,但用它来开发 app 还是显得有点不对路,因此用 python 开发的 app 应当是作为编码练习、或者自娱自乐所用,加上目前这方面的模块还不是特别成熟,bug比较多,总而言之,劝君莫轻入。

准备工作

利用 python 开发app需要用到 python 的一个模块–kivykivy是一个开源的,跨平台的 Python 开发框架,用于开发使用创新的应用程序。简而言之,这是一个 python 桌面程序开发框架(类似wxpython 等模块),强大的是kivy支持 linux、mac、windows、android、ios平台,这也是为什么开发app需要用到这个模块。 虽然 kivy 是跨平台的,但是想要在不同的平台使用 python 代码,还需要将 python 代码打包成对应平台的可执行程序,好在 kivy 项目下有个打包工具项目–、buildozer,这是官方推荐的打包工具,因为相对比较简单,自动化程度高,其他项目比如:python-for-android也能起到类似的作用,这里不展开介绍。

搭建kivy开发环境

需要在 pc 上安装 kivy 开发环境,这里演示下 mac 与 linux 下的安装过程。

install kivy for mac

安装一些依赖包:

brew install pkg-config sdl2 sdl2_image sdl2_ttf sdl2_mixer gstreamer

安装 cython 以及 kivy

pip install cython==0.25
pip install kivy

如果安装 kivy 报错,则使用下面的方式安装 kivy

git clone https://github.com/kivy/kivy
python setup.py install

安装后测试:

$python
Python 2.7.10 (default, Jul 15 2017, 17:16:57)
[GCC 4.2.1 Compatible Apple LLVM 9.0.0 (clang-900.0.31)] on darwin
Type "help", "copyright", "credits" or "license" for more information.
>>>
>>> import kivy
[INFO   ] [Logger      ] Record log in /Users/didi/.kivy/logs/kivy_18-05-08_4.txt
[INFO   ] [Kivy        ] v1.10.1.dev0, git-5f6c66e, 20180507
[INFO   ] [Python      ] v2.7.10 (default, Jul 15 2017, 17:16:57)
[GCC 4.2.1 Compatible Apple LLVM 9.0.0 (clang-900.0.31)]

说明:导入 kivy 模块没有报错则说明安装成功。

install kivy for centos7

先安装依赖:

yum install \\\\
make \\\\
mercurial \\\\
automake \\\\
gcc \\\\
gcc-c++ \\\\
SDL_ttf-devel \\\\
SDL_mixer-devel \\\\
khrplatform-devel \\\\
mesa-libGLES \\\\
mesa-libGLES-devel \\\\
gstreamer-plugins-good \\\\
gstreamer \\\\
gstreamer-python \\\\
mtdev-devel \\\\
python-devel \\\\
python-pip \\\\
java-devel

安装 cython 以及 kivy :

pip install Cython==0.20
pip install kivy

centos 安装 kivy 参考:在Linux上安装Kivy pip

说明:其他安装 kivy 方式可移步:kivy官方下载 (需要翻墙)

用kivy开发第一个python app

安装完 kivy 就可以开发 app 程序了,这里演示下 hello-world 程序,关于 kivy 更复杂的用法不是本文重点,后面再成文介绍。 1) 创建一个 main.py 文件,写入:

#! -*- coding:utf-8 -*-
from kivy.app import App
class HelloApp(App):
pass
if __name__ == '__main__':
HelloApp().run()

2)创建一个hello.kv文件,写入:

Label:
text: 'Hello, World! I am nMask'

简单说明:main.py是入口函数,定义了一个HelloApp类,该类继承kivy.apphello.kv文件是kivy程序,相当于定义界面风格等,该文件命名规则为类名小写且去除 app。

运行第一个python app

python main.py

运行结果:

安装buildozer工具

通过以上的编码,我创建了自己的第一个 python app 程序,该程序可以直接在 mac、linux、windows平台下运行,那么如何让它在安卓或者苹果手机上运行呢?我们知道在安卓上运行,需要将其打包成 apk 安装程序,因此就需要用到前面提到过的 buildozer 工具,(buildozer 工具可以打包 kivy 程序,支持 android、ios 等),buildozer的安装过程比较简单:

pip install buildozer

使用buildozer工具将kivy程序打包成apk

在 python 项目目录下运行:

buildozer init

运行成功将会创建一个配置文件 buildozer.spec,可以通过修改配置文件更改 app 的名称等,然后运行:

buildozer android debug deploy run

运行以上命令将会生成跨平台的安装包,可适用安卓、ios 等,如果用于安卓,则是利用 python-for-android 项目。

在第一次运行以上命令的时候,会自动在系统中下载安卓 sdk 等必要文件,如下图。(过程需要翻墙,而且有很多依赖需要下载)

说明:这里只演示打包成 apk 文件,iso 平台的可自行研究,Buildozer 参考文档

python apk程序测试

如果以上步骤都运行成功的话,应该会在项目目录下的 bin 目录下生成一个 apk 文件,类似如下:

然后将 apk 下载到安卓系统的手机上,安装即可,测试效果如下: 打开 app:

buildozer使用说明

Usage:
buildozer [--profile <name>] [--verbose] [target] <command>...
buildozer --version
Available targets:
android        Android target, based on python-for-android project
ios            iOS target, based on kivy-ios project
android_old    Android target, based on python-for-android project (old toolchain)
Global commands (without target):
distclean          Clean the whole Buildozer environment.
help               Show the Buildozer help.
init               Create a initial buildozer.spec in the current directory
serve              Serve the bin directory via SimpleHTTPServer
setdefault         Set the default command to run when no arguments are given
version            Show the Buildozer version
Target commands:
clean      Clean the target environment
update     Update the target dependencies
debug      Build the application in debug mode
release    Build the application in release mode
deploy     Deploy the application on the device
run        Run the application on the device
serve      Serve the bin directory via SimpleHTTPServer
Target "android_old" commands:
adb                Run adb from the Android SDK. Args must come after --, or
use --alias to make an alias
logcat             Show the log from the device
Target "ios" commands:
list_identities    List the available identities to use for signing.
xcode              Open the xcode project.
Target "android" commands:
adb                Run adb from the Android SDK. Args must come after --, or
use --alias to make an alias
logcat             Show the log from the device
p4a                Run p4a commands. Args must come after --, or use --alias
to make an alias

buildozer打包过程中的坑点

如果在打包过程中遇到报错,可以修改buildozer.spec配置文件中的log_level2,然后重新运行,可以看具体的错误信息。

报错:You might have missed to install 32bits libs

这个错是我在centos7上运行时报的错,大意是系统缺少了某些32位的依赖文件。 解决方案:

yum -y install --skip-broken glibc.i686 arts.i686 audiofile.i686 bzip2-libs.i686 cairo.i686 cyrus-sasl-lib.i686 dbus-libs.i686 directfb.i686 esound-libs.i686 fltk.i686 freeglut.i686 gtk2.i686 hal-libs.i686 imlib.i686 lcms-libs.i686 lesstif.i686 libacl.i686 libao.i686 libattr.i686 libcap.i686 libdrm.i686 libexif.i686 libgnomecanvas.i686 libICE.i686 libieee1284.i686 libsigc++20.i686 libSM.i686 libtool-ltdl.i686 libusb.i686 libwmf.i686 libwmf-lite.i686 libX11.i686 libXau.i686 libXaw.i686 libXcomposite.i686 libXdamage.i686 libXdmcp.i686 libXext.i686 libXfixes.i686 libxkbfile.i686 libxml2.i686 libXmu.i686 libXp.i686 libXpm.i686 libXScrnSaver.i686 libxslt.i686 libXt.i686 libXtst.i686 libXv.i686 libXxf86vm.i686 lzo.i686 mesa-libGL.i686 mesa-libGLU.i686 nas-libs.i686 nss_ldap.i686 cdk.i686 openldap.i686 pam.i686 popt.i686 pulseaudio-libs.i686 sane-backends-libs-gphoto2.i686 sane-backends-libs.i686 SDL.i686 svgalib.i686 unixODBC.i686 zlib.i686 compat-expat1.i686 compat-libstdc++-33.i686 openal-soft.i686 alsa-oss-libs.i686 redhat-lsb.i686 alsa-plugins-pulseaudio.i686 alsa-plugins-oss.i686 alsa-lib.i686 nspluginwrapper.i686 libXv.i686 libXScrnSaver.i686 qt.i686 qt-x11.i686 pulseaudio-libs.i686 pulseaudio-libs-glib2.i686 alsa-plugins-pulseaudio.i686 python-matplotli

参考:https://ask.fedoraproject.org/en/question/9556/how-do-i-install-32bit-libraries-on-a-64-bit-fedora/

报错:Error compiling Cython file

错误大意为cython文件出错,可能是cython模块没有安装,或者版本有问题。 解决方案:

pip install cython==0.25

报错:IOError: [Errno 2] No such file or directory…..

这是在打包的最后一步,将 apk 文件 copy 到项目bin目录下时报的错,是 buildozer 的一个 bug。 解决方案: 修改/usr/local/lib/python2.7/dist-packages/buildozer/tagets/android.py文件: (1)在文件开头导入:

from distutils.version import LooseVersion

(2) 将786行:XXX found how the apk name is really built from the title这一行以下的代码替换为:

__sdk_dir = self.android_sdk_dir
build_tools_versions = os.listdir(join(__sdk_dir, 'build-tools'))
build_tools_versions = sorted(build_tools_versions, key=LooseVersion)
build_tools_version = build_tools_versions[-1]
gradle_files = ["build.gradle", "gradle", "gradlew"]
is_gradle_build = any((exists(join(dist_dir, x)) for x in gradle_files)) and build_tools_version >= ’25.0'

buildozer虚拟机

kivy 官方推出了一个 buildozer 虚拟机镜像,已经安装好了 buildozer 以及一些依赖文件,为 buildozer 打包测试提供平台。由于之前我在 mac 上利用 buildozer 打包一直报错,后来换成 centos 也依然没有成功,因此便下载了此虚拟机,测试效果如下:

虚拟机下载地址:http://txzone.net/files/torrents/kivy-buildozer-vm-2.0.zip

说明:对于无法解决依赖问题的朋友,可以使用此虚拟机进行程序打包,开发环境还是推荐用自己的本机。

kivy开发实例

因为本文重点在于介绍如何利用kivy+buildozer开发一款 python app,因此对于kivy的开发过程,以及 app 功能进行了最简化。想要学习如何开发更复杂的 app,可参考:https://muxuezi.github.io/posts/kivy-perface.html#

Linux file 结构体和 inode 结构体

thbcm阅读(351)

在设备驱动程序中,一般需要关心两个结构体:file 和 inode。

1. file 结构体

file 结构体代表一个打开的文件,系统中每个打开的文件在内核空间都有一个关联的 struct file。

它由内核在打开文件时创建,并传递给在文件上进行操作的任何函数。在文件的所有实例都关闭后,内核释放这个数据结构。

注:在内核和驱动源代码中,struct file 的指针通常被命名为 file 或 filp(即 file pointer)。

struct file {
        union {
           struct llist_node         fu_llist;
           struct rcu_head          fu_rcuhead;
        } 
        f_u;
        struct path               f_path;
        struct inode              *f_inode;/* cached value */
        const struct file_operations      *f_op;/* 和文件关联的操作 */
        /*
         * Protects f_ep_links, f_flags.
         * Must not be taken from IRQ context.
         */
        spinlock_t                f_lock;
        enum rw_hint              f_write_hint;
        atomic_long_t              f_count;
        unsigned int              f_flags;/* 文件标志,如O_RDONLY、O_NONBLOCK、O_SYNC */
        fmode_t                 f_mode;/* 文件读/写模式,FMODE_READ、FMODE_WRITE */
        struct mutex              f_pos_lock;
        loff_t                  f_pos;/* 当前读写位置 */
        struct fown_struct        f_owner;
        const struct cred        *f_cred;
        struct file_ra_state        f_ra;
        u64                f_version;

        #ifdef CONFIG_SECURITY
        void *f_security;
        #endif
        /* needed for tty driver, and maybe others */
        void *private_data; /* 文件私有数据 */
        #ifdef CONFIG_EPOLL
        /* Used by fs/eventpoll.c to link all the hooks to this file */
        struct list_head f_ep_links;
        struct list_head f_tfile_llink;
        #endif /* #ifdef CONFIG_EPOLL */
        struct address_space *f_mapping;
        errseq_t f_wb_err;
    }
    __randomize_layout
  __attribute__((aligned(4)));/* lest something weird decides that 2 is OK */
  
    struct file_handle {
      __u32 handle_bytes;
      int handle_type;
      /* file identifier */
      unsigned char f_handle[0];
    };

文件读/写模式 mode、标志 f_flags 都是设备驱动关心的内容,而私有数据指针 private_data 在设备驱动中被广泛应用,大多被指向设备驱动自定义以用于描述设备的结构体。

2. inode 结构体

VFS inode 包含文件访问权限、属主、组、大小、生成时间、访问时间、最后修改事件等信息。它是 Linux 管理文件系统的基本单位,也是文件系统连接任何子目录、文件的桥梁,inode 结构体的定义如下:

struct inode {

        umode_t                        i_mode;

/* inode的权限 */

        unsigned short                i_opflags;

        kuid_t                        i_uid;

/* inode拥有者的id */

        kgid_t                        i_gid;

/* inode所属的群组id */

        unsigned int                i_flags;

#ifdef CONFIG_FS_POSIX_ACL

        struct posix_acl        *i_acl;

        struct posix_acl        *i_default_acl;

#endif

        const struct inode_operations        *i_op;

        struct super_block        *i_sb;

        struct address_space        *i_mapping;

#ifdef CONFIG_SECURITY

        void                        *i_security;

#endif

        /* Stat data, not accessed from path walking */

        unsigned long                i_ino;

        /*

         * Filesystems may only read i_nlink directly.  They shall use the

         * following functions for modification:

         *

         *    (set|clear|inc|drop)_nlink

         *    inode_(inc|dec)_link_count

         */

        union {

                const unsigned int i_nlink;

                unsigned int __i_nlink;

        };

        dev_t                        i_rdev;

/* 若是设备文件,此字段将记录设备的设备号 */

        loff_t                        i_size;

/* inode所代表的文件大小 */

        struct timespec                i_atime;

/* inode最近一次的存取时间 */

        struct timespec                i_mtime;

/* inode最近一次的修改时间 */

        struct timespec                i_ctime;

/* inode的产生时间 */

        spinlock_t                i_lock;

/* i_blocks, i_bytes, maybe i_size */

        unsigned short          i_bytes;

        unsigned int                i_blkbits;

        enum rw_hint                i_write_hint;

        blkcnt_t                i_blocks;

/* inode所使用的block数,一个block为512字节 */

#ifdef __NEED_I_SIZE_ORDERED

        seqcount_t                i_size_seqcount;

#endif

        /* Misc */

        unsigned long                i_state;

        struct rw_semaphore        i_rwsem;

        unsigned long                dirtied_when;

/* jiffies of first dirtying */

        unsigned long                dirtied_time_when;

        struct hlist_node        i_hash;

        struct list_head        i_io_list;

/* backing dev IO list */

#ifdef CONFIG_CGROUP_WRITEBACK

        struct bdi_writeback        *i_wb;

/* the associated cgroup wb */

        /* foreign inode detection, see wbc_detach_inode() */

        int                        i_wb_frn_winner;

        u16                        i_wb_frn_avg_time;

        u16                        i_wb_frn_history;

#endif

        struct list_head        i_lru;

/* inode LRU list */

        struct list_head        i_sb_list;

        struct list_head        i_wb_list; 

/* backing dev writeback list */

        union {

                struct hlist_head        i_dentry;

                struct rcu_head                i_rcu;

        };

        u64                        i_version;

        atomic_t                i_count;

        atomic_t                i_dio_count;

        atomic_t                i_writecount;

#ifdef CONFIG_IMA

        atomic_t                i_readcount;

/* struct files open RO */

#endif

        const struct file_operations        *i_fop;

/* former ->i_op->default_file_ops */

        struct file_lock_context        *i_flctx;

        struct address_space        i_data;

        struct list_head        i_devices;

        union {

                struct pipe_inode_info        *i_pipe;

                struct block_device        *i_bdev;

/* 若是块设备,为其对应的block_device结构体指针 */

                struct cdev                *i_cdev;

/* 若是字符设备,为其对应的cdev结构体指针 */

                char                        *i_link;

                unsigned                i_dir_seq;

        };

        __u32                        i_generation;

#ifdef CONFIG_FSNOTIFY

        __u32                        i_fsnotify_mask;

/* all events this inode cares about */

        struct fsnotify_mark_connector __rcu        *i_fsnotify_marks;

#endif

#if IS_ENABLED(CONFIG_FS_ENCRYPTION)

        struct fscrypt_info        *i_crypt_info;

#endif

        void                        *i_private;

/* fs or device private pointer */

} __randomize_layout;

Bootstrap组件介绍

thbcm阅读(329)

一、下拉菜单

用于显示链接列表的可切换、有上下文的菜单。下拉菜单的 JavaScript 插件让它具有了交互性。

1、实例

将下拉菜单触发器和下拉菜单都包裹在 .dropdown 里,或者另一个声明了 position: relative; 的元素。然后加入组成菜单的 HTML 代码。

<div class="dropdown">
 <button class="btn btn-default dropdown-toggle" type="button" id="dropdownMenu1" data-toggle="dropdown" aria-haspopup="true" aria-expanded="true">
  Dropdown
   <span class="caret"></span>
 </button>
 <ul class="dropdown-menu" aria-labelledby="dropdownMenu1">
   <li><a href="#">Action</a></li>
   <li><a href="#">Another action</a></li>
   <li><a href="#">Something else here</a></li>
   <li role="separator" class="divider"></li>
   <li><a href="#">Separated link</a></li>
 </ul>
</div>

  aria-haspopup :true表示点击的时候会出现菜单或是浮动元素; false表示没有pop-up效果。

  aria-expanded:表示展开状态。默认为undefined, 表示当前展开状态未知。其它可选值:true表示元素是展开的;false表示元素不是展开的

  aria-labelledby:当想要的标签文本已在其他元素中存在时,可以使用aria-labelledby,并将其值为所有读取的元素的id。如下:

  当ul获取到焦点时,屏幕阅读器是会读:“选择您的职位”

  data-toggle: 表示什么事件类型发生

二、按钮式下拉菜单

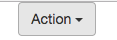
  把任意一个按钮放入 .btn-group 中,然后加入适当的菜单标签,就可以让按钮作为菜单的触发器了。

1、单按钮下拉菜单

<!-- Single button -->
<div class="btn-group">
 <button type="button" class="btn btn-default dropdown-toggle" data-toggle="dropdown" aria-haspopup="true" aria-expanded="false">
  Action <span class="caret"></span>
 </button>
 <ul class="dropdown-menu">
   <li><a href="#">Action</a></li>
   <li><a href="#">Another action</a></li>
   <li><a href="#">Something else here</a></li>
   <li role="separator" class="divider"></li>
   <li><a href="#">Separated link</a></li>
 </ul>
</div>

  鼠标指向时,显示背景颜色。

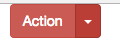
2、分裂式下拉菜单

只是多一个分开的按钮。

<!-- Split button -->
<div class="btn-group">
 <button type="button" class="btn btn-danger">Action</button>
 <button type="button" class="btn btn-danger dropdown-toggle" data-toggle="dropdown" aria-haspopup="true" aria-expanded="false">
   <span class="caret"></span>
   <span class="sr-only">Toggle Dropdown</span>​
 </button>
 <ul class="dropdown-menu">
   <li><a href="#">Action</a></li>
   <li><a href="#">Another action</a></li>
   <li><a href="#">Something else here</a></li>
   <li role="separator" class="divider"></li>
   <li><a href="#">Separated link</a></li>
 </ul>
</div>

  可以看到分成了左右两个按钮。

三、面板

某些时候你可能需要将某些 DOM 内容放到一个盒子里。对于这种情况,可以试试面板组件。

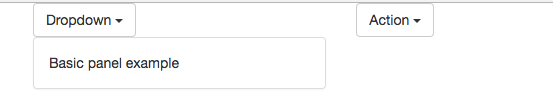
1、基本实例

默认的 .panel 组件所做的只是设置基本的边框(border)和内补(padding)来包含内容。

<div class="panel panel-default">
 <div class="panel-body">
  Basic panel example
 </div>
</div>

  显示效果:


2、带标题的面板

通过 .panel-heading 可以很简单地为面板加入一个标题容器。你也可以通过添加设置了 .panel-title 类的 <h1>-<h6> 标签,添加一个预定义样式的标题。不过,<h1>-<h6> 标签的字体大小将被 .panel-heading 的样式所覆盖。

为了给链接设置合适的颜色,务必将链接放到带有 .panel-title 类的标题标签内。

Bootstrap常见面试题

thbcm阅读(364)

1.为什么使用 bootstrap?

Bootstrap 具有移动设备优先、浏览器支持良好、容易上手、响应式设计等优点,所以 Bootstrap 被广泛应用。

2.为了让 Bootstrap 开发的网站对移动设备友好,确保适当的绘制和触屏缩放,需要在网页的 head 之中添加 viewport meta 标签,width 属性控制设备的宽度。假设您的网站将被带有不同屏幕分辨率的设备浏览,那么将它设置为 device-width 可以确保它能正确呈现在不同设备上。

initial-scale=1.0 确保网页加载时,以 1:1 的比例呈现,不会有任何的缩放。

在移动设备浏览器上,通过为 viewport meta 标签添加 user-scalable=no 可以禁用其缩放(zooming)功能。

通常情况下,maximum-scale=1.0 与 user-scalable=no 一起使用。这样禁用缩放功能后,用户只能滚动屏幕,就能让您的网站看上去更像原生应用的感觉,所以要加上以下代码:

<metanamemetaname="viewport" content="width=device-width,initial-scale=1">

3.对于各类尺寸的设备,Bootstrap 设置的 class 前缀分别是什么?

超小设备手机(<768px):.col-xs-

小型设备平板电脑(>=768px):.col-sm-

中型设备台式电脑(>=992px):.col-md-

大型设备台式电脑(>=1200px):.col-lg-

4. Bootstrap 如何设置响应式表格?

增加 class=”table-responsive”

5、使用 Bootstrap 创建垂直表单的基本步骤?

(1)向父<form>元素添加 role=”form”;

(2)把标签和控件放在一个带有 class=”form-group”的<div>中,这是获取最佳间距所必需的;

(3)向所有的文本元素<input>、<textarea>、<select>添加 class=”form-control”。

6、使用 Bootstrap 创建水平表单的基本步骤?

(1)向父<form>元素添加 class=”form-horizontal”;

(2)把标签和控件放在一个带有 class=”form-group”的<div>中;

(3)向标签添加 class=”control-label”。

7、使用 Bootstrap 如何创建表单控件的帮助文本?

增加 class=”help-block”的 span 标签或 p 标签。

8、使用 Bootstrap 激活或禁用按钮要如何操作?

激活按钮:给按钮增加 .active的class

禁用按钮:给按钮增加 disabled=”disabled”的属性

9、Bootstrap 有哪些关于<img>的 class?

(1).img-rounded 为图片添加圆角

(2).img-circle 将图片变为圆形

(3).img-thumbnail 缩略图功能

(4).img-responsive 图片响应式 (将很好地扩展到父元素)

10、Bootstrap 中有关元素浮动及清除浮动的 class?

(1)class=”pull-left” 元素浮动到左边

(2)class=”pull-right” 元素浮动到右边

(3)class=”clearfix” 清除浮动

11、除了屏幕阅读器外,其他设备上隐藏元素的 class?

class=”sr-only”

12、Bootstrap 如何制作下拉菜单?

(1)将下拉菜单包裹在 class=”dropdown”的<div>中;

(2)在触发下拉菜单的按钮中添加:class=”btn dropdown-toggle” id=”dropdownMenu1″ data-toggle=”dropdown”

(3)在包裹下拉菜单的ul中添加:class=”dropdown-menu” role=”menu” aria-labelledby=”dropdownMenu1″

(4)在下拉菜单的列表项中添加:role=”presentation”。其中,下拉菜单的标题要添加 class=”dropdown-header”,选项部分要添加 tabindex=”-1″。

13、Bootstrap 如何制作按钮组?以及水平按钮组和垂直按钮组的优先级?

(1)用 class=”btn-group”的<div>去包裹按钮组;class=”btn-group-vertical”可设置垂直按钮组。

(2)btn-group 的优先级高于 btn-group-vertical 的优先级。

14、Bootstrap 如何设置按钮的下拉菜单?

在一个 .btn-group 中放置按钮和下拉菜单即可。

15、Bootstrap 中的输入框组如何制作?

(1)把前缀或者后缀元素放在一个带有 class=”input-group”中的<div>中;

(2)在该<div>内,在 class=”input-group-addon”的<span>里面放置额外的内容;

(3)把<span>放在<input>元素的前面或后面。

16、Bootstrap 中的导航都有哪些?

(1)导航元素:有 class=”nav nav-tabs”的标签页导航,还有 class=”nav nav-pills”的胶囊式标签页导航;

(2)导航栏:class=”navbar navbar-default” role=”navigation”;

(3)面包屑导航:class=”breadcrumb”

17、Bootstrap 中设置分页的 class?

默认的分页:class=”pagination”

默认的翻页:class=”pager”

18、Bootstrap 中显示标签的 class?

class=”label”

19、Bootstrap 中如何制作徽章?

<span class="badge">26</span>

20、Bootstrap 中超大屏幕的作用是什么?

设置 class=”jumbotron” 可以制作超大屏幕,该组件可以增加标题的大小并增加更多的外边距。

联系我们