 小狮博客
网上各种言论说 React 上手比 Vue 难,可能难就难不能深刻理解 JSX,或者对 ES6 的一些特性理解得不够深刻,导致觉得有些点难以理解,然后说 React 比较难上手,还反人类啥的,所以我打算写两篇文章来讲新手学习 React 的时候容易迷惑的点写出来。
为什么要引入 React
在写 React 的时候,你可能会写类似这样的代码:
import React from 'react'


function A() {
  // ...other code
  return <h1>前端桃园</h1>
}
你肯定疑惑过,下面的代码都没有用到 React,为什么要引入 React 呢?
如果你把 import React from ‘react’ 删掉,还会报下面这样的错误:

那么究竟是哪里用到了这个 React,导致我们引入 React 会报错呢,不懂这个原因,那么就是 JSX 没有搞得太明白。
你可以讲上面的代码(忽略导入语句)放到在线 babel 里进行转化一下,发现 babel 会把上面的代码转化成:
function A() {
  // ...other code
  return React.createElement("h1", null, "前端桃园");
}
因为从本质上讲,JSX 只是为 React.createElement(component, props, ...children) 函数提供的语法糖。
为什么要用 className 而不用 class
- React 一开始的理念是想与浏览器的 DOM API 保持一直而不是 HTML,因为 JSX 是 JS 的扩展,而不是用来代替 HTML 的,这样会和元素的创建更为接近。在元素上设置
class需要使用className这个 API:
   const element = document.createElement("div")
element.className = "hello" - 浏览器问题,ES5 之前,在对象中不能使用保留字。以下代码在 IE8 中将会抛出错误:
   const element = {
    attributes: {
      class: "hello"
    }
} - 解构问题,当你在解构属性的时候,如果分配一个
class变量会出问题:
   const { class } = { class: 'foo' } // Uncaught SyntaxError: Unexpected token }
   const { className } = { className: 'foo' }
   const { class: className } = { class: 'foo' }
其他讨论可见:有趣的话题,为什么jsx用className而不是class
为什么属性要用小驼峰
因为 JSX 语法上更接近 JavaScript 而不是 HTML,所以 React DOM 使用camelCase(小驼峰命名)来定义属性的名称,而不使用 HTML 属性名称的命名约定。
来自 JSX 简介
为什么 constructor 里要调用 super 和传递 props
这是官网的一段代码,具体见:状态(State) 和 生命周期
class Clock extends React.Component {
  constructor(props) {
    super(props);
    this.state = {date: new Date()};
  }


  render() {
    return (
      <div>
        <h1>Hello, world!</h1>
        <h2>It is {this.state.date.toLocaleTimeString()}.</h2>
      </div>
    );
  }
}
而且有这么一段话,不仅让我们调用 super 还要把 props 传递进去,但是没有告诉我们为什么要这么做。
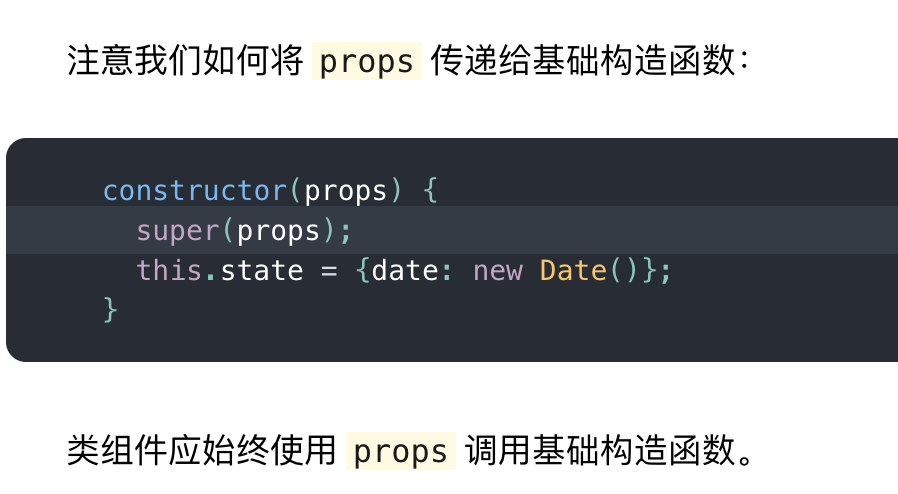
不知道你有没有疑惑过为什么要调用 super 和传递 props,接下来我们来解开谜题吧。
为什么要调用 super
其实这不是 React 的限制,这是 JavaScript 的限制,在构造函数里如果要调用 this,那么提前就要调用 super,在 React 里,我们常常会在构造函数里初始化 state,this.state = xxx ,所以需要调用 super。
为什么要传递 props
你可能以为必须给 super 传入 props,否则 React.Component 就没法初始化this.props:
class Component {
  constructor(props) {
    this.props = props;
    // ...
  }
}
不过,如果你不小心漏传了 props,直接调用了 super(),你仍然可以在 render和其他方法中访问 this.props(不信的话可以试试嘛)。
为啥这样也行?因为React 会在构造函数被调用之后,会把 props 赋值给刚刚创建的实例对象:
const instance = new YourComponent(props);
instance.props = props;
props 不传也能用,是有原因的。
但这意味着你在使用 React 时,可以用 super() 代替 super(props) 了么?
那还是不行的,不然官网也不会建议你调用 props 了,虽然 React 会在构造函数运行之后,为 this.props 赋值,但在 super() 调用之后与构造函数结束之前,this.props 仍然是没法用的。
// Inside React
class Component {
  constructor(props) {
    this.props = props;
    // ...
  }
}


// Inside your code
class Button extends React.Component {
  constructor(props) {
    super(); //  忘了传入 props
    console.log(props); //  {}
    console.log(this.props); //  undefined
  }
  // ...
}
要是构造函数中调用了某个访问 props 的方法,那这个 bug 就更难定位了。因此我强烈建议始终使用super(props),即使这不是必须的:
class Button extends React.Component {
  constructor(props) {
    super(props); //  We passed props
    console.log(props); //  {}
    console.log(this.props); //  {}
  }
  // ...
}
上面的代码确保 this.props 始终是有值的。
如果你想避免以上的问题,你可以通过class 属性提案 来简化代码:
class Clock extends React.Component {
  state = {date: new Date()};


  render() {
    return (
      <div>
        <h1>Hello, world!</h1>
        <h2>It is {this.state.date.toLocaleTimeString()}.</h2>
      </div>
    );
  }
}
更详细的内容可见Dan 的博客
为什么组件用大写开头
前面以及说过了,JSX 是 React.createElement(component, props, …children) 提供的语法糖,component 的类型是:string/ReactClass type,我们具体看一下在什么情况下会用到 string 类型,什么情况下用到 ReactClass type 类型
- string 类型react会觉得他是一个原生dom节点
- ReactClass type 类型 自定义组件
例如(string):在 jsx 中我们写一个
<div></div>转换为js的时候就变成了
React.createElement("div", null)例如(ReactClass type):在jsx中我们写一个
function MyDiv() {
    return (<div><div>)
}
转换为js的时候就变成了
function MyDiv() {
  return React.createElement("div", null);
}


React.createElement(MyDiv, null);
上边的例子中如果将MyDiv中的首字母小写,如下
function myDiv() {
    return (<div><div>)
}
转换为 js 的时候就变成了
function MyDiv() {
  return React.createElement("div", null);
}


React.createElement("myDiv", null);
由于找不到 myDiv 这个 dom,所以就会报错。
为什么调用方法要 bind this
前提知识:深刻的理解 JavaScript 中的 this
相信刚写 React 的时候,很多朋友可能会写类似这样的代码:
class Foo extends React.Component {
  handleClick () {
    this.setState({ xxx: aaa })
  }


  render() {
    return (
      <button onClick={this.handleClick}>
        Click me
      </button>
    )
  }
}
发现会报 this 是 undefined 的错,然后可能对事件处理比较疑惑,然后去看官网的事件处理有下面一段话:
你必须谨慎对待 JSX 回调函数中的
this,在 JavaScript 中,class 的方法默认不会绑定this。如果你忘记绑定this.handleClick并把它传入了onClick,当你调用这个函数的时候this的值为undefined。这并不是 React 特有的行为;这其实与 JavaScript 函数工作原理有关。通常情况下,如果你没有在方法后面添加
(),例如onClick={this.handleClick},你应该为这个方法绑定this。
然后你看了官网的例子和建议之后,知道需要为事件处理函数绑定 this就能解决,想下面这样:
class Foo extends React.Component {
  handleClick () {
    this.setState({ xxx: aaa })
  }


  render() {
    return (
      <button onClick={this.handleClick.bind(this)}>
        Click me
      </button>
    )
  }
}
但是可能你没有去思考过为什么需要 bind this?如果你不能理解的话,还是 js 的基础没有打好。
React 是如何处理事件的?
咱们先来了解一下 React 是如何处理事件的。
React 的事件是合成事件, 内部原理非常复杂,我这里只把关键性,可以用来解答这个问题的原理部分进行介绍即可(后面应该会写一篇 react 的事件原理,敬请期待)。
上篇文章已经说过,jsx 实际上是 React.createElement(component, props, …children) 函数提供的语法糖,那么这段 jsx 代码:
 <button onClick={this.handleClick}>
     Click me
 </button>
会被转化为:
React.createElement("button", {
     onClick: this.handleClick
}, "Click me")
了解了上面的,然后简单的理解 react 如何处理事件的,React 在组件加载(mount)和更新(update)时,将事件通过 addEventListener 统一注册到 document 上,然后会有一个事件池存储了所有的事件,当事件触发的时候,通过 dispatchEvent 进行事件分发。
所以你可以简单的理解为,最终 this.handleClick 会作为一个回调函数调用。
理解了这个,然后再来看看回调函数为什么就会丢失 this。
this 简单回顾
在函数内部,
this的值取决于函数被调用的方式。
如果你不能理解上面那句话,那么你可能需要停下来阅读文章,去查一下相关资料,否则你可能看不懂下面的,如果你懒的话,就看为你准备好的 MDN 吧。
通过上面对事件处理的介绍,来模拟一下在类组件的 render 函数中, 有点类似于做了这样的操作:
class Foo {
    sayThis () {
         console.log(this); // 这里的 `this` 指向谁?
     }


     exec (cb) {
         cb();
     }


    render () {
         this.exec(this.sayThis);
  }
}


var foo = new Foo();
foo.render(); // 输出结果是什么?
你会发现最终结果输出的是 undefined,如果你不理解为什么输出的是 undefined,那么还是上面说的,需要去深刻的理解 this 的原理。如果你能理解输出的是undefined,那么我觉得你就可以理解为什么需要 bind this 了。
那么你可能会问:为什么React没有自动的把 bind 集成到 render 方法中呢?在 exec 调用回调的时候绑定进去,像这样:
class Foo {
    sayThis () {
         console.log(this); // 这里的 `this` 指向谁?
     }


     exec (cb) {
         cb().bind(this);
     }


    render () {
         this.exec(this.sayThis);
  }
}


var foo = new Foo();
foo.render(); // 输出结果是什么?
因为 render 多次调用每次都要 bind 会影响性能,所以官方建议你自己在 constructor 中手动 bind 达到性能优化。
四种事件处理对比
对于事件处理的写法也有好几种,咱们来进行对比一下:
1. 直接 bind this 型
就是像文章开始的那样,直接在事件那里 bind this
class Foo extends React.Component {
  handleClick () {
    this.setState({ xxx: aaa })
  }


  render() {
    return (
      <button onClick={this.handleClick.bind(this)}>
        Click me
      </button>
    )
  }
}优点:写起来顺手,一口气就能把这个逻辑写完,不用移动光标到其他地方。
缺点:性能不太好,这种方式跟 react 内部帮你 bind 一样的,每次 render 都会进行 bind,而且如果有两个元素的事件处理函数式同一个,也还是要进行 bind,这样会多写点代码,而且进行两次 bind,性能不是太好。(其实这点性能往往不会是性能瓶颈的地方,如果你觉得顺手,这样写完全没问题)
2. constuctor 手动 bind 型
class Foo extends React.Component {
  constuctor(props) {
    super(props)
    this.handleClick = this.handleClick.bind(this)
  }
  handleClick () {
    this.setState({ xxx: aaa })
  }


  render() {
    return (
      <button onClick={this.handleClick}>
        Click me
      </button>
    )
  }
}优点:相比于第一种性能更好,因为构造函数只执行一次,那么只会 bind 一次,而且如果有多个元素都需要调用这个函数,也不需要重复 bind,基本上解决了第一种的两个缺点。
缺点:没有明显缺点,硬要说的话就是太丑了,然后不顺手(我觉得丑,你觉得不丑就这么写就行了)。
3. 箭头函数型
class Foo extends React.Component {
  handleClick () {
    this.setState({ xxx: aaa })
  }


  render() {
    return (
      <button onClick={(e) => this.handleClick(e)}>
        Click me
      </button>
    )
  }
}优点:顺手,好看。
缺点:每次 render 都会重复创建函数,性能会差一点。
4. public class fields 型
这种 class fields还处于实验阶段,据我所知目前还没有被纳入标准,具体可见这里。
class Foo extends React.Component {
  handleClick = () => {
    this.setState({ xxx: aaa })
  }


  render() {
    return (
      <button onClick={this.handleClick}>
        Click me
      </button>
    )
  }
}优点:好看,性能好。
缺点:没有明显缺点,如果硬要说可能就是要多装一个 babel 插件来支持这种语法。
总结
我平时用的就这四种写法,我这边从代码的美观性、性能以及是否顺手方便对各种写法做了简单的对比。其实每种方法在项目里用都是没什么问题的,性能方面基本上可以忽略,对于美观性和顺手比较主观,所以总体来说就是看大家的偏好咯,如果硬要推荐的话,我还是比较推荐第四种写法,美观而且不影响性能。
为什么要 setState,而不是直接 this.state.xx = oo
这个问题是我们公司后端写 React 的时候提出的问题,为啥不能直接修改 state,要 setState 一下。我在想,从 vue 转到 React 可能也会有这种疑问,因为 vue 修改状态都是直接改的。
如果我们了解 setState 的原理的话,可能就能解答这个问题了,setState 做的事情不仅仅只是修改了 this.state 的值,另外最重要的是它会触发 React 的更新机制,会进行 diff ,然后将 patch 部分更新到真实 dom 里。
如果你直接 this.state.xx == oo 的话,state 的值确实会改,但是改了不会触发 UI 的更新,那就不是数据驱动了。
那为什么 Vue 直接修改 data 可以触发 UI 的更新呢?因为 Vue 在创建 UI 的时候会把这些 data 给收集起来,并且在这些 data 的访问器属性 setter 进行了重写,在这个重写的方法里会去触发 UI 的更新。如果你想更多的了解 vue 的原理,可以去购买染陌大佬的剖析 Vue.js 内部运行机制。
不明白访问器属性的可以看这篇文章:深入理解JS里的对象
setState 是同步还是异步相关问题
1. setState 是同步还是异步?
我的回答是执行过程代码同步的,只是合成事件和钩子函数的调用顺序在更新之前,导致在合成事件和钩子函数中没法立马拿到更新后的值,形式了所谓的“异步”,所以表现出来有时是同步,有时是“异步”。
2. 何时是同步,何时是异步呢?
只在合成事件和钩子函数中是“异步”的,在原生事件和 setTimeout/setInterval等原生 API 中都是同步的。简单的可以理解为被 React 控制的函数里面就会表现出“异步”,反之表现为同步。
3. 那为什么会出现异步的情况呢?
为了做性能优化,将 state 的更新延缓到最后批量合并再去渲染对于应用的性能优化是有极大好处的,如果每次的状态改变都去重新渲染真实 dom,那么它将带来巨大的性能消耗。
4. 那如何在表现出异步的函数里可以准确拿到更新后的 state 呢?
通过第二个参数 setState(partialState, callback) 中的 callback 拿到更新后的结果。
或者可以通过给 setState 传递函数来表现出同步的情况:
this.setState((state) => {
    return { val: newVal }
})
5. 那表现出异步的原理是怎么样的呢?
直接讲源码肯定篇幅不够,可以看这篇文章:你真的理解setState吗?。
我这里还是用最简单的语言让你理解:在 React 的 setState 函数实现中,会根据 isBatchingUpdates(默认是 false) 变量判断是否直接更新 this.state 还是放到队列中稍后更新。然后有一个 batchedUpdate 函数,可以修改 isBatchingUpdates 为 true,当 React 调用事件处理函数之前,或者生命周期函数之前就会调用 batchedUpdate 函数,这样的话,setState 就不会同步更新 this.state,而是放到更新队列里面后续更新。
这样你就可以理解为什么原生事件和 setTimeout/setinterval 里面调用 this.state 会同步更新了吧,因为通过这些函数调用的 React 没办法去调用 batchedUpdate 函数将 isBatchingUpdates 设置为 true,那么这个时候 setState 的时候默认就是 false,那么就会同步更新。
最后
setState 是 React 非常重要的一个方法,值得大家好好去研究一下他的原理。
以上就是W3Cschool编程狮关于新手学习 react 迷惑的点(也可以复习,建议收藏!)的相关介绍了,希望对大家有所帮助。