Golang:判断interface是否为nil

thbcm阅读(309)

在Go语言中,接口(interface)是一种强大的类型,它能够存储任意类型的值。然而,当我们操作接口时,有时需要判断接口是否为空(nil)。本文将介绍几种判断Go语言接口是否为nil的技巧,帮助读者更好地处理接口空值情况。

接口与空值

在Go语言中,接口是一种抽象类型,它定义了一组方法的集合。接口变量可以持有任意实现了这组方法的具体类型的值。当接口变量未被赋值或赋值为nil时,即表示接口为空。
判断接口是否为nil的方法

以下是几种常用的方法来判断接口是否为nil:

  1. 方法一:使用类型断言
    可以使用类型断言(type assertion)来判断接口变量是否为nil。类型断言将接口变量转换为具体类型的值,并返回两个值:转换后的值和一个布尔值,表示转换是否成功。如果转换后的值为nil,那么原始的接口变量也为nil。例如:
    var i interface{} = nil
    if v, ok := i.(SomeType); ok && v == nil {
        // 接口为空
    }
  2. 方法二:判断接口变量的动态类型
    接口变量的动态类型信息可以通过使用reflect包来获取。通过​reflect.ValueOf​函数可以获取接口变量的值,然后可以使用​IsNil()​方法来判断其是否为nil。例如:
    var i interface{} = nil
    if reflect.ValueOf(i).IsNil() {
        // 接口为空
    }

    需要注意的是,使用reflect包的方法会带来一定的性能开销,所以在性能要求较高的场景下,最好避免频繁使用。

  3. 方法三:判断接口变量是否为nil值类型

    如果接口变量的底层类型是值类型(如int、bool、float64等),可以直接与其零值进行比较来判断接口是否为nil。例如:

    var i interface{} = nil
    if i == nil {
        // 接口为空
    }

    需要注意的是,这种方法仅适用于底层类型为值类型的情况,对于底层类型为引用类型(如mapslicechan等)的接口变量,无法使用此方法进行判断。

示例代码

下面是一个示例代码,演示了如何使用上述方法来判断接口是否为nil:

package main

import (
	"fmt"
	"reflect"
)

type SomeType struct{}

func main() {
	var i interface{} = nil

	// 方法一:使用类型断言
	if v, ok := i.(SomeType); ok && v == nil {
		fmt.Println("接口为空")
	}

	// 方法二:判断接口变量的动态类型
	if reflect.ValueOf(i).IsNil() {
		fmt.Println("接口为空")
	}

	// 方法三:判断接口变量是否为nil值类型
	if i == nil {
		fmt.Println("接口为空")
	}
}下面是一个示例代码,演示了如何使用上述方法来判断接口是否为nil:下面是一个示例代码,演示了如何使用上述方法来判断接口是否为nil:

总结

在Go语言中,接口的空值判断是我们在处理接口时常常遇到的问题。本文介绍了三种常用的方法来判断接口是否为nil,包括使用类型断言、判断接口变量的动态类型和判断接口变量是否为nil值类型。根据具体的场景和需求,选择合适的方法进行判断。通过掌握这些技巧,开发人员可以更好地处理接口空值问题,提高代码的健壮性和可靠性。
Python库xarray:强大的多维数据处理工具

thbcm阅读(342)

在数据科学和科学计算领域,处理多维数据是一项常见而重要的任务。Python库xarray是一个功能强大的工具,专门用于处理、分析和可视化多维数据集。本文将深入介绍xarray库的特性、用法和优势,帮助读者更好地理解和利用这个强大的数据处理工具。

xarray简介

xarray是一个开源的Python库,提供了一种灵活且高效的数据结构,用于处理具有标签维度的多维数组(也称为数据集)。它在NumPy的基础上构建,与Pandas紧密集成,并且为科学计算和数据分析提供了丰富的功能。

xarray的主要特点

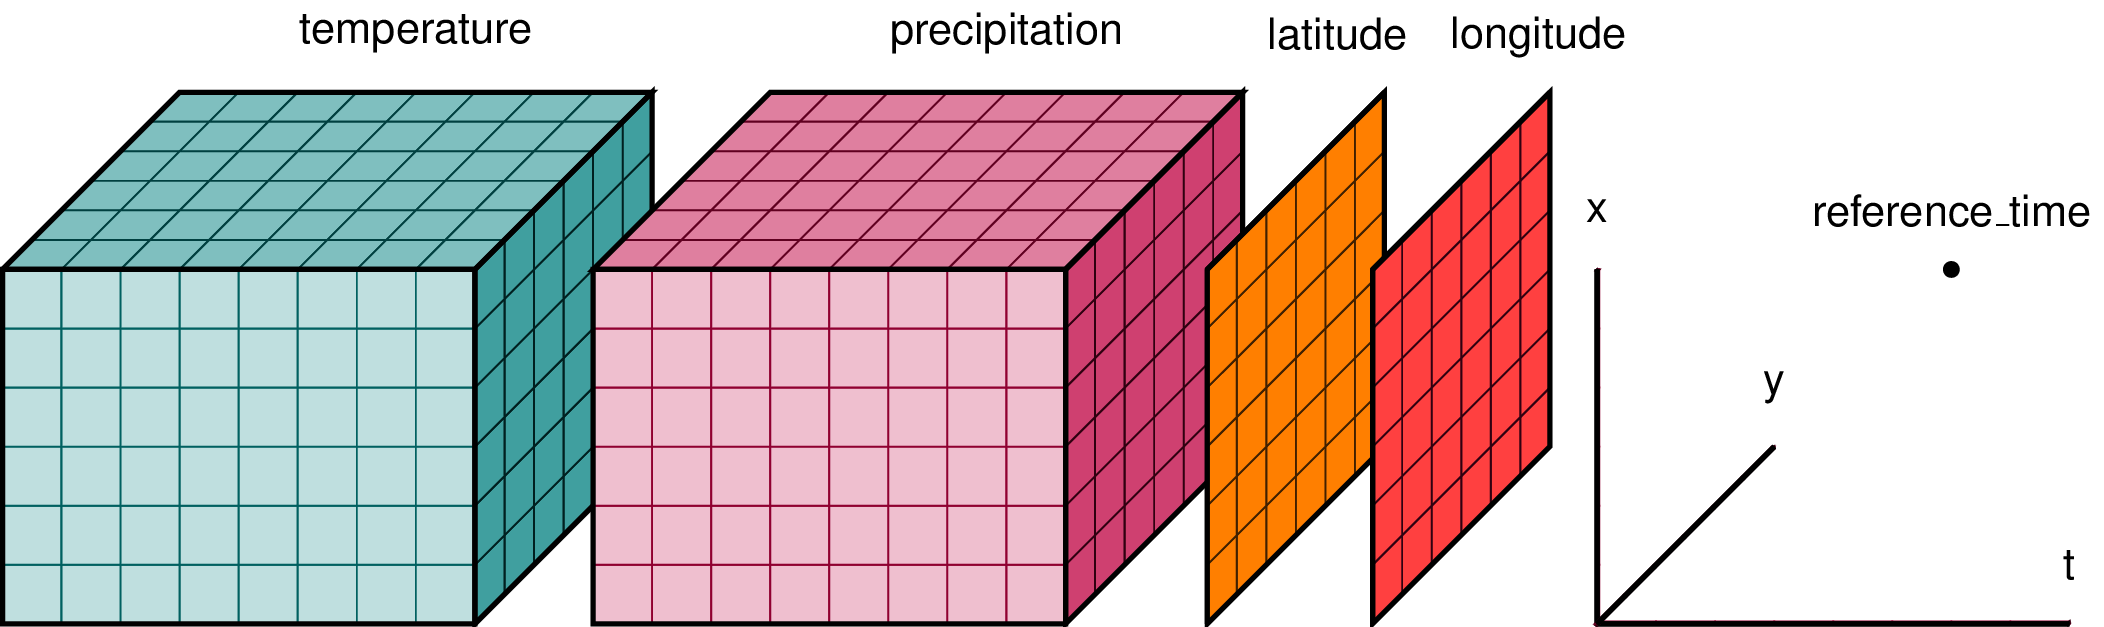
  • 标签维度:xarray引入了维度和坐标的概念,使得数据集的操作更加直观和灵活。每个维度都可以具有一个或多个坐标,从而提供了更丰富的数据索引和切片方式。
  • 数据集和数据数组:xarray提供了两种基本的数据结构,即DataArray和Dataset。DataArray用于表示单个多维数组,而Dataset用于表示多个具有相同维度的DataArray的集合。
  • 标签导向的操作:xarray支持基于标签的数据选择、索引和计算,使得数据处理更加直观和可读性更高。它提供了类似于Pandas的语法和功能,如标签索引、条件选择和数据分组。
  • 多维数据分析:xarray提供了丰富的功能,包括数据重塑、切片、合并、计算和统计分析等。它还支持快速的并行计算、内存映射和延迟计算,适用于处理大型数据集和高性能计算。

xarray的用法示例

下面是一些示例代码,展示了xarray库的常见用法:

  • 创建和加载数据集:
    import xarray as xr
    
    # 创建一个数据集
    ds = xr.Dataset({
        'temperature': ([['x', 'y'], [0, 1]], [[25.0, 28.0], [30.0, 27.5]]),
        'humidity': ([['x', 'y'], [0, 1]], [[60, 65], [70, 75]])
    })
    
    # 从文件加载数据集
    ds = xr.open_dataset('data.nc')

  • 数据选择和切片:
    # 根据标签选择数据
    temperature = ds['temperature']
    temperature = ds.temperature
    
    # 根据坐标切片数据
    subset = ds.sel(x=slice(0, 2), y=slice(0, 2))

  • 数据计算和统计分析:
    # 计算平均值
    mean_temperature = ds['temperature'].mean(dim='time')
    
    # 计算标准差
    std_temperature = ds['temperature'].std(dim=['x', 'y'])
    
    # 应用自定义函数
    def custom_function(arr):
        return arr.max() - arr.min()
    
    result = ds.apply(custom_function)

  • 可视化:
    # 绘制数据集
    ds.plot()
    
    # 绘制某个变量
    ds['temperature'].plot()
    
    # 绘制统计结果
    mean_temperature.plot()

xarray的优势和适用场景

xarray在处理多维数据方面具有许多优势,适用于以下场景:

  • 气象和气候科学:xarray提供了方便的工具和方法,用于处理气象、气候和地球科学领域的多维数据集。
  • 大数据集处理:xarray的并行计算、内存映射和延迟计算等功能使其非常适合处理大型数据集。它能够高效地处理大量数据,并且可以利用现代计算机的多核处理能力进行并行计算。
  • 数据分析和可视化:xarray的标签导向操作和与Pandas的紧密集成使其成为数据分析和可视化的强大工具。它提供了丰富的统计分析方法和灵活的可视化功能,能够帮助用户深入理解数据。
  • 交互式数据探索:xarray与Jupyter Notebook等交互式计算环境结合使用时,可以实现方便的数据探索和实验性分析。它的直观操作和可读性高的语法使得数据探索变得简单而愉快。

总结

xarray是一款强大而灵活的多维数据处理工具,为科学计算和数据分析提供了丰富的功能和工具。它的标签导向操作、多维数据分析和与Pandas的集成使其成为处理多维数据集的理想选择。通过掌握xarray的用法和特点,用户可以更高效地处理、分析和可视化多维数据,从而加快数据科学工作的进展。无论是处理气象数据、大数据集还是进行数据分析和可视化,xarray都能够发挥出色的效果,为用户带来便利和效益。

Java开发者的必备工具库——Hutool

thbcm阅读(312)

Hutool是一款为Java开发者设计的优秀工具库,它提供了丰富的功能和简化常见任务的方法,使得Java开发变得更加高效和便捷。本文将详细介绍Hutool的特点、功能和使用方法,展示它是如何成为Java开发者的全能工具库。

Hutool简介

Hutool是一个开源的Java工具库,由国内开发者林智能(looly)开发并维护。它的目标是提供一套简洁、易用且功能强大的工具,方便开发者处理常见的开发任务。Hutool的设计理念是”让工具更加简单”,它提供了一系列实用的工具类和方法,涵盖了字符串处理、日期时间操作、加密解密、文件操作、网络通信等方面。

Hutool的特点

  • 简单易用:Hutool的设计追求简洁和易用性,提供了简单而一致的API,使得开发者能够快速上手并提高开发效率。
  • 功能丰富:Hutool提供了大量的工具类和方法,涵盖了各种常见的开发任务,如字符串处理、集合操作、日期时间处理、加解密、文件操作、网络通信等,满足了开发中的多种需求。
  • 高性能:Hutool在实现上注重性能优化,采用了一些高效的算法和数据结构,使得它在处理大规模数据和高并发场景下表现出色。
  • 可靠稳定:Hutool经过广泛测试和实际应用验证,具有良好的稳定性和可靠性,可以放心使用于生产环境中。

Hutool的常用功能

  • 字符串处理:Hutool提供了丰富的字符串处理方法,如判断字符串是否为空、截取、拼接、格式化等,使得字符串操作更加简单便捷。
  • 日期时间操作:Hutool提供了方便的日期时间操作方法,支持日期格式化、解析、计算、比较等,简化了日期时间处理的繁琐步骤。
  • 加密解密:Hutool支持常见的加密解密算法,包括MD5、SHA1、AES、DES等,通过简单的API调用实现数据的加密和解密。
  • 文件操作:Hutool提供了文件读写、复制、移动、删除等操作的方法,方便开发者进行文件管理和处理。
  • 网络通信:Hutool封装了HTTP客户端和服务端的操作方法,支持HTTP请求发送和接收,简化了网络通信的实现。

Hutool的使用示例

<-- 导入Hutool依赖库 -->
<dependency>
    <groupId>cn.hutool</groupId>
    <artifactId>hutool-all</artifactId>
    <version>5.8.16</version>
</dependency>
public class HutoolExample {
    public static void main(String[] args) {
        // 字符串处理
        String str = "Hello, Hutool!";
        System.out.println(StrUtil.isEmpty(str)); // 判断字符串是否为空
        System.out.println(StrUtil.sub(str, 0, 5)); // 截取字符串

        // 加密解密
        String password = "123456";
        String encrypted = SecureUtil.md5(password); // 使用MD5加密
        System.out.println(encrypted);

        // 文件操作
        File file = new File("test.txt");
        FileUtil.writeUtf8String("Hello, Hutool!", file); // 写入文件

        // 日期时间操作
        DateTime now = DateUtil.date();
        System.out.println(DateUtil.formatDateTime(now)); // 格式化日期时间
    }
}

总结

Hutool是一款功能强大且易用的Java工具库,它提供了丰富的功能和简化常见任务的方法。通过使用Hutool,Java开发者可以提高开发效率,简化开发流程,并且享受到高性能和可靠性带来的优势。无论是字符串处理、日期时间操作、加密解密还是文件操作和网络通信,Hutool都提供了简单而强大的工具,使得开发变得更加便捷。如果您是Java开发者,不妨尝试使用Hutool,体验它为您带来的便利和效率提升。

Java死锁:线程间的致命握手

thbcm阅读(332)

在多线程编程中,死锁是一种常见而又棘手的问题。本文将深入探讨Java死锁的原因、如何识别死锁以及预防死锁的方法,帮助开发人员更好地理解和处理这一问题。

什么是死锁?

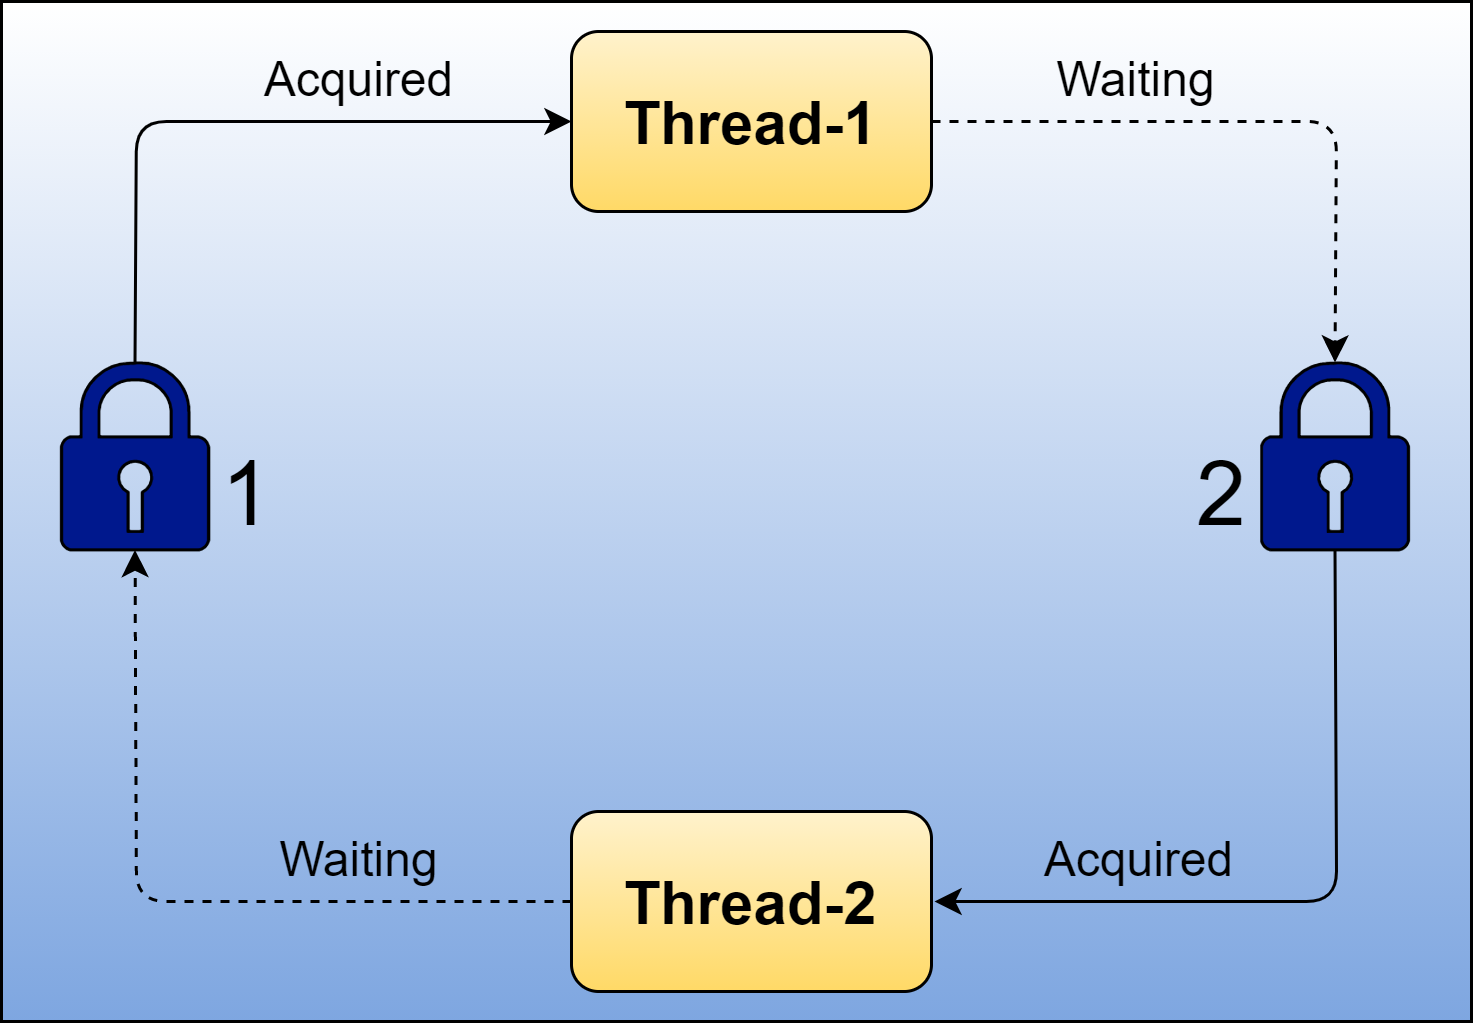
死锁(Deadlock)描述的是这样一种情况:多个进程/线程同时被阻塞,它们中的一个或者全部都在等待某个资源被释放。由于进程/线程被无限期地阻塞,因此程序不可能正常终止

死锁的原因

死锁指的是两个或多个线程互相等待对方持有的资源,导致程序无法继续执行的状态。死锁产生的主要原因是以下四个条件同时满足:

  • 互斥条件:至少有一个资源被标记为独占状态,一次只能被一个线程持有。
  • 请求与保持条件:一个线程在持有资源的同时又请求其他线程持有的资源。
  • 不剥夺条件:已经获得的资源在未使用完之前不能被其他线程剥夺。
  • 循环等待条件:存在多个线程形成循环等待资源的关系。

如何识别死锁

及时发现和解决死锁是至关重要的。以下是一些常用的方法来识别死锁:

  • 线程转储:通过获取线程转储信息,可以查看线程的状态以及它们等待的资源。如果多个线程都处于等待状态,并且彼此持有对方所需的资源,那么可能存在死锁。
  • 监控工具:使用监控工具可以实时监测程序的运行状态。一些监控工具可以检测到线程的等待和持有资源的情况,从而帮助发现潜在的死锁情况。
  • 日志分析:通过分析日志文件,可以查看线程在等待资源时的行为和状态。如果多个线程在等待彼此持有的资源,可能存在死锁。

预防死锁的方法

为了避免死锁的发生,可以采取以下预防措施:

  • 避免循环等待:尽量按照相同的顺序获取资源,避免出现循环等待的情况。
  • 加锁顺序:在获取多个资源时,确保所有线程按照相同的顺序获取资源,避免不同的线程以不同的顺序获取资源而导致死锁。
  • 超时机制:在获取资源时设置超时机制,如果一段时间内无法获取到资源,就放弃当前资源并释放已经获取的资源,避免长时间的等待。
  • 死锁检测和恢复:使用死锁检测算法来检测死锁的发生,一旦检测到死锁,可以采取相应的恢复策略,如中断某个线程或回滚操作。
  • 合理设计:在程序设计过程中,合理规划资源的使用方式,减少资源竞争的可能性,从而降低死锁的发生概率。

总结

Java死锁是多线程编程中常见的问题,它会导致程序无法继续执行。通过理解死锁的原因、识别死锁的方法和采取预防措施,我们可以更好地应对死锁问题。避免循环等待、加锁顺序、设置超时机制、死锁检测和恢复以及合理设计都是预防死锁的有效方法。通过合理的设计和仔细的分析,我们可以大大减少死锁的风险,确保多线程程序的稳定性和可靠性。

Faust :强大分布式流处理库

thbcm阅读(304)

Faust是一个功能强大的Python库,专为高性能、可伸缩和容错的分布式流处理任务而设计。本文将深入探索Faust库的特性、用法和应用场景,帮助读者更好地理解和利用这个优秀的工具。

 什么是Faust?

Faust是由Robinhood开发的Python库,旨在提供一种简单而强大的方式来进行分布式流处理。它基于Kafka消息队列和Python的协程(coroutines)机制,提供了可伸缩、容错的流处理框架。

Faust的主要特性

  • 高性能:Faust利用Kafka和协程的优势,能够实现高吞吐量和低延迟的流处理。
  • 可扩展:Faust支持水平扩展,可以轻松处理大规模的数据流。
  • 容错性:Faust具备故障恢复和容错机制,确保在节点故障时保持数据一致性。
  • 灵活性:Faust提供灵活的API和丰富的操作符,使开发者可以轻松定义和组合流处理任务。

Faust的用法

  • 安装Faust使用pip命令可以轻松安装Faust库:​pip install faust
  • 创建Faust应用通过定义Faust应用来开始使用库的功能。一个简单的Faust应用包括定义主题、流处理逻辑和启动应用等步骤。
  • 定义流处理逻辑使用Faust提供的API和操作符,开发者可以定义流处理任务的逻辑。可以进行数据转换、过滤、聚合等操作,以及与外部系统的交互。
  • 启动Faust应用一旦定义了流处理逻辑,可以通过调用Faust应用的main()方法来启动应用。Faust会自动连接到Kafka集群,并开始处理数据流。

示例代码

import faust

# 定义Faust应用
app = faust.App('my-app', broker='kafka://localhost:9092')

# 定义输入主题
input_topic = app.topic('my-topic')

# 定义输出主题
output_topic = app.topic('processed-topic')

# 定义流处理逻辑
@app.agent(input_topic)
async def process(stream):
    async for event in stream:
        # 在这里进行流处理操作
        processed_event = event.upper()  # 示例:将输入事件转换为大写
        await output_topic.send(value=processed_event)

# 启动Faust应用
if __name__ == '__main__':
    app.main()

Faust的应用场景

  • 实时数据处理:Faust适用于实时数据处理场景,如实时监控、实时分析和实时推荐等。它能够快速处理大量的数据流,并实时生成结果。
  • 异步任务处理:Faust的协程机制使其能够高效地处理异步任务。可以将异步任务作为数据流的一部分进行处理,实现高性能的异步处理。
  • 大数据处理:由于Faust的可伸缩性和容错性,它非常适合处理大规模的数据集。可以通过水平扩展来处理大量的数据流,实现高吞吐量的大数据处理。

总结

Faust是一个强大的分布式流处理库,为Python开发者提供了处理实时数据、异步任务和大数据处理的能力。通过了解Faust的特性、使用方法和应用场景,我们可以充分利用这个工具,构建高性能、可伸缩和容错的分布式流处理系统。无论是实时监控、实时分析还是大数据处理,Faust都能为我们提供强大的支持,让我们的数据处理任务更加高效和可靠。

MySQL流程控制:掌握条件语句与循环结构的使用

thbcm阅读(299)

MySQL是一种广泛应用的关系型数据库管理系统,具有强大的数据处理和存储能力。除了支持数据操作语言(DML)和数据定义语言(DDL)之外,MySQL还提供了流程控制语句,用于实现条件判断和循环结构。本文将深入介绍MySQL的流程控制,包括条件语句(IF、CASE)和循环结构(WHILE、LOOP),帮助读者灵活运用这些语句来处理复杂的业务逻辑。

条件语句

IF语句

IF语句是MySQL中最常用的条件语句之一,用于根据条件执行不同的操作。IF语句的基本语法如下:

IF condition THEN
    statements;
ELSEIF condition THEN
    statements;
ELSE
    statements;
END IF;

根据条件的结果,IF语句会选择执行相应的语句块。可以使用多个ELSEIF来添加更多的条件判断。

CASE语句

CASE语句是另一种常用的条件语句,用于根据不同的条件执行不同的操作。CASE语句有两种形式:简单CASE和搜索CASE。简单CASE适用于对单个表达式进行匹配,而搜索CASE适用于对多个条件进行匹配。

简单CASE语句的基本语法如下:

CASE expression
    WHEN value1 THEN result1;
    WHEN value2 THEN result2;
    ...
    ELSE result;
END CASE;

搜索CASE语句的基本语法如下:

根据条件或表达式的结果,CASE语句会选择执行相应的结果。

循环结构

WHILE循环

WHILE循环是MySQL中的一种迭代结构,用于重复执行一组语句,直到满足指定的条件。WHILE循环的基本语法如下:

WHILE condition DO
    statements;
END WHILE;

在每次迭代中,首先检查条件是否为真,如果为真,则执行语句块。然后再次检查条件,如果仍为真,则继续执行,直到条件为假时退出循环。

 LOOP循环

LOOP循环是另一种MySQL中的迭代结构,它会无限循环执行一组语句,直到遇到LEAVE语句或达到指定的条件。LOOP循环的基本语法如下:

LOOP
    statements;
    IF condition THEN
        LEAVE;
    END IF;
END LOOP;

在每次迭代中,首先执行语句块,然后检查条件,如果满足条件,则执行LEAVE语句退出循环。

MySQL流程控制的应用场景

MySQL流程控制语句在处理复杂的业务逻辑时非常有用。以下是一些常见的应用场景:

  • 条件判断和分支处理:通过IF和CASE语句,可以根据不同的条件执行相应的操作,实现分支处理逻辑。
  • 循环处理和迭代计算:使用WHILE和LOOP循环结构,可以重复执行一组语句,实现数据的迭代计算、累加和批量处理等操作。
  • 错误处理和异常处理:流程控制语句还可以结合异常处理机制,对异常情况进行捕获和处理,保证代码的稳定性和安全性。

总结

MySQL流程控制语句在开发和管理数据库应用中扮演着重要的角色。使用条件语句,我们可以根据不同的条件执行不同的逻辑分支,实现灵活的数据处理和操作。使用循环结构,我们可以重复执行一组语句,处理大量的数据或实现复杂的计算逻辑。这些流程控制工具为我们处理各种复杂情况提供了强大的支持。然而,在使用流程控制语句时,也需要注意避免过度复杂化的代码逻辑和性能问题。合理使用流程控制语句,避免嵌套过深或循环次数过多,可以提高代码的可维护性和执行效率。

CAP原理:在分布式系统中做出权衡

thbcm阅读(312)

随着互联网规模的不断扩大和复杂性的增加,分布式系统的设计和实现成为解决现代应用程序需求的关键。然而,分布式系统的设计带来了一系列挑战,其中之一就是如何在保证系统可靠性的同时满足一致性和可用性的需求。这时,CAP定理的概念应运而生。

CAP定理背景

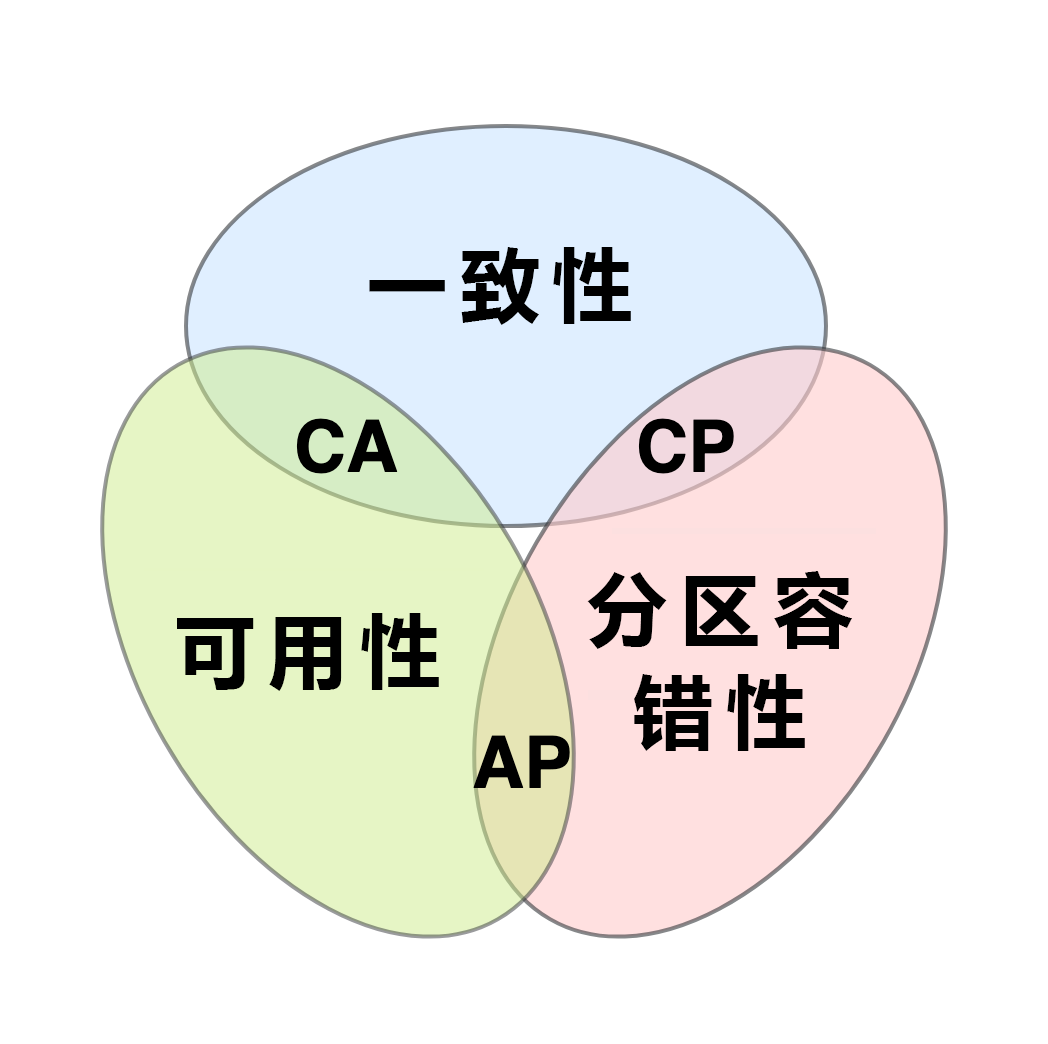
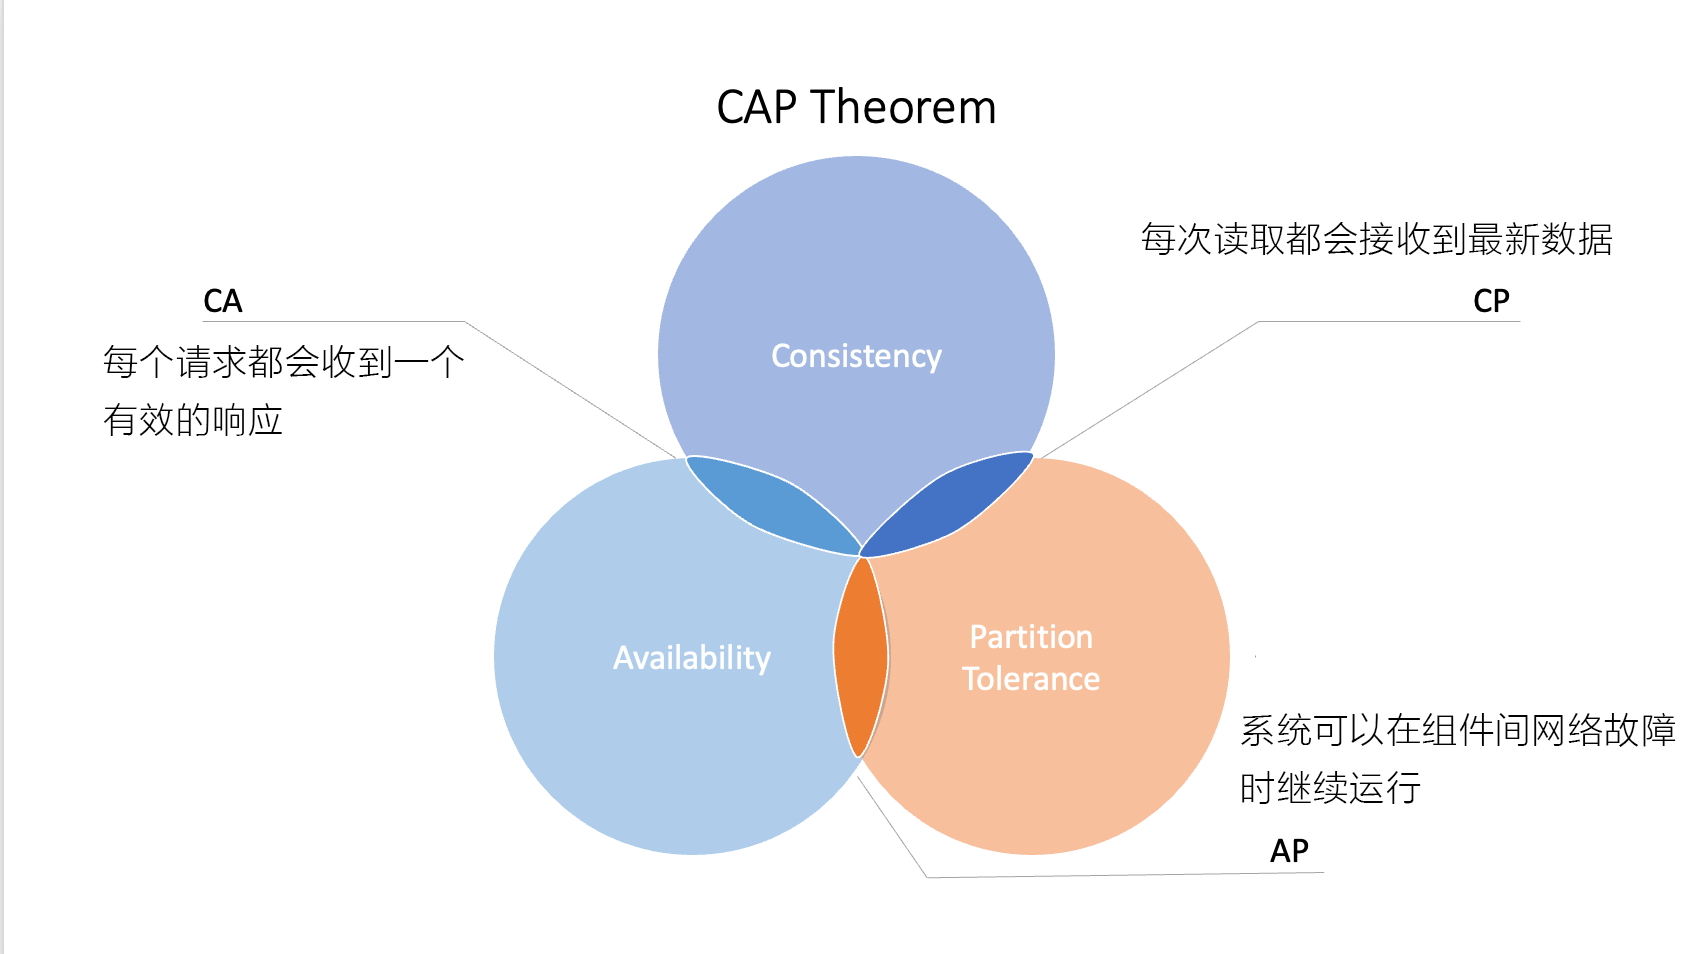
CAP定理最早由计算机科学家Eric Brewer在2000年提出,它成为了分布式系统设计的基本原则。CAP代表了一致性(Consistency)、可用性(Availability)和分区容错性(Partition tolerance)这三个特性,而CAP定理则指出在分布式系统中,无法同时满足这三个特性。

解读CAP定理

CAP定理的核心思想是,在分布式系统设计中,当发生网络分区时,我们必须在一致性和可用性之间进行权衡选择。具体来说,当系统遇到网络分区的情况时,我们必须选择是保证数据一致性,即保证所有节点具有相同的数据副本,还是保证系统的可用性,即保证系统能够继续响应用户请求。让我们更加深入地了解一下CAP定理对分布式系统的三个特性的概念:

  • 一致性(Consistency):分布式系统的多个副本之间保持数据的一致性,即更新后的数据能够立即在所有节点中得到反映。 
  • 可用性(Availability):系统在任何时刻都能够正常响应用户的请求,并提供所需的服务,不会因故障而中断或无法响应。 
  • 分区容错性(Partition tolerance):系统能够在面对网络中的节点和通信故障时继续正常运行,保证系统的可靠性和鲁棒性。

CAP定理权衡选择: 

  • CP模型(一致性和分区容错性): CP模型选择了一致性和分区容错性,即在面对网络分区时,系统优先保证数据的一致性。这意味着系统会暂停对用户请求的响应,直到数据一致性得到保证。CP模型适用于对数据一致性要求较高的场景,如金融系统或订单处理系统。 
  • AP模型(可用性和分区容错性): AP模型选择了可用性和分区容错性,即在面对网络分区时,系统优先保证系统的可用性。这意味着系统会继续响应用户请求,但可能会导致数据的不一致性。AP模型适用于对系统的可用性要求较高的场景,如社交网络或实时通信应用。
  • CA模型(一致性和一致性和):AP模型选择了可用性和分区容错性,即在面对网络分区时,系统优先保证数据的一致性(C),而可用性(A)可能会受到影响。在CA模型下,系统会暂停对用户请求的响应,直到数据一致性得到保证。这种权衡选择适用于对数据一致性要求较高的场景,如金融系统或订单处理系统。

实际系统设计中的考虑因素

  • 业务需求:根据具体的业务需求和用户期望,权衡一致性和可用性的重要性。 
  • 数据的重要性:根据数据的重要性和敏感性,决定对数据一致性的要求程度。 
  • 系统规模和复杂性:考虑系统的规模和复杂性,选择适合的分布式系统模型。 
  • 可行性和成本:考虑实际可行性和成本因素,选择合适的系统设计方案。

总结

CAP定理是一种针对分布式系统设计的权衡和选择的原则,它涉及到一致性、可用性和分区容错性三个方面的权衡。在实际应用中,我们需要根据具体的业务需求、数据的重要性以及系统规模和复杂性来综合考虑一致性和可用性之间的权衡。通过合理的权衡和选择,我们可以设计出满足实际需求的分布式系统,为用户提供高性能、高可靠性的应用体验。但需要注意的是,CAP定理不是绝对的规则,而是一种指导原则。在实际应用中,也存在一些扩展和变种的分布式系统模型,可以在一定程度上弱化CAP定理的限制。

C++栈空间魔法:释放内存的秘密

thbcm阅读(282)

在C/C++编程中,栈是一种重要的数据结构,用于存储函数调用的上下文、局部变量以及其他临时数据。通常情况下,栈空间的分配是在编译时静态确定的。然而,有时我们需要在运行时动态地分配栈空间,以满足灵活的内存需求。

静态分配与动态分配: 

在C/C++中,栈空间的静态分配是指在编译时为每个函数分配固定大小的栈空间。这种方式的好处是简单高效,但限制了栈空间的大小。动态分配则是在运行时根据需要分配栈空间,允许更灵活的内存管理。 

使用alloca函数(C语言): 

C语言提供了alloca函数,可以在栈上动态分配内存。alloca函数的原型如下:

void* alloca(size_t size);

alloca函数接受一个参数size,表示要分配的内存大小(以字节为单位)。它在栈上分配内存,并返回一个指向分配内存的指针。需要注意的是,alloca函数分配的内存在函数返回时会自动释放,不需要手动释放。 

以下是一个示例代码,演示了如何使用alloca函数动态分配栈空间:

#include <stdio.h>
#include <alloca.h>

void dynamicStackAllocation() {
    int* dynamicArray;
    int size = 10;

    dynamicArray = (int*)alloca(size * sizeof(int));

    // 使用动态分配的栈空间
    for (int i = 0; i < size; i++) {
        dynamicArray[i] = i;
    }

    // 打印动态分配的栈空间
    for (int i = 0; i < size; i++) {
        printf("%d ", dynamicArray[i]);
    }
}

int main() {
    dynamicStackAllocation();
    return 0;
}

使用变长数组(C++语言): 

C++语言引入了变长数组(Variable Length Arrays,VLA)的概念,可以在栈上动态分配数组。与alloca函数不同,变长数组的大小可以在运行时确定,并且可以通过数组名进行访问。 以下是一个示例代码,展示了如何使用变长数组实现动态分配的栈空间:

#include <iostream>

void dynamicStackAllocation() {
    int size = 10;

    int dynamicArray[size];

    // 使用动态分配的栈空间
    for (int i = 0; i < size; i++) {
        dynamicArray[i] = i;
    }

    // 打印动态分配的栈空间
    for (int i = 0; i < size; i++) {
        std::cout << dynamicArray[i] << " ";
    }
}

int main() {
    dynamicStackAllocation();
    return 0;
}

需要注意的是,变长数组的大小不能是负数,并且超出栈容量可能导致栈溢出的风险。因此,在使用变长数组时应谨慎考虑栈空间的大小。

总结

通过使用C/C++语言的特性,我们可以实现栈空间的动态分配。在C语言中,可以使用alloca函数在栈上动态分配内存;而在C++语言中,可以使用变长数组来实现动态分配的栈空间。这些动态分配栈空间的方法提供了更灵活的内存管理,在某些场景下非常有用。但需要注意的是,动态分配的栈空间大小应谨慎考虑,以避免栈溢出等问题的发生。通过合适的使用和管理,我们可以在C/C++编程中实现栈空间的动态分配,提高程序的灵活性和效率。

Java编程思想:构建优雅而强大的应用

thbcm阅读(308)

在Java编程领域,编程思想是开发者应该掌握的核心概念之一。本文将深入探讨Java编程思想,通过具体实例分析,帮助读者更好地理解并优化Java编程的方法与理念。

什么是Java编程思想?

Java编程思想是一种编程哲学,它强调了代码的可维护性、可读性和可扩展性。它包括了一系列最佳实践和设计模式,有助于开发者构建高质量的Java应用程序。

1. 面向对象编程

Java是一种面向对象的编程语言,因此理解面向对象编程思想至关重要。例如,面向对象编程鼓励将问题划分为多个对象,并通过封装、继承和多态来组织代码。以下是一个简单的面向对象编程示例:


    public
     
    class
     Car {


     private String make; private String model; public Car(String make, String model) { this.make = make; this.model = model; } public void start() { System.out.println("The " + make + " " + model + " is starting."); } } 


2. 设计模式

设计模式是解决常见编程问题的可复用解决方案。了解和应用设计模式可以提高代码的质量和可维护性。例如,单例模式确保一个类只有一个实例,工厂模式用于对象的创建,观察者模式用于实现发布-订阅模式。


    // 单例模式示例 
   
   
    public class Singleton { private static Singleton instance; private Singleton() {} public static Singleton getInstance() { if (instance == null) { instance = new Singleton(); } return instance; } } 


3. 异常处理

Java编程思想还包括有效的异常处理。了解何时抛出异常、如何捕获和处理异常是至关重要的。以下是一个异常处理的示例:


    try
     { 
   
   
     // 可能引发异常的代码 int result = 1 / 0; } catch (ArithmeticException e) { // 处理异常 System.out.println("An error occurred: " + e.getMessage()); } 


4. 多线程编程

Java是一种支持多线程编程的语言,因此编程思想也涵盖了多线程编程。多线程思想涉及线程同步、并发性和线程间通信等概念。以下是一个简单的多线程示例:


    public
     
    class
     MyThread extends Thread {


     @Override public void run() { for (int i = 0; i < 5; i++) { System.out.println("Thread: " + i); } } } 


总结

Java编程思想是编写高质量Java应用程序的基础,它涵盖了面向对象编程、设计模式、异常处理和多线程编程等方面。通过深入理解和应用这些思想,开发者可以编写出更加可维护和高效的Java代码。无论您是初学者还是有经验的开发者,这些思想都将帮助您在Java编程的旅程中取得成功。

XXL-JOB:分布式任务调度平台的领先选择

thbcm阅读(339)

在现代软件开发中,任务调度是一个关键的组成部分,它能够有效地管理和执行各种定时任务和批处理作业。本文将介绍XXL-JOB,这是一个领先的分布式任务调度平台,为开发人员提供了强大的任务调度和管理功能。通过深入了解XXL-JOB的特点和用法,读者将能够充分利用这个平台来简化任务调度流程,提高系统的可靠性和效率。

XXL-JOB简介

XXL-JOB是一个开源的分布式任务调度平台,基于Java语言开发。它具备可靠性高、易用性强、扩展性好的特点,并且已经在众多企业和项目中得到广泛应用。XXL-JOB提供了一个友好的Web界面,供用户管理和监控任务,同时支持分布式部署,能够应对高并发和大规模任务调度的需求。

核心功能

XXL-JOB提供了一系列核心功能,包括:

  • 定时任务调度:用户可以创建和管理各种定时任务,定义任务的触发时间和执行逻辑。
  • 分布式任务执行:XXL-JOB支持将任务分发到多个执行器节点上并行执行,实现任务的分布式处理。
  • 实时监控和日志查看:用户可以实时监控任务的执行情况,查看任务的日志和执行结果。
  • 报警和告警:XXL-JOB提供了丰富的报警和告警机制,用户可以根据需要配置告警规则,及时获取任务执行异常的通知。
  • 任务调度中心:XXL-JOB提供了一个任务调度中心,用户可以在该中心进行任务的集中管理和配置。

使用案例

XXL-JOB在各行各业都得到了广泛应用,涵盖了多个领域和场景,例如:

  • 数据处理和数据清洗:XXL-JOB可以定时执行数据处理和清洗任务,帮助企业实现数据的自动化处理流程。
  • 定时报表生成:XXL-JOB能够按照设定的时间自动执行报表生成任务,提供准确、及时的报表数据。
  • 分布式爬虫和数据采集:XXL-JOB支持分布式任务执行,可以同时启动多个爬虫任务,提高数据采集效率。
  • 后台任务调度:XXL-JOB可以管理后台任务的调度和执行,包括日志清理、缓存刷新等操作。

优势和价值

XXL-JOB相比其他任务调度平台具有以下优势和价值:

  • 易用性:XXL-JOB提供了直观友好的Web界面,用户可以轻松创建、管理和监控任务,无需深入编程。
  • 可靠性:XXL-JOB支持分布式部署,具备高可用性和容错性,能够应对大规模任务调度的需求。
  • 扩展性:XXL-JOB提供了丰富的扩展接口和插件机制,可以根据业务需求进行定制和扩展。
  • 社区支持:作为一个开源项目,XXL-JOB拥有活跃的社区支持和持续的更新,用户可以获取及时的技术支持和新功能。

总结

XXL-JOB是一个强大而成熟的分布式任务调度平台,通过其优秀的功能和易用性,帮助开发人员简化任务调度流程,提高系统的可靠性和效率。无论是处理大规模数据、定时报表生成还是分布式爬虫任务,XXL-JOB都能够胜任,并且具备高可靠性、易扩展性和优秀的用户体验。对于企业和开发团队来说,选择XXL-JOB作为任务调度平台是一个明智的决策,能够有效提升工作效率,降低系统风险,并满足不断增长的任务调度需求。

联系我们