Python常见BUG类型

thbcm阅读(418)

很多小伙伴,在初学习 Python 的过程中,遇见 BUG 时便手忙脚乱,不知如何是好,今天小编在这给大家总结了一些常见的 BUG 类型及其应对措施,希望小伙伴们认真阅读做好笔记呢。

错误类型 1:语法错误

i = 1 

while True :

    i += 1

    if i == 100 :

        return

报错:

SyntaxError: ‘return’ outside function

从代码中不难看出这位小伙伴是想执行一个循环体,当 i 的值等于 100 时停止计算并返回,而 return 不能够再方法以外使用。

解决方法:

i = 1 

while True :

    i += 1

    if i == 100 :

        break

错误类型 2:类型错误

 name = ‘老王’

 age = 50

 print(‘我是’ + name + ‘,年龄’ + age)

报错:

TypeError: must be str, not int

从代码中可以看出该为小伙伴是想将名字和年龄做一个组合输出,但在进行 + 拼接时,必须使用字符串,而年龄却是 int 类型。

解决办法:将 int 类型数据转成字符串。

name = ‘老王’

age = 50

print(‘我是’ + name + ‘,年龄’ + str(age))

错误类型 3:语法错误

name = ‘老王’

if name = ‘老王’:

    print(‘Hello’)

报错:

SyntaxError: invalid syntax

此处看似是在判断 name 是否为’小王’如果是则输出  ‘Hello’,但却忽略了 ‘=’ 符号是赋值符,’==’ 才是比较符。

解决方法:

name = ‘老王’

if name == ‘老王’:

    print(‘Hello’)

错误类型 4:缩进错误

  name = ‘老王’

  for index in range(10):

  if name == ‘老王’: 

     print(‘Hello’)

else: 

    print(‘No body’)

报错:

IndentationError: unindent does not match any outer indentation level

该类型报错较为常见,也比较不应该,主要还是由于粗心大意而忽视了语法的缩进符。

解决方法:使用 4 个空格代表缩进,或摁 tab 实现自动缩进。

name = ‘老王’

for index in range(10):

  if name == ‘老王’: 

    print(‘Hello’)

  else: 

    print(‘No body’)

错误类型 5:索引错误

 text = ‘hello world’

 print(text[11])

报错: 

IndexError: string index out of range

该类型的错误为所需提取的字符串超出了范围,记住字符串下标是从 0 开始计数的,而不是从 1 开始,另外字符串内的空格也是计数的。

错误类型 6:值错误

text = ‘Hello World’

result = text.index(‘你好’)

print(result)

报错: 

ValueError: substring not found

该类型错误是用户想要在字符串中查找不存在的字符串,查找字符串时先确认原字符串是否有我们需要的子字符串。

错误类型 7:索引错误

list1 = [‘迪迦’,’赛文’,’塞罗’,’艾斯’]

print(list1[4])

报错:

IndexError: list index out of range

该用户是想取出列表中的最后一个位置的信息,但取值超出了列表范围或列表不存在,记住列表的下标也是从 0 开始计数的。

解决办法:

list1 = [‘迪迦’,’赛文’,’塞罗’,’艾斯’]

#方法一

print(list1[3])

#方法二

print(list1[-1])

错误类型 8:属性错误

tp1 = (‘to’, ‘be’, ‘or’, ‘not’, ‘to’, ‘be’)

tp1.remove(‘to’)

报错:

AttributeError: ‘tuple’ object has no attribute ‘remove’

可以看出用户是想将元组的 ‘to’ 信息删除,然而却忽略了元组没有 remove 方法。

解决方法:将元组转换成列表后进行删除操作。

tp1 = (‘to’, ‘be’, ‘or’, ‘not’, ‘to’, ‘be’)

list1 = list(tp1)

list1.remove(‘to’)

错误类型 9:键错误

 dic1 = {

    ‘name’:’老王’,

    ‘age’:50,

    ‘friend’:[‘孙子’,’孔子’,’老子’,’迪迦’]

}

print(dic1[‘height’])

报错:

KeyError: ‘height’

key 键错误:没有指定的键值 ‘height’ ,从用户定义的字典不难看出里面并无 ‘height’ 这个键,而用户却像从中取没有的值,不难免报错了。

错误类型 10:类型错误

dic1 = { 

    ‘name’:’老王’,

    ‘age’:50,

    ‘friend’:[‘孙子’,’孔子’,’老子’,’迪迦’]

}

dic1.pop()

报错:

TypeError: pop expected at least 1 arguments, got 0

使用 pop() 方法时至少需要传入一个参数,但用户并没有进行传参操作。

以上便是小编为大家总结出来的几种常见 BUG 类型,特别对于初学者来说,应该好好琢磨下,如何根据报错的类型,分析修改完善自己所写的代码,孰能生巧,只要肯用心,这些 BUG 都不足挂齿!!!

好课推荐:Python3 入门、Python3 进阶
HTML5都有哪些新特性?

thbcm阅读(367)

什么是HTML5?

HTML5 是下一代 HTML 标准。

HTML5 将成为 HTML、XHTML 以及 HTML DOM 的新标准。

自从1999年 HTML 上个版本的诞生,Web 世界已经经历了巨变, 

HTML 仍在完善之中。然而,现代大部分浏览器都已具备某些 HTML5 的支持

那么HTML都有哪些新特性呢?

用于绘画的 canvas 元素

标签 描述
<canvas> 标签定义图像,比如图表和其它图像。该标签基于 Javascript 的绘图 API

用于媒介回放的 video 和 audio 新多媒体元素

标签 描述
<audio> 定义音频内容
<video> 定义视频(video 或者 movie)
<source> 定义多媒体资源<video>和<audio>
<embed> 定义嵌入的内容,比如插件。
<track> 为诸如<video>和<audio>元素之类的媒介规定外部文本轨道

用于表单的 datalist 新表单元素

标签 描述
<datalist> 定义选项列表。请于 input 元素配合使用该元素,来定义 input 可能的值
<keygen> 规定用于表单的密钥对生成器字段
<output> 定义不同类型的输出,比如脚本的输出

用于新的语义和结构的新元素

标签 描述
<article> 定义页面独立的内容区域
<aside> 定义页面的侧边栏内容
<bdi> 允许您设置一段文本,使其脱离其父元素的文本方向设置
<command> 定义命令按钮,比如单选按钮、复选框或按钮
<details> 用于描述文档或文档某个部分的细节
<dialog> 定义对话框,比如提示框
<summary> 标签包含 details 元素的标题
<figure> 规定独立的流内容(图像、图表、照片、代码等等)。
<figcaption> 定义<figure>元素的标题
<footer> 定义 section 或 document 的页脚。
<header> 定义了文档的头部区域
<mark> 定义带有记号的文本。
<meter> 定义度量衡。仅用于已知最大和最小值的度量。
<nav> 定义导航链接的部分。
<progress> 定义任何类型的任务的进度。
<rudy> 定义 ruby 注释(中文注音或字符)。
<rt> 定义字符(中文注音或字符)的解释或发音。
<rp> 在 ruby 注释中使用,定义不支持 ruby 元素的浏览器所显示的内容。
<section> 定义文档中的节(section、区段)。
<time> 定义日期或时间。
<wbr> 规定在文本中的何处适合添加换行符。

HTML5 已移除的元素

以下的 HTML 4.01 元素在 HTML5 中已经被删除:

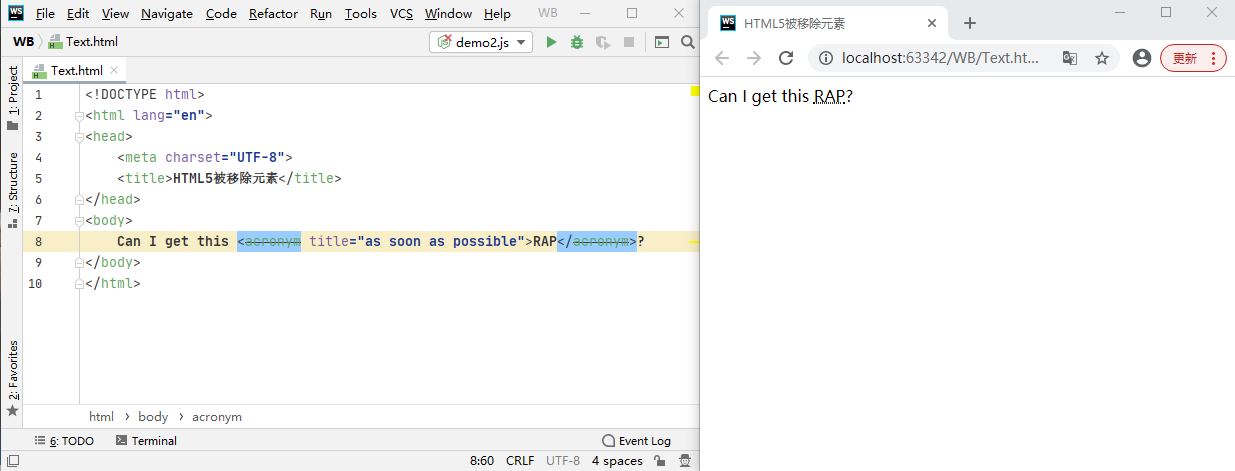
  • <acronym>
  • <applet>
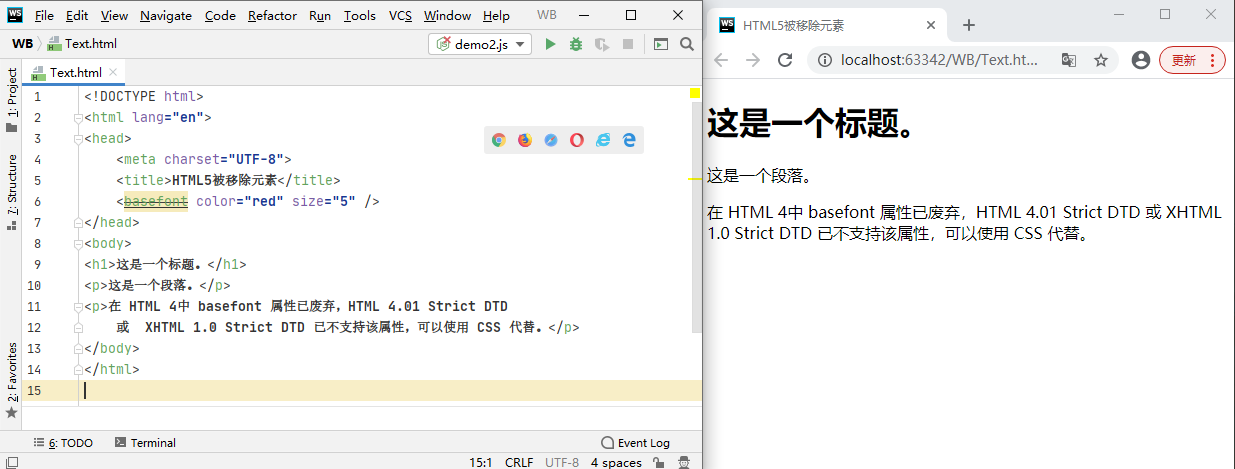
  • <basefont>
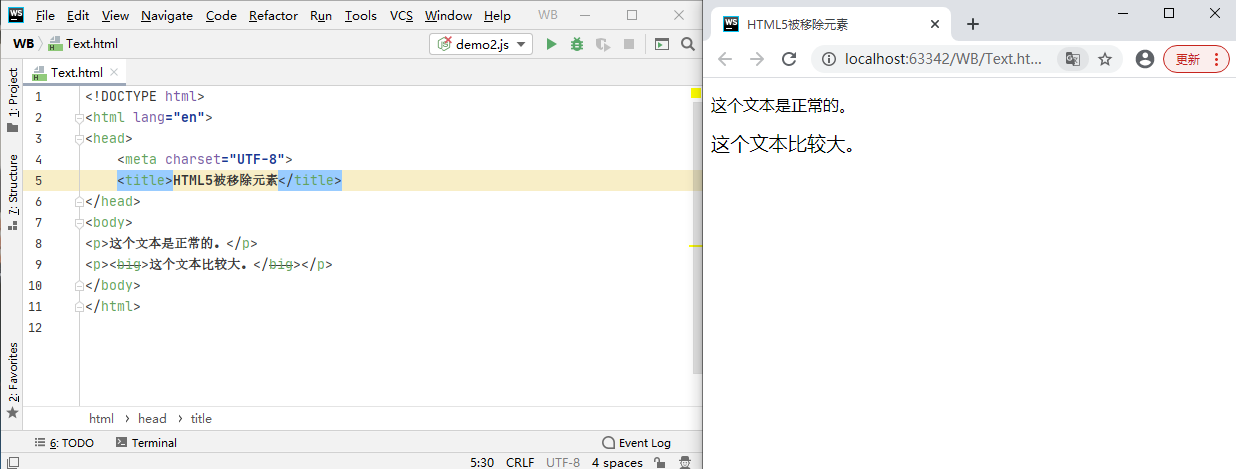
  • <big>
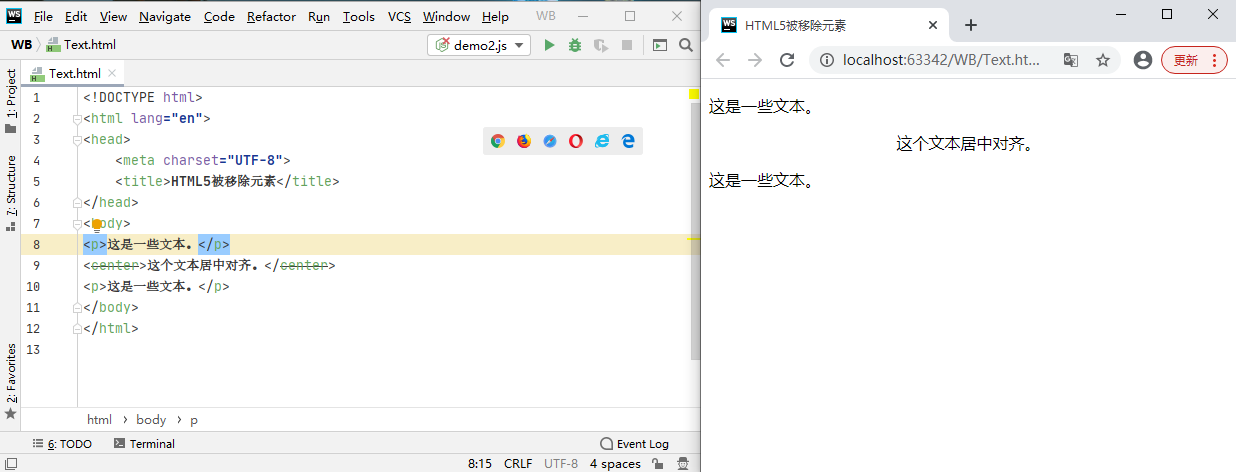
  • <center>
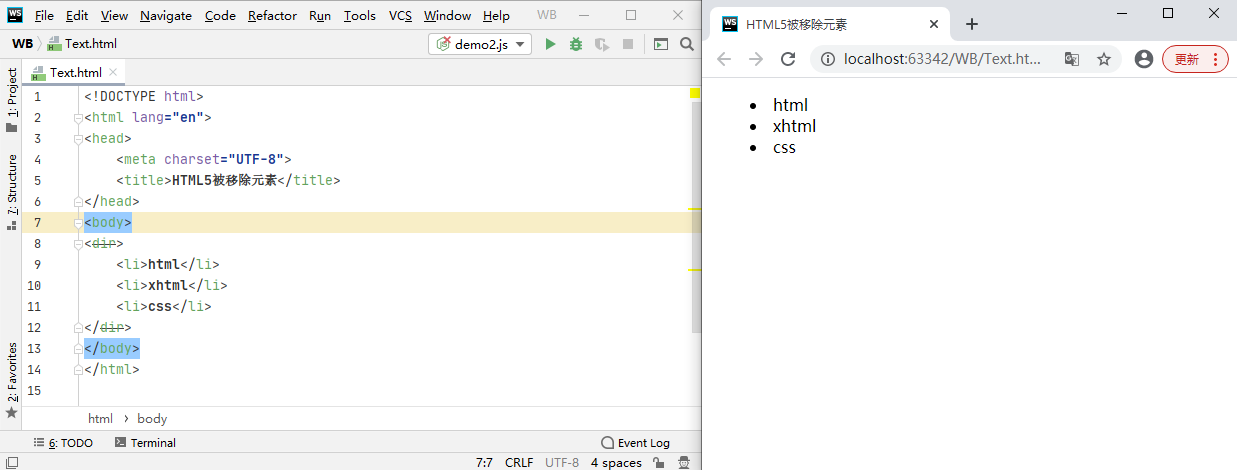
  • <dir>
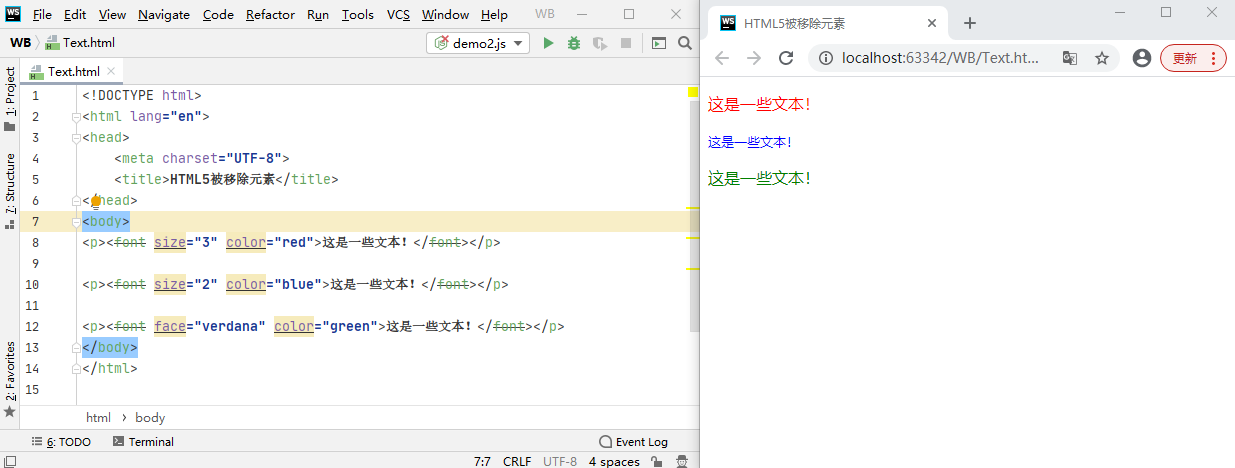
  • <font>
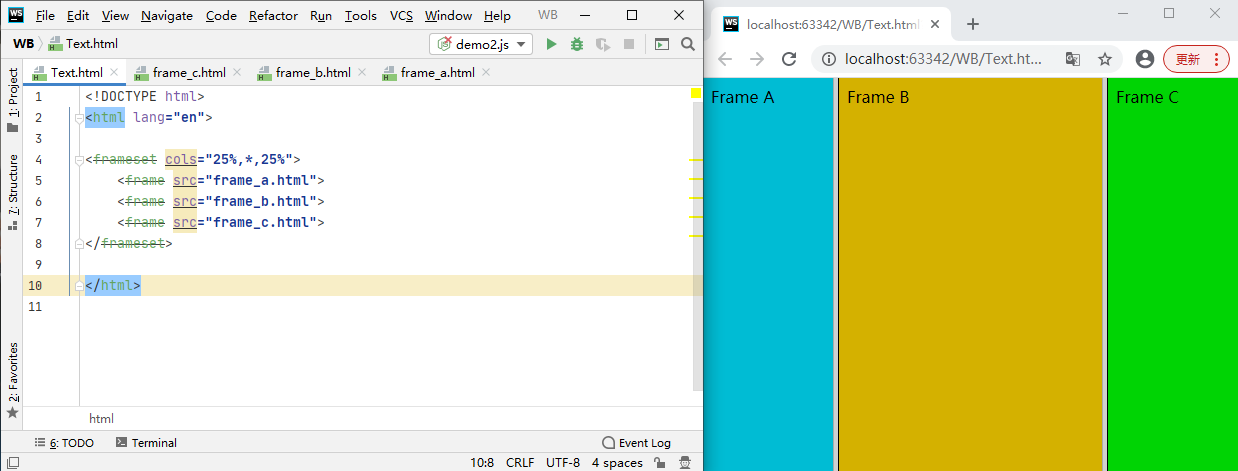
  • <frame>
  • <frameset>
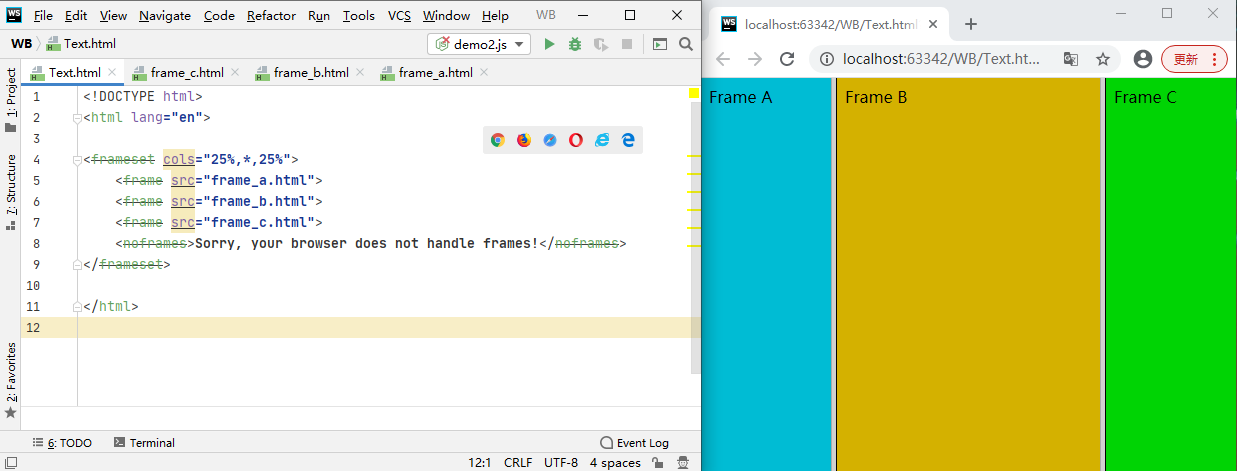
  • <noframes>
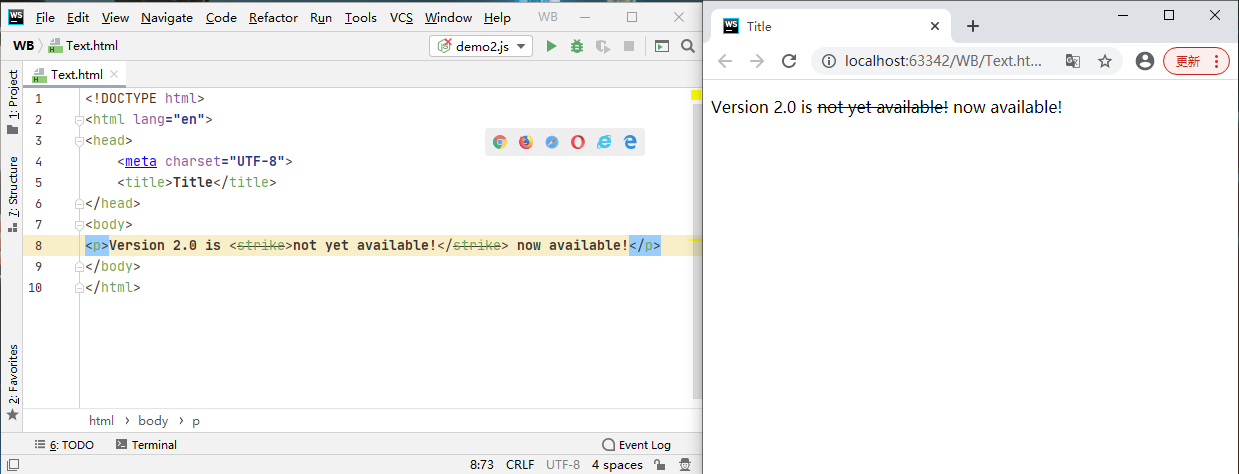
  • <strike>
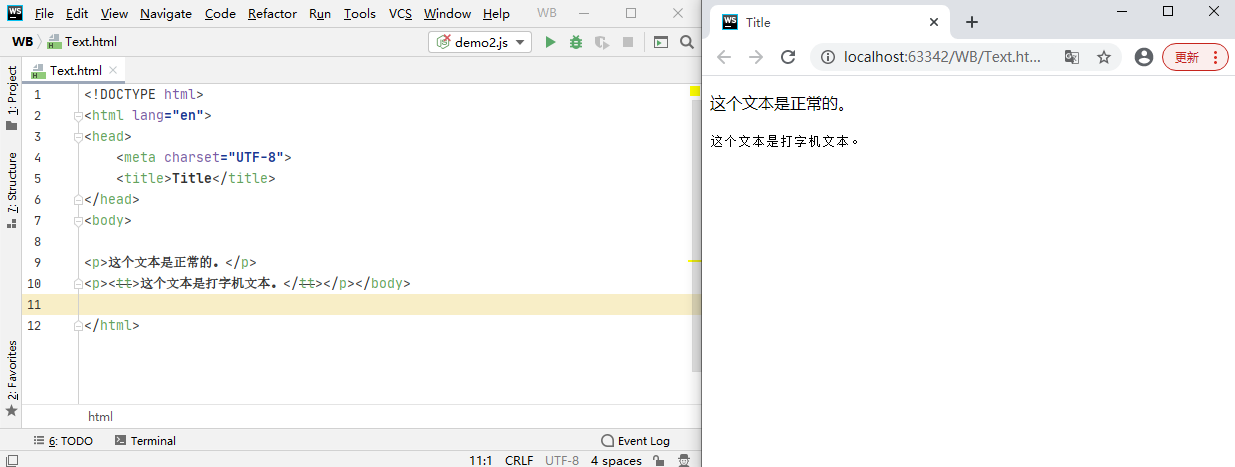
  • <tt>

学习新标签的同时要与实践并行,才能学以致用掌握它:

HTML5移除了哪些元素?

thbcm阅读(366)

在 HTML 5 中被删除的 HTML 4.01 元素有:

<acronym>定义首字母缩写词

请使用<abbr>标签替代它

<applet>标签用来定义嵌入的applet

请使用<object>代替它

<applet code=”Bubbles.class” width=”350″ height=”350″>

一个嵌入的 Java applet

</applet>

<basefont>标签用来设置文档的默认字体大小

<big>标签制作更大的文本。

<center>标签对其包围的文本进行水平居中处理

<dir>标签定义目录列表

<font>规定文本的尺寸、字体和颜色

<frame>标签定义子窗口(框架)

<frameset>标签定义框架集

<noframes>为不支持框架的浏览器显示文本

<strike>标签定义加删除线的文本

请使用<del>标签代替

<tt>标签定义打字机文本

当然了 HTML5 中新增了不少新元素:

Python–pytest测试框架入门详解

thbcm阅读(465)

大家好呀,我是在秃头路上不断前行的小编。

今天来给想入门 Python 测试却又还在门外徘徊不断、犹豫不决的小伙伴们聊聊 pytest,拿好小本本,认真记。

我们先了解下 pytest 这么一个测试框架:

pytest 可谓是 Python 测试框架中的元老了,十分完善成熟,其主要有以下 6 个特点:

  • 简单灵活,容易上手,文档丰富;
  • 支持参数化,可以细粒度地控制要测试的测试用例;
  • 能够支持简单的单元测试和复杂的功能测试,还可以用来做 selenium / appnium 等自动化测试、接口自动化测试(pytest+requests);
  • pytest 具有很多第三方插件,并且可以自定义扩展,比较好用的如 pytest-selenium(集成 selenium )、pytest-html(完美html 测试报告生成)、pytest-rerunfailures(失败 case 重复执行)、pytest-xdist(多 CPU 分发)等;
  • 测试用例的 skip 和 xfail 处理;
  • 可以很好的和 CI 工具结合,例如 jenkins

那么如何使用 pytest 呢 ?不要急,且听我一一讲解。

第一步:安装和简单使用

安装:

pip install pytest

简单使用:

新建一个test_sample.py文件,输入以下代码:

def input_number(i):

    return i + 1

def test_answer():

    assert inc(2) == 3

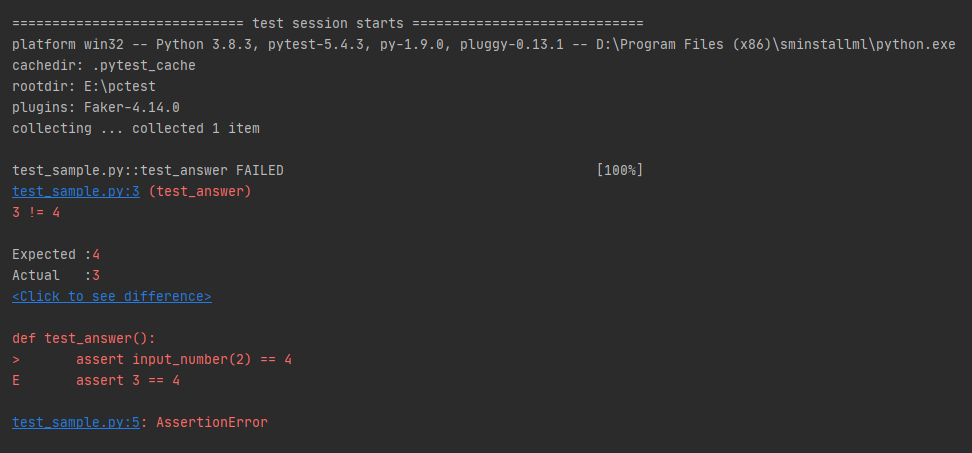
在 test_sample.py 文件中,点击执行 pytest 命令,pytest 将运行当前目录及其子目录下所有名称为“test_.py” 或 “_test.py”的文件。

上述代码中我们使用了 assert 语句来验证测试期望值,pytest 中有一种断言反思机制,能智能地报告 assert 表达式的中间值,这个测试返回了一个失败报告,因为 input_number(2) 没有返回 4 。 

第二步:配置文件

pytest 配置文件可以改变 pytest 的运行方式,它是一个固定的文件 pytest.ini 文件,读取配置信息,按指定的方式去运行。

[pytest]

# 添加命令行参数

addopts = -s

# 文件搜索路径

testpaths = ./scripts

# 文件名称

python_files = test_*.py

# 类名称

python_classes = Test*

# 方法名称

python_functions = test_*

addopts

addopts 参数可以更改默认命令行选项,这个当我们在 cmd 输入指令去执行用例的时候,会用到,比如我想测试完生成报告,指令比较长

pytest -s —html=report.html

每次输入这么多,不太好记住,于是可以加到 pytest.ini 里

在配置文件中修改 addopts = -s —html = report.html

这样我下次打开 cmd,直接输入 pytest,它就能默认带上这些参数了


testpaths

默认的情况下,pytest将会进入到当前目录下的目录和文件中,去收集测试用例(test_开头的函数)。但是很多时候我们只想搜索固定的某一个文件夹,比如项目目录下的scripts文件夹。这样的话,我们可以通过配置文件来是想这个功能。

testpaths = ./scripts

python_files

pytest 默认会找 test 开头的 py 文件,如果我们想指定某个文件或者指定某些有规律的文件名可以使用这个参数来进行修改

python_files = test_*.py

python_classes

pytest 默认会找 Test 开头的类,如果我们想指定某个类或者指定某些有规律的类名可以使用这个参数来进行修改

python_classes = Test*

python_functions

pytest 默认会找 test 开头的函数,如果我们想指定某个函数或者指定某些有规律的函数名可以使用这个参数来进行修改

python_functions = test_*

第三步:断言

断言是一种除错机制,用于验证代码是否符合编码人员的预期。编码人员在开发期间应该对函数的参数、代码中间执行结果合理地使用断言机制,确保程序的缺陷尽量在测试阶段被发现。

简单地讲,断言就是对某种假设条件进行检查。

assert 预期结果 == 实际结果

def test_cut(self):

a = 5

b = 5

cut_num = a – b

assert 10 == cut_num

assert 后面的 10 是一个期望的值,cut_num 是实际得出的值,pytest 框架会自行判断二者的关系是否等价(==),当条件成立时,则断言成功,脚本通过。条件不成立时,则断言失败,脚本不通过。

总结:

pytest 作为 Python 测试框架中的元老,其用途是非常广泛的,比如 fixture,以及各式各样的第三方插件。

以上就是小编今天给大家讲解的 pytest 简单的入门。如果再学习到更多的相关知识。我们就可以结合上面的内容来做基本的自动化测试了。

推荐好课:Python 自动化管理、Python 自动化办公。

能白剽的python学习网站

thbcm阅读(480)

作为一个从零基础开始学python的小编,今天给大家分享几个免费的python学习网站,让各位小伙伴们少走一些弯路,少踩一些坑。

1、w3cschool

不是我吹啊,咱w3cschool是真的好用,教程支持在线运行,从基础到进阶,包含基础语法,面向对象编程知识, 错误调试,单元测试,多进程,协程,网络编程,爬虫等高级知识点。

推荐好课:Python3 教程、Python2 教程。

如果你学不懂,还有各式各样的会员免费课程,无疑是python学习利器啊!

2、GitHub

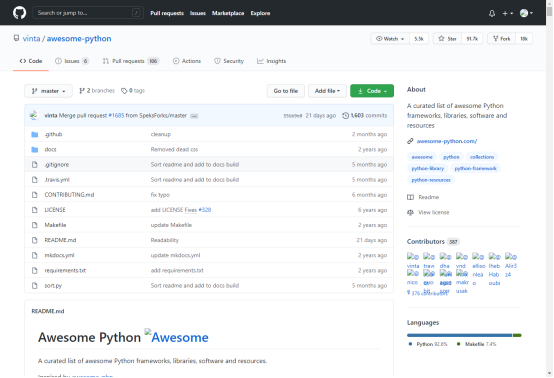
GitHub 是一个面向开源及私有软件项目的托管平台,可以在上面找到很多很的开源学习项目,fork之后便是知识的实践操场啊。

https://github.com/

小编在这也给大家推荐一个python的学习项目:Awesome Python,Awesome Python是号称最全的python资源项目,里面有着各种精选出来的python框架、库、软件以及资源。Awesome Python在GitHub上已获九万多的star,受欢迎程度客家一般了。

https://github.com/vinta/awesom

3、慕课网

慕课网上也有很多免费的python教程,基础学习绝对够用了。

https://www.imooc.com/course/list?


4、B站

B站上的宝藏教程太多了,除了python,还有很多其他学习资源,自己找找,总有一款适合你。

推荐:小甲鱼零基础入门学习Python,B站播放量最高的Python入门课程。

推荐:Python教程_600集Python从入门到精通教程

5、python官网

最后,官网的文档是自学最适合的资料,里面的内容也是最新的,其实很多教程都源于这里。建议阅读英文文档,实在不行,Google Chrome翻译打开基本上也能理解的差不多。

jQuery 的 post 请求

thbcm阅读(371)

get 和 post 请求概述

#jQuery#在Http中,有多种请求方式,如get、post等,但是最常用的是获取数据和提交数据,获取数据是get请求,提交数据是post请求。

注意:HTTP请求是指客户端向服务器发送的请求。例如使用自己的电脑打开浏览器,输入“百度”的网址,此时就是从你的计算机向百度的服务器发起HTTP请求。

本文专门来讲述一下 $.post( ) 方法

 $.post( ) 方法

使用$.post()方法可以将html客户端的内容提交到服务器上,并且还可以将Post过来的数据存储到数据库中。

请注意,查询字符串(名称/值对)是在 POST 请求的 HTTP 消息主体中发送的:

POST /test/demo_form.php HTTP/1.1

Host: w3cschool.com

name1=value1&name2=value2

有关 POST 请求的其他一些注释:

  • POST 请求不会被缓存
  • POST 请求不会保留在浏览器历史记录中
  • POST 不能被收藏为书签
  • POST 请求对数据长度没有要求

$.post() 方法通过 HTTP POST 请求向服务器提交数据。

语法:

$.post(
URL,data,callback);

必需的 URL 参数规定您希望请求的 URL。

可选的 data 参数规定连同请求发送的数据。

可选的 callback 参数是请求成功后所执行的函数名。

下面的例子使用 $.post() 连同请求一起发送数据:

实例

$(“button”).click(function(){
  $.get(“demo_test.php”,function(data,status){
    alert(“数据: ” + data + “\n状态: ” + status);
  });
});


尝试一下 »

$.post() 的第一个参数是我们希望请求的 URL (“demo_test_post.php”)。

然后我们连同请求(name 和 url)一起发送数据。

“demo_test_post.php” 中的 PHP 脚本读取这些参数,对它们进行处理,然后返回结果。

第三个参数是回调函数。第一个回调参数存有被请求页面的内容,而第二个参数存有请求的状态。

提示: 这个 PHP 文件 (“demo_test_post.php”) 类似这样:

<?php

$name = isset($_POST[‘name’]) ? htmlspecialchars($_POST[‘name’]) : ”;

$url = isset($_POST[‘url’]) ? htmlspecialchars($_POST[‘url’]) : ”;

echo ‘网站名: ‘ . $name;

echo “\n”;

echo ‘URL 地址: ‘ .$url;

?>

get方法与post方法的区别

 功能 GET POST
后退按钮/刷新 无害 数据会被重新提交(浏览器应该告知用户数据会被重新提交)。
书签 可收藏为书签 不可收藏为书签
缓存 能被缓存 不能缓存
编码类型 application/x-www-form-urlencoded application/x-www-form-urlencoded or multipart/form-data。为二进制数据使用多重编码。
历史 参数保留在浏览器历史中。 参数不会保存在浏览器历史中。
对数据长度的限制 是的。当发送数据时,GET 方法向 URL 添加数据;URL 的长度是受限制的(URL 的最大长度是 2048 个字符)。 无限制。
对数据类型的限制 只允许 ASCII 字符。 没有限制。也允许二进制数据。
安全性 与 POST 相比,GET 的安全性较差,因为所发送的数据是 URL 的一部分。

在发送密码或其他敏感信息时绝不要使用 GET !

POST 比 GET 更安全,因为参数不会被保存在浏览器历史或 web 服务器日志中。
可见性 数据在 URL 中对所有人都是可见的。 数据不会显示在 URL 中。

《大秦赋》很火?,咱用Python扒拉一下它

thbcm阅读(417)

大家好呀,我是你们亲爱的 w3cschool 小编。

最近,最火的电视剧莫过于《大秦赋》了,小编也是一直在追,12 月 1 号开播,那口碑杠杠的。可三集过后,小编那是直呼好家伙啊,我****。相信看过小伙伴们和我是一样的,直呼好家伙了。该剧在豆瓣上的评分也由最初的 8.9 分,降到了现今的 6.0 分,可谓是高走低开,观者全程**。

于是乎小编忍不住的用 Python 爬取了豆瓣上《大秦赋》的评论相关数据,进行了一波分析,也给大家分享一下思路。

一、数据爬取

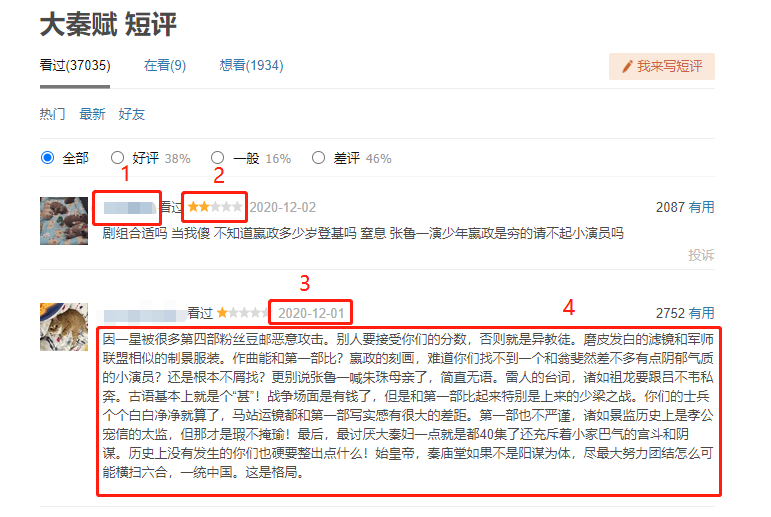
既然要做分析,那肯定得先搞到数据。小编选择的是豆瓣网下手,原因嘛,很简单,它家数据全呐,反扒难度还不大。我们主要要获取的信息为评论的星级以及评论时间,顺带将评论者及评语咱也一起扒拉下来。

技术方面,小编用的是requests、bs4、pandas、time、matplotlib五个库,工具为Pychram和Anaconda jupyter nootbook。

开始编写前我们先来看下网站页面url变化规律:

https://movie.douban.com/subject/26413293/comments?status=P

https://movie.douban.com/subject/26413293/comments?start=20&limit=20&status=P&sort=new_score

https://movie.douban.com/subject/26413293/comments?start=40&limit=20&status=P&sort=new_score

小伙伴们看出来了么,不难发现页面变换中仅有 start 是不一样的,所以在后续翻页操作中我们只需要修改 start 参数即可,那么小编在这给大家一个问题,首页 url 如何解决呢?

关于反扒:

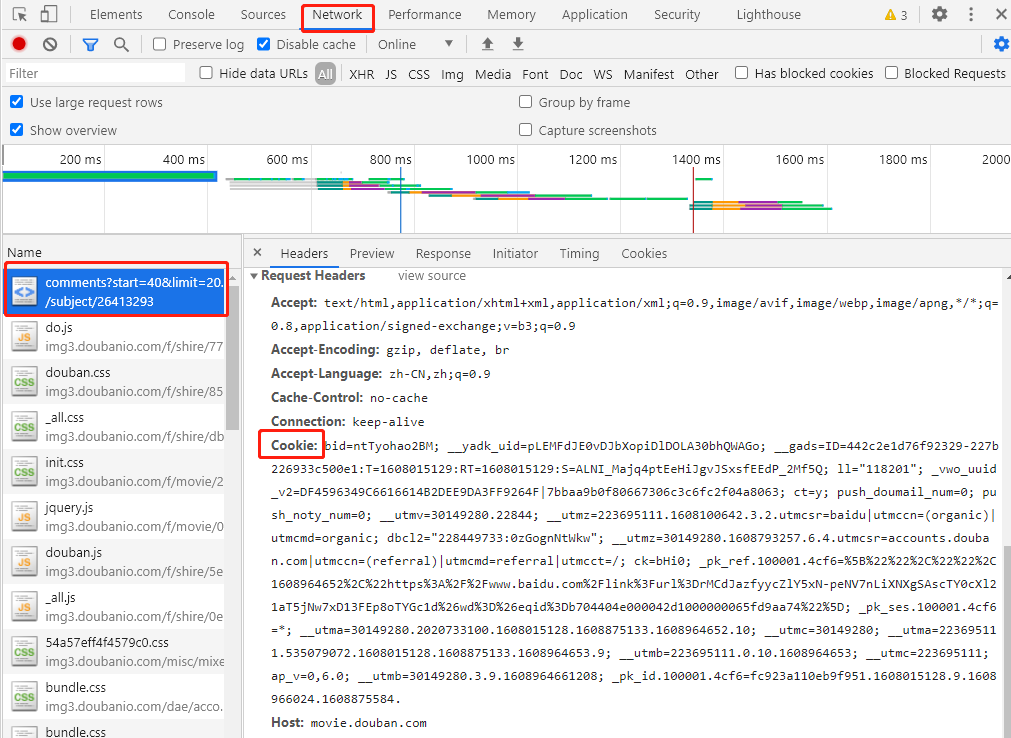
对于豆瓣的爬取措施,其实找到真实的短评链接,是极其容易的。但是小编建议大家要登录后携带 cookie 信息进行数据的爬取,不然豆瓣会识别你为爬虫封禁你的 ip,至于该放什么小编给大家一个参考:

 headers = {

    “Accept”:”application/json, text/plain, */*”,

    “Accept-Language”:”zh-CN,zh;q=0.9″,

    “Connection”:”keep-alive”,

    “Host”:”movie.douban.com”,

    “User-Agent”:’Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/87.0.4280.88 Safari/537.36′,

    “Cookie”:’这里是你自己的cookie’

    }

那么 cookie 信息在哪呢,我们打开网页摁下 F12,或者鼠标右键选择检查,点击 NetWork 然后刷新一下界面,找到刷新出来的第一个信息,然后扒拉一下就能找到啦。

补充一点:小编本打算将《大秦赋》的所有短评都给扒拉下来的,可最终也只爬取到了 500 条,这应该也是豆瓣的反扒措施(有大神的话,可以下去研究一下如何破解,然后告诉小编)。

二、数据处理

1、剔除重复值

采用如下命令查看重复项数量:

np.sum(df.duplicated()) #计算重复数量

采用如下命令删除所有变量都重复的行:

df.drop_duplicates(keep = False) #删除所有变量都重复的行

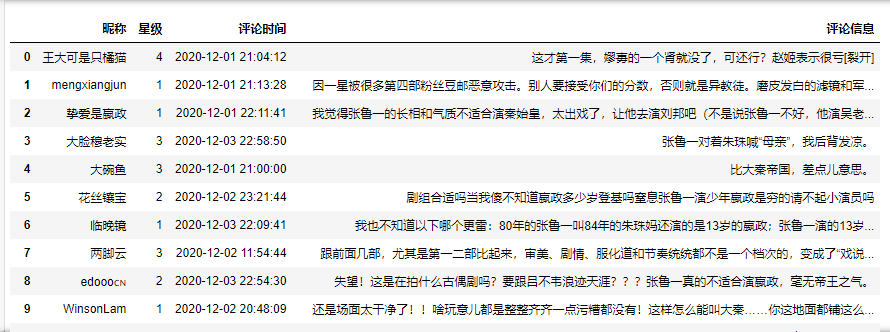
结果如下:

可以看出,得到的结果还是很漂亮的。

三、可视化分析

俗话说:“字不如表,表不如图”。我们所爬取到的数据,最终还是要有一个可视化的效果呈现,才能够让我们分析出数据背后所存在的规律,让我们有一个清晰的认识。下面小编从以下几个方面来对我们所获取到的数据进行数据可视化分析。

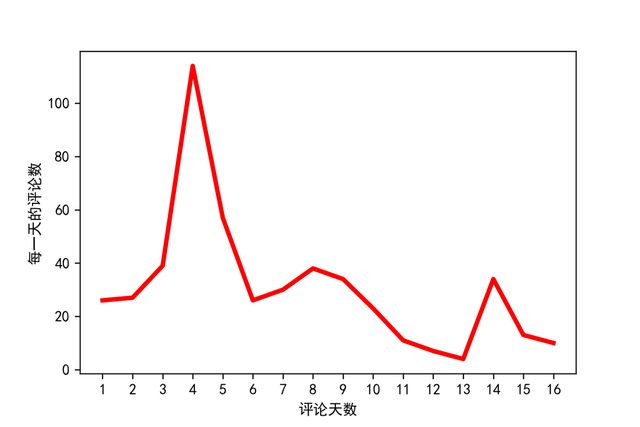
1、评论数随时间的变化趋势

从图中我们不难看出:短评数量在 12 月 4 日之前,一直处于上升趋势,在 12 月 4 日达到顶峰。和小编的观看情感变化是如出一辙,从期待到失望。

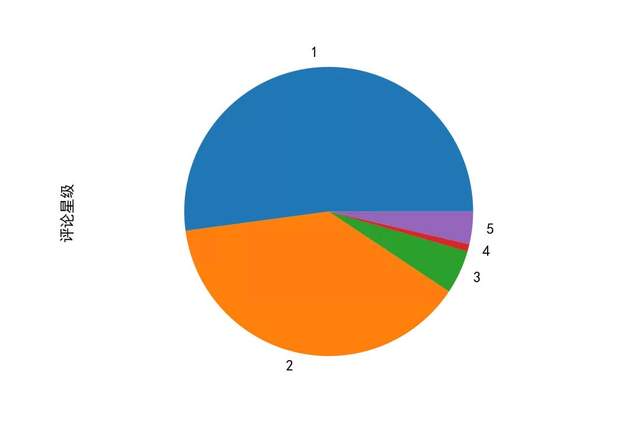
2、星级评分的饼图

从图中可以看出:大家对于该剧的评价还是很低的,1 星和 2 星基本占据了整个饼图,也就是说该剧并没有得到大家的认可。好了不多说了小编就是那个一星贡献者。

推荐好课:

Python 数据分析入门案例讲解

6个值得去学习的JavaScript框架

thbcm阅读(357)

现在的框架和库已经从蛮荒时代崛起了,很多老旧的技术纷纷开始将功能分离成模块。现在不再需要在整个核心语言中支持所有特性了,开发者允许所有用户创建库和框架来增强核心语言的功能。这样,语言的灵活性获得了显著提高。
如果在已经在使用 JavaScript (以及 JQuery) 来支持 HTML,那么你肯定知道开发和维护一个大型应用需要付出多大的努力以及编写多么复杂的代码,而 JavaScript 框架可以帮助你快速的构建交互式 Web 应用 (包含单页面应用或者多页面应用)。
当一个新手开发者想要学习 JavaScript时,他常常会被各种 JavaScript 框架所吸引,也幸亏有为数众多的社区,任何开发者都可以轻易地通过在线教程或者其他资源来学习。
但是,唉!多数的程序员都很难决定学习和使用哪一个框架。因此在本文中,我将为大家推荐 6 个值得好好学习的 JavaScript 框架。让我们开始吧。

1.AngularJS

无论你是何时听说的 JavaScript,很可能你早就听过 AngularJS,因为这是在JavaScript 社区中最为广泛使用的框架了。它发布于 2009 年,由 Google 开发 (这够有说服力让你使用了吧) ,它是一个开源项目,这意味着你可以阅读、编辑和修改其源代码以便更加符合自身的需求,并且不用向其开发者支付一分钱 (这不是很酷吗?)。

如果说你觉得通过纯粹的  JavaScript 代码编写一个复杂的 Web 应用比较困难的话,那么你肯定会兴奋的跳起来,因为它将显著地减轻你的编码负担。它符合支持双向数据绑定的 MVC (模型-视图-控制Model–view–controller) 设计典范。假如你不熟悉 MVC,你只需要知道它代表着无论何时探测到某些变化,它将自动更新前端 (比如,用户界面端) 和后端 (代码或者服务器端) 数据。

MVC 可以大大减少构建复杂应用程序所需的时间和精力,所以你只需要集中精力于一处即可 (DOM 编程接口会自动同步更新视图和模型)。由于 视图组件 与 模型组件 是分离的,你可以很容易的创建一个可复用的组件,使得用户界面的效果非常好看。

如果因为某些原因,你已经使用了 Type (一种与  JavaScript 非常相似的语言),那么你可以很容易就上手 AngularJS,因为这两者的语法高度相似。与 Type 相似这一特点在一定程度上提升了 AngularJS 的受欢迎程度。

目前,Angular 2.0 已经发布,并且提升了移动端的性能,这也足以向一个新的开发者证明,该框架的开发活跃度够高并且定期更新。

AngularJS 有着大量的用户,包括 (但不限于) Udemy、Forbes、GoDaddy、Ford、NBA 和 Oscars。

对于那些想要一个高效的 MVC 框架,用来开发面面俱到、包含健壮且现代化的基础架构的单页应用的用户来说,我极力的推荐这个框架。这是为无经验  JavaScript 开发者设计的首选框架。

2.React

与 AngularJS 相似,React 也是一个 MVC (模型-视图-控制Model–view–controller) 类型的框架,但不同的是,它完全针对于视图组件 (因为它是为 UI 特别定制的) ,并且可与任何架构进行无缝衔接。这意味着你可以马上将它运用到你的网站中去。

它从核心功能中抽象出 DOM 编程接口 (并且因此使用了虚拟 DOM),所以你可以快速渲染 UI,这使得你能够通过 node.js 将它作为一个客户端框架来使用。它是由 Facebook 开发的开源项目,还有其它的开发者为它贡献了代码。

假如说你见到过并喜欢 Facebook 和 Instagram 的界面,那么你将会爱上 React。通过 React,你可以给你的应用的每个状态设计一个简单的视图,当数据改变的时候,视图也自动随之改变。只要你想的话,可以创建各种的复杂 UI,也可以在任何应用中复用它。在服务器端,React 同样支持通过 node.js 来进行渲染。对于其他的接口,React 也一样表现得足够灵活。

除 Facebook 和 Instagram 外,还有好多公司也在使用 React,包括 Whatsapp、BBC、PayPal、Netflix 和 Dropbox 等。

如果你只需要一个前端开发框架来构建一个非常复杂且界面极好的强大视图层,那我极力向你推荐这个框架,但你需要有足够的经验来处理各种类型的  JavaScript 代码,而且你再也不需要其他的组件了 (因为你可以自己集成它们)。

3.Vue.js

这是一个开源的  JavaScript 框架,发布于 2014 年,它有个极为简单的 API,用来为现代 Web 界面Modern Web Interface开发交互式组件Reactive components。其设计着重于简单易用。与 Ember 相似,它使用的是 MVVM (模型-视图-视图模型Model–view–viewmodel) 设计范例,这样简化了设计。

这个框架最有吸引力的一点是,你可以根据自身需求来选择使用的模块。比如,你需要编写简单的 HTML 代码,抓取 JSON,然后创建一个 Vue 实例来完成可以复用的小特效。

与之前的那些  JavaScript 框架相似,它使用双路数据绑定来更新模型和视图,同时也使用连接器来完成视图和数据连接器的通信。这是一个还未完全成熟的框架,因为它全部的关注点都在视图层,所以你需要自己处理其它组件。

如果你熟悉 AngularJS,那你会感觉很顺手,因为它大量嵌入了 AngularJS 的架构,如果你懂得  JavaScript 的基础用法,那你的许多项目都可以轻易地迁移到该框架之下。

假如你只想把任务完成,或者想提升你自身的  JavaScript 编程经验,又或者你需要学习不同的  JavaScript 框架的本质,我极力推荐这个。

4.Ember

这个  JavaScript 框架在 2011 年正式发布,是由 Yehuda Katz 开发的开源项目。它有一个庞大且活跃的在线社区,所以在有任何问题时,你都可以在社区中提问。该框架吸收融合了非常多的通用的  JavaScript 风格和经验,以便确保开发者能最快地做到开箱即用。

它使用了 MVVM (模型-视图-视图模型Model–view–viewmodel) 的设计模式,这使得它与 MVC 有些不一样,因为它由一个 连接器 (binder) 帮助视图和数据连接器进行通信。

对于 DOM 编程接口的快速服务端渲染,它借助了 Fastboot.js,这能够让那些复杂 UI 的性能得到极大提高。

它的现代化路由模式和模型引擎还支持 RESTful API,这确保你可以使用到这种最新的技术。它支持句柄集成模板Handlebars integrated template,用来自动更新数据。

早在 2015 年间,它的风头曾一度盖过 AngularJS 和 React,被称为最好的 JavaScript 框架,对于它在  JavaScript 社区中的可用性和吸引力,这样的说服力该是足够了的。

对于不追求高灵活性和大型架构的用户,并且仅仅只是为了赶赴工期、完成任务的话,我个人非常推荐这个 JavaScript 框架。

5.Adonis

如果你曾使用过 Laravel 和 NodeJS,那么你在使用这一个框架之时会觉得相当顺手,因为它是集合了这两个平台的优点而形成的一个框架,对于任何种类的现代应用来说,它都显得非常专业、圆润和精致。

它使用了 NodeJS,所以是一个很好的后端框架,同时还附带有一些前端特性 (与前面提到那些更多地注重前端的框架不同),所以想要进入后端开发的新手开发者会发觉这个框架相当迷人。

相比于 NoSQL,很多的开发者都比较喜欢使用 SQL 数据库 (因为他们需要增强和数据以及其它特性的交互性),这一现象在这个框架中得到了很好的体现,这使得它更接近标准,开发者也更容易使用。

如果你混迹于各类 PHP 社区,那你一定很熟悉 服务提供者Service Providers,也由于 Adonis 其中包含相应的 PHP 风格,所以在使用它的时候,你会觉得似曾相识。

在它所有的特性中,最好的便是那个极为强大的路由引擎,支持使用函数来组织和管理应用的所有状态、支持错误处理机制、支持通过 SQL ORM 来进行数据库查询、支持生成器、支持箭头函数arrow functions、支持代理等等。

如果喜欢使用无状态 REST API 来构建服务器端应用,我比较推荐它,你会爱上这个框架的。

6.Backbone.js

这个框架可以很容易的集成到任何第三方的模板引擎中,默认使用的是 Underscore 模板引擎,而且该框架仅有一个依赖项 (JQuery),因此它以轻量而闻名。它支持带有 RESTful JSON 接口的 MVC (模型-视图-控制Model–view–controller) (可以自动更新前端和后端) 设计范例。

假如你曾经使用过著名的社交新闻网络服务 reddit,那么你肯定听说过它在几个单页面应用中使用了Backbone.js。Backbone.js 的原作者为之建立了与 Coffe 旗鼓相当的 Underscore 模板引擎,所以你可以放心,开发者知道该做什么。

该框架在一个软件包中提供了键值对key-value 模型、视图以及几个打包的模块,所以你不需要额外下载其他的外部包,这样可以节省不少时间。框架的源码可以在 GitHub 进行查看,你可以根据需求进行深度定制。

至此,我已经在本文着重说明了 6 个值得好好学习的  JavaScript 框架,希望你读完本文后能够决定使用哪个框架来完成自己的任务。

如果说对于选择框架,你还是不知所措,请记住,这个世界是实践出真知而非教条主义的。最好就是从列表中挑选一个来使用,看看最后是否满足你的需求和兴趣,如果还是不行,接着试试另一个。你也尽管放心好了,列表中的框架肯定是足够了的。

Python爬虫入门案例—-语音播报天气预报

thbcm阅读(389)

Hello,大家好呀,我是你们亲爱的 w3cschool 小编,今天给大家分享一份 Python 爬虫入门小案例—-语音播报天气预报。

此案例实现的功能为:利用爬虫,爬取某一地区的天气信息,并打印出进行语音播报。

一、前期准备

此案例中要用到的库有:requests、lxml、pyttsx3,可通过 cmd 命令进去命令提示符界面,通过如下命令安装:

pip install requests

pip install lxml

pip install pyttsx3

requests 比 urllib 更加方便,可以节约我们大量的工作。(用了 requests 之后,你基本都不愿意用 urllib 了)一句话,requests 是 Python 实现的最简单易用的 HTTP 库,建议爬虫使用 requests 库。

lxml 是 Python 的一个解析库,支持 HTML 和 XML 的解析,支持 XPath 解析方式,而且解析效率非常高。

pyttsx3 是一个款将文本转为语音的 Python 包,不同于其他 Python 包,pyttsx3 真的可以文本转语音。基本用法如下:

import pyttsx3

test = pyttsx3.init()

test.say(‘hello w3cschool!’)

# 关键一句,若无,语音不会播放

test.runAndWait()

如果你是 linux 系统,pyttsx3 文本转语音不奏效。那么你可能还需要安装 espeak、ffmpeg 和 libespeak1。安装命令如下:

sudo apt update && sudo apt install espeak ffmpeg libespeak1

爬虫是爬取网页的相关内容,了解 HTML 能够帮助你更好的理解网页的结构、内容等。

TCP / IP 协议,HTTP 协议这些知识最好要了解一下,懂得基本含义,这样能够让你了解在网络请求和网络传输上的基本原理。

二、详细步骤

1、get 请求目标网址

我们首先导入 requests 库,然后就用它来获取目标的网页,我们请求的是天气网站中的厦门天气。

import requests

# 向目标url地址发送请求,返回一个response对象

resp = requests.get(‘https://www.tianqi.com/xaimen/’)

# .text是response对象的网页html

print(resp.text)

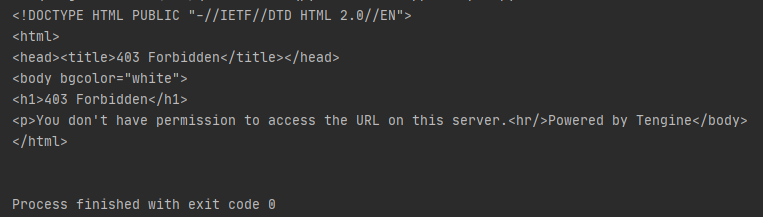
当然仅凭这三行代码,很大的可能是爬取不到网页的,显示 403,这是什么意思呢?

403 错误是一种常见的网络错误类型,表示资源不可用,服务器知道客户的请求,但拒绝处理它。

这是因为我们写的爬虫如果不添加请求头进行访问的话,脚本会自行发送一个 Python 爬取的请求,而大部分的网站都会设施反爬虫机制,不允许网站内容被爬虫爬取。

那么,这就无解了吗?那肯定是不可能的,俗话说得好,上有政策,下有对策,我们想让目标服务器相应,那么我们就对我们得爬虫进行一下伪装即可。在我们这次的小案例中我们添加常用的 User-Agent 字段进行伪装即可。 

所以,改一下我们之前得代码,将爬虫伪装成浏览器请求,如下:

import requests

headers = {‘User-Agent’:’Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/87.0.4280.88 Safari/537.36′}

# 向目标url地址发送请求,返回一个response对象

resp = requests.get(‘https://www.tianqi.com/xaimen/’,headers=headers)

# .text是response对象的网页html

print(resp.text)     

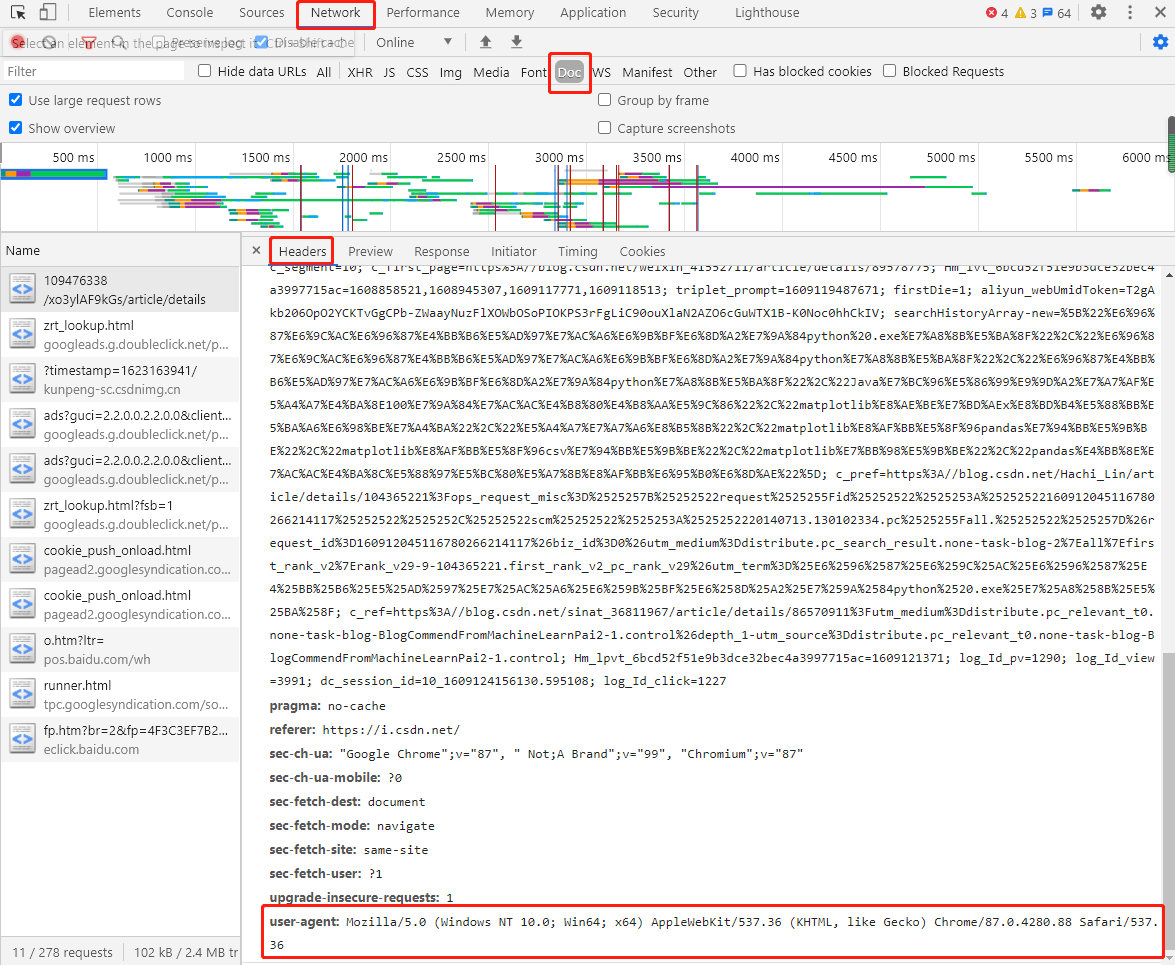
有小伙伴就要问了:User-Agent 字段怎么来的呢?在这里我们以 Chrome 浏览器为例子,先随便打开一个网页,按键盘的 F12 或在空白处点击鼠标右键选择“检查”;然后刷新网页,点击“Network”再点击“Doc”,点击 Headers,在信息栏查看Request Headers 的 User-Agent 字段,直接复制,黏贴到编译器就可以用啦,注意要以字典形式添加呀。   

2、lxml.etree 解析网页  

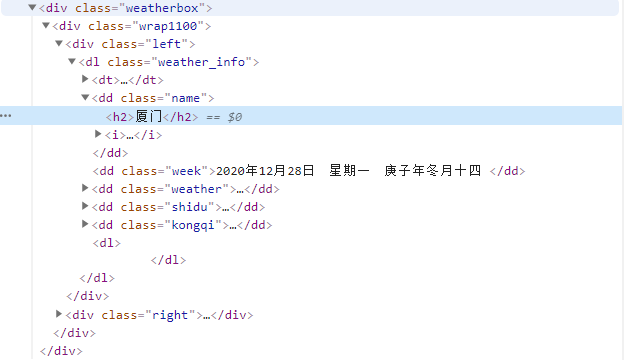
我们从网页爬取到得数据杂乱,其中也只有一部分是我们真正想要得到得数据,例如在本案例中我们只需网页中厦门市的天气详细信息,如图所示:

那么我们如如何提取呢?这时候就要用到 lxml.etree 啦。  

观察网页结构可以发现我们所需要的天气信息都在“dl class=’weather_info’”这一自定义列表下,于是乎我们只需在之前的代码后添加如下代码便能解析出该信息了:

html = etree.HTML(html)

html_data = html.xpath(“//d1[@class=’weather_info’]//text()”)  

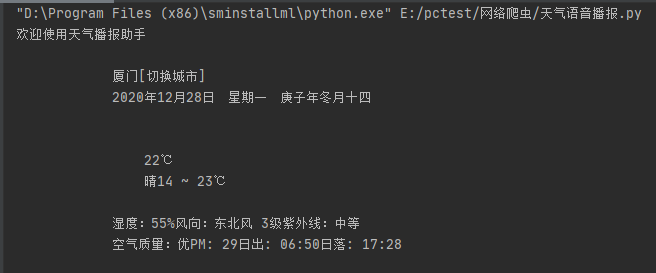
我们尝试一下打印其中信息,得到信息如图所示:

不难发现,得到的信息和我们想要的信息不是很一致,网页中的空格及换行符也一并让我们提取了出来,生成的对象也是列表类型。

所以呢,我们接下来还需做如下处理:

txt = “欢迎使用天气播报助手”

for data in html_data:

txt += data

再次打印不难发现我们所需要的信息都已经有了,看上去也是很 nice,不过美中不足的是 [切换城市] 还在,我们呢也不想要它。

那么怎么办呢,咱用字符串方法替换掉它即可。

txt = txt.replace(‘[切换城市]’,”)

三、pyttsx3 播报天气信息

到这一步,我们想要的数据都已被我们爬取下来并处理好保存在 txt 变量里啦,现在就让他读出来,到了 pyttsx3 这个库上场的时候了,代码如下:

test = pyttsx3.init()

test.say(txt)

test.runAndWait()

至此,我们的小案例就做完啦,推荐好课:Python 静态爬虫、Python Scrapy网络爬虫。

一步步的摸索,到功能的实现,在其中得到的乐趣及成就感,相信小伙伴们是很开心的。

最后:完整源码奉上:

import requests

import pyttsx3

from lxml import etree

url = ‘https://www.tianqi.com/xiamen/’

headers = {‘User-Agent’:’Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/87.0.4280.88 Safari/537.36′}

resp = requests.get(url=url, headers=headers)  # 向目标url地址发送请求,返回一个response对象

html = resp.text  # .text是response对象的网页html

html = etree.HTML(html)

html_data = html.xpath(“//dl[@class=’weather_info’]//text()”)

txt = “欢迎使用天气播报助手”

for data in html_data:

    txt += data

print(txt)

txt = txt.replace(‘[切换城市]’,”)

txt += ‘\n播报完毕!谢谢!’

print(txt)

test = pyttsx3.init()

test.say(txt)

test.runAndWait()

Python selenium的动态 id、class 怎么定位

thbcm阅读(372)

python 中会遇到定位不到元素的缘由-动态 id、class。

未打开新页面、没有 alert、没有 frame、添加等待时间,但还是定位不到元素?有很多是你要定位的元素属性是动态的。即每次打开页面,这个元素的 id 或 class 等元素属性是动态生成的。代码履行时,元素的属性已经和之前不同,用之前的属性值去定位当然是定位不到的,会抛出 NoSuchElementException。

那么,怎样判断元素是不是动态呢?很简单,一般看到元素属性里有拼接1串数字的,就有很多是动态的。想要分辨?刷新一下阅读器再看该元素,属性值中的数字串改变了,即是动态属性了。

如下:

<div id=”btn-attention_2031232″>…</div>

怎样定位这类型的元素呢?

1.根据其他属性定位

如果有其他固定属性,最早斟酌的当然是根据元素的其他属性来定位,定位方式那么多,没必要在一棵树上吊死。

2.根据相对关系定位

根据其附近的父节点、子节点、兄弟节点定位

3.根据 DOM 顺序 index 定位

这个很简单,找到该元素在主文档或某级父节点中的 index,然后根据 index 可轻松定位,不过这类方式不是很未定,如果可以用其他方式定位更适合

4.根据部分元素属性定位

xpath 中提供了3个非常好的方法来为我们定位部分属性值:

driver.find_element_by_xpath(“//div[contains(@id, ‘btn-attention’)]”) 
driver.find_element_by_xpath(“//div[starts-with(@id, ‘btn-attention’)]”) 
driver.find_element_by_xpath(“//div[ends-with(@id, ‘btn-attention’)]”) # 这个需要结尾是‘btn-attention’

contain(a,b)如果 a 中含有字符串 b,则返回 true,否则返回 false

starts-with(a,b)如果 a 是以字符串 b 开头,则返回 true ,否则返回 false

ends-with (a, b) 如果 a 是以字符串b结尾,返回 true,否则返回 false

这里要注意一下,各种浏览器对 xpath 的支持情况不一样,像IE就差点,所以有时候会出现 xpath 在一个浏览器能定位到但在另外一个浏览器定位不到的问题,不要惊讶。

联系我们