Matchering:音频音高和音频信号匹配的先进工具

thbcm阅读(324)

在音频处理领域,音高和音频信号的匹配是一项重要且具有挑战性的任务。本文将介绍Matchering,这是一个先进的音频音高和音频信号匹配工具。通过深入了解Matchering的原理和功能,读者将能够了解如何使用这个工具来进行音频匹配,提高音频处理的准确性和效率。

Matchering简介

Matchering是一个开源的音频处理工具,专注于音高和音频信号的匹配。它基于Python和C++开发,提供了一系列强大的算法和功能,用于音高估计、音频特征提取和匹配。Matchering旨在帮助音频工程师、音乐制作人和研究人员解决音频匹配问题,提供准确且高效的解决方案。
核心功能

Matchering提供了多个核心功能,包括:

  • 音高估计:Matchering使用先进的算法和技术,能够准确地估计音频中的音高信息。这对于音频音高匹配和音频处理具有重要意义。
  • 音频特征提取:Matchering支持提取音频的各种特征,如音高、节奏、能量等。这些特征可以用于进一步的音频匹配和分析。
  • 匹配算法:Matchering提供了多种匹配算法,包括基于模板匹配和机器学习的方法。用户可以根据需求选择适合的算法来进行音频匹配。
  • 可视化工具:Matchering提供了丰富的可视化工具,用户可以直观地观察和分析音频匹配结果,提供更好的音频处理决策依据。

使用示例

以下是使用Matchering进行音频匹配的简单示例:

import matchering as mr

# 1. 加载音频文件
audio_path = "path/to/audio.wav"
audio = mr.load_audio(audio_path)

# 2. 提取音频特征
features = mr.extract_features(audio)

# 3. 进行音高估计
pitch = mr.estimate_pitch(features)

# 4. 加载匹配模板
template_path = "path/to/template.wav"
template = mr.load_audio(template_path)

# 5. 提取模板特征
template_features = mr.extract_features(template)

# 6. 进行音频匹配
match_results = mr.match_audio(features, template_features)

# 7. 处理匹配结果
for result in match_results:
    start_time = result["start_time"]
    end_time = result["end_time"]
    confidence = result["confidence"]
    # 在这里可以对匹配结果进行处理,如打印时间范围和置信度等信息

# 8. 可视化匹配结果
mr.visualize_match(match_results, features, template_features)

上述示例演示了使用Matchering进行音频匹配的基本流程。首先,我们加载待匹配的音频文件和匹配模板文件。之后,通过调用extract_features函数,提取音频和模板的特征。然后,调用estimate_pitch函数进行音高估计,获取音频的音高信息。接下来,使用match_audio函数进行音频匹配,得到匹配结果。最后,可以对匹配结果进行处理或使用visualize_match函数可视化匹配结果。

使用案例

Matchering在音频处理领域有广泛的应用,涵盖了多个场景,例如:

  • 音频样本匹配:音乐制作人可以使用Matchering来匹配音频样本,以便在音乐制作过程中使用相似的音频片段。
  • 音高校正:音频工程师可以利用Matchering估计音频的音高信息,并对音频进行校正和调整,以达到音乐制作的要求。
  • 音频相似度计算:研究人员可以使用Matchering来计算音频之间的相似度,用于音频分类、音乐推荐等应用。

优势和价值

Matchering相比其他音频匹配工具具有以下优势和价值:

  • 准确性:Matchering采用先进的算法和技术,能够提供准确的音高估计和音频匹配结果。
  • 可扩展性:Matchering提供了丰富的功能和算法选择,可以根据需求进行定制和扩展。
  • 开源支持:Matchering是一个开源项目,拥有活跃的社区支持和持续的更新,用户可以获取及时的技术支持和新功能。
  • 易用性:Matchering提供了易于使用的API和文档,使用户能够快速上手并集成到自己的音频处理流程中。

总结

Matchering是一个强大而灵活的音频音高和音频信号匹配工具,通过其先进的算法和功能,帮助音频工程师和音乐制作人解决音频匹配的挑战。无论是音频样本匹配、音高校正还是音频相似度计算,Matchering都能够提供高精度和高效率的解决方案。选择Matchering作为音频匹配工具,将为音频处理工作带来更准确、更可靠的结果,并极大地提升音频处理的效率和质量。
Spring IoC:控制反转的强大利器

thbcm阅读(310)

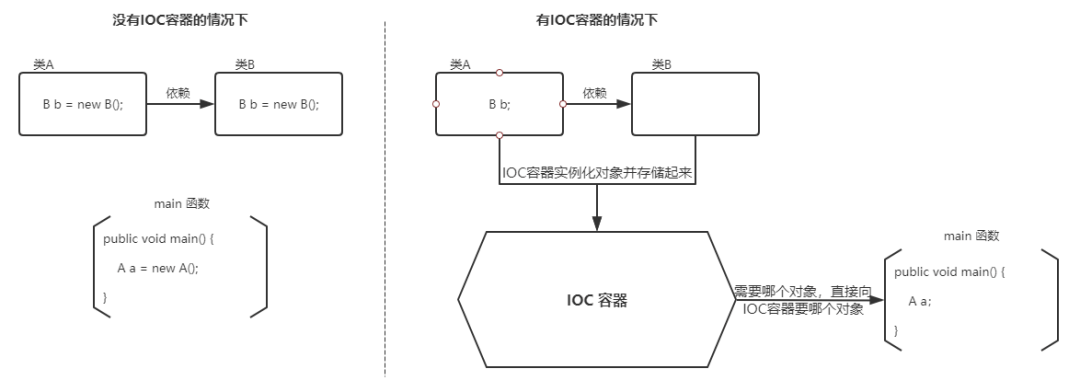
Spring IoC(Inversion of Control,控制反转)是Spring框架的核心特性之一,通过将对象的创建和依赖关系的管理交给容器来实现松耦合、可维护和可扩展的应用程序开发。本文将深入解析Spring IoC的概念、原理和使用方法,帮助读者全面理解IoC的重要性以及如何在Spring中充分利用IoC容器来提升开发效率。

什么是Spring IoC?

Spring IoC是一种设计原则和模式,其核心思想是控制反转。传统的开发模式中,对象之间的依赖关系由开发者手动创建和维护,而IoC通过将这些控制权反转给容器,实现了对象的创建和依赖关系的自动管理。

Spring IoC的原理

Spring IoC容器通过以下方式实现控制反转:

  • 配置元数据:开发者使用XML、注解或Java配置等方式,将对象的创建和依赖关系描述在配置文件或代码中。
  • 容器实例化对象:Spring IoC容器读取配置元数据,并根据配置信息实例化对象。
  • 依赖注入:容器根据配置中的依赖关系,将所需的依赖注入到相应的对象中。
  • 生命周期管理:容器管理对象的生命周期,包括对象的创建、初始化、销毁等。

Spring IoC的优势

使用Spring IoC带来以下优势:

  • 松耦合:通过IoC容器管理对象的依赖关系,对象之间的耦合度降低,便于维护和扩展。
  • 可测试性:IoC容器使得测试变得更加容易,可以通过替换依赖对象或模拟对象来进行单元测试。
  • 配置灵活性:通过配置文件或注解,可以灵活地调整对象的创建和依赖关系,而无需修改代码。
  • 代码简洁性:IoC容器负责创建和管理对象,开发者只需关注业务逻辑,代码更加简洁清晰。

Spring IoC的使用方法

在Spring中使用IoC容器的步骤如下:

  • 定义Bean:通过在配置文件或类上添加注解来定义Bean,并指定其依赖关系。
  • 配置IoC容器:在Spring配置文件中配置IoC容器,或使用基于注解的配置方式。
  • 获取Bean:通过IoC容器获取所需的Bean对象,并使用其提供的功能。

示例代码如下所示:

// 定义一个服务接口
public interface UserService {
    void addUser(String username);
}

// 实现服务接口
public class UserServiceImpl implements UserService {
    public void addUser(String username) {
        System.out.println("添加用户:" + username);
    }
}

// 配置IoC容器
@Configuration
public class AppConfig {
    @Bean
    public UserService userService() {
        return new UserServiceImpl();
    }
}

// 使用IoC容器
public class Main {
    public static void main(String[] args) {
        ApplicationContext context = new AnnotationConfigApplicationContext(AppConfig.class);
        UserService userService = context.getBean(UserService.class);
        userService.addUser("John");
    }
}

上述示例中,我们定义了一个UserService接口及其实现类UserServiceImpl。通过在配置类AppConfig中使用​@Bean​注解,将UserServiceImpl作为一个Bean配置到IoC容器中。在Main类中,我们使用AnnotationConfigApplicationContext来创建IoC容器,并通过​getBean​方法获取UserService的实例,然后调用其方法。

总结

Spring IoC是一种强大的控制反转容器,通过将对象的创建和依赖关系的管理交给容器来实现松耦合、可维护和可扩展的应用程序开发。本文通过解析Spring IoC的概念、原理和使用方法,帮助读者深入理解IoC的重要性,并指导如何在Spring框架中充分利用IoC容器来提升开发效率。

Cookie、Session和Token:身份验证与状态管理的三重较量

thbcm阅读(367)

在现代Web应用程序中,身份验证和状态管理是至关重要的功能。为了实现这些功能,开发人员使用了各种机制和技术。其中,Cookie、Session和Token是最常见的三种方法。它们在实现方式、存储位置和应用场景等方面存在差异。本文将详细介绍Cookie、Session和Token的定义、原理和区别,以帮助读者更好地理解和应用这些概念。

Cookie

Cookie是一种在客户端存储数据的机制,用于跟踪和识别用户。当用户访问一个网站时,服务器可以通过在响应头中设置Cookie来将数据发送到客户端。客户端浏览器将Cookie存储在本地,并在下次请求同一网站时将Cookie附加到请求头中发送回服务器。Cookie通常包含用户身份验证信息、会话标识和其他与用户相关的数据。

主要特点: 

  1. 存储在客户端,可以在浏览器关闭后持久存在; 
  2. 有大小限制,通常在几KB到几十KB之间; 
  3. 可以设置过期时间,控制Cookie的有效期; 
  4. 可以通过设置域名和路径限制Cookie的作用范围。

应用场景:

  • 身份验证:存储用户凭据或令牌,实现持久登录状态;

Session 

Session是在服务端存储用户状态的机制,用于跟踪和管理用户会话。当用户访问一个网站时,服务器会为每个用户创建一个唯一的会话标识(Session ID),并将该标识存储在服务器端。通常,Session ID会在响应中通过Cookie或URL参数的方式返回给客户端,客户端浏览器会在每次请求中将Session ID发送回服务器。服务器使用Session ID来查找并恢复与该用户相关的会话数据。 

主要特点:

  1. 存储在服务器端,通常存储在内存或数据库中;
  2. 服务器可以根据Session ID查找和管理会话数据; 
  3. 可以存储更多的用户信息,不受Cookie大小限制;
  4. 有效期通常较短,会话结束或超时后会自动销毁。 

应用场景: 

  • 用户状态管理:记录用户登录状态、购物车内容等;
  • 数据共享:在多个请求之间共享数据;
  • 安全性:防止用户篡改或伪造身份信息。

Token 

Token是一种轻量级的身份验证机制,用于验证用户身份和授权访问资源。Token是由服务器签发的一段加密字符串,它包含了关于用户身份和权限的信息。当用户进行身份验证后,服务器会生成一个Token,并将其返回给客户端。客户端在后续的请求中将Token附加在请求头或URL中发送给服务器进行验证。服务器可以通过解析和验证Token来确认用户的身份和权限。 

主要特点: 

  1. 存储在客户端,通常存储在浏览器的本地存储或内存中; 
  2. 服务器无需保持会话状态,可实现无状态(stateless)身份验证; 
  3. 可以设置有效期和访问权限,提高安全性; 
  4. 可以在不同的域名和应用程序之间共享身份验证信息。 

应用场景: 

  • 身份验证和授权:用户登录和访问受保护资源;
  • 单点登录(SSO):在多个应用程序中共享用户身份信息; 
  • 分布式系统:在不同的微服务之间传递身份信息。

区别与适用场景 

  • 存储位置:Cookie和Token存储在客户端,而Session存储在服务器端。
  • 安全性:Token相对于Cookie和Session更安全,因为它们不存储敏感信息,只包含加密的身份验证信息。 
  • 扩展性:Token更适合构建分布式系统,因为它们可以在不同的应用程序之间共享和验证身份信息。 
  • 有效期管理:Cookie和Token可以设置过期时间,而Session通常在会话结束或超时后自动销毁。
  • 存储容量:Cookie和Token大小有限制,而Session可以存储更多的数据。

总结

综上所述,Cookie、Session和Token是常见的身份验证和状态管理机制。它们在存储位置、安全性、扩展性和有效期管理等方面存在差异。选择使用哪种机制应根据具体的应用场景和安全要求进行评估。Cookie适合简单的身份验证和状态管理,Session适用于服务器端状态管理,而Token则更适合构建分布式系统和提供安全的身份验证机制。

Golang技巧揭秘:如何优雅美化你的代码

thbcm阅读(326)

Go语言是一种简洁、高效且具有并发特性的编程语言,它有许多有用的特性和技巧,可以帮助程序员提高编码的效率和质量,逐渐受到越来越多程序员的喜爱。无论您是刚入门Go语言还是有经验的开发者,本文将分享一些有用的Go技巧,帮助您在开发过程中更加高效、优雅地编写代码。

使用defer语句来确保资源的释放

defer语句可以让一个函数或方法在其所属的函数返回之前执行,这样可以用来释放文件、数据库连接、锁等资源,避免内存泄漏或死锁。例如,下面的代码可以确保文件被正确地关闭:

func main() {
    file, err := os.Open("test.txt")
    if err != nil {
        log.Fatal(err)
    }
    defer file.Close() // 文件会在main函数返回之前关闭
    // do something with file
}

使用多返回值来处理错误

Golang支持函数或方法返回多个值,这样可以用来返回错误信息,而不是使用异常或全局变量。这样可以让错误处理更加清晰和灵活,避免程序崩溃或出现意外的行为。例如,下面的代码可以检查文件是否存在,并返回相应的布尔值和错误信息:

func fileExists(filename string) (bool, error) {
    _, err := os.Stat(filename)
    if err == nil {
        return true, nil // 文件存在,无错误
    }
    if os.IsNotExist(err) {
        return false, nil // 文件不存在,无错误
    }
    return false, err // 其他错误
}

使用切片和映射来实现动态数组和字典

Golang没有提供数组和字典这样的内置数据结构,但是它提供了切片和映射,它们可以实现类似的功能,而且更加灵活和高效。切片是对底层数组的一个视图,它可以动态地增长或缩小,而不需要复制或重新分配内存。映射是一种无序的键值对集合,它可以用任意类型的键和值,而不需要预先定义或排序。例如,下面的代码可以用切片和映射来存储和打印一组学生的成绩:

func main() {
    // 创建一个切片,初始容量为10
    scores := make([]int, 0, 10)
    // 创建一个映射,键为字符串,值为整数
    names := make(map[string]int)
    // 添加一些数据
    scores = append(scores, 90, 80, 70, 60, 50)
    names["Alice"] = 90
    names["Bob"] = 80
    names["Charlie"] = 70
    names["David"] = 60
    names["Eve"] = 50
    // 打印切片和映射的长度和内容
    fmt.Println(len(scores), scores) // 5 [90 80 70 60 50]
    fmt.Println(len(names), names) // 5 map[Alice:90 Bob:80 Charlie:70 David:60 Eve:50]
}

使用goroutine和channel来实现并发和通信

Golang是一种并发的编程语言,它提供了goroutine和channel这两个强大的特性,可以让程序在多个逻辑处理器上同时运行多个任务,并且在它们之间安全地传递数据。goroutine是一种轻量级的线程,它可以用go关键字来启动,而不需要显式地创建或管理。channel是一种同步的管道,它可以用make函数来创建,而不需要使用锁或条件变量。例如,下面的代码可以用goroutine和channel来实现一个并发的计数器:

func main() {
    // 创建一个有缓冲的channel,容量为10
    ch := make(chan int, 10)
    // 启动10个goroutine,每个goroutine向channel发送一个数字
    for i := 0; i < 10; i++ {
        go func(i int) {
        ch <- i // 向channel发送i
        }(i)
    }
    // 从channel接收10个数字,并打印它们的和
    sum := 0
    for i := 0; i < 10; i++ {
        sum += <-ch // 从channel接收一个数字,并累加到sum
    }
    fmt.Println(sum) // 45
}

总结

掌握这些有用的Go技巧,将帮助您在开发过程中更加高效、优雅地编写代码。无论是处理序列数据、实现并发模式还是管理依赖关系,这些技巧都将成为您的利器。继续学习和探索Go语言的特性,不断提升自己的技能,将使您成为一名更出色的Go开发者。

Django序列化:简化数据处理与传输

thbcm阅读(360)

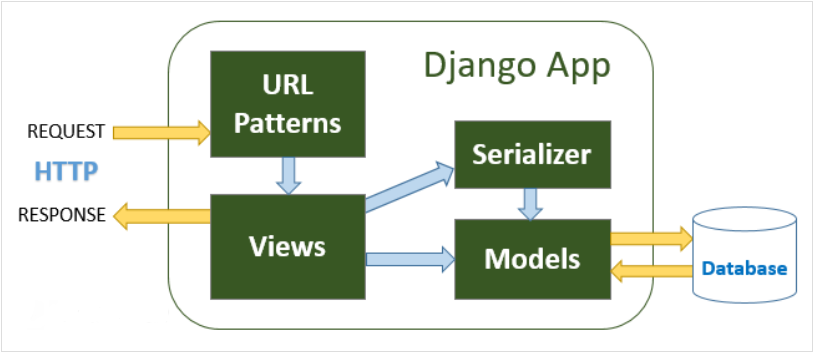
数据序列化是Web应用程序开发中的常见任务之一。在Django框架中,我们可以利用内置的序列化功能,将数据转换为JSON格式,实现数据的传输和交互。本文将介绍Django中的序列化机制,重点探讨如何将数据转换为JSON格式,帮助读者更好地理解和应用Django的序列化功能。

数据序列化是什么? 

数据序列化是将数据结构或对象转换为可传输或存储的格式的过程。在Web开发中,常见的序列化格式之一是JSON(JavaScript Object Notation)。JSON是一种轻量级的数据交换格式,易于阅读和编写,被广泛应用于前后端数据交互和API开发。


Django中的序列化器(Serializer): 

Django提供了一个强大的序列化器类,名为`serializers.Serializer`,用于将Django模型对象转换为序列化格式,如JSON。序列化器通过定义字段和规则,指定需要序列化的模型属性和关联关系。Django序列化器不仅可以将模型对象序列化为JSON格式的数据,还可以反序列化JSON数据为模型对象。 

数据序列化为JSON的基本步骤: 

使用Django序列化器将数据转换为JSON格式的过程相对简单。下面是实现该过程的基本步骤:

# 1. 导入Django序列化器
from rest_framework import serializers

# 2. 定义序列化器类
class MyModelSerializer(serializers.Serializer):
    # 定义需要序列化的字段
    field1 = serializers.CharField()
    field2 = serializers.IntegerField()

# 3. 创建需要序列化的数据对象
data = {
    'field1': 'Value 1',
    'field2': 42
}

# 4. 实例化序列化器并进行序列化
serializer = MyModelSerializer(data=data)
if serializer.is_valid():
    json_data = serializer.data
    # 在这里可以使用json_data进行进一步处理或传输
else:
    errors = serializer.errors
    # 处理序列化错误

序列化器的高级功能: 

除了基本的数据序列化,Django序列化器还提供了一些高级功能,增强了序列化的灵活性和效率。以下是一些常用的高级功能: 

  • 序列化器验证:可以在序列化器中定义验证规则,对序列化的数据进行有效性和完整性验证。 
  • 嵌套序列化:可以处理模型之间的关联关系,实现嵌套序列化,将关联模型的数据包含在主模型的序列化结果中。 
  • 反序列化:除了将数据序列化为JSON格式,序列化器还可以反序列化JSON数据为模型对象,实现数据的反向转换。 

应用场景: 

Django的序列化功能在许多应用场景中非常有用。例如: 

  • API开发:将模型数据序列化为JSON格式,作为API的响应数据,供前端进行数据获取和展示。 
  • 数据导出:将数据库中的数据批量导出为JSON文件,用于数据备份、迁移或与其他系统进行数据交换。 
  • 缓存持久化:将复杂的数据结构序列化为JSON格式,存储在缓存中,提高系统性能和响应速度。 

总结

Django的序列化功能提供了便捷的方法,将数据转换为JSON格式,实现数据的传输和交互。通过使用Django序列化器,我们可以轻松地将模型对象序列化为JSON数据,并实现数据的反序列化。了解Django序列化的基本用法和高级功能,将帮助开发人员更好地利用Django的强大功能,简化数据交互和API开发的过程。无论是构建API、导出数据还是实现缓存持久化,Django序列化器都是一个强大而灵活的工具。

SSL协议:保障网络通信的安全协议

thbcm阅读(290)

在当今数字化时代,安全性对于网络通信至关重要。SSL(Secure Sockets Layer)协议是一种常用的安全协议,用于保护在计算机网络上进行的数据传输。本文将深入探讨SSL协议的工作原理、加密机制和应用场景,帮助读者理解SSL协议的重要性以及如何确保网络通信的安全性。

什么是SSL

SSL(Secure Sockets Layer)是一种用于在网络上保护信息安全的标准安全技术。它通过对网络连接进行加密来确保数据在客户端和服务器之间的安全传输。SSL协议使用了非对称加密和对称加密技术,可以防止数据在传输过程中被窃取或篡改。SSL主要用于保护网站上的敏感信息,如个人信息、信用卡信息等。在现代网络通信中,SSL已经被其后继标准TLS(Transport Layer Security)所取代,但是通常情况下人们仍然称之为SSL。

SSL的工作原理

上面的概念性描述中提到了两个关键:第一个:SSL是一种保护信息安全的技术标准;第二个:SSL使用了对称加密技术和非对称加密的技术;具体来讲SSL的工作原理涉及下面三个关键步骤:
  • 握手阶段:客户端发起与服务器的连接请求,服务器会返回其SSL证书。客户端验证证书的有效性,并生成一个预主密钥,再用服务器的公钥加密后发送给服务器。
  • 密钥协商阶段:服务器接收到客户端发送的预主密钥后,使用自己的私钥解密得到预主密钥,然后双方基于预主密钥生成会话密钥(对称密钥),用于加密通信数据。
  • 数据传输阶段:客户端和服务器使用会话密钥进行加密和解密通信数据,确保数据在传输过程中的机密性和完整性。
通过以上步骤,SSL协议实现了对数据的加密传输,防止了中间人攻击和窃听等安全威胁,从而保障了网络通信的安全性。

SSL协议的加密机制

  • 对称加密:对称加密是一种加密方式,使用相同的密钥对数据进行加密和解密。在SSL协议中,对称加密算法通常用于加密和解密实际的数据传输。对称加密算法的优势在于加密和解密速度快,但密钥的安全传输和管理是一个挑战。
  • 非对称加密:非对称加密是一种使用公钥和私钥进行加密和解密的方式。在SSL协议中,非对称加密算法用于密钥交换和身份验证过程。服务器拥有私钥,用于解密客户端发送的加密数据,而公钥则公开给客户端进行加密操作。非对称加密算法的优势在于安全性高,但加密和解密速度比对称加密慢。
  • 混合加密:SSL协议通常使用混合加密机制,结合了对称加密和非对称加密的优点。在握手阶段,SSL协议使用非对称加密算法来交换临时的对称密钥。一旦对称密钥建立,后续的数据传输将使用对称加密算法进行加密和解密。这样可以保证安全性和效率的平衡。
  • 消息认证码(MAC):除了加密数据,SSL协议还使用消息认证码(MAC)来确保数据的完整性。MAC是一种通过使用密钥和散列函数对消息进行计算得到的固定长度值。接收方可以使用相同的密钥和散列函数对接收到的消息计算MAC,并与发送方发送的MAC进行比较,以验证数据是否被篡改。
  • 数字证书与公钥基础设施(PKI):SSL协议中使用数字证书来验证服务器的身份。数字证书是由受信任的第三方机构颁发的,其中包含了服务器的公钥以及其他相关信息。公钥基础设施(PKI)用于管理和验证数字证书的真实性和可信度。

SSL的应用场景

SSL协议的常见应用场景还是挺多的,比如下面这些。当然,除了下面这些,还有其他很多场景,这里就不过多赘述了。
  • 网站加密通信:通过HTTPS协议来保护网站上的数据传输,确保用户和网站之间的通信安全。
  • 电子邮件加密:例如使用SMTPS、IMAPS和POP3S等协议来保护电子邮件的传输过程,确保邮件内容的机密性。
  • 虚拟专用网络(VPN):通过SSL VPN技术来建立安全的远程访问连接,使远程用户可以安全地访问公司内部网络资源。
  • 远程管理和访问:例如通过SSH(Secure Shell)来进行远程服务器管理,以及通过HTTPS访问远程管理界面等。
  • 安全聊天和即时通讯:许多即时通讯应用程序使用SSL/TLS来加密用户之间的通信内容,确保聊天内容的机密性。

总结

SSL协议作为一种重要的安全协议,为网络通信提供了保护。通过使用SSL协议,可以确保数据传输的机密性、完整性和身份验证。了解SSL协议的工作原理、加密机制和应用场景,有助于理解网络安全的重要性,并采取适当的措施保障数据的安全。无论是在个人用户还是企业组织中,SSL协议都是确保网络通信安全的关键组成部分。

C++宏的超能力:do-while的妙用让代码更具魔力!

thbcm阅读(319)

C++宏是一种在预处理阶段展开的文本替换机制,可以在代码中定义宏来简化代码或实现特定功能。其中,do-while结构是一种常见的宏包裹技巧,本文将深入探讨在C++中使用宏do-while的好处和实际应用。

理解宏

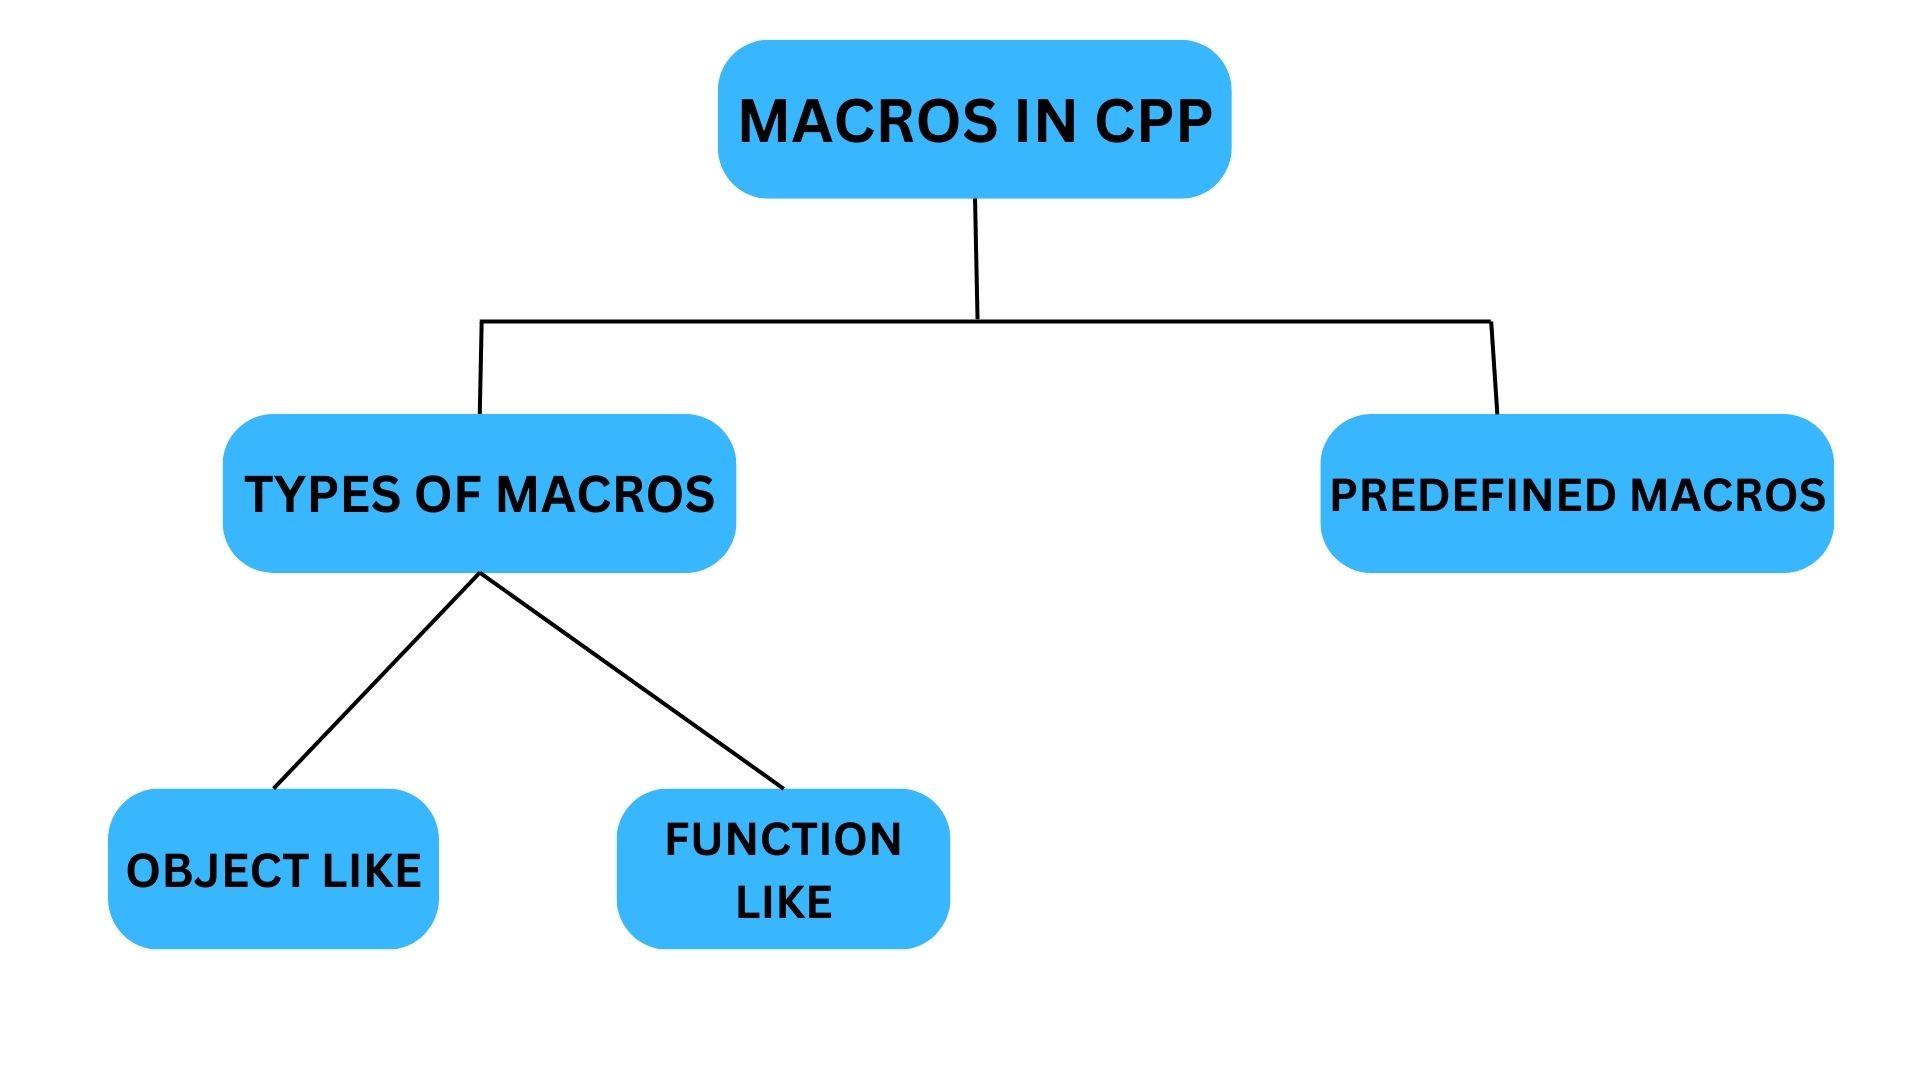
宏是C++中的一种预处理指令,用于在编译之前对源代码进行文本替换。通过宏定义,可以将一段代码片段替换为指定的文本,从而简化代码编写和提高效率。

do-while结构

do-while是C++中的一种循环结构,它保证循环体至少执行一次。宏do-while结构利用这个特性,在宏定义中使用do-while包裹代码块,以实现更灵活的宏功能。

宏do-while的好处

  • 灵活性:宏do-while可以包裹多行代码,避免由于代码片段的复杂性而导致的宏定义问题。
  • 一致性:宏do-while结构确保循环体至少执行一次,消除了常规循环可能出现的异常情况,保证代码的一致性。
  • 控制流:宏do-while可以通过使用break和continue语句控制循环流程,实现更加灵活的逻辑控制。

使用示例

当使用C++宏时,do-while结构可以用于包裹代码块,以实现更灵活的宏功能。以下是一个使用宏do-while的示例:

#include <iostream>

#define LOG_ERROR(msg) \
    do { \
        std::cerr << "[ERROR] " << msg << std::endl; \
    } while (false)

int main() {
    int x = 10;
    int y = 0;

    do {
        if (y == 0) {
            LOG_ERROR("Division by zero");
            break;
        }

        int result = x / y;
        std::cout << "Result: " << result << std::endl;
    } while (false);

    return 0;
}

在上面的示例中,我们定义了一个名为
LOG_ERROR的宏,用于输出错误日志。宏定义中使用了do-while结构来包裹代码块,以确保日志输出的一致性。在
main函数中,我们使用了do-while结构来处理除法运算。如果除数
y为0,我们会输出一个错误日志并使用
break语句跳出循环。否则,我们执行除法运算并输出结果。

实际应用场景

  • 错误处理:通过宏do-while结构,可以定义一组简洁的错误处理宏,用于处理函数返回的错误码,提高代码的可读性和维护性。
  • 资源管理:宏do-while可以用于资源的自动释放,如使用宏定义RAII(Resource Acquisition Is Initialization)类,通过do-while结构在作用域结束时自动释放资源。
  • 日志记录:宏do-while结构可以包裹日志记录的代码,实现灵活的日志级别控制和格式化输出。

注意事项

  • 宏展开:宏定义在预处理阶段展开,可能导致代码的可读性和调试的困难,需要谨慎使用。
  • 命名冲突:宏定义的命名需要避免与其他代码冲突,以免产生意想不到的结果。
  • 代码块保护:在宏do-while中,需要注意代码块的保护,以确保宏在使用时不会产生意外的副作用。

总结

宏do-while是C++中一种巧妙的代码包裹技巧,通过包裹代码块,它使得宏的使用更加灵活、一致,并且可以应用于各种实际场景。然而,在使用宏do-while时需要注意展开后的代码可读性、命名冲突和代码块保护等方面的问题。合理地运用宏do-while,可以提高代码的简洁性、可维护性和可扩展性,为C++编程带来便利。

Scrapy:Python中强大的网络爬虫框架

thbcm阅读(297)

Scrapy是一个基于Python的开源网络爬虫框架,它提供了一套简洁高效的工具和API,用于快速、灵活地构建和管理网络爬虫。本文将介绍Scrapy的核心概念、使用方法以及其在实际应用中的优势。

Scrapy是什么

Scrapy是一个基于Python的开源网络爬虫框架,旨在简化和加速开发者构建和管理网络爬虫的过程。它提供了一套强大的工具和API,使得爬取网页数据变得高效、灵活和可扩展。Scrapy的核心设计理念是使用”蜘蛛”(Spider)来定义如何爬取和解析网页。Spider是一个用户自定义的类,通过指定起始URL和数据提取规则,来定义爬取的行为。Scrapy提供了丰富的功能和机制来处理请求、处理响应、提取数据,并支持异步非阻塞的方式处理大量数据和页面。

Scrapy的核心概念

  • Spider(蜘蛛):定义如何爬取和解析网页的规则,指定起始URL和数据提取规则。
  • Selector(选择器):用于从HTML或XML文档中提取数据的强大工具。
  • Item(数据项):表示要爬取的数据结构,类似于模型或字典。
  • Pipeline(管道):负责处理从Spider中提取的数据,如数据清洗、存储等。
  • Middleware(中间件):用于处理请求和响应的扩展组件,可自定义处理逻辑。

Scrapy的使用方法

  1. 首先,确保已经安装了Scrapy。可以使用以下命令在命令行中安装Scrapy:
    pip install scrapy
  2. 创建一个新的Scrapy项目,可以使用以下命令:
    scrapy startproject myproject
    cd myproject
  3. 在项目的根目录下,创建一个名为myspider.py的Python文件,并使用以下代码编写蜘蛛(Spider):
    import scrapy
    
    class MySpider(scrapy.Spider):
        name = "myspider"
        start_urls = [
            "http://example.com"
        ]
    
        def parse(self, response):
            for article in response.css('article'):
                title = article.css('h2 a::text').get()
                link = article.css('h2 a::attr(href)').get()
                yield {
                    'title': title,
                    'link': link
                }

    在上述代码中,我们定义了一个名为MySpider的Spider类。name属性指定了Spider的名称,start_urls属性指定了起始URL。在parse方法中,我们使用CSS选择器提取了网页中的标题和链接,并通过yield语句将提取的数据返回。

  4. 保存并关闭myspider.py文件。在命令行中,使用以下命令运行爬虫:
    scrapy crawl myspider -o output.json

    上述命令将运行名为myspider的Spider,并将提取的数据保存到名为output.json的文件中。运行完毕后,您将在项目的根目录中找到生成的output.json文件,其中包含了提取的标题和链接数据。

Scrapy的优势

  • 高性能:Scrapy采用异步非阻塞的方式处理请求和响应,高效处理大量数据和页面。
  • 可扩展性:Scrapy提供了丰富的扩展机制,可以自定义Downloader、Pipeline等组件,满足各种需求。
  • 内置功能:Scrapy内置了多线程、自动重试、请求调度等功能,简化了爬虫的开发和管理。
  • 数据提取:Scrapy提供强大的选择器工具,支持XPath和CSS选择器,方便快速提取所需数据。
  • 文档丰富:Scrapy拥有详细的官方文档和活跃的社区,提供了大量的示例和教程,方便学习和参考。

实际应用场景

  • 网络数据采集:Scrapy可用于爬取网页中的结构化数据,如新闻、商品信息等。
  • 数据挖掘和分析:通过爬取数据并进行处理,Scrapy可用于进行数据挖掘和分析,提供有价值的洞察。
  • 监测和监控:Scrapy可用于定期检查网站的变化、监测竞争对手等,提供实时的数据更新和报告。

总结

Scrapy作为一款强大的网络爬虫框架,提供了高效、灵活的工具和API,使得开发者能够轻松构建和管理复杂的网络爬虫。其核心概念、使用方法和优势使得Scrapy成为Python爬虫领域的瑰宝。通过掌握Scrapy,您将能够更加高效地获取和处理网络数据,并应用于各种实际应用场景中。

Nginx反向代理:加速和保护您的Web应用

thbcm阅读(342)

Nginx是一款高性能、轻量级的Web服务器软件,同时也是一个功能强大的反向代理服务器。本文将详细介绍如何使用Nginx作为反向代理服务器,包括反向代理的概念、Nginx的优势、配置步骤以及常见应用场景,帮助读者充分理解和应用Nginx的反向代理功能。

什么是反向代理?

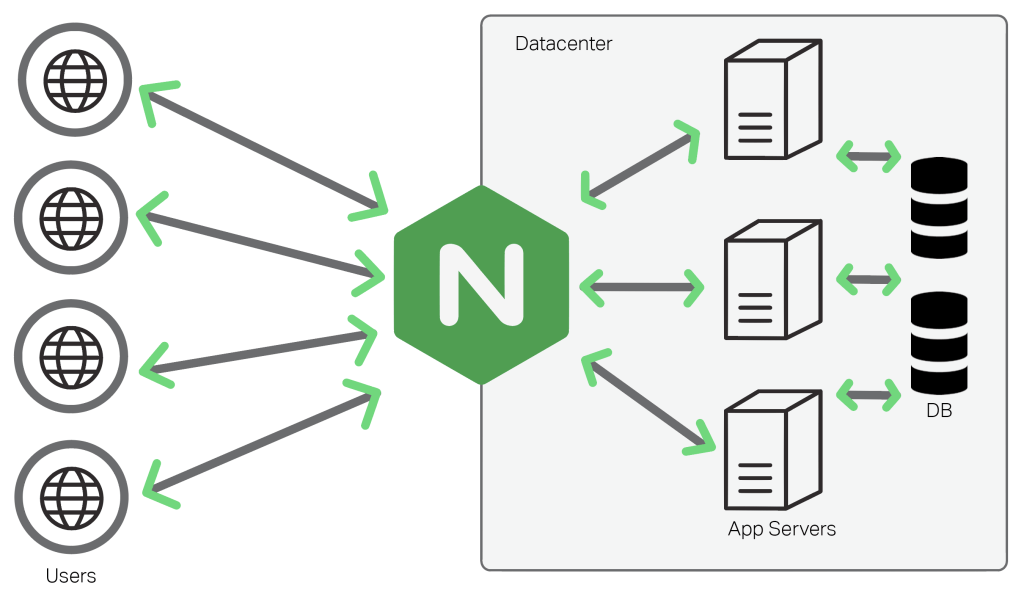
反向代理是一种网络通信模式,它位于服务器端与客户端之间,代理服务器接收客户端的请求,并将请求转发给后端的真实服务器。客户端并不直接与真实服务器通信,而是通过反向代理服务器来访问资源。这种模式可以提供负载均衡、缓存、安全性等多种好处。

Nginx作为反向代理的优势

Nginx作为反向代理具有以下优势:

  • 高性能:Nginx采用异步非阻塞的事件驱动模型,能够处理大量并发连接,具有出色的性能表现。
  • 负载均衡:Nginx可以根据配置的负载均衡算法,将请求均匀地分发到多个后端服务器,提高系统的整体性能和可靠性。
  • 静态资源缓存:Nginx支持静态资源的缓存,可以减轻后端服务器的负载,提高用户访问速度。
  • 安全性:Nginx可以作为反向代理,将请求先发送到反向代理服务器进行处理,从而隐藏后端真实服务器的IP地址和细节,提高系统的安全性。

配置Nginx作为反向代理服务器的步骤

下面是配置Nginx作为反向代理服务器的基本步骤:

  1. 安装Nginx:根据操作系统的不同,下载并安装适合的Nginx版本。
  2. 编辑Nginx配置文件:打开Nginx的配置文件(通常位于​/etc/nginx/nginx.conf​),根据需要进行修改。
  3. 配置反向代理:在配置文件中,使用location块配置反向代理的规则,指定代理的目标服务器地址。

    server {
        listen 80;
        server_name example.com;
        
        location / {
            proxy_pass http://backend_server;
        }
    }


    在上述示例中,客户端的请求通过Nginx代理转发到名为​backend_server​的后端服务器。

  4. 保存并重启Nginx:保存配置文件并重启Nginx服务,使配置生效。

常见应用场景

Nginx作为反向代理服务器的应用场景非常广泛,以下是一些常见的应用场景:

  • 负载均衡:将请求分发到多个后端服务器,平衡负载,提高系统的并发处理能力。
  • 缓存加速:缓存静态资源,减轻后端服务器的负载,提高用户访问速度。
  • SSL终端代理:作为SSL终端代理,将客户端的SSL请求解密,转发到后端的非SSL服务器。
  • 高可用性与故障转移:通过配置健康检查和故障转移策略,实现后端服务器的高可用性和容错能力。
  • 安全防护:作为安全层,对请求进行过滤、限制和防护,提高系统的安全性。

总结

Nginx作为反向代理服务器具有出色的性能、负载均衡能力、静态资源缓存和安全性等优势。通过本文的讲解,读者可以了解到反向代理的概念、Nginx作为反向代理的优势、配置步骤以及常见的应用场景,能够更好地理解和应用Nginx的反向代理功能。无论是提高系统的性能、实现负载均衡,还是加速静态资源访问和提升安全性,Nginx作为反向代理都是一个强大而灵活的解决方案。

Spring Boot的自定义过滤器与拦截器:掌握Web应用的控制与安全

thbcm阅读(357)

Spring Boot是一个流行的Java框架,提供了丰富的功能来简化Web应用程序的开发。本文将深入探讨Spring Boot中的自定义过滤器(Filter)和拦截器(Interceptor),解释它们的作用、区别和如何在应用程序中使用。

过滤器(Filter)的作用和使用

过滤器(Filter)是一种在请求和响应之间进行预处理和后处理的组件。它可以用于实现诸如日志记录、权限验证、字符编码转换等功能。在Spring Boot中,我们可以通过实现javax.servlet.Filter接口来创建自定义过滤器。自定义过滤器可以在应用程序的配置中进行注册,并按照指定的顺序被应用于请求和响应。自定义过滤器的代码示例:

import javax.servlet.*;
import javax.servlet.annotation.WebFilter;
import java.io.IOException;

@WebFilter(urlPatterns = "/*")
public class CustomFilter implements Filter {
    @Override
    public void init(FilterConfig filterConfig) throws ServletException {
        // 初始化方法
    }

    @Override
    public void doFilter(ServletRequest request, ServletResponse response, FilterChain chain)
            throws IOException, ServletException {
        // 过滤器逻辑处理
        // 在请求被处理之前执行的操作
        // ...

        chain.doFilter(request, response);

        // 在请求被处理之后执行的操作
        // ...
    }

    @Override
    public void destroy() {
        // 销毁方法
    }
}

拦截器(Interceptor)的作用和使用

拦截器(Interceptor)是一种在请求处理过程中拦截并进行处理的组件。它可以用于实现诸如身份验证、日志记录、性能监控等功能。在Spring Boot中,我们可以通过实现org.springframework.web.servlet.HandlerInterceptor接口来创建自定义拦截器。自定义拦截器可以在请求处理的不同阶段进行拦截,并执行相应的逻辑。自定义拦截器的代码示例:

import org.springframework.web.servlet.HandlerInterceptor;
import org.springframework.web.servlet.ModelAndView;

import javax.servlet.http.HttpServletRequest;
import javax.servlet.http.HttpServletResponse;

public class CustomInterceptor implements HandlerInterceptor {
    @Override
    public boolean preHandle(HttpServletRequest request, HttpServletResponse response, Object handler)
            throws Exception {
        // 在请求到达控制器之前执行的操作
        // 可以进行身份验证、权限控制等逻辑处理
        // 返回true表示继续执行请求,返回false表示中断请求
        // ...

        return true;
    }

    @Override
    public void postHandle(HttpServletRequest request, HttpServletResponse response, Object handler,
                           ModelAndView modelAndView) throws Exception {
        // 在请求处理完成后,但尚未返回响应之前执行的操作
        // 可以进行日志记录、性能监控等逻辑处理
        // ...
    }

    @Override
    public void afterCompletion(HttpServletRequest request, HttpServletResponse response, Object handler,
                                Exception ex) throws Exception {
        // 在请求处理完成并返回响应后执行的操作
        // 可以进行清理资源、异常处理等逻辑处理
        // ...
    }
}

过滤器与拦截器的区别

  • 运行环境:过滤器是基于Servlet规范的,可以在请求和响应的前后进行处理。拦截器是Spring框架提供的,运行在Spring MVC的上下文中,可以访问Spring容器中的资源。
  • 触发时机:过滤器在请求到达Servlet之前和离开Servlet之后执行。拦截器在请求进入控制器之前和离开控制器之后执行。
  • 配置方式:过滤器需要在web.xml或Servlet注册类中进行配置。拦拦截器可以通过Java配置或注解的方式进行配置。

如何选择过滤器或拦截器

  • 如果需要对请求和响应进行全局的处理,如字符编码转换、请求日志记录等,可以选择使用过滤器。
  • 如果需要在请求处理的不同阶段进行拦截,并进行特定的逻辑处理,如身份验证、权限控制等,可以选择使用拦截器。

总结

Spring Boot提供了灵活且强大的自定义过滤器和拦截器功能,用于处理Web应用程序的预处理和后处理。过滤器适用于全局的请求和响应处理,而拦截器适用于针对特定请求进行拦截和处理。通过合理使用过滤器和拦截器,我们可以实现许多常见的功能,提高应用程序的可维护性和可扩展性。在开发Spring Boot应用程序时,根据需求选择合适的过滤器或拦截器,可以为我们带来更好的开发体验和代码质量。

联系我们