Vue项目从2.5M优化到200kb的全过程

thbcm阅读(306)

文章来源于公众号:前端开发社区, 作者:炮哥

最近优化了一个vue cli3.0项目,项目从打包体积2.5M,优化到272k, 速度提高了约2/3。下面将优化方法写下:

需要新建文件’vue.config.js‘,(这文件名是固定这么写的),与package.json在同一级目录下。

BundleAnalyzer

作用:展示打包图形化信息,会打开一个html页面,帮助自己分析哪些文件过大,可针对其进行优化,上线前 注释掉

安装 webpack-bundle-analyzer 插件

  npm install webpack-bundle-analyzer --save-dev

vue.config.js: 里面:

// 引入
const BundleAnalyzerPlugin = require("webpack-bundle-analyzer").BundleAnalyzerPlugin;


// 展示图形化信息
chainWebpack: config => {
  config
      .plugin('webpack-bundle-analyzer')
      .use(BundleAnalyzerPlugin)
}

抽离 css 支持按需加载

安装 mini-css-extract-plugin 插件

 npm install mini-css-extract-plugin -D

vue.config.js里面:

chainWebpack: config => {
  let miniCssExtractPlugin = new MiniCssExtractPlugin({
    filename: 'assets/[name].[hash:8].css',
    chunkFilename: 'assets/[name].[hash:8].css'
  })
  config.plugin('extract-css').use(miniCssExtractPlugin)
}

图片按需加载

安装image-webpack-loader插件

 npm install image-webpack-loader -D

vue.config.js里面:

config.module.rule('images')
    .test(/\.(png|jpe?g|gif|webp)(\?.*)?$/)
    .use('image-webpack-loader')
    .loader('image-webpack-loader')
    .options({
      bypassOnDebug: true
    })
    .end()

图片压缩可以在:https://tinypng.com/ 进行批量压缩

gzip压缩代码

安装 compression-webpack-plugin 插件

 npm install compression-webpack-plugin -D

vue.config.js里面:

const CompressionWebpackPlugin = require('compression-webpack-plugin');


// 开启gzip压缩
  config.plugins.push(
    new CompressionWebpackPlugin(
      {
        filename: info => {
          return `${info.path}.gz${info.query}`
        },
        algorithm: 'gzip',
        threshold: 10240, // 只有大小大于该值的资源会被处理 10240
        test: new RegExp('\\.(' + ['js'].join('|') + ')$'
        ),
        minRatio: 0.8, // 只有压缩率小于这个值的资源才会被处理
        deleteOriginalAssets: false // 删除原文件
      }
    )
  )

公共代码抽离

vue.config.js里面:

// 开启gzip压缩


configureWebpack: config => {
  config.plugins.push(
    new CompressionWebpackPlugin(
      {
        filename: info => {
          return `${info.path}.gz${info.query}`
        },
        algorithm: 'gzip',
        threshold: 10240, // 只有大小大于该值的资源会被处理 10240
        test: new RegExp('\\.(' + ['js'].join('|') + ')$'
        ),
        minRatio: 0.8, // 只有压缩率小于这个值的资源才会被处理
        deleteOriginalAssets: false // 删除原文件
      }
    )
  )
}

element-ui 按需加载

安装 babel-plugin-component 插件

 npm install babel-plugin-component --save-dev

babel.config.js里面:

module.exports = {
  presets: [
    '@vue/app'
  ],
  plugins: [
    [
      "component",
      {
        libraryName: "element-ui",
        styleLibraryName: "theme-chalk"
      }
    ]
  ]
}

echarts 按需加载:

安装 babel-plugin-equire 插件:

npm install babel-plugin-equire -D

在项目中创建 echarts.js:

// eslint-disable-next-line
  const echarts = equire([
    // 写上你需要的 echarts api
    "tooltip",
    "line"
  ]);


  export default echarts;

babel.config.js里面:

module.exports = {
  presets: [
    '@vue/app'
  ],
  plugins: [
    [
      "component",
      {
        libraryName: "element-ui",
        styleLibraryName: "theme-chalk"
      }
    ],
    "equire"
  ]
}

具体页面应用:

 // 直接引用
 import echarts from '@/lib/util/echarts.js' 

 
 this.myChart = echarts.init(this.$refs.chart) 

lodash 按需加载:

安装 lodash-webpack-plugin 插件

 npm install lodash-webpack-plugin --save-dev

babel.config.js里面:

module.exports = {
  presets: [
    '@vue/app'
  ],
  plugins: [
    [
      "component",
      {
        libraryName: "element-ui",
        styleLibraryName: "theme-chalk"
      }
    ],
    "lodash",
    "equire"
  ]
}

vue.config.js里面:

const LodashModuleReplacementPlugin = require("lodash-webpack-plugin");


chainWebpack: config => {
    config
    .plugin("loadshReplace")
    .use(new LodashModuleReplacementPlugin());
}

prefetch 和 preload

删除无用的插件,避免加载多余的资源(如果不删除的话,则会在 index.html 里面加载 无用的 js 文件)

chainWebpack: config => {
    // 移除prefetch插件,避免加载多余的资源
    config.plugins.delete('prefetch')
    / 移除 preload 插件,避免加载多余的资源
    config.plugins.delete('preload');
}

完整的代码:

const MiniCssExtractPlugin = require('mini-css-extract-plugin');
const CompressionWebpackPlugin = require('compression-webpack-plugin');
const LodashModuleReplacementPlugin = require("lodash-webpack-plugin");


module.exports = {
  productionSourceMap: false, // 关闭生产环境的 source map
  lintOnSave: false,
  publicPath: process.env.VUE_APP_PUBLIC_PATH,
  devServer: {
    host: "localhost",
    port: 3002,
    proxy: {
      '/api': {
        target: "https://tapi.quanziapp.com/api/",
        ws: true,
        changeOrigin: true,
        pathRewrite: {
          '^/api': ''
        }
      },
    }
  },


  chainWebpack: config => {


    // 移除 prefetch 插件
    config.plugins.delete('prefetch');
    // 移除 preload 插件,避免加载多余的资源
    config.plugins.delete('preload');

 
    config.optimization.minimize(true);


    config.optimization.splitChunks({
      chunks: 'all'
    })


    config
      .plugin('webpack-bundle-analyzer')
      .use(require('webpack-bundle-analyzer').BundleAnalyzerPlugin)


    if (process.env.NODE_ENV !== 'development') {


      let miniCssExtractPlugin = new MiniCssExtractPlugin({
        filename: 'assets/[name].[hash:8].css',
        chunkFilename: 'assets/[name].[hash:8].css'
      })
      config.plugin('extract-css').use(miniCssExtractPlugin)
      config.plugin("loadshReplace").use(new LodashModuleReplacementPlugin());


      config.module.rule('images')
        .test(/\.(png|jpe?g|gif|webp)(\?.*)?$/)
        .use('image-webpack-loader')
        .loader('image-webpack-loader')
        .options({
          bypassOnDebug: true
        })
        .end()
        .use('url-loader')
        .loader('file-loader')
        .options({
          name: 'assets/[name].[hash:8].[ext]'
        }).end()
      config.module.rule('svg')
        .test(/\.(svg)(\?.*)?$/)
        .use('file-loader')
        .loader('file-loader')
        .options({
          name: 'assets/[name].[hash:8].[ext]'
        })
    }
  },
  configureWebpack: config => {
    // config.plugins.push(["equire"]);


    if (process.env.NODE_ENV !== 'development') {
      config.output.filename = 'assets/[name].[hash:8].js'
      config.output.chunkFilename = 'assets/[name].[hash:8].js'
    }
    // 公共代码抽离
    config.optimization = {
      // 分割代码块
      splitChunks: {
        cacheGroups: {
          //公用模块抽离
          common: {
            chunks: 'initial',
            minSize: 0, //大于0个字节
            minChunks: 2, //抽离公共代码时,这个代码块最小被引用的次数
          },
          //第三方库抽离
          vendor: {
            priority: 1, //权重
            test: /node_modules/,
            chunks: 'initial',
            minSize: 0, //大于0个字节
            minChunks: 2, //在分割之前,这个代码块最小应该被引用的次数
          },
        },
      }
    }
    // 开启gzip压缩
    config.plugins.push(
      new CompressionWebpackPlugin(
        {
          filename: info => {
            return `${info.path}.gz${info.query}`
          },
          algorithm: 'gzip',
          threshold: 10240, // 只有大小大于该值的资源会被处理 10240
          test: new RegExp('\\.(' + ['js'].join('|') + ')$'
          ),
          minRatio: 0.8, // 只有压缩率小于这个值的资源才会被处理
          deleteOriginalAssets: false // 删除原文件
        }
      )
    )
  },
  css: {
    extract: true,
    sourceMap: false,
    loaderOptions: {
      sass: {
      },
    },
  },
}

以上就是W3Cschool编程狮关于Vue项目从2.5M优化到200kb的全过程的相关介绍了,希望对大家有所帮助。
写好JavaScript条件语句的5条守则

thbcm阅读(330)

  • 原文地址:5 Tips to Write Better Conditionals in JavaScript
  • 译文出自:阿里云翻译小组
  • 译者:眠云(杨涛)
  • 校对者:也树,Mcskiller

在用 JavaScript 工作时,我们经常和条件语句打交道,这里有5条让你写出更好/干净的条件语句的建议。

1.多重判断时使用 Array.includes

2.更少的嵌套,尽早 return

3.使用默认参数和解构

4.倾向于遍历对象而不是 Switch 语句

5.对 所有/部分 判断使用 Array.every & Array.some

6.总结

1.多重判断时使用 Array.includes

让我们看一下下面这个例子:

// condition
function test(fruit) {
  if (fruit == 'apple' || fruit == 'strawberry') {
    console.log('red');
  }
}

第一眼,上面这个例子看起来没问题。如果我们有更多名字叫 cherrycranberries 的红色水果呢?我们准备用更多的 || 来拓展条件语句吗?

我们可以用 Array.includes (Array.includes)重写条件语句。

function test(fruit) {
  const redFruits = ['apple', 'strawberry', 'cherry', 'cranberries'];


  if (redFruits.includes(fruit)) {
    console.log('red');
  }
}

我们把红色的水果(red fruits)这一判断条件提取到一个数组。这样一来,代码看起来更整洁。

2.更少的嵌套,尽早 Return

让我们拓展上一个例子让它包含两个条件。

  • 如果没有传入参数 fruit,抛出错误
  • 接受 quantity 参数,并且在 quantity 大于 10 时打印出来
function test(fruit, quantity) {
  const redFruits = ['apple', 'strawberry', 'cherry', 'cranberries'];


  // 条件 1: fruit 必须有值
  if (fruit) {
    // 条件 2: 必须是red的
    if (redFruits.includes(fruit)) {
      console.log('red');


      // 条件 3: quantity大于10
      if (quantity > 10) {
        console.log('big quantity');
      }
    }
  } else {
    throw new Error('No fruit!');
  }
}


// 测试结果
test(null); // error: No fruits
test('apple'); // print: red
test('apple', 20); // print: red, big quantity

在上面的代码, 我们有:

  • 1个 if/else 语句筛选出无效的语句
  • 3层if嵌套语句 (条件 1, 2 & 3)

我个人遵循的规则一般是在发现无效条件时,尽早Return

/_ 当发现无效语句时,尽早Return _/


function test(fruit, quantity) {
  const redFruits = ['apple', 'strawberry', 'cherry', 'cranberries'];


  // 条件 1: 尽早抛出错误
  if (!fruit) throw new Error('No fruit!');


  // 条件 2: 必须是红色的
  if (redFruits.includes(fruit)) {
    console.log('red');


    // 条件 3: 必须是大质量的
    if (quantity > 10) {
      console.log('big quantity');
    }
  }
}

这样一来,我们少了一层嵌套语句。这种编码风格非常好,尤其是当你有很长的if语句的时候(想象你需要滚动到最底层才知道还有else语句,这并不酷)

我们可以通过 倒置判断条件 & 尽早return 进一步减少if嵌套。看下面我们是怎么处理判断 条件2 的:

/_ 当发现无效语句时,尽早Return _/


function test(fruit, quantity) {
  const redFruits = ['apple', 'strawberry', 'cherry', 'cranberries'];


  // 条件 1: 尽早抛出错误
  if (!fruit) throw new Error('No fruit!');
  // 条件 2: 当水果不是红色时停止继续执行
  if (!redFruits.includes(fruit)) return; 


  console.log('red');


  // 条件 3: 必须是大质量的
  if (quantity > 10) {
    console.log('big quantity');
  }
}

通过倒置判断条件2,我们的代码避免了嵌套语句。这个技巧在我们需要进行很长的逻辑判断时是非常有用的,特别是我们希望能够在条件不满足时能够停止下来进行处理。

而且这么做并不困难。问问自己,这个版本(没有嵌套)是不是比之前的(两层条件嵌套)更好,可读性更高?

但对于我,我会保留先前的版本(包含两层嵌套)。这是因为:

  • 代码比较短且直接,包含if嵌套的更清晰
  • 倒置判断条件可能加重思考的负担(增加认知载荷)

因此,应当尽力减少嵌套和尽早return,但不要过度。如果你感兴趣的话,可以看一下关于这个话题的一篇文章和 StackOverflow 上的讨论。

  • Avoid Else, Return Early by Tim Oxley
  • StackOverflow discussion on if/else coding style

3.使用默认参数和解构

我猜下面的代码你可能会熟悉,在JavaScript中我们总是需要检查 null / undefined的值和指定默认值:

function test(fruit, quantity) {
  if (!fruit) return;
  // 如果 quantity 参数没有传入,设置默认值为 1
  const q = quantity || 1; 


  console.log(`We have ${q} ${fruit}!`);
}


//test results
test('banana'); // We have 1 banana!
test('apple', 2); // We have 2 apple!

实际上,我们可以通过声明 默认函数参数 来消除变量 q。

function test(fruit, quantity = 1) {
  // 如果 quantity 参数没有传入,设置默认值为 1
  if (!fruit) return;
  console.log(`We have ${quantity} ${fruit}!`);
}


//test results
test('banana'); // We have 1 banana!
test('apple', 2); // We have 2 apple!

这更加直观,不是吗?注意,每个声明都有自己的默认参数.

例如,我们也能给fruit分配默认值:function test(fruit = 'unknown', quantity = 1)

如果fruit是一个object会怎么样?我们能分配一个默认参数吗?

function test(fruit) { 
  // 当值存在时打印 fruit 的值
  if (fruit && fruit.name)  {
    console.log (fruit.name);
  } else {
    console.log('unknown');
  }
}


//test results
test(undefined); // unknown
test({ }); // unknown
test({ name: 'apple', color: 'red' }); // apple

看上面这个例子,我们想打印 fruit 对象中可能存在的 name 属性。否则我们将打印unknown。我们可以通过默认参数以及解构从而避免判断条件 fruit && fruit.name

// 解构 - 仅仅获取 name 属性
// 为其赋默认值为空对象
function test({name} = {}) {
  console.log (name || 'unknown');
}


// test results
test(undefined); // unknown
test({ }); // unknown
test({ name: 'apple', color: 'red' }); // apple

由于我们只需要 name 属性,我们可以用 {name} 解构出参数,然后我们就能使用变量name 代替 fruit.name

我们也需要声明空对象 {} 作为默认值。如果我们不这么做,当执行 test(undefined) 时,你将得到一个无法对 undefined 或 null 解构的的错误。因为在 undefined 中没有 name 属性。

如果你不介意使用第三方库,这有一些方式减少null的检查:

  • 使用 Lodash get函数
  • 使用Facebook开源的idx库(with Babeljs)

这是一个使用Lodash的例子:

function test(fruit) {
  // 获取属性名,如果属性名不可用,赋默认值为 unknown
  console.log(__.get(fruit, 'name', 'unknown'); 
}


// test results
test(undefined); // unknown
test({ }); // unknown
test({ name: 'apple', color: 'red' }); // apple

你可以在jsbin运行demo代码。除此之外,如果你是函数式编程的粉丝,你可能选择使用 Lodash fp,Lodash的函数式版本(方法变更为get或者getOr)。

4.倾向于对象遍历而不是Switch语句

让我们看下面这个例子,我们想根据 color 打印出水果:

function test(color) {
  // 使用条件语句来寻找对应颜色的水果
  switch (color) {
    case 'red':
      return ['apple', 'strawberry'];
    case 'yellow':
      return ['banana', 'pineapple'];
    case 'purple':
      return ['grape', 'plum'];
    default:
      return [];
  }
}


// test results
test(null); // []
test('yellow'); // ['banana', 'pineapple']

上面的代码看起来没有错误,但是我找到了一些累赘。用对象遍历实现相同的结果,语法看起来更简洁:

const fruitColor = {
  red: ['apple', 'strawberry'],
  yellow: ['banana', 'pineapple'],
  purple: ['grape', 'plum']
};


function test(color) {
  return fruitColor[color] || [];
}

或者你也可以使用 Map实现相同的结果:

  const fruitColor = new Map()
    .set('red', ['apple', 'strawberry'])
    .set('yellow', ['banana', 'pineapple'])
    .set('purple', ['grape', 'plum']);


function test(color) {
  return fruitColor.get(color) || [];
}

Map是一种在 ES2015 规范之后实现的对象类型,允许你存储 key 和 value 的值。

但我们是否应当禁止switch语句的使用呢?答案是不要限制你自己。从个人来说,我会尽可能的使用对象遍历,但我并不严格遵守它,而是使用对当前的场景更有意义的方式。

Todd Motto有一篇关于 switch 语句对比对象遍历的更深入的文章,你可以在这个地方阅读

TL;DR; 重构语法

在上面的例子,我们能够用Array.filter 重构我们的代码,实现相同的效果。

 const fruits = [
    { name: 'apple', color: 'red' }, 
    { name: 'strawberry', color: 'red' }, 
    { name: 'banana', color: 'yellow' }, 
    { name: 'pineapple', color: 'yellow' }, 
    { name: 'grape', color: 'purple' }, 
    { name: 'plum', color: 'purple' }
];


function test(color) {
  return fruits.filter(f => f.color == color);
}

有着不止一种方法能够实现相同的结果,我们以上展示了 4 种。

5.对 所有/部分 判断使用Array.every & Array.some

这最后一个建议更多是关于利用 JavaScript Array 的内置方法来减少代码行数。看下面的代码,我们想要检查是否所有水果都是红色:

const fruits = [
    { name: 'apple', color: 'red' },
    { name: 'banana', color: 'yellow' },
    { name: 'grape', color: 'purple' }
  ];


function test() {
  let isAllRed = true;


  // 条件:所有水果都是红色
  for (let f of fruits) {
    if (!isAllRed) break;
    isAllRed = (f.color == 'red');
  }


  console.log(isAllRed); // false
}

代码那么长!我们可以通过 Array.every减少代码行数:

const fruits = [
    { name: 'apple', color: 'red' },
    { name: 'banana', color: 'yellow' },
    { name: 'grape', color: 'purple' }
  ];


function test() {
  const isAllRed = fruits.every(f => f.color == 'red');


  console.log(isAllRed); // false
}

现在更简洁了,不是吗?相同的方式,如果我们想测试是否存在红色的水果,我们可以使用Array.some 一行代码实现。

const fruits = [
    { name: 'apple', color: 'red' },
    { name: 'banana', color: 'yellow' },
    { name: 'grape', color: 'purple' }
];


function test() {
  // 条件:任何一个水果是红色
  const isAnyRed = fruits.some(f => f.color == 'red');


  console.log(isAnyRed); // true
}

6.总结

让我们一起生产更多可读性高的代码。我希望你能从这篇文章学到东西。

以上就是W3Cschool编程狮关于写好JavaScript条件语句的5条守则的相关介绍了,希望对大家有所帮助。
Python少有人走过的坑

thbcm阅读(305)

文章来源于公众号:Python技术, 作者派森酱

毫无疑问,print函数是我们日常最常用的函数,无论是格式化输出还是打印中间变量进行调试,几乎没有print接不了的活儿。

但是上一次阿酱就差点被print给坑了。

坑从何来

最初是想要为自己的一个命令行小工具增加一个进度显示功能,于是用了threading模块来实现多线程,一个线程用于执行实际的逻辑,另一个线程用于打印当前进度。

根据我们多年使用命令行的经验,一般打印进度都是在行内打印,而 Pythonprint则会默认在结尾打印一个换行符,这就十分不美了。

不过好在,print也提供了接口来改变打印的末尾字符,通过指定printend参数,即可改变print的打印结果。

所以我就哼哧哼哧地开干了,把打印进度的print("#")调用改为print("#", end="")

类似这样:

import time
import threading


def print_sharp():
    while True:
        time.sleep(0.5)
        print("#", end="")


t1 = threading.Thread(target=print_sharp)
t1.setDaemon(True)
t1.start()


time.sleep(5)

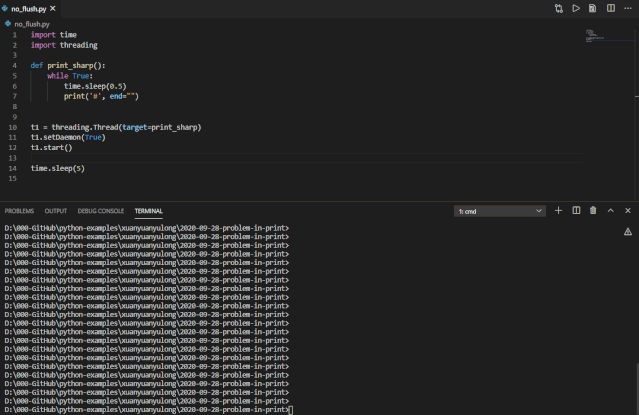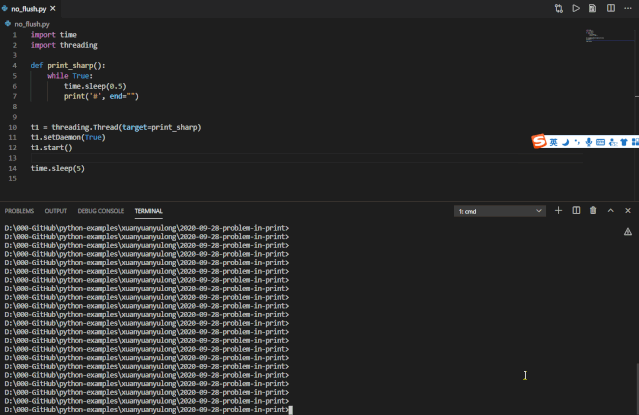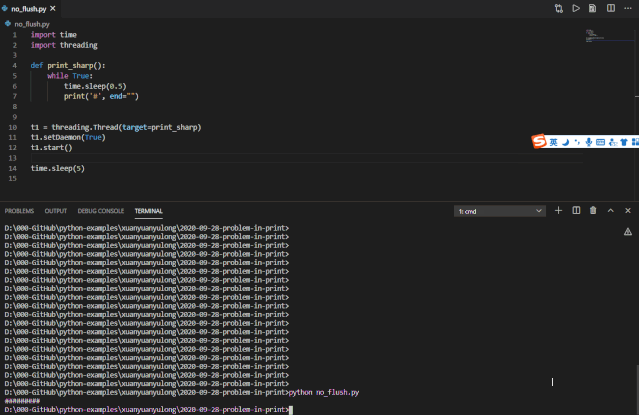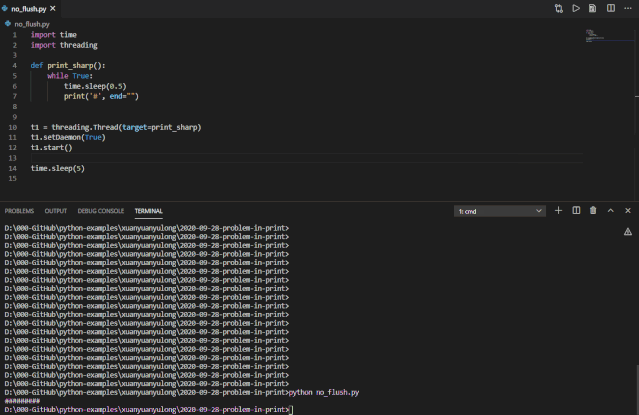
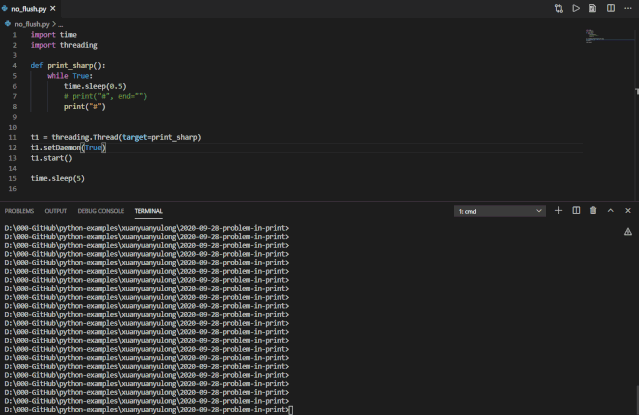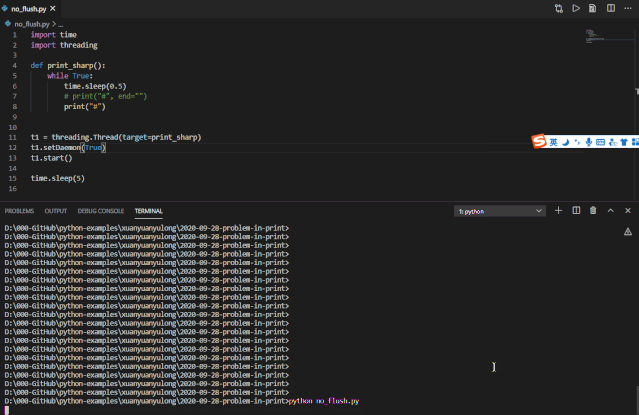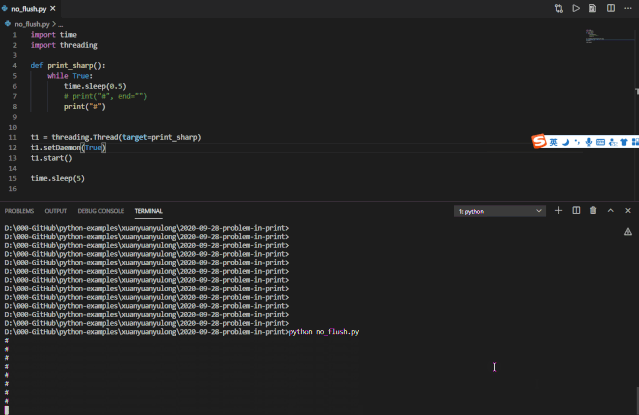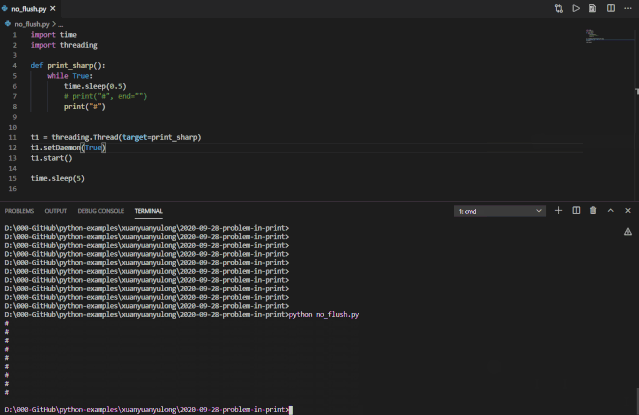
哪成想,这么一改却出了大问题:进度没法实时打印了。

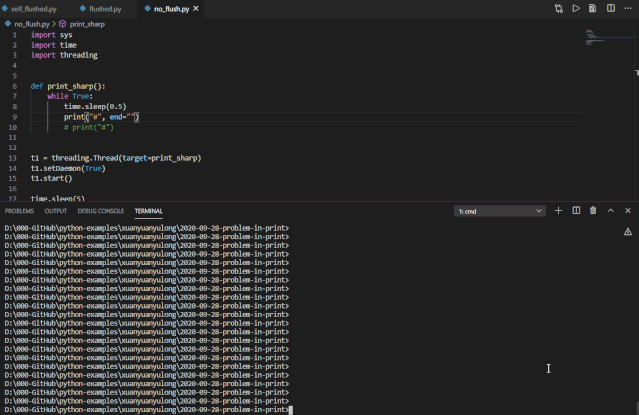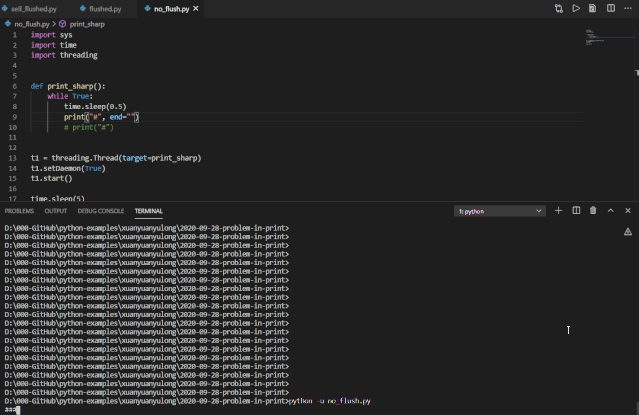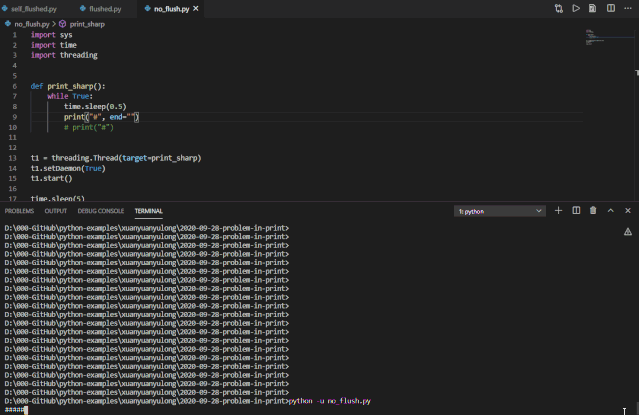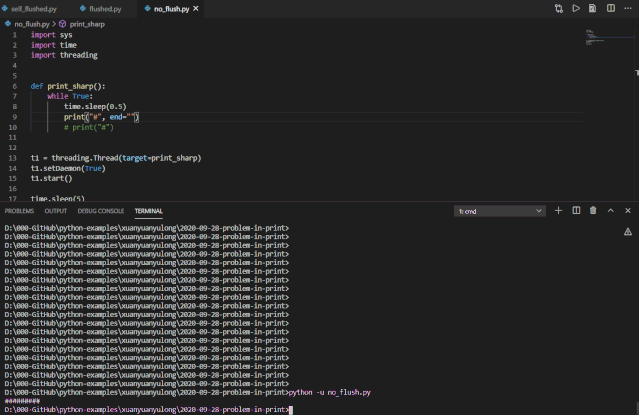
也就是说,本来应该在程序执行期间,挨个打印出来的#号不再是听话的、可爱的#号了,而是在整个程序执行完成之后一次性输出到控制台中。

它长大了,也变丑了

那我要你有何用?

啥问题呢?

一开始阿酱以为是多线程出了问题,傻乎乎地到处找资料来“佐证”自己的各种猜测——事后想来实在太傻了,以至于现在说起还是会哈哈哈

这件事给我们的教训就是:千万不要自以为是,而应踏踏实实地解决问题,虚心对待每个细节

实际上,之所以我们看不到实时的输出,就是因为我们改变了print的结尾字符。

为了尽量减少I/O操作, Python 存在一个这样的机制:尽量将输出字符缓存起来,当遇到字符串结束、换行符或强制刷新缓冲区时,才会一次性将缓冲区的内容输出到相应的流中。

——而我们改掉的地方,就是把print默认的换行符去掉了,所以原本每一个print都会触发一次缓冲区刷新,变成了现在一直触发不了缓冲区刷新,直到程序结束触发一次。

好嘛,知道了啥问题,我们又吭哧吭哧找资料,听说sys.stdout.flush可以强制触发标准输出缓冲区的刷新,于是在print后面,紧跟着又加上了sys.stdout.flush()

诶?还真好了?

这些可都是知识点,快记下来记下来,要考的

让我们查看print的官方文档,其原型为:

print(*objects, sep=' ', end='\n', file=sys.stdout, flush=False)

根据其下的描述, Pythonprint的输出是否进行缓冲,取决于两个参数:fileflush

file的类型有的需要缓冲,比如sys.stdout;而有的则不需要缓冲,比如sys.stderr

对于flush参数,当其值为False(默认)时,是否缓冲依赖file;而当其值为True时,则会强制刷新缓冲区。

我们把示例调用中的print调用修改一下:

import sys
import time
import threading


def print_sharp():
    while True:
        time.sleep(0.5)
        print("#", end="", flush=True)


t1 = threading.Thread(target=print_sharp)
t1.setDaemon(True)
t1.start()


time.sleep(5)

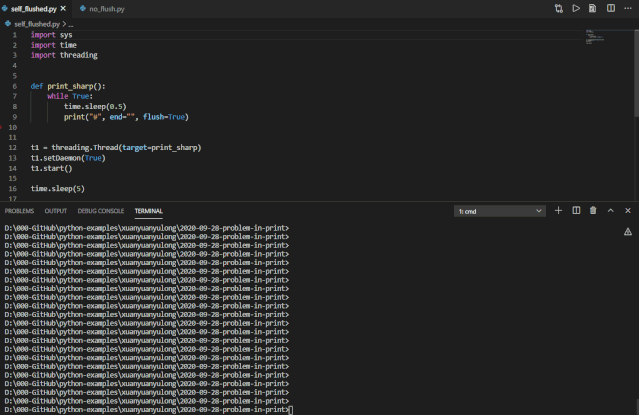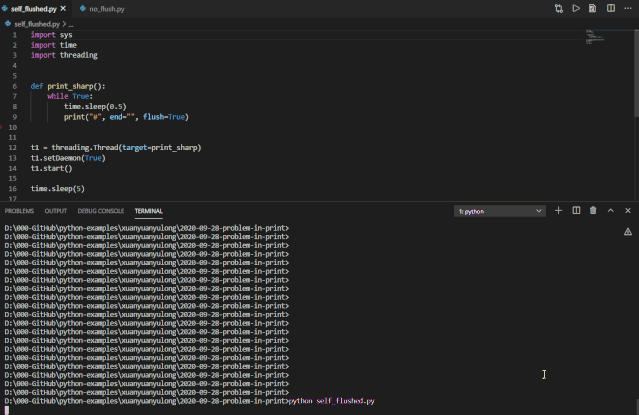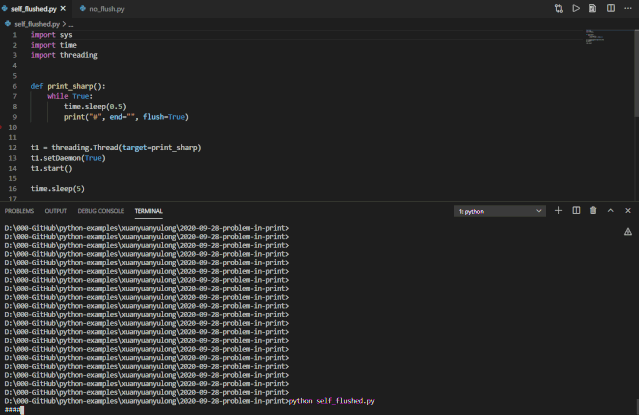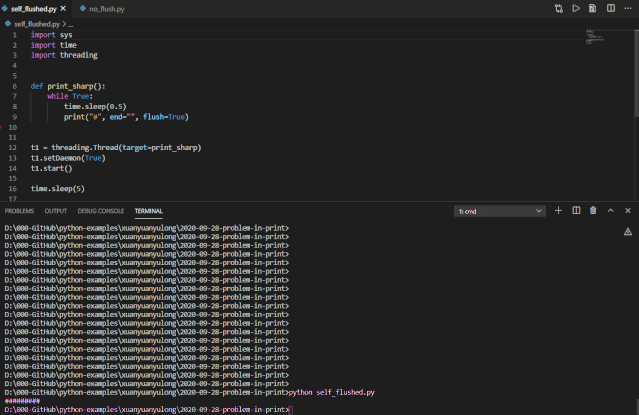
同样可以实现进度的实时打印。

此外,还有一种方法,在调用程序时增加一个-u选项,也可以实现缓冲区的实时刷新:

$ python -u no_flush.py

当然这种方法就不太推荐了,毕竟不能对程序的使用者作任何预设。

总结

本文是阿酱的一次踩坑实录,记录了 Python 中一个很少有人会遇到的奇葩问题。

总的来说,要想成为一个真正的Python程序员,只是单纯掌握基本语法和一些奇技淫巧是远远不够的,还是需要对Python本身有一定的了解。

毕竟,剑客如果不熟悉自己的剑,又该如何行走江湖呢?

以上就是W3Cschool编程狮关于Python少有人走过的坑的相关介绍了,希望对大家有所帮助。
Redis 实例对比工具之 Redis-full-check

thbcm阅读(305)

文章来源于公众号:Java极客技术 作者:鸭血粉丝

Hello 大家好,我是鸭血粉丝,前面一篇文章给大家介绍了 SpringBoot 项目是如何从单机切换接入集群的,没看过的小伙伴可以去看一下 SpringBoot 项目接入 Redis 集群 。这篇文章给大家介绍一个 Redis 工具 redis-full-check,主要是用来校验迁移数据过后的准确性,下面我们来看一下。

安装

Redis-full-check 是阿里开源的一个工具,GitHub 地址 https://github.com/alibaba/RedisFullCheck,安装前我们需要找一台 Linux 机器,并且 GLIBC的版本需要高于 2.14,不然使用的时候会提示 /lib64/libc.so.6: version GLIBC_2.14 not found 。下载我们有两种方式,第一种是在本地直接下载,然后上传到服务器上面;另一个是直接在服务器上面执行wget https://github.com/alibaba/RedisFullCheck/releases/download/release-v1.4.8-20200212/redis-full-check-1.4.8.tar.gz进行下载。下载完成过后解压tar xzvf redis-full-check-1.4.8.tar.gz。具体的过程我们如下进行:

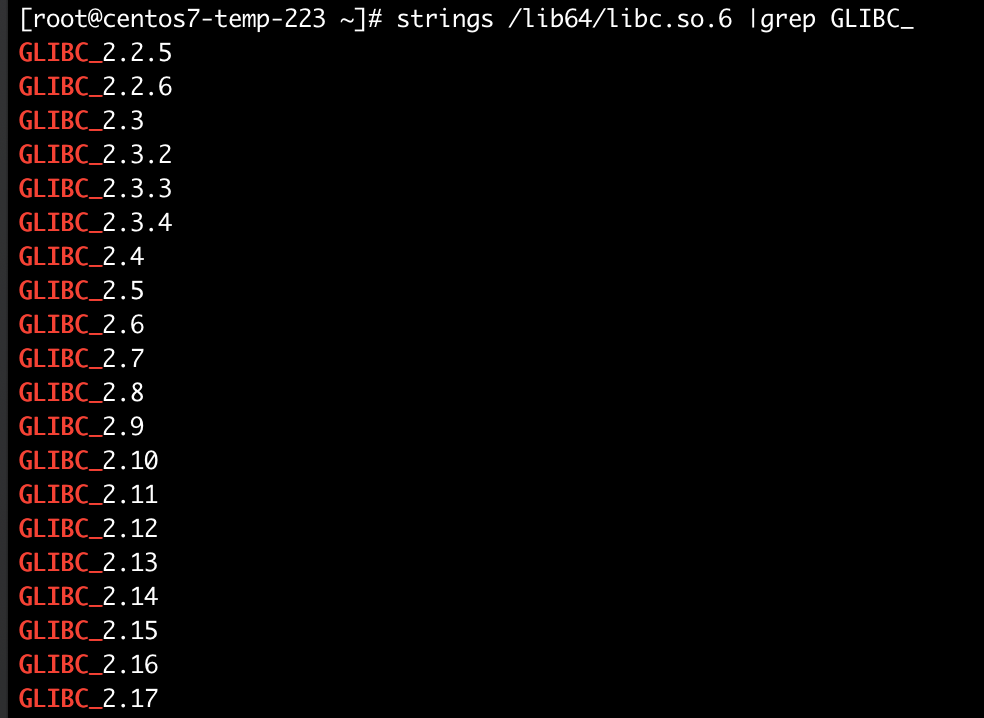
  1. 检查当前服务器的 GLIBC 版本,执行命令strings /lib64/libc.so.6 |grep GLIBC_,如下图,如果出现高于 2.14 的即可,如果没有可以考虑换一台服务器或者自己更新,但是更新有风险请谨慎,具体的更新方法自行百度;

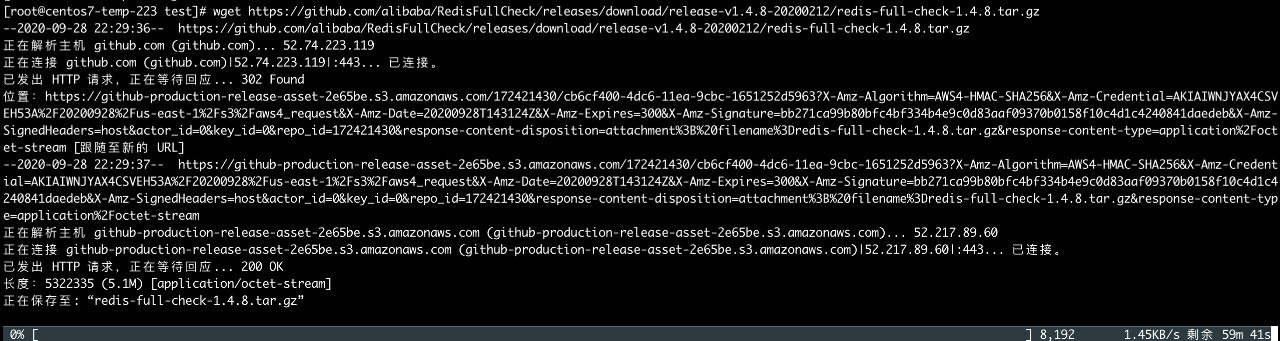
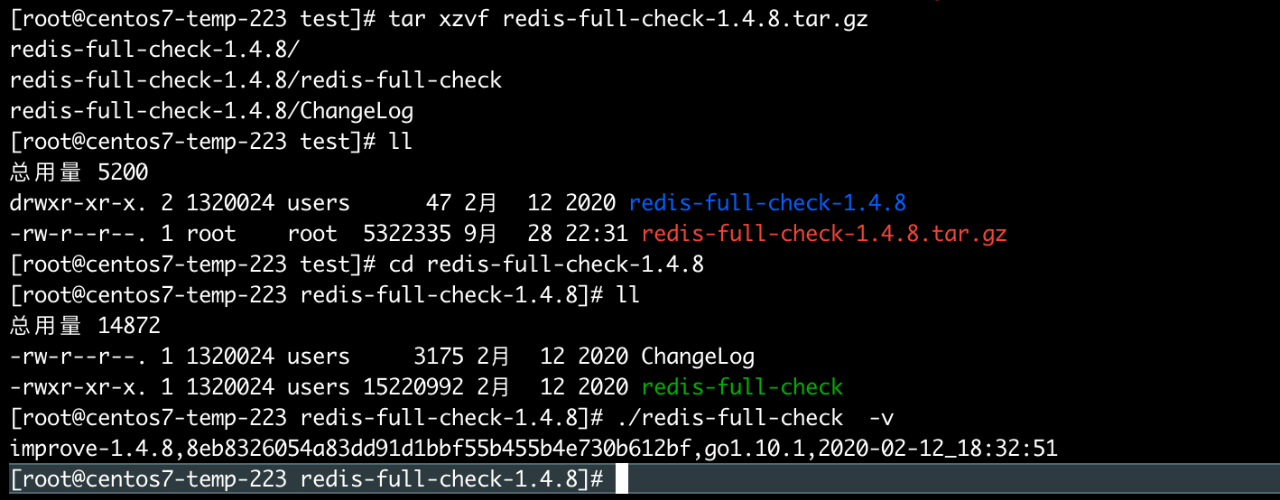
  1. 下载压缩包,执行:wget https://github.com/alibaba/RedisFullCheck/releases/download/release-v1.4.8-20200212/redis-full-check-1.4.8.tar.gz 下载完成后解压。阿粉这里已经下过了, 就不重复下载了,解压后进入目录,输入./redis-full-check -v 如果能正常看到版本号就说明下载安装成功了。

使用

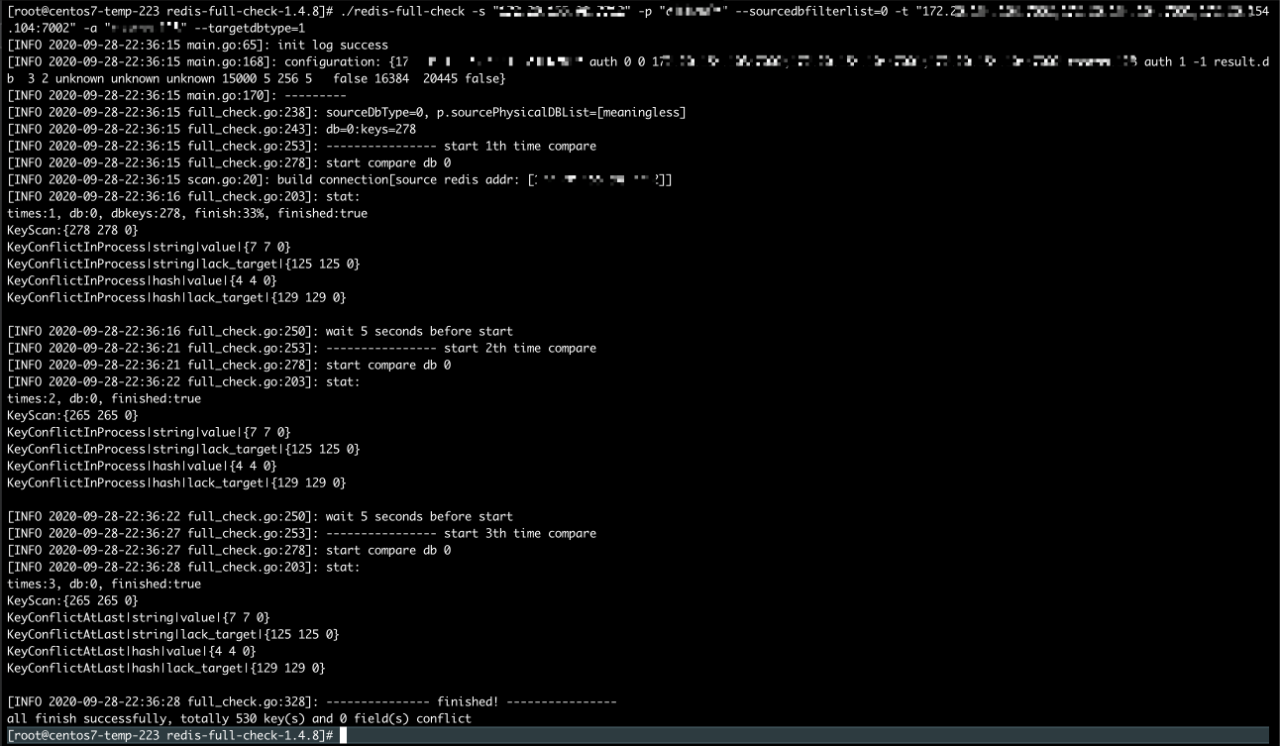
在使用这个工具之前,你需要的是两台不同的 Redis 实例,阿粉这边因为是从单机切换到集群,所以已经有了。下面就有单机和集群给大家演示。我们执行如下命令:./redis-full-check -s "172.20.xxx.xxx:6379" -p "sourcePassword" --sourcedbfilterlist=0 -t "172.20.xxx.xxx:6379;172.20.yyy.yyy:6379" -a "targetPassword" --targetdbtype=1

说明:

  1. -s: 表示源 Redis 实例
  2. p:源 Redis 密码
  3. –sourcedbfilterlist:匹配指定的 db 库,单集 Redis 是可以设置特定 db 库的,集群环境不行,根据自己的情况决定是否采用;
  4. -t:目标 Redis,阿粉这边是集群所以会有多个节点,每个节点用分号隔开,另外注意文档上说这里必须填写所有的 master 节点或者所有的 slave 节点,不能混合填写。阿粉这里填的都是 master 节点是成功,但是全部 slave 好像没成功,大家可以自己试试。
  5. -a:表示目标 Redis 的密码
  6. –targetdbtype=1:目标 Redis 环境的类型,0:db(standalone单节点、主从),1: cluster(集群版),2: 阿里云

详细的参数如下:

 -s, --source=SOURCE               源redis库地址(ip:port),如果是集群版,那么需要以分号(;)分割不同的db,只需要配置主或者从的其中之一。例如:10.1.1.1:1000;10.2.2.2:2000;10.3.3.3:3000。
  -p, --sourcepassword=Password     源redis库密码
      --sourceauthtype=AUTH-TYPE    源库管理权限,开源reids下此参数无用。
      --sourcedbtype=               源库的类别,0:db(standalone单节点、主从),1: cluster(集群版),2: 阿里云
      --sourcedbfilterlist=         源库需要抓取的逻辑db白名单,以分号(;)分割,例如:0;5;15表示db0,db5和db15都会被抓取
  -t, --target=TARGET               目的redis库地址(ip:port)
  -a, --targetpassword=Password     目的redis库密码
      --targetauthtype=AUTH-TYPE    目的库管理权限,开源reids下此参数无用。
      --targetdbtype=               参考sourcedbtype
      --targetdbfilterlist=         参考sourcedbfilterlist
  -d, --db=Sqlite3-DB-FILE          对于差异的key存储的sqlite3 db的位置,默认result.db
      --comparetimes=COUNT          比较轮数
  -m, --comparemode=                比较模式,1表示全量比较,2表示只对比value的长度,3只对比key是否存在,4全量比较的情况下,忽略大key的比较
      --id=                         用于打metric
      --jobid=                      用于打metric
      --taskid=                     用于打metric
  -q, --qps=                        qps限速阈值
      --interval=Second             每轮之间的时间间隔
      --batchcount=COUNT            批量聚合的数量
      --parallel=COUNT              比较的并发协程数,默认5
      --log=FILE                    log文件
      --result=FILE                 不一致结果记录到result文件中,格式:'db    diff-type    key    field'
      --metric=FILE                 metric文件
      --bigkeythreshold=COUNT       大key拆分的阈值,用于comparemode=4
  -f, --filterlist=FILTER           需要比较的key列表,以分号(;)分割。例如:"abc*|efg|m*"表示对比'abc', 'abc1', 'efg', 'm', 'mxyz',不对比'efgh', 'p'。
  -v, --version

查看结果

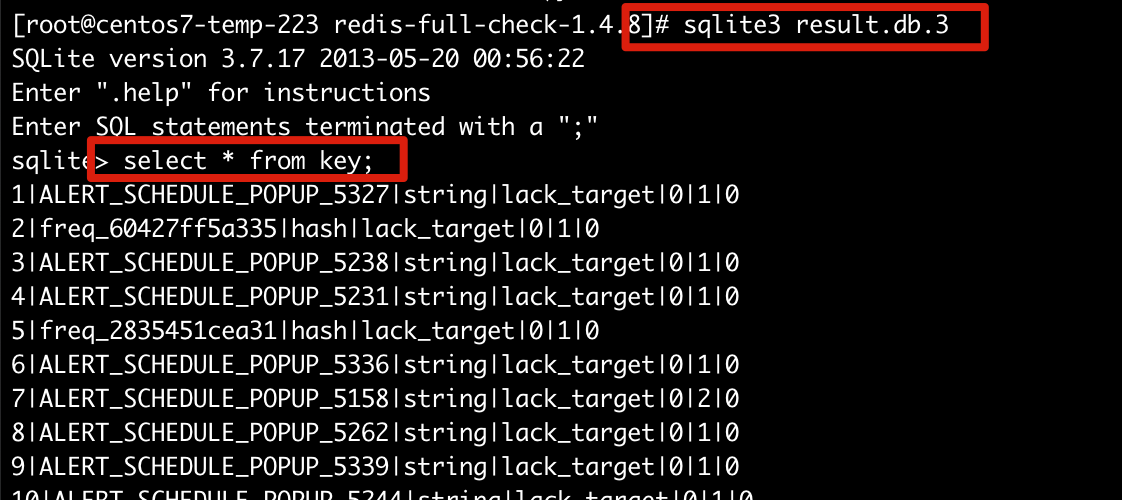
执行完上面的命令过后在当前目录下会生成三个文件,分别是result.db.1,result.db.2,result.db.3。我们可以通过 sqlite3 工具进行查询,如下所示:

通过sqlite3 result.db.3 命令进入终端,然后从 key 表中查询我们需要的数据。sqlite3 工具是一个类似 MySQL 的数据库,大家可以自己研究下如何使用,后面有机会阿粉再跟大家分享。

从上面的图中可以发现,这个结果看起来很难受,阿粉再教大家几招,让看起来爽一点!进入终端后我们依次输入下面图中命令

  1. .header on 打开表头,id 只是序号,key 表示源 Redis 中的 key,type 表示类型,db 表示 key 所在的源 Redis 的 db 库,source_len,和 target_len 分别表示在源 Redis 和目标 Redis 的中 value 的长度。我们可以通过长度来快速查看不同的数据。
  2. .mode column 设置输出模式
  3. .widht int int... 设置每列显示的长度,更美观
  4. .quit 退出终端

通过这个输出结果我们可以明显的看出哪些数据是不一致的,从而对比两个 Redis 实例的数据,需要注意的是 Redis-full-check 对比的是源实例是否是目标实例的子集

总结

今天阿粉给大家介绍了一个 Redis 实例数据对比的工具,能真正在生产上使用的一个阿里开源的很优秀的工具,希望对大家有帮助!具体的更多使用细节,大家可以自己研究研究,一个好的工具值得好好深入研究。

以上就是W3Cschool编程狮关于Redis 实例对比工具之 Redis-full-check的相关介绍了,希望对大家有所帮助。
如何优化尾调用

thbcm阅读(324)

文章来源于公众号:前端UpUp ,作者:TianTianUp

前言

经常看到关于尾递归这三个词,递归很多时候,都离不开我们,废话不多说,这次我们梳理一遍关于递归那些事。

在这里关于递归,这里就不赘述了,有兴趣的可以去查一查资料。

需要了解如何优化尾递归的话,我们需要从最开始讲起。

  • 什么是尾调用
  • 什么是尾递归
  • 如何优化尾递归

尾调用

从字面理解,自然而言就是在函数的尾部返回一个函数的调用,通常来说,指的是函数执行的最后一步。

举个例子

const fn = () => f1() || f2()
// 这里的话, f2函数有可能是尾调用,f1不可能是尾调用

为什么f1函数不是呢,我们看这个函数的等价形式

const fn = function () {
    const flag = f1()
    if(flag) {
        return flag
    } else {
        return f2()
    }
}

似乎写到这里,根据尾调用定义,我们就明白了,只有f2函数是在尾部调用。

说到这里,为什么要说尾调用呢?我们事先想一想传统的递归,典型的就是首先执行递归调用,然后根据这个递归的返回值并结算结果,那么传统的递归缺点有哪些呢

  • 效率低,占内存。
  • 如果递归链过长,可能会stack overflow

那么我们是不是可以做优化呢,这就可以涉及上面提到的尾调用,它的原理是啥呢

按照阮一峰老师在es6的函数扩展中的解释就是:函数调用会在内存形成一个“调用记录”,又称“调用帧”(call frame),保存调用位置和内部变量等信息。如果在函数A的内部调用函数B,那么在A的调用帧上方,还会形成一个B的调用帧。等到B运行结束,将结果返回到AB的调用帧才会消失。如果函数B内部还调用函数C,那就还有一个C的调用帧,以此类推。所有的调用帧,就形成一个“调用栈”(call stack)。

这里的“调用帧”和“调用栈”,说的应该就是“执行环境”和“调用栈”。因为尾调用时函数的最后一部操作,所以不再需要保留外层的调用帧,而是直接取代外层的调用帧,所以可以起到一个优化的作用。

从上述的描述中,我们视乎可以理解成

  • 它的原理类似于当编译器检测到一个函数调用是尾递归时,它会覆盖当前的活动记录而不是在函数栈中创建一个新的调用记录
  • 这样子,我们也可以理解成,不同的语言编译器或者是解释器做了尾递归优化,才让它不会爆栈。

既然是这样子的话,尾递归的优化,取决于浏览器,那具体有哪些主流浏览器支持呢

safari 和火狐,有兴趣的可以去了解一下,可以写个斐波那契数列数列验证一下。

手动优化

既然我们知道了,很多浏览器对于尾递归的优化支持的浏览器并不多,那你会好奇,当我们使用尾递归进行优化的时候,依然出现栈溢出的错误,那么我们如何解决呢?

我在网上看到一个不错的方案,采用的是蹦床函数

function trampoline(f) {
  while (f && f instanceof Function) {
    f = f();
  }
  return f;
}

那么如何使用呢

我们拿最常见的斐波那契数列来说吧

function fibonacci(n) {
  if (n === 0) return 0
  if (n === 1) return 1
  return fibonacci(n - 1) + fibonacci(n - 2)
}

根据上面的式子,我们可以将其写成迭代形式,用一个变量去缓存它的值


function fibonacci (n, ac1 = 0, ac2 = 1) {
    return n

MyBatis还是JPA?终于有答案了!

thbcm阅读(305)

对于一个和数据库打交道的程序员来说,很快会面临着一个艰难的选择。到底是选择MyBatis还是JPA呢?

很多人说,技术选择,都要根据需求来,这个没错。但是,除了需求,还有很重要的一个环节,那就是队友的水平。如果你选择了一些比较高级的技术,那么就是在给整个团队埋坑。

JPA的抽象层次更高,代码写起来也更简洁,但是它一点都不简单。虽然经过了多次的培训,我呆过的几个团队,还是把它用的和屎一样。

我扔掉了JPA

我仔细想了一下,有下面几点原因,造成了JPA在很多团队根本就玩不下去。

  1. JPA适合业务模型固定的场景,适合比较稳定的需求。但是国内这种朝三暮四的需求风格,产品经理这种传话筒式的设计模式,造成了需求的泛滥和不确定。JPA在这种模式下就是渣。
  2. JPA的技术要求比较高。不要怀疑,你刚开始用起里可能觉得非常简单。但随着你的深入使用,你会发现这是一个灾难。里面的各种转换和缓存,会把人绕晕。而大多数的快餐程序员是不想要了解这些的。
  3. 很多程序员很会写SQL,所以很多SQL语句长的很胖,长的要命。业务混乱,多张表关联,我甚至见过上百张业务表关联的复杂业务。DBA无奈之下,通常都会有sql审核。JPA搞sql审核?还是弱了一点。

所以,不是JPA不好,而是它不符合国情而已。想要在公司内推行JPA,你需要给我一个稳定的产品团队、一个牛X的技术团队才行。

所以,大多数公司宁可写一堆重复的、乱七八糟的 MyBatis 代码,也不会轻易尝试JPA,这是符合逻辑的,符合事物发展规律的。

所以,我们下面的文章就是来讨论 MyBatis 的,来看一下 MyBatis 到底要怎么写才算优雅。

MyBatis为什么不好用

优秀的程序员都是很懒的。所以很多人不想设计实体的 sql。 JPA 可以直接根据 Java 的实体代码,生成 sql 的库表,这在使用 MyBatis 的人来看,是非常羡慕的。

使用MyBatis,要倒着来。需要先设计库表,然后根据库表反向生成一堆Java代码和配置文件。

这个代码生成器,就是mybatis-generator

但是,请注意。这个生成器生成的代码,有四种模式!!!这就是最让初学者难受的地方。如果你也是刚接触MyBatis,强烈推荐只关注下面第一种模式。

  • MyBatis3 这种模式就是我们常用的方式,会生成domain类、Example类、mapper映射文件等。它生成的信息比较啰嗦,内容几乎无法改动。对于项目中自己写的sql,一般都采用手写的方式再写一份,而不是改动原来的文件。
  • MyBatis3Simple 上面这种模式的简易代码生成模式,缺少一些东西,但很简洁。对MyBatis没有经验,不推荐使用它。
  • MyBatis3DynamicSql 这是通过Builder模式实现的动态SQL特性,你还需要加入额外的jar包。加上它之后,其实和JPA是有点相似的。既然如此,那为何不直接使用JPA呢?所以这个DSQL虽然是默认的生成行为,但是非常不推荐。
  • MyBatis3Kotlin 这个不废话。就是生成Kotlin版的一些配置和代码信息。

所以,下面仅仅介绍MyBatis3模式的代码生成。

要使用它,需要在pom.xml里加入它的依赖。


    org.mybatis.generator
    mybatis-generator-core
    true
    test
    1.4.0

我个人喜欢使用 Java 代码来操作代码生成这个过程,所以下面就是生成代码的代码。

public class MBGTool {
    public static void main(String[] args) throws Exception {
        List warnings = new ArrayList();
        boolean overwrite = true;
        InputStream configFile = MBGTool.class.getResourceAsStream("/generator/generatorConfig.xml");
        ConfigurationParser cp = new ConfigurationParser(warnings);
        Configuration config = cp.parseConfiguration(configFile);
        DefaultShellCallback callback = new DefaultShellCallback(overwrite);
        MyBatisGenerator myBatisGenerator = new MyBatisGenerator(config, callback, warnings);
        myBatisGenerator.generate(null);
    }
}

从代码中,我们可以看到需要配置一个generatorConfig.xml文件,用来规定怎么生成代码文件。


        <table tableName="test"/>


运行我们的MBGTool文件之后,就可以生成 MyBatis 的代码了。

怎么写代码最优雅

但是,我这里并不是要推荐你使用这种模式。因为,它生成了一大堆无用的文件。假如你的项目使用了 sonar 这样的代码质量审查工具,你会发现很多飘红的地方,还有那要命的覆盖率问题。

怎么办?

经过我多年的摸索,我现在推荐一种非常好用的写法。自从我采用了这种方式之后,就再也没有换过。

第一、不需要代码生成器了

数据表的设计,还有 domain 的书写,全部靠手工。这样我们的代码,如果有必要,还可以迁移到 JPA 上去。这种模式还能顺便学习一下 Java 里面的数据类型,是如何和 SQL 里的数据类型一一对应的。在做表设计的时候,顺便能够了解一些背后的原理。

第二、不需要写映射文件了

生成器生成的东西,确实是有一堆无用的逻辑。比如我的某个数据表,根本不需要提供查询所有和删除这种动作,它还是默认提供了。

在这种简约模式下,我们直接手写 Mapper 文件,然后只声明所需要的接口方法就可以了。

@Mapper
public interface AccountBasicMapper {
    @Insert("AccountBasicMapper/insert.sql")
    void insert(@Param("r") AccountBasic record);
}

可以看到,里面有一个 Insert 注解,我们传入了一个具体的 domain,然后,就可以在AccountBasicMapper目录下的insert.sql文件里,书写具体的 sql 语句了。

sql语句样例如下:

INSERT INTO account_basic(
    account_id,
    nick_name,
    password,
    sex,
    state,
    photo_url,
    created,
    modified,
    version
)VALUES (
    ,
    ,
    ,
    ,
    ,
    ,
    ,
    ,

    
)

那么这是什么语法呢?它又是如何知道是这样配置的呢?这就需要引入 MyBatis 的脚本语言配置功能。在这里,我们使用的freemark的模版。

不要忘了加入它的依赖。


    org.mybatis.scripting
    mybatis-freemarker
    1.2.2

然后,在yaml文件里做上相应的配置就ok了。

mybatis:
  check_config_location: false
  scripting-language-driver:
    freemarker:
      template-file:
        base-dir: mappers/
      path-provider:
        includes-package-path: false
        separate-directory-per-mapper: false

这种方式的好处和坏处

我个人是非常喜欢这种模式的。因为它有下面几个好处:

  1. 用什么写什么,代码量少,简洁优雅。
  2. SQL集中,不用分散在代码里,xml里,或者注解里。方便DBA进行SQL审核。由于没了xml的干扰,SQL反而更加简洁了。
  3. 一个DAO方法一个sql文件,模式单一可控。
  4. MyBatis的功能优势可以全部发挥,无缝集成。

当然,缺点也是显而易见的。

  1. 即使变了个参数,也要修改很多sql文件。
  2. 需要为每一个方法配一个sql文件,即使这是个很弱智的插入查询方法。

不过,我并不认为这是个问题。每一个方法配备一个sql文件,代码写起来反而更加简单了。当出现问题的时候,也不用根据逻辑进行跟踪定位到拼接后的 SQL 语句。我现在,只需要拿到对应方法的 SQL 文件,就可以改吧改吧,直接在 sql 终端里执行调试。这样,sql 优化也变的简单了。

当然,一个人一个习惯。我个人喜欢这种模式,而且在我的团队里推行这种模式,发现运行的也很好。另外,程序员为了少写重复的 sql 代码,在设计Dao接口的时候,反而更加认真了。

这可能是一个额外的收获吧。

文章来源于公众号:猿逻辑 ,作者小Q

以上就是W3Cschool编程狮关于MyBatis还是JPA?终于有答案了!的相关介绍了,希望对大家有所帮助。

前端:道阻且长,行则将至

thbcm阅读(315)

前言

上一篇的随笔,有不少的同学感慨与互动,本文就上篇的留言的一些问题以及自身的经历总结一下前端的成长路径。

初心

首先明确一点,当选择一份工作的时候:

  1. 你很喜欢这份工作
  2. 你很擅长这份工作

如果你仅仅是为了混口饭吃才做的前端,建议早点转行,因为前端虽然没有想象中的那么难,但是肯定没你想象中的那么简单

不要仅仅为了一时的红利去选择你的工作,当度过了红利上升期的时候,带来的是大量内卷跟洗牌,未必后期能达到你的期望。

如果你不喜欢这个行业的话,你会做的非常痛苦,特别是对中途转行的同学来说,一定要考虑清楚你当前的需求,你是为什么转行到前端来的,是喜欢、擅长,还是仅仅是一时的风口加别人的引导。切记不要随波逐流,保持自己的深度思考,行行出状元,未必你只能做研发。

如果有一份工作是既喜欢又擅长的话,那么恭喜,你是这个世界上为数不多很幸运的人

旅途

目标

先明确自己是因为什么而选择前端这条路

  1. 喜欢这个行业,经验略欠缺又或者是转行过来的情况
  2. 前端只是为了下一份行业做准备(测试、UI、产品等等)
  3. 你很擅长前端,且愿意在前端这条路上走的更上一层
  4. 等等…………

明白自己的初心之后,再给自己定一个目标

  • 需要 1 年、2 年或者更久能达到中级、高级、资深、专家的级别
  • 需要多长的时间能够成功的转成到下一份喜欢的行业

时间只是一个概念,定下时间,给自己一个压力,才有动力成长。

规划

定制的目标虽然不同,但都需要给自己做一份规划,不要等到迷茫到来才想着去突破。

什么时候定下目标与规划都不晚,但是越早定下来,后期的成长与修正都会越好

规划简单分成两个方面,各有侧重点,但是都需要涉及

技术

  1. 熟悉 css、html、js 基本知识
  2. 熟悉主流框架 react、vue、angluar 等
  3. 熟悉构建框架 webpack、rollup、vite 等
  4. 搭建 cli 工具,为业务输出基础技术支持能力

业务

  1. 熟悉当前业务的具体流程,分析业务代码架构,复用、拓展等
  2. 跨端业务结合当前技术,提供适配多端能力,减少业务研发成本
  3. 结合 DevOps,提高研发效能环节,缩短研发时间与成本

根据自己的实际情况,给未来的职业生涯做一个简单的规划,往哪个方向靠拢,就侧重哪块去制定。

以技术支撑业务,以业务反馈技术,相辅相成,缺一不可。

突破

讨论一下可能会遇到的瓶颈与迷茫的一些突破

一直写业务感觉没什么成长

老实说其实写业务也挺有意思的,感觉没什么成长大概率是因为以下两点:

  1. 重复的工作一直做
  2. 重复的技术一直用

如同上述的规划一样,将业务抽丝剥茧的分析一下我们可以怎么突破当前的业务瓶颈:

  1. 相同的业务,能否做到业务代码复用:搭建业务组件中台,物料库,代码模板解决重复劳动力
  2. 不同的业务,能否做到基础组件、基础方法通用:配合 ui 统一基础风格,借助第三方框架或者自建组件框架,配合基础 cli 工程开发工程模板
  3. 每个项目是 cv 工程,还是有一次又一次的融入了新的技术跟设计,去加强完善,提高效能、体验,例如:多重条件判断、数据缓存等等,从小的模块开始更新。Vue、React等新特性的引入。
  4. 有没有回顾自己做过的项目,中间出现的问题有没有总结,没有解决暂时搁置的问题有没有解决,对之前写的不好的代码、逻辑有没有重构、或者重写(没有完美的代码,只有更好代码

说起来很简单,做起来也不容易,当你出现如上感觉的时候,想想看前面几点是否已经做到位

不要将三年工作做成一年经验,温水煮青蛙最可怕,把自己极限逼迫一下,做到最好

学历到底重不重要

目前大学生本科以上高等教育的人数不超过 5%(查新闻的,说错别打我)。

学历固然重要,也许你会失去进大厂工作的机会,但是不代表你失去了与广大研发沟通交流的机会。

多看看技术博客,多关注业内新技术的趋势,多关注开源项目,自己也可以慢慢的参与开源项目中去。

不要因为学历而限制自己在这条路上面的发展,高学历代表你的基础知识很完备、更系统,所以你会在这条路上走的更加艰辛而已

建议有条件、或者是刚毕业的同学,最好还是能够提升一下学历,未来你的上限会更高点

一直在小厂怎么突破

其实跟上述的学历问题也有重叠,不要因为在小厂就放松自己的要求

能尽量的规范开发流程就尽量去做,包括代码 review、性能分析、数据埋点分析、异常捕获处理等等,根据业务的实际情况来推进。

每推进一步,你的收获不会比大厂的少。眼界放广点,不要局限于自己的一亩三分地。

大佬,我学不动了

前端框架那么多,但是看看招聘要求都是精通 js 原理,三大框架了解其中一种即可。

万变不离其宗,js 基础是前端的钥匙,框架是前端大门。

前端走过了 jQuery、Seajs、Requirejs、Backbone 到现在各种框架百花齐放的时候,哪有那么多优秀的人精通所有内容(能做到的肯定有,但肯定不是我,哈哈)。

设计模式、实现原理、算法等等上层架构理念会使你更好、更快的去理解各个框架(学会去做一个开锁匠)。

选了几个比较经典的问题,欢迎各位同学留言互动啊,哈哈

写在最后

听了无数道理,看了无数事迹(包括上面所有的内容),却依然过不好这一生。

不要仅仅限制于听与看敢想敢做才是硬道理。不要在意结果,每个人的人生轨迹都不一样,如果成功的经历能复制的话,每个人都是成功者。

别去轻易否定自己

你拥有你的天地

没人能够把你定义

快乐才是真谛

道阻且长,行则将至

下文章来源于公众号:前端小兵成长营 ,作者Cookieboty

以上就是W3Cschool编程狮关于前端:道阻且长,行则将至的相关介绍了,希望对大家有所帮助。

面试官最爱问的 11道 Redis 面试题,我替你整理好了

thbcm阅读(335)

说说Redis基本数据类型有哪些吧

  1. 字符串:redis没有直接使用C语言传统的字符串表示,而是自己实现的叫做简单动态字符串SDS的抽象类型。C语言的字符串不记录自身的长度信息,而SDS则保存了长度信息,这样将获取字符串长度的时间由O(N)降低到了O(1),同时可以避免缓冲区溢出和减少修改字符串长度时所需的内存重分配次数。
  2. 链表linkedlist:redis链表是一个双向无环链表结构,很多发布订阅、慢查询、监视器功能都是使用到了链表来实现,每个链表的节点由一个listNode结构来表示,每个节点都有指向前置节点和后置节点的指针,同时表头节点的前置和后置节点都指向NULL。
  3. 字典hashtable:用于保存键值对的抽象数据结构。redis使用hash表作为底层实现,每个字典带有两个hash表,供平时使用和rehash时使用,hash表使用链地址法来解决键冲突,被分配到同一个索引位置的多个键值对会形成一个单向链表,在对hash表进行扩容或者缩容的时候,为了服务的可用性,rehash的过程不是一次性完成的,而是渐进式的。
  4. 跳跃表skiplist:跳跃表是有序集合的底层实现之一,redis中在实现有序集合键和集群节点的内部结构中都是用到了跳跃表。redis跳跃表由zskiplist和zskiplistNode组成,zskiplist用于保存跳跃表信息(表头、表尾节点、长度等),zskiplistNode用于表示表跳跃节点,每个跳跃表的层高都是1-32的随机数,在同一个跳跃表中,多个节点可以包含相同的分值,但是每个节点的成员对象必须是唯一的,节点按照分值大小排序,如果分值相同,则按照成员对象的大小排序。
  5. 整数集合intset:用于保存整数值的集合抽象数据结构,不会出现重复元素,底层实现为数组。
  6. 压缩列表ziplist:压缩列表是为节约内存而开发的顺序性数据结构,他可以包含多个节点,每个节点可以保存一个字节数组或者整数值。

基于这些基础的数据结构,redis 封装了自己的对象系统,包含字符串对象string、列表对象list、哈希对象hash、集合对象set、有序集合对象zset,每种对象都用到了至少一种基础的数据结构。

redis 通过encoding属性设置对象的编码形式来提升灵活性和效率,基于不同的场景redis会自动做出优化。不同对象的编码如下:

  1. 字符串对象string:int整数、embstr编码的简单动态字符串、raw简单动态字符串
  1. 列表对象list:ziplist、linkedlist
  1. 哈希对象hash:ziplist、hashtable
  1. 集合对象set:intset、hashtable
  1. 有序集合对象zset:ziplist、skiplist

Redis为什么快呢?

redis 的速度非常的快,单机的 redis 就可以支撑每秒10几万的并发,相对于 mysql 来说,性能是 mysql 的几十倍。速度快的原因主要有几点:

  1. 完全基于内存操作
  2. C语言实现,优化过的数据结构,基于几种基础的数据结构,redis做了大量的优化,性能极高
  3. 使用单线程,无上下文的切换成本
  4. 基于非阻塞的IO多路复用机制

那为什么Redis6.0之后又改用多线程呢?

redis 使用多线程并非是完全摒弃单线程,redis 还是使用单线程模型来处理客户端的请求,只是使用多线程来处理数据的读写和协议解析,执行命令还是使用单线程。

这样做的目的是因为 redis 的性能瓶颈在于网络IO而非CPU,使用多线程能提升IO读写的效率,从而整体提高 redis 的性能。

知道什么是热key吗?热key问题怎么解决?

所谓热key问题就是,突然有几十万的请求去访问 redis 上的某个特定key,那么这样会造成流量过于集中,达到物理网卡上限,从而导致这台redis的服务器宕机引发雪崩。

针对热key的解决方案:

  1. 提前把热key打散到不同的服务器,降低压力
  2. 加入二级缓存,提前加载热key数据到内存中,如果 redis 宕机,走内存查询

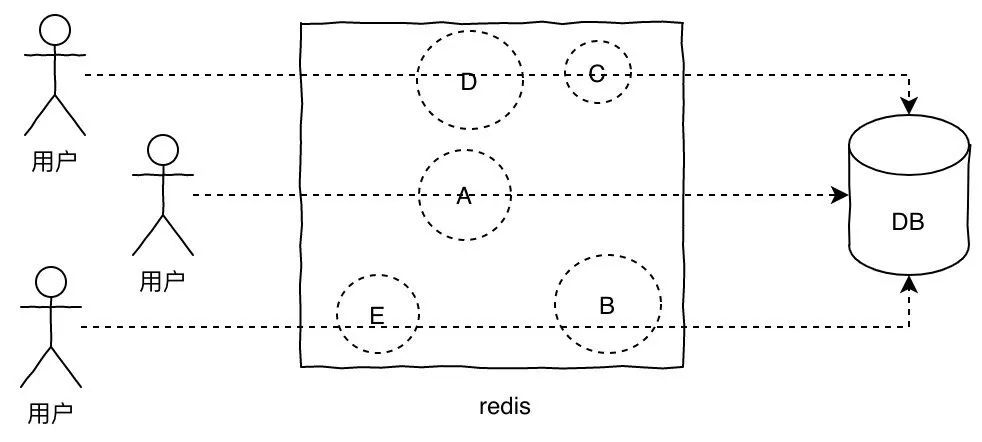
什么是缓存击穿、缓存穿透、缓存雪崩?

缓存击穿

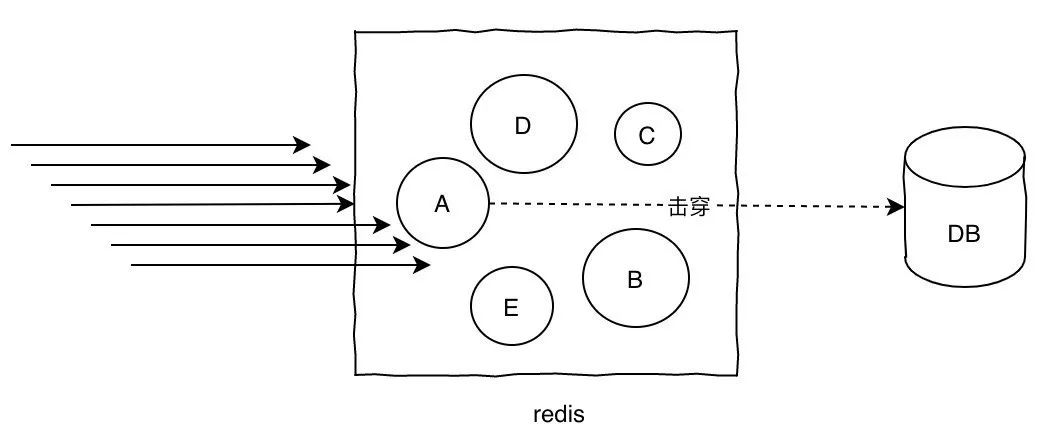
缓存击穿的概念就是单个key并发访问过高,过期时导致所有请求直接打到db上,这个和热key的问题比较类似,只是说的点在于过期导致请求全部打到DB上而已。

解决方案:

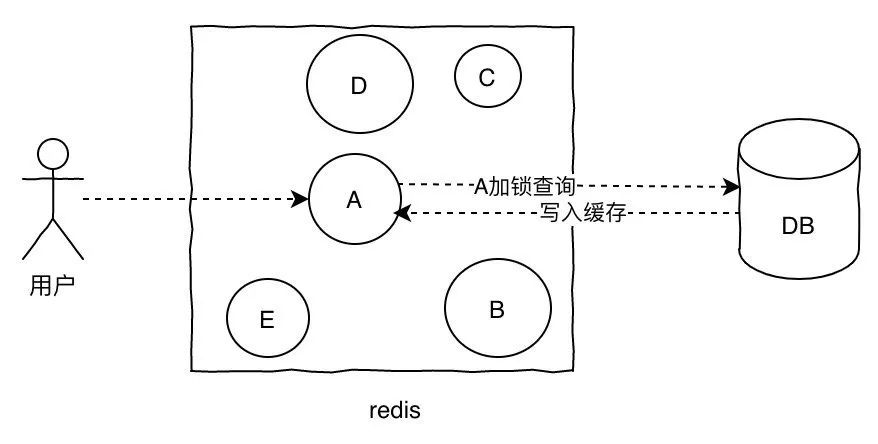
  1. 加锁更新,比如请求查询A,发现缓存中没有,对A这个key加锁,同时去数据库查询数据,写入缓存,再返回给用户,这样后面的请求就可以从缓存中拿到数据了。
  2. 将过期时间组合写在value中,通过异步的方式不断的刷新过期时间,防止此类现象。

缓存穿透

缓存穿透是指查询不存在缓存中的数据,每次请求都会打到DB,就像缓存不存在一样。

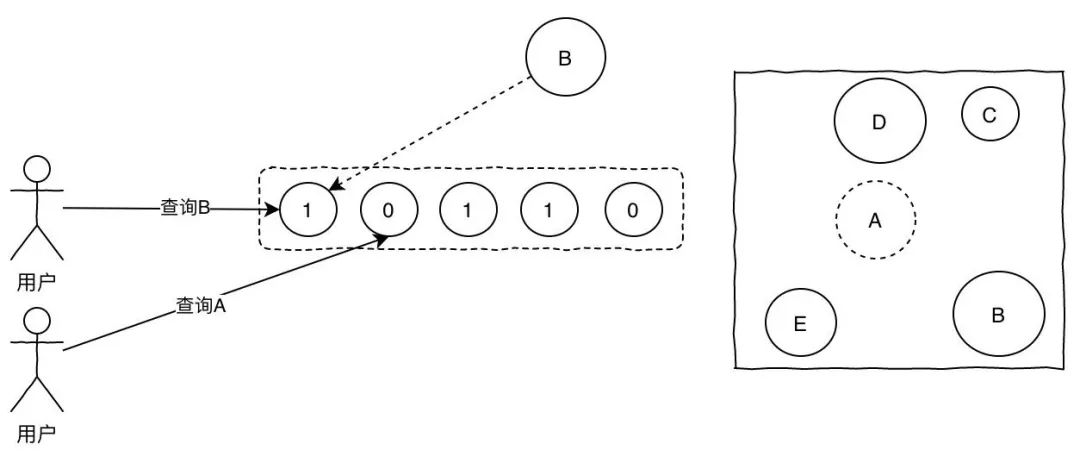
针对这个问题,加一层布隆过滤器。布隆过滤器的原理是在你存入数据的时候,会通过散列函数将它映射为一个位数组中的K个点,同时把他们置为1。

这样当用户再次来查询A,而A在布隆过滤器值为0,直接返回,就不会产生击穿请求打到DB了。

显然,使用布隆过滤器之后会有一个问题就是误判,因为它本身是一个数组,可能会有多个值落到同一个位置,那么理论上来说只要我们的数组长度够长,误判的概率就会越低,这种问题就根据实际情况来就好了。

缓存雪崩

当某一时刻发生大规模的缓存失效的情况,比如你的缓存服务宕机了,会有大量的请求进来直接打到DB上,这样可能导致整个系统的崩溃,称为雪崩。雪崩和击穿、热key的问题不太一样的是,他是指大规模的缓存都过期失效了。

针对雪崩几个解决方案:

  1. 针对不同key设置不同的过期时间,避免同时过期
  2. 限流,如果redis宕机,可以限流,避免同时刻大量请求打崩DB
  3. 二级缓存,同热key的方案。

Redis的过期策略有哪些?

redis主要有2种过期删除策略

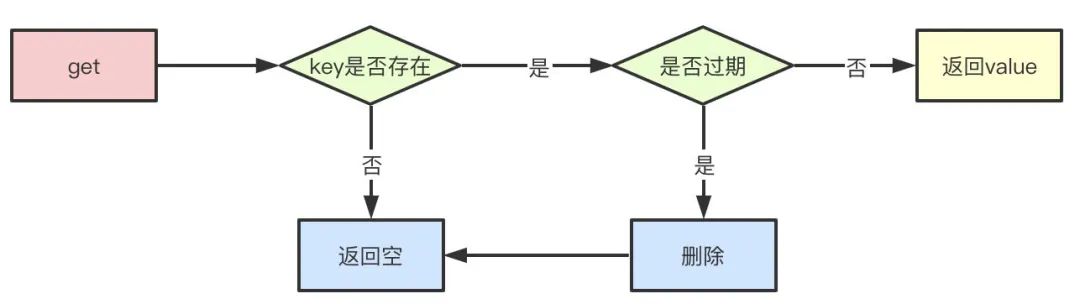
惰性删除

惰性删除指的是当我们查询key的时候才对key进行检测,如果已经达到过期时间,则删除。显然,他有一个缺点就是如果这些过期的key没有被访问,那么他就一直无法被删除,而且一直占用内存。

定期删除

定期删除指的是redis每隔一段时间对数据库做一次检查,删除里面的过期key。由于不可能对所有key去做轮询来删除,所以redis会每次随机取一些key去做检查和删除。

那么定期+惰性都没有删除过期的key怎么办?

假设redis每次定期随机查询key的时候没有删掉,这些key也没有做查询的话,就会导致这些key一直保存在redis里面无法被删除,这时候就会走到redis的内存淘汰机制。

  1. volatile-lru:从已设置过期时间的key中,移出最近最少使用的key进行淘汰
  2. volatile-ttl:从已设置过期时间的key中,移出将要过期的key
  3. volatile-random:从已设置过期时间的key中随机选择key淘汰
  4. allkeys-lru:从key中选择最近最少使用的进行淘汰
  5. allkeys-random:从key中随机选择key进行淘汰
  6. noeviction:当内存达到阈值的时候,新写入操作报错

持久化方式有哪些?有什么区别?

redis持久化方案分为RDB和AOF两种。

RDB

RDB持久化可以手动执行也可以根据配置定期执行,它的作用是将某个时间点上的数据库状态保存到RDB文件中,RDB文件是一个压缩的二进制文件,通过它可以还原某个时刻数据库的状态。由于RDB文件是保存在硬盘上的,所以即使redis崩溃或者退出,只要RDB文件存在,就可以用它来恢复还原数据库的状态。

可以通过SAVE或者BGSAVE来生成RDB文件。

SAVE命令会阻塞redis进程,直到RDB文件生成完毕,在进程阻塞期间,redis不能处理任何命令请求,这显然是不合适的。

BGSAVE则是会fork出一个子进程,然后由子进程去负责生成RDB文件,父进程还可以继续处理命令请求,不会阻塞进程。

AOF

AOF和RDB不同,AOF是通过保存redis服务器所执行的写命令来记录数据库状态的。

AOF通过追加、写入、同步三个步骤来实现持久化机制。

  1. 当AOF持久化处于激活状态,服务器执行完写命令之后,写命令将会被追加append到aof_buf缓冲区的末尾
  2. 在服务器每结束一个事件循环之前,将会调用flushAppendOnlyFile函数决定是否要将aof_buf的内容保存到AOF文件中,可以通过配置appendfsync来决定。
always ##aof_buf内容写入并同步到AOF文件
everysec ##将aof_buf中内容写入到AOF文件,如果上次同步AOF文件时间距离现在超过1秒,则再次对AOF文件进行同步
no ##将aof_buf内容写入AOF文件,但是并不对AOF文件进行同步,同步时间由操作系统决定

如果不设置,默认选项将会是everysec,因为always来说虽然最安全(只会丢失一次事件循环的写命令),但是性能较差,而everysec模式只不过会可能丢失1秒钟的数据,而no模式的效率和everysec相仿,但是会丢失上次同步AOF文件之后的所有写命令数据。

怎么实现Redis的高可用?

要想实现高可用,一台机器肯定是不够的,而redis要保证高可用,有2个可选方案。

主从架构

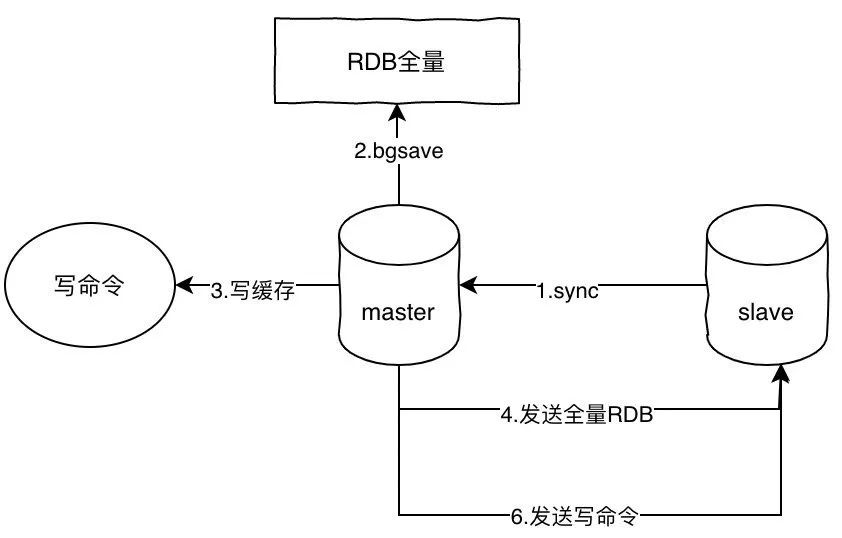
主从模式是最简单的实现高可用的方案,核心就是主从同步。主从同步的原理如下:

  1. slave发送sync命令到master
  2. master收到sync之后,执行bgsave,生成RDB全量文件
  3. master把slave的写命令记录到缓存
  4. bgsave执行完毕之后,发送RDB文件到slave,slave执行
  5. master发送缓存中的写命令到slave,slave执行

这里我写的这个命令是sync,但是在redis2.8版本之后已经使用psync来替代sync了,原因是sync命令非常消耗系统资源,而psync的效率更高。

哨兵

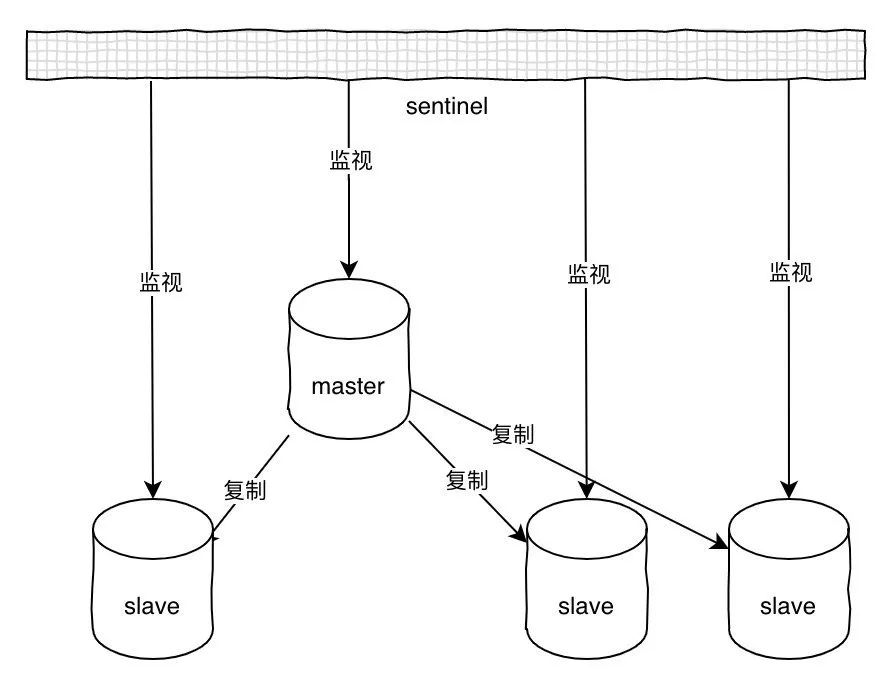
基于主从方案的缺点还是很明显的,假设master宕机,那么就不能写入数据,那么slave也就失去了作用,整个架构就不可用了,除非你手动切换,主要原因就是因为没有自动故障转移机制。而哨兵(sentinel)的功能比单纯的主从架构全面的多了,它具备自动故障转移、集群监控、消息通知等功能。

哨兵可以同时监视多个主从服务器,并且在被监视的master下线时,自动将某个slave提升为master,然后由新的master继续接收命令。整个过程如下:

  1. 初始化sentinel,将普通的redis代码替换成sentinel专用代码
  2. 初始化masters字典和服务器信息,服务器信息主要保存ip:port,并记录实例的地址和ID
  3. 创建和master的两个连接,命令连接和订阅连接,并且订阅sentinel:hello频道
  4. 每隔10秒向master发送info命令,获取master和它下面所有slave的当前信息
  5. 当发现master有新的slave之后,sentinel和新的slave同样建立两个连接,同时每个10秒发送info命令,更新master信息
  6. sentinel每隔1秒向所有服务器发送ping命令,如果某台服务器在配置的响应时间内连续返回无效回复,将会被标记为下线状态
  7. 选举出领头sentinel,领头sentinel需要半数以上的sentinel同意
  8. 领头sentinel从已下线的的master所有slave中挑选一个,将其转换为master
  9. 让所有的slave改为从新的master复制数据
  10. 将原来的master设置为新的master的从服务器,当原来master重新回复连接时,就变成了新master的从服务器

sentinel会每隔1秒向所有实例(包括主从服务器和其他sentinel)发送ping命令,并且根据回复判断是否已经下线,这种方式叫做主观下线。当判断为主观下线时,就会向其他监视的sentinel询问,如果超过半数的投票认为已经是下线状态,则会标记为客观下线状态,同时触发故障转移。

能说说redis集群的原理吗?

如果说依靠哨兵可以实现redis的高可用,如果还想在支持高并发同时容纳海量的数据,那就需要redis集群。redis集群是redis提供的分布式数据存储方案,集群通过数据分片sharding来进行数据的共享,同时提供复制和故障转移的功能。

节点

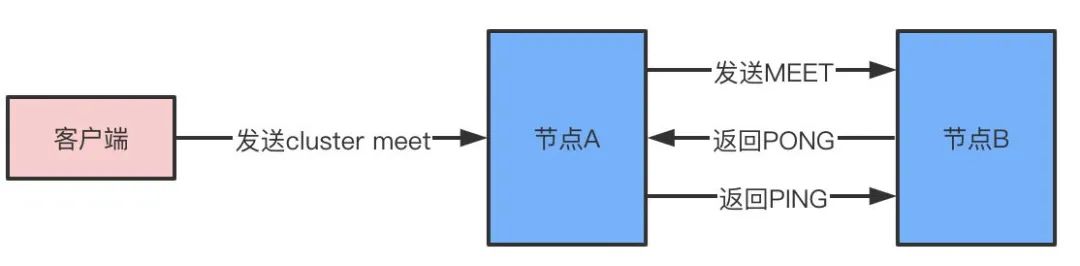
一个redis集群由多个节点node组成,而多个node之间通过cluster meet命令来进行连接,节点的握手过程:

  1. 节点A收到客户端的cluster meet命令
  2. A根据收到的IP地址和端口号,向B发送一条meet消息
  3. 节点B收到meet消息返回pong
  4. A知道B收到了meet消息,返回一条ping消息,握手成功
  5. 最后,节点A将会通过gossip协议把节点B的信息传播给集群中的其他节点,其他节点也将和B进行握手

槽slot

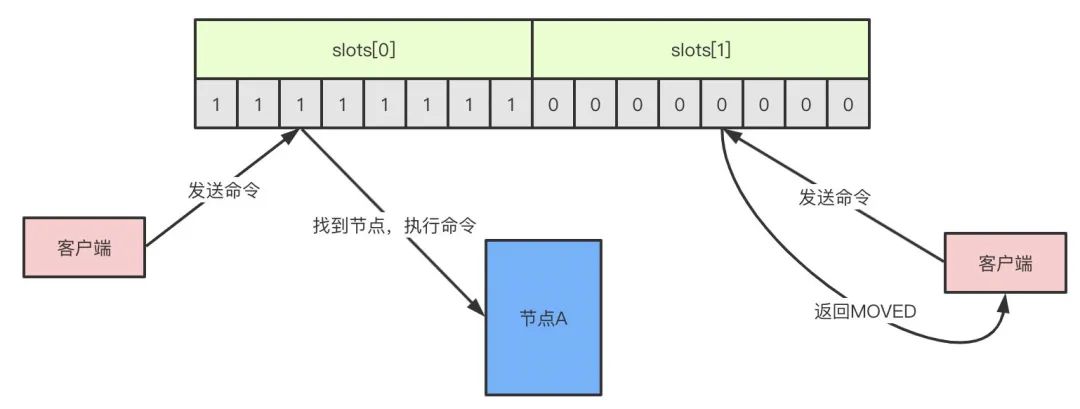
redis通过集群分片的形式来保存数据,整个集群数据库被分为16384个slot,集群中的每个节点可以处理0-16384个slot,当数据库16384个slot都有节点在处理时,集群处于上线状态,反之只要有一个slot没有得到处理都会处理下线状态。通过cluster addslots命令可以将slot指派给对应节点处理。

slot是一个位数组,数组的长度是16384/8=2048,而数组的每一位用1表示被节点处理,0表示不处理,如图所示的话表示A节点处理0-7的slot。

当客户端向节点发送命令,如果刚好找到slot属于当前节点,那么节点就执行命令,反之,则会返回一个MOVED命令到客户端指引客户端转向正确的节点。(MOVED过程是自动的)

如果增加或者移出节点,对于slot的重新分配也是非常方便的,redis提供了工具帮助实现slot的迁移,整个过程是完全在线的,不需要停止服务。

故障转移

如果节点A向节点B发送ping消息,节点B没有在规定的时间内响应pong,那么节点A会标记节点B为pfail疑似下线状态,同时把B的状态通过消息的形式发送给其他节点,如果超过半数以上的节点都标记B为pfail状态,B就会被标记为fail下线状态,此时将会发生故障转移,优先从复制数据较多的从节点选择一个成为主节点,并且接管下线节点的slot,整个过程和哨兵非常类似,都是基于Raft协议做选举。

了解Redis事务机制吗?

redis 通过MULTI、EXEC、WATCH等命令来实现事务机制,事务执行过程将一系列多个命令按照顺序一次性执行,并且在执行期间,事务不会被中断,也不会去执行客户端的其他请求,直到所有命令执行完毕。事务的执行过程如下:

  1. 服务端收到客户端请求,事务以MULTI开始
  2. 如果客户端正处于事务状态,则会把事务放入队列同时返回给客户端QUEUED,反之则直接执行这个命令
  3. 当收到客户端EXEC命令时,WATCH命令监视整个事务中的key是否有被修改,如果有则返回空回复到客户端表示失败,否则redis会遍历整个事务队列,执行队列中保存的所有命令,最后返回结果给客户端

WATCH的机制本身是一个CAS的机制,被监视的key会被保存到一个链表中,如果某个key被修改,那么REDIS_DIRTY_CAS标志将会被打开,这时服务器会拒绝执行事务。

文章来源于公众号:科技缪缪 ,作者科技缪缪

以上就是W3Cschool编程狮关于面试官最爱问的 11道 Redis 面试题,我替你整理好了的相关介绍了,希望对大家有所帮助。

适合Vue用户的React教程,走过路过千万不要错过

thbcm阅读(321)

双节旅游人如山,不如家中代码闲。 学以致用加班少,王者荣耀家中玩。

小编日常工作中使用的是 Vue ,对于 React 只是做过简单的了解,并没有做过深入学习。趁着这个双节假期,小编决定好好学一学 React ,今天这篇文章就是小编在学习 React 之后,将 ReactVue 的用法做的一个对比,通过这个对比,方便使用 Vue 的小伙伴可以快速将 Vue 中的写法转换为 React 的写法。

插槽,在React中没找到??

在使用Vue的时候,插槽是一个特别常用的功能,通过定义插槽,可以在调用组件的时候将外部的内容传入到组件内部,显示到指定的位置。在Vue中,插槽分为默认插槽,具名插槽和作用域插槽。其实不仅仅Vue,在 React 中其实也有类似插槽的功能,只是名字不叫做插槽,下面我将通过举例来说明。

默认插槽

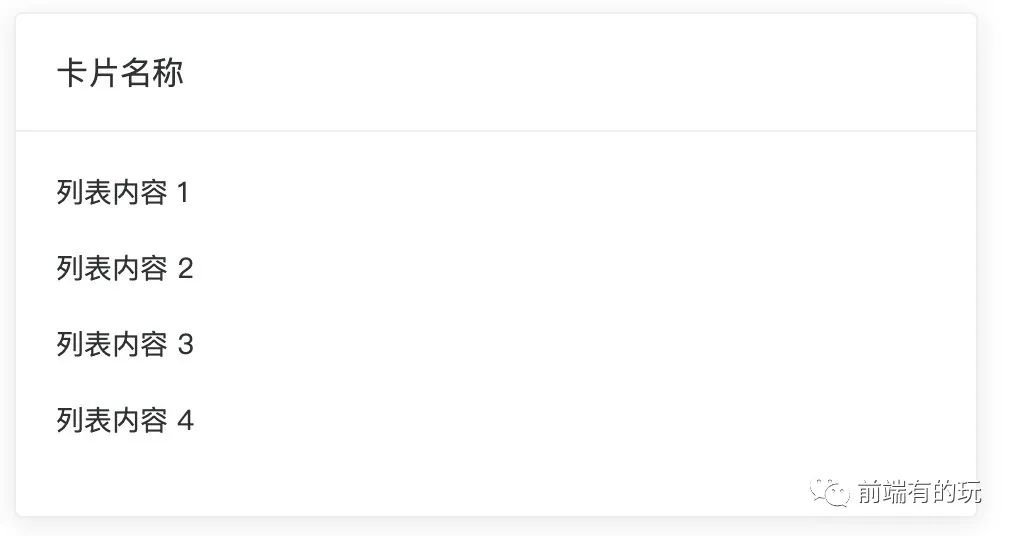
现在项目需要开发一个卡片组件,如下图所示,卡片可以指定标题,然后卡片内容可以用户自定义,这时候对于卡片内容来说,就可以使用插槽来实现,下面我们就分别使用VueReact来实现这个功能

Vue实现

  1. 首先实现一个card组件,如下代码所示

   
     <div class="card">
       <div class="card__title">
         <span>{{ title }}</span>
       </div>
       <div class="card__body">

         
       </div>
     </div>


   export default {
     props: {
       title: {
         type: String,
         default: ''
       }
     }
   }


可以看到上面我们使用了,这个就是组件的默认插槽,在使用组件的时候,传入的内容将会被放到所在位置

  1. 在外部使用定义的card组件

   
     <div>

       
         <div>我将被放在card组件的默认插槽里面</div>

       
     </div>


   import MyCard from '../components/card'
   export default {
     components: {
       MyCard
     }
   }


如上代码,就可以使用组件的默认插槽将外部的内容应用到组件里面指定的位置了。

React实现

虽然在React里面没有插槽的概念,但是React里面也可以通过props.children拿到组件标签内部的子元素的,就像上面代码`标签内的子元素,通过这个我们也可以实现类似Vue`默认插槽的功能,一起看看代码。

  1. 使用React定义Card组件
   import React from 'react'

   
   export interface CardProps {
     title: string,
     children: React.ReactNode
   }

   
   export default function(props: CardProps) {

   
     return (
       <div className="card">
         <div className="card__title">
           <span>{props.title}</span>
         </div>
         <div className="card__body">
           {/**每个组件都可以获取到 props.children。它包含组件的开始标签和结束标签之间的内容 */}
           {props.children}
         </div>
       </div>
     );
   }

   import React from 'react'
   import Card from './components/Card'

   
   export default function () {

   
     return (
       <div>

         
           <div>我将被放在card组件的body区域内容</div>

         
       </div>
     );
   }

    1. 在外部使用Card组件

具名插槽

继续以上面的Card组件为例,假如我们现在需求发生了变化,组件的title也可以使用插槽,这时候对于Vue就可以使用具名插槽了,而React也是有办法实现的哦。

Vue实现

Vue的具名插槽主要解决的是一个组件需要多个插槽的场景,其实现是为`添加name`属性来实现了。

  1. 我们就上面的需求对card组件进行修改


  <div class="card">
    <div class="card__title">

      
      <span v-if="title">{{ title }}</span>

      
    </div>
    <div class="card__body">


    </div>
  </div>


export default {
  props: {
    title: {
      type: String,
      default: ''
    }
  }
}

  1. card组件修改完之后,我们再去调整一下使用card组件的地方


  <div>


        <span>这里是标题</span>

      
      <div>我将被放在card组件的默认插槽里面</div>

    
  </div>


import MyCard from '../components/card'
export default {
  components: {
    MyCard
  }
}

React实现

React连插槽都没有, 更别提具名插槽了,但是没有不代表不能模拟出来。对于Reactprops,我们不仅仅可以传入普通的属性,还可以传入一个函数,这时候我们就可以在传入的这个函数里面返回JSX,从而就实现了具名插槽的功能。

  1. 对原有的Card组件进行修改
import React from 'react'


export interface CardProps {
  title?: string,
  // 加入了一个renderTitle属性,属性类型是Function
  renderTitle?: Function,
  children: React.ReactNode
}


export default function(props: CardProps) {


  const {title, renderTitle} = props
  // 如果指定了renderTtile,则使用renderTitle,否则使用默认的title
  let titleEl = renderTitle ? renderTitle() : <span>{title}</span>


  return (
    <div className="card">
      <div className="card__title">{titleEl}</div>
      <div className="card__body">
        {/**每个组件都可以获取到 props.children。它包含组件的开始标签和结束标签之间的内容 */}
        {props.children}
      </div>
    </div>
  );
}

  1. 这时候就可以在外部自定义title
import React from 'react'
import Card from './components/Card'


export default function () {
  return (
    <div>
       {
          return <span>我是自定义的标题</span>
        }
      }>
        <div>我将被放在card组件的body区域内容</div>

      
    </div>
  );
}

作用域插槽

有时让插槽内容能够访问子组件中才有的数据是很有用的,这个就是Vue提供作用域插槽的原因。我们继续使用上面的Card组件为例,现在我基于上面的卡片组件开发了一个人员信息卡片组件,用户直接使用人员信息卡片组件就可以将人员信息显示到界面中,但是在某些业务模块需要自定义人员信息显示方式,这时候我们就需要使用到作用域插槽了。

Vue实现

  1. 实现用户信息卡片组件,里面使用了作用域插槽


    <div class="content">


        <span>姓名: {{ userInfo.name }}</span>
        <span>性别: {{ userInfo.sex }}</span>
        <span>年龄: {{ userInfo.age }}</span>

      
    </div>


import CustomCard from '../card'
export default {
  components: {
    CustomCard
  },
  data() {
    return {
      userInfo: {
        name: '张三',
        sex: '男',
        age: 25
      }
    }
  }
}

  1. 在外部使用人员信息组件


  <div>


        <div class="custom-user">
          <ul>
            <li>姓名: {{ userInfo.name }}</li>
            <li>年龄: {{ userInfo.age }}</li>
          </ul>
        </div>


  </div>


import UserCard from '../components/user-card'
export default {
  components: {
    UserCard
  }
}

React实现

在具名插槽那一小节我们通过给组件传入了一个函数,然后在函数中返回JSX的方式来模拟了具名插槽,那么对于作用域插槽,我们依然可以使用函数的这种方式,而作用域插槽传递的参数我们可以使用给函数传参的方式来替代

  1. 实现人员信息卡片组件
   import React, { useState } from 'react'

   
   import Card from './Card'

   
   interface UserCardProps {
     renderUserInfo?: Function
   }

   
   export interface UserInfo {
     name: string;
     age: number;
     sex: string;
   }

   
   export default function(props: UserCardProps) {
     const [userInfo] = useState({
       name: "张三",
       age: 25,
       sex: "男",
     });

   
     const content = props.renderUserInfo ? (
       props.renderUserInfo(userInfo)
     ) : (
       <div>
         <span>姓名: {userInfo.name}</span>
         <span>年龄: {userInfo.age}</span>
         <span>性别: {userInfo.sex}</span>
       </div>
     );

   
     return 
       {content}

     
   }

  1. 在外部使用人员信息卡片组件
   import React from 'react'
   import UserCard, { UserInfo } from "./components/UserCard";

   
   export default function () {

   
     return (
       <div>
          {
             return (
               <ul>
                 <li>姓名: {userInfo.name}</li>
               </ul>
             );
           }}
         >
       </div>
     );
   }

Context, React中的provide/inject

通常我们在项目开发中,对于多组件之间的状态管理,在Vue中会使用到Vuex,在React中会使用到redux或者Mobx,但对于小项目来说,使用这些状态管理库就显得比较大材小用了,那么在不使用这些库的情况下,如何去完成数据管理呢?比如面试最常问的祖孙组件通信。在Vue中我们可以使用provide/inject,在React中我们可以使用Context

假设有这样一个场景,系统现在需要提供一个换肤功能,用户可以切换皮肤,现在我们分别使用VueReact来实现这个功能。

Vue中的provide/inject

Vue中我们可以使用provide/inject来实现跨多级组件进行传值,就以上面所说场景为例,我们使用provide/inject来实现以下

首先,修改App.vue内容为以下内容


  <div id="app">

    
  </div>


export default {
  data() {
    return {
      themeInfo: {
        theme: 'dark'
      }
    }
  },
  provide() {
    return {
      theme: this.themeInfo
    }
  }
}

然后在任意层级的子组件中像下面这样使用


  <div :class="`child-${theme.theme}`">
  </div>


export default {
  inject: ['theme']
}

这样就可以实现theme在所有子组件中进行共享了

React中的Context

Vue中我们使用provide/inject实现了组件跨层级传值功能,在React中也提供了类似的功能即Context,下面我们使用Context来实现相同的功能。

在项目src目录下新建context目录,添加MyContext.js文件,然后添加以下内容

import {createContext} from 'react'
// 定义 MyContext,指定默认的主题为`light`
export const MyContext = createContext({
  theme: 'light'
})

MyContext提供了一个Provider,通过Provider可以将theme共享到所有的子组件。现在我们在所有的组件的共同父组件比如App.js上面添加MyContext.Providertheme共享出去

import { MyContext } from '@/context/MyContext';


export default function() {

  
  const [theme, setTheme] = useState('dark')

  
  return (


    )
  }

然后这时候就可以直接在所有的子组件里面使用定义的主题theme

import React, { useContext } from 'react'
import { MyContext } from '@/context/MyContext';


export default function() {
   const {theme}  = useContext(MyContext)
   return <div className={`child-${theme}`}>
}

没有了v-model,但也不影响使用

我们知道ReactVue都是单向数据流的,即数据的流向都是由外层向内层组件进行传递和更新的,比如下面这段React代码就是标准的单向数据流.

import React, { useState } from "react";


export default function(){
  const [name] = useState('子君')
  return <input value={name}></input>
}

vue中使用v-model

如上代码,我们在通过通过value属性将外部的值传递给了input组件,这个就是一个简单的单向数据流。但是在使用Vue的时候,还有两个比较特殊的语法糖v-model.sync,这两个语法糖可以让Vue组件拥有双向数据绑定的能力,比如下面的代码


   <input v-model="name"/>


  export default {
    data() {
      return {
        name:'子君'
      }
    }
  }

通过v-model,当用户修改input的值的时候,外部的name的值也将同步被修改。但这是Vue的语法糖啊,React是不支持的,所以React应该怎么办呢?这时候再想想自定义v-modelv-model实际上是通过定义value属性同时监听input事件来实现的,比如这样:


  <div class="custom-input">
     <input :value="value" @input="$_handleChange"/>
  </div>


  export default {
    props:{
      value:{
        type: String,
        default: ''
      }
    },
    methods:{
      $_handleChange(e) {
        this.$emit('input', e.target.value)
      }
    }
  }

react寻找v-model替代方案

同理,React虽然没有v-model语法糖,但是也可以通过传入属性然后监听事件来实现数据的双向绑定。

import React, { useState } from 'react'


export default function() {
  const [name, setName] = useState('子君')


  const handleChange = (e) => {
    setName(e.target.value)
  }
  return <div>
    <input value={name} onChange={handleChange}></input>
  </div>
}

小编刚开始使用react,感觉没有v-model就显得比较麻烦,不过麻烦归麻烦,代码改写也要写。就像上文代码一样,每一个表单元素都需要监听onChange事件,越发显得麻烦了,这时候就可以考虑将多个onChange事件合并成一个,比如像下面代码这样

import React, { useState } from 'react'


export default function () {
  const [name, setName] = useState('子君')
  const [sex, setSex] = useState('男')


  const handleChange = (e:any, method: Function) => {
    method(e.target.value)
  }
  return <div>
    <input value={name} onChange={(e) => handleChange(e, setName)}></input>
    <input value={sex} onChange={(e) => handleChange(e, setSex)}></input>
  </div>
}

没有了指令,我感觉好迷茫

Vue中我们一般绘制页面都会使用到templatetemplate里面提供了大量的指令帮助我们完成业务开发,但是在React中使用的是JSX,并没有指令,那么我们应该怎么做呢?下面我们就将Vue中最常用的一些指令转换为JSX里面的语法(注意: 在Vue中也可以使用JSX)

v-showv-if

Vue中我们隐藏显示元素可以使用v-show或者v-if,当然这两者的使用场景是有所不同的,v-show是通过设置元素的display样式来显示隐藏元素的,而v-if隐藏元素是直接将元素从dom中移除掉。

  1. 看一下Vue中的v-showv-if的用法

   
     <div>
       <span v-show="showName">姓名:{{ name }}</span>
       <span v-if="showDept">{{ dept }}</span>
     </div>


   export default {
     data() {
       return {
         name: '子君',
         dept: '银河帝国',
         showName: false,
         showDept: true
       }
     }
   }


  1. v-showv-if转换为JSX中的语法

Vue中指令是为了在template方便动态操作数据而存在的,但是到了React中我们写的是JSX,可以直接使用JS,所以指令是不需要存在的,那么上面的v-show,v-if如何在JSX中替代呢

   import React, { useState } from 'react'

   
   export default function() {
     const [showName] = useState(false)

   
     const [showDept] = useState(true)

   
     const [userInfo] = useState({
       name:'子君',
       dept: '银河帝国'
     })

   
     return (
       <div>
         {/**模拟 v-show */}
         <span style={{display: showName ? 'block' : 'none'}}>{userInfo.name}</span>
         {/**模拟 v-show */}
         {showDept ? <span>{userInfo.dept}</span>: undefined}
       </div>
     )
   }

v-for

v-forVue中是用来遍历数据的,同时我们在使用v-for的时候需要给元素指定keykey的值一般是数据的id或者其他唯一且固定的值。不仅在Vue中,在React中也是存在key的,两者的key存在的意义基本一致,都是为了优化虚拟DOM diff算法而存在的。

  1. Vue中使用v-for

   
     <div>
       <ul>
         <li v-for="item in list" :key="item.id">
           {{ item.name }}
         </li>
       </ul>
     </div>


   export default {
     data() {
       return {
         list: [
           {
             id: 1,
             name: '子君'
           },
           {
             id: '2',
             name: '张三'
           },
           {
             id: '3',
             name: '李四'
           }
         ]
       }
     }
   }


  1. React中使用v-for的替代语法

react中虽然没有v-for,但是JSX中可以直接使用JS,所以我们可以直接遍历数组

   import React from 'react'

   
   export default function() {
     const data = [
       {
         id: 1,
         name: "子君",
       },
       {
         id: "2",
         name: "张三",
       },
       {
         id: "3",
         name: "李四",
       },
     ];

   
     return (
       <div>
         <ul>
           {
           data.map(item => {
             return <li key={item.id}>{item.name}</li>
           })
         }
         </ul>
       </div>
     )
   }

v-bindv-on

v-bindVue中是动态绑定属性的,v-on是用于监听事件的,因为React也有属性和事件的概念,所以我们在React也能发现可替代的方式。

  1. Vue中使用v-bindv-on

   
     <div>

       
       <input :value="value" @input="handleInput" />
     </div>


   export default {
     data() {
       return {
         value: '子君'
       }
     },
     methods: {
       handleInput(e) {
         this.value = e.target.value
       }
     }
   }


  1. React中寻找替代方案

Vue中,作者将事件和属性进行了分离,但是在React中,其实事件也是属性,所以在本小节我们不仅看一下如何使用属性和事件,再了解一下如何在React中自定义事件

开发一个CustomInput组件

   import React from 'react'

   
   export interface CustomInputProps {
     value: string;
     //可以看出 onChange是一个普通的函数,也被定义到了组件的props里面了
     onChange: ((value: string,event: React.ChangeEvent) => void) | undefined;
   }

   
   export default function(props: CustomInputProps) {

     
     function handleChange(e: React.ChangeEvent) {
       // props.onChange是一个属性,也是自定义的一个事件
       props.onChange && props.onChange(e.target.value, e)
     }

   
     return (
       <input value={props.value} onChange={handleChange}></input>
     )
   }

使用CustomInput组件

   import React, { useState } from 'react'

   
   import CustomInput from './components/CustomInput'

   
   export default function() {
    const [value, setValue] =  useState('')

   
    function handleChange(value: string) {
      setValue(value)
    }

   
     return (
       <div>

         
       </div>
     )
   }

总结

刚开始从Vue转到 React 的时候,其实是有点不适应的,但是当慢慢的习惯之后,就会发现VueReact 是存在很多共性的,可以参考的去学习。当然无论Vue还是 React ,上手比较快,但是想深入学习还是需要下功夫的,后续小编将会对VueReact 的用法在做更深入的介绍,敬请期待。

文章来源于公众号:前端进击者,作者:前端有的玩

以上就是W3Cschool编程狮关于适合Vue用户的React教程,走过路过千万不要错过的相关介绍了,希望对大家有所帮助。

怎样实现良好的数据库设计?

thbcm阅读(414)

1. 为什么要关注数据库设计?

无论是应用程序,还是数据库如何变化,数据始终是最重要的部分。通常,数据是系统存在的首要目的。这就是为什么,我们不应该只把数据库系统看作是保存数据的黑盒子,而要将其看成验证和防止数据腐化的工具。

要做到这一点,就要有健壮和深思熟虑的数据库设计。当然,业务逻辑是在应用层编码,它确保数据在到达数据库之前的格式是正确的。

但是,谁能保证网络故障或缺陷不会放行不可靠的“客人”?此外,应用层并不是通往数据库的唯一的“门”。我们可以使用导入脚本、维护脚本,DBA 和开发人员也会与之交互。我们可以在底层采取预防措施确保在数据存储前总是进行检查。

拥有健壮、可靠的数据也有助于开发和测试。将一个列设置为 Not Null 可以省掉许多假设该列为空的测试场景,还能简化代码,让开发人员不用(几乎)每次访问它之前都检查值。

在强调了良好的数据库设计的重要性后,让我们看看可以使用哪些工具来实现它。

2. 规范化

这无疑是良好设计的首要原则。这里,我们不打算深入研究规范化规则,只是想强调它的重要性。

关于这个话题,这里有份不错的资料,你可以进一步阅读。

https://docs.microsoft.com/en-us/office/troubleshoot/access/database-normalization-description

3. 数据类型

另一件要注意的事情是定义适当的属性类型。这不仅可以提高数据库的性能,还能在存储数据前验证数据。所以,我们应该在“integer”、“numeric”字段中保存数值数据;在“timestamp”、“timestamptz”字段中保存时间戳;在“bit”、“char(1)”或“boolean”字段中保存布尔值等等。

日期值得特别注意。如果 Date 属性假设只有日期部分(OrderDate,ReleaseDate),请使用没有时间部分的 Date 类型。如果你只需要保留时间(StartTime,EndTime),就使用合适的时间类型。

如果不需要指定精度,则将其指定为零(“time(0)”)。对带有时间部分的日期,有一个问题是,你必须总是截断时间部分,只显示日期,并且当你要在与数据库所在时区不同的地方显示时,要确保格式化后不会显示成昨天或明天。当跳转到夏令时的时候,带有时间部分的日期时间加减也可能出现问题。

4. 约束

约束是本文讨论的重点。它们将无效数据排除在外,并确保数据的健壮性。让我们一个一个来看。

非空约束

如果业务规则要求该属性应该始终存在,那么要毫不犹豫地将其设置为 Not Null。适合设置为 Not Null 的字段有 Id、Name、AddedDate、IsActive、State、CategoryId(如果所有项都应该有一个类别)、ItemCount、Price 以及许多其他字段。通常,这些属性在业务逻辑中扮演重要角色。其他可选的信息字段可能还是可以设置为 Null。

但是要注意,不要对可以为空的属性使用 Not Null 约束。例如,一个长时间运行的任务总有一个 StartTimestamp(Not Null),但是只有在任务完成时才更新 EndTimestamp(Null)。

另一个典型的例子是,Employee 表的 ManagerId,并不是所有员工都有经理。不要试图让 ManagerId 不为空,并为没有经理的员工插入“0”或“-1”。当我们添加外键约束时,这将导致其他问题。

唯一约束

同样,根据业务规则,一些属性(或属性的组合)应该是惟一的,比如 Id、PinNumber、BookId 和 AuthorId、OrderNo 等。应该通过添加惟一约束来保证这些属性的惟一。

还有一点要注意:可以使用唯一索引来实现同样的效果,但是添加约束是更好的方法。因为当添加惟一约束时,会自动创建非惟一索引。

因此,如果出于某种原因,你必须临时禁用 / 启用约束,将会非常容易。在使用唯一索引的情况下,你必须删除 / 重新创建索引,从性能和时间方面来说,这是一个昂贵的操作。

主键

Not Null 和唯一约束一起构成主键。当我们想到主键时,会很快想到 Id 或 ObjectId 之类的列。但是主键也可以是复合的,比如 BookId 和 AuthorId。

这里有个难题是,是使用单独的 Id 列作为主键,还是将两者的组合作为主键?通常,使用单独的 Id 列是一种更好的方法,因为它可以使连接更加清晰,还能方便地将另一列添加到惟一组合中。但是,即使有了一个单独的主键(Id),我们还是要为 BookId 和 AuthorId 列添加唯一约束。

Check 约束

Check 约束允许我们定义数据的有效值 / 范围。适合 Check 约束的属性有百分比(0 到 100 之间)、状态(0、1、2)、价格、金额、总数(大于或等于 0)、PinNumber(固定长度)等。

同样,不要尝试将业务逻辑编码到 Check 约束中。我记得有一次,在 AccountBalance 列中添加了一个“大于或等于零”的 Check 约束,从而避免了意外透支。

默认约束

默认约束也很重要。它们允许我们向现有表中添加新的 Not Null 列,并使“旧”API 与新结构兼容,直到所有各方都完成升级(尽管在完全升级后,默认约束应该删除)。

这里要记住一点。不要在默认约束中编写业务逻辑。例如,函数“now()”可能很适合(尽管不总是)作为日志表中的时间戳字段的默认值,但不适合 Orders 表的 OrderDate 字段。你可能会倾向于在插入语句中省略 OrderDate,而依赖于默认约束,但这意味着将业务逻辑扩展到数据库层。

此外,在某些情况下,业务可能只在订单批准后才给 OrderDate 赋值,因为默认约束深埋在数据库中,所以,当我们对应用层的代码进行更改时,它不会那么明显。

外键约束

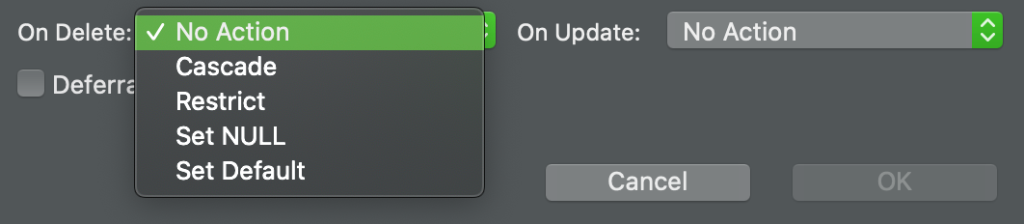
外键约束是关系数据库设计之王。外键与主键一起确保表之间的数据一致性。规范化规则告诉我们何时将数据提取到表中并使用外键引用它。这里我们将关注细节差别,比如 OnDelete 和 OnUpdate 规则。

让我们从简单的部分开始:OnUpdate。外键引用主键,它们很少(如果有的话)被修改。因此,OnUpdate 规则不是很常用,但将其设置为 Cascade 还是有意义的,因为我们有时可能必须更新某些行的主键(通常在迁移后)。这样,数据库将允许我们进行更新,并将新的 id 传播到子表中。

OnDelete 规则有点复杂。根据数据库的不同,我们有 NoAction、Restrict、SetNull、SetDefault 和 Cascade 选项。那么,选择哪一个呢?

通常,对于键引用查找或不引用实体的实体,我们选择 NoAction。例如,Products -> Categories、Books -> Authors 等。在大多数情况下,Restrict 与 NoAction 是相同的,但是对于某些数据库,它们有细微的区别。

https://www.vertabelo.com/blog/on-delete-restrict-vs-on-delete-no-action/

另一方面,当子记录不能在没有父记录的情况下存在时,选择 Cascade。在 Book 和 Author 示例中,当删除一本书时,我们也应该从 BookAuthor 表中删除记录。其他例子有 OrderDetails -> Orders、PostComments -> Posts 等。这里,有些人可能会不同意,数据库不应该自动删除子行,它们应该由应用层删除。根据业务逻辑,是这样的。但有时“不重要的”子项删除可以委托给数据库。

SetNull 很少使用。例如,Employee.ManagerId 和 Employee.Id 之间的外键可以是 SetNull。当一名经理被撤职,他的下属就没经理了。显然,只有当列可为空时才能选择该项规则。

在这些规则中,SetDefault 最罕见。当父记录被删除时,它将列设置为其默认值。因为外键引用主键,我们很难想象一个有外键的字段将默认值硬编码。但无论如何,这个选项是存在的,我们还是有可能需要它。

5. 索引

索引是良好数据库设计的重要组成部分,但有点偏离我们的讨论,因为它们几乎不能保护我们的数据(惟一索引除外)。

需要注意的一点是:一些 RDBMS 系统(例如 Oracle)会在创建外键时自动创建索引,而无需我们操心。其他数据库(例如 MS SQL Server)不会这样做,我们必须自己添加索引。

6. 小结

一个深思熟虑的设计可以为我们节省大量的编码、测试和故障排除时间。在设计良好的数据库上编写查询和报表令人愉快。将数据发布并迁移到新系统也会非常容易。

以上就是W3Cschool编程狮关于怎样实现良好的数据库设计?的相关介绍了,希望对大家有所帮助。

联系我们