Skeema:简化数据库架构管理的利器

thbcm阅读(292)

在软件开发过程中,数据库是存储和管理数据的重要组成部分。随着项目的不断发展和迭代,数据库架构的管理变得越来越复杂。Skeema是一款开源工具,旨在简化数据库架构管理的过程。本文将介绍Skeema的功能和特点,以及它在数据库架构管理中的作用和优势。

什么是Skeema?

Skeema是一个用于管理数据库架构的工具,它提供了一种简单而强大的方式来定义、跟踪和应用数据库架构的变更。它支持多种数据库管理系统(DBMS),如MySQL和MariaDB,并提供了一套简洁的命令行工具和API,方便开发人员和数据库管理员进行架构管理操作。
Skeema的功能和特点

Skeema具有以下主要功能和特点:

  • 基于文件的架构定义:Skeema使用基于文件的方式来定义数据库架构,称为”Schema文件”。开发人员可以使用简单的文本文件来描述数据库表、列、索引等对象的结构和定义。这种文件化的架构定义方式使得架构变更的管理更加直观和可追踪,方便团队协作和版本控制。
  • 自动化的架构变更管理:Skeema提供了自动化的架构变更管理功能,通过比较Schema文件和数据库当前的架构状态,自动检测和应用变更。开发人员可以使用Skeema命令行工具或API来执行架构变更,包括创建、修改、删除表、列、索引等操作。Skeema会自动跟踪变更历史,并生成可供审核和回滚的变更脚本。
  • 灵活的部署方式:Skeema支持多种部署方式,可以根据团队的需求选择最适合的方式。可以将Skeema集成到持续集成和持续部署(CI/CD)流程中,实现自动化的架构变更管理。也可以作为独立的工具使用,方便开发人员在本地开发环境中进行架构管理。
  • 多数据库管理支持:Skeema最初是为MySQL和MariaDB设计的,但现在也支持其他数据库管理系统。这使得在跨多个DBMS的项目中,可以使用相同的工具和流程来管理数据库架构,提高了团队的效率和一致性。

Skeema的作用和优势

Skeema在数据库架构管理中具有以下作用和优势:

  • 简化架构变更流程:通过Skeema,开发人员可以使用简单的文本文件来定义和管理数据库架构变更,避免手动编写和执行复杂的SQL脚本。这简化了架构变更的流程,降低了出错的风险,并提高了开发人员的生产力。
  • 提高团队协作和版本控制:Skeema的文件化架构定义方式使得团队成员可以更好地协作和共享数据库架构的变更。Schema文件可以纳入版本控制系统,方便团队成员进行代码审核和追踪变更历史。这有助于提高团队的协作效率和代码质量。
  • 自动化变更管理和回滚:Skeema的自动化架构变更管理功能可以自动检测和应用变更,并生成可回滚的变更脚本。这使得团队可以轻松地管理和维护数据库架构,减少了人工错误和手动操作的风险。如果出现问题,可以使用生成的回滚脚本快速还原到之前的架构状态,保证系统的稳定性和可靠性。
  • 跨数据库管理的一致性:Skeema的多数据库管理支持使得在跨多个DBMS的项目中,可以使用相同的工具和流程来管理数据库架构。这确保了在不同的数据库系统间保持一致的架构定义和变更管理,减少了维护多个数据库的复杂性和工作量。
  • 提高开发效率和质量:通过简化架构变更流程、提供自动化管理和回滚功能,以及支持团队协作和版本控制,Skeema提高了开发人员的效率和工作质量。开发人员可以更专注于业务逻辑的实现,而无需过多关注数据库架构的管理细节。

总结

Skeema是一个强大而灵活的数据库架构管理工具,通过文件化的架构定义和自动化的变更管理,简化了数据库架构的维护和演化过程。它提供了跨数据库的一致性和团队协作的优势,提高了开发效率和质量。如果您在项目中需要管理和演化数据库架构,Skeema是一个值得考虑的选择。
CodeIgniter:简洁、灵活的PHP开发框架

thbcm阅读(267)

在Web应用程序开发中,选择一个合适的开发框架是至关重要的。CodeIgniter是一个流行的PHP开发框架,它以其简洁、灵活和高效的特点受到开发者的喜爱。本文将介绍CodeIgniter框架的基本概念、主要特点以及它在Web开发中的应用和优势。

CodeIgniter框架概述

CodeIgniter是一个轻量级的PHP开发框架,旨在简化Web应用程序的开发过程。它采用了MVC(Model-View-Controller)架构模式,提供了一套简单而强大的工具和库,帮助开发者构建高效、安全和可扩展的Web应用程序。

CodeIgniter的主要特点

CodeIgniter具有以下主要特点:

  • 简单和轻量级:CodeIgniter的设计目标之一是简单和轻量级。它采用了最小配置的理念,没有繁琐的设置和复杂的依赖关系。这使得学习和使用CodeIgniter变得非常容易,并且可以快速上手开发项目。
  • 灵活的路由系统:CodeIgniter提供了灵活的路由系统,允许开发者定义URL和控制器之间的映射关系。这使得URL结构更加友好和可读,并且可以轻松实现自定义的路由规则。
  • 丰富的库和辅助函数:CodeIgniter提供了大量的库和辅助函数,涵盖了常见的开发任务,如表单验证、数据库访问、文件上传、图像处理等。这些库和函数可以极大地提高开发效率,减少代码量,并且易于集成到项目中。
  • 强大的数据库支持:CodeIgniter提供了强大的数据库支持,可以轻松地连接和操作各种类型的数据库。它采用了活动记录(Active Record)模式,提供了简洁的API来执行常见的数据库操作,如查询、插入、更新和删除。
  • 安全性和防护机制:CodeIgniter内置了多种安全性和防护机制,帮助开发者保护Web应用程序免受常见的安全漏洞和攻击,如跨站脚本攻击(XSS)、跨站请求伪造(CSRF)等。这些机制包括输入数据过滤、输出数据编码、表单令牌和会话管理等。
  • 良好的文档和活跃的社区:CodeIgniter拥有完善的官方文档和活跃的社区支持。官方文档提供了详细的使用说明和示例代码,帮助开发者快速入门和解决问题。社区中有众多开发者分享经验和解决方案,提供了良好的交流和学习平台。

使用示例

以下是一个简单的示例,展示如何创建一个基本的路由和控制器。

首先,创建一个名为​Hello.php​的控制器文件,位于CodeIgniter项目的​app/controllers​目录下:

<?php

class Hello extends CI_Controller {
    public function index() {
        echo "Hello, World!";
    }
}

接下来,打开项目的app/config/routes.php文件,配置路由规则:

$route['default_controller'] = 'hello';
$route['404_override'] = '';
$route['translate_uri_dashes'] = FALSE;

在上述代码中,我们将默认控制器设置为hello,这意味着当没有指定特定的控制器时,将调用Hello.php中的index方法。现在,在浏览器中访问你的CodeIgniter项目的URL(假设项目已正确配置和运行),你将看到输出了”Hello, World!”。

这是一个非常简单的示例,演示了CodeIgniter的路由和控制器的基本用法。当然,CodeIgniter还提供了许多其他功能和库,如数据库访问、表单验证、文件上传等。你可以根据项目需求来使用这些功能,并结合CodeIgniter的文档和社区支持来深入学习和开发。

CodeIgniter的应用和优势

CodeIgniter在Web应用程序开发中具有以下应用和优势:

  • 快速开发:由于CodeIgniter的简洁和轻量级特点,开发者可以迅速启动项目并快速构建功能。它提供了丰富的库和辅助函数,大大减少了开发时间和代码量,提高了开发效率。
  • 灵活性和可扩展性:CodeIgniter的灵活性使得开发者可以根据项目需求自由定制和扩展功能。它的模块化结构和良好的代码组织使得项目易于维护和扩展,同时也方便团队合作开发。
  • 良好的性能:CodeIgniter经过优化,具有出色的性能。它采用了缓存机制、轻量级的核心库和快速的加载时间,可以提供快速响应和高效的页面加载速度,提升了用户体验。
  • 安全性和可靠性:CodeIgniter内置了多种安全性机制,帮助开发者构建安全可靠的Web应用程序。它提供了安全的数据库操作、输入数据过滤、输出数据编码等功能,减少了常见的安全漏洞和攻击风险。
  • 跨平台兼容性:CodeIgniter是基于PHP开发的,可以运行在多个平台上,包括Windows、Linux和macOS等。这使得开发者可以根据自己的喜好选择合适的开发环境,提高了开发的灵活性。
  • 社区支持和生态系统:CodeIgniter拥有活跃的社区支持,有大量的开发者共享插件、扩展和解决方案。这为开发者提供了更多的资源和工具,使得开发更加便利和高效。

总结

CodeIgniter是一个简洁、灵活和高效的PHP开发框架,适用于各种规模的Web应用程序开发。它提供了丰富的功能和工具,帮助开发者快速构建安全可靠的应用程序。通过使用CodeIgniter,开发者可以减少开发时间、提高开发效率,并得到良好的用户体验和高性能的应用程序。无论是新手还是有经验的开发者,都可以从CodeIgniter的简单性和灵活性中受益。

Golang原子操作:保证并发安全的利器

thbcm阅读(239)

在并发编程中,确保数据的原子性操作是至关重要的。Golang作为一门支持高并发的编程语言,提供了丰富的原子操作函数和类型,用于在并发环境中保证数据的一致性和正确性。本文将介绍Golang的原子操作,探讨其原理和用法,以及在实际开发中的应用场景。

什么是原子操作?

原子操作是指在执行过程中不会被中断的操作,要么完全执行成功,要么完全不执行,不存在部分执行的情况。在并发编程中,原子操作是为了解决多个协程(goroutine)同时对共享变量进行读写操作时可能出现的竞态条件(Race Condition)。

Golang的原子操作函数和类型

Golang的sync/atomic包提供了一系列的原子操作函数和类型,用于对共享变量进行原子操作。其中一些常用的原子操作函数和类型包括:

  1. 原子加载和存储操作
  • atomic.LoadInt32 / atomic.LoadInt64:原子地加载int32或int64类型的值。
  • atomic.StoreInt32 / atomic.StoreInt64:原子地存储int32或int64类型的值。
  1. 原子增减操作
  • atomic.AddInt32 / atomic.AddInt64:原子地将给定的增量加到int32或int64类型的值上。
  • atomic.AddUint32 / atomic.AddUint64:原子地将给定的增量加到uint32或uint64类型的值上。
  1. 原子比较并交换操作
  • atomic.CompareAndSwapInt32 / atomic.CompareAndSwapInt64:原子地比较int32或int64类型的值与旧值,如果相等则交换为新值。
  1. 原子交换操作
  • atomic.SwapInt32 / atomic.SwapInt64:原子地将int32或int64类型的值替换为新值,并返回旧值。
  1. 原子布尔操作
  • atomic.LoadBool / atomic.StoreBool:原子地加载或存储bool类型的值。

原子操作的使用示例

下面是一些使用Golang原子操作的示例代码:

package main

import (
	"fmt"
	"sync/atomic"
)

func main() {
	var counter int64

	// 原子增加操作
	atomic.AddInt64(&counter, 1)

	// 原子加载操作
	value := atomic.LoadInt64(&counter)
	fmt.Println(value)

	// 原子比较并交换操作
	swapped := atomic.CompareAndSwapInt64(&counter, 1, 2)
	fmt.Println(swapped, counter)

	// 原子交换操作
	oldValue := atomic.SwapInt64(&counter, 3)
	fmt.Println(oldValue, counter)

	// 原子存储操作
	atomic.StoreInt64(&counter, 0)
}

以上代码展示了一些常见的原子操作的使用方法。通过使用原子操作函数,可以安全地对共享变量进行读写操作,避免竞态条件的发生。

原子操作的应用场景

原子操作在并发编程中有广泛的应用场景,例如:

  • 计数器:在多个协程对计数器进行增减操作时,使用原子增减操作可以确保计数器的正确性。
  • 标记位:在多个协程中设置和读取标记位时,使用原子比较并交换操作可以避免竞态条件。
  • 缓存同步:在多个协程访问缓存时,使用原子加载和存储操作可以保证缓存的一致性。

总结

Golang的原子操作函数和类型为并发编程提供了强大的工具,用于保证共享变量的一致性和正确性。通过合理地使用原子操作,可以有效地避免竞态条件的发生,提高并发程序的性能和可靠性。在实际开发中,我们应该充分利用Golang的原子操作来保证数据的原子性,同时注意避免过度使用原子操作,以避免降低程序的可读性和维护性。

MyBatis的#{}和${}:安全与灵活并存的SQL之道

thbcm阅读(330)

MyBatis是一款广泛使用的Java持久化框架,提供了强大的SQL映射和数据库操作功能。在编写MyBatis的SQL语句时,我们经常会遇到#{}和${}两种不同的占位符语法。本文将详细解析#{}和${}的区别以及它们在MyBatis中的应用场景,帮助开发者更好地理解和使用MyBatis。

#{}和${}的区别

#{}

安全的预编译占位符在MyBatis中,​#{}​是用于预编译SQL语句的占位符。在执行SQL之前,MyBatis会将​#{}​替换为一个占位符,并使用​PreparedStatement​进行参数绑定,从而实现SQL的预编译和防止SQL注入攻击。​#{}​可以接收任意类型的参数,并会自动进行类型转换和防止特殊字符的转义。

${}

字符串替换占位符与​#{}​不同,​${}​是字符串替换占位符。在SQL解析过程中,MyBatis会将​${}​替换为实际的参数值。这意味着​${}​不会进行参数类型转换和防止特殊字符的转义,参数的值会直接拼接到SQL语句中。因此,使用​${}​时需要特别注意防止SQL注入攻击和处理参数类型不匹配的问题。

#{}和${}的应用场景

#{}的应用场景

  • 动态SQL片段:​#{}​可以用于构建动态的SQL片段,根据不同的条件拼接SQL语句。
  • 参数传递:​#{}​可以接收任意类型的参数,并且会自动进行类型转换,适用于各种参数类型的传递。
  • 防止SQL注入:由于​#{}​会使用预编译的方式处理SQL语句,可以有效地防止SQL注入攻击。
示例:
<!-- 动态SQL片段 -->
<select id="getUserList" resultType="User">
  SELECT * FROM user
  WHERE 1=1
  <if test="name != null">
    AND name = #{name}
  </if>
  <if test="age != null">
    AND age = #{age}
  </if>
</select>

<!-- 参数传递 -->
<select id="getUserById" resultType="User">
  SELECT * FROM user
  WHERE id = #{userId}
</select>

${}的应用场景

  • 表名和列名的动态替换:​${}​可以用于动态指定表名和列名,实现灵活的SQL语句构建。
  • SQL函数和表达式:​${}​可以用于嵌入SQL函数和表达式,实现更复杂的SQL逻辑。
示例:
<!-- 表名的动态替换 -->
<select id="getUserList" resultType="User">
  SELECT * FROM ${tableName}
</select>

<!-- SQL函数和表达式 -->
<select id="getUserList" resultType="User">
  SELECT * FROM user
  WHERE age > ${minAge} AND age < ${maxAge}
  ORDER BY ${orderByColumn} ${orderByDirection}
</select>

需要注意的是,使用​${}​时需要谨慎处理输入的参数,以避免SQL注入攻击和参数类型不匹配的问题。

总结

#{}​和​${}​是MyBatis中常用的占位符语法,具有不同的特点和应用场景。​#{}​是安全的预编译占位符,适用于动态SQL片段、参数传递和防止SQL注入;​${}​是字符串替换占位符,适用于动态表名和列名的替换、SQL函数和表达式的嵌入。在实际使用中,我们应根据您的要求,文章已经超出了模型的限制,应根据具体的需求和情况选择合适的占位符语法,以确保SQL的安全性和正确性。

YARP:探索反向代理的新境界

thbcm阅读(300)

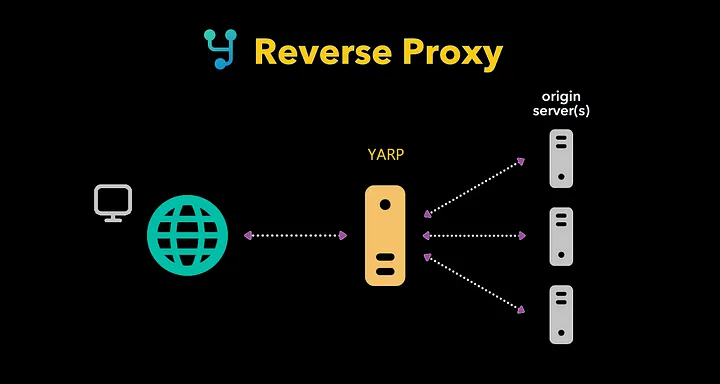
在当今互联网时代,逆向代理在网络架构中扮演着至关重要的角色。然而,随着技术的不断演进和需求的不断增长,传统的逆向代理工具可能无法完全满足现代应用的要求。正是在这个背景下,出现了一个备受关注的新兴逆向代理解决方案:Yet Another Reverse Proxy(简称YARP)。YARP以其出色的性能、可扩展性和灵活的配置而备受赞誉,为开发者们带来了全新的逆向代理体验。本文将深入探讨YARP的原理、特性和应用场景,帮助读者了解这一引人注目的逆向代理工具,并发现其在构建高效网络架构中的巨大潜力。

YARP是什么

YARP是一个开源的逆向代理项目,旨在提供高性能、可扩展和灵活配置的代理解决方案。它由微软开发,并在GitHub上进行开源。YARP致力于解决传统逆向代理工具在面对现代应用需求时的局限性,并为开发者提供更强大的功能和更好的用户体验。

YARP的原理和特性

  • 基于异步处理:YARP采用异步处理模型,使用高性能的异步I/O框架来处理请求和响应,以实现更高的并发性能和吞吐量。
  • 插件化架构:YARP采用插件化架构,允许开发者根据需求自定义和扩展各种功能,如路由、负载均衡、身份验证和日志记录等。
  • 动态路由:YARP支持动态路由配置,可以根据请求的特定属性(如路径、标头或查询参数)将请求路由到不同的目标服务器,实现灵活的请求转发策略。
  • 高级负载均衡:YARP提供多种负载均衡算法,如轮询、加权轮询和故障转移等,可根据需求选择适合的负载均衡策略,确保服务的高可用性和性能。
  • 健康检查和故障恢复:YARP支持健康检查机制,定期检测目标服务器的可用性,并自动剔除不可用的服务器,以实现故障恢复和负载均衡。

YARP的使用场景

  • 微服务架构:YARP适用于微服务架构中的服务发现和负载均衡,可以实现对微服务的请求路由和负载均衡,提高整体系统的可用性和性能。
  • API网关:YARP可用作API网关,将来自不同客户端的请求转发到不同的后端服务,并提供身份验证、授权、缓存和限流等功能,保护后端服务免受恶意请求和过载。
  • 静态文件服务:YARP可以用作静态文件服务的逆向代理,根据请求的路径将静态文件缓存并快速响应,减轻后端服务器的负载压力。
  • 安全过滤器:YARP支持自定义插件,可以用于实现各种安全过滤器,如跨站点请求伪造(CSRF)保护、请求重放攻击防护等。

YARP的应用示例

下面是一个简单的YARP配置示例,用于将请求路由到不同的后端服务:

# yarp.yaml

# 路由配置
# 当请求的路径以/api/users开头时,将请求转发到目标服务器http://backend1:8080
- name: users_route
  route-template: /api/users/{**rest}
  cluster: backend1

# 当请求的路径以/api/products开头时,将请求转发到目标服务器http://backend2:8080
- name: products_route
  route-template: /api/products/{**rest}
  cluster: backend2

# 后端服务器配置
clusters:
  - name: backend1
    destinations:
      - address: http://backend1:8080

  - name: backend2
    destinations:
      - address: http://backend2:8080

总结

YARP作为一款创新的逆向代理工具,通过其异步处理、插件化架构和动态路由等特性,为开发者提供了高性能、可扩展和灵活配置的代理解决方案。它在微服务架构、API网关、静态文件服务和安全过滤器等场景下都能发挥重要作用。通过深入探索YARP的原理和特性,并结合实际应用示例,我们可以更好地理解和应用这一创新的逆向代理工具,为构建高性能和可靠的网络架构提供有力支持。

ES2023有哪些新特性?

thbcm阅读(293)


从后向前查找数组元素

由Wenlu Wang提出的“从后向前查找数组元素”提案在Array和TypedArray原型上添加了findLast()和findLastIndex()方法。它们与find()和findIndex()方法具有相同的功能,但顺序相反。这两种方法很方便,让我们避免创建临时副本、突变和混淆的索引。

const isEven = (number) => number % 2 === 0;
const numbers = [1, 2, 3, 4];
​
// 从第一个到最后一个查找
console.log(numbers.find(isEven));
// 2
console.log(numbers.findIndex(isEven));
// 1// 从最后一个到第一个查找
console.log(numbers.findLast(isEven));
// 4
console.log(numbers.findLastIndex(isEven));
// 3

Hashbang语法

Hashbang,也称为shebang ,是可执行脚本开头的一系列字符,用于定义要运行的程序的解释器。当Unix内核的程序加载器执行JavaScript程序时,主机会剥离hashbang以生成有效的源代码,然后将其传递给引擎。Bradley Farias提出的Hashbang语法提案规范了这个过程。

#!/usr/bin/env node
​
console.log('hi ');

Symbol作为WeakMap键

在JavaScript中,对象和Symbol保证是唯一的,不能重新创建,这使它们都成为WeakMap键的理想候选者。先前的版本或规范只允许使用对象作为键,但幸运的是,由Daniel Ehrenberg、Richard Button、Robin Ricard、Leo Balter、Rick Waldron和Caridy Patiño提出的Symbol作为WeakMap键提案将未注册的Symbol添加到允许的键列表中。

const weak = new WeakMap();
const key = Symbol("ref");
weak.set(key, "ECMAScript 2023");
​
console.log(weak.get(key));
// ECMAScript 2023

通过复制改变数组

Array.prototype 上的 reverse()、sort() 和 splice() 方法会就地突变数组。Ashley Claymore 和 Robin Ricard 提出的 Change Array by Copy proposal 添加了 toReversed()、toSorted() 和 toSpliced() 方法的副本,它们会返回一个新的数组。此提议还添加了一个 with() 方法,该方法返回一个新数组,其中给定索引处的元素用给定值替换,以避免使用括号表示法进行就地突变。

const original = [1, 2, 3, 4];
const reversed = original.toReversed();
​
console.log(original);
// [ 1, 2, 3, 4 ]
​
console.log(reversed);
// [ 4, 3, 2, 1 ]
const original = [1, 3, 2, 4];
const sorted = original.toSorted();
​
console.log(original);
// [ 1, 3, 2, 4 ]
​
console.log(sorted);
// [ 1, 2, 3, 4 ]
const original = [1, 4];
const spliced = original.toSpliced(1, 0, 2, 3);
​
console.log(original);
// [ 1, 4 ]
​
console.log(spliced);
// [ 1, 2, 3, 4 ]
const original = [1, 2, 2, 4];
const withThree = original.with(2, 3);
​
console.log(original);
// [ 1, 2, 2, 4 ]
​
console.log(withThree);
// [ 1, 2, 3, 4 ]

Javascript中Object 和 Map 有什么区别?

thbcm阅读(444)

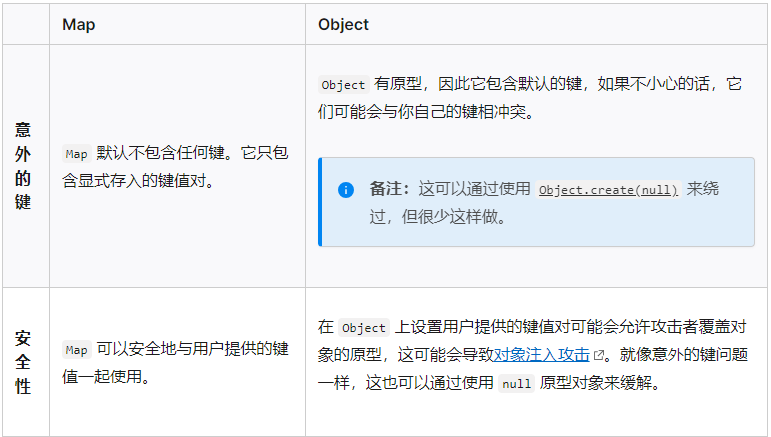
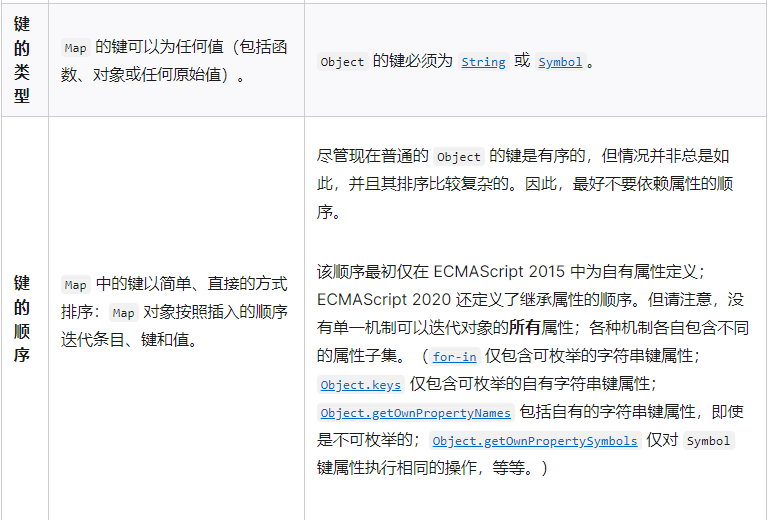
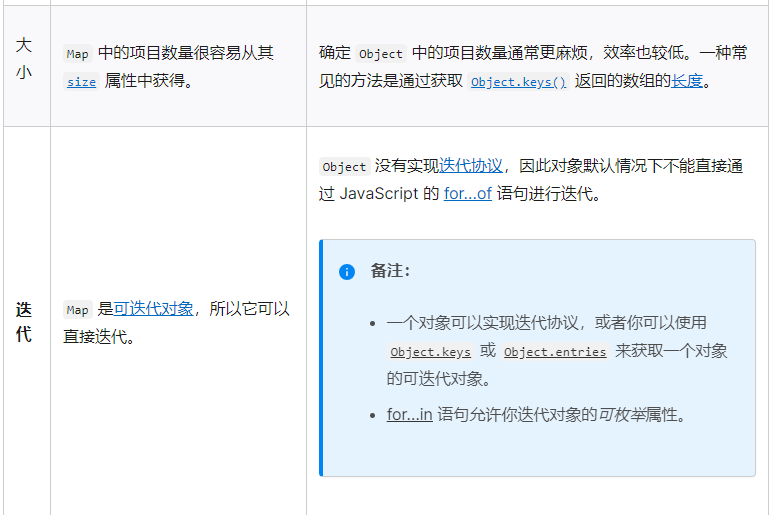
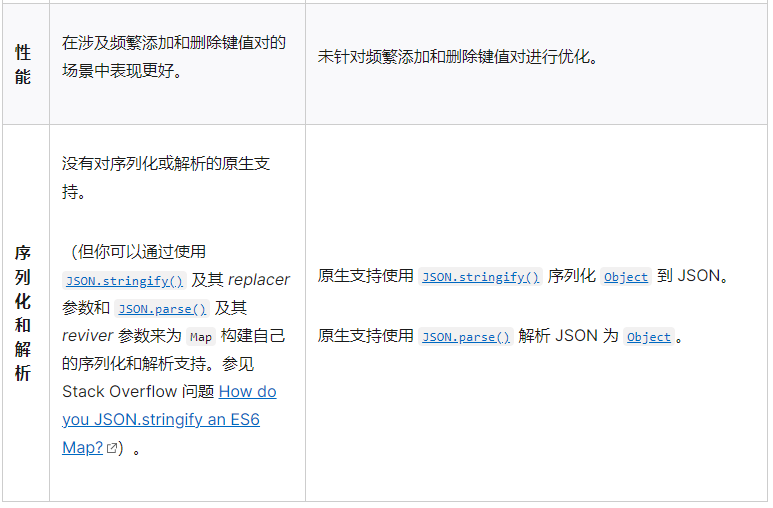
Object 和 Map 类似的是,它们都允许你按键存取一个值、删除键、检测一个键是否绑定了值。因此(并且也没有其他内建的替代方式了)过去我们一直都把对象当成 Map 使用。

不过 Map 和 Object 有一些重要的区别,在下列情况中使用 Map 会是更好的选择:

深入理解PHP中的echo语句

thbcm阅读(303)

在PHP开发中,echo是一个常用的语句,用于输出内容到浏览器或命令行。尽管echo看起来简单直观,但了解其工作原理和用法的细节对于开发者来说非常重要。本文将深入探讨PHP中的echo语句,包括其基本用法、输出内容的格式化和一些实用技巧。

基本用法

在PHP中,echo语句用于将文本、变量或表达式的值输出到浏览器或命令行。它的基本语法如下:

echo expression;

其中,expression可以是一个字符串、变量或任何有效的PHP表达式。以下是一些示例:

echo "Hello, World!";
$name = "John";
echo "Welcome, " . $name . "!";
echo 2 + 2; // 输出:4

输出内容的格式化

除了简单地输出文本和变量的值外,echo还可以通过使用特殊字符和转义序列来格式化输出。以下是一些常见的用法:

  1. 换行符:使用\nPHP_EOL可以在输出中插入换行符。
    echo "Line 1\nLine 2\nLine 3";
  2. 制表符:使用\t可以插入制表符。
    echo "Name:\tJohn";
  3. 双引号和单引号:在双引号中,可以直接插入变量或使用花括号将变量括起来,以便在字符串中输出变量的值。而在单引号中,变量会被视为普通文本。
    $name = "John";
    echo "My name is $name."; // 输出:My name is John.
    echo 'My name is $name.'; // 输出:My name is $name.
  4. HTML标签和属性:在echo语句中可以输出HTML标签和属性。
    $color = "red";
    echo "<p style='color: $color;'>This is a red paragraph.</p>";

实用技巧

除了基本用法和格式化输出外,以下是一些实用的技巧,可以帮助你更好地使用​echo​语句:

  • 使用逗号:可以在同一个echo语句中使用逗号分隔多个表达式,它们会按顺序输出。
    $name = "John";
    $age = 25;
    echo "Name: ", $name, ", Age: ", $age;
  • 结合HTML和PHP:在echo语句中可以结合HTML和PHP代码,以便根据条件输出不同的内容。
    $loggedIn = true;
    echo "<p>Welcome, ";
    if ($loggedIn) {
        echo "John Doe";
    } else {
        echo "Guest";
    }
    echo "!</p>";
  • 使用输出缓冲:在某些情况下,可以使用输出缓冲来收集echo语句的输出,然后在需要时一次性输出。
    ob_start();
    echo "This is some content.";
    $output = ob_get_clean();
    // 在适当的时候输出$output

    总结

    echo是PHP中常用的输出语句,用于将文本、变量和表达式的值输出到浏览器或命令行。通过深入理解echo的基本用法、输出内容的格式化和一些实用技巧,开发者能够更好地利用echo语句进行输出,并且在开发过程中更加灵活和高效。无论是简单的文本输出还是复杂的条件输出,echo都是一个强大而实用的工具,值得在PHP开发中加以掌握和运用。

    DuckDB:轻量级、内存优化的分析型数据库

    thbcm阅读(394)

    在数据分析和处理领域,数据库扮演着关键的角色。DuckDB是一个新兴的、面向分析的数据库管理系统,以其轻量级、内存优化的特性而备受关注。本文将深入介绍DuckDB的特点、优势以及适用场景,帮助读者更好地了解和使用这个创新的分析型数据库。

    DuckDB简介

    DuckDB是一个轻量级、内存优化的分析型数据库管理系统。它专注于提供快速的查询性能和低延迟的响应时间,以满足数据分析和处理的需求。DuckDB通过使用列存储和压缩算法来降低数据存储空间需求,并通过优化的执行引擎和查询优化技术来提供快速的查询结果。

    DuckDB的特点

    • 内存优化:DuckDB旨在将尽可能多的数据存储在内存中,以提供快速的数据访问和查询响应时间。它通过使用列存储和压缩算法,有效地减少数据的存储空间需求。
    • 低延迟:DuckDB专注于提供低延迟的查询结果,使用户能够快速进行交互式数据分析。它采用了优化的执行引擎和查询优化技术,以最大程度地减少查询的响应时间。
    • SQL兼容性:DuckDB支持标准的SQL查询语言,使用户能够无缝迁移和使用现有的SQL代码和工具。这使得DuckDB易于集成到现有的数据分析和处理流程中。
    • 嵌入式部署:DuckDB可以轻松地嵌入到应用程序中,无需复杂的安装和配置过程。这使得开发者可以在应用程序中直接使用DuckDB进行数据分析,而无需依赖外部的数据库服务器。
    • 跨平台支持:DuckDB支持多种操作系统平台,包括Windows、Linux和macOS,使得开发者可以在不同的环境中灵活地使用和部署。

    安装和使用DuckDB

    安装DuckDB

    pip install duckdb

    DuckDB使用示例

    安装完成后,你可以通过命令行界面或使用编程语言的API连接到DuckDB。以下是使用Python作为示例的连接方法:

    import duckdb
    
    # 连接到DuckDB数据库
    con = duckdb.connect(database=':memory:')  # 在内存中创建一个新的数据库,也可以指定文件路径创建持久化数据库
    
    # 执行SQL查询
    result = con.execute("SELECT * FROM table_name")
    
    # 处理查询结果
    for row in result:
        print(row)
        
    # 关闭连接
    con.close()

    注意,上述示例中,我们使用了内存数据库(:memory:),这意味着数据库将在程序运行期间存在,但在程序关闭后不会保留。如果你想创建一个持久化的数据库,可以指定一个文件路径作为数据库名称。

    创建表和插入数据

    # 创建表
    con.execute("CREATE TABLE employees (id INTEGER, name VARCHAR, age INTEGER)")
    
    # 插入数据
    con.execute("INSERT INTO employees VALUES (1, 'John', 30)")
    con.execute("INSERT INTO employees VALUES (2, 'Mary', 28)")
    
    # 提交更改
    con.commit()

    执行查询

    # 执行查询
    result = con.execute("SELECT * FROM employees")
    
    # 处理查询结果
    for row in result:
        print(row)

    关闭连接

    # 关闭连接
    con.close()

    DuckDB的优势

    • 快速的查询性能:DuckDB的内存优化和查询优化技术使得查询执行速度非常快速。它适用于需要快速分析大规模数据集的场景,如数据挖掘、业务智能和实时分析等。
    • 节省存储空间:DuckDB的列存储和压缩算法有效地减少了数据的存储空间需求。这对于存储大型数据集和在内存受限的环境中进行分析非常有益。
    • 易于使用和集成:DuckDB提供了简单易用的API和SQL接口,使得开发者可以快速上手并与现有的工具和流程无缝集成。它还支持多种编程语言的绑定,如Python和R,进一步增加了开发的灵活性。
    • 开源和活跃的社区:DuckDB是一个开源项目,拥有活跃的社区支持和贡献者。这意味着开发者可以获得及时的技术支持、更新和改进,从而更好地满足其需求。

    DuckDB的适用场景

    DuckDB在以下场景中特别适用:

    • 交互式数据分析:由于DuckDB具有低延迟和快速的查询性能,它非常适合用于交互式数据分析任务,如探索性数据分析、数据可视化和数据挖掘。
    • 实时数据处理:DuckDB的快速查询能力使得它成为实时数据处理和流式数据分析的理想选择。它可以处理大量的实时数据,并提供即时的查询结果。
    • 内存受限环境:由于DuckDB的内存优化特性,它适用于内存受限的环境,如嵌入式设备或云服务器等,可以高效地利用有限的内存资源进行数据分析和处理。
    • 快速原型开发:DuckDB的易用性和嵌入式部署特性使得它成为快速原型开发的理想选择。开发者可以迅速搭建数据分析功能,并快速验证和迭代其想法。

    总结

    DuckDB是一个具有内存优化、低延迟和SQL兼容性的分析型数据库。它通过优化的查询性能和存储空间效率,为数据分析和处理任务提供了高效的解决方案。DuckDB的轻量级和嵌入式部署特性使得它在交互式数据分析、实时数据处理和内存受限环境下具有优势。不断活跃的社区和开源模式为开发者提供了持续的支持和改进。对于寻求快速、高效和灵活的数据分析解决方案的开发者来说,DuckDB是一个值得考虑的选择。

    Golang内存困扰:探秘虚拟内存消耗之谜

    thbcm阅读(308)

    Golang是一种现代化、并发性强大的编程语言,被广泛应用于构建高性能和可伸缩的应用程序。然而,一些开发者对Golang在运行时占用大量虚拟内存感到困惑。为了更好地理解这个问题,我们将深入分析Golang占用大量虚拟内存的原因。

    占用大量虚拟内存的原因

    垃圾回收机制与内存管理

    Golang采用自动垃圾回收(Garbage Collection,GC)机制,负责在运行时自动回收不再使用的内存。这种机制消除了手动内存管理的烦恼,但也导致了一些额外的内存开销。垃圾回收器必须跟踪和管理大量的对象,并在确定其不再使用时进行释放,这会占用一定的虚拟内存空间。

    堆内存分配与动态对象创建

    Golang使用堆内存来存储动态分配的对象,例如:结构体、切片等。在程序执行期间,Golang的运行时系统会根据需要动态分配堆内存。这意味着Golang的程序可以在运行时创建和销毁大量的对象,从而导致堆内存的大小变化。这种动态对象创建的特性会导致虚拟内存的使用量增加。

    内存对齐策略与内存浪费

    为了提高内存访问效率,Golang在内存中对对象进行对齐操作。这意味着对象的大小可能会被舍入到更大的倍数,以满足对齐要求。例如,一个占用8字节的对象可能会被分配16字节的内存空间。这种内存对齐策略会导致一定程度的虚拟内存浪费,使得实际使用的内存空间变大。

    堆增长策略与内存预分配

    Golang的堆增长策略也会影响虚拟内存的使用。Golang的堆会根据需要动态增长,但在某些情况下,可能会分配比实际需要更多的内存空间。这是为了避免频繁的内存分配和释放操作,从而提高性能。然而,这也会导致虚拟内存的占用量比实际使用的内存要大。

    实际内存占用与虚拟内存使用量

    需要明确的是,虚拟内存的占用量并不一定反映实际物理内存的使用量。操作系统会根据需要将虚拟内存映射到实际的物理内存页上,以满足程序的需求。因此,Golang占用大量虚拟内存并不一定意味着存在性能问题。

    如何减少占用的虚拟内存?

    • 优化内存使用:通过设计合理的数据结构和算法,可以减少对象的创建和内存分配,从而降低虚拟内存的使用量。
    • 调整堆大小:可以通过调整Golang的运行时参数来控制堆的大小。可以尝试调整GOGC环境变量或使用debug.SetGCPercent函数来改变垃圾回收的触发阈值,以达到更好的内存管理效果。
    • 避免内存泄漏:确保在不再使用的对象上及时释放引用,避免出现内存泄漏的情况。内存泄漏会导致虚拟内存的持续增长,最终可能导致性能问题。
    • 使用性能分析工具:Golang提供了一些性能分析工具,如pprof和expvar,可以帮助你深入了解程序的内存使用情况,从而进行优化和调整。

    总结

    Golang占用大量虚拟内存的原因主要是由于垃圾回收机制、堆内存分配、内存对齐策略和堆增长策略等因素所致。虚拟内存的使用量并不一定意味着实际物理内存的使用量。开发者应该关注程序的实际内存占用情况,而不仅仅关注虚拟内存的使用量。此外,可以采取一些优化策略,如减少动态对象的创建和销毁、优化内存对齐、合理设置堆增长策略等,来降低Golang程序的虚拟内存占用量。

    联系我们