Excalidraw:创作无限可能的在线绘图工具

thbcm阅读(294)

在数字化时代,创作和共享图形内容已经成为许多领域的基本需求。Excalidraw作为一款开源的在线绘图工具,为用户提供了简单而强大的绘图功能。本文将介绍Excalidraw的特点、用法和优势,帮助你了解如何利用Excalidraw创作出令人惊叹的图形作品。

什么是Excalidraw?

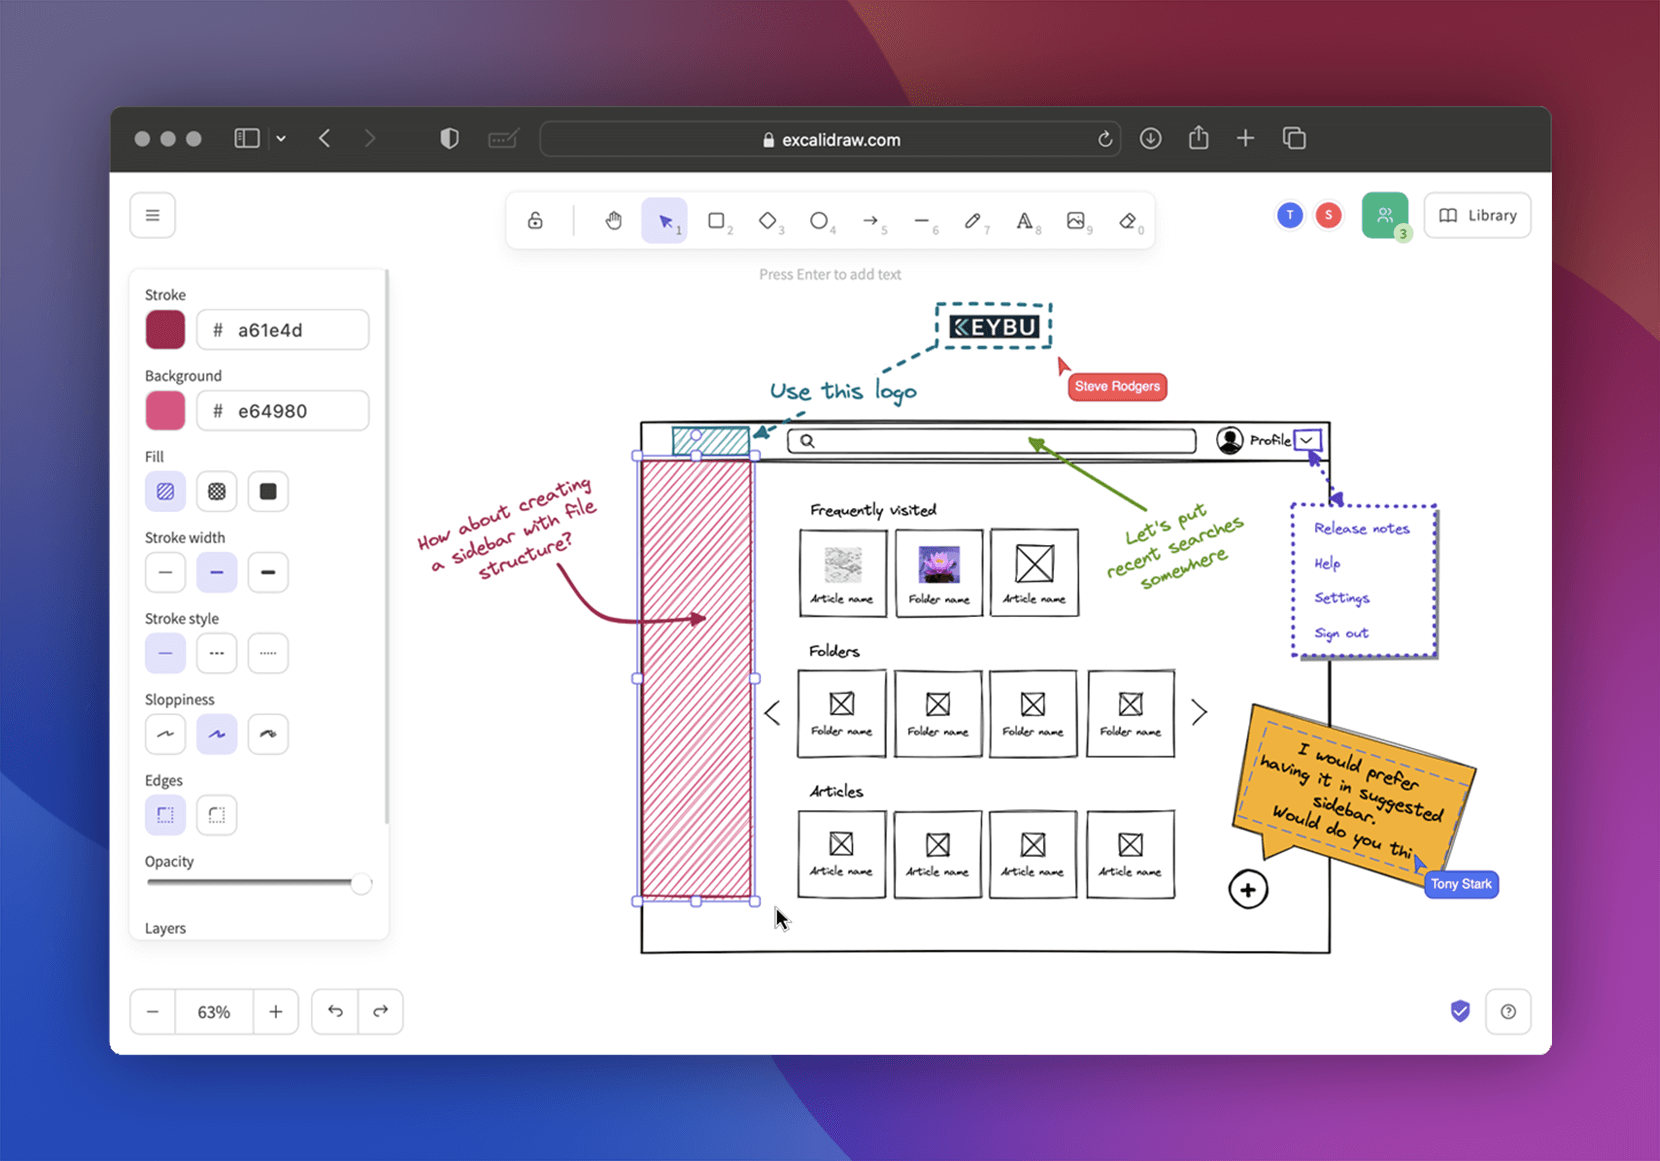
Excalidraw是一个基于Web的绘图工具,旨在帮助用户创建可视化的图形内容。它具有简单直观的用户界面,使用户能够轻松绘制各种图形,包括流程图、示意图、原型设计等。Excalidraw支持多用户实时协作,可以方便地与他人共享和编辑图形作品。
特点和用法

以下是Excalidraw的主要特点和用法:

  • 绘图工具和元素库:Excalidraw提供了一系列绘图工具,如画笔、形状工具、文本工具等,使用户可以自由绘制和编辑图形。此外,Excalidraw还提供了丰富的元素库,包含各种预定义的图形元素,如图标、箭头、符号等,可直接拖放到画布上使用。
  • 实时协作和共享:Excalidraw支持多用户实时协作,多个用户可以同时编辑同一份图形作品,实时观察和同步对方的操作。用户可以通过生成共享链接,轻松与他人共享图形内容,并邀请他人加入协作编辑。
  • 导出和嵌入:Excalidraw允许用户将绘制的图形导出为图像文件(PNG、SVG)或JSON格式,方便在其他应用程序中使用。此外,用户还可以通过嵌入代码将Excalidraw画布嵌入到网页或博客中,以展示和共享创作成果。
  • 自定义样式和主题:Excalidraw提供了丰富的样式和主题选项,用户可以自定义图形的颜色、线条样式、字体等,以满足个性化需求。用户还可以创建自己的主题,将其应用于绘制的图形作品。
  • 快捷操作和快捷键:Excalidraw提供了各种快捷操作和快捷键,以提高用户的操作效率和体验。例如,可以使用快捷键进行选择、复制、粘贴、撤销等操作,还可以通过拖动和调整对象的边缘来改变其大小和形状。

优势和适用场景

Excalidraw具有以下优势和适用场景:

  • 简单易用:Excalidraw的用户界面简洁直观,不需要复杂的学习过程,即可上手使用。
  • 实时协作:多用户实时协作功能使得团队成员可以远程共享和协同编辑图形内容,提高工作效率。
  • 可视化创作:Excalidraw使用户能够将想法和概念可视化,以图形形式清晰表达,适用于流程图、示意图、原型设计等场景。
  • 灵活导出和嵌入:Excalidraw支持导出图形作品,并可以嵌入到网页或博客中,方便共享和展示创作成果。
  • 自定义样式和主题:通过自定义样式和主题,用户可以根据个人喜好和需求,定制图形的外观和风格。

Excalidraw在各种领域都有广泛的应用,包括但不限于:

  • 软件开发:绘制流程图、架构图、数据库关系图等。
  • 产品设计:创建原型设计、界面布局图、用户流程图等。
  • 教育和培训:制作教学示意图、概念图、演示和解说图等。
  • 项目管理:绘制甘特图、时间轴图、任务流程图等。
  • 团队协作:共享会议笔记、头脑风暴图、团队思维导图等。

总结

Excalidraw作为一款强大而易用的在线绘图工具,为用户提供了创作无限可能的体验。它简化了图形创作的过程,通过实时协作和可视化工具,使用户能够轻松创建和共享各种图形内容。不论你是开发者、设计师、教育工作者还是项目管理者,Excalidraw都能满足你的绘图需求,并帮助你将想法和概念可视化。无论是个人使用还是团队协作,Excalidraw都是一个值得尝试的创作工具,让你的图形作品更加生动有趣。
TanStack:简化Web开发的现代工具集

thbcm阅读(298)

随着Web应用的快速发展,开发者们迫切需要一种现代化的技术堆栈,以提高开发效率、简化代码管理,并保证应用的性能和可靠性。TanStack作为一个集成了多个优秀工具和框架的堆栈,为开发者们提供了构建现代化Web应用的完美解决方案。本文将介绍TanStack的组成部分、特点和优势,帮助你了解如何利用TanStack打造出令人惊叹的Web应用。

什么是TanStack?

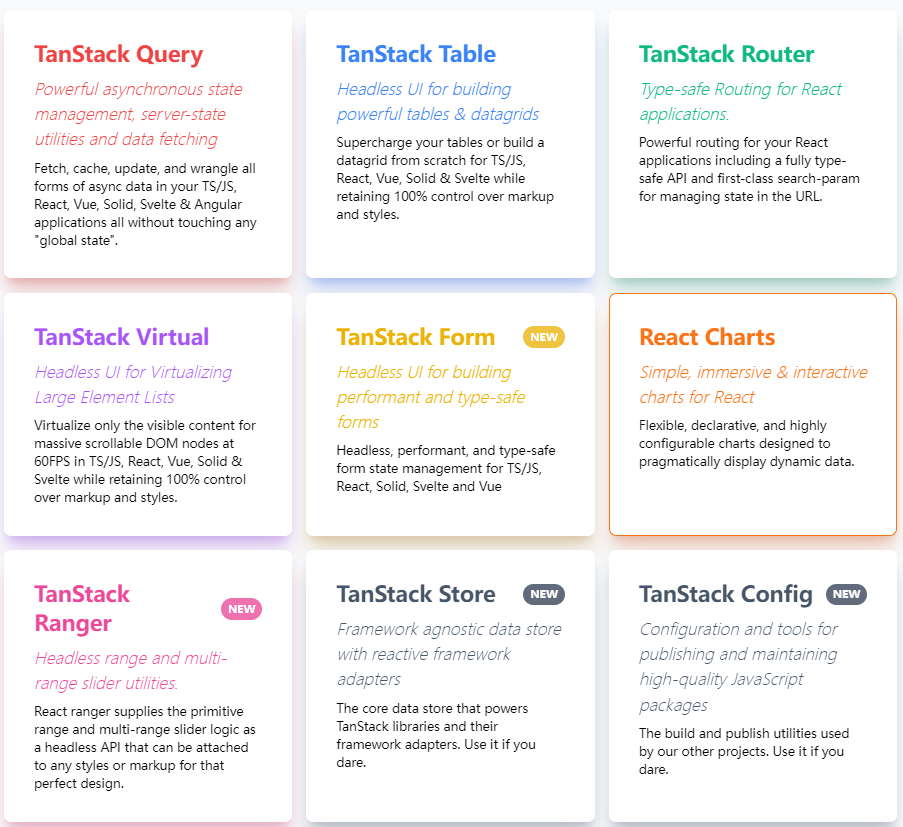
TanStack,由React Query的创造者Tanner Linsley开发的一系列工具,旨在让Web开发变得更加愉快。这些工具的一个显著特点是它们都是“无头”的(headless),这意味着你可以根据自己的需求自由定制它们,而无需处理不必要的复杂性。

TanStack系列工具

TanStack系列工具包括但不限于:

TanStack/Query(前身为React Query)

  • 用途:简化数据获取和状态管理,让应用运行得更快、更流畅。
  • 特点:通过有效管理服务器状态和缓存策略,减少不必要的数据重新获取,提高应用性能。

TanStack/Router

  • 用途:一个长期开发的路由库,可以作为React Router的直接替代品。React Router自始至终被视为客户端渲染应用的标准。
  • 特点:支持TypeScript,从Link组件到使用URL查询参数管理状态,提供全面的类型支持。TanStack Router是一个具有很大潜力的库,未来甚至有可能与Next.js和Remix竞争。

TanStack/Virtual

  • 用途:一个用于虚拟化大型列表的无头库。它不渲染任何标记,因此适用于任何样式系统和UI组件库。
  • 特点:解决大数据列表渲染性能问题,通过仅渲染视口内的项目来提高性能和响应速度。

TanStack/Table

  • 用途:另一个无头库,用于管理表格和复杂的数据网格。
  • 特点:提供了许多实用功能,如列排序、固定、过滤、分页等。

TanStack的工具集非常多样化,解决了我们在Web开发中每天面临的许多常见问题。由于其无头特性,这些工具可以轻松适用于大多数设置,允许开发者根据具体需求灵活定制。

TanStack的优势

  • 灵活性:由于其无头设计,TanStack提供了极高的灵活性,允许开发者根据自己的需求进行定制。
  • 易于集成:可以轻松地与现有的项目和技术栈集成,不论是传统的服务器渲染应用还是现代的单页面应用。
  • 强大的社区支持:由于Tanner Linsley对这些库的持续投入和优化,以及不断增长的用户基础,TanStack拥有强大的社区支持和丰富的学习资源。

总结

无论是在构建数据密集型的应用、处理复杂的路由需求、优化大型列表和表格的渲染性能,还是简化前端开发的状态管理,TanStack都提供了现代Web开发中所需的关键工具。它通过提供这些高度定制和灵活的工具,极大地提升了开发效率和用户体验,是任何希望提升Web开发流程的团队或个人的重要资源。

C++右值引用:提升性能和实现移动语义

thbcm阅读(279)

C++右值引用是C++11引入的一项重要特性,它在语言层面上提供了对临时对象和资源的优化支持。右值引用不仅可以提升程序的性能,还可以实现移动语义,避免不必要的数据拷贝。本文将深入探讨C++右值引用的概念、使用方法和其带来的好处,帮助你充分理解和应用这一重要特性。

什么是右值引用?

右值引用是C++中的一种引用类型,通过使用双引号(&&)来声明。它与传统的左值引用(使用单引号&声明)不同,右值引用可以绑定到临时对象、表达式的结果或被​std::move​转换的对象。右值引用扩展了C++的引用语义,使得开发者能够更好地管理资源和提高代码的性能。

右值引用的使用方法

使用右值引用需要遵循以下几个步骤:

声明右值引用

在变量声明时,使用双引号(&&)来声明右值引用。例如:

int&& rvalueRef = 42;

绑定到右值

右值引用只能绑定到右值,即临时对象、表达式的结果或被​std::move​转换的对象。例如:

int&& rvalueRef = 42;  // 绑定到右值42
int&& rvalueRef2 = std::move(variable);  // 绑定到通过std::move转换的对象

使用移动语义

通过使用​std::move​将左值转换为右值引用,可以实现移动语义,避免不必要的数据拷贝。例如:

std::vector<int> source;
std::vector<int> destination = std::move(source);  // 使用移动语义,避免数据拷贝

右值引用的好处

右值引用带来了以下几个重要好处:

  • 提升性能:右值引用可以避免不必要的数据拷贝,通过使用移动语义将资源从一个对象转移到另一个对象,提高程序的性能。移动语义在处理大型数据结构或资源密集型操作时尤为有用。
  • 实现移动语义:使用右值引用和移动语义,可以实现对象的高效移动,而不是进行昂贵的数据拷贝。这对于需要频繁创建、销毁或传递大型对象的情况非常有用。
  • 支持完美转发:右值引用也支持完美转发,即在函数参数传递过程中,将参数以原样转发给另一个函数。这样可以保持参数的值类别(左值或右值),避免不必要的额外拷贝。
  • 引入移动语义的标准库类型:C++标准库中的许多类型,如​std::vector​、​std::string​等,都实现了移动语义,可以通过右值引用实现高效的对象操作。这使得标准库的使用更加高效和方便。

总结

C++右值引用是一项强大的特性,它在语言层面上提供了对临时对象和资源的优化支持。通过使用右值引用,开发者可以提升程序的性能、实现移动语义、支持完美转发,并享受标准库中引入的移动语义的好处。掌握右值引用的概念和使用方法,有助于编写更高效、可维护的C++代码。然而,需要注意正确使用右值引用,并避免出现悬空引用和不安全的操作。通过合理地运用右值引用,你可以在C++中发挥其强大的潜力,提升代码性能和可读性。

反射和动态代理:灵活性与功能的对比

thbcm阅读(332)

Java反射和动态代理是Java语言中高级特性的重要组成部分。它们提供了在运行时操作类、对象和方法的能力,为开发者提供了灵活性和动态性。尽管它们都涉及到在运行时修改和操作代码,但它们的目的和应用场景有所不同。本文将深入探讨Java反射和动态代理的区别,帮助你理解它们的特点和适用情况,并正确应用于你的Java开发项目中。

Java反射

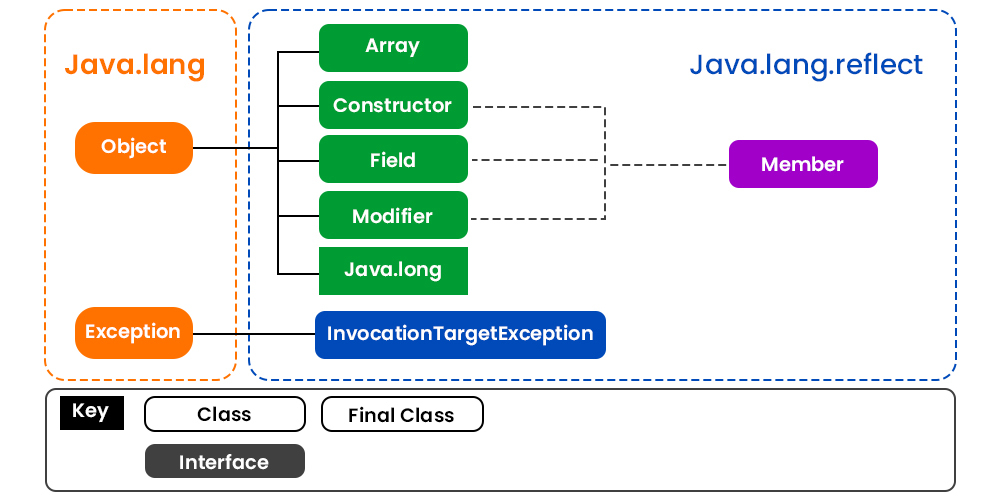
Java反射是指在运行时获取和操作类的信息,如类的属性、方法、构造函数等。它通过​java.lang.reflect​包中的类和接口实现。Java反射的主要特点包括:

  • 动态获取类信息:Java反射允许在运行时获取类的信息,如类名、父类、接口、字段、方法等。这使得开发者可以在编译时无法确定的情况下,动态地加载和使用类。
  • 动态创建对象:Java反射允许在运行时动态地创建对象,通过调用类的构造函数。这使得开发者可以根据需要在运行时创建不同类型的对象,而无需在编译时硬编码。
  • 动态调用方法:Java反射允许在运行时动态地调用类的方法,包括公共方法、私有方法和静态方法。这使得开发者可以根据需要动态地调用特定的方法,而无需在编译时确定调用。
  • 灵活性和动态性:Java反射提供了灵活性和动态性,使得开发者可以在运行时根据需要对类进行操作,而不需要在编译时固定类的结构和行为。

动态代理

Java动态代理是指在运行时创建代理对象,代理对象可以代替原始对象执行相同的操作,并可以在操作前后添加额外的逻辑。Java动态代理的主要特点包括:

  • 代理模式:Java动态代理使用代理模式,通过创建代理类来代替原始类执行操作。代理类实现了与原始类相同的接口,并将方法调用转发给原始对象,同时可以在方法调用前后添加额外的逻辑。
  • 运行时生成代理对象:Java动态代理在运行时生成代理对象,通过java.lang.reflect.Proxy类和接口实现。开发者可以指定要代理的接口,并提供一个InvocationHandler对象来处理方法调用。
  • AOP(面向切面编程):Java动态代理常用于AOP编程,通过在方法调用前后插入额外的逻辑,实现日志记录、性能监测、事务管理等横切关注点。这样可以将这些关注点从业务逻辑中分离出来,提高代码的可维护性和可重用性。
  • 代理对象的动态性:Java动态代理的代理对象是在运行时生成的,可以根据需要动态地创建不同类型的代理对象。这使得开发者可以根据不同的需求创建不同的代理对象,而无需在编译时确定代理的具体类型。

区别与适用场景

Java反射和动态代理在目的和应用场景上存在一些区别:

主要目的

  • Java反射:在运行时获取和操作类的信息,动态创建对象和调用方法。它适用于需要在运行时动态处理类和对象的情况,如框架开发、配置文件解析等。
  • Java动态代理:在运行时创建代理对象,代理对象可以代替原始对象执行相同的操作,并可以在操作前后添加额外的逻辑。它适用于AOP编程,通过在方法调用前后插入额外的逻辑,实现横切关注点的分离。

实现方式

  • Java反射:使用​java.lang.reflect​包中的类和接口来实现,在运行时获取和操作类的信息。它对于任何类都适用,但需要通过反射的方式来获取和调用类的成员。
  • Java动态代理:使用​java.lang.reflect.Proxy​类和接口来实现,在运行时生成代理对象。它要求被代理的类必须实现接口,代理对象与原始对象具有相同的接口。

功能

  • Java反射:主要用于获取和操作类的信息,动态创建对象和调用方法。它可以在运行时动态加载和使用类,提供了灵活性和动态性。
  • Java动态代理:主要用于创建代理对象,代替原始对象执行相同的操作,并可以在操作前后添加额外的逻辑。它常用于AOP编程,实现横切关注点的分离。

使用场景

  • Java反射:适用于需要在运行时动态处理类和对象的情况,例如框架开发、配置文件解析、插件系统等。它可以通过反射的方式获取和调用类的成员,实现高度灵活的操作。
  • Java动态代理:适用于AOP编程的场景,例如日志记录、性能监测、事务管理等。它通过在方法调用前后插入额外的逻辑,实现横切关注点的分离,提高代码的可维护性和可重用性。

总结

Java反射和动态代理是Java语言中强大的高级特性,它们在运行时操作类、对象和方法的能力为开发者提供了灵活性和动态性。尽管它们都涉及到在运行时修改和操作代码,但它们的目的和应用场景有所不同。通过正确理解和应用Java反射和动态代理,你可以提高代码的灵活性和可维护性,并在不同的场景中发挥它们的优势。无论是动态处理类和对象,还是实现横切关注点的分离,Java反射和动态代理都是你的强大工具。

Cupy:加速Python数值计算的神奇武器

thbcm阅读(341)

在Python中进行大规模的数值计算通常会面临性能瓶颈,特别是处理大型数据集或执行复杂算法时。为了克服这一挑战,出现了许多用于加速数值计算的库和工具。其中,Cupy作为一种高性能的GPU加速计算库,为Python开发者提供了强大的工具来利用GPU的并行计算能力,显著加快数值计算的速度。本文将介绍Cupy的特点、功能和应用场景,帮助读者理解并充分利用这个神奇的工具。

什么是Cupy?

Cupy是一个基于Numpy的开源库,旨在利用GPU进行高性能的数值计算。它提供了与Numpy类似的API,可以直接替换现有的Numpy代码,并通过GPU的并行计算能力来加速运算过程。Cupy底层使用CUDA(Compute Unified Device Architecture)编程模型,使得开发者可以轻松地利用GPU的并行计算能力。

Cupy的特点

  • 兼容性:Cupy提供了与Numpy几乎相同的API,因此现有的Numpy代码可以无缝迁移到Cupy上。这种兼容性使得使用Cupy进行GPU加速变得非常简单,开发者可以在不修改现有代码的情况下享受到性能的提升。
  • 高性能:通过利用GPU的并行计算能力,Cupy可以显著加速数值计算过程。相比于使用CPU进行计算,Cupy可以在很短的时间内处理大规模数据集和复杂算法。这使得Cupy成为处理高性能计算任务和大规模数据分析的理想选择。
  • 灵活性:Cupy提供了丰富的函数和操作符,支持广泛的数值计算任务。无论是矩阵运算、向量操作还是复杂的数学函数,Cupy都能提供高效的实现。此外,Cupy还支持自定义的核函数,使得开发者可以进一步优化和定制计算过程。
  • 可扩展性:Cupy可以与其他Python库和工具进行无缝集成。它与主流的机器学习库(如TensorFlow、PyTorch)和数据处理库(如Pandas)兼容,可以与它们配合使用,发挥出更大的威力。这种可扩展性使得Cupy在各种应用场景中都能发挥重要作用。

示例代码

以下是一个简单的Cupy示例代码,展示了如何使用Cupy库进行矩阵乘法运算:

import cupy as cp

# 创建两个随机矩阵
A = cp.random.rand(1000, 1000)
B = cp.random.rand(1000, 1000)

# 将数据移动到GPU上
A_gpu = cp.asarray(A)
B_gpu = cp.asarray(B)

# 在GPU上进行矩阵乘法运算
C_gpu = cp.matmul(A_gpu, B_gpu)

# 将结果移动回CPU
C = cp.asnumpy(C_gpu)

# 打印结果
print(C)

在这个示例中,首先使用cp.random.rand函数创建了两个随机的1000×1000的矩阵A和B。然后,通过cp.asarray函数将数据移动到GPU上,得到A_gpu和B_gpu。接下来,使用cp.matmul函数在GPU上进行矩阵乘法运算,得到结果矩阵C_gpu。最后,通过cp.asnumpy函数将结果矩阵C_gpu移回CPU,得到最终的结果矩阵C。

这个示例展示了Cupy的基本使用方法。通过利用Cupy库,可以将数值计算任务快速迁移到GPU上,利用GPU的并行计算能力加速计算过程,从而提高代码的性能和效率。

Cupy的应用场景

Cupy适用于许多需要进行大规模数值计算的场景,特别是那些对性能和效率要求较高的任务。以下是一些Cupy的应用场景:

  • 机器学习和深度学习:Cupy在机器学习和深度学习领域具有广泛的应用。通过利用GPU的并行计算能力,Cupy可以加速训练过程、模型推理和参数优化等任务。它与主流的深度学习框架(如TensorFlow和PyTorch)兼容,使得开发者可以轻松地将模型迁移到GPU上进行训练和推理。
  • 科学计算:在科学计算领域,Cupy可以加速各种数值计算任务,如线性代数运算、傅里叶变换、最优化问题等。通过利用GPU的并行计算能力,Cupy可以在较短的时间内处理大规模的数据集和复杂的算法,提高科学计算的效率。
  • 数据分析和可视化:对于需要处理大规模数据集和执行复杂数据分析的任务,Cupy可以显著加速计算过程。例如,在数据清洗、聚合、转换和可视化等任务中,Cupy可以提供高性能的实现,使得数据分析过程更加高效和快速。
  • 金融建模和风险分析:在金融领域,许多复杂的建模和分析任务需要处理大量的数据和复杂的算法。Cupy可以通过利用GPU的并行计算能力,加速金融建模和风险分析的过程,提高计算效率和准确性。
  • 计算机视觉和图像处理:计算机视觉和图像处理任务通常需要处理大规模图像数据和复杂的图像算法。Cupy可以通过利用GPU的并行计算能力,加速图像处理任务,例如图像滤波、特征提取和目标检测等,提高计算速度和算法效果。

总结

Cupy作为一种高性能的GPU加速计算库,为Python开发者提供了强大的工具来加速数值计算过程。通过利用GPU的并行计算能力,Cupy可以显著提高数值计算的速度,适用于各种需要处理大规模数据集和复杂算法的应用场景。无论是机器学习、科学计算、数据分析还是金融建模,Cupy都可以成为加速计算的神奇武器,帮助开发者提升效率、加快创新速度。因此,学习和掌握Cupy将对Python开发者来说是一项重要而有意义的投资。

React Native:跨平台移动应用开发的新时代

thbcm阅读(281)

移动应用开发已经成为现代技术领域的重要组成部分。为了满足不同平台的需求,开发人员通常需要编写多个版本的应用代码。然而,React Native的出现改变了这一局面。作为一种基于JavaScript的移动应用开发框架,React Native在开发效率和跨平台性方面取得了巨大的突破。本文将介绍React Native的基本概念、特点以及为什么它成为许多开发人员选择的首选工具。

什么是React Native?

React Native是由Facebook开发并开源的移动应用开发框架。它基于React框架,使用JavaScript和React的组件模型,允许开发人员使用相同的代码库构建原生移动应用。React Native的最大特点是跨平台性。开发人员可以使用相同的代码库构建iOS和Android应用,大大减少开发工作量。React Native通过将JavaScript代码解释为原生组件调用,实现了高性能的跨平台开发体验。

React Native的优势

  • 快速开发:React Native采用热重载技术,开发人员可以在应用运行时实时查看代码更改的效果,极大地提高了开发效率。此外,React Native还提供了丰富的UI组件库,可以快速构建漂亮的用户界面。
  • 原生性能:React Native应用在运行时会将JavaScript代码转换为原生组件调用,因此具备接近原生应用的性能。这是因为React Native并非使用Web View来渲染应用,而是使用原生组件,实现了更高的性能和更好的用户体验。
  • 社区和生态系统:React Native拥有庞大的开发者社区和活跃的生态系统。开发人员可以轻松找到各种开源组件、库和工具,加速开发过程。此外,React Native还有强大的支持和文档资源,使开发人员能够快速解决问题和学习新技术。

React Native的应用领域

React Native适用于各种移动应用开发场景,包括但不限于:

  • 社交媒体应用
  • 电子商务应用
  • 新闻和媒体应用
  • 音乐和视频应用
  • 内容发布平台
  • 健身和健康应用

总结

React Native作为一种跨平台移动应用开发框架,为开发人员提供了快速开发、原生性能和强大的生态系统等优势。通过使用React Native,开发人员可以使用相同的代码库构建iOS和Android应用,大大提高开发效率。随着其不断发展和成熟,React Native已成为许多开发人员选择的首选工具,为移动应用开发带来了新的时代。

ZooKeeper:分布式协调服务的关键组件

thbcm阅读(283)

在分布式系统中,协调和管理各个节点之间的通信和状态同步是一项复杂而关键的任务。为了解决这个问题,Apache ZooKeeper(以下简称ZooKeeper)应运而生。作为一个高性能的分布式协调服务,ZooKeeper提供了可靠的数据同步和节点管理功能,被广泛应用于分布式系统的开发和运维。本文将介绍ZooKeeper的基本概念、特点和应用场景,帮助读者更好地理解和使用这个重要的分布式系统组件。

什么是ZooKeeper?

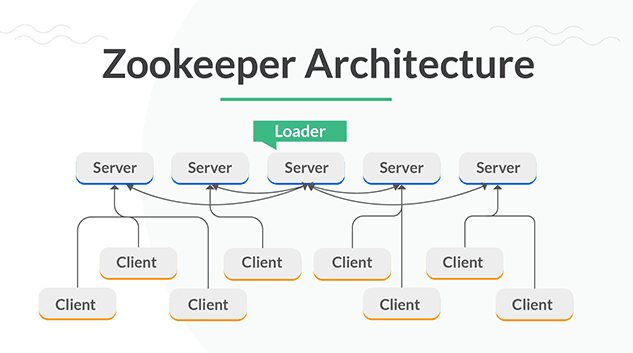
ZooKeeper是一个开源的分布式协调服务,旨在帮助开发人员构建可靠的分布式系统。它提供了一个分布式文件系统的抽象,用于存储和管理数据,并提供高性能的读写操作。ZooKeeper使用ZAB(ZooKeeper Atomic Broadcast)协议来保证数据的一致性和可靠性,可以容忍节点故障和网络分区等异常情况。

ZooKeeper的特点

  • 高可靠性与一致性:ZooKeeper通过ZAB协议来保证数据的一致性和可靠性。ZAB协议使用了类似于Paxos算法的机制,在分布式系统中实现了强一致性的数据复制和广播。这使得ZooKeeper能够容忍节点故障,并且在网络分区恢复后,可以保证数据的一致性。
  • 简单的数据模型和操作接口:ZooKeeper提供了一个类似于文件系统的数据模型,称为ZNode。每个ZNode都可以存储一个小型的数据对象,并可以设置触发器和监听器来监控数据的变化。用户可以使用基本的CRUD(创建、读取、更新、删除)操作来对ZNode进行操作,使得数据的管理和访问变得简单和直观。
  • 快速的读写性能:ZooKeeper使用内存中的数据结构来存储数据,并通过持久化日志来保证数据的持久性。这种设计使得ZooKeeper具有快速的读写性能。同时,ZooKeeper还支持数据的顺序访问,可以按照写入的顺序来读取数据,方便开发人员实现有序的操作。
  • 分布式协调和同步功能:ZooKeeper提供了一系列的分布式协调和同步功能,如分布式锁、选举、通知机制等。这些功能可以帮助开发人员解决分布式系统中的共享资源访问、领导者选举、配置管理等问题。通过使用这些功能,开发人员可以更轻松地构建可靠和高效的分布式系统。

ZooKeeper的应用场景

ZooKeeper广泛应用于各种分布式系统和应用场景,包括但不限于以下几个方面:

  • 分布式系统协调:ZooKeeper可以用于分布式系统中的节点管理、领导者选举、任务分配等协调任务。通过使用ZooKeeper提供的分布式锁和通知机制,可以实现分布式系统的协调和同步,确保系统的正确运行和一致性。
  • 分布式数据共享:ZooKeeper提供了可靠的数据存储和访问功能,可以用于分布式系统中的数据共享和访问控制。开发人员可以将数据存储在ZooKeeper的ZNode中,并使用ZooKeeper提供的权限控制机制来限制对数据的访问。这使得不同节点之间可以方便地共享数据,并且能够保持数据的一致性和可靠性。
  • 分布式配置管理:在分布式系统中,配置管理是一个重要的任务。ZooKeeper提供了可靠的配置管理功能,可以用于存储和管理分布式系统的配置信息。开发人员可以将配置信息存储在ZooKeeper中,并使用ZooKeeper的监听器机制来监控配置的变化,从而实现动态配置更新和系统的自适应。
  • 分布式队列和通知:ZooKeeper可以用作分布式系统中的队列和通知机制。开发人员可以使用ZooKeeper的顺序ZNode来实现有序的消息队列,或者使用ZooKeeper的临时ZNode和监听器机制来实现分布式事件通知。这些功能可以帮助开发人员构建可靠的消息系统和实现分布式任务调度。

总结

ZooKeeper作为一个高性能的分布式协调服务,扮演着分布式系统中重要的角色。它提供了可靠的数据同步和节点管理功能,简化了分布式系统的开发和运维。通过使用ZooKeeper,开发人员可以构建可靠、高效和一致的分布式系统。随着分布式系统的普及和需求的增加,ZooKeeper将继续发挥着重要的作用,并成为分布式系统开发的关键组件之一。

Yagmail:简化电子邮件发送

thbcm阅读(285)

电子邮件在现代通信中扮演着重要的角色,而在Python开发中,发送电子邮件的需求也非常常见。为了简化Python中的电子邮件发送过程,Yagmail库应运而生。Yagmail是一个强大而易于使用的Python库,提供了简洁的API和许多便捷的功能,使开发人员能够轻松地通过Gmail发送电子邮件。本文将介绍Yagmail库的基本特性和使用方法,以及它在实际应用中的优势。

Yagmail简介

Yagmail是一个基于Python的第三方库,旨在简化通过Gmail发送电子邮件的过程。它提供了一个高级的、面向对象的API,使电子邮件的发送变得简单而直观。Yagmail库内部使用了OAuth2协议进行身份验证,确保了安全性和可靠性。

基本特性和用法

  1. 安装和导入:需要安装Yagmail库,可以使用pip命令进行安装,并在需要使用的Python脚本中导入yagmail模块。
  2. 配置Gmail账号:在使用Yagmail之前,需要对Gmail账号进行配置。可以通过Yagmail提供的​yagmail.register()​方法来配置账号,该方法将引导用户进行身份验证和授权操作。
  3. 发送电子邮件:一旦Gmail账号配置完成,就可以使用Yagmail库发送邮件了。使用​yagmail.SMTP()​方法创建一个SMTP对象,并传入配置好的Gmail账号信息。然后,使用SMTP对象的send()方法发送电子邮件,指定收件人、主题和正文等必要参数。
  4. 附件和内嵌图片:Yagmail还提供了方便的方法来添加附件和内嵌图片到邮件中。可以使用SMTP对象的​attachment()​方法添加附件文件,并使用​inline()​方法添加内嵌图片。
  5. HTML格式邮件:使用Yagmail库发送HTML格式的电子邮件非常简单。只需在​send()​方法中设置参数​html=True​,并将HTML内容作为邮件的正文即可。

示例代码

import yagmail

# 安装和导入
# 请确保已经通过pip安装了Yagmail库

# 配置Gmail账号
yag = yagmail.SMTP('your_email@gmail.com')

# 发送电子邮件
recipient = 'recipient@example.com'
subject = 'Hello from Yagmail'
content = 'This is the body of the email.'
yag.send(to=recipient, subject=subject, contents=content)

# 附件和内嵌图片
attachment_path = 'path_to_attachment_file.pdf'
inline_image_path = 'path_to_inline_image.png'

yag.send(to=recipient, subject=subject, contents=content, attachments=attachment_path, inline=inline_image_path)

# HTML格式邮件
html_content = '<h1>Hello from Yagmail</h1><p>This is the <b>HTML</b> body of the email.</p>'

yag.send(to=recipient, subject=subject, contents=html_content, html=True)

以上代码展示了使用Yagmail库发送电子邮件的基本用法。首先,需要配置你的Gmail账号,然后使用yagmail.SMTP()方法创建一个SMTP对象。之后,可以使用SMTP对象的send()方法发送电子邮件,指定收件人、主题和正文等必要参数。如果需要添加附件和内嵌图片,可以通过attachmentsinline参数进行设置。如果要发送HTML格式的邮件,可以将html参数设置为True,并将HTML内容作为邮件的正文。

Yagmail的优势和应用场景

  • 简洁而直观的API:Yagmail提供了简洁而直观的API,使得发送电子邮件变得非常容易。开发人员可以快速上手,减少了繁琐的配置和操作步骤。
  • 支持附件和图片:Yagmail提供了便捷的方法来添加附件和内嵌图片,使得构建富媒体的邮件变得简单而灵活。
  • OAuth2身份验证:Yagmail使用OAuth2协议进行身份验证,确保了邮件发送过程的安全性和可靠性。
  • 自动化任务通知:Yagmail可以用于自动化任务的通知,例如在任务完成或出错时,通过电子邮件发送通知给相关人员。
  • 应用程序报警和监控:通过Yagmail库,开发人员可以轻松地实现应用程序的报警和监控功能,及时获取关键信息并及时采取行动。

总结

Yagmail是一个强大而易于使用的Python库,通过简洁的API和许多便捷的功能,使开发人员能够轻松地通过Gmail发送电子邮件。它的简单性、支持附件和图片、OAuth2身份验证等特点,使得Yagmail在实际应用中具有广泛的用途,如自动化任务通知、应用程序报警和监控等。通过使用Yagmail库,开发人员可以提高工作效率,简化电子邮件发送过程,并实现更好的用户体验。

RabbitMQ:探索神奇的延迟队列实现机制

thbcm阅读(258)

在消息队列系统中,延迟队列是一项重要的功能,它允许开发人员按照指定的延迟时间发送消息,并在延迟时间到达后将消息投递给消费者。RabbitMQ作为一个可靠的消息队列中间件,提供了一种简单而有效的方式来实现延迟队列。本文将深入探究RabbitMQ的延迟队列实现机制,介绍其基本原理和使用方法,帮助开发人员在实际应用中灵活运用延迟队列。

延迟队列基本原理

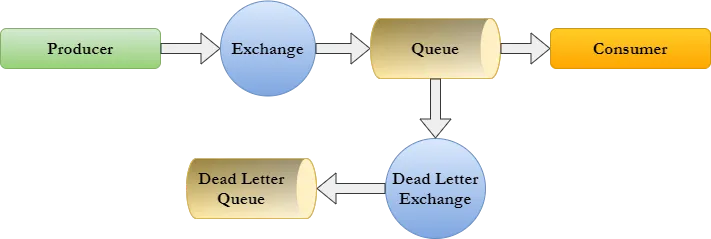
RabbitMQ的延迟队列实现基于消息的TTL(Time To Live)属性和死信队列(Dead Letter Queue)机制。

  • 消息的TTL属性:通过设置消息的TTL属性,可以指定消息在队列中的存活时间。当消息的TTL时间到达后,如果消息还未被消费者消费,则会被标记为”dead”状态。
  • 死信队列机制:当消息被标记为”dead”状态时,RabbitMQ会将该消息路由到预定义的死信队列中。死信队列是一个特殊的队列,用于存储那些无法被消费的消息。

延迟队列实现步骤

要使用RabbitMQ实现延迟队列,需要按照以下步骤进行配置和设置:

  1. 创建延迟队列:首先,创建一个普通的队列,并设置队列的消息TTL属性为所需的延迟时间。
  2. 创建死信队列:接下来,创建一个死信队列,并将普通队列的”dead”消息路由到死信队列。
  3. 配置死信队列消费者:为死信队列创建一个消费者,用于处理延迟时间到达的消息。这个消费者可以执行所需的业务逻辑操作。
  4. 发送延迟消息:最后,将需要延迟的消息发送到普通队列中。消息将等待指定的延迟时间后,如果没有被消费者消费,则会自动转发到死信队列。

延迟队列的应用场景

延迟队列在许多应用场景中非常有用,例如:

  • 订单超时处理:可以使用延迟队列来处理订单超时情况。将订单消息发送到延迟队列,设置适当的延迟时间,如果订单在规定时间内未支付,则将其标记为”dead”状态并进行相应处理。
  • 定时任务调度:延迟队列还可以用于定时任务调度。将需要执行的任务消息发送到延迟队列,根据任务的延迟时间,将其转发到死信队列,并由消费者执行实际的任务操作。
  • 消息重试机制:延迟队列可以应用于消息重试机制。如果某个消息处理失败,可以将该消息发送到延迟队列,并设置一定的延迟时间后进行重试。

总结

RabbitMQ的延迟队列实现机制基于消息的TTL属性和死信队列机制,通过合理的配置和设置,可以轻松实现延迟队列的功能。延迟队列在订单处理、定时任务调度和消息重试等应用场景中具有广泛的应用价值。通过灵活运用延迟队列,开发人员可以提高系统的可靠性、稳定性和可扩展性,为应用程序带来更好的用户体验。

二分查找算法:高效搜索有序数据的利器

thbcm阅读(296)

在计算机科学中,搜索是一项基本而重要的操作。对于有序数据,二分查找算法是一种高效的搜索方法。本文将介绍二分查找算法的原理、实现以及其在实际应用中的优势,帮助读者理解和应用这一常用的搜索算法。

什么是二分查找算法?

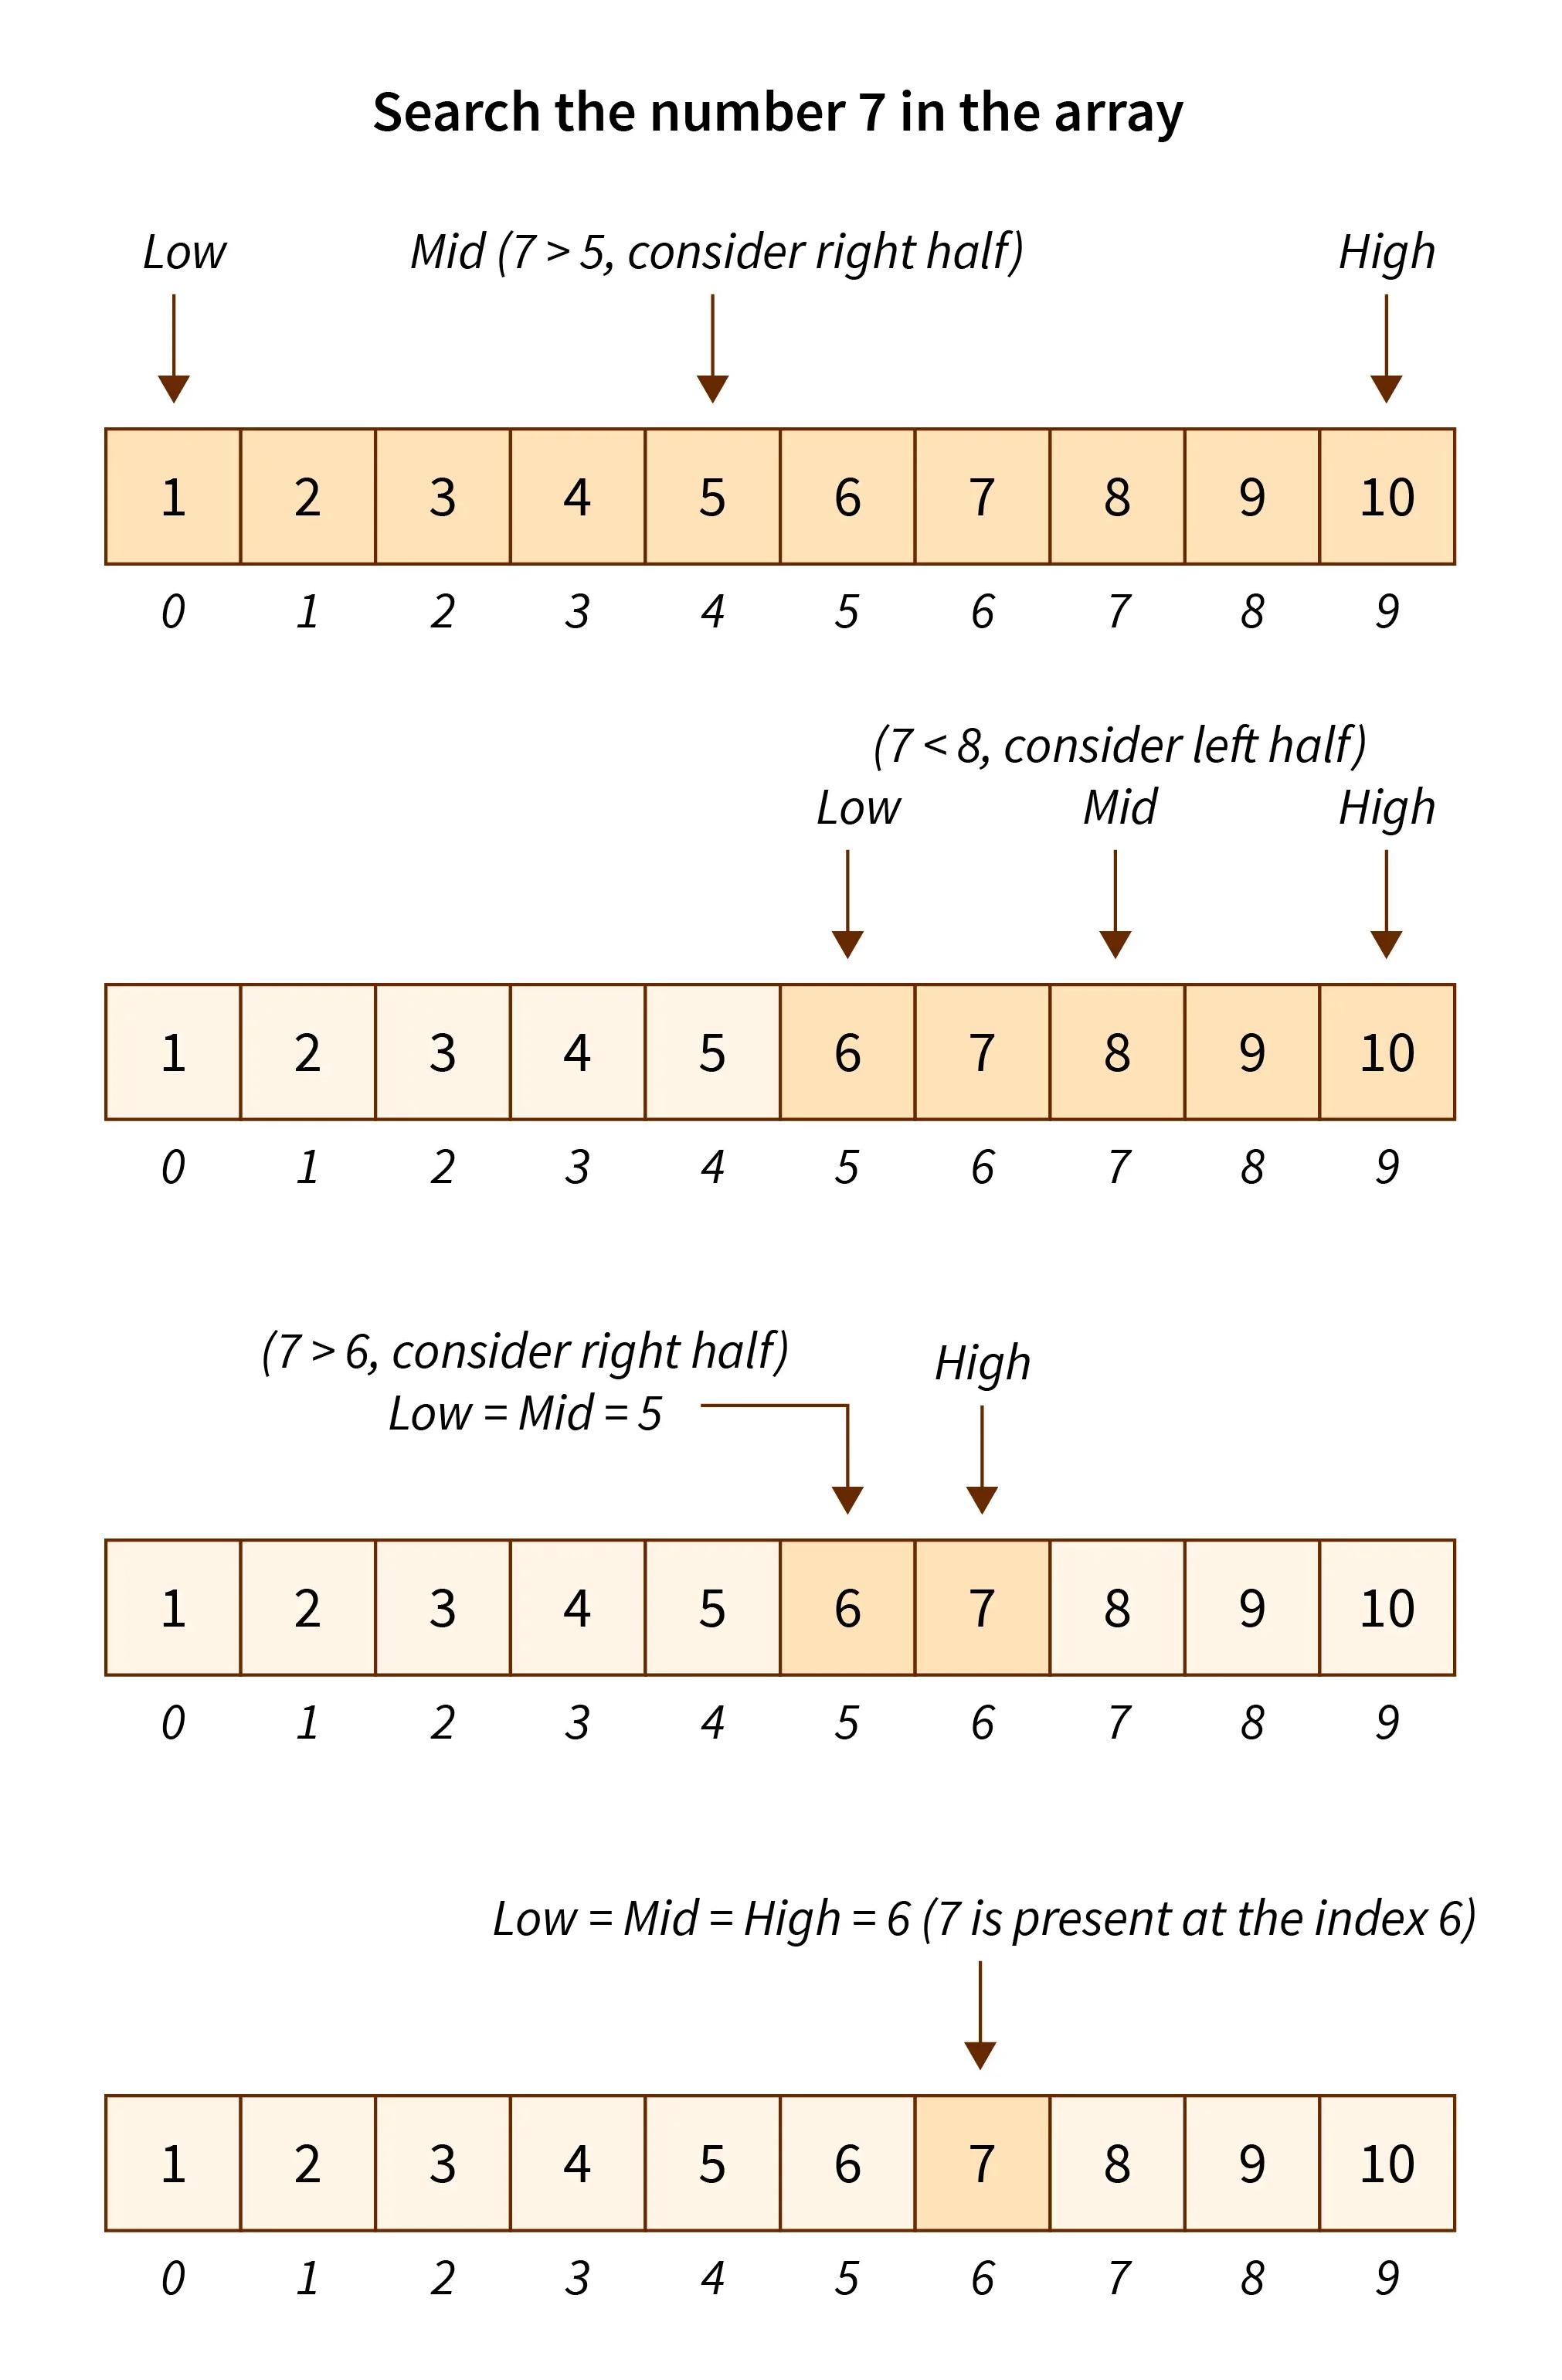
二分查找算法,也称为折半查找算法,是一种在有序数据集合中查找目标值的算法。它通过将目标值与数据集合的中间元素进行比较,从而将搜索范围缩小一半。如果目标值等于中间元素,则找到了目标;如果目标值小于中间元素,则在左半部分继续查找;如果目标值大于中间元素,则在右半部分继续查找。通过重复这个过程,最终可以找到目标值或确定目标值不存在于数据集合中。

二分查找算法的实现

public class BinarySearch {
    public static int binarySearch(int[] arr, int target) {
        int left = 0;
        int right = arr.length - 1;

        while (left <= right) {
            int mid = left + (right - left) / 2;

            if (arr[mid] == target) {
                return mid;
            } else if (arr[mid] < target) {
                left = mid + 1;
            } else {
                right = mid - 1;
            }
        }

        return -1;
    }
}

binarySearch方法中,我们使用了两个指针leftright来表示搜索范围的左右边界。在每次循环中,计算中间元素mid并与目标值进行比较。如果中间元素等于目标值,则找到了目标,返回其索引。如果中间元素小于目标值,则目标值可能在右半部分,将left指针更新为mid + 1。如果中间元素大于目标值,则目标值可能在左半部分,将right指针更新为mid - 1。通过不断缩小搜索范围,最终可以找到目标值或确定目标值不存在。

二分查找算法的优势

二分查找算法具有以下几个优势:

  • 高效的时间复杂度:二分查找算法的时间复杂度为O(log n),其中n是数据集合的大小。相比于线性搜索算法的O(n)时间复杂度,二分查找算法在大数据集合中的搜索效率更高。它通过每次将搜索范围缩小一半,快速逼近目标值,减少了搜索的次数。
  • 适用于有序数据:二分查找算法要求数据集合是有序的,但正是由于这一特性,它才能发挥出高效的搜索能力。在实际应用中,许多数据集合都是有序的,如数组、数据库索引等。二分查找算法可以快速定位目标值所在的位置,提高搜索效率。
  • 简单而易实现:二分查找算法的实现相对简单,只需熟悉基本的循环和条件判断即可。它不依赖于复杂的数据结构或算法思想,使得开发人员能够轻松理解和应用。

二分查找算法的应用

二分查找算法在许多实际应用中得到广泛应用,包括但不限于以下几个方面:

  • 数组搜索:对于有序数组,可以使用二分查找算法快速搜索目标值的位置。例如,在大型的升序数组中查找特定元素或确定元素是否存在。
  • 数据库索引:数据库中的索引通常是有序的,通过使用二分查找算法可以快速定位满足特定条件的数据行。这提高了数据库查询的效率,减少了搜索时间。
  • 字典搜索:在字典或词典中,单词通常是按字母顺序排列的。使用二分查找算法可以快速找到特定单词,或者在给定前缀的情况下找到以该前缀开头的所有单词。
  • 游戏开发:在游戏开发中,二分查找算法可以应用于各种场景,如查找特定物品的位置、确定游戏进度等。通过快速查找和定位,可以提供更好的游戏体验。

总结

二分查找算法是一种高效且常用的搜索算法,适用于有序数据集合中的搜索操作。它通过每次将搜索范围缩小一半,快速逼近目标值,具有较低的时间复杂度和简单的实现方式。在实际应用中,二分查找算法在数组搜索、数据库索引、字典搜索和游戏开发等领域发挥着重要作用。通过了解和掌握二分查找算法,我们可以更高效地搜索和处理有序数据,提高算法的效率和性能。

联系我们