PDF轻松搞定:Django高效生成指南

thbcm阅读(336)

Django是一个强大的Python web框架,它提供了大量的工具和功能使开发过程更高效和方便。其中一个有用的功能是,它可以帮助开发人员方便快速地生成PDF文件。本文将详细描述如何在Django中生成PDF文件,并提供一些示例。
一、使用第三方库:ReportLab

ReportLab是一个用于生成PDF文档的强大Python库。要在Django项目中使用ReportLab,首先需要安装该库:

pip install reportlab

接下来,创建一个Django视图,使用ReportLab生成PDF文件:

from django.http import FileResponse
from reportlab.pdfgen import canvas

def generate_pdf(request):
    response = FileResponse(content_type='application/pdf')
    response['Content-Disposition'] = 'attachment; filename="example.pdf"'

    buffer = response.content
    p = canvas.Canvas(buffer)

    # 在PDF中添加内容
    p.drawString(100, 100, "Hello, this is a PDF generated with ReportLab.")

    p.showPage()
    p.save()

    return response

二、使用第三方库:WeasyPrint

WeasyPrint是一个现代化的HTML和CSS到PDF转换库,它可以将Django模板转换为PDF文件。

首先,安装WeasyPrint:

pip install WeasyPrint

然后,创建Django视图来生成PDF:

from django.http import FileResponse
from django.template.loader import get_template
from weasyprint import HTML

def generate_pdf(request):
    template = get_template('your_template.html')
    html_content = template.render({'context_data': 'example data'})

    pdf_file = HTML(string=html_content).write_pdf()
    response = FileResponse(pdf_file, content_type='application/pdf')
    response['Content-Disposition'] = 'attachment; filename="example.pdf"'

    return response

三、使用Django自带的PDF支持:xhtml2pdf

xhtml2pdf是一个Django应用,它允许通过Django模板生成PDF文件。

首先,安装xhtml2pdf:

pip install xhtml2pdf

然后,在Django项目的INSTALLED_APPS中添加xhtml2pdf,并创建一个Django视图:

from django.http import HttpResponse
zongjom django.template.loader import get_template
from xhtml2pdf import pisa

def generate_pdf(request):
    template_path = 'your_template.html'
    template = get_template(template_path)
    context = {'context_data': 'example data'}

    html = template.render(context)
    response = HttpResponse(content_type='application/pdf')
    response['Content-Disposition'] = 'attachment; filename="example.pdf"'

    pisa_status = pisa.CreatePDF(html, dest=response)

    if pisa_status.err:
        return HttpResponse('PDF creation failed', content_type='text/plain')
    
    return responsezo

总结

本文章探讨了在Django项目中生成PDF文件的三种方法,每种方法都有其独特的优势。无论选择哪种方法,开发者都能够根据项目需求和个人偏好来生成高质量的PDF文件。这些方法提供了灵活性和可扩展性,使得在Django项目中满足生成PDF文件的需求变得相对简便。

如果你对编程知识和相关职业感兴趣,欢迎访问编程狮官网(https://www.w3cschool.cn/)。在编程狮,我们提供广泛的技术教程、文章和资源,帮助你在技术领域不断成长。无论你是刚刚起步还是已经拥有多年经验,我们都有适合你的内容,助你取得成功。
Go语言结构体内存分配:精准优化技巧解析

thbcm阅读(276)

在Go语言的舞台上,结构体是数据组织的重要工具,而其内存分配的优化技巧更是直接关系到程序性能的提升。本文将深入研究几项巧妙的技巧,助您在Go中精准优化结构体的内存分配,从而提高代码的性能和效率。

一、避免内存对齐浪费

Go语言的内存分配器会进行内存对齐,确保数据结构在内存中的布局是按照一定规则进行的。但有时候,结构体的字段顺序会导致内存对齐浪费。可以通过字段重新排列,将类型相同的字段放在一起,减小内存对齐所带来的空间浪费。

// 不优化的结构体
type UnoptimizedStruct struct {
    A int32
    B bool
    C float64
}

// 优化后的结构体
type OptimizedStruct struct {
    A int32
    C float64
    B bool
}

二、使用指针而非值类型:

在结构体中使用指针而非值类型字段,可以减小结构体的大小,从而减小每次复制的内存开销。但请注意,这样做可能会导致额外的指针解引用开销。

// 不优化的结构体
type UnoptimizedStruct struct {
    Data []byte
}

// 优化后的结构体
type OptimizedStruct struct {
    Data *[]byte
}

三、避免空字段的内存浪费

结构体中的空字段会占据一定的内存空间,可以通过将这些字段移动到结构体的末尾,减小内存浪费。

// 不优化的结构体
type UnoptimizedStruct struct {
    A int32
    B string
    C interface{}
}

// 优化后的结构体
type OptimizedStruct struct {
    A int32
    B string
    // C移到结构体末尾
    C interface{}
}

四、使用内嵌结构体

内嵌结构体可以通过嵌套字段的方式减小结构体的大小。这种方式也可以避免结构体字段的命名冲突,提高代码的可读性。

// 不优化的结构体
type UnoptimizedStruct struct {
    A int32
    B string
}

// 优化后的结构体
type OptimizedStruct struct {
    A int32
    B string
    // 使用内嵌结构体
    EmbeddedStruct
}

type EmbeddedStruct struct {
    C float64
}

五、使用sync.Pool减少内存分配

在一些需要频繁创建和销毁的结构体场景中,使用​sync.Pool​可以缓存并重复使用先前分配的对象,降低内存分配和垃圾回收的开销。

var structPool = sync.Pool{
    New: func() interface{} {
        return &MyStruct{}
    },
}

// 获取对象
obj := structPool.Get().(*MyStruct)

// 使用对象

// 释放对象
structPool.Put(obj)

总结

通过重新排列字段、合理使用指针、避免内存对齐浪费以及使用sync.Pool等巧妙技巧,我们能够在Go语言中高效地优化结构体的内存分配。这些方法不仅提高了程序的性能,还使代码更为精简和易读。通过深刻理解和应用这些技巧,您将能够更好地驾驭Go语言的内存管理,使程序在运行时更为高效。

如果你对编程知识和相关职业感兴趣,欢迎访问编程狮官网(https://www.w3cschool.cn/)。在编程狮,我们提供广泛的技术教程、文章和资源,帮助你在技术领域不断成长。无论你是刚刚起步还是已经拥有多年经验,我们都有适合你的内容,助你取得成功。
C++ Tuple探秘:多元数据组的精妙应用

thbcm阅读(308)

在C++的世界中,
tuple 犹如一位神奇的组织者,能够将不同类型的数据整齐有序地安排在一起。本文将深入研究
tuple 的基本概念、灵活初始化方式以及其高级特性,为您揭示 C++ 中这个强大而多才的数据结构。

Tuple的基本概念

tuple 是C++11标准引入的一种数据结构,允许将多个值组合在一起,形成一个逻辑单元。tuple 可以包含不同类型的元素,允许通过索引或解构(std::get 或结构绑定)的方式访问其中的元素。

创建和初始化Tuple

#include <tuple>
#include <iostream>

int main() {
    // 创建一个tuple
    std::tuple<int, double, std::string> myTuple;

    // 初始化tuple
    myTuple = std::make_tuple(42, 3.14, "Hello");

    // 或者直接初始化
    std::tuple<int, double, std::string> anotherTuple = std::make_tuple(10, 2.71, "World");

    // 访问tuple中的元素
    std::cout << std::get<0>(myTuple) << std::endl; // 输出:42
    std::cout << std::get<1>(myTuple) << std::endl; // 输出:3.14
    std::cout << std::get<2>(myTuple) << std::endl; // 输出:Hello

    return 0;
}

结构绑定与tuple的解构

#include <tuple>
#include <iostream>

int main() {
    // 创建一个tuple
    std::tuple<int, double, std::string> myTuple = std::make_tuple(42, 3.14, "Hello");

    // 结构绑定(C++17及以上)
    auto [first, second, third] = myTuple;

    // 访问元素
    std::cout << first << std::endl;  // 输出:42
    std::cout << second << std::endl; // 输出:3.14
    std::cout << third << std::endl;  // 输出:Hello

    return 0;
}

Tuple的高级应用

  • 返回多个值
    #include <tuple>
    #include <iostream>
    
    std::tuple<int, double> getValues() {
        return std::make_tuple(42, 3.14);
    }
    
    int main() {
        auto [a, b] = getValues();
        std::cout << "a: " << a << ", b: " << b << std::endl; // 输出:a: 42, b: 3.14
    
        return 0;
    }
    
  • 比较tuple:
    #include <tuple>
    #include <iostream>
    
    int main() {
        std::tuple<int, double, std::string> tuple1 = std::make_tuple(42, 3.14, "Hello");
        std::tuple<int, double, std::string> tuple2 = std::make_tuple(42, 3.14, "World");
    
        if (tuple1 == tuple2) {
            std::cout << "Tuples are equal." << std::endl;
        } else {
            std::cout << "Tuples are not equal." << std::endl;
        }
    
        return 0;
    }
    

Tuple的注意事项

  • tuple​的长度是固定的,一旦创建,就不能再添加或删除元素。
  • 对于大多数应用场景,tuple 提供了方便和灵活性,但在一些复杂的数据结构中可能不如结构体或类清晰。

总结

通过学习和理解 tuple 的使用方法,我们掌握了一种在C++中处理多元数据组的优雅方式。结合结构绑定的引入,tuple 提供了一种更为直观的方式来处理多值返回等场景。在实际应用中,我们可以根据具体情况选择 tuple 或其他数据结构,以确保代码既高效又易读。 C++ 中的 tuple,如同编程中的魔法,为我们的代码增添了不少神奇。

如果你对编程知识和相关职业感兴趣,欢迎访问编程狮官网(https://www.w3cschool.cn/)。在编程狮,我们提供广泛的技术教程、文章和资源,帮助你在技术领域不断成长。无论你是刚刚起步还是已经拥有多年经验,我们都有适合你的内容,助你取得成功。
GROM:Go语言驾驭数据库的ORM利器

thbcm阅读(407)

在Go语言的生态系统中,ORM(对象关系映射)框架是处理数据库操作的重要工具。GROM作为一款开源的Go语言ORM框架,为开发者提供了便捷的数据库操作方式。本文将深入介绍GROM的基本概念、特性以及如何在Go应用中使用GROM进行数据库操作。

GROM简介

GROM是由Go语言社区开发的一款强大的ORM框架,用于简化数据库操作和数据模型的处理。它支持多种数据库引擎,包括MySQL、PostgreSQL、SQLite等,为Go语言开发者提供了一致的API,使数据库操作更加直观和高效。

GROM的基本概念

  • 模型(Model): 在GROM中,模型是映射到数据库表的结构体。通过在结构体中定义字段,GROM能够自动创建数据库表和进行字段映射。
  • 关联关系(Association): GROM支持各种关联关系,包括一对一、一对多和多对多。这使得在处理复杂的数据关系时变得更加方便。
  • 钩子函数(Hooks): GROM允许在模型的生命周期中注册钩子函数,如在创建、更新、删除等操作前后执行特定逻辑。

GROM的特性

  • 数据库迁移(Migration): GROM提供了数据库迁移工具,能够帮助开发者管理数据库模式的变更,保证数据库与代码的同步。
  • 预加载(Preloading): GROM支持预加载相关数据,避免了N+1查询问题,提高了查询效率。
  • 事务支持: GROM允许开发者使用事务来保证一系列数据库操作的原子性,确保数据的一致性。

示例代码

package main

import (
	"fmt"
	"gorm.io/driver/sqlite"
	"gorm.io/gorm"
)

// 定义模型
type User struct {
	gorm.Model
	Name  string
	Email string
}

func main() {
	// 连接数据库
	db, err := gorm.Open(sqlite.Open("test.db"), &gorm.Config{})
	if err != nil {
		panic("无法连接数据库")
	}
	
	// 执行迁移,自动创建表
	db.AutoMigrate(&User{})

	// 创建用户
	user := User{Name: "John", Email: "john@example.com"}
	db.Create(&user)

	// 查询所有用户
	var users []User
	db.Find(&users)
	fmt.Println(users)

	// 查询特定用户
	var foundUser User
	db.First(&foundUser, "name = ?", "John")
	fmt.Println(foundUser)
}

总结

GROM作为Go语言中的一款强大ORM框架,为开发者提供了便捷、高效的数据库操作方式。其丰富的特性、简洁的API以及跨数据库的支持,使得在Go应用中使用ORM变得更加轻松。随着GROM的不断发展和社区支持,它将继续在Go语言开发中发挥着重要的作用,为开发者提供更好的数据库操作体验。

如果你对编程知识和相关职业感兴趣,欢迎访问编程狮官网(https://www.w3cschool.cn/)。在编程狮,我们提供广泛的技术教程、文章和资源,帮助你在技术领域不断成长。无论你是刚刚起步还是已经拥有多年经验,我们都有适合你的内容,助你取得成功。

MVC架构与DDD架构的较量:区别与优势解析

thbcm阅读(341)

在软件开发领域中,DDD(领域驱动设计)架构和MVC(Model-View-Controller)架构是两种常见的架构模式,它们各自具有独特的特点和优势。本文将深入探讨DDD架构和MVC架构之间的区别,并分析它们在实际应用中的适用性和优势。

MVC架构简介

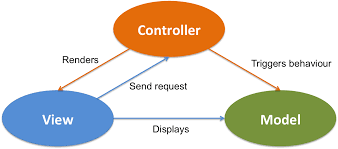
MVC架构是一种软件设计模式,将应用程序分为三个核心组件:模型(Model)、视图(View)和控制器(Controller)。模型负责处理数据逻辑,视图负责用户界面展示,控制器负责接收用户输入并作出相应的响应。

DDD架构简介

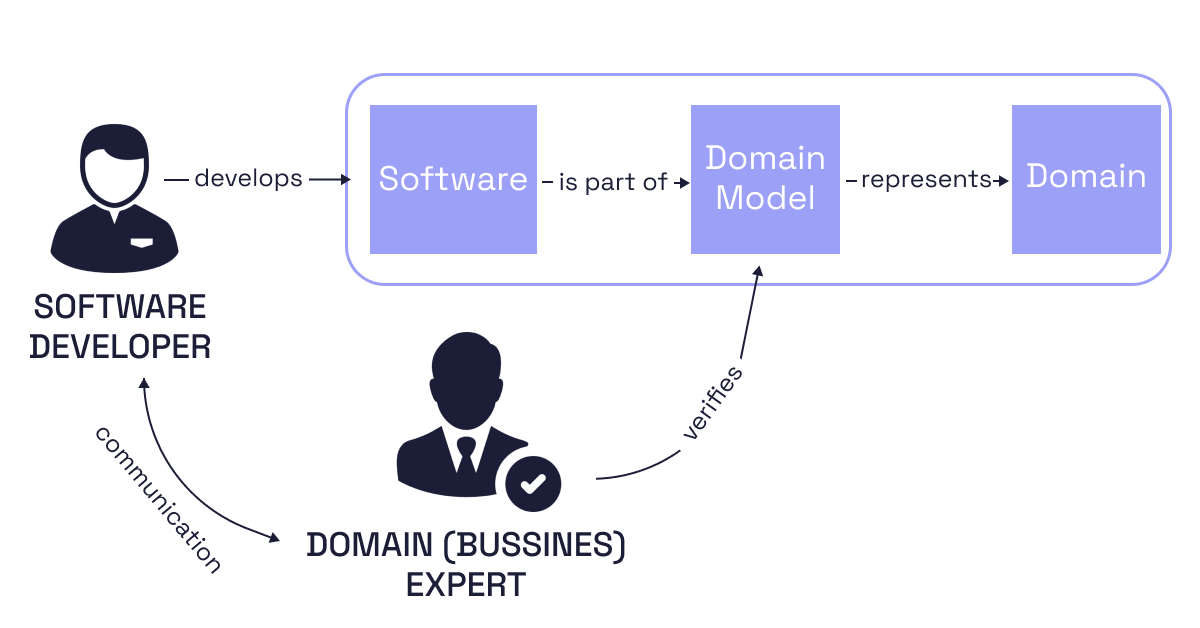
DDD架构是一种软件设计方法,将领域模型作为设计的核心。它强调领域模型的重要性,将业务逻辑和领域知识体现在代码中,以便更好地满足业务需求。

区别与对比

  • 设计焦点:MVC架构更注重分离用户界面和业务逻辑,通过将数据处理、显示和用户输入分离,实现了代码的解耦和复用。DDD架构更注重业务领域的建模和设计,将业务逻辑和领域知识体现在代码中,以更好地反映业务需求和业务流程。
  • 模型层次:在MVC架构中,模型层主要负责数据的处理和业务逻辑的实现,通常与数据存储和持久化紧密相关。在DDD架构中,模型层是领域模型的核心,负责表达业务领域的概念和规则,通常包含领域对象、值对象、领域服务等。
  • 模块化和可维护性:MVC架构通过分层设计实现了模块化和可维护性,使得开发人员可以更轻松地对代码进行管理和维护。DDD架构通过领域模型的划分和聚合实现了模块化和可维护性,使得业务逻辑更加清晰和可控。

优势与劣势

  • MVC架构优势:易于理解和使用,适合小型和中型应用程序。分层设计使得代码结构清晰,便于维护和扩展。
  • MVC架构劣势:可能导致模型层与视图层之间的耦合,使得代码难以复用和测试。适用于简单的用户界面,对复杂业务场景的支持有限。
  • DDD架构优势:通过领域驱动设计实现了业务逻辑和领域知识的高度统一,更贴近实际业务需求。领域模型的清晰划分和聚合使得代码结构清晰,便于扩展和维护。
  • DDD架构劣势:学习曲线较陡峭,需要理解领域模型和业务流程。不适合所有类型的应用程序,特别是简单的数据驱动型应用。

总结

MVC架构和DDD架构是两种常见的软件架构模式,各自具有独特的优势和适用场景。在实际应用中,开发人员应根据项目的规模、复杂度和业务需求选择合适的架构模式,以实现更好的代码设计和系统性能。

如果你对编程知识和相关职业感兴趣,欢迎访问编程狮官网(https://www.w3cschool.cn/)。在编程狮,我们提供广泛的技术教程、文章和资源,帮助你在技术领域不断成长。无论你是刚刚起步还是已经拥有多年经验,我们都有适合你的内容,助你取得成功。
理解Filter与Listener:Java Servlet中的关键组件

thbcm阅读(296)

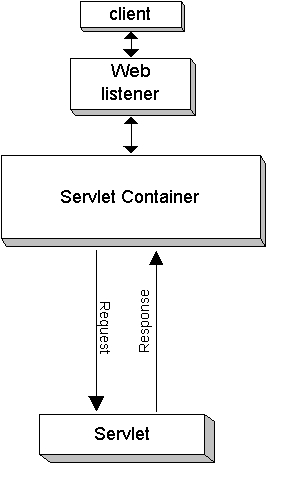
在Java Servlet开发中,Filter和Listener是两个重要的组件,用于处理HTTP请求和应用程序生命周期中的事件。本文将深入探讨Filter和Listener的作用、用法以及它们在Servlet应用中的重要性。

Filter

Filter是一种用于在请求被发送到Servlet之前或响应被发送回客户端之前执行某些任务的对象。它可以用于执行诸如日志记录、身份验证、编码转换等功能。

  • 过滤器链: 多个Filter可以链接在一起,形成一个过滤器链,依次对请求进行处理。
  • 生命周期方法: Filter接口定义了三个生命周期方法:​init()​、​doFilter()​和​destroy()​,开发人员可以在这些方法中编写自定义逻辑。

Listener

Listener是一种接口,用于监听应用程序中发生的事件,如Servlet的生命周期事件、HTTP会话的创建和销毁等。

  • 事件类型: Servlet规范定义了多种类型的事件,如​ServletContextEvent​、​ServletRequestEvent​和​HttpSessionEvent​等。
  • 应用场景: Listener可以用于执行初始化任务、记录日志、处理会话相关的操作等。

Filter与Listener的区别

  • 功能不同: Filter主要用于过滤和修改请求和响应,而Listener用于监听应用程序中的事件。
  • 触发时机不同: Filter在请求被发送到Servlet之前和响应被发送回客户端之前触发,而Listener则是在应用程序生命周期事件发生时触发。
  • 作用范围不同: Filter作用于请求和响应,而Listener作用于整个应用程序的生命周期。

使用示例

Filter示例

public class LoggingFilter implements Filter {
    public void init(FilterConfig config) throws ServletException {
        // 初始化操作
    }

    public void doFilter(ServletRequest request, ServletResponse response, FilterChain chain)
            throws IOException, ServletException {
        // 执行过滤操作
        chain.doFilter(request, response); // 继续执行过滤器链
    }

    public void destroy() {
        // 销毁操作
    }
}

Listener示例

@WebListener
public class AppStartupListener implements ServletContextListener {
    public void contextInitialized(ServletContextEvent event) {
        // 应用程序初始化逻辑
    }

    public void contextDestroyed(ServletContextEvent event) {
        // 应用程序销毁逻辑
    }
}

总结

Filter和Listener是Java Servlet中的两个重要组件,它们分别用于过滤和修改请求、响应,以及监听应用程序中的事件。合理使用Filter和Listener可以提高应用程序的灵活性和可维护性,使开发人员能够更好地控制应用程序的行为和状态。因此,在Servlet开发中,充分理解和熟练使用Filter和Listener是非常重要的。

如果你对编程知识和相关职业感兴趣,欢迎访问编程狮官网(https://www.w3cschool.cn/)。在编程狮,我们提供广泛的技术教程、文章和资源,帮助你在技术领域不断成长。无论你是刚刚起步还是已经拥有多年经验,我们都有适合你的内容,助你取得成功。
PHP 的只读属性:编码世界的守护者

thbcm阅读(329)

在 PHP 中,只读属性是指一旦属性被赋值后,便不能再被修改或者重新赋值的属性。这种特性在编程中常用于确保对象的某些状态或者属性在初始化后不被改变,从而增强代码的安全性和可维护性。让我们深入探讨 PHP 中只读属性的概念、用法以及适用场景。

什么是只读属性?

只读属性是指在 PHP 中,一旦给属性赋值后,就不能再修改其值的属性。这意味着只读属性在对象创建后只能被赋值一次,并且在对象的生命周期内保持不变。与之相对的是读写属性,它们可以在对象的生命周期中被多次赋值。

如何在 PHP 中创建只读属性?

在 PHP 中,可以使用关键字 ​readonly​(自 PHP 8.1 起)或者通过在类中定义 ​private​ 可见性的属性来创建只读属性。只读属性的值可以在类的构造函数中进行初始化,一旦初始化后,便不能再次修改。

示例代码

class Person {
    private readonly string $name;

    public function __construct(string $name) {
        $this->name = $name;
    }

    public function getName(): string {
        return $this->name;
    }
}

// 创建 Person 对象,并初始化只读属性
$person = new Person("John Doe");

// 尝试修改只读属性,这将引发错误
$person->name = "Jane Doe"; // Fatal error: Cannot write to a readonly property

只读属性的优势和用途

  • 增强安全性:只读属性可以防止意外的属性修改,提高了代码的安全性。这对于确保对象状态的一致性和不变性非常有用。
  • 提高可维护性:只读属性使得代码更加可预测和易于理解。它们明确指明了某些属性在对象生命周期中不会被改变,从而减少了代码维护和调试的复杂性。
  • 符合面向对象设计原则:只读属性支持封装性和抽象性,是面向对象设计原则的一部分。它们有助于将对象的状态和行为封装在一起,提高了代码的模块化程度和可重用性。
  • 避免意外修改:只读属性可以防止在不正确的时间或位置修改对象的状态,减少了由于状态变化导致的潜在错误。

总结

只读属性是 PHP 中一个有用且强大的特性,它使得代码更加安全、可靠和易于维护。通过限制属性的修改,只读属性帮助开发人员编写出更健壮且易于理解的代码。在适当的情况下,合理地使用只读属性可以提高代码的质量和可维护性,是面向对象编程中的一项重要实践。在使用只读属性时,需要确保遵循良好的设计原则,并根据具体的需求和场景来合理地应用它们,从而达到代码的优化和改进。

如果你对编程知识和相关职业感兴趣,欢迎访问编程狮官网(https://www.w3cschool.cn/)。在编程狮,我们提供广泛的技术教程、文章和资源,帮助你在技术领域不断成长。无论你是刚刚起步还是已经拥有多年经验,我们都有适合你的内容,助你取得成功。
探索数据可视化:Python 库 Matplotlib

thbcm阅读(301)

在数据科学和机器学习的领域中,数据可视化是一种强大的工具,它能够将复杂的数据转化为易于理解和解释的图形形式。在 Python 的丰富生态系统中,Matplotlib 库被认为是最流行和最强大的数据可视化工具之一。本文将深入探讨 Matplotlib 库的特性、用法以及如何利用它创建令人惊叹的可视化效果。

什么是 Matplotlib?

Matplotlib 是一个用于创建静态、动态和交互式图形的 Python 库。它提供了广泛的功能,包括线图、散点图、直方图、饼图、等高线图等。Matplotlib 不仅易于使用,而且灵活性高,可以满足各种数据可视化需求。

主要特性

  • 多种绘图样式:Matplotlib 支持多种绘图样式,包括线图、散点图、直方图、饼图、等高线图等,用户可以根据需求选择合适的绘图类型。
  • 自定义性强:Matplotlib 允许用户对图形的各个方面进行高度自定义,包括线条样式、颜色、标签、图例等,从而创建出符合个性化需求的图形。
  • 广泛的支持:Matplotlib 可以与其他 Python 库(如 NumPy、Pandas)以及 Jupyter Notebook 等配合使用,为用户提供更加丰富的数据分析和可视化功能。

如何使用 Matplotlib?

以下是一个简单的 Matplotlib 示例,演示了如何绘制一个简单的折线图:

# 安装 Matplotlib
# pip install matplotlib

import matplotlib.pyplot as plt

# 数据
x = [1, 2, 3, 4, 5]
y = [2, 3, 5, 7, 6]

# 绘制折线图
plt.plot(x, y, marker='o', linestyle='--', color='b', label='line')

# 添加标题和标签
plt.title('Simple Line Plot')
plt.xlabel('X-axis')
plt.ylabel('Y-axis')

# 添加图例
plt.legend()

# 显示图形
plt.show()

应用场景

Matplotlib 可以应用于各种场景,包括:

  • 教育和教学:在教育和教学中,数据可视化是帮助学生理解和掌握知识的重要手段。教师可以使用 Matplotlib 创建图形化的示例、案例研究和实验结果,使学生更好地理解复杂的概念和理论。
  • 金融和经济分析:在金融和经济领域,数据可视化是分析市场趋势、股票价格、货币汇率等方面的重要工具。Matplotlib 可以用来创建股票走势图、蜡烛图、散点图等,帮助分析师和交易员更好地理解市场情况。
  • 数据分析和探索:Matplotlib 是数据分析中不可或缺的工具之一。它可以帮助分析师和科学家快速探索数据集,理解数据之间的关系,发现趋势和模式,并从中提取有价值的见解。
  • 数据报告和演示:Matplotlib 可以用于创建高质量的数据报告和演示。通过将数据可视化成图表、图形和图像,用户可以更清晰地传达信息、展示趋势,并向观众解释数据分析的结果。
  • Web 应用和数据应用程序:许多 Web 应用和数据应用程序使用 Matplotlib 来呈现数据给用户。通过将 Matplotlib 结合到 Web 开发框架中,开发人员可以创建动态和交互式的数据可视化应用,让用户通过浏览器与数据进行交互。

总结

Matplotlib 是 Python 中最流行和强大的数据可视化工具之一,它提供了丰富的绘图功能和高度的自定义性,能够满足各种数据可视化需求。通过 Matplotlib,用户可以轻松创建出令人惊叹的图形效果,从而更好地理解和解释数据。因此,掌握 Matplotlib 是数据科学和机器学习领域的重要技能之一,也是提升数据分析能力的关键一步。

如果你对编程知识和相关职业感兴趣,欢迎访问编程狮官网(https://www.w3cschool.cn/)。在编程狮,我们提供广泛的技术教程、文章和资源,帮助你在技术领域不断成长。无论你是刚刚起步还是已经拥有多年经验,我们都有适合你的内容,助你取得成功。
探索Go 语言URL:解析与构建

thbcm阅读(311)

在 Go 语言中,解析和处理 URL 是日常开发中常见的任务之一。URL(统一资源定位符)是指定 Web 资源位置的标准方式,它由多个部分组成,包括协议、主机、路径、查询参数等。本文将深入探讨 Go 语言中如何解析和处理 URL,以及如何利用标准库中的工具来实现这些功能。

URL 解析

在 Go 语言中,可以使用 ​net/url​ 包来解析和处理 URL。​net/url​ 包提供了 ​url.Parse()​ 函数,用于将 URL 字符串解析为 ​url.URL​ 类型的结构体,包含了 URL 的各个组成部分。

以下是一个简单的示例,演示了如何解析 URL 字符串:

package main

import (
	"fmt"
	"net/url"
)

func main() {
	rawURL := "https://example.com/path?foo=bar&baz=qux"

	parsedURL, err := url.Parse(rawURL)
	if err != nil {
		fmt.Println("URL parsing error:", err)
		return
	}

	fmt.Println("Scheme:", parsedURL.Scheme)
	fmt.Println("Host:", parsedURL.Host)
	fmt.Println("Path:", parsedURL.Path)
	fmt.Println("Query:", parsedURL.RawQuery)
}

在上面的示例中,我们使用 ​url.Parse()​ 函数将 URL 字符串解析为 ​url.URL​ 类型的结构体,并输出了 URL 的各个部分,包括协议、主机、路径和查询参数等。

URL 构建

除了解析 URL,​net/url​ 包还提供了用于构建 URL 的功能。我们可以使用 ​url.URL​ 结构体提供的方法来构建 URL,并添加路径、查询参数等信息。

以下是一个简单的示例,演示了如何构建 URL:

package main

import (
	"fmt"
	"net/url"
)

func main() {
	baseURL := &url.URL{
		Scheme: "https",
		Host:   "example.com",
	}

	path := "/path"
	queryParams := url.Values{}
	queryParams.Set("foo", "bar")
	queryParams.Add("baz", "qux")

	baseURL.Path = path
	baseURL.RawQuery = queryParams.Encode()

	fmt.Println("Constructed URL:", baseURL.String())
}

在这个示例中,我们首先创建了一个 ​url.URL​ 结构体作为基本的 URL。然后,我们设置了路径和查询参数,并使用 ​Encode()​ 方法将查询参数编码为 URL 编码格式。最后,我们使用 ​String()​ 方法将构建的 URL 转换为字符串并输出。

URL 查询参数解析

在实际开发中,解析 URL 中的查询参数是非常常见的需求。​net/url​ 包提供了 ​url.Values​ 类型来处理查询参数,可以方便地获取、添加、删除和修改查询参数。

以下是一个示例,演示了如何解析 URL 查询参数:

package main

import (
	"fmt"
	"net/url"
)

func main() {
	rawQuery := "foo=bar&baz=qux&baz=quux"

	queryParams, err := url.ParseQuery(rawQuery)
	if err != nil {
		fmt.Println("Query parsing error:", err)
		return
	}

	fmt.Println("Parsed query parameters:")
	for key, values := range queryParams {
		fmt.Printf("%s: %v\n", key, values)
	}
}

在这个示例中,我们使用 ​url.ParseQuery()​ 函数解析了一个 URL 查询参数字符串,并输出了解析后的查询参数及其值。

总结

在本文中,我们深入探讨了 Go 语言中如何解析和处理 URL。通过使用 ​net/url​ 包,我们可以轻松地解析 URL 字符串、构建 URL、处理查询参数等。URL 的解析和处理在 Web 开发中是一个非常常见的任务,掌握了这些技巧,将有助于编写更健壮、更可靠的 Go 语言程序。

如果你对编程知识和相关职业感兴趣,欢迎访问编程狮官网(https://www.w3cschool.cn/)。在编程狮,我们提供广泛的技术教程、文章和资源,帮助你在技术领域不断成长。无论你是刚刚起步还是已经拥有多年经验,我们都有适合你的内容,助你取得成功。
Vue 插槽:灵活而强大的组件化工具

thbcm阅读(308)

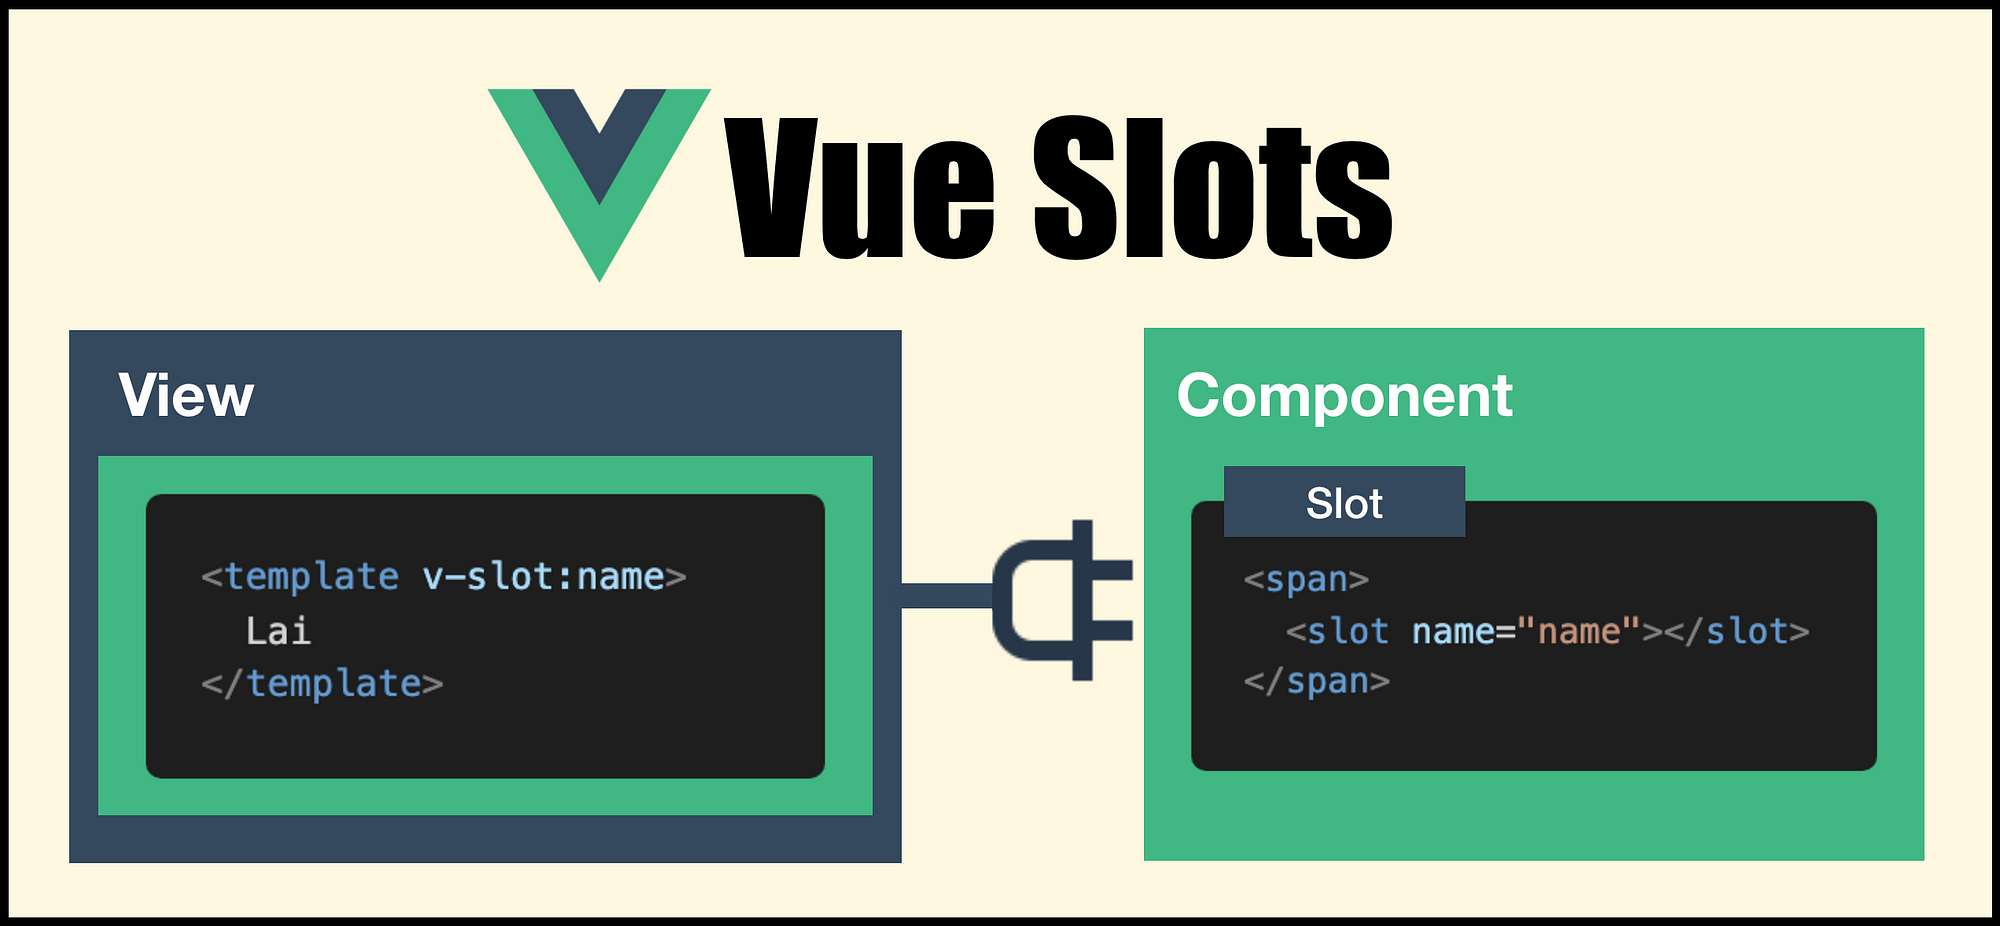
Vue.js 是一款流行的 JavaScript 前端框架,它提供了强大的组件化能力,使得前端开发变得更加简单和高效。其中,插槽(Slot)是 Vue 中一个重要的概念,它使得组件的内容更加灵活、可重用,并支持更高级的组件设计模式。本文将深入探讨 Vue 插槽的原理、用法以及实际应用场景。

什么是 Vue 插槽?

在 Vue 中,插槽是一种特殊的语法,用于定义组件的内容结构。插槽允许开发者在组件的模板中预留一些位置,使得父组件可以向子组件中动态地传入内容。这种灵活的机制使得组件的结构更加通用、可复用,并且可以根据不同的需求传入不同的内容。

基本插槽

在 Vue 中,最简单的插槽称为基本插槽(Default Slot)。它允许父组件在子组件中插入任意内容。基本插槽通过在子组件的模板中使用 ​<slot>​ 元素来定义,父组件中的内容将会替换掉子组件中的 ​<slot>​ 元素。

以下是一个基本插槽的示例:

<!-- ChildComponent.vue -->
<template>
  <div>
    <h2>子组件内容:</h2>
    <slot></slot>
  </div>
</template>
<!-- ParentComponent.vue -->
<template>
  <div>
    <h1>父组件内容:</h1>
    <ChildComponent>
      <p>这是父组件传入的内容。</p>
    </ChildComponent>
  </div>
</template>

命名插槽

除了基本插槽,Vue 还支持命名插槽(Named Slot),允许父组件向子组件中的具体位置传入内容。在子组件的模板中,可以使用 ​<slot>​ 元素的 ​name​ 属性来定义命名插槽,然后在父组件中使用 ​<template>​ 元素的 ​v-slot​ 指令来指定插入的内容。

以下是一个命名插槽的示例:

<!-- ChildComponent.vue -->
<template>
  <div>
    <h2>子组件内容:</h2>
    <slot name="header"></slot>
    <div>
      <slot></slot>
    </div>
  </div>
</template>
<!-- ParentComponent.vue -->
<template>
  <div>
    <h1>父组件内容:</h1>
    <ChildComponent>
      <template v-slot:header>
        <h3>这是父组件传入的标题</h3>
      </template>
      <p>这是父组件传入的内容。</p>
    </ChildComponent>
  </div>
</template>

作用域插槽

除了基本插槽和命名插槽,Vue 还提供了作用域插槽(Scoped Slot)功能,允许子组件向父组件传递数据。通过作用域插槽,父组件可以在子组件中使用子组件内部的数据和方法。

以下是一个作用域插槽的示例:

<!-- ChildComponent.vue -->
<template>
  <div>
    <h2>子组件内容:</h2>
    <slot name="item" v-for="item in items" :item="item"></slot>
  </div>
</template>
<!-- ParentComponent.vue -->
<template>
  <div>
    <h1>父组件内容:</h1>
    <ChildComponent>
      <template v-slot:item="slotProps">
        <p>{{ slotProps.item }}</p>
      </template>
    </ChildComponent>
  </div>
</template>

<script>
import ChildComponent from './ChildComponent.vue';

export default {
  components: {
    ChildComponent
  },
  data() {
    return {
      items: ['item1', 'item2', 'item3']
    }
  }
}
</script>

应用场景

Vue 插槽在实际开发中有许多应用场景,包括:

  • 布局组件:允许父组件灵活地传入内容来配置布局。
  • 列表渲染:允许父组件向子组件中动态地传入列表数据。
  • 对话框和模态框:允许父组件传入不同的内容来配置对话框或模态框的内容。

总结

Vue 插槽是 Vue 组件化开发中非常重要的一个特性,它使得组件的内容更加灵活、可复用,并支持更高级的组件设计模式。通过深入理解和灵活运用 Vue 插槽,可以提高组件的可维护性和可扩展性,加速开发速度,提升用户体验。

如果你对编程知识和相关职业感兴趣,欢迎访问编程狮官网(https://www.w3cschool.cn/)。在编程狮,我们提供广泛的技术教程、文章和资源,帮助你在技术领域不断成长。无论你是刚刚起步还是已经拥有多年经验,我们都有适合你的内容,助你取得成功。
联系我们