Python定时器:掌握时间的魔法之道

thbcm阅读(308)

在现代计算机编程中,时间管理是至关重要的一部分。为了执行定时任务、调度事件或者创建计时器功能,Python提供了内置的定时器模块。本文将详细介绍Python中定时器的概念、用法以及如何利用定时器模块来处理各种时间相关的任务。

什么是定时器?

在编程中,定时器是一种工具,允许我们在指定的时间间隔后执行特定的操作。Python的定时器模块提供了一种简单而强大的方式来实现这种功能。
Python定时器模块

Python中的定时器模块被称为​timer​,通过​threading​库提供。它允许我们创建定时器对象,设置定时器的延迟时间,并指定要执行的函数或代码块。

定时器的基本用法

下面是一个简单的示例,展示了如何在Python中使用定时器:

import threading

def hello_world():
    print("Hello, world!")

timer = threading.Timer(5.0, hello_world)
timer.start()

在上述示例中,我们创建了一个定时器对象​timer​,并指定了一个延迟时间为5秒。当定时器触发时,它将调用​hello_world()​函数,并在控制台打印”Hello, world!”。

定时器的取消

如果在定时器开始执行之前,我们希望取消定时器,可以使用​cancel()​方法。下面是一个示例:

import threading

def hello_world():
    print("Hello, world!")

timer = threading.Timer(5.0, hello_world)
timer.start()

# 取消定时器
timer.cancel()

在上述示例中,我们在定时器开始执行之前使用​cancel()​方法取消了定时器。

定时器的重复执行

除了在指定的延迟时间后执行一次,定时器还可以设置为重复执行。为此,我们可以在定时器回调函数内部再次调用定时器的​start()​方法。下面是一个示例:

import threading

def hello_world():
    print("Hello, world!")
    timer.start()  # 重复执行定时器

timer = threading.Timer(5.0, hello_world)
timer.start()

在上述示例中,定时器在每次执行完毕后,会再次启动自身,从而实现了定时器的重复执行。

总结

Python的定时器模块提供了一种便捷的方式来处理时间相关的任务。通过定时器,我们可以在指定的时间间隔后执行特定的操作。无论是执行定时任务、调度事件还是创建计时器功能,定时器模块都能满足我们的需求。希望本文对你理解和应用Python定时器提供了一定的帮助,让你掌握时间的魔法之道。
如果你对编程知识和相关职业感兴趣,欢迎访问编程狮官网(https://www.w3cschool.cn/)。在编程狮,我们提供广泛的技术教程、文章和资源,帮助你在技术领域不断成长。无论你是刚刚起步还是已经拥有多年经验,我们都有适合你的内容,助你取得成功。
Docker网络:连接容器的无限可能

thbcm阅读(289)

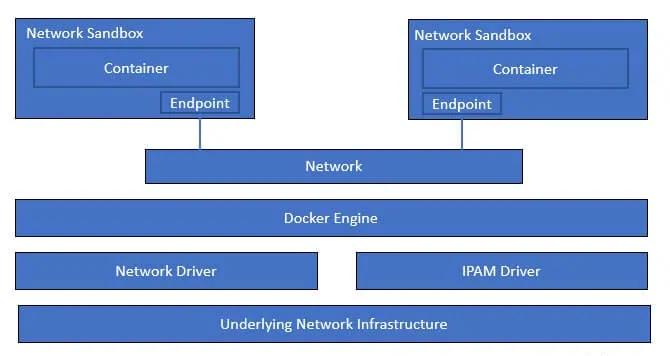
在现代容器化技术中,Docker无疑是最为流行和广泛使用的平台之一。除了提供强大的容器化功能外,Docker还提供了灵活而强大的网络功能,使得容器之间的通信和连接变得更加简单和高效。本文将深入探究Docker网络,介绍其概念、不同类型的网络模式以及如何使用Docker网络构建强大的容器化应用。

Docker网络概述

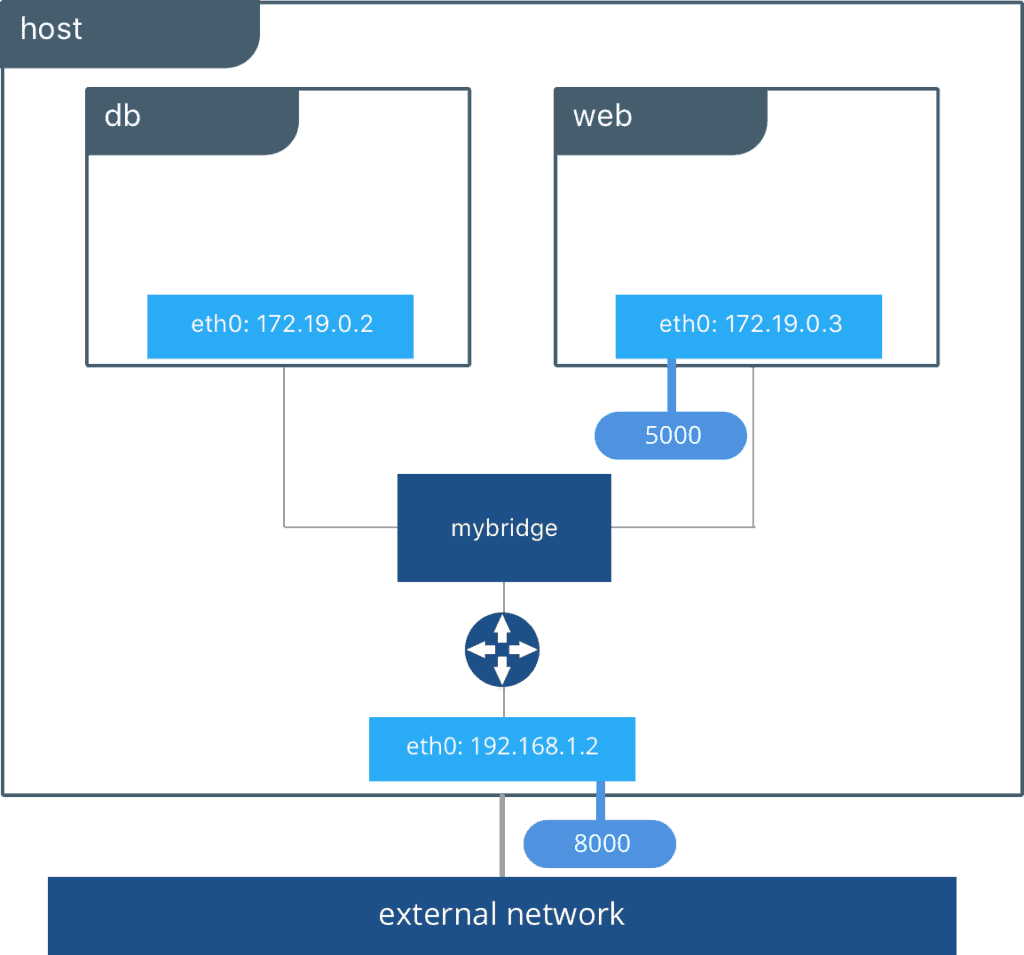
Docker网络是一种虚拟网络环境,用于连接和通信不同的Docker容器。它提供了一种隔离和安全的方式,使得容器能够相互通信,同时与主机和外部网络进行交互。Docker网络还可以根据应用需求配置不同的网络模式,以满足各种场景下的网络需求。

Docker网络模式

Docker提供了多种网络模式,可以根据应用的需求选择适当的模式。以下是几种常见的Docker网络模式:

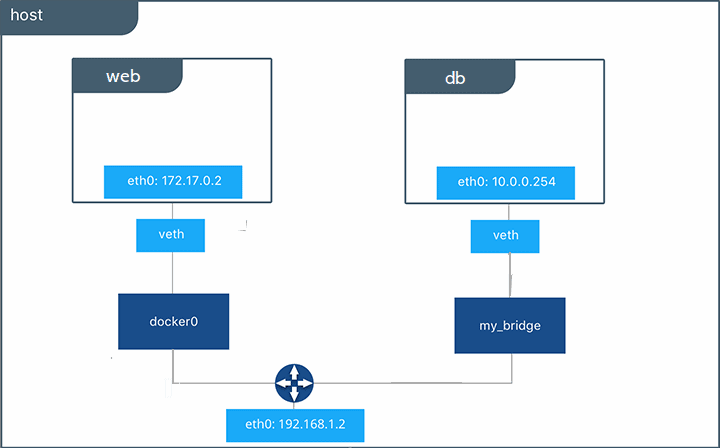
  • 默认桥接网络(Bridge Network):默认桥接网络是Docker的默认网络模式。在该模式下,Docker创建一个虚拟网络桥接器,容器连接到该桥接器以实现互联互通。此模式下的容器可以使用IP地址进行通信,也可以通过容器名称进行访问。

  • 主机网络(Host Network):主机网络模式将容器直接连接到主机的网络栈,使得容器和主机共享相同的网络命名空间。这意味着容器可以使用主机的网络接口和IP地址,从而实现与主机相同的网络访问能力。

  • none网络(None Network):none网络模式将容器隔离在一个独立的网络栈中,与宿主机和其他容器完全隔离。在这种模式下,容器无法进行网络通信,只能与自身进行内部操作。
  • 自定义网络(Custom Network):自定义网络模式允许用户创建自己的虚拟网络,容器可以连接到该网络并进行通信。这种模式下,用户可以自定义网络的配置、子网范围和网关等参数,实现更精细的网络控制和管理。

Docker网络连接

除了不同的网络模式,Docker还提供了多种方式来连接和管理容器之间的网络通信:

  • 链接(Linking):链接是一种早期的容器连接方法,通过在一个容器中引用另一个容器的名称来实现通信。这种方法已逐渐被网络模式取代,但在某些特定场景下仍然有用。
  • 网络别名(Network Alias):网络别名是一种在容器中指定多个名称的方法,使得容器可以通过不同的名称进行网络访问。这在多个容器需要访问同一服务时非常有用。
  • 容器间通信(Container-to-Container Communication):容器间通信是通过容器的IP地址和端口进行直接通信的方式。在同一网络中的容器可以通过互相的IP地址进行通信,实现容器之间的数据交换和服务调用。

总结

Docker网络是连接和管理容器之间通信的重要组成部分。通过选择适当的网络模式和合适的连接方式,我们可以构建强大的容器化应用程序,实现容器之间的高效通信和协作。希望本文能够帮助你深入理解Docker网络的概念和使用方法,并为你在构建容器化应用时提供最佳实践和指导。

如果你对编程知识和相关职业感兴趣,欢迎访问编程狮官网(https://www.w3cschool.cn/)。在编程狮,我们提供广泛的技术教程、文章和资源,帮助你在技术领域不断成长。无论你是刚刚起步还是已经拥有多年经验,我们都有适合你的内容,助你取得成功。
Prometheus:现代监控与警报的开源之光

thbcm阅读(283)

在当今高度互联的数字世界中,监控和警报系统已经成为了保障应用程序和基础架构稳定性的关键组成部分。而在众多可选方案中,Prometheus凭借其强大的功能和灵活性逐渐崭露头角。本文将深入介绍Prometheus,探讨其特点、架构和用途,帮助读者了解和利用这个开源监控解决方案。

什么是Prometheus?

Prometheus是一个开源的系统监控和警报工具,由SoundCloud于2012年创建并于2015年开源。它旨在帮助开发人员和系统管理员收集、存储和分析应用程序和基础架构的度量指标数据。

Prometheus的特点

  • 多维度数据模型:Prometheus采用多维度数据模型,每个时间序列由指标名称和一组标签键值对组成,使得数据的灵活建模和查询成为可能。
  • 灵活的查询语言:Prometheus提供了强大而直观的查询语言PromQL,支持对指标数据进行过滤、聚合和计算,以满足不同的监控需求。
  • 实时监控和警报:Prometheus具备实时监控能力,可以收集和存储时间序列数据,并根据用户定义的规则触发警报。这使得及时发现和解决问题成为可能。
  • 可视化和报告:Prometheus可以与多种可视化工具和报告生成器集成,如Grafana和Prometheus自带的Dashboard,帮助用户更好地展示和理解监控数据。
  • 可扩展性:Prometheus具有良好的可扩展性,能够处理大规模的监控环境。它支持分布式部署和自动发现,可以与其他工具集成,如Kubernetes、容器化应用和云服务。

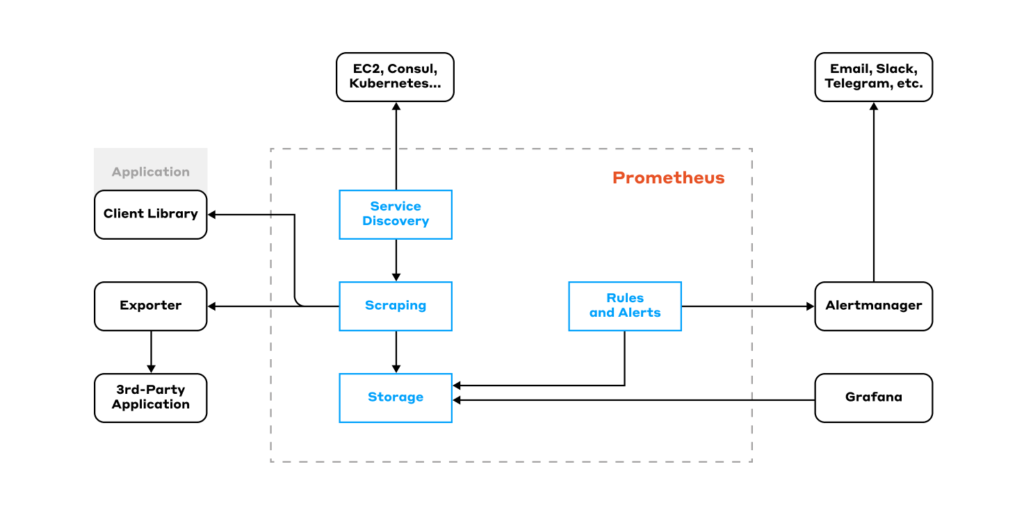
Prometheus的架构

  • 数据采集器(Collector):负责定期收集和抓取目标系统的度量指标数据,并将其存储在本地数据库中。
  • 存储引擎(Storage Engine):Prometheus使用自己的本地时间序列数据库,用于存储和查询采集到的指标数据。
  • 查询处理器(Query Processor):处理用户通过PromQL查询语言提交的请求,从存储引擎中检索和计算所需的数据。
  • 警报管理器(Alertmanager):负责接收来自Prometheus的警报信息,并根据用户定义的规则进行处理和分发。

Prometheus的使用场景

  • 应用程序监控:Prometheus可以监控应用程序的性能指标、请求处理时间、错误率等,帮助开发人员及时发现和解决问题。
  • 基础架构监控:Prometheus可用于监控服务器、网络设备、数据库、存储系统等基础架构组件的运行状态和性能指标。
  • 容器化环境监控:作为Kubernetes的首选监控方案,Prometheus可以监控容器化环境中的Pod、服务发现、自动扩展等关键指标。
  • 云服务监控:Prometheus支持与各种云服务提供商集成,如AWS、GCP和Azure,可以监控云资源的使用情况、服务健康状态等。
  • 分布式系统监控:Prometheus的可扩展性使其成为监控分布式系统的理想选择,可以收集和分析分布式应用程序的度量指标。

总结

Prometheus作为一种现代监控和警报解决方案,具备灵活性、可扩展性和强大的功能集,得到了广泛的应用和社区支持。它的多维度数据模型、实时监控和警报能力以及可视化和报告功能,使得用户可以更好地理解和管理其应用程序和基础架构的健康状况。随着数字化时代的不断发展,Prometheus将继续在监控领域发挥重要的作用,为用户提供可靠的监控解决方案。

如果你对编程知识和相关职业感兴趣,欢迎访问编程狮官网(https://www.w3cschool.cn/)。在编程狮,我们提供广泛的技术教程、文章和资源,帮助你在技术领域不断成长。无论你是刚刚起步还是已经拥有多年经验,我们都有适合你的内容,助你取得成功。
Linux系统监控:保障稳定性与性能的关键

thbcm阅读(256)

Linux操作系统作为广泛应用于服务器和嵌入式设备的开源操作系统,对于系统监控的需求尤为重要。通过对Linux系统进行有效的监控,管理员可以实时了解系统的运行状态、识别潜在问题并采取相应的措施。本文将介绍Linux系统监控的基本原理、常用工具和关键指标,帮助读者全面了解和应用Linux系统监控的重要性。

系统监控的重要性

系统监控是确保Linux系统稳定性和性能的关键环节。通过监控,管理员可以实时追踪系统资源的使用情况,如CPU、内存、磁盘和网络等,以及进程的运行状态。及时发现和解决系统故障,如高负载、内存泄漏、磁盘空间不足等。分析历史数据和趋势,以进行容量规划和性能优化。监控安全事件,如入侵尝试、异常登录等。

常用的系统监控工具

  • top:top​命令是一个实时的系统监控工具,可以查看系统资源的使用情况、进程列表和负载情况等。
  • htop:htop​是​top​的增强版,提供了更多的功能和交互界面,如进程树、颜色标识和动态排序等。
  • vmstat:vmstat​命令可以提供系统整体和每个CPU的性能指标,如CPU利用率、内存使用、磁盘I/O等。
  • iostat:iostat​命令用于监控磁盘和设备的I/O性能指标,如读写速度、I/O等待时间等。
  • sar:sar​命令可以收集和报告系统的各种性能指标,如CPU、内存、网络等,可以生成报表和图形化分析。
  • nmon:nmon​是一个全面的系统监控工具,可以显示多个资源的使用情况,并提供实时的图形化界面。

关键的系统监控指标

在进行系统监控时,以下是一些重要的指标需要关注:

  • CPU利用率:监控CPU的使用情况,包括用户、系统和空闲时间。
  • 内存使用:关注物理内存和交换空间的使用情况,以避免内存泄漏和性能下降。
  • 磁盘空间:监控磁盘空间的使用情况,避免磁盘满导致的应用程序异常。
  • 网络流量:监控网络接口的流量和带宽使用情况,以及网络连接的状态。
  • 进程状态:检查系统中运行的进程和服务的状态,及时发现异常或僵死进程。
  • 负载情况:关注系统的平均负载,以了解系统的繁忙程度。

高级系统监控技术

除了常规的系统监控工具外,还有一些高级技术可以进一步提升系统监控的效果:

  • 日志分析:通过分析系统日志,可以发现潜在的问题和异常情况,如错误日志、警告消息等。
  • 自动化监控:利用自动化工具和脚本,可以实现对系统监控任务的自动化化,包括数据的收集、报警通知和报表生成等。
  • 可视化和报表:使用图形化工具如Grafana,可以将监控指标以图表的形式展示,方便管理员和团队实时了解系统状态。
  • 基础设施即代码:将系统监控纳入基础设施即代码的实践,通过版本控制和自动化配置管理工具,确保系统监控的一致性和可追溯性。

总结

Linux系统监控是确保系统稳定性和性能的关键环节。通过有效的系统监控工具和关键指标的监控,管理员可以实时了解系统的运行状态、及时发现潜在问题并采取相应的措施。同时,借助高级技术如日志分析、自动化监控和可视化报表等,可以进一步提升系统监控的效果和效率。

如果你对编程知识和相关职业感兴趣,欢迎访问编程狮官网(https://www.w3cschool.cn/)。在编程狮,我们提供广泛的技术教程、文章和资源,帮助你在技术领域不断成长。无论你是刚刚起步还是已经拥有多年经验,我们都有适合你的内容,助你取得成功。
理解Vue的缓存清除机制:优化性能与避免问题

thbcm阅读(314)

Vue.js作为一种流行的前端框架,提供了强大的缓存机制,以提高应用程序的性能和用户体验。然而,在某些情况下,缓存可能会导致问题,如页面更新不及时或数据不一致。本文将探讨Vue的缓存清除机制,包括常见的缓存策略、手动清除缓存的方法以及避免常见问题的技巧。

Vue的缓存策略

Vue使用了一种称为”响应式缓存”的策略,它根据数据的依赖关系自动追踪和更新组件。当响应式数据发生变化时,Vue会重新渲染相关的组件,并尽可能复用已经渲染过的组件和DOM元素,以减少不必要的重绘和重新计算。

清除Vue的缓存

在某些情况下,我们需要手动清除Vue的缓存,以确保页面更新和数据一致性。以下是一些常见的清除缓存的方法

  • 强制更新:Vue提供了​$forceUpdate​方法,可以强制重新渲染组件及其子组件,跳过缓存机制。但这种方法会导致整个组件树的重新渲染,性能可能会受到影响,应谨慎使用。
  • Watch监听:通过在组件中使用​watch​选项,可以监听指定的数据变化,并在回调函数中执行相应的逻辑。在回调函数中,可以手动更新其他相关的数据,以达到清除缓存的效果。
  • 计算属性:计算属性是Vue中一种便捷的缓存策略,它会根据响应式数据的变化自动进行缓存。如果需要在特定情况下清除缓存,可以通过修改计算属性的依赖项来实现。
  • Key属性:在使用​v-for​指令渲染列表时,可以使用key属性给每个元素添加唯一的标识。当列表数据发生变化时,Vue会根据​key​属性的变化来判断是否复用组件或创建新的组件,从而实现缓存的清除。

避免常见问题的技巧

在使用Vue的缓存机制时,有些常见问题需要特别注意。以下是一些技巧,帮助您避免这些问题

  • 避免在​data​选项中直接修改数组或对象的元素,因为Vue无法追踪这种直接修改的变化。应该使用Vue提供的数组方法(如​push​、​pop​、​splice​等)或​Vue.set​方法来修改数组或对象,以确保缓存的正确更新。
  • 注意在父组件和子组件之间传递数据时,确保子组件的​props​是响应式的。否则,当父组件的数据变化时,子组件可能无法正确响应并更新。
  • 在使用动态组件或条件渲染时,要特别注意组件的缓存状态。Vue提供了​<keep-alive>​组件,可以手动控制组件的缓存行为,以便根据需要清除缓存。

Vue的缓存清除机制示例代码

<template>
  <div>
    <h2>{{ message }}</h2>
    <button @click="updateMessage">更新消息</button>
  </div>
</template>

<script>
export default {
  data() {
    return {
      message: 'Hello, Vue!',
    };
  },
  methods: {
    updateMessage() {
      // 清除缓存的方法
      this.$forceUpdate(); // 强制更新组件
    },
  },
};
</script>

上述示例中,我们有一个简单的Vue组件,其中包含一个消息文本和一个按钮。当点击按钮时,调用updateMessage方法来清除缓存并强制更新组件。通过使用this.$forceUpdate()方法,我们可以跳过缓存机制,确保组件重新渲染并显示最新的消息。

总结

Vue的缓存机制是提高前端应用程序性能的重要工具。了解和正确使用Vue的缓存策略,以及掌握清除缓存的方法,可以帮助我们优化应用程序性能并避免常见的问题。通过合理地管理缓存,我们可以提高页面的更新速度和数据的一致性,提供更好的用户体验。同时,我们还需注意避免常见的问题,如直接修改响应式数据、正确传递响应式的props等,以确保缓存的正确更新。掌握Vue的缓存清除机制,将有助于我们构建高效、可靠的Vue应用程序。

如果你对编程知识和相关职业感兴趣,欢迎访问编程狮官网(https://www.w3cschool.cn/)。在编程狮,我们提供广泛的技术教程、文章和资源,帮助你在技术领域不断成长。无论你是刚刚起步还是已经拥有多年经验,我们都有适合你的内容,助你取得成功。
C++中extern关键字:链接、作用域与模块化编程

thbcm阅读(273)

在C++编程中,extern是一个常见的关键字,用于声明外部变量和函数。它在程序的链接、作用域以及与其他源文件的交互方面发挥着重要作用。本文将深入探讨C++中的extern关键字,解释它的概念、作用以及正确使用的方法。

extern的概念

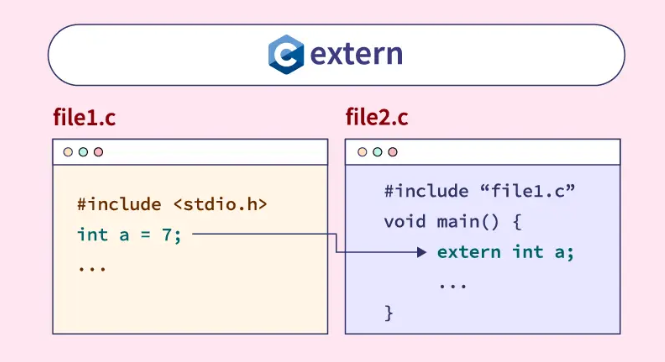
extern​是一个用于修饰变量和函数声明的关键字。它告诉编译器该变量或函数在其他地方定义或实现,不需要在当前文件中进行定义。通过使用​extern​关键字,我们可以引用其他源文件中的变量和函数,实现模块化编程和代码重用。

extern的作用域

extern​关键字的作用域取决于它被声明的位置和上下文。主要有以下两种情况:

  • 函数内部声明:当在函数内部使用​extern​关键字声明变量时,它将指示该变量具有全局作用域,可以在函数外部访问。这样做可以将变量的生命周期延长到函数外部。
  • 文件间声明:当在一个源文件中使用​extern​关键字声明变量或函数时,它将指示该变量或函数在其他源文件中定义或实现。这样可以使得不同源文件之间能够共享变量和函数。

extern的用法

extern​关键字可以用于不同的场景和用途:

  • 声明全局变量:在一个源文件中使用​extern​关键字声明全局变量,让其他文件能够引用并使用该变量。
  • 声明全局函数:类似地,使用​extern​关键字可以声明全局函数,使其他源文件能够调用该函数。
  • 引用外部变量:在函数内部使用​extern​关键字引用外部变量,以便访问和修改全局变量的值。多文件编译:在多个源文件中使用​extern​关键字来声明和引用共享的变量和函数,实现模块化编程和代码重用。

示例代码

下面是一个简单的示例代码,演示了​extern​关键字的用法:

// 文件1: main.cpp
#include <iostream>
extern int globalVariable;  // 声明全局变量

extern void externalFunction();  // 声明函数

int main() {
    externalFunction();  // 调用外部函数
    std::cout << "Global variable value: " << globalVariable << std::endl;  // 访问外部变量
    return 0;
}

// 文件2: other.cpp
#include <iostream>
int globalVariable = 42;  // 定义全局变量

void externalFunction() {
    std::cout << "External function called." << std::endl;
}

在上述示例中,​main.cpp​文件声明了一个全局变量globalVariable和一个外部函数externalFunction。这样,它可以在其他文件中访问和使用这些变量和函数。​other.cpp​文件实现了这些变量和函数的定义。

当编译并运行这段代码时,它将打印出以下输出:

External function called. Global variable value: 42

这表明成功地在​main.cpp​文件中引用了​other.cpp​文件中定义的全局变量和函数。

总结

extern​关键字在C++中是一个重要的概念,用于声明外部变量和函数,实现模块化编程和代码重用。通过正确使用​extern​关键字,我们可以在不同的源文件中共享变量和函数,提高代码的可维护性和可扩展性。通过深入理解和灵活运用​extern​关键字,我们可以更好地组织和管理C++程序,并提高开发效率。

如果你对编程知识和相关职业感兴趣,欢迎访问编程狮官网(https://www.w3cschool.cn/)。在编程狮,我们提供广泛的技术教程、文章和资源,帮助你在技术领域不断成长。无论你是刚刚起步还是已经拥有多年经验,我们都有适合你的内容,助你取得成功。
Swagger:简化 RESTful API设计与文档化的利器

thbcm阅读(291)

在构建现代 Web 应用程序时,设计和文档化 RESTful API 是至关重要的一环。Swagger 提供了一个开源的工具集,旨在简化 API 的设计、构建和文档化过程。本文将介绍 Swagger 的概念、功能和优势,以及如何使用 Swagger 提高 API 开发的效率和可靠性。

什么是 Swagger?

Swagger 是一个用于设计、构建、文档化和使用 RESTful Web 服务的工具集。它的核心规范是使用 OpenAPI Specification(OAS),这是一种描述和定义 API 的标准。Swagger 提供了一套工具和库,帮助开发人员根据 OAS 规范来设计、构建和测试 API,并生成易于理解和交互式的 API 文档。

Swagger 的功能和优势

  • 设计和构建 API:Swagger 提供了一个直观的界面,让开发人员能够设计和定义 API 的各个方面,包括端点、请求方法、参数、请求体、响应和错误等。通过 Swagger,开发人员可以更好地规划和组织 API 的结构,确保一致性和易用性。
  • 自动生成文档:Swagger 可以基于 API 的定义自动生成详细的 API 文档。这些文档包括 API 的端点、请求和响应示例、参数说明、错误处理和认证要求等信息。生成的文档具有交互式界面,让开发人员和其他团队成员可以轻松地浏览和理解 API 的功能和用法。
  • 与多种编程语言兼容:Swagger 支持多种流行的编程语言,并提供了与各种语言相关的工具和库。开发人员可以使用自己熟悉的编程语言来构建和实现 Swagger 规范的 API,从而简化开发过程。
  • API 可视化和测试:Swagger UI 是 Swagger 提供的一个交互式界面,用于可视化和测试 API。开发人员可以使用 Swagger UI 浏览和测试 API 的不同端点,发送请求并查看响应。这有助于在开发过程中快速验证和调试 API。
  • 客户端代码生成:Swagger 还提供了一些代码生成工具,可以根据 API 的定义自动生成客户端代码。这些生成的代码可以帮助开发人员快速集成 API,并提供了与 API 交互的便捷方法。

在Java中使用Swagger 

  1. 添加 Swagger 依赖项:在 Java 项目的构建管理工具(如 Maven 或 Gradle)中,添加 Swagger 相关的依赖项。以下是 Maven 的示例配置:
    <dependencies>
        <dependency>
            <groupId>io.springfox</groupId>
            <artifactId>springfox-boot-starter</artifactId>
            <version>3.0.0</version>
        </dependency>
    </dependencies>
  2. 配置 Swagger:创建一个配置类(如 SwaggerConfig.java),用于配置 Swagger 的相关设置。这个类应该使用 @Configuration 注解进行标记,并添加 @EnableSwagger2 注解来启用 Swagger。以下是一个示例配置类:
    @Configuration
    @EnableSwagger2
    public class SwaggerConfig {
        
        @Bean
        public Docket api() {
            return new Docket(DocumentationType.SWAGGER_2)
                .select()
                .apis(RequestHandlerSelectors.basePackage("com.example.api")) // 指定 API 所在的包
                .paths(PathSelectors.any())
                .build()
                .apiInfo(apiInfo());
        }
    
        private ApiInfo apiInfo() {
            return new ApiInfoBuilder()
                .title("API 文档")
                .description("这是一个示例 API 文档")
                .version("1.0.0")
                .build();
        }
    }
  3. 注解 API:在你的控制器类或方法上使用 Swagger 的注解来描述 API 相关的信息,如 API 的路径、请求方法、参数、响应等。以下是一些常用的注解:
    • @Api​:用于描述整个 API 文档的信息。
    • @ApiOperation用于描述单个 API 操作的信息。
    • @ApiParam​:用于描述 API 参数的信息。
    • @ApiResponses用于描述 API 响应的信息。

    以下是一个示例控制器类:

    @RestController
    @RequestMapping("/api")
    @Api(tags = "示例 API")
    public class ExampleController {
    
        @GetMapping("/hello")
        @ApiOperation("获取欢迎消息")
        public String hello(@RequestParam("name") @ApiParam("姓名") String name) {
            return "Hello, " + name + "!";
        }
    }
  4. 运行应用程序:启动你的 Java 应用程序,并访问 Swagger UI 界面。Swagger UI 默认会在 /swagger-ui.html 路径下提供 API 文档的展示和测试界面。例如,如果你的应用程序在本地运行,并且端口号为 8080,则可以通过访问 http://localhost:8080/swagger-ui.html 来打开 Swagger UI。通过 Swagger UI,你可以查看 API 文档、测试 API 的不同端点,并查看请求和响应的示例。

总结

Swagger 提供了一个强大的工具集,使得设计、构建和文档化 RESTful API 变得更加简单和高效。通过使用 Swagger,开发人员可以规范和组织 API 的设计,自动生成详细的交互式文档,并与多种编程语言兼容。这样可以提高开发团队的协作效率,减少开发错误,同时提供清晰、可靠的 API 接口给其他开发人员和使用者。无论是构建新的 API 还是维护现有的 API,使用 Swagger 都有助于提高开发速度和代码质量,从而推动 Web 应用程序的成功开发和部署。

如果你对编程知识和相关职业感兴趣,欢迎访问编程狮官网(https://www.w3cschool.cn/)。在编程狮,我们提供广泛的技术教程、文章和资源,帮助你在技术领域不断成长。无论你是刚刚起步还是已经拥有多年经验,我们都有适合你的内容,助你取得成功。
探索Spring Boot如何查看程序中有哪些的Bean?

thbcm阅读(319)

在 Spring Boot 应用程序中,Bean 是核心组件,它们负责实现应用的各种功能。在开发和调试过程中,了解程序中存在哪些 Bean 是非常重要的。本文将介绍几种方法,帮助您查看 Spring Boot 程序中的 Bean,并了解它们的类型、数量和配置信息。

方法一:使用 Actuator 端点

Spring Boot Actuator 提供了一组用于监控和管理应用程序的功能。通过启用 Actuator,您可以使用 /actuator 路径下的端点来查看应用程序的各种信息,包括 Bean。以下是使用 Actuator 查看 Bean 的步骤:

  1. 在 ​pom.xml​ 文件中添加 Actuator 依赖:
    <dependencies>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-actuator</artifactId>
        </dependency>
    </dependencies>
  2. 启用 Actuator 端点,在 ​application.properties​ 文件中添加以下配置:
    management.endpoints.web.exposure.include=*
  3. 启动应用程序,并访问 ​/actuator/beans​ 端点,如 http://localhost:8080/actuator/beans。您将看到一个包含所有 Bean 信息的 JSON 响应。

方法二:使用 Spring Boot DevTools

Spring Boot DevTools 是一个开发工具,可以提供热部署、自动重启和其他开发便利功能。DevTools 还提供了一个特殊的页面,用于展示应用程序的 Bean 信息。以下是使用 DevTools 查看 Bean 的步骤:

  1. 在 pom.xml 文件中添加 DevTools 依赖:
    <dependencies>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-devtools</artifactId>
            <optional>true</optional>
        </dependency>
    </dependencies>
  2. 启动应用程序,并访问 ​/actuator​ 端点,如 http://localhost:8080/actuator。
  3. 在 Actuator 页面中,找到 “Beans” 链接并点击。您将看到一个展示所有 Bean 信息的页面。

方法三:使用 ApplicationContext

Spring Boot 应用程序的 ApplicationContext 是管理 Bean 的容器。您可以通过访问 ApplicationContext 对象来查看应用程序中的 Bean。以下是使用 ApplicationContext 查看 Bean 的步骤:

  1. 在您的代码中注入 ApplicationContext 对象:
    @Autowired
    private ApplicationContext applicationContext;
  2. 在合适的位置,使用 ​applicationContext.getBeanDefinitionNames() ​方法获取所有 Bean 的名称列表,或者使用 ​applicationContext.getBeansOfType()​ 方法获取特定类型的 Bean。
  3. 您可以将 Bean 的名称列表打印到控制台,或者进一步处理它们以满足您的需求。

总结

在本文中,我们介绍了几种方法来查看 Spring Boot 程序中的 Bean。您可以使用 Actuator 端点来获取 Bean 的详细信息,使用 DevTools 页面查看 Bean 的概览,或者通过访问 ApplicationContext 对象来获取 Bean 的名称列表或特定类型的 Bean。这些方法将帮助您更好地了解应用程序中的 Bean,从而更好地理解和调试您的 Spring Boot 应用程序。

如果你对编程知识和相关职业感兴趣,欢迎访问编程狮官网(https://www.w3cschool.cn/)。在编程狮,我们提供广泛的技术教程、文章和资源,帮助你在技术领域不断成长。无论你是刚刚起步还是已经拥有多年经验,我们都有适合你的内容,助你取得成功。
Python权限功能设计:保护数据的安全与访问控制

thbcm阅读(261)

在许多应用程序和系统中,数据的安全性和访问控制是至关重要的。Python作为一种广泛使用的编程语言,提供了丰富的权限功能,用于保护数据并限制用户对数据的访问。本文将介绍Python中的权限功能设计,包括角色和权限模型、权限验证和实现策略,帮助读者理解和设计安全的Python应用程序。

角色和权限模型

权限功能的设计通常涉及两个关键概念:角色和权限。角色是指用户或用户组的分类,而权限是指用户或用户组可以执行的操作或访问的资源。在Python中,通常使用角色和权限模型来管理和控制用户对数据和功能的访问。

角色和权限模型可以通过以下方式定义:

  • 角色:定义不同用户类型或用户组,如管理员、普通用户、访客等。
  • 权限:定义不同的操作或资源,如读取数据、写入数据、删除数据等。

权限验证

在Python中,实现权限功能的一种常见方式是通过权限验证。权限验证是指在用户试图执行某个操作或访问某个资源之前,对其权限进行验证以确定其是否具有所需权限。

权限验证可以通过以下步骤实现:

  • 定义角色和权限:在应用程序中定义角色和权限的列表,并将它们与特定操作或资源相关联。
  • 用户认证:对用户进行身份验证,并确定其所属的角色。
  • 权限检查:在用户尝试执行操作或访问资源之前,检查其角色是否具有所需的权限。如果用户的角色具有所需权限,则允许执行操作或访问资源;否则,拒绝访问并返回相应的错误信息。

实现策略

在Python中,可以使用多种方法来实现权限功能。以下是一些常见的实现策略:

  • 基于装饰器的权限验证:使用装饰器将权限验证逻辑应用到函数或方法上。在每次调用函数或方法时,装饰器会首先进行权限检查,然后再执行实际的功能代码。
  • 中间件权限验证:在Web应用程序中,可以使用中间件来实现权限验证。中间件是位于应用程序和Web框架之间的一层,可以在请求到达应用程序之前进行权限检查和处理。
  • RBAC(Role-Based Access Control)模型:RBAC是一种广泛使用的权限管理模型,它将用户、角色和权限之间建立了清晰的关系。在Python中,可以使用RBAC模型来定义和管理用户角色、权限和访问控制。

示例代码

下面是一个简单示例,演示了基于装饰器的权限验证方法:

# 定义角色和权限的映射关系
roles = {
    'admin': ['read', 'write', 'delete'],
    'user': ['read']
}

# 装饰器函数,用于进行权限验证
def check_permission(role, permission):
    def decorator(func):
        def wrapper(*args, **kwargs):
            if role in roles and permission in roles[role]:
                return func(*args, **kwargs)
            else:
                raise PermissionError(f"Role '{role}' does not have permission '{permission}'.")
        return wrapper
    return decorator

# 使用装饰器进行权限验证
@check_permission('admin', 'write')
def write_data(data):
    print(f"Writing data: {data}")

@check_permission('user', 'read')
def read_data():
    print("Reading data")

# 测试权限验证
try:
    write_data("Hello world")  # 权限验证通过,执行写入数据操作
except PermissionError as e:
    print(e)

try:
    read_data()("Hello world")  # 权限验证通过,执行读取数据操作
except PermissionError as e:
    print(e)

总结

Python的权限功能设计为应用程序提供了保护数据的安全性和访问控制的重要手段。通过角色和权限模型,可以对用户进行分类和权限分配。通过权限验证和实现策略,可以在用户尝试执行操作或访问资源之前进行权限检查,并根据结果允许或拒绝访问。选择适合应用程序需求的权限实现策略,如装饰器、中间件或RBAC模型,可以确保应用程序的数据安全性和访问控制。设计和实现合理的权限功能,是构建安全可靠的Python应用程序的重要一环。

如果你对编程知识和相关职业感兴趣,欢迎访问编程狮官网(https://www.w3cschool.cn/)。在编程狮,我们提供广泛的技术教程、文章和资源,帮助你在技术领域不断成长。无论你是刚刚起步还是已经拥有多年经验,我们都有适合你的内容,助你取得成功。
为何PostgreSQL性能优于MySQL?

thbcm阅读(297)

在数据库选择过程中,性能是一个至关重要的考虑因素。PostgreSQL和MySQL是两个广泛使用的关系型数据库管理系统,它们在性能方面有着不同的特点。本文将深入探讨为何PostgreSQL在某些方面表现优于MySQL,并解释其中的原因。

多版本并发控制(MVCC)

  • PostgreSQL采用了MVCC作为其并发控制机制,而MySQL使用了锁机制。MVCC允许多个事务并发地读取和修改数据库,而不会导致读写冲突。相比之下,MySQL的锁机制在高并发环境下可能导致大量的锁竞争和死锁问题。
  • MVCC的优势在于读取操作不会被写入操作阻塞,从而提高了并发性能。它使用版本号来跟踪和管理数据的不同版本,因此读取操作可以同时进行,而不会受到写入操作的影响。

复杂查询优化

  • PostgreSQL在复杂查询的优化和执行方面表现出色。它的查询优化器能够根据统计信息和表结构,生成更高效的查询计划。此外,PostgreSQL支持更多复杂的查询类型,如递归查询、窗口函数和自定义聚合函数等,这些功能可以提供更灵活和高效的数据处理能力。
    -- PostgreSQL 示例
    BEGIN;
    UPDATE accounts SET balance = balance - 100 WHERE user_id = 1;
    UPDATE products SET stock = stock - 1 WHERE product_id = 123;
    COMMIT;
  • MySQL的查询优化器相对简单,并且在处理复杂查询时可能存在一些限制。这可能导致在某些情况下,MySQL的性能不如PostgreSQL。

数据完整性和约束

  • PostgreSQL提供了更严格和灵活的数据完整性和约束机制。它支持更多的数据类型、检查约束、外键约束和域约束等。这些约束可以在数据库层面保证数据的有效性和一致性。
    -- PostgreSQL 添加约束
    CREATE TABLE users (
        user_id SERIAL PRIMARY KEY,
        username VARCHAR(50) UNIQUE NOT NULL,
        email VARCHAR(255) UNIQUE NOT NULL
    );
  • 相比之下,MySQL的数据完整性和约束机制相对简单。它对数据类型和约束的支持较少,可能需要在应用程序层面进行额外的验证和处理。这可能导致数据一致性和安全性方面的一些问题。

扩展性和插件支持

  • PostgreSQL具有良好的扩展性和插件支持。它提供了许多内置的扩展和插件,如全文搜索、地理空间数据处理和JSON支持等。此外,PostgreSQL还支持编写自定义的扩展和插件,以满足特定需求。
    -- PostgreSQL JSONB 示例
    CREATE TABLE documents (
        doc_id SERIAL PRIMARY KEY,
        content JSONB
    );
    
    INSERT INTO documents (content) VALUES ('{"title": "Sample Document", "author": "John Doe"}');
    
    -- PostgreSQL 查询计划
    EXPLAIN SELECT * FROM products WHERE category = 'Electronics';
    
    -- 使用索引
    CREATE INDEX idx_products_category ON products(category);
  • MySQL的扩展性和插件支持相对较弱。虽然MySQL也提供了一些扩展和插件,但数量和功能上都不及PostgreSQL。

总结

尽管MySQL是一种广泛使用的数据库管理系统,但在某些方面,PostgreSQL表现出更好的性能。其采用的MVCC并发控制机制、复杂查询优化、严格的数据完整性和约束、扩展性和插件支持等特性,使得PostgreSQL在高并发、复杂查询和数据一致性方面具有优势。然而,性能是一个复杂的问题,受到多个因素的影响,包括硬件配置、数据库设计和优化等。在选择数据库时,需要根据具体的应用需求和场景综合考虑各种因素,以确保选择合适的数据库系统。

如果你对编程知识和相关职业感兴趣,欢迎访问编程狮官网(https://www.w3cschool.cn/)。在编程狮,我们提供广泛的技术教程、文章和资源,帮助你在技术领域不断成长。无论你是刚刚起步还是已经拥有多年经验,我们都有适合你的内容,助你取得成功。
联系我们