Python爬虫—-Xpath语法快速入门

thbcm阅读(316)

什么是 Xpath?

       XPath 即为 XML 路径语言,它是一种用来确定 XML (标准通用标记语言子集)文档中某部分位置的语言。XPath 基于 XML 的树状结构,提供在数据结构树中找寻节点的能力。起初 XPath 的提出的初衷是将其作为一个通用的、介于 XPointer 与 XSL 间的语法模型。但是  XPath 很快的被开发者采用来当作小型查询语言。

       简单的来说:Xpath(XML Path Language)是一门在 XML 和 HTML 文档中查找信息的语言,可用来在 XML 和 HTML 文档中对元素和属性进行遍历。

XPath 开发工具

       这里给大家介绍两个小编用得较多也是用得最为广泛与便捷的工具:

  • Chrome 插件 XPath Helper (需科学上网);
  • Firefox 插件 Try XPath。

       当然 Chrome 插件 XPath Helper 也可以寻找安装包后通过插件伴侣安装,安装方法步骤如下:

  1.  打开插件伴侣,选择下载好的插件;
  2. 选择提取插件内容到桌面,桌面上会多一个文件夹;
  3. 把文件夹放入想要放的路径下;
  4. 打开谷歌浏览器,选择扩展程序,开发者模式打开,选择加载已解压的扩展程序,选择路径打开即可。

XPath 节点

       在 XPath 中,有七种类型的节点:元素、属性、文本、命名空间、处理指令、注释以及文档(根)节点。XML 文档是被作为节点树来对待的。树的根被称为文档节点或者根节点。

XPath 语法

       XPath 使用路径表达式来选取 XML 文档中的节点或节点集。节点是通过沿着路径 (path) 或者步 (steps) 来选取的。

       使用方式:

       使用 // 获取整个页面当中的元素,然后写标签名,然后在写谓语进行提取,比如:

//title[@lang=’en’]

       需要注意的知识点:

  •  / 和 // 的区别:/ 代表只获取子节点,// 获取子孙节点,一般 // 用的比较多,当然也要视情况而定;
  • contains:有时候某个属性中包含了多个值,那么可以使用 contains 函数,示例如下:

//title[contains(@lang,’en’)]

  • 谓词中下标是从 1 开始的,不是从 0 开始的

lxml 库

       lxml 是 一个HTML/XML的解析器,主要的功能是如何解析和提取 HTML/XML 数据。

       该库为第三方库需使用 pip 进行安装,命令如下:

pip install lxml

 基本使用:

       如下是案例实操的 html 文件代码,屏幕前的小伙伴可以保存下来一起动手练习。

<div>

    <ul>

         <li class=”im-0″><a href=”link1.html”> first </a></li>

         <li class=”im-1″><a href=”link2.html”> second </a></li>

         <li class=”im-active”><a href=”link3.html”> third </a></li>

         <li class=”im-1″><a href=”link4.html”> fourth </a></li>

         <li class=”im-0″><a href=”link5.html”> fifth </a>

     </ul>

 </div>

案例 1:将字符串解析为 html 文档

from lxml import etree

text = ”

html = etree.HTML(text) #读取

print(html)

# 按字符串序列化html

result = etree.tostring(html).decode(‘utf-8’)

print(result)

案例 2:从文件中读取 html 代码:

from lxml import etree

html = etree.parse(‘hello.html’) #读取

# 按字符串序列化html

result = etree.tostring(html).decode(‘utf-8’)

print(result)

案例 3:在 lxml 中使用 Xpath 语法

from lxml import etree

html = etree.parse(‘hello.html’)

# 获取所有 li 标签:

# result = html.xpath(‘//li’)

# print(result)

# for i in result:

#     print(etree.tostring(i))

# 获取所有li元素下的所有 class 属性的值:

# result = html.xpath(‘//li/@class’)

# print(result)

# 获取 li 标签下 href 为https://www.w3cschool.cn/的 a 标签:

# result = html.xpath(‘//li/a[@href=”https://www.w3cschool.cn/“]’)

# print(result)

# 获取 li 标签下所有 span 标签:

# result = html.xpath(‘//li//span’)

# print(result)

# 获取 li 标签下的 a 标签里的所有 class:

# result = html.xpath(‘//li/a//@class’)

# print(result)

# 获取最后一个 li 的 a 的 href 属性对应的值:

# result = html.xpath(‘//li[last()]/a/@href’)

# print(result)

# 获取倒数第二个 li 元素的内容:

# result = html.xpath(‘//li[last()-1]/a’)

# print(result)

# print(result[0].text)

# 获取倒数第二个 li 元素的内容的第二种方式:

result = html.xpath(‘//li[last()-1]/a/text()’)

print(result)

总结:

      纸上得来终觉浅,绝知此事要躬行,一份耕耘,一份收获。

推荐好课:Python 静态爬虫Python Scrapy网络爬虫

真惨!连各大编程语言都摆起地摊了!

thbcm阅读(380)


本文来源:公众号「编程技术宇宙」

作者:轩辕之风O


困难年年有,今年特别多。

公司要做一个新的网站,可预算有限,听说为了生计,各大编程语言们都摆起了地摊儿,我决定去瞧瞧,看看能不能淘点做网站需要的东西。

选择静态web服务器

一进集市,这烟火气就扑面而来,平时一个个端着架子的C++、Java、Python居然能放下身段,招呼叫卖,我还是头一回见。

“老哥,需要来点什么?”,C语言给我打起了招呼。

“我想要建个网站”,我回答到。

“那你可算来对地方了”,C语言摊主起身说到,“建网站总得需要一个Web服务器吧,你看这里,apacheweb服务器,卖的可好了”

我摇了摇头,“这个apache,之前有用过,是用的多进程模型,连接多了有些吃力啊?”

“老哥是行家啊,来看这一款我们最新推出的nginx服务器,采用epoll多路复用+事件驱动,性能强劲!上万连接不在话下”,C语言摊主自豪的说到。

随后摊主给我展示了这个nginx服务器的能力,果然不错,我加入了购物车,继续往前逛。

挑选web应用开发框架

没走几步来到 C# 的摊前。

“哟,老哥,你这是要做网站啊?”,C#摊主主动给我打起了招呼。

“你怎么知道的?”,我好奇的问到。

“你这购物车里不是装了一个nginx嘛!既然做网站,可得试试我们家的.NET Framework哦,各种装备,应有尽有。”,C#热情的拉着我过去。

不过我还是拒绝了他:“实在不好意思,听说你们家产品只能在Windows系统上面运行,不支持Linux,还是算了,我再看看别家”

C#摊主不肯放弃,“别呀,我们已经支持Linux了,您再看看,现在搞活动,免费送IIS服务器哦,你把那nginx退了吧,喂,再考虑一下啊·····”

不等他说完,我就溜走了,来到了Python的摊前。

Python摊主也看出了我要做网站,也推销起他家的产品来。

“大哥,你做网站,肯定不想只做一个静态的吧,来试试咱们家的Web框架做一个动态网站?咱Python家的产品,简单、轻量又实惠。”,摊主热情的说到。

“有哪些推荐的呢?”,我问到。

Python摊主指着摊位上的几个产品说道:“有DjangoFlaskTornado这三款是现在主打拳头产品,用了的都说好”

我正想蹲下仔细看看,背后传来一个声音:“这位大哥,搁这选Web开发框架呐?快来我这边看看”

一边说,一边硬把我往后面拽。

来到他的摊位上,我一看原来是PHP摊主。

“咱PHP产品琳琅满目,就是专门为做网站而生的,现在做活动,跳楼价只要9.9,错过不再有!”

这PHP摊主好生能说,一顿猛夸把我说的晕头转向,不知怎的竟然就加入了购物车。

继续向前,来到了Java的摊位,一个好大的摊位,摆放的东西也是看的人眼花缭乱。

“你这个摊位不错啊,又宽敞人流又多”

“可不是咋的,刚为了抢这个摊位,跟PHP那家伙还干了一架呢。”,Java摊主笑着说到。

看到我购物车里的东西,Java摊主也开始推销起来:“大哥,这年头怎么还用PHP那家伙的东西,赶紧去退了吧,咱Java摊里的东西都是大品牌,质量有保障!”

“这,不太好吧,这PHP也是大品牌啊”

Java摊主摇了摇头,“他一个脚本语言怎么跟我们比啊?大哥你看,我们有Spring、SpringMVC、SpringBoot、SpringCloud等等明星产品,用户众多,售后工作也到位。而且现在搞活动可以送tomcat服务器,你要是用户量不多都可以把nginx退掉,省一笔钱。”

“看起来很厉害的样子呢,我考虑一下”,我打算再去别的地方看看比较一下。

Java摊主一把拉住了我,“大哥,不说了,咱今天碰到是缘分,你做网站有很多服务是吧,得用到RPC吧,你今天下单,我再送你一套netty框架,又能帮你省一笔了”

Java摊主盛情难却,我一时兴起,买下了好几个,购物车都装满了一大半了。

挑选数据库

刚付完钱准备离开,背后又传来一个声音:“大哥,做网站你得用数据库吧,快来这看看”

我寻声望去,原来是 C++ 摊主在叫我。

“来看看我的MySQL数据库,做网站必备!”

我看了一下产品说明书,感觉还不错,看了下钱包,刚才在Java摊主那里花费不少,有些囊中羞涩了,问到:“能不能优惠一点”

C++摊主一听,脸上的笑容少了一半,“如果你选个MongoDB组个套餐,可以给你8折优惠”

“MongoDB?我要这个干嘛”

摊主一听来了劲头,开始滔滔不绝:“有些数据啊他不适合存在数据库里,比如文档啊,JSON啊,这些东西你要用数据库存储,增加字段和查询,可麻烦了,你用MongoDB就方便都多了······”

被他说了一通,感觉是得要个这个玩意儿。

摊主见我有些心动,又继续推销:“大哥看来真是行家,您做网站是不是有图片音频视频需要存储,我这里还有一个对象存储(OSS)系统CEPH,你看看要不要也一并带上,我还是给您八折,怎么样?”

“实在不好意思,我这预算有些吃紧了,这个就算了吧”,我婉拒到。

“哎哎大哥您往这瞧,咱家也有对象存储minio,现在市场推广期,免费送了!”,旁边的Golang摊主招呼了起来。

居然有免费这好事,我倒是想去看看。

C++摊主见状小声说到:“免费的你敢用,出了问题都找不到人,还是看看我的吧,直接给你六折,怎么样?”

我一想也是,正想下单买下,背后传来一声“且慢”!

我回头一看,原来是刚才的Java摊主,“大哥,咱Java家的ElasticSearch也考虑一下呗。”

我回到Java摊主这边,问到:“这又是个什么?我需要用到吗?”

Java摊主也开始给我掰扯起来:“咱家的ElasticSearch那可是搜索行家,你网站内容多了是不是需要个搜索功能啊,咱家的这个ES,全文搜索不在话下,秒级响应,做网站必备啊。看你是回头客,给你九折!”

我正想做一个搜索功能,看来这个也是必不可少,也一起拿下了。

缓存服务器

我推着购物车准备回家了,今天真是满载而归。

来到集市出口,又碰到了一开始的C语言摊主,摊主一瞧挥着手喊道:“大哥,你还差个内存缓存系统,过来看看,Redis搞活动呢!哎,别走啊,Memcached亏本处理了,过来看看啊”

我一摸钱包,完蛋,严重超支了!我加快了步伐,匆忙离开······

彩蛋

看着我采购回来的一堆东西,老板是气不打一处来。

“咱们就做一个内网论坛,全公司不过100号人,你给我搞这么多,几个意思?”

“老板,您听我解释···”

“解释个啥,明天不用来了”

哦豁,丢了饭碗,我也去摆地摊了···

鸿蒙OS 2.0手机开发者Beta发布

thbcm阅读(325)

北京时间12月16日上午10点,华为在北京举行了 HarmonyOS 2.0 手机开发者Beta活动。

鸿蒙OS借助分布式能力造就新硬件、新交互、新服务,打开焕然一新的全场景世界,将必然成为下一个时代——万物互联时代的王者,虽然物联网的概念兴起多年,但是智能设备的割裂,让万物互联始终停留在一个概念上,鸿蒙OS将是把这个概念变成事实的强大操作系统。

版本介绍

HarmonyOS 是面向万物互联时代的全场景分布式操作系统,并不是基于单手机形态的操作系统。因为万物互联是未来10年~20年的主流趋势,华为希望和设备厂商以及应用开发者一起打造一个面向万物互联时代的超级终端体验。

HarmonyOS 2.0支持的设备

HarmonyOS 2.0相比HarmonyOS 1.0(华为智慧屏)会支持更多的设备品类。

  • 2020年9月,华为智慧屏、智能穿戴、车机设备基于HarmonyOS进行开发者beta,具体请参见智慧屏、智能穿戴、车机。华为面向第三方的设备发布HarmonyOS开源(128K~128M内存),具体请参见联接类模组设备、智慧视觉类设备。
  • 2020年12月,华为发布基于HarmonyOS进行手机开发者beta。

手机开发者beta功能

手机开发者beta,提供如下主要功能,应用的开发过。

  • 全新的手机UI控件,新增50+UI控件,供开发者开发手机HarmonyOS应用,统一多设备UI交互体验。
  • HarmonyOS应用框架支持手机,支持HarmonyOS应用在多设备上快速迁移、接续、流转、无安装加载。
  • 提供Windows及MaC平台开发编译工具链体验,方便开发者快速开发HarmonyOS应用。
  • 为手机开发者提供40+个 Sample Code,方便开发者快速了解适应HarmonyOS接口及开发方式。
  • 开放多模态感知等分布式能力接口,支持感知用户多种的移动状态。
  • 提供标准化的输入法框架及能力,开发者可开发多种输入方式及功能。
  • 提供标准化的电话系统接口能力。
  • 提供完善的无障碍开发框架,开发者可以方便的开发无障碍应用。
  • 提供标准化的分布式数据管理能力,开发者可以调用标准化的分布式DB接口,实现数据在设备间实时同步。
  • 增强账号系统能力,可将无账号设备纳入到HarmonyOS分布式系统中。

快速上手

应用快速入门

HarmonyOS应用基于工具开发,采用应用程序框架、系统自带的UI控件、丰富的API接口,开发者可以轻松地实现具有多维、自然交互特点的应用程序。HarmonyOS采用了多种分布式技术,使得应用程序的开发实现与不同终端设备的形态差异无关。这能够让开发者聚焦上层业务逻辑,更加便捷、高效地开发应用。

HarmonyOS软件包以APP Pack(Application Package)形式发布,它是由一个或多个HAP(HarmonyOS Ability Package)以及描述每个HAP属性的pack.info组成。HAP是的部署包,HarmonyOS应用代码围绕Ability组件展开。。

设备快速入门

HarmonyOS设备基于HUAWEI DevEco Device Tool 工具开发。基于Hi3861开发板,支持联接类模组设备的开发;基于Hi3518开发板、Hi3516开发板,支持智慧视觉类设备的开发。开发板持续扩展中。

配套工具

应用开发工具

HUAWEI DevEco Studio提供如下功能:

  • 工程模板,入门简单:新增手机和平板两种设备的HarmonyOS应用开发,手机工程模板9个,平板工程模板2个。
  • 跨端应用,分布调试:支持跨设备分布式应用开发,一个工程开发多个设备的FA/PA,并进行分布式调试和部署。
  • 多端应用,实时预览:支持实时、动态、多端的界面预览,支持预览JS样式,也支持预览Java样式。
  • 模拟仿真,高效便捷:新增手机和平板两种设备的远程模拟器,方便开发者使用。

设备开发工具

HUAWEI DevEco Device Tool支持在Hi3516和Hi3518开发板上以USB方式进行烧录、支持Hi3861开发板以AT指令集方式输入。

查看 《HarmonyOS 开发文档

HarmonyOS 2.0下载

jQuery选择器都有哪些?都有什么作用?

thbcm阅读(329)

选择器,就是用一种方法把你所要的元素选中。这个元素被选中了,你就能对它进行各种操作。jQuery 选择器和 CSS 选择器几乎完全一样,当然了,学习 jQuery 之前你必须要学会CSS基础教程

在 JavaScript 中,如果你想要选取一个元素,只能使用 getElementByID( ),getElementTagName( ),getElementByClassName( ) 等方法来获取,这些方法的功能有限,而且名字”又长又臭”,估计已经吓跑了不少初学的小伙伴。

相比 jQuery 的选择器就不同了,jQuery 完全继承了 CSS 选择器的风格,对我们的开发提供了极大的便利。

一. ID选择器

二. Class选择器

三. 元素选择器

四. 层级选择器

五. 全选择器(*)

六.属性筛选选择器

选择器 描述
$(“[attribute|+’value’]”) 选择指定属性值等于给定字符串或以该文字串为前缀(该字符串后跟一个连字符“-”)的元素
$(“[attribute|+’value’]”) 选择指定属性具有包含一个给定的子字符串的元素(选择给定的属性是以包含某些值的元素)
$(“[attribute*+’value’]”) 选择指定属性用空格分隔的值中包含一个给定值的元素
$(“[attribute~=’value’]”) 选择指定属性是给定值得元素
$(“[attribute=’value’]”) 选择不存在指定属性,或者指定的属性值不等于给定值的元素
$(“[attribute^=’value’]”) 选择指定属性是以给定字符串开始的元素
$(“[attribute$=’value’]”) 选择指定属性是以给定值结尾的元素,这个比较是区分大小写的
$(“[attribute]”) 选择所有具有指定属性的元素,该属性可以是任何职
$(“[attribute$=’value’]”) 选择匹配所有指定的属性筛选器的元素

七.子元素选择器

选择器 描述
$(“:first-child”) 选择所有父级元素下的第一个子元素
$(“:last-child”) 选择所有父级元素下的最后一个子元素
$(“:only-child”) 如果某个元素是其父元素的唯一子元素,那么它就会被选中
$(“:nth-child”) 选择的他们所有父元素的第n个子元素
$(“:nth-last-child”) 选择所有他们父元素的第n个子元素。计数从最后一个元素开始到第一个

八.表单元素选择器

选择器 描述
$(“:input”) 选择所有 input,textarea,select 和 button 元素
$(“:text”) 匹配所有文本框
$(“:password”) 匹配所有密码框
$(“:radio”) 匹配所有单选按钮
$(“:checkbox”) 匹配所有复选框
$(“:submit”) 匹配所有提交按钮
$(“:image”) 匹配所有图像域
$(“:reset”) 匹配所有重置按钮
$(“:button”) 匹配所有按钮
$(“:file”) 匹配所有文本域

当然了还有其他的选择器,在 jQuery选择器 中可以找到

小编找到了非常适合初学者学习的 jQuery选择器检测器,jQuery的样式它应有尽有

为了达到边学边练的效果,jQuery微课绝对能帮到你完整学习jQuery

网站常见反扒方式

thbcm阅读(346)

今天小编带大家了解下,网站反爬虫方式,首先先给大家三个小问题,认真思考哦!

  • 网站反爬虫方式有哪些
  • 网站为什么要反爬虫
  • 如何应付反爬虫   

网站反爬虫方式:

 一、通过 User-Agent 来控制访问:  

无论是浏览器还是爬虫程序,在向服务器发起网络请求的时候,都会发过去一个头文件:headers, 表明身份,对于爬虫程序来说,最需要注意的字段就是:User-Agent 很多网站都会建立 User-Agent 白名单,只有属于正常范围的 User-Agent 才能够正常访问。

解决方法:可以自己设置一下 User-Agent,或者更好的是,可以从一系列的 User-Agent 里随机挑出一个符合标准的使用 。

二、通过 JS 脚本来防止爬虫:  

举个例子:如果想爬取某个网站,在请求之前,它会有一个验证页面来验证你是否为爬虫程序。它是怎么实现的呢?他会通过 JS 代码生成一大段随机的数字,然后要求浏览器通过 js 的运算得出这一串数字的和,再返回给服务器。

解决方法:  使用 PhantomJS !PhantomJS 是一个 Python 包,他可以在没有图形界面的情况下,完全模拟一个浏览器“,JS 脚本验证什么的再也不是问题了。


 三、通过IP限制来反爬虫:  

如果一个固定的 ip 在短暂的时间内,快速大量的访问一个网站,那自然会引起注意,管理员可以通过一些手段把这个 ip 给封了,爬虫程序自然也就做不了什么了。

解决方法:比较成熟的方式是:IP 代理池 简单的说,就是通过 ip 代理,从不同的 ip 进行访问,这样就不会被封掉 ip 了。可是ip代理的获取本身就是一个很麻烦的事情,网上有免费和付费的,但是质量都层次不齐。

如果是企业里需要的话,可以通过自己购买集群云服务来自建代理池。

实现方式如下:

def get_ip_poll():     

”’     

模拟代理池     返回一个字典类型的键值对,    

 ”’    

   ip_poll = [“http://xx.xxx.xxx.xxx:9999”,

              “http://xx.xxx.xxx.xxx:8000”, 

             “http://xx.xxx.xxx.xxx:8080”, 

             “http://xx.xxx.xxx.xxx:9922”,  

            “http://xx.xxx.xxx.xxx:8090”]

   addresses = {}     

   addresses[‘http’] = ip_poll[random.randint(0, len(ip_poll))]      

return addresses  

四、通过 robots.txt 来限制爬虫:  

世界上做爬虫最大最好的就是 Google 了,搜索引擎本身就是一个超级大的爬虫,Google 开发出来爬虫 24h 不间断的在网上爬取着新的信息,并返回给数据库,但是这些搜索引擎的爬虫都遵守着一个协议:robots.txt  robots.txt(统一小写)是一种存放于网站根目录下的 ASCII 编码的文本文件,它通常告诉网络搜索引擎的漫游器(又称网络蜘蛛),此网站中的哪些内容是不应被搜索引擎的漫游器获取的,哪些是可以被漫游器获取的。robots.txt协议并不是一个规范,而只是约定俗成的,所以并不能保证网站的隐私。

注意robots.txt是用字符串比较来确定是否获取URL,所以目录末尾有与没有斜杠“/”表示的是不同的URL。

robots.txt 允许使用类似”Disallow: *.gif”这样的通配符[1][2]。因为一些系统中的 URL 是大小写敏感的,所以 robots.txt 的文件名应统一为小写。robots.txt 应放置于网站的根目录下。如果想单独定义搜索引擎的漫游器访问子目录时的行为,那么可以将自定的设置合并到根目录下的 robots.txt,或者使用 robots 元数据(Metadata,又称元数据)。

当然在特定情况下,比如说我们爬虫的获取网页的速度,和人类浏览网页是差不多的,这并不会给服务器造成太大的性能损失,在这种情况下,我们是可以不用恪守 robots 协议的。

今天的分享内容就到这啦。推荐好课:Python3 入门Python3 进阶

新手小白如何学好Python?

thbcm阅读(346)

Python 是一门什么语言呢?答案是肯定的:它是一门语法简洁、功能强大、上手及其简单、应用领域极为广泛的一门计算机编程语言。

根据 TIOBE 最新的排行,Python 已超越众多编程语言,与 C、JAVA 成为了当今三大流行语言之一。

那么新手小白如何学好 Python?有哪些方法可以参考吗?小编在这里谈一些自己的方法。

1. 打基础 

实际上,对于学习编程而言,即使 Python 是其中最为简单的编程语言,无限地接近人类的语言习惯,但其学习起来还是有一定的门槛的,所以在前期打好基础尤其重要。

小编在这呢也不建议新手在一开始学习就配置相关的开发环境,即使 Python 编译器安装过程十分简单,这听起来似乎很矛盾,没有相关的编译器如何编写代码呢?但请一定相信我,小编有几位朋友,在了解 Python 的热门程度后对学 Python 的热情一度十分高涨,但他们因为语言工具包和相关 IDE 的安装失败便逐渐的屎去了学习的欲望,从入门到“入土”不是闹着玩的。

小编在这建议用一些免费课程的网页编译器去边学边练,既可以学习相关知识点,也可以敲写代码,再也不用当心被编译环境劝退了。在这里给大家分享小编当初学 Python 的地方:Python2 教程Python3 教程

只有前期基础打好,后期写项目会有一种打通任督二脉的快感,编程之路一定要耐心,细心。

2. 模块库

当我们将基础知识学会了,接下来可以学一些简单的第三方的模块库,比如:turtle 绘图库,urllib、requests 爬虫模块等。

小编第一个学习的便是 urllib 爬虫库,满足自己的一些小癖好,我自己在学习 urllib 模块的时候,爬取了某“农药”手游的几百张皮肤,反正这个阶段你看你想要的方向是什么,你就学什么。

3. 实战项目 

在实战项目阶段,就要开始进行框架学习啦,面向网站开发的 djangoflask,爬虫的 scrapy

多动手实践,始终相信,实践是检验真理的唯一标准,查找和处理过程中遇到的问题和一场,遇到问题多搜索。

在成功解决这些问题之后,会有一个很大的成就感,这样就形成了一种正反馈,才是你学习 Python 最大的动力来源。

PHP是什么语言?

thbcm阅读(351)

曾看到过这么一则笑话:

某女:你能让这个论坛的人都吵起来,我今晚就跟你走。

某软件工程师:PHP 是最好的语言!某论坛真的就炸锅了,各种吵架……

某女:服了你了,我们走吧,你想干啥都行。

某软件工程师:今天不行,我一定要说服他们,PHP必须是最好的语言……


实则,PHP 是最好的语言这个梗不是出自别处,而是出自 2001 年 7 月的 PHP 的官方文档中!

PHP is the best language for web programming, but what about other languages?

PHP是网络编程最好的语言,但其他语言又怎样呢?

–PHP and other languages

那么 PHP 究竟有怎样的魔力,使得其如此自信,使得无数人趋之若鹜呢?

PHP(PHP: Hypertext Preprocessor,“超文本预处理器”)是一种通用开源的、简单的,面向对象的,解释型的,健壮的,安全的,性能非常之高的,独立于架构的,可移植的,动态的脚本语言。

PHP 语法结合了 C、Java、Perll 以及其自创的语法,其独特之处竟令大部分 PHP 开发者必须得有个参考手册握在手边才敢写代码。

但它仍然能够吸引众多开发者,最为重要的原因无疑就是:超低的门槛、广大的用户群体。以及别的语言绝无仅有的东西,你行吗你?记忆卡。。。

言归正传,PHP 能够比 CGI 或者 Perl 更快速的执行动态网页。用 PHP 做出的动态页面与其他的编程语言相比,PHP 是将程序嵌入到 HTML 文档中去执行,执行效率比完全生成 HTML 标记的 CGI 要高许多;与同样是嵌入 HTML 文档的脚本语言 JavaScript 相比,PHP 在服务器端执行,充分利用了服务器的性能;PHP 执行引擎还会将用户经常访问的 PHP 程序驻留在内存中,其他用户在一次访问这个程序时就不需要重新编译程序了,只要直接执行内存中的代码就可以了,这也是 PHP 高效率的体现之一。PHP 具有非常强大的功能,所有的 CGI 或者 JavaScript 的功能 PHP 都能实现,而且支持几乎所有流行的数据库以及操作系统。

PHP 它驱动全球超过 2 亿多个网站,有全球超过 81.7% 的公共网站在服务器端采用 PHP。PHP 常用的数据结构都内置了,使用起来方便简单,也一点都不复杂,表达能力相当灵活。

洗白:

PHP 具有简单易懂的语法,没有奇怪的黑魔法,可以同时面向过程和面向对象,在安装后各种扩展集于一身,包括但不限于 MySQL,JSON,mbstr 等,极为方便。一个网页用 HTML 和 PHP 实现不得有手就行,甚至最新版的 PHP 中都已内置了小型的 Web 服务器,连 apache 和 nginx 都不用上、一分钟搭建博客论坛就问你怕不怕,国外 Ci、laravel、kohana、zf 等框架层出不穷、国内 tp 社区棒、语言创建者积极上进优化、语言 bug 全世界的程序员和你一起修复。最重要的是大小公司都用、找工作不愁啊!

好课推荐:

PHP快速入门到开发就业PHP入门篇:十天学会PHP(2020版)

Vue很难学吗?手把手教你写Vue

thbcm阅读(347)

Vue是什么?

Vue.js 是一套用于构建用户界面的渐进式框架。
与其他重量级框架不同的是,Vue 采用自底向上增量开发的设计。
Vue 的核心库只关注视图层,它不仅易于上手,还便于与第三方库或既有项目整合。
另一方面,当与单文件组件和 Vue 生态系统支持的库结合使用时,Vue 也完全能够为复杂的单页应用程序提供驱动。

很多同学可能觉得 Vue 很难学因此不敢于尝试,接下来小编带你了解最基础的编写“Hello World”,相信通过这个你就有信心去学习掌握 Vue。

Vue环境设置

由于我们需要让一切保持简单,为什么不适用 CDN,它基本上是由另一台服务器导入 Vue.js 的。在目前而言为了练习、理解和学习 Vue 的基础知识,您可以将这种简单的设置用于非常小的项目中。

选项1:

<!– development version –>

<script src=”https://cdn.jsdelivr.net/npm/[[email protected]](/cdn-cgi/l/email-protection)/dist/vue.js”></script>

<!– production version –>

<script src=”https://cdn.jsdelivr.net/npm/[[email protected]](/cdn-cgi/l/email-protection)”></script>

选项2:

<script src=”https://unpkg.com/[[email protected]](/cdn-cgi/l/email-protection)/dist/vue.js”></script>

选项3:

您可以将 Vue.js的开发或生产版本下载到本地,并使用 HTML 文件中的 script 标签直接将其包含在内。

注意:开发版本包含控制台警告,这些警告对于调试非常有用。而生产版本主要针对大小(通过使用 vue.js 文件的缩小版本等)和速度进行了优化,这对于在实时环境中发布非常重要。

初始代码

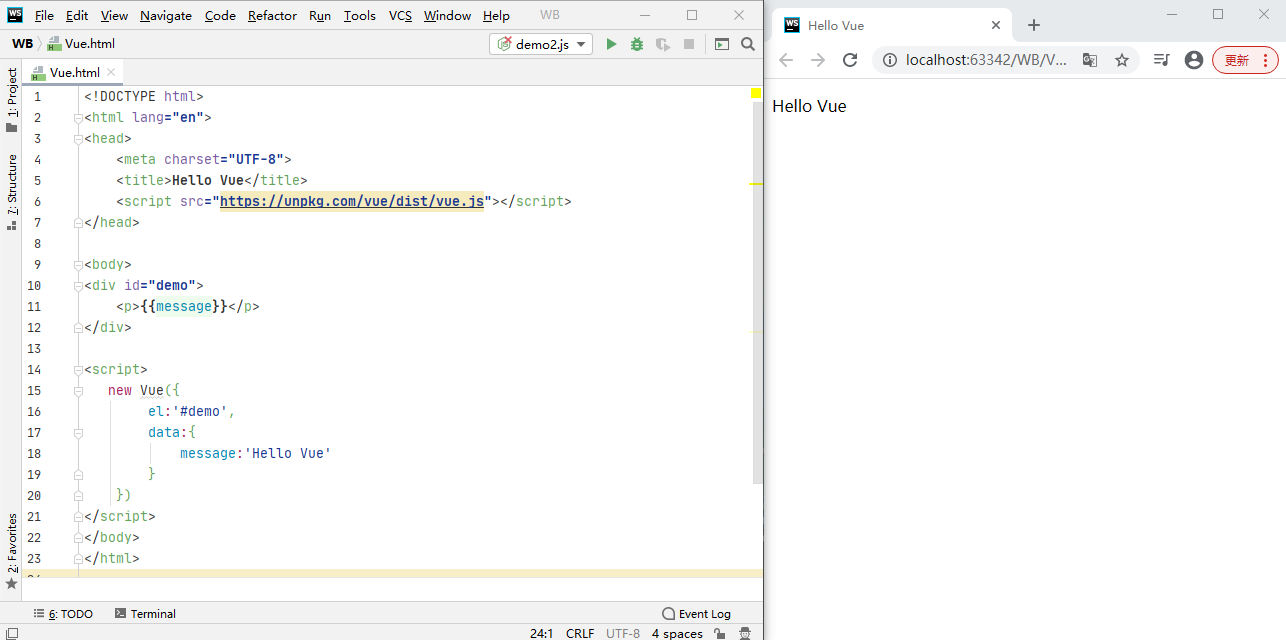
使用以下代码创建一个 HTML 文件 

<!DOCTYPE html>

<html>

  <head>

    <title>Hello Vue!</title>

    <!– including Vue with development version CDN –>

    <script src=”https://cdn.jsdelivr.net/npm/vue/dist/vue.js”></script>

  </head>

  <body>

    <div id=”app”>

      <h1>Hello World!</h1>

    </div>

  </body>

</html>

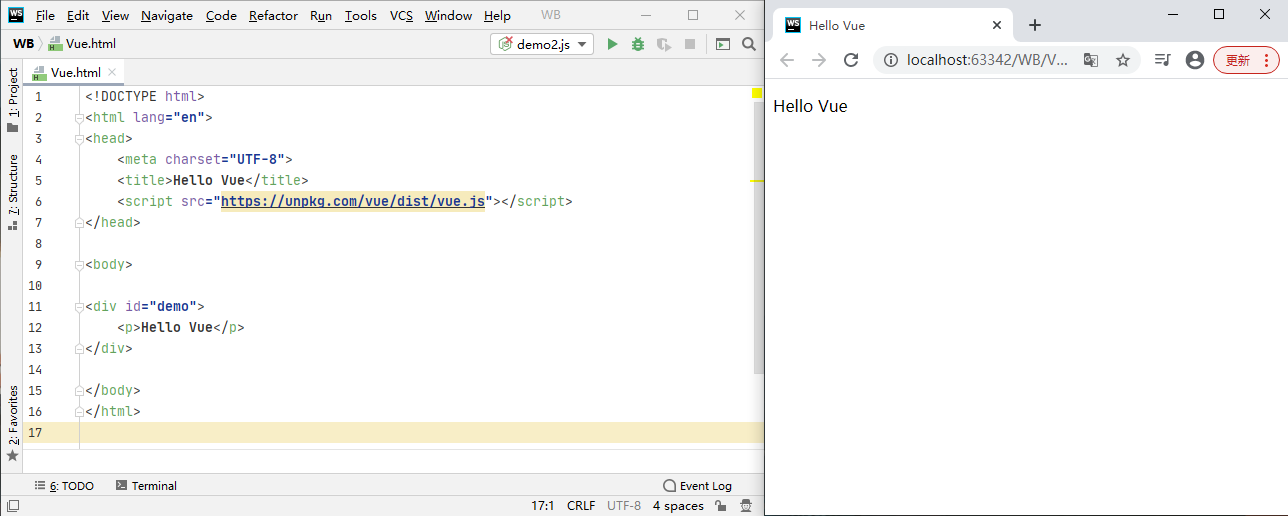
代码非常简单基础。我们给页面命名为“Hello Vue”。以及<head>部分中使用带有<script>标签的 CDN 的 vue.js 的开发版本。我们正显示“Hello World”<body>部分中带有 id=“demo”的<div>元素内<h1>标签内的消息。

浏览器中的当前输出如下:

进入 Vue 实例

步骤 1:创建新的 Vue 实例

我们已经使用<script>标签将 Vue.js 导入了我们的项目,但这并不能解决问题。 这相当于在我们的工作台上有一台笔记本电脑。 要打开它并完成一些工作,我们必须按下电源按钮。 同样,要在我们的项目中使用 Vue,我们必须使用new关键字创建 Vue 对象的实例。 这个实例是 Vue 的电源按钮!

new Vue();

步骤 2:传递选项对象

仅创建实例只会为 Vue 供电。 但是我们想对 Vue 做更多的。 为此,我们必须将选项或配置对象作为参数传递给刚创建的实例。 此选项对象具有 Vue 可以识别的一些保留属性,它们被指定为键值对。 顾名思义,并非所有属性都是必需的,可以在需要时指定。 通常,它们用于存储数据和执行某些操作。

例如:“el”,“data”,“method”等。

new Vue({ options/config object });

步骤 3:建立与 DOM 的连接

我们希望以某种方式获取对我们希望操纵的一部分 HTML 代码的控制。 在我们的示例中,它是带有 id 和“app”的<div>元素,因此我们可以通过 Vue 显示消息“Hello World”。

为了在 Vue 实例和 DOM 的一部分之间建立这种连接,以便可以根据我们的需要对其进行控制,我们有一个名为“el”的保留属性,该属性转换为元素。 此属性将字符串作为值指定为 CSS 选择器,即id的“#”和“.”对于class。

new Vue({ el: “#app” });

通过此简单的代码行,我们现在将带有 id 的<div>元素,“app”及其内容链接到 Vue 实例。 它们现在不可分割!

步骤 4:指定我们的数据

为了存储我们要在此 Vue 实例及其链接的 DOM 中使用的所有数据/信息,我们还有一个保留的属性,称为“data”。 与“el”不同,“data”将对象作为其值。 由于我们要向 DOM 显示消息“Hello World”,因此让我们在“数据”对象中将其指定为键值对。

new Vue({ el: “#app”, data: { message: “Hello World” } });

步骤 5:将此数据呈现到 DOM

只需使用如下所示的两个大括号即可将 Vue 实例的数据对象中指定的值呈现到 DOM。 (有关更多信息,请参阅下一篇文章!)

<div id=”app”> <h1>{{ message }}</h1> </div>

为了区分上一个输出(没有 Vue),使用 Vue 来显示,请让我们显示“Hello World!”而不是“Hello World!

看吧,Vue是不是很简单?这么容易就完成了一个实例

当然了,Vue还有更多拓展的内容,小编特地帮你挑选出来供你学习

Python常见BUG类型

thbcm阅读(340)

很多小伙伴,在初学习 Python 的过程中,遇见 BUG 时便手忙脚乱,不知如何是好,今天小编在这给大家总结了一些常见的 BUG 类型及其应对措施,希望小伙伴们认真阅读做好笔记呢。

错误类型 1:语法错误

i = 1 

while True :

    i += 1

    if i == 100 :

        return

报错:

SyntaxError: ‘return’ outside function

从代码中不难看出这位小伙伴是想执行一个循环体,当 i 的值等于 100 时停止计算并返回,而 return 不能够再方法以外使用。

解决方法:

i = 1 

while True :

    i += 1

    if i == 100 :

        break

错误类型 2:类型错误

 name = ‘老王’

 age = 50

 print(‘我是’ + name + ‘,年龄’ + age)

报错:

TypeError: must be str, not int

从代码中可以看出该为小伙伴是想将名字和年龄做一个组合输出,但在进行 + 拼接时,必须使用字符串,而年龄却是 int 类型。

解决办法:将 int 类型数据转成字符串。

name = ‘老王’

age = 50

print(‘我是’ + name + ‘,年龄’ + str(age))

错误类型 3:语法错误

name = ‘老王’

if name = ‘老王’:

    print(‘Hello’)

报错:

SyntaxError: invalid syntax

此处看似是在判断 name 是否为’小王’如果是则输出  ‘Hello’,但却忽略了 ‘=’ 符号是赋值符,’==’ 才是比较符。

解决方法:

name = ‘老王’

if name == ‘老王’:

    print(‘Hello’)

错误类型 4:缩进错误

  name = ‘老王’

  for index in range(10):

  if name == ‘老王’: 

     print(‘Hello’)

else: 

    print(‘No body’)

报错:

IndentationError: unindent does not match any outer indentation level

该类型报错较为常见,也比较不应该,主要还是由于粗心大意而忽视了语法的缩进符。

解决方法:使用 4 个空格代表缩进,或摁 tab 实现自动缩进。

name = ‘老王’

for index in range(10):

  if name == ‘老王’: 

    print(‘Hello’)

  else: 

    print(‘No body’)

错误类型 5:索引错误

 text = ‘hello world’

 print(text[11])

报错: 

IndexError: string index out of range

该类型的错误为所需提取的字符串超出了范围,记住字符串下标是从 0 开始计数的,而不是从 1 开始,另外字符串内的空格也是计数的。

错误类型 6:值错误

text = ‘Hello World’

result = text.index(‘你好’)

print(result)

报错: 

ValueError: substring not found

该类型错误是用户想要在字符串中查找不存在的字符串,查找字符串时先确认原字符串是否有我们需要的子字符串。

错误类型 7:索引错误

list1 = [‘迪迦’,’赛文’,’塞罗’,’艾斯’]

print(list1[4])

报错:

IndexError: list index out of range

该用户是想取出列表中的最后一个位置的信息,但取值超出了列表范围或列表不存在,记住列表的下标也是从 0 开始计数的。

解决办法:

list1 = [‘迪迦’,’赛文’,’塞罗’,’艾斯’]

#方法一

print(list1[3])

#方法二

print(list1[-1])

错误类型 8:属性错误

tp1 = (‘to’, ‘be’, ‘or’, ‘not’, ‘to’, ‘be’)

tp1.remove(‘to’)

报错:

AttributeError: ‘tuple’ object has no attribute ‘remove’

可以看出用户是想将元组的 ‘to’ 信息删除,然而却忽略了元组没有 remove 方法。

解决方法:将元组转换成列表后进行删除操作。

tp1 = (‘to’, ‘be’, ‘or’, ‘not’, ‘to’, ‘be’)

list1 = list(tp1)

list1.remove(‘to’)

错误类型 9:键错误

 dic1 = {

    ‘name’:’老王’,

    ‘age’:50,

    ‘friend’:[‘孙子’,’孔子’,’老子’,’迪迦’]

}

print(dic1[‘height’])

报错:

KeyError: ‘height’

key 键错误:没有指定的键值 ‘height’ ,从用户定义的字典不难看出里面并无 ‘height’ 这个键,而用户却像从中取没有的值,不难免报错了。

错误类型 10:类型错误

dic1 = { 

    ‘name’:’老王’,

    ‘age’:50,

    ‘friend’:[‘孙子’,’孔子’,’老子’,’迪迦’]

}

dic1.pop()

报错:

TypeError: pop expected at least 1 arguments, got 0

使用 pop() 方法时至少需要传入一个参数,但用户并没有进行传参操作。

以上便是小编为大家总结出来的几种常见 BUG 类型,特别对于初学者来说,应该好好琢磨下,如何根据报错的类型,分析修改完善自己所写的代码,孰能生巧,只要肯用心,这些 BUG 都不足挂齿!!!

好课推荐:Python3 入门Python3 进阶

HTML5都有哪些新特性?

thbcm阅读(309)

什么是HTML5?

HTML5 是下一代 HTML 标准。

HTML5 将成为 HTML、XHTML 以及 HTML DOM 的新标准。

自从1999年 HTML 上个版本的诞生,Web 世界已经经历了巨变, 

HTML 仍在完善之中。然而,现代大部分浏览器都已具备某些 HTML5 的支持

那么HTML都有哪些新特性呢?

用于绘画的 canvas 元素

标签 描述
<canvas> 标签定义图像,比如图表和其它图像。该标签基于 Javascript 的绘图 API

用于媒介回放的 videoaudio 新多媒体元素

标签 描述
<audio> 定义音频内容
<video> 定义视频(video 或者 movie)
<source> 定义多媒体资源<video>和<audio>
<embed> 定义嵌入的内容,比如插件。
<track> 为诸如<video>和<audio>元素之类的媒介规定外部文本轨道

用于表单的 datalist 新表单元素

标签 描述
<datalist> 定义选项列表。请于 input 元素配合使用该元素,来定义 input 可能的值
<keygen> 规定用于表单的密钥对生成器字段
<output> 定义不同类型的输出,比如脚本的输出

用于新的语义和结构的新元素

标签 描述
<article> 定义页面独立的内容区域
<aside> 定义页面的侧边栏内容
<bdi> 允许您设置一段文本,使其脱离其父元素的文本方向设置
<command> 定义命令按钮,比如单选按钮、复选框或按钮
<details> 用于描述文档或文档某个部分的细节
<dialog> 定义对话框,比如提示框
<summary> 标签包含 details 元素的标题
<figure> 规定独立的流内容(图像、图表、照片、代码等等)。
<figcaption> 定义<figure>元素的标题
<footer> 定义 section 或 document 的页脚。
<header> 定义了文档的头部区域
<mark> 定义带有记号的文本。
<meter> 定义度量衡。仅用于已知最大和最小值的度量。
<nav> 定义导航链接的部分。
<progress> 定义任何类型的任务的进度。
<rudy> 定义 ruby 注释(中文注音或字符)。
<rt> 定义字符(中文注音或字符)的解释或发音。
<rp> 在 ruby 注释中使用,定义不支持 ruby 元素的浏览器所显示的内容。
<section> 定义文档中的节(section、区段)。
<time> 定义日期或时间。
<wbr> 规定在文本中的何处适合添加换行符。

HTML5 已移除的元素

以下的 HTML 4.01 元素在 HTML5 中已经被删除:

  • <acronym>
  • <applet>
  • <basefont>
  • <big>
  • <center>
  • <dir>
  • <font>
  • <frame>
  • <frameset>
  • <noframes>
  • <strike>
  • <tt>

学习新标签的同时要与实践并行,才能学以致用掌握它:

联系我们