 小狮博客
如果把 Agent 写成一个简单公式,可以是:
踩了个大坑!K8s 挂载目录的日志,居然也在吃容器内存?
最近一直收到某个服务pod容器内存超过80%的告警,堆内存加上堆外内存目前看也只有1G左右,但pod内存却达到4G多,查来查去查到
active_file对应的logs占用大量内存,目前现状是k8s中springboot服务日志挂载到宿主机/logs目录,/logs目录的所有日志大小有3G,容器内存显示也包含日志的3G,即使挂载出来了也没生效?
RocketMQ 常见面试题与高频考点:从原理到实战的自我检验
这是 RocketMQ 系列文章的
收官之章,也是一份特别的礼物 ——
面试自查手册。
sync.Mutex 互斥锁
balance = balance + amount 在 CPU 层面至少拆成三步:
60 路并发出图率从 20% 到 90%:我踩的四个坑
这不是一篇”怎么排查出图慢”的技术教程,那种文章 CSDN 上够多了。这篇写的是我在排查过程中犯的四个错:
为什么错、错在哪一层、下一次怎么避开。
Claude Code 最强Skills路由器:/ask-matt 完全上手指南(入门篇)
/ask-matt 是 Matt Pocock 工程技能体系的导航仪。
高可用之路·观测篇-指标失明
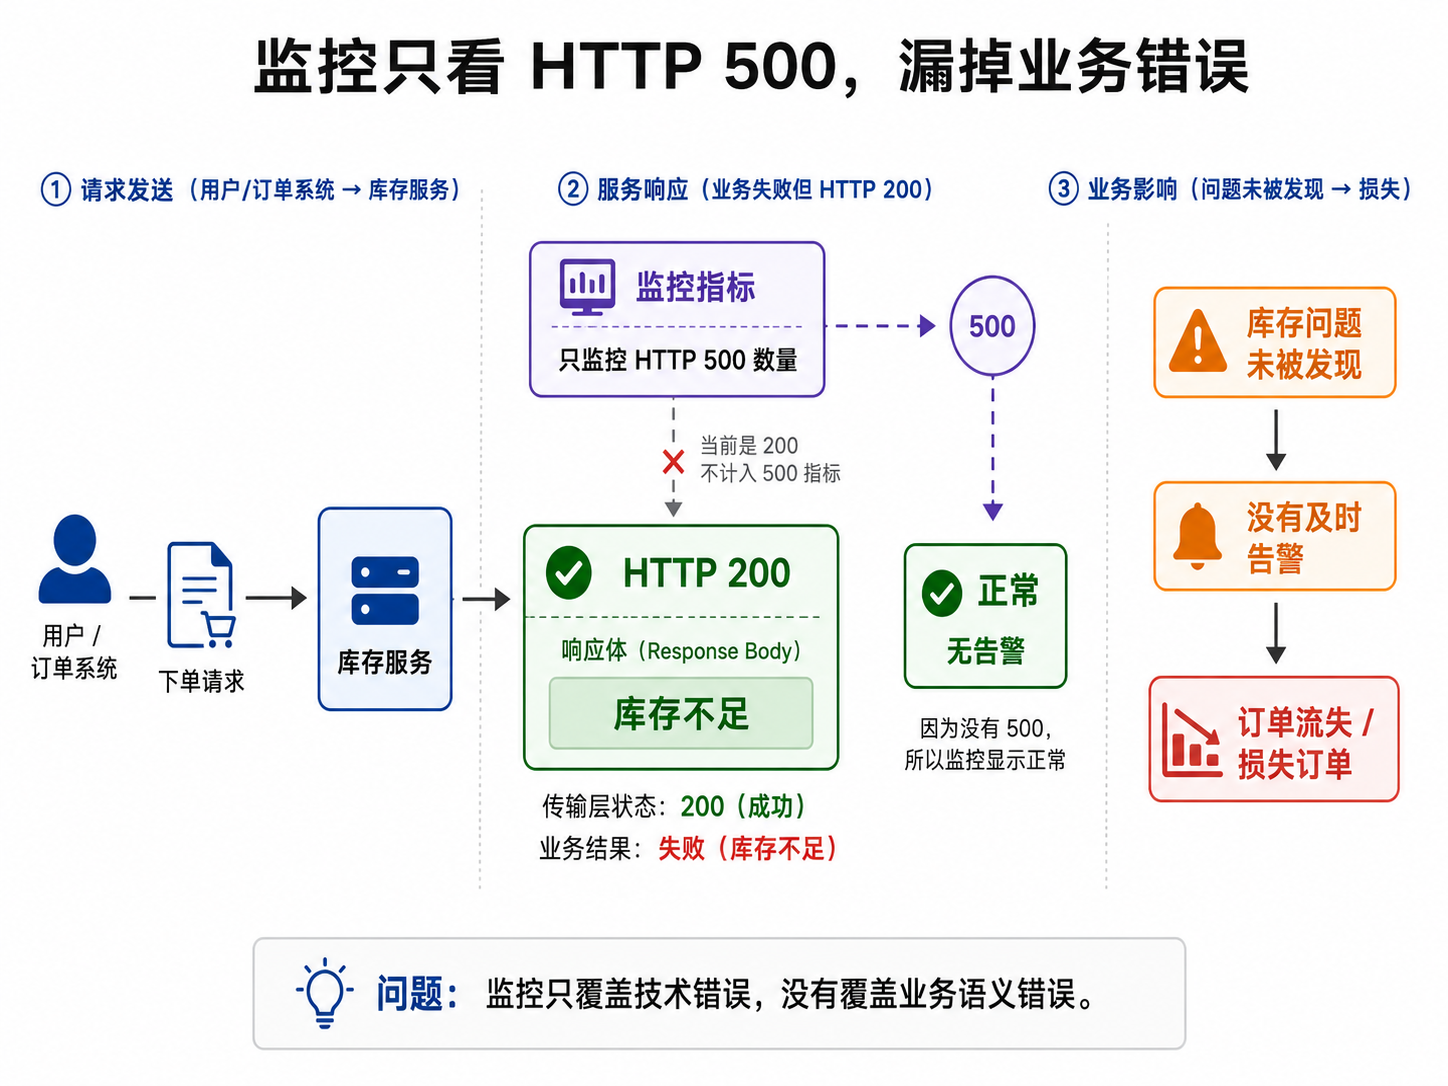
最常见的情形是我们根本没有一个指标去反映相关的问题。这个在日常往往表现为漏配监控。举一个很常见的例子,如果我们只监控Http返回码为500的报错,而认为Http返回码是200都正常的话,其实很有可能出了问题而不自知。因为Http返回码是500还是200在大部分情况下只能反映Server内部处理有没有异常,但并无法反映业务上的问题。例如库存不够了,往往给用户返回是Http200返回码,但用户Get到的信息却是库存不足。如果没有对这个业务返回码做相应的监控,那么我们无法观测到由于库存不够导致的持续订单损失。 如下图所示:
Redis主从切换后,旧主恢复竟触发全量同步?——我猜错了,原因比想象中更严谨
如果你也遇到过类似的现象,或者单纯好奇Redis主从复制在故障转移后到底怎么决策的——这篇文章就是为你写的。我们不背八股文,而是从这次排查经历出发,把背后的设计逻辑彻底理清楚。
spec-kit实战:我用SDD方法论解决AI编码幻觉问题
这种破事我起码遇到过十次。直到上个月试了GitHub官方出的spec-kit,才终于不用在AI的「自由发挥」和我的「反复返工」之间反复横跳。
从 vibe coding 到 spec coding:Trellis 的实践总结
现在用 ai 写代码很多时候都是一把梭的,也就是说我只需要给 ai 一个要求指令,剩下的就交给 ai了,现在模型能力确实越来越强,有时候我甚至可以不用 superpowers 这种工作流插件都可以做到很规范。所以这种 vibe coding 的写法已经很广泛了,只要可以满足我们要求就可以。