 小狮博客
【今日观点】 Agent 记忆系统难在取舍
真正拉开差距的地方,不在这些名词,而在边界条件。
真正拉开差距的地方,不在这些名词,而在边界条件。
既然是部分实例有问题,那关键就要找出异常实例与正常实例的差异,首先确认负载是否均衡。
报错信息表示:主库在回放事务 18c68804-62e7-11f1-846e-00163ed55da5:3425315180 时失败了,失败位置发生在执行 Write_rows 事件写入从库本地 row-based binlog 的过程中,...
新功能、重构、修 Bug,很多代码都是先由 Claude Code、Codex 等 Agent CLI 生成第一版,再由工程师 review、修改、合并。
去Github下载对应的引擎文件;
每次改需求都要后端重新开接口,加班加到想删库跑路?
我的判断很简单:Agentic Coding 不是把一个聊天窗口升级成“万能工程师”,而是把一组能力不同、失败模式不同的模型,编排成一条可验证的执行链路。 模型负责判断和执行,workflow 负责顺序和门禁,人负责风险决策。三者少一个...
众所周知,AI 有很多预训练的数据,以英文世界的语料为主,但是很多软件在持续迭代、文档在持续迭代,预训练的数据可能是过期的,所以我们在让 AI 回答问题之前,如果你有权威数据来源,那要提前告诉 AI,每个 AI Agent 通常都会提供一个...
这个程序有一个问题: 它只能检查一个人。每次运行只能处理一次输入,然后就结束了。如果有多个人要检查,就得一遍遍运行程序,太麻烦了。
Casebook 不是另一个测试用例管理平台,而是在 AI Agent 时代重新定义测试用例资产该如何被创建、维护和使用。
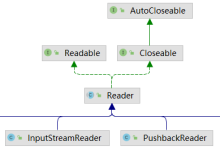
常用的Reader子类有以下5个: