 小狮博客
【今日观点】 Agent 记忆系统难在取舍
真正拉开差距的地方,不在这些名词,而在边界条件。
真正拉开差距的地方,不在这些名词,而在边界条件。
在并发场景下,数据操作可能会遇到如下三类问题:
这四种声明涵盖了Go程序结构的全部骨架。与C语言不同,Go没有宏定义( #define)、头文件包含等预处理器机制;与Java不同,Go没有类、注解等概念。
如果你读过码哥之前那篇「185,000 星的 Superpowers 插件,90% 的人只用了它 10% 的功能」,14 个 Skill 的基本面你已经知道了。那篇写的是 v5.1,拆的是「是什么」和「怎么用」。
问题在于—— 谁愿意手动标定 64 个效果向量?每个向量 18 个分量,64 次重复,枯燥且容易出错。
小侄女走到大嫂面前,大声的说了一句:妈妈,我爱你
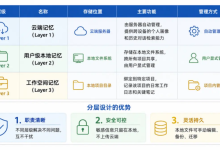
WorkBuddy 采用三层记忆架构,分别对应不同的作用域和读写策略:
一个 coding agent 同时接 GitHub、Slack、Jira、Sentry、Grafana、PagerDuty,再加几个内部 MCP server,很容易暴露上百个工具。传统做法是启动会话时把所有工具 schema 全塞进上下...
这篇文章会先从 AI 工作负载的典型 I/O 模式出发,梳理不同业务对存储系统提出的实际挑战;随后围绕 GPFS、Alluxio 和 JuiceFS 展开比较,分析它们在架构设计、文件系统语义、缓存机制、成本模型和适用边界上的差异,以及它们...
这个时候,如果你有一个自托管的 AI 网关,那么就可以非常轻易的汇总管理他们: