 小狮博客
大家好,我是狂师。
CUDA时长统计
因为这里的宏改动,主要涉及CUDA头文件和CUDA文件的修改,所以Cython文件和Python文件还有异常捕获宏我们还是复用
这篇文章里面用到的。测试内容是,定义一个原始数组和一个索引数组,输出索引的结果数组。
.NET 10 首个预览版发布,跨平台开发与性能全面提升
本次更新聚焦 JIT 编译器优化、运行时性能提升和跨平台开发体验增强,同时引入多项开发者期待的功能改进。
『Python底层原理』–Python字符串的秘密
无论是处理用户输入、文件读写还是网络通信,字符串都扮演着核心角色。
基于 Trae Claude-3.7 从0到1 打造加密货币钱包Dompet-App
大家好!今天我要分享如何使用强大的AI助手Trae Claude-3.7,从零开始构建一款功能丰富的加密货币钱包应用——Dompet-App。无论你是区块链爱好者还是移动开发新手,这个项目都能让你快速掌握React Native开发的精髓!
浅谈Tox之一
What is tox?
全程使用 AI 从 0 到 1 写了个小工具
AI在各个领域都有着迅猛的发展,至于编程更甚,尤其是Cursor的问世,让许多不懂技术不懂编程的人也跃跃欲试,经常在网上看到零基础小白使用AI几小时写个APP的文章,虽然我也经常用AI来解决程序问题,但大都是写个脚本或者实现代码片段,确实很好用,但对于只用AI从0到1完整实现个项目还没体验过,本着体验过才有发言权的原则,我决定亲自去试试。恰好最近在整理RSS,于是就想通过AI来写一个简单的RSS阅读器,以满足我自己琐碎时间的阅读需求
AI 插件第二弹,更强更好用
为了让大家获得更好的使用体验,我在业余时间加紧开发,如今插件已迭代至 第四个版本!
你的登录接口真的安全吗?
前言
大家学写程序时,第一行代码都是hello world。但是当你开始学习 WEB 后台技术时,很多人的第一个功能就是写的登录 (小声:别人我不知道,反正我是)。 但是我在和很多工作经验较短的同学面试或沟通的时候,发现很多同学虽然都有在简历上写:负责项目的登录/注册功能模块的开发和设计工作,但是都只是简单的实现了功能逻辑,在安全方面并没有考虑太多。这篇文章主要是和大家聊一聊,在设计一个登录接口时,不仅仅是功能上的实现,在安全方面,我们还需要考虑哪些地方。
安全风险
暴力破解!
只要网站是暴露在公网的,那么很大概率上会被人盯上,尝试爆破这种简单且有效的方式: 通过各种方式获得了网站的用户名之后,通过编写程序来遍历所有可能的密码,直至找到正确的密码为止
伪代码如下:
# 密码字典
password\_dict = \[\]
# 登录接口
login\_url = ''
def attack(username):
 for password in password\_dict:
     data = {'username': username, 'password': password}
       content = requests.post(login\_url, data).content.decode('utf-8')
       if 'login success' in content:
           print('got it! password is : %s' % password)
那么这种情况,我们要怎么防范呢?
验证码
有聪明的同学就想到了,我可以在它密码错误达到一定次数时,增加验证码校验!比如我们设置,当用户密码错误达到 3 次之后,则需要用户输入图片验证码才可以继续登录操作:
伪代码如下:
fail\_count = get\_from\_redis(fail\_username)
if fail\_count >= 3:
 if captcha is None:
  return error('需要验证码')
    check\_captcha(captcha)
success = do\_login(username, password)
if not success:
 set\_redis(fail\_username, fail\_count + 1)
伪代码未考虑并发,实际开发可以考虑加锁。
这样确实可以过滤掉一些非法的攻击,但是以目前的 OCR 技术来说的话,普通的图片验证码真的很难做到有效的防止机器人(我们就在这个上面吃过大亏)。当然,我们也可以花钱购买类似于三方公司提供的滑动验证等验证方案,但是也并不是 100% 的安全,一样可以被破解(惨痛教训)。
登录限制
那这时候又有同学说了,那我可以直接限制非正常用户的登录操作,当它密码错误达到一定次数时,直接拒绝用户的登录,隔一段时间再恢复。比如我们设置某个账号在登录时错误次数达到 10 次时,则 5 分钟内拒绝该账号的所有登录操作。
伪代码如下:
fail\_count = get\_from\_redis(fail\_username)
locked = get\_from\_redis(lock\_username)


if locked:
 return error('拒绝登录')
if fail\_count >= 3:
 if captcha is None:
  return error('需要验证码')
    check\_captcha(captcha)
success = do\_login(username, password)
if not success:
 set\_redis(fail\_username, fail\_count + 1)
    if fail\_count + 1 >= 10:
     # 失败超过10次,设置锁定标记
     set\_redis(lock\_username, true, 300s)
umm,这样确实可以解决用户密码被爆破的问题。但是,这样会带来另一个风险:攻击者虽然不能获取到网站的用户信息,但是它可以让我们网站所有的用户都无法登录! 攻击者只需要无限循环遍历所有的用户名(即使没有,随机也行)进行登录,那么这些用户会永远处于锁定状态,导致正常的用户无法登录网站!
IP 限制
那既然直接针对用户名不行的话,我们可以针对 IP 来处理,直接把攻击者的 IP 封了不就万事大吉了嘛。我们可以设定某个 IP 下调用登录接口错误次数达到一定时,则禁止该 IP 进行登录操作。
伪代码如下:
ip = request\['IP'\]
fail\_count = get\_from\_redis(fail\_ip)
if fail\_count > 10:
 return error('拒绝登录')
# 其它逻辑
# do something()
success = do\_login(username, password)
if not success:
 set\_redis(fail\_ip, true, 300s)
这样也可以一定程度上解决问题,事实上有很多的限流操作都是针对 IP 进行的,比如 niginx 的限流模块就可以限制一个 IP 在单位时间内的访问次数。 但是这里还是存在问题:
- 比如现在很多学校、公司都是使用同一个出口 IP,如果直接按 IP 限制,可能会误杀其它正常的用户
- 现在这么多 VPN,攻击者完全可以在 IP 被封后切换 VPN 来攻击
手机验证
那难道就没有一个比较好的方式来防范吗? 当然有。 我们可以看到近些年来,几乎所有的应用都会让用户绑定手机,一个是国家的实名制政策要求,第二个是手机基本上和身份证一样,基本上可以代表一个人的身份标识了。所以很多安全操作都是基于手机验证来进行的,登录也可以。
- 当用户输入密码次数大于 3 次时,要求用户输入验证码(最好使用滑动验证)
- 当用户输入密码次数大于 10 次时,弹出手机验证,需要用户使用手机验证码和密码双重认证进行登录
手机验证码防刷就是另一个问题了,这里不展开,以后再有时间再聊聊我们在验证码防刷方面做了哪些工作。
伪代码如下:
fail\_count = get\_from\_redis(fail\_username)


if fail\_count > 3:
 if captcha is None:
  return error('需要验证码')
    check\_captcha(captcha)


if fail\_count > 10:
 # 大于10次,使用验证码和密码登录
 if dynamic\_code is None:
     return error('请输入手机验证码')
    if not validate\_dynamic\_code(username, dynamic\_code):
     delete\_dynamic\_code(username)
     return error('手机验证码错误')


 success = do\_login(username, password, dynamic\_code)


 if not success:
     set\_redis(fail\_username, fail\_count + 1)
我们结合了上面说的几种方式的同时,加上了手机验证码的验证模式,基本上可以阻止相当多的一部分恶意攻击者。但是没有系统是绝对安全的,我们只能够尽可能的增加攻击者的攻击成本。大家可以根据自己网站的实际情况来选择合适的策略。
中间人攻击?
什么是中间人攻击
中间人攻击 (man-in-the-middle attack, abbreviated to MITM),简单一点来说就是,A 和 B 在通讯过程中,攻击者通过嗅探、拦截等方式获取或修改 A 和 B 的通讯内容。
举个栗子: 小白给小黄发快递,途中要经过快递点 A,小黑就躲在快递点 A,或者干脆自己开一个快递点 B 来冒充快递点 A。然后偷偷的拆了小白给小黄的快递,看看里面有啥东西。甚至可以把小白的快递给留下来,自己再打包一个一毛一样的箱子发给小黄。
那在登录过程中,如果攻击者在嗅探到了从客户端发往服务端的登录请求,就可以很轻易的获取到用户的用户名和密码。
HTTPS
防范中间人攻击最简单也是最有效的一个操作,更换 HTTPS,把网站中所有的 HTTP 请求修改为强制使用 HTTPS。
为什么 HTTPS 可以防范中间人攻击? HTTPS 实际上就是在 HTTP 和 TCP 协议中间加入了 SSL/TLS 协议,用于保障数据的安全传输。相比于 HTTP,HTTPS 主要有以下几个特点:
- 内容加密
- 数据完整性
- 身份验证
具体的 HTTPS 原理这里就不再扩展了,大家可以自行 Google
加密传输
在 HTTPS 之外,我们还可以手动对敏感数据进行加密传输:
- 用户名可以在客户端使用非对称加密,在服务端解密
- 密码可以在客户端进行 MD5 之后传输,防止暴露密码明文
其它
除了上面我们聊的这些以外,其实还有很多其它的工作可以考虑,比如:
- 操作日志,用户的每次登录和敏感操作都需要记录日志(包括 IP、设备等)
- 异常操作或登录提醒,有了上面的操作日志,那我们就可以基于日志做风险提醒,比如用户在进行非常登录地登录、修改密码、登录异常时,可以短信提醒用户
- 拒绝弱密码 注册或修改密码时,不允许用户设置弱密码
- 防止用户名被遍历 有些网站在注册时,在输入完用户名之后,会提示用户名是否存在。这样会存在网站的所有用户名被泄露的风险(遍历该接口即可),需要在交互或逻辑上做限制
- …
后记
现在国家不断的出台各种法律,对用户的数据越来越看重。作为开发者,我们也需要在保护用户数据和用户隐私方面做更多的工作。后面我也会和大家聊一聊,我们在数据安全方面,做了哪些工作,希望可以给到大家一点点帮助。
以上就是W3Cschool编程狮关于你的登录接口真的安全吗?的相关介绍了,希望对大家有所帮助。
Java面试题:谈谈String、StringBuffer、StringBuilder的区别?
文章来源于公众号:程序新视界 作者:丑胖侠二师兄
关于字符串的面试题除了内存分布、equals 比较,最常见的就是与StringBuffer和StringBuilder之间的区别了。
如果你回答:String 类是不可变的,StringBuffer和StringBuilder是可变类,StringBuffer是线程安全的,StringBuilder则不是线程安全的。
就上面的总结而言,好像知道的有点少。本篇文章就带领大家全面的了解一下它们三个的区别与底层实现。
String字符串的拼接
关于String字符串前面多篇文章已经详细描述过,它的不可变性也是因为每当通过“+”操作时,都会在内存中生成新的字符串而导致的。
String a = "hello ";
String b = "world!";
String ab = a + b;
针对上述代码,内存分布图如下:
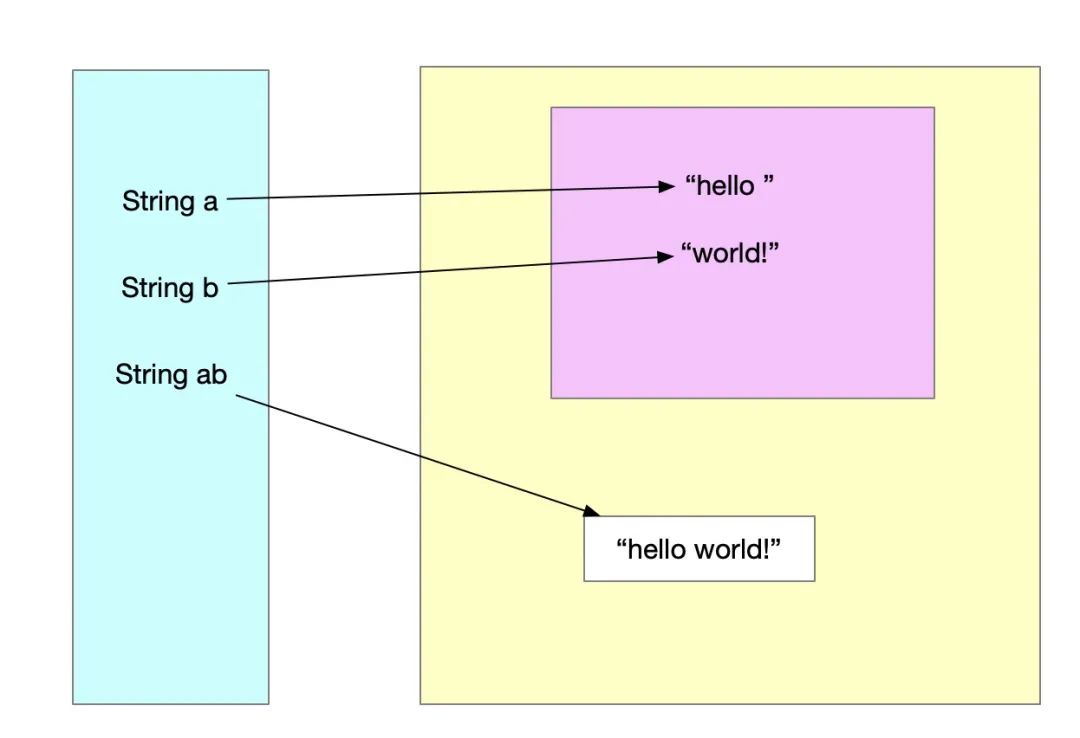
其中 a 和 b 初始化时位于字符串常量池,ab 拼接后的对象位于堆中。可以很直观的看出,经过拼接新生成了String对象。如果拼接多次,那么会生成多个中间对象。
上面的结论在Java8之前是成立的,在Java8时 JDK 对“+”号拼接进行了优化,上面所写的拼接方式会被优化为基于StringBuilder的append方法进行处理。
stack=2, locals=4, args_size=1
     0: ldc           #2                  // String hello
     2: astore_1
     3: ldc           #3                  // String world!
     5: astore_2
     6: new           #4                  // class java/lang/StringBuilder
     9: dup
    10: invokespecial #5                  // Method java/lang/StringBuilder."<init>":()V
    13: aload_1
    14: invokevirtual #6                  // Method java/lang/StringBuilder.append:(Ljava/lang/String;)Ljava/lang/StringBuilder;
    17: aload_2
    18: invokevirtual #6                  // Method java/lang/StringBuilder.append:(Ljava/lang/String;)Ljava/lang/StringBuilder;
    21: invokevirtual #7                  // Method java/lang/StringBuilder.toString:()Ljava/lang/String;
    24: astore_3
    25: return
上面是通过 javap -verbose命令反编译字节码的结果,很显然可以看到StringBuilder的创建和`append方法的调用。
此时,如果再笼统的回答:通过加号拼接字符串会创建多个String对象,因此性能比StringBuilder差,就是错误的了。因为本质上加号拼接的效果最终经过编译器处理之后和StringBuilder是一致的。
如果你在代码中使用如下写法:
StringBuilder sb = new StringBuilder("hello ");
sb.append("world!");
System.out.println(sb.toString()); 编译器的插件甚至建议你使用String来代替。
StringBuffer与StringBuilder的对比
StringBuffer和StringBuilder实现的核心代码基本一致,很多代码都是公用的。这两个类均继承自抽象类AbstractStringBuilder。
我们来从构造方法到append方法来逐一看一下它们的区别。先看StringBuilder的构造方法:
public StringBuilder(String str) {
    super(str.length() + 16);
    append(str);
} 其中super方法便是调用的AbstractStringBuilder的构造方法。对应StringBuffer的构造方法中实现也是如此:
public StringBuffer(String str) {
    super(str.length() + 16);
    append(str);
} 从构造方法来说,StringBuffer和StringBuilder是一样的。下面再看看append方法,StringBuilder实现如下:
@Override
public StringBuilder append(String str) {
    super.append(str);
    return this;
} StringBuffer对应的方法如下:
@Override
public synchronized StringBuffer append(String str) {
    toStringCache = null;
    super.append(str);
    return this;
} 很显然,在StringBuffer的append方法实现上除了内部将toStringCache变量赋值为null,唯一的不同就是在方法上使用synchronized进行了同步处理。
toStringCache是用来缓存最后一次调用toString方法时生成的字符串,当StringBuffer内容变动时,该值也会变动。
通过上面的append方法的对比,我们可以很轻易的发现StringBuffer是线程安全的,StringBuilder是非线程安全的。当然,使用synchronized进行同步处理,性能便会降低很多。
StringBuffer与StringBuilder的底层实现
StringBuffer与StringBuilder都调用了父类的构造方法:
AbstractStringBuilder(int capacity) {
    value = new char[capacity];
} 通过该构造方法我们可以看到它们用来处理字符串信息的关键属性为value。在初始化时先初始化一个长度为传入字符串长度+16的char[]数组,也就是value值,用来存储实际的字符串。
在调用父类构造方法之后便是调用各自的append方法(见前面的代码),而其中的核心处理又的调用父类的append方法:
public AbstractStringBuilder append(String str) {
    if (str == null)
        return appendNull();
    int len = str.length();
    ensureCapacityInternal(count + len);
    str.getChars(0, len, value, count);
    count += len;
    return this;
} 上述代码中其中str.getChars方法用来对传入的str字符串进行拼接,在原有的value数组后面进行填充。而count用来记录当前value数字中已经使用的长度。
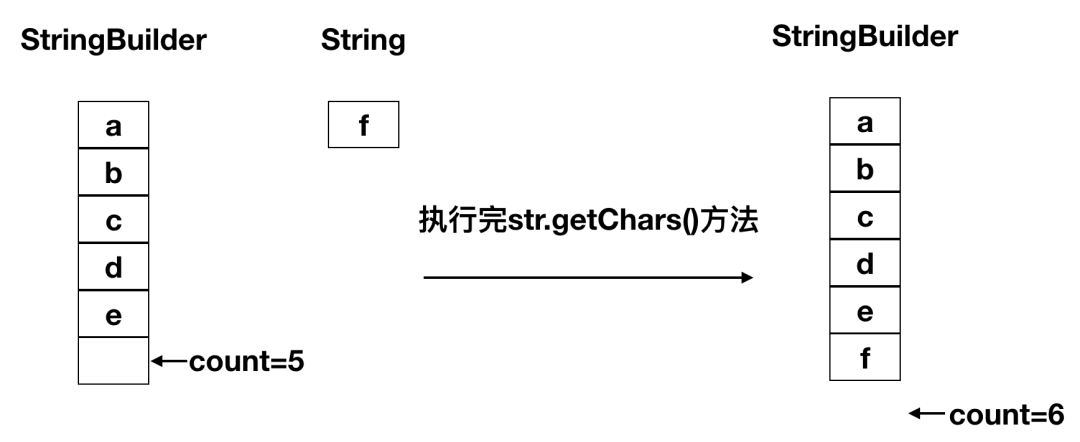
那么,当没有使用synchronized进行同步操作时,线程不安全发生在哪里?上面代码中count+=len并不是原子操作。比如当前count为 5,两个线程同时执行到 ++ 操作,拿到的值都为 5,执行完加操作之后赋值给count,两个线程赋值都为 6,而不是 7。此时便出现了线程不安全的问题。
为什么String要设计成不可变
在 Java 中将String设计成不可变的是综合考虑到各种因素的结果,有如下原因:
1、字符串常量池的需要,如果字符串可变,改变一个对象会影响到另外一个独立的对象。不变这也是字符串常量池存在的前提条件。
2、Java 中String对象的哈希码被频繁地使用,比如在HashMap等容器中。字符串不变保证了hash码的唯一性,可以方向缓存并使用。
3、安全性,确保String在当做参数传递时保持不变,避免安全隐患。比如在数据库用户名、密码、访问路径等传输过程中的保持不变,防止改变字符串指向对象的值被改变。
4、由于字符串变量不可变,在多线程中可以被共享使用。
小结
单纯的死记硬背面试题我们都会,但要在记忆面试题的过程中了解更多底层实现原理,不仅仅有助于理解“为什么”,同时还能学到更多相关的知识和原理。
在本文中简化了StringBuilder和StringBuffer内部数据的 copy 、数组扩容等步骤的讲解,感兴趣的朋友可以继续对照源码进行深入研究。
以上就是W3Cschool编程狮关于Java面试题:谈谈String、StringBuffer、StringBuilder的区别?的相关介绍了,希望对大家有所帮助。