javascript删除HTML结点操作

thbcm阅读(282)

HTML 页面上删除结点的操作跟添加结点中将段落添加在指定依附点之前相似,将段落添加在指定依附点之前代码为document.body.insertBefore(newGraf, docForm),删除的为 document.body.removeChild(deleteNode)就能够了。使用的是 removeChild 方法,删除的是 body 域里面的元素。

看个代码介绍一下吧。

假设有下面一段代码,内容有4段。

<html> 
<head> 
<title>Deleting Nodes</title> 
</head> 
<body> 
<p>给你一张过去的CD,听听那时我们的爱情,有时会突然忘了,我还在爱着你</p> 
<p>再唱不出那样的歌曲,听到都会红着脸躲避,虽然会常常忘了,我仍然爱着你</p> 
<p>由于爱情,不会轻易悲伤,所以一切都是幸福的样子</p> 
<p>由于爱情,简单的生长,仍然随时都能为你疯狂</p> 
<input type=”button” onclick=”deleteNodes()” value=”delete Nodes”/> 
<script> function deleteNodes() { } </script> 
</body> 
</html>

现在要删除段落内容,该如何实现 deleteNodes 方法呢?

很简单,两行代码弄定。

var deleteNode =document.getElementsByTagName(“p”)[0]; 
document.body.removeChild(deleteNode);

var deleteNode =document.getElementsByTagName(“p”)[0];

获得到要删除的段落内容,document.getElementsByTagName(“p”)[0]为 body 标签域内的第一个 p 标签内容。

document.body.removeChild(deleteNode);

 将获得到的要删除的节点信息从页面上面删除,使用 removeChild 方法。

如果段落有 id 的话,那就能够直接使用 getElementById 方法来指定的获得要删除的对象,不用再使用  getElementsByTagName 方法获得到对象集合,再通过数组下标来指定删除对象了。


我们的示例中删除的是 document.getElementsByTagName(“p”)[0],也能够删除其他段落,比如document.getElementsByTagName(“p”)[3] 等真实存在的段落信息。

Ajax的数据类型

thbcm阅读(319)

在 Ajax 的使用中,遇到了一个这样的问题:界面开发出来是用在手机上使用的,但是数据是通过服务器提供的 API,在界

面上使用 JQuery 的 Ajax 来调用数据,开始怎样也调用不到,而且不报毛病,后面现在浏览器测试好了,在放手机上加载本地的界面。

1、服务器关键代码以下:

/**

 * @see HttpServlet#doGet(HttpServletRequest request, HttpServletResponse

 *      response)

 */

protected void doGet(HttpServletRequest request,

HttpServletResponse response) throws ServletException, IOException {

response.setContentType(“text/javascript”);//这个要注意

PrintWriter out = response.getWriter();

String callback = request.getParameter(“callback”);

out.print(callback

+ “([{ name:’John’,age:’19’},{ name:’joe’,age:’20’}])”);

System.out.println(“callback = ” + callback);

out.flush();

out.close();

}

2、界面关键代码:

 $.ajax({  

  url:”http://localhost:8081/JsonpServer/JsonpServlet”,     

  dataType:”jsonp”,  

  jsonp:”callback”,//传递给要求处理程序或页面的,用以取得jsonp回调函数名的参数名(默许为:callback),需和服务器端一致  

  jsonpCallback:”person”,//自定义的jsonp回调函数名称,默许为jQuery自动生成的随机函数名  

  success:function(json){  

  //alert(json[0].name);  

  }  

  });  

  // 相当于重写success后履行的函数(自定义为person)  

      function person(json){  

      alert(“I am person function…”);  

      alert(json[0].name);  

  } 

分析:

最开始没有效果是 dataType:”json”, 所以测试了很久都没有出来, 后面修改成    dataType:”jsonp”,  就能够使用了。
缘由是  dataType 为 json 数据格式的时候,不能跨域访问,jsonp  是跨域访问的。

以下课程能帮你对XML有更好的了解:

Java this 关键字详解

thbcm阅读(301)

this 关键字

this 关键字代表了所属函数的调用者对象。

this 关键字的作用:

  • 如果存在同名成员变量与局部变量时,在方法内部默认是访问局部变量的数据,可以通过 this 关键字指定访问成员变量的数据;
  • 在一个构造函数中可以调用另外一个构造函数初始化对象。

this 关键字调用其他的构造函数要注意的事项: 

  • this 关键字调用其他的构造函数时,this关键字必须要位于构造函数中的第一个语句;
  • this 关键字在构造函数中不能出现互相调用的情况,因为是一个死循环。

this 关键字要注意的事项:

  • 存在同名的成员变量与局部变量时,在方法的内部访问的是局部变量(java采取的是“就近原则”的机制访问的);
  • 如果在一个方法中访问了一个变量,该变量值存在成员变量的情况下,那么java编译器会在该变量的前面添加this关键字。

this关键字调用其他的构造函数要注意的事项: 

  • this关键字调用其他的构造函数时,this关键字必须要位于构造函数中的第一个语句;
  • this关键字在构造函数中不能出现互相调用的情况,因为是一个死循环。

推荐好课:深入解析Java面向对象Java基础入门到框架实践

this关键字实例

class Student{

    int id; //身份证

    String name; //名字

    //目前情况: 存在同名的成员变量与局部变量,在方法内部是使用局部变量的。

    public Student(int id, String name) { //一个函数的形式参数也是属于局部变量。

        //调用了本类的一个参数的构造方法

        //this(name);//如果能在这里调用到下面一个参数的构造方法时,那就可以解决重复代码的问题。

        this(); //调用了本类的无参的构造方法。

        this.id = id; //this.id = id; 局部变量的id给成员变量的id赋值。

        System.out.println(“两个参数的构造方法调用了…”);

    }

    public Student() {

        System.out.println(“无参的构造方法被调用了…”);

    }

    public Student(String name) {

        this.name = name;

        //System.out.println(“一个参数的构造方法被调用了…”);

    }

}

public class Demo1 {

    public static void main(String[] args) {

        Student s = new Student(110, “迪迦”);

        System.out.println(“编号: “+s.id+”  名字: “+s.name);

        Student s2 = new Student(“W3CSCHOOL”);

        System.out.println(“名字: “+s2.name);

    }

}

Java 中的三种循环结构 你会用么?

thbcm阅读(322)

1.for循环

格式:

 for(初始化语句1; 判断语句2; 步进语句3){ 

         循环代码4

 }

执行流程: 

    先执行1初始化语句

    执行2判断语句,如果判断结果是true

    执行4循环代码

    执行3步进语句

    继续回到2 4 3 2 4 3 

    如果判断结果是false,代表循环结束

注意:

    初始化语句只在第一次循环中执行,之后不再执行

代码演练:

public static void main(String[] args) {

        /*

        判断0-10的奇偶数

         */

        //偶数:能够被2整除的数字称为偶数

        // 0 是一个特殊的偶数

        for(int i=0;i<=10;i++){

            if (i%2 == 0){

                System.out.println(i+”是偶数”);

            }else {

                System.out.println(i+”是奇数”);

            }

        }

    }

2.while循环

格式:

初始化语句1;

while(判断语句2){

        循环代码3;

        步进语句4;

 }

执行流程:

1 初始化语句

2 执行判断语句,如果是true就执行大括号里面的代码,如果是false就结束循环

3 循环代码

4 步进语句

再次循环执行2判断语句

代码演练:

public static void main(String[] args) {

        /*

        求1-100的累加和

         */

        int x = 1;

        int sum = 0;

        while (x<=100){

            sum += x;

            x++;

        }

        System.out.println(“1-100的累加和为:”+sum);

    }

3.do-while循环

格式:

初始化语句1;

do{

        循环语句2;

        步进语句3;

}while(判断语句4);

执行流程:

1 初始化语句

2 循环语句

3 步进语句

4 判断语句 , 如果判断的结果是true就继续循环,如果判断的结果是false就结束循环

注意:

 do-while循环是先执行后判断,不管条件是否满足至少执行一次

代码演练:

public static void main(String[] args) {

        /*

        输出1-10的和

         */

        int a = 1;

        int sum = 0;

        do {

            sum += a;

            a++;

        }while (a<=10);

        System.out.println(“1-10的和为:”+sum);

    }

三种循环的使用场景

三种循环结构均可实现相应的功能,按照实际需要选择更为简便的形式。以下为使用场景的总结:

  • 明确循环次数的时候:建议使用for循环
  • 不明确循环次数的时候:建议使用while循环
  • do…while循环比较特殊,它先执行循环体,然后根据判断条件决定是否再次执行循环,即do…while至少执行一次循环

循环嵌套

代码演练1

public static void main(String[] args) {

        /*

        循环嵌套:

            外层循环执行1次,内存循环执行一圈

         */

        /*

        循环出从0点0分-23点59分

         */

        //遍历小时

        for (int i=0; i<24; i++){

            //遍历分钟

            for (int j=0; j<60; j++){

                System.out.println(i + “点” + j + “分”);

            }

        }

代码演练2

public static void main(String[] args) {

        for (int i = 1; i < 10; i++) {

            System.out.println(“你是第” + i + “位顾客”);

            while (true) {

                System.out.println(“请选择你想要购买的商品:1.水果 2.蔬菜 3.饮料 4.结束购买”);

                Scanner sc = new Scanner(System.in);

                int a = sc.nextInt();

                if (a == 1) {

                    System.out.println(“您购买的是水果”);

                } else if (a == 2) {

                    System.out.println(“你购买的是蔬菜”);

                } else if (a == 3) {

                    System.out.println(“您购买的是饮品”);

                } else if (a == 4) {

                    break;

                } else {

                    System.out.println(“您输入的指令有错误”);

                }

            }

        }

    }

两种死循环的写法

1.while(true){…}

2.for(;;){…}

推荐好课:Java微课Java多线程讲解

用Python写剪刀石头布游戏

thbcm阅读(301)

相信很多的小伙伴小时候都有玩过剪刀石头布的游戏吧那么你和电脑玩过吗?以下是小编用Python脚本写的剪刀石头布的小游戏。

1、电脑赢的情况

电脑(computer) 玩家(player)
石头 (stone) 剪刀(scissors)
剪刀 (scissor) 布(cloth)
布 (cloth) 石头(stone)

2、玩家赢的情况

玩家 (player) 电脑(computer)
石头 (stone) 剪刀(scissors)
剪刀 (scissor) 布(cloth)
布 (cloth) 石头(stone)

根据以上规则我们可以用 if 的形式来做到,代码如下:

import random

C_G = [‘stone’,’scissor’,’cloth’]

computer = random.choice(C_G)

player = input(‘please enter your choice(stone,scissor,cloth):’)

if computer == ‘stone’:

    if player == ‘stone’:

        print(‘\033[33mdraw\033[0m’)

    elif player == ‘scissor’:

        print(‘\033[32myou lose!!!\033[0m’)

    else:

        print(‘\033[31myou win!!!\033[0m’)

if computer == ‘scissor’:

    if player == ‘scissor’:

        print(‘\033[33mdraw\033[0m’)

    elif player == ‘stone’:

        print(‘\033[31myou win!!!\033[0m’)

    else:

        print(‘\033[32myou lose!!!\033[0m’)

if computer == ‘cloth’:

    if player == ‘cloth’:

        print(‘\033[33mdraw\033[0m’)

    elif player == ‘scissor’:

        print(‘\033[31myou win!!!\033[0m’)

    else:

        print(‘\033[32myou lose!!!\033[0m’)

print(‘your choice:%s’ % player,’computer choice:%s’ % computer )

进阶一

可以把赢的情况写在一个列表中这样可以让上面的脚本更精简些

import random

C_G = [‘stone’,’scissor’,’cloth’]

computer = random.choice(C_G)

WinList = [[‘stone’,’scissor’],[‘scissor’,’cloth’],[‘cloth’,’stone’]]

player = input(‘please enter your choice(stone,scissor,cloth):’)

if computer == player:

    print(‘\033[33mdraw\033[0m’)

elif [player,computer] in WinList:

    print(‘\033[33myou win!!\033[0m’)

else:

    print(‘\033[32myou lose!!!\033[0m’)

print(‘your choice:%s’ % player,’computer choice:%s’ % computer )

进阶二

为了更加方便玩我们分别用数字 0, 1, 2 代替:石头(stone)、剪刀(scissor)、布(cloth)

import random

C_G = [‘stone’,’scissor’,’cloth’]

computer = random.choice(C_G)

WinList = [[‘stone’,’scissor’],[‘scissor’,’cloth’],[‘cloth’,’stone’]]

choice_memu = ”’

(0)stone

(1)scissor

(2)cloth

please choice(0/1/2):”’

number = int(input(choice_memu))

player = C_G[number]

if computer == player:

    print(‘\033[33mdraw\033[0m’)

elif [player,computer] in WinList:

    print(‘\033[33myou win!!\033[0m’)

else:

    print(‘\033[32myou lose!!!\033[0m’)

print(‘your choice:%s’ % player,’computer choice:%s’ % computer )

进阶三

我们用三局两胜的手段来决出最后的冠军如果是平局就继续猜直至电脑赢了两局或者玩家赢了两局才得出最后的冠军。

import random

C_G = [‘stone’,’scissor’,’cloth’]

computer = random.choice(C_G)

WinList = [[‘stone’,’scissor’],[‘scissor’,’cloth’],[‘cloth’,’stone’]]

choice_memu = ”’

(0)stone

(1)scissor

(2)cloth

please choice(0/1/2):”’

c_win = 0

p_win = 0

d_win = 1

while c_win < 2 and p_win < 2:

  number = int(input(choice_memu))

  player = C_G[number]

  if computer == player:

    d_win+=1

  elif [player,computer] in WinList:

    p_win+=1

    if p_win == 2:

      print(‘\033[31myou win!!!\033[0m’)

      break

  else:

    c_win+=1

    if c_win == 2:

      print(‘\033[32myou lose!!!\033[0m’)

      break

total_time = p_win + c_win + d_win

print(‘you guesse: %s times’ % total_time,’you lost: %s times’ % c_win,’you win: %s times’ % p_win,’draw: %s times’ % d_win)

以上就是小编对剪刀石头布小游戏的编写思路了,希望小伙伴们能够有所收获。

推荐好课:Python Flask建站框架Python Django框架

Js 冒泡事件阻止

thbcm阅读(460)

一. 事件目标

现在,事件处理程序中的变量event保存着事件对象。而 event.target 属性保存着产生事件的目标元素。这个属性是 DOM API 中规定的,但是没有被所有浏览器实现 。jQuery对这个事件对象进行了必要的扩大,从而在任何浏览器中都能够使用这个属性。通过.target,可以肯定DOM中首先接收到事件的元素(即实际被单击的元素)。而且,我们知道this援用的是处理事件的DOM元素,所以可以编写以下代码:

$(document).ready(function(){

 $(‘#switcher’).click(function(event){

  $(‘#switcher .button’).toggleClass(‘hidden’);

  })

 })

$(document).ready(function(){

 $(‘#switcher’).click(function(event){

  if(event.target==this){

  $(‘#switcher .button’).toggleClass(‘hidden’);

  }

  })

 })

此时的代码确保了被单击的元素是<div id=”switcher”> ,而不是其他后代元素。现在,单击按钮不会再折叠样式转换器,而单击边框则会触发折叠操作。但是,单击标签一样甚么也不会产生,由于它也是一个后代元素。实际上,我们可以不把检查代码放在这里,而是通过修改按钮的行动来到达目标 。

二. 停止事件传播

事件对象还提供了一个 .stopPropagation() 方法,该方法可以完全禁止事件冒泡。与 .target 类似,这个方法也是一种纯 JavaScript 特性,但在跨浏览器的环境中则没法安全地使用 。不过,只要我们通过jQuery来注册所有的事件处理程序,就能够放心肠使用这个方法。

下面,我们会删除刚才添加的检查语句 event.target == this,并在按钮的单击处理程序中添加一些代码:

$(document).ready(function(){

 $(‘#switcher .button’).click(funtion(event){

  //……

   event.stopPropagation();

  })

 }) 

同之前一样,需要为用作单击处理程序的函数添加一个参数,以便访问事件对象。然后,通过简单地调用 event.stopPropagation() 就能够避免其他所有 DOM 元素响应这个事件。这样一来,单击按钮的事件会被按钮处理,而且只会被按钮处理。单击样式转换器的其他地方则可以折叠和扩大全部区域。

三. 默许操作

如果我们把单击事件处理程序注册到一个锚元素,而不是一个外层的<div>上,那末就要面对另外一个问题:当用户单击链接时,浏览器会加载一个新页面。这类行动与我们讨论的事件处理程序不是同一个概念,它是单击锚元素的默许操作。类似地,当用户在编辑完表单后按下回车键时,会触发表单的 submit 事件,在此事件产生后,表单提交才会真正产生。

如果我们不希望履行这类默许操作,那末在事件对象上调用 .stopPropagation() 方法也杯水车薪,由于默许操作不是在正常的事件传播流中产生的。在这类情况下,.preventDefault() 方法则可以在触发默许操作之前终止事件 。

提示 当在事件的环境中完成了某些验证以后,通常会用到 .preventDefault()。例如,在表单提交期间,我们会对用户是不是填写了必填字段进行检查,如果用户没有填写相应字段,那末就需要禁止默许操作。我们将在第8章详细讨论表单验证。

事件传播和默许操作是相互独立的两套机制,在两者任何一方产生时,都可以终止另外一方。如果想要同时停止事件传播和默许操作,可以在事件处理程序中返回 false,这是对在事件对象上同时调用 .stopPropagation() 和 .preventDefault() 的一种简写方式。

CSS+HTML VS CSS+XML

thbcm阅读(435)

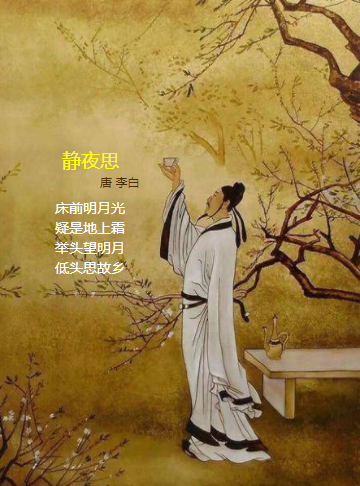
首先上个网页效果图

我们平常都用 html+css+JavaScript 来写网页,使网页美观生动。今天先不说 JavaScript,那么就是静态页面的实现,html+css。实现上面的效果是很容易的。

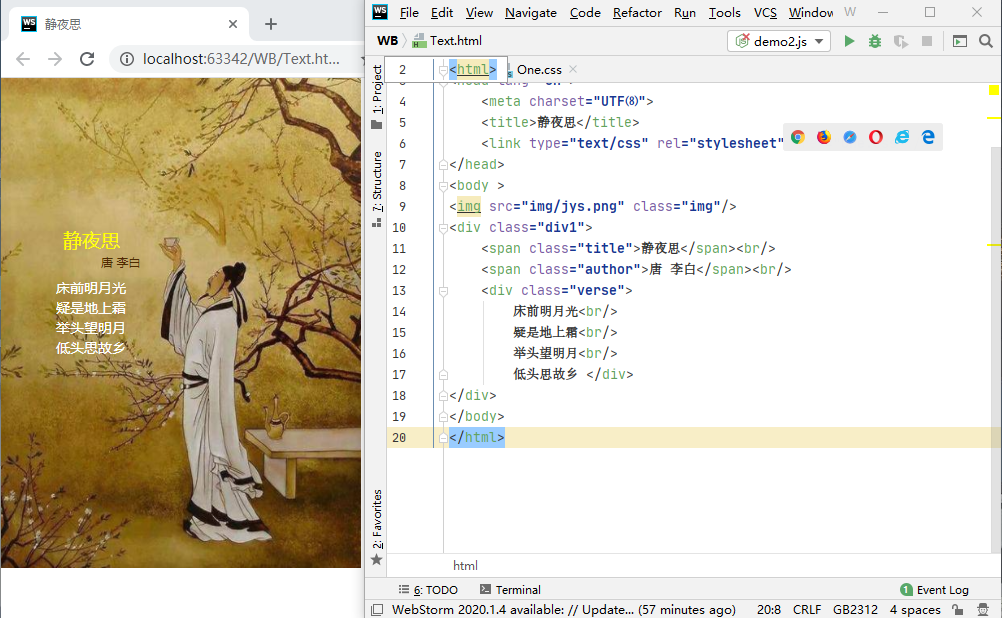
就像下面这样:

那么你知道 xml+css 也是可以写网页的吗?

在学到 css 课程之前,我从来没有这么想过。

接下来我们分析一下(先找个理由把它们联系起来吧,可能分析的不是那末正确,but just now,who cares?):

先来看看他们的定义(来自维基百科):

HTML(超文本标记语言/HyperText Markup Language)是一种用于创建网页的标准标记语言。HTML 是一种基础技术,常与 CSS、JavaScript 一起被众多网站用于设计使人赏心悦目的网页、网页利用程序和移动利用程序的用户界面。网页阅读器可以读取 HTML 文件,并将其渲染成可视化网页。HTML 描写了一个网站的结构语义随着线索的显现,使之成为一种标记语言而非编程语言。

XML(可扩大标记语言/eXtensible Markup Language),是一种标记语言。标记指计算机所能理解的信息符号,通过此种标记,计算机之间可以处理包括各种信息的文章等。如何定义这些标记,既可以选择国际通用的标记语言,比如 HTML,也能够使用像 XML 这样由相干人士自由决定的标记语言,这就是语言的可扩大性。XML 是从标准通用标记语言(SGML)中简化修改出来的。它主要用到的有可扩大标记语言、可扩大样式语言(XSL)、XBRL 和 XPath 等。

CSS(层叠样式表/Cascading Style Sheets),又称串样式列表、级联样式表、串接样式表、层叠样式表,一种用来为结构化文档(如HTML 文档或 XML 利用)添加样式(字体、间距和色彩等)的计算机语言,由 W3C 定义和保护。目前最新版本是 CSS2.1,为 W3C 的推荐标准。CSS3 现在已被大部份现代阅读器支持,而下一版的 CSS4 仍在开发进程中。

HTML 与 XML 同为标记语言。标记语言,是一种将文本和文本相干的其他信息结合起来,展现出关于文档结构和数据处理细节的电脑文字编码。与文本相干的其他信息(包括文本的结构和表示信息等)与原来的文本结合在一起,但是使用标记进行标识。

感觉定义好长,自己顺一下理解就是,标记语言是将普通的文本加上标记,合在一起构成一个文档,这个文档是有结构的,而且是适用于电脑处理的。

感觉还是理解的不深入。这么想吧,html 和 xml 都可以被阅读器解析,显示在网页上。然后再加上 CSS 渲染,应当也是可以展现在网页上的。

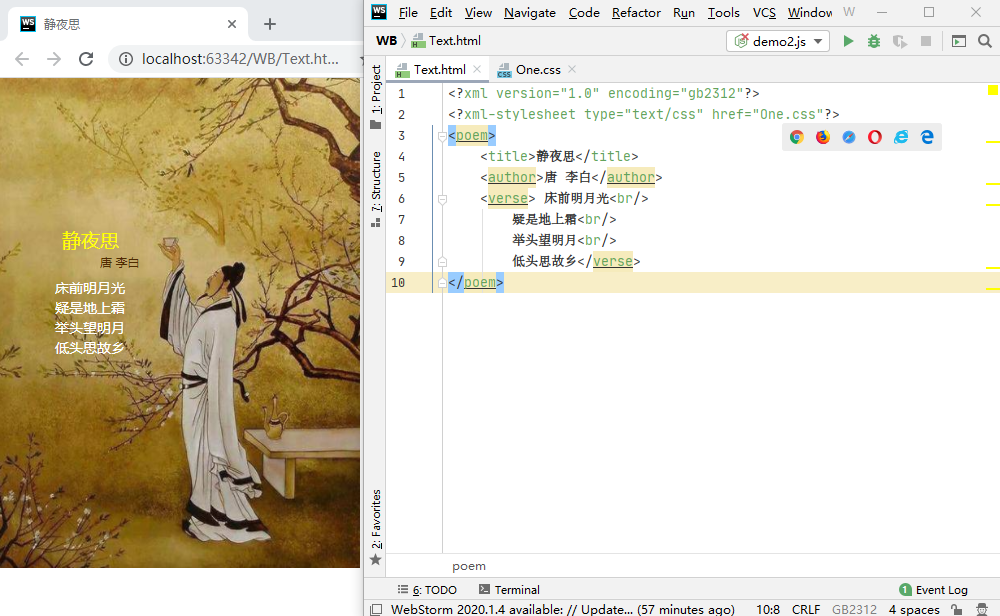
分析终了(好费头脑),理论上 xml+css 是可以实现效果的。那末实际呢?没错,也是可以的,Duang~~~

那么为何大家熟知的都是用 html,从没见过用 xml 写网页的呢?

由于设计初衷不同:XML 设计用来传送及携带数据信息,不用来表现或展现数据,HTML 语言则用来表现数据,所以 XML 用处的焦点是它说明数据是甚么,和携带数据信息。

术业有专攻。适用的就是好的。

PS:今天这个例子就只是扩大一下,其实不是说推荐用 xml 来写页面。

【附】

古诗鉴赏源码:

1、HTML+CSS实现

html源码:

<!DOCTYPE html> 

<html> 

<head lang=”en”> 

<meta charset=”UTF⑻”> 

<title>静夜思</title> 

<link type=”text/css” rel=”stylesheet” href=”静夜思.css” /> 

</head> 

<body> 

<img src=”poem.jpg” class=”img”/> 

<div class=”div1″> 

<span class=”title”>静夜思</span><br/> 

<span class=”author”>唐 李白</span><br/> 

<div class=”verse”> 床前明月光<br/> 

疑是地上霜<br/> 

举头望明月<br/> 

低头思故乡 </div> 

</div> 

</body> 

</html>

与 html 配合的 css 源码:

.div1{ } 

.img{ width:360px; height:490px; position:absolute; left:0px; top:0px; } 

.title{ font-size:19px; color:#FFFF00; position:absolute; left:62px; top:150px; } 

.author{ font-size:12px; color:#4f2b00; position:absolute; left:100px; top:176px; } 

.verse{ position:absolute; /* 绝对定位 */ color:#FFFFFF; font-size:14px; left:55px; top:200px; line-height:20px; /* 行间距 */ }

2.XML+CSS 实现

xml 源码:

<?xml version=”1.0″ encoding=”gb2312″?> 
<?xml-stylesheet type=”text/css” href=”14⑺.css”?> 
<poem> 
<title>静夜思</title> 
<author>唐 李白</author> 
<verse> 床前明月光<br/> 
疑是地上霜<br/> 
举头望明月<br/> 
低头思故乡</verse> 
</poem>

与 XMl 配合的 css 源码:

poem{ margin:0px; background:url(poem.jpg) no-repeat; /*添加背景图片 */ width:360px; height:490px; position:absolute; /* 绝对定位 */ left:0px; top:0px; } 
title{ font-size:19px; color:#FFFF00; position:absolute; left:62px; top:150px; } 
author{ font-size:12px; color:#4f2b00; position:absolute; left:100px; top:176px; } 
verse{ position:absolute; /* 绝对定位 */ color:#FFFFFF; font-size:14px; left:55px; top:200px; line-height:20px; /* 行间距 */ } 
br{ display:block; /* 让诗句分行显示 */ }

numpy之linspace()函数使用详解

thbcm阅读(291)

linspace() 函数

作为序列生成器, numpy.linspace()函数用于在线性空间中以均匀步长生成数字序列。

Numpy通常可以使用numpy.arange()生成序列,但是当我们使用浮点参数时,可能会导致精度损失,这可能会导致不可预测的输出。为了避免由于浮点精度而造成的任何精度损失,numpy在numpy.linspace()为我们提供了一个单独的序列生成器,如果您已经知道所需的元素数,则这是首选。 但是通常使用带有适当参数的linspace()arange()可以得到相同的输出,因此可以为同一任务选择两者。

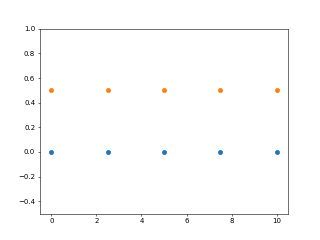
例如,以下代码使用numpy.linspace()在0到10之间绘制2个线性序列,以显示该序列生成的均匀性。

import numpy as np

import matplotlib.pyplot as plt


y = np.zeros(5)

x1 = np.linspace(0, 10, 5)

x2 = np.linspace(0, 10, 5)

plt.plot(x1, y, ‘o’)

plt.plot(x2, y + 0.5, ‘o’)

plt.ylim([-0.5, 1])

plt.show()

输出 :
语法:

格式: array = numpy.linspace(start, end, num=num_points)将在startend之间生成一个统一的序列,共有num_points个元素。

  • start -> Starting point (included) of the rangestart ->范围的起点(包括)
  • end -> Endpoint (included) of the rangeend ->范围的端点(包括)
  • num -> Total number of points in the sequencenum >序列中的总点数

让我们通过几个示例来理解这一点:

import numpy as np


a = np.linspace(0.02, 2, 10)


print(‘Linear Sequence from 0.02 to 2:’, a)

print(‘Length:’, len(a))

输出

Linear Sequence from 0.02 to 2: [0.02 0.24 0.46 0.68 0.9  1.12 1.34 1.56 1.78 2.  ]

Length: 10

上面的代码段生成了0.02到2之间的均匀序列,其中包含10个元素。

endpoint 关键字参数

如果您不想在序列计算中包括最后一点,则可以使用另一个关键字参数endpoint ,可以将其设置为False 。 (默认为True )

import numpy as np


a = np.linspace(0.02, 2, 10, endpoint=False)


print(‘Linear Sequence from 0.02 to 2:’, a)

print(‘Length:’, len(a))

输出

Linear Sequence from 0.02 to 2: [0.02  0.218 0.416 0.614 0.812 1.01  1.208 1.406 1.604 1.802]

Length: 10

如您所见,最后一点(2)没有包含在序列中,因此步长也不同,这将产生一个完全不同的序列。

retstep 关键字参数 

这是一个布尔型可选参数(如果已指定),还将返回步长以及序列数组,从而产生一个元组作为输出

import numpy as np


a = np.linspace(0.02, 2, 10, retstep=True)


print(‘Linear Sequence from 0.02 to 2:’, a)

print(‘Length:’, len(a))

输出

Linear Sequence from 0.02 to 2: (array([0.02, 0.24, 0.46, 0.68, 0.9 , 1.12, 1.34, 1.56, 1.78, 2.  ]), 0.22)

Length: 2

由于输出是元组,因此它的长度是2,而不是10!

axis 关键字参数 

这将在结果中设置轴以存储样本。 仅当开始和端点为数组数据类型时才使用它。

默认情况下( axis=0 ),采样将沿着在开始处插入的新轴进行。 我们可以使用axis=-1来获得末端的轴。

import numpy as np


p = np.array([[1, 2], [3, 4]])

q = np.array([[5, 6], [7, 8]])


r = np.linspace(p, q, 3, axis=0)

print(r)

s = np.linspace(p, q, 3, axis=1)

print(s)

输出

array([[[1., 2.],

        [3., 4.]],


       [[3., 4.],

        [5., 6.]],


       [[5., 6.],

        [7., 8.]]])


array([[[1., 2.],

        [3., 4.],

        [5., 6.]],


       [[3., 4.],

        [5., 6.],

        [7., 8.]]])

在第一种情况下,由于axis = 0 ,我们从第一个轴获取序列限制。

在这里,限制是子数组对[1, 2] and [5,6]以及[3, 4] and [7,8] ,它们取自pq的第一轴。 现在,我们比较结果对中的相应元素以生成序列。

因此,第一行的顺序为[[1 to 5], [2 to 6]] ,第二行的顺序为[[1 to 5], [2 to 6]] [[3 to 7], [4 to 8]] ,对其进行评估并组合形成[ [[1, 2], [3, 4]], [[3, 4], [5, 6]], [[5, 6], [7,8]] ] 。

第二种情况将在axis=1或列中插入新元素。 因此,新轴将通过列序列生成。 而不是行序列。

考虑序列[1, 2] to [5, 7][3, 4] to [7, 8]并将其插入到结果的列中,得到[[[1, 2], [3, 4], [5, 6]], [[3, 4], [5, 6], [7, 8]]] 。

推荐好课:Python3进阶:数据分析及可视化Python 自动化办公

利用sort()函数与文件碎片实现表格的前端排序,兼容IE6原生态

thbcm阅读(318)

表格排序在网页的利用也很多,特别是一些信息系统输出一个密密层层的表格给人看,客户肯定会提出表格排序的要求。很多人定式思惟地认为表格的排序一定要通过数据库后端进行交互,使用带 order by asc/desc 的语句去实现,然后再利用 ajax 似乎很完善似得。其实根本就不用与数据库打交道。在前端给出任意一个表格,都能够利用 sort() 函数与文件碎片实现表格的前端排序。在 jquery 里面是有一个 advanceTable 的插件做这件事,但是这个插件相当不好的是什么呢?与平常的插件一样,代码写得天花龙凤,没有任何注释,一点都不好改,而且不能实现于任意表格,任意浏览器。下面给出一种利用 Javascript 兼容 IE6 的原生态、无插件、不连接数据库的方法去实现这个功能。

一、基本目标

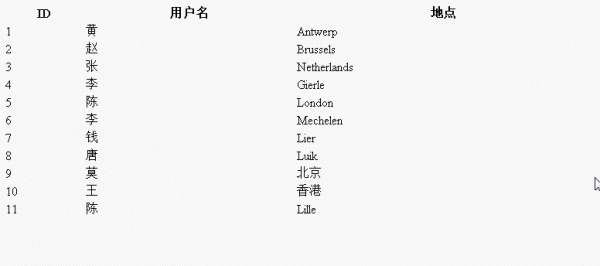
在网页中有以下的表格,点击表头的任意一项可以实现排序,再点击实现逆序排列

二、HTML布局

这个不会就没成心思了。 学过网页都知道表格怎样整。唯一注意的是,实现悬停鼠标手型表示,在前后放一个<a style=”cursor:pointer;”></a>夹着就能够了,不用担心单击会跳转的问题,没有 href 属性就没问题了。为这个表格设置一个id为myTable,便于以后做事。

<!DOCTYPE html PUBLIC “-//W3C//DTD XHTML 1.0 Transitional//EN” “http://www.w3.org/TR/xhtml1/DTD/xhtml1-transitional.dtd”> 
<html xmlns=”http://www.w3.org/1999/xhtml”> 
<head> 
<meta http-equiv=”Content-Type” content=”text/html; charset=utf⑻” /> 
<title>表格排序</title> 
</head> 
<body> 
<table width=”100%” id=”myTable”> 
<thead> 
<tr> 
<th onclick=”SortTable(‘myTable’,0)”><a style=”cursor:pointer;”>ID</a></th> 
<th onclick=”SortTable(‘myTable’,1)”><a style=”cursor:pointer;”>用户名</a></th> 
<th onclick=”SortTable(‘myTable’,2)”><a style=”cursor:pointer;”>地点</a></th> 
</tr> 
</thead> 
<tbody> 
<tr> <td>1</td> <td>黄</td> <td>Antwerp</td> </tr> 
<tr> <td>2</td> <td>赵</td> <td>Brussels</td> </tr> 
<tr> <td>3</td> <td>张</td> <td>Netherlands</td> </tr> 
<tr> <td>4</td> <td>李</td> <td>Gierle</td> </tr> 
<tr> <td>5</td> <td>陈</td> <td>London</td> </tr> 
<tr> <td>6</td> <td>李</td> <td>Mechelen</td> </tr> 
<tr> <td>7</td> <td>钱</td> <td>Lier</td> </tr> 
<tr> <td>8</td> <td>唐</td> <td>Luik</td> </tr> 
<tr> <td>9</td> <td>莫</td> <td>北京</td> </tr> 
<tr> <td>10</td> <td>王</td> <td>香港</td> </tr> 
<tr> <td>11</td> <td>陈</td> <td>Lille</td> </tr> 
</tbody> 
</table> 
</body> 
</html> 

三、核心脚本

关键是对 soft(softfunction())排序函数的写作,利用到文件碎片的思想

<script> //这个东西是用来判断是不是逆序 
var IsAsc=true; function SortTable(TableID,Col){ 
IsAsc=!IsAsc; 
var DTable=document.getElementById(TableID); 
var DBody=DTable.tBodies[0];//能够取到tbody的里的所有节点 
var DataRows=DBody.rows;//能够取到tbody里面的所有行节点,DataRows相当于1个数组 //把援用数组的值存到正常数组操作 
var MyArr=new Array(); 
for(var i=0;i<DataRows.length;i++){ 
MyArr[i]=DataRows[i]; 
} //判断上次排序的列和这次是不是为同一列 
if(DBody.CurrentCol==Col){ 
MyArr.reverse();//将数组颠倒 
} else{ 
//javascript要求必须sort(function())
自己写比对函数,写出你认为怎样才算小于、怎样才是大于,怎样才是等于 MyArr.sort( //传过来的对象是MyArr这个数组的任意两个元素tr1与tr2,行1与行2 
function compare(TR1,TR2){ 
var value1,value2; //如果你现在是在排序号的,也就是是在比较ID那一列,最左列,第0列,那末我必须依照数字去处理 if(Col==0){ //取当前行的自定义标签与后一行的自定义标签 
value1=parseInt(TR1.cells[Col].innerHTML); 
value2=parseInt(TR2.cells[Col].innerHTML); 
if(value1<value2) //⑴代表前者小于后者 return ⑴; 
else if(value1>value2) //1代表前者大于后者 
return 1; else //0代表两个值相等 return 0; } //否则,依照字符串来排 else{ //把列中比对单元格里面的值转化成字符串再比较 
value1=TR1.cells[Col].innerHTML+””; value2=TR2.cells[Col].innerHTML+””; //直接调用javascript的中文比对方法,这个方法能够自动比对字符串并且返回相应的结果的 
return value1.localeCompare(value2); } } ); } //创建一个文档碎片,将所有的行都添加进去,相当于一个暂存架,如果直接加到document.body里面,会插入一行,就刷新一次,如果数据多了就会影响用户体验 //先将行全部放在暂存架里面,然后将暂存架里面的行,一起添加到document.body,这样表格只会刷新一次。 //就像你去商店购物,要先将要买的物品(行)全部写在单子上(文档碎片),然后超市全部购买,而不会想到一样东西就去一次 
var frag=document.createDocumentFragment(); for(var i=0;i<MyArr.length;i++){ frag.appendChild(MyArr[i]);//将数组里的行全部添加到文档碎片中 } DBody.appendChild(frag);//将文档碎片中的行全部添加到 body中 DBody.CurrentCol=Col;//记录下当前排序的列 } </script>

备注:如果单元格里面寄存的不是一个正常的值怎样办呢,或单元格里面有一堆东西,你可以为所有单元格赋予一个自定义属性,通过比对这个单元格的自定义属性,以后排序函数的取值改成 TR1.cells[Col].getAttribute(“”)+””便可,就变成比对这个自定义属性的值了,这类情况多见于动态网页里面的大工程。

推荐好课:JavaScript微课ES6微课

Python 几种常见的测试框架

thbcm阅读(335)

测试的常用规则

  1. 一个测试单元必须关注一个很小的功能函数,证明它是正确的;
  2. 每个测试单元必须是完全独立的,必须能单独运行。这样意味着每一个测试方法必须重新加载数据,执行完毕后做一些清理工作。通常通过setUp()和setDown()方法处理;
  3. 编写执行快速的测试代码。在某些情况下,测试需要加载复杂的数据结构,而且每次执行的时候都要重新加载,这个时候测试执行会很慢。因此,在这种情况下,可以将这种测试放置一个后台的任务中。
  4. 采用测试工具并且学着怎么使用它。
  5. 在编写代码前执行完整的测试,而且在编写代码后再重新执行一次。这样能保证你后来编写的代码不会破坏任何事情;
  6. 在提交代码前执行完整的测试;
  7. 如果在开发期间被打断了工作,写一个打断的单元测试,关于你下一步将要开发的。当你回来工作时,你能知道上一步开发到的指针;
  8. 单元测试函数使用长的而且具有描述性的名字。在正式执行代码中,可能使用square()或sqr()取名,但是在测试函数中,你必须取像test_square_of_number_2()、test_square_negativer_number()这些名字,这些名字描述更加清楚;
  9. 测试代码必须具有可读性;
  10. 单元测试对新进的开发人员来说是工作指南。

单元测试的目的是对一个模块、一个函数或者一个类来进行正确性检验,如果单元测试通过,说明我们测试的对象能够正常工作。如果单元测试不通过,要么测试对象有 bug,要么测试条件输入不正确。下面小编为大家介绍 Python 的几种测试框架。

推荐好课:Python 自动化管理Python 自动化办公

1. unittest

unittest 和 JUnit类似,可以说是python的标准单元测试框架,所以有时也被人称为 PyUnit。它使用起来和xUnit 家族其他成员类似。 用的人也比较多。兼容 python2 以及python3 。

个人比较喜欢用这个,主要之前用过JUnit,用这个上手就很快。而且属于python自动集成,不用额外的安装包,感觉是该有的都有了,用着方便。

示例:

import unittest

class TestStringMethods(unittest.TestCase):

    def test_upper(self):

        self.assertEqual(‘foo’.upper(), ‘FOO’)

    def test_isupper(self):

        self.assertTrue(‘FOO’.isupper())

        self.assertFalse(‘Foo’.isupper())

    def test_split(self):

        s = ‘hello world’

        self.assertEqual(s.split(), [‘hello’, ‘world’])

        # check that s.split fails when the separator is not a string

        with self.assertRaises(TypeError):

            s.split(2)

if __name__ == ‘__main__’:

    unittest.main()

2. unittest2

unittest2 可以说是一个针对 unittest 测试框架新特性的补丁。它很大程度上和 unittest 都类似。然后还添加了一些 unittest 没有的方法。

3. pytest

参考文档:http://pytest.org/latest/

看了一下,pytest文档还是蛮详细的。比较关注的一点是,pytest 直接可以通过 @pytest.mark.parametrize 进行参数化,而unittest 则需要借助DDT。

示例:

def inc(x):

    return x + 1

def test_answer():

    assert inc(3) == 5

执行如下:

$ pytest

======= test session starts ========

platform linux — Python 3.x.y, pytest-3.x.y, py-1.x.y, pluggy-0.x.y

rootdir: $REGENDOC_TMPDIR, inifile:

collected 1 item

test_sample.py F

======= FAILURES ========

_______ test_answer ________

    def test_answer():

>       assert inc(3) == 5

E       assert 4 == 5

E        +  where 4 = inc(3)

test_sample.py:5: AssertionError

======= 1 failed in 0.12 seconds ========

4. nose

nose 扩展了 unittest,从而使得测试更容易。

一般可以用 unittest 方式写用例,写完之后用 nose 来执行。nose 的测试收集方式还是很方便的。

 还有一个特定就是,nose 可以采用  @with_setup() 来定义方法的 setup 和 teardown。

示例:

def setup_func():

    “set up test fixtures”

def teardown_func():

    “tear down test fixtures”

@with_setup(setup_func, teardown_func)

def test():

    “test …”

5. doctest

doctest 模块会搜索那些看起来像交互式会话的 Python 代码片段,然后尝试执行并验证结果。

doctest 中,如果要写测试用例,只需要在写在以 ”’ ”’包围的文档注释即可,也就是可以被__doc__这个属性引用到的地方。这点比较特别,跟其他单元测试框架都不一样。但是我觉得这样的话就注定了doctest不适合大型测试,因为做不到代码和测试的分离。

import doctest

“””

This is the “example” module.

The example module supplies one function, factorial().  For example,

>>> factorial(5)

120

“””

def factorial(n):

    “””Return the factorial of n, an exact integer >= 0.

    >>> [factorial(n) for n in range(6)]

    [1, 1, 2, 6, 24, 120]

    >>> factorial(30)

    265252859812191058636308480000000

    >>> factorial(-1)

    Traceback (most recent call last):

        …

    ValueError: n must be >= 0

    Factorials of floats are OK, but the float must be an exact integer:

    >>> factorial(30.1)

    Traceback (most recent call last):

        …

    ValueError: n must be exact integer

    >>> factorial(30.0)

    265252859812191058636308480000000

    It must also not be ridiculously large:

    >>> factorial(1e100)

    Traceback (most recent call last):

        …

    OverflowError: n too large

    “””

    import math

    if not n >= 0:

        raise ValueError(“n must be >= 0”)

    if math.floor(n) != n:

        raise ValueError(“n must be exact integer”)

    if n+1 == n:  # catch a value like 1e300

        raise OverflowError(“n too large”)

    result = 1

    factor = 2

    while factor <= n:

        result *= factor

        factor += 1

    return result

if __name__ == “__main__”:

    doctest.testmod(verbose=True)

verbose 参数用于控制是否输出详细信息,默认为 False ,如果不写,那么运行时不会输出任何东西,除非测试 fail。

输出如下:

Trying:

    [factorial(n) for n in range(6)]

Expecting:

    [1, 1, 2, 6, 24, 120]

ok

Trying:

    factorial(30)

Expecting:

    265252859812191058636308480000000

ok

Trying:

    factorial(-1)

Expecting:

    Traceback (most recent call last):

        …

    ValueError: n must be >= 0

ok

Trying:

    factorial(30.1)

Expecting:

    Traceback (most recent call last):

        …

    ValueError: n must be exact integer

ok

Trying:

    factorial(30.0)

Expecting:

    265252859812191058636308480000000

ok

Trying:

    factorial(1e100)

Expecting:

    Traceback (most recent call last):

        …

    OverflowError: n too large

ok

1 items had no tests:

    __main__

1 items passed all tests:

   6 tests in __main__.factorial

6 tests in 2 items.

6 passed and 0 failed.

Test passed.

联系我们