简化RESTful开发,Spring Data REST减轻你的工作量

thbcm阅读(408)

1.简介

Springboot 和 Spring MVC 简化了web应用中的RESTful开发,然而还有一种更简单的,那就是Spring Data REST。Spring Data REST 建立在Data Repository之上,它可以直接把resository以HATEOAS风格暴露成Web服务,就不需要再手写Controller层。

  • HATEOAS,即Hypermedia as the Engine of Application State ,它是一种更成熟的REST模型,在资源的表达中包含了链接信息,客户端可以根据链接来发现可执行的动作。

Spring Data REST支持Spring Data JPA、Spring Data MongoDB、Spring Data Neo4j、Spring Data GenFire、Spring Data Cassandra,这里选择大家比较熟悉的JPA。

2 举个例子

我们用例子来感受一下吧。

2.1 创建项目

我们通过Spring Initializr来快速创建Springboot项目。选中的依赖组件如下:
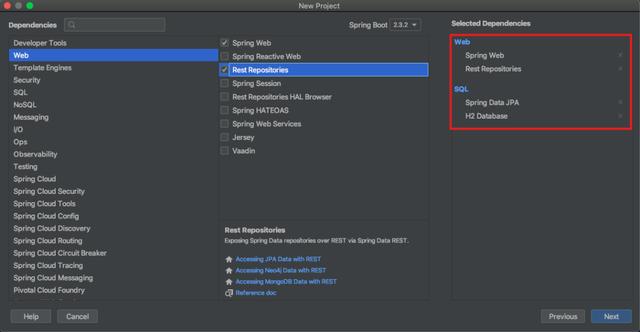
  • (1)Spring Web:提供Web服务;
  • (2)Rest Repositories:提供Spring Data REST的支持;
  • (3)Spring Data JPA:通过JPA提供Repository方式的数据访问;
  • (4)H2 Database:H2数据库,为了方便简洁,使用该数据库。

(推荐课程:Spring教程)

导入后对应的pom.xml中依赖如下:

<dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-jpa</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-rest</artifactId> </dependency> <dependency> <groupId>com.h2database</groupId> <artifactId>h2</artifactId> <scope>runtime</scope> </dependency>

2.2 实体类

创建一个实体类User,如下所示:

package com.pkslow.rest.entity;


import javax.persistence.Entity;
import javax.persistence.GeneratedValue;
import javax.persistence.GenerationType;
import javax.persistence.Id;


@Entity
public class User {
    @Id
    @GeneratedValue(strategy = GenerationType.AUTO)
    private Integer id;
    private String name;
    private Integer age;
    private String email;

  
  //getter & setter
}

2.3 Repository接口定义

定义Repository接口用于操作数据库,如下所示:

package com.pkslow.rest.repo;


import com.pkslow.rest.entity.User;
import org.springframework.data.repository.CrudRepository;
import org.springframework.data.rest.core.annotation.RepositoryRestResource;


@RepositoryRestResource(path = "user")
public interface UserRepository extends CrudRepository<User, Integer> {
}

注解RepositoryRestResource是Data REST用于暴露Repository,path为访问路径,设置为user,则访问地址为http://localhost:8080/user。

2.4 启动访问

准备好以上代码,直接启动Springboot应用即可,我们把端口设置为8080,访问如下:
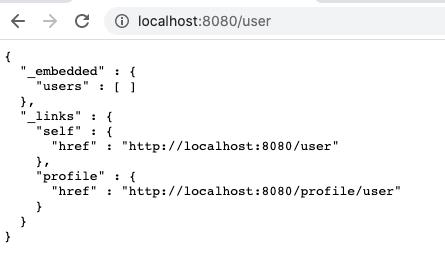
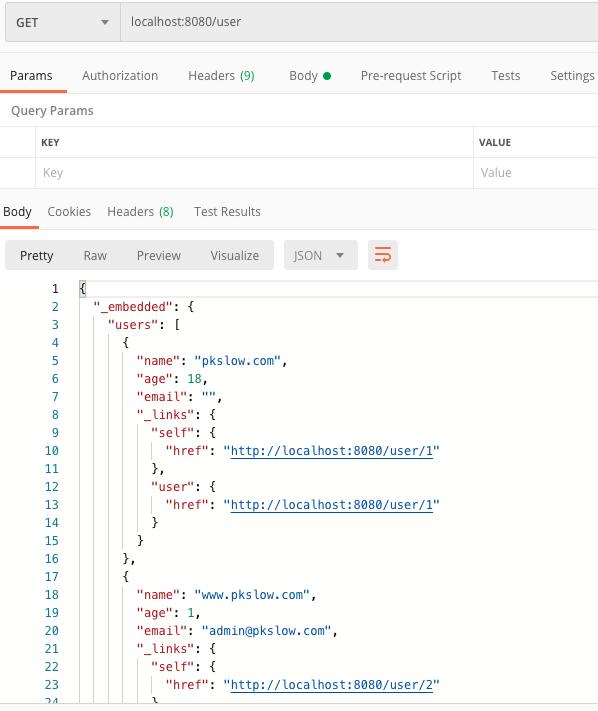
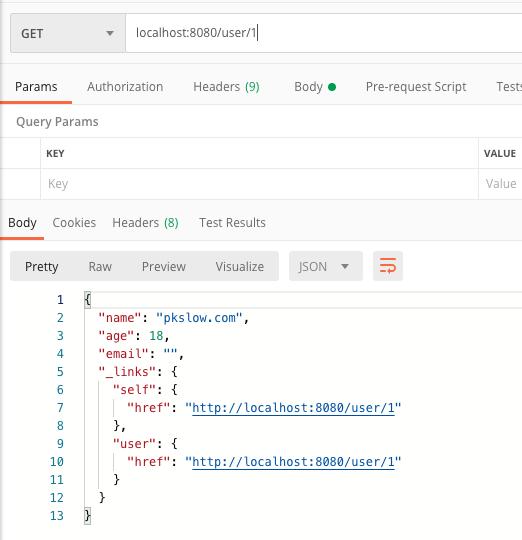
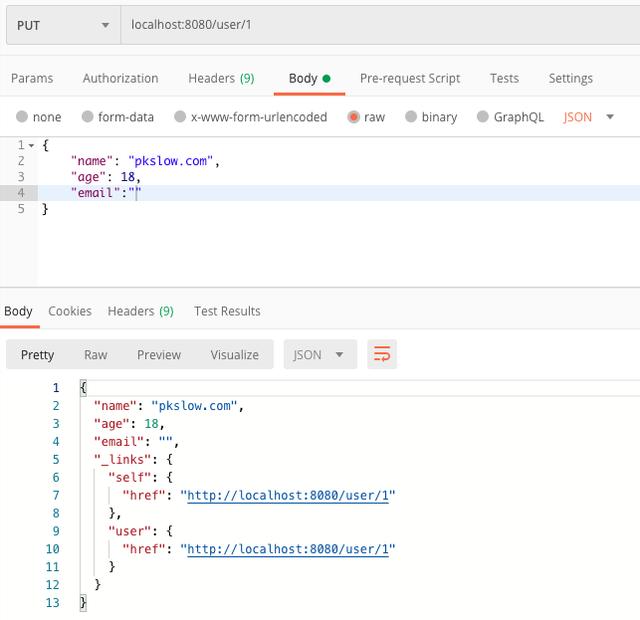
我们用Postman做一个基本操作。

新增:
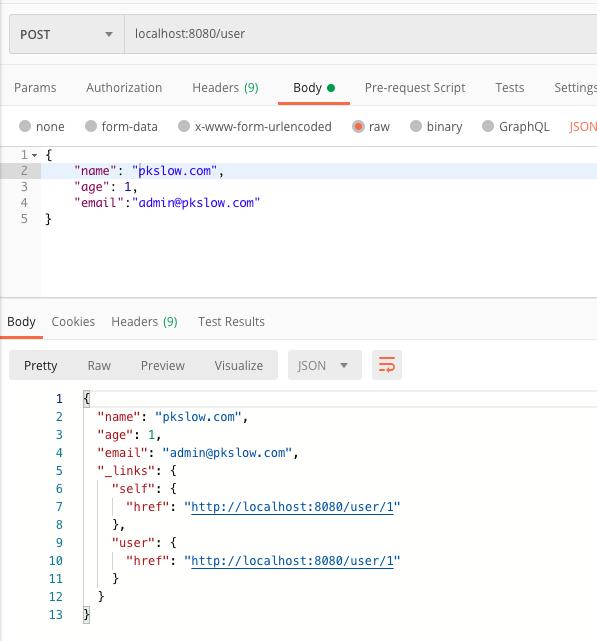
查询:
通过主键ID查询:
修改:
删除:
不难发现,返回的Json都带有链接,这就是HATEOAS风格。

3 更多探索

3.1 分页及排序功能

可以快速实现分页及排序功能,只需要把Repository的父接口改为PagingAndSortingRepository即可,如下所示:

@RepositoryRestResource(path = “user”) public interface UserRepository extends PagingAndSortingRepository<User, Integer> { }

其实就是多了两个方法findAll(Sort var1)和findAll(Pageable var1),如下所示:

public interface PagingAndSortingRepository<T, ID> extends CrudRepository<T, ID> { Iterable<T> findAll(Sort var1);


    Page<T> findAll(Pageable var1);
}

查询http://localhost:8080/user?page=1&size=2&sort=id,desc,表示查询第二页,每页2条记录,以ID倒序展示。如下:

{ “_embedded”: { “users”: [ { “name”: “pkslow.com”, “age”: 18, “email”: “pkslow@pkslow.com”, “_links”: { “self”: { “href”: “http://localhost:8080/user/33” }, “user”: { “href”: “http://localhost:8080/user/33” } } }, { “name”: “pkslow.com”, “age”: 18, “email”: “pkslow@pkslow.com”, “_links”: { “self”: { “href”: “http://localhost:8080/user/32” }, “user”: { “href”: “http://localhost:8080/user/32” } } } ] }, “_links”: { “first”: { “href”: “http://localhost:8080/user?page=0&size=2&sort=id,desc” }, “prev”: { “href”: “http://localhost:8080/user?page=0&size=2&sort=id,desc” }, “self”: { “href”: “http://localhost:8080/user?page=1&size=2&sort=id,desc” }, “next”: { “href”: “http://localhost:8080/user?page=2&size=2&sort=id,desc” }, “last”: { “href”: “http://localhost:8080/user?page=17&size=2&sort=id,desc” }, “profile”: { “href”: “http://localhost:8080/profile/user” } }, “page”: { “size”: 2, “totalElements”: 35, “totalPages”: 18, “number”: 1 } }

可以发现page是从0开始的,1表示第二页;返回结果还提供了第一页、上一页、本页、下一页、最后一页的链接;以及分页信息。

(推荐微课:Spring微课)

3.2 事件监听

REST提供了8个基于Repository的事件,如下:

  • BeforeCreateEvent
  • AfterCreateEvent
  • BeforeSaveEvent
  • AfterSaveEvent
  • BeforeLinkSaveEvent
  • AfterLinkSaveEvent
  • BeforeDeleteEvent
  • AfterDeleteEvent

添加一个自定义事件如下:

package com.pkslow.rest.event;


import com.pkslow.rest.entity.User;
import org.springframework.data.rest.core.event.AbstractRepositoryEventListener;
import org.springframework.stereotype.Component;


@Component
public class PkslowEventListener extends AbstractRepositoryEventListener<User> {


    @Override
    public void onBeforeCreate(User entity) {
        System.out.println("pkslow creating:" + entity);
    }


    @Override
    public void onBeforeSave(User entity) {
        System.out.println("pkslow saving:" + entity);
    }


    @Override
    public void onAfterDelete(User entity) {
        System.out.println("pkslow deleted:" + entity);
    }
}

分别执行了增加、修改、删除后,日志如下:

pkslow creating:User{id=null, name=’pkslow.com’, age=18, email=’pkslow@pkslow.com’} pkslow saving:User{id=32, name=’pkslow.com’, age=20, email=’pkslow@pkslow.com’} pkslow deleted:User{id=14, name=’pkslow.com’, age=18, email=’pkslow@pkslow.com’}

说明事件成功执行,结合这个功能,可以实现很多业务逻辑,如删除后记录操作日志,并删除其它相关数据。

(推荐教程:Spring Boot 那些事)

3.3 路径

默认基础路径是/,可以通过spring.data.rest.base-path=api进行配置,这样就变成了localhost:8080/api/user。

4 集成HAL Browser查看

HAL Browser是一个专门用于浏览基于JSON Hypertext Application Language的前端工具。我们前面已经提供了HATEOAS风格的RESTful服务,HAL Browser可以方便查看。

加入依赖:

<dependency> <groupId>org.springframework.data</groupId> <artifactId>spring-data-rest-hal-browser</artifactId> <version>3.3.2.RELEASE</version> </dependency>

启动后访问http://localhost:8080/browser/index.html#/如下:
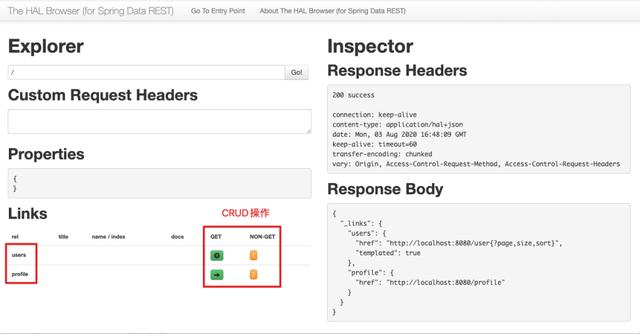
可以进行CRUD操作,具体就不一一展示了。

以上就是关于Spring Data REST的介绍,它可以方便大家使用RESTful开发,希望对大家有所帮助,虽然项目中使用的机会并不大,但也可以扩展一些知识面。
什么是Python Wheels? python.whl有什么用处?

thbcm阅读(368)

Python .whl文件(或wheels)是python很少被提到的一部分,不过它们对python包的安装过程相当重要。如果你已经使用pip安装了python包,那么很大可能轮子(wheels)使你的安装速度更快了,效率更高了。

轮子是Python生态系统的一个组件,它有助于使包的安装工作正常进行。它们允许更快的安装和更稳定的包分发过程。在本教程中,您将深入了解轮子是什么,它们提供了什么好处,以及它们是如何获得吸引力并使使用Python变得更方便的。

(推荐教程:python教程)

轮子简介

在学习如何将项目打包到轮子中之前,从用户的角度了解使用轮子是什么样子是很有帮助的。

可以像往常一样在环境中安装一个Python包来开始这个实验。在这种情况下,安装uWSGI 2.0.x版本:

$ python -m pip install 'uwsgi==2.0.*'
 2 Collecting uwsgi==2.0.*
 3   Downloading uwsgi-2.0.18.tar.gz (801 kB)
 4      |████████████████████████████████| 801 kB 1.1 MB/s
 5 Building wheels for collected packages: uwsgi
 6   Building wheel for uwsgi (setup.py) ... done
 7   Created wheel for uwsgi ... uWSGI-2.0.18-cp38-cp38-macosx_10_15_x86_64.whl
 8   Stored in directory: /private/var/folders/jc/8_hqsz0x1tdbp05 ...
 9 Successfully built uwsgi
10 Installing collected packages: uwsgi
11 Successfully installed uwsgi-2.0.18

要完全安装uWSGI, pip需要经过几个不同的步骤:

  1. 在第3行,它下载一个名为uwsgi-2.0.18.tar.gz的TAR文件(tarball),该文件是用gzip压缩的。
  2. 在第6行,它接受tarball并通过调用setup.py构建一个.whl文件。
  3. 在第7行,它将轮子标记为uWSGI-2.0.18-cp38-cp38-macosx_10_15_x86_64.whl。
  4. 在第10行,它在构建了轮子之后安装实际的包。

pip检索的tar.gz tarball是一个源分发包,或sdist,而不是一个轮子。在某些方面,sdist是轮子的反义词。

源代码发行版包含源代码。这不仅包括Python代码,还包括与包绑定的任何扩展模块的源代码(通常用C或c++编写)。对于源发行版,扩展模块是在用户端而不是开发人员端编译的。

源分发版还包含一个元数据包,位于名为.egg-info的目录中。该元数据有助于构建和安装包,但用户实际上并不需要使用它做任何事情。

从开发人员的角度来看,当您运行以下命令时,会创建一个源分发包:

$ python setup.py sdist

现在尝试安装一个不同的包:chardet:

$ python -m pip install 'chardet==3.*'
 2 Collecting chardet
 3   Downloading chardet-3.0.4-py2.py3-none-any.whl (133 kB)
 4      |████████████████████████████████| 133 kB 1.5 MB/s
 5 Installing collected packages: chardet
 6 Successfully installed chardet-3.0.4

您可以看到一个与uWSGI安装明显不同的输出。

安装chardet时直接从PyPI下载一个.whl文件。车轮名称为chardet-3.0.4-py2.py3-none-any。whl遵循特定的命名约定,稍后您将看到。从用户的角度来看,更重要的是,当pip在PyPI上找到一个兼容的滚轮时,并不存在构建阶段。

从开发人员的角度来看,轮子是运行以下命令的结果:

$ python setup.py bdist_wheel

为什么uWSGI给你一个源分布,而chardet提供一个轮子?您可以通过查看PyPI上每个项目的页面并导航到下载文件区域来了解原因。本节将向您展示pip在PyPI索引服务器上实际看到的内容:

  1. 由于项目的复杂性,uWSGI只提供了一个源分发版(uWSGI -2.0.18.tar.gz)。
  2. chardet同时提供了一个轮盘和一个源代码发行版,但是如果与您的系统兼容,pip会更喜欢轮盘。稍后您将看到如何确定兼容性。

另一个用于轮子安装的兼容性检查示例是psycopg2,它为Windows提供了大量的车轮,但没有为Linux或macOS客户端提供任何轮子。这意味着,根据您的具体设置,pip安装psycopg2可以获取一个滚轮或源分发版。

为了避免这些类型的兼容性问题,一些包提供了多个轮子,每个轮子都针对特定的Python实现和底层操作系统。

到目前为止,您已经看到了轮子和sdist之间的一些明显区别,但更重要的是这些区别对安装过程的影响。

(推荐微课:python3基础微课)

轮子加速安装

在上面,您看到了获取预构建轮子的安装和下载sdist的安装的比较。轮子使得Python包的端到端安装速度更快,原因有两个:

  1. 在其他条件相同的情况下,轮子通常比源分发包更小,这意味着它们可以在网络中更快地移动。
  2. 直接从wheels安装避免了从源分发版构建包的中间步骤。

几乎可以保证,安装chardet只需uWSGI所需时间的一小部分。然而,这是一种不公平的比较,因为chardet是一个明显更小和更简单的包。使用不同的命令,您可以创建一个更直接的比较,它将演示轮子造成的差异有多大。

你可以通过-no-binary选项让pip忽略它对车轮的倾斜:

$ time python -m pip install \
      --no-cache-dir \
      --force-reinstall \
      --no-binary=:all: \
      cryptography

这个命令计算加密包的安装时间,告诉pip使用源分发包,即使有合适的轮可用。包括:all:使规则适用于密码学及其所有依赖关系。

在我的机器上,从开始到结束大约需要32秒。不仅安装要花费很长时间,而且构建加密还需要提供OpenSSL开发头,并可用于Python。

现在可以重新安装密码学,但是这次要确保pip使用来自PyPI的wheels。因为pip更喜欢轮子,所以这类似于完全不带参数调用pip install。但在这种情况下,你可以让意图显式通过要求车轮-纯二进制:

此选项仅花费4秒多一点的时间,即仅为密码学及其依赖项使用源分发版时所用时间的八分之一。

以上就是关于 Python Wheels 的相关介绍了,希望对大家有所帮助。

python中关于numpy库的介绍

thbcm阅读(441)

1.Numpy是什么?

NumPy(Numerical Python的缩写)是一个开源的Python科学计算库。使用NumPy,就可以很自然地使用数组和矩阵。 NumPy包含很多实用的数学函数,涵盖线性代数运算、傅里叶变换和随机数生成等功能。

这个库的前身是1995年就开始开发的一个用于数组运算的库。经过了长时间的发展,基本上成了绝大部分Python科学计算的基础包,当然也包括所有提供Python接口的深度学习框架。

2.为什么使用Numpy?

a)便捷:

对于同样的数值计算任务,使用NumPy要比直接编写Python代码便捷得多。这是因为NumPy能够直接对数组和矩阵进行操作,可以省略很多循环语句,其众多的数学函数也会让编写代码的工作轻松许多。

b)性能:

NumPy中数组的存储效率和输入输出性能均远远优于Python中等价的基本数据结构(如嵌套的list容器)。其能够提升的性能是与数组中元素的数目成比例的。对于大型数组的运算,使用NumPy的确很有优势。对于TB级的大文件,NumPy使用内存映射文件来处理,以达到最优的数据读写性能。

c)高效:

NumPy的大部分代码都是用C语言写成的,这使得NumPy比纯Python代码高效得多。

当然,NumPy也有其不足之处,由于NumPy使用内存映射文件以达到最优的数据读写性能,而内存的大小限制了其对TB级大文件的处理;此外,NumPy数组的通用性不及Python提供的list容器。因此,在科学计算之外的领域,NumPy的优势也就不那么明显。

(推荐教程:python教程)

3.Numpy的安装:

  1. 官网安装:http://www.numpy.org/。
  2. pip 安装:pip install numpy。
  3. LFD安装:针对windows用户http://www.lfd.uci.edu/~gohlke/pythonlibs/。
  4. Anaconda安装(推荐):Anaconda里面集成了很多关于python科学计算的第三方库,主要是安装方便。下载地址:https://www.anaconda.com/download/。

4.numpy 基础:

NumPy的主要对象是同种元素的多维数组。这是一个所有的元素都是一种类型。在NumPy中维度(dimensions)叫做轴(axes),轴的个数叫做秩(rank)。NumPy的数组类被称作 ndarray(矩阵也叫数组 。通常被称作数组。

常用的ndarray对象属性有:

  • ndarray.ndim(数组轴的个数,轴的个数被称作秩),
  • ndarray.shape(数组的维度。这是一个指示数组在每个维度上大小的整数元组。例如一个n行m列的矩阵,它的shape属性将是(2,3),这个元组的长度显然是秩,即维度或者ndim属性),
  • ndarray.size(数组元素的总个数,等于shape属性中元组元素的乘积),
  • ndarray.dtype(一个用来描述数组中元素类型的对象,可以通过创造或指定dtype使用标准Python类型。另外NumPy提供它自己的数据类型)。

Numpy的数据类型:

import numpy as np
a = np.dtype(np.int_)     #  np.int64, np.float32 …
print(a) 

Numpy内置的特征码:

int8, int16, int32,int64 可以由字符串’i1’, ‘i2’,’i4’, ‘i8’代替,其余的以此类推。

import numpy as np
a = np.dtype(‘i8’)    # ’f8’, ‘i4’’c16’,’a30’(30个字符的字
# 符串), ‘>i4’…
print (a)

可以指明数据类型在内存中的字节序,’>’表示按大端的方式存储,’<’表示按小端的方式存储,’=’表示数据按硬件默认方式存储。大端或小端存储只影响数据在底层内存中存储时字节的存储顺序,在我们实际使用python进行科学计算时,一般不需要考虑该存储顺序。

(推荐微课:python3基础微课)

5.创建数组并查看其属性:

(1) 用np.array从python列表和元组创建数组:

import numpy as np
a = np.array([[1,2,3], [4, 5, 6]], dtype=int)
print(a.shape)       #  a.ndim, a.size, a.dtype

import numpy as np
a = np.array([(1,2,3), (4, 5, 6)], dtype=float)
print(a.shape)      #  a.ndim, a.size, a.dtype

(2) 用np.arange().reshape()创建数组:

import numpy as np
a = np.arange(10).reshape(2, 5) # 创建2行5列的二维数组,
# 也可以创建三维数组,
# a = np.arange(12).reshape(2,3,2)
print(a)

判断下列三维数组的shape:

a = np.array([[[1,2,3], [4, 5, 6], [7, 8, 9]]])
b = np.array([[[1,2,3]], [[4, 5, 6]], [[7, 8, 9]]])

6.基本运算:

import numpy as np
a = np.random.random(6)
b = np.random.rand(6)
c = np.random.randn(6)
print(a-b)                    # print(a+b),print(a*c) …
# 二维数组运算
d = np.random.random((2,3))
e = np.random.randn(2, 3)
f = np.random.rand(2,3)
print(d-e)                    # print(d+f),print(e*f) …
print(np.dot(a,b))          #复习矩阵乘法
print(a.dot(b))
# Numpy 随机数模块np.random.random, np.random.randn, np.random.rand的比较
(1)rand 生成均匀分布的伪随机数。分布在(0~1)之间
(2)randn 生成标准正态分布的伪随机数(均值为0,方差为1)。

import numpy as np
a = np.ones((2,3)) 
b = np.zeros((2,3))
a*=3
b+=a

7.常用函数:

import numpy as np 
a = np.arange(10)
np.where()

8.索引,切片和迭代:

import numpy as np
 a = arange(10)**3
a[2]
a[2:5]
a[:6:2] = -1000
a[ : :-1]
for i in a:
    print i**(1/3.)


# 多维数组的索引
b = np.arange(20).reshape(5,4)
b[2,3]
b[0:5, 1]
b[ : ,1]
b[1:3, : ]
#当少于轴数的索引被提供时,确失的索引被认为是整个切片
b[-1]    #相当于b[-1,:]
# b[i] 中括号中的表达式被当作 i 和一系列 : ,来代表剩下的轴。NumPy也允许你使用“点”像 b[i,...] 。
#点 (…)代表许多产生一个完整的索引元组必要的分号。如果x是
#秩为5的数组(即它有5个轴),那么:x[1,2,…] 等同于 x[1,2,:,:,:],x[…,3] 等同于 x[:,:,:,:,3],x[4,…,5,:] 等同 x[4,:,:,5,:].


三维数组的索引:
c = np.arange(12).reshape(2,3,2)
c[1]
c[2,1]    # 等价于c[2][1]
c[2,1,1]  # 等价于c[2][1][1]


# 通过数组索引
d = np.arange(10)**2
e = np.array ([3, 5, 6])
d[e] = ?


#练习, 用同样的方法在二维数组中操作。
# 通过布尔数组索引
f = np.arange(12).reshape(3, 4)
g = f>4
print(g)
f [g]

迭代多维数组是就第一个轴而言的:

h = np.arange(12).reshape(3,4)
for i in h:
   print(i)

如果想对每个数组中元素进行运算,我们可以使用flat属性,该属性是数组元素的一个迭代器:

for i in h.flat:
print(i)

补充:flatten()的用法: np.flatten()返回一个折叠成一维的数组。但是该函数只能适用于numpy对象,即array或者mat,普通的list列表是不行的。

import numpy as np
a = np.array([[1,2], [3, 4], [5, 6]])

 
a.flatten()
b = np.mat([[1,2,3], [4, 5, 6]])
b.flatten()
c = [[1,2,3], [4, 5, 6]]
c.flatten() ?

想要list达到同样的效果可以使用列表表达式:

[y for x in a for y in x]

9. 形状操作:

ravel(),vstack(),hstack(),column_stack,row_stack, stack, split, hsplit, vsplit

import numpy as np


#增加维度
a = np.arange(5)
a[:, np.newaxis]
a[np.newaxis, :]
np.tile([1,2], 2)


#合并
a = np.arange(10).reshape(2,5)
print(a.ravel())
print(a.resize(5,2))
b = np.arange(6).reshape(2,3)
c = np.ones((2,3))
d = np.hstack((b,c))              # hstack:horizontal stack 左右合并
e = np.vstack((b,c))              # vstack: vertical stack 上下合并          
f = np.column_stack((b,c))
g = np.row_stack((b,c))
h = np.stack((b, c), axis=1)      # 按行合并
i = np.stack((b,c), axis=0)       # 按列合并
j = np.concatenate ((b, c, c, b), axis=0)   #多个合并

 
#分割
k = np.hsplit(i, 2)
l = np.vsplit(i, 2)
m = np.split(i, 2, axis=0)
n = np.split(i, 2,axis=1)

 
o = np.array_split(np.arange(10),3)   #不等量分割

10.深拷贝:

import numpy as np
a = np.arange (4)
b = a
c = a
d = b
a[0]=10  a = ? b = ? c= ? d = ?
b = a.copy()
a [0] = 9
b = ?

11.广播 Broadcasting

广播是一种强有力的机制,它让Numpy可以让不同大小的矩阵在一起进行数学计算。我们常常会有一个小的矩阵和一个大的矩阵,然后我们会需要用小的矩阵对大的矩阵做一些计算。

把一个向量加到矩阵的每一行:

    import numpy as np
    a = np.array ([[1,2,3], [4,5,6], [7,8,9]])
    b = np.array ([10,10,10])
    c = np.tile(b, (4,1))
    d = a + c
    #用广播机制:
    c = a + b

对两个数组使用广播机制要遵守下列规则:

  1. 如果数组的秩不同,使用1来将秩较小的数组进行扩展,直到两个数组的尺寸的长度都一样。
  2. 如果两个数组在某个维度上的长度是一样的,或者其中一个数组在该维度上长度为1,那么我们就说这两个数组在该维度上是相容的。
  3. 如果两个数组在所有维度上都是相容的,他们就能使用广播。
  4. 如果两个输入数组的尺寸不同,那么注意其中较大的那个尺寸。因为广播之后,两个数组的尺寸将和那个较大的尺寸一样。
  5. 在任何一个维度上,如果一个数组的长度为1,另一个数组长度大于1,那么在该维度上,就好像是对第一个数组进行了复制。

以上就是关于python中numpy库的相关知识了,希望对大家有所帮助。

Go 1.14.7 和 Go 1.13.15 更新;Go1.15 RC2 发布

thbcm阅读(390)

Go语言这次依旧还是小版本更新,包括 Go 1.14.7 和 Go 1.13.15,主要解决最近报告的安全问题。为什么Go 每次更新都是发布两个版本?这是 Go 的惯例,会同时维护两个版本的更新,比如现在是 Go1.14 和 Go1.13,如果 Go1.15 发布了,之后就会变成 Go1.15 和 Go1.14。

(推荐教程:Go Web 编程)

因为涉及到安全问题,建议所有用户都进行相应版本更新(如果不确定哪个版本,请选择 Go 1.14.7)。

涉及到的具体问题如下:

  • encoding/binary:ReadUvarint 和 ReadVarint 可以从无效输入中读取无限数量的字节。对 ReadUvarint 或 ReadVarint 的某些无效输入可能导致这些函数在返回错误之前从 ByteReader 参数读取无限数量的字节。当调用者直接从网络读取数据时,这可能导致处理的输入超出预期,并且依赖于 ReadUvarint 和 ReadVarint 甚至仅从无效输入中仅消耗少量的有限字节数。在更新后,ReadUvarint 和 ReadVarint 现在总是在消耗了一定数量的字节(特别是 MaxVarintLen64,即 10)之后返回。返回的结果没有改变;这些函数仅检测并返回一些错误,而无需读取过多的输入。具体 issue 见:https://github.com/golang/go/issues/40618。

(推荐微课:Go 基础微课)

在刚刚发布的 Go1.15 RC2 版本中,也修复了该问题。关于 Go1.15 的更多信息可以参见文档:https://tip.golang.org/doc/go1.15, 已经8月份了,Go1.15 正式发布应该不远了。

八大理由告诉你,为什么学python

thbcm阅读(419)

学习python的人有很多,你们是否询问过自己:“我为什么要学习python语言呢”,编程语言那么多,你选择了python,这是为什么呢?

Python是世界上公认的编程语言中需求最大和最流行的编程语言之一。在最新的StackOverflow调查中,Python已经超过了C语言、C++和Java,登上榜首。这就是为什么许多程序员和新手开发人员更愿意学习Python,并且认为Python语言是最受欢迎的编程语言之一。

为什么应该学习Python?

当你从基础知识开始学习,一切碎片化的知识都能变得充实。因此,在了解学习Python的原因之前,我们先来介绍一下Python,以便了解它作为编程语言的强大功能。

(推荐教程:python教程)

1991年,吉多·范罗苏姆推出了Python。在开发这门语言时,他脑海中有一些想法,而且他成功地开发了一种编程语言,可以用于:

  • Web开发
  • 软件开发
  • 系统脚本
  • 数学问题

Python的特点

  • Python能够在不同的平台上无缝工作,比如Mac、Windows、Linux、Raspberry Pi等等。
  • 因为Python是在解释器系统上执行的,所以它可以实现快速的原型制作。也就是说,你可以在编写代码的瞬间运行它。
  • Python的语法就像英语一样,简单且易于理解(与其他语言相比)。这也使得开发人员工作更快,因为这种语言可以用更少的代码行进行编写。
  • 无论函数式还是程式,Python都可以满足程序员的需求。

Python的应用领域有哪些?

  • 快速的原型制作
  • 用于生产就绪的软件开发
  • 在软件中开发工作流程
  • 快速的原型制作
  • 用于生产就绪的软件开发
  • 在软件中开发工作流程
  • 当你想读取或更改/改进文件时,可以将Python连接到数据库系统
  • 它可以用于执行复杂的数学运算和管理大数据
  • 在服务器上用于建立网站应用程序

Python是一门通用语言,可以在许多项目、应用领域和函数中使用它。Python的主要应用领域有:

  • Web开发
  • 系统自动化及管理
  • 电脑绘图
  • 基本游戏开发
  • 安全和渗透测试
  • 数据科学
  • 金融和贸易
  • 科学与数学计算
  • 通用和特定于应用程序的脚本
  • 测绘及地理(GIS软件)

学习Python的8大数据驱动原因

学习Python有很多原因,让我用可靠的数据给你答案。

(推荐微课:python3基础微课)

1.Python对初学者很友好

众所周知,Python是一门对初学者友好的语言,它的语法清晰易读,Python几乎没有不必要的标准化文档,这使得初学者和专家都可以专注于手头的工作,而不是代码。

此外,Python的可读性和效率使其成为顶尖大学里最常教授的入门语言。这也对未来的就业市场产生了一些影响, Python可能成为更受欢迎的技术选择。

2.Python待遇好

在某些国家和地区,特别是在美国,Python工程师的薪水是行业中最高的。根据美国技能和薪资分析平台Gooroo的数据,Python是美国第二高薪的编程语言(超过C++、Java和JavaScript),年薪接近103500美元。

拥有Python技能的软件开发人员的平均工资大约是76746美元,初级开发人员更高,而高级开发人员则非常高;拥有Python技能的Web开发人员的收入约为59108美元,高级开发人员的收入为77000美元;拥有Python技能的数据科学家可以挣到97663美元,而经验丰富的专家可以挣到140000美元。

3.Python开发人员的需求量很大

根据Indeed.com上最新的工作趋势,对Python开发人员的需求正在增长。因此,拥有Python证书有助于求职者在很短的时间内找到一份工作。对具有Python技能的开发人员的需求显然超过了求职者的数量,Python开发人员的就业市场前景非常好。

4.数据科学的高度优先性

真正推动Python普及的,是它在数据科学和数据工程应用中的高度优先性。使用Python时,可以运用Pandas、NumPy、SciPy等最广泛使用的库,结合快速原型制作的能力以及其他工具,使数据工程师可以保持高效。

作为一门语言,Python在2020年得到了高度的普及。2020年2月的调查显示,Python语言排在第3位。之前它排在前50名之后,因此被誉为快速崛起的编程语言。根据PYPL(流行编程语言)索引,与其他编程语言相比,基于搜索引擎的搜索结果,Python被列为最流行的语言。

5.Python能够节约时间

我相信只要使用过一次Python的大多数开发人员都会同意这一观点,即用这种语言编写任何代码会比其他大多数技术节省大量时间。以下为Python和Java的一个对比,其结果相同,但请看编码:

用Java演示的经典“Hello, world”程序,如下:

public classHelloWorld {
   public static void main(String[] args) {
      System.out.println("Hello,world");
   }
}

而要得到相同的结果,在Python中你所要做的就是:

print("Hello,world")

这足以证明Python的省时。

6.Python有大量的资源

Python拥有大量的资源来帮助它进行更新,包括一个内置的单元测试框架、一个大容量的内置功能标准库,以及足够的框架和环境,这使得开发人员能够专注于编写网站或应用程序。Django是最常用的Python web框架,还有Pyramid、web2py、Flask和Zope 2等。

7.Python是可移植的和可扩展的

Python被称为可移植语言,因为拥有用于Windows的Python代码的用户可以在任何平台(如Mac、Linux或Unix)上执行和运行,无需修改代码。Python的可扩展特性允许用户将Python代码编写成C或C++之类的语言。

8.大公司使用Python

你曾经梦想过在谷歌或脸书这样的科技巨头工作吗?Python可能就是你的敲门砖。因为这些公司,以及Dropbox、YouTube、Instagram、Quora、Mozilla、IBM、雅虎和许多其他公司都在使用Python来完成各种任务,并一直在雇用Python开发人员。

作为一种编程语言,Python将继续扩展到新的计算领域,它将成为物联网的主要编程语言。当前的市场趋势证明,Python开发人员在未来几年将有巨大的潜力。

无论您是一名有经验的程序员还是一名新手,学习python编程语言的最佳技巧都是找出自己的学习风格并深入编码的不二法门。这需要一定的时间,但稳扎稳打就能逐步实现。

以上就是关于为什么选择学习python的八大理由了,希望对大家有所帮助。

增加两行代码,却整整花了两天时间

thbcm阅读(380)

明明只是增加了两行代码,为什么却花了整整两天的时间?

这个问题看似合理,但其背后隐藏着一些可怕的假设:

  • 代码行数=工作量
  • 代码行数=价值
  • 所有代码行都一样

但这些统统不属实。

有人花了整整两天的时间改好了代码,但为什么我们回头去看的时候会觉得这些改动如此简单?

(推荐教程:python教程)

因为问题报告对如何再现的描述非常模糊。

我花了好几个小时才成功地重现了问题。有些开发人员会立即去找报告问题的人,在获得更多信息之后再展开调查。而我会尽力使用已提供的信息。我知道有些开发人员不喜欢改bug,因此他们会想法设法逃避这种工作。声称信息量不足是及时甩锅的一个好办法,看起来你像是在努力帮忙,但又无需做任何工作。我知道报告错误非常困难,我非常感谢那些报告错误的人。我会尽可能利用已有信息,实在没办法再去请求报告错误的人提供更多信息,目的是为了表达对他们的感谢。

因为报告的问题与某个功能有关,但我不熟悉这个功能。

我很少使用与这个问题相关的功能,而且我并没有接触过与该功能相关的具体细节。因此,我花费了很长时间来理解如何使用这个功能,以及这个bug与软件交互的具体过程。

因为我花了很长时间调查引发问题的真正原因,而不仅仅是流于表面。

如果某些代码抛出了错误,则你只需把它包装在try..catch语句中即可抑制错误。没有错误,就没有问题。对吗?不好意思,在我看来,把问题藏起来并不等同于解决问题。掩盖错误很容易引发其他意料之外的副作用。我不想留到将来,再与它们打交道。

因为我调查了除了问题报告的步骤之外,是否还有其他方法可以再现这个问题。

通过一组再现步骤可以很容易地让错误浮现,但实际上它可能涉及更深层的问题。找到问题的确切原因,并研究解决问题的所有方法,才能提供有价值的见解。比如代码的实际使用方式,可能其他地方存在有待解决的问题,或者存在代码不一致,导致某个代码路径中引发了错误,而其他路径则不会。

因为我花时间验证了代码的其他部分是否会受到类似问题的影响。

如果某个错误引发了这个bug,那么代码库的其他地方可能也存在相同的错误。我可以借这个机会仔细检查一下。

(推荐课程:JavaScript教程)

因为如果我找出了问题的根源,那么就可以寻求最简单的解决方法,同时引入副作用的风险也很小。

我不希望用最快捷的方法修复问题。我希望修复这个问题之后将来不会引起混乱或引发其他问题。

因为我对此次代码变更进行了彻底的测试,并验证了它能够解决所有受影响代码路径下的问题。

我不想依靠他人来测试我做的更改是否正确。我不希望以后等到我完全忘记此次更改之后再发现某个bug,迫使我不得不再次回头看这些代码。来回切换思维费时费力,又令人沮丧。我不希望让专职的测试人员再来检验同一个更改。

我不喜欢改bug的工作,部分原因是因为这种工作让人感觉是我之前的失误造成的。而我不喜欢改bug的另一个原因是,我更喜欢从事新的工作。

问:有什么是比改bug更糟糕的工作呢? 答:反复修复同一个bug。

我愿意花时间确保每次遇到的bug都会被完全修复,这样我就无需再面对这个bug,也无需再花时间调查、修复并测试这个bug。

以上就是关于为什么有时候明明只增加了一点点代码,却花费了好几天时间的相关介绍了,希望对大家有所帮助。

原文:www.mrlacey.com/2020/07/youve-only-added-two-lines-why-did-that.html

参考来源:blog.csdn.net/csdnnews/article/details/107903206

Vue 中插槽是怎么发出数据的

thbcm阅读(403)

在工作中BUG的出现是在所难免的,但是在写代码的时候没法实时发现BUG,等事后再去解决BUG,还得花很多时间去进行log调试,这里给大家推荐一个不错的BUG监控工具:Fundebug。

我们知道使用作用域插槽可以将数据传递到插槽中,但是如何从插槽传回来呢?

(推荐教程:Vue 1教程)

将一个方法传递到我们的插槽中,然后在插槽中调用该方法。无法发出事件,因为插槽与父组件共享相同的上下文(或作用域)。

// Parent.vue <template> <Child> <template #default=”{ clicked }”> <button @click=”clicked”> Click this button </button> </template> </Child> </template>

// Child.vue <template> <div> <!– 将“handleClick” 作为 “clicked” 传递到我们的 slot –> <slot :clicked=”handleClick” /> </div> </template>

在本文中,我们将介绍其工作原理,以及:

  • 从插槽到父级的 emit
  • 当一个槽与父组件共享作用域时意味着什么
  • 从插槽到祖父组件的 emit
  • 更深入地了解如何使用方法从插槽通讯回来

从插槽到父级的 emit

现在看一下Parent组件的内容:

// Parent.vue <template> <Child> <button @click=””> Click this button </button> </Child> </template>

我们在 Child 组件的插槽内有一个button 。单击该按钮时,我们要在Parent 组件内部调用一个方法。

如果button 不在插槽中,而是直接在Parent组件的子组件中,则我们可以访问该组件上的方法:

// Parent.vue <template> <button @click=”handleClick”> Click this button </button> </template>

当该 button 组件位于插槽内时,也是如此:

/ Parent.vue <template> <Child> <button @click=”handleClick”> Click this button </button> </Child> </template>

之所以可行,是因为该插槽与 Parent 组件共享相同的作用域。

(推荐教程:Vue 2教程)

插槽和模板作用域

模板作用域:模板内部的所有内容都可以访问组件上定义的所有内容。

这包括所有元素,所有插槽和所有作用域插槽。

因此,无论该按钮在模板中位于何处,都可以访问handleClick方法。

乍一看,这可能有点奇怪,这也是为什么插槽很难理解的原因之一。插槽最终渲染为Child 组件的子组件,但它不与Child 组件共享作用域。相反,它充当Parent 组件的子组件。

插槽向祖父组件发送数据

如果要从插槽把数据发送到祖父组件,常规的方式是使用的$emit方法:

// Parent.vue <template> <Child> <button @click=”$emit(‘click’)”> Click this button </button> </Child> </template>

因为该插槽与Parent 组件共享相同的模板作用域,所以在此处调用$emit将从Parent组件发出事件。

从插槽发回子组件

与Child 组件通讯又如何呢?

我们知道如何将数据从子节点传递到槽中

// Child.vue <template> <div> <slot :data=”data” /> </div> </template>

以及如何在作用域内的插槽中使用它:

// Parent.vue <template> <Child> <template #default=”{ data }”> {{ data }} </template> </Child> </template>

除了传递数据,我们还可以将方法传递到作用域插槽中。如果我们以正确的方式连接这些方法,则可以使用它来与Child组件通信:

// Parent.vue <template> <Child> <template #default=”{ clicked }”> <button @click=”clicked”> Click this button </button> </template> </Child> </template>

// Child.vue
<template>
  <div>
    <!-- Pass `handleClick` as `clicked` into our slot -->
    <slot :clicked="handleClick" />
  </div>
</template>

每当单击按钮时,就会调用Child组件中的handleClick方法。

(推荐微课:Vue 2.x 微课)

以上就是关于在Vue中插槽是怎么发送数据的详细内容了,希望对大家有所帮助。

原文:stackoverflow.com/questions/50942544/emit-event-from-content-in-slot-to-parent/50943093

Visual Studio开发利器,CodeRush新版本发布v20.1.6——支持Blazor

thbcm阅读(441)

CodeRush能帮助你以极高的效率创建和维护源代码。Consume-first 申明,强大的模板,智能的选择工具,智能代码分析和创新的导航以及一个无与伦比的重构集,在它们的帮助下能够大大的提高你效率。

具体更新内容如下:

Visual Studio 2019的CodeRush菜单位置自定义中的更改

Visual Studio 2019 16.4及更高版本现在允许您指定应放置CodeRush菜单的位置,因此已删除了较旧的CodeRush选项(位于Quick Setup选项页面上),这也使您在启动时性能得到提升(在典型的开发机器上节省了大约1600ms )。

(推荐课程:Visual Studio Code 使用教程)

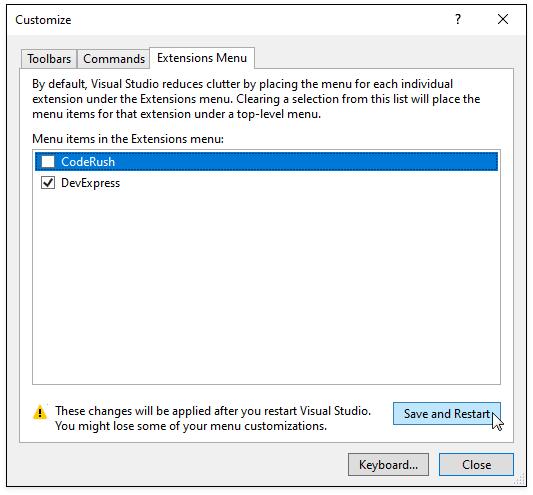
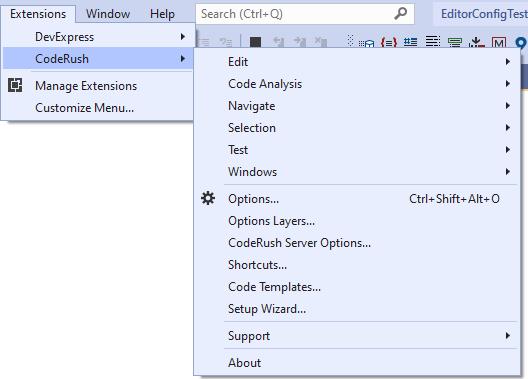
默认情况下,CodeRush菜单位于Visual Studio Extensions菜单中。

如果您想将CodeRush菜单重新定位到Visual Studio菜单栏的顶层(建议使用CodeRush获得更高效率编码体验的大多数开发人员),请按照以下步骤操作:

  • 打开Visual Studio 2019
  • 选择Extensions -> Customize Menu…
  • 在Extensions Menu标签中取消选中CodeRush entry
  • 重新启动Visual Studio

支持Blazor

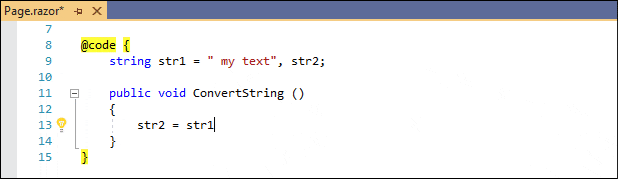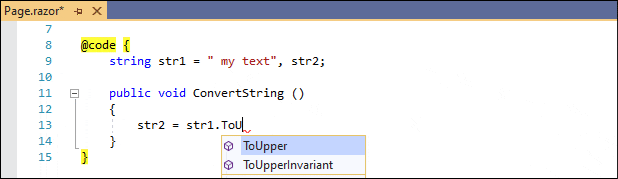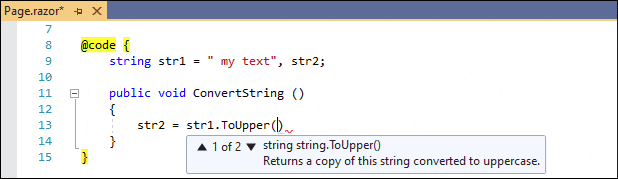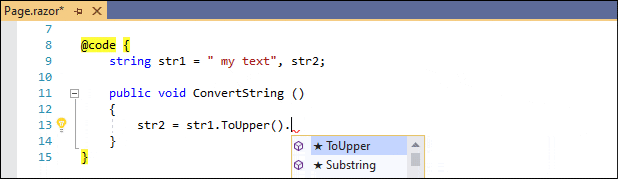
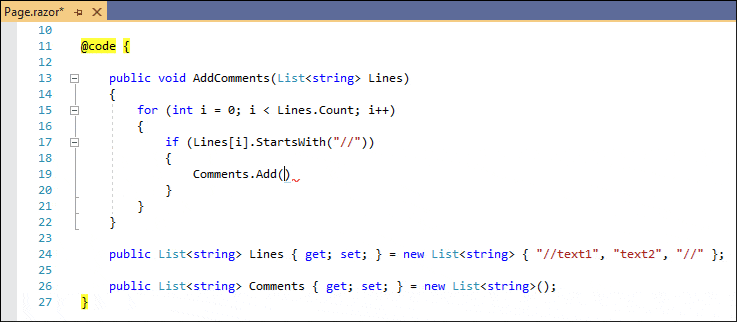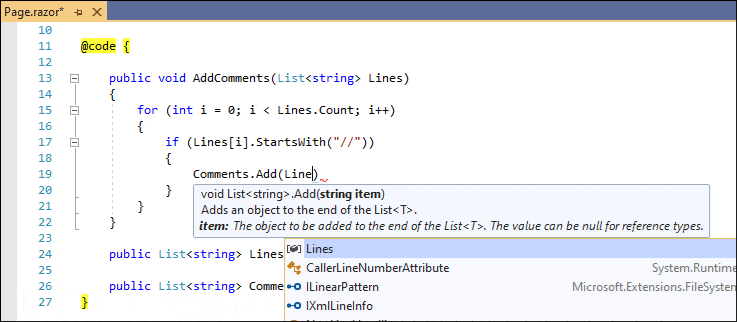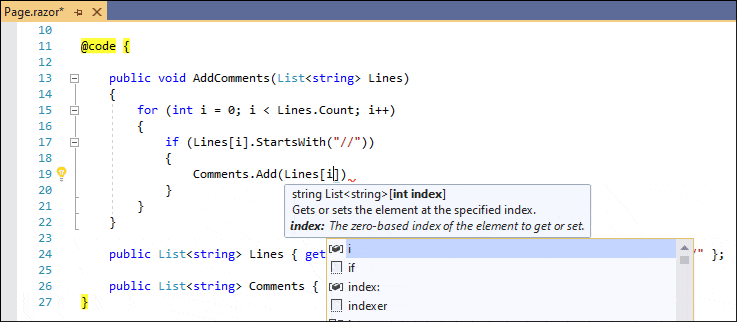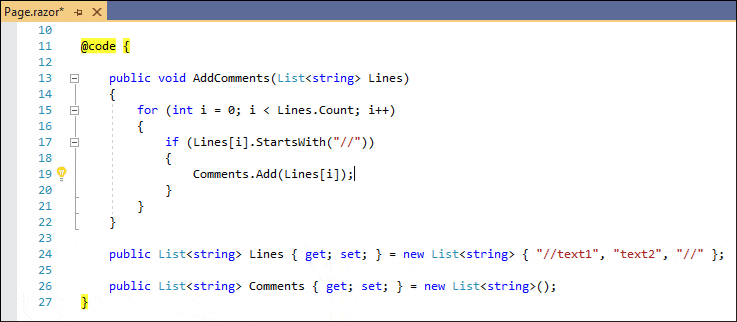
.razor文件中@code部分中现已提供以下CodeRush功能:

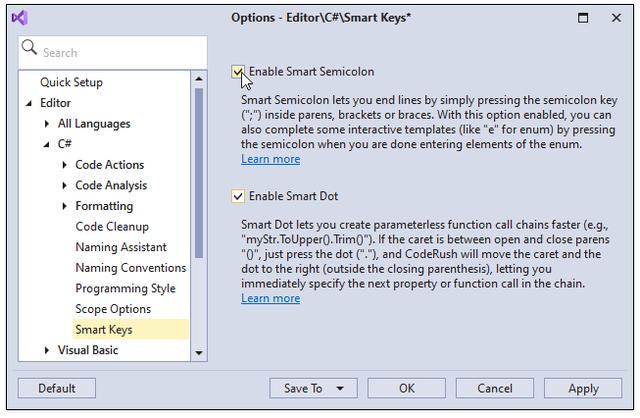
Smart Dot

Smart Semicolon

默认情况下,’Smart Dot‘和’Smart Semicolon‘被禁用,您可以在Editor | C# | Smart Keys选项页面启用这些功能。

重构

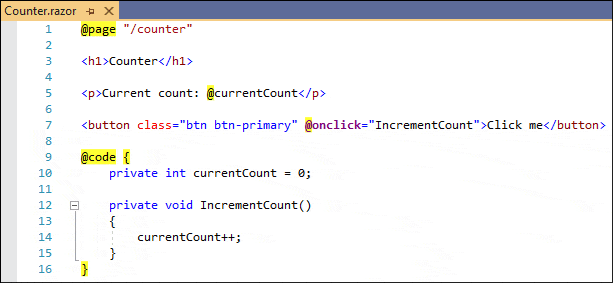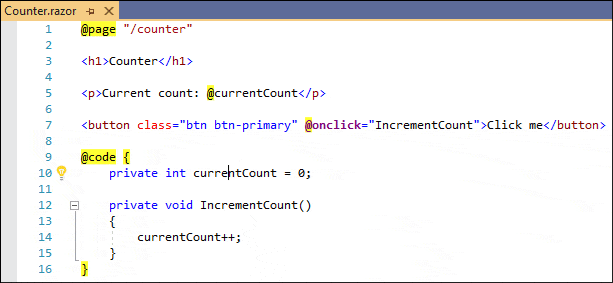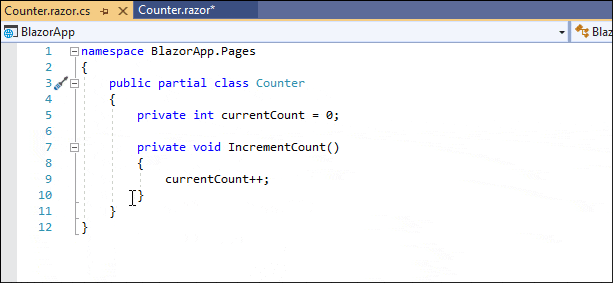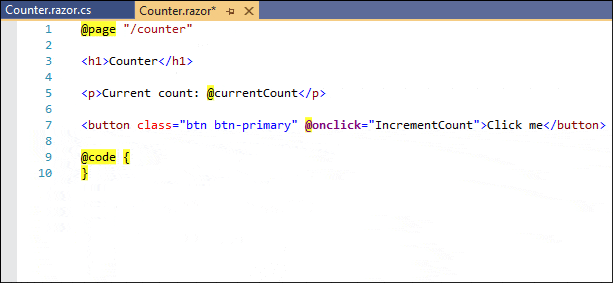
此版本新增 ‘Move to Code Behind‘重构,此重构将位于razor page @code部分中的代码移动到代码隐藏文件(.razor.cs)中。 如果没有代码隐藏文件,则此重构将创建一个。 此重构还带来了对代码隐藏文件的领先注释、属性和任何必要的引用。

要使用此重构,只需将插入号放在@code节中的代码中,然后按Ctrl+.或Ctrl+~调用Code Actions菜单,选择”Move to Code Behind“,然后按Enter。

增强代码样式

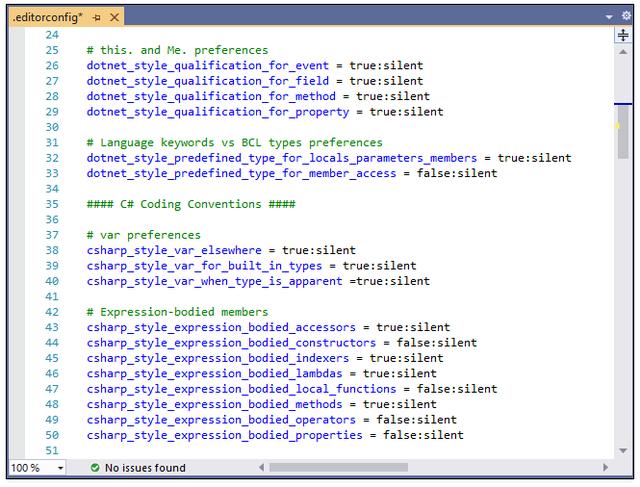
现在,您可以使用下面的Visual Studio选项和位于EditorConfig文件中的相应设置在CodeRush中配置代码样式:

  • ‘this.’ and ‘Me.’ preferences;
  • predefined type preferences;
  • ‘var’ preferences;
  • use expression body.

您还可以运行code cleanup来将这些设置应用于代码。

以上就是关于CodeRush新版本v20.1.6的详细内容了,希望对大家有所帮助。

信息安全学习:常用的攻击手段–SQL注入

thbcm阅读(453)

一、概述

1. 攻击原理

SQL注入是较常见的网络攻击方式之一,主要针对WEB应用,利用程序员编写代码的疏忽,对于连接数据库的应用,通过重组SQL语句,使服务器执行恶意SQL代码,从而获取到非授权的权限和资料。京东 16年12月10日 泄露12G用户账号信息。SQL注入在OWASP2013、2017中排名都是在首位。

(推荐课程:SQL教程)

2. 如何判断有没有SQL注入漏洞

(1) 单引号判断

针对get请求带整数参数的,请求参数:?id=1',如果页面报SQL运行错误,则可能存在SQL注入。

(2) 数字型判断

有缺陷的代码语句:

select * from table where id=3

如果提交参数?id= x and 1=1构造成如下SQL:

select * from table where id=1 and 1=2

如果页面报SQL运行错误,则可能存在SQL注入。

(3) 字符型判断

有缺陷的代码语句:

select * from table where id=’x’

如果提交参数?id=x' and '1'='1构造如下SQL:

select * from table where id= ‘x’ and ‘1’=’1′

如果页面报SQL运行错误,则可能存在 SQL注入。

2. 应对方案

  • 不信任用户的输入
  • 输入字符串过滤
  • 字符转义
  • 避免用拼接字符串、组合成SQL语句的方式来执行SQL
  • 不要使用管理员权限连接数据库,数据库访问权限设置最小化
  • 机密信息加密或进行哈希处理
  • 程序异常时对错误进行捕获,避免原生错误返回给用户

(推荐微课:SQL微课)

二、觉见的SQL注入扫描工具

1. SQLIer

(1) 开源地址

github.com/BCable/sqlier

(2) 获取信息

./sqlier.sh -s 10 网址

(3) 参数

  • -c [host] 清除站点信息.
  • -o [file] 输出破解的密码.
  • -s [seconds] 每个请求间隔时间.
  • -u [usernames] 暴力破解猜测用户名,用逗号隔开.
  • -w [options] wget参数.

(4) 猜测表名字段

  • --table-names [table_names] 猜测表名,用逗号隔开。
  • --user-fields [user_fields] 猜测用户名字段,逗号隔开。
  • --pass-fields [pass_fields] 猜测密码字段,逗号隔开。

2. SQLmap

一款用来检测与利用SQL注入漏洞的工具。

安装:

pip install sqlmap

SQL注入点

可以提交SQL语句地方就是SQL注入点。想进入SQL注入,先找到SQL注入点。

python sqlmap.py -u “http://test/test.aspx?id=123“

3. jSky

国内深圳宇造诺赛公司出品的一款WEB漏洞扫描工具,收费软件。

4. Pangolin(穿山甲)

也是宇造诺赛的产品,专门进行SQL注入扫描。

5. iiscan 亿思

在线免费的网站漏洞检测平台,可以检测SQL注入漏洞、跨站漏洞等。

6. MDCSOFT WEB应用防火墙

集WEB防护、网页保护、负载均衡、应用交付一体的WEB整体安全防护设备。

7. 其它工具

啊d注入工具 阿里云在线漏洞扫描

以上就是关于常用的攻击手段–SQL注入的相关介绍了,希望对大家有所帮助。

代码优化技巧 : 逻辑判断

thbcm阅读(405)

想成为一名合格的程序员,那么代码优化是相当重要的一部分,一份高质量的代码,可以让人一目了然,既方便自己,也方便他人。

if else、switch case 是日常开发中最常见的条件判断语句,这种看似简单的语句,当遇到复杂的业务场景时,如果处理不善,就会出现大量的逻辑嵌套,可读性差并且难以扩展。

编写高质量可维护的代码,我们先从最小处入手,一起来看看在前端开发过程中,可以从哪些方面来优化逻辑判断?

下面我们会分别从 JavaScript 语法和 React JSX 语法两个方面来分享一些优化的技巧。

JavaScript 语法篇

嵌套层级优化

function supply(fruit, quantity) {
    const redFruits = ['apple', 'strawberry', 'cherry', 'cranberries'];
    // 条件 1: 水果存在
    if(fruit) {
        // 条件 2: 属于红色水果
        if(redFruits.includes(fruit)) {
            console.log('红色水果');
            // 条件 3: 水果数量大于 10 个
            if (quantity > 10) {
                console.log('数量大于 10 个');
            }
        }
    } else {
        throw new Error('没有水果啦!');
    }
}

分析上面的条件判断,存在三层 if 条件嵌套。

如果提前 return 掉无效条件,将 if else的多重嵌套层次减少到一层,更容易理解和维护。

function supply(fruit, quantity) {
    const redFruits = ['apple', 'strawberry', 'cherry', 'cranberries'];
    if(!fruit) throw new Error('没有水果啦'); // 条件 1: 当 fruit 无效时,提前处理错误
    if(!redFruits.includes(fruit)) return; // 条件 2: 当不是红色水果时,提前 return

    
    console.log('红色水果');

    
    // 条件 3: 水果数量大于 10 个
    if (quantity > 10) {
        console.log('数量大于 10 个');
    }
}

多条件分支的优化处理

当需要枚举值处理不同的业务分支逻辑时, 第一反应是写下 if else ?我们来看一下:

function pick(color) {
  // 根据颜色选择水果
  if(color === 'red') {
      return ['apple', 'strawberry']; 
  } else if (color === 'yellow') {
      return ['banana', 'pineapple'];
  } else if (color === 'purple') {
      return ['grape', 'plum'];
  } else {
      return [];
  }
}

在上面的实现中:

  • if else 分支太多
  • if else 更适合于条件区间判断,而 switch case 更适合于具体枚举值的分支判断

使用 switch case 优化上面的代码后:

function pick(color) {
  // 根据颜色选择水果
  switch (color) {
    case 'red':
      return ['apple', 'strawberry'];
    case 'yellow':
      return ['banana', 'pineapple'];
    case 'purple':
      return ['grape', 'plum'];
    default:
      return [];
  }
}

switch case 优化之后的代码看上去格式整齐,思路很清晰,但还是很冗长。继续优化:

  • 借助 Object 的 { key: value } 结构,我们可以在 Object 中枚举所有的情况,然后将 key 作为索引,直接通过 Object.key 或者 Object[key] 来获取内容
const fruitColor = {                                                                        
    red: ['apple', 'strawberry'],
    yellow: ['banana', 'pineapple'],
    purple: ['grape', 'plum'],
}
function pick(color) {
    return fruitColor[color] || [];
}

  • 使用 Map 数据结构,真正的 (key, value) 键值对结构 ;
const fruitColor = new Map()
.set('red', ['apple', 'strawberry'])
.set('yellow', ['banana', 'pineapple'])
.set('purple', ['grape', 'plum']);


function pick(color) {
  return fruitColor.get(color) || [];
}

优化之后,代码更简洁、更容易扩展。

为了更好的可读性,还可以通过更加语义化的方式定义对象,然后使用 Array.filter 达到同样的效果。

const fruits = [
    { name: 'apple', color: 'red' }, 
    { name: 'strawberry', color: 'red' }, 
    { name: 'banana', color: 'yellow' }, 
    { name: 'pineapple', color: 'yellow' }, 
    { name: 'grape', color: 'purple' }, 
    { name: 'plum', color: 'purple' }
];


function pick(color) {
  return fruits.filter(f => f.color == color);
}

(推荐教程:JavaScript教程)

使用数组新特性简化逻辑判断

巧妙的利用 ES6 中提供的数组新特性,也可以让我们更轻松的处理逻辑判断。

多条件判断

编码时遇到多个判断条件时,本能的写下下面的代码(其实也是最能表达业务逻辑的面向过程编码)。

function judge(fruit) {
  if (fruit === 'apple' || fruit === 'strawberry' || fruit === 'cherry' || fruit === 'cranberries' ) {
    console.log('red');
  }
}

但是当 type 未来到 10 种甚至更多时, 我们只能继续添加 || 来维护代码么 ?

试试 Array.includes ~

// 将判断条件抽取成一个数组
const redFruits = ['apple', 'strawberry', 'cherry', 'cranberries'];
function judge(type) {
    if (redFruits.includes(fruit)) {
        console.log('red');
     }
}

判断数组中是否所有项都满足某条件

const fruits = [
    { name: 'apple', color: 'red' },
    { name: 'banana', color: 'yellow' },
    { name: 'grape', color: 'purple' }
  ];


function match() {
  let isAllRed = true;


  // 判断条件:所有的水果都必须是红色
  for (let f of fruits) {
    if (!isAllRed) break;
    isAllRed = (f.color === 'red');
  }


  console.log(isAllRed); // false
}

上面的实现中,主要是为了处理数组中的所有项都符合条件。

使用 Array.every 可以很容的实现这个逻辑:

const fruits = [
    { name: 'apple', color: 'red' },
    { name: 'banana', color: 'yellow' },
    { name: 'grape', color: 'purple' }
  ];


function match() {
  // 条件:所有水果都必须是红色
  const isAllRed = fruits.every(f => f.color == 'red');


  console.log(isAllRed); // false
}

判断数组中是否有某一项满足条件

Array.some ,它主要处理的场景是判断数组中是否有一项满足条件。

如果想知道是否有红色水果,可以直接使用 Array.some 方法:

const fruits = [
    { name: 'apple', color: 'red' },
    { name: 'banana', color: 'yellow' },
    { name: 'grape', color: 'purple' }
  ];


// 条件:是否有红色水果 
const isAnyRed = fruits.some(f => f.color == 'red');

还有许多其他数组新特性,比如 Array.find、Array.slice、Array.findIndex、Array.reduce、Array.splice 等,在实际场景中可以根据需要选择使用。

函数默认值

使用默认参数

const buyFruit = (fruit,amount) => {
     if(!fruit){
        return
  }
  amount = amount || 1;
  console.log(amount)
}

我们经常需要处理函数内部的一些参数默认值,上面的代码大家都不陌生,使用函数的默认参数,可以很好的帮助处理这种场景。

const buyFruit = (fruit,amount = 1) => {
     if(!fruit){
        return
  }
  console.log(amount,'amount')
}

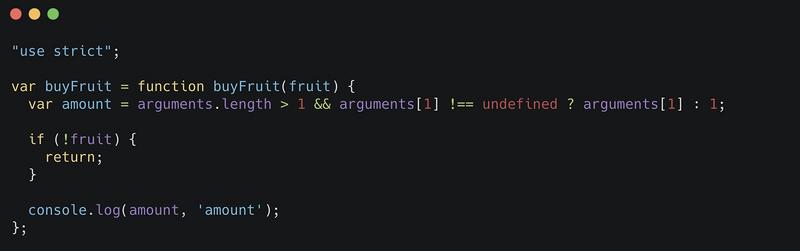
我们可以通过 Babel 的转译来看一下默认参数是如何实现的。

从上面的转译结果可以发现,只有参数为 undefined 时才会使用默认参数。

测试的执行结果如下:

buyFruit('apple','');  // amount
buyFruit('apple',null);  //null amount
buyFruit('apple');  //1 amount

所以使用默认参数的情况下,我们需要注意的是默认参数 amount=1 并不等同于 amount || 1。

使用解构与默认参数

当函数参数是对象时,我们可以使用解构结合默认参数来简化逻辑。

Before:

const buyFruit = (fruit,amount) => {
    fruit = fruit || {};
    if(!fruit.name || !fruit.price){
        return;
    }
    ...
  amount = amount || 1;
  console.log(amount)
}

After:

const buyFruit = ({ name,price }={},amount) => {
  if(!name || !prices){
      return;
  }
  console.log(amount)
}

复杂数据解构

当处理比较简的对象时,解构与默认参数的配合是非常好的,但在一些复杂的场景中,我们面临的可能是更复杂的结构。

const oneComplexObj = {
    firstLevel:{
        secondLevel:[{
            name:"",
            price:""
        }]
    }
}

这个时候如果再通过解构去获取对象里的值。

const {
    firstLevel:{
        secondLevel:[{name,price]=[]
    }={}
} = oneComplexObj;        

可读性就会比较差,而且需要考虑多层解构的默认值以及数据异常情况。

这种情况下,如果项目中使用 lodash 库,可以使用其中的 lodash/get 方法。

import lodashGet from 'lodash/get';


const { name,price} = lodashGet(oneComplexObj,'firstLevel.secondLevel[0]',{});

策略模式优化分支逻辑处理

策略模式:定义一系列的算法,把它们一个个封装起来, 并且使它们可相互替换。

使用场景:策略模式属于对象行为模式,当遇到具有相同行为接口、行为内部不同逻辑实现的实例对象时,可以采用策略模式;或者是一组对象可以根据需要动态的选择几种行为中的某一种时,也可以采用策略模式;这里以第二种情况作为示例:

Before:

const TYPE = {
    JUICE:'juice',
    SALAD:'salad',
    JAM:'jam'
}
function enjoy({type = TYPE.JUICE,fruits}){
  if(!fruits || !fruits.length) {
        console.log('请先采购水果!');
           return;
    }
  if(type === TYPE.JUICE) {
    console.log('榨果汁中...');
      return '果汁';
  }
  if(type === TYPE.SALAD) {
      console.log('做沙拉中...');
      return '拉沙';
  }
  if(type === TYPE.JAM) {
    console.log('做果酱中...');
      return '果酱';
  }
  return;
}


enjoy({type:'juice',fruits});

使用思路:定义策略对象封装不同行为、提供策略选择接口,在不同的规则时调用相应的行为。

After:

const TYPE = {
    JUICE:'juice',
    SALAD:'salad',
    JAM:'jam'
}


const strategies = {
    [TYPE.JUICE]: function(fruits){
        console.log('榨果汁中...');
        return '果汁';
    },
    [TYPE.SALAD]:function(fruits){
        console.log('做沙拉中...');
        return '沙拉';
    },
    [TYPE.JAM]:function(fruits){
        console.log('做果酱中...');
        return '果酱';
    },
}


function enjoy({type = TYPE.JUICE,fruits}) {
    if(!type) {
        console.log('请直接享用!');
           return;
    }
    if(!fruits || !fruits.length) {
        console.log('请先采购水果!');
           return;
    }
    return strategies[type](fruits);
}


enjoy({type:'juice',fruits});

(推荐微课:JavaScript微课)

框架篇之 React JSX 逻辑判断优化

JSX 是一个看起来很像 XML 的 JavaScript 语法扩展。一般在 React 中使用 JSX 来描述界面信息,ReactDOM.render() 将 JSX 界面信息渲染到页面上。

在 JSX 中支持 JavaScript 表达式,日常很常见的循环输出子组件、三元表达式判断、再复杂一些直接抽象出一个函数。

在 JSX 中写这么多 JavaScript 表达式,整体代码看起来会有点儿杂乱。试着优化一下!

JSX-Control-Statements

JSX-Control-Statements 是一个 Babel 插件,它扩展了 JSX 的能力,支持以标签的形式处理条件判断、循环。

If 标签

<If> 标签内容只有在 condition 为 true 时才会渲染,等价于最简单的三元表达式。

Before:

{ condition() ? 'Hello World!' : null }

After:

<If condition={ condition() }>Hello World!</If>

注意:<Else /> 已被废弃,复杂的条件判断可以使用 <Choose> 标签。

Choose 标签

<Choose> 标签下包括至少一个 <When> 标签、可选的 <Otherwise> 标签。

<When> 标签内容只有在 condition 为 true 时才会渲染,相当于一个 if 条件判断分支。

<Otherwise> 标签则相当于最后的 else分支。

Before:

{ test1 ? <span>IfBlock1</span> : test2 ? <span>IfBlock2</span> : <span>ElseBlock</span> }

After:

<Choose>
  <When condition={ test1 }>
    <span>IfBlock1</span>
  </When>
  <When condition={ test2 }>
    <span>IfBlock2</span>
  </When>
  <Otherwise>
    <span>ElseBlock</span>
  </Otherwise>
</Choose>

For 标签

<For> 标签需要声明 of、each 属性。

of 接收的是可以使用迭代器访问的对象。

each 代表迭代器访问时的当前指向元素。

Before:

{
  (this.props.items || []).map(item => {
      return <span key={ item.id }>{ item.title }</span>
  })
}

After:

<For each="item" of={ this.props.items }>
   <span key={ item.id }>{ item.title }</span>
</For>

注意:<For> 标签不能作为根元素。

With 标签

<With> 标签提供变量传参的功能。

Before:

renderFoo = (foo) => {
    return <span>{ foo }</span>;
}


// JSX 中表达式调用
{
    this.renderFoo(47)
}

After:

<With foo={ 47 }>
  <span>{ foo }</span>
</With>

使用这几种标签优化代码,可以减少 JSX 中存在的显式 JavaScript 表达式,使我们的代码看上去更简洁,但是这些标签封装的能力,在编译时需要转换为等价的 JavaScript 表达式。

总结

以上就是一些常见的逻辑判断优化技巧总结。当然,编写高质量可维护的代码,除了逻辑判断优化,还需要有清晰的注释、含义明确的变量命名、合理的代码结构拆分、逻辑分层解耦、以及更高层次的贴合业务的逻辑抽象等等,相信各位在这方面也有自己的一些心得。

联系我们