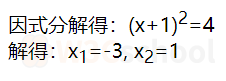编程语言初学者的好帮手,一款支持python,Java等7门语言的可视化编程工具

thbcm阅读(394)

对于初学编程的同学来说,有一个很大的难点,那就是无法理解每一段代码什么意思,能实现什么功能。能否理解执行每段代码的功能相当关键,这一点对于学习编程语言的同学来说,应该颇有感触。本文就给大家带来一款神器,可以让初学者轻松理解每一段代码实现的功能过程。

实现一个排序、回溯、递归算法,它执行的过程到底是什么样的?为什么有的测试用例总是过不去?

手动一步一步写出来显然是很繁琐的,要么就借助IDE,把每一步的执行结果以调试日志的形式输出到控制台,看一下每一步到底发生了什么。

曾经看过一则消息,VS Code正准备加入可视化调试过程这项功能,这让我颇为期待,但是目前还无法提供这项功能。

python Tutor

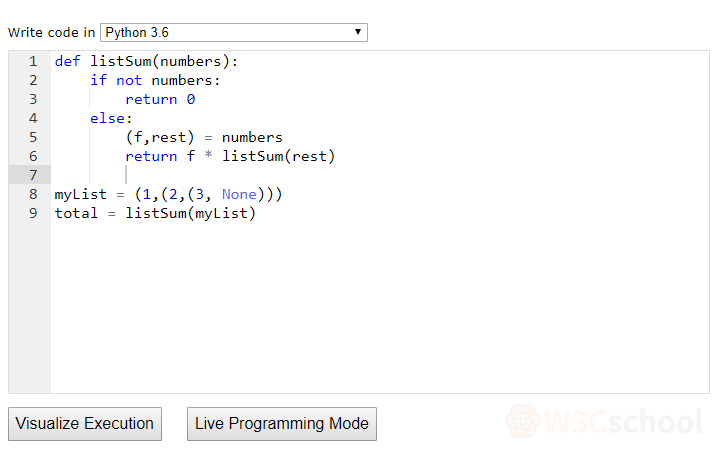
Python Tutor是一款在线的代码执行过程可视化工具。

def listSum(numbers):
    if not numbers:
        return 0
    else:
        (f,rest) = numbers
        return f * listSum(rest)


myList = (1,(2,(3, None)))
total = listSum(myList)

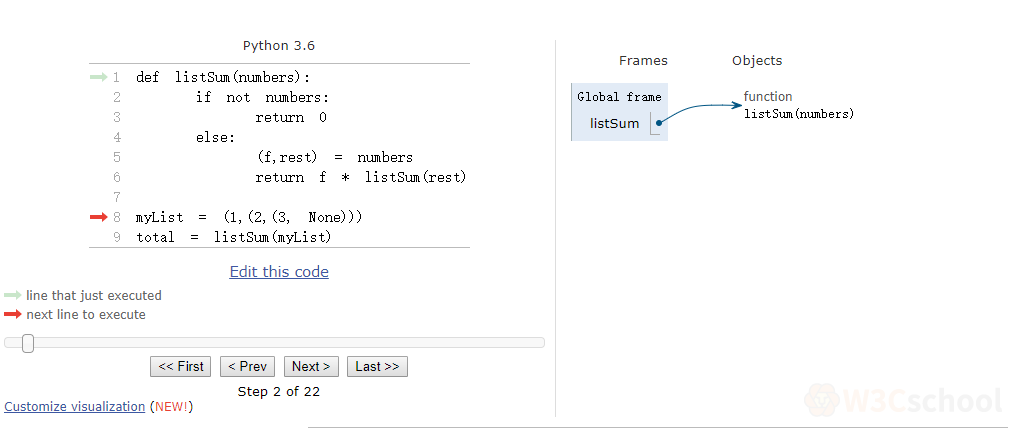
你可以把上面这段代码黏贴到 python Tutor 的编辑框点击Visualize Execution就可以动态的执行你的代码,并且实时展示每一步的执行过程。

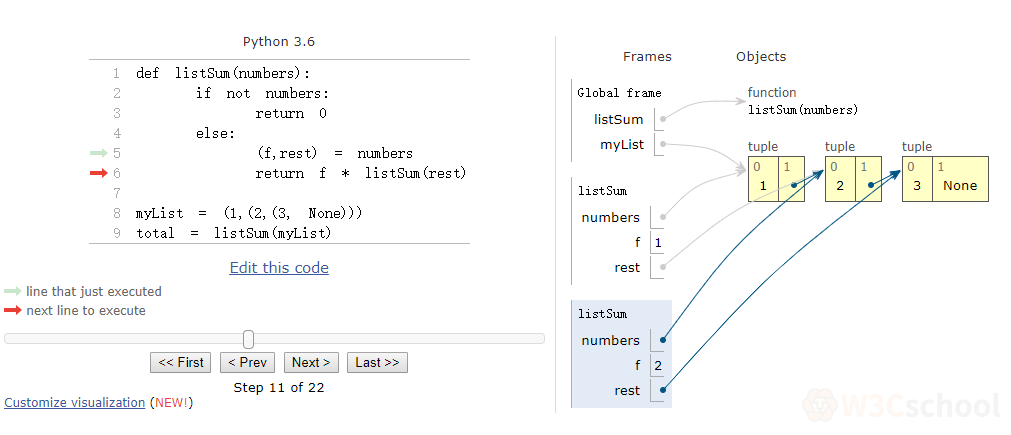
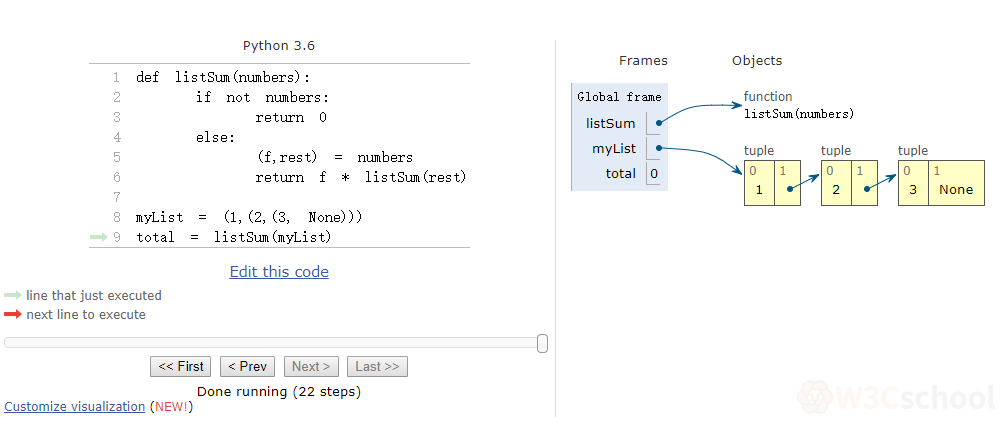
变化的效果如下图(实现过程图片过来,节选其中几张):

整个程序数变动的过程活生生呈现你眼前,够明了了吧。

python tutor 我多作为程序出现自已解释不了的错误,在网站上运行一次,执行过程对比,查找错误原因,又快又准。

然后,这款工具的名称为 Python Tutor,但是,它支持的语言却不止 Python 这一种。它目前支持如下编程语言:

  • Python
  • Java
  • C
  • C++
  • JavaScript
  • TypeScript
  • Ruby

其中,支持比较全面的就是 Python,对于 Python,它支持 Python 3.6、 Python 2.7、 Python with Anaconda。

Python是一门对第三方包依赖很强的一种编程语言,因此,在开发过程中会经常用到 numpy、 pandas 、pprint 等工具包。默认的 Python 3.6 和 Python 2.7 只有一些标准库,没有第三方包。

所以,如果你执行的代码片段中用到了第三方工具包,可以选择 Python with Anaconda ,这是因为 Anaconda 默认会安装常用的工具包。

但是,使用 Python with Anaconda 的速度会慢一些。

在我个人看来,这个工具比较适合编程初学者,例如面临校招的同学,这个工具对于熟悉编程帮助很大,可以加快你的学习效率,提升对编程语言的理解。

最后推荐一下上述7门编程语言的教程,感兴趣的同学可以看一下:

为什么Java是最受欢迎的编程语言,这里告诉你原因

thbcm阅读(359)

在编程语言中,Java 一直是最受程序员欢迎的一门语言,也是工作中使用最广泛的语言。同时他也是刚接触编程的同学最想学习的一门语言。那么为什么 Java 会有这么大的吸引力呢?

任何一个从事开发的人员,你在问他:想学习编程,学习哪种语言会比较好呢?他的回答肯定是“java语言”。那么为什么会产生这样的结果呢?总结大概有这么几方面的原因:

1、 Java有着25年的独立开发史

Java 是源自一个“Oak”语言,从1995年正式改名为Java,一直运行到今天,已经有25年的发展历史。

第一个java开发工具包(jdk1.0)正式发布,标志着java成为一种独立的开发工具,也是java发展历程中的重要里程碑。

从Java版本的更新中,可以看出Java语言一直不断地进行优化和升级,为开发人员提供更加优质的开发语言。目前,已经更新至Java12版本。

2、 Java语言易学还跨平台

Java语言一种面向对象的计算机编程语言,不仅吸收了C++语言的优点,还摒弃掉C++语言里的多继承、指针等难以理解的概念,因此,Java语言具有了功能强大和简单易用两大特点。同时java语言还有分布式、可移植性、多线程性、高性能等特点,更多的开发人员喜欢使用java。

Java源自Oak语言,就继承了Oak的跨平台性。也正是因为java有跨平台的特点,各大厂商纷纷购买了java使用许可证。

一种语言的诞生,会结合当前行业的发展需求和语言本身的特点,进行优化和升级,最终呈现在开发者面前。

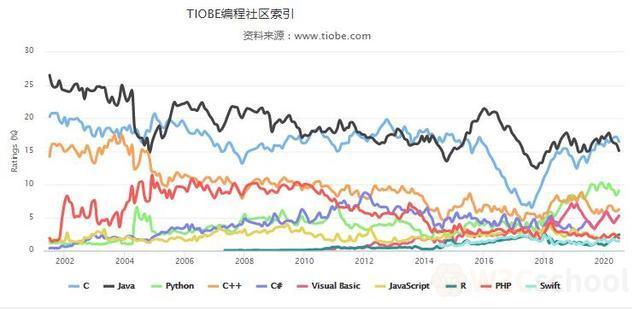
3、 83次荣获TIOBE排行榜第一

TIOBE编程社区每月都会发布编程语言的指数,判断市场上哪些因素影响语言的发展。

Java语言83次荣登TIOBE排行榜榜首,让每一个使用java的程序员都为之骄傲。

看看编程语言趋势走向:

4、90%的服务器使用java

目前,使用java语言的开发者全球已有数百万人,数十亿设备皆由java开发,并且能够通过java虚拟机在任何硬件和操作系统上运行,90%的“财富”500强公司都使用java作为后端开发的服务器端语言。

5、45.5%的开源项目使用java

目前,大型企业使用的都是java语言开发项目。正是因为java语言的安全性、可移植性、简单性、多线程性等特点,开发项目更加方便、快捷。同时移动端app开发,使用的是java语言。而Android是开源。

不管是开源项目还是闭合项目,Java都能带来更大的价值。

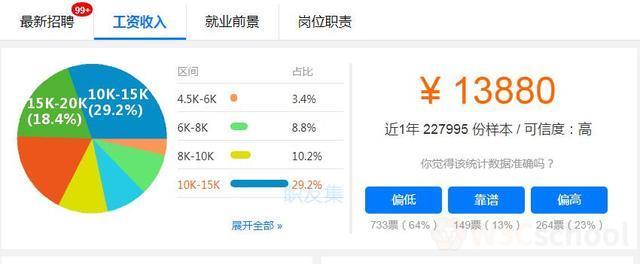
6、Java市场需求大,就业岗位多,岗位薪资水平高,平均收入在13880元

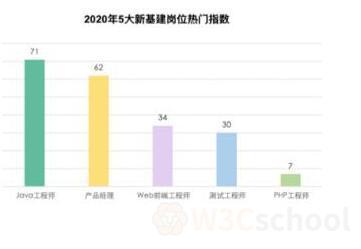
在今年智联招聘和拉勾网分别发了关于新基建人才的需求报告,其中新基站的岗位指数需求中,软件开发工程师的需求量最大。在软件开发岗位中,java开发工程师的需求量最大。

平均薪资在12939元,但从职友网上统计的数据来看,java的平均薪资在13880元。

Java 作为当今市场上使用者最多,应用最广泛的一门语言,它具有高薪资,高就业率,就业范围广的优点。但是想要达到高薪资,那么就该深入学习的提升自己能力 。有兴趣的同学可以看一下以下教程:

C,Java和Python三门编程语言性能比较

thbcm阅读(333)

在编程中有许多语言,而不同的编程语言有时候也能实现相同的功能,那么不同语言之间的运行速度有多少差别呢?这里选择C,Java和python三门热门语言来做比较。

实验

这里使用三种语言进行矩阵乘法。 矩阵的大小为2048 x 2048(即每个矩阵的乘法和加法运算为8,589,934,592),我为它们填充了0.0到1.0之间的随机值(使用随机值而不是对所有三种语言使用完全相同的矩阵的影响可以忽略不计)。每个实验运行了五次,并计算了平均运行时间。

1.C代码

#include <stdlib.h>
#include <stdio.h>
#include <time.h>


#define n 2048


double A[n][n];
double B[n][n];
double C[n][n];


int main() {


    //populate the matrices with random values between 0.0 and 1.0
    for (int i = 0; i < n; i++) {
        for (int j = 0; j < n; j++) {


            A[i][j] = (double) rand() / (double) RAND_MAX;
            B[i][j] = (double) rand() / (double) RAND_MAX;
            C[i][j] = 0;
        }
    }


    struct timespec start, end;
    double time_spent;


    //matrix multiplication
    clock_gettime(CLOCK_REALTIME, &start);
    for (int i = 0; i < n; i++) {
        for (int j = 0; j < n; j++) {
            for (int k = 0; k < n; k++) {
                C[i][j] += A[i][k] * B[k][j];
            }
        }
    }
    clock_gettime(CLOCK_REALTIME, &end);
    time_spent = (end.tv_sec - start.tv_sec) + (end.tv_nsec - start.tv_nsec) / 1000000000.0;
    printf("Elapsed time in seconds: %f \n", time_spent);
    return 0;
}

2.Java代码

import java.util.Random;


public class MatrixMultiplication {
    static int n = 2048;
    static double[][] A = new double[n][n];
    static double[][] B = new double[n][n];
    static double[][] C = new double[n][n];


    public static void main(String[] args) {
        //populate the matrices with random values between 0.0 and 1.0
        Random r = new Random();
        for (int i = 0; i < n; i++) {
            for (int j = 0; j < n; j++) {
                A[i][j] = r.nextDouble();
                B[i][j] = r.nextDouble();
                C[i][j] = 0;
            }
        }


        long start = System.nanoTime();
        //matrix multiplication
        for (int i = 0; i < n; i++) {
            for (int j = 0; j < n; j++) {
                for (int k = 0; k < n; k++) {
                    C[i][j] += A[i][k] * B[k][j];
                }
            }
        }


        long stop = System.nanoTime();
        double timeDiff = (stop - start) * 1e-9;
        System.out.println("Elapsed time in seconds: " + timeDiff);
    }
}

3.python代码

import random
import time


n = 2048


#populate the matrices with random values between 0.0 and 1.0
A = [[random.random() for row in range(n)] for col in range(n)]
B = [[random.random() for row in range(n)] for col in range(n)]
C = [[0 for row in range(n)] for col in range(n)]


start = time.time()
#matrix multiplication
for i in range(n):
    for j in range(n):
        for k in range(n):
            C[i][j] += A[i][k] * B[k][j]


end = time.time()
print("Elapsed time in seconds %0.6f" % (end-start))

如何编译与运行

#C
gcc MatrixMultiplication.c -o matrix
./matrix


#Java
javac MatrixMultiplication.java
java MatrixMultiplication


#Python
python MatrixMultiplication.py

运行时间

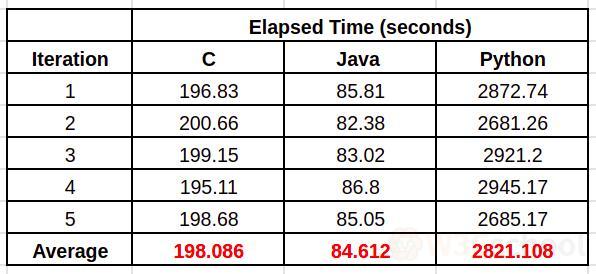
根据这些结果,C比Java慢2.34倍,Python比Java慢33.34倍。

等待!!! C不是应该最快的吗???

实际上,这是不公平的比较。 当我们编译Java程序时,即使没有任何优化标志,Java JIT(即时)编译器也会自动执行优化。 但是,对于GCC(编译C程序),情况并非如此,我们必须显式设置优化标志。

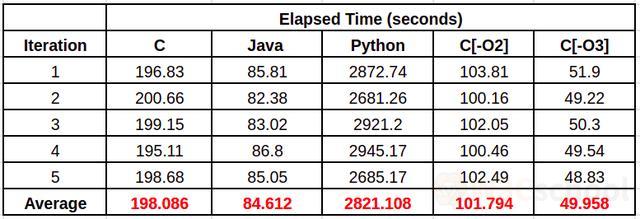
因此,在编译C程序时使用了-O2和-O3优化标志,并再次进行了实验。

gcc -O2 MatrixMultiplication.c -o matrix./matrixgcc -O3 MatrixMultiplication.c -o matrix./matrix

新的运行时间

现在,Java代码比C[-O3]慢1.69倍,而Python代码慢56倍。 我做出了正确的决定(或者很幸运:-)),选择了C而不是其他编程语言。

总结结果

讨论结果

  • Python相对非常慢,因为C是经过编译的,而Python是被解释的。 编译器一次将C代码转换为机器代码。 另一方面,解释器必须读取,解释和执行每一行代码,并更新机器状态(这会增加很多开销)。 将程序编译为机器代码时,CPU可以直接执行它。 但是,当涉及到解释器时,CPU将运行解释器,并且解释器本身将执行程序。 (如果您对编译器和解释器感兴趣,请阅读Vaidehi Joshi撰写的精彩文章)
  • 这就是使Python非常灵活的原因。 Python牺牲了一点性能来提供更多的灵活性/高级编程功能(如果不使用C语言指定数据类型,则不能将变量初始化为n = 100,但是可以在Python中进行初始化)。
  • JIT(Java编译器)位于C和Python之间。 首次执行代码时,将对其进行解释。 但是,当一段代码频繁执行时,它会实时编译为机器代码,并且进一步的执行将使用编译后的版本。

以上就是关于三门编程语言的比较结论,对C,Java和python感兴趣的同学可以学习一下相关教程

C教程:https://www.w3cschool.cn/c/

Java教程:https://www.w3cschool.cn/java/

Java微课:https://www.w3cschool.cn/minicourse/play/javaminicourse

python教程:https://www.w3cschool.cn/python3/

python微课:https://www.w3cschool.cn/minicourse/play/python3course

文章参考来源:www.toutiao.com/a6853865072431727111/

放假期间发现一个好东西,突然感觉不喜欢再写for循环

thbcm阅读(1009)

用过好多种遍历方法,发现其中还是for执行速度最快。因为它很简单,没有额外的函数调用栈和上下文。但是在实际开发中,我们也不能只考虑速度,而是要结合语义话,可读性和程序性能,去选择究竟使用哪种方案。下面来看for , foreach , map ,for...in , for...of五种方法现场battle。

自我介绍

for

我是最早出现的一方遍历语句,在座的各位需称我一声爷爷。我能满足开发人员的绝大多数的需求。

// 遍历数组
let arr = [1,2,3];
for(let i = 0;i < arr.length;i++){
    console.log(i) // 索引,数组下标
    console.log(arr[i]) // 数组下标所对应的元素
}


// 遍历对象
let profile = {name:"April",nickname:"二十七刻",country:"China"};
for(let i = 0, keys=Object.keys(profile); i < keys.length;i++){
    console.log(keys[i]) // 对象的键值
    console.log(profile[keys[i]]) // 对象的键对应的值
}


// 遍历字符串
let str = "abcdef";
for(let i = 0;i < str.length ;i++){
    console.log(i) // 索引 字符串的下标
    console.log(str[i]) // 字符串下标所对应的元素
}


// 遍历DOM 节点
let articleParagraphs = document.querySelectorAll('.article > p');
for(let i = 0;i<articleParagraphs.length;i++){
    articleParagraphs[i].classList.add("paragraph");
    // 给class名为“article”节点下的 p 标签添加一个名为“paragraph” class属性。
}

forEach

我是ES5版本发布的。按升序为数组中含有效值的每一项执行一次 callback 函数,那些已删除或者未初始化的项将被跳过(例如在稀疏数组上)。我是 for 循环的加强版。

// 遍历数组
let arr = [1,2,3];
arr.forEach(i => console.log(i))


// logs 1
// logs 2
// logs 3
// 直接输出了数组的元素


//遍历对象
let profile = {name:"April",nickname:"二十七刻",country:"China"};
let keys = Object.keys(profile);
keys.forEach(i => {
    console.log(i) // 对象的键值
    console.log(profile[i]) // 对象的键对应的值
})

map

我也是ES5版本发布的,我可以创建一个新数组,新数组的结果是原数组中的每个元素都调用一次提供的函数后的返回值。

let arr = [1,2,3,4,5];
let res = arr.map(i => i * i);


console.log(res) // logs [1, 4, 9, 16, 25]

for…in枚举

我是ES5版本发布的。以任意顺序遍历一个对象的除Symbol以外的可枚举属性。

// 遍历对象
let profile = {name:"April",nickname:"二十七刻",country:"China"};
for(let i in profile){
    let item = profile[i];
    console.log(item) // 对象的键值
    console.log(i) // 对象的键对应的值


// 遍历数组
let arr = ['a','b','c'];
for(let i in arr){
    let item = arr[i];
    console.log(item) // 数组下标所对应的元素
    console.log(i) // 索引,数组下标


// 遍历字符串
let str = "abcd"
for(let i in str){
    let item = str[i];
    console.log(item) // 字符串下标所对应的元素
    console.log(i) // 索引 字符串的下标
}

for…of迭代

我是ES6版本发布的。在可迭代对象(包括 Array,Map,Set,String,TypedArray,arguments 对象等等)上创建一个迭代循环,调用自定义迭代钩子,并为每个不同属性的值执行语句。

// 迭代数组数组
let arr = ['a','b','c'];
for(let item of arr){
    console.log(item)
}
// logs 'a'
// logs 'b'
// logs 'c'


// 迭代字符串
let str = "abc";
for (let value of str) {
    console.log(value);
}
// logs 'a'
// logs 'b'
// logs 'c'


// 迭代map
let iterable = new Map([["a", 1], ["b", 2], ["c", 3]]
for (let entry of iterable) {
    console.log(entry);
}
// logs ["a", 1]
// logs ["b", 2]
// logs ["c", 3]


// 迭代map获取键值
for (let [key, value] of iterable) {
    console.log(key)
    console.log(value);
}


// 迭代set
let iterable = new Set([1, 1, 2, 2, 3, 3,4]);
for (let value of iterable) {
    console.log(value);
}
// logs 1
// logs 2
// logs 3
// logs 4


// 迭代 DOM 节点
let articleParagraphs = document.querySelectorAll('.article > p');
for (let paragraph of articleParagraphs) {
    paragraph.classList.add("paragraph");
    // 给class名为“article”节点下的 p 标签添加一个名为“paragraph” class属性。
}


// 迭代arguments类数组对象
(function() {
  for (let argument of arguments) {
    console.log(argument);
  }
})(1, 2, 3);
// logs:
// 1
// 2
// 3


// 迭代类型数组
let typeArr = new Uint8Array([0x00, 0xff]);
for (let value of typeArr) {
  console.log(value);
}
// logs:
// 0
// 255

经过第一轮的自我介绍和技能展示后,我们了解到:

  • for语句是最原始的循环语句。定义一个变量i(数字类型,表示数组的下标),按照一定的条件,对i进行循环累加。条件通常为循环对象的长度,当超过长度就停止循环。因为对象无法判断长度,所以搭配Object.keys()使用。
  • forEach ES5 提出。自称是for语句的加强版,可以发现它比for语句在写法上简单了很多。但是本质上也是数组的循环。forEach每个数组元素执行一次 callback 函数。也就是调用它的数组,因此,不会改变原数组。返回值是undefine。
  • map ES5 提出。给原数组中的每个元素都按顺序调用一次 callback 函数。生成一个新数组,不修改调用它的原数组本身。返回值是新的数组。
  • for...in ES5 提出。遍历对象上的可枚举属性,包括原型对象上的属性,且按任意顺序进行遍历,也就是顺序不固定。遍历数组时把数组的下标当作键值,此时的i是个字符串型的。它是为遍历对象属性而构建的,不建议与数组一起使用。
  • for...of ES6 提出。只遍历可迭代对象的数据。

能力甄别

作为一个程序员,仅仅认识他们是远远不够的,在实际开发中鉴别他们各自的优缺点。因地制宜的使用他们,扬长避短。从而提高程序的整体性能才是能力之所在。

关于跳出循环体

在循环中满足一定条件就跳出循环体,或者跳过不符合条件的数据继续循环其它数据。是经常会遇到的需求。常用的语句是break 与 continue。

简单的说一下二者的区别,就当复习好了。

  • break语句是跳出当前循环,并执行当前循环之后的语句;
  • continue语句是终止当前循环,并继续执行下一次循环;

注意:forEach 与map 是不支持跳出循环体的,其它三种方法均支持。

原理 :查看forEach实现原理,就会理解这个问题。

Array.prototype.forEach(callbackfn [,thisArg]{

    
}

传入的function是这里的回调函数。在回调函数里面使用break肯定是非法的,因为break只能用于跳出循环,回调函数不是循环体。

在回调函数中使用return,只是将结果返回到上级函数,也就是这个for循环中,并没有结束for循环,所以return也是无效的。

map() 同理。

map()链式调用

map()方法是可以链式调用的,这意味着它可以方便的结合其它方法一起使用。例如:reduce(),sort(), filter() 等。但是其它方法并不能做到这一点。forEach()的返回值是undefined,所以无法链式调用。

// 将元素乘以本身,再进行求和。
let arr = [1, 2, 3, 4, 5];
let res1 = arr.map(item => item * item).reduce((total, value) => total + value);


console.log(res1) // logs 55 undefined"

for…in会遍历出原型对象上的属性

Object.prototype.objCustom = function() {};
Array.prototype.arrCustom = function() {};
var arr = ['a', 'b', 'c'];
arr.foo = 'hello
for (var i in arr) {
    console.log(i);
}
// logs
// 0
// 1
// 2
// foo
// arrCustom
// objCustom

然而在实际的开发中,我们并不需要原型对象上的属性。这种情况下我们可以使用hasOwnProperty() 方法,它会返回一个布尔值,指示对象自身属性中是否具有指定的属性(也就是,是否有指定的键)。如下:

Object.prototype.objCustom = function() {};
Array.prototype.arrCustom = function() {};
var arr = ['a', 'b', 'c'];
arr.foo = 'hello
for (var i in arr) {
    if (arr.hasOwnProperty(i)) {
        console.log(i);
    }
}
// logs
// 0
// 1
// 2
// foo


// 可见数组本身的属性还是无法摆脱。此时建议使用 forEach

对于纯对象的遍历,选择for..in枚举更方便;对于数组遍历,如果不需要知道索引for..of迭代更合适,因为还可以中断;如果需要知道索引,则forEach()更合适;对于其他字符串,类数组,类型数组的迭代,for..of更占上风更胜一筹。但是注意低版本浏览器的是配性。

性能

有兴趣的读者可以找一组数据自行测试,文章就直接给出结果了,并做相应的解释。

for > for-of > forEach > map > for-in

–for 循环当然是最简单的,因为它没有任何额外的函数调用栈和上下文;

  • for...of只要具有Iterator接口的数据结构,都可以使用它迭代成员。它直接读取的是键值。
  • forEach,因为它其实比我们想象得要复杂一些,它实际上是array.forEach(function(currentValue, index, arr), thisValue)它不是普通的 for 循环的语法糖,还有诸多参数和上下文需要在执行的时候考虑进来,这里可能拖慢性能;
  • map() 最慢,因为它的返回值是一个等长的全新的数组,数组创建和赋值产生的性能开销很大。
  • for...in需要穷举对象的所有属性,包括自定义的添加的属性也能遍历到。且for...in的key是String类型,有转换过程,开销比较大。

总结

在实际开发中我们要结合语义话、可读性和程序性能,去选择究竟使用哪种方案?

  • 如果你需要将数组按照某种规则映射为另一个数组,就应该用 map。
  • 如果你需要进行简单的遍历,用 forEach 或者 for of。
  • 如果你需要对迭代器进行遍历,用 for of。
  • 如果你需要过滤出符合条件的项,用 filterr。
  • 如果你需要先按照规则映射为新数组,再根据条件过滤,那就用一个 map加一个 filter。

总而言之,要灵活应用,因地制宜,不同的环境下选择合适的语法。千万不要因为过分追求性能,而忽略了语义和可读性。在您的统治之下,他们5个只能是各自发挥长处,谁都别想称霸。

到最后给大家推荐一下Java的学习课程吧

Java教程:https://www.w3cschool.cn/java/

Java微课:https://www.w3cschool.cn/minicourse/play/javaminicourse

文章参考来源:www.toutiao.com/a6842942752037011976/

解析:JavaScript中的函数式编程

thbcm阅读(366)

JavaScript是一种很受欢迎的编程语言,今天整理这篇文章是为了让大家更深入了解一下JavaScript。下面我将展示一些有关如何在JavaScript中应用函数式编程的例子。

JavaScript中的函数式编程

即使函数式编程可以极大地改善应用程序的代码,但其原理在开始时可能会有些挑战。由于详细解释所有这些都将花费大量时间,因此我们决定使用两个实际的代码示例来介绍这些概念。

1.Maybe Monad

在第一个示例中,我们找到一种避免验证变量是否为Null的方法。假设在我们的应用程序中,我们可以找到具有以下格式的用户:

const someUser = {
 name: 'some_name',
 email: 'some@email.com',
 settings: {
  language: 'sp'
 }
};

有一个功能,可以以用户设置的语言返回欢迎消息。

const allGreetings = {
 'en': '嗨',
 'sp': '你好',
 'fr': '欢迎你'
};
const getGreetingForUser = (user) => {
 //将要执行
}

来看一个遵循命令式模型的“getGreetingForUser”函数的实现:

const getGreetingForUser = (user) => {
 if (!user) {
   return allGreetings.en;
 }
 if (user.settings && user.settings.language) {
   if (allGreetings[user.settings.language]) {
     return allGreetings[user.settings.language]
   } else {
     return allGreetings.en;
   }
 } else {
   return allGreetings.en;
 }
};
console.log(getGreetingForUser(someUser));

如上面所看到的,必须检查用户是否已经存在,是否已设置语言,以及是否已准备好欢迎消息。如果出现问题,我们将以默认语言返回一条消息。

现在,让我们看一下相同的函数,但是这次我们将在其实现中使用函数式编程:

const getGreetingForUser = (user) => {
  return RamdaFantasy.Maybe(user)
    .map(Ramda.path(['settings', 'language']))
    .chain(maybeGreeting);
};
const maybeGreeting = Ramda.curry((greetingsList, userLanguage) => {
  return RamdaFantasy.Maybe(greetingsList[userLanguage]);
})(allGreetings);
console.log(getGreetingForUser(someUser).getOrElse(allGreetings.en));

为了处理可能为null或未定义的情况,我们将使用Maybe Monad。这使我们可以在对象周围创建包装器,并为空对象分配默认行为。

让我们比较两种解决方案:

//代替验证用户是否为空
if (!user) {
  return allGreetings.en;
}
//我们将用:
RamdaFantasy.Maybe(user) //我们将用户添加到包装器中

//代替:
 if (user.settings && user.settings.language) {
   if (allGreetings[user.settings.language]) {
//我们将用:
 <userMaybe>.map(Ramda.path(['settings', 'language'])) //如果存在数据,映射将会用它

//不是在else中返回默认值:
 return indexURLs['en'];
.getOrElse(allGreetings。EN)
// 指定的默认值。

2 Either Monad

当我们知道存在空错误时的默认行为时,Maybe Monad非常有用。

但是,如果我们有一个引发错误的函数,或者我们将各种引发错误的函数链接在一起,并且我们想知道哪个发生了故障,则可以改用Either Monad。

现在,让我们假设我们要计算产品的价格,同时考虑增值税和可能的折扣。我们已经有了以下代码:

const withTaxes = (tax, price) => {
 if (!_.isNumber(price)) {
 return new Error("Price is not numeric");
 }
 return price + (tax * price);
};
const withDiscount = (dis, price) => { 
  if (!_.isNumber(price)) { 
    return new Error("Price is not numeric"); 
  } 
  if (price < 5) 
    return new Error("Discounts not available for low-priced items"); 
  } 
  return price - (price * dis);5
}; 
const isError = (e) => e && e.name === 'Error';
const calculatePrice(price, tax, discount) => { 
//将要执行
}

让我们来看一个遵循命令式模型的“calculatePrice”函数的实现:

const calculatePrice = (price, tax, discount) => {
  const priceWithTaxes = withTaxes(tax, price);
  if (isError(priceWithTaxes)) {
    return console.log('Error: ' + priceWithTaxes.message);
  }
  const priceWithTaxesAndDiscount = withDiscount(discount, priceWithTaxes);
  if (isError(priceWithTaxesAndDiscount)) {
    return console.log('Error: ' + priceWithTaxesAndDiscount.message);
  }
  console.log('Total Price: ' + priceWithTaxesAndDiscount);
}
//我们计算出价值25的产品(含21%的增值税和10%的折扣)的最终价格。
 calculatePrice(25, 0.21, 0.10)

现在,让我们了解如何使用Either Monad重写此函数。

都有两个构造函数,Left和Right。我们要实现的是将异常存储到Left构造函数,并将正常结果(快乐路径)存储到Right构造函数。

首先,将更改已经存在的withTaxes和withDiscount函数,以便在出现错误时它们返回Left,在一切正常的情况下返回Right:

const withTaxes = Ramda.curry((tax, price) => {
  if (!_.isNumber(price)) {
    return RamdaFantasy.Either.Left(new Error("Price is not numeric"));
  }
  return RamdaFantasy.Either.Right(price + (tax * price)); 
});
const withDiscount = Ramda.curry((dis, price) => {
  if (!_.isNumber(price)) {
    return RamdaFantasy.Either.Left(new Error("Price is not numeric")); 
  }
  if (price < 5) { 
    return RamdaFantasy.Either.Left(new Error("Discounts not available for low-priced items")); 
  } 
  return RamdaFantasy.Either.Right(price - (price * dis)); 
});

然后,我们为Right案例创建一个函数(显示价格),为Left案例创建另一个函数(显示错误),然后使用它们创建Either Monad:

const showPrice = (total) => { console.log('Price: ' + total) }; 
const showError = (error) => { console.log('Error: ' + error.message); }; 
const eitherErrorOrPrice = RamdaFantasy.Either.either(showError, showPrice);

最后,只需要执行Monad来计算最终价格:

//计算出价值25的产品(含21%的增值税和10%的折扣)的最终价格。
 eitherErrorOrPrice(
   RamdaFantasy.Either.Right(25)
     .chain(withTaxes(0.21))
     .chain(withDiscount(0.1))
)

结论:JavaScript中的函数式编程

正如我们所看到的,一旦用Maybe和Either单子分解了代码,就没有那么复杂了。如果使用得当,它们可以使我们的代码更易于阅读和维护。

唯一的不便是我们需要克服的初始障碍,但这可以通过在网上一些示例并进行一些测试来完成。

以上就是JavaScript中应用函数式编程的示例,希望能对大家有所帮助。然后想学习JavaScript的同学可以点以下链接

JavaScript教程:https://www.w3cschool.cn/javascript/

JavaScript微课:https://www.w3cschool.cn/minicourse/play/jscourse

文章参考来源:www.toutiao.com/a6836176173207126541/

Java练习题,包含类,方法,对象,属性调用,this使用和构造方法

thbcm阅读(418)

这是一篇Java练习贴,文章中布置了习题,讲解了需求,跟考点。后面也跟着习题的代码。有兴趣的同学可以自己写一下代码,然后再来跟文中的代码对比,看看有什么值得学习的地方。

Java习题第一题

题目:创建一个LOL中的英雄类和怪物类,要求:

怪物类中加入生命值属、等级属性,生命值=等级*1000

英雄类中加入“经验值”,“等级”,“攻击力”等属性变量,加入“击打”方法,击打的目标是怪物,击打的结果是怪物的生命值-英雄攻击力

考点:类的声明、方法的声明、对象的声明与属性调用

Hero类

public class Hero {


        int EXP;//经验值
        int grade;//等级
        int aggressivity;//攻击

        
        //击打的方法
        int strike(int x){
            return x - aggressivity;
        }

        
        public int getEXP() {
            return EXP;
        }


        public void setEXP(int EXP) {
            this.EXP = EXP;
        }


        public int getGrade() {
            return grade;
        }


        public void setGrade(int grade) {
            this.grade = grade;
        }


        public int getAggressivity() {
            return aggressivity;
        }


        public void setAggressivity(int aggressivity) {
            this.aggressivity = aggressivity;
        }


}

Monster 类

public class Monster {


        int grade;//等级
        int healthValue ;//生命值

        
        public int getGrade() {
            return grade;
        }
        public void setGrade(int grade) {
            this.grade = grade;
        }
        public int getHealthValue() {
            healthValue = grade*1000;
            return healthValue;
        }
        public void setHealthValue(int healthValue) {
            this.healthValue = healthValue;
        }


}

main

public class Work1 {


    public static void main(String[] args) {
        //怪物属性
        Monster m = new Monster();
        m.setGrade(5);
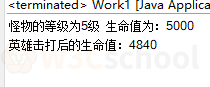
        System.out.println("怪物的等级为"+m.grade+"级  生命值为:"+m.getHealthValue());

        
        //英雄 
        Hero h = new Hero();
        h.setAggressivity(160);
        int a;
        a = h.strike(m.healthValue);
        m.setHealthValue(a);
        System.out.println("英雄击打后的生命值:"+m.healthValue);
    }
}

Java习题第二题

题目:自定义一个英雄类,要求:

英雄的级别最低为0,最高为30级,经验值最低为0,最高为30级时的经验值

该类中要求有一个含有参数的构造函数,参数为英雄的经验值,初始化时要保证经验值在要求范围之内,通过经验值计算英雄的级别,英雄的级别计算公式如下: N=当前级别,EXP(经验值)=30(N^3+5N)-80

构建一个无参的构造方法,将经验值设置为0

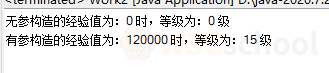
利用英雄类无参和带有参数的构造函数分别构建英雄对象,并输出英雄的等级和经验值。

考点:类的声明、构造方法、this的使用,方法的调用

Hero类

public class Hero2 {


    int EXP;//经验值
    int grade;//等级

    
    //有参的构造函数
    public Hero2(int EXP){
        this.EXP = EXP;//经验值
        }

    
    //无参的构造函数
    public Hero2(){
        EXP=0;//经验值
    }

    
}

main

public class Work2 {


    public static void main(String[] args) {
        //无参构造结果
        Hero2 e= new Hero2();
        System.out.print("无参构造的");
        System.out.println("经验值为:"+e.EXP+" 时,等级为:"+e.grade+" 级");

        
        //有参构造结果
        int a=120000;
        Hero2 h = new Hero2(a);
        System.out.print("有参构造的");
        for(int i = 1 ; i <=30 ; i++ ) {

            
            //System.out.println(i+"级经验值:"+(30*(i*i*i+5*i)-80));//输出1-30级每级的经验值所需经验
            if((30*(i*i*i+5*i)-80) <= h.EXP && (30*((i+1)*(i+1)*(i+1)+5*(i+1))-80)>h.EXP ) {
                h.grade=i;
                break;
            }
        }
        System.out.println("经验值为:"+h.EXP+" 时,等级为:"+h.grade+" 级");
    }


}

以上是两道Java的习题及代码,希望对同学们有所帮助。对Java感兴趣的同学可以看一下教程

文章参考来源:blog.csdn.net/d694046387/java/article/details/107620181

一篇文章带你了解什么是 Spring JPA

thbcm阅读(425)

同学们好,今天我跟大家伙们聊一下关于 Spring JPA 的相关知识,首先我们来了解一下什么 JPA 。

1.什么是JPA

JPA (Java Persistence API) 是 Sun 官方提出的 Java 持久化规范。它为 Java 开发人员提供了一种对象/关联映射工具来管理 Java 应用中的关系数据。他的出现主要是为了简化现有的持久化开发工作和整合 ORM 技术,结束现在 Hibernate,TopLink,JDO 等 ORM 框架各自为营的凌乱局面。JPA 在充分吸收了现有Hibernate,TopLink,JDO 等ORM框架的基础上发展而来的,具有易于使用,伸缩性强等优点。从上面的解释中我们可以了解到JPA 是一套规范,而类似 Hibernate,TopLink,JDO这些产品是实现了 JPA 规范。

了解了什么是 JPA,我们来看看本文的主角——spring data jpa。

2.spring data jpa

pring Data JPA 是 Spring 基于 ORM 框架、JPA规范的基础上封装的一套 JPA 应用框架,底层使用了 Hibernate 的 JPA 技术实现,可使开发者用极简的代码即可实现对数据的访问和操作。它提供了包括增删改查等在内的常用功能,且易于扩展!学习并使用 Spring Data JPA 可以极大提高开发效率。

什么意思呢?如果用过Hibernate 或者MyBatis 的话,就会知道对象关系映射(ORM)框架有多么方便。但是Spring Data JPA框架功能更进一步,为我们做了 一个数据持久层框架几乎能做的任何事情。以Springboot整合MyBatis为例,比如我们要向数据库中插入一些用户的数据,那么我们需要先定义用户的实体类,然后我们要定义一个UserDao:

@Repository
public class UserDao {
    @Autowired
    JdbcTemplate jdbcTemplate;


    public int addUser(User user){
    return jdbcTemplate.update("INSERT INTO t_user(username,jobs,phone) VALUE (?,?,?)",
    user.getName,user.getJobs,user.getPhone);
    }
    public int updateUser(User user){
    return jdbcTemplate.update("UPDATE t_user SET username=?,jobs=?,phone=? WHERE id=?",
    user.getName,user.getJobs,user.getPhone,user.getId);
    }
    public int deleteUser(Integer id){
    return jdbcTemplate.update("DELETE FROM t_user WHERE id=?",id);
    }
    public User getUserById(Integer id){
    return jdbcTemplate.queryForObject("SELECT * FROM t_user WHERE id =?",new BeanPropertyRowMapper<>(User.class),id);
    }
    public List<User> getAllUser{
    return jdbcTemplate.query("SELECT * FROM t_user",new BeanPropertyRowMapper<>(User.class));
    }
}

以及UserService

@Service
public class UserService {


    @Autowired
    UserDao userDao;
    public int addUser(User user){
    return userDao.addUser(user);
    }
    public int updateUser(User user){
    return userDao.updateUser(user);
    }
    public int deleteUser(Integer id){
    return userDao.deleteUser(id);
    }
    public User getUserById(Integer id){
    return userDao.getUserById(id);
    }
    public List<User> getAllUser{
    return userDao.getAllUser;
    }
}

最后,我们在去调用对应的service 中的方法。这是传统的方式,如果使用mapper,会稍微简单一些,比如我们要添加mapper

@Mapper
public interface UserMapper {
    int addUser(User user);
    int deleteUser(int id);
    int updateUser(User user);
    User getUserById(Integer id);
    List<User> getAllUsers;


}

然后定义一个UserMapper.xml ,添加对应的CURD SQL语句,做好映射,然后改造service,例如

@Service
public class UserService {


    @Autowired
    UserMapper userMapper;
    public int addUser(User user){
    return userMapper.addUser(user);
    }
    public int updateUser(User user){
    return userMapper.updateUser(user);
    }
    public int deleteUser(Integer id){
    return userMapper.deleteUser(id);
    }
    public User getUserById(Integer id){
    return userMapper.getUserById(id);
    }
    public List<User> getAllUser{
    return userMapper.getAllUsers;
    }
}

发现什么问题了吗?如果我们要去实现多个表的操作,我们需要定义不同的实体类,然后实现对应的mapper,然后写同样的增删改查方法,最后调用。这也太麻烦了些,而Spring data jpa 则可以轻松的帮我们实现这些繁琐重复且没有技术含量的操作。我们一起看下吧!

3.案例演示

1.首先,我们需要配置pom.xml

<dependency>
        <groupId>mysql</groupId>
        <artifactId>mysql-connector-java</artifactId>
    </dependency>

 
    <dependency>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-data-jpa</artifactId>
    </dependency>

2.然后是application.properties 的配置

spring.datasource.url=jdbc:mysql://127.0.0.1:3306/test?useUnicode=true&characterEncoding=utf-8&serverTimezone=UTC&useSSL=true
spring.datasource.username=root
spring.datasource.password=123456
spring.datasource.driver-class-name=com.mysql.jdbc.Driver
spring.jpa.properties.hibernate.hbm2ddl.auto=create
spring.jpa.properties.hibernate.dialect=org.hibernate.dialect.MySQL5InnoDBDialect
spring.jpa.show-sql=true

这里重点简单介绍下spring.jpa.properties.hibernate.hbm2ddl.auto有几种配置:

  • create:表示每次加载Hibernate时都会删除上一次生成的表(包括数据),然后重新生成新表,即使两次没有任何修改也会这样执行。适用于每次执行单测前清空数据库的场景。
  • create-drop:表示每次加载Hibernate时都会生成表,但当SessionFactory关闭时,所生成的表将自动删除。
  • update:最常用的属性值,第一次加载Hibernate时创建数据表(前提是需要先有数据库),以后加载Hibernate时不会删除上一次生成的表,会根据实体更新,只新增字段,不会删除字段(即使实体中已经删除)。
  • validate:每次加载Hibernate时都会验证数据表结构,只会和已经存在的数据表进行比较,根据model修改表结构,但不会创建新表。
  • 不配置此项,表示禁用自动建表功能

spring.jpa.show-sql=true 该配置当在执行数据库操作的时候会在控制台打印 sql 语句,方便我们检查排错等。

spring.jpa.properties.hibernate.dialect=org.hibernate.dialect.MySQL5InnoDBDialect 这是数据库的方言配置。

3.接下来我们建立用户实体类

@Entity
public class User {

 
    @Id
    @GeneratedValue
    private long id;
    @Column(nullable = false, unique = true)
    private String userName;
    @Column(nullable = false)
    private String password;
    @Column(nullable = false)
    private int age;
}

这里的一些注解解释如下:

  • @Entity 是一个类注解,用来注解该类是一个实体类用来进行和数据库中的表建立关联关系,首次启动项目的时候,默认会在数据中生成一个同实体类相同名字的表(table),也可以通过注解中的 name 属性来修改表(table)名称, 如@Entity(name=“user”) , 这样数据库中表的名称则是 user。该注解十分重要,如果没有该注解首次启动项目的时候你会发现数据库没有生成对应的表。
  • @Table 注解也是一个类注解,该注解可以用来修改表的名字,该注解完全可以忽略掉不用,@Entity 注解已具备该注解的功能。
  • @Id 类的属性注解,该注解表明该属性字段是一个主键,该属性必须具备,不可缺少。
  • @GeneratedValue 该注解通常和 @Id 主键注解一起使用,用来定义主键的呈现形式,该注解通常有多种使用策略,先总结如下:
  • @GeneratedValue(strategy= GenerationType.IDENTITY) 该注解由数据库自动生成,主键自增型,在 mysql 数据库中使用最频繁,oracle 不支持。
  • @GeneratedValue(strategy= GenerationType.AUTO)  主键由程序控制,默认的主键生成策略,oracle 默认是序列化的方式,mysql 默认是主键自增的方式。
  • @GeneratedValue(strategy= GenerationType.SEQUENCE) 根据底层数据库的序列来生成主键,条件是数据库支持序列,Oracle支持,Mysql不支持。
  • @GeneratedValue(strategy= GenerationType.TABLE) 使用一个特定的数据库表格来保存主键,较少使用。

上面这些主键生成策略中,以 mysql 为例,  IDENTITY  和 AUTO 用的较多,二者当中IDENTIT 用的多些,以下文章当中演示的 demo 主键均使用 @GeneratedValue(strategy= GenerationType.IDENTITY) 的生成策略。

@Column 是一个类的属性注解,该注解可以定义一个字段映射到数据库属性的具体特征,比如字段长度,映射到数据库时属性的具体名字等。

@Transient  是一个属性注解,该注解标注的字段不会被映射到数据库当中。

4. 声明 UserRepository接口,继承JpaRepository,如下所示

public interface UserRepository extends JpaRepository<User, Long> {

 
}

这里的 JpaRepository继承了接口PagingAndSortingRepository 和QueryByExampleExecutor。而,PagingAndSortingRepository又继承CrudRepository。

因此,JpaRepository接口同时拥有了基本CRUD功能以及分页功能。因此,这里我们可以继承JpaRepository,从而获得Spring为我们预先定义的多种基本数据操作方法。

5.然后我们定义一个测试类,  这里我们演示下添加操作, @Transactional 表示开启事务防止出现脏数据。


        ……
        @Autowired
    private UserRepository userRepository;

 
    @Test
    @Transactional
    public void userAddTest() {
        User user = new User();
        user.setUserName("吴彦祖");
        user.setAge(30);
        user.setPassword("123456");
        userRepository.save(user);
        User item = userRepository.findByUserName("wyk");
        log.info(JsonUtils.toJson(item));
    }

6.接下来我们说下查询,查询可以分为基本查询和自定义查询,一种是 spring data 默认已经实现,只需要要继承JpaRepository,一种是根据查询的方法来自动解析成 SQL。

@Test
public void testQuery() throws Exception {
    User user=new User();
    userRepository.findAll();
    userRepository.findOne(1l);
    userRepository.save(user);
    userRepository.delete(user);
    userRepository.count();
    userRepository.exists(1l);
    ……
}

7.自定义的简单查询就是根据方法名来自动生成SQL,主要的语法是findXXBy,readAXXBy,queryXXBy,countXXBy, getXXBy后面跟属性名称,举几个例子:

User findByUserName(String userName);

 
User findByUserNameOrEmail(String username, String email);

 
Long deleteById(Long id);

 
Long countByUserName(String userName);

 
List<User> findByEmailLike(String email);

 
User findByUserNameIgnoreCase(String userName);

 
List<User> findByUserNameOrderByEmailDesc(String email);

8.接下来,我们说下复杂的查询,在实际的开发中我们需要用到分页、删选、连表等查询的时候就需要特殊的方法或者自定义 SQL,以分页查询为例,分页查询在实际使用中非常普遍了,spring data jpa已经帮我们实现了分页的功能,在查询的方法中,需要传入参数Pageable,当查询中有多个参数的时候Pageable建议做为最后一个参数传入。Pageable是 spring 封装的分页实现类,使用的时候需要传入页数、每页条数和排序规则

Page<User> findALL(Pageable pageable);

 
Page<User> findByUserName(String userName,Pageable pageable);

9.我们看下下面的测试用例

@Test
public void testPageQuery() throws Exception {
    int page=1,size=5;
    Sort sort = new Sort(Direction.DESC, "id");
    Pageable pageable = new PageRequest(page, size, sort);
    userRepository.findALL(pageable);
    userRepository.findByUserName("testName", pageable);
}

  1. Spring data 大部分的SQL都可以根据方法名定义的方式来实现,但是由于某些原因我们想使用自定义的 SQL 来查询,spring data 也是完美支持的,如下所示:
@Modifying
@Query("update User u set u.userName = ?1 where c.id = ?2")
int modifyByIdAndUserId(String  userName, Long id);

 
@Transactional
@Modifying
@Query("delete from User where id = ?1")
void deleteByUserId(Long id);

 
@Transactional(timeout = 10)
@Query("select u from User u where u.emailAddress = ?1")
User findByEmailAddress(String emailAddress);

以上就是关于spring data jpa 的介绍。对spring 或者 Java感兴趣的同学可以看一下教程

Spring教程:https://www.w3cschool.cn/wkspring/

Spring微课:https://www.w3cschool.cn/minicourse/play/springcourse

Java教程:https://www.w3cschool.cn/java/

Java微课:https://www.w3cschool.cn/minicourse/play/javaminicourse

文章参考来源:www.toutiao.com/a6843247617955070471/
springboot 定时任务,异步任务的案例分享

thbcm阅读(367)

整理这篇文章是为了给大家分享两个springboot的异步任务、定时任务的简单案例,让大家有个参考对象。

异步任务简单案例

在我们开发项目时,常常会用到异步处理任务,比如我们在网站上发送邮件,后台会去发送邮件,此时会造成前台响应不动,直到邮件发送完毕,响应才会成功,所以我们一般会采用多线程的方式去处理这些任务。

  1. 新建一个service包
  1. 创建AsyncService类
@Service
    public class AsyncService {

    
       public void hello(){
           try {
               Thread.sleep(3000);
          } catch (InterruptedException e) {
               e.printStackTrace();
          }
           System.out.println("业务进行中~~");
      }
    }

  1. 创建controller包
  1. 在controller包下创建一个AsyncController类
@RestController
    public class AsyncController {

    
       @Autowired
       AsyncService asyncService;

    
       @GetMapping("/hello")
       public String hello(){//调用方法后会延迟3秒在页面显示Success
           asyncService.hello();
           return "success";
      }

    
    }

此时访问Localhost:8080/hello的情况是:延迟3秒后,在页面输出Success,在后台会输出业务进行中~~

新问题:如果想页面直接输出信息“Success”,而让这个hello方法直接在后台用多线程操作,就需要加上@Async注解,这样spring boot就会自己开一个线程池进行调用

改进:给AsyncService加上注解

@Async//告诉Spring这是一个异步方法
    public void hello(){
       try {
           Thread.sleep(3000);
      } catch (InterruptedException e) {
           e.printStackTrace();
      }
       System.out.println("业务进行中~~");
    }

但是要让这个注解起作用,还需要在入口文件中开启异步注解功能

@EnableAsync //开启异步注解功能
@SpringBootApplication
    public class SpringbootTaskApplication {
           public static void main(String[] args) {
               SpringApplication.run(SpringbootTaskApplication.class, args);
          }
    }

此时再次测试,发现页面直接输出了Success,但是后台仍然是3秒后输出业务进行中

定时任务简单案例

工作中常常要设置一些定时任务,比如每天在某个时间分析一遍日志

所以Spring提供了异步执行任务调度的方式,提供了两个接口。

TaskExecutor接口

TaskScheduler接口

两个注解:

• @EnableScheduling

• @Scheduled

创建一个ScheduleService,里面编写一个hello方法,让它定时执行

@Service
publicclassScheduledService{


    //秒分时日月周几
    @Scheduled(cron="0 * * * * ?")
    //这里需要学习一些cron表达式的语法,明白时间如何设置,这里的意思是每当时间到0秒时就执行一次
    publicvoidhello(){
        System.out.println("hello/////");
    }
}

要使用定时功能,还需要在入口文件中加上@EnableScheduling,表明开启定时任务功能

@SpringBootApplication
    @EnableScheduling//开启定时任务注解功能
    @EnableAsync//开启异步注解功能
    publicclassSpringbootTaskApplication{

    
    publicstaticvoidmain(String[]args){
    SpringApplication.run(SpringbootTaskApplication.class,args);
    }

    
    }

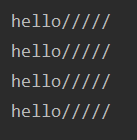
此时测试运行,发现每当时间为0秒时就会在后台打印出 hello////

以上就是分享的两个简单案例,对SpringBoot和java有学习兴趣的同学,可以看一下教程

Java教程:https://www.w3cschool.cn/java/

Java微课:https://www.w3cschool.cn/minicourse/play/javaminicourse

SpringBoot教程:https://www.w3cschool.cn/seansblog/

SpringBoot从入门到精通微课:https://www.w3cschool.cn/minicourse/play/springboot_my

HTML学习笔记之文本标签

thbcm阅读(417)

作为一名热爱学习的同学,每当学习一点新知识,咱就做一点笔记,以免学会的知识偷偷跑掉。毕竟“好记性不如烂笔头”。

p 段落标签

顾名思义,就是写一段话需要用到的标签,用法如下:

        <p>这是一段话(此处省略1500字)</p>

br 换行标签

有时候,写两句就需要换一下行,就可以用到b标签,与普通文档中的回车符意义相同,用法如下:

        <p>这是一段话(此处省略1500字)<br />这句我就换了行</p>

a 超链接标签

页面之间跳转就需要用到超链接,其中的href属性用于定义超链接的URL,用法如下:

        <a href="https://www.csdn.net/">这是一个超链接</a>

hr 水平线标签

当你需要一条长长的分割线时,或许可以考虑一下hr标签,用法如下:

        <p>
            我说完了,需要一条分割线结束
            <hr />
            第二部分
        </p>

h1-h6 标题标签

当需要字体大小不同的标题时,可以用标题标签,字体的大小从h1开始到h6越来越小,h1最大,h6最小,用法如下:

        <h1>这是h1标签,字体很大</h1>
        <h6>这是h6标签,字体很小</h6>

pre 预先格式化标签

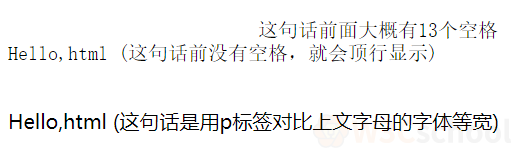
因为HTML很多标签会合并空格,所以当你想要展示很多个空格的时候,往往并不会像你想的那样,当然,pre标签可以满足你的要求,被包围在pre里的文本通常会保留空格和换行符,并且字体等宽。字体等宽:其实汉字一般都是等宽的,设置字体等宽对于字母比较明显,可以看下面示例:

        <pre>
             这句话前面大概有13个空格
Hello,html (这句话前没有空格,就会顶行显示)
        </pre>
        <p>Hello,html (这句话是用p标签对比上文字母的字体等宽)</p>

可以看到,pre里的l和o宽度一样,而p标签里l宽度比o窄,这就是pre标签的字体等宽。

header 页眉标签

页眉标签即在页面最上方展示的内容,用法如下:

        <footer>这里是页脚</footer>

nav 导航栏标签

一般网页在页眉下面都有一条包含首页之类的导航栏,nav实现的就是这一效果,一般搭配a标签使用,用法如下:

            <nav>
                <a href="http://www.tup.tsinghua.edu.cn/index.html">清华大学出版社</a>
                <a href="https://www.w3cschool.com.cn">w3cschool在线教程</a>
            </nav>

section 节标签

section标签定义文档中的节(section、区段),比如章节、页眉、页脚或文档中的其他部分,用法上和div相差不大,用法如下:

        <section>
          <h1>标题</h1>
          <p>正文内容</p>
        </section>

b 加粗标签

b标签原本含义是加粗,现在表示“文体突出”文字,通俗讲就是普通段落文字中突出不安分的文字,并把这部分文本呈现为粗体文本,用法如下:

        <p>这句话突然有几个字被<b>加粗</b></p>

strong 加粗标签

strong在HTML4中,表示strong emphasized text,即“更强调的文本”,在HTML5中其含义变成了important text,即“重要的文本”。其效果大致与b相同,都是对文本进行加粗,用法如下:

        <p>是该<strong>强调</strong>几句话了</p>

i 倾斜标签

i标签原本只是倾斜,现在用来体现与文本中其余部分不同的部分,并把这部分文本呈现为斜体文本,用法如下:

        <p>有几个字走着走着就<i>倒</i>了</p>

em 倾斜标签

em在HTML4和HTML5中,都表示emphasized text,即“强调的文本”,也有说法认为HTML5中,em表示有压力的强调,意义基本一致。其效果大致与i相同,都是对文本进行倾斜处理,用法如下:

        <p>又有几个字也<em>倒</em>了下来</p>

cite 作品标题

cite用来定义作品(比如书籍、歌曲、电影、电视节目、绘画、雕塑等)的标题,其效果与倾斜类似,用法如下:

        <p>庄子的<cite>《逍遥游》</cite>我并没有看过</p>

small 小型文本标签

small将旁注呈现为小型文本。免责声明、注意事项、法律限制或版权声明等通常都使用小型文本,小型文本有时也用于新闻来源、许可要求等。对于由em元素强调过的或由strong元素标记为重要的文本,small元素不会取消对文本的强调,也不会降低这些文本的重要性。当然,b和i标签也可以应用在small里,用法如下:

        <small>这里是<em>小型文本</em><strong>标签</strong></small>

ins&del 标记文本改变标签

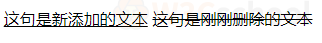
ins标记定义文档中的插入文本,和del标记一起使用,来描述对文档的更新和修正。del表示删除的文本,浏览器中通常以删除线文本显示,ins表示新添加的文本,浏览器中通常以下划线文本显示。用法及效果如下:

        <ins>这句是新添加的文本</ins>
        <del>这句是刚刚删除的文本</del>

sub&sup 文字上下标标签

sub标记可定义下标文本,sup标记可定义上标文本。用法及效果如下:

        <p>
            因式分解得:(x+1)<sup>2</sup>=4
            <br />
            解得:x<sub>1</sub>=-3, x<sub>2</sub>=1
        </p>

time 时间标签

time标记是HTML5的新增标记,用来定义日期时间。网页中经常会出现日期和时间信息,但过去一直没有标准的方式来标注,time标记的出现便是为了解决这个问题,其目的是让搜索引擎等其它程序可以更容易的提取日期时间信息,但在页面上似乎并不显示其内容,用法如下:

        <p>
            我每天早上<time>6:00</time>起床。
            我姐姐的<time datetime="1995-10-13">生日</time>马上要到了。
        </p>

var 变量标签

var标签经常与 code和pre标签一起使用,用来显示计算机编程代码范例及类似方面的特定元素,用var标签标记的文本通常显示为斜体。

address 联系信息标签

address标签定义文档或文章的作者/拥有者的联系信息,address元素中的文本通常呈现为斜体,address元素通常连同其他信息被包含在footer元素中,其用法如下

        <address>
            Written by <a href="mailto:webmaster@example.com">Jon Doe</a>.<br> 
            Visit us at:<br>
            Example.com<br>
            Box 564, Disneyland<br>
            USA
        </address>

div 块级容器标签

div元素是块级元素,它是可用于组合其它HTML元素的容器,div元素没有特定的含义,如果与 CSS 一同使用,div元素可用于对大的内容块设置样式属性。在HTML5中header等结构化元素出现之前,最常用的组容器就是div元素,它代表一个通用的内容块,结合CSS对文档赋予结构。其用法如下:

        <div style="color: red;">
            <h3>标题</h3>
            <p>文本内容</p>
        </div>

span 行内容器标签

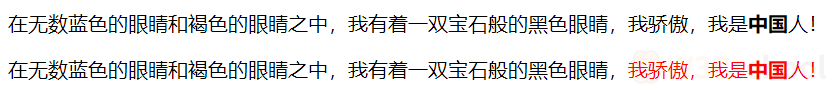
span元素是一个行内元素,它是div元素的一位表亲,同样是一个没有语义的通用元素,就其本身而言,span元素对文档的视觉效果没有任何影响,配合CSS使用时会发生变化,用法及效果如下:

        <p>
            在无数蓝色的眼睛和褐色的眼睛之中,我有着一双宝石般的黑色眼睛,<span>我骄傲,我是<strong>中国</strong>人!</span>
        </p>
        <p>
            在无数蓝色的眼睛和褐色的眼睛之中,我有着一双宝石般的黑色眼睛,<span style="color: red;">我骄傲,我是<strong>中国</strong>人!</span>
        </p>

ul 无序列表标签

无序列表类似于word中的项目符号列表,列表项排列没有顺序,只以项目符号作为分项标识。无序列表使用ul标记,需要为每一个列表项使用标记li标记,用法如下:

        <ul>
            <li>唱</li>
            <li>跳</li>
            <li>rap</li>
            <li>篮球</li>
        </ul>

ol 有序列表标签

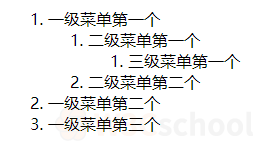
有序列表使用标记ol,其列表项仍然使用标记li,当需要子菜单或更多层次时,需要使用嵌套的方式实现,具体代码及效果如下:

        <ol>
            <li>一级菜单第一个</li>
            <ol>
                <li>二级菜单第一个</li>
                <ol>
                    <li>三级菜单第一个</li>
                </ol>
                <li>二级菜单第二个</li>
            </ol>
            <li>一级菜单第二个</li>
            <li>一级菜单第三个</li>
        </ol>

dl 描述列表标签

dl元素代表了一个描述列表,由0到多个“术语-描述”组构成,每一组都与一个或多个“术语”(dt元素的内容)以及一个或多个“描述”(dd元素的内容)相关,具体代码及效果如下:

        <dl>
            <dt>赤鷩</dt>
            <dd>鸟,可以御火</dd>
            <dd>赤鷩,山鸡之属,胸腹洞赤,冠金,背黄,头绿,尾中有赤,毛彩鲜明。</dd>
            <dt>鳢鱼</dt>
            <dd>鱼,其状如鳖,其音如羊</dd>
            <dt>肥囗</dt>
            <dd>蛇,六足四翼,见则天下大旱</dd>
        </dl>

附:使用字符实体表示特殊字符

大多数字母数字字符都可以在HTML文档中直接使用而不会有任何问题,然而,有一些字符在HTML中具有特殊含义,浏览器很可能会错误理解,这时,就需要使用一组不同的字符代替这些特殊字符,这就是字符实体(也叫转义字符),部分常用符号如下:

以上就是关于HTML文本标签的笔记了。有兴趣的同学可以用HTML编辑器测试一下代码效果。

想学习HTML的请往这走:

HTML教程:https://www.w3cschool.cn/html/

HTML零基础入门:https://www.w3cschool.cn/minicourse/play/html_txy

CSS学习笔记之基础与选择器

thbcm阅读(417)

这是一篇关于CSS基础跟选择器的笔记,毕竟自己的记性没有笔记本好用,所以记录一下,以后忘了也好有地方翻一下,复习重温。

CSS介绍

我们可以使用HTML构建稳定的结构基础,而页面的风格样式控制则交给CSS来完成。网页的样式包括各种元素的颜色、大小、线形、间距等等,这对于设计或维护一个数据较多的网站来说,工作量是巨大的。好在可以使用CSS来控制这些样式,这将大大提高网页设计和维护的效率,并且使网页的整体风格很容易做到统一。

CSS概述

CSS是英文Cascading Style Sheet的缩写,中文译为层叠样式表,也有人翻译为级联样式表,简称样式表。它是一种用来定义网页外观样式的技术,在网页中引入CSS规则,可以快捷高效地对页面进行布局设计,可以精确的控制HTML标记对象的宽度、高度、位置、字体、背景等外观效果。 CSS是一种标识性语言,不仅可以有效的控制网页的样式,更重要的是实现了网页内容与样式的分离,并允许将CSS规则单独存放于一个文档中, CSS文件的扩展名为“css”。

CSS3

CSS3标准早在1995年就开始制订, 2001年提上W3C研究议程,但是,10年来CSS3可以说是基本上没有什么很大的变化,一直到2011年6月才发布了全新版本的CSS3,目前,许多浏览器都广泛支持CSS3。 CSS3是CSS技术的一个升级版本,CSS3语言将CSS划分为更小的模块,在朝着模块化的方向发展。以前的版本是一个比较庞大而且比较复杂模块,所以,把它分解成为一个个小的简单的模块,同时也加入了更多新的模块。在CSS3中有字体、颜色、布局、背景、定位、边框、多列、动画、用户界面等等多个模块。

CSS的基本用法

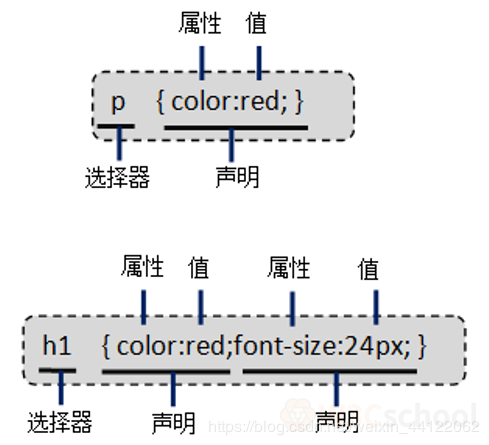
CSS的使用规则由两部分组成:选择器和一条或多条声明。其基本基本语法如下:

        选择器{
            属性1: 值;
            属性2: 值;
            …
            属性n: 值;
        }

CSS属性

CSS的属性按照相关功能进行了分组,包含了字体、文本、背景、列表、动画等多个分组,这些属性的具体使用方法和示例将会在后续中提到。

在HTML文档中使用CSS的方法

根据CSS在HTML文档中的使用方法和作用范围不同,CSS样式表的使用方法分为三大类:行内样式、内部样式表和外部样式表,而外部样式表又可分为链入外部样式表和导入外部样式表。本节我们从四个分类来认识在HTML中使用CSS的方法。

  • 行内样式
  • 内部样式表
  • 外部样式表
  • 链入外部样式表
  • 导入外部样式表

行内样式

行内样式(inline style),也叫内联样式,它是CSS四种使用方法中最为直接的一种,它的实现借用HTML元素的全局属性style,把CSS代码直接写入其中即可。 严格意义上行内样式是一种不严谨的使用方式,它不需要选择器,这种方式下CSS代码和HTML代码混合在一起,因此不推荐使用行内样式。行内样式的基本语法如下:

        <标记 style="属性:值; 属性:值; …">

内部样式表

当单个文档需要特殊的样式时,应该使用内部样式表。内部样式表是将样式放在页面的head区里,这样定义的样式就应用到本页面中了,内部样式表使用style标记进行声明,是较为常用的一种使用方法。其基本语法如下:

    <head>
        <meta charset="utf-8" />
        <title></title>
        <style type="text/css">
            选择器1{属性:值;…}
            选择器2{属性:值;…}
            ……
            选择器n{属性:值;…}
        </style>
    </head>

style标记定义HTML文档的样式信息,规定的是HTML元素如何在浏览器中呈现,其中type用来指定元素中的内容类型。

链入外部样式表

当为了保证站点的风格统一,或当定义样式内容较多,且需要多个页面共享样式时,可使用外部样式表。链入外部样式表是把样式表保存为一个外部样式表文件,然后在页面中用link标记链接到这个样式表文件,link标记放在页面的head区内。其基本语法为:

    <head>
        <meta charset="utf-8" />
        <title></title>
        <link href="样式表路径" rel="stylesheet" type="text/css" />
    </head>

其中:

href:指出样式表存放的路径。

rel:用来定义链接的文件与HTML之间的关系,rel="stylesheet"是指在页面中使用这个外部的样式表。

type属性用于指定文件类型,“text/css”指文件的类型是样式表文本。

导入外部样式表

导入外部样式表是指在HTML文件头部的style元素里导入一个外部样式表,导入外部样式表采用import方式。导入外部样式表和链入样式表的方法很相似,但导入外部样式表的样式实质上相当于存在网页内部。其基本语法为:

    <head>
        <meta charset="utf-8" />
        <title></title>
        <style type="text/css">
            @import url("样式表路径");
        </style>
    </head>

CSS基本选择器

选择器是CSS中很重要的概念,它可以大幅度提高开发人员编写或修改样式表的工作效率。CSS3提供了大量的选择器,大体上可以分为基本选择器、组合选择器、属性选择器、伪类选择器和伪对象选择器等。由于浏览器支持情况,很多选择器在实际开发中很少用到,本篇主要记录最基本又最常用的几种选择器。 基本选择器包括标记选择器、类选择器、id选择器和通用选择器。

标记选择器

HTML文档中最基本的构成是HTML标记,如果要对文档中的所有同类标记都使用同一个CSS样式时,就应使用标记选择器。其基本语法为:

        标记名{ 属性1:值1; 属性2:值2;…}

例如要使所有P标签的文本居中时,语法如下:

            p{
                text-align: center;
            }

类选择器

类选择器的基本语法为:

        标记名.类名{属性1:值1;属性2:值2;…}

类选择器针对标记的全局属性class,引用方式为:

        <标记名 class="类名">

值得注意的是,这里的类名可以是任何合法的字符,由设计者定义。如果对所有的标记均可使用,则采用*.类名的形式,这里的*表示全部,当然,也可以省略。

下面举几个例子:

        <style type="text/css">
            p.text1{color:brown;font-size:14px;}
            /* 该形式下只允许<p>标记中类名为"text1"的标签引用该样式 */
            *.text1{ color:brown;font-size:14px; }
            或
            .text1{ color:brown;font-size:14px; }
            /* 表示所有类名为"text1"的标签都可引用该样式 */
        </style>

id选择器

id选择器和类选择器大致相同,不同的是定义时不使用“.”而使用“#”,作用于HTML标记的全局属性是“id”而不是“class”。 id选择器的基本语法为:

        标记名#id名{ 属性1: 值1;属性2: 值2;…}

id选择器针对标记的全局属性id,引用方式为:

        <标记名 id="id名">

当然,与类选择器一样,如果对所有的标记均使用时,则采用*#id名的形式,这里*表示全部,也可以省略。

通用选择器

通用选择器是一种特殊的选择器,用 * 表示,匹配网页中的所有元素,除非使用更为具体的选择器指定某一元素中对应的相同属性应使用其它值。通用选择器和对body元素设定样式稍有不同,因为通用选择器应用于每一个元素,而不依赖从应用于body元素的规则中继承的属性。其基本用法如下:

        <style type="text/css">
            *{
                属性1: 值1;
                属性2: 值2;
                …
            }
        </style>

其它CSS选择器

除了CSS基本选择器外,CSS还有许多其它选择器。

组合选择器

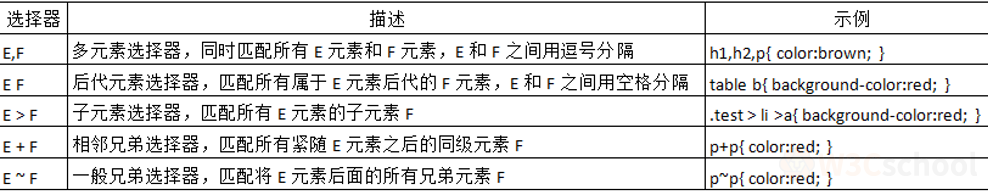
CSS中组合选择器,可以算作是基础选择器的升级版,也就是组合去使用基础选择器的意思。组合选择器主要有五个类别:多元素选择器、后代选择器、子选择器、相邻选择器和兄弟选择器。

多元素选择器

多元素选择器的基本语法为:

        E, F {属性1:值1;属性2:值2;… } 

这个很好理解,就是同时选中多个元素,中间用“,”隔开。

后代元素选择器

后代元素选择器的基本语法为:

        E F {属性1:值1;属性2:值2;… } 

这个也很好理解,就是匹配所有属于E元素后代的F元素,E元素与F元素用空格隔开,例如:

        table b{color:red; } 

就表示将表格中的所有b元素文字设置为红色。

子元素选择器

子元素选择器的基本语法为:

        E>F{属性1:值1;属性2:值2;…}

子元素选择器只能选择某元素的子元素,其中E为父元素,F为直接子元素,E>F所表示的是选择了E元素下的所有子元素F,其间用>连接。这和后代元素选择器不一样,在后代元素选择器中F是E的所有后代元素,而子元素选择器中F必须是E的子元素。

相邻兄弟选择器

相邻兄弟选择器的基本语法为:

        E+F{属性1:值1;属性2:值2;…}

相邻兄弟选择器可以选择紧接在另一元素后的元素,而且它们具有相同的父元素,其间用+号链接,换句话说,E和F具有同一个父元素,而且F元素在E元素后面并且紧紧相邻。

一般兄弟选择器

一般兄弟选择器的基本语法为:

        E~F{属性1:值1;属性2: 值2;…}

一般兄弟选择器将选择某元素后面的所有兄弟元素,其间用~号链接,它和相邻兄弟选择器类似,需要在同一个父元素之中,并且F元素在E元素之后。区别在于E ~ F 选择器匹配所有E元素后面的F元素,E+F仅匹配紧跟在E元素后边的F元素。

属性选择器

属性选择器是在标记后面加一个中括号,中括号中列出各种属性或者表达式。属性选择器的形式很多,我们这里通过示例简单介绍几个。

存在属性匹配

通过匹配存在的属性来控制元素的样式,一般要把匹配的属性包含在中括号中。 例如将任何带有href属性的a标记设置为综色:

        a[href]{color:brown;}

精确属性匹配 只有当属性值完全匹配指定的属性值时才会应用样式,id选择器和类选择器本质上就是精确属性匹配选择器。 例如将指向网址“http://www.w3cschool.cn” 的链接a标记设置为棕色:

        a[href="http://www.w3cschool.cn"]{color:brown;}

前缀匹配

只要属性值的开始字符串匹配指定字符串,即可对元素应用样式。前缀匹配使用[^=]形式实现,如:

        [id^="user"]{color:brown;}

那么下列的标签均可以变为棕色:

        <p id="userName">小明</p>
        <p id="userWeight">体重</p>
        <p id="userAge">年龄</p>

后缀匹配

与前缀匹配相反,只要属性值的结尾字符匹串配指定字符串,即可对元素应用样式。后缀匹配使用[$=]形式实现,如:

        [id$="Name"]{color:brown;}

那么下列的标签均可以变为棕色:

        <p id="JackName">杰克</p>
        <p id="RoseName">萝丝</p> 

子字符串匹配

只要属性中存在指定字符串即应用样式,使用[*=]形式实现,如:

        [id*="test"]{color:brown;}

那么下列的标签均可以变为棕色:

        <p id="Rosetest">段落1</p>
        <p id="testY">段落2</p> 
        <p id="xtesty">段落3</p>

以上就是CSS的学习笔记了,希望对大家有所帮助。然后对CSS感兴趣的同学可以看一下教程:

CSS教程:https://www.w3cschool.cn/css/

CSS微课:https://www.w3cschool.cn/minicourse/play/csscourse

联系我们