 小狮博客

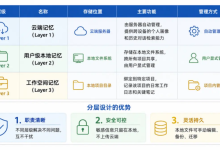
WorkBuddy记忆管理全景指南
WorkBuddy 采用三层记忆架构,分别对应不同的作用域和读写策略:
WorkBuddy 采用三层记忆架构,分别对应不同的作用域和读写策略:
一个 coding agent 同时接 GitHub、Slack、Jira、Sentry、Grafana、PagerDuty,再加几个内部 MCP server,很容易暴露上百个工具。传统做法是启动会话时把所有工具 schema 全塞进上下...
这篇文章会先从 AI 工作负载的典型 I/O 模式出发,梳理不同业务对存储系统提出的实际挑战;随后围绕 GPFS、Alluxio 和 JuiceFS 展开比较,分析它们在架构设计、文件系统语义、缓存机制、成本模型和适用边界上的差异,以及它们...
这个时候,如果你有一个自托管的 AI 网关,那么就可以非常轻易的汇总管理他们:
筛选项目时,我习惯先按 Star 排序 —— 毕竟 Star 多一般意味着项目质量好、社区认可度高,对吧?
承接上篇单次工具调用能力,本篇重点解决 Agent 工程落地的核心痛点,搭建 Observe-Think-Act 完整自主循环,实现多轮自主推理与迭代任务,同时针对性解决死循环、接口超时、程序崩溃、参数报错等常见问题,通过多层安全约束,完成...
命令的使用方式类似于 C 语言中的函数,命令后面需要提供一对括号,并且通常需要提供参数, 多个参数使用空格分隔而不是逗号 ,。
解决思路是两步走: 让压缩变主动, 让内容在源头就变少。
订单、库存、财务流水、项目台账、客户资料和操作日志,最后大多要用表格展示。只看最简单的例子,DataGrid 好像就是接收一组列和一个数组,然后画出表头、行和滚动条。
感谢 KaiCode’26 对 Wow 的认可,也感谢一路参与 Wow 的贡献者和使用者。